Представим главную страницу маркетплейса, музыкальную волну или ленту ресторанов. Каталог может содержать сотни тысяч или миллионы объектов, а пользователь ожидает несколько подходящих вариантов почти сразу. Простое решение — показать популярное или сравнить человека со всем каталогом — быстро упирается в ограничения: популярность слабо персонализирует, полный перебор дорог, история действий запаздывает, а хорошая модель поздней стадии уже не может вернуть объект, потерянный при раннем отборе.
Этот обзор собирает двадцать два опубликованных кейса в один учебный маршрут. Нас интересует не рейтинг компаний, а то, как меняется сама задача: от многоэтапной системы «отобрать → ранжировать → применить ограничения» к более общим представлениям, длинным последовательностям, семантическим идентификаторам и разным формам генеративных рекомендаций. Отдельно разберём обучение, индексирование и эксперименты: они готовят систему, но не являются шагами обработки одного пользовательского запроса. Текст рассчитан на читателя, который знает основы машинного обучения, но может впервые системно собирать RecSys целиком.
Граница выводов
1. Базовый путь: события → кандидаты → ранжирование → выдача
Объект рекомендации зависит от продукта. У Lamoda это товар, у Авито — объявление, у Яндекс Музыки — трек, у Uber Eats — ресторан или магазин, у Meta в рекламном кейсе — рекламное объявление. Система видит события: показы, клики, просмотры, поисковые запросы, лайки, пропуски, корзины, заказы. Эти события ещё не являются готовыми метками. Команда сама решает, что считать положительным действием, каким отрицательным сигналам доверять и какой временной горизонт использовать.
Для большого каталога полезно мыслить базовым маршрутом. Сначала история пользователя и признаки объектов превращаются в представления. Затем быстрый этап отбирает сравнительно небольшой пул кандидатов. Более дорогая модель ранжирует уже этот пул. После неё продукт применяет доступность, разнообразие, ограничения категории, логистики или рекламы и формирует видимую выдачу. Такой путь явно показан, например, у Lamoda и в вводной части ARGUS. Но это учебная схема, а не утверждение, что все двадцать два кейса устроены одинаково.
Таблицу можно прокрутить по горизонтали.
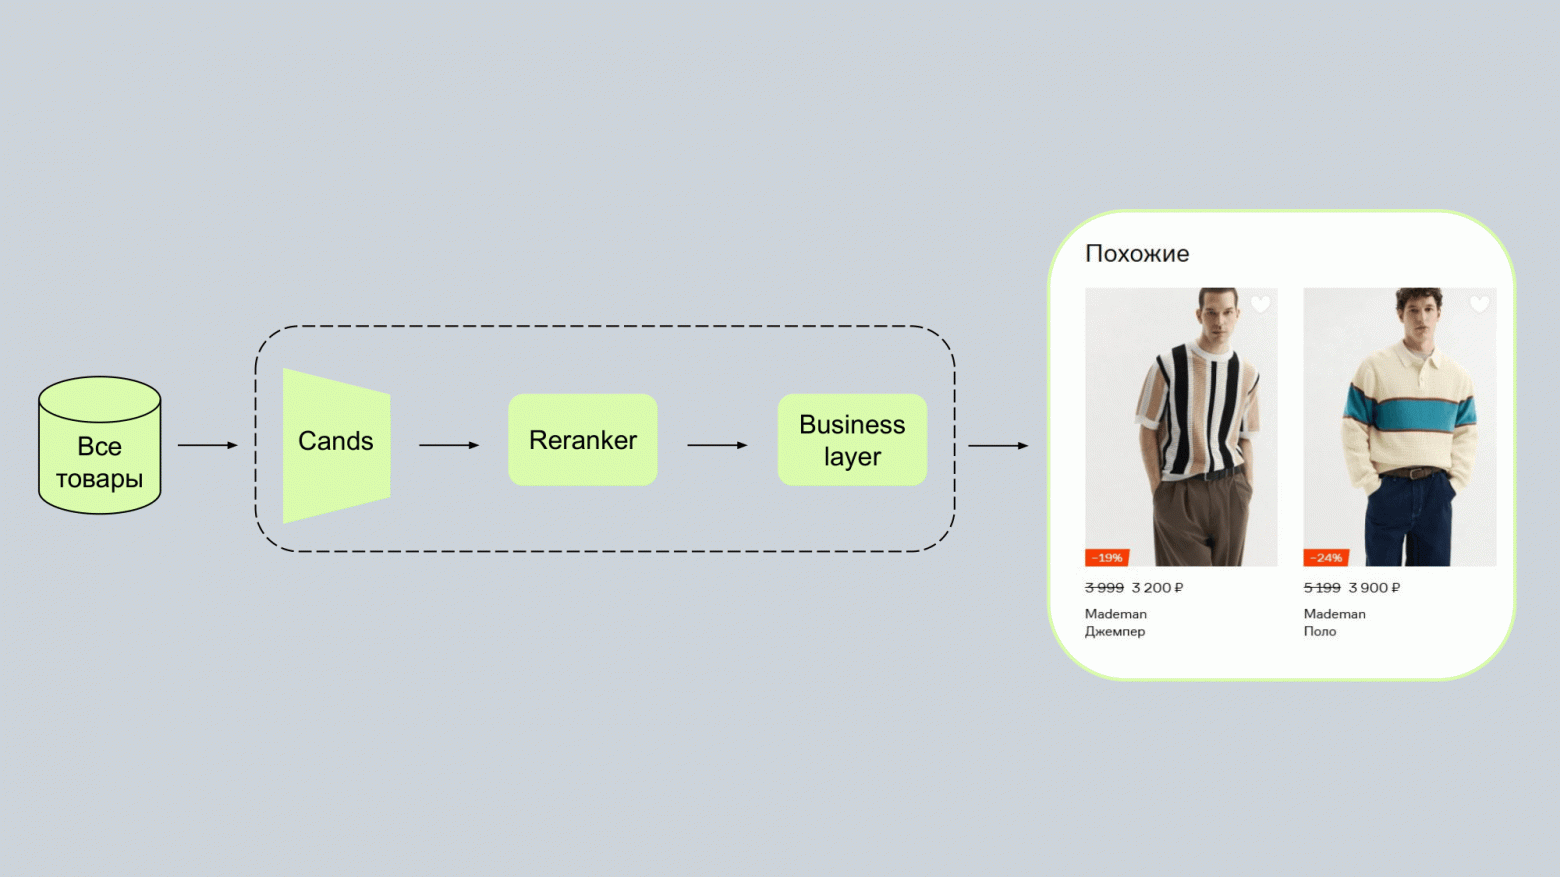
Lamoda показывает базовую причину каскада: тяжёлую модель невыгодно применять ко всему каталогу, поэтому сначала список быстро сужают, затем ранжируют точнее.
Источник: Lamoda, исходная статьяВажно отделить подготовку от запроса. Обучение модели, пересчёт эмбеддингов объектов, построение ANN-индекса, ежедневный расчёт кандидатов, A/B-тест и переобучение по свежим событиям могут занимать часы или идти непрерывно в фоне. При одном запросе пользователь не ждёт этих процессов: сервис читает уже подготовленные веса, индекс, признаки или кандидатов и выполняет только необходимую онлайн-часть.
2. Популярность, коллаборативные сигналы и графы не исчезли
Самый простой ориентир — популярность: что чаще смотрят, покупают или слушают. Она может быть базовым вариантом, отдельным признаком или запасным источником, особенно когда о пользователе мало данных. Но популярность не объясняет индивидуальный интерес и легко усиливает уже часто показываемые объекты. Поэтому современные кейсы не «убивают» этот сигнал, а помещают его рядом с более персональными представлениями. В Авито старый user2vec был взвешенной суммой векторов просмотренных объявлений, а популярность объявления оставалась одним из признаков ранжирования в прежней системе.
Коллаборативная фильтрация использует совместные действия пользователей: если объекты встречаются в похожих историях, их можно сближать даже без полного описания содержания. В Lamoda поведение использовалось как разметка похожести, а изображения и текст — как содержание товара. В Wildberries нижние кластеры Semantic ID позже применяли, чтобы накапливать коллаборативный сигнал на группе близких карточек. Это показывает не смену одной «эры» другой, а сочетание источников: содержание помогает новым и редким объектам, поведение лучше отражает реальные выборы, когда его достаточно.
Графовый подход тоже существует как отдельное семейство: вершинами могут быть пользователи и товары, рёбрами — просмотры, покупки или связи товар–товар. Но в этой подборке нет достаточно подробного промышленного GNN-кейса с сопоставимой постановкой, внедрением и метриками. Поэтому из двадцати двух глав нельзя делать вывод ни о популярности GNN в индустрии, ни о том, что конкретная компания «обязательно использует графовую нейросеть».
3. Две башни: почему быстрый поиск по векторам остаётся сильной основой
Двухбашенная модель строит вектор пользователя и вектор объекта независимо, а совместимость считает простой функцией, обычно скалярным произведением. Главное инженерное преимущество — векторы объектов можно вычислить заранее и положить в индекс приближённого поиска ближайших соседей (ANN). Во время запроса остаётся построить актуальный вектор пользователя и быстро найти близкие объекты. Это особенно удобно для стадии отбора кандидатов, где полный перебор каталога слишком дорог.
В Авито объектная башня кодирует объявление, а пользовательская башня-трансформер читает историю объявлений и поисков. Один и тот же скалярный сигнал используют двумя способами: как запрос к ANN-индексу для получения кандидатов и как дополнительный признак ранжировщика. Авторы сообщают, что мультикатегорийная модель как признак ранжирования дала +2,3% целевых действий покупателей на главной, а однокатегорийная модель для «Личных вещей» как источник кандидатов — +1,1% на главной и +8,1% внутри категории в указанных сценариях. Это разные проверки, их проценты не складываются.
В отдельном докладе Авито об объектном энкодере команда меняли только объектный энкодер кандидатной модели: вместо DCNv2 построили трансформер, который совместно обучается с пользовательским энкодером и строит представление из текста, изображений и атрибутов без отдельного запоминаемого вектора для каждого item ID в выбранной постановке. Итоговый A/B-тест новой версии дал +0,8% покупателей, +1,5% выручки монетизационных инструментов и +10% конверсии движка из показа в контакт по слайду автора. Это результат всей подготовленной версии, а не изолированная оценка одного attention-слоя.
Две башни не решают всё. Пользовательский вектор может слишком рано сжать длинную историю, а простое скалярное произведение ограничивает взаимодействие пары. Поэтому поздние стадии часто используют более модель, которая читает историю с учётом конкретного кандидата (target-aware), а новые работы пытаются переиспользовать общую обработку истории между множеством кандидатов вместо полного отказа от двухбашенного поиска.
4. Последовательности: порядок действий, длинная история и свежесть
Агрегированные счётчики отвечают на вопрос «что пользователь обычно делает», но теряют порядок. Последовательная модель читает события по времени и может отличить устойчивую привычку от недавно изменившегося намерения. В рекомендациях это особенно важно, потому что один клик, новый поиск или серия пропусков иногда меняют текущую задачу быстрее, чем успевает обновиться дневной профиль.
ARGUS сохраняет в истории тройку «контекст — объект — реакция» и совместно учится предсказывать следующий объект и будущий отклик. Масштабирование проверяли до энкодера 1,007 млрд параметров, но показанное продуктовое внедрение Offline V4 использовало Medium-конфигурацию на 126 млн параметров и историю 8192 событий. Для «Моей волны» на соответствующем слайде указаны +2,26% TLT и +6,37% Like Likelihood для этой внедрённой конфигурации. Экспериментальная большая модель и рабочая версия — не одно и то же.
Uber Eats начал с другой стороны. Гибрид сохранил DCNv2 для обычных признаков и добавил трансформер, учитывающий конкретного кандидата, который читает историю относительно конкретного ресторана. Затем UserContext сократил отставание признаков с дней до нескольких секунд в работающем контуре. Следующий вариант, построенный вокруг трансформера, оценивает список кандидатов за один проход: авторы оценивают вычислительную сложность на один магазин примерно как 1/T от pointwise-схемы при T одновременно оцениваемых магазинах в модели listwise scoring. Но статья не приводит CTR, CVR или GMV uplift и не раскрывает долю трафика, уже переведённую на эту архитектуру.
WildBERT показывает ещё одно измерение — два временных масштаба. Long-State хранит долгосрочный профиль примерно за год, а nearline обновляет краткосрочное состояние за считанные секунды. Замена части офлайн-выдачи на nearline дала +3,1% GMV главной, а отдельное повышение разнообразия — +3,5% в другом изменении. Их нельзя складывать. Netflix, в свою очередь, пытается сделать общую последовательную модель источником прогнозов и эмбеддингов для нескольких задач; это не означает, что весь продукт превращён в один генератор способ использования foundation model.
Pinterest TransAct V2 не пропускает десятки тысяч событий через трансформер целиком. Для каждого кандидата система ищет релевантные события в долгосрочной истории, свежей последовательности и показах, но независимо от сходства сохраняет несколько последних действий. В производственной конфигурации дорогая часть видит 192 события. Это кандидат-зависимый выбор истории внутри CTR-ранжировщика, а не генерация готового списка выбор событий.
Alibaba MUSE доводит тот же принцип до истории в 100 тысяч действий: быстрый поиск по истории (GSU) выбирает под рекламный товар события по заранее рассчитанным мультимодальным векторам, а более точный модуль (ESU) подробно обрабатывает 50 найденных событий GSU. Полного дорогого прохода по 100 тысячам событий для каждого кандидата нет.
LinkedIn Feed SR делает историю основой ранжировщика, но сохраняет полезные числовые признаки. Модель чередует показанные публикации и реакции, а популярность, возраст кандидата и связь с автором добавляет после трансформера позднее добавление признаков. При оценке множества публикаций общая история обрабатывается один раз общая обработка истории.
5. Что именно считается объектом: товар, похожий товар или текущее предложение
Иногда качество ограничивает не архитектура, а определение сущности. В похожих товарах Lamoda запросом служит исходный товар, а кандидаты должны быть одновременно похожими и полезными конкретному пользователю. Команда оставила два дополняющих источника: обученный мультимодальный вектор изображения+текста и отдельный визуальный FashionCLIP. При 200 кандидатах их пересечение было около 20%, что авторы использовали как признак взаимодополняемости источников. Затем CatBoost-реранкер учитывает товарные, пользовательские и совместные признаки. Финальная связка двух генераторов и реранкера дала статистически значимые +1,5% покупок в A/B-тесте.
Ozon показывает другую проблему: один item_id может жить при разных ценах и сроках доставки. Если клики и заказы полгода копились при цене 10 000 ₽, а сегодня товар стоит 5 000 ₽, отдельный свежий признак цены не отменяет старые поведенческие агрегаты. Поэтому команда ввела offer_id = item_id + price_bin + delivery_bin как идентификатор состояния предложения, а матрица W переносит между состояниями только часть прошлой истории в зависимости от близости.
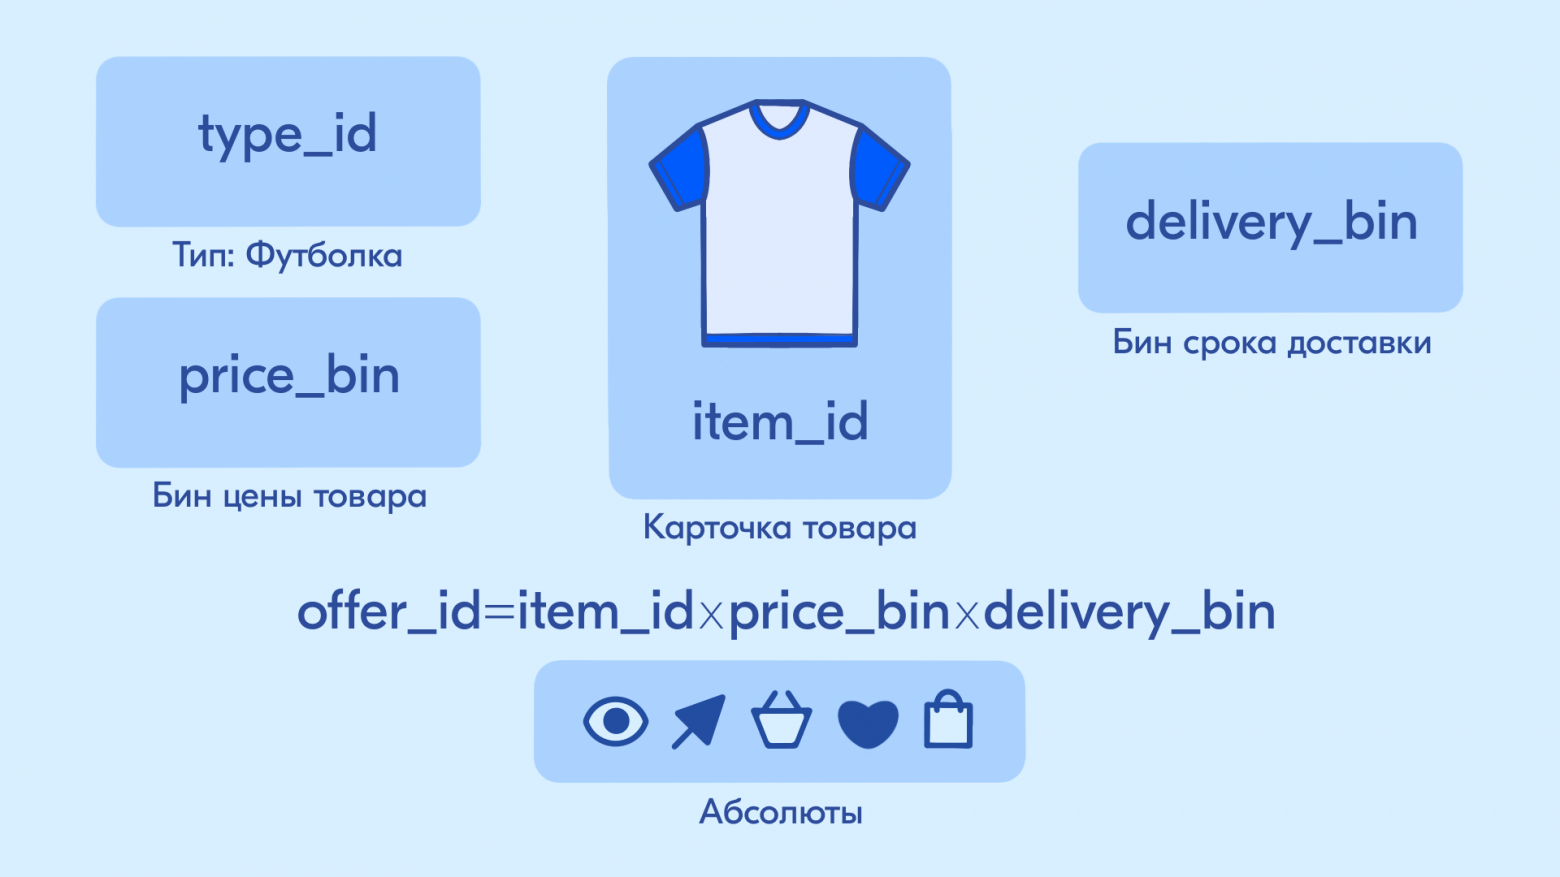
Ozon меняет не ранжирующую нейросеть, а единицу накопления истории: один товар в разных ценовых и логистических условиях становится разными предложениями для поведенческих агрегатов.
Источник: Иллюстрация из статьи Ozon TechТакой перенос помогает и холодному старту: новый продавец знакомого продукта может получить взвешенный сигнал от аналогов, а новый товар — от соседей категории в близких состояниях. Для товаров моложе двух недель с уже имеющейся активностью автор сообщает +5% заказов, +11% корзин и +19% просмотров в ретроспективной оценке. Отдельно два последовательных A/B-теста дали +0,4% к конверсии поисковой сессии в заказ и +0,9% к среднему GMV на пользователя на глобальных метриках. Эти уровни оценки нельзя смешивать.
6. Общая модель, общие эмбеддинги и генерация — три разные идеи
В современных публикациях легко смешать несколько изменений под словом «foundation» или «generative». Общая модель может просто учить представления для нескольких задач. Семантический идентификатор может заменить голый ID структурированным кодом. Генератор может выдавать коды кандидатов. А объединённая архитектура может совместно использовать дорогой энкодер истории для отбора и ранжирования. Это четыре разных изменения, хотя они способны встретиться в одной системе.
Таблицу можно прокрутить по горизонтали.
У Netflix мотивация — уменьшить число изолированных моделей и переносить знания между задачами. Foundation model можно использовать напрямую, брать её пользовательские и объектные эмбеддинги или дообучать под конкретное приложение тремя способами. Статья сообщает устойчивое улучшение относительного качества при росте данных и размера модели, но не публикует численное изменение продуктовых метрик в A/B-тесте при масштабировании. Поэтому foundation model здесь — общий слой обучения предпочтений, а не доказанная замена всего каскада одной генеративной выдачей.
Meta HSTU — фундаментальная ветка 2024 года. Авторы называют семейство Generative Recommenders, но в ранжировании по известному кандидату модель предсказывает пользовательское действие, а не готовый список ID. Генеративность относится к постановке обучения на общей истории; M-FALCON переиспользует эту историю между кандидатами задачи обучения и M-FALCON.
Alibaba LUM разводит роли ещё явнее: большая авторегрессионная модель по условию строит представления интереса, а финальный CTR-прогноз остаётся за DLRM три стадии. В sponsored search Taobao авторы версии v2 сообщают +2,9% CTR и +1,2% RPM онлайн-результаты. Генеративность LUM не означает, что рекламная выдача целиком генерируется LLM.
У Meta Adaptive Ranking слово LLM-scale относится к вычислительной сложности рекламы, а не к текстовой генерации. Ключевой приём — один раз посчитать дорогую пользовательскую часть для всего запроса и переиспользовать её для многих объявлений Request-Oriented Computation Sharing. После запуска на Instagram в IV квартале 2025 года Meta сообщает +3% рекламных конверсий и +5% CTR для targeted users в своей области измерения. Это рекламные метрики конкретной аудитории; переносить их на музыку, магазин или ресторанную ленту нельзя.
7. Semantic ID и генеративный поиск: генерируется объект, а не текст
Обычный ID хорошо различает конкретные объекты, но сам номер ничего не говорит об их сходстве. Семантический идентификатор (Semantic ID) — последовательность дискретных кодов, где общий префикс должен отражать близость содержания. У Wildberries код строят снизу вверх: сначала получают небольшие группы максимально близких товаров, затем объединяют их в более крупную иерархию построение иерархии. Такой путь выбран после проблем RQ-VAE, включая одиночные кластеры и коллапс кодбука в проверенной постановке.
Semantic ID не равен обычному ID. Несколько карточек могут делить код или длинный префикс; смысл именно в переносе статистики между близкими объектами и смене гранулярности. В уже описанном применении Wildberries расширение покрытия товаров коллаборативными представлениями связано с Ads Revenue +4%, а обучение на нижних кластерах — с десятикратным уменьшением числа «бакетов» по слайду автора. Второй результат ресурсный и с «серым» продуктовым итогом; он не означает десятикратное ускорение всей системы.
В докладе Яндекса 2025 года генеративность сначала относится к предварительному моделированию полной истории, а последующая рабочая задача всё ещё может быть дискриминативной. ARGUS учится на контексте, объекте и реакции, затем дообучается под отбор кандидатов или ранжирование двухэтапно. Дальше команда исследует единую модель и conditioning, но это направление не нужно выдавать за уже завершённую замену всего стека: показанные Like Recall для conditioning остаются офлайн-оценкой, а A/B-результата именно полного генеративного перехода в этой главе нет в эксперименте conditioning.
Генерация объекта здесь означает выбор идентификатора или его кода из каталога, а не написание текстового описания. И «teacher/student» не означает автоматически LLM: учителем может быть сильный ранжировщик. Это важно для Sona, где Teacher Recall и дистилляция используют Cross-ARGUS как модель качества, а не языковую модель.
Kuaishou OneRec меняет границу сильнее. Видео кодируются семантическими идентификаторами, а модель с энкодером истории и авторегрессионным декодером генерирует сразу последовательность из пяти видео, учитывая уже выбранную часть списка генерация целого списка. Затем отдельная персонализированная модель награды оценивает несколько собственных вариантов выдачи, а итеративная настройка предпочтений обучает генератор предпочитать более сильные списки модель награды и IPA. В онлайн-тесте на 1% основного трафика Kuaishou OneRec-1B+IPA дала +1,68% общего времени просмотра и +6,56% средней длительности просмотра относительно текущего каскада таблица 2. Это промышленный генеративный контраст Sona, но не генерация текста.
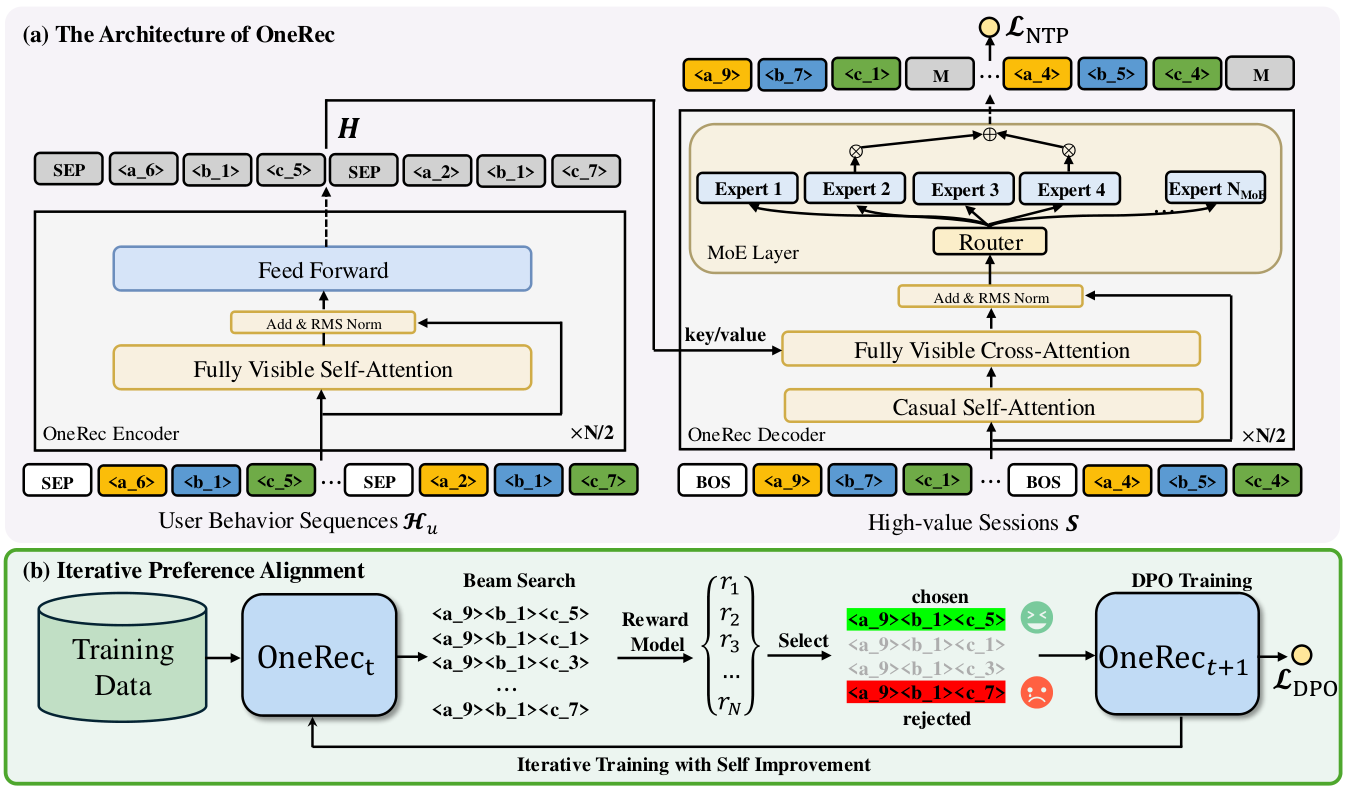
OneRec разделяет базовое обучение генерации списка и последующую настройку предпочтений по оценкам модели награды. Это другой способ объединения рекомендаций, чем генератор кандидатов плюс ранжирование в Sona.
Источник: Оригинальная иллюстрация · Kuaishou8. Sona: как каскад действительно сокращали по шагам
Кейс Sona важен тем, что переход не произошёл одним скачком. Исходная «Моя волна» имела несколько источников кандидатов, предварительное и финальное ранжирование. Сначала команда заменила только позднее ранжирование на Cross-ARGUS: кандидат получает доступ к представлениям длинной истории через cross-attention. На отдельном онлайн-эксперименте автор показывает +1,22% Active Users и +1,64% Total Listening Time для замены ранжировщика. Генерация кандидатов на этом шаге оставалась прежней.
Следующий шаг — Gryphon: трек представляется короткой последовательностью семантических кодов, генератор предсказывает код по частям, затем код отображается обратно в конкретные треки, которые всё равно нужно оценить отдельным модулем. В промежуточной системе генеративный отбор и Cross-ARGUS уже заменили старые генераторы, предварительное и финальное ранжирование двумя моделями. Затем общий энкодер истории объединил их в Sona: дорогая обработка истории выполняется один раз, но функции «предложить кандидатов» и «оценить кандидатов» сохраняются в одной архитектуре.
Обычный Recall плохо подходит для сравнения такой системы с логами старой выдачи: новая модель может предложить хорошую музыку, которой в старых показах просто не было. Поэтому команда использует Cross-ARGUS как учителя. Teacher Recall@k — доля верхних k объектов учителя, которые попали в верхние k новой системы. Это совпадение с сильным ранжировщиком, а не «доля правильных рекомендаций» и не пользовательская метрика определения и оговорки.
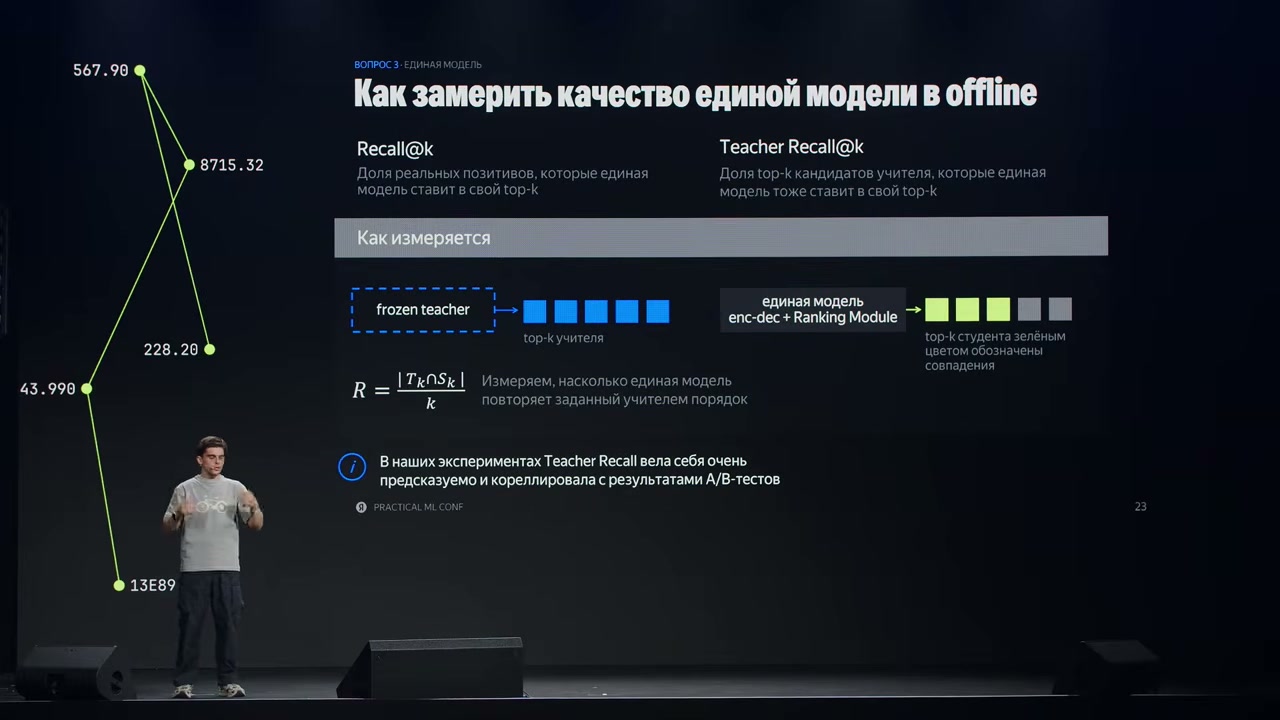
Teacher Recall нужен потому, что обычный recall воспроизводит взаимодействия, собранные старой системой. Учитель задаёт другой офлайн-ориентир, но A/B-тест всё равно остаётся отдельной проверкой.
Источник: Николай Савушкин · Practical ML Conf 2026Согласовать генератор и ранжировщик тоже пришлось отдельно. Если ранжировщик учится только на сохранённых показах старой системы, он плохо видит распределение кандидатов нового декодера. При дистилляции на собственных кандидатах текущий декодер генерирует варианты, замороженный Cross-ARGUS размечает их, а ранжировщик учится воспроизводить эти оценки. Teacher Recall@10 составляет 0,5654 для «кандидаты декодера + сохранённые показы», 0,5618 только для кандидатов декодера и 0,2983 только для старых показов в сравнении обучения. Это офлайн-метрика согласованности с учителем, не доля довольных слушателей.
Длинная история остаётся дорогой. В итоговой конфигурации показано 8192 события: 2048 свежих проходят более глубокую обработку, 6144 старых — меньшее число слоёв; автор сообщает качество, близкое к полной обработке, примерно при половине стоимости инференса на этом слайде. Веса публикуются каждые 10 минут, но медианный путь от события до обновления составляет 45 минут, p99 — 60 минут. Это свежесть модели, а не задержка ответа на запрос.
Финальный опубликованный A/B-тест относится к «Моей волне» на умных устройствах с Алисой: +4,53% Active users, +6,30% Total listening time, +7,37% Deeply engaged users, +11,42% Likes и +17,99% команд повтора относительно контроля. На дату доклада полного перевода всего трафика не было; другие поверхности и долгосрочный эффект продолжали проверяться. Свежие треки остаются отдельной проблемой: генератору в описанной постановке нужно увидеть объект при обучении ограничения.
9. Инфраструктура становится частью модели: индекс, стоимость инференса и свежесть
Даже сильное представление бесполезно, если поиск кандидатов или ранжирование не укладываются в бюджет. Meta SilverTorch идёт дальше обычного «модель + внешний индекс»: ANN-индекс, фильтрация допустимости и часть оценивания оформляются как состояние и операции одной PyTorch-модели Index as Model. После ANN нейронная переоценка может обработать больше кандидатов, а многозадачная оценка объединяет вероятности разных действий внутри retrieval. Это не означает, что индекс обязательно обучается градиентом: часть модулей всё равно задаётся инженерно.
Meta отдельно публикует системные числа: один вариант SilverTorch имеет 13,35× преимущество по cost-per-request, а отдельные операции получают свои ускорения — например, Int8 ANN 2,2–14,7× против Faiss-GPU и Bloom-проверка 291–523× против CPU-инвертированного индекса в конкретных измерениях. Эти множители нельзя перемножать: они относятся к разным участкам. Похожий принцип у Adaptive Ranking — сложность маршрутизируется по запросам, а общие пользовательские вычисления выполняются один раз; «дороже модель» становится осмысленным только вместе с контролем задержки и стоимости.
Ещё один повторяющийся приём — считать общий контекст один раз. TransAct V2 хранит одну историю запроса и передаёт кандидатам ссылки на неё; для последовательных признаков статья сообщает восьмикратное уменьшение PCIe-передачи shared history. HSTU использует M-FALCON, а LinkedIn совместно оценивает около 512 публикаций одной ленты общая обработка истории. Эти множители относятся к отдельным операциям, не ко всему сервису.
ByteDance RankMixer показывает другой путь: крупный ранжировщик не обязан быть трансформером или генератором. Группы признаков превращаются в токены, перемешиваются и проходят собственные полносвязные сети mixer. В таблице авторов плотная часть растёт с 15,8 млн до 1,1 млрд параметров, а задержка модели меняется с 14,5 до 14,3 мс при одновременном переходе fp32→fp16 и лучшей загрузке GPU условия.
Свежесть — тоже отдельная ось. Uber сократил лаг признаков до секунд, WildBERT держит nearline рядом с Long-State, SilverTorch потоково обновляет состояние индекса без полной публикации модели между снапшотами. Историческая ветка здесь — Monolith 2022. Он отделяет непрерывное обучение от пользовательского запроса, синхронизирует изменившиеся разреженные параметры на уровне минут, а плотные — примерно раз в день в описанном производственном режиме. Это полезный ранний кейс динамических эмбеддингов и непрерывного обучения, но не «первый свежий материал» основного маршрута 2025–2026.
В Monolith живой рекламный эксперимент публикует показатель AUC Improvement % по дням для Ads-модели. Его нельзя переименовать в CTR, GMV или конверсию. Это хороший пример общей дисциплины обзора: инфраструктурная свежесть, офлайн-AUC и бизнес-поведение — разные уровни доказательств.
10. Офлайн-метрика выбирает кандидата на A/B, но не заменяет A/B
Метрика всегда отвечает на конкретный вопрос. Recall@K спрашивает, сколько нужных объектов попало в top-K; NDCG дополнительно учитывает порядок; AUC сравнивает распределение оценок положительных и отрицательных примеров; Teacher Recall сравнивает список с учителем. CTR, конверсия, GMV, покупки, время прослушивания и активные пользователи уже измеряют поведение продукта. Даже если названия похожи, база, знаменатель, когорта и способ сбора данных определяют смысл числа.
Таблицу можно прокрутить по горизонтали.
Особенно легко смешать базы у HSTU. +65,8% NDCG@10 относится к публичному Books: 0,0257 против 0,0156 офлайн-оценка. Отдельные +12,4% по E-Task и +4,4% по C-Task получены в онлайн-ранжировании Meta онлайн-результаты; источник не раскрывает задачи настолько, чтобы назвать их CTR, CVR или GMV.
У Pinterest +13,31% HIT@3/repin офлайн сравнивается с Wide & Deep без последовательных признаков офлайн-оценка, а онлайн V2 сравнивается с работающим TransAct и даёт +6,35% сохранений и −12,80% скрытий онлайн-результаты. У OneRec офлайн-таблица основана на оценках модели награды, а +1,68% общего времени просмотра и +6,56% средней длительности — онлайн-метрики на 1% основного трафика онлайн-результаты.
Доклад МТС на AiConf 2024 полезен именно как предупреждение об офлайн-валидации. Разбиение делается по времени: обучение использует прошлое, тест — следующий период, что снижает риск утечки будущих взаимодействий разбиение по времени. Затем популярные объекты даунсемплируются только в тестовой оценке; обучающая выборка не переписывается под каждый коэффициент. В первом Ticketland-исследовании обучили 150 вариантов одного класса моделей и оставили 84 после фильтрации для офлайн-анализа. Это не 150 архитектур и не 84 A/B-теста.
В ретроанализе четырёх моделей обычные метрики максимум давали ранговую корреляцию 0,8 с конверсией. После перебора примерно 400 сочетаний метрики и коэффициента преобразования 43 конфигурации получили ранговую корреляцию 1 на этом маленьком наборе. Итоговая выбранная настройка — PartialAUC@3 при iqr_coef = −0,25; на тех же четырёх моделях указаны Pearson 0,877 и ранговая корреляция 1 для ретроспективной связи. Это способ лучше согласовать офлайн-отбор с известными A/B, а не доказательство роста покупок от самой метрики.
Особенно опасно путать проценты и процентные пункты или разные когорты. Ozon сохраняет знак % там, где источник не уточняет относительное изменение против пунктов для доли новинок. У Meta Ads +3% конверсий и +5% CTR относятся к targeted users. У Sona проценты относятся к эксперименту на умных устройствах с Алисой. Если знаменатель, поверхность или контроль отличаются, числа нельзя складывать, вычитать или ранжировать как общий рейтинг моделей.
11. Как читать подборку без двадцати двух полных глав подряд
Основной маршрут нужен для понимания изменения архитектур, а не для чтения всех деталей каждой компании. Достаточно пройти указанные разделы; полную главу открывайте, когда соответствующий компромисс появляется в вашей системе.
- 1. Lamoda: почему нужен каскад → два источника кандидатов. Цель: понять, почему полнота раннего отбора и точность позднего ранжирования — разные задачи.
- 2. Авито: двухбашенная модель → как она работает в продукте. Цель: связать эмбеддинги, ANN-поиск, пользовательскую историю и применение одного сигнала и в кандидатах, и в ранжировании.
- 3. ARGUS: место трансформера в RecSys → контекст–объект–реакция → внедрение. Цель: увидеть, как длинная история и общая задача обучения переходят в рабочий каскад.
- 4. Netflix: зачем общая модель → три способа использования. Цель: отделить общую базовую модель и эмбеддинги от идеи «одна модель генерирует всю выдачу».
- 5. Яндекс: что называется генеративным → переход к единой модели. Цель: понять, как генеративное предобучение, conditioning и замена каскада относятся друг к другу.
- 6. Sona: исходный каскад → Teacher Recall → итоговый эксперимент. Цель: закончить маршрут конкретным переходом Cross-ARGUS → генератор кодов → общая модель и сохранить границы A/B-теста.
Если базовый каскад уже знаком, генеративную ветку можно пройти коротко: Sona генерирует коды кандидатов и затем ранжирует их на общей истории; OneRec генерирует последовательность видео и настраивает её по модели награды; LUM оставляет финальное решение обычному ранжировщику и даёт ему признаки интереса. Это три разные границы объединения.
Оставшиеся шестнадцать глав — ветки по задаче, а не «второй обязательный курс»; OneRec и LUM уже получили роль в короткой генеративной ветке выше.
- Объект и коммерческий контекст: Ozon — offer_id меняет единицу статистики; Авито — item-энкодер усиливает представление объекта без перестройки всего каскада.
- Длинная история под кандидата: TransAct V2 сохраняет релевантные и свежие события; MUSE ищет полезные события по мультимодальным векторам среди истории до 100K.
- Свежесть: Uber Eats связывает target-aware историю с near-real-time признаками; WildBERT разделяет краткосрочное состояние и Long-State.
- Последовательный ранжировщик: HSTU объясняет историческую постановку GR и общие вычисления; LinkedIn Feed SR сочетает трансформер с числовым контекстом.
- Инфраструктура и бюджет: SilverTorch объединяет индекс и часть оценивания; Adaptive Ranking распределяет вычисления между рекламными запросами.
- Коды и плотное масштабирование: Wildberries Semantic ID строит иерархию объектов; RankMixer масштабирует MLP-подобный ранжировщик без обязательной генерации.
- Проверка и историческая свежесть: МТС согласует офлайн-выбор с A/B; Monolith остаётся веткой 2022 года про непрерывное обучение.
12. Что действительно меняется в этой подборке — и что пока рано обобщать
В пределах этих двадцати двух источников повторяется не один «победивший алгоритм», а несколько способов сделать историю полезнее. Одни системы увеличивают окно и специализируют последовательную модель, как HSTU и ARGUS. Другие сначала выбирают из огромной истории только нужные кандидату события, как TransAct V2 и MUSE. Третьи стараются вычислить общий контекст один раз и переиспользовать его для многих кандидатов — LinkedIn Feed SR, HSTU, Sona и Meta Adaptive Ranking. Это разные ответы на одну цену: подробно перечитывать длинную историю отдельно для каждого объекта слишком дорого.
Генеративная линия тоже расходится на несколько ветвей. Sona генерирует семантические коды кандидатов и затем ранжирует конкретные треки на общих представлениях истории. OneRec генерирует целую последовательность видео и отдельно согласует её с моделью награды. LUM вообще не обязана генерировать финальную выдачу: большая модель поведения готовит контекстные признаки для обычного CTR-ранжировщика. Параллельно RankMixer показывает, что масштабировать качество можно и через переработку плотного MLP-ранжировщика под GPU, без обязательного трансформера или генерации.
Из подборки нельзя честно вывести популярность методов на всём рынке. HSTU 2024 года здесь важен как фундаментальная историческая работа, а более поздняя дата публикации кейса не делает его «свежим внедрением». В источниках 2025–2026 годов тоже различаются статусы: есть продуктовые A/B-тесты, отдельные рабочие компоненты, инфраструктурные измерения и направления дальнейшего перехода. Популярность, коллаборативные сигналы, контентные признаки, двухбашенный ANN, CatBoost и другие прежние инструменты продолжают жить внутри новых систем; появление генеративной модели не делает их автоматически устаревшими.
Заключение
Современная рекомендательная система начинается не с выбора трансформера, а с конкретного объекта, доступных событий и продуктовой цели. В большом каталоге нужно понимать, где хороший объект может потеряться, какую часть истории имеет смысл читать подробно и какие вычисления можно разделить между кандидатами. Двухбашенные модели остаются сильной основой быстрого поиска; последовательные модели добавляют порядок и контекст; Semantic ID меняет представление каталога; генеративные подходы могут генерировать кандидатов, целый список или лишь признаки для привычного ранжировщика. Sona, OneRec и LUM хорошо показывают, насколько разными бывают эти границы.
- 01
Собрать контекст
Сервис получает доступные на этот момент события пользователя, контекст запроса и заранее рассчитанные признаки объектов.
- 02
Подготовить кандидатов или список
Каталог сокращается через источники кандидатов, ANN-поиск или генерацию кодов; в более объединённой модели может сразу формироваться последовательность объектов.
- 03
Использовать историю
Модель читает нужную часть истории: целиком в допустимом окне, через выбранные события или через общий контекст, переиспользуемый между кандидатами.
- 04
Оценить и применить ограничения
Ранжирование или генеративная модель определяет порядок, после чего продукт учитывает доступность, разнообразие, логистику, рекламу и другие ограничения.
- 05
Показать и собрать обратную связь
Показы, клики, пропуски, покупки и прослушивания становятся будущими данными для обучения и экспериментов.
Обучение, построение индекса, пересчёт эмбеддингов, подготовка длинных историй, обучение модели награды и A/B-тест находятся вне этого пути запроса. Офлайн Recall, NDCG, AUC или Teacher Recall отвечают на разные вопросы и не заменяют продуктовые метрики. Главное общее изменение в этих кейсах — более тесное согласование представлений, истории, отбора и ранжирования при явном контроле вычислительной цены. Каскады не исчезли как класс: где-то их сокращают, где-то усиливают общей моделью, а где-то сохраняют и улучшают отдельный компонент. Поэтому переносить стоит не чужой процент прироста, а постановку: что именно заменили, на каком трафике проверили и какой ценой.
Первоисточники
Обзор собран по опубликованным разборам. Подробности измерений, исходные иллюстрации и ссылки на разделы находятся в соответствующих главах.
- От рекомендательного стека к одной генеративной модели в Яндекс Музыке
- ARGUS: как масштабировать рекомендательные трансформеры
- Foundation Model for Personalized Recommendation
- Как мы улучшили рекомендации для пользователей Авито с помощью трансформенной персонализации
- Эволюция similar-рекомендаций: как мы переосмыслили ленту похожих товаров
- От товара к предложению: как Ozon учитывает цену и доставку в ранжировании
- Next-Gen Restaurant Recommendation with Generative Modeling and Real-Time Features
- Трансформеры для персональных рекомендаций на маркетплейсе: от гипотез до A/B-тестирования
- Monolith: Real Time Recommendation System With Collisionless Embedding Table
- SilverTorch: Index as Model — A New Retrieval Paradigm for Recommendation Systems
- Meta Adaptive Ranking Model: Bending the Inference Scaling Curve to Serve LLM-Scale Models for Ads
- «Semantic IDs: архитектура и наш опыт внедрения» — Александр Тришин
- Как мы развивали трансформерный item-энкодер в рекомендательной модели
- Генеративные рекомендательные технологии в Яндексе / Николай Савушкин
- Валидация в RecSys для корреляции с А/В: что работает в контентных рекомендациях / Дарья Тихонович (AiConf 2024)
- TransAct V2: Lifelong User Action Sequence Modeling on Pinterest Recommendation
- Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative Recommendations
- OneRec: Unifying Retrieve and Rank with Generative Recommender and Preference Alignment
- Unlocking Scaling Law in Industrial Recommendation Systems with a Three-step Paradigm based Large User Model
- MUSE: A Simple Yet Effective Multimodal Search-Based Framework for Lifelong User Interest Modeling
- RankMixer: Scaling Up Ranking Models in Industrial Recommenders
- An Industrial-Scale Sequential Recommender for LinkedIn Feed Ranking