Разбор готов
ByteDance RankMixer: как увеличить ранжировщик до миллиарда параметров без роста задержки
Лента коротких видео должна быстро оценивать кандидатов по истории человека, свойствам ролика и сотням других признаков. Более сложная модель может лучше учитывать их сочетания, но простое расширение нейросети не гарантирует ни качества, ни эффективной работы GPU. В RankMixer команда ByteDance изменила устройство плотной части ранжировщика: сгруппировала признаки в токены, организовала дешёвый обмен информацией между ними и дала каждому токену собственную сеть. Разбор опирается на версию v3 от 26 июля 2025 года. В ней есть архитектура, отключения компонентов, эксперименты с разреженными экспертами, таблица стоимости и отдельные A/B-результаты для Douyin, Douyin Lite и рекламы.
Для инженеров, которым нужно понять связь между моделью ранжирования и оборудованием: почему число параметров не равно стоимости и как проверять заявления о масштабировании.
Рекомендуем. Читайте после Feed SR: здесь главный вопрос — не устройство истории, а взаимодействия разнородных признаков и реальная стоимость крупного ранжировщика.
Публикация · на английском
RankMixer: Scaling Up Ranking Models in Industrial RecommendersОткрыть оригинальную статью (PDF)Jie Zhu, Zhifang Fan, Xiaoxie Zhu, Yuchen Jiang и соавторы · ByteDance · Опубликовано: 21 июля 2025 г.
Почему большой ранжировщик может плохо использовать мощный GPU
В промышленном ранжировании признаки приходят из разных источников: ID человека и ролика, статистика взаимодействий, представление истории, признаки автора и пересечения пользователя с кандидатом. Сеть должна учитывать их совместное влияние. В старых архитектурах для этого постепенно добавляли разные специальные модули. Каждый мог приносить качество, но их сочетание не обязательно превращалось в удобные для GPU крупные матричные операции.
Авторы описывают режим, когда вычисления ограничены чтением памяти и накладными расходами, а арифметические блоки GPU недогружены. Увеличение числа параметров тогда не равно полезному увеличению вычислительной работы. Некоторые более широкие или глубокие модели улучшали качество слабо, а иногда ухудшали его.
RankMixer меняет плотную часть ранжировщика над входными представлениями. Он не заменяет поиск кандидатов и не требует превращать весь запрос в текст. Слово «токен» здесь означает вектор группы признаков, а не слово языка или ID генерируемого видео. Это принципиально другой уровень системы, чем OneRec или языковой помощник.
S1 · §1: IntroductionИз сотен признаков собирают небольшое число токенов
Разные признаки сначала переводятся в векторы. Затем их группируют по смыслу и приводят к одинаковой размерности. Например, связанные пользовательские признаки оказываются рядом, а признаки кандидата образуют другую группу. Авторы используют знание предметной области при группировке; несмотря на название подпроцедуры tokenization, это не готовый языковой токенизатор.
Один токен на каждый из сотен признаков тоже неудобен: на токен приходится слишком маленькая сеть, матрицы дробятся, важные взаимодействия получают мало вычислений. Противоположная крайность — один общий токен — приближает архитектуру к обычной MLP и скрывает различия признаковых пространств. Поэтому число и размер токенов выбирают как параметры модели.
В конфигурациях статьи 100-миллионная модель использует 16 токенов ширины 768 и два блока; миллиардная — 32 токена ширины 1536 и два блока. Это конкретные найденные настройки на данных Douyin. Они не являются рекомендацией брать те же размеры для другого объёма данных или оборудования.
S3.SS2 · §3.1–3.2Как токены обмениваются информацией без self-attention
Каждый блок RankMixer сначала перемешивает информацию между токенами, затем применяет отдельную полносвязную сеть к каждому результату. В механизме Multi-Head Token Mixing вектор токена делится на части, после чего части из разных токенов перегруппировываются. Так следующий слой получает сведения из разных признаковых пространств без построения полной матрицы парных весов внимания.
Полезная интуиция: независимые специалисты по группам признаков должны обменяться короткими порциями информации, а не каждый раз заново вычислять, насколько каждый специалист похож на каждого другого. После обмена каждый токен обрабатывает собственная FFN. У этих сетей разные параметры, поэтому признаки разного происхождения не вынуждены проходить через одну и ту же функцию.
Вокруг двух частей блока остаются нормализация и остаточные связи. Выходы последних токенов усредняются и используются для прогнозирования целевых действий. Последовательные признаки могут быть подготовлены отдельным модулем истории до RankMixer: модель смешивает уже полученные признаки, а не обязана сама быть полным кодировщиком всех событий пользователя.
- 01
Подготовить группы
Разнородные признаки переводятся в векторы и собираются в смысловые группы.
- 02
Выровнять токены
Группы проецируются в одинаковую ширину, подходящую для параллельных операций.
- 03
Смешать части
Multi-Head Token Mixing передаёт информацию между признаковыми группами.
- 04
Обработать отдельно
У каждого токена своя FFN; блоки повторяются, затем выходы объединяются для целевых задач.
Что подтвердили отключения компонентов
Авторы сравнивают несколько способов передавать информацию между токенами при близком вычислительном бюджете. Удаление перемешивания ухудшает AUC: независимые сети видят только свои части признаков. Замена собственных сетей токенов общей FFN тоже ухудшает результат. Значит, пользу даёт сочетание обмена между пространствами и отдельной обработки каждого пространства.
Self-attention между токенами в таблице 3 даёт близкое, но немного худшее качество, при этом добавляет 16% параметров и 71,8% FLOPs относительно выбранного способа перемешивания. Это измеренный компромисс в данной архитектуре; из него не следует, что внимание бесполезно для рекомендаций вообще.
В отдельном сравнении простое увеличение DLRM-MLP до примерно 100 млн параметров даёт ограниченный выигрыш. RankMixer-100M лучше использует похожий масштаб. Поэтому доказательство здесь строится не только на финальной большой модели: есть промежуточные сравнения структуры и отключения её частей.
S4.SS4 · §4.4, таблицы 2–3Как сравнивали масштаб и качество
Офлайн-эксперименты используют журналы Douyin и более 300 признаков: числовые, идентификаторы, признаки истории и пересечения. Цели включают досмотр и быстрый пропуск видео. Авторы измеряют обычный AUC, пользовательский UAUC, число плотных параметров и FLOPs. Таблица качества и график вычислительных затрат отвечают на разные вопросы.
Кривые показывают, что в проверенном диапазоне RankMixer улучшался при увеличении ширины, числа токенов и размера сети. Более широкие матрицы при этом лучше использовали GPU, чем простое наращивание глубины. Поэтому считать модель хорошей только по кривой «AUC против параметров» недостаточно: другая архитектура может достигать похожего AUC ценой намного большего числа операций.
Такие кривые относятся к конкретным данным, задачам и распределённому обучению статьи. Они не доказывают неограниченный рост качества и не отменяют ограничения памяти, подготовки признаков и пропускной способности сервиса.
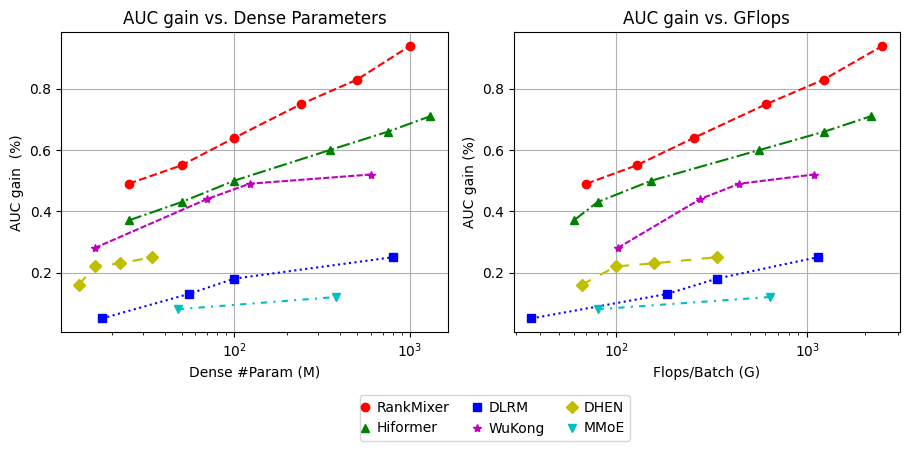
Рисунок 2: авторы сопоставляют качество с числом параметров и FLOPs. Сравнение стоимости требует смотреть обе оси.
Источник: Оригинальная иллюстрация · ByteDanceЗачем понадобились разреженные эксперты
Чтобы увеличивать вместимость модели без пропорционального увеличения работы на каждый пример, собственные FFN токенов можно расширить до смеси экспертов. Во время применения активируется только часть сетей. Но обычная разреженная маршрутизация создаёт проблему: одни эксперты получают много примеров, другие почти не обучаются и становятся бесполезными.
В исследованном варианте Dense-Training / Sparse-Inference обучение использует более плотный путь, а применение — разреженный. Для выбора экспертов авторы рассматривают ReLU-маршрутизацию и штраф, который удерживает среднюю долю активированных экспертов около заданного бюджета. В отличие от жёсткого одинакового top-k, разным токенам можно выделить разное число экспертов.
График показывает офлайн-сравнение таких вариантов при уменьшении доли активных экспертов. Он объясняет путь дальнейшего увеличения модели, но не означает, что все показатели основной миллиардной модели и всех разреженных вариантов получены в одной конфигурации. В частности, ускорение sparse-GEMM нужно читать отдельно от таблицы основного промышленного сравнения.
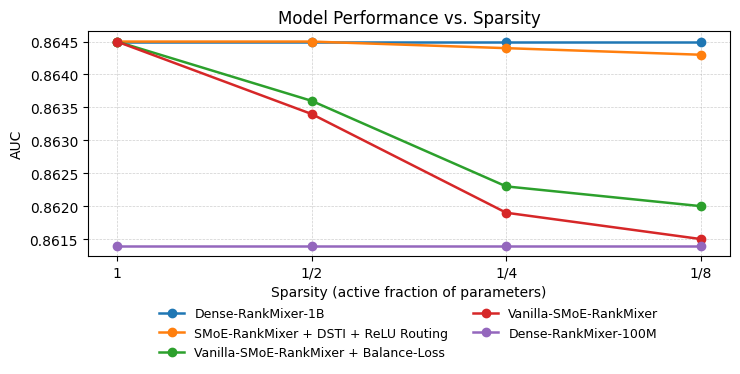
Рисунок 3: качество разных вариантов смеси экспертов при изменении доли активируемых сетей. Это отдельный эксперимент с разреженностью.
Источник: Оригинальная иллюстрация · ByteDanceИз чего складывается почти неизменная задержка
Таблицу можно прокрутить по горизонтали.
MFU — доля теоретически доступной вычислительной производительности GPU, которую использует модель. Сама по себе высокая MFU не гарантирует полезного качества, но здесь она помогает объяснить, почему рост числа операций не привёл к такому же росту задержки. Крупные матрицы лучше используют оборудование, а собственные FFN уменьшают число операций на параметр.
Инженерная часть включает объединение параллельных FFN в один вычислительный оператор, более крупные матрицы и переход основных операций с fp32 на fp16. В версии v3 авторы объясняют задержку через три фактора: операции на параметр, использование GPU и доступную аппаратную производительность при выбранной точности. Разреженные эксперты исследованы отдельно; не следует приписывать все результаты таблицы основного сравнения одной sparse-MoE-оптимизации.
Число параметров в таблице выросло примерно в 70 раз. В других местах статьи встречается более общее утверждение о стократном росте. Для конкретной конфигурации надёжнее опираться на сами значения 15,8 млн и 1,1 млрд и не заменять их более эффектным округлением.
S4.SS6 · §4.6 и таблица 6Что именно измерили в Douyin и рекламе
Таблицу можно прокрутить по горизонтали.
Активные дни — среднее число дней использования приложения за период эксперимента, а не размер дневной аудитории напрямую. Рост времени в приложении тоже нельзя переименовывать в рост выручки. Рекламный ADVV измеряется в другом сценарии, поэтому рекламные и пользовательские результаты не образуют единый общий процент.
В ранней HTML-версии v2 подробная таблица содержала меньшие показатели, чем аннотация. Версия v3 обновляет таблицу 4: авторы уточняют, что результаты длительных обратных A/B-тестов продолжали расти, и отмечают обновление от 24 июля 2025 года. В этом разборе используем более позднюю таблицу с явно указанным overall-сегментом. Поэтому числа из старых пересказов нельзя смешивать с обновлённым результатом.
В разбиении по активности выигрыш в активных днях выше у менее активных пользователей. Это наблюдение конкретного A/B-теста. Оно не доказывает универсального решения холодного старта и не заменяет отдельную проверку новых пользователей.
S4.SS7 · §4.7 и таблицы 4–5Что стоит перенести в свою систему
Первый переносимый вопрос — какие операции реально занимают время. Если GPU ждёт память или множество маленьких запусков, простое добавление параметров может быть не главным ограничением. Второй вопрос — как сгруппировать признаки так, чтобы сохранить их смысл и получить крупные параллельные операции. Третий — соответствует ли усложнение модели выигрышу на целевых действиях пользователей.
Для собственного эксперимента сначала нужен сильный исходный ранжировщик, одинаковые признаки и сопоставимые условия обслуживания. Затем следует отдельно сравнить группировку признаков, способ обмена токенов, размер модели и точность вычислений. Иначе будет непонятно, дал ли качество новый механизм взаимодействий или просто другая конфигурация оборудования.
Сопоставьте RankMixer с Feed SR и Meta Adaptive Ranking. Первый переиспользует общую историю между кандидатами, второй распределяет вычисления под запрос. RankMixer показывает ещё один путь — переработать саму плотную архитектуру под разнородные признаки и GPU. Эти решения могут дополнять друг друга, но статья не проверяет их совместный эффект.
S5 · §5: Conclusion; выводы из §3–4