ARGUS: учиться на показах, контексте и реакции пользователя
Предсказание только следующего понравившегося объекта теряет отрицательную обратную связь и влияние прежней системы рекомендаций. ARGUS совместно предсказывает следующий объект взаимодействия и реакцию человека, учитывая контекст события.
Статья · на русском
ARGUS: как масштабировать рекомендательные трансформерыКирилл Хрыльченко · Опубликовано: 20 июня 2025 г.
Две задачи вместо одного положительного события
История состоит из троек: контекст, объект и обратная связь. Контекст объясняет, откуда пришло взаимодействие, на какой странице оно произошло и какие настройки действовали. Реакция может включать лайк, пропуск и долю прослушанного.
Первая задача предсказывает объект следующего взаимодействия, включая отрицательные исходы. Вторая, уже зная объект, предсказывает реакцию пользователя. Это помогает отдельно учить поведение прежних рекомендаций и предпочтения человека. Органические действия, например поиск и собственная библиотека, также входят в историю.
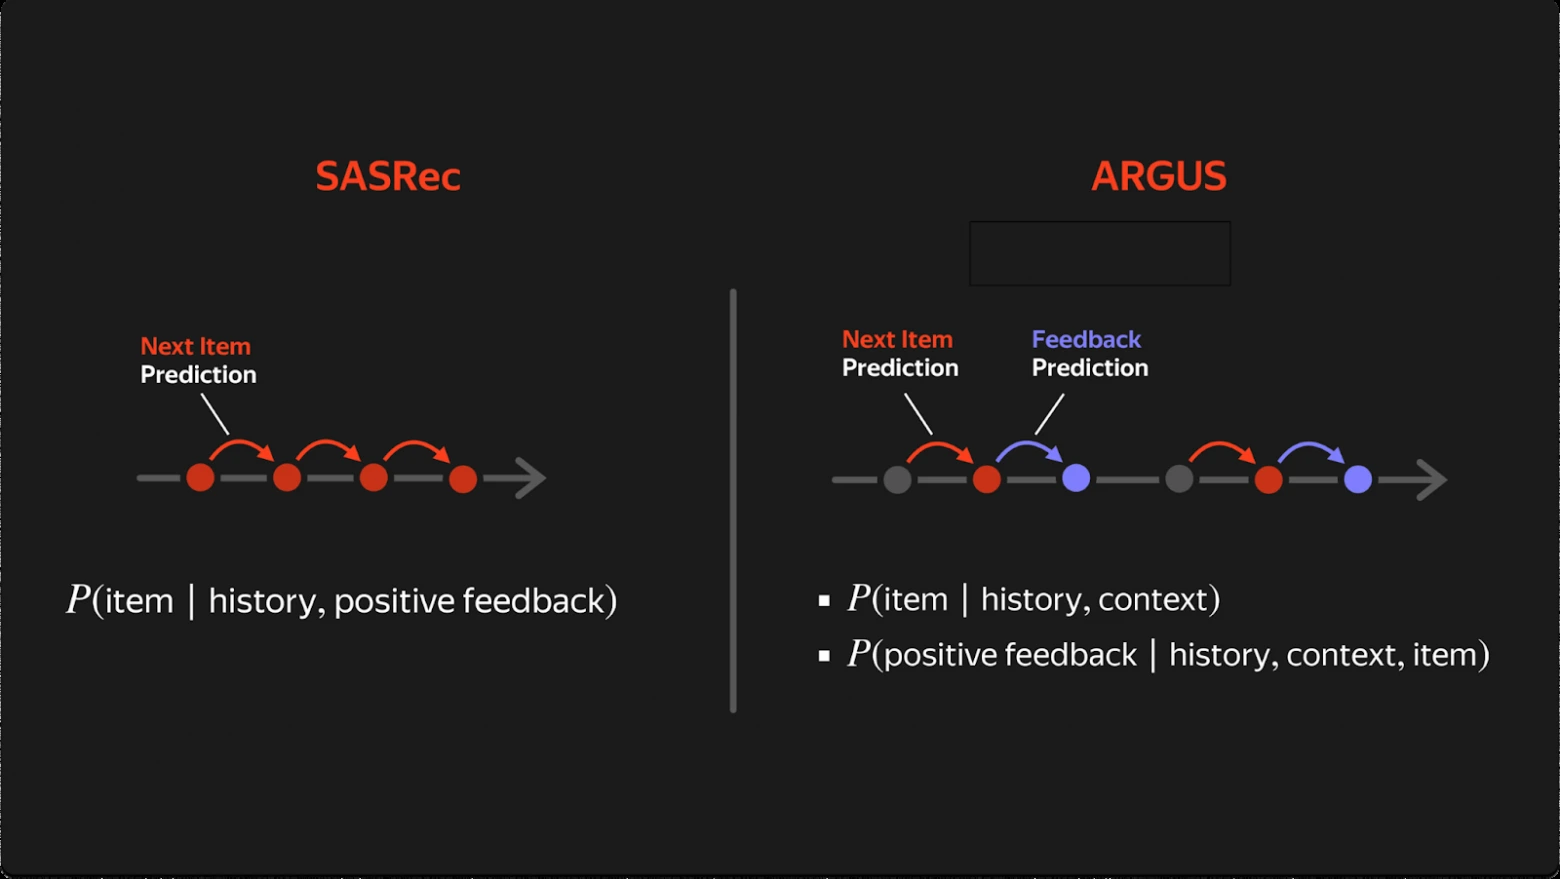
Разница целей SASRec и ARGUS.
Источник: Иллюстрация из оригиналаПочему это дорого и как упростили вход
Три токена на событие утраивают историю. В Simplified ARGUS контекст, объект и реакцию объединяют в один вектор, сохраняя обе цели обучения. Текущий контекст и объект добавляются к выходу трансформера при вычислении соответствующего предсказания.
По описанию автора упрощение ускоряет обработку примерно втрое, но делает представление менее зависимым от конкретного целевого объекта. Это осознанный компромисс между выразительностью и вычислениями.
Этот фрагмент в оригиналеПервое внедрение было офлайновым
Большую модель не стали сразу целиком запускать на каждом запросе. Её дообучили как двухбашенную: векторы пользователей и объектов пересчитываются ежедневно, а в реальном времени достаточно их скалярного произведения.
Результат стал новым признаком существующего ранжировщика. Для совместимости с его задачей ARGUS дообучали на попарном порядке показанных треков, а задержку истории в один день воспроизводили в обучении. Это отличается от прямого использования двух предобученных выходов модели.
Этот фрагмент в оригиналеПовторные прогоны заменили обучением по последовательности
Каузальная маска позволяет получить представления пользователя для многих моментов истории за один проход. Затем показы сопоставляют с нужным прошлым состоянием и считают потери сразу для множества событий.
На практике история разбита на ограниченные по длине фрагменты: формулировка «год за один проход» не означает неограниченный контекст. Для предобучения собрали более 300 млрд прослушиваний; проверяли на следующей неделе по общей временной границе.
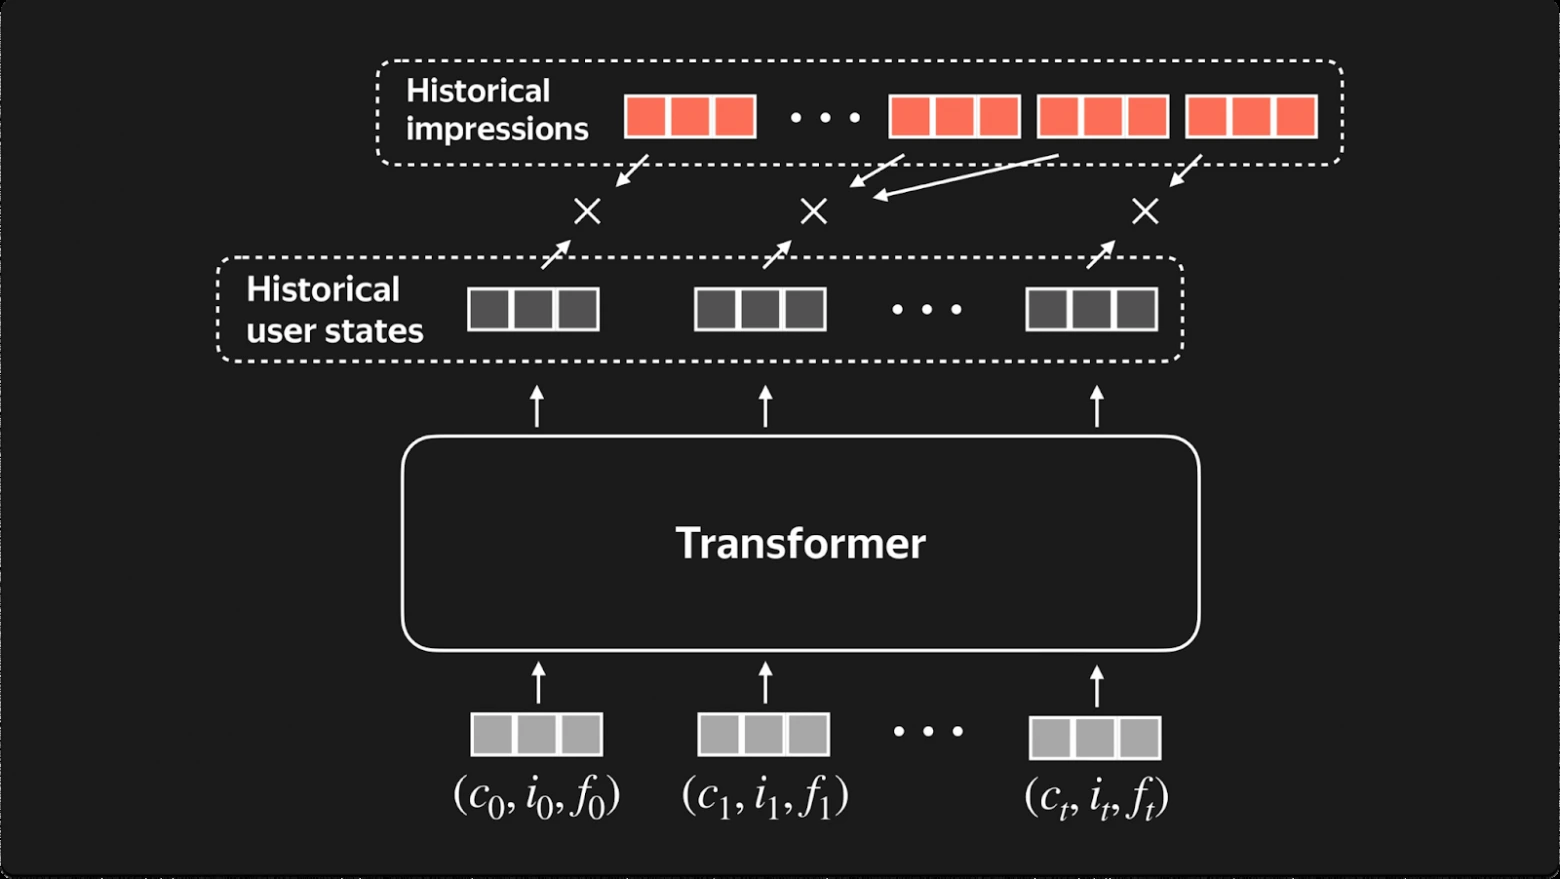
Обучение на последовательности показов.
Источник: Иллюстрация из оригиналаЧто показали увеличение модели и проверки компонентов
Проверили четыре размера энкодера — от 3,2 млн до примерно миллиарда параметров — и увидели рост качества. Сокращение дообучения и отказ от предобучения ухудшали результат. История до 8 тысяч событий также оказалась полезной.
В этом сравнении HSTU не обошла выбранный трансформер. Это вывод конкретного эксперимента Яндекса, а не утверждение о любом применении HSTU. Для итогового ранкера отдельно измеряли изменение правильности порядка пар после добавления признака.
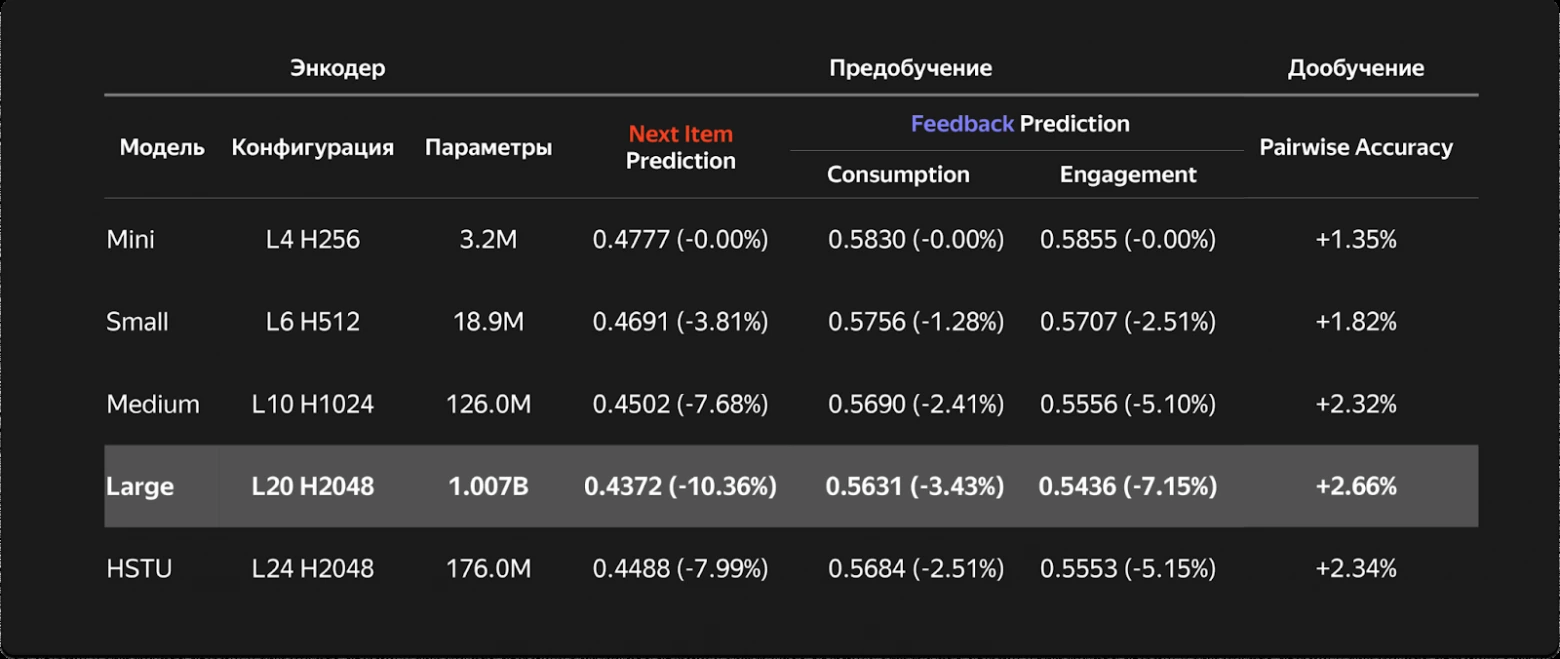
Результаты масштабирования модели.
Источник: Иллюстрация из оригиналаНе смешиваем разные продуктовые результаты
Для отдельной настройки «Незнакомое» автор приводит +12% суммарного времени прослушивания и +10% вероятности лайка. Для музыкальных сценариев в Станциях — +0,75% времени с активной колонкой. Это разные поверхности и метрики.
В Маркете и Лавке внедрения тоже упомянуты, но их численные эффекты в статье не раскрыты. Более поздний перенос ARGUS в реальное время отделён от первоначального офлайнового запуска.
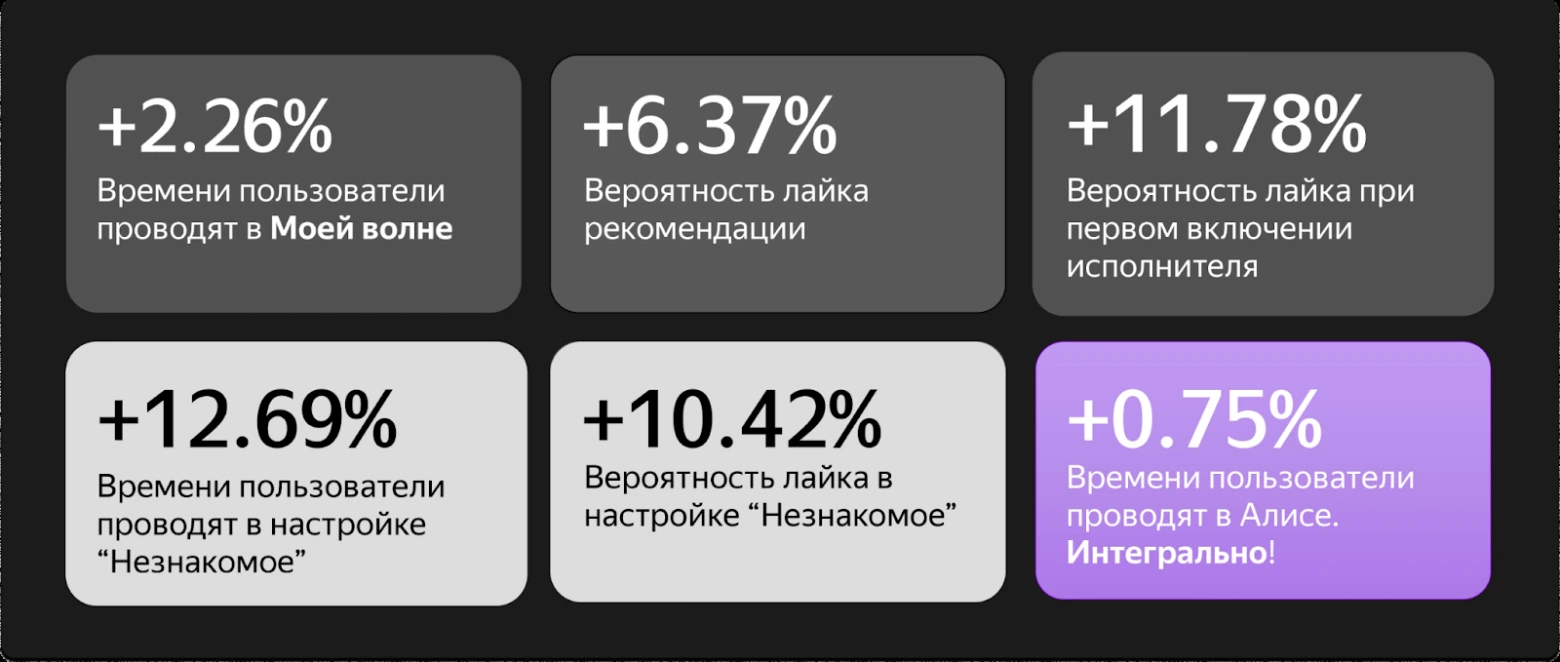
Продуктовые метрики, опубликованные командой.
Источник: Иллюстрация из оригинала