Разбор готов
LinkedIn Feed SR: как трансформер заменил ранжировщик ленты и сохранил полезные признаки
Пользователь открывает профессиональную ленту и ожидает увидеть подходящие публикации сразу. У сервиса есть история показов и реакций, связи между людьми, признаки текста и популярность кандидатов. Прежний ранжировщик LinkedIn учитывал множество таких сигналов, но отдельные агрегаты плохо передавали порядок действий. Просто заменить его большой языковой моделью не получилось: текстовое описание истории оказалось дорогим, а связи между людьми и числовые признаки использовались недостаточно хорошо. В Feed SR команда сделала историю центром модели, сохранила важные признаки кандидата и перестроила обслуживание на CPU и GPU. Этот разбор основан на версии статьи v1 от 12 февраля 2026 года: архитектуре, экспериментах, системных оптимизациях и ошибках внедрения.
Для инженеров RecSys и поиска, которые хотят понять переход от признакового ранжировщика к последовательной модели: что предсказывать, какие признаки сохранить и почему хорошей офлайн-оценки недостаточно.
Рекомендуем. Начните здесь, если хотите связать модель, данные, A/B-тест и систему обслуживания в одном промышленном кейсе.
Публикация · на английском
An Industrial-Scale Sequential Recommender for LinkedIn Feed RankingОткрыть оригинальную статью (PDF)Lars Hertel, Gaurav Srivastava и соавторы · LinkedIn · Опубликовано: 12 февраля 2026 г.
Какая задача стояла у ленты
В ленте соседствуют публикации знакомых, материалы за пределами сети контактов и другие типы объектов. Отбор кандидатов возвращает подходящие публикации из нескольких источников. Ранжировщик затем оценивает вероятности действий: клика, долгого чтения, лайка, комментария или пересылки. Финальный порядок учитывает веса этих целей и дополнительную бизнес-логику. Feed SR меняет эту стадию оценки кандидатов, а не весь поиск публикаций в каталоге.
Прежняя модель состояла из двух ветвей: для пассивных действий вроде чтения и пропуска и для активных реакций. Внутри использовались DCNv2, полносвязные слои и выходы под несколько задач. Обучение начиналось с трёх недель данных и продолжалось ежедневно; модель применялась на CPU в Java-стеке. Непрокликанные показы при обучении сохраняли с вероятностью 0,1 и компенсировали это весом 10 в функции потерь.
Сильный исходный вариант уже содержал накопленные знания о продукте. Поэтому сравнение с трансформером означало проверку целой системы: сохранит ли новая модель социальные сигналы, учтёт ли свежесть и сможет ли ответить достаточно быстро. Само наличие внимания к истории ещё не доказывало, что лента станет лучше.
S3 · §3: BackgroundИстория состоит из показов и последующих реакций
В Feed SR входом служат последние 1000 показов за доступный год истории. Для каждого показа отдельно строится представление публикации и представление реакции. Получается чередование «публикация → действие → публикация → действие». Действие — набор бинарных признаков, поскольку на один материал человек может и отреагировать, и потратить время. Модель учится предсказывать эти действия для позиций истории.
Это отличается от задачи «назвать следующий товар в каталоге». Выход Feed SR — несколько вероятностей для конкретной публикации, например вероятность долгого чтения и комментария. Обучение использует бинарную кросс-энтропию на позициях последовательности. Причинная маска внимания закрывает будущие события: представление публикации не должно видеть собственную последующую реакцию.
Представления текста и автора помогают переносить знания между публикациями. При этом ID автора и участника, который вернул публикацию в ленту, сохраняют сведения о повторяющихся связях. Удалить все ID ради универсальности здесь означало бы потерять важную часть социального контекста.
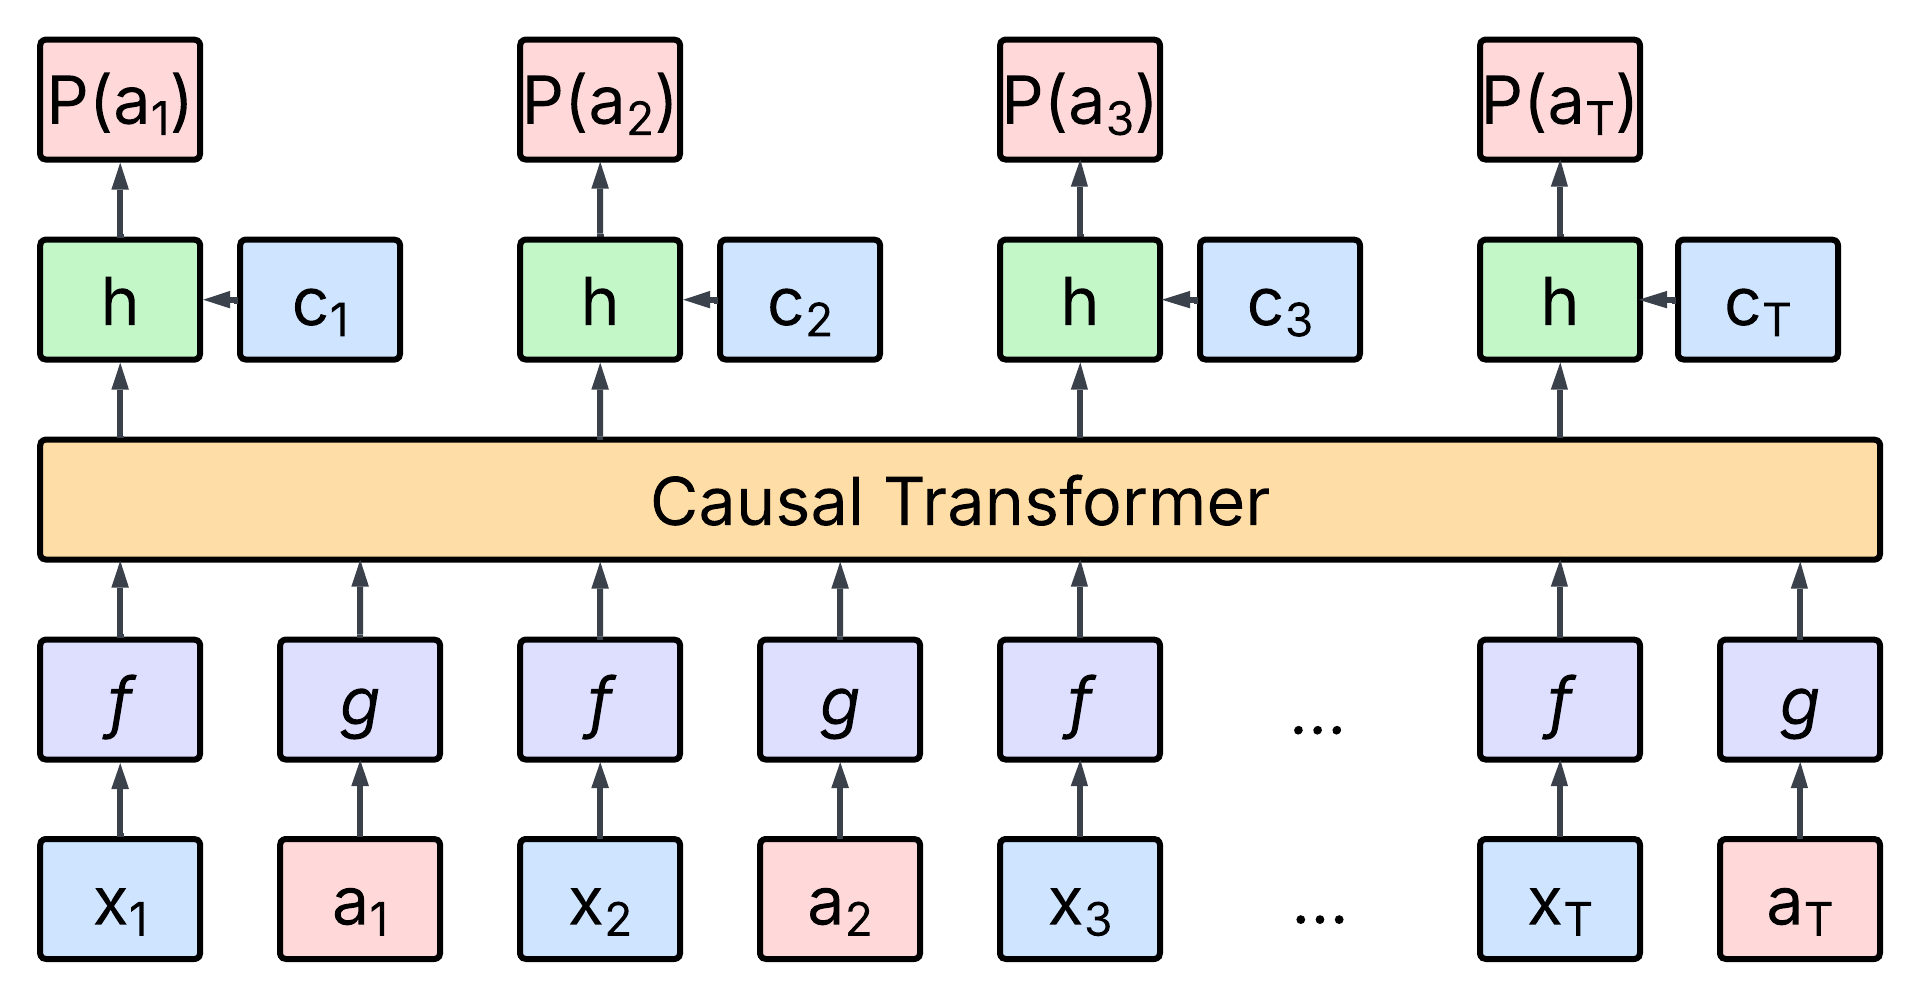
Архитектура Feed SR, рисунок 1: публикации и действия чередуются во входе, а дополнительные признаки присоединяются к выходу трансформера.
Источник: Оригинальная иллюстрация · LinkedInКакие признаки оставили за пределами трансформера
Заманчиво вложить каждый известный признак в каждый исторический токен. Но тогда вектор токена растёт, вместе с ним увеличиваются размер трансформера и стоимость обработки всей истории. Кроме того, популярность старой публикации не обязательно полезна для оценки нынешнего кандидата. Feed SR оставляет в последовательности компактные признаки, которым действительно нужен временной контекст.
Числовые признаки кандидата и контекста добавляются после трансформера. Например, сколько внимания уже получила публикация, каков её возраст и насколько тесно зритель взаимодействовал с автором. Такой способ называется поздним объединением признаков. Он не отказывается от инженерных сигналов, а переносит их в более подходящее место.
В отдельном опыте перенос примерно трети признаков из последовательной ветви снизил Long Dwell AUC на 0,07% в обозначениях авторов, но сократил время шага обучения примерно на 12%. A/B-сравнение позднего и раннего объединения не показало ухудшения ключевых метрик ленты. В итоге Feed SR использует около 20% набора признаков прежней модели, но сохраняет полезные сигналы популярности и связи с автором.
После объединения команда сравнила линейный выход, MLP, DCNv2 и MMoE — несколько экспертов с отдельным выбором их смеси для каждой задачи. MMoE оказался лучшим из проверенных вариантов. Чтобы одни и те же эксперты не забирали всю нагрузку обучения, к весам их выбора применяли dropout. Эти эксперименты объясняют, почему «трансформер плюс один линейный слой» не стал окончательной архитектурой.
S4.SS2.SSS3 · §4.2.3–4.3Почему порядок событий мог дать утечку
Позиционные признаки и устойчивость обучения пришлось подбирать на данных ленты. Авторы используют RoPE для положения событий, нормализацию до подслоёв и обучаемое масштабирование остаточных связей. Без подходящей нормализации AUC мог падать до 0,5 прямо в процессе обучения. Обычный softmax в их опытах работал не хуже альтернативных функций внимания; заменить блоки на HSTU при одинаковых вычислениях тоже не помогло.
Отдельная ошибка касалась доступности меток внутри сессии. Если человек долго прочитал первую публикацию, последующие публикации этой же сессии тоже чаще читаются долго. В обучении модель могла опираться на такие предыдущие реакции, хотя при формировании выдачи эти метки ещё отсутствовали в доступной истории. Это утечка из-за различия между обучающим примером и состоянием работающей системы.
Команда попробовала закрывать вниманию события той же сессии либо перемешивать их порядок при подготовке обучения. Оба варианта убрали наблюдавшееся переобучение, но специальная маска замедляла обучение. В окончательном варианте выбрали перемешивание внутри сессии. Это решение относится к конкретной доступности данных LinkedIn; из него не следует, что порядок действий вообще не важен.
Более свежие события получили больший вес в функции потерь; команда также изучала ежедневное продолжение обучения. Однако опубликованный основной онлайн-результат получен без инкрементального обучения. При пересказе нельзя объединять улучшения разных опытов в один доказанный эффект.
S4.SS7 · §4.4–4.7Почему текстовая LLM и добавленный TransAct не стали финалом
В первом альтернативном решении признаки публикации превращали в текстовый запрос к дообученной LLM. Модель отвечала условными Yes или No, а оценку ответа использовали для вероятности действия. Офлайн это выглядело перспективно, но на одну публикацию уходили сотни текстовых токенов. История превращалась в десятки тысяч токенов и становилась дорогой.
Текстовая запись плохо передавала некоторые числовые и социальные признаки. LLM-ранкер неплохо работал с материалами за пределами сети контактов, но не превзошёл прежнюю модель онлайн в целом. Feed SR использует два компактных токена на показ и явно сохраняет связь зрителя с автором. Вывод здесь не в бесполезности LLM, а в несоответствии конкретного представления данных требованиям ленты.
TransAct, добавленный к существующему ранжировщику, улучшал и офлайн-, и онлайн-метрики. Но длинная история сильно увеличивала время обучения и задержку применения. Попытку совместно оценивать кандидатов было трудно встроить в систему, рассчитанную на независимую обработку каждого объекта. Поэтому историю сделали основой новой архитектуры, чтобы её вычисления сразу переиспользовались между кандидатами.
S5 · §5: Alternative Approaches ConsideredКак разделили работу CPU и GPU
До запуска трансформера нужно получить признаки пользователя и публикаций, соединить их и подготовить тензоры. Это отдельная нагрузка, и не вся она хорошо выполняется на GPU. В Feed SR CPU-сервис получает и преобразует признаки, а PyTorch-сервер на GPU считает модель. Такие компоненты можно масштабировать независимо, если узким местом становятся разные части запроса.
История заранее сохраняется в компактных столбцовых буферах Apache Arrow в хранилище «ключ — значение». Во время запроса CPU-сервис получает историю и признаки кандидатов и отправляет Arrow-данные через gRPC. Перевод в тензоры без лишнего копирования особенно важен для больших историй: быстрая модель не компенсирует многократную сериализацию одних и тех же данных.
Векторизация подготовки оказалась существеннее многих усложнений модели. Разбор истории ускорили с 450 до 2 мс, а преобразование разреженного признака в плотный — с 254 до 5 мс. Это сравнение с исходной неоптимизированной реализацией на циклах. Эти числа относятся к отдельным операциям, а не к полной задержке ответа пользователя.
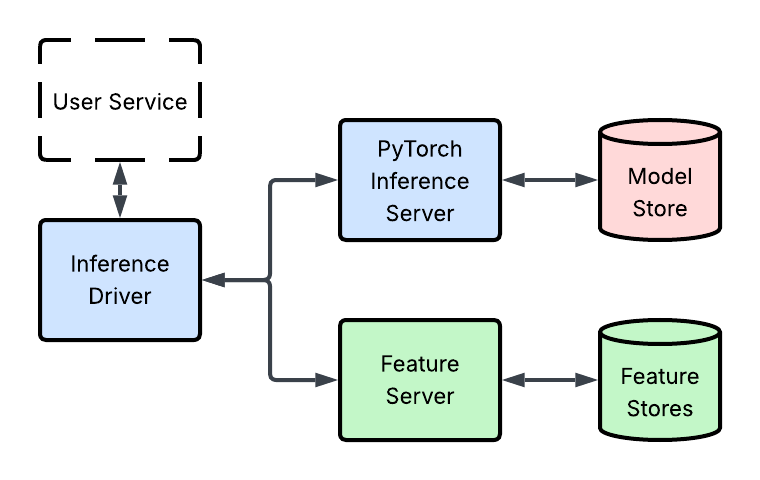
Система Feed SR, рисунок 3: CPU получает и подготавливает признаки, GPU применяет модель; история хранится отдельно от кандидатов.
Источник: Оригинальная иллюстрация · LinkedInОбщую историю считают один раз для множества кандидатов
Один запрос обычно требует оценить около 512 публикаций. Если запускать трансформер независимо для каждой, он сотни раз обработает одну и ту же историю. Feed SR добавляет кандидатов к общему контексту и считает их за один проход. История видит только своё прошлое; каждый кандидат видит историю и себя, но не другие кандидаты. Такая маска сохраняет независимость оценок кандидатов при общих вычислениях.
Для типичной нагрузки примерно в 500 кандидатов и истории длиной 1000 авторы сообщают об ускорении прохода трансформера в 80 раз относительно повторной обработки контекста. Это не ускорение всего сервиса в 80 раз. Получение признаков, передача данных и другие модели остаются частью ответа.
Произвольная маска в стандартном PyTorch SDPA мешала использовать быстрый путь FlashAttention. Поэтому команда написала ядро SRMIS: оно получает длину контекста и число кандидатов и знает рисунок внимания без создания полной квадратной маски. Ядро пропускает ненужные блоки вычислений и в среднем ещё примерно вдвое ускоряет эту операцию относительно masked SDPA. Два ускорения имеют разные базы сравнения; перемножать их в обещание пользовательского эффекта нельзя.
S6.SS2.SSS2 · §6.2.2: GPU-Side OptimizationЧто показал A/B-тест и сколько стоило обучение
Таблицу можно прокрутить по горизонтали.
Основной выигрыш во времени в продукте был больше у активных участников. Для новых пользователей доказанного прироста нет. Кроме того, новая модель обучается дороже по энергии, хотя её применение требует меньше энергии, чем прежний CPU-вариант. Поэтому оценивать экономику только по дешёвому инференсу было бы неверно.
Статья не даёт универсального бюджета оборудования для другой ленты. Общий результат получен на системе LinkedIn с собственными признаками, журналами событий и несколькими дополнительными моделями после ранжирования. Из него можно взять метод проверки и архитектурные решения, но не готовый прогноз роста метрик своего продукта.
S7 · §6.5 и таблицы 4–5Самый полезный урок — сверять одинаковые запросы офлайн и онлайн
При оценке кандидатов авторы отказались от выборочного удаления негативных объектов: оно завышало офлайн-AUC и ухудшало связь с онлайн-показателями. Это не запрет любых негативов при обучении. Речь о том, что проверка должна отражать реальное множество оцениваемых кандидатов, а не упрощённую задачу с удобными отрицательными примерами.
Для одних и тех же сессий команда сравнивала оценки офлайн-конвейера с записанными онлайн-оценками. Так обнаружили множество ошибок преобразования признаков. Часть старых Java-преобразований не совпадала с новым Python/PyTorch-путём. Здесь проверка равенства входов и выходов оказалась прямой частью улучшения продукта, а не формальным тестом после обучения.
Для обсуждения на системном дизайне полезно проследить три границы: что известно в момент выдачи; какие признаки следует вычислять один раз на запрос; на каком множестве кандидатов измеряется качество. Затем сравните этот кейс с Яндекс Лавкой, Uber Eats и RankMixer. Они показывают разные способы использовать историю и вычислительный бюджет, а не последовательные ступени единой «лучшей» модели.
S8 · §8: Deployment Lessons