Разбор готов
Meta: как адаптивное ранжирование рекламы масштабировали до сложности LLM
Когда человек открывает Instagram, рекламная система должна быстро выбрать подходящие объявления среди кандидатов и передать их на следующий этап показа. Чем глубже модель изучает историю действий и сочетания признаков, тем лучше она потенциально распознаёт интересы, но тем дороже становится каждый ответ. Простое наращивание числа видеокарт увеличивает стоимость, а многократная обработка одной и той же истории тратит вычисления впустую. В статье от 31 марта 2026 года инженеры Meta объясняют, как Adaptive Ranking Model подбирает сложность вычислений под запрос, переиспользует пользовательские признаки, ускоряет Wukong Turbo и работу GPU, распределяет крупные таблицы эмбеддингов между устройствами. Разберём, что именно изменили, какие ограничения обходили и на каких условиях Meta сообщает о результатах Instagram.
Глава полезна инженерам рекомендательных и рекламных систем, которые развивают ранжирование под жёсткой задержкой, а также ML-инженерам, работающим с GPU-инференсом. Она помогает связать архитектуру модели, стоимость обработки признаков, распределённые эмбеддинги и производственные показатели без смешения инференса с обучением.
Статья · на английском
Meta Adaptive Ranking Model: Bending the Inference Scaling Curve to Serve LLM-Scale Models for AdsXi Chen и соавторы · Опубликовано: 31 марта 2026 г.
Почему усложнить рекламную модель было недостаточно
Когда сервис выбирает рекламу, он учитывает данные о человеке, его действиях и объявлениях, которые могут быть показаны. Ранжирующая модель оценивает подходящесть кандидатов; эти оценки используются в дальнейшей системе выбора рекламы. Meta хотела увеличить сложность такой модели, чтобы точнее учитывать интересы и намерение человека. Но вся эта работа происходит во время обращения к продукту, поэтому пользователь не должен ждать, пока вычислители закончат анализ длинной истории.
Авторы называют исходную задачу «тройным ограничением инференса»: качество, которое требует сложной модели; задержка, которую нужно удерживать ниже секунды; и стоимость, которая должна оставаться оправданной для глобального рекламного сервиса. Инференс здесь означает применение уже подготовленной модели к запросу. Добавить больше GPU можно, но такой путь не решает проблему повторных операций и не гарантирует экономически приемлемую отдачу от расходов на оборудование.
Meta сравнивает вычислительную сложность своей модели с крупными языковыми моделями и использует выражение LLM-scale. В этом материале оно означает высокий уровень вычислительной сложности и объём параметров, а не генерацию текста. Предмет статьи — выбор модели для запроса, расчёт рекламных оценок и обслуживание этих вычислений. Как именно модель обучали на рекламных данных, здесь не разбирается.
Introducing Meta Adaptive Ranking ModelМаршрутизатор выбирает сложность под запрос
Одинаковая тяжёлая модель для любого запроса расходует ресурсы даже тогда, когда конкретной ситуации достаточно менее сложной обработки. В Adaptive Ranking Model перед вычислением рекламных оценок стоит маршрутизатор: он учитывает контекст и предполагаемое намерение человека и отправляет запрос в подходящий вариант ранжирования. Так команда стремится направлять дорогие вычисления туда, где они принесут наибольшую пользу, не замедляя остальной поток.
На первой оригинальной схеме Meta путь начинается с User Request. Следующий блок User Journey перечисляет клики по рекламе, рекламные конверсии и вовлечённость в ленту как примеры пользовательских сигналов. Adaptive Compute Model Router разделяет поток на High Complex User Journey и Standard Context User Journey. Верхняя ветвь ведёт к LLM-scale runtime model, нижняя — к standard runtime model. В обеих показаны Wukong Turbo и обработка последовательностей: различается предусмотренная сложность, а не сам факт использования пользовательской истории.
Затем результаты обеих ветвей приходят в общий блок Ranked Ads — упорядоченные рекламные кандидаты. На схеме за ним идут Auction, то есть рекламный аукцион, и Ads Shown — показ объявлений. Это важная граница ответственности: в статье разбирают ускорение ранжирования, а не устройство рекламного аукциона. Принцип маршрутизации показан наглядно, хотя точные правила выбора ветви остаются внутренней частью системы.
Вывод из оригинальной схемы source-0: дополнительная сложность применяется выборочно до получения ранжированных объявлений; далее обе ветви сходятся в общем рекламном процессе. Подписи «High Complex» и «Standard» описывают пути обработки, а не опубликованные численные уровни вычислений.
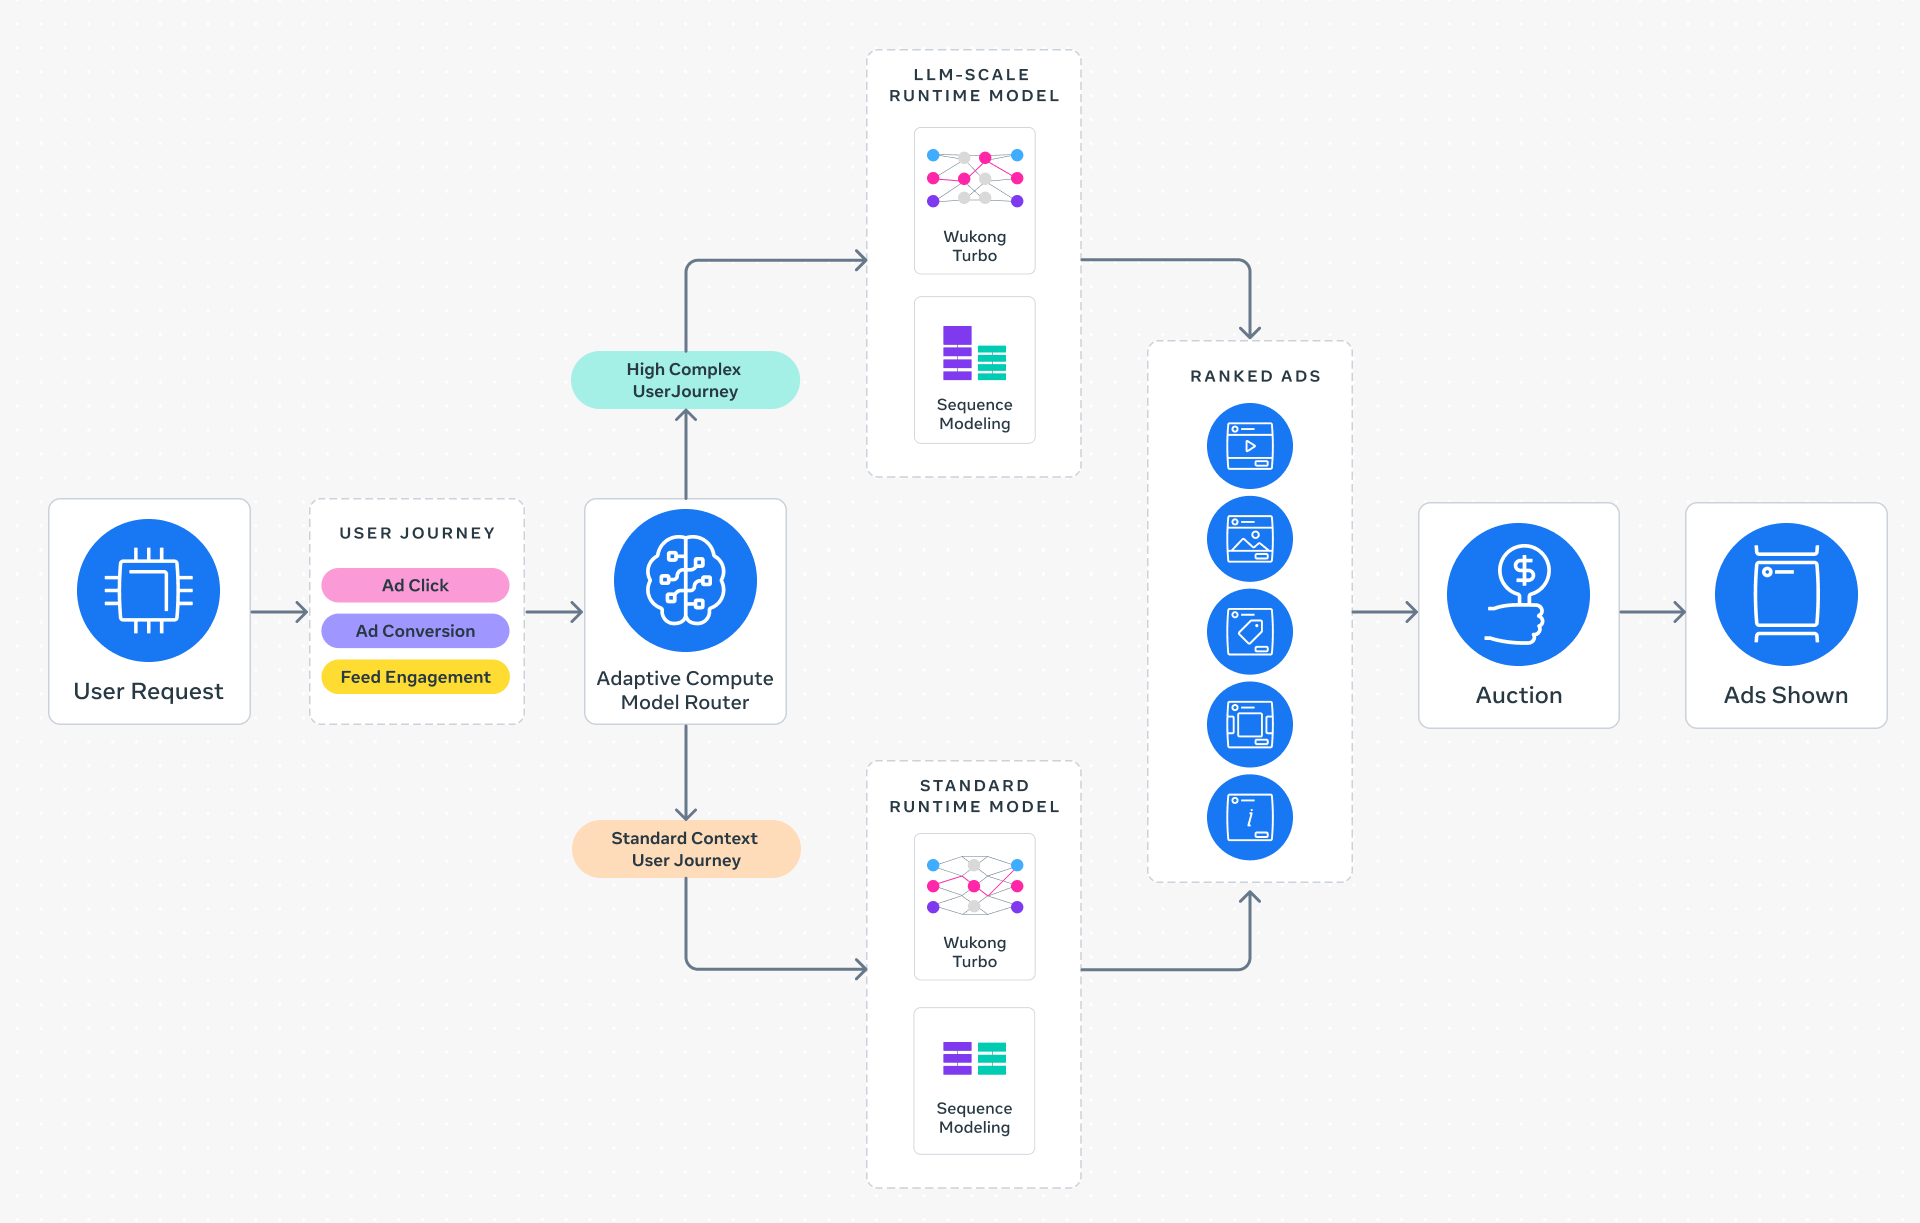
Часть запросов направляется в более сложную модель, остальные проходят через стандартное ранжирование. Решение принимает адаптивный маршрутизатор.
Источник: Оригинальная иллюстрация · MetaТри направления, которые пришлось менять вместе
Одной маршрутизации было недостаточно. Даже выбранная для сложного запроса модель должна успеть обработать признаки, выполнить вычисления и получить доступ к своим параметрам. Поэтому Meta описывает три взаимосвязанных направления разработки. Первое экономит операции внутри одного запроса, второе подгоняет численную точность и вычислительный граф под аппаратуру, третье организует память и обслуживание моделей, которые не помещаются на одну карту.
Таблицу можно прокрутить по горизонтали.
Второй рисунок подписан LLM-Scale Runtime Ads Model Serving System. Его цветные полосы повторяют эту классификацию; стрелки соединяют направления работы над системой. Сам рисунок не показывает, что сначала обязательно выполняется вся «оптимизация модели», потом вся «настройка оборудования», а затем «инфраструктура»: в работающем сервисе эти решения действуют одновременно. Ниже разберём их по тем проблемам, которые они устраняют.
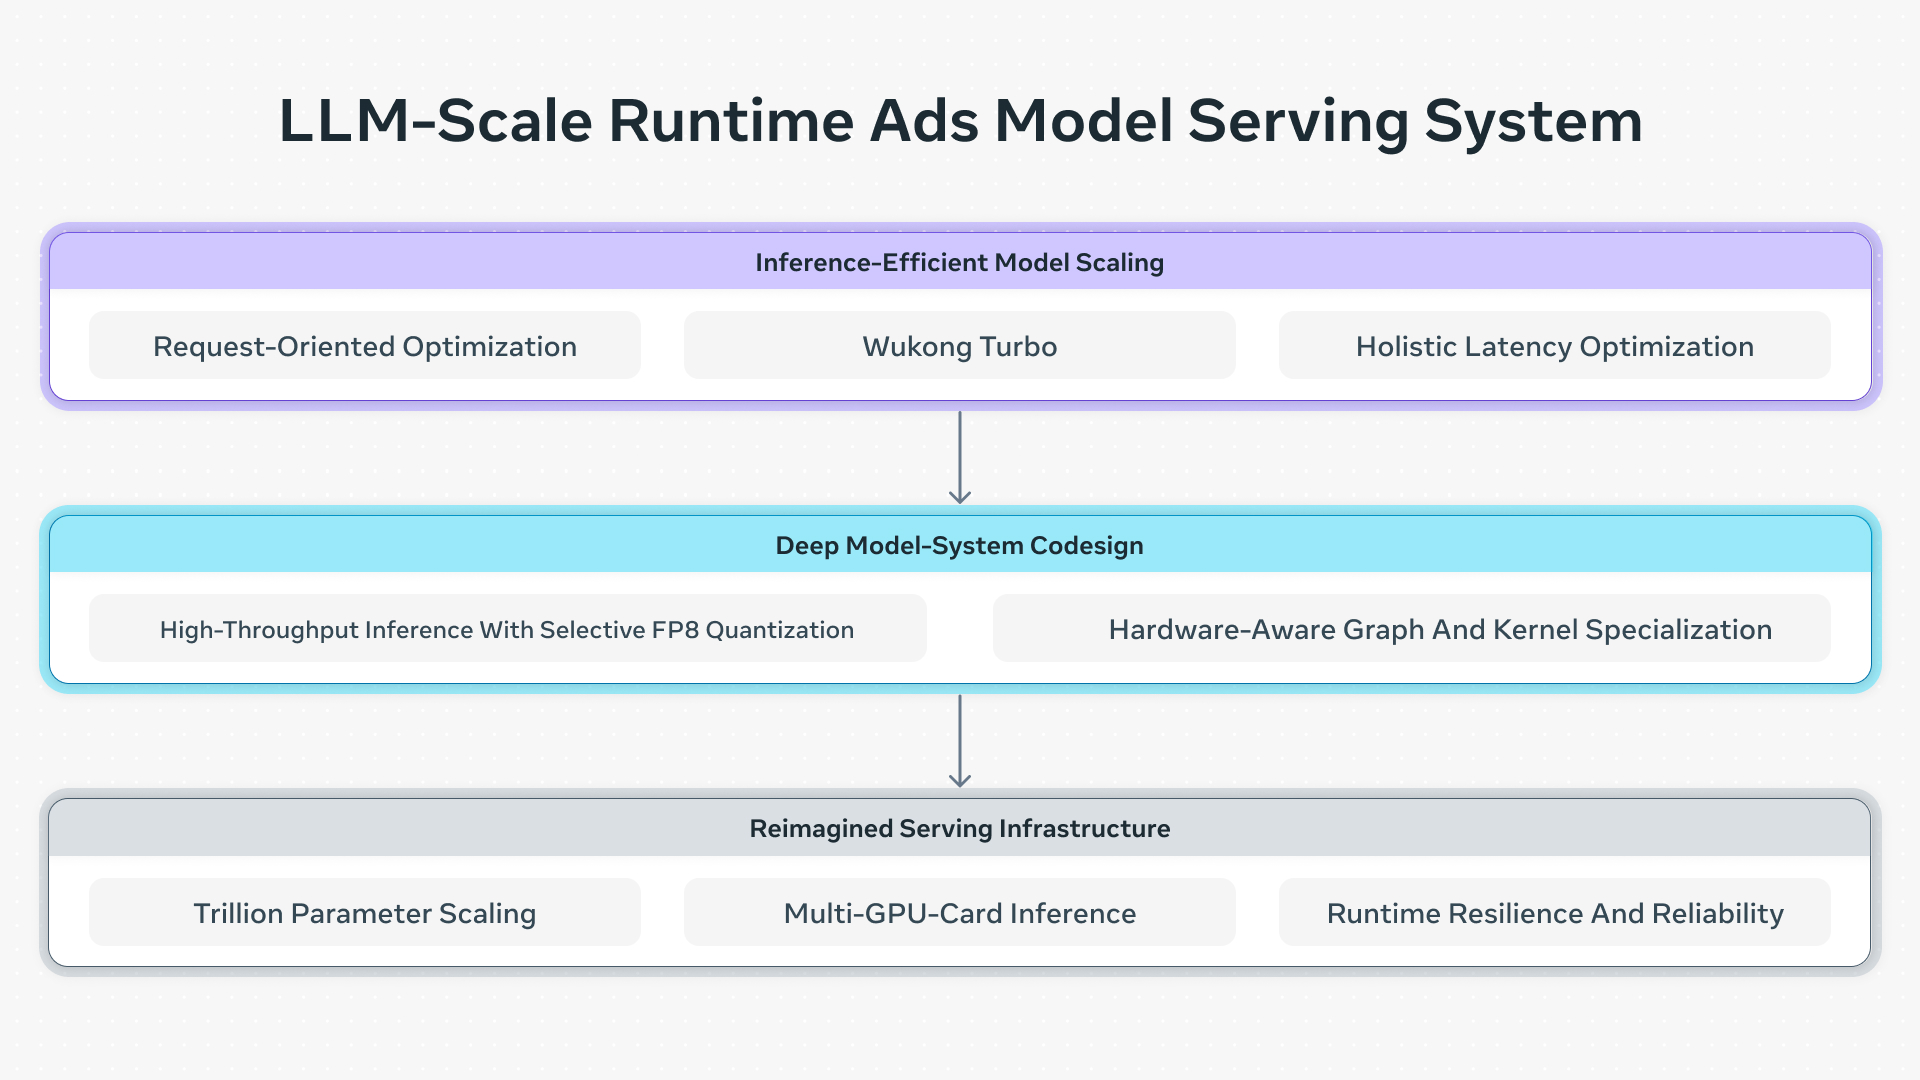
Три направления оптимизации: вычисления модели, совместная настройка модели и оборудования, инфраструктура исполнения.
Источник: Оригинальная иллюстрация · MetaИсторию пользователя перестали считать заново для каждого объявления
Традиционный способ ранжирования обрабатывает каждую пару «пользователь — объявление» как отдельный пример. Если у запроса много рекламных кандидатов, вычисление одних и тех же пользовательских признаков повторяется для каждого из них. Особенно дорого обходятся плотные представления пользовательских сигналов: модель сначала тратит ресурсы, чтобы понять контекст человека, а затем снова выполняет близкую работу для следующего объявления.
Meta называет замену Request-Oriented Optimization — оптимизацией вокруг запроса. Она отделяет дорогие вычисления, общие для набора кандидатов, от оценки конкретного объявления. Request-Oriented Computation Sharing готовит общие пользовательские представления один раз за запрос. После этого индивидуальная часть модели использует уже рассчитанные сигналы при ранжировании кандидатов.
Возникает и проблема передачи данных: если сначала создать общий вектор, а затем физически скопировать его для каждого кандидата, часть экономии съест память. Поэтому применяется In-Kernel Broadcast: GPU-ядро использует представление уровня запроса сразу для нескольких кандидатов, не требуя столь же большого объёма повторных чтений и копирования. Авторы связывают такой подход со снижением нагрузки на пропускную способность памяти.
Именно уменьшение повторяемой части позволяет Meta говорить о переходе от линейного к сублинейному росту затрат при масштабировании сложности модели. При этом оценки отдельных кандидатов по-прежнему нужны; выигрыш возникает от того, что дорогостоящий общий расчёт больше не умножается на число объявлений. При чтении заявления о сублинейном росте важно различать разделяемую тяжёлую часть и сохраняющиеся вычисления для конкретных объявлений.
Transforming scaling costs from linear to sub-linearБолее длинная история без многократных вычислений и копий данных
Если модель учитывает не несколько последних действий, а длинную последовательность поведения, она получает более богатый контекст, но каждая дополнительная позиция увеличивает стоимость обработки. Раньше такие последовательности было трудно использовать из-за сочетания затрат на вычисления и хранение истории. В Request-Oriented Sequence Scaling тяжёлая обработка последовательности выполняется один раз для всего рекламного запроса. Представления этой истории затем доступны оценке всех объявлений-кандидатов.
Отдельная задача возникает до обслуживания запросов — при хранении журналов пользовательских действий для обучающих данных. Если многократно прикладывать одну и ту же историю к примерам разных объявлений, хранилище заполняется дублями. Meta описывает централизованное хранилище «ключ — значение», где журналы лежат отдельно и присоединяются к обучающим данным в процессе их подготовки. Так уменьшается объём избыточных копий; статья объединяет эту экономию хранения с экономией вычислений при обработке запроса.
Эти два механизма решают разные части задачи. Во время инференса повторно используют готовое представление истории. При подготовке данных избегают дублирования самих журналов. Эффект двух оптимизаций складывается из уменьшения стоимости подготовки обучающих данных и уменьшения стоимости применения модели к запросу; эти процессы происходят в разное время.
Transforming scaling costs from linear to sub-linearWukong Turbo: как глубокую модель сделали устойчивее и быстрее
Повторное использование истории экономит внешние вычисления, но сама ранжирующая сеть тоже должна хорошо работать при росте глубины. Основой служит внутренняя архитектура Meta Ads Wukong. Она сочетает факторизационные взаимодействия признаков — способы учитывать их совместное влияние, — обработку последовательностей и механизм внимания между слоями, который связывает полученные представления. Wukong Turbo — переработанный вариант этой архитектуры для выполнения более крупных моделей.
Первая проблема при углублении сети — численная нестабильность: некоторые слагаемые могут делать вычисления плохо обусловленными. В Wukong Turbo авторы выделяют приём No-Bias, который убирает такие нестабильные слагаемые. По их заявлению, он увеличивает пропускную способность без роста числа параметров или арифметических операций FLOPs. В статье не расшифровано, из каких именно выражений удаляют слагаемые; поэтому нет оснований автоматически приравнивать No-Bias к удалению свободного члена из каждого линейного слоя.
Вторая проблема — обмен данными внутри распределённой архитектуры. Meta применяет small parameter delegation: небольшие группы параметров переводятся из схемы Fully Sharded Data Parallel (FSDP), где параметры разделяются между устройствами, в схему Distributed Data Parallel (DDP), использующую другую организацию размещения. Такой перенос предназначен для снижения сетевых и память-зависимых накладных расходов. Дополняет его упрощение линейных слоёв с использованием разреженности: избыточные компоненты перестают загружать вычисления.
Итоговый смысл Wukong Turbo — возможность увеличивать глубину и сложность ранжирования, не отдавая выигрыш в качестве задержкам обмена или нестабильности вычислений. На схеме маршрутизации Wukong Turbo находится в обоих вариантах модели. Логика этих изменений общая: повышая сложность вычислений, нужно одновременно сдерживать численные ошибки, лишние операции и расходы на передачу параметров.
Maximizing Structural Throughput with Wukong TurboПочему ускорения нейросети мало: узкое место до GPU
GPU может выполнять саму модель быстро и всё равно простаивать, если данные для неё готовятся слишком медленно. Meta описывает именно такую проблему в подготовке признаков: клиентские CPU расходовали много оперативной памяти, а ускорители ждали обработанных входов. Увеличение вычислительной мощности модели в такой ситуации усугубляет разрыв между подготовкой данных и их потреблением.
Часть предварительной обработки перенесли с клиентских CPU на удалённые GPU-хосты. Чтобы передавать меньше лишних данных, используют компактный формат записей в виде кортежей — упорядоченных наборов значений. Сами операции подготовки реализуют специализированными GPU-ядрами, рассчитанными на массовую обработку данных. Тем самым GPU получает работу раньше и реже ждёт, пока CPU завершит очередной этап.
Один из примеров — операция Top-K, выбирающая K элементов с наибольшими значениями. Для переработанного GPU-варианта авторы указывают снижение сложности с O(N log N) до O(N). Это характеристика конкретной операции подготовки, а не новая сложность всей рекомендательной модели и не обещание постоянного времени отклика. Вдобавок команда оптимизировала сжатие данных и перестроила клиентский поток выполнения, чтобы убрать конкуренцию задач за общий пул потоков.
Заявленное изменение асимптотики операции Top-K внутри GPU-ориентированной обработки; N обозначает объём входных элементов этой операции.
Здесь важен сквозной взгляд на задержку: её создаёт вся цепочка от входных признаков до готовых оценок. Оптимизация CPU/GPU-разделения, передачи данных, Top-K и конкуренции потоков нужна, чтобы сложная сеть действительно укладывалась в ограничение времени рекламного запроса.
Neutralizing Complexity Overhead through Holistic Latency OptimizationFP8 только там, где точность можно уменьшить
Понижение численной точности уменьшает объём обрабатываемых данных и позволяет эффективнее использовать вычислительные блоки ускорителей. Но рекламное ранжирование чувствительно к небольшим изменениям оценок: если заменить формат чисел во всех слоях без разбора, различия между близкими объявлениями могут исказиться. Meta прямо описывает такой риск для сплошной низкоточной квантизации и выбирает более осторожный путь.
В Adaptive Ranking Model применяется избирательная FP8-квантизация после обучения. FP8 — компактный восьмибитный формат чисел с плавающей точкой. Команда измеряет работу отдельных частей модели в коротких контрольных запусках (микробенчмарках) и переводит на FP8 те слои, которые хорошо переносят потери точности. Остальные части могут сохранять более точные вычисления. Это способ использовать аппаратные преимущества FP8 без одинакового преобразования всей сети.
По оценке авторов, качество рекомендаций при таком выборе слоёв меняется пренебрежимо мало. Одновременно улучшается полезная загрузка оборудования. На уровне всего направления совместной настройки модели и устройств Meta приводит MFU 35% на нескольких типах оборудования. MFU — доля доступной вычислительной производительности ускорителя, которая реально используется арифметикой модели. Это заявленная характеристика инфраструктуры, а не прирост качества рекомендаций на 35%.
Избирательность здесь существеннее названия числового формата: ускорение получают те слои, где выигрыш в вычислениях не разрушает качество итоговых оценок. Практическое решение принимают на уровне отдельных слоёв, поскольку чувствительность вычислений к FP8 неодинакова.
High-Throughput Inference with Selective FP8 QuantizationГраф вычислений подстраивают под память и ядра GPU
Нейросеть описывается последовательностью операций — вычислительным графом. Даже если арифметики немного, выполнение может замедляться из-за постоянного переноса данных между памятью GPU и вычислительными блоками или из-за запуска большого числа крошечных операций. Meta оптимизирует граф вместе с GPU-ядрами — программами, выполняющими группы операций на ускорителе.
Первый приём — объединять операции, которым нужны одни и те же входные данные. Тогда значения реже приходится заново читать из основной высокопропускной памяти ускорителя (HBM), а промежуточные результаты удаётся удерживать ближе к вычислениям, во внутрикристальной памяти SRAM. Это сокращает перемещение данных и расходы на промежуточное хранение.
Второй приём — группировать тысячи небольших операций в более насыщенные вычислениями ядра. Для этого используют Grouped General Matrix Multiply, то есть сгруппированное матричное умножение, и horizontal fusion — объединение независимых однотипных операций для совместного запуска. Так GPU меньше времени тратит на накладные действия и эффективнее использует свои вычислительные блоки.
Избирательная FP8-квантизация из предыдущего раздела уменьшает цену арифметики, а специализация графа снижает цену перемещения данных и запусков ядер. Вместе эти меры обеспечивают совместную настройку модели и аппаратуры, о которой говорит Meta. Для разнородного парка ускорителей такой подход особенно полезен: вычисления согласуют с устройством памяти и доступными аппаратными операциями.
Hardware-Aware Graph and Kernel SpecializationОткуда берётся масштаб около триллиона параметров
Рекламная рекомендательная модель работает с большим количеством категориальных признаков: например, с идентификаторами объектов и событий. Чтобы сеть могла использовать такой признак, его номер преобразуют в обучаемый числовой вектор — эмбеддинг. Таблица эмбеддингов содержит множество таких векторов; при большом количестве уникальных значений она быстро становится одной из главных статей расхода памяти. Поэтому масштаб O(1T) параметров, о котором пишет Meta, связан в том числе с очень большими разреженными таблицами, а не только с плотными слоями нейросети.
У размера таблицы есть неприятный компромисс. Если выделить чрезмерно много отдельных представлений, модель получает больше возможностей запоминать частные комбинации и может переобучаться. Если уменьшить хеш-пространство слишком сильно, разные идентификаторы начинают чаще попадать в одинаковые ячейки. Такие хеш-коллизии смешивают сведения о разных значениях и ухудшают качество.
Meta распределяет размер хеш-пространств с учётом разреженности признаков: для разных групп данных потребность в ёмкости различается. Неиспользуемые эмбеддинги удаляют, чтобы не держать в памяти то, что не помогает работе модели. Дополнительно применяют объединённые таблицы (unified embeddings): несколько признаков могут пользоваться общей таблицей, вместо того чтобы каждому выделять полностью отдельную память. Так высвобождают ёмкость для представлений и взаимодействий признаков, которые действительно нужны модели.
Триллионный порядок числа параметров — характеристика размеров рекламной рекомендательной архитектуры с разреженными представлениями. Он не означает, что при оценке каждого объявления выполняется столько же плотных арифметических операций, сколько у языковой модели с триллионом активных весов. Это важно для понимания того, почему следующая задача — прежде всего распределить память таблиц между ускорителями.
Trillion Parameter ScaleКогда таблица больше памяти одной видеокарты
По описанию Meta, общий объём эмбеддингов приблизился к терабайту и перестал помещаться в памяти одного GPU. Однокарточная система в таком случае ограничивает развитие модели не только скоростью вычислений, но и физическим объёмом памяти. Решение — разделить большие таблицы на части, или шарды, и разместить их на нескольких картах.
Во время оценки объявления системе могут понадобиться эмбеддинги из разных частей распределённой таблицы. Поэтому простое добавление карт создаёт новые затраты на передачу данных. Команда использует аппаратно-зависимые оптимизации обмена между шардами, чтобы сохранять высокую пропускную способность. В статье такая организация названа multi-card sharding.
Meta заявляет, что многокарточное обслуживание достигло производительности, сопоставимой с однокарточными конфигурациями. Это результат для описываемого авторами решения, а не универсальное правило, что обмен между GPU бесплатен. Число карт, их модели и параметры сравниваемых конфигураций не раскрываются. Главный архитектурный результат — размер таблиц перестаёт быть жёстко ограничен памятью одного устройства.
Multi-GPU-Card Embedding ScalingКак запускать крупную модель и выдерживать изменения трафика
Большая модель должна не только быстро считать оценки, но и достаточно быстро загружаться при выпуске новой версии или восстановлении обслуживания. Когда параметры распределены по устройствам, загрузка становится отдельной производственной задачей: длительное ожидание модели снижает доступность вычислительных мощностей.
Meta ускоряет этот этап за счёт параллельной загрузки несколькими потоками и удалённого кеширования. По утверждению авторов, разработанный способ позволяет загрузить модель менее чем за 10 минут. Это время загрузки, а не время ответа рекламному запросу. Оно относится к их системе подготовки к работе; подробности размера загружаемого состояния и конфигурации замера не перечислены.
После загрузки важно выдерживать колебания рекламного трафика. Для автоматического изменения числа обслуживающих ресурсов Meta опирается на утилизацию потоковых мультипроцессоров GPU — аппаратных блоков, выполняющих параллельные вычисления. Когда нагрузка растёт или снижается, этот сигнал помогает подстраивать выделенные мощности. Так система стремится поддерживать стабильную работу без постоянного избыточного резервирования ускорителей.
Быстрая загрузка и автоматическое масштабирование не меняют сам алгоритм ранжирования, но делают возможной его работу на реальной нагрузке. Поэтому стабильность зависит и от того, насколько быстро можно ввести новый экземпляр модели в работу, и от того, насколько гибко система распределяет текущую нагрузку.
Runtime Resilience and ReliabilityЧто означают опубликованные показатели вычислений
Meta приводит несколько технических ориентиров, относящихся к разным сторонам системы. Их полезно читать вместе с соответствующим объектом измерения, а не сводить в одно число «ускорения модели». Авторы утверждают, что изменили кривую зависимости между сложностью ранжирования, затратами и задержкой благодаря совместной работе архитектуры, программного выполнения и инфраструктуры.
Таблицу можно прокрутить по горизонтали.
Эти числа не складываются и не переводятся напрямую в стоимость одного рекламного показа. В статье нет совместного профиля нагрузки, распределения задержек по перцентилям и стоимости на запрос. Но направление результата определено достаточно ясно: дорогие пользовательские вычисления перестали повторяться для каждого кандидата, а оставшаяся работа лучше размещается и выполняется на ускорителях.
Inference-efficient model scaling:Что изменилось в рекламе Instagram
После инженерных оптимизаций Meta сообщает о продуктовых результатах внедрения Adaptive Ranking Model на Instagram. По словам компании, запуск состоялся в IV квартале 2025 года, а приведённые изменения относятся к targeted users — обозначенной авторами целевой группе пользователей. Это уже показатели рекламного продукта: они описывают действия людей, а не нагрузку на GPU.
Таблицу можно прокрутить по горизонтали.
Результаты не следует распространять автоматически на все сервисы Meta или на всю аудиторию Instagram. Авторы не описывают устройство контрольной группы, длительность измерения и статистическую неопределённость, поэтому их формулировку нельзя самостоятельно превращать в подробный отчёт об A/B-тесте. Точно так же заявленные +3% и +5% нельзя смешивать с MFU, временем загрузки или скоростью вычислений: это разные уровни результата.
Как производственный кейс статья показывает, зачем понадобилась вся цепочка оптимизаций. Увеличение сложности имело смысл лишь при сохранении времени ответа и контроле стоимости: бизнес-результат приводится вместе с вычислительными характеристиками, но без разложения прироста по отдельным приёмам.
Since launching on Instagram in Q4 2025Дальше — более длинные истории, автоматизация оптимизаций и свежие веса
Запуск на Instagram Meta называет первым этапом развития Adaptive Ranking Model. Следующее направление — ещё глубже использовать пользовательские сигналы и более длинные последовательности действий. При изменении плотности сигналов и типа запроса инфраструктура должна всё точнее выбирать объём работы, сохраняя баланс качества, задержки и стоимости.
Для роста модели Meta планирует развивать способы сжатия и вычисления с ещё более низкой точностью на разнообразных типах оборудования. Это продолжение уже внедрённых подходов к разделению вычислений и избирательной FP8-квантизации, но новые методы компрессии и ultra-low precision обозначены именно как дальнейшее развитие.
Отдельно компания исследует агентные средства оптимизации GPU-ядер. Их предполагаемая роль — самостоятельно подбирать эффективное выполнение при появлении новой аппаратуры и изменении архитектуры модели, сокращая объём ручной работы инженеров. Здесь слово «агентный» относится к автоматизации системной оптимизации, а не к выбору рекламных объявлений агентом.
Ещё один план — сделать модель почти немедленно реагирующей на свежие данные за счёт постепенного обновления весов прямо в работающем экземпляре (incremental, in-place weight updates). В статье это направление будущих исследований, а не подтверждённая задержка обновления весов текущего сервиса. Конечной целью авторы называют лучшие рекламные результаты, в том числе отдачу от рекламных расходов (ROAS), но не приводят отдельный измеренный эффект этих будущих функций.
The Path Forward: Evolving the Adaptive Ranking Model StackИтог: как запрос проходит адаптивное ранжирование
Meta решала задачу, в которой усложнение модели быстро упиралось в задержку и стоимость: рекламный запрос должен завершаться за доли секунды, а длинная история пользователя не должна обрабатываться заново для каждого объявления. Adaptive Ranking Model сочетает маршрутизацию по сложности запроса, общие пользовательские вычисления, Wukong Turbo и оптимизированное выполнение на нескольких GPU. В итоговой системе это выглядит так:
- 01
Запрос и контекст
Сервис получает запрос и доступные сигналы о действиях человека. В схеме показаны клики, конверсии и вовлечённость в ленту.
- 02
Выбор сложности
Адаптивный маршрутизатор по контексту направляет запрос в более сложный или стандартный вариант ранжирующей модели.
- 03
Общая обработка признаков
Тяжёлую пользовательскую историю рассчитывают один раз на запрос; результаты доступны всем объявлениям-кандидатам через оптимизированные GPU-операции.
- 04
Оценка кандидатов
Выбранная модель с Wukong Turbo и обработкой последовательностей оценивает объявления. FP8, специализированные ядра и распределённые таблицы помогают уложиться в ресурсы.
- 05
Аукцион и показ
Ранжированные объявления поступают в рекламный аукцион, после которого выбранные объявления показываются человеку.
По сообщению Meta, после запуска на Instagram в IV квартале 2025 года у targeted users рекламные конверсии выросли на 3%, а CTR — на 5%. Технические ориентиры — задержка порядка O(100 мс), MFU 35% и масштаб O(1T) параметров — описывают другую сторону системы. Статья не раскрывает методику продуктового сравнения и конфигурации всех замеров. Более глубокие последовательности, агентная настройка ядер и почти мгновенное обновление весов пока относятся к планам, а не к измеренному результату внедрения.
By unifying these innovations