Трансформерная персонализация: учитывать поиск и порядок действий
Взвешенная сумма просмотренных объявлений плохо отражала смену намерения и не учитывала поисковые запросы. Две части модели кодируют объявление и историю пользователя; их близость используется и для отбора кандидатов, и в ранжировщике.
Статья · на русском
Как мы улучшили рекомендации для пользователей Авито с помощью трансформенной персонализацииАлександр Михеев · Опубликовано: 27 февраля 2026 г.
Чего не хватало user2vec
Раньше пользователь представлялся суммой векторов объявлений с убывающими по времени весами. Это быстро, но плохо описывает нелинейные связи: интерес к велосипеду может означать потребность не только в другом велосипеде, но и в аксессуарах.
Новая модель отдельно кодирует объявление и последовательность действий. Часть для объявлений можно рассчитать заранее; пользовательскую запускают по свежей истории.
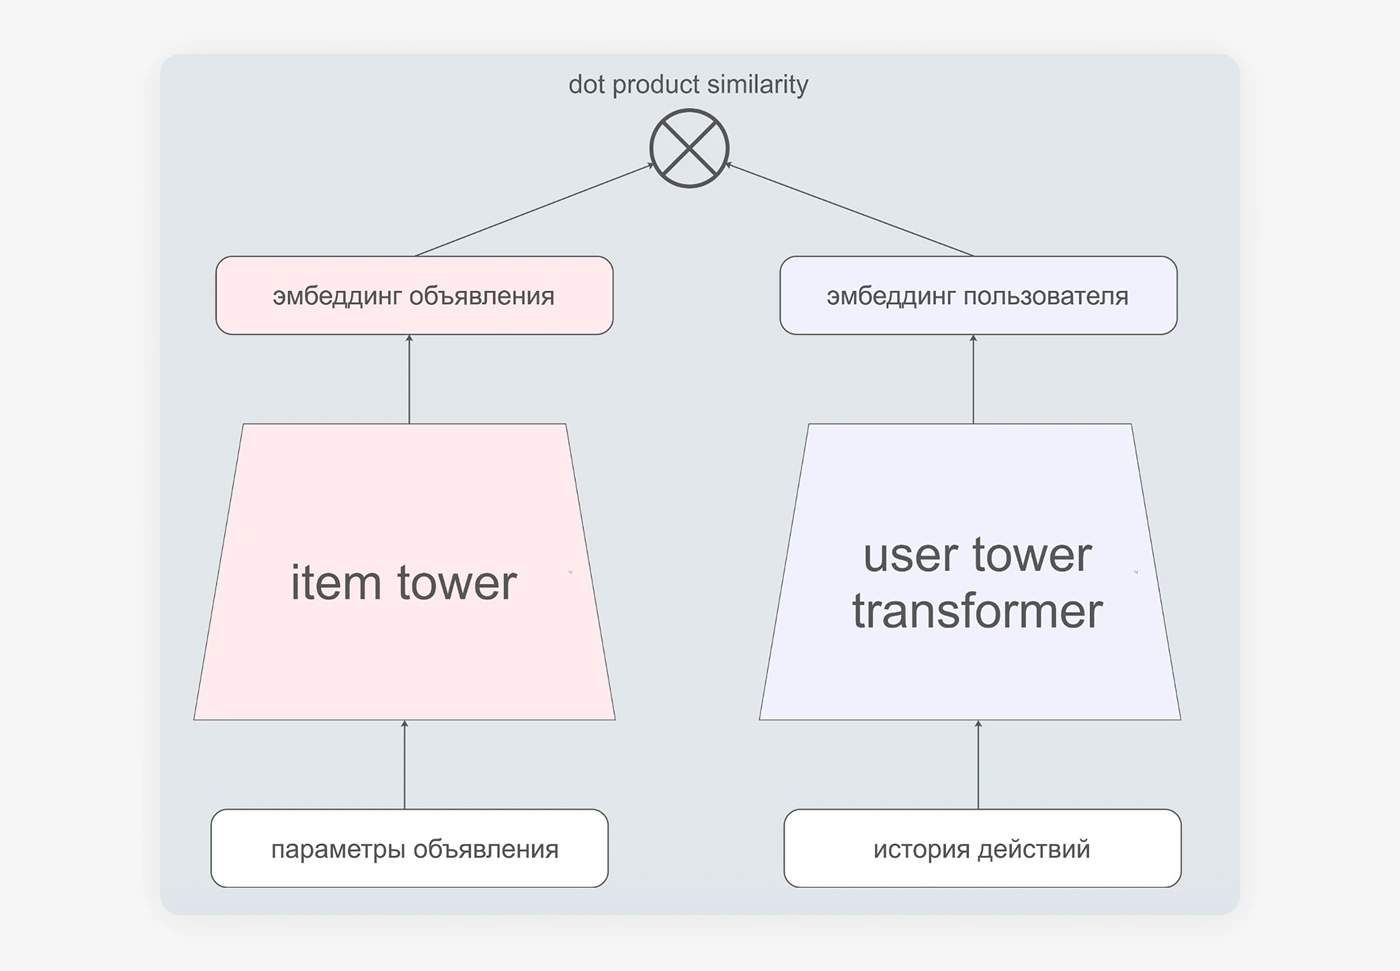
Две ветви модели: объявление и история пользователя.
Источник: Иллюстрация из оригиналаПоисковые запросы включили в историю
События разделили на действия с объявлениями и поиск. Для каждого типа есть свои признаки и кодировщик, но позиции сохраняют место в исходной общей последовательности. Поэтому разбиение на две подпоследовательности не уничтожает порядок.
Числовые признаки кодируются интерполяцией между векторами границ интервала, чтобы близкие цены не превращались в резко разные значения. Бинарные, категориальные и текстовые признаки получают разную ёмкость представлений. Их взаимодействия обрабатывает Deep Cross Network.
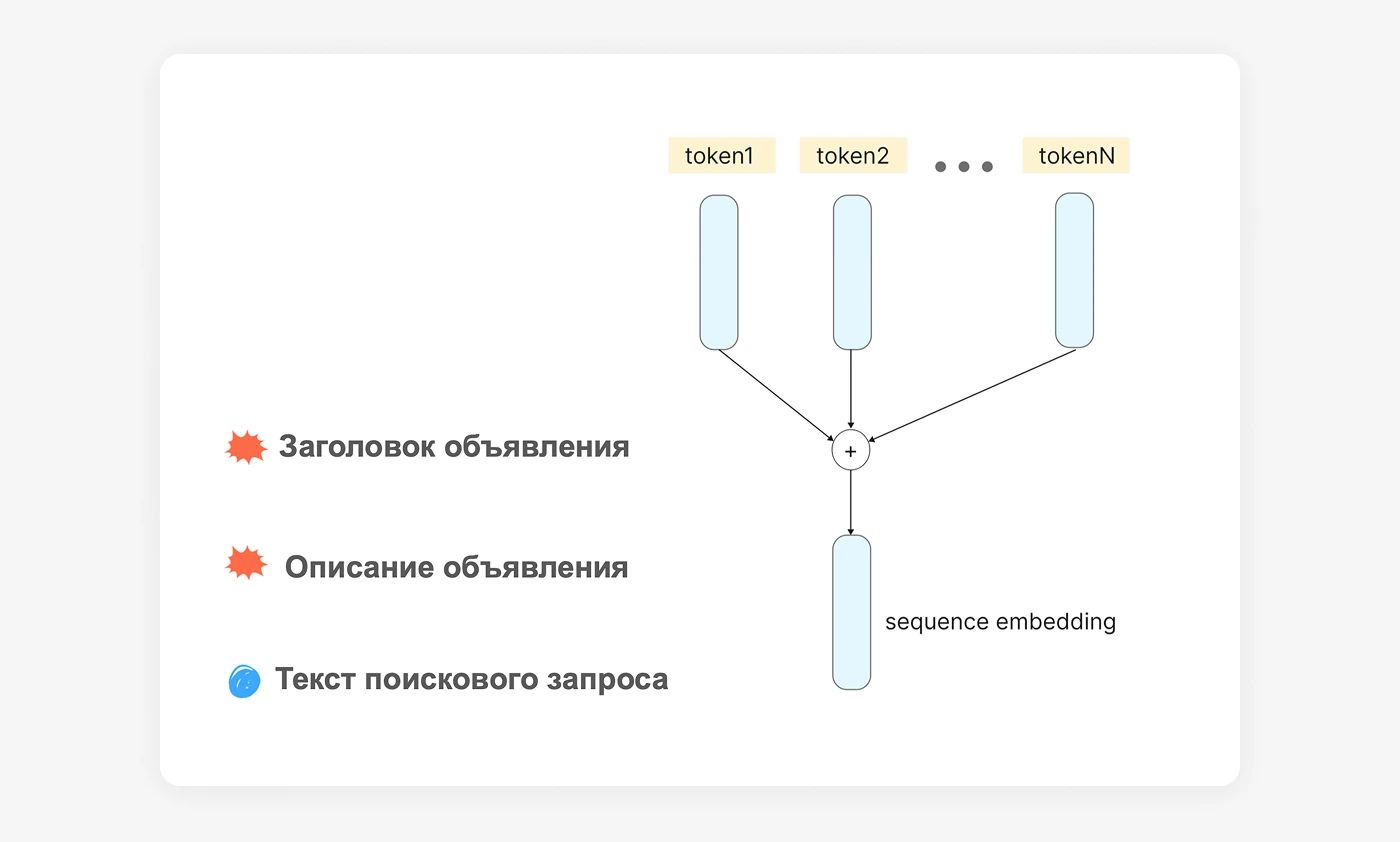
Текстовые признаки объявления и поискового запроса.
Источник: Иллюстрация из оригиналаОбучающий пример должен быть сложнее повтора клика
Между историей и целевым объявлением вводят случайный разрыв от минут до дней. Из той же сессии убирают действия, непосредственно ведущие к целевому событию. Это мешает модели решать задачу простым повторением уже почти завершённой покупки.
Положительная пара — история и целевое объявление. Отрицательные берут из других примеров пакета и дополняют случайными объявлениями общей базы. В сравнении функций потерь выбрали InfoNCE: в описанных экспериментах она дала немного лучшие метрики.
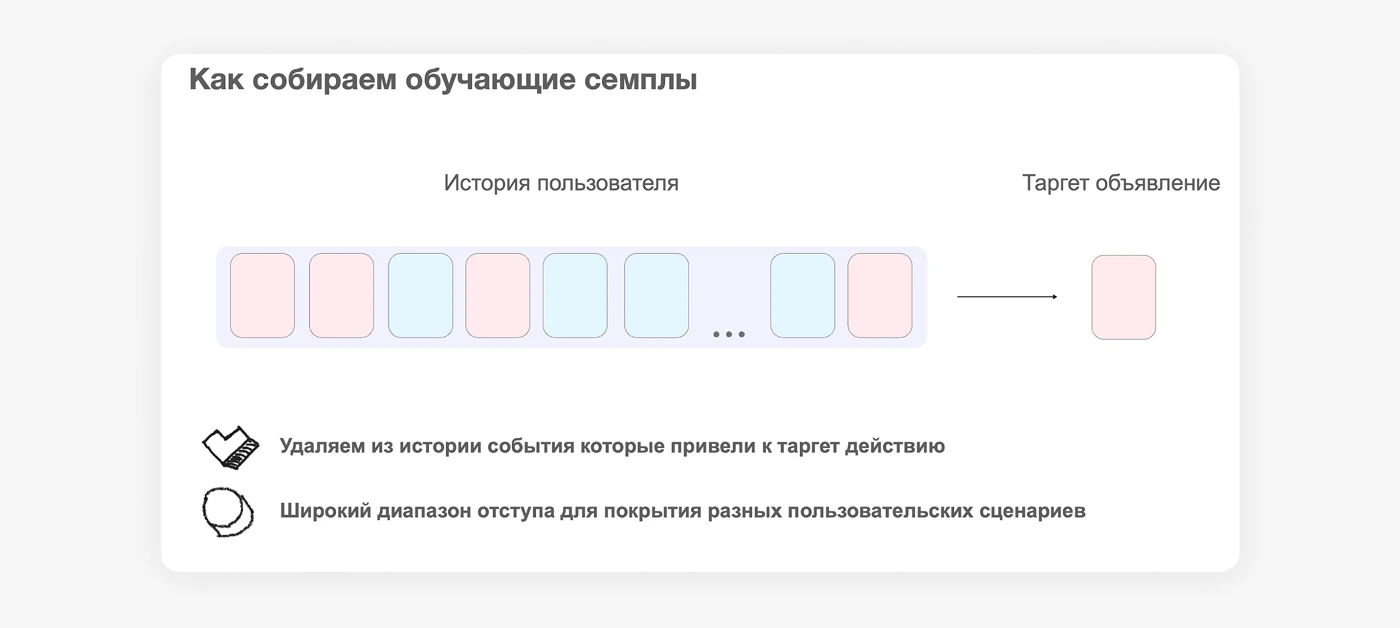
Формирование обучающих примеров.
Источник: Иллюстрация из оригиналаНесколько векторов пользователя и два применения
Один вектор пользователя должен вместить больше информации, чем вектор одного товара. Поэтому профиль представили несколькими векторами: каждый сопоставляют с кандидатом, затем объединяют оценки.
Векторы объявлений хранят в Redis и обновляют при изменении карточек; для поиска соседей используют Sphinx. Aqueduct разделяет подготовку на CPU и вызов модели на GPU. Для ранжировщика вычисляют близость пользователя ко всем кандидатам, в том числе полученным другими моделями.
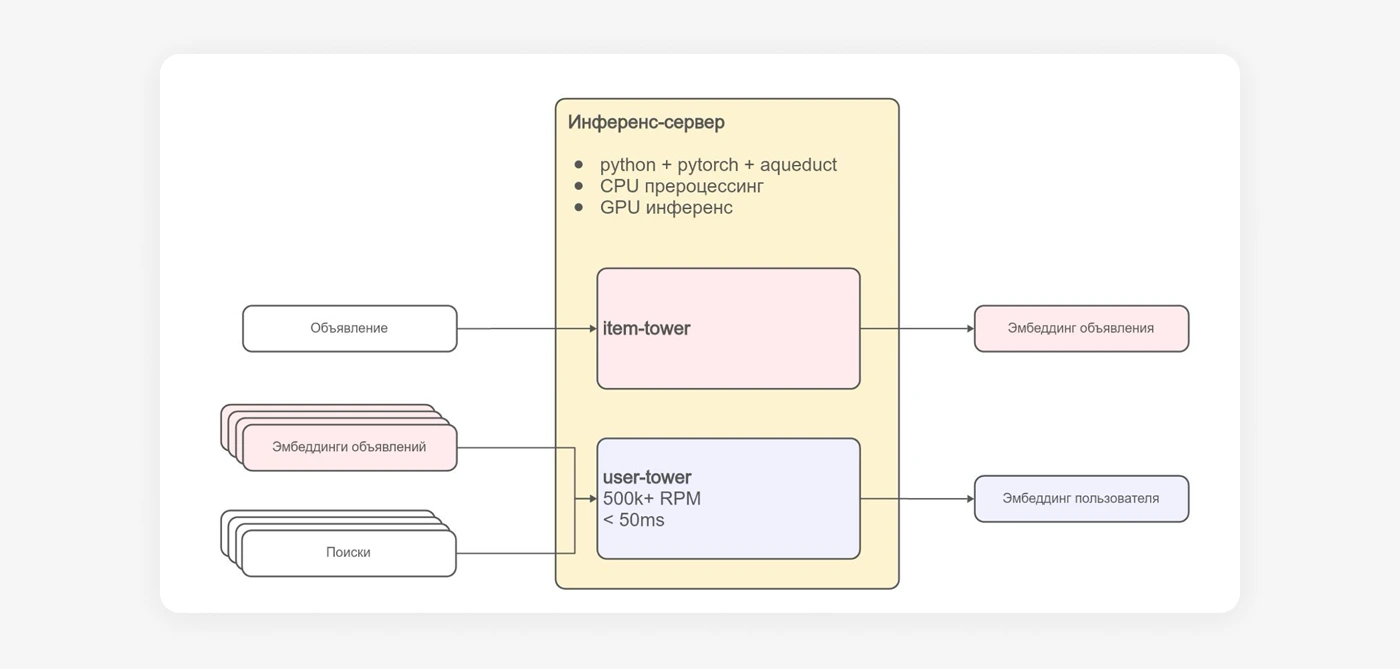
Подготовка и применение пользовательского вектора.
Источник: Иллюстрация из оригиналаРезультаты относятся к разным моделям
Модель, обученная по всем категориям и используемая как признак ранжирования, дала +2,3% целевых действий на главной. Отдельная модель для «Личных вещей» в роли отбора кандидатов — +1,1% на главной и +8,1% внутри категории.
Это разные сценарии и области измерения. Категорийный рост не является ростом всей площадки, а результат двух моделей не представлен как единый суммарный эффект.
Этот фрагмент в оригинале