Разбор готов
Яндекс Музыка: от рекомендательного стека к одной генеративной модели
Чтобы выбрать следующий трек в «Моей волне», система Яндекс Музыки последовательно отбирала и ранжировала кандидатов с помощью множества моделей. Каждый этап имел свои ограничения: хороший трек мог не пройти ранний отбор, а изменения приходилось согласовывать по всему каскаду. Николай Савушкин рассказывает, как команда постепенно заменила ранжирование, затем поиск кандидатов и объединила их в модель Sona. В докладе есть архитектура, способ обучения и результаты эксперимента, а также важные оговорки: речь идёт о проверке на умных устройствах, не о завершённой замене рекомендаций во всей Музыке.
Материал полезен тем, кто уже знаком с основами рекомендаций и хочет понять переход к генеративному подбору объектов. Здесь особенно интересны совместное обучение частей системы, работа с длинной историей и оценка нового алгоритма по данным, собранным старым.
Рекомендуем. Полезно для понимания того, как связаны отбор кандидатов, ранжирование, обучение и стоимость выполнения одной рекомендательной системы.
Видео · на русском
От рекомендательного стека к одной генеративной модели в Яндекс МузыкеНиколай Савушкин · Practical ML Conf 2026 · Опубликовано: 19 сентября 2026 г.
Исходный доклад · Открыть оригинал
Почему каскад стало трудно развивать
В прежней системе сначала несколько моделей предлагали кандидатов, затем предварительное и финальное ранжирование сокращали и упорядочивали список. У поздней стадии нет возможности вернуть трек, который ранний отбор уже потерял. А требование к разнообразию или новизне приходится учитывать на всём пути.
У музыки есть дополнительная особенность: человек часто слушает её фоном. Пропуск, лайк или дизлайк случаются реже самого прослушивания. При этом знакомые треки помогают удерживать время слушания, а сервису важно открывать человеку новую музыку. Эти цели могут конфликтовать.
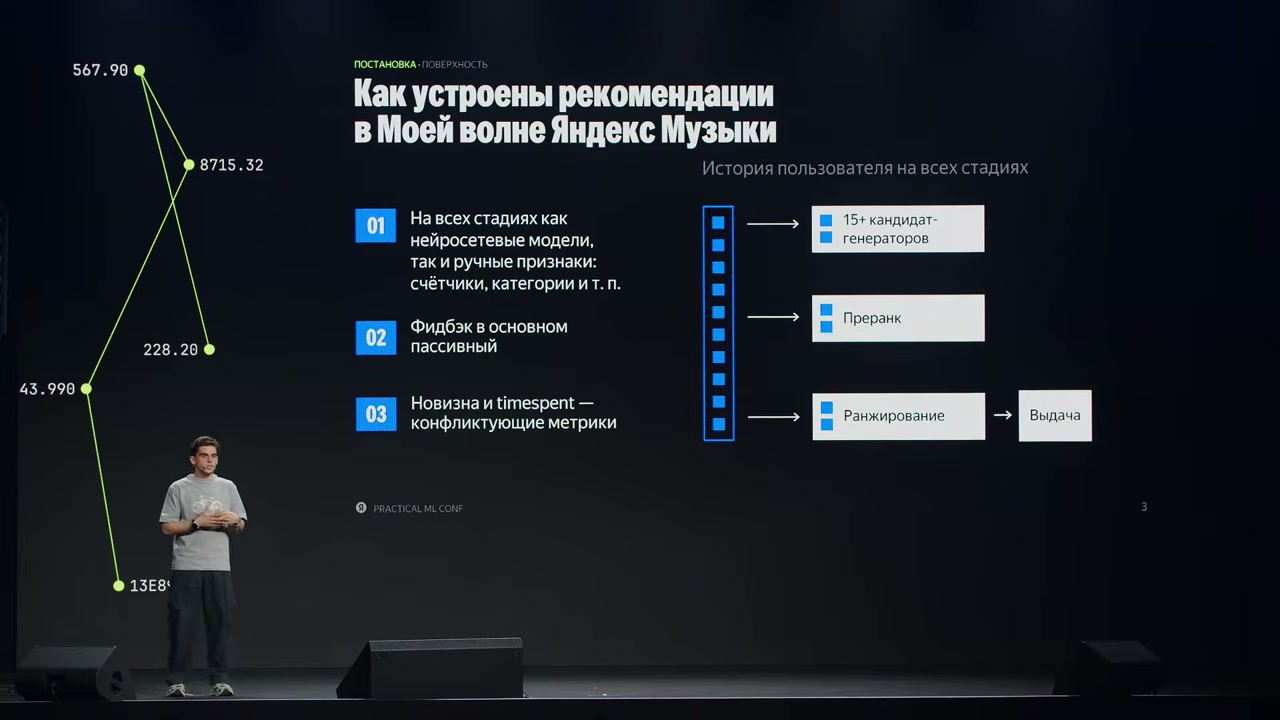
Исходный каскад «Моей волны»: источники кандидатов, предварительное и финальное ранжирование.
Источник: Николай Савушкин · Practical ML Conf 2026Первый шаг: кандидат смотрит на историю
Модель с двумя башнями отдельно превращает пользователя и трек в векторы, а затем сравнивает их простой функцией. Такая форма удобна для поиска, но длинная история сжимается в одно представление ещё до того, как модель узнает, какой именно трек нужно оценить.
В Cross-ARGUS история кодируется в последовательность представлений. Отдельный модуль получает признаки выбранного трека и обращается к нужным частям этой истории через механизм внимания. Так он может оценить реакцию на конкретного кандидата, не полагаясь только на один заранее сжатый вектор.
Автор описывает два этапа обучения: сначала предсказание следующего объекта по истории, затем обучение ранжированию. Предварительное обучение оказалось важным. Замена финального ранжирования проверялась отдельно, прежде чем команда объединила всю систему.
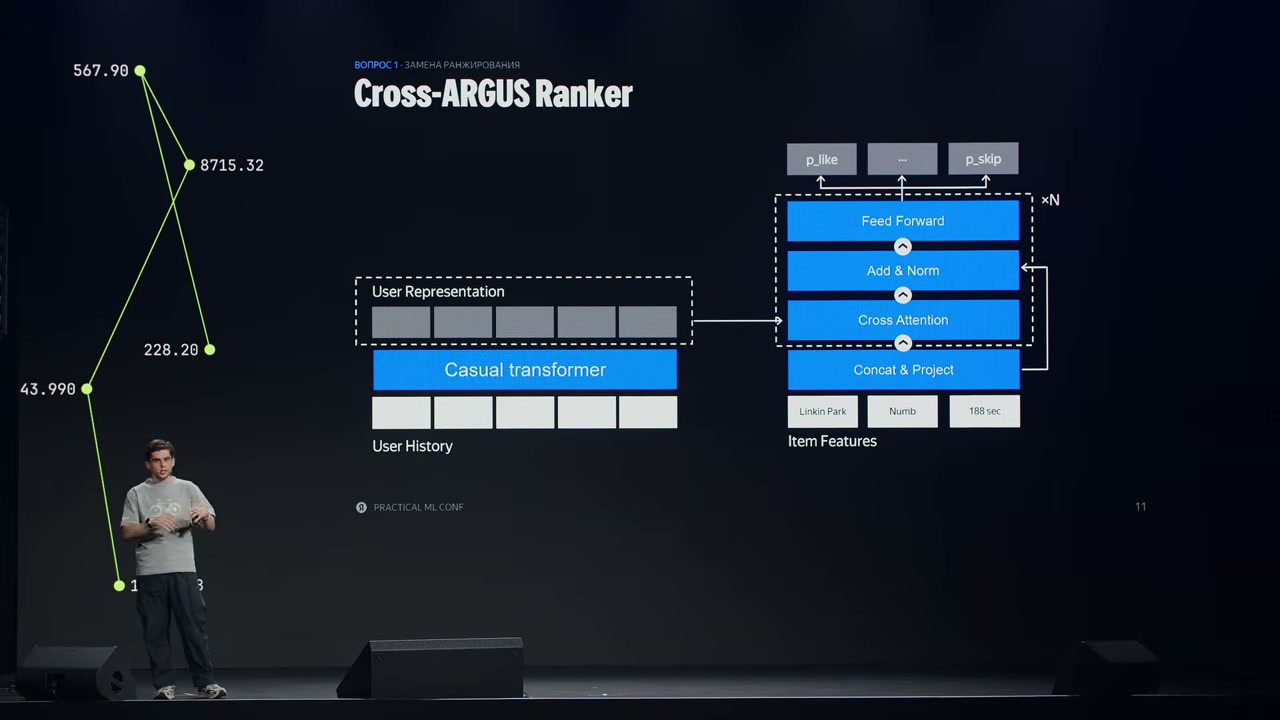
Cross-ARGUS: признаки целевого трека обращаются к представлениям истории через cross-attention.
Источник: Николай Савушкин · Practical ML Conf 2026Что дала замена ранжирования
Двухстадийное обучение сначала учит модель понимать последовательность прослушиваний, а затем — оценивать конкретного кандидата. На слайде автор сравнивает его с обучением без предварительного этапа. Офлайн используется weighted pair accuracy — взвешенная точность упорядочивания пар объектов. Это проверка ранжирования на данных, а не показатель активности слушателей.
В отдельном онлайн-эксперименте Cross-ARGUS заменяет только этап ранжирования. На слайде показаны +1,22% по Active Users (активные пользователи, основная метрика) и +1,64% по Total Listening Time (суммарное время прослушивания). Генерация кандидатов и предварительное ранжирование ещё остаются прежними. Поэтому эти цифры относятся к замене одного этапа, а не ко всей Sona.
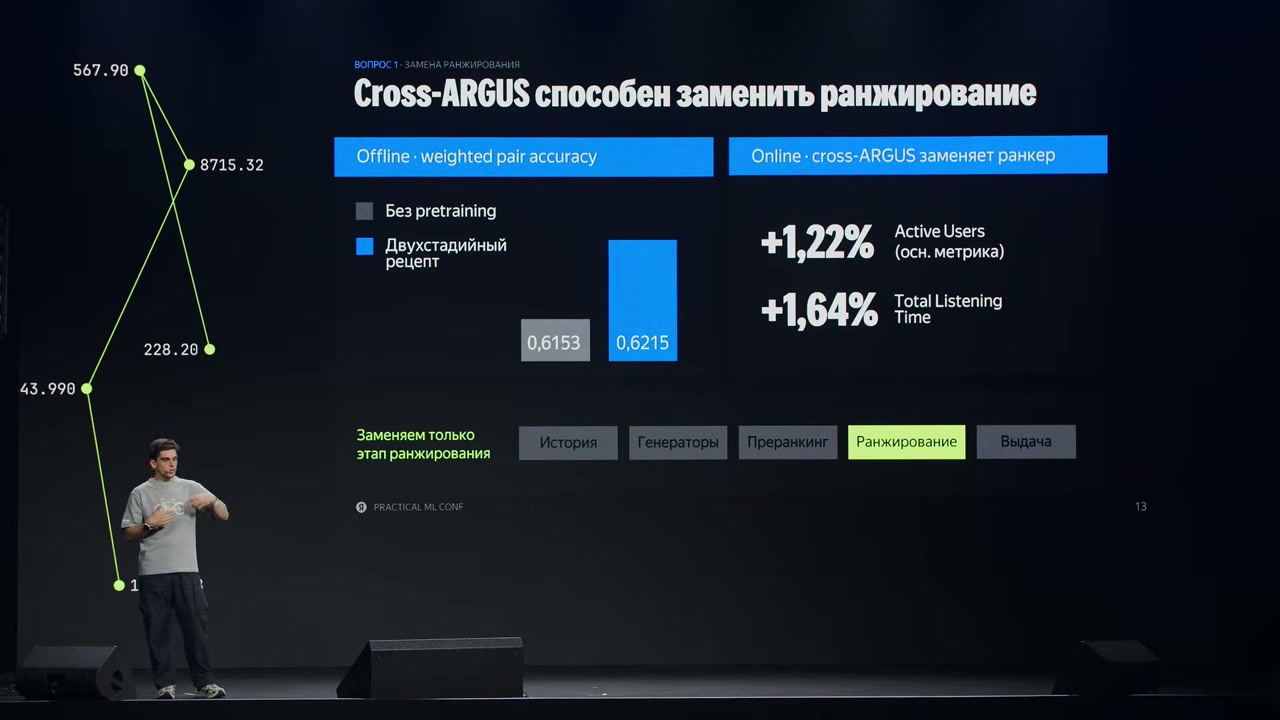
Слайд 13. Предварительное обучение улучшает офлайн-оценку, а замена только ранжирования даёт рост двух пользовательских метрик. Это разные сравнения.
Источник: Николай Савушкин · Practical ML Conf 2026Второй шаг: генерировать коды треков
Для отбора кандидатов нужно работать с большим каталогом. Команда представляет трек короткой последовательностью дискретных кодов — семантическим идентификатором. Модель предсказывает эти коды по очереди, а не оценивает сразу каждый трек каталога.
Код строится из представления, учитывающего текстовые сведения и звук, а затем уточняется по взаимодействиям слушателей. Полученный вектор последовательно разбивают на группы: после выбора центра группы кодируют оставшееся отличие. Так формируется составной код трека.
Несколько треков могут получить одинаковый код. Поэтому генерация кода ещё не даёт окончательный ответ. После обратного отображения в объекты каталога отдельный модуль оценивает конкретные треки. В докладе эта архитектура названа Gryphon.
Варианты кодирования команда сравнивает по конечной задаче отбора кандидатов. Красивое пространство представлений само по себе не гарантирует, что система найдёт нужную музыку.
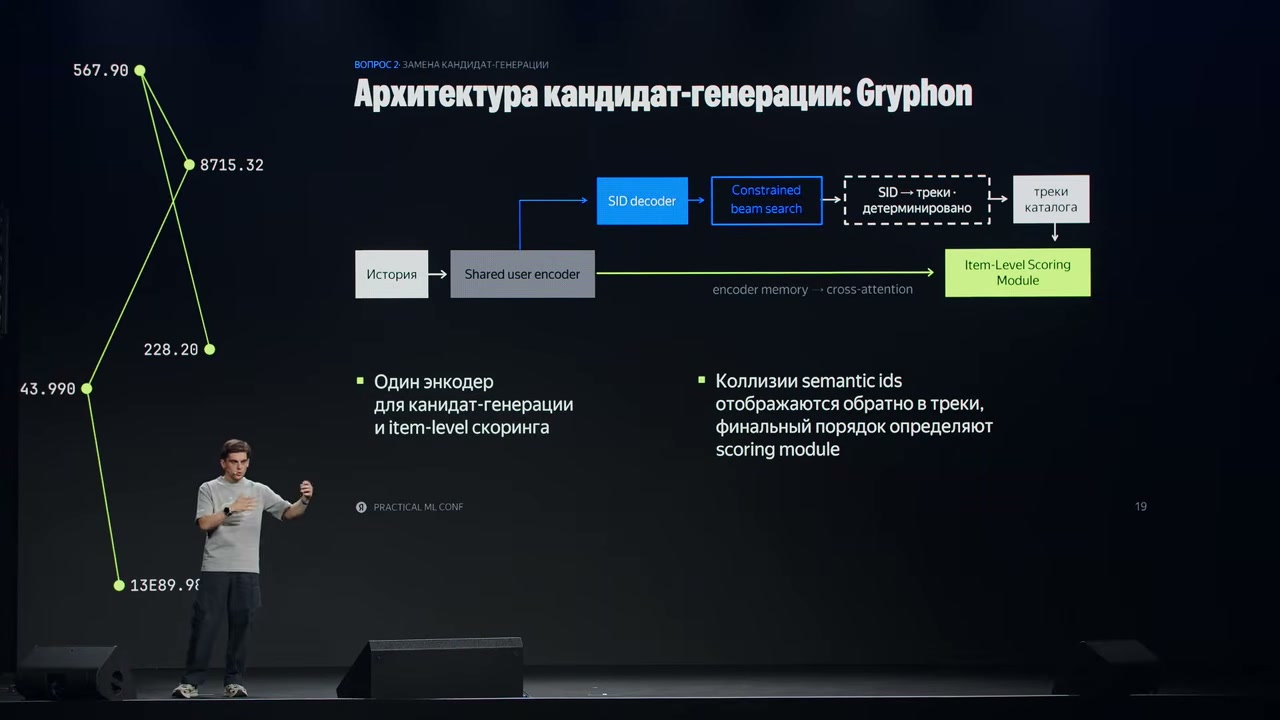
Gryphon: генерация семантических кодов, отображение в треки и оценка конкретных объектов.
Источник: Николай Савушкин · Practical ML Conf 2026Что получилось при замене каскада двумя моделями
Следующий эксперимент объединяет генеративный отбор кандидатов и Cross-ARGUS. Две модели заменяют прежние генераторы, предварительное и финальное ранжирование. На слайде результаты сопоставлены с вариантом, где менялся только ранжировщик.
Таблицу можно прокрутить по горизонтали.
На этом слайде числа подписаны без единицы; сохраняем запись автора. Для первых двух значений варианта «Только ранкер» знак процента явно указан на предыдущем слайде. Порог отнесения слушателя к Deeply engaged users здесь не раскрыт. Новое решение улучшает все три показанных показателя относительно исходной системы; вычитать столбцы и считать разность отдельным измеренным эффектом нельзя.
Однако история слушателя по-прежнему обрабатывается дважды — отдельно генератором и ранжировщиком. Именно это дублирование становится причиной следующего изменения: общего энкодера в Sona.
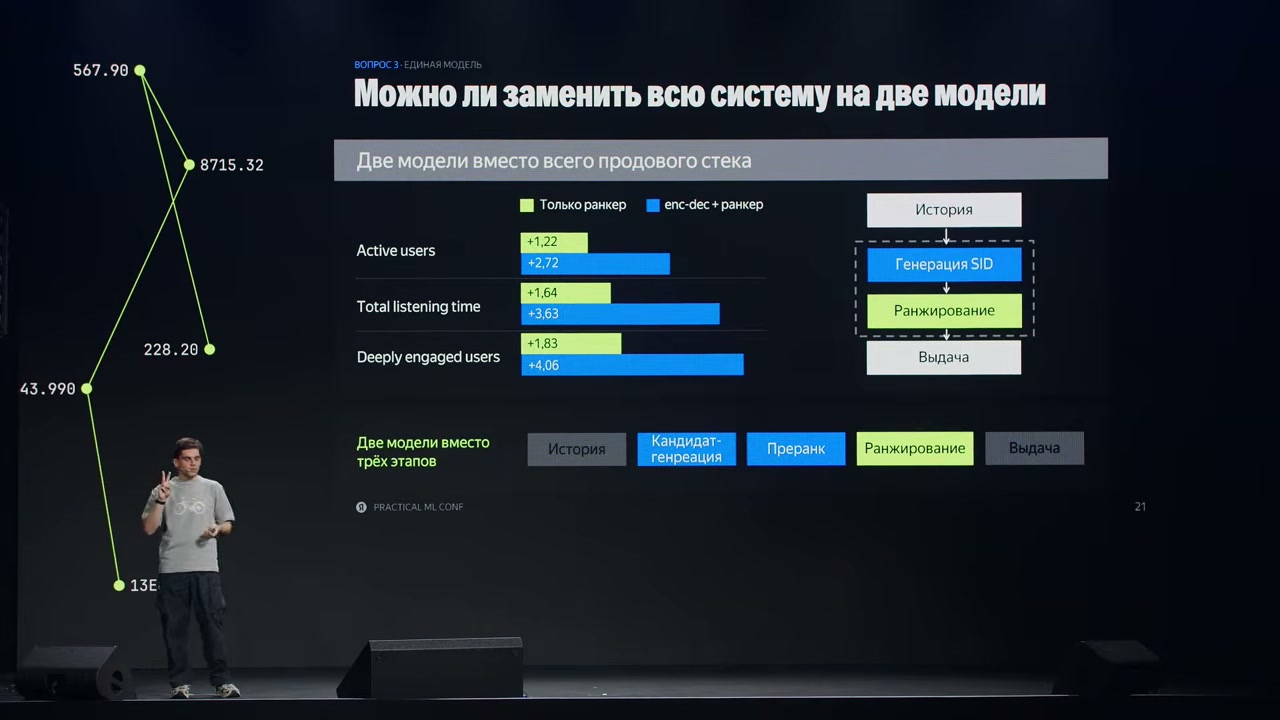
Слайд 21. Синие столбцы показывают вариант с двумя моделями; зелёные — замену только ранжирования. Это промежуточный результат до объединения в Sona.
Источник: Николай Савушкин · Practical ML Conf 2026Как две модели превратились в Sona
После отдельных экспериментов у команды были две модели, каждая из которых заново анализировала историю пользователя. Их объединили: один энкодер готовит представления истории, декодер предлагает коды треков, а ранжирующий модуль оценивает полученных кандидатов по тем же представлениям.
При генерации сохраняют несколько перспективных продолжений кода. Этот поиск называется beam search. Коды превращаются в треки, после чего ранжирование определяет их порядок. Общей становится дорогая обработка истории; функции выбора кандидатов и оценки не исчезают, а оказываются внутри одной архитектуры.
Доклад с 01:59:30Как оценивали систему: от обычного recall к Teacher Recall
Обычный recall при отборе кандидатов отвечает на вопрос: какую долю будущих положительных взаимодействий удалось найти в списке рекомендаций? Но наблюдаемые взаимодействия возникли при работе прежней системы. Если новая система предлагает другую хорошую музыку, она может хуже воспроизводить старые показы и получить меньший recall. Такой результат ещё не доказывает, что слушателям стало хуже.
Команда использует сильную модель Cross-ARGUS как учителя: её качество уже проверили онлайн при замене ранжирования. Учитель оценивает музыку с учётом длинной истории слушателя. Teacher Recall измеряет, насколько верхняя часть выдачи новой системы совпадает с верхней частью выдачи этого учителя. Тем самым ориентиром становится оценка сильной модели, а не только взаимодействия, собранные прежней системой.
Формула со слайда 23: Tₖ — первые k объектов учителя, Sₖ — первые k объектов новой модели; оба списка имеют размер k.
Считаем общие треки в двух списках и делим их количество на k. Условный пример: при k = 5 три общих трека дадут 3/5 = 0,6. Это не «60% правильных рекомендаций»: новая модель воспроизвела три из пяти предпочтений учителя. Перестановка этих трёх треков внутри списка не изменит значение метрики. В следующем сравнении на слайде автор использует k = 10.
Автор сообщает, что в экспериментах команды эта оценка хорошо согласовывалась с последующими онлайн-проверками. Это основание использовать её для отбора вариантов модели, но не гарантия роста бизнес-метрик и не замена A/B-тесту. Важно различать три вещи: попадание в будущие взаимодействия, совпадение с учителем и реальное поведение слушателей.
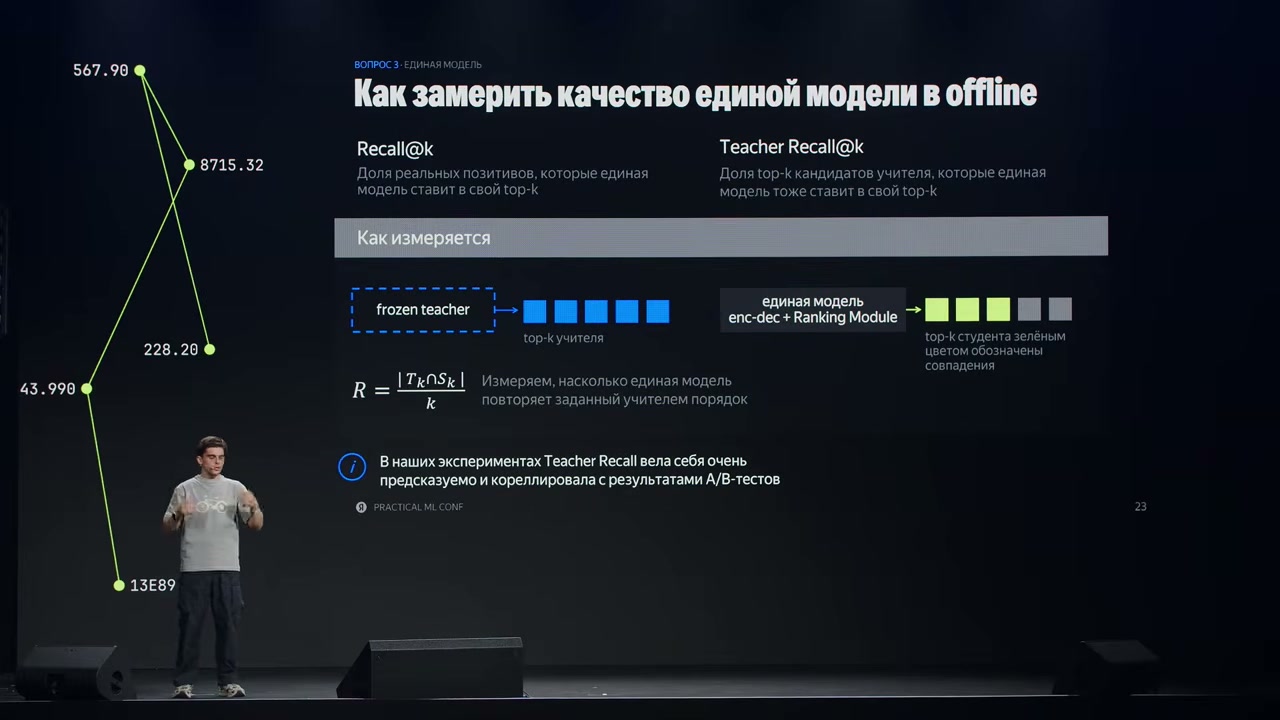
Слайд 23. Teacher Recall@k — доля верхних k кандидатов учителя, которые попали в верхние k кандидатов новой модели. Измеряется совпадение наборов, а не точное совпадение порядка внутри них.
Источник: Николай Савушкин · Practical ML Conf 2026Как согласовать генерацию и ранжирование
Даже при общей обработке истории генератор и ранжировщик могут быть плохо согласованы. Генератор учится предсказывать следующий положительный объект, а ранжировщик — различать положительные и отрицательные реакции. Таких реакций мало, и обучающие кандидаты могут отличаться от тех, которые новая модель предложит при работе.
Команда генерирует варианты кодов текущим декодером, переводит их в треки и оценивает замороженным ранжировщиком-учителем. Ранжирующий модуль учится воспроизводить его оценки. Эту процедуру автор называет rollout-дистилляцией. На слайде вместе с такими кандидатами используются и сохранённые показы действующей системы.
В этом сравнении обучение на собственных кандидатах генератора заметно лучше обучения только на старых показах; добавление показов к кандидатам даёт меньшую дополнительную прибавку. Это офлайн-совпадение с учителем, а не доля довольных пользователей. Решение одновременно даёт более плотный обучающий сигнал и готовит ранжировщик к тем объектам, которые ему предстоит оценивать.
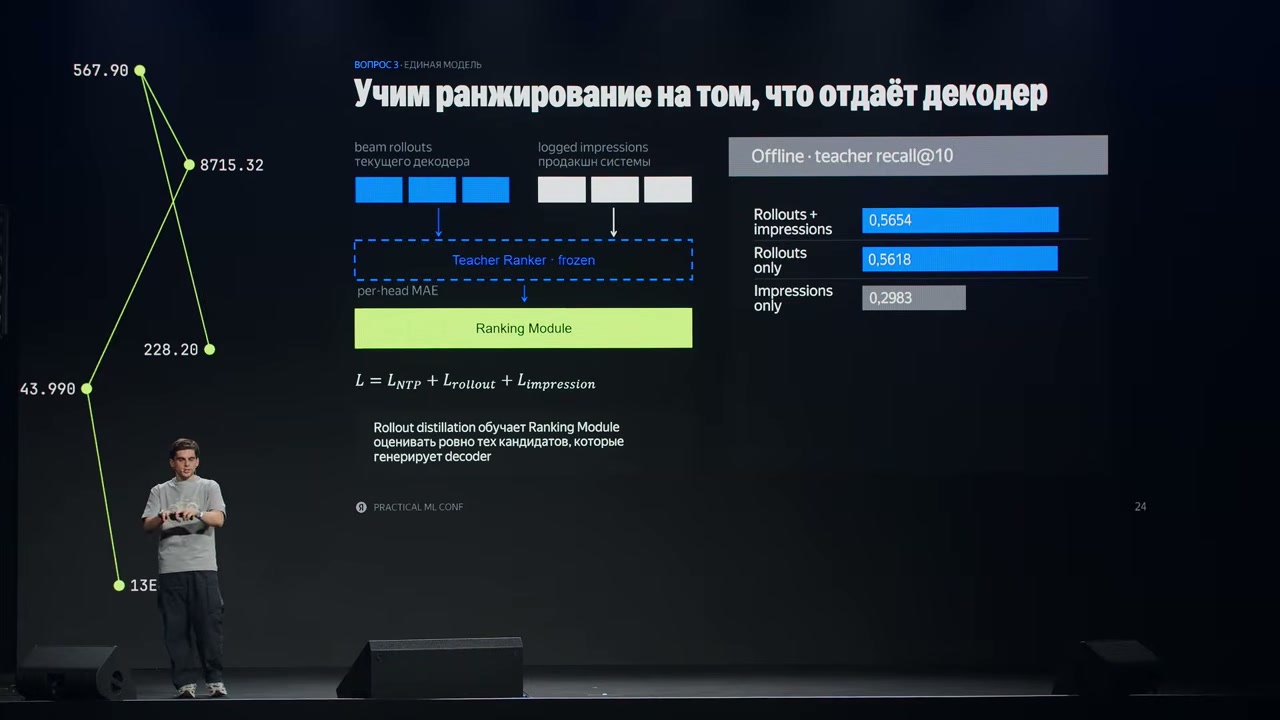
Слайд 24. Учитель размечает кандидатов декодера и сохранённые показы. Сравнение справа объясняет, почему недостаточно обучаться только на показах старой системы.
Источник: Николай Савушкин · Practical ML Conf 2026Длинная история и обновление модели
Увеличение истории помогает качеству, но требует больше вычислений. В итоговой конфигурации на слайде 8192 события: 2048 свежих обрабатываются глубокой моделью, 6144 старых — меньшим количеством слоёв. Декодер получает представления всех позиций. По данным автора, качество остаётся близким к обработке полной истории, а стоимость инференса составляет примерно половину.
Обновление модели организовано отдельно от выдачи рекомендаций: события собираются в сессии, поступают в очередь обучения, затем новые веса публикуются каждые 10 минут. Полный путь от события до обновления весов занимает 45 минут по медиане и 60 минут на 99-м перцентиле. Ранжировщик-учитель имеет свой цикл обучения раз в 24 часа. Эти интервалы относятся к свежести модели, а не к задержке ответа слушателю.
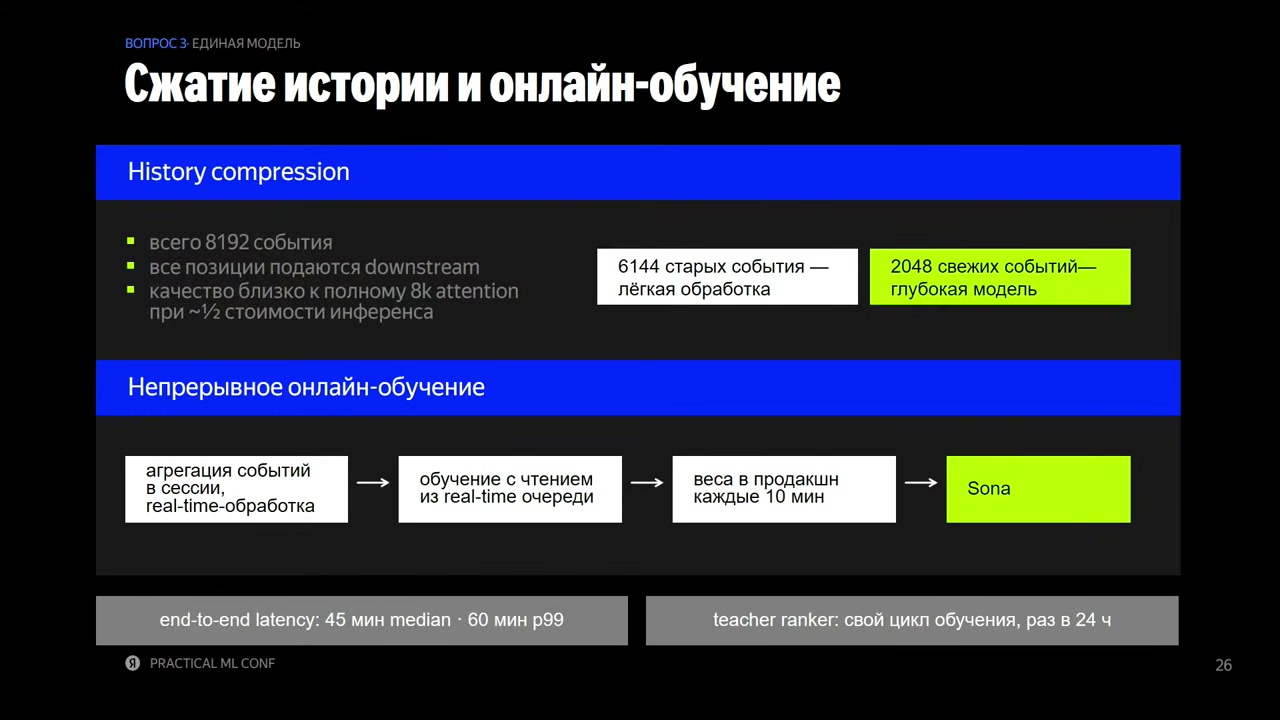
Слайд 26. Длинная история обрабатывается с разной глубиной; обновление весов каждые 10 минут не означает, что любое событие повлияет на модель через 10 минут.
Источник: Николай Савушкин · Practical ML Conf 2026Итоговый A/B-тест на умных устройствах
По словам автора, объединённая модель улучшила пользовательские метрики в A/B-тесте «Моей волны» на умных устройствах с Алисой. Это результат конкретного эксперимента. На дату выступления команда ещё проводила долгосрочную проверку и тесты на других поверхностях; полного перехода всего трафика не было.
Здесь сравниваются Sona и действующая система на одной поверхности — умных устройствах с Алисой. Знак процента обозначает относительное изменение против контроля, а не процентные пункты. Числа нельзя переносить на всю аудиторию Музыки или складывать с результатами предыдущих экспериментов. Длительность теста, размер выборки и доверительные интервалы на слайде не указаны.
Слайд также сопоставляет рост Active users с предыдущим экспериментом ARGUS на этой поверхности: +4,53% против +1,93%. Указанные автором 2,35 раза — отношение двух приростов метрики, а не увеличение числа пользователей в 2,35 раза. Для Deeply engaged users не раскрыт точный порог вовлечённости; сохраняем название метрики без выдуманного определения.
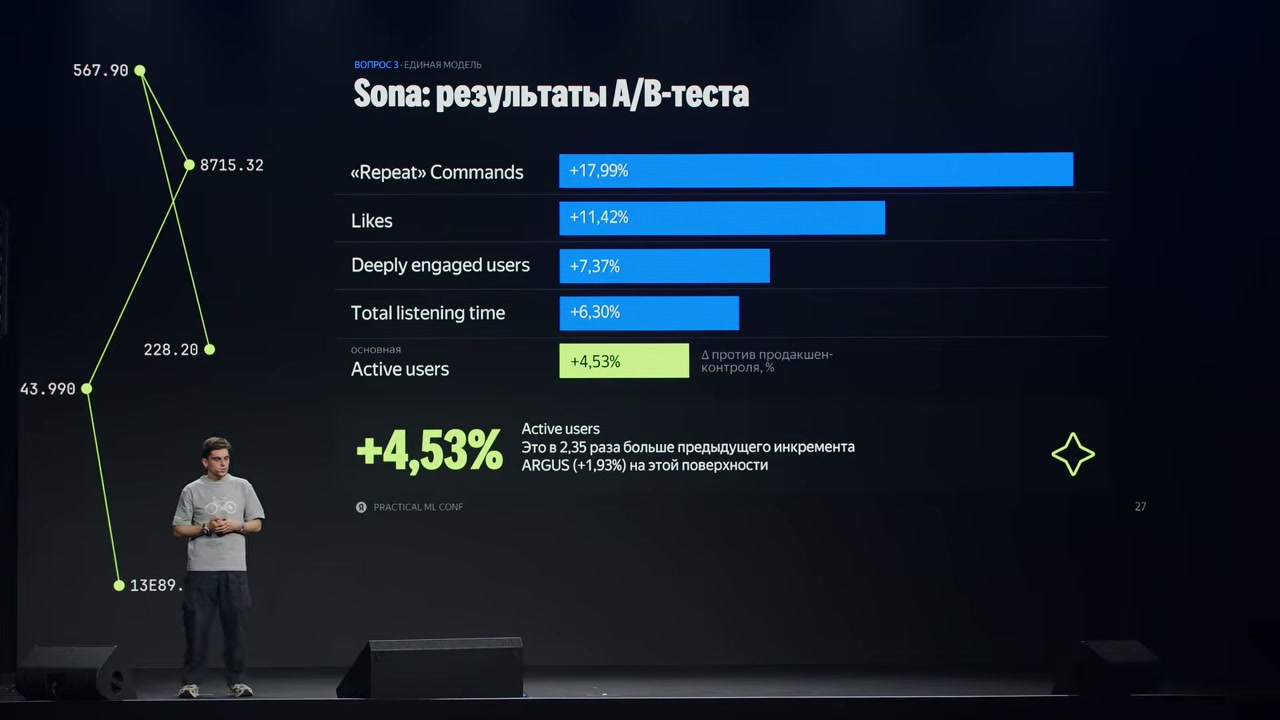
Слайд 27. Sona улучшила показанные пользовательские метрики относительно контроля. Основной результат — +4,53% Active users в эксперименте на умных устройствах с Алисой.
Источник: Николай Савушкин · Practical ML Conf 2026Что ещё не решено
Отдельная проблема — совершенно свежие треки. В описанной постановке генератору нужно увидеть объект при обучении, чтобы начать его предлагать. Отсутствие ухудшения метрик знакомства с новой музыкой пока может объясняться дообучением на данных действующей системы.
В ответах на вопросы автор также признаёт, что проблема обучения на собственной обратной связи и разнообразия рекомендаций не решена окончательно. Возможность заменить каскад одной моделью не означает запрета на будущие дополнительные источники кандидатов.
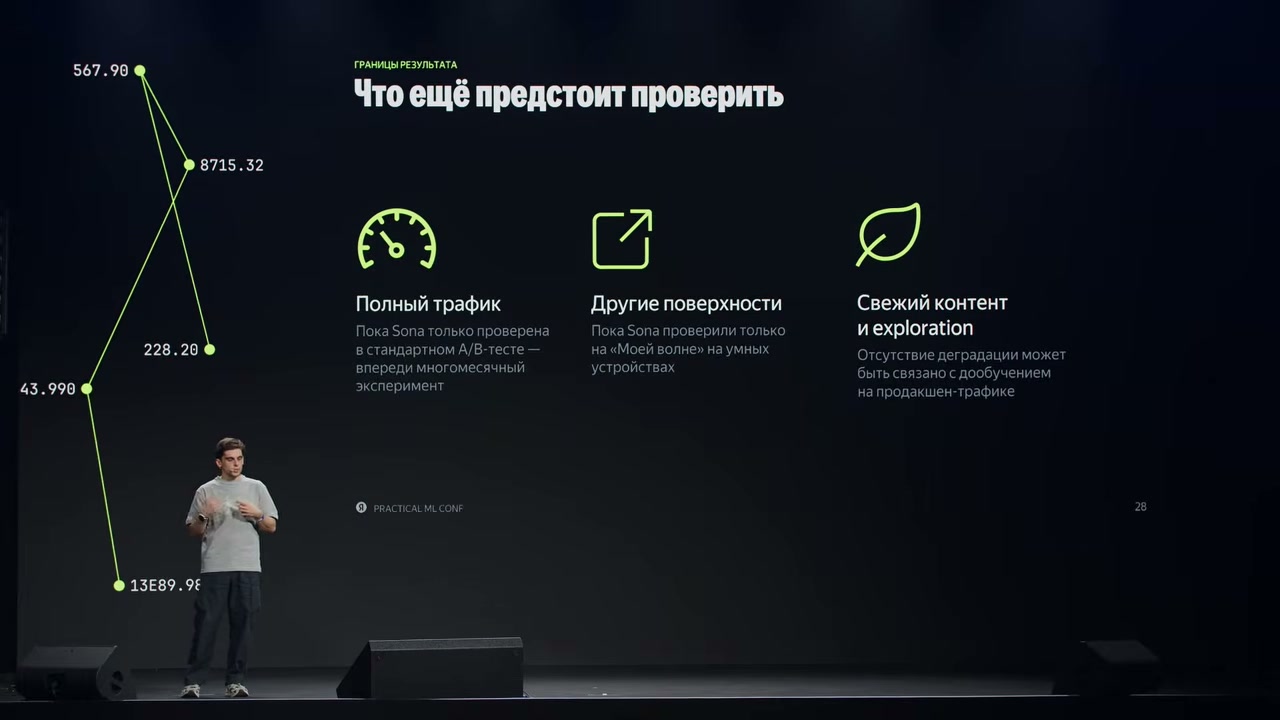
Границы результата: полный трафик, другие поверхности, свежий контент и exploration ещё требуют проверки.
Источник: Николай Савушкин · Practical ML Conf 2026Итог: как устроена Sona и чем проверяли результат
Мы разобрали, как команда постепенно сокращала сложность рекомендательного каскада «Моей волны». Сначала сильный Cross-ARGUS заменил ранжирование, затем генеративная модель взяла на себя поиск кандидатов. Объединение в Sona позволило один раз обрабатывать историю слушателя и использовать её представления для обеих задач. Функции отбора и оценки сохранились, но теперь согласуются внутри одной модели.
- 01
История слушателя
Система получает последовательность взаимодействий с музыкой; недавние и давние события обрабатываются с разной глубиной.
- 02
Общие представления
Энкодер превращает историю в представления, к которым обращаются генератор и ранжирующий модуль.
- 03
Коды треков
Декодер по очереди предсказывает части семантических кодов и сохраняет несколько перспективных продолжений.
- 04
Конкретные кандидаты
Коды сопоставляются с треками каталога. Один код может соответствовать нескольким объектам, поэтому окончательный выбор ещё впереди.
- 05
Ранжирование и выдача
Ранжирующий модуль оценивает кандидатов с учётом той же истории и определяет порядок рекомендаций.
Обучение происходит отдельно: учитель оценивает кандидатов текущего генератора, а ранжирующий модуль перенимает эти оценки. Teacher Recall помогает сравнивать варианты офлайн по совпадению с сильным учителем. A/B-тест проверяет уже поведение слушателей: активность, время прослушивания и вовлечённость. Улучшение одной офлайн-метрики само по себе не доказывает рост этих показателей.
В итоговом эксперименте на «Моей волне» в умных устройствах с Алисой Active users выросла на 4,53%, а суммарное время прослушивания — на 6,30% относительно контроля. На момент доклада ещё проверялись долгосрочный эффект и другие поверхности, полного перевода трафика не было. Свежие треки, разнообразие и обучение на собственной обратной связи остаются важными ограничениями. Поэтому результат доклада — проверенная в конкретном эксперименте архитектура и путь её построения, а не завершённая замена рекомендаций во всей Музыке.
Источник: итоговые результаты, затем ограничения эксперимента