Разбор готов
Pinterest TransAct V2: длинная история, негативные показы и ускорение обслуживания
Короткая история быстро улавливает текущий интерес, но может забывать редкие темы и делать ленту однообразной. TransAct V2 дополняет свежие действия многолетней историей, ищет нужные события под конкретный кандидат и добавляет задачу предсказания следующего взаимодействия. Основной объём статьи посвящён тому, как такую модель реально обслуживать: что записывать в обучающие журналы, как не копировать историю для каждого кандидата и как объединить GPU-операции. Разбор версии v1 от 2 июня 2025 года отдельно рассматривает качество модели, отдельное вычислительное ядро и задержки перегруженного сервиса: это три разных типа экспериментов.
Для RecSys-инженеров, которым интересны длинные последовательности внутри CTR-модели, выбор отрицательных примеров, соответствие обучения и инференса и оптимизация передачи данных на GPU.
Рекомендуем. Читайте после исходного TransAct: здесь особенно хорошо разобраны негативные показы, общая история запроса и влияние очередей на хвост задержки.
Публикация · на английском
TransAct V2: Lifelong User Action Sequence Modeling on Pinterest RecommendationОткрыть оригинальную статью (PDF)Xue Xia, Saurabh Vishwas Joshi, Kousik Rajesh и соавторы · Pinterest · Опубликовано: 2 июня 2025 г.
V2 развивает CTR-модель, а не заменяет её генератором списка
Как и раньше, Homefeed использует отбор кандидатов, ранжирование и смешивание. Многозадачная модель оценивает вероятности взаимодействий с конкретным пином. TransAct V2 расширяет признаки пользователя внутри этого ранжировщика. Существующие признаки контекста, автора и объекта, слои взаимодействий и выходы под разные действия сохраняются.
Это важно для сравнения с HSTU и OneRec. Здесь не генерируют семантические ID готового списка. Дополнительная задача предсказания действий помогает обучению представлений, но прикладной выход остаётся набором оценок кандидата. Название next-action не меняет эту границу ответственности.
В качестве онлайн-контроля авторы выбирают уже работающий TransAct с realtime-последовательностью. Поэтому результаты V2 описывают следующий шаг после сильной модели, а не повторяют сравнение TransAct 2023 года с отсутствующей свежей историей.
§1 и §3.1: Ranking ModelКакие истории объединяет новая модель
Долгосрочная история содержит явные действия за период порядка нескольких лет: сохранения, клики и скрытия. Простые показы из неё исключены, но для показов существует отдельная последовательность. Свежая последовательность, долгосрочная последовательность и последовательность показов поэтому несут разные сведения и не являются тремя копиями одного журнала.
Для события используются время, тип действия, поверхность продукта и 32-мерный PinSage-вектор. Несколько реакций на один пин могут быть представлены multi-hot-набором типов. Поверхность, например поиск или главная лента, помогает различать контекст взаимодействия.
Максимальную длину долгосрочной истории выбирают по 90-му процентилю историй за два года с весами по частоте посещения. В статье это масштаб порядка 10 тысяч событий, а не обещание хранить абсолютно каждое событие каждого человека. Самые крупные векторы PinSage переводят из fp16 в int8, уменьшая размер этой части вдвое. Коэффициент нормировки 0,65 относится к их распределению векторов и не является универсальным параметром квантования.
§3.2.1: Lifelong User Sequence FeaturesКандидат выбирает нужную часть длинной истории
Для кандидата по скалярному произведению PinSage-векторов ищут ближайшие события в долгосрочной истории, оставшейся realtime-истории и показах. Кроме результатов сходства всегда сохраняют несколько самых свежих действий. Это защищает от ситуации, когда новый намеренный интерес ещё не похож на текущий кандидат и полностью выпадает из входа.
Все выбранные части соединяются в последовательность длиной порядка сотен событий. Производственный вариант в эксперименте использует длину 192, два слоя и размерность feed-forward части 32. История в десятки тысяч событий не проходит целиком через каждое внимание: большая история нужна для поиска, короткая — для подробной обработки.
Как в исходном TransAct, вектор кандидата рано добавляют к каждому событию. Но V2 также использует признаки поверхности и обучаемое позиционное представление. Поэтому не следует переносить вывод первой статьи «позиции не помогли» как неизменную особенность всей линейки.
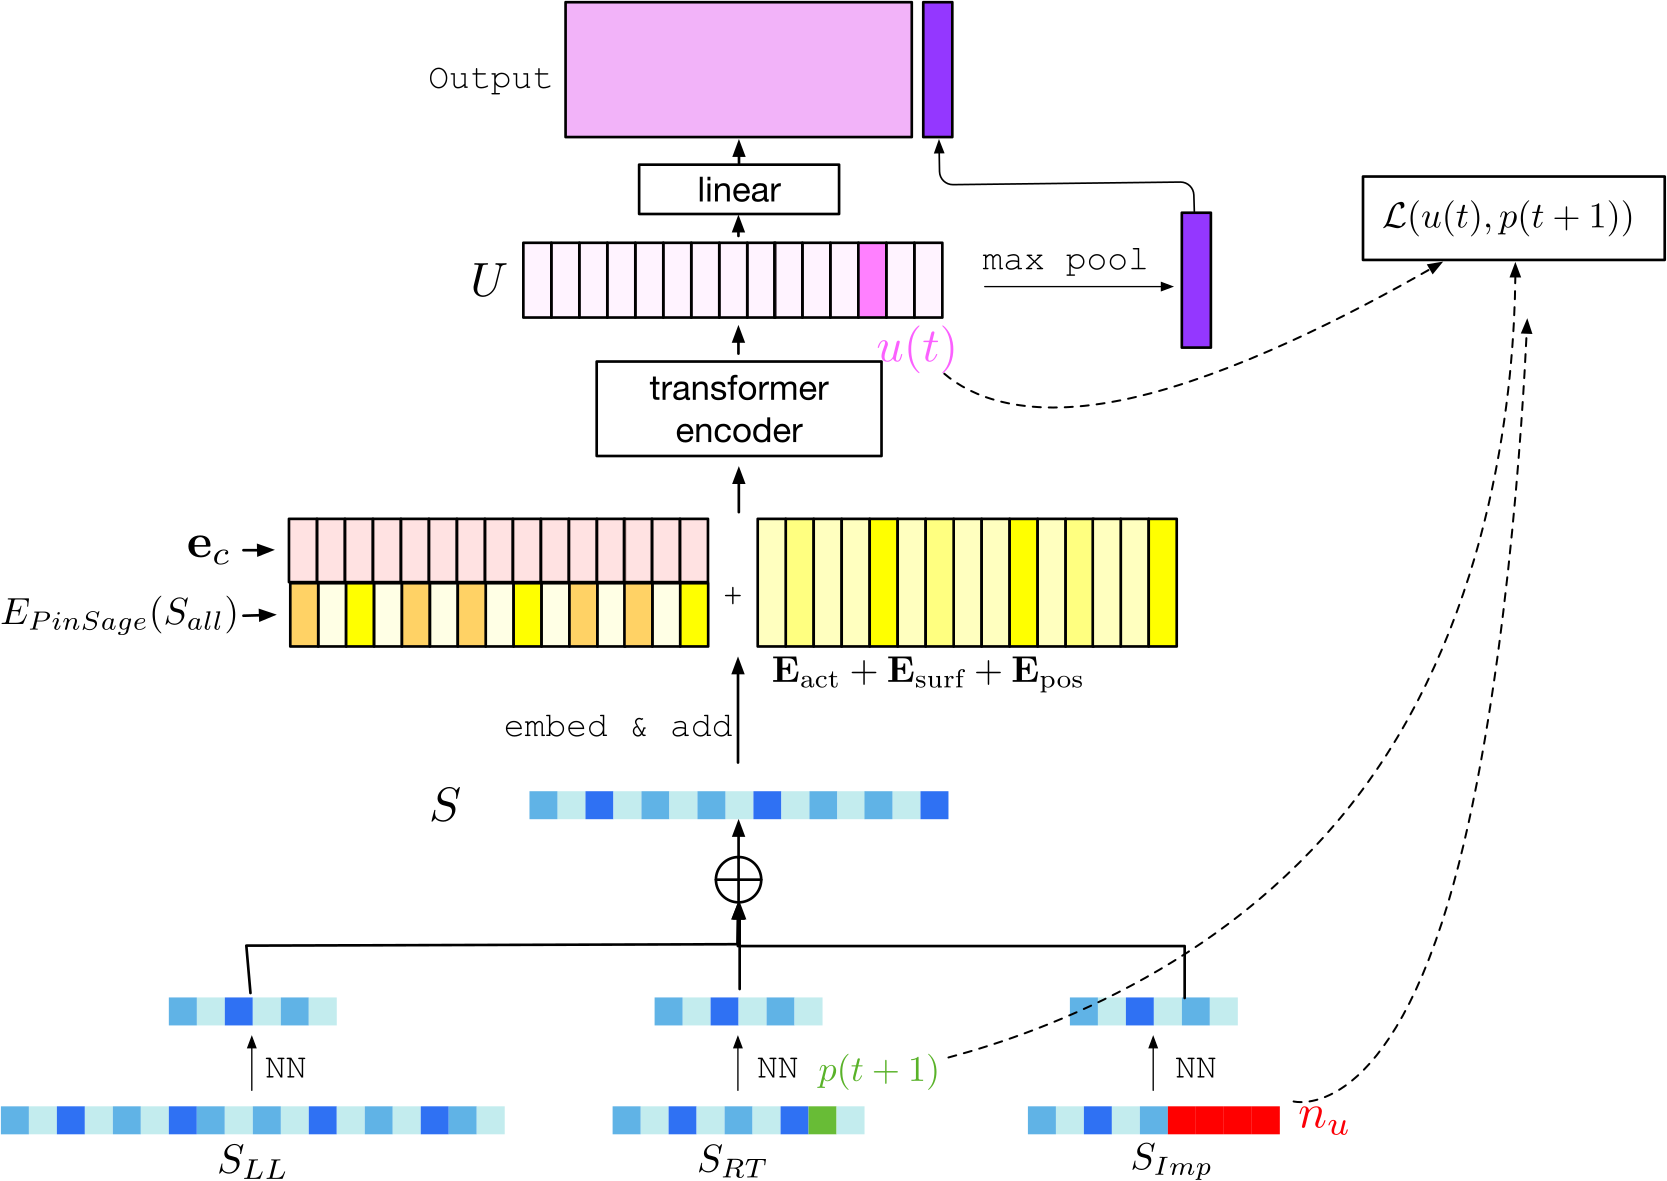
Рисунок 3: отбор событий из долгосрочной истории, свежих действий и показов; самые недавние действия добавляются независимо от их сходства с кандидатом.
Источник: Оригинальная иллюстрация · PinterestЧто именно предсказывает Next Action Loss
Основная функция потерь по-прежнему обучает выходы CTR-модели на реакциях на кандидата. NAL добавляет отдельное обучение: представление пользователя после события t должно предпочитать следующий положительный объект отрицательным альтернативам. Для этого используют sampled softmax, а взвешенный NAL складывают с основной кросс-энтропией.
Чтобы это не превратилось в чтение ответа из будущего, используется причинная маска: при предсказании следующего события разрешены только предыдущие события. Это отдельная роль маски, отличная от маски случайного временного окна в TransAct 2023 года. Первая предотвращает утечку при обучении предсказания, вторая регулирует зависимость от недавнего интереса.
Положительные примеры выбираются из недавних событий с положительной реакцией. Для негативов сравнивают объекты из историй других людей в пакете и пины, показанные этому пользователю без последующего взаимодействия. Вторые обычно представляют более правдоподобную трудную альтернативу, поэтому помогают уменьшать нежелательные рекомендации.
Показ без действия — всё равно не абсолютное доказательство неприязни: человек мог не заметить объект. В статье это обучающее приближение. Его преимущество подтверждено опытами на выбранных данных, а не универсальным правилом считать любой непрокликанный показ истинным негативом.
§3.3: Next Action LossПочему обучение не читает всю многолетнюю историю заново
Во время выдачи система получает полную долгосрочную историю и выполняет поиск событий под конкретные кандидаты. В обучающие журналы записываются только результаты этого поиска. Обучение читает уже выбранные события и сразу передаёт их трансформеру, не повторяя весь дорогой поиск на каждом примере.
Авторы описывают снижение объёма записи с O(L) до O(1). Эта константа относится к фиксированному размеру выбранной истории для примера; она не означает нулевого хранения исходных историй. Полные события всё ещё нужны онлайн-компонентам и системам формирования признаков.
Разные пути подготовки обучения и выдачи создают риск несовпадения. Здесь их связывает одинаковое представление выбранных соседей. При переносе нужно проверять версию векторов, доступность события в момент показа и согласованность выбора истории. Необходимо сохранять то, что было реально известно при выдаче, а не незаметно подставлять более поздние данные.
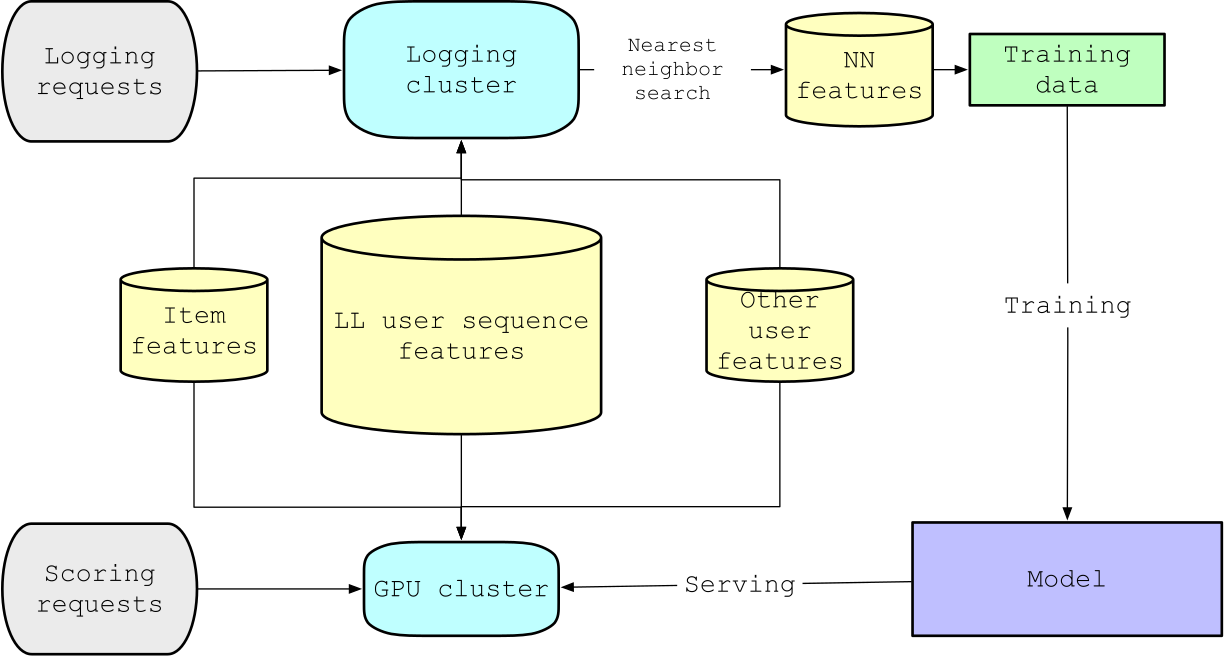
Рисунок 4: в рабочем запросе используется полная история, а в обучающие данные попадает её выбранная часть. Разные пути подготовки должны сохранять одинаковый смысл признаков.
Источник: Оригинальная иллюстрация · PinterestКак перестали многократно передавать одну историю
В одном запросе ранжируются многие кандидаты одного человека. Наивная реализация копирует одну и ту же длинную историю для каждого кандидата сначала на CPU, затем на GPU. При числе кандидатов N и длине истории L стоимость передачи растёт как O(NL), хотя полезная исходная история одна.
Pinterest вводит разреженный формат с одной копией признаков уровня запроса и смещениями, показывающими, какие кандидаты к ней относятся. Специальное Triton-ядро выполняет поиск соседей прямо по этому представлению. Не нужно сначала разворачивать историю в N копий на GPU. Для последовательных признаков авторы сообщают о восьмикратном уменьшении передачи через PCIe.
Деквантование int8-векторов, нормализацию и поиск тоже объединяют: вместо нескольких проходов с промежуточными тензорами данные обрабатываются в меньшем числе операций. Это отдельная оптимизация от дедупликации. Её нельзя переименовывать в восьмикратное ускорение всего ранжировщика.
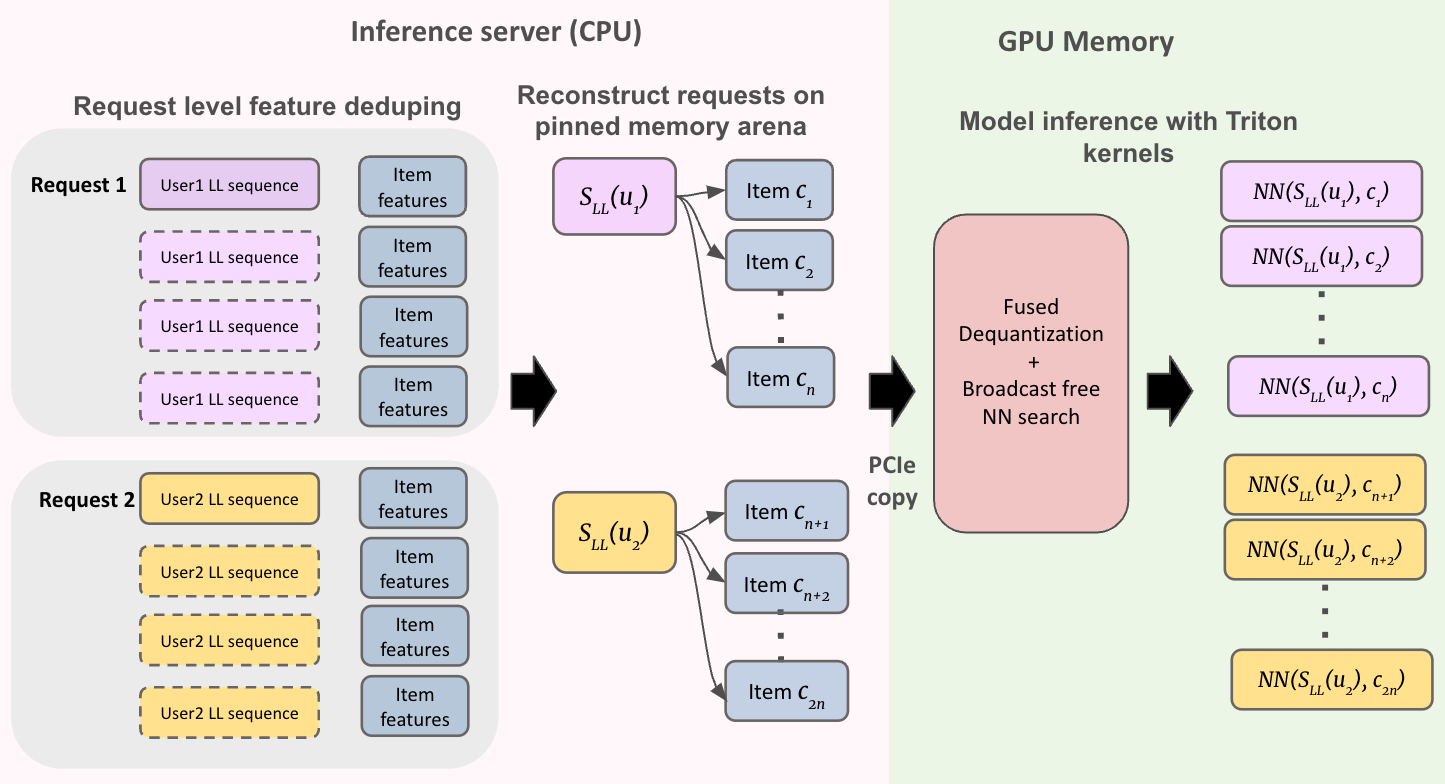
Рисунок 5: дедупликация истории на уровне запроса и общий формат данных для поиска на GPU. Кандидаты ссылаются на историю вместо хранения повторных копий.
Источник: Оригинальная иллюстрация · PinterestОдно быстрое ядро ещё не равно быстрому сервису
SKUT, Single Kernel Unified Transformer, объединяет операции небольшого трансформера в одно специализированное Triton-ядро. Вместо многократного создания промежуточных Q/K/V используются вычисления по плиткам и объединение последующих преобразований. Размер модели d_model=64 делает такую специализацию осуществимой.
На производственной форме входа с пакетом 256 и длиной 192 таблица 5 показывает снижение задержки forward на 85,09% и использования памяти на 13,24% относительно выбранной PyTorch-реализации. Это приблизительно соответствует заявленному ускорению отдельного прохода в 6,6 раза. Оно не является сокращением полной пользовательской задержки в 6,6 раза.
В основном опыте FlashAttention-2 напрямую не сравнивается из-за необходимых нестандартных масок. Поэтому корректно называть исходный PyTorch-вариант и условия, а не утверждать, что SKUT обгоняет любую оптимизированную реализацию внимания при любом размере модели.
Для обслуживания также используют заранее выделенную pinned-memory arena. Данные пакета строятся сразу в закреплённой памяти, и отдельная копия из обычной CPU-памяти исчезает. Но сама arena без дедупликации почти не помогала в некоторых опытах: узкое место переходило в пропускную способность PCIe. Эффект зависит от сочетания изменений.
§3.4.2, §4.4.3 и таблица 5Офлайн и онлайн здесь имеют разные исходные варианты
Обучение использует две недели данных Homefeed: 6,9 млрд примеров, 182 млн пользователей и 350 млн пинов. Проверочные данные собраны через семь дней после последнего дня обучения. Используются внутренние данные Pinterest, потому что нужны несколько историй с типами действий, поверхностями и векторами содержания; статья не представляет этот опыт как готовый публичный benchmark.
Таблицу можно прокрутить по горизонтали.
Отдельно сравниваются способы выбора негативов NAL. Негативы из показов улучшают и положительные, и отрицательные цели сильнее in-batch-выборки. Но таблица отключения NAL, общая офлайн-таблица и продуктовый A/B-тест — разные сравнения, поэтому их числа нельзя складывать или вычитать для получения обещанного эффекта.
§4.1–4.2, таблица 2Почему ускорение хвоста в сотни раз требует осторожного чтения
Авторы подбирают длину последовательности и ширину сети по качеству и времени выполнения. Более длинный вход продолжает улучшать офлайн-метрику, но увеличивает задержку. Итоговая форма входа выбрана как практический компромисс, а не предел выразительности.
Серверные оптимизации измеряются под высокой нагрузкой: 29 тысяч примеров в секунду на хост, динамическое формирование пакетов, параллельные потоки и очередь. Здесь фиксированная нагрузка и медленный исходный вариант создают большие задержки ожидания. После ускорения обработки очередь уменьшается гораздо сильнее, чем время собственно forward.
В рисунке 9 P99 полного инференс-RPC улучшается примерно в 250 раз, тогда как forward на P99 — примерно в 2,2 раза. Это результат выбранного стенда с очередью, а не утверждение, что математическое преобразование модели стало в 250 раз быстрее. Для другой загрузки сервера и другого исходного варианта такой множитель не следует ожидать.
В самой статье описание памяти A10G использует неоднозначные названия shared memory, SRAM и кеша. Поэтому переносимые выводы здесь ограничены объединением операций и измерениями на указанной форме входа; цифру «6 МБ shared memory» не следует использовать как спецификацию памяти одного блока GPU.
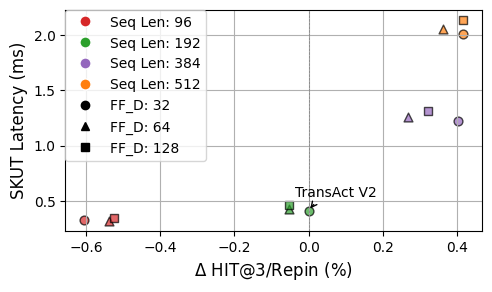
Рисунок 6: увеличение длины и ширины улучшает качество, но повышает задержку. Настройка выбранного маленького трансформера определяет пригодность специализированного ядра.
Источник: Оригинальная иллюстрация · PinterestОнлайн-выигрыш измерен поверх исходного TransAct
Таблицу можно прокрутить по горизонтали.
NAL отдельно особенно помогает скрытиям, но его маленькие изменения сохранений, разнообразия и времени статистически незначимы. Полный вариант объединяет долгосрочную историю с дополнительным обучением и показывает более широкий выигрыш. Из этого нельзя заключить, что один только новый loss даёт +6,35% сохранений.
Сравните V2 с MUSE, который тоже ищет релевантные события внутри истории, и с Feed SR, который переиспользует общий контекст между кандидатами. V2 сочетает отбор короткой истории, согласованную запись признаков и оптимизацию переноса данных. Главный инженерный вопрос — не сколько событий накоплено вообще, а какие из них модель реально видит и сколько раз система их читает.
§4.3 и таблица 3