Разбор готов
Netflix: общая модель для персональных рекомендаций
Netflix использует персонализацию в разных частях продукта — например, в «Continue Watching» и «Today’s Top Picks for You». Исторически для таких задач существовало много специализированных моделей, которые обучались независимо, хотя опирались на общие источники данных. По мере роста числа алгоритмов поддержка становилась дороже, а удачные улучшения было трудно переносить между моделями. Дополнительное ограничение — многие модели видят только короткий отрезок недавней истории пользователя из-за стоимости обучения и жёстких требований к задержке ответа. В статье Netflix разбирает переход к foundation model для рекомендаций: общей большой модели, которая учится на масштабной истории взаимодействий и контенте, а затем передаёт знания другим задачам через общие веса, дообучение или эмбеддинги.
Материал полезен инженерам рекомендательных систем и ML-инженерам, которые работают с последовательностями пользовательских действий, длинной историей, холодным стартом и общими представлениями для нескольких продуктовых задач. Здесь особенно важны не отдельные трюки, а полный путь: от токенизации взаимодействий и цели обучения до обновления новых объектов, стабилизации эмбеддингов и масштабирования модели.
Рекомендуем. Показывает, зачем объединять обучение моделей, которые решают разные задачи в одном продукте.
Статья · на английском
Foundation Model for Personalized RecommendationKo-Jen Hsiao, Yesu Feng, Sudarshan Lamkhede · Опубликовано: 21 марта 2025 г.
Почему набор специализированных моделей перестал устраивать
Исходная система персонализации Netflix состоит из разных обучаемых моделей под разные задачи. Проблема не в том, что каждая из них обязательно плоха, а в общей стоимости такого устройства: модели независимо обучаются на похожих данных, их приходится отдельно поддерживать, а новый приём или улучшение из одной задачи трудно переносить в другую. Поэтому команда хочет централизовать изучение предпочтений пользователя и сделать полученные знания доступными нескольким моделям.
Вторая причина — длина истории. Многие рекомендательные модели в основном извлекают признаки из недавних действий пользователя и ограничивают временное окно из-за стоимости обучения или задержки работающего сервиса. Foundation model должна собирать информацию из гораздо более полной истории взаимодействий и из самого контента в большом масштабе. Затем эти знания можно передавать другим задачам двумя основными способами: использовать общие веса как отправную точку для дообучения или напрямую передавать построенные моделью векторные представления — эмбеддинги.
Архитектурная идея вдохновлена переходом NLP от множества небольших моделей к крупным языковым моделям. Netflix выделяет два принципа. Первый — подход, ориентированный на данные: меньше ручной инженерии признаков, больше масштабных качественных данных и, где возможно, обучение всей цепочки целиком. Второй — использование задачи предсказания следующего токена на больших объёмах неразмеченных данных. Авторы называют это semi-supervised learning и переносят ту же общую идею на последовательности пользовательских действий.
Motivation, абзацы после заголовка до раздела DataСырые действия нужно сначала превратить в осмысленную последовательность
На конец 2024 года Netflix указывает более 300 млн пользователей и сотни миллиардов взаимодействий — от просмотра каталога до полноценного просмотра фильма. Масштаб сопоставляется в статье с количеством токенов, на которых обучают большие языковые модели, но авторы отдельно подчёркивают: одного объёма мало. Важно решить, какие события действительно несут сигнал о предпочтениях и какие повторы можно сжать.
Для этого вводится токенизация взаимодействий. Здесь токен — не кусок текста, а осмысленная единица истории пользователя. Близкие действия можно объединять в более высокий уровень, например собрать несколько действий вокруг одного и того же тайтла в один элемент последовательности. Авторы сравнивают этот процесс с BPE в обработке текста, где соседние единицы постепенно объединяются в более крупные токены. Но в рекомендациях при таком объединении нужно отдельно решить, какие сведения сохранить: например, суммировать длительность просмотра или агрегировать типы вовлечения.
Получается компромисс между длиной последовательности и количеством информации внутри одного токена. Слишком сильное сжатие теряет полезные сигналы. Слишком подробная история становится дорогой по времени и памяти. Netflix сравнивает этот выбор с компромиссом между размером словаря и длиной контекста в языковых моделях.
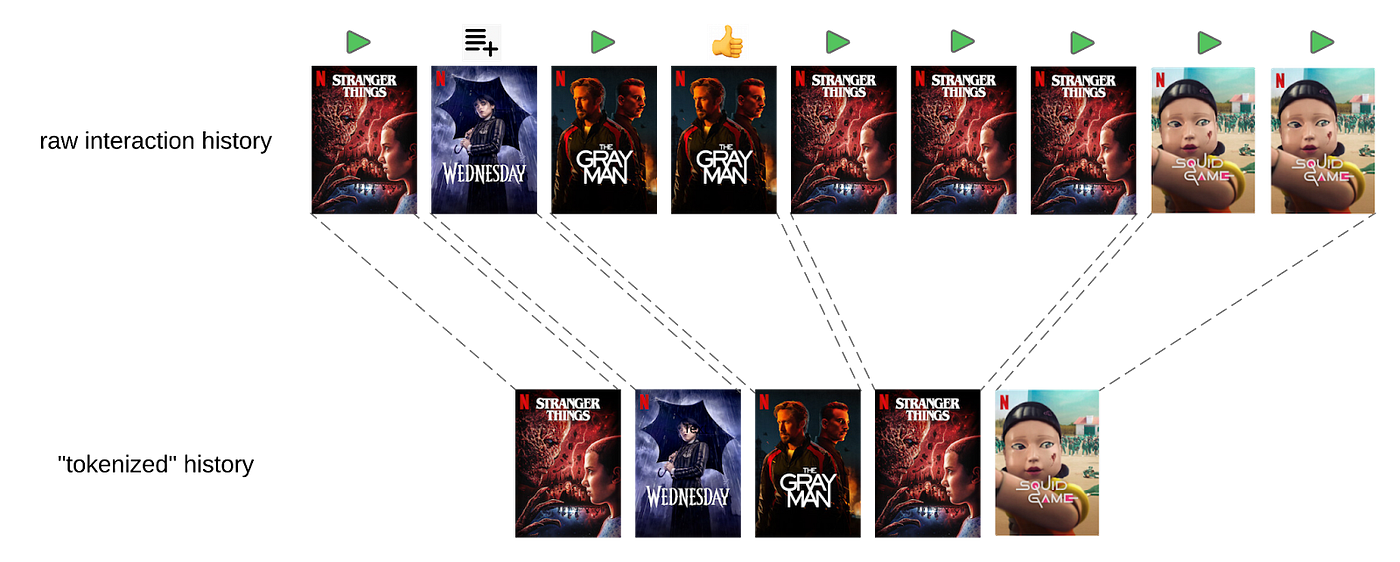
Несколько соседних действий с одним фильмом объединяются в событие. В последовательности остаются важные сведения о просмотре, а повторы занимают меньше места.
Источник: Netflix Technology BlogКак работать с тысячами событий при миллисекундной задержке
Даже после сжатия активный пользователь может иметь историю в тысячи событий. Обычный self-attention, то есть механизм, в котором позиции последовательности сопоставляются друг с другом, становится слишком дорогим на таком контексте. В работающей рекомендательной системе ограничение особенно жёсткое: окно на применении модели часто составляет лишь сотни событий, потому что ответ нужен за миллисекунды. Авторы противопоставляют это LLM-приложениям, где задержка в секунды нередко допустима.
Во время обучения Netflix использует два приёма. Первый — разреженное внимание: модель не обязана вычислять полное взаимодействие каждой позиции с каждой; в качестве примера упомянуто low-rank compression. Это позволяет расширить контекст до нескольких сотен событий при приемлемой вычислительной стоимости. Второй — sliding window sampling: из полной истории выбираются перекрывающиеся окна. На разных эпохах модель видит разные участки одной истории и постепенно обучается на всей последовательности, не помещая её целиком в одно контекстное окно.
На применении модели, если требуется многошаговое декодирование, можно использовать KV-cache — кеш уже посчитанных ключей и значений механизма внимания. Он позволяет повторно использовать вычисления по прошлому контексту вместо их полного пересчёта на каждом шаге. В совокупности токенизация, эффективное внимание, окна обучения и кеш должны удержать баланс между длинной историей и стоимостью обработки.
Data, абзацы от «Even with such strategies...» до «These approaches collectively...»Что именно хранится внутри токена взаимодействия
Токен рекомендации богаче обычного идентификатора. В него входят признаки самого действия — локаль, время, длительность, тип устройства — и признаки контента, включая ID объекта и метаданные вроде жанра или страны выпуска. Большинство категориальных признаков модель кодирует обучаемыми эмбеддингами. Время требует отдельной обработки: важно учитывать и абсолютный момент, и относительное расстояние между событиями; авторы отдельно отмечают значение абсолютного времени для поведения, зависящего от календарного контекста.
Таблицу можно прокрутить по горизонтали.
Для прогноза следующего действия модель соединяет признаки текущего запроса с признаками результата предыдущего действия. Такое выравнивание важно, потому что часть информации появляется только после взаимодействия и не должна притворяться известной заранее. В результате каждый шаг последовательности одновременно содержит текущий контекст и сведения о том, что пользователь сделал до него.
Information in Each ‘Token’; Request-Time Features; Post-Action FeaturesПочему простого next-token prediction недостаточно
Базовая цель обучения — авторегрессионное предсказание следующего токена, как в GPT: по предыдущей истории модель пытается предсказать следующее взаимодействие. Это позволяет использовать огромный объём данных без ручной разметки отдельной целевой метки для каждого примера. Но рекомендация отличается от текста, поэтому Netflix меняет учебную постановку.
Первая проблема — не все действия одинаково важны. Пятиминутный просмотр трейлера и двухчасовой просмотр фильма не должны трактоваться как равнозначные сигналы. Ещё сложнее связать отдельное действие с долгосрочной удовлетворённостью пользователя. Один из описанных способов — multi-token prediction: на каждом шаге предсказывать не один следующий токен, а следующие n токенов. Так модель вынуждена учитывать более длинные зависимости и меньше фокусироваться только на ближайшем событии.
Вторая модификация — дополнительные цели. Главной целью остаётся следующий item ID, но параллельно можно предсказывать другие поля, например жанр или исходный язык. Такая многозадачная постановка служит регуляризатором против переобучения на шумных ID объектов и даёт отдельный сигнал о намерениях или долгосрочных жанровых предпочтениях. Если цели организовать иерархически, сначала прогноз жанра или языка может сузить набор возможных объектов, а уже затем упрощается предсказание конкретного ID.
Considerations for Model Objective and Architecture, оба абзаца с модификациями целиХолодный старт: как рекомендовать тайтл, которого ещё не было в истории
Для foundation model рекомендаций появляется особая проблема: каталог меняется. Новый тайтл нужно уметь оценивать ещё до того, как накопились взаимодействия. Netflix строит решение вокруг двух возможностей — инкрементального обучения и применения модели к сущностям, которых она не видела в обучающих данных.
При инкрементальном обновлении нельзя просто сохранить неизменный словарь токенов, как это часто возможно у языковой модели. Для новых тайтлов нужны новые строки в таблицах эмбеддингов и новые части выходных компонентов. Поэтому следующую версию модели начинают с параметров предыдущей, а параметры новых тайтлов инициализируют отдельно. В статье приведены два варианта: добавить небольшой случайный шум к среднему существующих эмбеддингов или собрать взвешенную комбинацию эмбеддингов похожих тайтлов по метаданным. По наблюдению авторов, конкретный способ инициализации становится менее важным, когда для дообучения появляется больше реальных взаимодействий.
Одного инкрементального обучения недостаточно: часть новых сущностей всё равно может не попасть в данные. Поэтому итоговое представление тайтла сочетает полностью обучаемый ID-эмбеддинг и эмбеддинг из метаданных. Метаданные могут описывать жанры, сюжет и тон: для каждого типа соответствующие эмбеддинги можно усреднить, а затем объединить эти части в общий metadata-based embedding. Затем mixing layer смешивает контентную и ID-часть не простой суммой, а механизмом внимания, зависящим от «возраста» сущности. Новый объект с малым числом взаимодействий сильнее опирается на метаданные, а зрелый — на ID.
Есть ещё одна тонкость: два тайтла с похожими метаданными могут вести себя по-разному у пользователей, поэтому контент не должен полностью заменить ID. Во время обучения Netflix добавляет случайность, чтобы модель не научилась игнорировать метаданные и полагаться только на ID. Цель — получить разумное представление даже для только что вышедшего или ещё не запущенного тайтла, когда пользовательских взаимодействий нет.
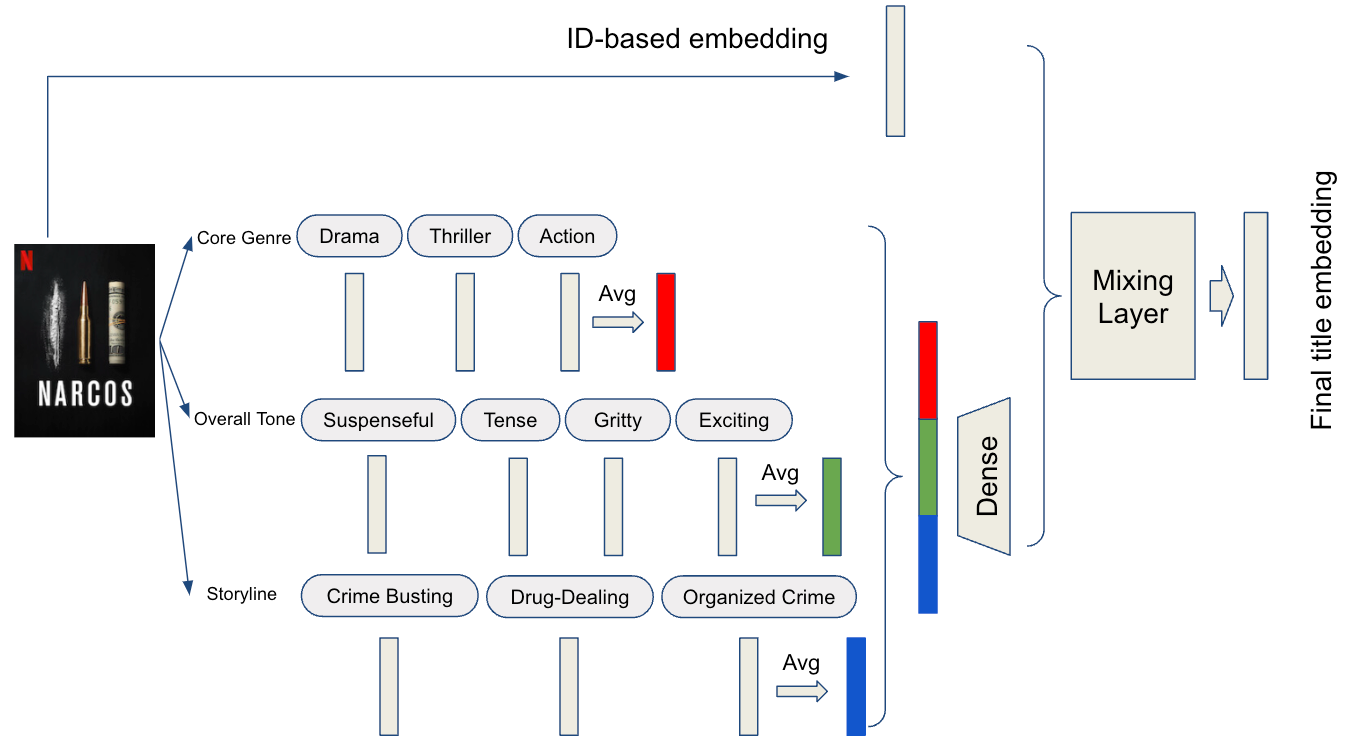
Представления жанра, настроения и сюжета объединяются с обучаемым вектором фильма. Новый фильм может опираться на метаданные ещё до первых просмотров.
Источник: Netflix Technology BlogКак одна foundation model используется в других рекомендательных задачах
Таблицу можно прокрутить по горизонтали.
Эмбеддинги пользователей и сущностей — видео, игр, жанров — рассчитываются пакетными задачами и сохраняются для офлайн- и онлайн-применений. Это делает foundation model источником общих признаков, а не обязательно единственной моделью, которая непосредственно формирует рекомендацию.
Но у такого переиспользования есть эксплуатационная проблема: координаты эмбеддингов сами по себе произвольны и не обязаны сохранять тот же смысл после нового обучения. Downstream-система может молча полагаться на старую геометрию и сломаться после переобучения. Netflix применяет ортогональное низкоранговое преобразование, чтобы стабилизировать пространство пользовательских и объектных эмбеддингов между версиями базовой модели.
При дообучении downstream-команда может взять всю foundation model или только нужный подграф и адаптировать его к своим данным. Авторы пишут, что такой подход достигает качества, сопоставимого с предыдущими моделями, при меньшем объёме данных и вычислений у потребителя, хотя первоначальное обучение самой foundation model требует значительных ресурсов.
Downstream Applications and Challenges, пункты Direct Use as a Predictive Model, Utilizing embeddings, Fine-Tuning with Specific DataЧто именно Netflix масштабирует и что удалось подтвердить
Следующий шаг — масштабирование. В статье оно не сводится только к числу параметров: Netflix говорит о росте данных, размера модели и длины контекста. В данные могут входить пользовательская вовлечённость, внешние отзывы, мультимедийные материалы и качественные эмбеддинги. Для такого масштаба одновременно нужны различающая модели оценка, эффективные алгоритмы обучения и серьёзные вычислительные ресурсы.
Авторы сообщают, что их эксперименты подтверждают scaling law для foundation model рекомендаций: при увеличении объёма данных и размера модели относительное качество последовательно улучшается. Figure 3 показывает рост relative performance improvement с увеличением числа параметров; ось размера модели логарифмическая. Конкретные размеры моделей, абсолютные значения качества, названия метрик и величина прироста в текстовом источнике не приведены, поэтому из статьи нельзя восстановить численный эффект масштабирования.
В заключении Netflix также упоминает presentation bias среди специфических проблем рекомендаций. Однако основной текст подробно разбирает холодный старт, но не описывает отдельный механизм, эксперимент или метрику для presentation bias. Поэтому нельзя приписывать foundation model конкретное решение этой проблемы на основании данного источника.
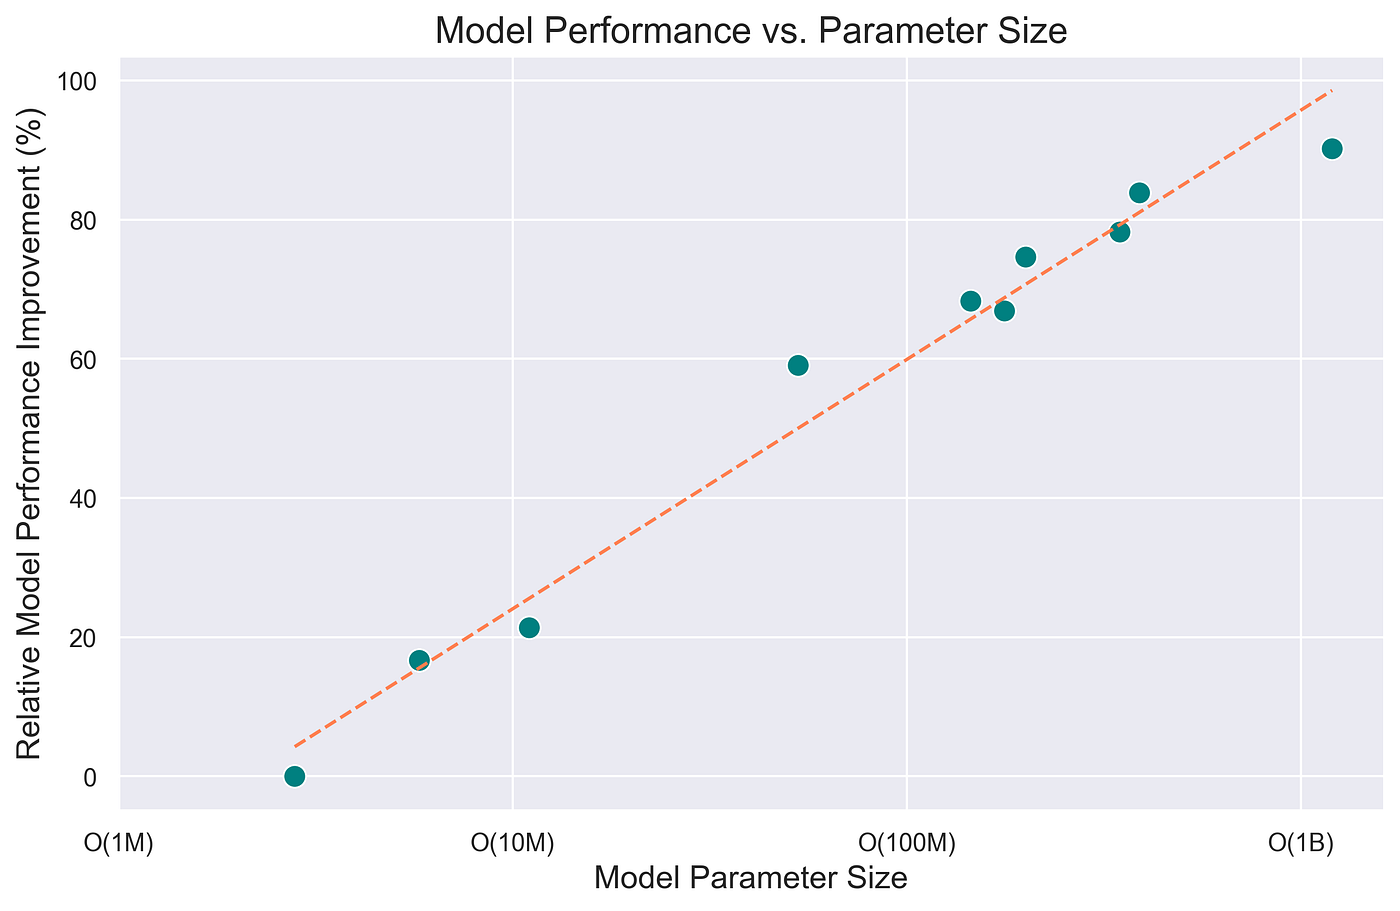
Авторы показывают рост относительного качества с размером модели. Ось параметров логарифмическая; конкретная метрика качества и база сравнения в статье не названы.
Источник: Netflix Technology BlogИтог: общая модель предпочтений вместо изолированных представлений
Путь Netflix начинается не с попытки просто увеличить существующий ранжировщик, а с пересборки общего слоя обучения предпочтений. Команда сжимает сырые действия в содержательные токены, расширяет доступную историю через эффективное внимание и оконную выборку, добавляет к ID контекст и метаданные, а обычное предсказание следующего объекта дополняет multi-token и вспомогательными целями. Затем решается проблема постоянно меняющегося каталога: новые тайтлы получают параметры при инкрементальном обучении и могут опираться на метаданные ещё до накопления взаимодействий.
- 01
Собрать текущий контекст
Во вход попадают признаки текущего запроса — например, время, устройство или местоположение — вместе с историей уже случившихся действий.
- 02
Сформировать последовательность
Повторяющиеся действия объединяются в токены, которые сохраняют важные сведения о взаимодействии и контенте.
- 03
Обработать историю
Foundation model строит представление предпочтений по последовательности; при многошаговом декодировании прошлые вычисления можно переиспользовать через KV-cache.
- 04
Получить прогнозы и эмбеддинги
Предикторные головы могут оценивать следующий объект или другие свойства, а модель также выдаёт векторы пользователей и сущностей.
- 05
Передать результат дальше
Продуктовые модели используют прогнозы и векторы для отбора кандидатов или рекомендаций похожих фильмов. Пакетный расчёт и дообучение для конкретной задачи выполняются отдельно от этого пути.
Подтверждённый итог в статье качественный, а не численный: Netflix наблюдает последовательное улучшение относительного качества при росте данных и размера модели и пишет о многообещающих результатах подключения к продуктовым моделям. При этом в источнике не раскрыты конкретная метрика качества на графике, база сравнения, A/B-результаты и размер итоговой модели.
Ограничения остаются существенными. Истории могут насчитывать тысячи событий, тогда как рабочее окно из-за миллисекундной задержки обычно ограничивается сотнями. Каталог постоянно меняется, поэтому нужны инкрементальные обновления и работа с невиданными сущностями. Пространство эмбеддингов нестабильно между обучениями и требует отдельной стабилизации. Масштабирование требует сильной оценки, эффективного обучения и больших вычислений. Авторы также упоминают смещение из-за способа показа рекомендаций, но не разбирают его решение.
Итог по Motivation, Data, Unique Challenges, Downstream Applications, Scaling и Conclusion