Разбор готов
Авито: как автоматизировали модерацию видео при нехватке размеченных данных
Видео в объявлении помогает показать товар подробнее, но одновременно создаёт новые способы нарушить правила: запрещённый объект может появиться в кадре, контакт конкурента — в надписи или речи, чужое лицо — в ролике, а само видео может вообще не относиться к продаваемому товару. Сначала Авито проверял такие ролики вручную, не задерживая публикацию самого объявления: объявление выходило без видео, а ролик добавлялся после отдельной проверки. По мере роста продукта этот путь стал дорогим и медленным. В разборе проследим, как команда перешла к автоматической модерации при нехватке собственных данных и почему итоговая система состоит не из одной универсальной нейросети, а из набора специализированных моделей для изображения, текста, речи, звуков, метаданных и связи видео с объявлением.
Материал полезен ML- и CV-инженерам, которые строят модерацию мультимодального контента или работают с задачей, где одной размеченной выборки недостаточно. Особенно показателен путь от ручной проверки к набору переиспользуемых моделей и способ измерять пропущенные нарушения после автоматизации.
Рекомендуем. Подробный кейс о данных и ошибках модерации, а не только о выборе модели.
Статья · на русском
Как мы запустили автоматическую модерацию видео в объявлениях АвитоВладимир Морозов · Опубликовано: 11 октября 2024 г.
Что именно нужно модерировать в видео
Модерация в Авито проверяет публикации на соответствие правилам сервиса. Для видео возможны те же два общих режима, что и для другого контента. При премодерации материал проверяется до появления у пользователей; при постмодерации — уже после публикации. В исходном материале выбор между ними связывают прежде всего с риском нарушения и скоростью проверки: при высоком риске и быстрой проверке предпочтительнее не выпускать материал заранее, а при низком риске допустима проверка после публикации.
Второе решение — проверять контент людьми или автоматически. Ручной процесс проще запустить, потому что не нужно предварительно собирать датасет и обучать модели. Но он хуже масштабируется: требуется контролировать качество работы модераторов, а рост объёма контента требует дополнительных людей. Автоматическая модерация сложнее на старте, зато автор связывает её с более высокой скоростью, меньшей стоимостью и более предсказуемым результатом.
Для дальнейшей декомпозиции команда разделяет две сущности. Причина нарушения отвечает на вопрос, что именно пользователь сделал неправильно: например, призывает перейти на другой сайт. Домен нарушения показывает, где искать сигнал: в видеоряде, аудио, качестве файла или в несоответствии между роликом и объявлением. Один и тот же общий поток видео поэтому превращается в несколько технически разных задач.
Раздел «Зачем Авито следить за видео и какие вообще есть подходы к модерации» и начало раздела «Какой была наша первая система модерации видео»Первая версия: объявление публикуется раньше видео
Видео было новым для Авито типом контента, а полноценную автоматическую систему нельзя было построить сразу. Поэтому основной объект — объявление — и ролик сначала проверялись не синхронно. Если само объявление успешно проходило модерацию, его публиковали без видео. Ролик шёл в отдельный поток, а после успешной проверки появлялся в уже опубликованном объявлении. Такой порядок позволял не увеличивать время публикации объявления только из-за добавленного видео.
- 01
Проверка объявления
Сначала модерацию проходит само объявление. Если оно нарушает правила, публикация отклоняется.
- 02
Публикация без ролика
Успешно проверенное объявление появляется на площадке, но пока без приложенного видео.
- 03
Премодерация видео
Ролик поступает в отдельную предварительную проверку; на исходной схеме этот этап подписан как премодерация видео по статистикам.
- 04
Ручная проверка
После предварительного этапа видео смотрит модератор.
- 05
Добавление или отказ
Если ролик проходит проверку, он появляется в объявлении; иначе объявление остаётся без видео.
После запуска проявились ограничения полностью ручного подхода. Видео обходится дороже изображений, потому что объект сложнее и его дольше просматривать. Поток трудно масштабировать в обе стороны: при росте контента нужны новые сотрудники, при снижении нагрузки освобождается их время. Дополнительно остаётся человеческий фактор — качество ручной модерации тоже приходится контролировать, и, по словам автора, иногда возникают конфликты.
Наконец, ручная проверка в источнике характеризуется как в разы более медленная, чем автоматическая. Именно сочетание стоимости, скорости, управления потоком и человеческого фактора стало причиной не одномоментной замены людей, а постепенного перехода к автомодерации.
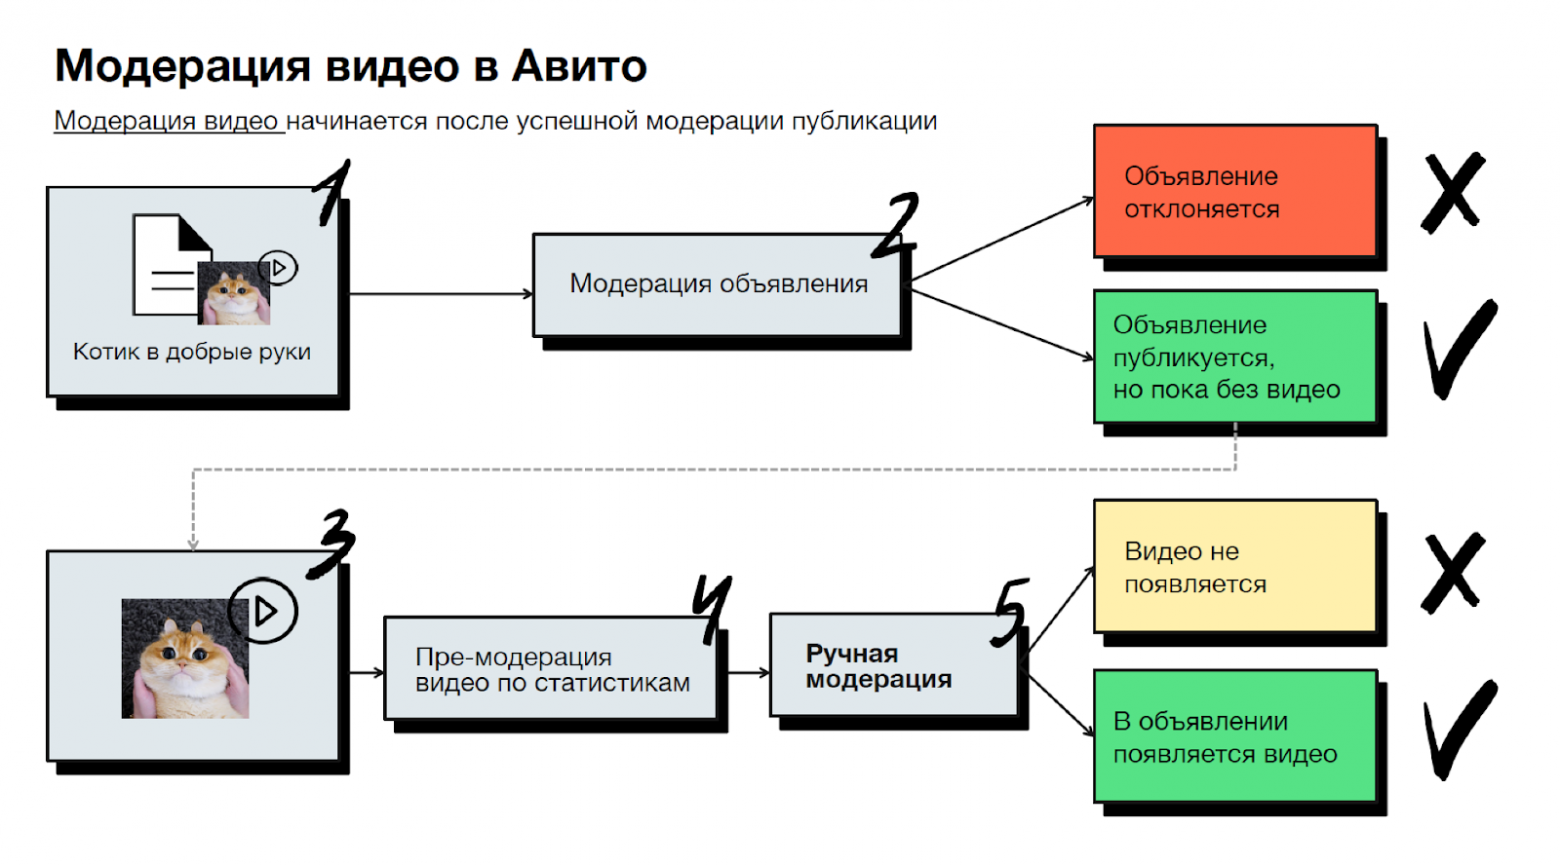
Первый поток модерации: после успешной проверки объявление публикуется без видео; ролик отдельно проходит премодерацию по статистикам и ручную модерацию, после чего либо появляется в объявлении, либо нет.
Источник: Владимир МорозовПочему исторических данных оказалось недостаточно
Перед началом проекта команда ожидала получить большой объём хорошо размеченных внутренних примеров и обучить на них модели. Это предположение не подтвердилось. Возможность прикладывать видео к объявлениям появилась незадолго до проекта, пользователей функции было ещё немного, а большинство роликов не содержало нарушений. Положительные примеры для редких причин поэтому приходилось специально искать.
Вторая проблема — назначение существующей разметки. Она создавалась прежде всего для контроля ручной модерации, а не как учебный датасет для набора ML-задач. В ней не было полноценного разделения на домены и подробной классификации причин нарушения. То есть наличие исторических решений модераторов ещё не означало наличие подходящих целевых меток для обучения конкретных моделей.
Третье ограничение связано с хранением данных. Видео с нарушениями после замены на исправленные версии удалялись спустя несколько дней, поэтому редкие полезные примеры не успевали накопиться в большом объёме. Команда дополняла внутренние данные открытыми датасетами, материалами с YouTube и видеостоков.
Внешние данные тоже не гарантировали однозначной разметки. Автор приводит набор для распознавания насилия, где люди разыгрывали сцены в комнате: один изображал удар палкой, но оба участника смеялись. Такой пример хорошо показывает проблему домена данных: формальная метка может существовать, однако визуальная сцена остаётся неоднозначной и не обязательно похожа на реальные нарушения продукта.
Раздел «Как мы собрали данные для автоматической модерации»Базовая ветка видеоряда: от кадров к нескольким причинам нарушений
Основная визуальная ветка начинается не с нейросети, а с отбора кадров. Можно брать случайные кадры, каждый N-й кадр, ключевые кадры или сначала кластеризовать содержимое. Источник отдельно предупреждает, что стратегия отбора становится частью защиты системы: предсказуемый способ выборки можно попытаться обойти, спрятав нарушение между анализируемыми кадрами.
- 01
Отбор кадров
Из ролика выбирается набор фреймов, который должен достаточно полно представлять содержание видео.
- 02
Кодирование кадров
Модель-кодировщик, или энкодер, превращает каждый кадр в числовое векторное представление — эмбеддинг.
- 03
Объединение во времени
Модуль Joint Net собирает набор эмбеддингов кадров в одно представление всего ролика.
- 04
Отдельные головы
Небольшие классификационные модули используют общий эмбеддинг и каждый оценивает собственную причину нарушения.
Для кодирования кадров автор перечисляет CNN, CLIP и BLIP. Внутренние бенчмарки команды показали лучшее качество у BLIP, однако стартовали с CLIP. Численных результатов этого сравнения и условий теста в статье нет, поэтому разницу между моделями нельзя превратить в количественное преимущество.
Joint Net нужен, чтобы превратить последовательность признаков кадров в один признак ролика. В тексте в качестве простого базового решения предлагаются усреднение или максимум; для коротких роликов такой вариант, по словам автора, уже даёт хорошие метрики. На приложенной архитектурной схеме среди вариантов агрегации также показаны Avg/Sum, Attention, CNN и RNN. После общего представления добавляются отдельные головы для разных причин, поэтому тяжёлое кодирование видео выполняется один раз, а новые классификаторы можно подключать поверх него.
На первом этапе в эту визуальную модель сознательно не добавляли аудио или другие дополнительные признаки. Причина в источнике практическая: такая мультимодальность сразу усложнила бы разработку. Другие сигналы команда подключала отдельными ветками, которые можно развивать независимо.
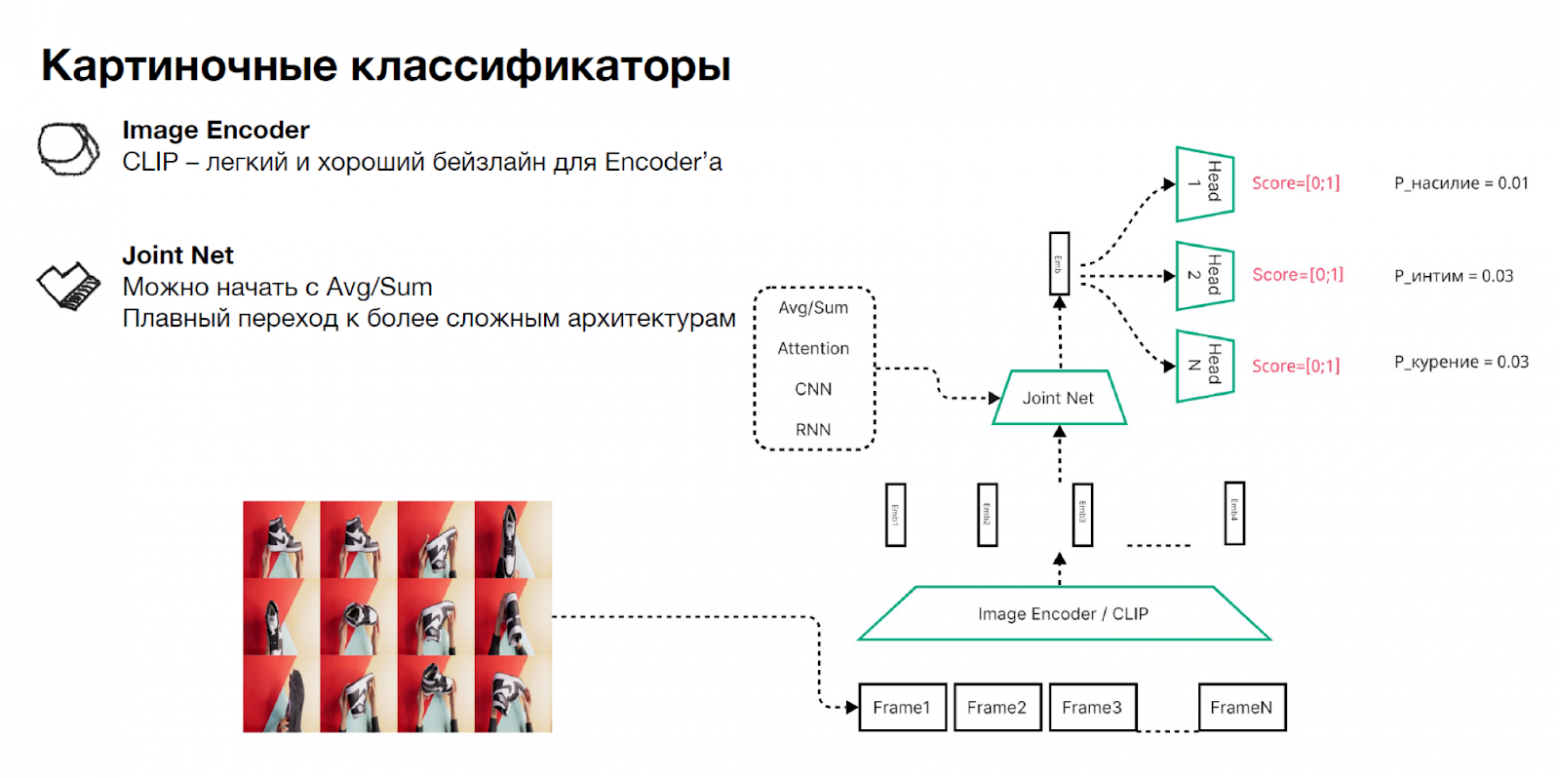
Схема видеоклассификатора: кадры кодируются CLIP, их эмбеддинги объединяются Joint Net, а отдельные головы выдают оценки разных причин. Внутри Joint Net на слайде перечислены Avg/Sum, Attention, CNN и RNN. Значения 0,01 и 0,03 возле примерных причин — иллюстрация выходов, а не опубликованные метрики качества.
Источник: Владимир МорозовЧто делать, когда для отдельной причины почти нет данных
Для второстепенной причины нарушения иногда нет времени сначала собирать и размечать отдельный датасет. В качестве примера источник приводит поиск кальяна. Здесь команда предлагает zero-shot-подход: использовать уже обученную связь между текстом и изображением в CLIP без отдельного обучения классификатора на примерах этой причины.
Текстовое описание искомого объекта превращается CLIP в вектор, то же происходит с каждым выбранным кадром. Затем измеряется косинусная близость — насколько направления двух векторов похожи. Для причины берётся максимальная близость среди всех кадров. На схеме аналогично заданы текстовые запросы для оружия, кальяна и казино; для кальяна итоговая оценка записана как максимум cosine similarity по фреймам.
Ещё один способ переиспользования — запускать уже существующий классификатор изображений отдельно на кадрах видео. Если для конкретного нарушения порядок кадров несущественен, строить специальную временную модель может не понадобиться. На отдельной схеме каждый Frame1…FrameN проходит Image Classifier, после чего выбирается максимальная оценка; там же указано ограничение N ≤ 180. Источник не уточняет, относится ли это число ко всем рабочим видеомоделям или только к показанной конфигурации.
Связь между кадрами всё же нужна для задач, где важна динамика: автор отдельно называет распознавание действий, или action recognition, и сложные способы обхода модерации. Поэтому использование обычного картиночного классификатора здесь не заявляется как универсальная замена видеоархитектуре — это упрощение для причин, где отдельного кадра достаточно.
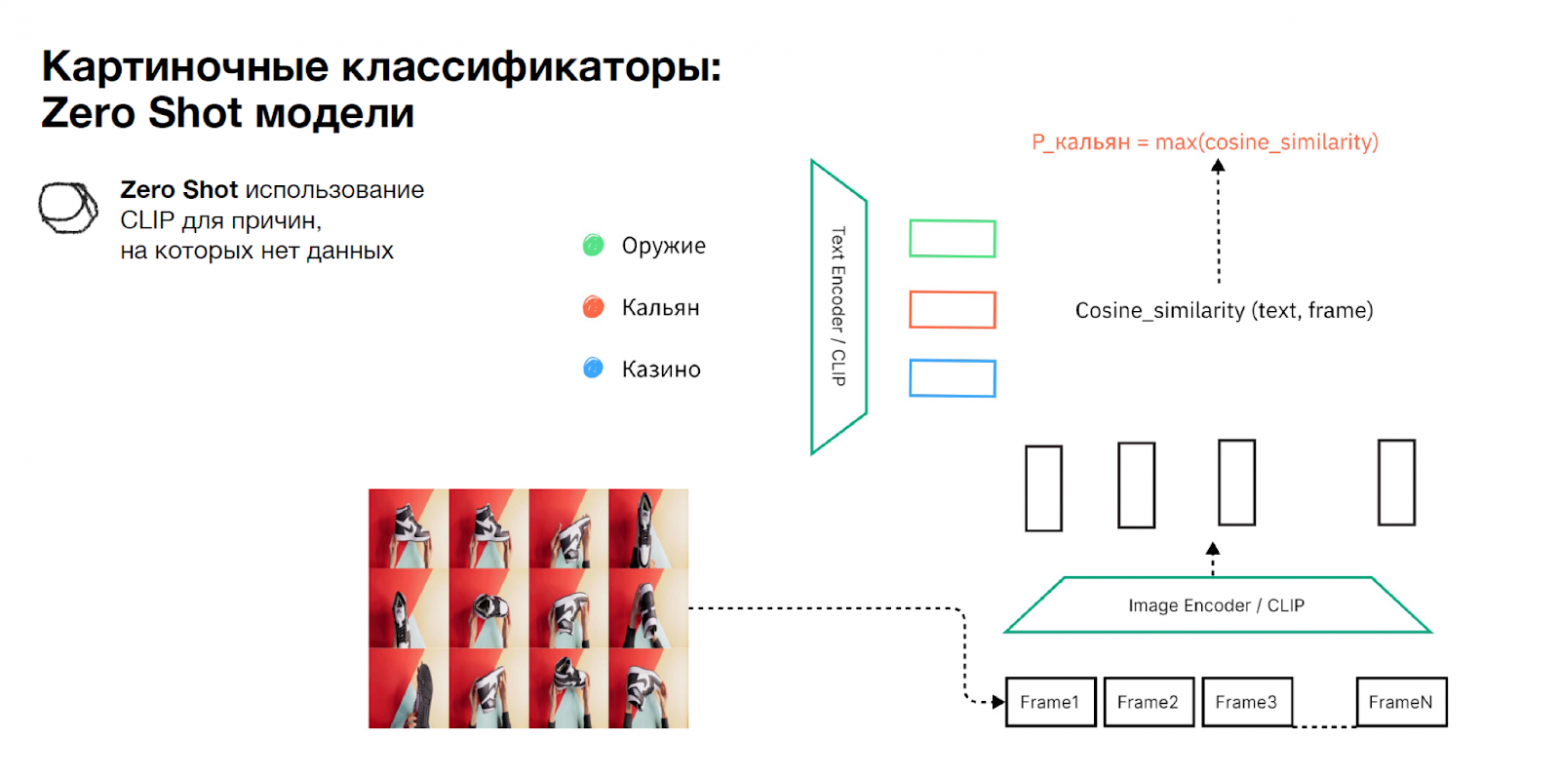
Zero-shot CLIP: текстовые запросы для искомых причин и кадры переводятся в одно векторное пространство; итоговая оценка причины берётся как максимальная cosine similarity по кадрам.
Источник: Владимир Морозов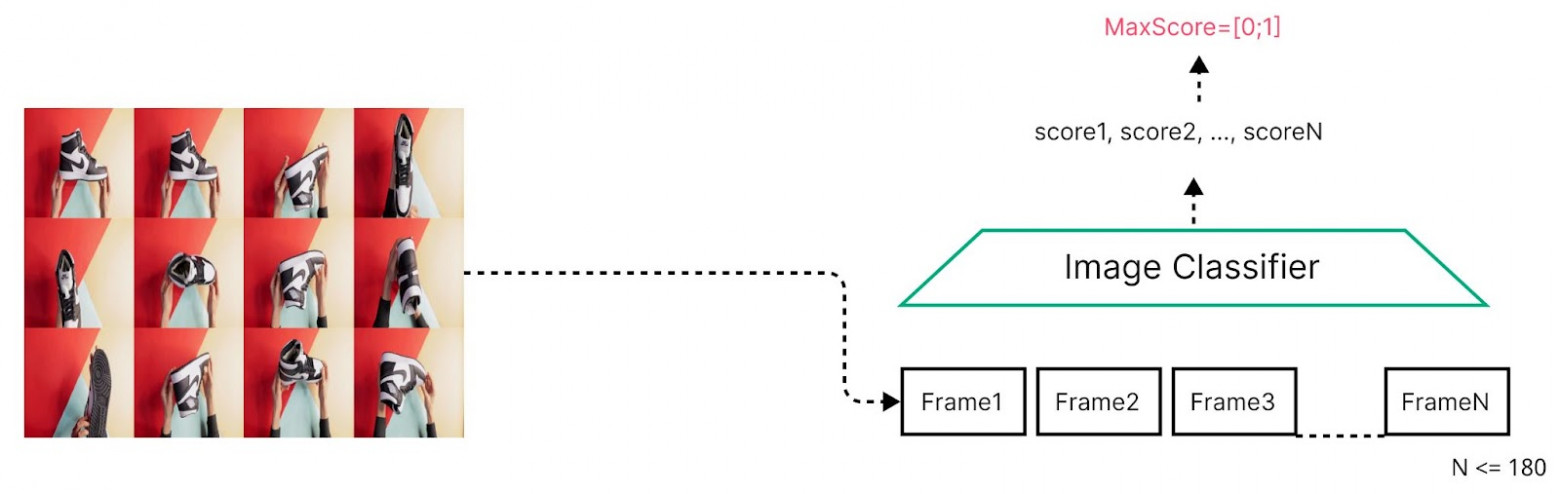
Переиспользование классификатора изображений: каждый кадр получает собственную оценку, а итогом служит MaxScore. На схеме явно указано N ≤ 180.
Источник: Владимир МорозовСпециализированные детекторы: логотипы и лица
Не все визуальные нарушения удобно сводить к классификации всего кадра. Например, логотип может занимать небольшую часть изображения, но указывать на попытку увести пользователя к другой компании. В таком случае сначала нужно локализовать объект, а уже потом понять, с каким известным логотипом он совпадает.
В тексте этот путь описан как детектор плюс векторный поиск по базе логотипов. На исходной схеме кадры сначала проходят Logo Detector / YOLOv8. Обнаруженная область кодируется Encoder / ResNet, после чего Matcher сравнивает полученный вектор с представлениями логотипов из базы и формирует оценки совпадения для разных логотипов. Такое разделение позволяет искать множество брендов через общую схему обнаружения и сравнения.
Для лиц задача похожа по форме, но архитектура на схеме более многоступенчатая. Сначала лёгкий MobileNetV3 large отбирает подходящие кадры. Затем Face Detector / RetinaNet with MobileNetV1 находит лица, Align / InsightFace подготавливает найденные области, а Encoder / Face Net превращает их в эмбеддинги. Matcher сравнивает их с векторами лиц из имеющейся базы. Источник связывает такую проверку, в частности, с авторскими правами и мошенничеством.
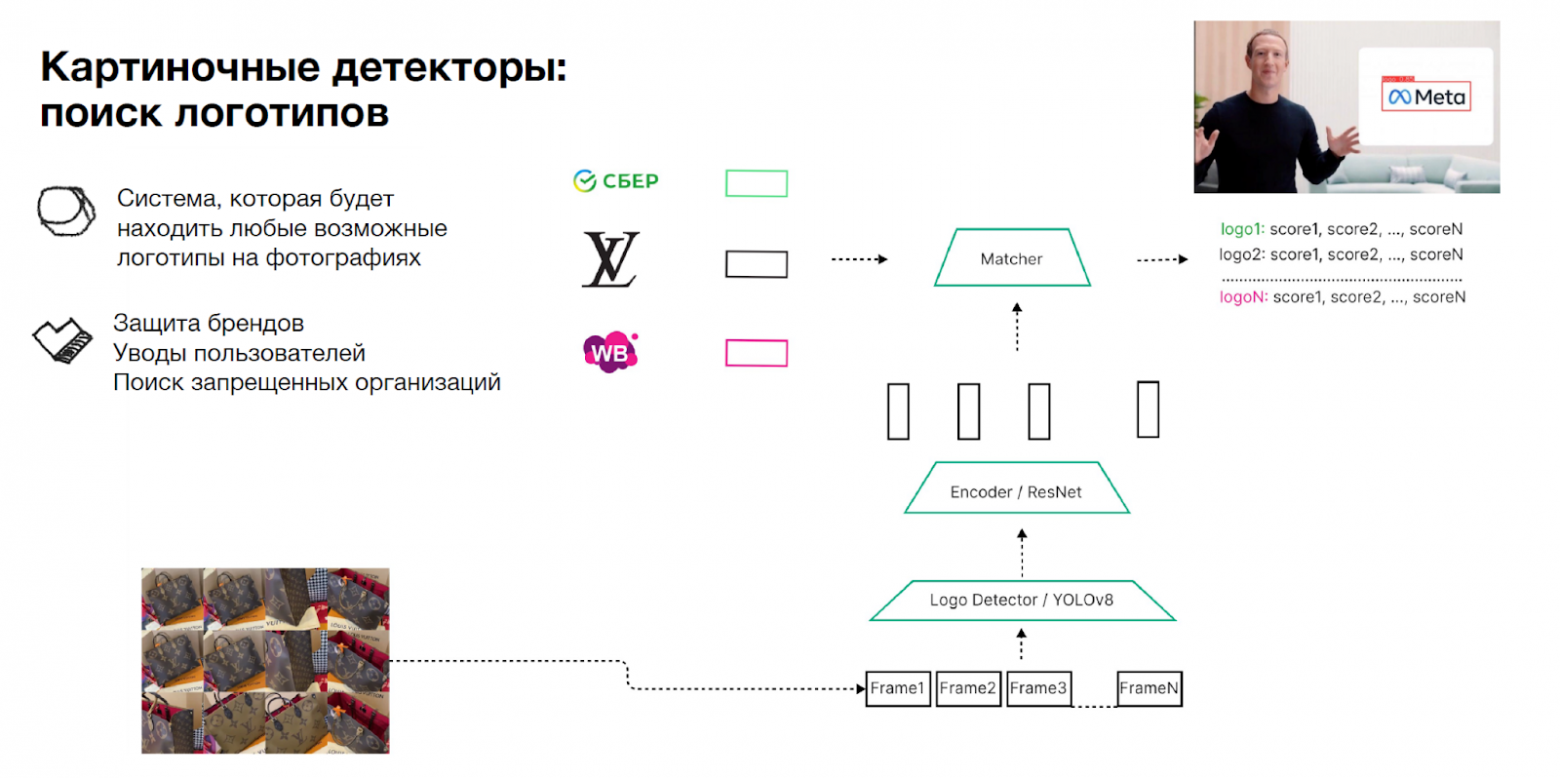
Поиск логотипов: YOLOv8 локализует объект, ResNet строит представление найденной области, Matcher сравнивает его с представлениями логотипов из базы.
Источник: Владимир Морозов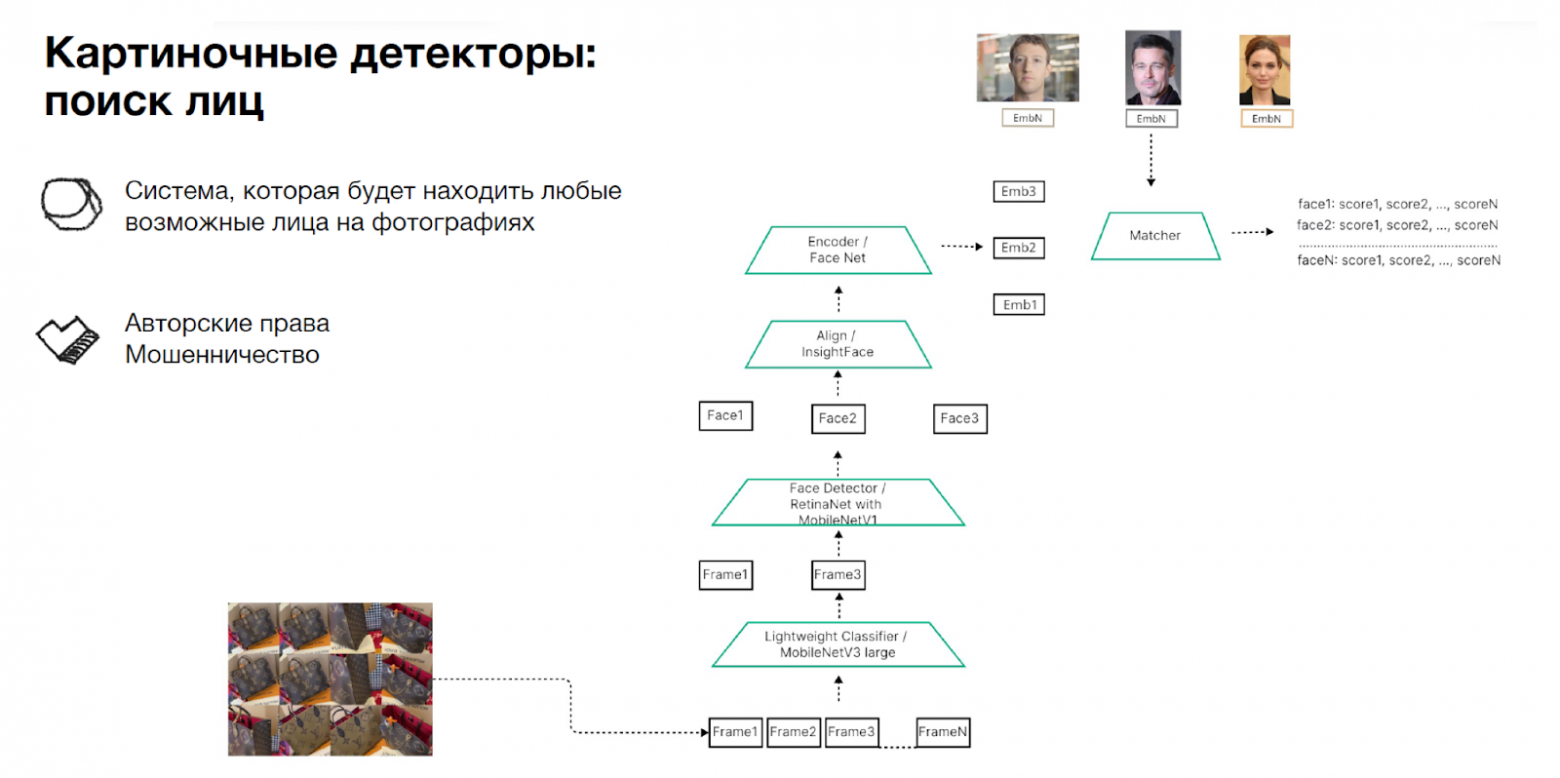
Поиск лиц на схеме разбит на предварительный отбор кадров, детекцию лица, выравнивание, построение эмбеддинга Face Net и сравнение Matcher с базой эталонных представлений.
Источник: Владимир МорозовТекст, речь и звуки требуют отдельных веток
Часть нарушений находится не в визуальном объекте, а в написанном тексте: например, в контактах, оскорблениях или упоминаниях сайтов конкурентов. Для этого используется распознавание текста на изображении — OCR. Система сначала извлекает строки из кадров, а затем проверяет уже обычный текст. При отсутствии обучающей выборки автор предлагает начинать с регулярных выражений и других правил, если заранее известно, какие шаблоны нужно находить.
На схеме OCR сначала работает Text Detector / CRAFT, который находит области с текстом. Затем Text Recognizer / ResNet + biLSTM + Attention распознаёт содержимое. Полученная строка поступает в набор Text Classifier / Regex, каждый из которых отвечает за отдельный тип нарушения. Поэтому тяжёлое распознавание текста не нужно повторять отдельно для каждого правила.
С речью применяется почти та же логика. Аудиодорожка сначала превращается в текст системой автоматического распознавания речи. Базовой моделью команда выбрала многоязычный Whisper и дообучила его на данных Авито. Транскрипт затем проходит через текстовые классификаторы и регулярные выражения, как результат OCR. Среди примеров причин источник называет провокации, сайты конкурентов, контактную информацию и оскорбления.
Однако не все значимые звуки являются речью. Для неречевых сигналов, например громкого постороннего шума, используется Audio Spectrogram Transformer. Это отдельный аудиоклассификатор, который получает звуковой сигнал и выдаёт оценки по нескольким классам. Таким образом, Whisper и Audio Spectrogram Transformer решают разные подзадачи: первый извлекает слова, второй ищет признаки непосредственно в звуке.
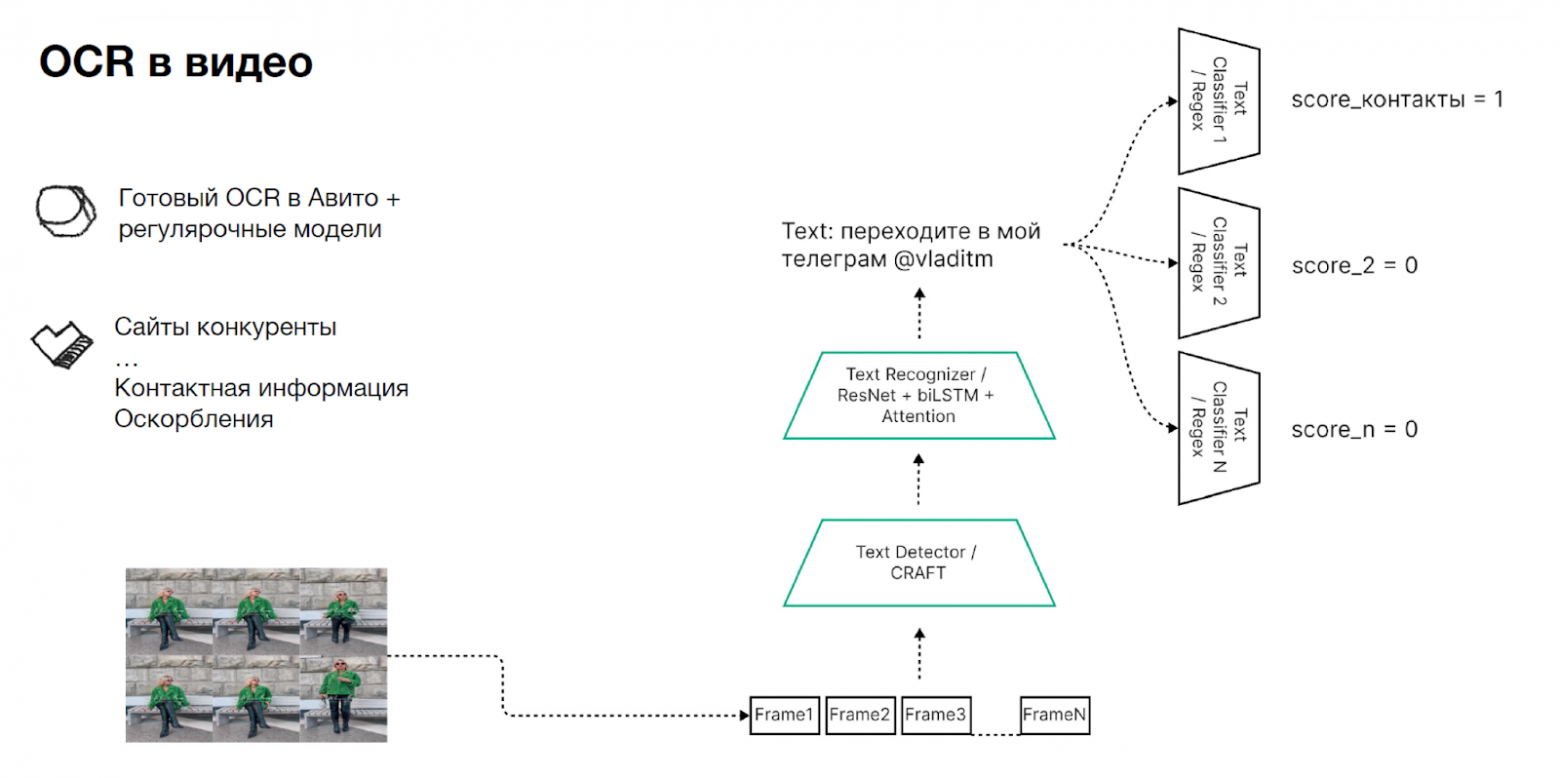
OCR-ветка: CRAFT находит текст, ResNet + biLSTM + Attention распознаёт его, затем строка поступает в отдельные текстовые классификаторы или регулярные выражения.
Источник: Владимир Морозов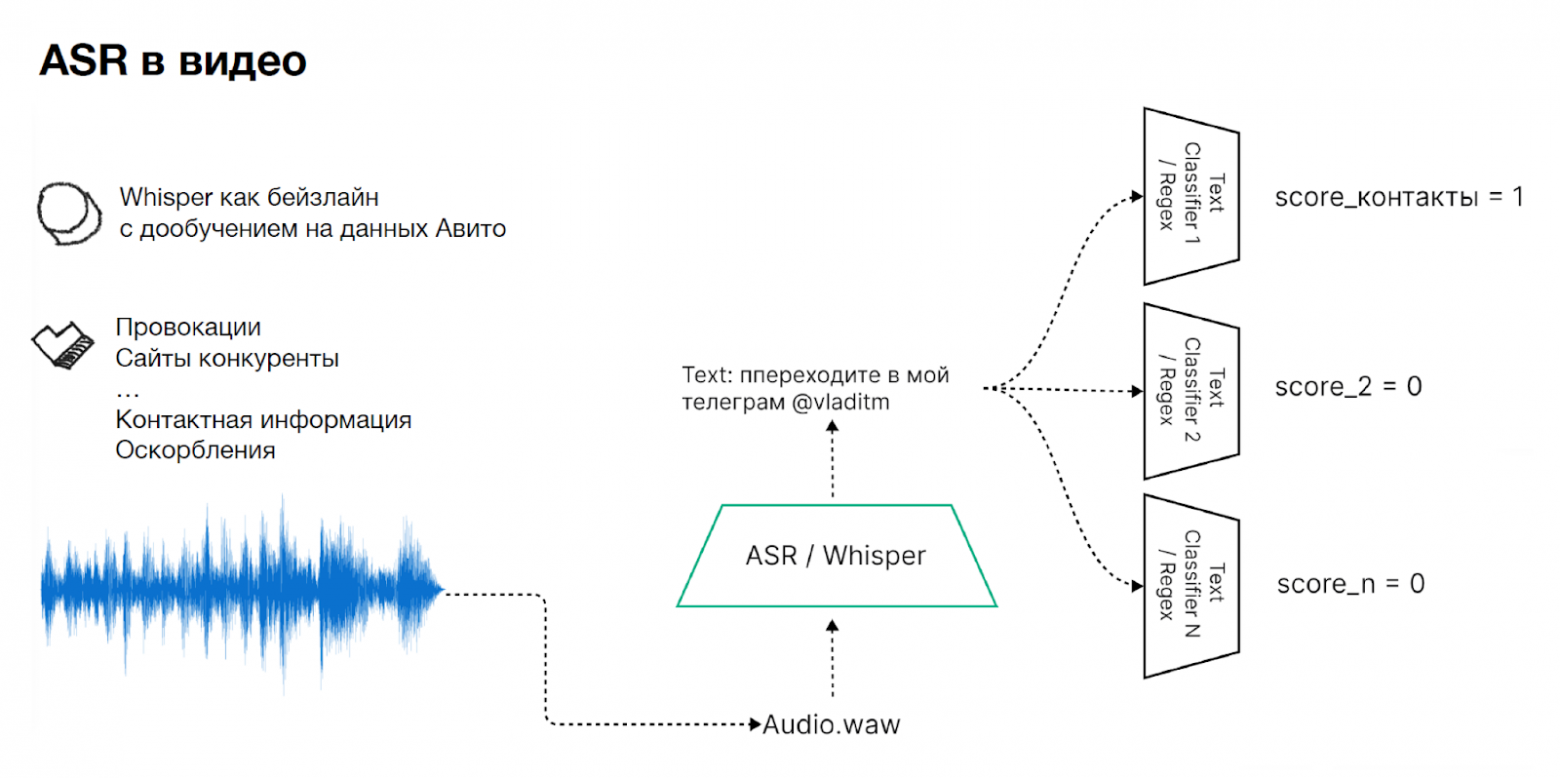
Речевая ветка повторяет логику OCR: Whisper превращает Audio.wav в текст, после чего причины нарушений ищут текстовые классификаторы и регулярные выражения.
Источник: Владимир Морозов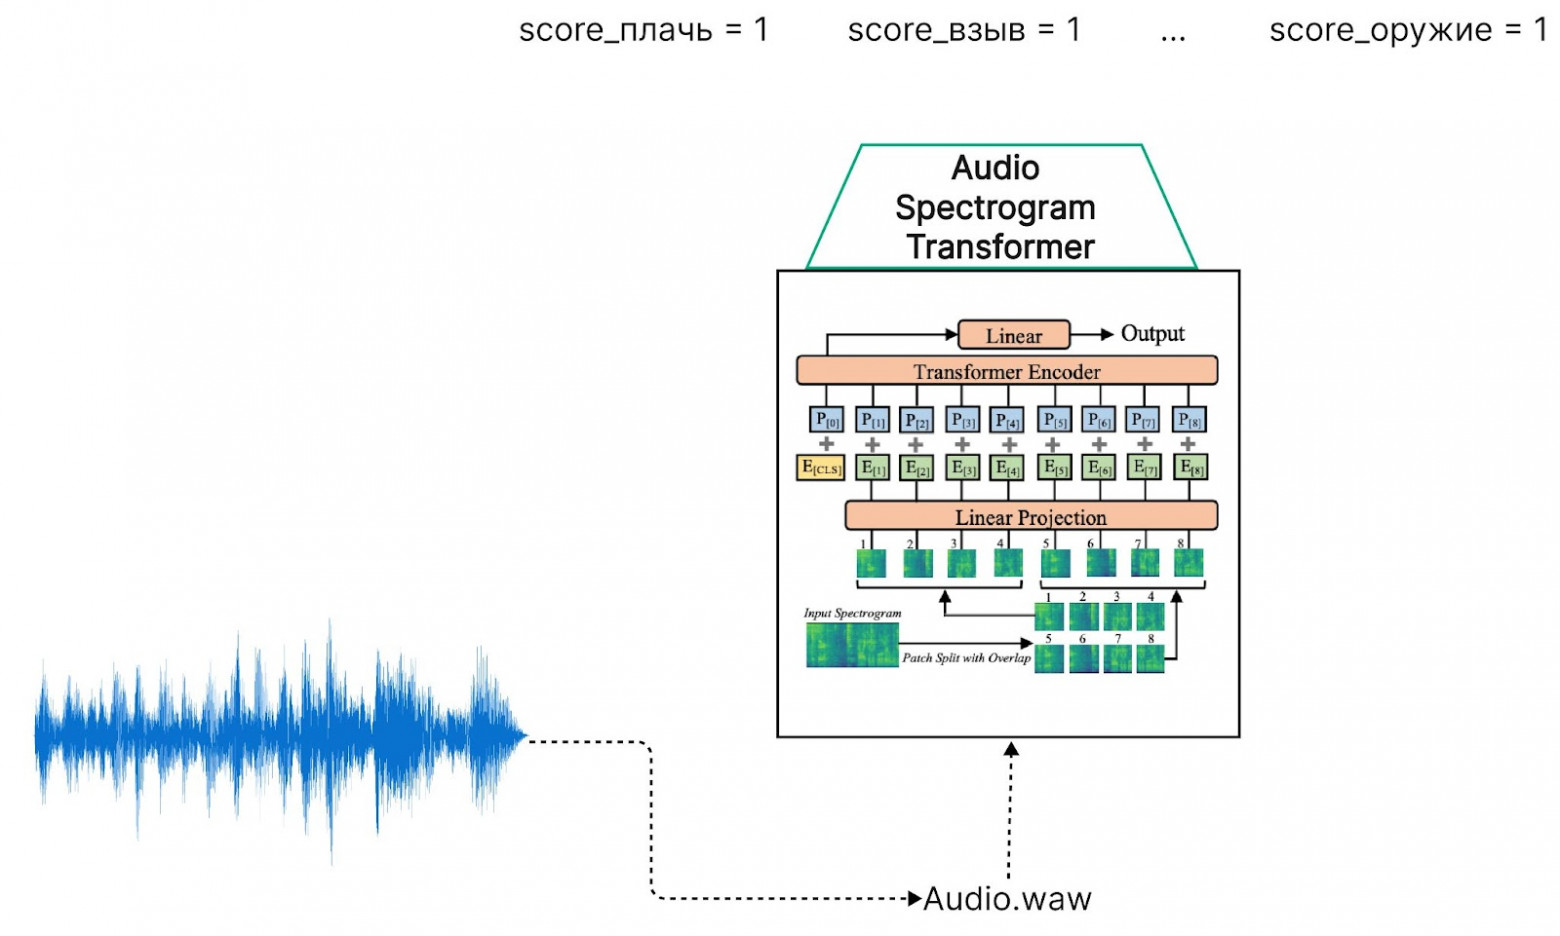
Audio Spectrogram Transformer анализирует непосредственно аудио и выдаёт отдельные оценки звуковых событий или причин, не требуя предварительной транскрипции речи.
Источник: Владимир МорозовКачество ролика и соответствие самому объявлению
Отдельная группа проверок вообще не требует анализировать семантику каждого кадра. Для выявления видео совсем плохого качества источник предлагает использовать метаданные: битрейт и FPS. FPS показывает число кадров в секунду, а битрейт характеризует поток видеоданных. На таких признаках можно обучить базовый классификатор качества. Конкретный набор признаков, архитектура и метрики такой модели в статье не раскрыты.
Другая задача возникает даже с технически корректным роликом: он может не иметь отношения к объявлению. В исходном примере объявление о квартире сопровождается посторонним видео. Чтобы проверить соответствие модальностей, команда снова переиспользует CLIP: кадры видео и фотографии объявления кодируются визуальной частью модели, а заголовок и описание — текстовой.
На схеме признаки кадров видео отдельно агрегируются Joint Net в Video Emb, а изображения объявления — другим Joint Net в Image Emb. Текст объявления превращается в Text Emb. Эти представления поступают в общую классификационную голову, выдающую оценку нарушения от 0 до 1. Слайд отдельно подчёркивает, что в этой постановке обучать нужно только Joint Net и Head, то есть агрегаторы и конечную голову, переиспользуя CLIP для получения исходных представлений.
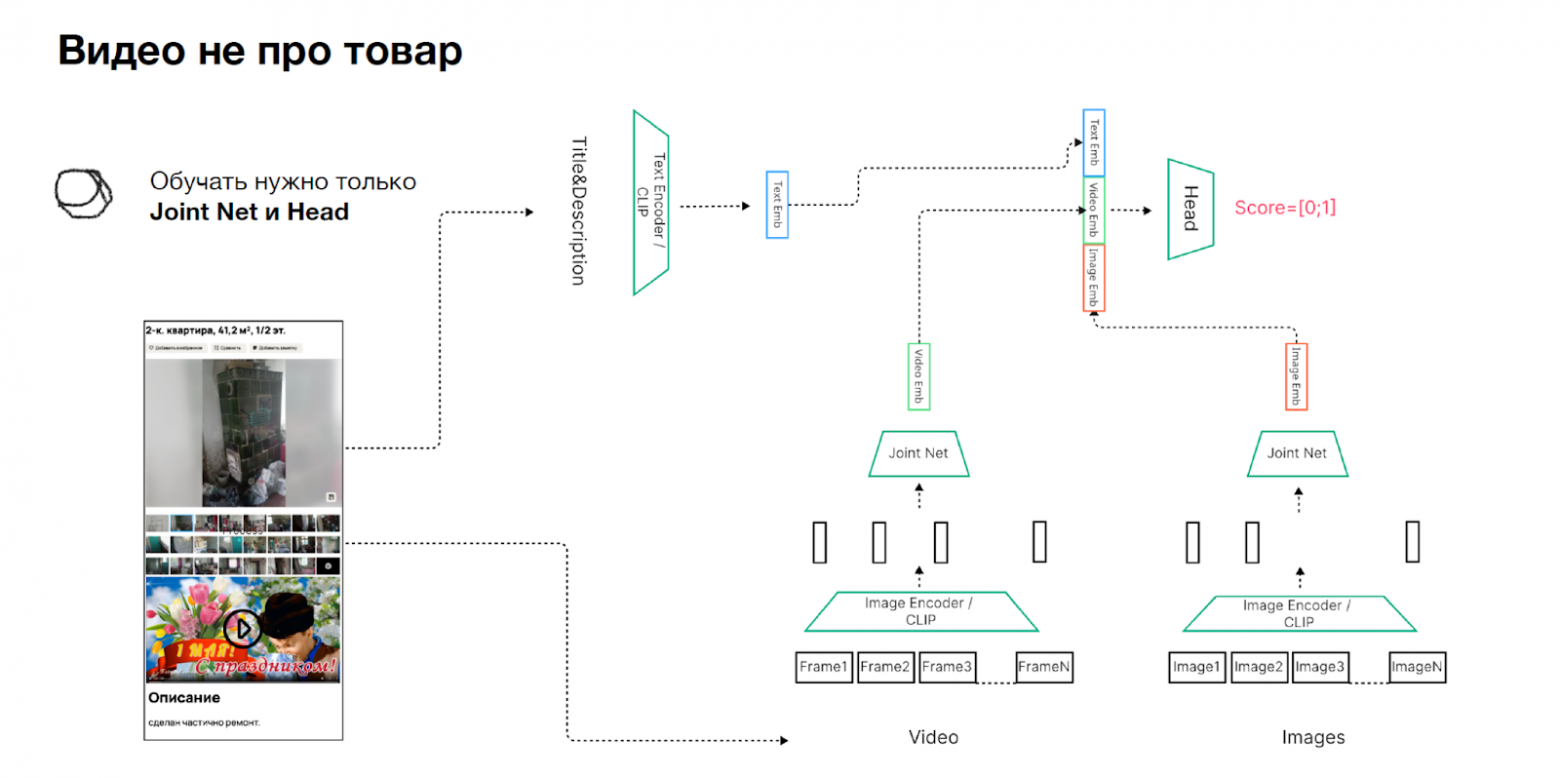
Проверка соответствия ролика объявлению: текст, видео и изображения преобразуются CLIP в представления, видео и изображения агрегируются Joint Net, а общая Head выдаёт оценку. На слайде отдельно указано, что обучать нужно Joint Net и Head.
Источник: Владимир МорозовИтоговая архитектура — набор моделей, а не одна большая сеть
После декомпозиции система не превращается в единую огромную мультимодальную модель. На общей схеме параллельно существуют OCR с текстовыми классификаторами, распознавание речи с текстовыми классификаторами, обычные классификаторы изображений, классификаторы видео, детектор логотипов, детектор лиц, аудиоклассификаторы и проверка соответствия модальностей. Каждая ветка ищет свои причины, а их сигналы вместе определяют, найдено ли нарушение.
Такой подход важен и с точки зрения разработки. Для новой причины не всегда требуется менять всё сразу: где-то достаточно новой классификационной головы поверх общего видеоэмбеддинга, где-то zero-shot CLIP, где-то регулярного выражения после уже работающего OCR или Whisper, а для отдельного типа объекта понадобится специализированный детектор.
Изменился и продуктовый поток. Раньше после отдельной премодерации каждый ролик попадал к человеку. В актуальной на момент статьи схеме после премодерации работает автомодерация. Если нарушение не обнаружено, видео автоматически разрешается и появляется на площадке. Если система выставила признак нарушения, ролик отправляется на ручную модерацию, где уже принимается окончательное решение.
По словам автора, большинство роликов к этому моменту проходило автомодерацию, а ручная проверка требовалась только для небольшого процента видео с найденными нарушениями. За счёт этого ролики публиковались значительно быстрее, чем в исходном полностью ручном потоке. Точная доля автоматизации и количественное сравнение времени публикации в статье не приведены.
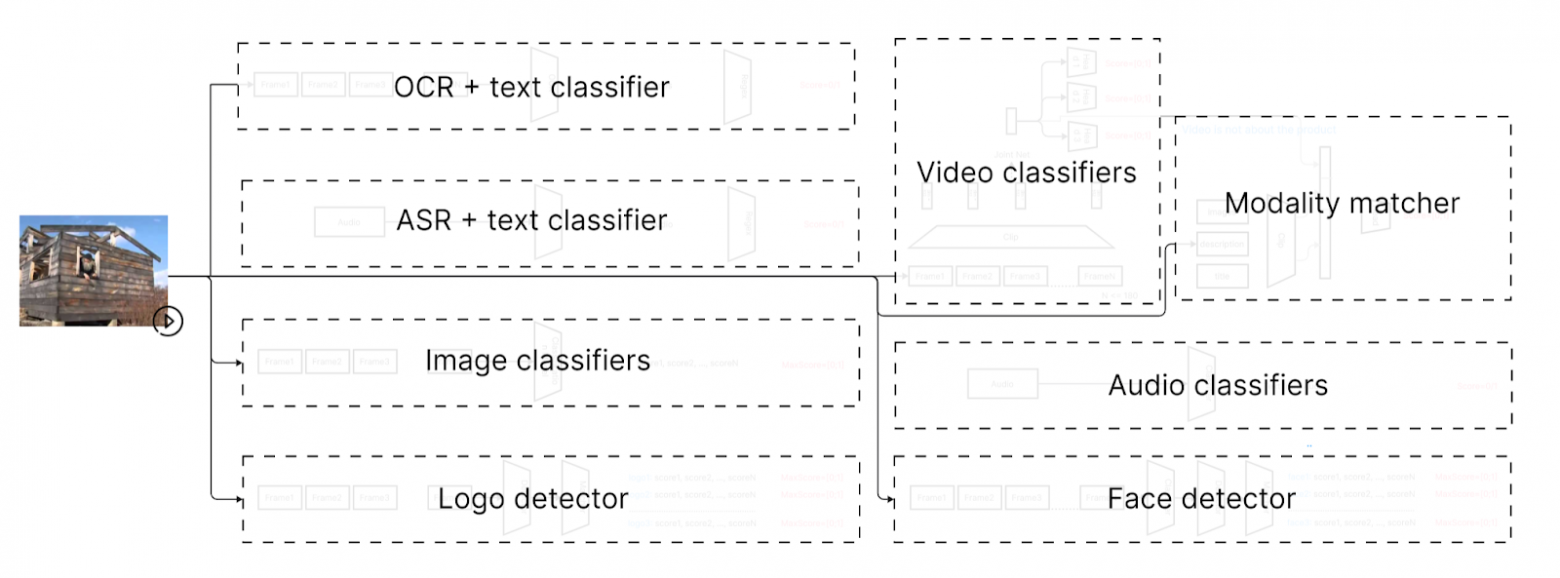
Полная система собрана из независимых веток для OCR, речи, отдельных кадров, видео, логотипов, лиц, аудио и сопоставления модальностей. Основной вывод схемы — автомодерация представляет собой ансамбль специализированных компонентов.
Источник: Владимир Морозов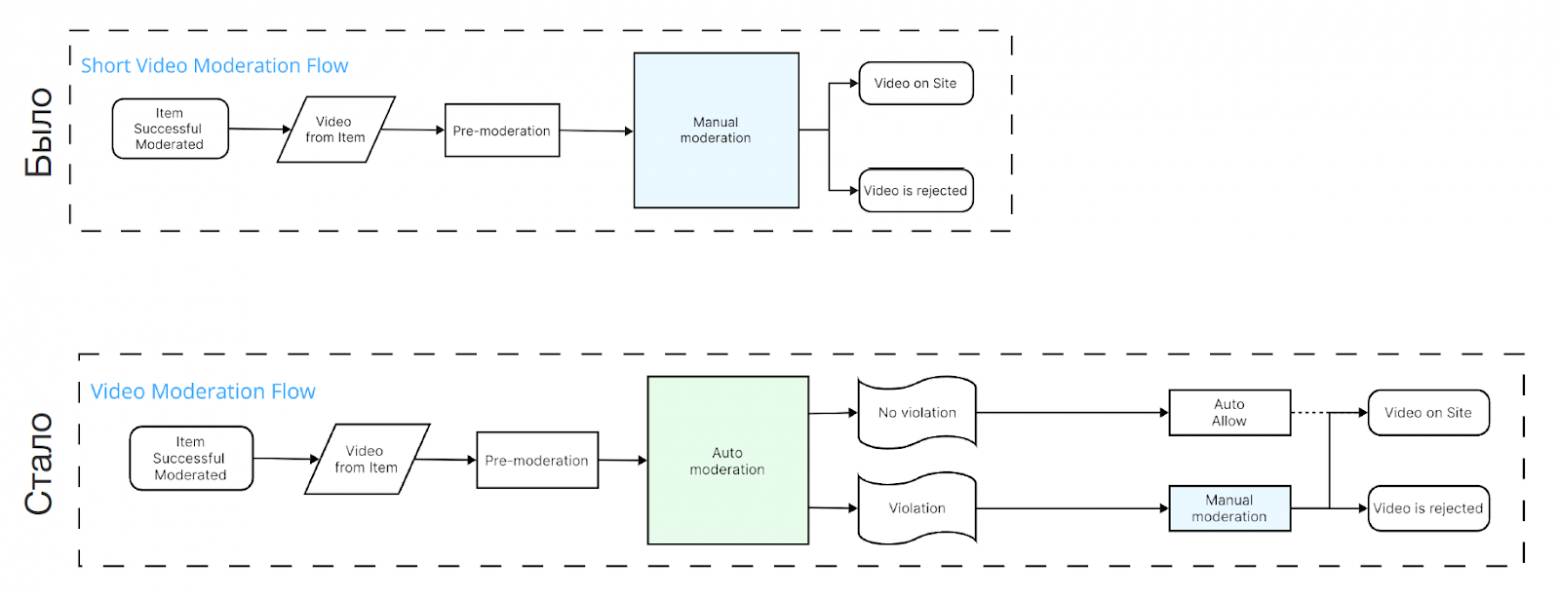
Сравнение потоков до и после автоматизации: раньше после премодерации всё видео шло человеку; в новой схеме ролики без найденных нарушений автоматически разрешаются, а обнаруженные нарушения отправляются на ручную проверку.
Источник: Владимир МорозовКак измерять качество, если большинство разрешённых видео уже никто не смотрит
После автоматизации появляется новая проблема оценки. Для ролика, который модель пометила нарушающим и отправила человеку, можно получить обратную связь от ручной модерации. Но большая часть видео, где нарушение не найдено, автоматически публикуется. Если их никогда не перепроверять, команда не увидит систематически пропускаемые нарушения и не сможет корректно оценить полноту модели.
Таблицу можно прокрутить по горизонтали.
Для такой оценки команда изменила инструкцию ручной модерации. Требовалось точнее указывать домен и подробнее размечать причину нарушения. Иначе даже при наличии решения человека было бы трудно понять, какая именно автоматическая ветка ошиблась и что нужно улучшать. На схеме анализа отдельно подчёркивается необходимость смотреть метрики по доменам, моделям и причинам.
Второе изменение — выборочная ручная перепроверка видео, которые автомодерация сочла нормальными. Если автоматическая система нашла нарушение, ручная проверка позволяет различить истинное срабатывание, True Positive, и ложное срабатывание, False Positive. Если нарушение не найдено, основная масса видео публикуется, но часть потока всё равно отправляется человеку. Так команда получает примеры пропущенных нарушений, False Negative, и корректно разрешённых видео, True Negative.
Именно эта выборка нужна для оценки Recall: без ручного просмотра хотя бы части автоматически разрешённых роликов неизвестно, сколько нарушений система пропустила. При этом источник не приводит объём выборки, способ пересчёта результатов сэмпла на весь поток, доверительные интервалы, пороги моделей или итоговые значения Precision и Recall. Поэтому статья объясняет устройство контура измерения, но не позволяет восстановить численное качество системы.
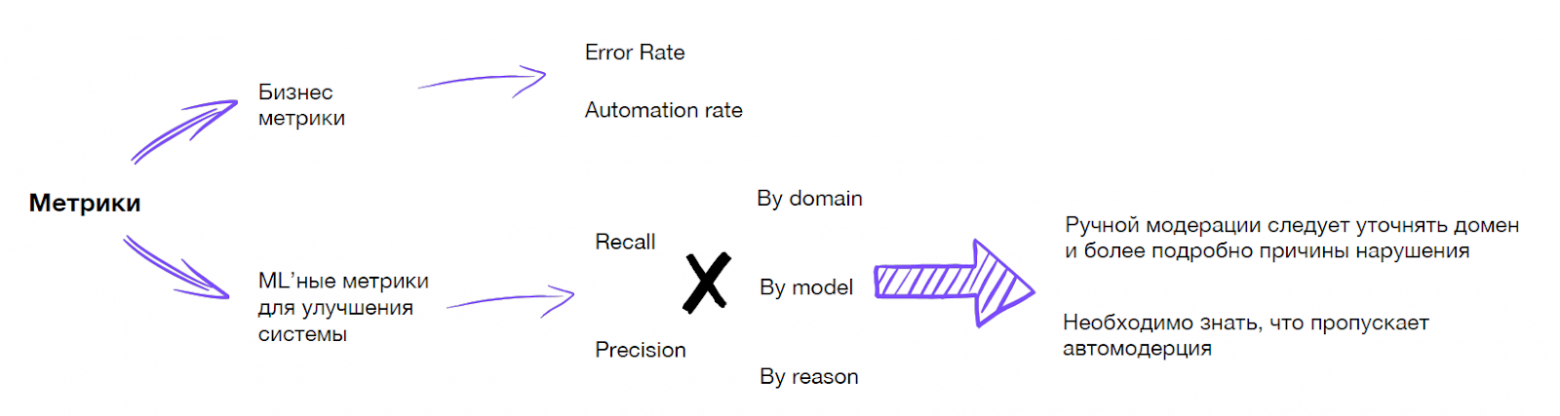
Схема анализа качества разделяет бизнес-метрики Error Rate и Automation rate и ML-метрики Recall и Precision; для диагностики предлагаются разрезы по домену, модели и причине нарушения.
Источник: Владимир Морозов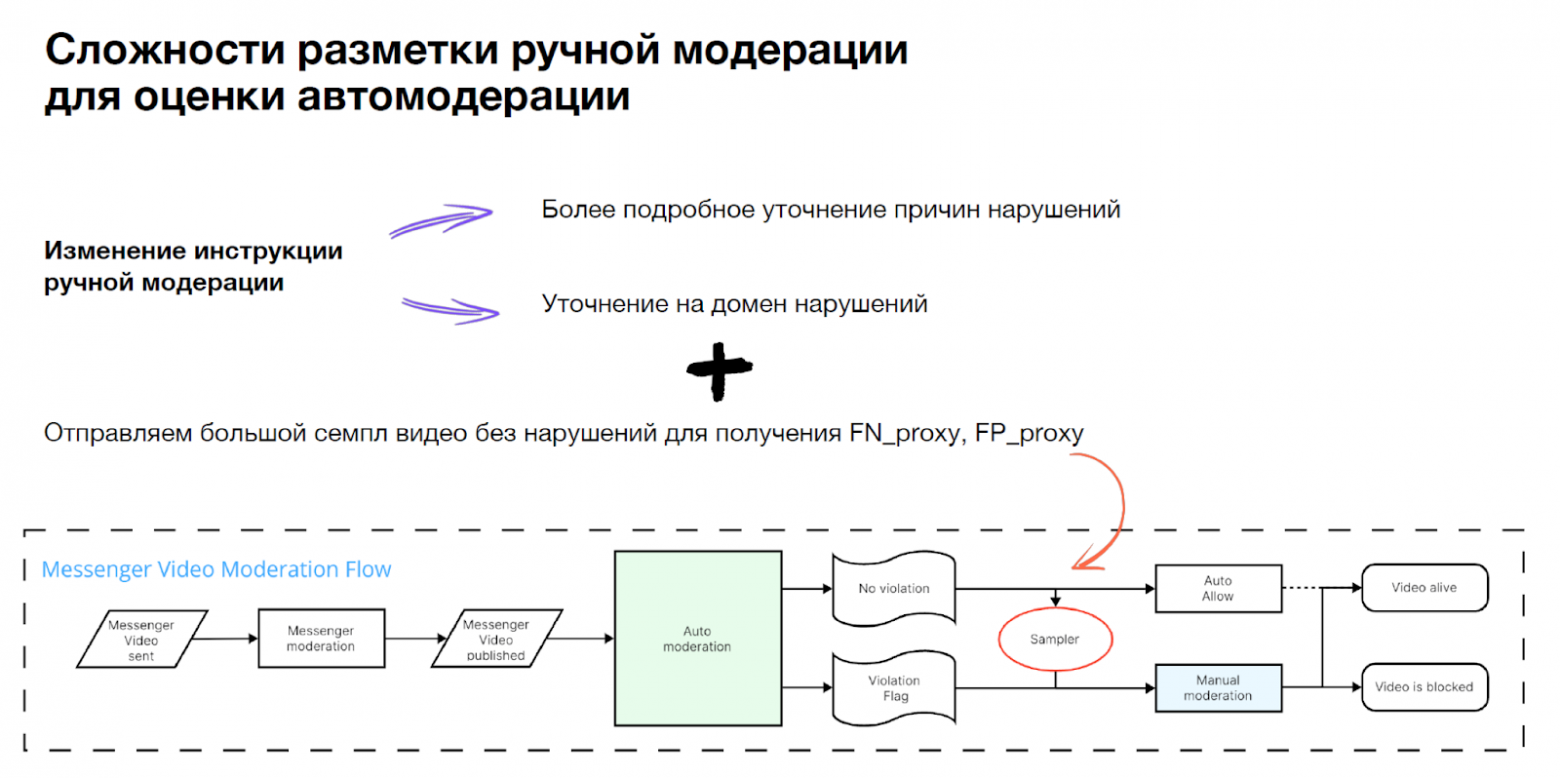
После изменения инструкции ручной модерации автоматически разрешённые видео выборочно возвращаются на ручную проверку, чтобы увидеть нарушения, которые автомодерация пропускает.
Источник: Владимир МорозовИтог: как работает автомодерация видео
Путь команды был постепенным. Сначала объявление после проверки публиковалось без ролика, а видео проходило отдельную премодерацию и ручную проверку. Затем выяснилось, что для обучения не хватает чистой исторической разметки: нарушающих роликов мало, разметка шумная, а сами видео по правилам хранения быстро удалялись. Данные дополняли внешними наборами, а задачу разложили на видеоряд, текст, речь и звуки, качество и соответствие ролика объявлению. Для каждой ветки выбрали отдельный, по возможности уже готовый подход.
- 01
Выбор фреймов
Из ролика отбираются кадры для дальнейшего анализа; способ отбора должен учитывать возможность обхода модерации.
- 02
Визуальные проверки
Кадры кодируются и проходят классификаторы причин нарушений, а отдельные ветки ищут логотипы и лица.
- 03
Текст и звук
OCR извлекает надписи, Whisper превращает речь в текст, а Audio Spectrogram Transformer анализирует неречевые звуки.
- 04
Качество и соответствие
Метаданные помогают находить плохое качество, а CLIP сопоставляет видео с текстом и изображениями объявления.
- 05
Решение
Сигналы нескольких моделей объединяются: ролики без найденных нарушений пропускаются автоматически, найденные нарушения отправляют на ручную проверку.
По описанию Авито, большинство роликов теперь проходит автомодерацию и появляется на сайте быстрее, а вручную проверяется лишь небольшой процент видео, где система нашла нарушение. Точных значений уровня автоматизации, доли ошибок, Precision или Recall источник не приводит.
Ограничения остаются существенными: для части причин мало собственных данных, качество разметки изначально не подходило для обучения, условия внутренних бенчмарков не раскрыты, а точность отдельных веток и итоговой системы не опубликована. Для оценки пропусков команда изменила ручную разметку и отправляет выборку автоматически разрешённых видео на дополнительную проверку.
Раздел «Вместо выводов» вместе с итоговой архитектурой и разделом оценки