Разбор готов
Anthropic: как организовать работу агента на много контекстных окон
Claude Agent SDK — это окружение, в котором языковая модель может пользоваться инструментами, собирать контекст, планировать и выполнять действия. Anthropic разбирает конкретную проблему такого агента: сложная задача может длиться часы или дни и не помещаться в одно контекстное окно. Тогда работа распадается на сессии, а новая сессия не помнит предыдущую сама по себе. Одного автоматического сжатия истории недостаточно: в эксперименте с клоном claude.ai агент либо пытался реализовать слишком много сразу и оставлял незавершённый код, либо позже видел уже сделанную часть проекта и преждевременно объявлял работу законченной. В разборе посмотрим, как Anthropic превратила файловую систему, git, список функций и браузерные проверки во внешнюю память и рабочий протокол для последовательных сессий.
Материал полезен разработчикам LLM-агентов и AI-инструментов для программирования, которые хотят запускать одну задачу через несколько контекстных окон. На примере видно, как передавать состояние между сессиями, ограничивать объём работы одного запуска и проверять результат не только по коду, но и через реальный пользовательский путь.
Рекомендуем. Полезно для агентов, которым недостаточно одного диалога или одного окна контекста.
Почему длинной задаче недостаточно большого контекста
Главное ограничение здесь не в том, умеет ли модель написать отдельный фрагмент кода. Долгий проект требует сохранять направление работы между несколькими сессиями. Anthropic сравнивает это с командой инженеров, работающих по сменам: каждый новый человек приходит без памяти о прошлой смене. Для агента роль такой границы играет контекстное окно — объём информации, который модель может одновременно учитывать.
Claude Agent SDK уже умеет управлять контекстом, в том числе с помощью compaction — сжатия накопленной истории, чтобы агент не исчерпал окно слишком быстро. Теоретически такая схема должна позволять продолжать полезную работу сколь угодно долго. Но в эксперименте Anthropic одного compaction оказалось мало: даже Opus 4.5, запущенный в цикле через несколько контекстных окон, не строил качественное веб-приложение целиком — от интерфейса до серверной части — только по высокоуровневой инструкции вроде просьбы сделать клон claude.ai.
Первый тип сбоя возникал в начале. Агент пытался сделать слишком много за один заход — фактически реализовать приложение целиком. Контекст заканчивался посередине изменения, а следующая сессия получала наполовину готовую функцию без ясного описания состояния. Ей приходилось угадывать, что произошло, и тратить время на восстановление базовой работоспособности. Anthropic отдельно отмечает, что compaction не всегда передаёт следующей сессии достаточно ясные инструкции.
Второй тип сбоя проявлялся позже. Когда часть функций уже была реализована, новая сессия осматривала проект, видела заметный прогресс и могла решить, что задача завершена, хотя исходные требования выполнены не полностью. Поэтому проблема распалась на две части: заранее зафиксировать весь объём требуемой функциональности и заставить каждую последующую сессию делать небольшой проверяемый шаг, оставляя проект в состоянии, с которого удобно продолжать.
Вступление и раздел «The long-running agent problem», абзацы от «As AI agents become more capable…» до определения «clean state».Две роли: подготовить среду и затем двигаться маленькими шагами
Решение Anthropic состоит из двух режимов работы. В самой первой сессии действует initializer agent — агент-инициализатор. Его задача не в том, чтобы немедленно реализовать как можно больше функций, а в том, чтобы подготовить рабочую среду для следующих запусков. Он создаёт сценарий запуска init.sh, журнал claude-progress.txt и начальный git-коммит, по которому видно, какие файлы появились в проекте.
Все следующие сессии работают как coding agent: выбирают небольшой следующий кусок задачи, вносят изменение и оставляют структурированное состояние для продолжения. Центральная идея — не пытаться передать всю историю разговора. Вместо этого важные факты о проекте закрепляются в артефактах, которые новая сессия может быстро прочитать: журнале прогресса, списке требований и истории git.
Anthropic называет хорошим конечным состоянием сессии «clean state»: примерно таким, в каком изменение можно было бы слить в основную ветку. Не должно оставаться крупных известных ошибок, код должен быть упорядочен и описан достаточно ясно, чтобы следующий разработчик мог начать новую функцию, а не сначала разбирать последствия предыдущей.
Важно, что initializer agent и coding agent в этой работе не являются двумя разными моделями или двумя разными наборами инструментов. В примечании Anthropic уточняет: их называют отдельными агентами только потому, что первая и последующие сессии получают разные начальные пользовательские инструкции. Системный промпт, инструменты и общая агентная обвязка остаются одинаковыми. Авторы также указывают на сопровождающий quickstart с примерами кода, но сама инженерная идея не зависит от отдельной реализации из quickstart.
Раздел «The long-running agent problem», абзацы «When experimenting internally…» и «The key insight…»; раздел «Environment management»; примечание 1.Список функций не даёт агенту забыть, что проект ещё не закончен
Чтобы агент не пытался «сделать всё сразу» и не завершал проект раньше времени, initializer agent превращает исходную просьбу пользователя в подробный список проверяемых функций. В примере с клоном claude.ai получилось более 200 пунктов. Один пункт описывал, например, создание нового чата: открыть главный интерфейс, нажать New Chat, проверить появление новой беседы, начальное состояние области чата и запись в боковой панели.
В начале все функции помечаются как failing, то есть не прошедшие проверку. Это важно: у следующей сессии появляется явная граница между тем, что уже доказано работающим, и тем, что ещё нужно реализовать. Список становится не просто планом, а общей внешней памятью о полноте продукта.
Coding agent разрешают менять в этом файле только статус поля passes. Инструкции формулируются жёстко: тесты нельзя удалять или переписывать ради удобства, иначе можно незаметно потерять требуемую функциональность. Такая защита нужна потому, что агент сам является и исполнителем, и участником проверки: без ограничений ему проще изменить критерий успеха, чем исправить продукт.
После экспериментов Anthropic остановилась на JSON, а не Markdown. По наблюдению авторов, модель реже неуместно меняла или перезаписывала структурированный JSON-файл. Это не универсальная метрика надёжности форматов, а конкретный вывод их экспериментов с этой обвязкой.
Раздел «Feature list», от «To address the problem…» до абзаца о выборе JSON вместо Markdown.Одна функция за сессию и обязательный след в git
После подготовки окружения coding agent получает более узкое правило: работать только над одной функцией за раз. По словам Anthropic, именно переход к инкрементальной работе оказался критичным для борьбы с попыткой реализовать слишком большой кусок проекта за один контекст.
Но маленький объём изменения сам по себе не гарантирует, что следующая сессия поймёт состояние проекта. Поэтому после работы агент должен зафиксировать результат двумя способами: сделать git-коммит с содержательным сообщением и записать краткое резюме в файл прогресса. Git здесь служит не только журналом. Если изменение оказалось плохим, агент может откатить его и вернуться к рабочему состоянию кодовой базы.
Такой протокол снижал и накладные расходы между сессиями. Новому запуску не нужно заново расследовать, какие файлы менялись и почему приложение перестало работать: последние решения видны в истории и журнале. Источник описывает рост эффективности качественно, но не приводит числа по экономии токенов, времени или количеству восстановленных сессий.
Раздел «Incremental progress», все абзацы от «Given this initial environment scaffolding…» до «trying to get the basic app working again».Почему модульных тестов и curl оказалось недостаточно
Ещё один наблюдаемый сбой: Claude мог отметить функцию готовой без полноценной проверки. Без специальной инструкции агент менял код, запускал модульные тесты (unit tests) или отправлял curl-запросы к серверу разработки, но не всегда замечал, что пользовательский сценарий целиком всё ещё сломан. Локальная проверка отдельных частей не гарантировала работу интерфейса от начала до конца.
Для веб-приложения Anthropic добавила явное требование проверять функцию так, как её проверял бы человек, через инструменты автоматизации браузера. В этой постановке Claude в большинстве случаев хорошо проводил сквозные проверки пользовательского сценария (end-to-end) после того, как его явно направили на такой способ тестирования. Через Puppeteer MCP агент мог открыть приложение, взаимодействовать с интерфейсом и увидеть ошибки, которые не были очевидны из исходного кода.
Авторы пишут, что такие инструменты заметно улучшили результат, но не дают численной метрики этого улучшения. На приложенной иллюстрации показана браузерная проверка клона claude.ai: это пример того, как агент смотрит не только на код, но и на фактический интерфейс.
Проверка браузером тоже не делает систему безошибочной. Ограничения зрения модели и самого инструмента автоматизации оставляют слепые зоны. Конкретный пример Anthropic: Claude не видит нативные alert-модальные окна браузера через Puppeteer MCP, поэтому функции, зависящие от таких окон, в эксперименте чаще оставались с ошибками.
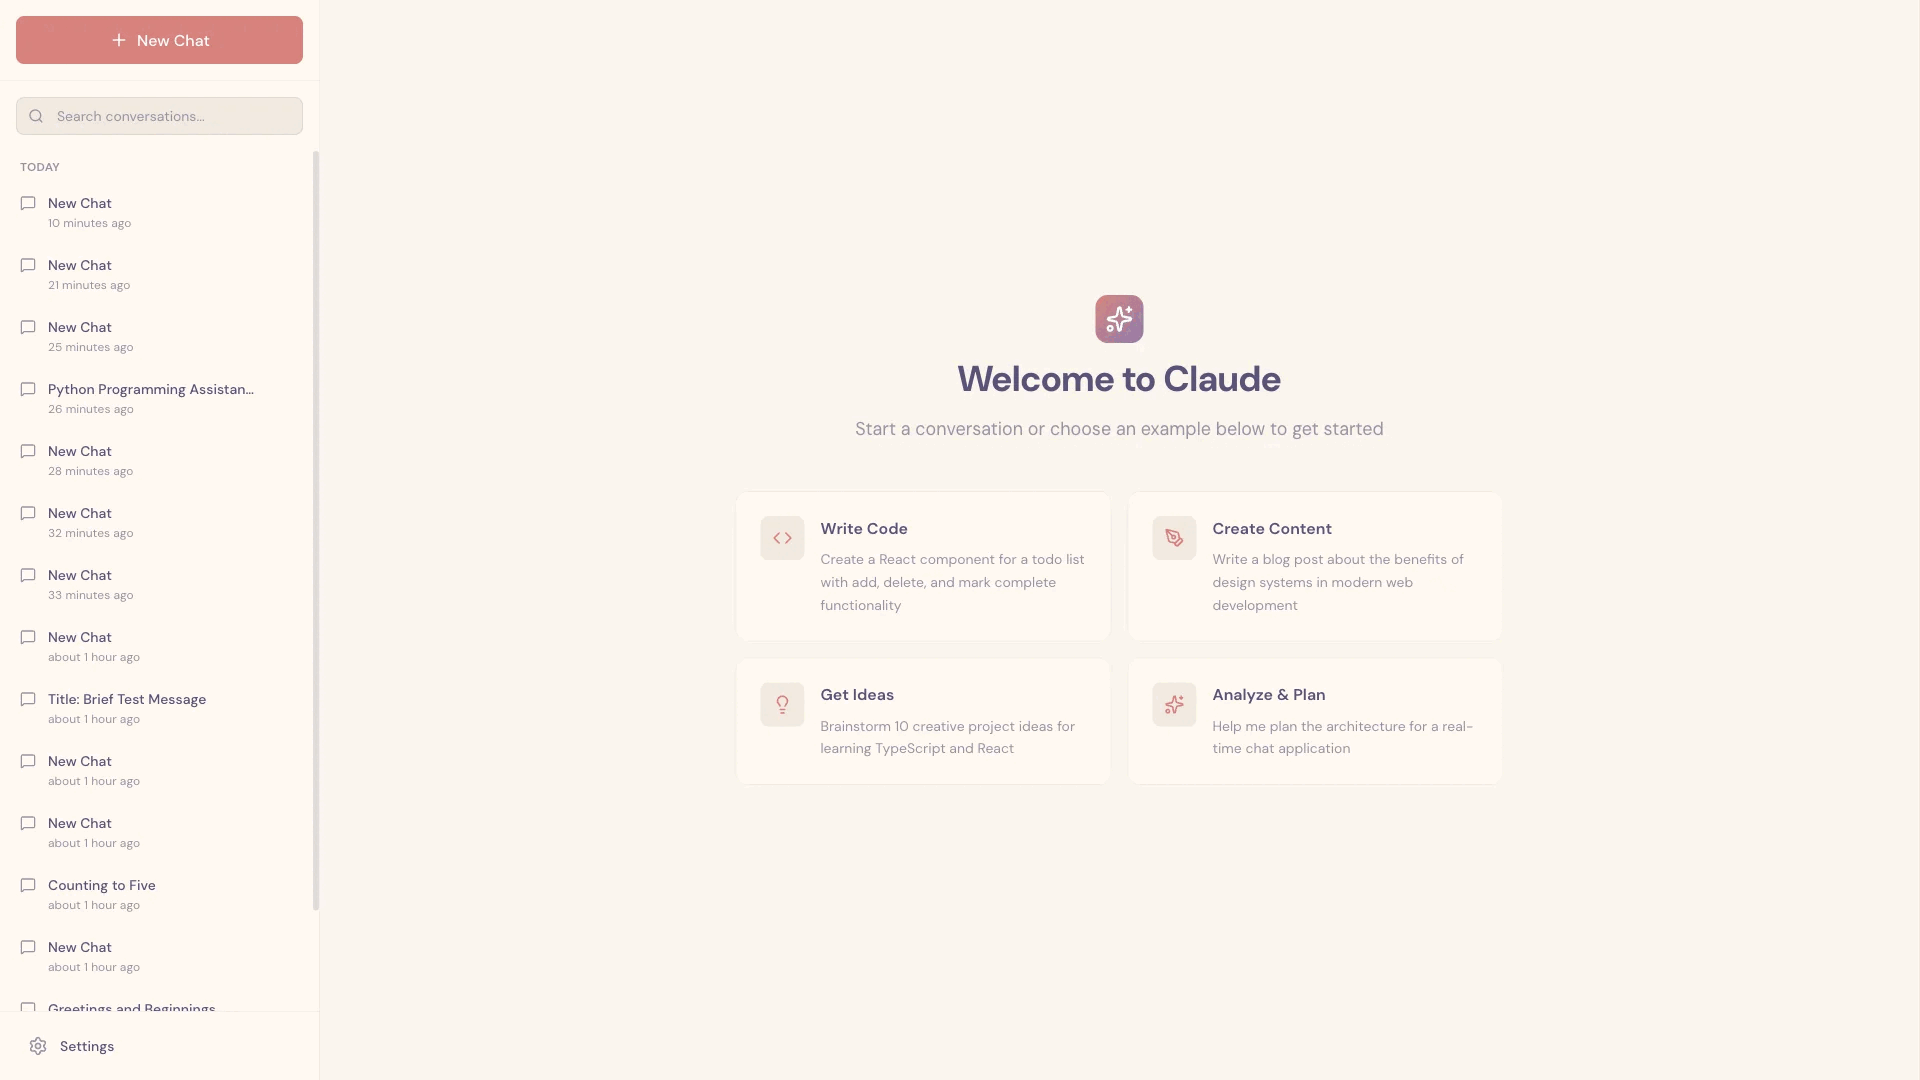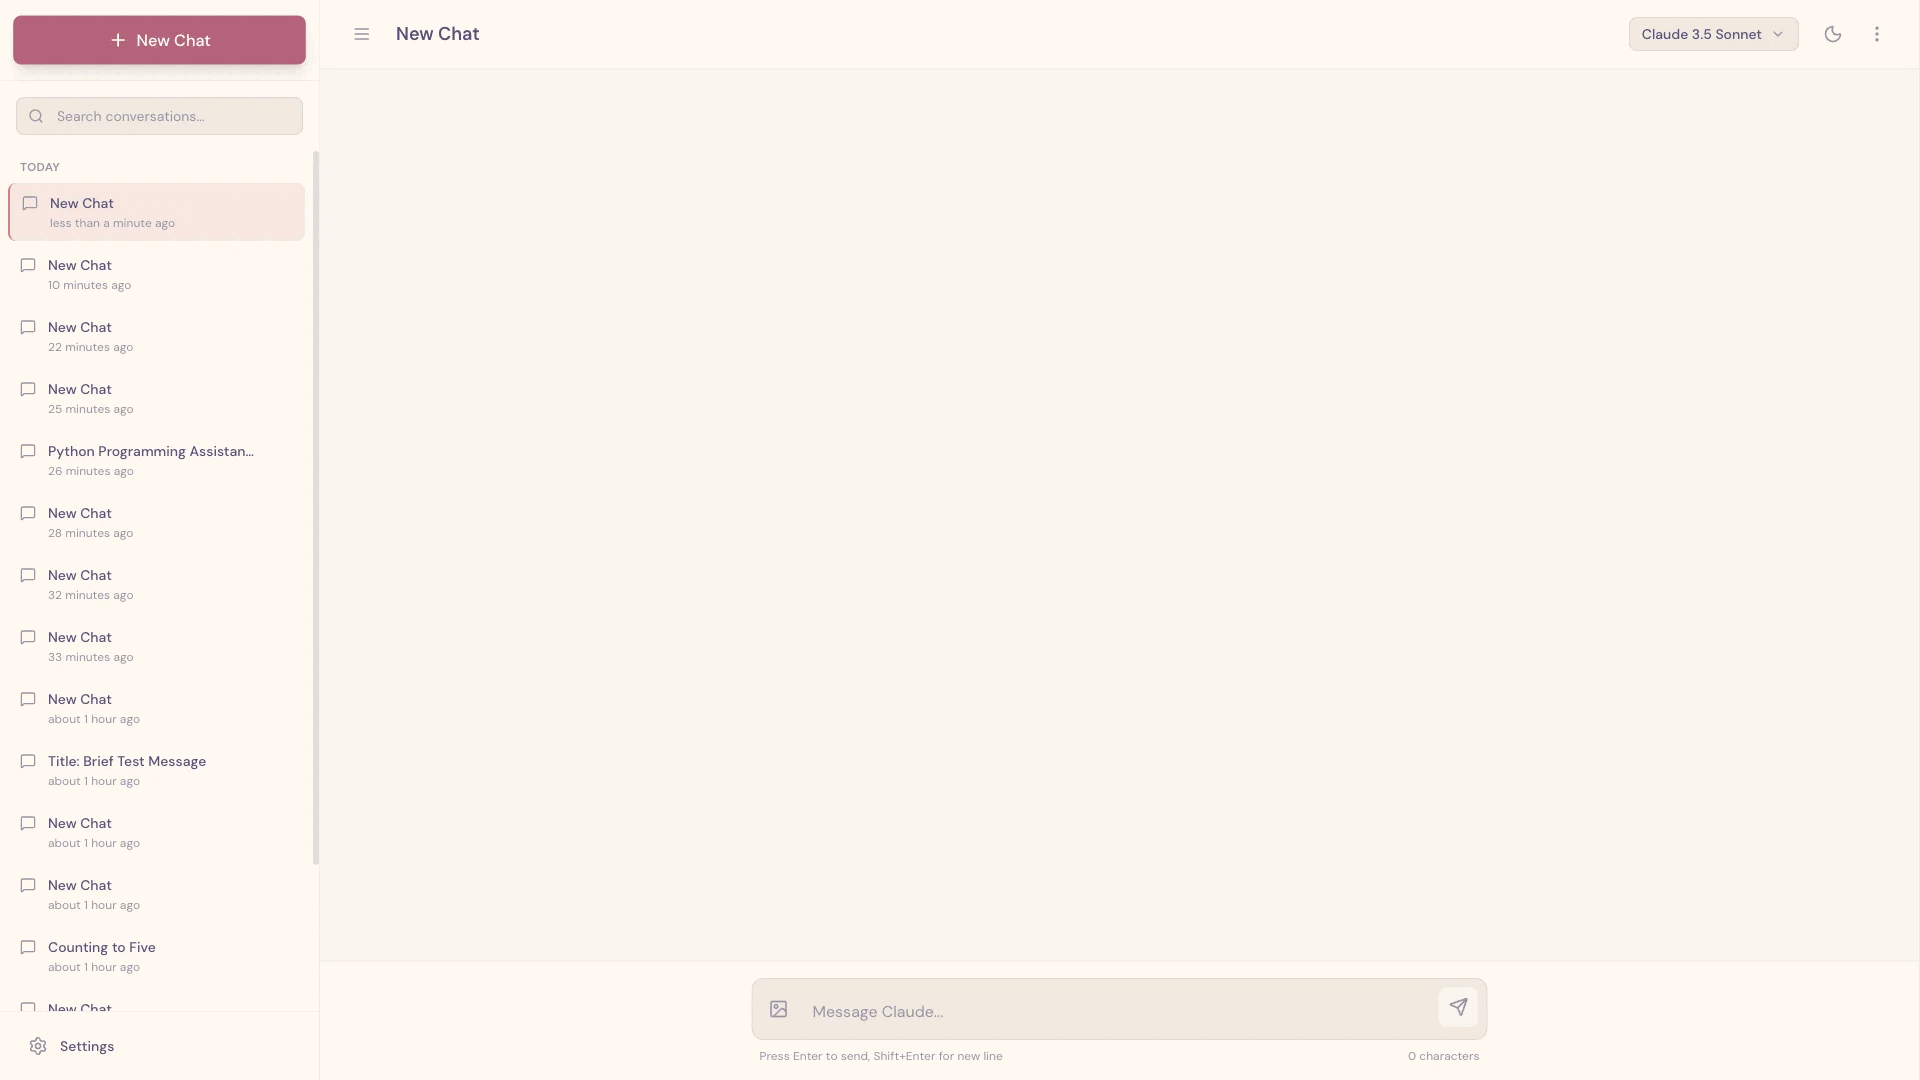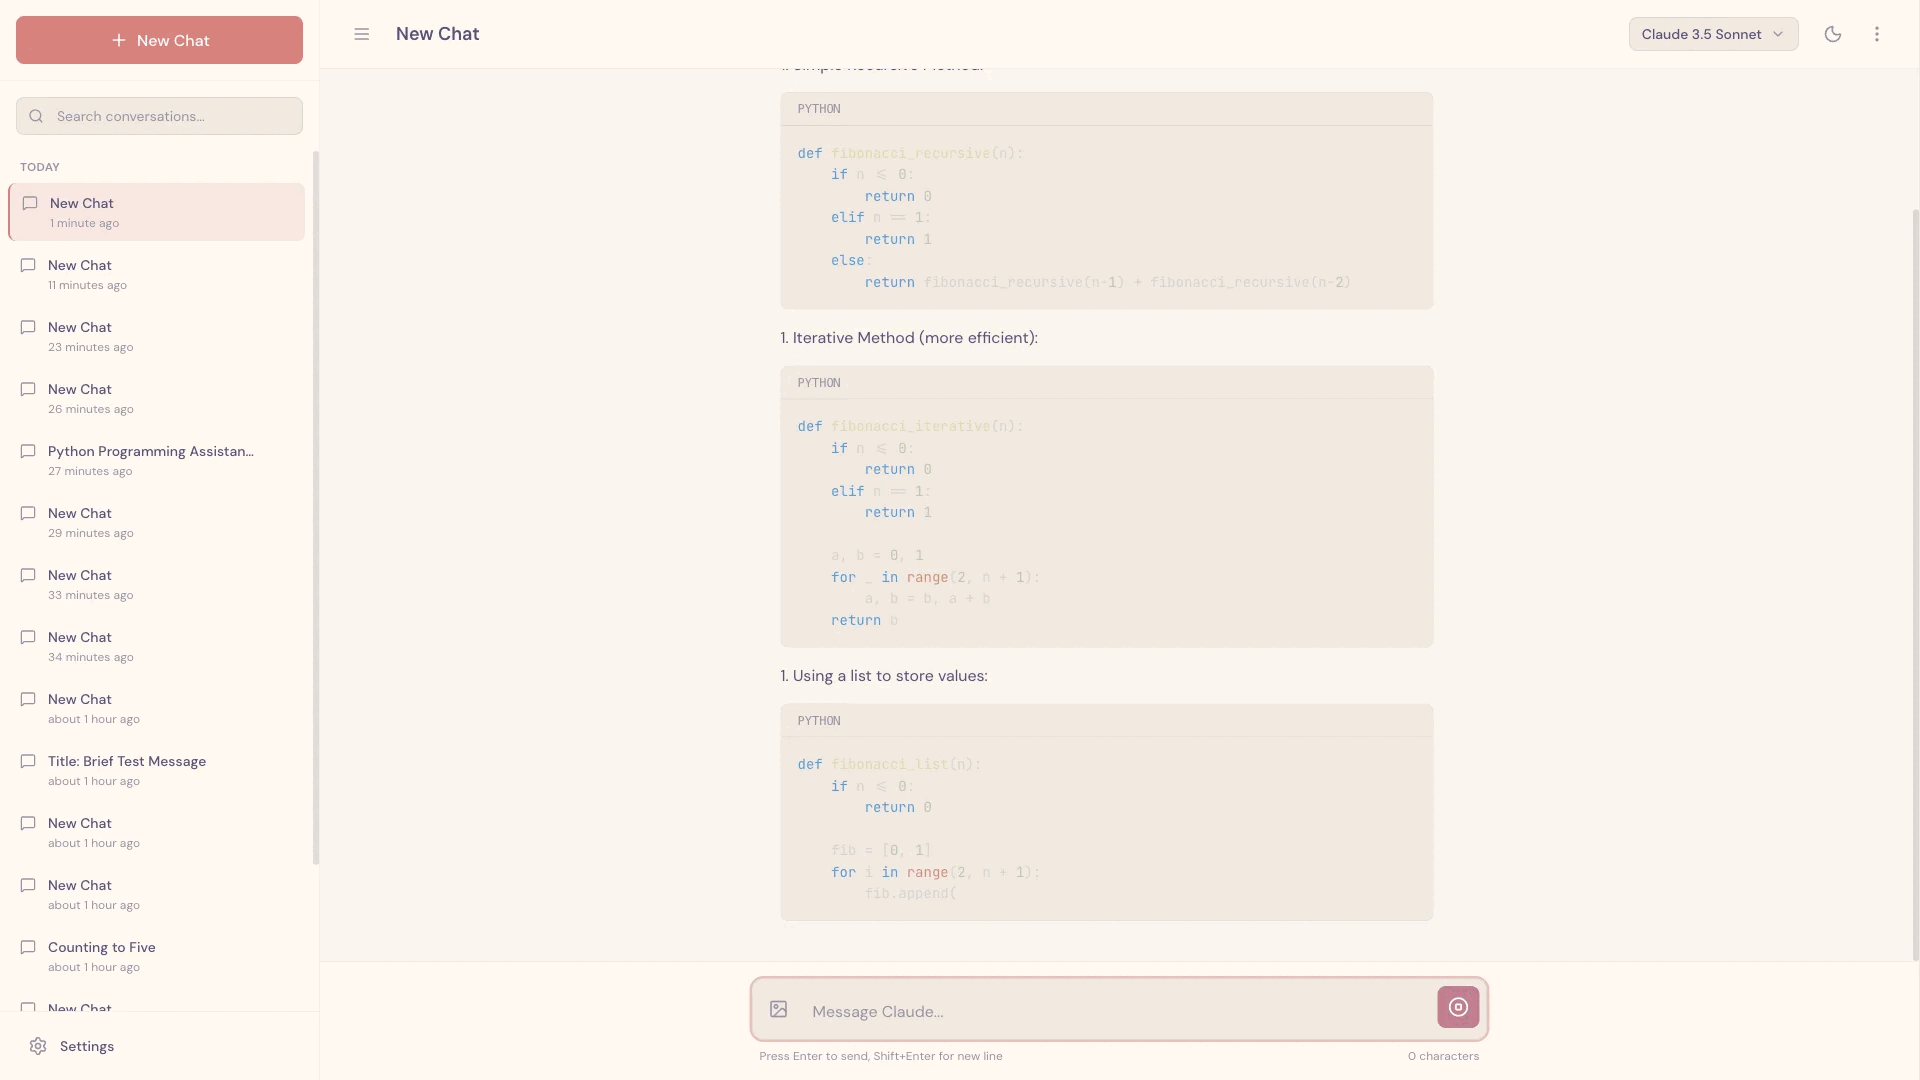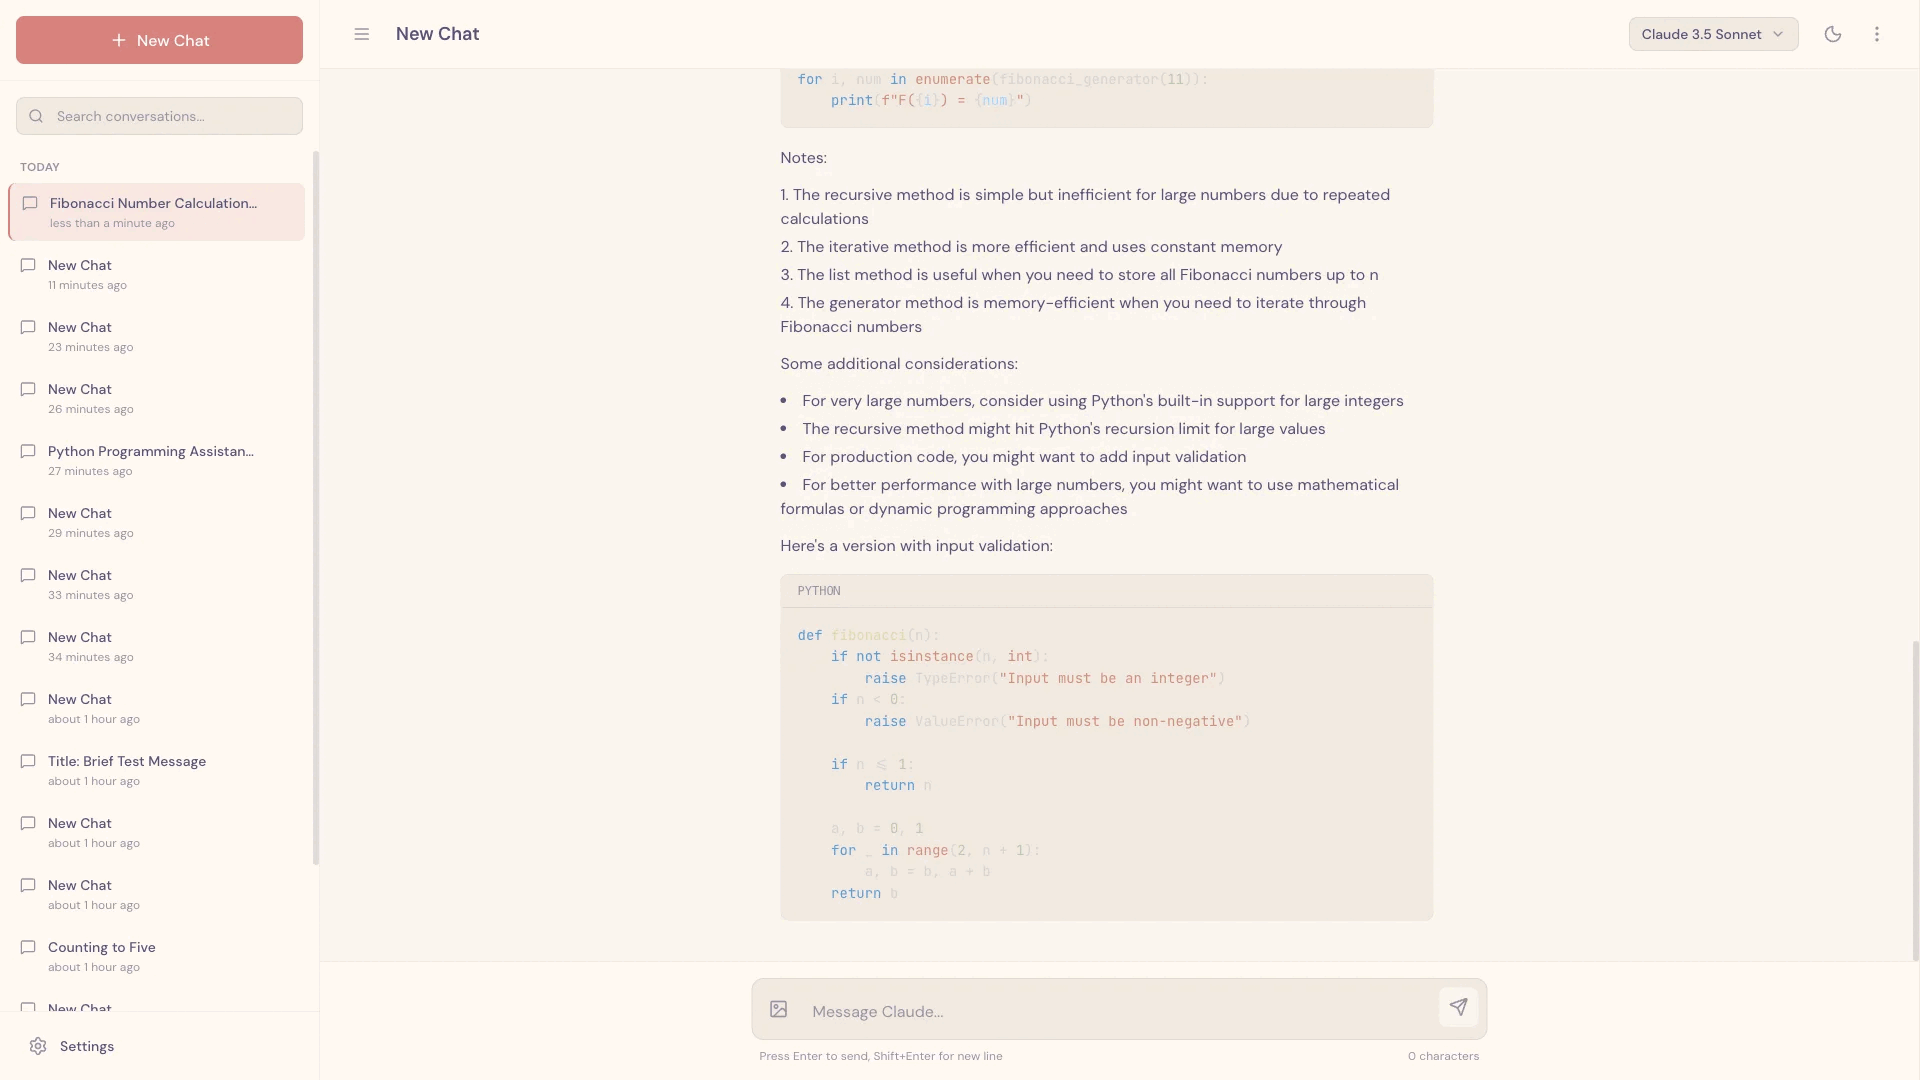
Проверка клона claude.ai через Puppeteer MCP: агент открывает интерфейс, создаёт беседу и проверяет ответ. Сквозной сценарий помогает заметить ошибки, которых не видно при чтении кода.
Источник: AnthropicКак новая сессия восстанавливает контекст за несколько шагов
Каждый coding agent начинает не с написания кода, а с ориентации в проекте. Сначала он проверяет текущий каталог командой pwd, затем читает claude-progress.txt, список функций и недавнюю историю git. После этого выбирает самый приоритетный пункт, который ещё не выполнен. Такая последовательность превращает старт новой сессии в повторяемую процедуру вместо свободного исследования репозитория.
Initializer agent заранее создаёт init.sh, который умеет поднять сервер разработки. Поэтому coding agent не тратит каждую сессию на выяснение способа запуска. Anthropic отдельно отмечает, что это экономит токены: инструкция о запуске уже материализована в проекте.
Перед новой функцией агент проводит базовую сквозную проверку уже существующего продукта. В клоне claude.ai он запускал локальный сервер, открывал приложение через Puppeteer MCP, создавал новый чат, отправлял сообщение и проверял получение ответа. Если приложение было оставлено в сломанном состоянии, сначала исправлялась эта проблема. Начать новую функцию поверх уже повреждённой базы означало бы с высокой вероятностью усложнить восстановление. В приведённом в источнике примере после такой проверки агент отдельно отмечает работоспособность основных функций чата, переключения темы, загрузки разговоров и обработки ошибок и только затем переходит к следующему пункту.
- 01
Найти рабочий каталог
Агент запускает pwd и убеждается, где находятся файлы, которые ему разрешено менять.
- 02
Восстановить историю
Читает claude-progress.txt, список функций и последние git-коммиты, чтобы понять недавние изменения и незавершённые задачи.
- 03
Поднять приложение
Использует init.sh, чтобы запустить сервер разработки известным способом, не изобретая процедуру заново.
- 04
Проверить основу
Прогоняет короткий пользовательский сценарий в браузере и сначала исправляет найденную поломку, если она есть.
- 05
Выбрать следующий пункт
Берёт одну наиболее приоритетную функцию со статусом «не пройдено» и только после этого начинает новое изменение.
Четыре типовых сбоя и что делает каждая роль
В конце инженерной части Anthropic сводит подход в четыре повторяющихся сбоя. Здесь полезно разделять ответственность первого и последующих запусков: initializer agent создаёт структуру, а coding agent обязан пользоваться ею и оставлять её актуальной.
Таблицу можно прокрутить по горизонтали.
Эта таблица показывает, что решение строится не вокруг одного «идеального промпта». Устойчивость появляется из сочетания долговременных артефактов, ограниченного объёма изменения, обязательной проверки и дисциплины завершения сессии. Каждый следующий запуск получает не память модели о прошлом, а реконструируемое состояние проекта.
Раздел «Agent failure modes and solutions», таблица от «Claude declares victory…» до «Start the session by reading init.sh».Границы демонстрации и открытые вопросы
Anthropic описывает этот подход как один возможный набор решений для обвязки долго работающего агента, а не как окончательную архитектуру. В материале нет количественного бенчмарка, доли успешно завершённых проектов, сравнения с альтернативной обвязкой или данных о массовом использовании. Поэтому корректный вывод — показан рабочий инженерный шаблон внутреннего эксперимента, а не доказанная универсальная схема для любых долгих задач.
Открыт и вопрос о числе агентов. Авторы не знают, лучше ли один универсальный coding agent проходит все контексты или выгоднее многоагентная архитектура. Они предполагают, что отдельные роли — агент тестирования, контроля качества или очистки кода — могут лучше выполнять соответствующие подзадачи жизненного цикла разработки, но это обозначено как направление дальнейшей работы, а не результат эксперимента.
Наконец, демонстрация оптимизирована под веб-разработку от интерфейса до серверной части. Anthropic считает перспективным перенос идей на другие долгие агентные задачи, например научные исследования или финансовое моделирование, но источник не проверяет эти области. Даже внутри веб-разработки остаются ограничения восприятия и автоматизации браузера, поэтому сквозная проверка снижает часть ошибок, но не покрывает все возможные дефекты.
Раздел «Future work» и заключительные ограничения из раздела «Testing».Итог: как длинная задача переживает смену контекстного окна
Путь команды начинается с простого наблюдения: даже сильная модель и автоматическое сжатие контекста не гарантируют устойчивую разработку через много сессий. В эксперименте агент либо брал слишком большой объём работы, либо позже считал частично готовый проект законченным. Поэтому Anthropic перенесла важное состояние из памяти диалога в сам проект. Перед основной работой initializer agent создаёт полный список функций, init.sh, журнал прогресса и исходную git-историю. Это подготовка среды, а не очередной шаг выполнения пользовательской функции. Отдельного обучения модели в описанном подходе нет.
- 01
Восстановить состояние
Агент читает рабочий каталог, журнал прогресса, список функций и последние коммиты.
- 02
Проверить базовый сценарий
Запускает приложение через init.sh и прогоняет короткую сквозную проверку в браузере.
- 03
Выбрать одну функцию
Берёт приоритетный пункт, который ещё не отмечен как прошедший проверку, вместо попытки закрыть проект целиком.
- 04
Реализовать и проверить
Вносит изменение и проверяет пользовательский сценарий; статус меняет только после подтверждённой работы.
- 05
Оставить чистое состояние
Делает описательный git-коммит и обновляет журнал, чтобы следующая сессия могла продолжить без расследования прошлого.
Главный результат материала — не новая модель, а дисциплина многосессионной работы: явный объём проекта, маленькие изменения, воспроизводимый запуск, проверка глазами пользователя и устойчивые артефакты между контекстами. В демонстрации клона браузерные инструменты помогали находить ошибки, которых не было видно по коду, однако Anthropic не приводит численного выигрыша по качеству, времени или стоимости. Puppeteer MCP также не покрывает все элементы интерфейса, например нативные alert-окна. Остаётся неизвестным, будет ли лучше один универсальный агент или набор специализированных ролей, а выводы пока проверены прежде всего на веб-разработке от интерфейса до серверной части. Поэтому этот материал стоит читать как инженерный шаблон для долгих агентных задач, а не как доказательство массового автономного программирования.
Суммарно: «The long-running agent problem», «Environment management», «Feature list», «Incremental progress», «Testing», «Getting up to speed», «Agent failure modes and solutions», «Future work» и примечание 1.