Разбор готов
Alibaba MUSE: как искать важные события среди 100 тысяч действий пользователя
Покупатель может месяцами смотреть товары, и в его истории накапливаются десятки тысяч действий. Для конкретного рекламного предложения полезна только небольшая часть этой истории. Если брать последние события, можно забыть устойчивый интерес; если подробно обрабатывать всё, ответ станет дорогим. MUSE сначала ищет подходящие события по содержанию товаров, а затем внимательно объединяет найденное с поведенческими признаками. Статья показывает, почему простой поиск оказался достаточным на первой стадии, а более богатая обработка понадобилась на второй. Важно: речь о выборе событий внутри истории пользователя для CTR-ранжирования рекламы Taobao, а не о поиске новых товаров во всём каталоге.
Для инженеров рекомендаций и рекламы, которые работают с длинной историей, редкими товарами, изображениями и текстом. Разбор помогает различать поиск кандидатов каталога и поиск полезных событий для ранжировщика.
Рекомендуем. Лучший следующий кейс, если хочется понять, как использовать длинную историю без полного тяжёлого внимания ко всем событиям.
Публикация · на английском
MUSE: A Simple Yet Effective Multimodal Search-Based Framework for Lifelong User Interest ModelingОткрыть оригинальную статью (PDF)Bin Wu, Feifan Yang, Zhangming Chan и соавторы · Alibaba Group / Wuhan University · Опубликовано: 8 декабря 2025 г.
Два разных поиска внутри рекламной системы
Рекламная система сначала получает кандидатов из большого каталога, затем применяет более дорогой ранжировщик. Для оценки одного кандидата этому ранжировщику нужно понять, какие прошлые действия человека действительно относятся к предлагаемому товару. MUSE решает именно вторую задачу: поиск по уже известной истории человека.
Авторы разделяют её на General Search Unit, GSU, и Exact Search Unit, ESU. Первая стадия быстро выбирает небольшую релевантную подпоследовательность из длинного журнала. Вторая подробно обрабатывает выбранные события для прогноза клика. Поэтому top-K в GSU — это K исторических действий, а не K товаров, которые покажут пользователю.
Обычные векторы ID хорошо отражают накопленные взаимодействия, но у редких товаров данных мало. У давно исчезнувших объектов представления тоже могут быть слабыми. Между тем изображение и название способны показать, что два разных товара близки по назначению. MUSE использует такие признаки содержания, сохраняя поведенческий путь для сигналов совместных взаимодействий.
S2 · §1–2: Introduction и PreliminariesКакие представления товара используют
Изображение и текст товара заранее переводятся в вектор. В статье сравниваются OpenCLIP, I2I и SCL. Последний подход обучает представления с учётом семантики и поведения, например связи поискового запроса с купленным товаром. Поэтому сходство отражает не только визуальное впечатление, но и признаки, важные для выбора товара.
Для MUSE выбран SCL. Эти векторы фиксируются при обучении основной CTR-модели и доступны через поиск в таблице. Это важная граница: рекламный ранжировщик не запускает тяжёлую обработку фотографии заново для каждого кандидата и каждого события. Во время ответа используются заранее подготовленные представления.
В опубликованной проверке более детальные представления особенно важны на стадии ESU. При замене векторов только в быстром поиске разница меньше, чем при замене сразу и в поиске, и в подробной обработке. Следовательно, добавить семантический отбор, а затем снова выбросить семантику — значит потерять часть полезного сигнала.
S2 · §2: Multimodal Representations; §4.1Почему в быстром поиске оставили косинусное сходство
Для данного кандидата система сравнивает его вектор с векторами товаров из истории. По величине косинусного сходства выбираются наиболее подходящие события. В опытах с двухстадийными моделями в ESU передают 50 событий. Например, среди тысяч просмотров можно найти старые взаимодействия с близкими товарами, которые не попали бы в короткое окно последних действий.
Команда попробовала усложнить сходство обучаемым преобразованием и добавить к мультимодальным оценкам оценки по ID. Это не дало убедительного выигрыша, соответствующего дополнительным вычислениям. В таблице 2 простой мультимодальный косинус даёт GAUC 0,6377; обучаемый вариант — 0,6369, а добавление ID-косинуса — 0,6379.
GAUC — вариант AUC, агрегированный по группам пользователей. Здесь он относится к итоговому прогнозу клика после ESU. Таблицы не показывают абстрактную точность ближайших соседей в отрыве от ранжирования. Решение оставить простой GSU основано на качестве всей проверяемой модели при фиксированной второй стадии, а не на тезисе, что обучаемый поиск всегда хуже.
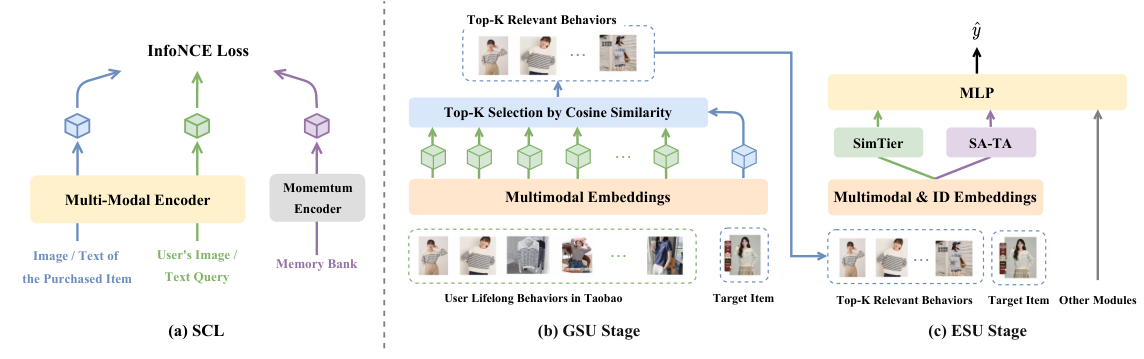
Рисунок 1: замороженные мультимодальные представления помогают отобрать историю, затем SimTier и SA-TA используют найденные события для CTR-прогноза.
Источник: Оригинальная иллюстрация · AlibabaSimTier: вместо большого набора векторов — распределение сходств
После отбора для каждого исторического события уже известно сходство с текущим кандидатом. SimTier рассматривает весь набор таких величин: диапазон от −1 до 1 разбивается на интервалы, и модель считает, сколько событий попало в каждый. Получается компактная гистограмма интереса.
Она отличает ситуацию «много очень близких товаров» от ситуации «несколько слабых совпадений». Два человека могут иметь одинаковое максимальное сходство с кандидатом, но совершенно разную историю в остальных интервалах. Такой набор частот передаёт ранжировщику больше информации, чем один лучший найденный объект.
При этом гистограмма сама по себе не сохраняет порядок событий. Выражение «моделирование последовательности» в статье не означает, что SimTier изучает все временные переходы трансформером. Он сжимает распределение семантического сходства. Это объясняет его сравнительную простоту и одновременно ограничение: временную динамику нельзя автоматически приписывать одному этому вектору.
S4.SS3 · §4.3: Explicit Multimodal Sequence ModelingSA-TA: содержание дополняет поведенческое внимание
Вторая ветвь ESU использует векторы ID товаров. Обычное внимание вычисляет, какие исторические объекты важны для текущего кандидата. Но если ID редкого объекта выучен плохо, такая оценка ненадёжна. SA-TA добавляет к ней семантическое сходство из мультимодальных векторов.
В формуле 4 смешиваются три сигнала: исходная оценка внимания по ID, мультимодальное сходство и их поэлементное произведение. Три коэффициента обучаются. Затем softmax превращает смешанные оценки в веса для объединения поведенческих представлений. Содержание помогает выбрать, на какие события смотреть, а ID-путь сохраняет коллаборативную информацию.
Выход этой ветви объединяют с гистограммой SimTier и передают в сеть прогноза клика. В таблице 3 обычное Target Attention при том же GSU даёт GAUC 0,6301, одна SimTier — 0,6345, а SA-TA вместе с SimTier — 0,6377. Это отдельное отключение компонентов, а не сравнение с промышленным онлайн-вариантом SIM.
S4.SS3 · §4.3: Semantic-Aware FusionКак спрятали передачу длинной истории за другими вычислениями
При истории до 100 тысяч событий важной проблемой становится передача векторов из удалённого хранилища. Но загрузка истории не зависит от того, какие кандидаты в итоге найдены: пользователь уже известен в начале запроса. Поэтому MUSE запускает получение истории параллельно со стадией подбора кандидатов.
GSU-сервис заранее получает историю и мультимодальные векторы и сохраняет их в GPU-памяти. После появления кандидатов остаётся посчитать сходства, выбрать события и выполнить ESU. Авторы пишут, что предварительная загрузка обычно завершается раньше подбора кандидатов, поэтому её задержка перекрывается другой работой.
Это не означает нулевой стоимости длинной истории. Нужны память, сеть и управление актуальностью представлений; просто часть времени убрана из последовательного критического пути ответа. Если в другой системе отбор кандидатов очень короткий, сеть медленнее или история не помещается в память, тот же приём может не скрыть все расходы.
- 01
Пользователь известен
Начинаются подбор кандидатов и независимая загрузка его истории.
- 02
История подготовлена
Векторы событий находятся в GPU-памяти до подробного ранжирования.
- 03
Кандидат известен
GSU выбирает похожие исторические события под конкретный товар.
- 04
Получен прогноз
SimTier и SA-TA создают признаки интереса для CTR-модели.
Какие сравнения проводились на 5K и 1K событий
Промышленный набор содержит неделю показов: шесть дней используют для обучения, последний — для теста. В таблице 4 указаны 3,71 млрд примеров и максимальная история 100K. Но для основного офлайн-сравнения таблицы 5 историю намеренно обрезают до 5K, чтобы ускорить эксперименты. В открытом наборе предел — 1K.
Таблицу можно прокрутить по горизонтали.
У сравнений есть тонкости реализации. SIM-Hard и SIM-Soft используют тот же усиленный ESU, что MUSE; для TWIN сохраняют его специальное внимание и добавляют SimTier; MISS оставляют с ID-only ESU. Поэтому таблица не является сравнением неизменённых библиотечных реализаций всех методов. Авторы раскрывают эти решения, и их важно учитывать при воспроизведении.
Открытый набор содержит подготовленные 128-мерные SCL-векторы, но не исходные фотографии и названия товаров. В версии v1 числа размера открытого набора в таблице 4 и описании §6.2 расходятся. Поэтому для практики стоит проверять актуальную карточку набора и файлы, а не переносить одну из этих величин в доказанный масштаб.
S7.SS2 · §6–7.2, таблицы 4–5Что означает результат на истории 100K
В отдельной офлайн-проверке расширение истории MUSE с 5K до 100K улучшило GAUC на 0,38% в обозначениях авторов. Онлайн-система сравнивалась уже с промышленным SIM, у которого история ограничивалась 5K. При запуске MUSE-100K авторы сообщают о +12,6% CTR, +5,1% RPM и +11,4% ROI.
CTR отражает частоту кликов, RPM — рекламный доход на тысячу показов, ROI — возврат рекламных вложений в используемом авторами определении. Проценты относятся к рекламной системе Taobao. Их нельзя переименовывать в прирост покупок, общей выручки платформы или результатов поиска.
Онлайн-выигрыш включает и изменение архитектуры, и увеличение доступной истории. Из таблицы 6 нельзя выделить, какая доля прироста связана только с SCL, SimTier или числом событий. Для компонентов полезны отдельные офлайн-отключения; A/B подтверждает работоспособность всей промышленной конфигурации.
Разбиение по группам показывает более сильный офлайн-выигрыш для пользователей с длинной историей и менее популярных товаров. Это согласуется с мотивацией метода, но не доказывает качество для человека без истории. Полностью отсутствующие события и плохо представленные старые события — разные проблемы.
S7.SS5 · §7.3–7.5 и таблица 6Что даёт содержательное сходство и что проверить у себя
В приложении авторы показывают, что разные GSU находят разные исторические товары. Примеры полезны для диагностики смысла вектора: близость должна отражать признаки, связанные с покупательским интересом, а не только фон картинки или случайное совпадение категории. Но отдельная удачная картинка не заменяет измерение качества на всём наборе.
При переносе MUSE полезно отдельно проверить два выбора: какие события попали в короткую историю и как ранжировщик их использовал. Если хорошие события уже отобраны, улучшение ещё одного сложного поиска может быть менее полезным, чем сохранение семантической информации на второй стадии. Именно это различие подтверждают основные эксперименты статьи.
Сравните MUSE с LUM, где большая модель создаёт дополнительные признаки для существующего ранжировщика, и с Feed SR, где основой становится сама последовательность показов и действий. У MUSE другая граница: подробная модель получает маленькую выбранную часть очень длинной истории, зависящую от кандидата.
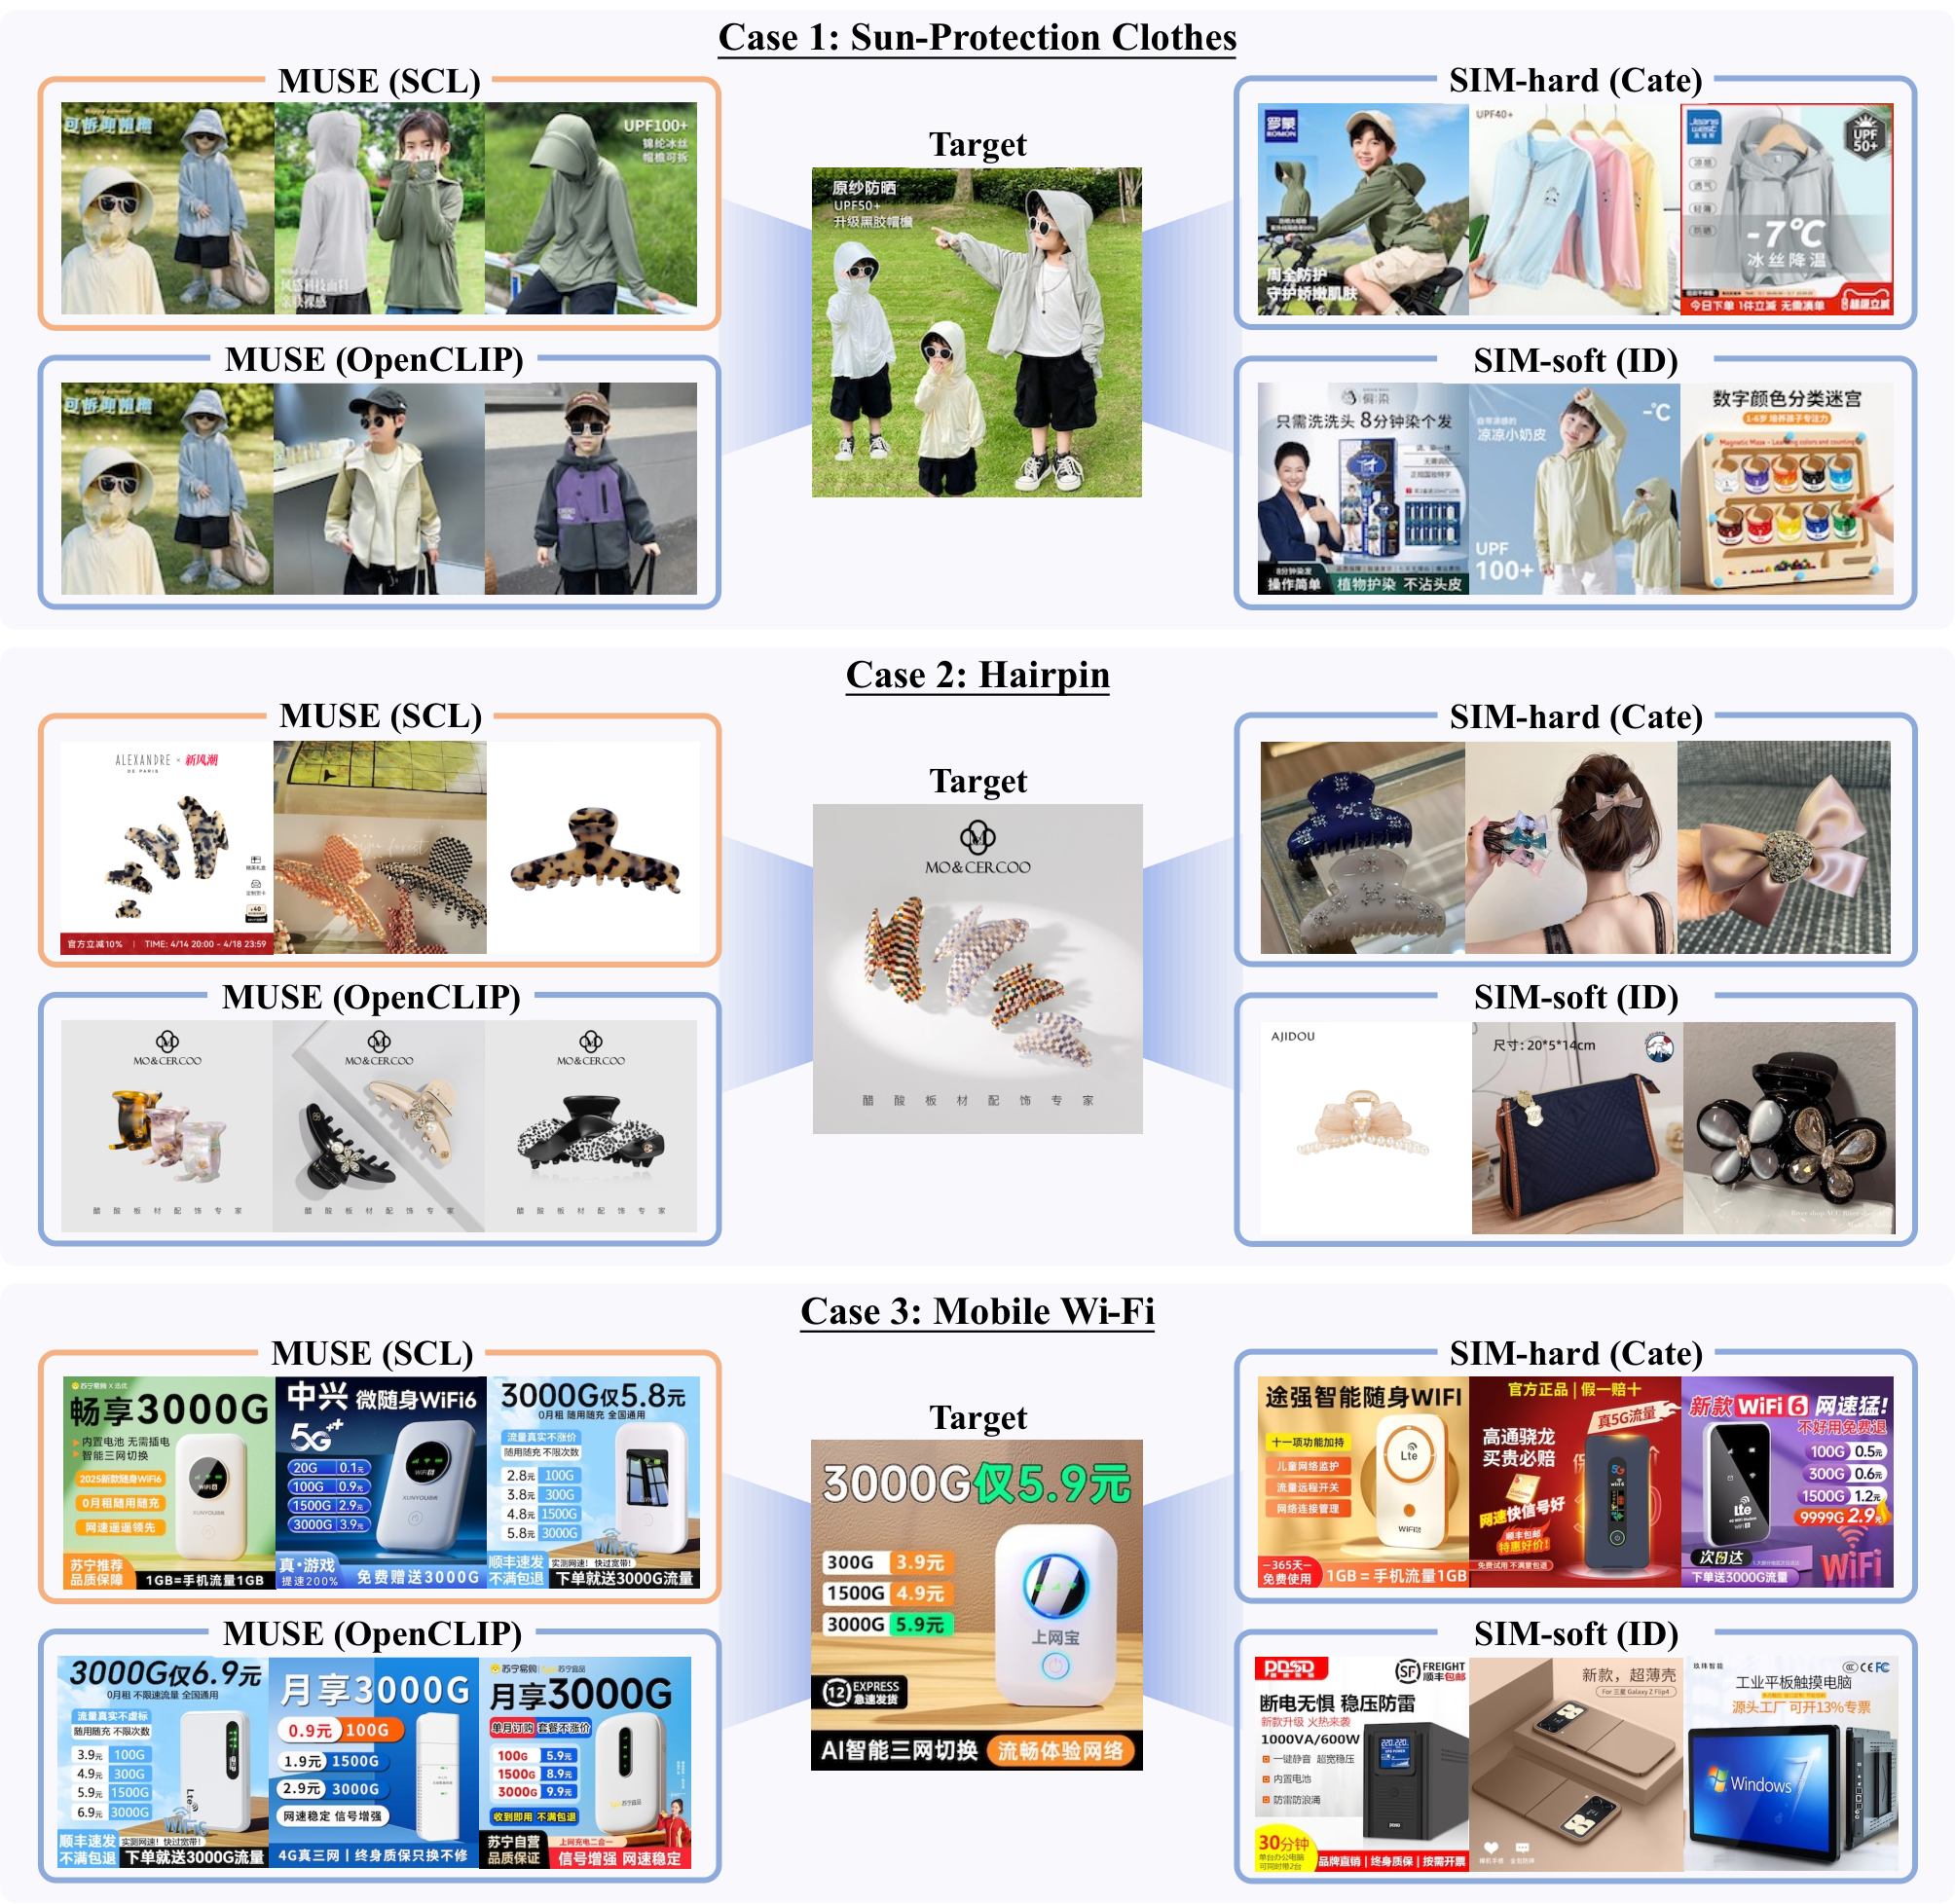
Рисунок 7 из приложения: примеры различий в исторических товарах, найденных разными GSU. Это качественная иллюстрация, а не самостоятельный A/B-результат.
Источник: Оригинальная иллюстрация · Alibaba