Как Grab построил собственную vision LLM для обработки документов
Grab извлекает данные из удостоверений, водительских прав и регистрационных документов на разных языках Юго-Восточной Азии. Авторы последовательно описывают выбор модели, подготовку данных, неудачи LoRA и собственную компактную архитектуру.
Статья · на английском
How we built a custom vision LLM to improve document processing at GrabJia Chen, Manish Sahu, Sing Kwan Ng, Yang Yang · Опубликовано: 4 ноября 2025 г.
Почему прежних решений не хватало
Обычное OCR плохо справлялось с разнообразием шаблонов. Внешние LLM ошибались и отвечали медленно; открытые модели не давали нужного качества. Основой выбрали Qwen2-VL 2B с поддержкой переменного разрешения.
Разрешение изображения важно именно для мелкого текста: жёсткое уменьшение или обрезка может испортить символы ещё до распознавания. При выборе Qwen2-VL учитывали также размер, позволяющий полностью дообучать модель на доступных GPU, и эффективность токенизации тайского и вьетнамского текста.
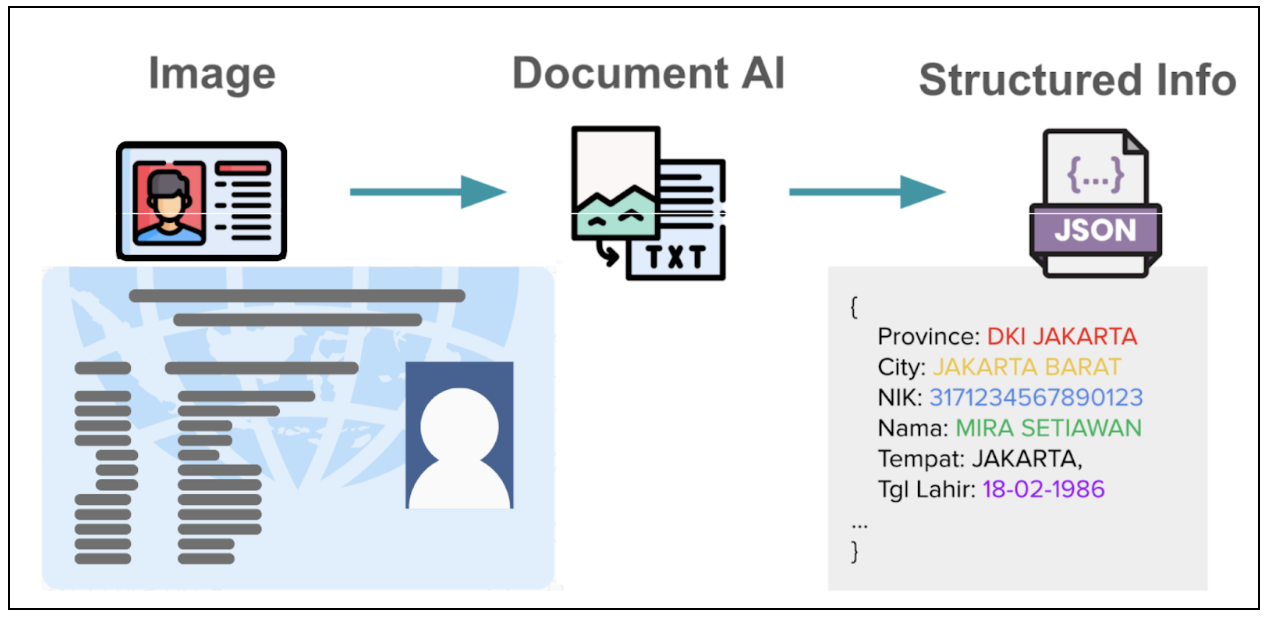
Изображение документа → извлечение информации → структурированный ответ. Figure 1 из статьи Grab.
Источник: Grab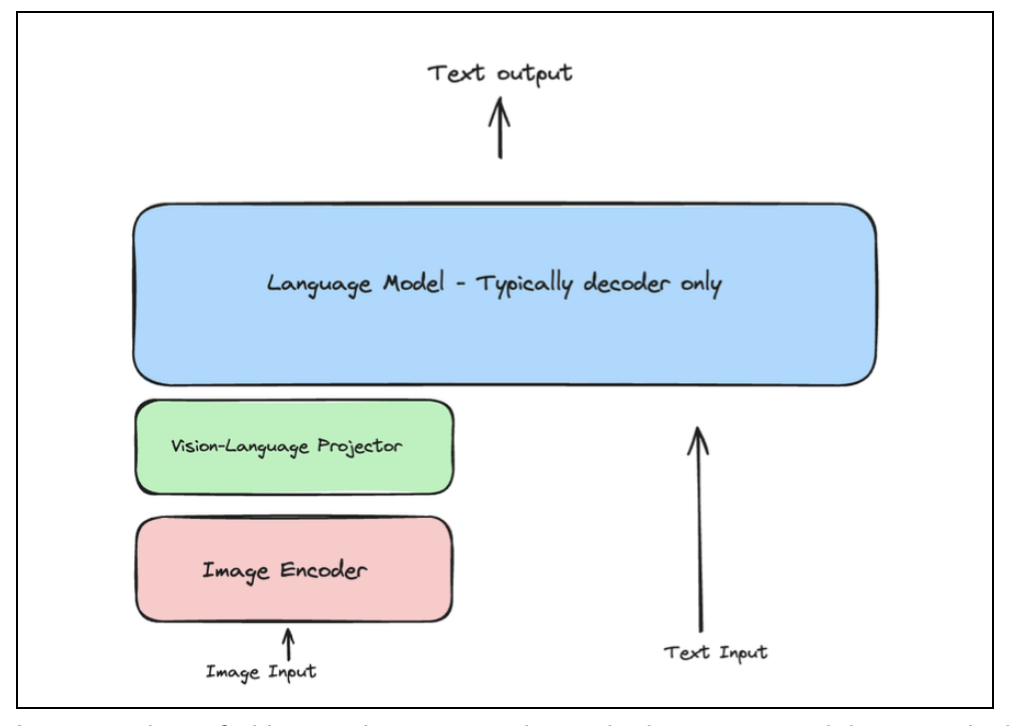
Три части Vision LLM: обработка изображения, проектор и языковая модель. Figure 2 из статьи Grab.
Источник: GrabПодготовка данных
Тексты на нужных языках превращали в синтетические изображения. Внутренняя система Documint находила документ, исправляла ориентацию, распознавала текст и извлекала поля. Автоматическую разметку проверяли люди.
Синтетический набор строили из текстов Common Crawl на индонезийском, тайском, вьетнамском и английском. Меняли шрифты, фон и искажения. Documint отдельно готовил разметку реальных документов: от выделения области и исправления поворота до распознавания строк и преобразования полей в JSON.
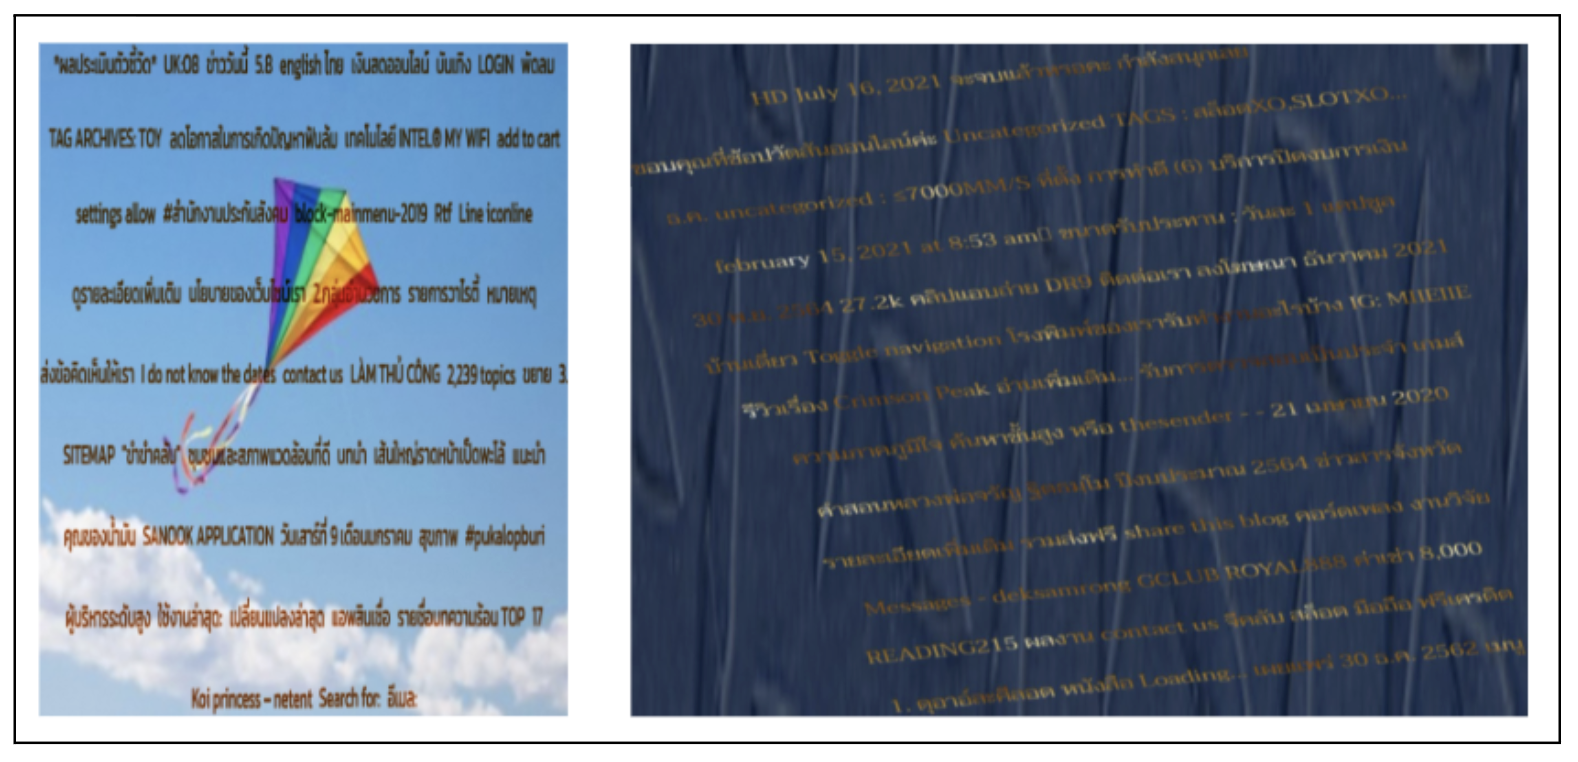
Синтетические примеры тайского текста, использованные для обучения. Figure 3 из статьи Grab.
Источник: Grab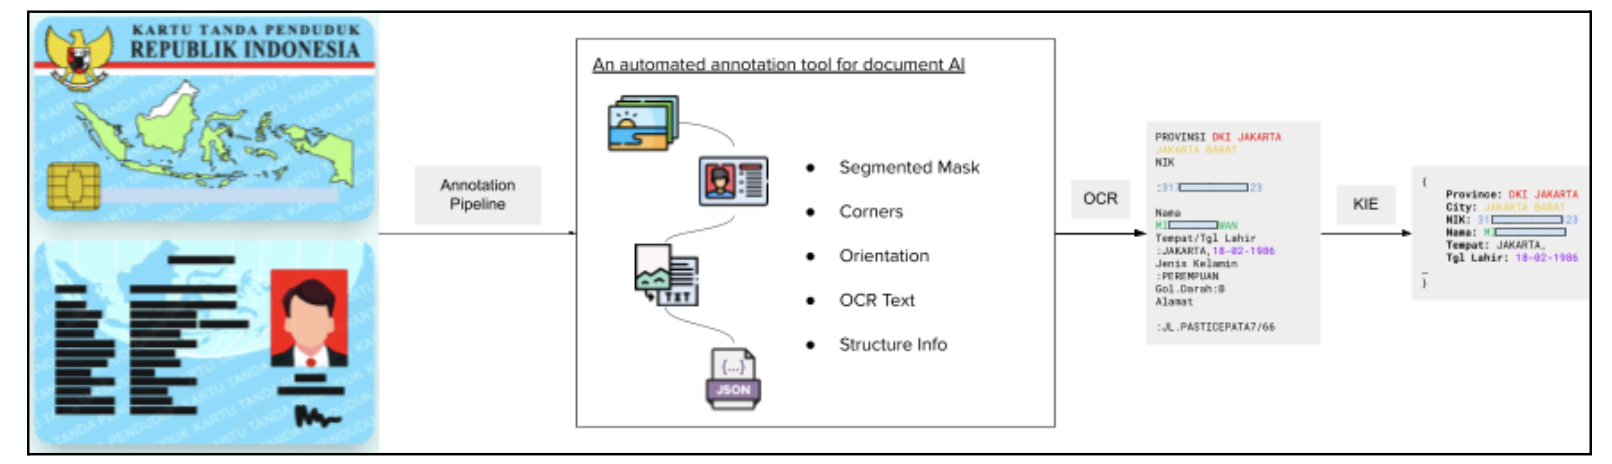
Подготовка разметки документов в Documint. Figure 4 из статьи Grab.
Источник: GrabПервый этап: LoRA
LoRA-настройка помогла с индонезийскими документами, но оставила проблемы с тайскими, вьетнамскими и плотным мелким текстом. Авторы связывают это с недостатком нужной письменности при обучении зрительной части.
Читать в оригиналеВторой этап: полное дообучение
Сначала зрительные компоненты обучали на синтетическом OCR, затем всю модель — на документах. Точность полей выросла относительно baseline на 70 процентных пунктов для тайских документов и на 40 для вьетнамских.
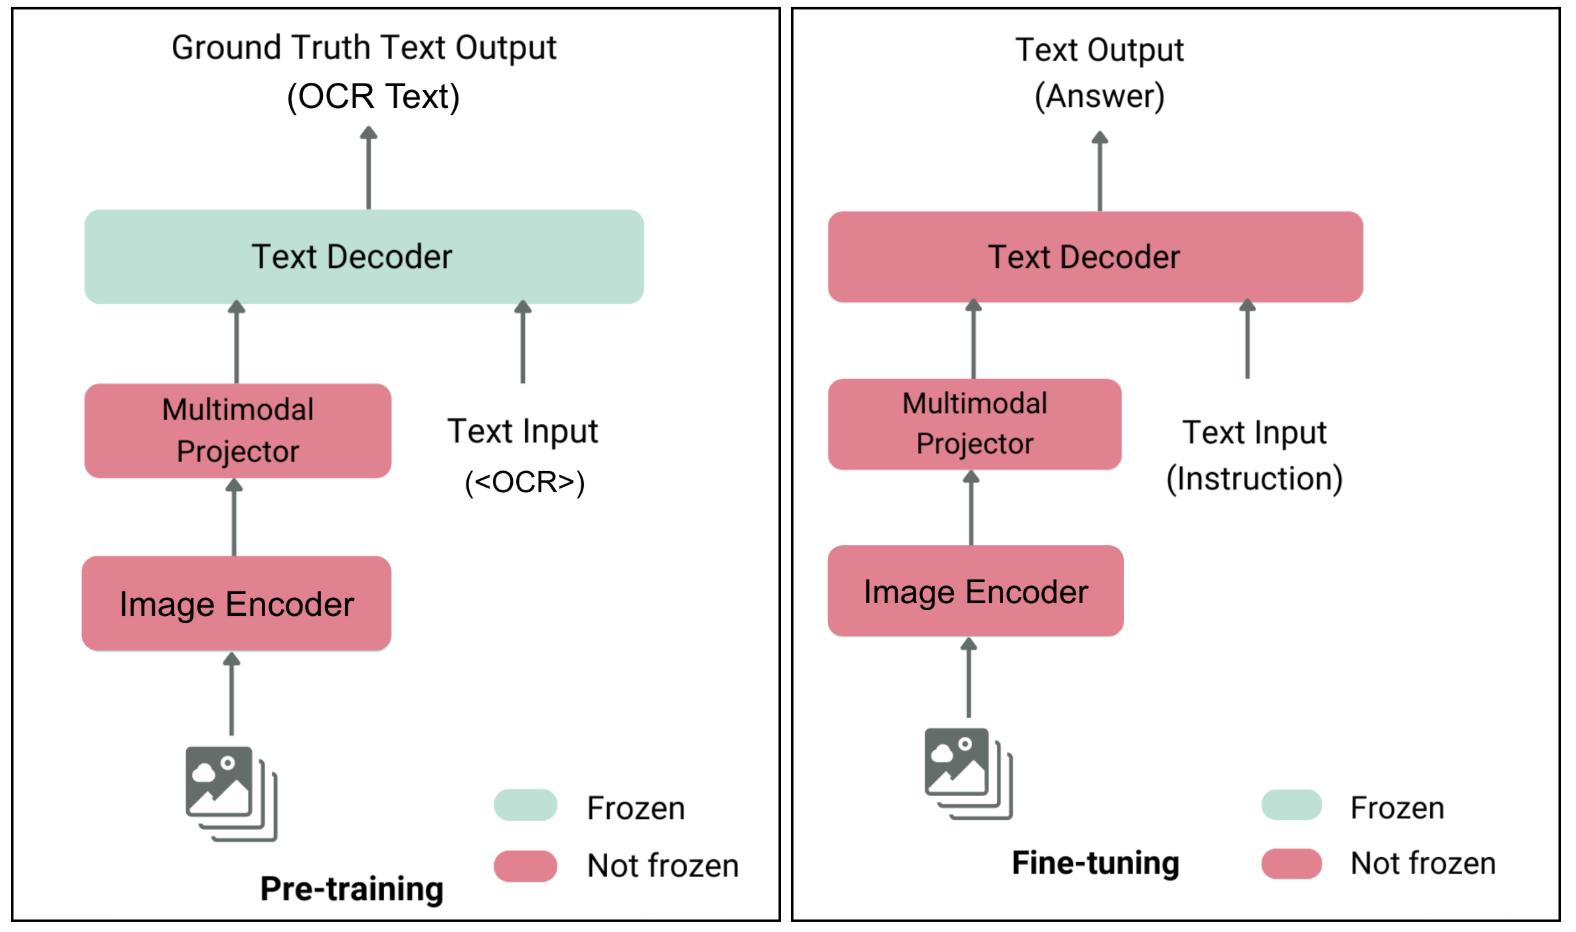
Два этапа обучения: зрительные компоненты, затем вся модель. Figure 5 из статьи Grab.
Источник: Grab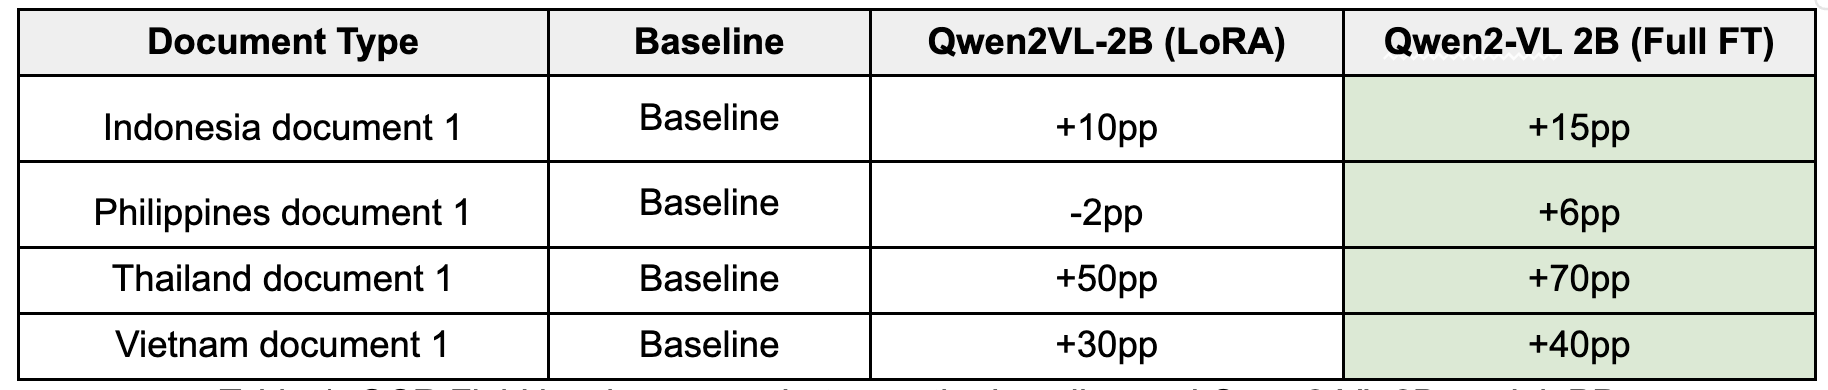
Исходная таблица Grab: изменение точности полей относительно baseline; pp — процентные пункты.
Источник: GrabТретий этап: собственная модель около 1B
Зрительную часть Qwen2-VL 2B соединили с Qwen2.5 0.5B через новый проектор. Обучение включало согласование частей, общие зрительные задачи, нужную письменность и конкретные документы.
Сначала обучали новый проектор, соединяющий зрительную и языковую части. Затем улучшали зрительную часть на общих задачах: вопросы к изображению, распознавание текста и описания. После этого добавляли синтетические примеры нужных письменностей и лишь в конце дообучали все параметры на целевых документах. Таким образом, компактность не достигалась одним удалением слоёв: новую комбинацию компонентов последовательно согласовывали и адаптировали.
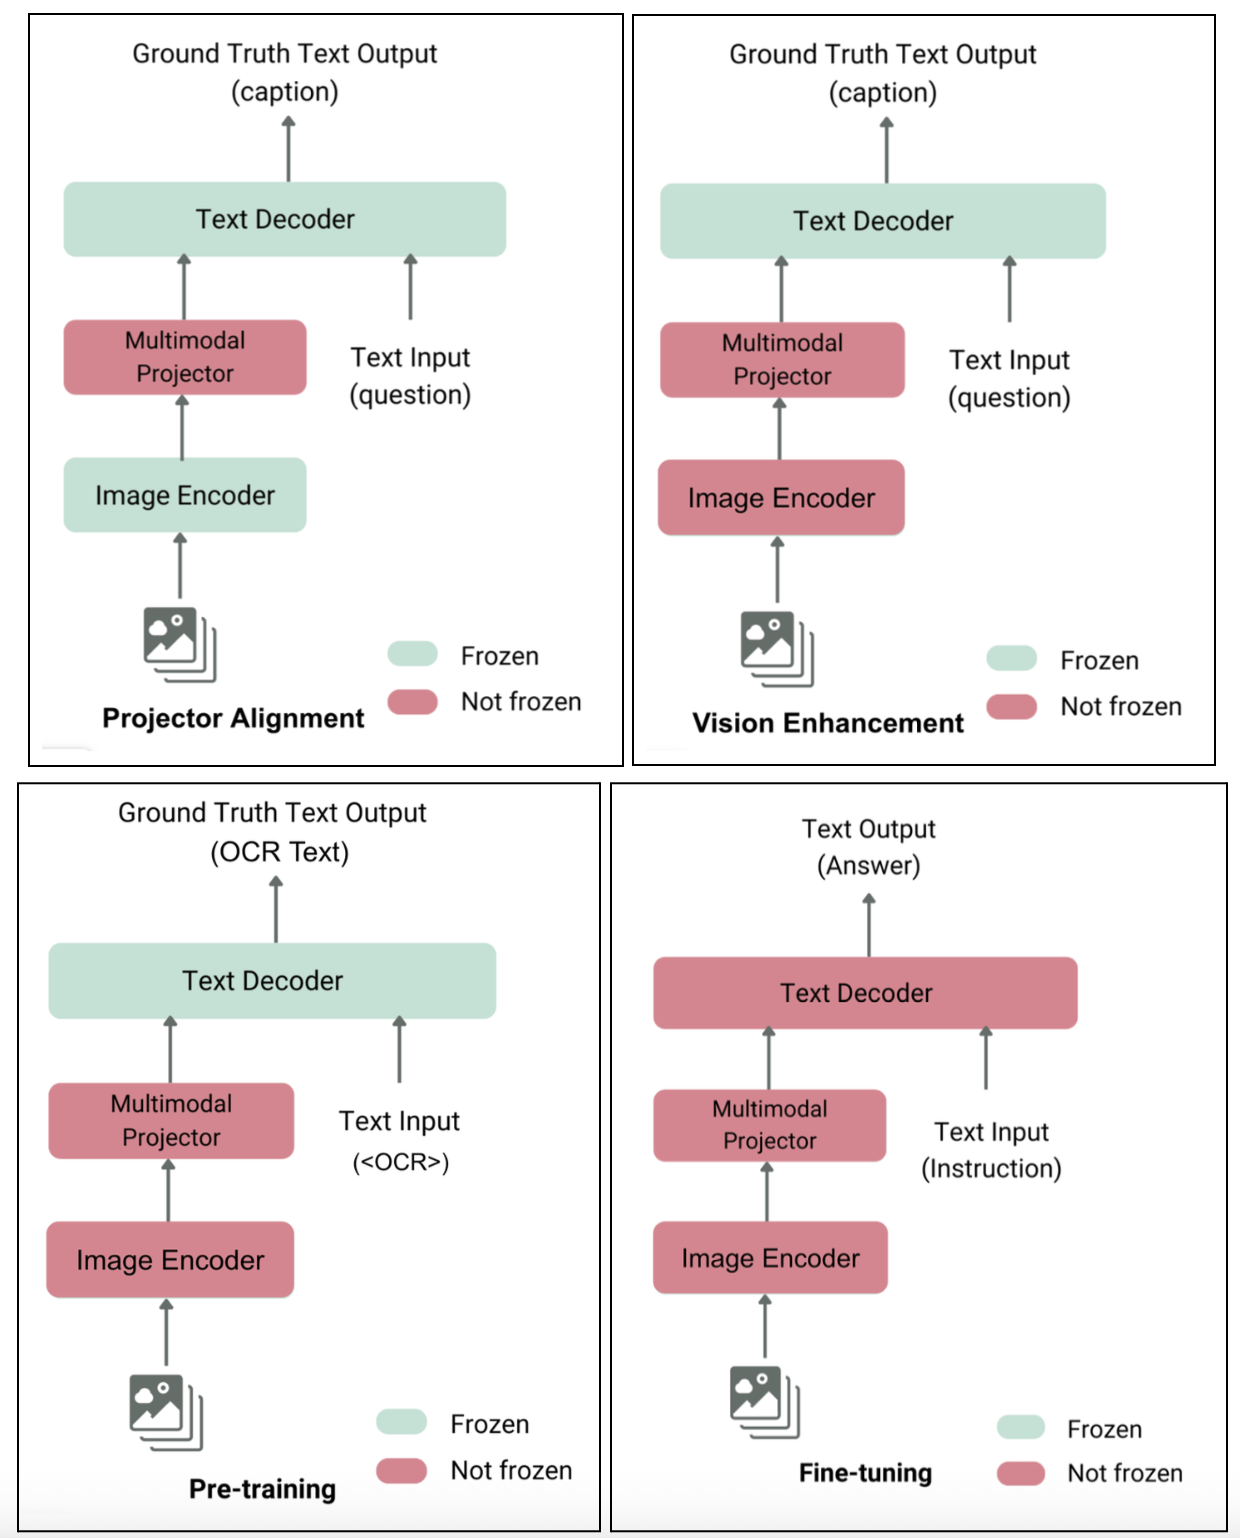
Четыре этапа обучения собственной модели. Зелёным отмечены замороженные компоненты, красным — обучаемые. Figure 6 из статьи Grab.
Источник: GrabРезультат и дальнейшая работа
На большинстве типов документов точность оказалась в пределах 3 процентных пунктов от 2B при меньшей задержке. Далее команда планирует расширять поддержку языков и типов документов.
Авторы отдельно обсуждают редкие медленные ответы внешних API: задержка P99 у них могла в 3–4 раза превышать P50. Для массовой проверки документов важна и эта нестабильность. Опубликованная таблица содержит нормированные задержки; абсолютное время ответа из неё восстановить нельзя. Вывод о преимуществе полного дообучения относится к этому набору документов и языков.
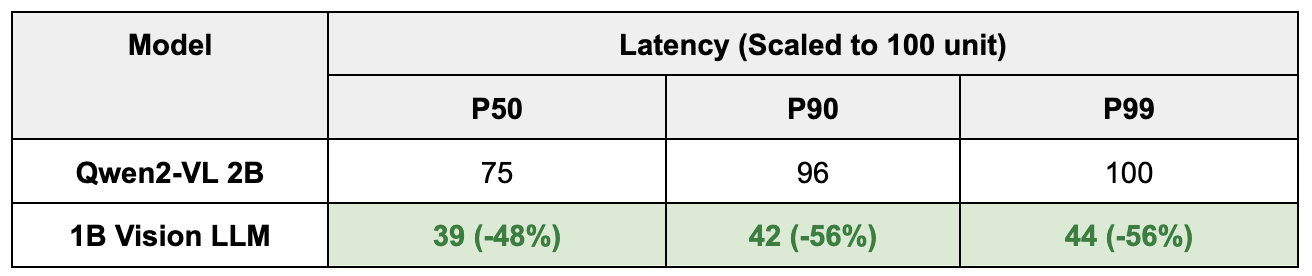
Таблица задержек из статьи Grab: значения нормированы, это не миллисекунды.
Источник: Grab