Разбор готов
Alibaba LUM: как большая модель пользователя усиливает привычный ранжировщик
У рекламного ранжировщика за годы накапливаются полезные признаки, обученные параметры и правила работы с бизнес-целями. Большая последовательная модель обещает лучше понимать историю, но полная замена проверенного ранжировщика может потерять эти преимущества и не уложиться в задержку. Alibaba предложила другой путь: отдельно обучить Large User Model, запросить у неё интересы под нужные условия и передать результат существующей модели. Разбор основан на версии v2 статьи, обновлённой в январе 2026 года. Она описывает три стадии, особую постановку обучения, совместный расчёт нескольких условий, промышленный кеш и эксперименты в рекламном поиске Taobao.
Для инженеров, которые хотят использовать большие модели поведения в зрелом поиске или рекламе без полной замены действующего ранжирования.
Рекомендуем. Читайте как альтернативу полной генеративной замене каскада: LUM усиливает существующий ранжировщик и сохраняет его самостоятельную роль.
Публикация · на английском
Unlocking Scaling Law in Industrial Recommendation Systems with a Three-step Paradigm based Large User ModelОткрыть оригинальную статью (PDF)Bencheng Yan, Shilei Liu, Zhiyuan Zeng и соавторы · Alibaba Group · Опубликовано: 12 февраля 2025 г.
Почему хорошее предсказание истории не равно хорошему CTR
При генеративном обучении модель старается объяснить, какие действия встречаются в истории. Рабочий рекламный ранжировщик решает более узкую задачу: оценить вероятность клика по конкретному товару при конкретном запросе. Такая вероятность должна быть полезна и для порядка выдачи, и для дальнейших рекламных расчётов. Успех в восстановлении последовательности не гарантирует нужной калибровки этих вероятностей.
Есть и практические ограничения. Производственная модель постоянно дообучается на потоке данных и использует множество актуальных признаков. Более тяжёлый кодировщик истории может не обработать дневной поток вовремя или не успеть ответить в отведённый срок. А перенос всех признаков и правил в новую архитектуру требует отдельной работы.
LUM не пытается доказать, что такие требования неважны. Напротив, три стадии сохраняют отдельную быструю модель решения и используют большую модель для подготовки полезного знания о пользователе. Слово «knowledge» в статье означает обученные поведенческие представления, а не текстовую базу фактов и не RAG по документам.
S1 · §1: IntroductionТри стадии вместо единственного большого ранжировщика
- 01
Построить модель поведения
Авторегрессионный трансформер учится на истории пользователя с условиями взаимодействий.
- 02
Запросить интересы
История дополняется условием: например, поисковым запросом, категорией или поверхностью продукта.
- 03
Принять решение
Полученные представления и сходства становятся признаками традиционной модели отбора или CTR-ранжирования.
Первая стадия отвечает за дорогое обучение LUM. Вторая получает из неё представления интересов для нужного контекста. Третья использует их вместе с обычными признаками пользователя, товара и запроса. Эти части могут обновляться и вычисляться по разным расписаниям.
Таким образом, LUM не обязана сама выдавать окончательный порядок рекламных объявлений. В промышленном примере итоговую оценку по-прежнему рассчитывает зрелый DLRM — нейросетевая модель рекомендаций на признаках. Это позволяет сохранить накопленные параметры, инженерные сигналы и привычный способ быстрых обновлений.
Рисунок 3: предварительное обучение LUM, запрос интересов по условиям и использование полученных представлений в модели отбора или ранжирования.
Источник: Оригинальная иллюстрация · AlibabaЧто означает токен условия
Обычная последовательная модель видит цепочку объектов и предсказывает следующий. В LUM каждому объекту предшествует токен условия. Например, просмотр товара мог произойти в поиске, после определённого запроса или на конкретной поверхности. История записывается чередованием «условие → объект → условие → объект».
Токен условия собирается из структурированных признаков: ID сценария, представления поискового текста и другой доступной контекстной информации. Это не обязательно текстовый prompt, который вводит человек. Сравнение с prompt engineering у авторов помогает понять управляемость запроса, но технически модель получает векторы признаков.
Условие позволяет различать разные значения одной истории. Интерес человека в главной ленте и при поиске «платья» не обязан совпадать. Во время применения можно добавить нужное условие и получить представление именно для него, а не один неизменный вектор пользователя на все задачи.
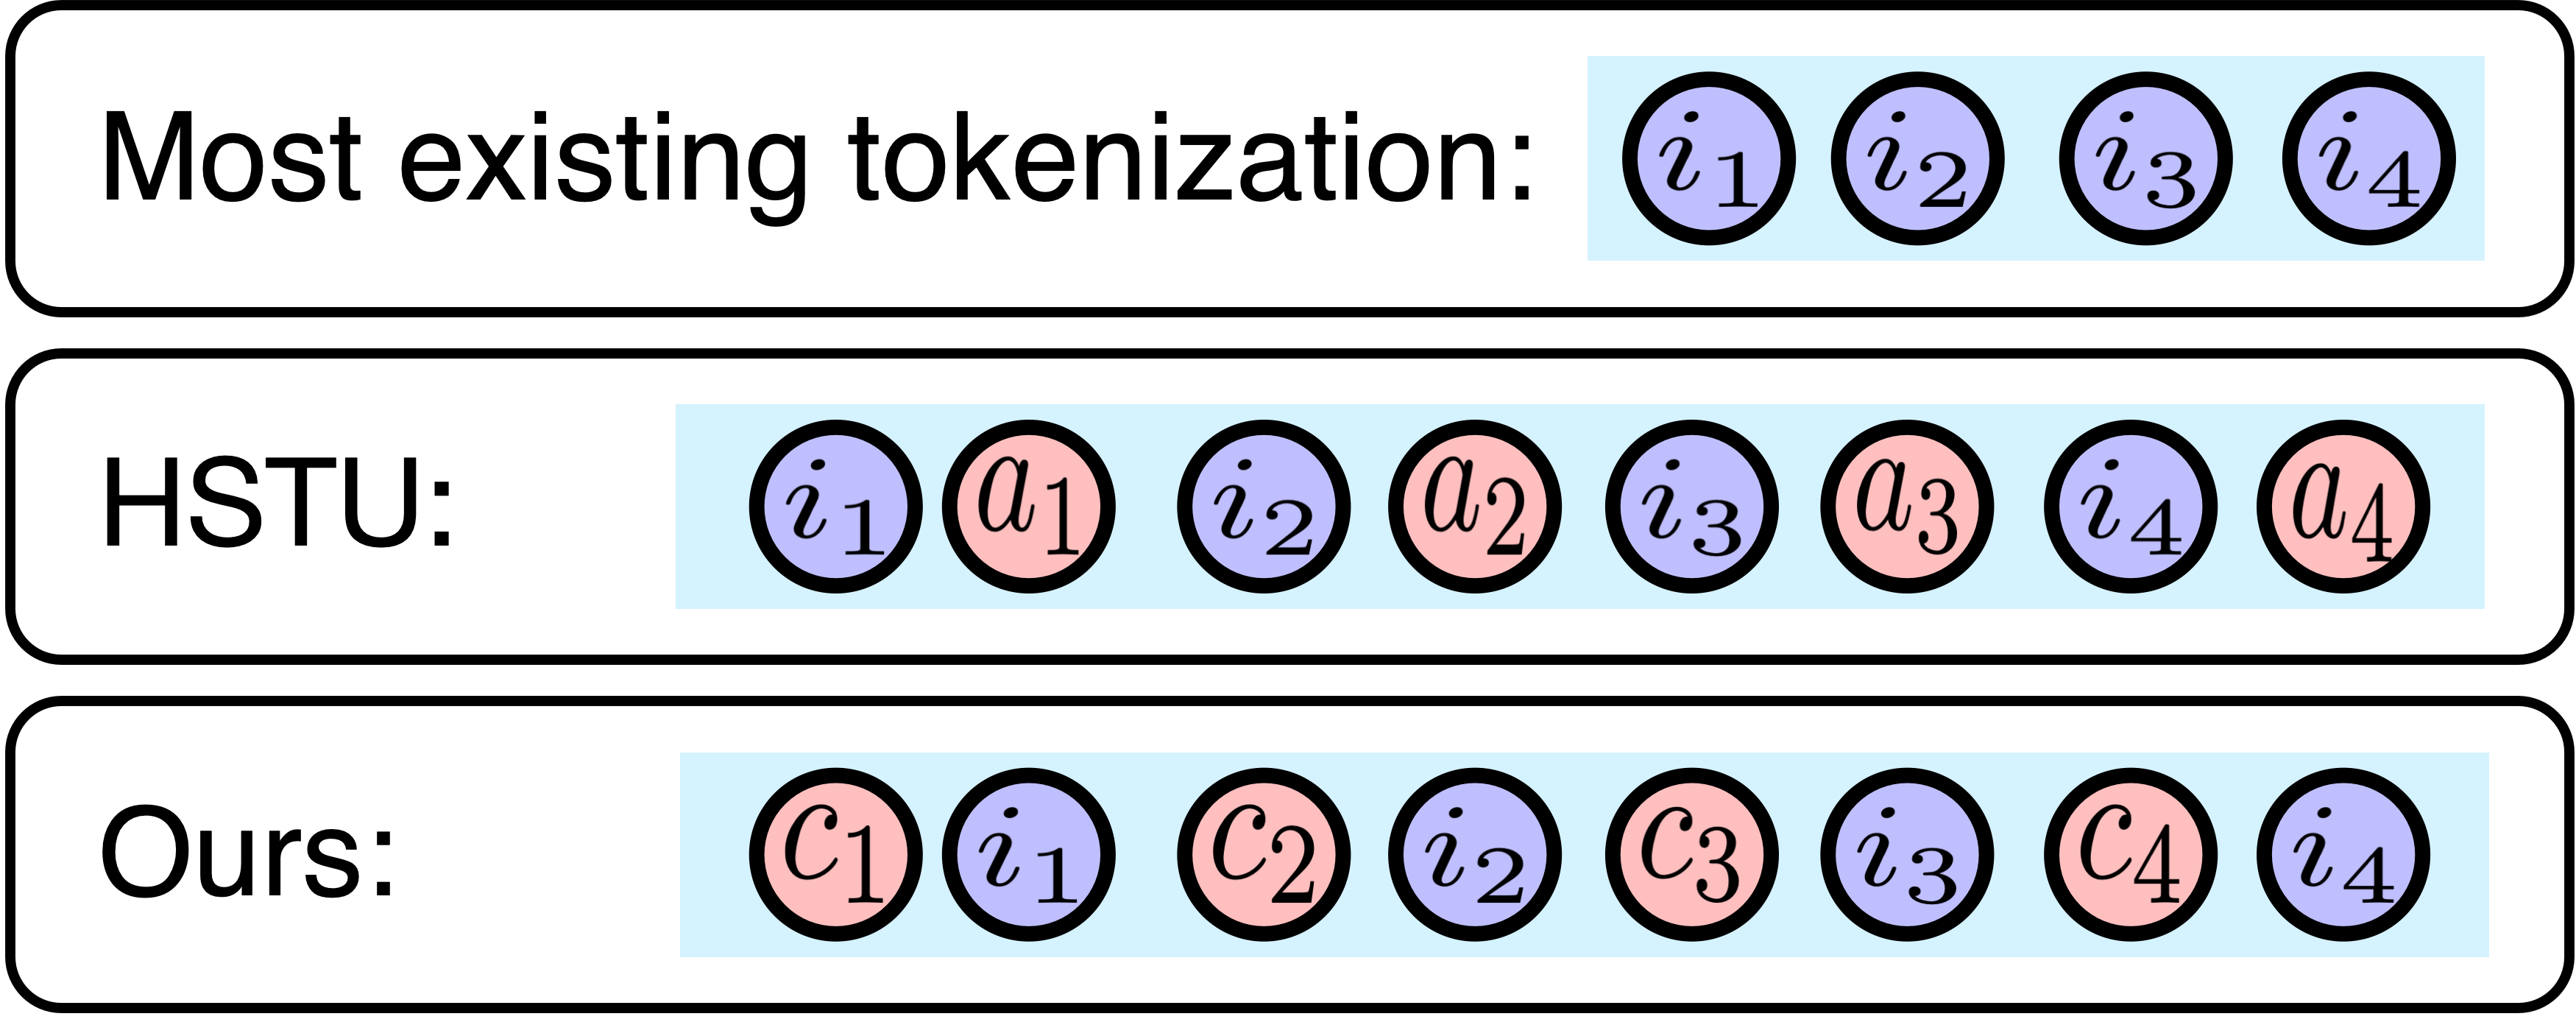
Рисунок 2: LUM вставляет условие перед объектом. Цель обучения — следующий объект при известном условии, а не текстовое продолжение запроса.
Источник: Оригинальная иллюстрация · AlibabaКак обучают LUM на большом словаре товаров
Признаки объекта и условия проходят через отдельные преобразования в общее векторное пространство. Затем последовательность обрабатывает обычный авторегрессионный трансформер. Функция потерь применяется к выходу позиции условия, чтобы приблизить его к представлению следующего правильного объекта.
Полный расчёт вероятности по каталогу в миллиарды объектов был бы дорогим. Поэтому используют контрастивную функцию InfoNCE: правильный объект сравнивается с отрицательными объектами из того же пакета обучения. Негативы здесь — другие объекты пакета, а не список заведомо отвергнутых конкретным пользователем товаров. Это важное различие для интерпретации обучающей задачи.
Чтобы короткие истории не оставляли большую часть входа пустой, несколько историй упаковывают в одну вычислительную последовательность. Такой packing повышает использование ресурсов. При воспроизведении нужно сохранять границы пользователей в логике внимания: объединённый буфер данных не должен превращаться в общую историю разных людей.
В таблице 6 время обработки дневного объёма на первой стадии снижается со 151 до 26 часов при packing. Это измерение конкретной стадии и конфигурации. Оно не означает, что полный выпуск большой модели на любом объёме данных всегда укладывается в сутки.
S4.SS1.SSS3 · §4.1.2–4.1.3Несколько вопросов к одной истории можно задать совместно
Одному человеку можно поставить несколько условий: интерес в поиске, на главной, в определённой категории. Если каждый раз запускать модель заново, общая история будет многократно пересчитана. LUM объединяет условия в один запрос к общему префиксу истории.
При этом условия не должны обмениваться информацией друг с другом. Специальная маска внимания разрешает каждому из них использовать общую историю, но закрывает взаимные зависимости между условиями. Так общие вычисления выполняются один раз, а полученные представления остаются привязанными к собственным вопросам.
По таблице 6 время второй стадии для дневных данных сокращается с 17 до 3,6 часа. В тексте это обозначено как улучшение на 78%. Корректнее понимать его как уменьшение времени выбранной операции, а не ускорение всего сервиса рекомендаций на 78%.
S4.SS2 · §4.2 и рисунок 4Как знания LUM становятся признаками обычной модели
Авторы используют два способа передачи результата. Первый — напрямую добавить полученные представления интересов и представление товара к входу модели. Второй — заранее посчитать сходство каждого интереса с конкретным товаром и дать ранжировщику эти оценки как дополнительные признаки.
В отборе кандидатов такие признаки можно встроить в пользовательскую и товарную башни. В CTR-ранжировании они дополняют уже существующие числовые, категориальные и поведенческие сигналы. Поскольку последнее решение остаётся за прикладной моделью, она может учиться на задаче клика, а не только на восстановлении истории.
Отключения в таблице 5 показывают, что условия и способ использования представлений имеют самостоятельное значение. Вариант без токена условия даёт AUC 0,7416, а основной LUM — 0,7514. Только прямые дополнительные признаки дают 0,7402; признаки вместе со сходствами интересов — 0,7514. Сравнение относится к указанному обучению с нуля, а не к сильнейшей перенесённой промышленной модели.
S4.SS3 · §4.3: Knowledge UtilizationОнлайн-запрос, кеш и обучение образуют общий цикл
В sponsored search Taobao расчёт интересов запускается рано: параллельно с отбором кандидатов и предварительным ранжированием. К тому моменту, когда требуется окончательная CTR-оценка, результаты второй стадии стараются уже положить в централизованный кеш. Это отделяет тяжёлый расчёт истории от короткого завершающего этапа.
Кеш хранит и свежие результаты, и заранее рассчитанные офлайн-интересы как запасной вариант при жёстком ограничении времени. Ранжировщик получает представления из кеша, использует их для решения и записывает в журналы. Затем при своём потоковом обучении он читает именно эти записанные признаки, не запуская LUM заново на каждый обучающий пример.
LUM обучается параллельно с прикладной моделью. После обновления её новая версия создаёт новые признаки в онлайн-системе, и они постепенно попадают в последующие обучающие данные ранжировщика. Это сохраняет соответствие использованных интересов между моментом показа и обучением по журналам.
Для переноса такого решения важны версия признаков, время их доступности, свежесть кеша и поведение при недоступности большой модели. Статья описывает архитектурный запасной путь, но не публикует полную конфигурацию сроков хранения и всех эксплуатационных ограничений.
S4.SS4 · §4.4: Industrial DeploymentС чем сравнивали качество и какую стоимость посчитали
Эксперименты включают публичные наборы и промышленный набор Taobao. В основном сравнении на промышленном наборе используют историю 4096, сопоставимые трансформерные модели примерно на 0,3 млрд параметров и одинаковые признаки при обучении с нуля. LUM показывает AUC 0,7514 против 0,7338 у исходной модели; для сильных вариантов с переносом признаков и параметров сравнение уже другое: 0,7794 против 0,7777.
Последняя пара особенно важна. Если сравнить новую модель со слабой версией старой, обученной с нуля, можно преувеличить практический выигрыш. В зрелом продукте накопленные признаки и параметры имеют самостоятельную ценность. Статья не ограничивается одним исходным вариантом и показывает, как меняется результат после их сохранения.
В опытах стоимости задан бюджет менее 30 мс на ранжирование 100 кандидатов. Для LUM авторы измеряют только LUM-Step3: получение интересов считается отдельно или перекрывается другими работами и кешем. Поэтому стабильная задержка Step3 при росте размера LUM не доказывает бесплатности предварительного обучения и извлечения интересов.
Аналогично сравнение скорости потокового обучения охватывает заключительную стадию LUM против полного E2E-GR. Это полезное измерение ограничения прикладной модели, но для экономики продукта нужно дополнительно учитывать GPU, хранение и обновления первых двух стадий.
S5 · §5.1–5.5, таблицы 3 и 5–6Онлайн-результат и нерешённые вопросы
Таблицу можно прокрутить по горизонтали.
В ранее найденных китайских пересказах встречались другие рекламные показатели. Этот разбор фиксирует версию v2 первичной статьи и использует её CTR и RPM. Это позволяет не смешивать обновления модели, разные рекламные поверхности и разные даты публикаций.
Новые поисковые тексты могут частично обрабатываться через обобщение текстовых признаков. С совершенно новым ID сценария или категории сложнее: условие ещё не получило надёжного представления. Авторы прямо оставляют холодный старт условий за пределами основного исследования. Поэтому гибкость структурированного условия не означает, что любой новый продукт подключается без данных и обучения.
Сравните LUM с OneRec и MUSE. OneRec объединяет выбор списка в генерации; LUM сохраняет обычный ранжировщик; MUSE выбирает релевантные события внутри истории. Все три используют поведение человека, но заменяют разные части системы и требуют разных проверок.
S5.SS6 · §5.6: Online Results; ограничения §4.2