Разбор готов
Kuaishou OneRec: от каскада ранжирования к генерации списка видео
Когда пользователь обновляет ленту коротких видео, система обычно сначала отбирает кандидатов, затем применяет дешёвое и дорогое ранжирование. Хороший ролик, потерянный на ранней стадии, уже не вернётся в выдачу. OneRec исследует более радикальный путь: одна модель по истории человека генерирует сразу список идентификаторов видео. Чтобы список был полезным, ей недостаточно повторять наблюдавшиеся сессии — нужна отдельная настройка предпочтений. Этот разбор фиксирует исходную статью v1 от 26 февраля 2025 года: семантические коды, генерацию сессий, модель награды, итеративное обучение и онлайн-тест. Более поздние работы семейства OneRec не считаются автоматически частью этого эксперимента.
Для инженеров, знакомых с двухстадийными рекомендациями и последовательными моделями. Материал объясняет, что именно объединяет генеративная рекомендация и какие компоненты вокруг большой модели всё равно остаются.
Рекомендуем. Читайте после LUM: OneRec предлагает объединить выбор списка, тогда как LUM намеренно сохраняет отдельный прикладной ранжировщик.
Публикация · на английском
OneRec: Unifying Retrieve and Rank with Generative Recommender and Preference AlignmentОткрыть оригинальную статью (PDF)Jiaxin Deng, Shiyao Wang, Kuo Cai и соавторы · Kuaishou · Опубликовано: 26 февраля 2025 г.
Что мешало обычному каскаду
В обычном каскаде первая стадия быстро находит видео из большого каталога. Затем предварительный ранжировщик сокращает список, а более дорогая модель оценивает оставшихся кандидатов. Это позволяет сочетать масштаб и качество, но каждая стадия видит только то, что не отбросила предыдущая. Улучшить позднюю модель недостаточно, если нужный ролик до неё не дошёл.
Генеративный поиск уже умеет выдавать идентификаторы кандидатов вместо запроса к векторному индексу. Однако если после него всё равно остаётся сложный независимый ранжировщик, граница между этапами сохраняется. OneRec ставит задачу шире: по истории пользователя создать готовую последовательность видео для очередного запроса к ленте.
Объединение относится к обучаемому механизму выбора списка в данном сценарии. Оно не означает исчезновения журналов событий, каталогов, ограничений допустимости или инфраструктуры обновления модели. В самой статье остаются отдельные системы обучения, обслуживания и подготовки данных для настройки предпочтений.
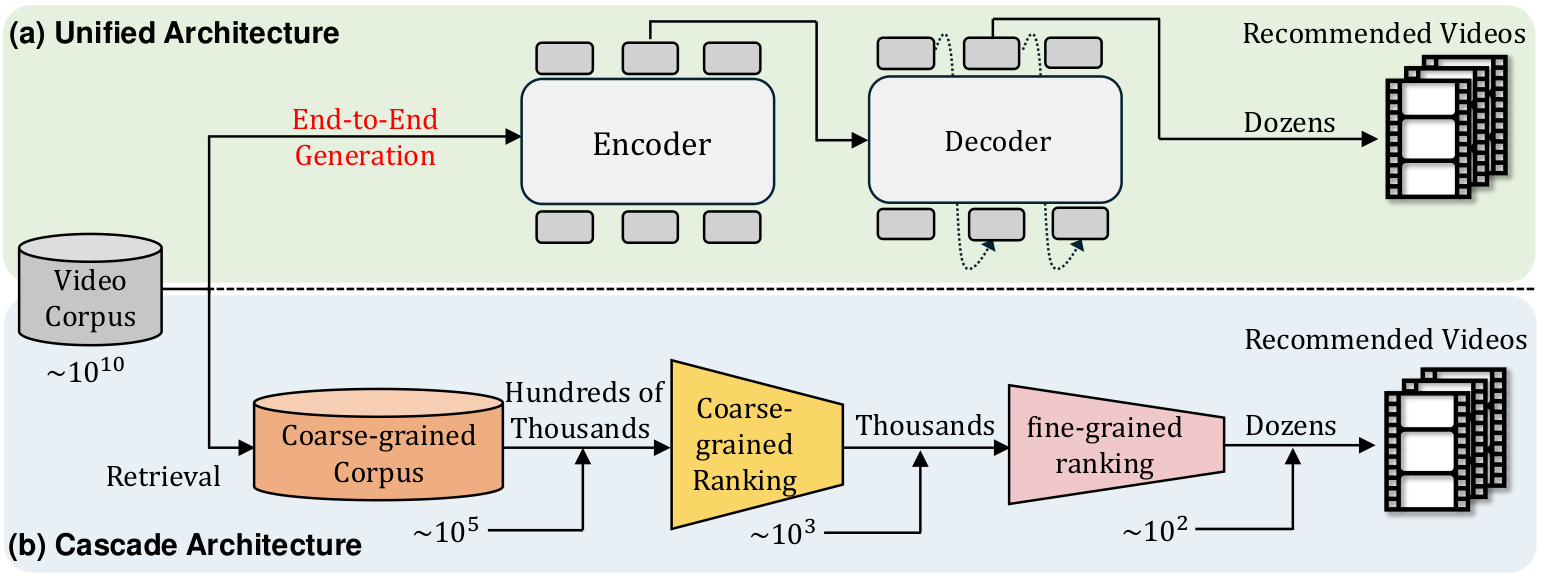
Рисунок 1: авторы сравнивают единую генеративную модель с каскадом «отбор кандидатов → предварительное ранжирование → ранжирование».
Источник: Оригинальная иллюстрация · KuaishouВидео превращается в короткую последовательность кодов
Генерировать произвольные названия роликов неудобно: ответ должен точно указывать на объект каталога. Поэтому каждый ролик сначала получает мультимодальный вектор, согласованный с поведением пользователей. Затем этот вектор сжимается в несколько дискретных кодов — семантический идентификатор.
В исходном эксперименте используют три уровня кодов по 8192 возможных значения. На первом уровне выбирается центр, близкий к вектору. Из вектора вычитается найденный центр, а следующий уровень кодирует оставшуюся ошибку. Так несколько небольших словарей описывают более детальную структуру, чем один грубый кластер.
Чтобы объекты не скапливались в небольшом числе популярных кодов, авторы используют сбалансированный вариант K-means. Кластеры должны получать сопоставимое число объектов. Это ответ на проблему неравномерного распределения кодов, а не гарантия равномерных пользовательских интересов или равного числа показов каждому автору.
Такой идентификатор должен оставаться связанным с реальным каталогом. Версия кодировщика и соответствие кодов видео становятся частью рабочего состояния системы. Из статьи нельзя вывести, что любая сгенерированная комбинация кодов автоматически допустима и доступна пользователю: это отдельная граница практического переноса.
S3.SS1 · §3.1: Preliminary и Algorithm 1Зачем генерировать сразу сессию
Если независимо предсказать несколько хороших роликов, они ещё могут образовать однообразную или плохо связанную выдачу. В OneRec единица обучения — список видео из успешной пользовательской сессии. При генерации следующего видео модель видит уже выбранную часть списка, поэтому может учить зависимости между его элементами.
Для подготовки обучающих сессий учитывают, что человек действительно посмотрел не менее пяти видео, суммарное время просмотра превышало порог и были полезные взаимодействия. Конкретное численное значение временного порога статья не раскрывает. Следовательно, воспроизвести такой фильтр только по названию метода недостаточно: придётся отдельно определить качество сессии для своего продукта.
В экспериментальной конфигурации контекст содержит 256 прошлых объектов, а целевой список — пять видео. Каждый объект представлен своими семантическими кодами. Между объектами используется специальный начальный токен. Модель учится предсказывать очередной код с помощью кросс-энтропии, последовательно формируя весь список.
Это обучающая цель на показанных качественных сессиях. Она ещё не говорит, что модель умеет лучше выбирать из всех возможных альтернатив. Именно эту разницу между повторением хороших примеров и предпочтением одной собственной выдачи другой адресует следующая стадия.
S3.SS2 · §3.2: Session-wise List GenerationEncoder-decoder и эксперты выполняют разные роли
Кодировщик обрабатывает историю положительных взаимодействий: эффективные просмотры, лайки, подписки и другие действия. Декодировщик использует полученное представление и генерирует коды списка. В отличие от текстовой LLM общего назначения, словарь выхода здесь привязан к каталогу видео.
Чтобы повысить вместимость декодировщика, полносвязные блоки заменяют смесью экспертов. В настройках статьи указаны 24 эксперта и выбор двух на соответствующий шаг обработки токена. Не все параметры большой модели работают одновременно. Это позволяет увеличивать общее число параметров без пропорционального увеличения вычислений на токен.
Число активированных экспертов и доля активных параметров всей модели — разные величины. В разделе развёртывания авторы сообщают о 13% активных параметров при инференсе. Это не противоречит выбору двух из 24 экспертов: помимо экспертов есть общие части модели. Однако такая доля сама по себе не даёт полной оценки задержки или требуемой памяти.
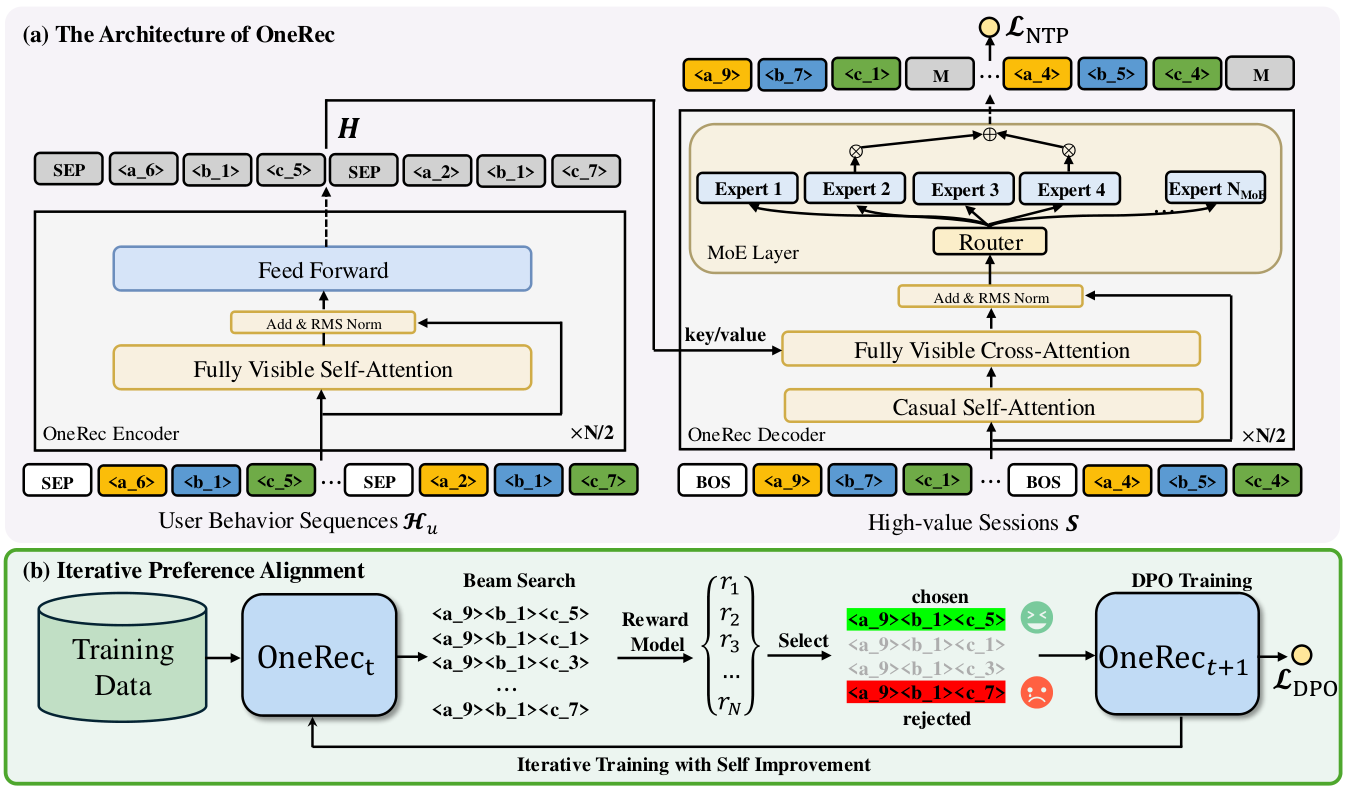
Рисунок 2: сначала OneRec учится на сессиях, затем собственные варианты выдачи оцениваются моделью награды и используются для итеративной настройки предпочтений.
Источник: Оригинальная иллюстрация · KuaishouОткуда берутся предпочтения, если пользователь увидел один список
Для обычного обучения по предпочтениям нужны хороший и плохой ответы на один контекст. Но в ленте пользователь видит только фактически выбранный список. Нельзя узнать его реальную реакцию на все непоказанные варианты. OneRec обучает отдельную персонализированную модель награды по журналам реальных взаимодействий.
Она получает пользователя и сессию и предсказывает несколько результатов: время просмотра сессии, вероятность просмотра, подписки и лайка. Эти выходы позволяют оценить сгенерированную выдачу, даже если её ещё не показывали. Но это модельные оценки, а не измеренные реакции на непоказанный список.
Такой подход делает возможным массовую подготовку сравнительных примеров. Одновременно появляется риск оптимизировать ошибки оценщика: генератор может научиться повышать предсказанную награду без соразмерного улучшения реального опыта. Поэтому офлайн-рост награды нужно подтверждать A/B-тестом и проверять несколько целей, а не только одну.
S3.SS3 · §3.3.1: Personalized Reward ModelКак работает итеративная настройка предпочтений
Текущая OneRec генерирует для одной истории несколько вариантов списка с помощью beam search — поиска, который сохраняет несколько перспективных продолжений. В эксперименте рассматривают 128 вариантов. Модель награды оценивает их, после чего из лучших и худших вариантов составляются пары предпочтений.
Плохой вариант здесь не случайный набор нерелевантных видео. Его предложил сам текущий генератор, поэтому это правдоподобная альтернатива — self-hard negative. Именно на таких различиях модель учится усиливать вероятность более предпочтительной выдачи относительно менее предпочтительной.
Используется Direct Preference Optimization, DPO: функция потерь сравнивает относительные вероятности двух списков с опорной моделью. Затем обновлённая OneRec снова создаёт примеры, оценщик снова выбирает пары, и цикл повторяется. IPA — это организация такого итеративного обновления, а не просто ещё одно имя для любой DPO-настройки.
Для ограничения вычислительной стоимости на генерацию предпочтений берут 1% обучающих данных. В опыте с долей от 1 до 5% дальнейший рост давал ограниченный дополнительный выигрыш, но требовал больше GPU для сервера генерации. Этот 1% — выбранная настройка статьи, а не универсальная доля полезных данных для всех рекомендаций.
S3.SS3 · §3.3.2 и Algorithm 2Какие системы остаются вокруг единой модели
- 01
Собрать взаимодействия
Журналы превращаются в истории и качественные сессии для обучения.
- 02
Обучить начальную модель
Сначала используется предсказание кодов целевых сессий.
- 03
Добавить предпочтения
Отдельный сервер создаёт варианты, модель награды формирует пары, добавляется DPO.
- 04
Синхронизировать параметры
Обновления получают онлайн-инференс и сервер подготовки новых примеров.
Для онлайн-обслуживания в статье выбрана версия примерно на миллиард параметров. Обучение использует XLA и смешанную точность bfloat16. Для применения описаны кеш ключей и значений декодировщика, float16 и beam size 128. Это снижает расходы генерации, но само по себе не публикует гарантированную полную задержку ответа для другого продукта.
Сервер подготовки DPO-примеров — отдельный потребитель ресурсов. Его стоимость особенно важна при сравнении с привычным каскадом: один общий генератор может сократить часть моделирования, но дополнительный цикл генерации и оценки альтернатив не становится бесплатным. Поэтому «одна модель» здесь не равна «один процесс без вспомогательных систем».
S4 · §4: System DeploymentПочему офлайн-таблицу нельзя читать как реальные просмотры
В таблице 1 варианты рекомендаций сравниваются по оценкам заранее обученной модели награды. Например, mean и max для времени просмотра относятся к предсказаниям оценщика на сгенерированных списках. Это не измеренное среднее время реальных пользователей и не независимая продуктовая метрика.
Сравнение включает SASRec, BERT4Rec, FDSA, TIGER, OneRec разных размеров и несколько способов настройки предпочтений. Результаты показывают пользу генерации списка и итеративного выбора собственных альтернатив. При этом некоторые варианты DPO уступают исходной OneRec по отдельным целям: сам факт добавления preference loss не гарантирует улучшения.
Анализ распределения кодов показывает, что неопределённость особенно велика на первом уровне семантического ID, а последующие уровни сильнее обусловлены уже выбранным префиксом. Это объясняет роль поиска нескольких продолжений, но не доказывает калиброванность вероятностей клика. Вероятность кода в генераторе и вероятность пользовательской реакции — разные объекты оценки.
S5.SS1 · §5.1–5.4 и таблица 1Что проверили на 1% основного трафика
Таблицу можно прокрутить по горизонтали.
Сравнение показывает, что увеличение модели и настройка предпочтений дают отдельные прибавки в данном эксперименте. Но из разницы строк нельзя вывести гарантированный эффект IPA при любом генераторе: остальные условия и способ формирования примеров остаются важны.
В подписи таблицы встречается формулировка absolute improvement, хотя значения записаны в процентах, а основной текст называет их улучшением показателей. Поэтому здесь сохраняем исходную запись процентов и базу сравнения, не переименовывая их в процентные пункты. Для времени просмотра процентные пункты вообще не являются естественной единицей.
В заключении авторы отдельно признают ограничения интерактивных метрик, например лайков. Рост просмотра нельзя автоматически назвать улучшением всех пользовательских целей, разнообразия, удовлетворённости или выручки. Денежный эффект в этом разборе не вычисляется из процентов просмотра.
S5.SS5 · §5.5: Online A/B Test, таблица 2Где проходит граница доказанного результата
Сильная часть кейса — путь от представления каталога до онлайн-проверки: семантические коды делают генерацию адресной, сессионная цель учит структуру списка, модель награды даёт сравнительные примеры, а A/B-тест проверяет реальную реакцию. Ни один из этих компонентов отдельно не объясняет весь выигрыш.
Остаются вопросы для переноса: обновление семантического индекса, доступность нового контента, недопустимые или повторяющиеся объекты, устойчивость оценщика и стоимость генерации альтернатив. Они не исчезают при объединении каскада. Если статья не раскрывает полную реализацию конкретного защитного механизма, её нельзя восстановить по названию модели.
Для практического обсуждения сравните OneRec с LUM и Spotify NEO/GLIDE. LUM добавляет представления к существующему решению, GLIDE использует генерацию как отбор кандидатов, а OneRec в этом эксперименте генерирует список целиком. Сначала стоит выбрать, какую часть собственной системы нужно улучшить, и лишь затем решать, требуется ли такая степень объединения.
S6 · §6: Conclusion; сопоставление с §3–5