Разбор готов
Meta HSTU: как действия пользователя стали основой большой рекомендательной модели
Большой рекомендательный сервис каждую минуту получает новые объекты и реакции людей. Инженеры превращают эту историю в тысячи счётчиков, пересечений и векторов, но увеличение привычной сети не всегда улучшает качество. В работе HSTU команда Meta исследует другой путь: представить признаки и действия общей временной последовательностью, учиться на нескольких её позициях сразу и переиспользовать историю между кандидатами. Эта глава разбирает версию v3 от 6 мая 2024 года: постановку задач, устройство блока, разреженное вычисление внимания, обучение и M-FALCON. Результаты публичных наборов, промышленных задач и тестов скорости рассматриваются отдельно.
Для инженеров RecSys, которые хотят понять HSTU за пределами громких чисел: что именно является генеративным, что предсказывается при ранжировании и какие системные изменения поддерживают масштаб.
Рекомендуем. Читайте в связке с Feed SR: HSTU объясняет исходную формулировку, а LinkedIn показывает, какие решения оказались полезными или неудачными в другой ленте.
Публикация · на английском
Actions Speak Louder than Words: Trillion-Parameter Sequential Transducers for Generative RecommendationsОткрыть оригинальную статью (PDF)Jiaqi Zhai, Lucy Liao, Xing Liu и соавторы · MRS, Meta AI · Опубликовано: 27 февраля 2024 г.
Зачем превращать разнородные признаки в общую историю
Обычная промышленная модель использует признаки разной природы: ID объектов и авторов, темы, подписки, числовые счётчики и отношения. В GR, Generative Recommenders, авторы выбирают основную хронологическую последовательность взаимодействий и добавляют к ней изменения других категориальных признаков. Медленно меняющиеся состояния можно хранить как редкие изменения, а не дублировать на каждом показе.
Числовые агрегаты полностью так записать было бы слишком дорого. Авторы делают более сильную гипотезу: достаточно выразительная модель длинной истории сможет выучить часть полезных агрегированных зависимостей по исходным событиям. Это исследуемый выбор представления данных, а не общее доказательство ненужности счётчиков.
В промышленном опыте поведенческие и категориальные данные действительно дают сильные результаты. Но при небольшом вычислительном бюджете обычный DLRM с хорошими ручными признаками иногда лучше. Статья сама показывает эту границу: замена сильной инженерии признаков требует достаточных данных, длины истории и вычислительной мощности.
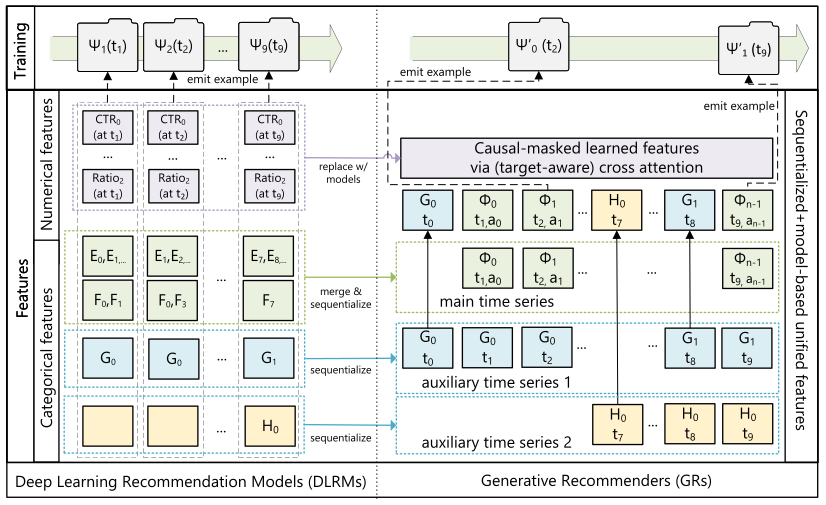
Рисунок 2: различие представления признаков и обучения. Несколько целевых позиций общей истории используются совместно вместо независимого повторения контекста.
Источник: Оригинальная иллюстрация · MetaГенеративное обучение не обязательно генерирует список ID
Для отбора кандидатов модель предсказывает следующий объект с положительным взаимодействием по предыдущей истории. Если следующее событие отрицательное или относится к другому категориальному признаку, целевой объект может быть не определён. Следовательно, не каждое следующее событие автоматически является хорошей рекомендацией.
Для ранжирования задача другая: при известном кандидате предсказать действие пользователя. Во входе чередуются объекты и последовавшие реакции. Представление позиции объекта используется для прогноза его реакции, а маска закрывает эту реакцию и последующие события. Это позволяет кандидату взаимодействовать с предыдущей историей до получения окончательной оценки.
В статье к выходу позиции кандидата применяется небольшая многозадачная сеть. То есть здесь может оставаться оценка вероятностей действий для предоставленных кандидатов. Такой Generative Recommender не следует автоматически приравнивать к OneRec, где декодировщик генерирует семантические коды списка. Общий термин объединяет разные постановки.
§2.2: ranking и retrieval, таблица 1Почему несколько целей одной истории выгодно учить вместе
В независимом обучении на показах множество примеров одного пользователя повторяют почти одинаковый префикс. Длинная последовательность многократно обрабатывается ради одной очередной метки. GR использует несколько целевых позиций за один проход, распределяя стоимость кодировщика между ними.
Для промышленного потока важно и то, как часто длинная история попадает в обучение. Авторы обсуждают выборку пользователей с вероятностью, связанной с обратной длиной истории, и формирование примеров в конце запроса или сессии. Без этого очень активные пользователи могли бы многократно создавать дорогие почти одинаковые примеры.
Приведённое уменьшение асимптотической сложности относится к сопоставлению конкретных схем повторного и совместного обучения. Оно не означает, что любое обучение HSTU линейно по длине: внимание к длинной истории остаётся дорогим, и дальше нужны отдельные меры для его вычисления.
§2.3: Generative trainingЧто меняется внутри HSTU по сравнению с обычным Transformer
Блок сначала совместно строит Q, K, V и вектор U, который управляет пропусканием признаков. Затем агрегирует историческую информацию с относительными смещениями по позиции и времени. После нормализации агрегированный результат поэлементно умножается на U и проходит выходное преобразование. Остаточные связи соединяют одинаковые блоки.
В пространственной агрегации HSTU использует поэлементную нелинейность SiLU вместо обычной softmax-нормировки весов по всей последовательности. Мотивация связана с интенсивностью интереса: количество похожих прошлых действий само может быть полезным сигналом, а нормировка суммы к единице меняет эту информацию.
Поэлементное произведение с U даёт явные взаимодействия и управляемое пропускание представлений. Но это не описание отдельного дискретного маршрутизатора, выбирающего top-k экспертов, как в OneRec или sparse-вариантах RankMixer. Сходство с gating не означает идентичность архитектур.
Нормализация после агрегации нужна для устойчивости обучения. Авторы показывают пользу конструкции на своих данных и синтетическом потоке с меняющимся словарём. В LinkedIn Feed SR softmax и стандартные трансформерные блоки оказались удачнее. Эти результаты совместимы: речь о разных задачах и рецептах обучения.
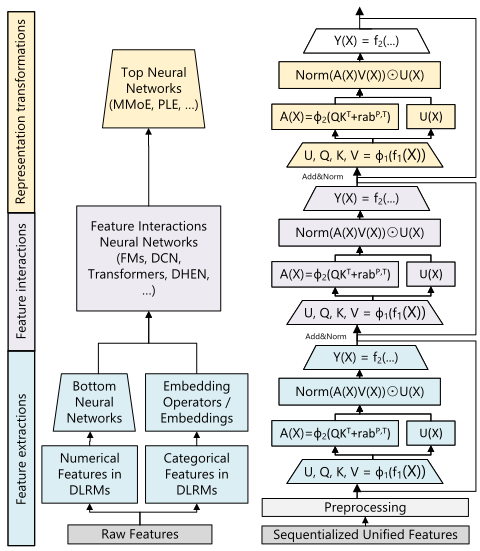
Рисунок 3: авторы сопоставляют компоненты DLRM с упрощённым блоком HSTU. Агрегация, взаимодействие и преобразование объединяются в более регулярную структуру.
Источник: Оригинальная иллюстрация · MetaРазная длина истории превращается в выигрыш по ресурсам
При максимальной длине в тысячи событий многие пользователи имеют гораздо более короткую историю. Если дополнить каждый пример до общего максимума, значительная часть работы будет приходиться на пустые позиции. Специализированное ядро использует реальные длины последовательностей и объединённые матричные операции разных размеров.
Дополнительно вводится Stochastic Length: длинные истории во время обучения иногда заменяются подпоследовательностями, а иногда сохраняются целиком. Настройка вероятностей позволяет уменьшить средний вычислительный бюджет, не отказываясь полностью от наблюдения длинных зависимостей.
Это не постоянное обрезание всех пользователей до одинакового маленького окна и не доказательство безвредности случайного удаления 80% событий в любом продукте. В опытах проверяют выбранные значения параметров и регрессию качества. Для некоторых длин и настроек NE ухудшается в пределах указанной авторами величины, поэтому стоимость и допустимую потерю нужно читать вместе.
§3.2: Sparsity и Stochastic LengthПочему триллион параметров не означает триллион плотных весов
В рекомендательной системе огромный словарь ID создаёт большие таблицы векторов. В заголовочной величине 1,5 трлн параметров присутствуют и такие embedding-параметры. Это не плотная текстовая LLM на 1,5 трлн параметров, которая выполняет все соответствующие матричные операции для каждого токена.
Отдельную проблему создаёт память промежуточных активаций при больших пакетах. В HSTU уменьшают число линейных преобразований и объединяют нормализацию, нелинейность и выходные операции. В описанной оценке промежуточные состояния составляют около 14d против 33d у выбранной Transformer-конфигурации, что позволяет делать сеть глубже при похожем бюджете памяти.
Для больших ID-таблиц авторы также используют rowwise AdamW и размещение состояний оптимизатора в DRAM. Это уменьшает давление на HBM, но не устраняет память и обмен данными из общей стоимости. Поэтому сравнение только плотных блоков не описывает всю промышленную систему.
§3.3: Minimizing activation memory; §4.3.1M-FALCON переиспользует историю между кандидатами
При ранжировании многим кандидатам нужно обратиться к одной истории. Если каждый обрабатывает её отдельно, общий контекст пересчитывается многократно. M-FALCON объединяет кандидатов в микропакеты и меняет маску внимания так, чтобы переиспользовать общую работу, сохранив требуемую семантику оценки каждого кандидата.
Для больших наборов кандидатов применяется несколько микропакетов и, при необходимости, кеширование ключей и значений. Размер микропакета и актуальность кеша становятся параметрами системы. Это не просто увеличение обычного batch size независимых пользователей.
В промышленном сравнении авторы обслуживают GR, который по их определению примерно в 285 раз сложнее исходного DLRM, с большей пропускной способностью: 1,50× при 1024 кандидатах и 2,99× при 16384. Это сравнение полного способа обслуживания в указанной конфигурации, а не универсальное ускорение блока HSTU в 285 раз.
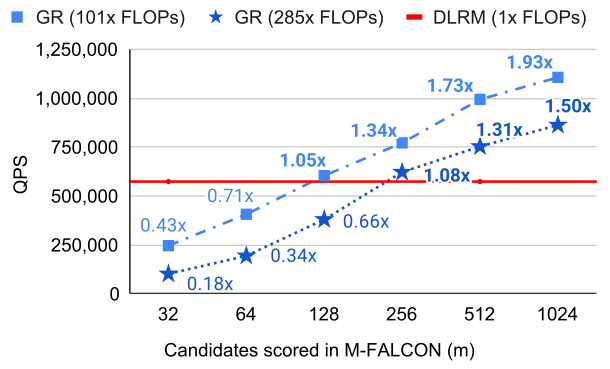
Рисунок 6: пропускная способность GR с M-FALCON относительно промышленного DLRM зависит от числа одновременно оцениваемых кандидатов.
Источник: Оригинальная иллюстрация · MetaПубличный benchmark и поток промышленного обучения — разные проверки
На MovieLens и Books используют несколько эпох с полным перемешиванием, сравниваясь с сильным рецептом SASRec. Основной HSTU имеет сопоставимую конфигурацию, а HSTU-large — больше слоёв и голов. В частности, +65,8% NDCG@10 относится к HSTU-large на Books: 0,0257 против 0,0156. Это не онлайн-рост вовлечённости.
В промышленном опыте данные проходят один раз в потоке. Для ранжирования используется Normalized Entropy, NE: нормированная ошибка вероятностного прогноза, где меньше — лучше. Для отбора кандидатов дополнительно рассматривают log perplexity. Поэтому здесь нельзя читать каждую таблицу как одинаковый Recall@K или CTR.
В потоковых опытах стандартные Transformer-конфигурации имели проблемы устойчивости; сравниваются также усиленный Transformer++ и несколько отключений HSTU. Таблица не доказывает, что любой современный трансформер обязательно расходится. Она фиксирует результат конкретного обучения, гиперпараметров и представления данных.
Для тестов эффективности кодировщика используют H100, bfloat16 и длины 1024–8192. Stochastic Length применяется при обучении. Максимумы примерно 15,2× для обучения и 5,6× для инференса имеют разные условия. Их нельзя подменять единым ускорением полной ленты.
§4.1 и таблицы 4–5Какая метрика выросла на 12,4%
Таблицу можно прокрутить по горизонтали.
В статье E-Task обозначает основную engagement-задачу, C-Task — основную consumption-задачу. Конкретные пользовательские действия и поверхность не раскрыты настолько, чтобы назвать +12,4% ростом CTR Instagram, времени в Facebook или рекламных конверсий. Принадлежность авторов Meta не даёт права восстановить эти детали догадкой.
В отборе кандидатов различаются добавление нового источника к существующим и замена основного источника. Их результаты не складываются. Аналогично онлайн-показатели ранжирования нельзя прибавлять к отбору для получения общего эффекта системы.
Отключение части ручных признаков у DLRM ухудшает его качество. GR на одних только взаимодействиях тоже слабее полной GR. Следовательно, результат связан не только с названием блока, но и с тем, какие категориальные изменения, действия и контекст включены в общую историю.
§4.3, таблицы 6–7Как читать заявления о масштабировании
Качество GR улучшалось при согласованном увеличении длины, числа слоёв, размерности и вычислений в исследованном диапазоне. Длину истории авторы считают особенно важной. При этом фиксируемая величина вычислений для потокового обучения нормируется на год: её нельзя сравнивать с ценой разового обучения текстовой модели без этой оговорки.
Результат не отменяет сильные прикладные модели и не гарантирует, что небольшая команда выиграет, отказавшись от всех признаков ради HSTU. Исследование показывает, что согласованная последовательная постановка и совместная оптимизация обучения и инференса могут снять конкретные ограничения масштабирования.
Практический маршрут: сначала понять TransAct, затем Feed SR как разные варианты общего контекста, после этого сравнить с OneRec. Вопрос для своей системы — какую цель должна предсказывать модель и на каком этапе общая история действительно экономит работу, а не только увеличивает число параметров.
§4.3.1 и §6: Conclusions