Разбор готов
Pinterest TransAct: как свежие действия дополнили долгосрочные интересы в ленте
Человек мог месяцами сохранять идеи для ремонта, а сегодня начать выбирать подарок. Заранее рассчитанный вектор интересов хорошо помнит первое, но не всегда успевает отразить второе. Pinterest добавил к пакетным представлениям PinnerFormer отдельный модуль TransAct, который во время ранжирования анализирует последние действия человека с учётом кандидата. Статья 2023 года интересна не только трансформером: она показывает перенос модели с CPU на GPU, ухудшение разнообразия, необходимость повторного обучения и разницу между офлайн- и онлайн-проверкой. Разбор фиксирует версию v1 от 31 мая 2023 года, а не последующую TransAct V2.
Для инженеров рекомендаций, которые хотят добавлять свежую историю в существующий ранжировщик, сохраняя пакетные представления, многозадачную цель и ограничения рабочего сервиса.
Рекомендуем. Начните с этой главы перед TransAct V2: она объясняет исходную гибридную модель и проблемы, которые следующая версия развивает дальше.
Публикация · на английском
TransAct: Transformer-based Realtime User Action Model for Recommendation at PinterestОткрыть оригинальную статью (PDF)Xue Xia, Pong Eksombatchai, Nikil Pancha и соавторы · Pinterest · Опубликовано: 31 мая 2023 г.
Какое место TransAct занимает в Homefeed
Pinterest сначала отбирает тысячи пинов из большого каталога, затем ранжирует их и смешивает результат по продуктовым требованиям. Ранжировщик Pinnability прогнозирует несколько действий для пары «человек — пин»: клик, сохранение на доску, скрытие и другие реакции. Поэтому хорошие рекомендации должны повышать полезные действия и одновременно реже предлагать то, что человек захочет убрать.
Pinnability использует числовые, категориальные и векторные признаки. После подготовки представлений DCN V2 моделирует их взаимодействия, а несколько выходов нейросети дают вероятности разных действий. TransAct добавляется как модуль понимания истории внутри этой модели; он не заменяет отбор кандидатов и не выдаёт окончательный список сам по себе.
Рядом остаётся PinnerFormer: пакетно рассчитанное представление длительных интересов. Эти ветви решают разные задачи. PinnerFormer даёт устойчивую информацию за большой период, TransAct реагирует на то, что произошло недавно. Статья проверяет именно совместную работу, а не гипотезу, что свежие события позволяют забыть всё остальное.
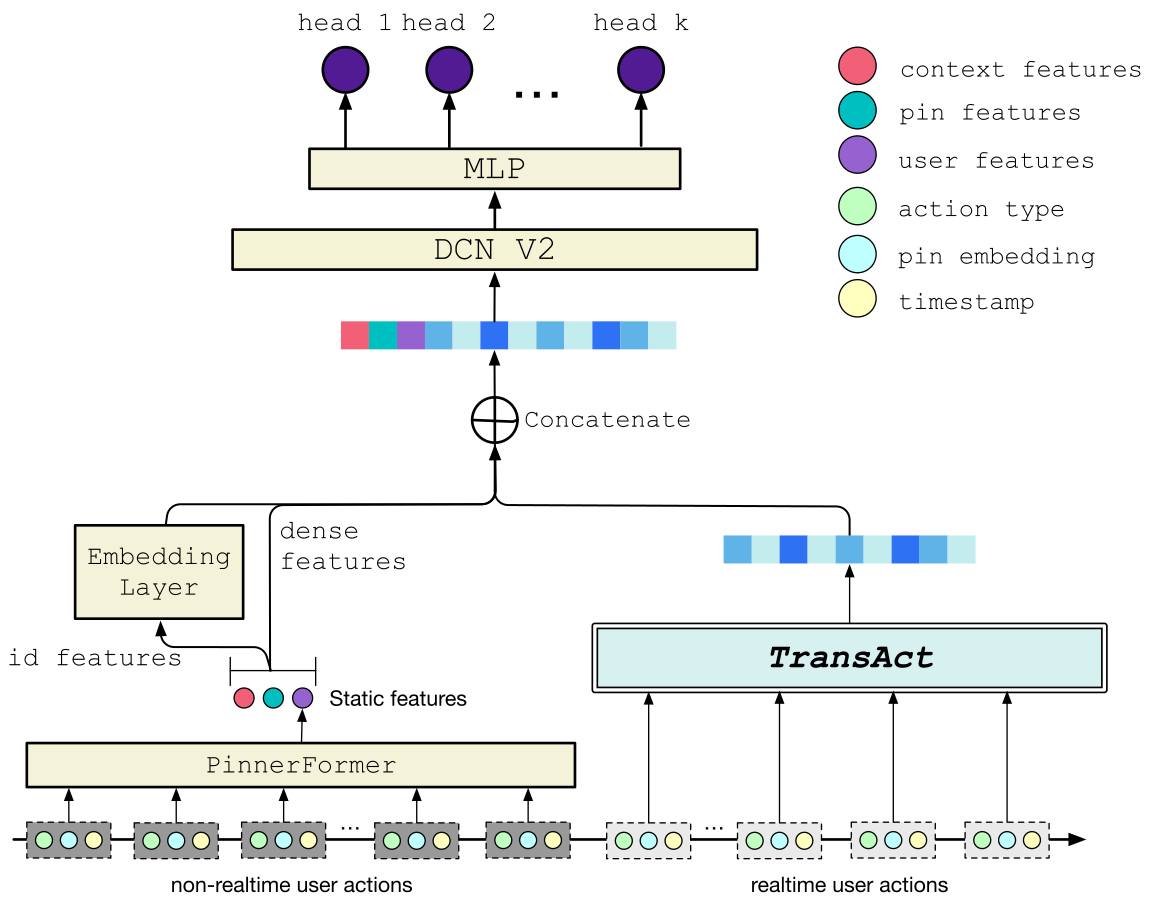
Рисунок 2: в Pinnability совместно используются TransAct, пакетный PinnerFormer и остальные признаки; после объединения модель предсказывает разные действия.
Источник: Оригинальная иллюстрация · PinterestПочему недостаточно знать только список просмотренных пинов
Для каждого пользователя берут последние 100 действий и сортируют от новых к старым. Если действий меньше, последовательность дополняется пустыми позициями. В событии есть время, тип действия и 32-мерный PinSage-вектор пина. Отдельное обучаемое представление типа действия помогает отличать сохранение, обычное взаимодействие и скрытие.
Сходный по содержанию объект может означать противоположные предпочтения: один пин человек сохранил, другой скрыл. Если усреднить только векторы содержания, различие потеряется. Поэтому TransAct объединяет представление типа действия с представлением самого пина, а не считает любой объект истории положительным примером.
Вектор PinSage уже подготовлен отдельной системой. TransAct не обрабатывает исходную фотографию каждый раз во время ранжирования. Это позволяет использовать содержательную близость объектов без запуска тяжёлого визуального кодировщика на каждое событие каждого запроса.
§3.2–3.3.1: последовательность действийКандидат участвует в обработке истории с самого начала
Представление пользователя полезно делать зависимым от оцениваемого кандидата: для пина о мебели важны одни прошлые действия, для рецепта — другие. Авторы сравнивают два ранних способа добавить кандидата. В первом его вектор дописывают отдельной позицией, во втором присоединяют к признакам каждого события истории. Второй вариант, concat, оказался лучше в их опытах.
Дальше работает трансформер с двумя блоками. В исходной версии позиционное кодирование не используется: проверка не показала его полезности. Поэтому не следует описывать этот вариант как обязательную причинную next-item-модель с позициями. Его основная задача — построить полезные признаки для многозадачного ранжировщика, а не назвать следующий ID каталога.
Полный выход по всем 100 событиям был бы слишком большим для последующего DCN. Команда оставляет выходы первых десяти, то есть самых свежих позиций, и добавляет максимумы по всей последовательности. Так компактный результат сохраняет подробности недавних действий и агрегированную информацию об остальной доступной истории.
Отключения подтверждают необходимость компромисса. Все позиции дают немного лучший показатель скрытий, но не лучший баланс сохранений и стоимости. Четыре слоя с более широкой сетью тоже давали качество, однако увеличивали задержку примерно на 30% и не укладывались в требования. Окончательная архитектура выбрана по сочетанию целей, а не максимальному офлайн-результату.
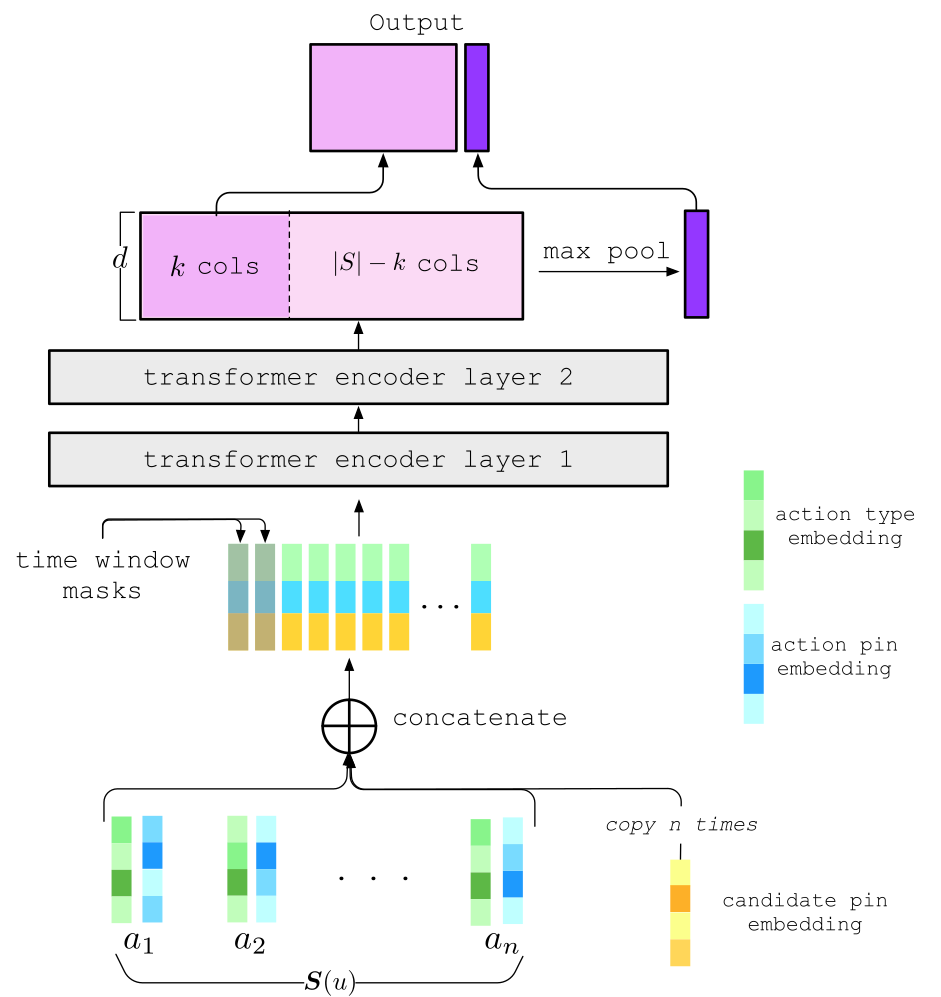
Рисунок 3: тип действия, содержание исторического пина и кандидат объединяются до трансформера; сжатый выход передаётся общей модели.
Источник: Оригинальная иллюстрация · PinterestКак офлайн-проверка уменьшала позиционное смещение
Обучающие данные собраны из первых двух недель журнала Homefeed, проверка — из третьей. В статье указаны 3 млрд обучающих примеров, 177 млн пользователей и 720 млн пинов. Для обучения отрицательные показы прореживают, а соотношения типов действий выбирают с учётом их частот и значимости.
Для офлайн-оценки используют небольшую долю сессий со случайным порядком рекомендаций. Это помогает уменьшить влияние того, что высоко показанный пин получает больше действий просто из-за позиции. Модель сортирует кандидатов одного запроса, и HIT@3 считает целевые реакции среди первых трёх. Для сохранений больше — лучше, для скрытий меньше — лучше.
В сравнении таблицы 1 TransAct даёт +9,40% HIT@3/repin и −14,86% HIT@3/hide относительно выбранного исходного ранжировщика. Это изменение офлайн-показателя, а не доля сохранений во всём продукте. Определённые результаты альтернативных моделей отмечены как статистически незначимые; их нельзя использовать как уверенное доказательство преимущества по каждому действию.
Простое усреднение свежих векторов тоже помогало. CNN, RNN и LSTM не всегда оказывались лучше этого дешёвого варианта, а обычный трансформер ещё уступал полной конструкции TransAct. Так эксперименты отделяют пользу самих новых признаков от пользы архитектуры их обработки.
§4.1–4.3, таблицы 1–3Долгосрочная ветвь остаётся полезной
Таблицу можно прокрутить по горизонтали.
Самая большая потеря в этих опытах возникает без TransAct, но отключение PinnerFormer тоже ухудшает результат. Следовательно, свежая история не делает долгосрочный профиль бесполезным. Это особенно важно при переносе: сравнивать стоит не только новый модуль против пустого входа, но и добавление модуля к уже сильному профилю.
Категория non-core в статье означает людей, которые не сохраняли пины за последние 28 дней. Это не то же самое, что полностью новый пользователь без единого события. У таких людей свежие действия могут стать особенно полезным сигналом, но их выигрыш не доказывает решение всех вариантов холодного старта.
§4.3.1: отключения realtime-batch hybridКак обслуживали модель с 65-кратным ростом FLOPs
Pinnability вместе с TransAct требует примерно в 65 раз больше арифметических операций, чем предшествующий вариант. Сохранить сопоставимые задержку и стоимость помог переход от CPU-обслуживания к GPU и переработка всей подготовки вычислений. Само число FLOPs не является замером 65-кратного роста стоимости.
Главной проблемой оказались многочисленные маленькие операции. Модель использует сотни признаков; если для каждого отдельно запускать поиск ID, чтение вектора и копирование CPU→GPU, накладные расходы превосходят полезную работу. Команда объединила lookup-операции разных признаков, использовала GPU-таблицы cuCollections и копирование общего непрерывного буфера вместо множества отдельных тензоров.
Для GPU пересмотрели и разбиение запросов. Мелкие пакеты, удобные для CPU, плохо загружали ускоритель. Вместо прежнего scatter-gather с множеством маленьких частей стали использовать более крупные исходные пакеты, а для ёмкости кеша — сочетание DRAM и SSD. CUDA Graphs позволили воспроизводить подготовленную последовательность операций без прежнего количества отдельных запусков.
Это кейс совместного изменения модели и системы обслуживания. Нельзя обещать прежнюю стоимость, просто включив GPU у своей нейросети: результат зависит от размеров пакетов, поиска признаков, копирования и структуры распределённого сервиса.
§3.4.2: GPU servingСвежие признаки не отменяют обновление весов
Поток пользовательских событий приходит через Kafka. Flink проверяет записи, объединяет дубликаты и согласует временные различия между источниками, затем сохраняет материализованные признаки в Rockstore. Во время выдачи история преобразуется в вход модели. Поэтому «realtime» относится и к пути доставки признаков, а не только названию нейросети.
При этом модель с новыми событиями, но старыми весами постепенно теряла выигрыш. В отдельном опыте авторы сравнили фиксированные и переобучаемые варианты в течение двух недель. Повторное обучение на свежих данных поддерживало вовлечённость лучше, чем неизменная модель.
В описанной промышленной конфигурации Pinnability обучают с нуля дважды в неделю. Это найденный баланс Pinterest, а не универсальное расписание для всех продуктов. Частота действий, изменение содержания и стоимость обновлений в другой системе могут потребовать иного режима.
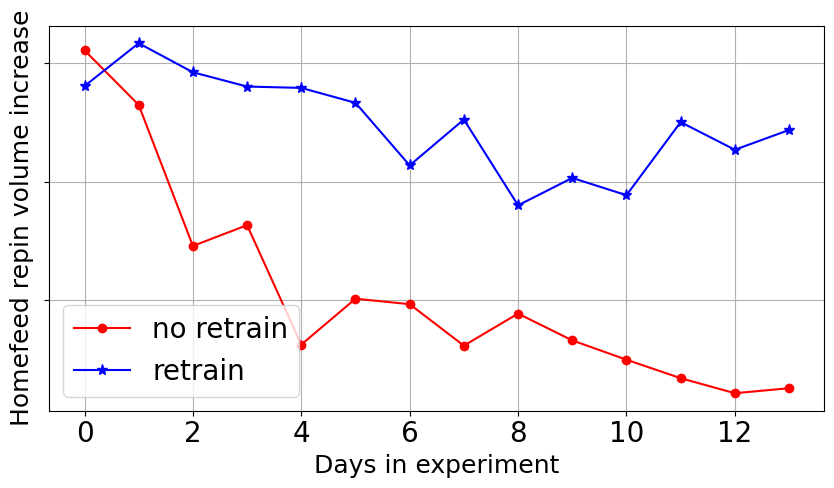
Рисунок 6: изменение выигрыша при фиксированной и повторно обучаемой модели. Новые события во входе сами по себе не предотвращают старение модели.
Источник: Оригинальная иллюстрация · PinterestКороткая история усиливала интерес, но сужала выдачу
После добавления свежих действий разнообразие показов снизилось на 2–3%. В статье разнообразие связано с числом различных верхнеуровневых интересов в таксономии Pinterest, показанных человеку. Это конкретное определение, а не абстрактное эстетическое разнообразие картинок.
Чтобы сеть не опиралась только на самые последние события, во время обучения случайно выбирают окно от 0 до 24 часов и закрывают события внутри него. В рабочем инференсе этой маски нет. Она заставляет модель учиться использовать и менее свежие части истории, не удаляя их из финальной системы навсегда.
В результате снижение разнообразия удалось сократить примерно до 1% без потери ключевого показателя сохранений. То есть проблему уменьшили, но не довели разнообразие до исходного уровня. Больший dropout и случайное удаление фиксированной доли действий давали менее удачный баланс разнообразия и вовлечённости.
§3.3.4 и §4.4.4: Random Time Window MaskЧто показал онлайн-тест и где заканчивается вывод
Таблицу можно прокрутить по горизонтали.
Эти проценты относятся к разным действиям и не складываются в единый рост качества. В частности, +11% сохранений не означает +11% выручки или времени в продукте. Для скрытий уменьшение — полезное направление, а число сохранений сравнивается отдельно.
В других сценариях авторы сообщают о +2,8% сохранений в Related Pins, +2,3% в Search, +1,4% CTR email-уведомлений и +1,9% открытий push. Это самостоятельные внедрения, а не дополнительные прибавки к результату Homefeed.
После полного внедрения команда наблюдала усиление эффекта через обратную связь: новая выдача меняет действия, эти действия меняют будущие признаки и обучение. Такое наблюдение полезно для понимания эксплуатации, но не даёт основания прибавить неизвестный процент к опубликованной таблице A/B. Далее читайте TransAct V2, где длинная история и дополнительная обучающая задача сравниваются уже с этим сильным исходным вариантом.
§4.4, таблица 5; §5: Discussion