Разбор готов
Meituan: как предварительный ранжировщик учится у дорогой модели и укладывается в задержку
Пользователь ищет заведение или услугу, и поисковая система быстро сокращает тысячи подходящих кандидатов до сотен. Дорогой финальный ранжировщик не может вернуть то, что отсеял дешёвый предварительный. Поэтому Meituan обучает раннюю модель не только на кликах, но и на решениях следующей стадии. Статья 2022 года подробно показывает три вида передачи знания и отдельный поиск структуры с ограничением задержки. Она полезна и рядом с современными большими моделями: объясняет, почему качество одной последней сети не равно качеству каскада и почему промежуточной стадии нужна собственная метрика.
Для инженеров поиска, рекламы и рекомендаций, которые улучшают каскад: отбор кандидатов, предварительное ранжирование, подробное ранжирование и последующие правила выдачи.
Рекомендуем. Читайте как противовес идее обязательной замены всего каскада: ранние и поздние стадии можно согласовать, сохраняя их разные вычислительные бюджеты.
Статья · на китайском
美团搜索粗排优化的探索与实践 — исследование и практика оптимизации предварительного ранжирования晓江, 所贵, 李想 и соавторы · Meituan, Search Recommendation Algorithms · Опубликовано: 11 августа 2022 г.
Предварительная стадия выбирает множество, а не окончательный порядок
В описанном поиске Meituan после получения кандидатов идут предварительное ранжирование, подробное ранжирование, переранжирование и смешивание. Предварительная стадия сокращает множество примерно тысячного масштаба до сотенного. Её ошибка может быть необратимой: если сильный кандидат удалён, более точная поздняя модель его уже не рассмотрит.
У предварительного ранжировщика меньше признаков и более простая сеть, потому что число оцениваемых объектов выше. Но цель не в том, чтобы идеально воспроизвести окончательный порядок всех объектов. Главное — оставить полезное множество для следующей стадии и уложиться в общий срок ответа.
Поэтому улучшение сложной модели в конце каскада и улучшение раннего отбора — разные задачи. Кейс исследует связь между ними: как использовать доступные офлайн-решения дорогой модели, не перенося её полную стоимость в каждый онлайн-запрос.
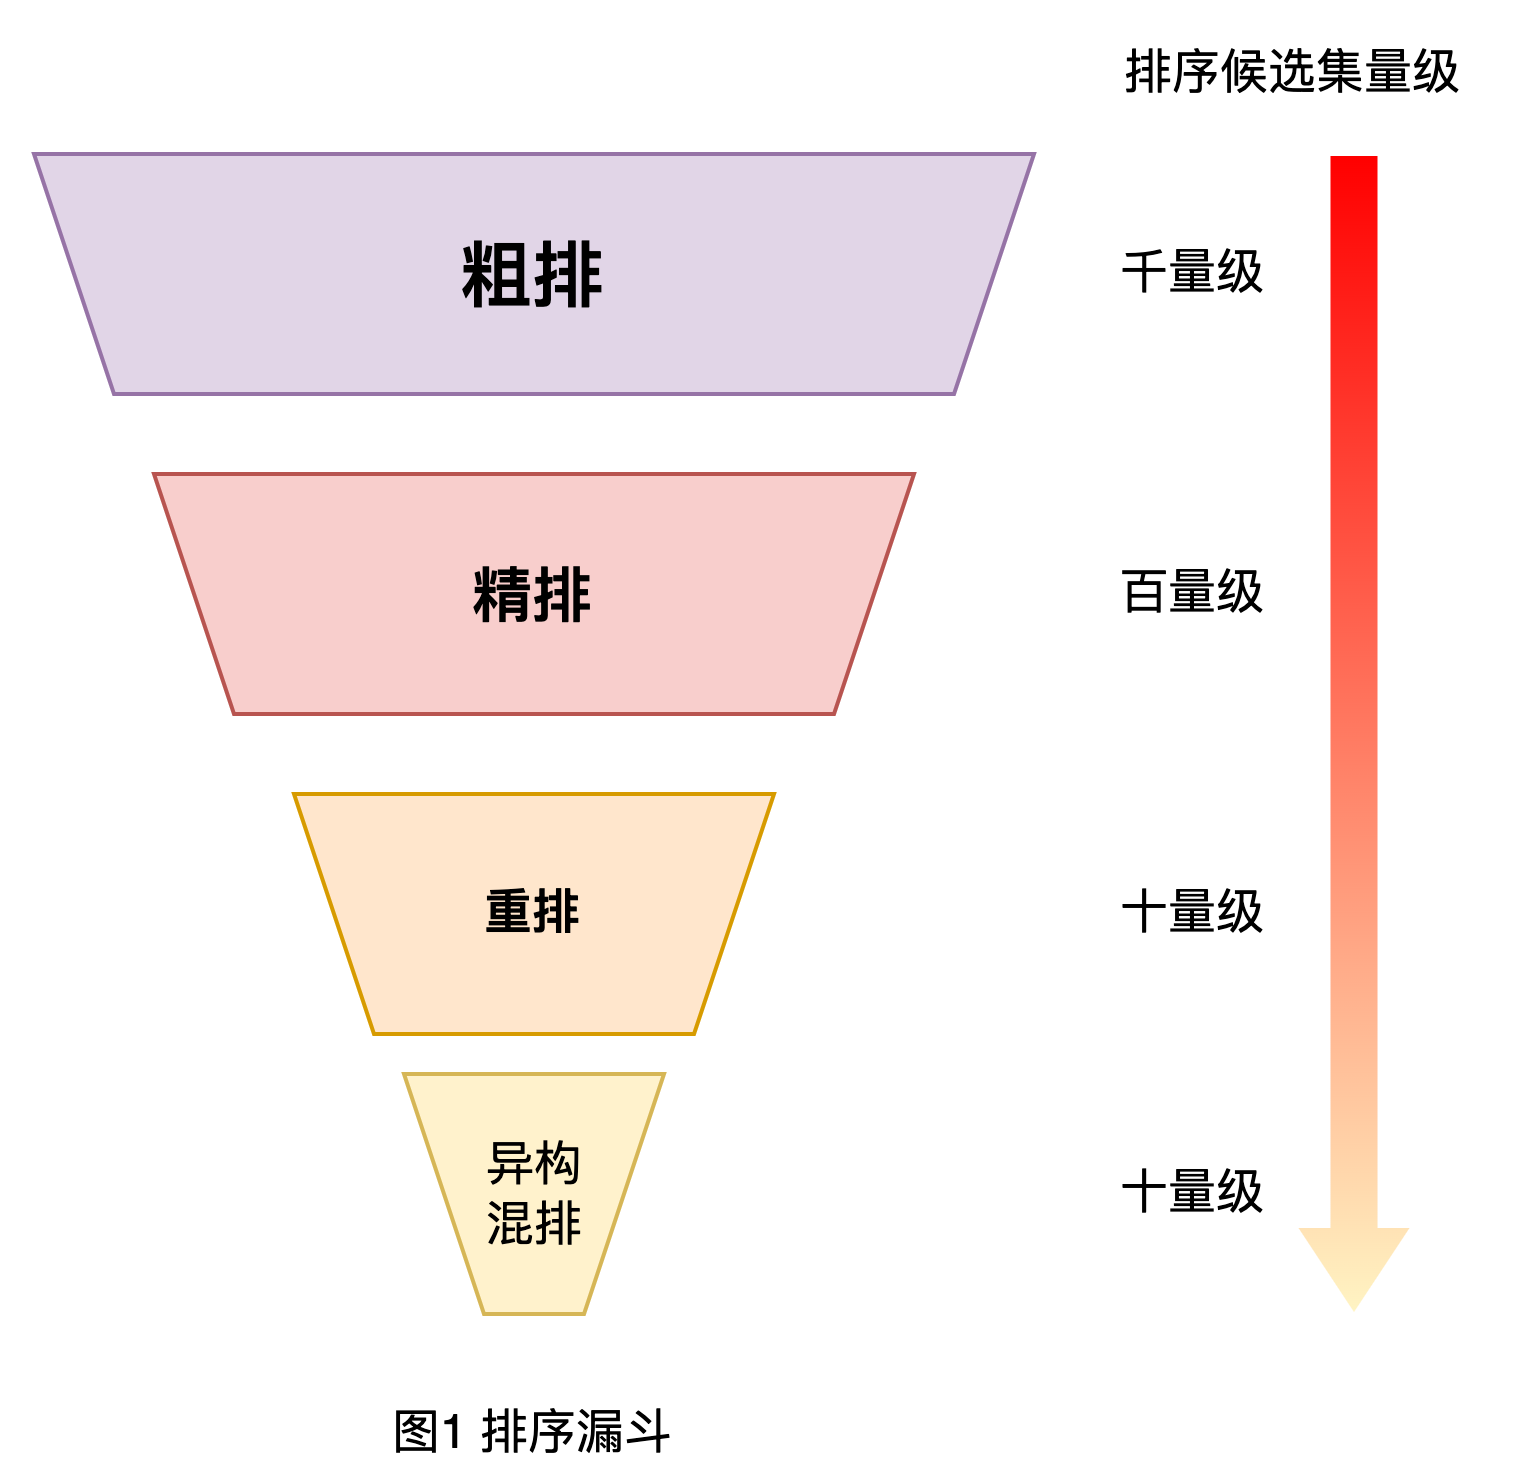
Рисунок 1: поисковый каскад Meituan. Предварительная стадия должна сохранить подходящих кандидатов для более дорогой последующей обработки.
Источник: Оригинальная иллюстрация · MeituanПочему от двух башен перешли к более связанной модели
Авторы описывают собственную эволюцию: ручное линейное взвешивание в 2016 году, простая логистическая регрессия в 2017-м, двухбашенная модель в 2018-м. Две башни отдельно кодируют пользователя с запросом и заведение; заранее рассчитанные векторы заведений позволяют быстро получать оценки.
Обратная сторона — ограниченные взаимодействия признаков разных сторон. В 2019 году к выходам башен добавляли пересечения и GBDT, а с 2020 года исследовали сквозную нейросетевую предварительную модель. Это не утверждение об общем запрете двух башен: в источнике речь о том, чего стало не хватать конкретному поиску.
Сложную финальную сеть нельзя просто скопировать на раннюю стадию. Одна и та же операция, применённая к тысячам кандидатов вместо сотен, создаёт другой бюджет. Поэтому следующий шаг — передать часть её знания дешёвой модели во время обучения, сохранив быстрый онлайн-путь.
§2: 粗排演进路线Показанные кандидаты — не весь мир предварительной модели
Клик, заказ или оплата возникают только у объектов, дошедших до показа. А предварительная модель должна оценить и множество непоказанных объектов. Обучение только на пользовательской реакции поэтому имеет смещение отбора: данные зависят от предыдущих решений каскада.
У финального ранжировщика есть дополнительные решения о кандидатах, которые он оценил, но не показал высоко. Их можно использовать для подготовки обучающих сравнений ранней модели. При этом плохая позиция дорогой модели — её оценка, а не наблюдённый отказ пользователя. Кейс не превращает непоказанный объект в достоверно нелюбимый товар.
Для согласования Meituan исследует три направления: передать порядок списка, приблизить численные оценки и приблизить структуру внутренних представлений. Эти направления дополняют обучение по реальным действиям, но не создают независимую истину о каждой возможной выдаче.
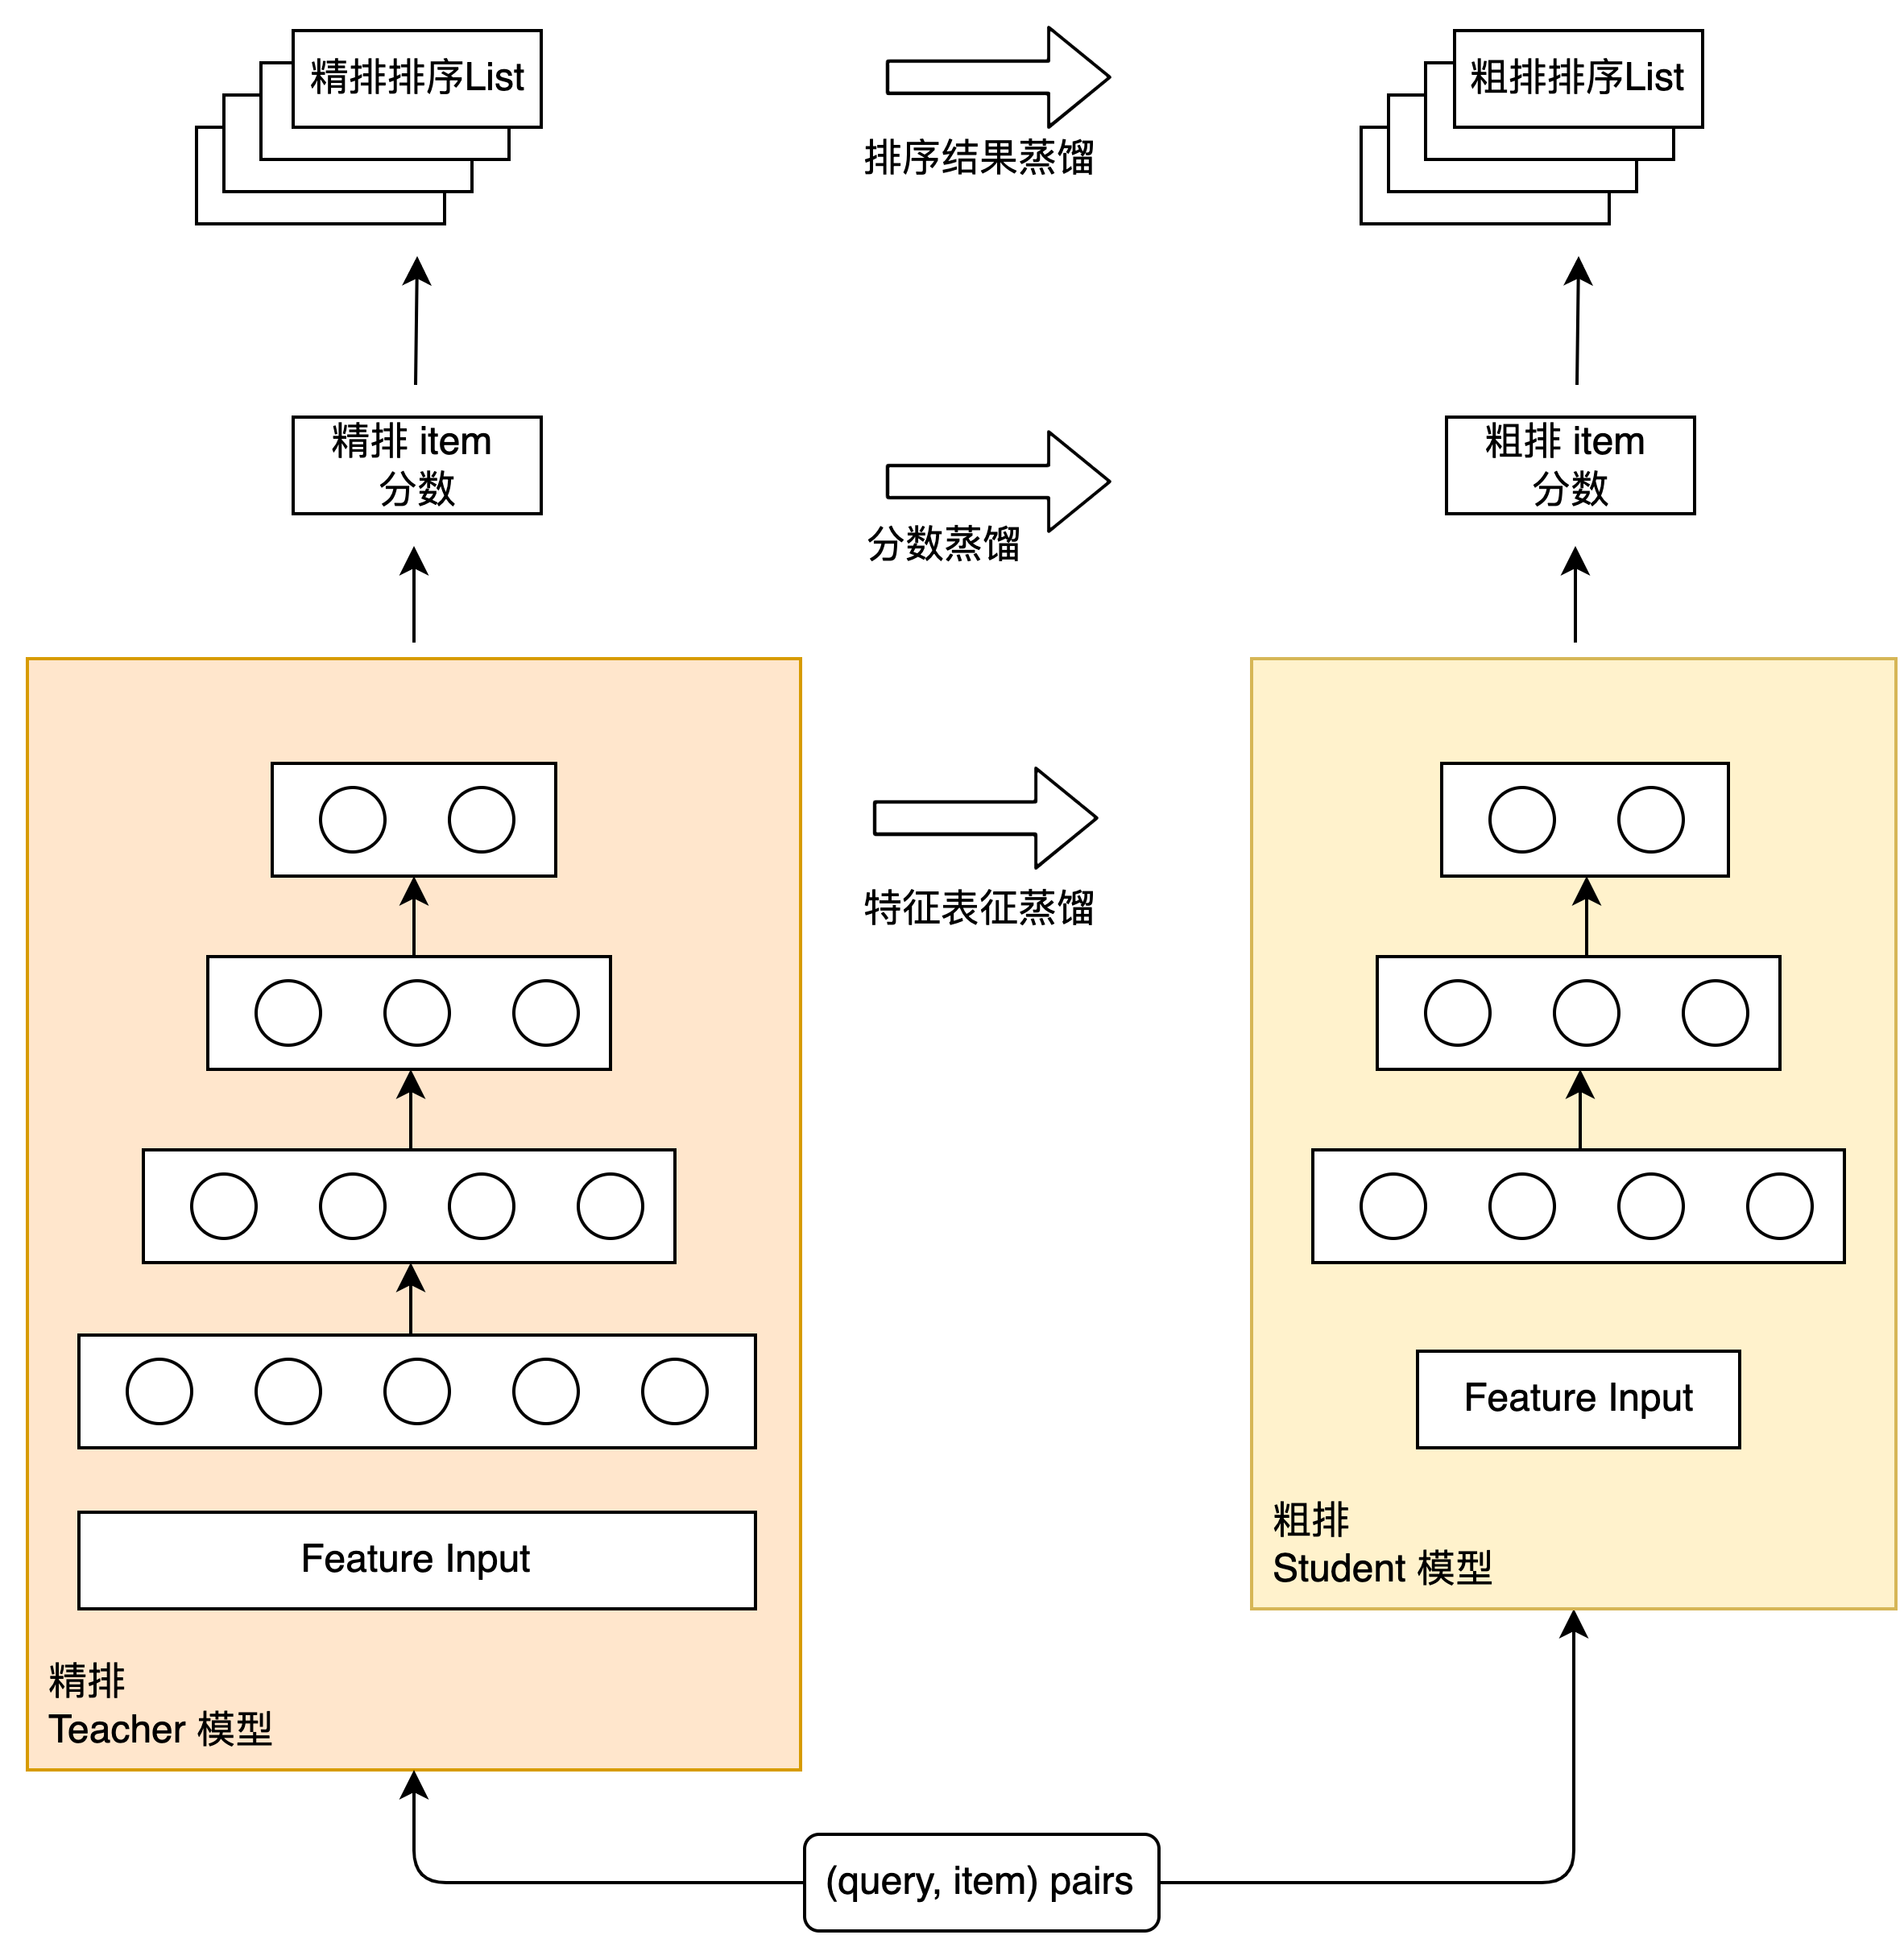
Рисунок 2: дорогая модель учит предварительную на уровне списка, численных выходов и представлений. Передача знания происходит при обучении.
Источник: Оригинальная иллюстрация · MeituanКак из списка учителя строили обучающие пары
Таблицу можно прокрутить по горизонтали.
Первая стратегия расширяет негативную выборку ранней модели. Вторая сильнее использует относительный порядок учителя, вместо обучения только по факту пользовательского действия. Третья объединяет позиции в уровни релевантности и сравнивает эти уровни.
Из текста можно понять направление последовательной доработки, но нельзя механически сложить все приведённые проценты CTR с последующими опытами и объявить результатом одного общего A/B-теста. Модель, выборка и исходный вариант по ходу работы меняются.
§3.1.1: три стратегииЧто добавляет дистилляция численных оценок
Порядок списка показывает, какой объект учитель поставил выше, но скрывает размер различия между оценками. Meituan добавляет приближение выходов заранее обученного финального ранжировщика. Предварительная модель получает дополнительную функцию потерь на разницу своих численных оценок с оценками учителя.
В статье описана квадратичная ошибка и коэффициент lambda, регулирующий её вклад в общую цель. Это отдельная настройка силы дистилляции: слишком большое требование повторять учителя может мешать собственной обучающей задаче. Точного универсального значения коэффициента источник не даёт.
Для добавленного способа авторы сообщают о +5 п.п. Recall@150 и +0,05% CTR. Эти результаты относятся к очередному сравнению внутри их работы; они не означают, что в любом поиске простое добавление MSE к оценке учителя принесёт ту же величину.
§3.1.2: 精排预测分数蒸馏Почему простого сходства скрытых векторов оказалось мало
Скрытые представления учителя содержат больше, чем одна итоговая оценка. Но прямое приближение отдельных координат не обязательно сохраняет отношения между объектами. Для ранжирования важно не только сходство одного вектора, но и сравнительная структура: какие пары учитель считает близкими и какие различает.
Meituan дополняет предыдущую функцию потерь контрастивной передачей представлений. На исходной схеме сопоставляются представления ученика и учителя, положительные и отрицательные пары. Цель — передать полезные отношения, а не заменить маленькую сеть всем вычислительным графом большой.
В статье для этого этапа заявлены +14 п.п. Recall@150 и +0,15% CTR. Более подробный метод вынесен в отдельную первичную работу по ссылке [10]. Сам блог не раскрывает весь набор гиперпараметров и состав каждой пары, поэтому эти детали не восстанавливаются по рисунку догадками.
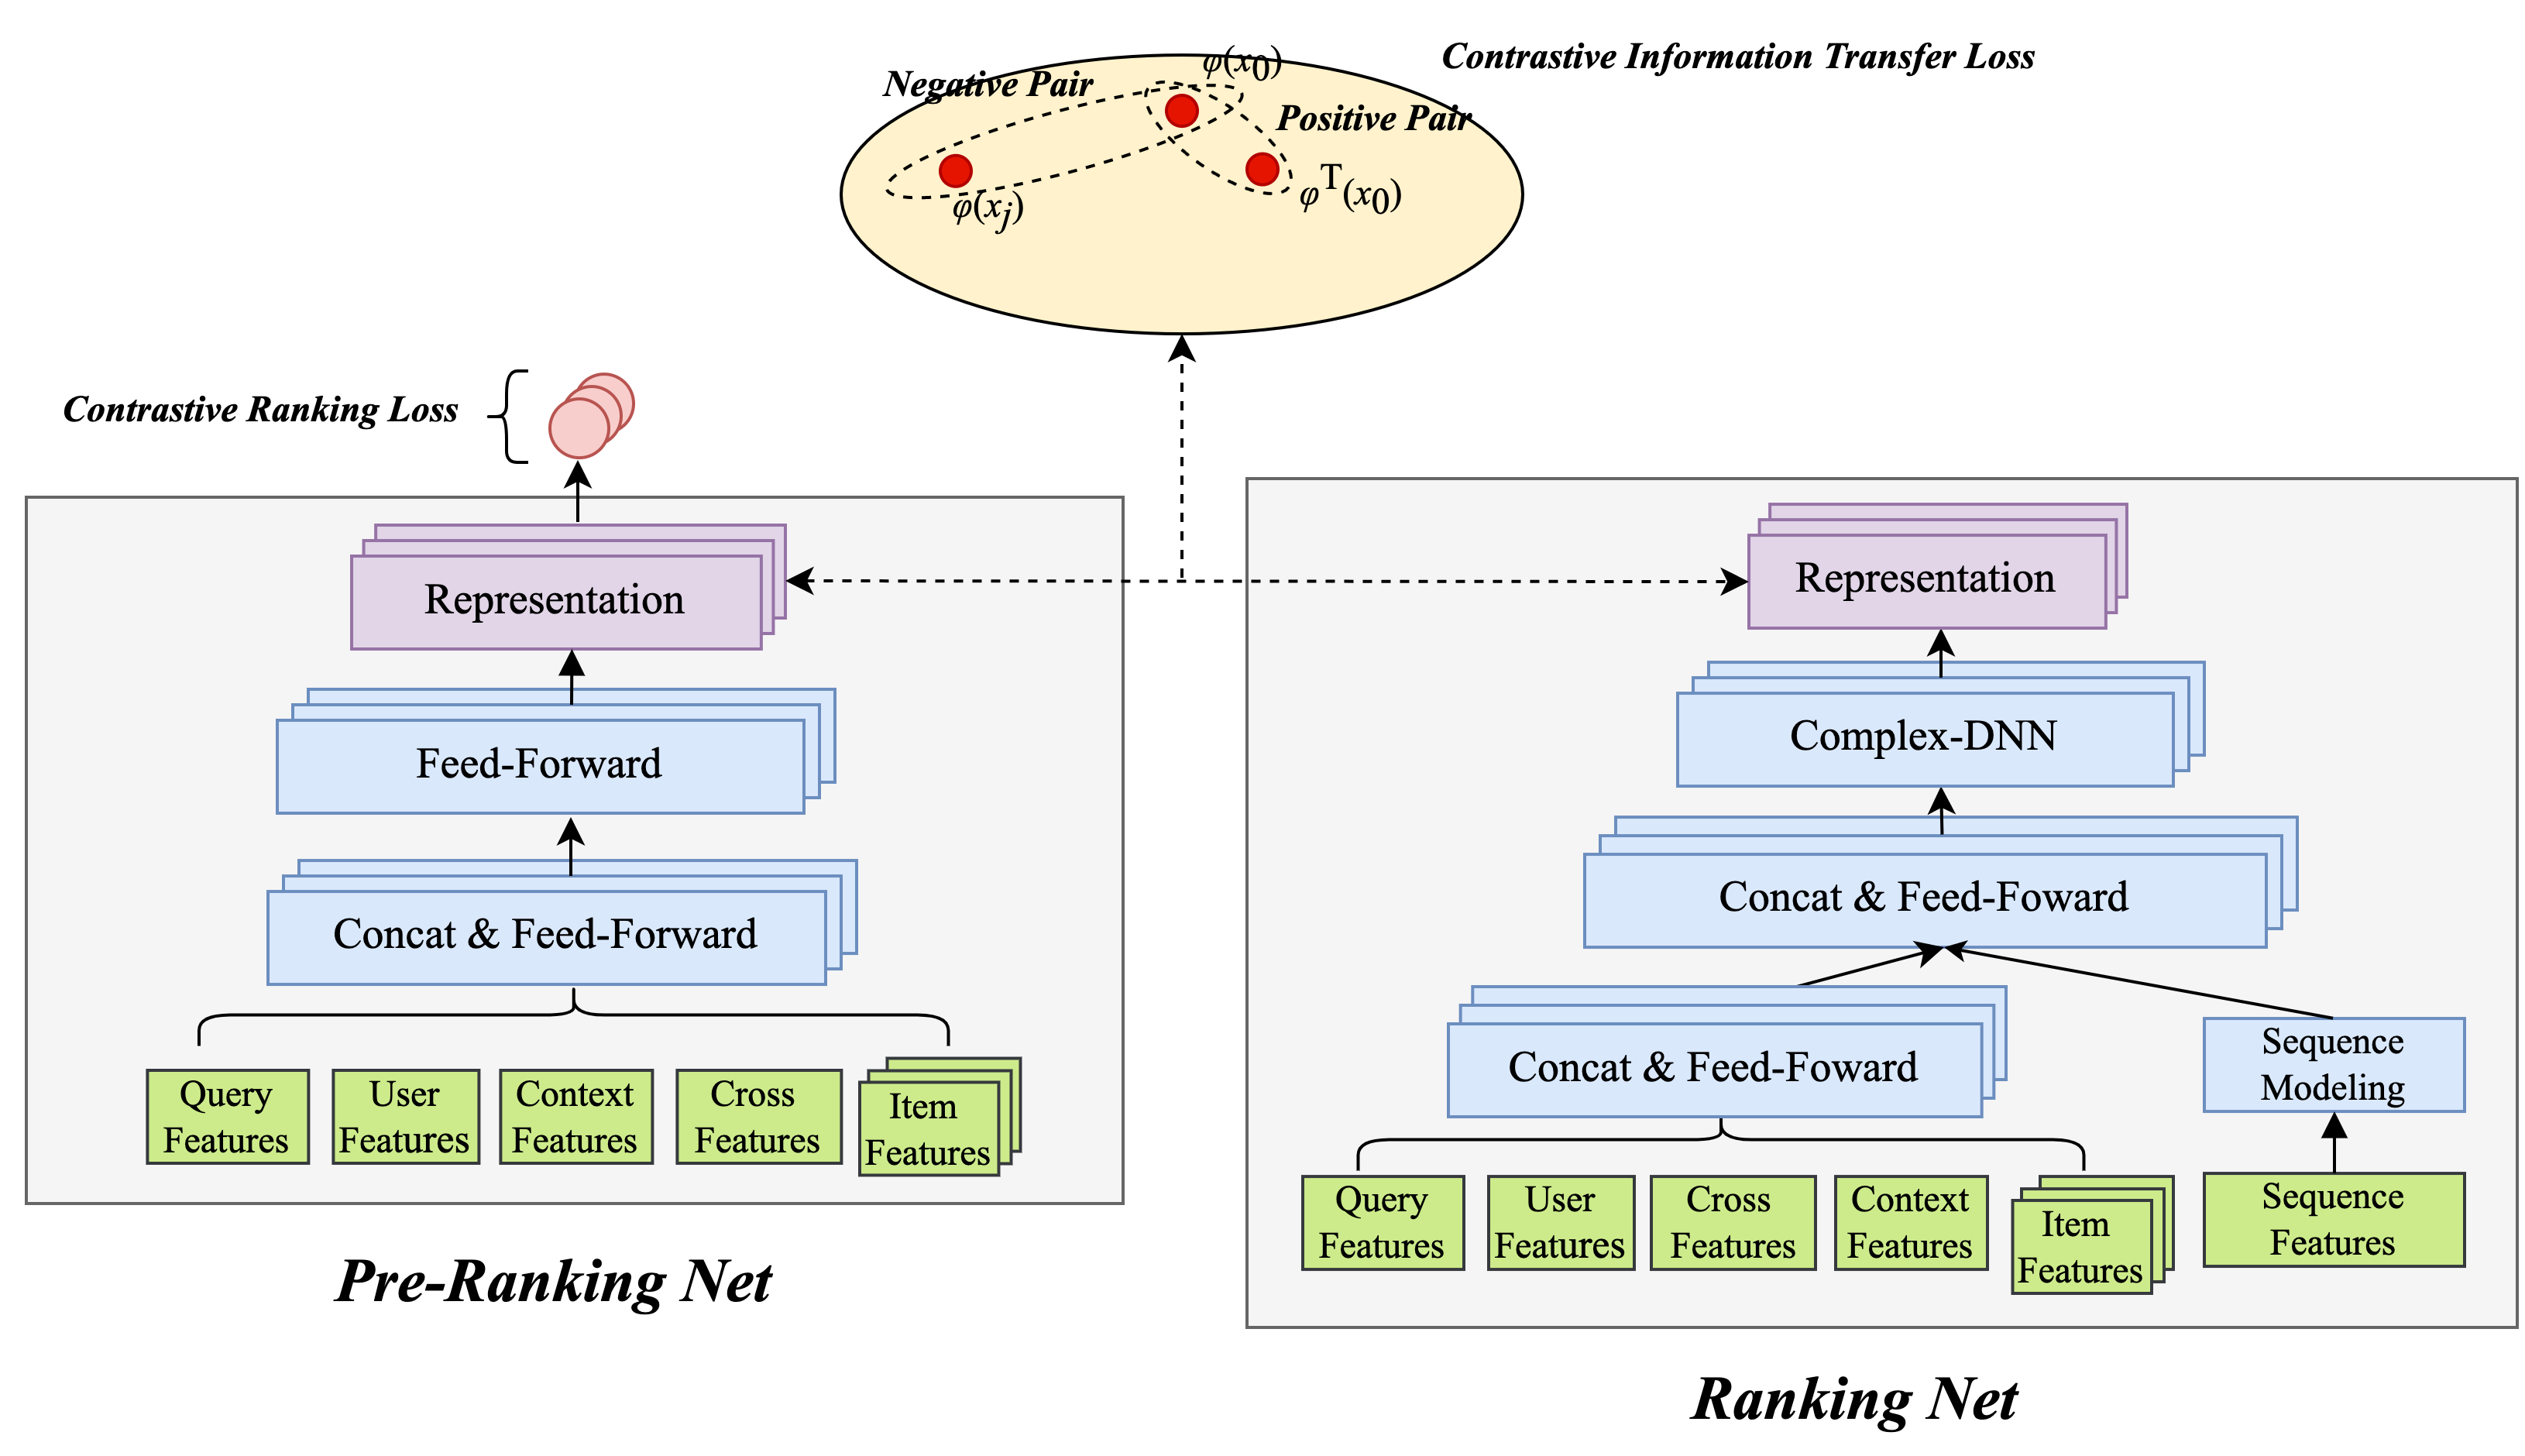
Рисунок 6: контрастивная передача информации между представлениями предварительной и финальной моделей. Это обучающий механизм, а не дополнительные онлайн-вычисления полного учителя.
Источник: Оригинальная иллюстрация · MeituanПочему одновременно выбирают признаки и структуру сети
Даже при хорошем учителе заранее фиксированная маленькая архитектура может быть плохим компромиссом. Простое добавление богатых пересечений признаков, по опыту авторов, не укладывалось в требования задержки. Поэтому они исследуют NAS — поиск структуры нейросети с несколькими целями.
В пространстве поиска рассматриваются и наборы признаков, и варианты вычислительных блоков. На рисунке показан выбор между MLP разной ширины и нулевой операцией, позволяющей не использовать ветвь. Обучение выбирает, куда действительно стоит потратить ограниченные вычисления, а не только максимизирует качество при заранее заданной сети.
Знание учителя остаётся частью этой настройки. Сначала выбрать архитектуру только по пользовательской задаче, а потом отдельно заставлять её копировать учителя может дать менее удачный итог. В данном кейсе согласование стадий и вычислительный бюджет рассматриваются совместно.
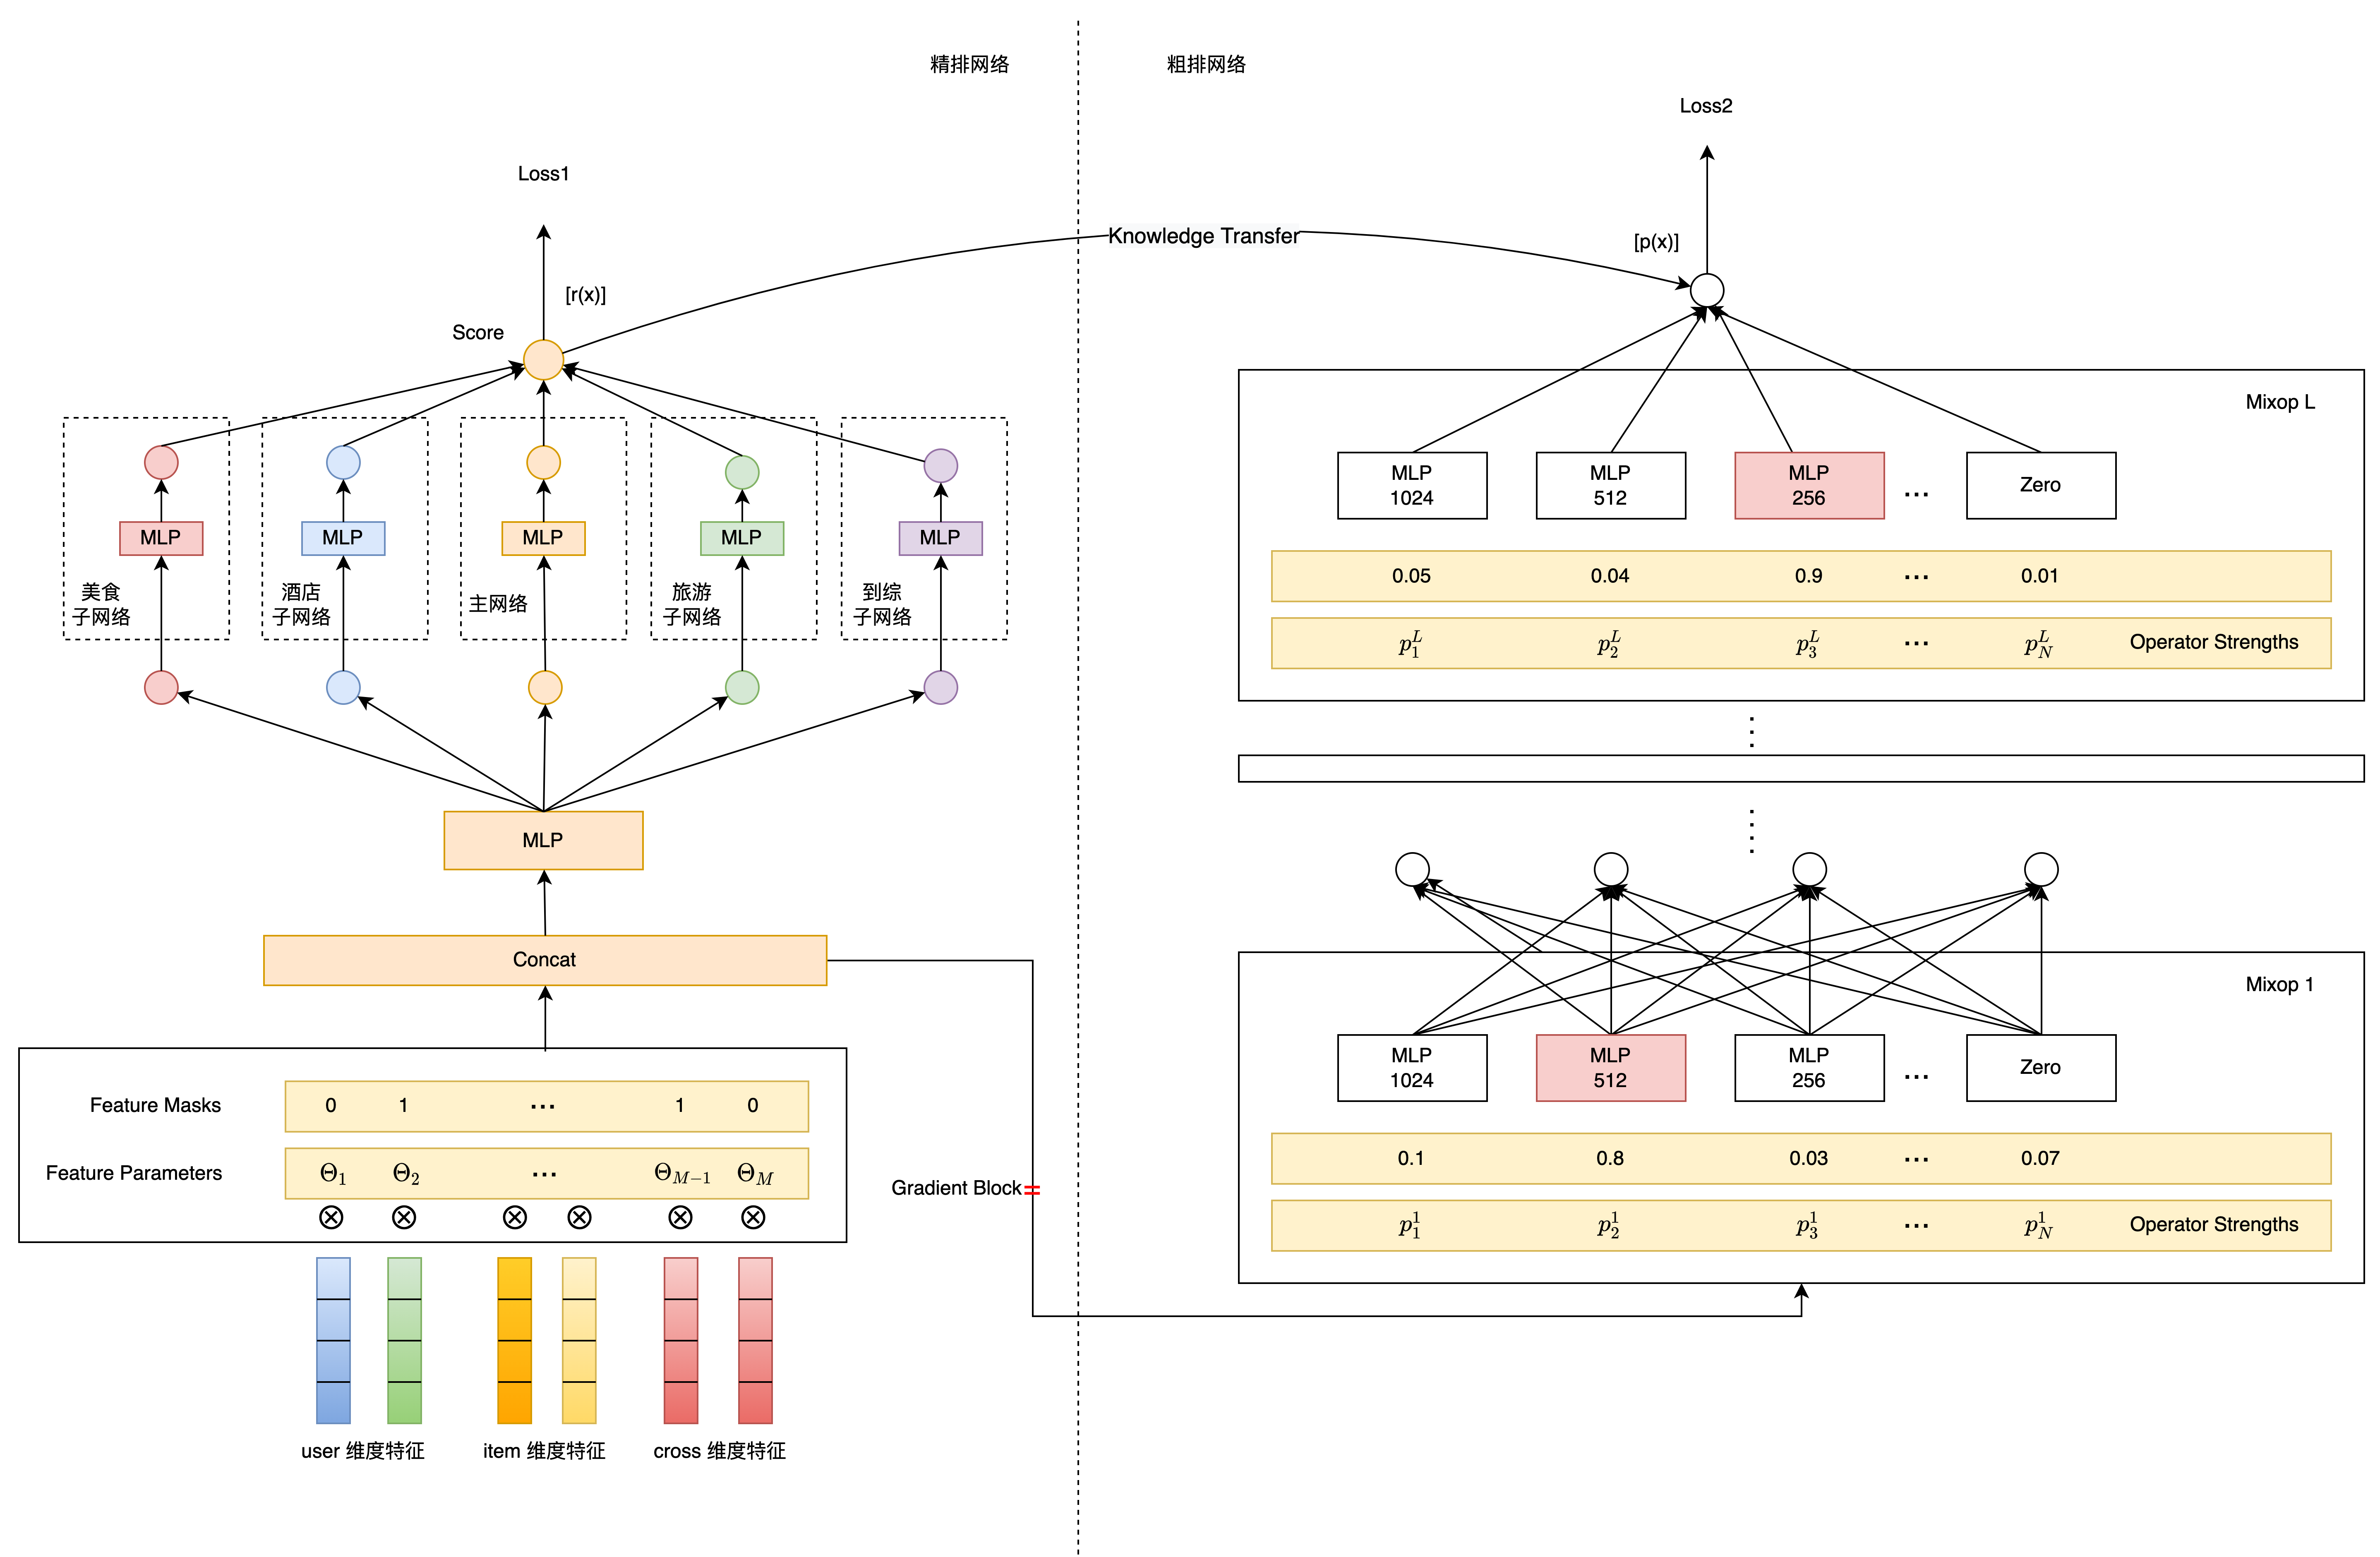
Рисунок 7: совместный выбор признаков и структуры. Варианты блоков разной ширины и Zero образуют пространство поиска, а не все исполняются в конечной модели одновременно.
Источник: Оригинальная иллюстрация · MeituanВремя ответа становится измеримой частью поиска
FLOPs или число параметров — недостаточная замена времени выполнения. Две похожие по арифметике сети могут по-разному обращаться к памяти и использовать оборудование. В показанной модели задержки учитываются варианты операторов, размеры их входов и вероятности выбора ветвей.
На рисунке 8 ожидаемая задержка следующего блока выражается через вероятности выбора разных MLP и время переходов между размерностями. Это позволяет штрафовать дорогие решения во время поиска. Но ожидаемая величина всё равно является моделью затрат; выбранную конечную архитектуру нужно отдельно проверить в реальном сервисе.
Итоговый описанный NAS-опыт дал +11 п.п. Recall@150 и +0,12% CTR без увеличения онлайн-задержки. Абсолютные миллисекунды, полный профиль оборудования и стоимость обслуживания в блоге не опубликованы. «Задержка не выросла» поэтому сохраняется как сравнение авторов, а не готовый SLA для другого продукта.
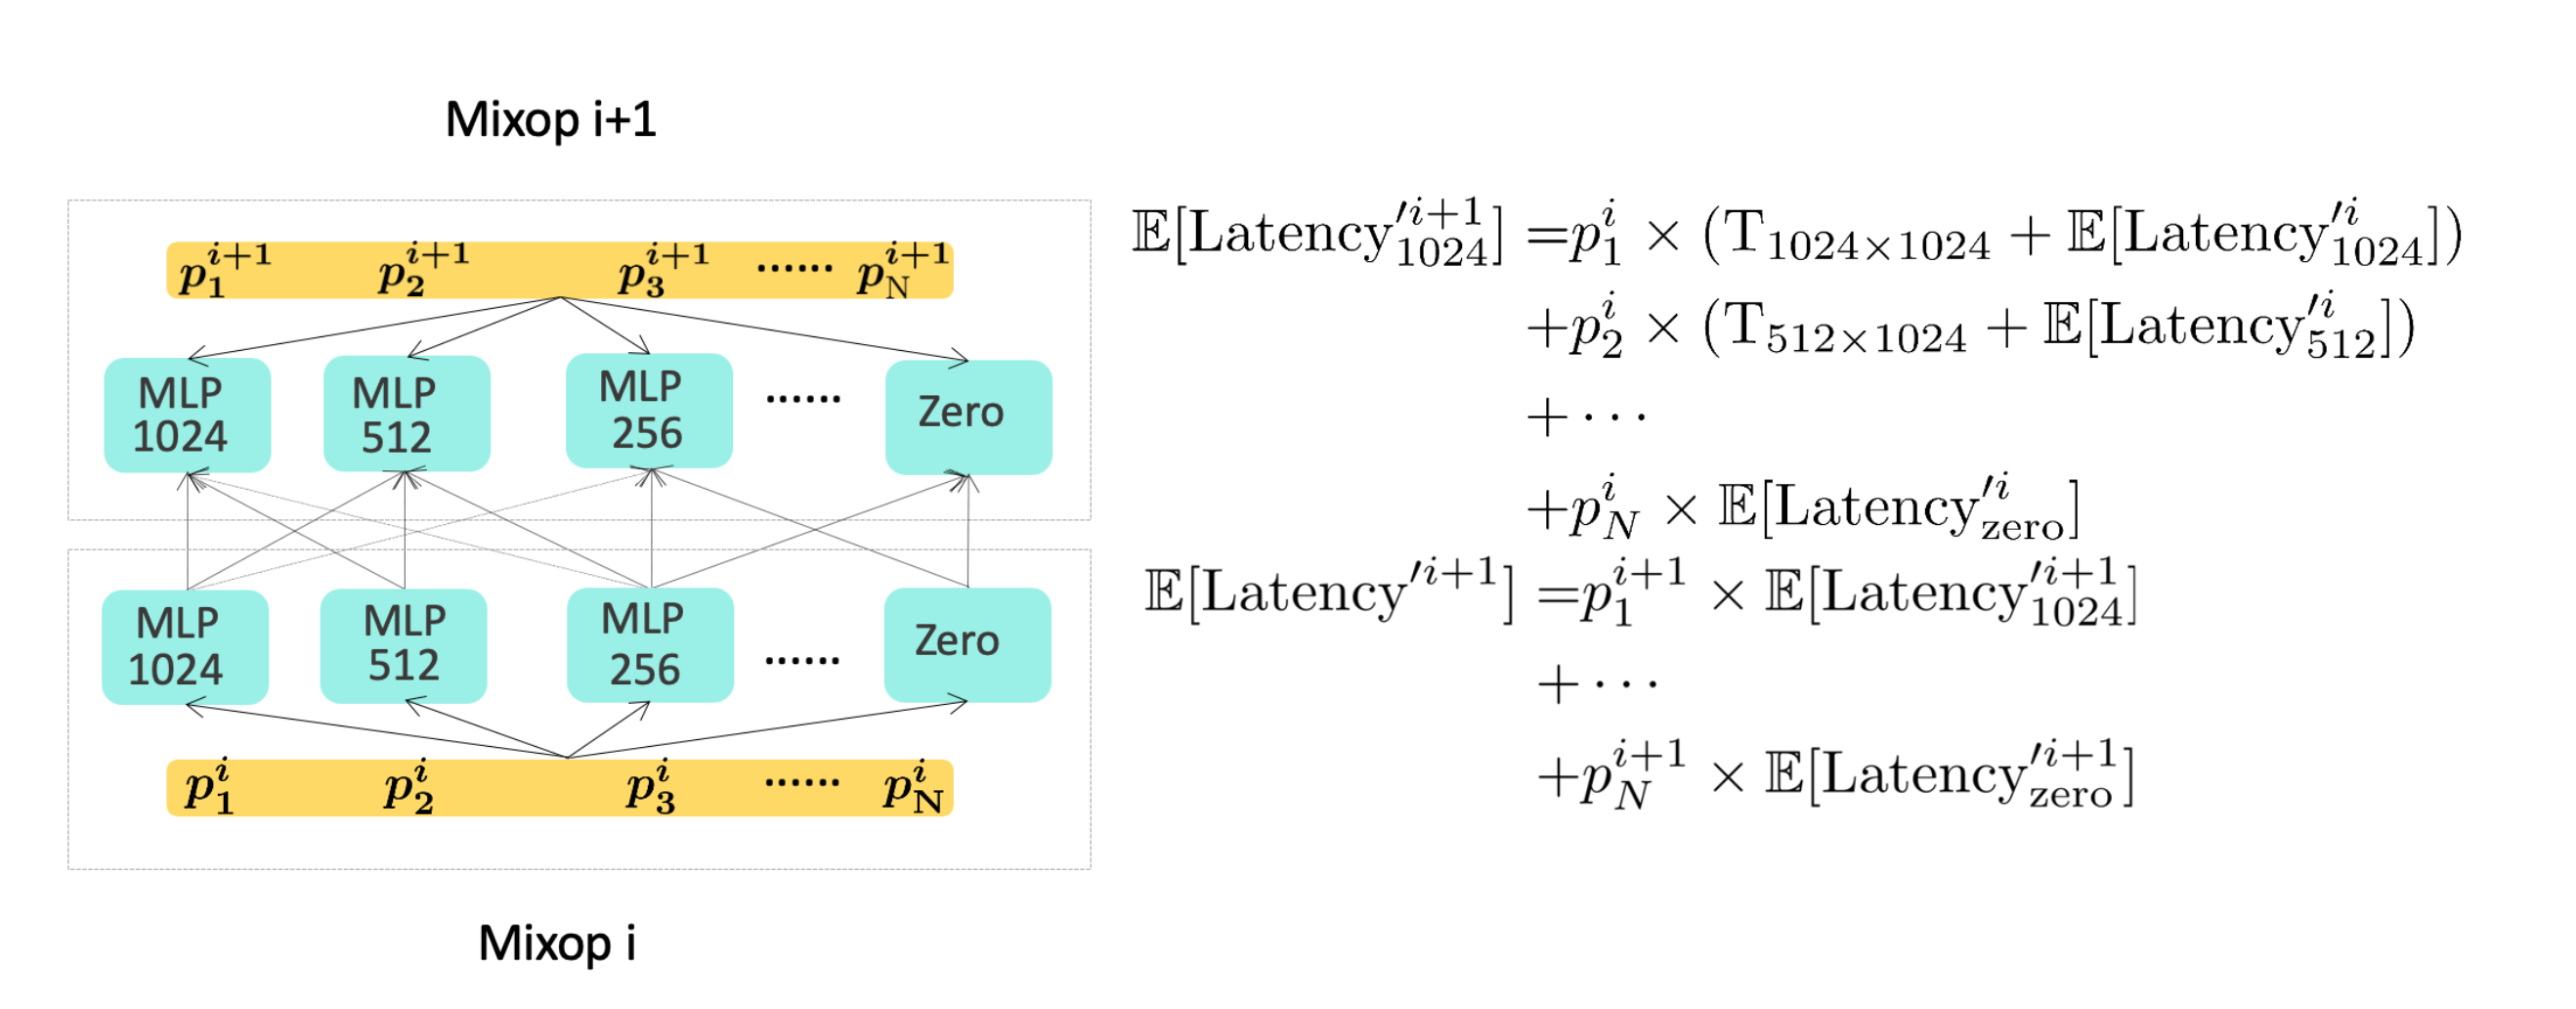
Рисунок 8: расчёт ожидаемой задержки с учётом выбора блока и входной размерности. Это часть поиска структуры; окончательный вариант ещё требует замера онлайн.
Источник: Оригинальная иллюстрация · MeituanЧто на самом деле измеряет Recall@150
В приложении Recall определяется по пересечению верхних K объектов предварительной модели с верхними K объектами финального ранжировщика. Учитель задаёт эталонное множество. Такой показатель отражает способность ранней стадии сохранить объекты, которые ценит следующая.
Это не классический recall всех купленных товаров каталога и не точность пользовательской разметки. Если дорогая модель ошибается или имеет собственное смещение, согласование с ней не устраняет эти ограничения. Поэтому в статье офлайн-метрика подтверждается отдельными онлайн-изменениями CTR.
Увеличение Recall на 5 п.п. означает изменение доли пересечения на пять процентных пунктов. Оно не тождественно относительному росту Recall на 5%. Изменения CTR в тексте записаны процентами; без исходных значений их нельзя переводить в дополнительные клики на заданное число пользователей.
§5: 附录 — определение RecallКак использовать этот кейс рядом с большими моделями
Кейс показывает, что сильный финальный ранжировщик полезен не только на последней стадии. Его решения могут улучшить более дешёвую раннюю модель через данные и обучение, не добавляя полный онлайн-проход учителя. Это другой путь, чем обязательное объединение всех стадий в один генератор.
Авторы сообщают о внедрении описанных работ, а дальнейшие направления — многозадачное предварительное ранжирование и более динамическое распределение вычислений — перечисляют отдельно. Упоминание планов и ранних наблюдений не превращает их в измеренный результат всех описанных сравнений.
Для практического обсуждения сначала определите, какие хорошие кандидаты теряются на ранней стадии, затем выберите эталонное множество, данные для дистилляции и допустимый бюджет. После этого сопоставьте OneRec, который исследует объединение выбора списка, и RankMixer, который перестраивает плотную модель под GPU. Это альтернативы под разные ограничения, а не доказанная линейка от «устаревшего каскада» к единственному правильному решению.
§4: 总结 и ограничения раскрытия