Разбор готов
Lamoda: как устроили рекомендации похожих товаров
В ленте «Похожие» недостаточно найти товары одного цвета или бренда: в каталоге одежды сходство может определяться силуэтом, стилем, ценой, категорией, изображением и тем, что выбирает конкретный пользователь. При этом в каталоге Lamoda сотни тысяч товаров, поэтому нельзя каждый раз прогонять весь ассортимент через тяжёлую модель. В разборе проследим весь путь системы: от прежнего атрибутного алгоритма и его ограничений до двух новых источников кандидатов, совместного обучения на изображениях и описаниях, детектора одежды, персонального ранжирования с CatBoost и работающей системы, где офлайн-расчёт отделён от онлайн-ранжирования.
Материал полезен ML- и RecSys-инженерам, которые строят многоэтапные рекомендации и хотят увидеть не только удачную модель, но и полный путь экспериментов: как собирать пары, выбирать сложные отрицательные примеры, сравнивать энкодеры и функции потерь, контролировать разнообразие источников кандидатов и учитывать стоимость онлайн-ранжирования.
Статья · на русском
Эволюция similar-рекомендаций: как мы переосмыслили ленту похожих товаровДмитрий Борисов · Опубликовано: 30 июня 2026 г.
Почему похожие товары — это многоэтапная задача
Lamoda начинает не с конкретной нейросети, а с архитектурного ограничения. В каталоге находятся сотни тысяч товаров, поэтому тяжёлая модель не должна сравнивать запрос с каждым товаром. Сначала система делает отбор кандидатов: быстро собирает небольшой набор товаров, которые могут быть похожи на исходный. Затем реранкер — более дорогая модель повторного ранжирования — переставляет кандидатов с учётом пользователя, контекста и дополнительных признаков. После модели действуют правила итоговой выдачи: доступность, допустимые категории, ограничения отображения и другие продуктовые условия. Только после этих стадий пользователь получает готовую ленту.
Саму похожесть можно определять по разным сигналам. Рекомендации по содержанию товара используют категорию, бренд, цвет, цену, материал и стиль: такой подход понятен, но хуже ловит общий визуальный образ или силуэт. Поведенческие модели опираются на совместные просмотры, корзины и заказы; сигнал ближе к реальному спросу, зато у нового товара ещё нет истории. Графовые методы могут описывать связи «пользователь — товар» и «товар — товар», но требуют отдельной инфраструктуры и обновления графа. Deep similarity вместо явного правила строит векторное пространство, где похожие товары должны оказаться рядом; туда можно свести изображения, текст, атрибуты и поведение, но обучение и внедрение сложнее.
Прежняя система Lamoda уже сочетала два источника: визуальный поиск по фотографии и контентный поиск по атрибутам. В интерфейсе они были разделены на «баблы»: «Визуально», «В стиле этого бренда», «Этого цвета». Визуальный источник позже сохранился как отдельный кандидатный генератор, поэтому важнее понять, как была устроена атрибутная часть и почему её возможностей перестало хватать.
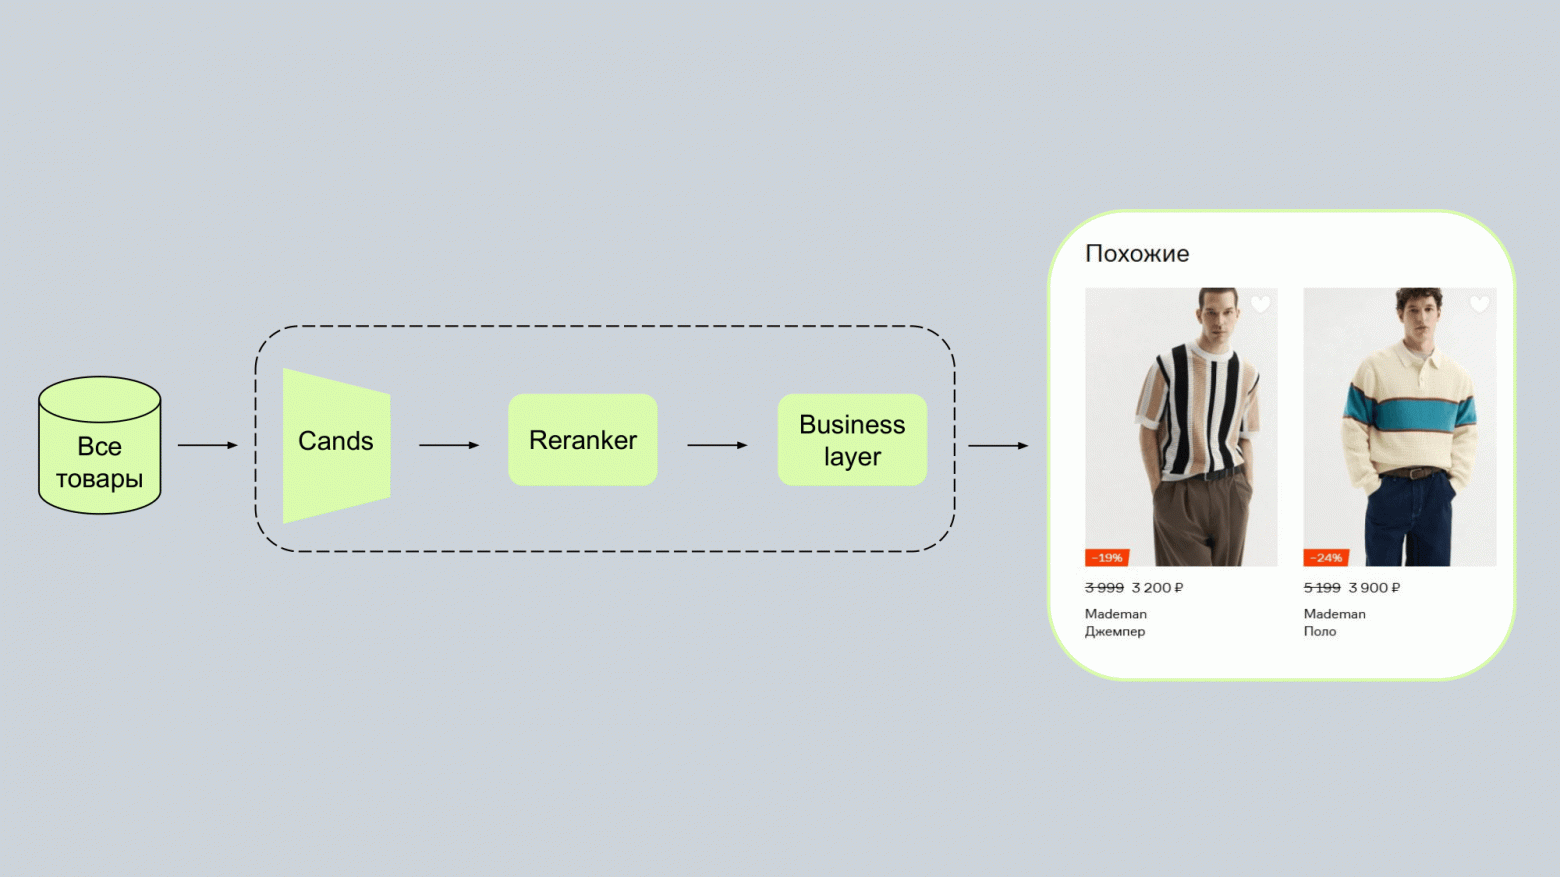
Каскад Lamoda: сначала отбор кандидатов, затем точное ранжирование и бизнес-правила. Это позволяет работать с большим каталогом.
Источник: Lamoda, исходная статьяСтарая модель на атрибутах: мягкая похожесть атрибутов и отдельные веса по категориям
Контентную модель обучали на парах товаров. Для каждой пары строили признаки близости по бренду, цвету, цене, категории и другим атрибутам. С числовыми признаками можно было получить непрерывную оценку — например, привести близость цен к шкале от 0 до 1. Для категорий простой тест «совпало / не совпало» оказался слишком грубым: разные бренды или цвета тоже могут быть близкими именно в конкретном товарном контексте.
Чтобы получить более мягкую близость категориальных атрибутов, команда использовала Word2Vec. Входом был не голый атрибут, а атрибут вместе с контекстом товара: условно не просто «розовый», а «женские юбки + розовый». В роли последовательностей для обучения использовали реальные заказы и исходили из предположения, что товары одной категории в одном заказе часто могут быть заменителями или близкими альтернативами. После такого обучения появлялись контекстные связи: для женских юбок розовый оказывался близок к бежевому, а для мужских джинсов Armani — к Hugo Boss. Это не универсальные утверждения о цветах или брендах, а связи, извлечённые в конкретных товарных контекстах.
Затем для каждой пары формировали общий вектор признаков похожести и обучали линейную модель, которая определяла вес каждого признака. Целевая метка равнялась 1, если два товара одной категории встретились в одном заказе, и 0 для случайной пары товаров той же категории. Одной модели на весь каталог не было: отдельные линейные модели обучали для обуви, джинсов, футболок и других категорий, потому что сама логика похожести различалась. Итоговая оценка была взвешенной суммой признаков.
Обучение старой системы проходило на месячном окне данных. Результаты подтверждали необходимость разных весов: для спортивной обуви важными оказывались цена, вид спорта и бренд, а для женских платьев заметную роль играла более детальная каталожная категория — например, повседневное, вечернее или праздничное платье. Такой подход особенно хорошо использовал качественное каталожное дерево Lamoda.
«Базовая архитектура и старый алгоритм», от «Чтобы обучить такую content-модель...» до абзаца про месячное окно и разные важности атрибутовЧто старая система умела и чего ей не хватало
Таблицу можно прокрутить по горизонтали.
Переход к новой системе поэтому не был попыткой заменить «плохую» модель. Старая схема решала задачу, поддерживала холодный старт и давала объяснимые результаты. Изменение понадобилось из-за накопившихся требований: объединить изображения и текст, уменьшить число отдельных моделей, получить единое векторное представление товара и добавить персонализацию на последующей стадии.
Одновременно команда упростила пользовательский интерфейс. От трёх баблов отказались: по статистике, пользователи редко переключались между ними и обычно оставались на первом. Вместо ручного выбора режима два источника кандидатов начали смешивать в одной полке. Это продуктовая причина, которая напрямую повлияла на архитектуру: источники должны были не дублировать друг друга, а давать разные типы похожести для одного общего реранкера.
«Базовая архитектура и старый алгоритм», блок «Что хорошо работало / Чего не хватало»; «Обновляем алгоритм рекомендаций», абзац об отказе от бабловНовая постановка: обучение похожести и поведение как разметка похожести
Основной новый кандидатный алгоритм обучали через metric learning — обучение пространства векторов, где похожие товары нужно приблизить, а непохожие отдалить. У каждого обучающего примера есть товар-якорь, положительный товар, который считается похожим, и отрицательный товар, который должен лежать дальше. В такой постановке критично не только выбрать архитектуру, но и определить, что именно считать положительной связью.
Положительные пары собирали из двух поведенческих источников. Первый — заказы: если товары одной категории попадали в один заказ, их относили к одному классу похожести, сохраняя прежнюю идею о заменителях и близких альтернативах. Второй — пользовательские сессии. Если за одну сессию человек смотрел товары одной категории с близкими ключевыми атрибутами, их тоже использовали как положительные примеры. Для сессий условие делали строже, потому что просмотров существенно больше, чем заказов, и среди них больше шума.
Отрицательные примеры не выбирали только случайно заранее. Во время обучения применяли hard negative mining — поиск сложных отрицательных примеров: товаров, которые модель уже считает визуально или семантически близкими к якорю, хотя они не входят в его положительный класс. Такие ошибки информативнее очевидно далёких примеров и заставляют модель точнее проводить границу между настоящей похожестью и случайной близостью.
Датасет расширили с месячного окна старой модели до годового, чтобы захватить сезонность fashion-каталога: зимние куртки, летние платья и новогодние товары живут в разных временных режимах. Заказы и сессии держали примерно в пропорции 50/50. Заказов меньше, но это более сильный сигнал выбора, поэтому объём сессионных примеров подгоняли к сопоставимому количеству. Дополнительно пары балансировали по месяцам, чтобы самые активные периоды не вытеснили остальные сезоны.
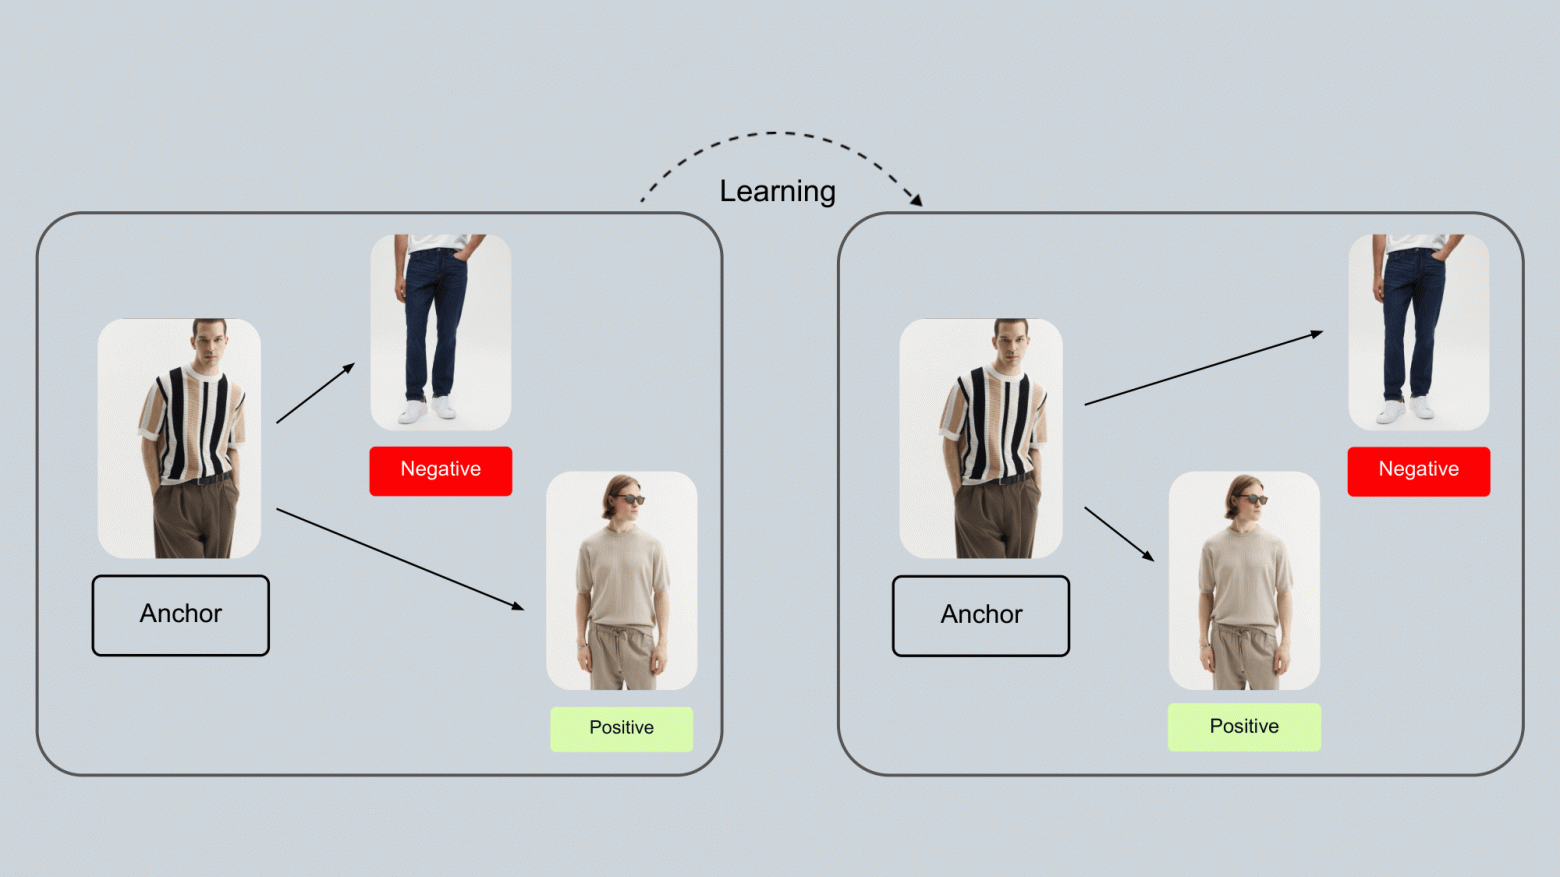
При обучении похожий товар приближается к исходному, а неподходящий отдаляется. Качество этих связей зависит от того, как собрана разметка.
Источник: Lamoda, исходная статьяМультимодальный эмбеддинг и серия экспериментов
Для каждого товара основной алгоритм использует две модальности: фотографию и текстовое описание. Энкодер — модель, превращающая вход в вектор, — отдельно строит вектор изображения и вектор нормализованного текста. После этого два вектора объединяются в один эмбеддинг товара. Во время обучения пакеты примеров балансировали по категориям, чтобы частые группы не доминировали. Для поиска сложных отрицательных примеров использовали Multi Similarity Miner, а для обучения выбранного пространства — Circle Loss.
Команда не зафиксировала архитектуру заранее, а перебрала варианты почти на каждом участке. Для изображения сравнивали fashion-clip, dino-v2 и clip; для текста — rubert-tiny2, ruroberta-large и e5-large. Для объединения модальностей проверяли простую конкатенацию, обучаемые projection-head слои и усреднение. Для функции потерь — triplet loss, contrastive loss и Circle Loss; для расстояния — cosine и euclidean distance; отдельно меняли процедуры поиска сложных отрицательных примеров.
Решение принимали по двум офлайн-метрикам. CMC@8 отвечает на бинарный вопрос: есть ли хотя бы один релевантный товар среди первых восьми кандидатов. Precision@8 измеряет долю релевантных товаров среди этих восьми. Эти две метрики не равны бизнес-эффекту: они оценивают качество списка кандидатов на размеченной выборке.
Таблицу можно прокрутить по горизонтали.
Отрицательные результаты здесь важны не меньше финальной строки. Дообучение заметно превзошло готовые представления; среди готовых baseline сильнее всего оказался только текст. Усреднение и обучаемые projection-head не обошли простую конкатенацию в выбранном сравнении. Triplet Loss, Contrastive Loss и euclidean distance не стали финальными вариантами. Более тяжёлые текстовые энкодеры давали очень близкое качество, но команда не стала выбирать модель только по третьему знаку после запятой: учитывались также скорость, размер и сложность дальнейшего внедрения.
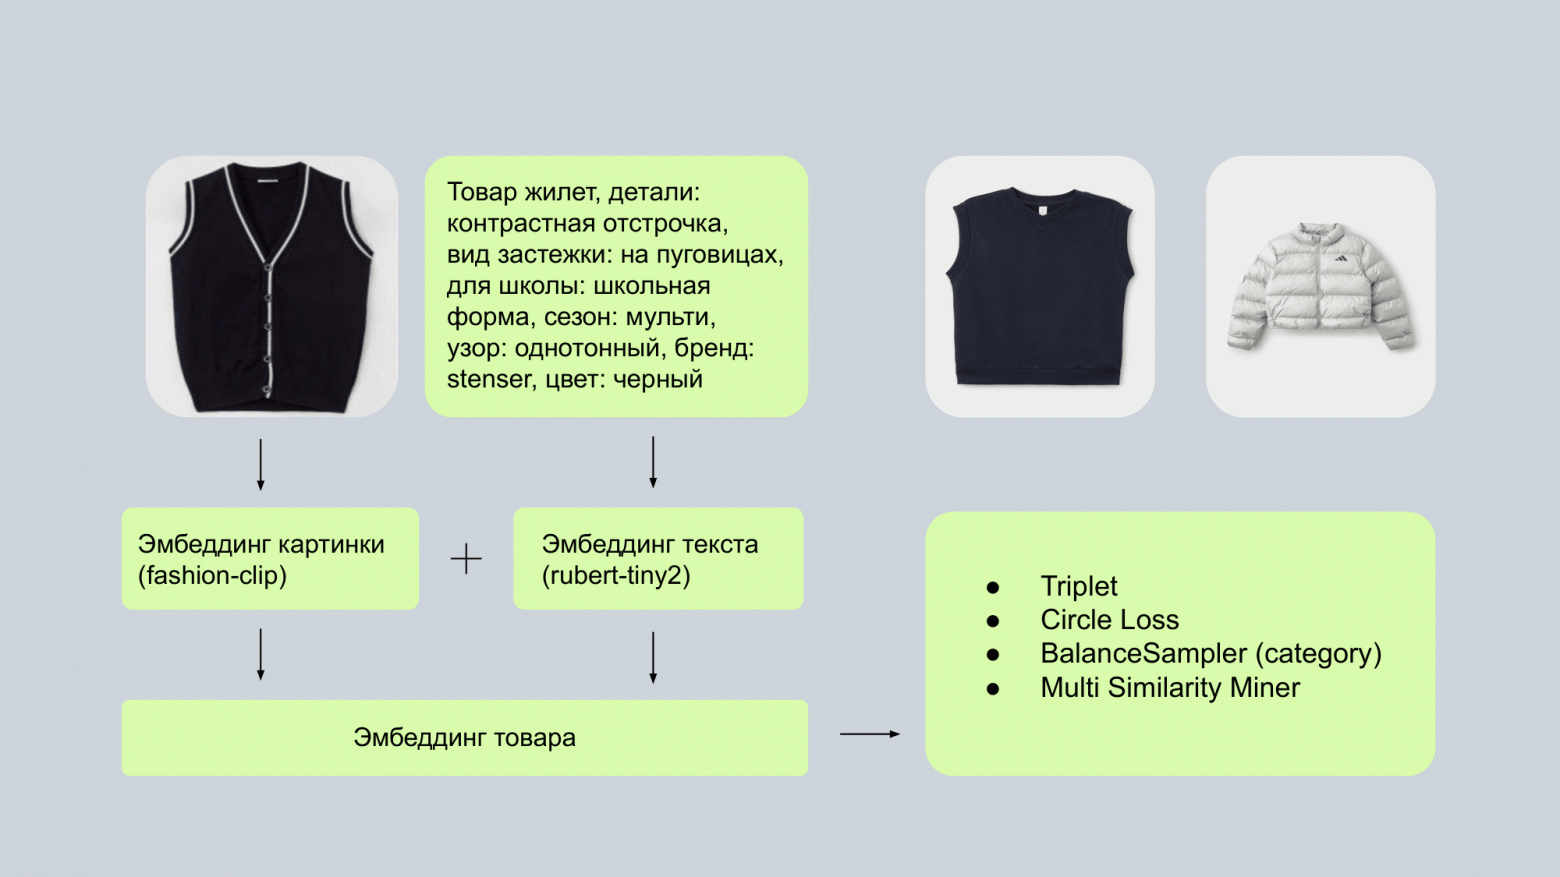
Изображение и описание превращаются в два вектора, которые объединяются в представление товара. Сложные примеры помогают уточнять границы похожести.
Источник: Lamoda, исходная статьяЗачем перед визуальным энкодером понадобился детектор одежды
Фотография товара в fashion-каталоге часто показывает не одну вещь, а целый образ. Если якорный товар — куртка на модели в полный рост, на снимке одновременно могут быть заметны брюки, обувь и аксессуары. Если отправить весь кадр в визуальный энкодер, его вектор может частично описывать эти посторонние объекты. Тогда ближайшими соседями окажутся товары, похожие не на куртку, а на другую крупную деталь снимка.
Поэтому перед вычислением визуального эмбеддинга система находит область нужной одежды. Bounding box — прямоугольник вокруг объекта — задаёт участок изображения, который затем вырезается; в энкодер поступает уже этот кроп. В рабочем основном алгоритме детектор возвращает один из примерно 15 типов объектов, а товарные категории заранее сопоставлены с типами детектора, чтобы выбрать, какой именно объект вырезать.
Фильтры по категории позже всё равно не позволили бы брюкам оказаться в финальной выдаче похожих курток. Но к тому моменту ущерб уже мог быть нанесён: нерелевантные визуальные соседи заняли бы часть ограниченной квоты кандидатов, и реранкер получил бы меньше хороших альтернатив. Поэтому детектор улучшает не только отдельный вектор, а полноту полезного кандидатного набора до поздних фильтров.
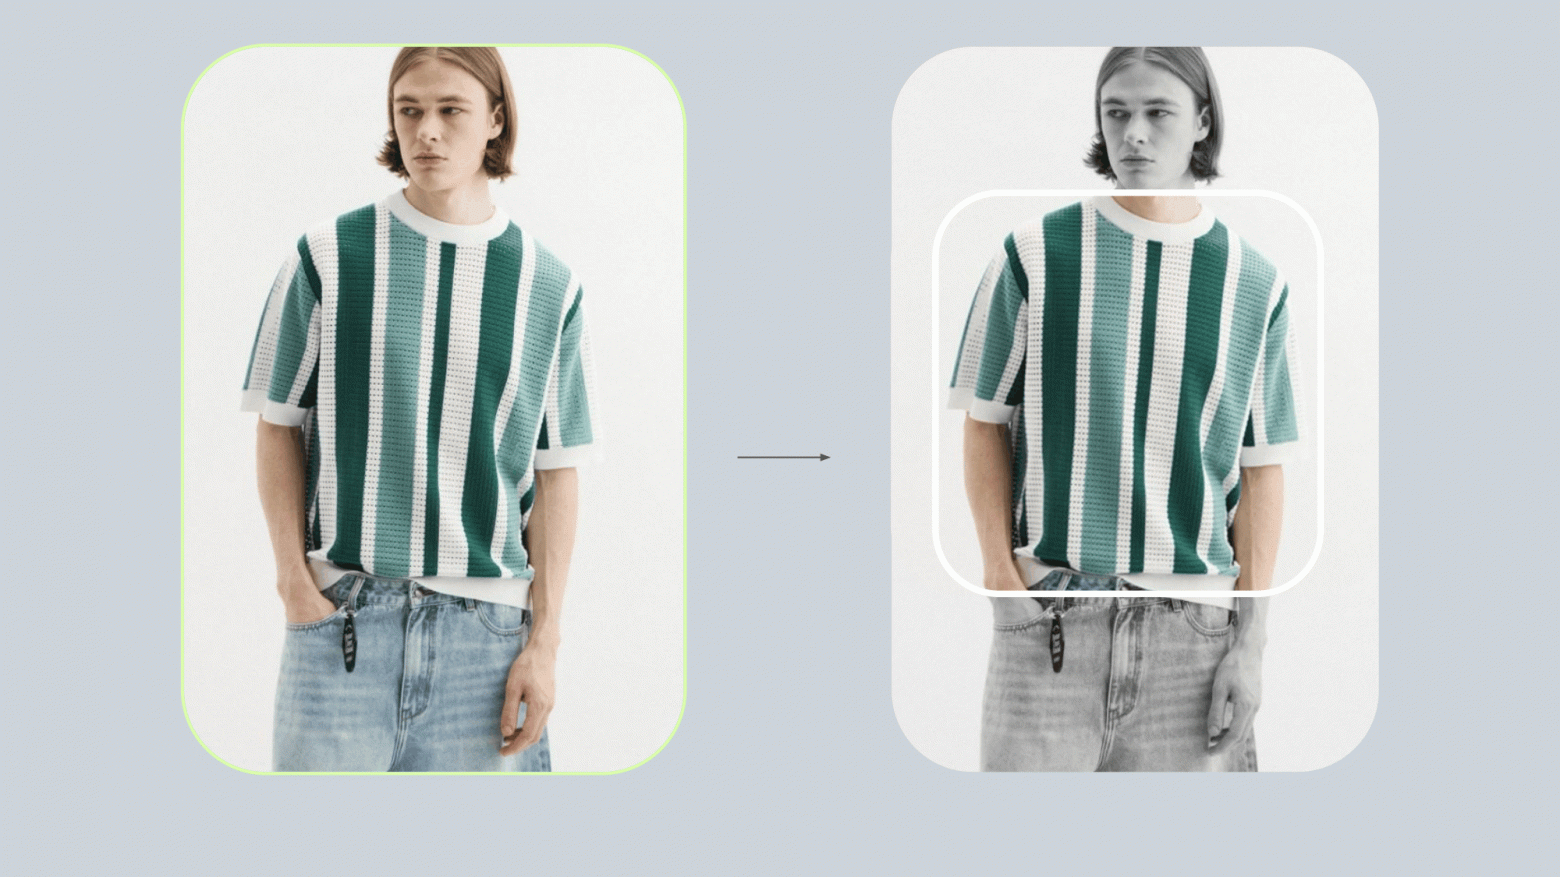
Детектор выделяет нужную вещь на фотографии: брюки и фон не должны определять похожесть футболки.
Источник: Lamoda, исходная статьяДва источника кандидатов и контроль их пересечения
Основной кандидатный алгоритм использует и изображение, и текст. Фотография проходит через детектор, нужная область обрезается и кодируется визуальным энкодером; текст нормализуется, предварительно обрабатывается и кодируется отдельно. Векторы конкатенируются, после чего для каждого якорного товара ищутся ближайшие соседи в общем пространстве. Затем система применяет правила по доступности, категории, полу, ассортиментным ограничениям и другим условиям. Готовый список кандидатов сохраняется в Aerospike — хранилище «ключ — значение», из которого данные можно быстро забрать при пользовательском запросе.
На стадии отбора кандидатов основной целью была полнота, поэтому новую модель сначала оценивали по recall@k — доле релевантных объектов, которые удалось включить в первые k кандидатов. Источник сообщает о значимом росте recall@k, но не приводит численное значение и k в этом сравнении. На исторических сессиях дополнительно выросли продуктовые прокси: просмотры страниц на 13%, а добавления в корзину в рамках одной сессии на 30%. Это историческая оценка прокси-показателей, а не заявленный финальный A/B-эффект на покупки.
Второй источник — чисто визуальный. Он не дообучается на описанной задаче и использует готовый FashionCLIP as is. При необходимости фотография тоже проходит через детектор; затем строится визуальный эмбеддинг, находятся ближайшие соседи, применяются те же бизнес-ограничения, а кандидаты сохраняются в Aerospike. Визуальные эмбеддинги сохраняются отдельно, потому что позже они нужны ещё и как онлайн-признаки ранжирования. Для этого алгоритма источник сообщает значимый прирост целевой метрики: +2% к добавлению в корзину, но не раскрывает в этом фрагменте дизайн сравнения.
Два источника полезны только тогда, когда они приносят разные товары. Если оба возвращают почти одно и то же, они просто расходуют квоту перед реранкером. Lamoda отдельно измерила пересечение: при генерации 200 кандидатов на каждый якорный товар основной мультимодальный и визуальный источники пересекались примерно на 20%. Команда интерпретировала это как признак взаимодополняемости: первый источник сочетает мультимодальное представление и поведенческую разметку, второй сильнее фокусируется на внешнем сходстве.
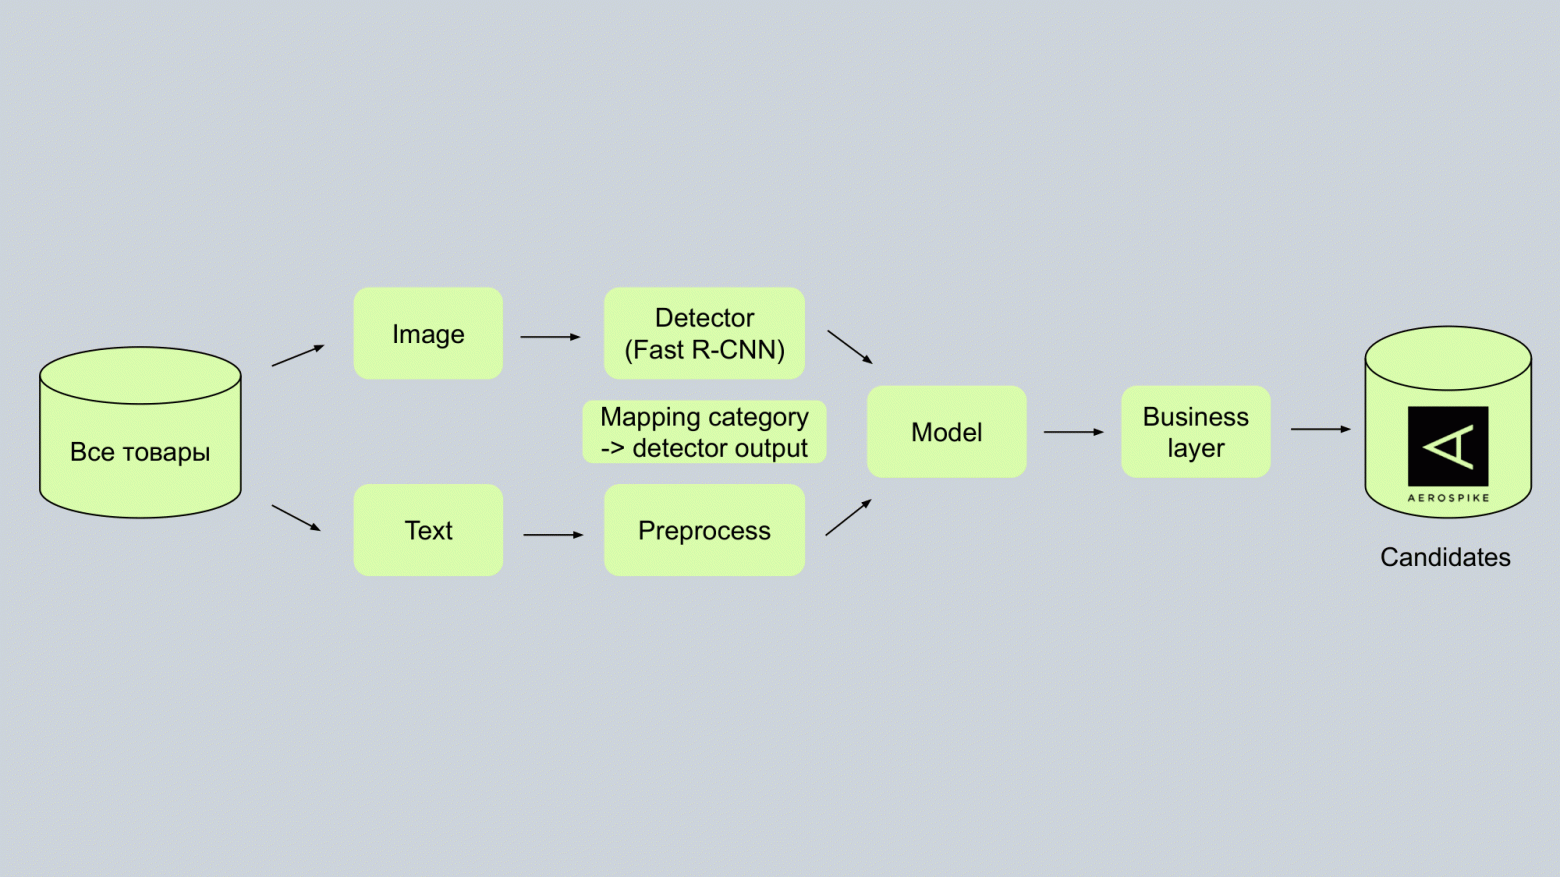
Основной алгоритм обрабатывает изображение и текст, применяет ограничения и сохраняет кандидатов в Aerospike.
Источник: Lamoda, исходная статьяПерсонализация переносится в реранкер
После широкого отбора кандидатов цель меняется. На первой стадии важно не потерять хорошие варианты, а на ранжировании — поставить выше именно те товары, которые вероятнее подойдут конкретному пользователю. Поэтому один и тот же якорный товар может дать разный финальный порядок: для одного пользователя выше окажутся более дорогие варианты, для другого — доступные бренды или фасеты, с которыми он чаще взаимодействовал.
Реранкер построен на CatBoost. Он обучается на реальных показах товаров, а целевой меткой служит добавление в корзину: модель учится отличать показанные товары, которые вызвали явный интерес, от остальных. Признаки делятся на три группы: товарные, пользовательские и совместные «пользователь — товар». Именно совместные признаки позволяют учитывать соответствие товара привычным брендам, стилям, цветовым группам и другим предпочтениям конкретного человека.
Отдельный эксперимент был посвящён не точности как таковой, а цене онлайн-ответа. Чем больше признаков вычисляет реранкер, тем тяжелее обработка на бэкенде. Команда сравнивала варианты с разными наборами признаков и выбрала не самый большой вариант с абсолютным максимумом метрики, а минимальный набор, чьё качество оставалось внутри доверительного интервала лучшей модели. На исходном графике не подписаны числовые шкалы, поэтому нельзя восстановить конкретную задержку или точное число признаков; важен сам критерий выбора — статистически сопоставимое качество при более стабильном времени ответа.
«Финальное ранжирование: оптимизируем precision», от объяснения персонализации до выбора набора признаков по доверительному интервалуКак офлайн-расчёты соединяются с онлайн-выдачей
Финальная система разделяет заранее вычисляемую часть и обработку пользовательского запроса. На Hadoop-кластере каждый день рассчитываются кандидаты и признаки для рекомендательной полки. Реранкер переобучается по расписанию в Airflow. Рассчитанные признаки отправляются в Aerospike, а обученная CatBoost-модель сохраняется в S3. Такое разделение позволяет не пересчитывать тяжёлые векторные кандидаты с нуля при каждом открытии «Похожих».
Во время запроса сервис реранкера читает из Aerospike кандидатов, признаки и сохранённые эмбеддинги. Затем запускает CatBoost, рассчитывает дополнительные embedding-признаки через скалярное произведение векторов и делает жадное объединение кандидатов из двух источников. После объединения список обрезается до top-N и передаётся в сервис рекомендаций, который формирует видимую пользователю ленту.
Именно вся связка, а не одна отдельная нейросеть, дошла до финальной продуктовой проверки. После объединения двух новых кандидатных генераторов и персонализированного реранкера A/B-тест показал статистически значимый прирост покупок на 1,5%. Источник не сообщает длительность теста, размер выборки, единицу рандомизации, доверительный интервал или исходный уровень покупок, поэтому число следует читать только как заявленный эффект конкретного эксперимента.
Дальнейшие планы тоже показывают, что решение не считается завершённым: команда собирается улучшать детектор одежды и словарь сопоставления категорий с его выходами, экспериментировать с обучающим датасетом и формированием групп для ранжирования, исследовать новые модели и энкодеры для основного источника кандидатов, а также продолжать добавлять признаки в реранкер.
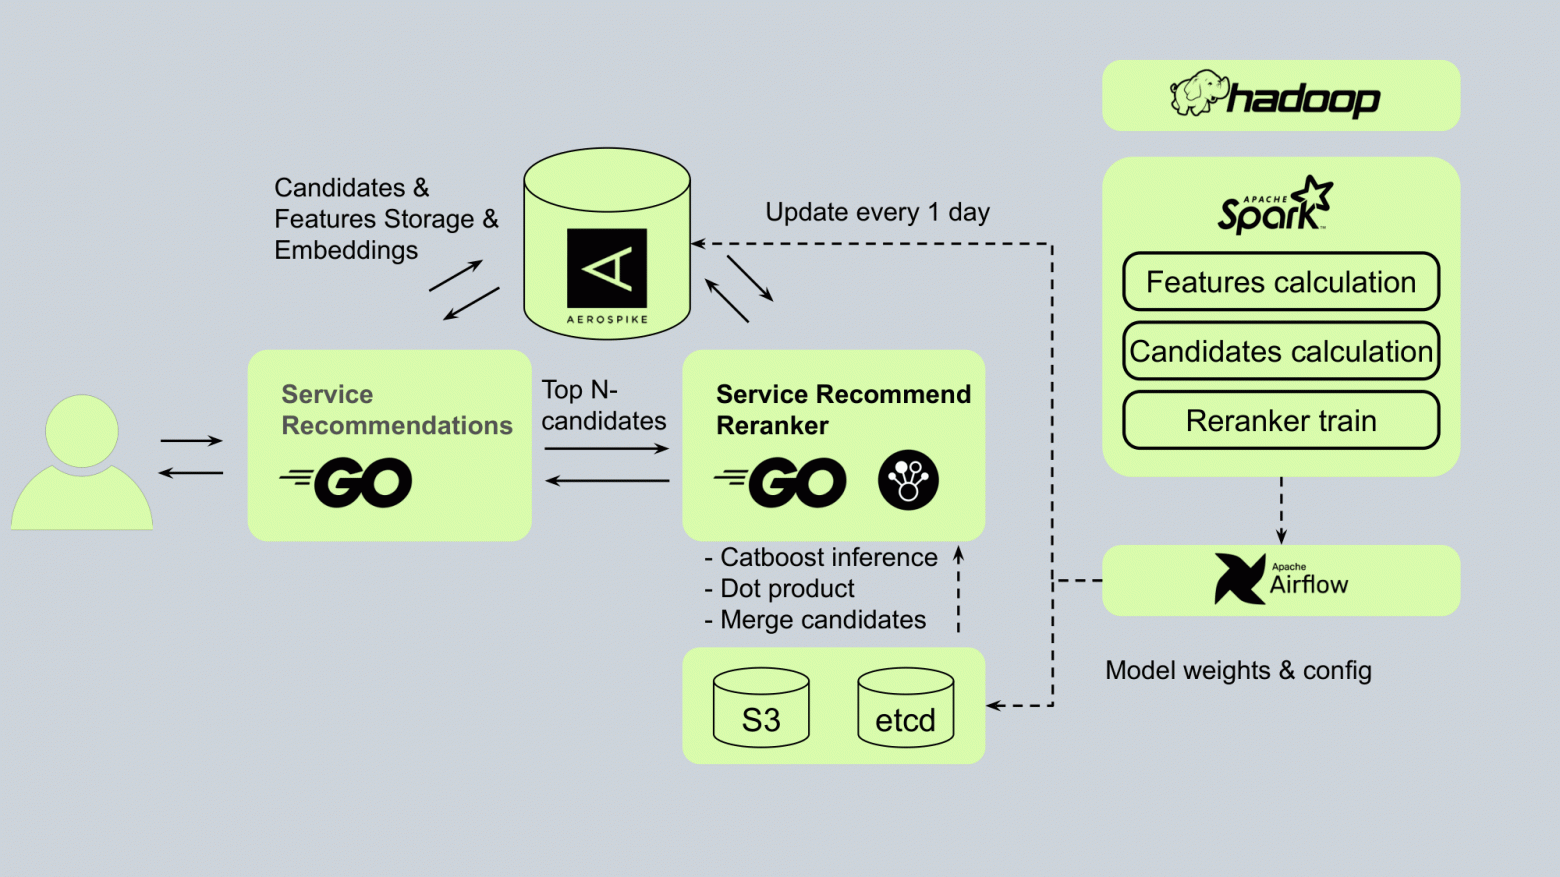
Обучение и ежедневный расчёт вынесены из онлайн-запроса. Сервис ранжирования получает готовые данные и применяет CatBoost перед показом рекомендаций.
Источник: Lamoda, исходная статьяИтог: от общей похожести к персонализированной ленте
Путь Lamoda начался не с отказа от работающей модели, а с её пределов. Атрибутная схема была понятной, поддерживала новые товары и позволяла задавать разные веса по категориям, но плохо объединяла текст и изображение, требовала множества отдельных моделей и почти не учитывала конкретного пользователя. Новая система разделила задачу: два разных алгоритма расширяют набор похожих товаров, а персонализация появляется на стадии CatBoost-реранжирования. При обучении основного источника команда прошла через сравнение энкодеров, способов объединения модальностей, датасетов, функций потерь и расстояний; финальный выбор учитывал не только максимум offline-метрики, но и стоимость внедрения. Кандидаты и признаки рассчитываются заранее; эта ежедневная подготовка не выполняется заново при каждом открытии ленты.
- 01
Получить запрос
Сервис получает исходный товар и контекст пользователя, которому нужна полка похожих товаров.
- 02
Загрузить кандидатов
Из Aerospike берутся заранее подготовленные списки двух источников, признаки и векторные представления.
- 03
Персонально переупорядочить
CatBoost оценивает товары с учётом товарных, пользовательских и совместных признаков; дополнительные векторные признаки рассчитываются через скалярное произведение.
- 04
Объединить и показать
Кандидаты двух источников жадно объединяются, список обрезается до top-N и передаётся в сервис рекомендаций, а затем в приложение.
Финальная связка двух кандидатогенераторов и реранкера дала в A/B-тесте статистически значимые +1,5% по покупкам. До этого основной источник показал рост recall@k без опубликованного числа и на исторических сессиях +13% просмотров страниц и +30% добавлений в корзину; визуальный источник — +2% к добавлению в корзину. Эти оценки получены в разных условиях и их нельзя складывать. Источник также не раскрывает дизайн финального A/B-теста, численную цену онлайн-инференса и точные параметры recall@k. Детектор, датасет, энкодеры и признаки реранкера остаются направлениями дальнейших изменений.
Сводно: «Базовая архитектура и старый алгоритм», «Обновляем алгоритм рекомендаций», «Архитектура инференса новых алгоритмов», «Финальное ранжирование: оптимизируем precision», «Как все работает вместе», «Итоги и планы»