Трансформеры для персональных рекомендаций на маркетплейсе: от гипотез до A/B-тестирования
Иван Ващенко рассказывает, как команда Wildberries развивает WildBERT для персональных рекомендаций. В материале — пакетная модель, Head-to-Head-тесты, свежие эксперименты и переход к более быстрым рекомендациям.
Статья · на русском
Трансформеры для персональных рекомендаций на маркетплейсе: от гипотез до A/B-тестированияИван Ващенко · Опубликовано: 4 декабря 2025 г.
Где используют WildBERT
WildBERT применяется для похожих товаров, отбора кандидатов, доранжирования и пользовательских признаков. Основная часть статьи посвящена пакетной модели, обученной на годовой истории заказов.
Заказы выбрали как более надёжный сигнал предпочтений, чем клики. Пакетная модель использует годовую историю, но между расчётом и показом рекомендаций проходит до суток. Для быстрого изменения интересов внутри посещения такого обновления недостаточно.
Читать в оригиналеПредыдущие оптимизации
Каталог ограничили пятью миллионами товаров, использовали отрицательные примеры внутри обучающего пакета и квоты на категории. Между расчётом рекомендаций и показом оставалась задержка.
Читать в оригиналеHead-to-Head: быстрее проверять гипотезы
На трафике сравнивают базовый BERT и его изменённую версию. Обе модели получают сопоставимые свежие данные. Путь выдачи упрощают, сохраняя необходимые бизнес-фильтры. Процесс организован через Airflow и допускает до трёх параллельных тестов в неделю.
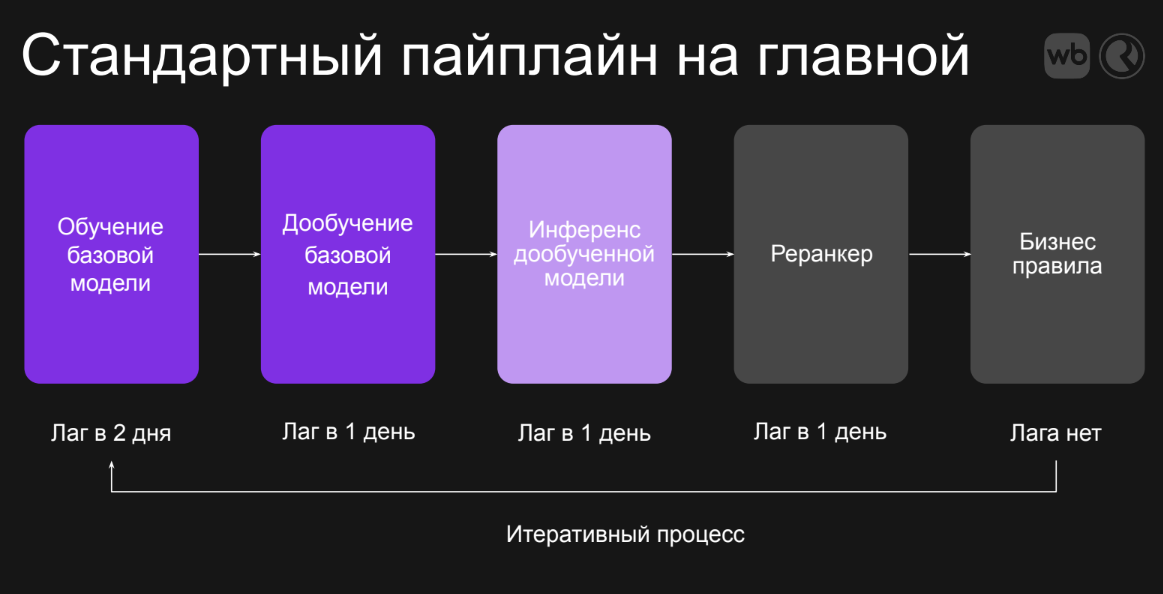
Стандартный процесс формирования рекомендаций на главной странице Wildberries.
Источник: Wildberries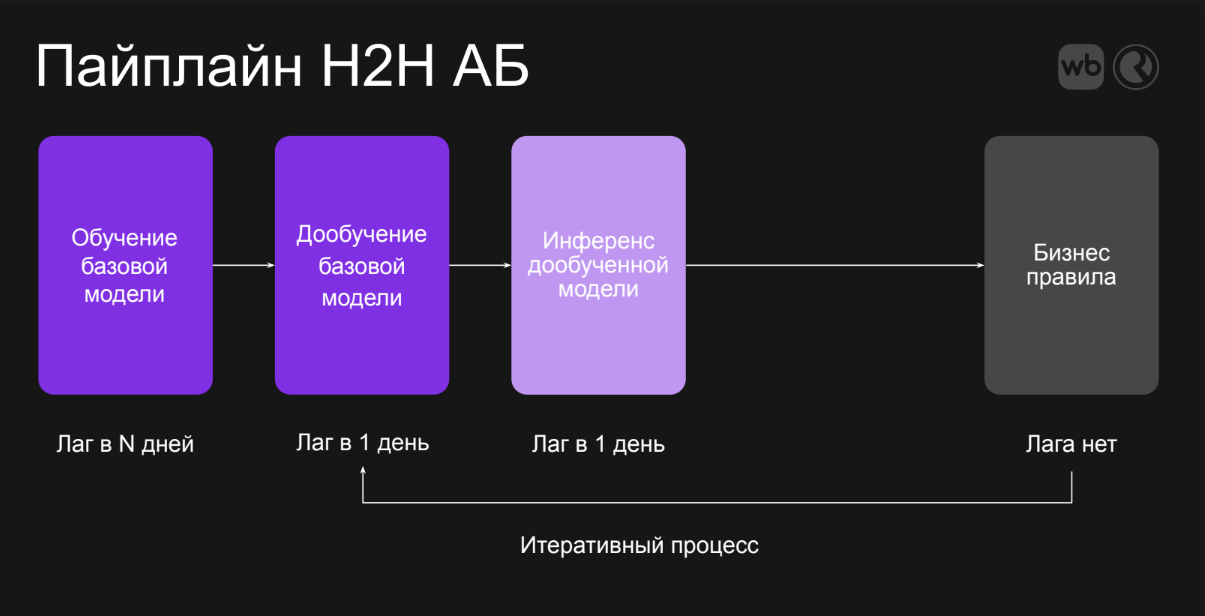
Процесс Head-to-Head-тестирования: на схеме автора отсутствует этап реранкера.
Источник: WildberriesЧто меняли в модели
- Различали состояния заказов, включая выкуп и отмену.
- Добавляли сложные отрицательные примеры и разнообразие в функцию потерь.
- Дообучали на свежих данных; лаг сократили с двух дней до суток.
- Вместо постоянных квот снижали оценки повторяющейся категории.
- Добавляли признаки пользователя.
Результаты отдельных тестов
Сложные отрицательные примеры дали около +2% GMV на главной странице. Признаки пользователя — почти +3% GMV в другом тесте. Это отдельные сравнения, не суммарный эффект.
Читать в оригиналеКак обновляют рекомендации после действий пользователя
События приходят через Kafka. Сервис на Go собирает их в пакеты, подготавливает вход модели и отправляет его на Triton. Модель возвращает вектор текущего состояния пользователя. По нему HNSW находит кандидатов среди векторов товаров, а готовый список сохраняется в key-value хранилище. Новые действия снова запускают цикл.
Этот режим авторы называют nearline: выдача обновляется за секунды. В отличие от годовой модели на заказах, здесь используют разные виды взаимодействий за несколько недель и более компактный вектор. При первом A/B-тесте заметили снижение разнообразия; после расширения доступных категорий конверсия выросла. Численного эффекта этого изменения в тексте не приводят.
Этот фрагмент в оригиналеЧто ещё нужно было изменить
Быстрая модель уже получает часть информации о долгосрочных предпочтениях из офлайновой модели. Команда планирует подобрать их сочетание, перенести Head-to-Head-проверки в новый режим и ускорить поиск кандидатов.
Остаётся и продуктовая проблема: модель учится предсказывать клики после кликов, поэтому рекомендации могут выглядеть привлекательными, но не приводить к покупке. Переход к предсказанию покупок после кликов в статье обозначен как следующий шаг.
Этот фрагмент в оригинале