Представим продукт с большой языковой моделью (LLM): корпоративный помощник, поддержка или кодовый агент. На тестовом запросе всё выглядит просто — загрузить сильную модель на графический ускоритель (GPU) и вызвать её через программный интерфейс (API). Под реальной нагрузкой эта схема быстро распадается на несколько ограничений. Модель может не помещаться в доступную память, длинный вход задерживает первый токен, новые запросы мешают уже идущей генерации, повторяющийся контекст считается заново, а очередь превращает быстрый отдельный запуск в медленный сервис. Ускорить одну вычислительную операцию недостаточно, если GPU простаивает из-за сети или запрос попал на машину без нужного кеша.
В этом обзоре разберём инженерный путь по десяти опубликованным кейсам: от выбора модели и точности чисел до организации кеша, маршрутизации, разделения обработки входа и генерации, спекулятивной генерации, низкоуровневых ядер и отказоустойчивости. Это не рейтинг компаний и не единая «правильная архитектура». У ВТБ ограничением была память для протоколирования, у Т-Банка — экономика общего сервиса и повторяемость промптов, у Яндекса — длинные агентные сессии и очереди, у vLLM — взаимное влияние стадий, у Huawei — стоимость проверки черновых токенов. Обзор полезен ML-инженерам, разработчикам LLM-платформ и техническим лидам, которым нужно понимать, что именно измерять перед очередной оптимизацией.
Три слоя задачи
1. Сначала определить, что именно должно стать быстрее
У LLM нет одной «задержки». Сначала система читает входной контекст и строит промежуточные состояния — это обработка входа, или prefill. Только после этого появляется первый токен. Затем модель генерирует продолжение по одному или нескольким токенам — стадия decode. Поэтому время до первого токена (TTFT) отвечает за ожидание начала ответа, а среднее время на один следующий токен (TPOT) и интервал между соседними токенами (ITL) — за плавность продолжения. Полная задержка ответа включает обе стадии, очередь, сеть и обвязку.
Среднее значение скрывает редкие зависания. Медиана, или P50, делит измерения пополам. P95 означает, что 95% измерений не больше указанной границы; P99 смотрит ещё глубже в хвост. Это важно под нагрузкой: в расчётном примере Яндекса цель была 10 запросов в секунду (RPS) при P99 TTFT не более 5 секунд, а в отдельной серии экспериментов на 16 GPU требование ослабили до P95 TTFT ≤ 5 секунд. Эти две постановки нельзя объединять в одну цифру.
Таблицу можно прокрутить по горизонтали.
Goodput особенно полезен, когда одна конфигурация выдаёт много токенов, но нарушает требования к пользователю. В vLLM пороги goodput в собственном примере задавались по TTFT и среднему TPOT; p99 ITL измерялся отдельно. Поэтому нельзя сказать, что конфигурация «прошла goodput», только потому что у неё хороший хвост ITL.
2. Слой 1: выбрать подходящую модель, а не самую большую
Первый способ удешевить инференс — не ускорять исходную модель, а проверить, нужна ли она вообще. В 2025 году ВТБ использовал Qwen 2.5 для протоколирования встреч. В конфигурации команды вариант 32B (32 миллиарда параметров) требовал около 80 ГБ видеопамяти, тогда как в рабочей системе были A100 на 40 ГБ. Команда сравнила меньшую Qwen 14B (14 миллиардов параметров) и две версии 32B с пониженной точностью: четырёхбитную AWQ INT4 и восьмибитную SmoothQuant INT8. Дистилляция здесь означала обучение меньшей модели на протоколах, подготовленных большой моделью: более 4000 стенограмм дали более 8000 обучающих пар.
Автоматическая метрика не выбрала итоговую модель в одиночку. После обучения опубликованные баллы после обучения были 86,7 для 14B, 88,0 для AWQ и 89,2 для SmoothQuant, но рабочей стала 14B: при ручной проверке она лучше сохраняла детали, таймкоды и хэштеги. Табличные 20–43 минуты в статье относятся к замеру на нераскрытом объёме работы и не являются задержкой обработки одной встречи. Сам кейс исторический: Qwen 2.5 в публикации 2025 года — контекст решения команды, а не текущий рейтинг моделей.
TBC Uzbekistan в другом кейсе тоже начал не с ускорителя. Для локального двуязычного банковского решения в 2025 году целились примерно в 7–9 млрд параметров и выбрали Gemma-2-9B-IT среди подходящих по размеру вариантов. Модель сначала укрепляли на узбекском и русском, затем обучали банковским инструкциям с QLoRA — обучением небольших добавок к квантизированной базовой модели. Это пример выбора по языку, домену, размещению на собственных серверах и будущему голосовому сценарию; статья прямо оставляет устройство быстрого инференса для следующей публикации. Gemma-2 здесь также историческая базовая модель проекта, а не рекомендация на 2026 год.
Т-Банк формализует похожее разделение решения: T-index агрегирует качество по наборам задач, но стоимость токена в него не входит. Качество и цена затем сопоставляются отдельно при выборе моделей для общего сервиса. Это полезная дисциплина: сначала определить минимально достаточное качество, затем сравнивать способы его получить дешевле. Иначе оптимизация инференса превращается в гонку за скоростью модели, которую продукту всё равно нельзя выпускать.
3. Что именно занимает память: веса, активации и KV-cache
Три вида данных живут по-разному. Веса — обученные параметры модели; они загружаются и многократно используются для разных запросов. Активации — промежуточные численные результаты конкретного прохода по сети; они возникают из текущего входа и нужны следующим слоям. KV-cache — сохраняемая часть промежуточных результатов механизма внимания для уже обработанных токенов. Он относится к конкретному контексту и позволяет не пересчитывать его на каждом следующем шаге.
Таблицу можно прокрутить по горизонтали.
Квантизация — уменьшение точности хранения или вычислений — поэтому бывает разной. AWQ в кейсе ВТБ сжимал веса с учётом наблюдаемых активаций. SmoothQuant перераспределял масштаб между весами и активациями, чтобы сделать INT8 устойчивее к выбросам. В поддержке Яндекса отдельно названы FP8 для весов и восьмибитный формат E4M3 для KV-cache: фраза «модель квантизована» не отвечает на вопрос, как хранится кеш.
В агентных сценариях KV-cache часто важнее небольшого ускорения отдельной операции. В рассматриваемых длинных сессиях большая часть контекста повторяется, но паузы и маршрутизация могут вытеснить или потерять полезный кеш. Яндекс подчёркивает чувствительность экономики prefill: в иллюстрации доклада падение cache hit с 97,5% до 95% удваивало объём повторных вычислений на стадии входа. Это объяснение конкретного профиля нагрузки, а не универсальная формула.
4. Слой 2: обработка входа и генерация по-разному используют GPU
Prefill обычно обрабатывает много входных токенов сразу и хорошо нагружает вычислительные блоки. Decode делает последовательные короткие шаги: каждый новый токен зависит от уже полученного префикса, а значительная часть времени уходит на чтение весов и кеша. Поэтому одна настройка параллелизма и размера пакета редко оптимальна для обеих стадий.
В поддержке Яндекса вместе перечислены непрерывное пакетирование, обработка входа частями, разделение обработки входа и генерации, повторное использование KV-кеша через RadixAttention и спекулятивная генерация. Непрерывное пакетирование означает, что место завершившегося запроса можно сразу отдать новому, а не ждать окончания всей первоначальной группы. Обработка входа частями (chunked prefill) режет длинный вход на части, чтобы он меньше блокировал генерацию других запросов. Эти приёмы уменьшают конфликт стадий, но не устраняют его одинаковым способом.
Параллелизм тоже платный. Т-Банк на внутренней T-Pro 2.1 распределял вычисления одного запроса между двумя GPU: по слайду prefill ускорялся примерно вдвое, очередь сокращалась примерно вдвое, а межкарточные коммуникации снижали эффективность на 2–5%. Автор связывал это с удвоением допустимого трафика при прежних обязательствах по времени ответа (SLA) в конкретном режиме с большой долей prefill. Это не правило «TP2 всегда вдвое быстрее»: выигрыш зависит от модели, топологии и того, что именно ограничивает очередь.
5. Пакетирование полезно, пока не ломает задержку и память
Пакетирование объединяет несколько запросов в один запуск, чтобы лучше использовать ускоритель. Но рост пакета увеличивает одновременно удерживаемые активации и KV-cache и может сделать шаг дороже. В спекулятивной генерации небольшая модель предлагает черновой блок токенов, который затем проверяет основная модель. Подробно разберём этот приём ниже; здесь важна цена проверки большого пакета. В докладе Huawei на Ascend 910A2 при длине проверяемого блока 9 токенов (K=9) DSpark с размером пакета (BS) 128 показывал 1,43× относительно основной модели, DFlash — 1,22×; при BS=256 DFlash опускался до 0,99×. Причина не в том, что сама модель внезапно стала хуже, а в том, что проверка длинного блока кандидатов дорожает сразу для большого числа запросов.
Важно не путать уровни пакетирования. Batches API в шлюзе поддержки Яндекса — способ передать пакет обращений через интерфейс. Continuous batching внутри движка — способ совместно планировать уже поступившие запросы на GPU. А BatchWorker VK решает вообще другую задачу: днями или неделями прогоняет большие таблицы хранилища YT через готовые модели. Это пакетная обработка данных, не обязательно LLM и не измерение чатовой задержки.
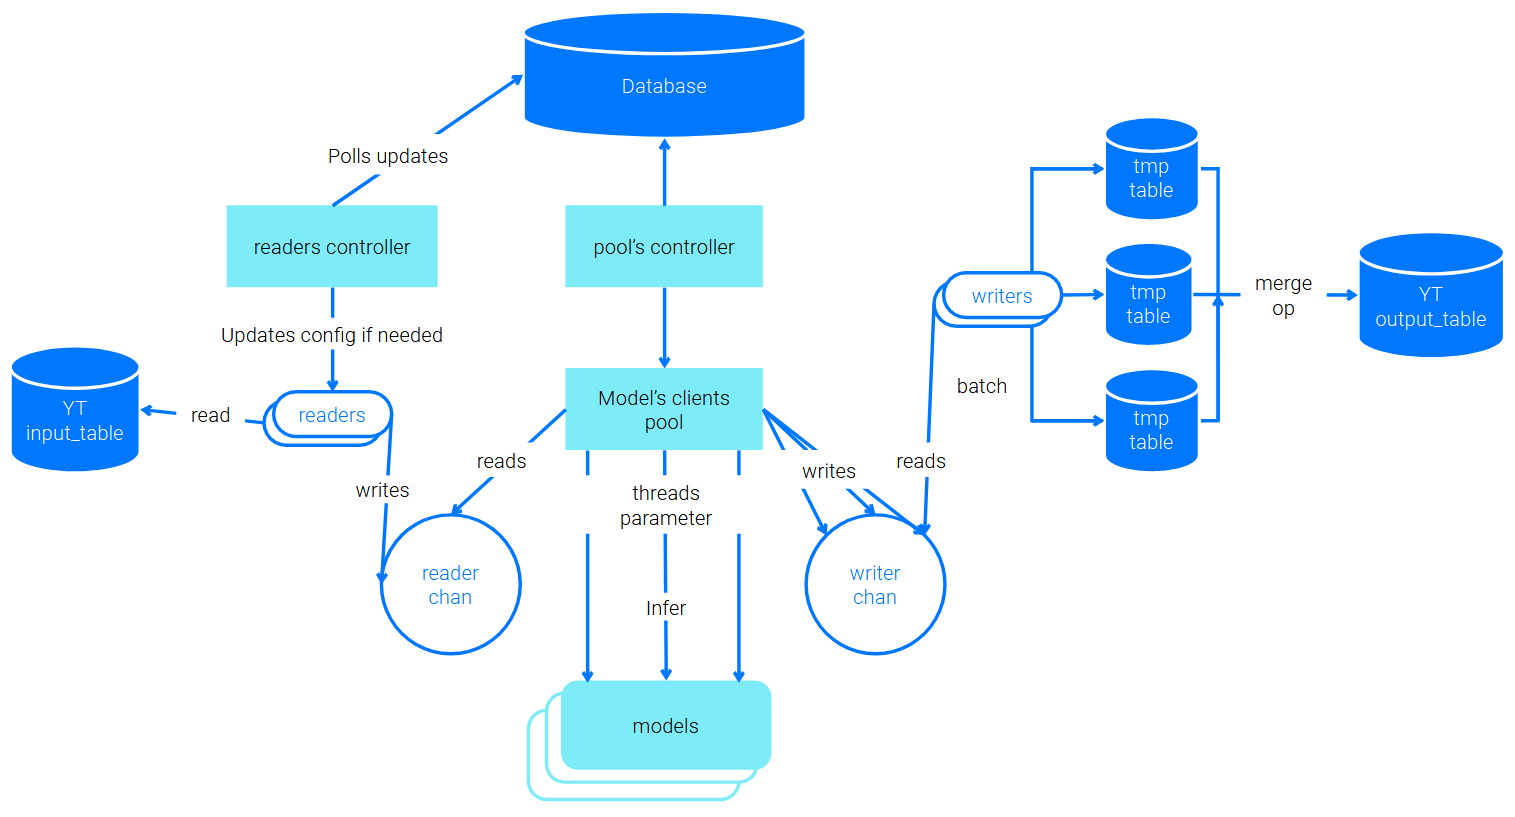
Общий конвейер VK: читатели YT → входной канал → пул клиентов модели → выходной канал → параллельная запись во временные таблицы и слияние в выходную. Контроллеры обновляют конфигурацию читателей и пул хостов.
Источник: Артём Петров / VK · исходная схемаКейс VK полезен именно как урок инфраструктуры: чтение, применение модели и запись имеют разную скорость и отдельные отказные сценарии. Исполнители возвращают незавершённую работу после отказа сервера, размер выходного буфера ограничивают по памяти, а результаты сначала пишут во временные таблицы и затем сливают. Это не рецепт сервиса мгновенных ответов, зато хорошо показывает, почему надёжность и контроль очереди между быстрыми и медленными стадиями важнее красивого среднего времени одного вызова.
6. Кеш и маршрутизация: иногда дешевле перенести состояние, чем пересчитать
Если следующий запрос повторяет большой префикс, система может либо пересчитать его, либо направить запрос туда, где остался KV-cache, либо перенести кеш. Выбор зависит от размера состояния, сети, загруженности исполнителя и вероятности, что сессия продолжится. Жёсткое закрепление пользователя за одной GPU повышает локальность, но уменьшает свободу балансировки; общий кеш помогает переживать паузы, но требует памяти и транспорта.
В Commodity LLM Т-Банка анализ показал примерно 95% повторяемых системных промптов, но около 10% попаданий в KV-cache больших моделей из-за распределения связанных запросов по разным узлам. Команда добавила Mooncake: в их условиях передача кеша по InfiniBand была выгоднее повторного prefill. Автор связывает этот этап с примерно четырёхкратным ростом cache hit, более чем трёхкратным снижением стоимости токена и приблизительно двукратным сокращением TTFT. Эти числа относятся к одному этапу их системы и не должны перемножаться с последующими оптимизациями.
Затем маршрутизация с учётом расположения кеша (KV-aware routing) дал более тонкий компромисс. На базе SGL Model Gateway cache hit вырос с 80,1% до 82,3%, а Mean TTFT ухудшился с 0,79 до 0,86 секунды, потому что часть GPU стала чуть перегружаться. Prefetched tokens снизились с 201 до 36 kk: в исходной таблице это количество токенов, не байты. Объём данных, передаваемых по InfiniBand, автор описывает как примерно пятикратно меньший, но это не означает пятикратное ускорение сервиса.
В агентном инференсе Яндекса общий L3-кеш на Mooncake решает соседнюю проблему: после паузы нужный контекст может уже не помещаться локально. В рабочей системе сначала L3 поднял долю закешированных входных токенов примерно с 55% до 80%, затем LayerSplit — до 90%. В демонстрационной серии порядок был другим: LayerSplit добавляли до L3. Эти последовательности имеют разные базы сравнения и не складываются в один «эффект оптимизации».
7. Разделение стадий: изоляция помогает только при дешёвой передаче
Разделение prefill и decode, или разделённое обслуживание P/D, помещает тяжёлую обработку входа и пошаговую генерацию на разные экземпляры модели. Идея сильная: длинный новый запрос больше не прерывает decode пользователей, которые уже получают ответ. Но decode должен получить весь нужный KV-cache, поэтому выигрыш по плавности выдачи ответа покупается сетью, дополнительными сервисами и новыми отказами.
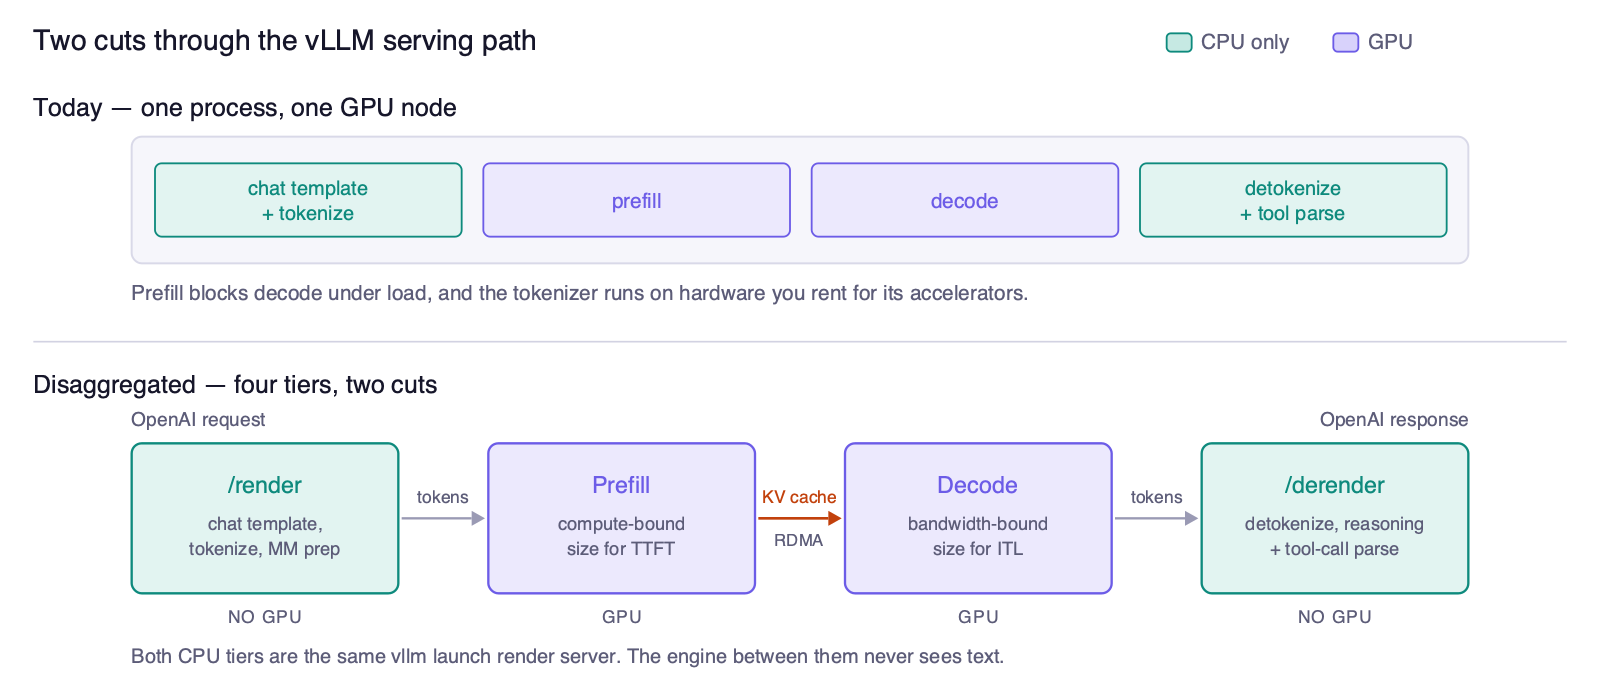
Обработка входа и генерация могут работать в отдельных GPU-пулах с передачей KV-кеша. Второе разделение выносит подготовку запроса и разбор ответа на центральный процессор (CPU).
Источник: Оригинальная иллюстрация · vLLM / IBM ResearchСобственный тест из гайда vLLM специально полезен отрицательной частью. Стенд: один сервер, две L40S по 48 ГБ без NVLink, Qwen2.5-7B-Instruct, примерно 8 тысяч входных и 256 выходных токенов, 100 запросов на каждую предлагаемую интенсивность. Совмещённая база — vllm serve --data-parallel-size 2; автор отдельно предупреждает, что это не то же самое, что две полностью независимые реплики за балансировщиком и что такой контроль мог быть сильнее.
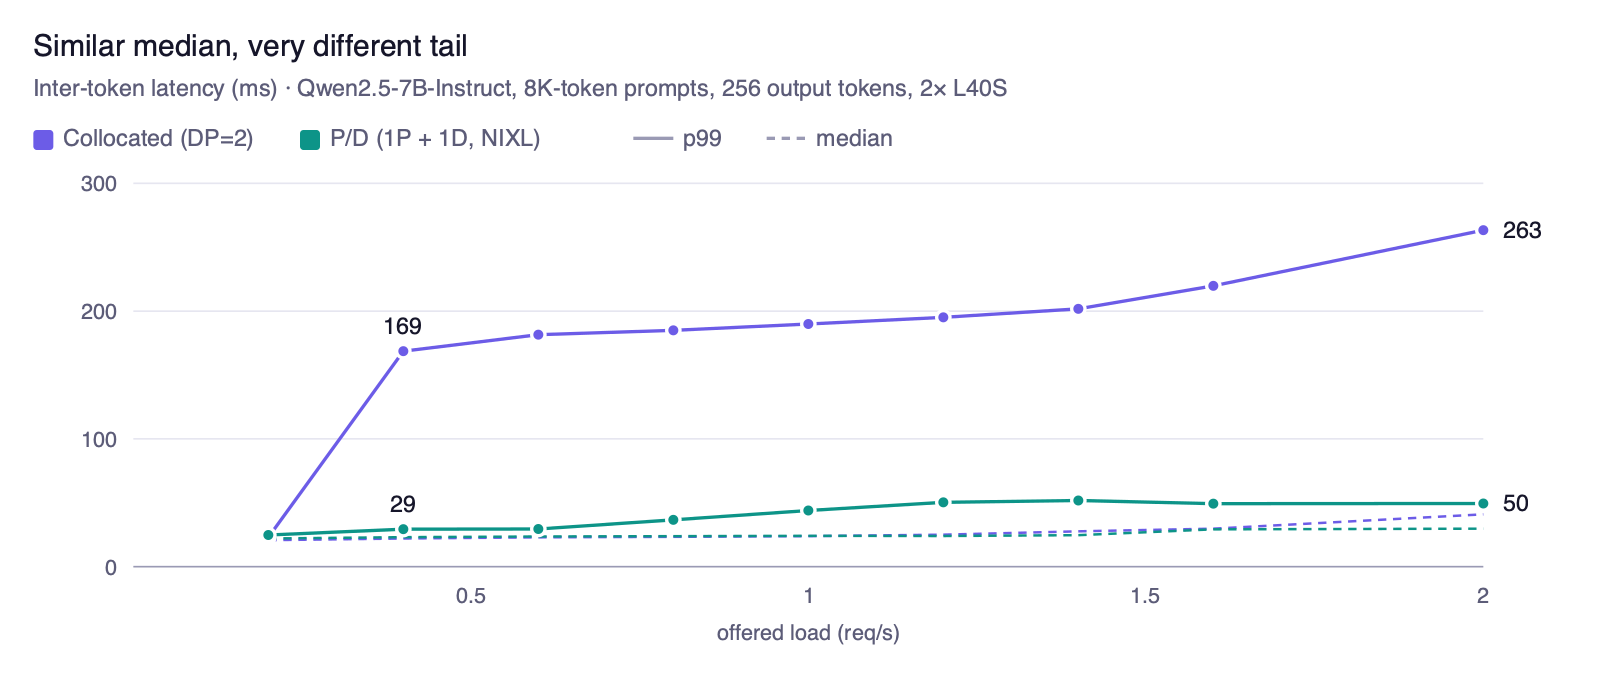
Медиана задержки между токенами остаётся близкой, но её 99-й перцентиль заметно снижается при разделении prefill и decode.
Источник: Оригинальная иллюстрация · vLLM / IBM ResearchПри 0,4 запроса/с p99 ITL снизился со 169 до 29 мс, при 2 запросах/с — с 263 до 50 мс. Но для входа около 8k нужно было передать примерно 470 МБ KV; это занимало около 1,3 секунды. При 0,2 запроса/с медианный TTFT ухудшился с 0,7 до 2,2 секунды, поэтому двухсекундный порог P/D не выполнял. То есть P/D улучшил хвост промежутков между токенами, но испортил первый токен.
Яндекс получил похожий урок на другом стенде. После KV-aware routing серия на 16 GPU давала около 3,4 RPS при P95 TTFT ≤ 5 секунд. Простой переход к 3P1D — три исполнителя обработки входа и один исполнитель генерации — снизил результат до 2,27 RPS, на 34% относительно предыдущего варианта. Только дальнейшие изменения контекстного параллелизма, LayerSplit и общего кеша сделали разделение полезнее. Поэтому P/D — не универсальный выигрыш, а инструмент изоляции, который сначала должен оправдать цену передачи KV.
vLLM рассматривает и второе разделение: вынести применение шаблона диалога, токенизацию и разбор результата на CPU-сервер /render и /derender, оставив GPU только идентификаторы токенов. Для простого входа около 9k токенов подготовка занимала примерно 15 мс CPU и была дешёвой, но потоковый разбор разметки рассуждений и структурированных вызовов инструментов в другом замере оказался примерно в девять раз тяжелее CPU-варианта внутри процесса модели и увеличил медиану полной задержки примерно на 15%. Даже «дешёвый CPU-слой» нужно профилировать на своём формате ответа.
8. Спекулятивная генерация: черновик и проверка тоже требуют времени
Спекулятивный декодинг добавляет небольшую модель-черновик, или драфтер. Она предлагает несколько будущих токенов, а основная модель проверяет их одним проходом и принимает корректный префикс. Здесь под стоимостью понимается время вычисления. Польза появляется, если стоимость драфтера и проверки меньше, чем цена последовательной генерации того же числа полезных токенов. Поэтому высокая длина принятого продолжения сама по себе ещё не означает ускорение.
В докладе Huawei про DFlash и DSpark стоимость полезного токена записывается через время драфтера D(b,k), время проверки основной моделью V(b,k) и ожидаемое число полезных выходных токенов G(k), включая дополнительный токен основной модели. На большом батче длинная проверка дорожает, поэтому команда выбирает динамический бюджет: драфтер может предложить 16 позиций, но контроллер проверяет только ту часть, для которой ожидаемый выигрыш перекрывает дополнительную стоимость.
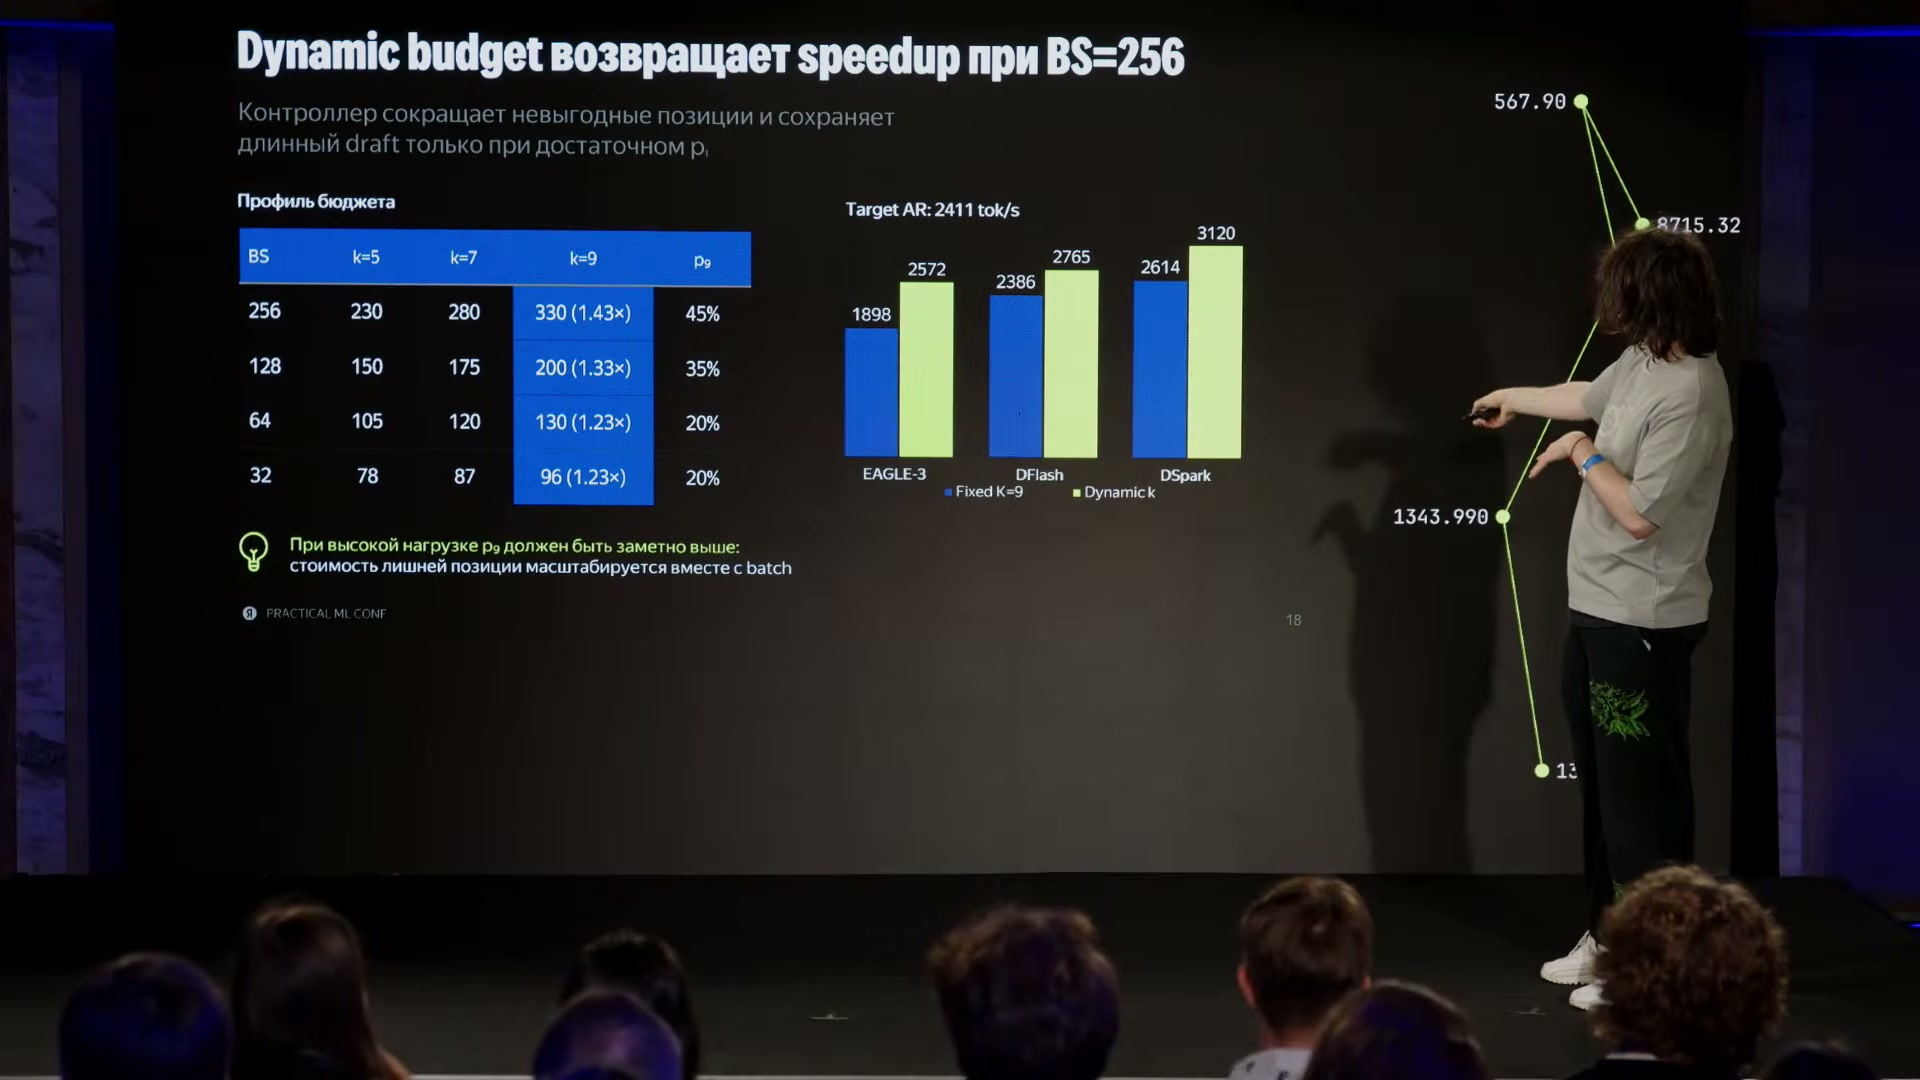
Huawei, Ascend, Model Runner V1, пакет из 256 запросов: динамическая длина проверки повышает пропускную способность. DSpark — 3120 токенов/с против 2614 при фиксированной длине K=9 и 2411 без драфтера.
Источник: Станислав ИлюшинКлючевые числа относятся к Huawei, Ascend и Model Runner V1 при BS=256: Target AR без драфтера — 2411 токенов/с; DSpark с фиксированным K=9 — 2614; DSpark с динамическим k — 3120. Это системная пропускная способность конкретного теста. Асинхронный Model Runner V2 был реализован, но на момент доклада скорость ещё не измерили, поэтому результат V1 нельзя приписывать V2.
Интеграция показывает ещё одну цену: в V1 CPU ждал оценки уверенности драфтера с ускорителя, а реальные графы исполнения имеют ступенчатую стоимость. 160 и 184 входных позиции могли запускать один и тот же заранее подготовленный граф для группы размеров до 192, поэтому удаление 24 кандидатов не обязательно сокращало время. Отдельный графовый путь DSpark дал заявленные 10% в локальном опыте, но его не приняли в основную ветку из-за объёма изменений и будущего сопровождения. Быстрый алгоритм должен вписываться не только в математику, но и в движок.
9. Профилирование ядер: оптимизировать то, что действительно занимает время
Профилирование отдельных операций помогает понять, есть ли резерв внутри модели. Вычислительное ядро (kernel) — небольшая программа, которая выполняет такую операцию на ускорителе. Т-Банк интегрировал HPC-Ops Tencent для Hopper в SGLang и получил на своём трафике до 10% прироста пропускной способности на одну карту, тогда как внешнее заявление библиотеки доходило до 50%. Разница хорошо иллюстрирует правило: чужой коэффициент ускорения — не характеристика вашего сервиса.
Meta автоматизирует такой поиск через KernelEvolve. Агент предлагает ядро, компилирует его на целевом ускорителе, сравнивает результат с эталоном, измеряет скорость и использует профилировщик для следующей попытки. В тесте 160 операций ATen на трёх платформах авторы сообщают корректность всех 480 сочетаний. Из этого не следует ускорение всех 480 конфигураций. Корректность — фильтр допуска, а скорость измеряется отдельно.
Производственное число Meta относится к рекомендациям: для инференса рекламной модели Andromeda на NVIDIA компания сообщает рост пропускной способности более 60% относительно уже оптимизированного варианта, использовавшего в том числе torch.compile и библиотеки производителей. Другой результат — более 25% на обучении рекламной модели на MTIA. Это разные модели, оборудование и режимы; складывать проценты нельзя.
Adobe даёт полезный смежный пример, но это не LLM: историческая оптимизация 2024–2025 годов для диффузионной генерации видео Firefly. Команда экспортировала модель в ONNX, затем использовала TensorRT BF16, позже смешанную точность с FP8, отдельно проверяя влияние квантизации на качество. Профилирование исходного ONNX-графа показало слой SDPA с около 70,6% времени именно в том запуске. Для основной диффузионной части опубликованы 1,6× для TensorRT BF16 и до 2,5× для BF16+FP8 относительно PyTorch, но статья не даёт полного сравнения всех вариантов на одинаковом стенде и не позволяет переносить эти коэффициенты на LLM или весь путь генерации видео.
Общий вывод низкого уровня — сначала профилировать. Ядро может быть вычислительно ограничено, упираться в память, сеть или управляющие запуски CPU. А квантизация требует двух независимых проверок: не потеряли ли мы нужное качество и стал ли реальная вычислительная операция быстрее на целевом железе. Имитация FP8 в PyTorch у Adobe проверяла численные эффекты, но сама по себе не измеряла ускорение.
10. Слой 3: очередь, goodput и отказоустойчивость
Необходимую мощность сервиса нужно оценивать не по средней скорости одного запроса, а по распределению прихода работы. Яндекс показывает это на расчёте для DeepSeek V4 Flash: наивное разделение prefill/decode давало оценку 36 GPU для 10 RPS при P99 TTFT не более 5 секунд; учёт нелинейной стоимости холодного хвоста поднял её до 40, модель очереди с пуассоновским приходом — до 56, а подгонка под реальные всплески добавила ещё около 50% относительно предыдущей ступени. Эти проценты последовательны, имеют разные базы и не являются универсальным коэффициентом запаса.
Похожая логика появляется в поддержке Яндекса. Сервис обслуживает пользовательские и внутренние запросы, поэтому LiteLLM используется как шлюз с ключами, учётом токенов и приоритетами, а HAProxy — для дальнейшей маршрутизации. Модели разворачиваются в двух дата-центрах: при потере одного автоматизация должна продолжить работу, пусть и медленнее. Закрепление связанных запросов за одним исполнителем (sticky sessions) помогают повторно использовать KV-cache, но ограничивают свободу перераспределения нагрузки.
Таблицу можно прокрутить по горизонтали.
В AgentOps при нагрузке 10 RPS автор приводит около 2 секунд по P50 и 5 секунд по P90 задержки ответа; отдельно — 8 мс P50 на генерацию одного токена. Железо, длины запросов и точная граница измерения задержки в докладе не раскрыты, поэтому эти числа нельзя сравнивать с vLLM или Яндексом как рейтинг производительности. Сравнивать имеет смысл только внутри заданной конфигурации и SLO.
Надёжность меняет архитектуру не меньше задержка. В Т-Банке на инфраструктуре примерно с тысячей InfiniBand-соединений временная потеря линии могла породить более 10⁴ ошибок передачи KV и потребовать около 40 минут на полный перезапуск кластера; команда добавила обход неисправной линии. В VK долгие пакетные задания требуют возврата незавершённой работы и ограниченного буфера. Оптимизация закончена не тогда, когда один запрос стал быстрее, а когда система переживает очереди, частичные сбои и обновления без потери заданного уровня обслуживания.
11. Как читать десять кейсов без десяти полных глав подряд
Основной маршрут построен так, чтобы каждый следующий кейс добавлял новый уровень системы. На первом проходе читайте только указанные разделы и возвращайтесь к полной главе, когда соответствующее узкое место появится в вашей задаче.
- 1. ВТБ: ограничение памяти → почему победила 14B. Понять, почему качество продукта и эксплуатационный бюджет сначала задают пространство вариантов: меньшая модель, квантизация или дистилляция.
- 2. Т-Банк: где искать резерв → компромисс KV-aware routing → T-index. Связать модель, движок и организацию сервиса и отделить качество от цены.
- 3. Яндекс: расчёт SLO → неудачный 3P1D → результат L3 и LayerSplit. Увидеть, как очереди, cache hit и реальные сессии меняют размер кластера.
- 4. vLLM: стенд L40S → узкое место переноса KV → как воспроизвести. Научиться проверять P/D одновременно по TTFT, ITL и goodput, а не по одному графику.
- 5. Huawei: динамическая проверка → асинхронный V2. Понять цену драфтера, верификации, батча и graph buckets; не переносить результат V1 на ещё не измеренную V2.
- 6. Яндекс AgentOps: требования сервиса → технические результаты. Собрать финальный уровень: приоритеты, несколько дата-центров, маршрутизация и различие пользовательской задержки и времени токена.
Ветка выбора модели: TBC: сравнение семейств и границы статьи показывают, как собственные серверы, низкоресурсный язык и размер модели влияют на выбор до оптимизации обслуживания запросов. Ветка пакетной обработки: VK: три слоя BatchWorker и запись полезны для долгих заданий над таблицами; это не чатовый LLM-serving.
Ветка низкого уровня: Meta: проверка ядер и результаты внедрения показывают цикл «корректность → профилирование → скорость». Смежная ветка квантизации: Adobe: проверка PTQ, профилирование и ограничения полезны как исторический пример оптимизации трансформерной диффузионной видеомодели. Коэффициенты ускорения оттуда нельзя переносить на LLM.
Заключение
Оптимизация LLM-инференса начинается не с выбора модного движка. Сначала нужно зафиксировать качество, форму нагрузки и SLO: время первого токена, плавность продолжения, хвостовые перцентили и допустимую стоимость. Затем определить, где тратятся ресурсы: в весах, активациях, повторном prefill, decode, очереди, сети или CPU-обвязке. Кейсы показывают, что сильный локальный приём легко проигрывает на уровне системы: P/D может ухудшить TTFT, KV-aware routing — немного увеличить среднее ожидание, а длинный блок черновых токенов — стать дороже обычной генерации.
- 01
Выбрать маршрут
Шлюз определяет модель и приоритет запроса, затем направляет его в подходящий пул с учётом доступности и, если это оправдано, локальности KV-cache.
- 02
Переиспользовать контекст
Система находит сохранённый префикс локально или в общем кеше. Если перенос состояния дороже пересчёта, конфигурация должна это показать на измерениях.
- 03
Обработать новый вход
Prefill вычисляет только недостающую часть контекста. Пакетирование и параллелизм выбирают так, чтобы не разрушить TTFT и ёмкость кеша.
- 04
Сгенерировать продолжение
Decode выдаёт токены; спекулятивная генерация применяется только там, где стоимость драфтера и проверки уменьшает TPOT на реальной нагрузке.
- 05
Проверить SLO и восстановление
Сервис фиксирует TTFT, TPOT/ITL, goodput, очередь и ошибки; при сбое использует допустимый запасной путь вместо бесконечного повторения или потери запроса.
Выбор базовой модели, дистилляция, калибровка квантизации, компиляция ядер, подготовка графов исполнения для групп размеров и нагрузочная оценка новых версий происходят отдельно от этого пути. Из десяти кейсов следует не единая архитектура, а порядок мышления: сначала достаточное качество, затем измеренное узкое место, затем изменение с известной ценой. Сравнивать чужие проценты между компаниями нельзя; сравнивать нужно конфигурации на собственной модели, железе, сети и распределении запросов.
Первоисточники
Обзор собран по опубликованным разборам. Подробности измерений, исходные иллюстрации и ссылки на разделы находятся в соответствующих главах.
- Как мы дистиллировали Qwen для автоматического протоколирования совещаний
- When Languages Lack Data: Making Open-Source LLMs Work for Banking in Uzbekistan
- AgentOps в продакшене: инфраструктура для LLM-агентов и автоматизация поддержки
- Диффузионный драфтинг в спекулятивном декодинге: DFlash и DSpark — от модели до вывода в продакшн
- Строим экономически эффективный инференс LLM для агентских (и не только) сценариев
- Commodity LLM: как мы строим инфраструктуру и процессы для массового инференса LLM
- Taking vLLM Apart: A Practical Guide to Disaggregated Serving
- Эффективный пакетный инференс моделей. Опыт инженеров VK
- KernelEvolve: How Meta’s Ranking Engineer Agent Optimizes AI Infrastructure
- Optimizing Transformer-Based Diffusion Models for Video Generation with NVIDIA TensorRT