Пакетный инференс: как обработать большую таблицу и пережить сбои
Командам VK нужно прогонять большие таблицы через модели, иногда несколько дней подряд, сохраняя уже полученный результат. Общий Batch-worker связывает YTsaurus с экземплярами моделей через Open Inference Protocol.
Статья · на русском
Эффективный пакетный инференс моделей. Опыт инженеров VKАртём Петров · Опубликовано: 15 апреля 2025 г.
Что пользователь отдаёт платформе
Пользователь разворачивает модель с нужными ресурсами и указывает входную и выходную таблицы. Общий сервис берёт на себя чтение, вызовы и запись результатов. Благодаря Open Inference Protocol входы описываются именем, формой тензора, типом и данными, поэтому для каждой модели не нужен отдельный обработчик.
В статье используются MLServer и Triton. В Triton можно собрать последовательность из токенизатора и модели, переводящей текст в вектор; внешний клиент обращается к ней как к одному конвейеру.
Этот фрагмент в оригиналеТри независимые части работы
Чтение формирует пакеты строк и помещает их в канал. Размер пакета можно менять во время работы. На каждом хосте модели действует свой обработчик, а периодические проверки обнаруживают недоступные экземпляры.
Если хост отказывает после получения задания, его нужно убрать из работы, а задание вернуть в общий поток. Опасность в том, что все обработчики могут одновременно пытаться записать повторы в заполненный канал. Авторы описывают собственные каналы с асинхронным возвратом и учётом незавершённых запросов, чтобы не закрыть поток раньше времени.
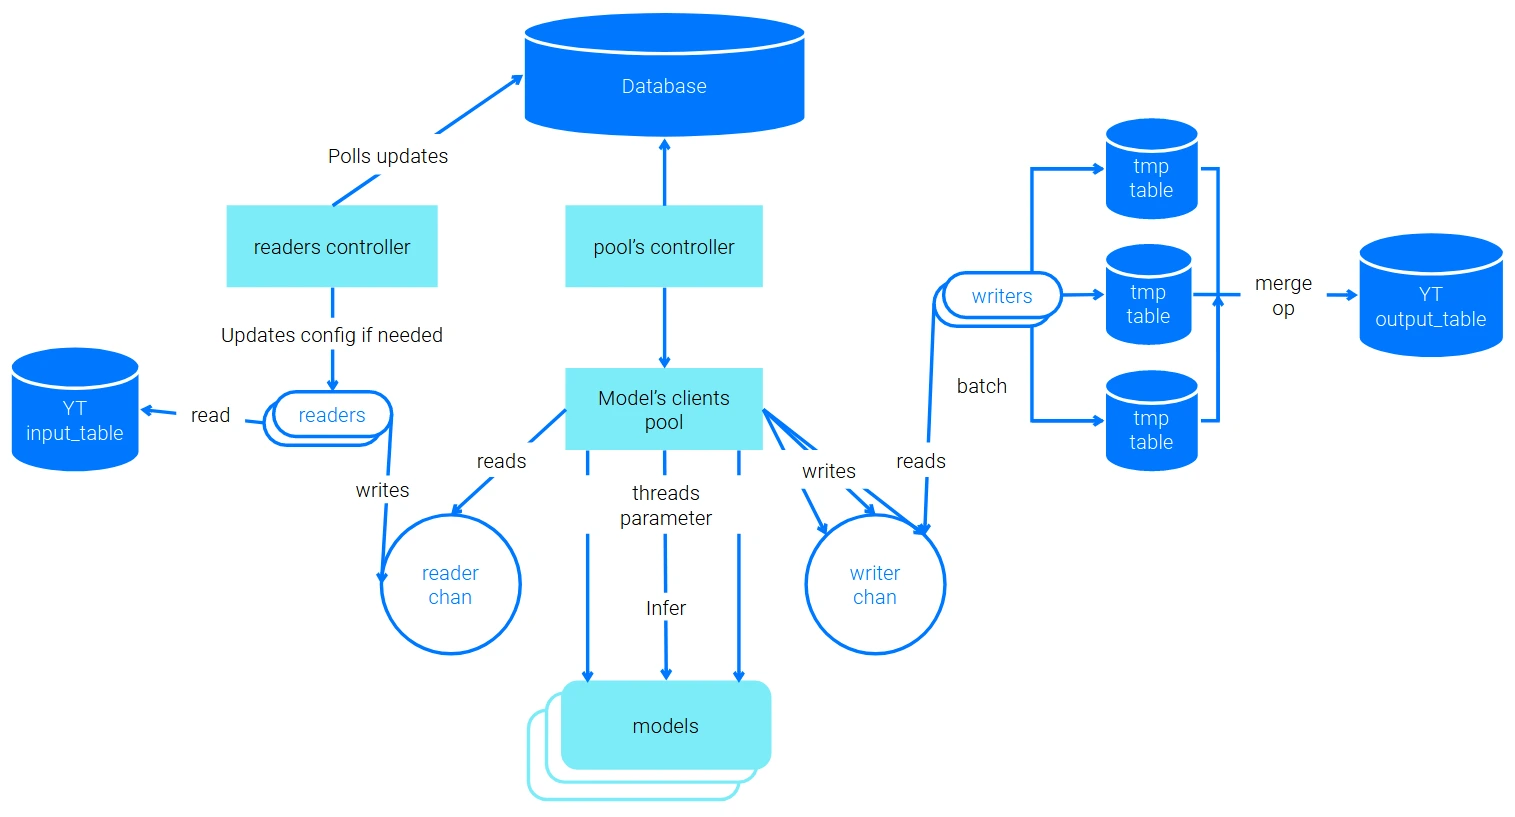
Полная схема пакетной обработки.
Источник: Иллюстрация из оригиналаОтветы могут быть намного тяжелее входов
Короткая строка способна превратиться в большой массив чисел. Ограничить очередь только числом сообщений недостаточно: память закончится на крупных ответах. Поэтому объём буфера задают в гигабайтах и оценивают размер результата через RequestSize.
В YTsaurus частая запись маленьких порций порождает много неполных блоков. Их слияние блокирует операции над таблицей. Вместо записи всего в одну таблицу команда пишет параллельно во временные, затем сливает заполненные и начинает следующую группу.
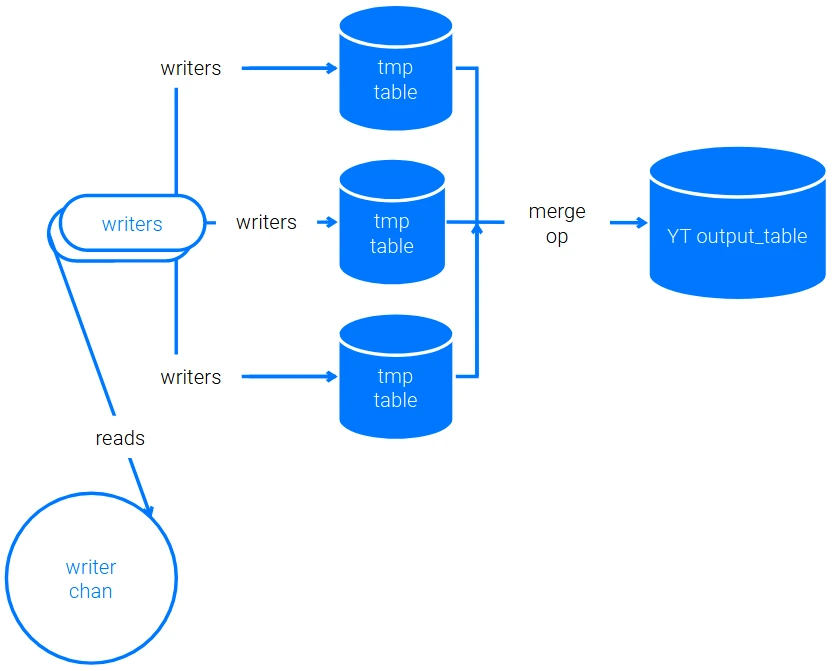
Запись и объединение результатов обработки.
Источник: Иллюстрация из оригиналаЧто осталось нерешённым
Группа таблиц всё ещё может ждать самый медленный поток. Древовидное слияние предложено как следующее улучшение. Балансировка также сложнее простого распределения по очереди: быстро возвращающий ошибки экземпляр способен забирать слишком много работы.
Поддержка новых протоколов, дополнительные пользовательские метрики и визуализация на момент публикации перечислены в планах. Заявленное возможное ускорение от них нельзя приписывать уже работающей версии.
Этот фрагмент в оригинале