Quick Fix: учить исправление кода на реальной работе пользователей
Исправление должно учитывать внутренние таблицы и стиль кода — и появляться раньше, чем пользователь исправит ошибку сам. Databricks дообучила Llama 3.1 8B на парах неудачного и последующего успешного запуска ячейки.
Статья · на английском
The Power of Fine-Tuning on Your Data: Quick Fixing Bugs with LLMs via Never Ending Learning (NEL)Samantha Banchik и соавторы · Databricks · Опубликовано: 8 апреля 2025 г.
Что должен исправлять помощник
Quick Fix предлагает изменения прямо в Databricks Notebook. Ошибки бывают синтаксическими, связаны с именами колонок или с логикой программы. При этом корректное исправление должно сохранять привычный язык и стиль: превращение SQL в PySpark может создать пользователю лишнюю работу.
Большие готовые модели дают сильную отправную точку, но подсказка нужна быстро. Длинный промпт с примерами или повторная проверка собственных ответов увеличивают ожидание. Маленькая открытая модель дешевле в обслуживании, однако без дообучения уступала крупным конкурентам.
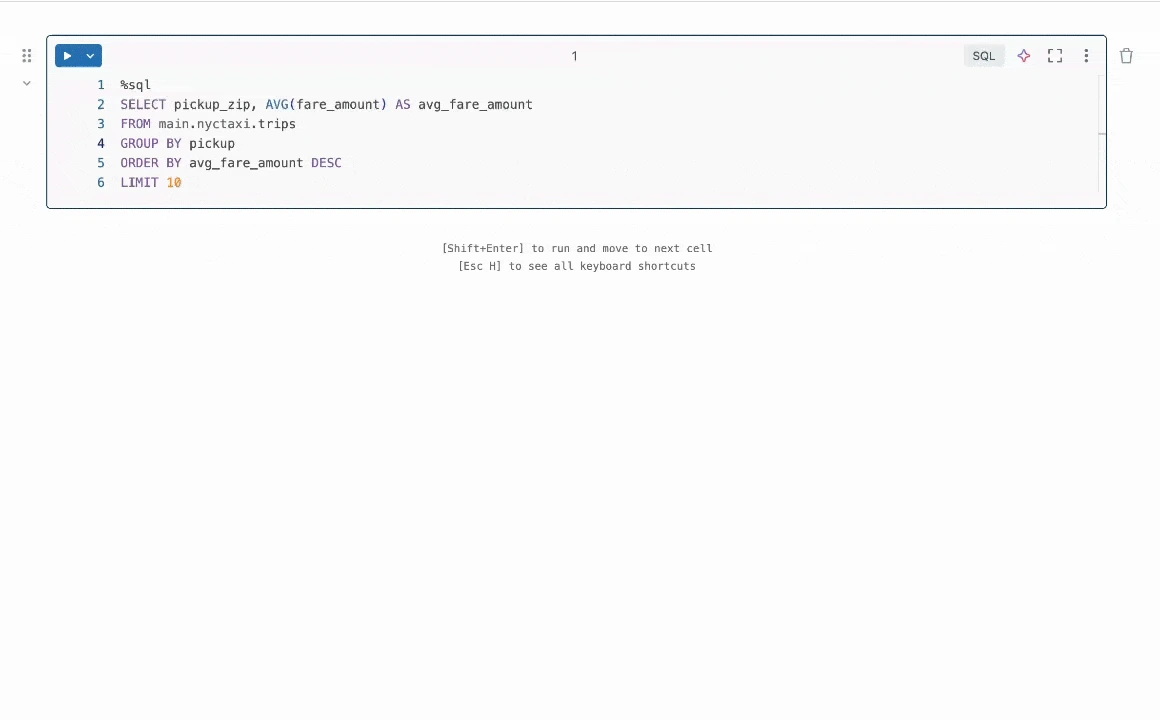
Пример ошибки в рабочем блокноте.
Источник: Иллюстрация из оригиналаОткуда берутся обучающие пары
Команда сохраняет код ячейки в момент ошибки и контекст: сообщение об ошибке, соседние ячейки, доступные таблицы и API. Затем находит следующий успешный запуск этой же ячейки. Исправление мог написать пользователь, помощник или они вместе.
Два края отбрасывают: код вообще не изменился — значит, причина могла быть во внешних настройках; код изменился слишком сильно — вероятно, это уже другая программа. Оставшиеся пары позволяют учиться на реальных задачах без отдельной ручной разметки каждого исправления.
Этот фрагмент в оригиналеГенерировать всю ячейку или только изменения
Обучили две версии Llama 3.1 8B Instruct. Одна возвращает весь исправленный код, другая — только разницу, которую нужно применить. Второй формат требует меньше выходных токенов, хотя сама задача генерации сложнее.
Скорость обучения и число итераций выбирали на отложенных примерах по точному совпадению с сохранённым исправлением. Авторы признают ограничение: другой корректный вариант кода получит ноль по такой метрике. Поэтому окончательное сравнение провели на пользователях.
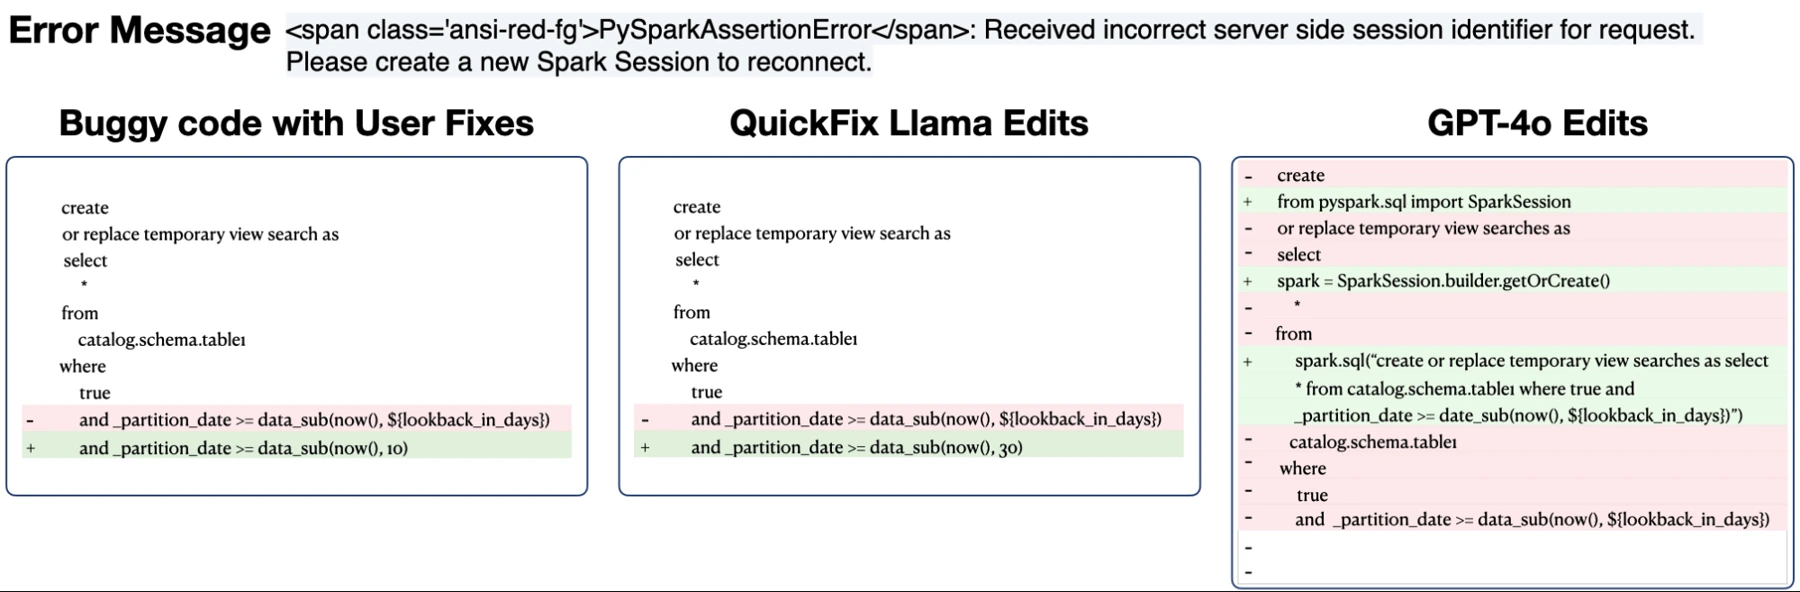
Пример исправления кода из оригинала.
Источник: Иллюстрация из оригиналаЧто показал внутренний эксперимент
Дообученная модель, генерирующая изменения, получила в 1,4 раза более высокую долю принятых предложений и вдвое меньшую задержку относительно GPT-4o. Значения на графиках нормированы к этому сопернику. Это результаты внутреннего A/B-теста на сотрудниках Databricks, а не универсальный рейтинг моделей для программирования.
В одном примере модель сохранила SQL вместо ненужного перехода на PySpark. В другом выбрала реальную колонку из переданного контекста, тогда как GPT-4o положилась на неподходящую подсказку сообщения об ошибке. Новые взаимодействия могут пополнять обучающий набор — отсюда название Never Ending Learning.
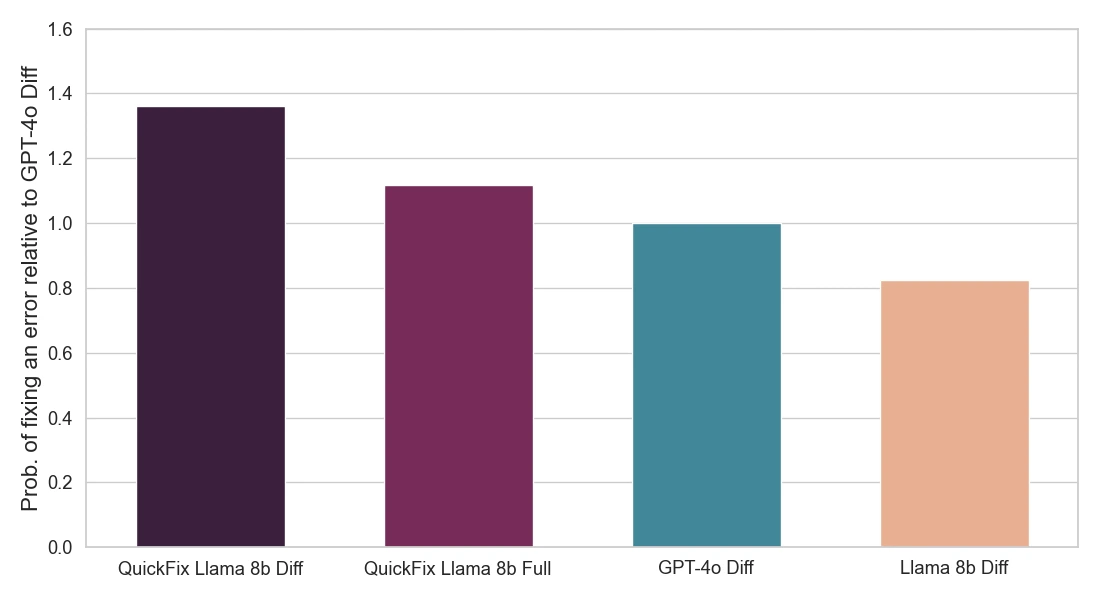
Доля принятых исправлений во внутреннем эксперименте.
Источник: Иллюстрация из оригинала