Как ускоряли видеодиффузию Adobe Firefly с TensorRT
Генерация видео требует много повторных вычислений: задержка и число GPU ограничивают доступность сервиса. Команда профилировала модель и перенесла вычисления в TensorRT со смешанной точностью FP8 и BF16.
Статья · на английском
Optimizing Transformer-Based Diffusion Models for Video Generation with NVIDIA TensorRTMaximilian Müller и соавторы · NVIDIA / Adobe · Опубликовано: 21 апреля 2025 г.
От исследовательской модели к обслуживанию запросов
Статья описывает оптимизацию Adobe Firefly на AWS EC2 P5/P5en с GPU семейства Hopper. Модель экспортировали в ONNX, чтобы использовать общий путь от исследовательского кода к развёртыванию и не переписывать вычисления вручную.
Оптимизировали именно диффузионную часть генератора. Поэтому её ускорение нужно отличать от времени всей пользовательской операции, куда могут входить подготовка запроса и другие этапы.
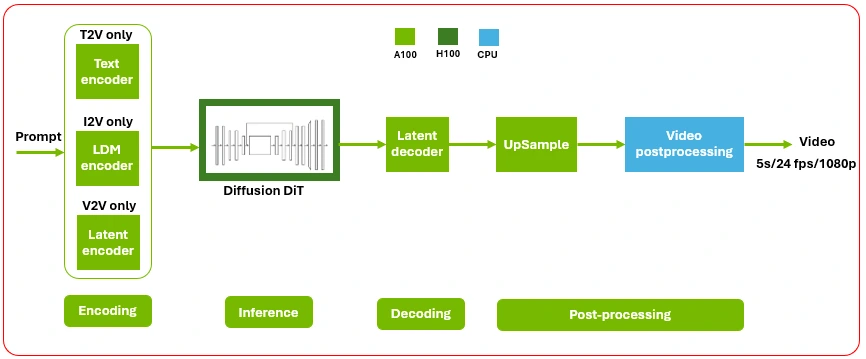
Этапы генерации видео в Firefly.
Источник: Иллюстрация из оригиналаСначала нашли дорогие операции
Профилирование через Nsight Deep Learning Designer показало, что основное время занимало внимание — сопоставление элементов представления видео друг с другом. Связав операции ONNX с выполнением на GPU, инженеры увидели, где теряются время и память.
Для вычислений использовали сочетание FP8 и BF16. Более короткое представление чисел уменьшает объём весов и промежуточных данных и позволяет задействовать быстрые операции GPU. При этом не все части модели обязаны работать с одинаковой точностью.
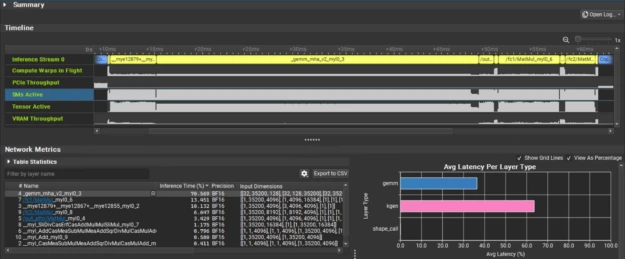
Профиль вычислений, который анализировала команда.
Источник: Иллюстрация из оригиналаПроверка качества и проверка скорости — разные этапы
Квантизацию после обучения настраивали через PyTorch API TensorRT Model Optimizer. Это позволяло проверить влияние округления чисел в уже имеющемся исследовательском процессе до экспорта всей сети.
Авторы отдельно предупреждают: эмуляция FP8 в PyTorch подходит для оценки качества, но не показывает реальное ускорение FP8 на устройстве. Производительность нужно измерять после сборки и запуска оптимизированной модели.
Этот фрагмент в оригиналеКак читать заявленные результаты
Для опубликованного развёртывания авторы сообщают о снижении задержки диффузии на 60% и совокупной стоимости владения примерно на 40%. На графике вычислительная основа модели ускоряется до 2,5 раза относительно PyTorch. Это согласующиеся способы описать время одной части системы, а не два независимых эффекта, которые можно перемножить.
Результат относится к Firefly, выбранной точности, оборудованию и настройкам этого сравнения. Перенос на другую видеомодель требует собственной проверки качества и профилирования.
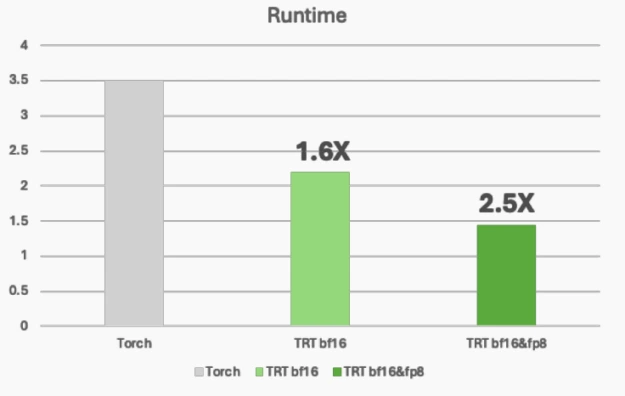
Сравнение времени работы конфигураций в тесте авторов.
Источник: Иллюстрация из оригинала