Разбор готов
Яндекс — экономически эффективный инференс LLM для агентных сценариев
Кодовый агент может полтора часа решать задачу, сотни раз обращаться к языковой модели и многократно передавать почти одну и ту же историю. Для API языковых моделей Яндекс Studio такая нагрузка создаёт две проблемы: сколько видеокарт нужно, чтобы укладываться в задержку ответа, и как избежать повторной обработки огромного контекста. Обычный расчёт по средней скорости недооценивает очереди и всплески, а простая балансировка теряет уже вычисленный кеш. В докладе Владислава Носивского от 19 сентября 2026 года последовательно разбираются оценка ресурсов, бенчмарк агентных сессий и эксперименты с маршрутизацией, разделением стадий, параллелизмом и общим кешем.
Для ML-инженеров, разработчиков LLM-сервисов и инфраструктурных команд: как оценивать GPU под задержку, воспроизводить агентные сессии и выбирать оптимизации KV-cache без смешения расчётов, бенчмарков и рабочих наблюдений.
Видео · на русском
Строим экономически эффективный инференс LLM для агентских (и не только) сценариевВладислав Носивской · Опубликовано: 19 сентября 2026 г.
Исходный доклад · Открыть оригинал
Что считать экономичным инференсом
Автор руководит группой инференса, описывает предоставление API к языковым моделям и работу с открытыми инструментами. Инференс здесь — применение модели для получения ответа.
По горизонтали автор откладывает число GPU как основную составляющую затрат; по вертикали — максимальное число запросов в секунду, RPS, при выполнении выбранного требования к обслуживанию, SLO.
Первая задача — оценить число GPU для заданного RPS. Вторая — при уже выделенных GPU увеличить допустимую нагрузку, сравнивая разные конфигурации.
Доклад сочетает расчётный пример, серию экспериментов и отдельные наблюдения из работающей системы. Заявленный масштаб экспериментов — несколько сотен GPU-часов; это не денежная стоимость обслуживания клиентов.
Доклад · 04:38:17Почему агенту так нужен KV-cache
Сессия содержит сотни обращений к модели и, по словам автора, десятки миллионов токенов. В суммарное время входят задержка до первого токена каждого обращения и последующая генерация.
Кеш ключей и значений внимания, KV-cache, позволяет использовать уже обработанную часть контекста вместо повторных вычислений. Автор связывает экономическую осуществимость таких сессий с приближением к теоретически возможному попаданию в кеш.
Снижение cache hit с 97,5% до 95% автор иллюстрирует как удвоение вычислений и потребности в GPU на стадии обработки входа, prefill. Это объяснение чувствительности стоимости к повторной обработке, а не универсальная точная формула для любой нагрузки.
Попадание по длине повторно используемого контекста и доля запросов с попаданием в кеш — разные показатели. Указанные проценты нельзя превращать в долю запросов, которым вообще не нужна генерация.
Доклад · 04:40:25Задача: 10 запросов в секунду при P99 TTFT
Учебная постановка: DeepSeek V4 Flash, 10 RPS, 99-й перцентиль времени до первого токена, TTFT, не более пяти секунд.
Автор дополнительно предполагает согласованные ограничения на длину контекста, длину ответа и скорость генерации; конкретные значения части этих ограничений в речи не названы.
Цель по cache hit — 90%. На этом этапе это допущение для расчёта, а не уже полученный результат; способы приблизиться к нему разбираются позже.
Эту постановку нельзя смешивать со второй частью доклада: там эксперимент проводят на 16 GPU и ослабляют требование с P99 до P95.
Доклад · 04:41:50Какие измерения нужны до расчёта
На реальном экземпляре модели снимают зависимость пропускной способности от длины контекста: к концу длинного входа обработка становится дороже.
Для упрощения расчёта обработку входа, prefill, и пошаговую генерацию, decode, считают на разных экземплярах сервиса.
Раздельный расчёт стадий здесь — приём методологии. В дальнейшем физическое разделение prefill/decode проверяется как самостоятельное архитектурное изменение со своими издержками.
Измерения показывают: DeepSeek V4 Flash занимает около 2370 байт KV-cache на токен без SWA; около 30 ГБ KV-cache доступно на ранг. FULL:SWA = 90:10 для prefill и 99:1 для decode. SWA — внимание со скользящим окном. Эти соотношения относятся к указанным стадиям, а не ко всему объёму памяти модели.
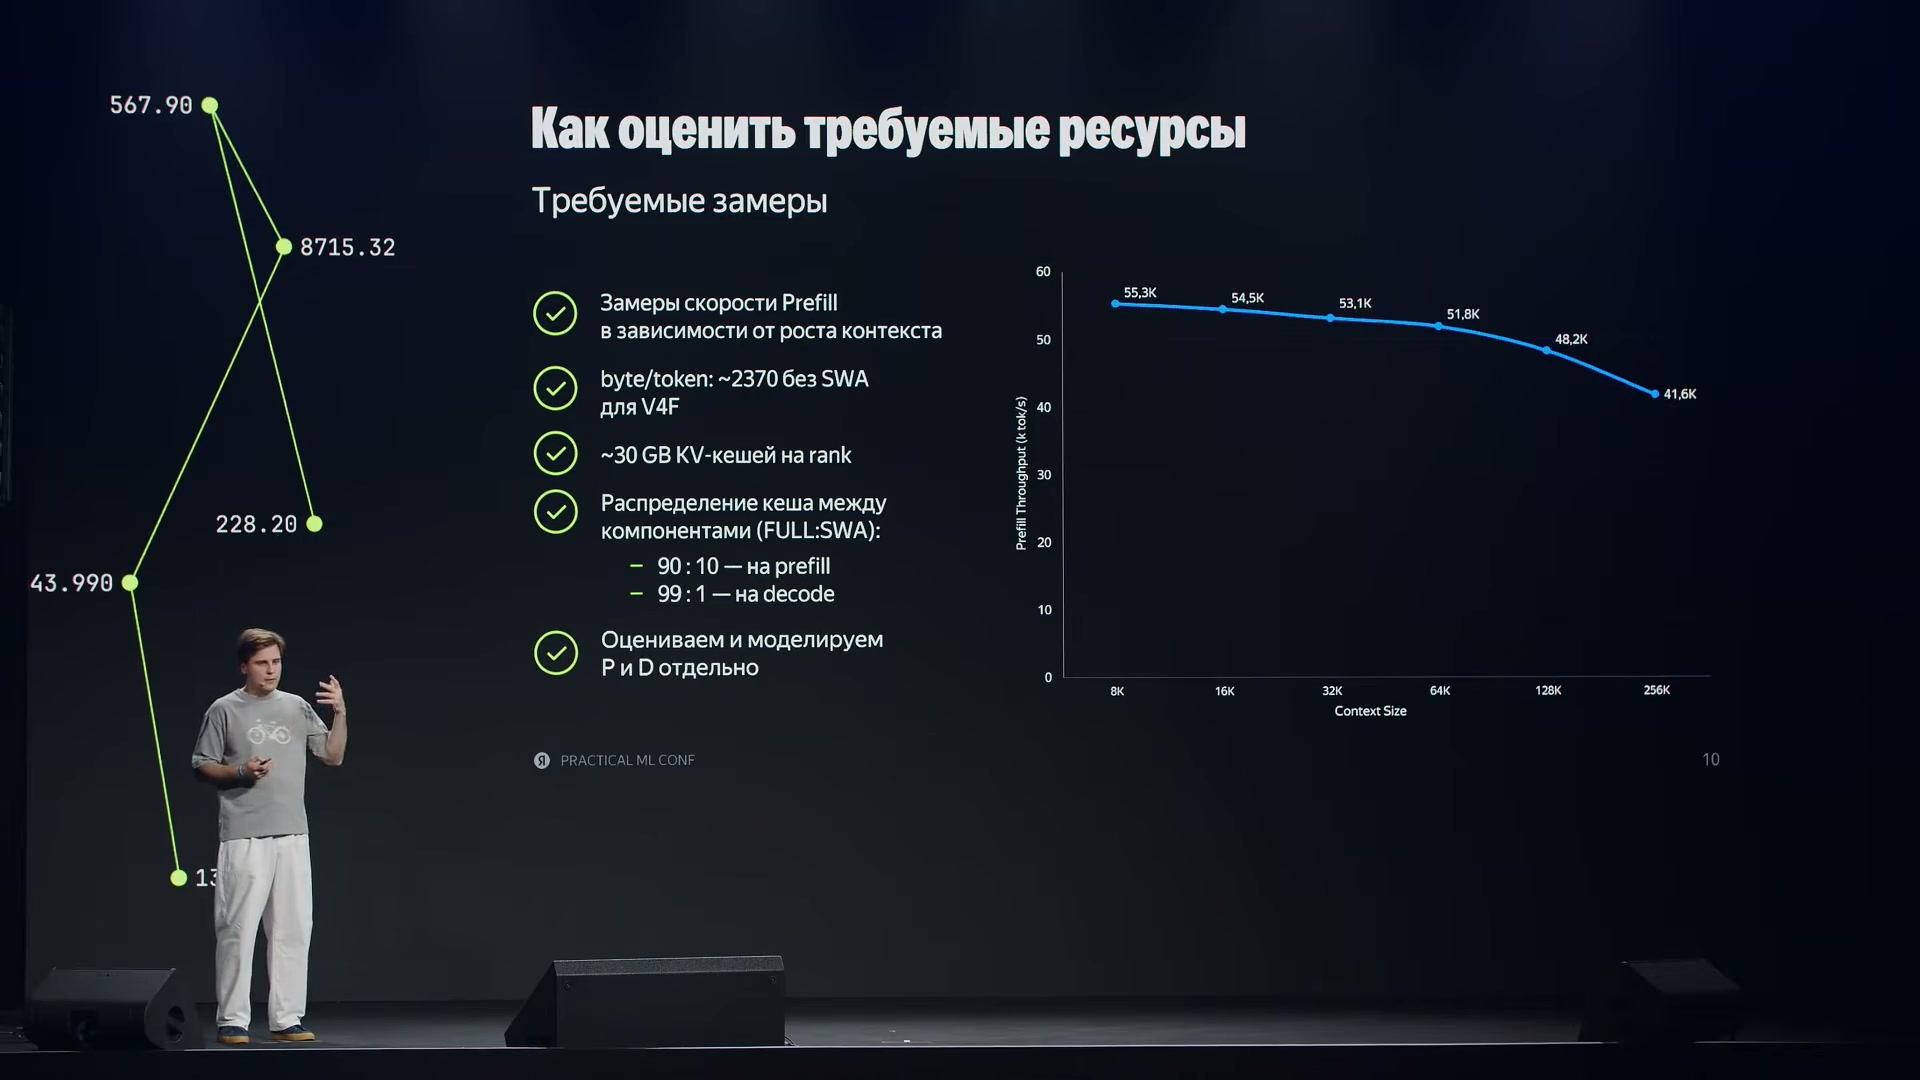
Замеры decode, prefill и размера KV-кеша нужны до выбора конфигурации; характеристики относятся к измеряемой модели.
Источник: Яндекс · исходный докладПочему на бумаге хватило 36 GPU
Для контекста 256 000 токенов и cache hit 90% автор берёт примерно 25 000 новых токенов в конце. Он использует измеренную пропускную способность уже для длинного контекста, а не оптимистичную скорость на коротком.
На стадии decode запрос занимает память около 30 секунд. Основным ограничением в этом приближении становится ёмкость памяти, а не то же вычислительное ограничение, что у prefill.
Закон Литтла связывает вместимость по одновременно удерживаемым запросам, время их жизни и допустимую интенсивность поступления. Автор отмечает, что наивная оценка decode сохраняется дольше, чем оценка prefill.
Первое приближение для 10 RPS: 28 GPU на prefill и восемь на decode, всего 36. Это промежуточный расчёт, который ещё не подтверждает выполнение P99 TTFT.
Для decode: каждый запрос занимает 256 тыс. токенов в FULL-пуле и 128 токенов в SWA. FULL-пул около 15 млн токенов вмещает примерно 57 запросов, SWA-пул около 136 тыс. токенов не является ограничителем. По закону Литтла получается 57/30 ≈ 1,9 RPS на GPU decode.
Закон Литтла со слайда 17082; N — одновременные запросы, T — 30 секунд.
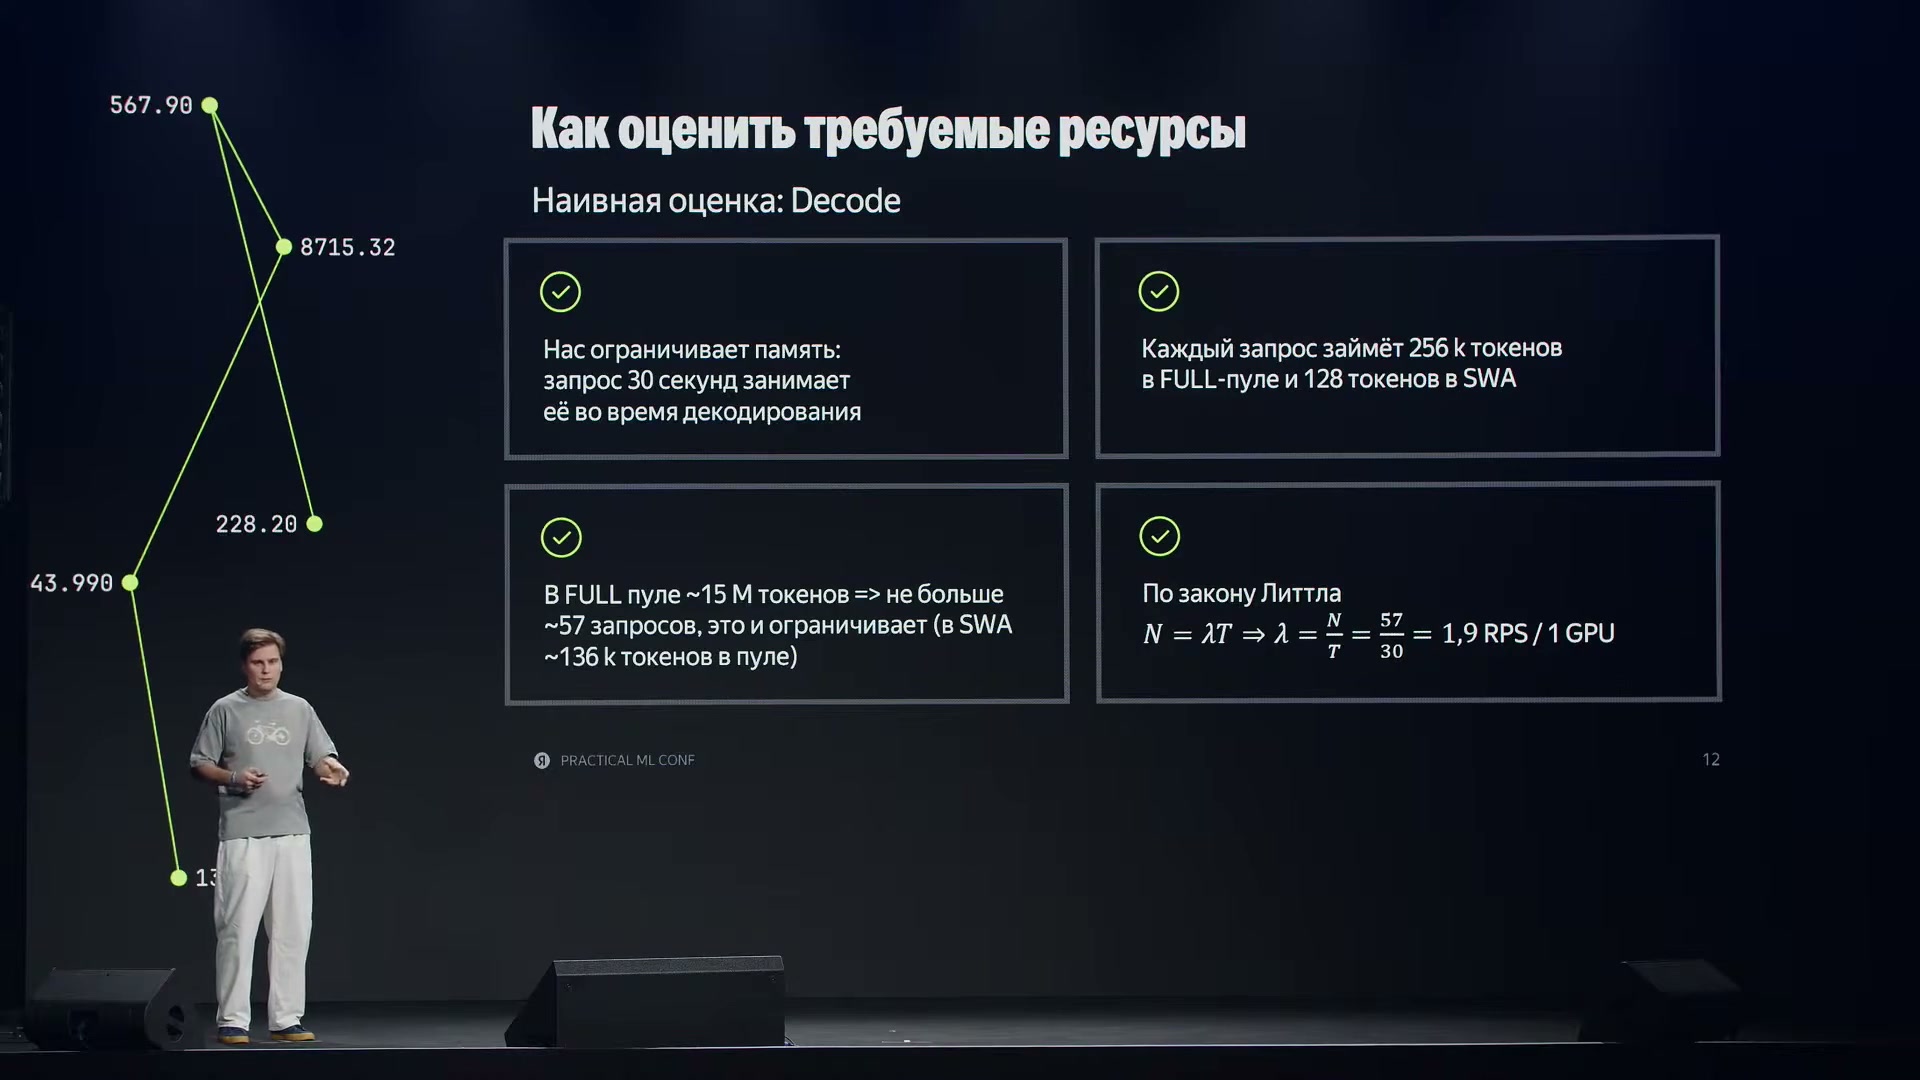
Наивная оценка нагрузки через время ответа и закон Литтла. Следующие слайды уточняют эту оценку.
Источник: Яндекс · исходный докладХолодный хвост обрабатывается нелинейно
Ошибка остаётся даже при использовании точки с длинным контекстом: последние 10% входа не обязаны занимать 10% времени полной обработки.
Автор предлагает аппроксимировать измеренную зависимость времени от длины квадратичной функцией и оценить её коэффициенты по эксперименту. Это модель данного расчёта, а не утверждение о точной форме стоимости любого prefill.
Стоимость необработанного хвоста считают как T(полный контекст) − T(уже закешированный префикс), а не как 0,1 × T(полный контекст).
После этой поправки общая оценка возрастает до 40 GPU: автор указывает +11% к прежним 36. Следующее уточнение связано уже не с вычислением хвоста, а с ожиданием в очереди.
Квадратичная аппроксимация времени prefill со слайда 17142.
Стоимость холодного хвоста по разности полных времён, а не по доле длины.
После поправки на кадре получается 1,28 RPS на четыре GPU, итоговая расчётная оценка 40 GPU (+11%).
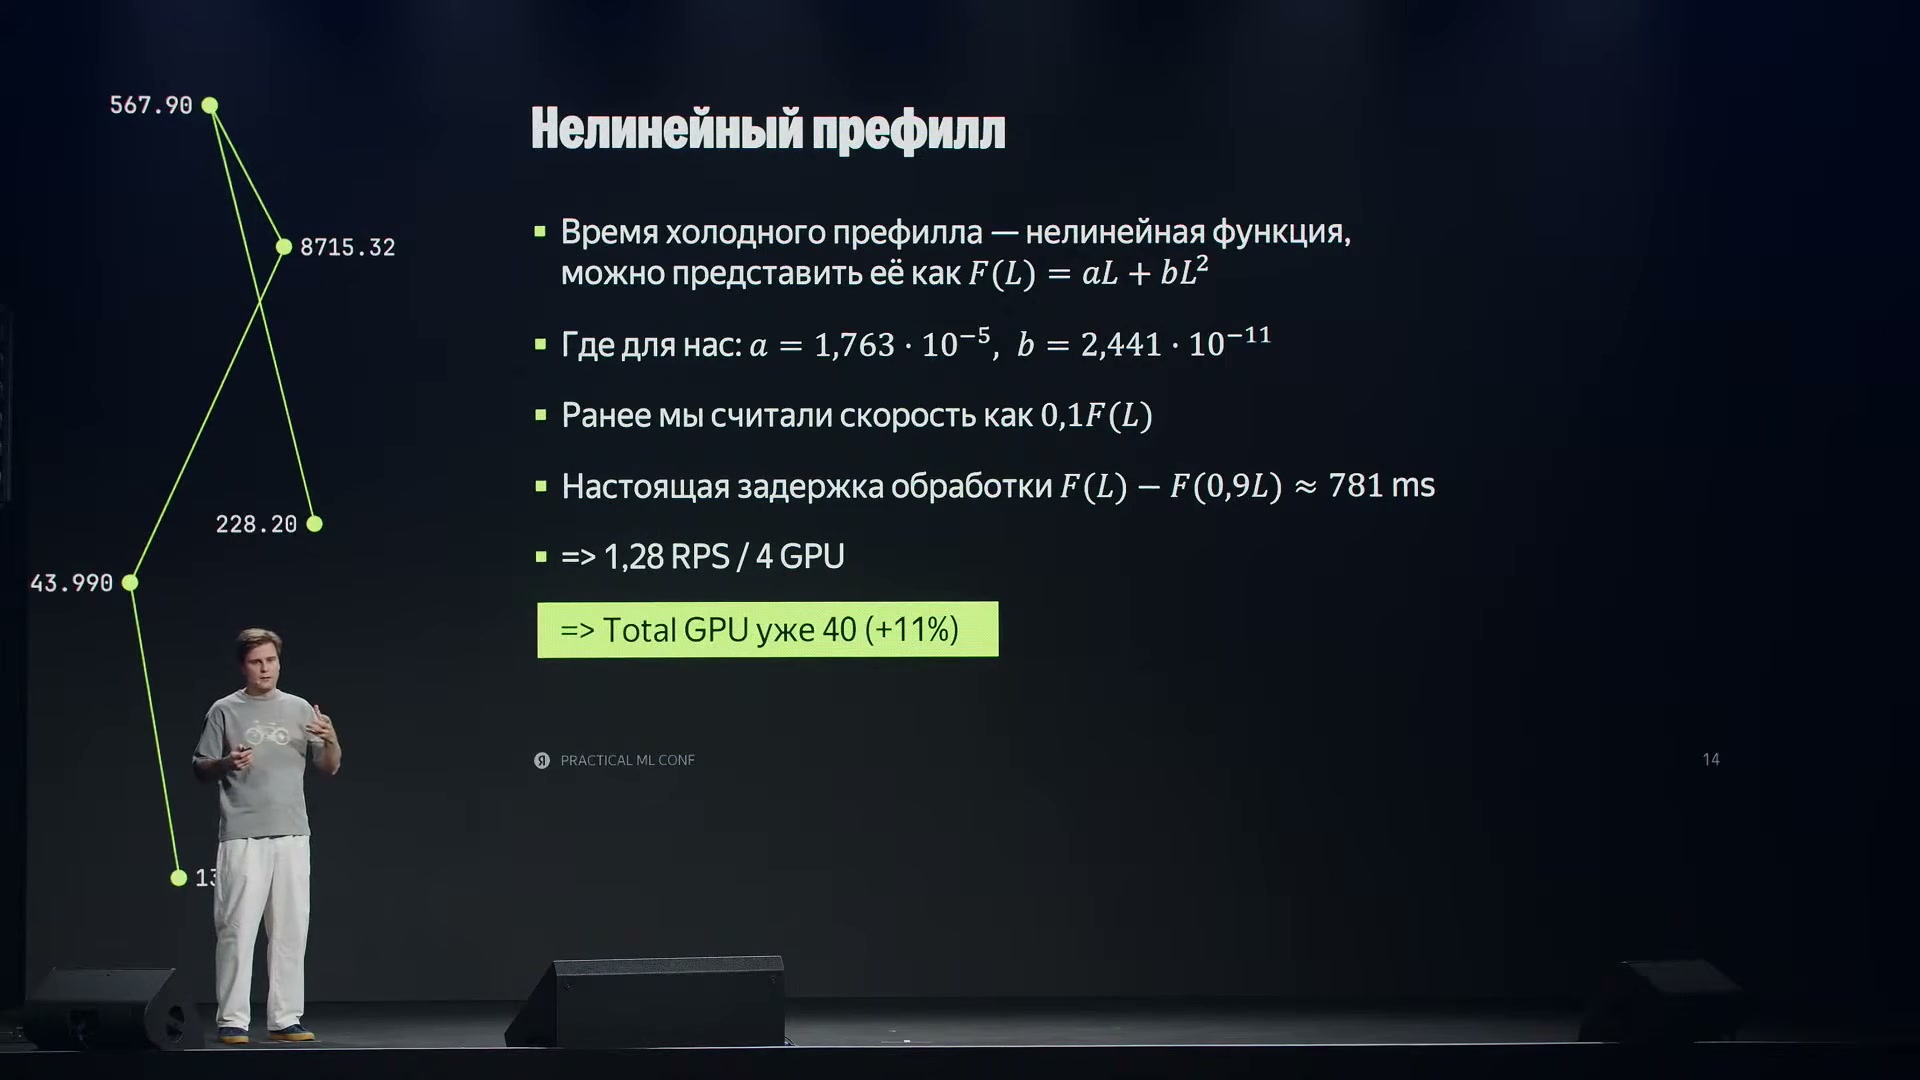
Время prefill растёт нелинейно с длиной входа; это меняет оценку необходимых ресурсов.
Источник: Яндекс · исходный докладОчередь увеличивает оценку до 56 GPU
Автор приводит время самой обработки входа около 780 миллисекунд, но напоминает, что TTFT включает также ожидание начала обработки.
Средние 10 RPS не означают равномерный запрос каждые одинаковые промежутки времени: локальные всплески накапливают очередь, затишья позволяют ей уменьшиться.
Первая модель поступления запросов — пуассоновский процесс. Автор описывает его как типичный способ генерации нагрузки при заданном RPS в стандартных бенчмарках движков.
Для оценки очереди моделируют много траекторий поступления запросов и рекурсивно рассчитывают ожидание каждого запроса. Затем ищут максимальную интенсивность, при которой выполняется требование к задержке.
Учёт очереди и исходного P99 TTFT добавляет ещё около 40% к числу GPU. Это очередная ступень после поправки на нелинейность, а не прибавка к пропускной способности.
Экспоненциальные интервалы пуассоновского потока.
Рекурсия ожидания очереди со слайда 17292.
Предел интенсивности при P99 TTFT ≤ 5 секунд.
В модели очереди λmax ≈ 0,834 RPS на четыре GPU, итоговая оценка — 56 GPU (+40% относительно 40).
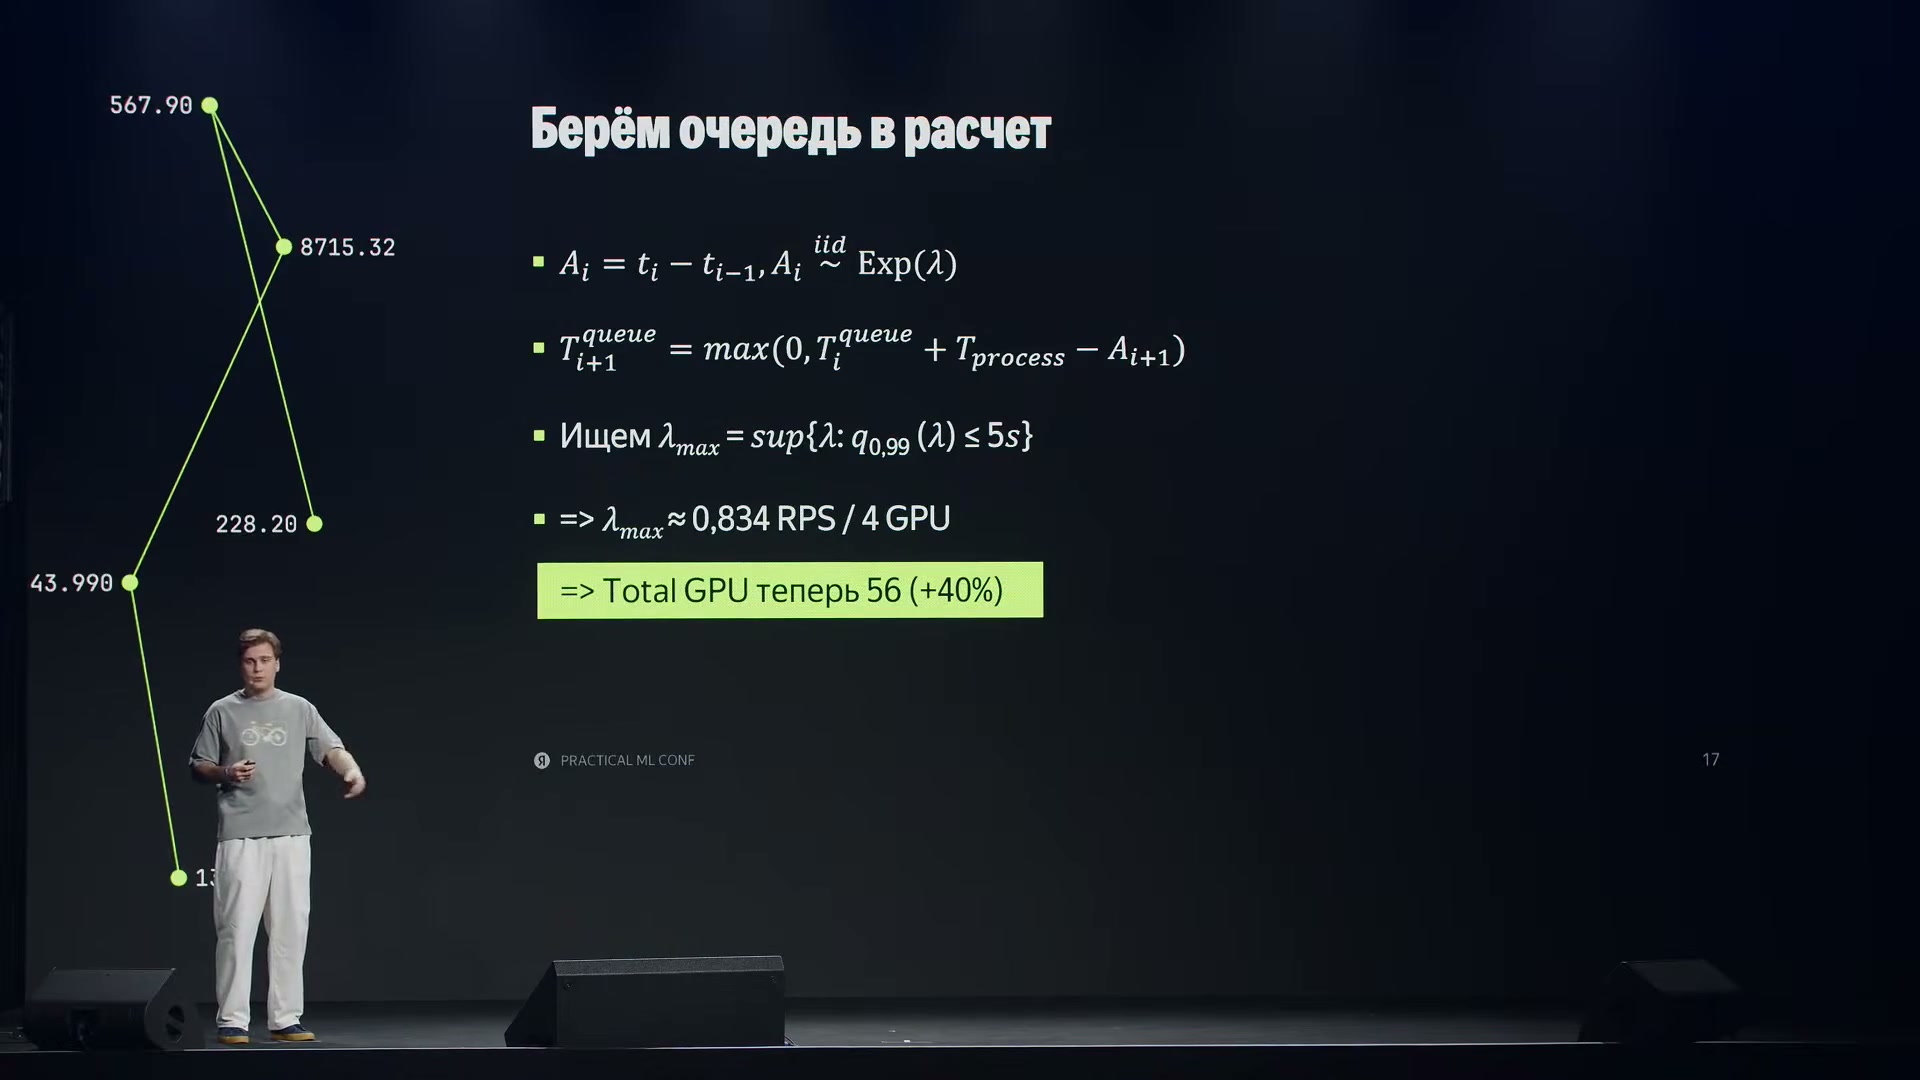
Учёт очереди и ограничений SLO дополнительно увеличивает требуемые ресурсы.
Источник: Яндекс · исходный докладПочему реальные всплески хуже Пуассона
Автор исследует логи своей модели за 3 сентября в минутных окнах за сутки. Меньше половины окон похожи на пуассоновский процесс, больше 40% имеют более выраженные всплески.
В верхней квартиле по нагрузке пуассоновских окон остаётся особенно мало. Именно такие периоды важны для оценки очередей под высокой нагрузкой.
Параметры подбирают так, чтобы описать 5% самых загруженных окон. После пересчёта автор получает ещё около 50% GPU относительно предыдущей ступени.
Всплески могут порождать запуски субагентов. Кроме того, API модели могут использовать не только агенты: например, пакетная суммаризация меняет картину поступления запросов.
Итог расчётной части — выбор между более оптимистичной пуассоновской и более пессимистичной всплесковой оценками. Последовательные поправки нельзя складывать как независимые проценты или выдавать за одну универсальную норму запаса.
По минутным окнам: 47% минутных окон похожи на Пуассона, 1,5% имеют меньшую дисперсию, 43% превышают 99,9-й перцентиль Пуассона. Среди наиболее загруженных 25% минут похожи на Пуассона лишь 12,5%.
Таблицу можно прокрутить по горизонтали.
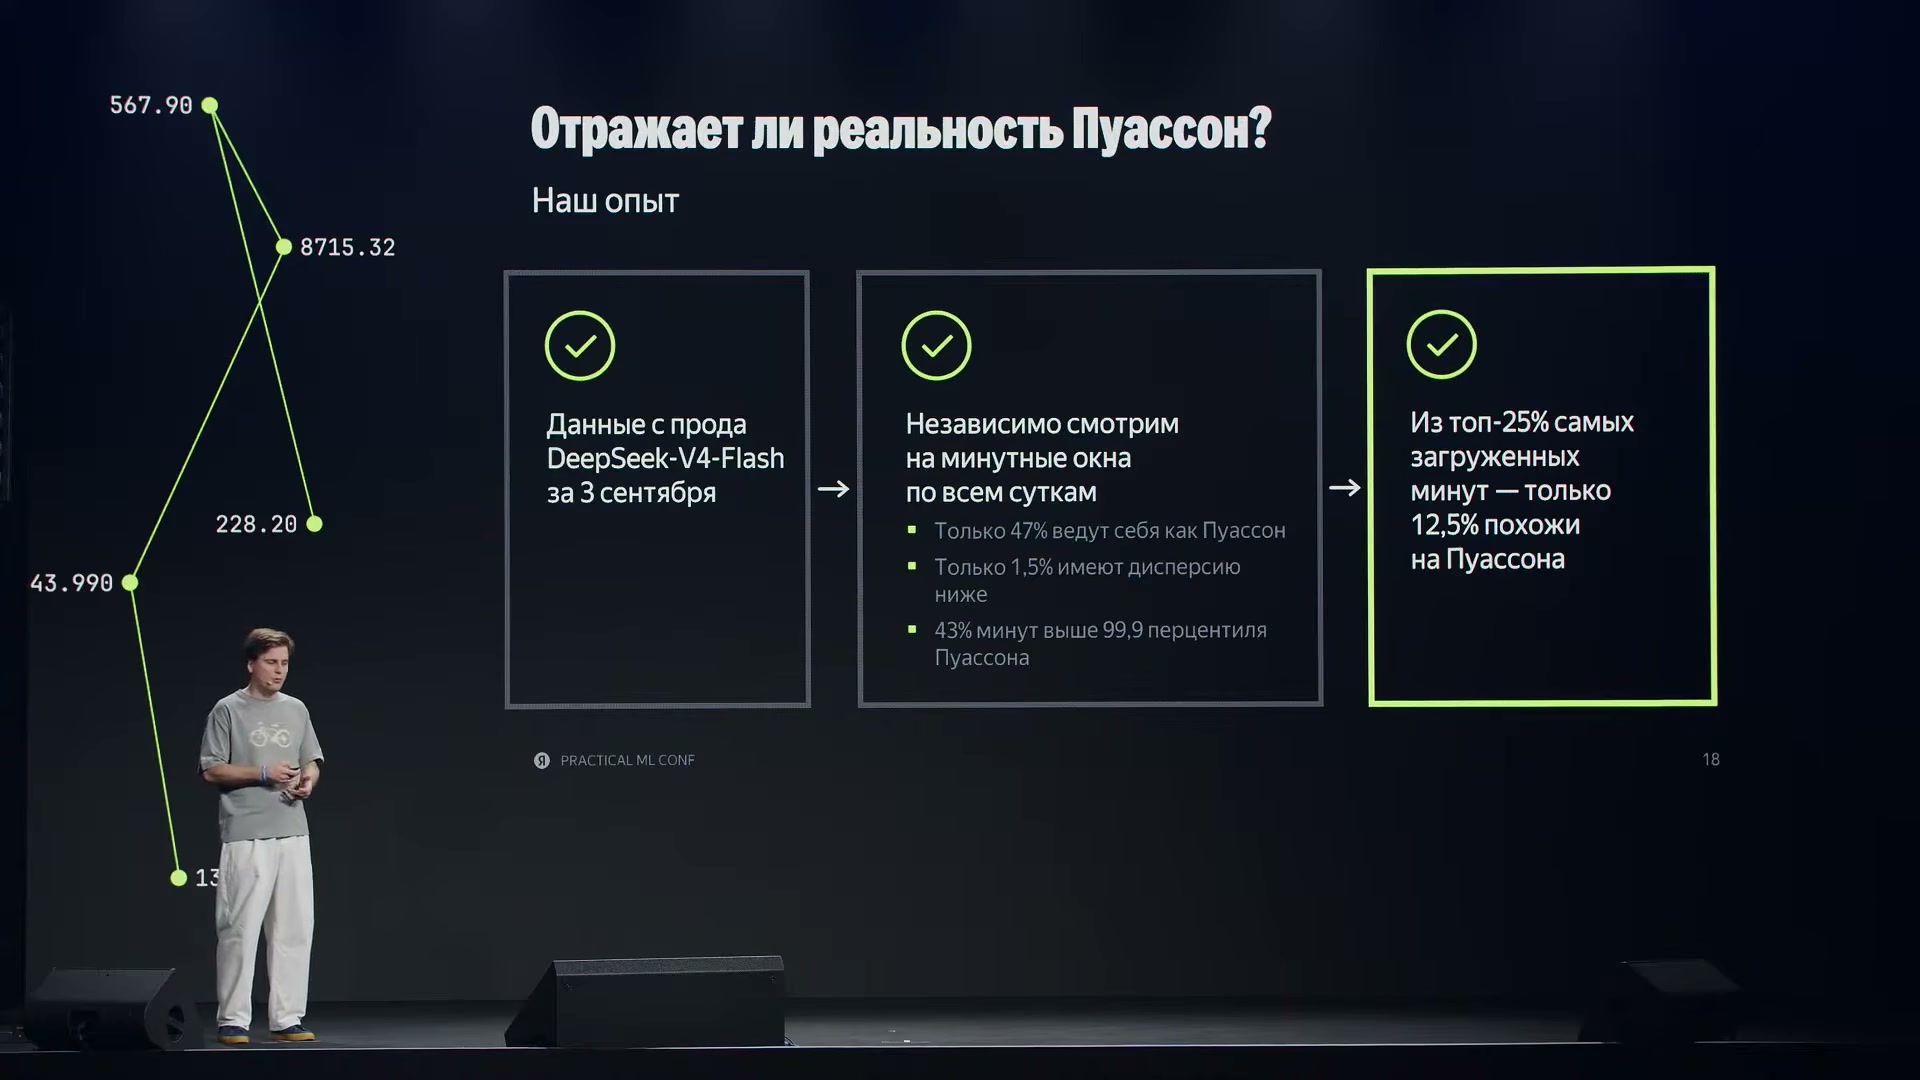
На реальной нагрузке распределение поступления запросов не всегда соответствует пуассоновской модели.
Источник: Яндекс · исходный докладКакие свойства агентной нагрузки определяют архитектуру
Растущий контекст делает важной локальность KV-cache: следующий запрос выгодно направлять туда, где сохранился префикс, либо обеспечивать доступ к общему хранилищу.
Паузы между шагами не контролируются сервисом. При вытеснении кеша после возвращения пользователя приходится пересчитывать контекст; при жёстком закреплении память может простаивать, потому что пользователь вообще не обязан вернуться.
Для всплесков нужен запас мощности либо организация обработки, при которой новые холодные запросы меньше мешают уже выполняемым.
Относительно длинные ответы и существенно разная потребность prefill и decode в GPU мотивируют независимую настройку и масштабирование стадий. Это причина проверить разделение, но не обещание его автоматической выгоды.
В обзоре оптимизаций дополнительно перечислены agentic-aware routing, autoscaling, speculative decoding и небольшие пакеты генерации. Это предложенные направления оптимизации, а не отдельно проверенные в докладе внедрения.
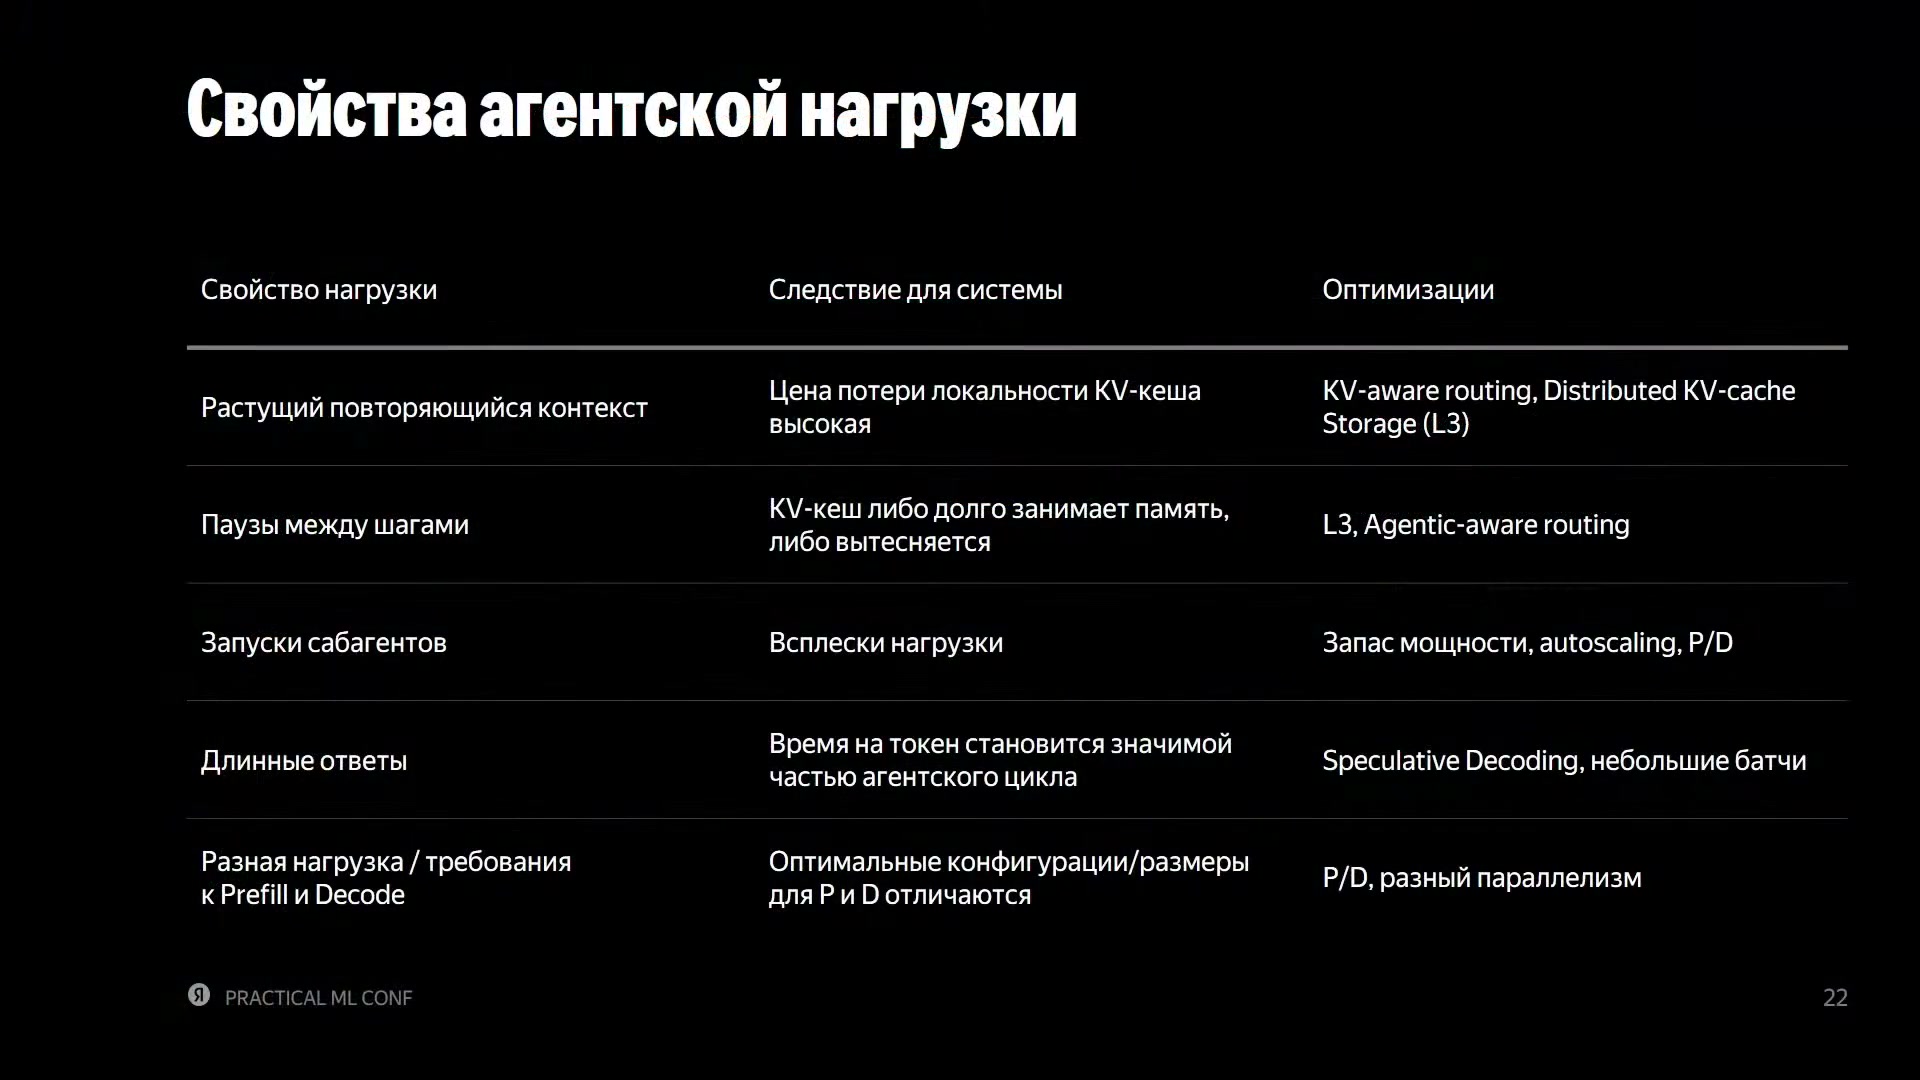
Разные свойства агентной нагрузки требуют разных оптимизаций: маршрутизации, кеширования и организации prefill/decode.
Источник: Яндекс · исходный докладБенчмарк из настоящих агентных сессий
Сессию выбирают и прогревают до некоторого её этапа. Затем в течение часа измеряют работу прогретой системы; завершившиеся сессии заменяют следующими.
Воспроизведение сохраняет потенциальное повторное использование контекста и паузы между шагами, включая время работы внешних инструментов, например выполнения сценария оболочки.
Число одновременно обслуживаемых сессий и RPS — не одна величина. Автор сначала ставит вопрос о сессиях, а часть следующих результатов проговаривает в RPS; подменять единицы нельзя.
Доклад · 04:52:54Четыре независимых экземпляра: SLO нарушено
Для серии сравнений берут DeepSeek V4 Flash и 16 GPU. Требование ослабляют до P95 TTFT не более пяти секунд, потому что ресурсов меньше, чем в первой расчётной постановке.
Базовый вариант — четыре независимых экземпляра по четыре GPU с обычным балансировщиком. Обработка входа и генерация ещё не разделены на разные группы экземпляров.
По результату автора максимально допустимое число сессий при этом SLO — ноль: уже одна сессия нарушает ограничение из-за низкого попадания в кеш.
Ноль означает отсутствие допустимой нагрузки по выбранному критерию, а не неспособность модели вообще отвечать.
В исходном сравнении: при одной сессии 8,5% запросов нарушают P95 TTFT ≤ 5000 мс; cache hit 77% по запросам и 94% по длине. Эти две доли не взаимозаменяемы.
Даже при одной сессии 8,5% запросов превышают предел TTFT. На слайде два показателя cache hit: 77% по запросам и 94% по длине; высокий процент повторно использованных токенов не спасает хвост задержки.
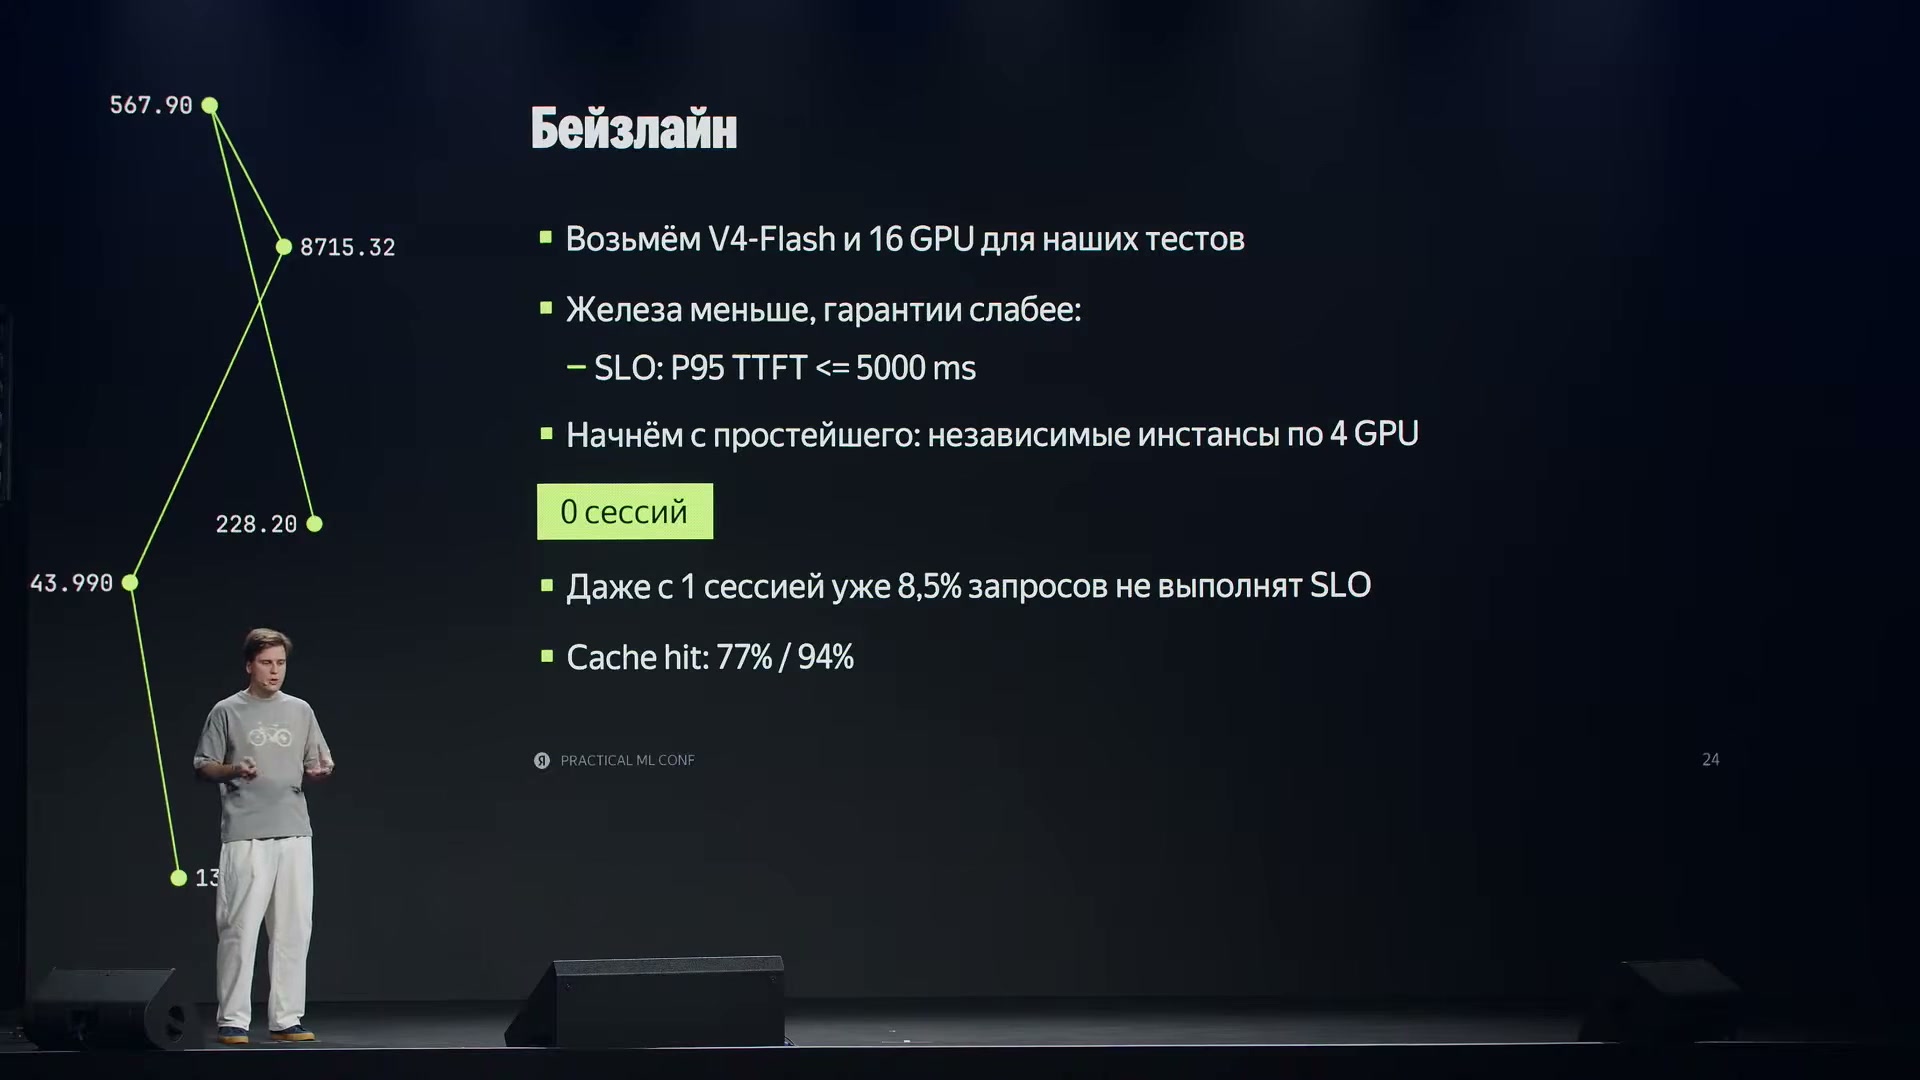
Исходная конфигурация и доля запросов, не укладывающихся в SLO; показаны конкретные условия теста.
Источник: Яндекс · исходный докладМаршрутизация по сохранённому контексту
Маршрутизатор получает текущие сведения о KV-cache каждого рабочего процесса и направляет запрос с учётом уже сохранённого контекста. Это KV-aware routing.
Автор допускает собственную реализацию, но команда использует экосистему NVIDIA Dynamo, в том числе её маршрутизатор.
В отдельном замечании об эксплуатации автор говорит, что на prefill существенных проблем с такой маршрутизацией не наблюдают. На decode обычное циклическое распределение, Round Robin, плохо учитывает ограничение по памяти при длинных контекстах.
Команда добавила политику, которая учитывает суммарную длину контекстов одновременно выполняемых запросов, а не только количество запросов в пакете: одинаковое число запросов может означать разную занятость памяти.
После добавления маршрутизации в серии на 16 GPU автор называет примерно 3,4 RPS и близкое к идеальному попадание в кеш. Точное число сессий и раздельные показатели cache hit в речи не приведены.
Это программная оптимизация поверх прежнего сервиса модели. Автор называет её дешёвой или бесплатной в сравнении с последующими изменениями кластера; это не означает отсутствия затрат на разработку.
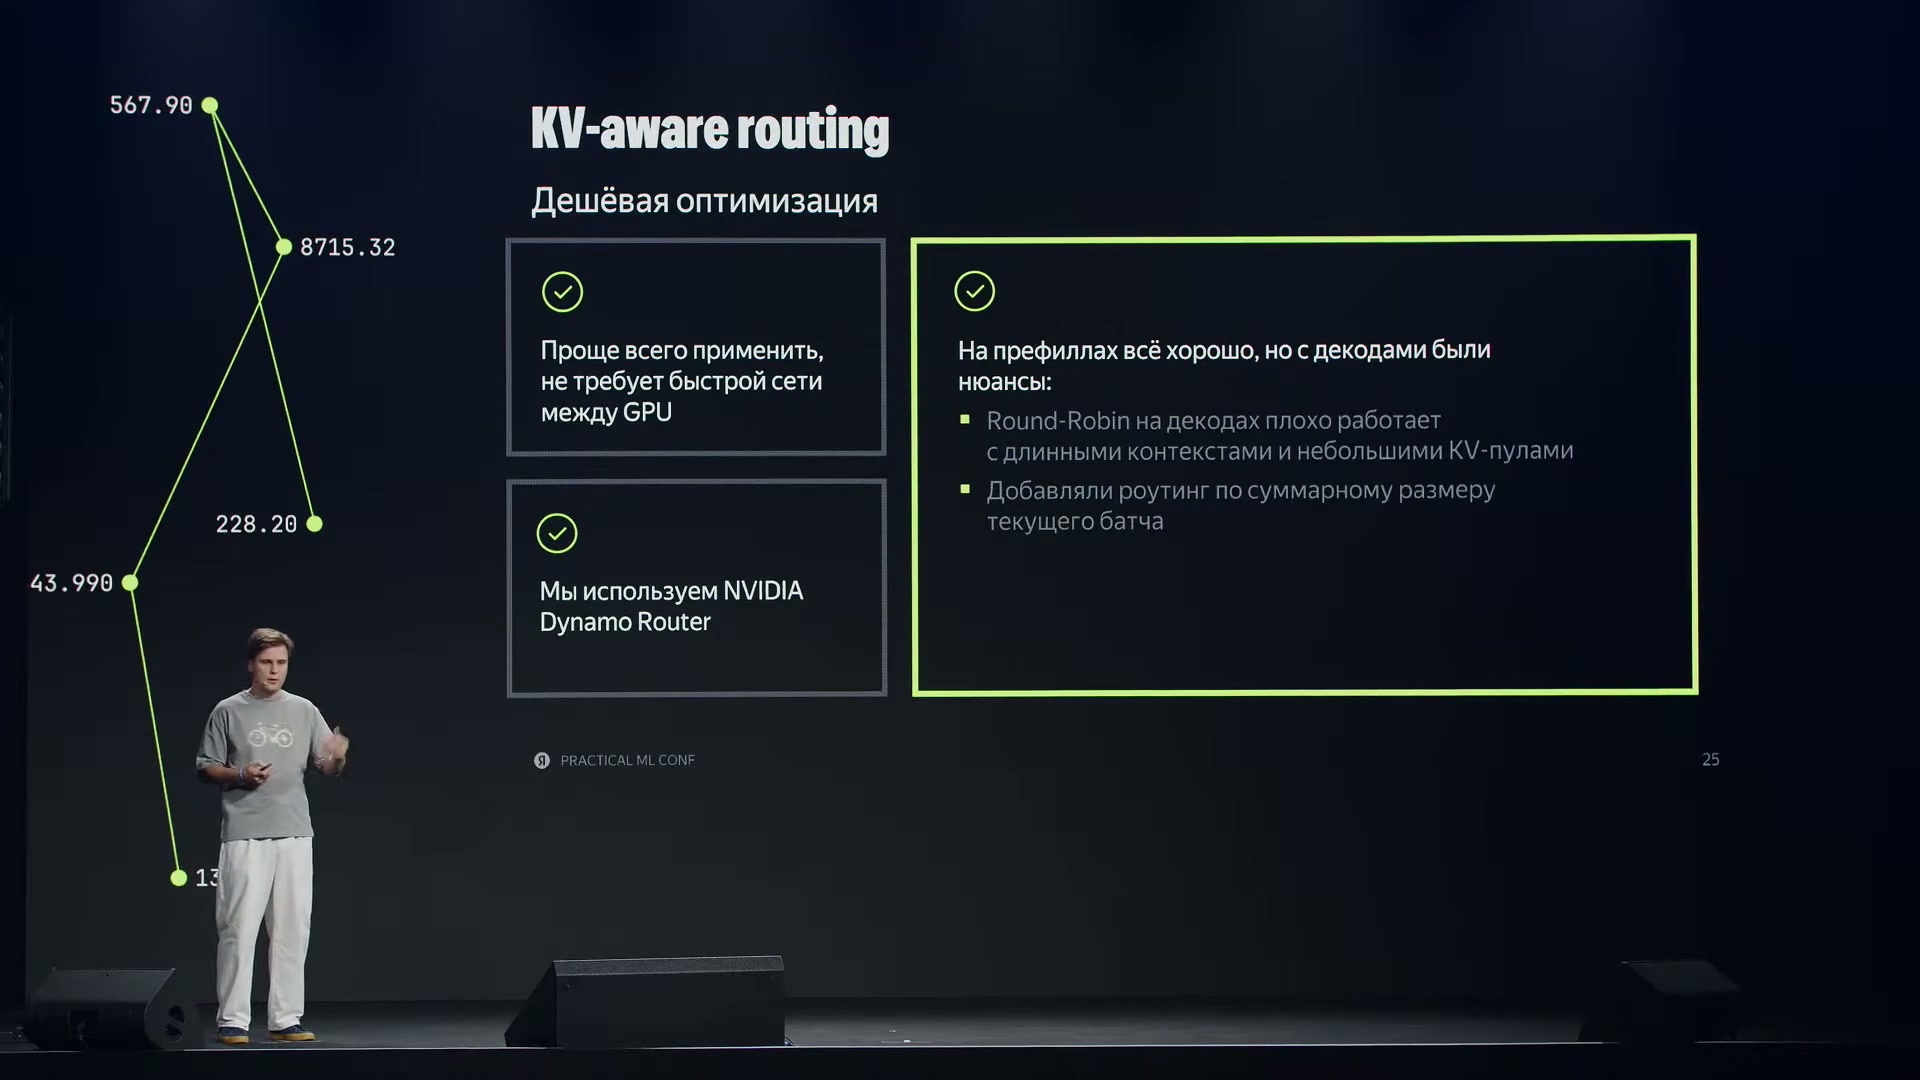
Маршрутизация с учётом KV-кеша повышает эффективность повторных обращений; результат относится к описанной нагрузке.
Источник: Яндекс · исходный докладНеудача простого разделения 3P1D
Физическое разделение требует быстрой сети для передачи KV-cache между prefill и decode. Оно позволяет независимо масштабировать стадии и выбирать для них разные конфигурации.
При простом переходе к 3P1D — трём экземплярам prefill и одному decode — автор получает ухудшение на 34% относительно предыдущего варианта с маршрутизацией.
Попадание в кеш остаётся неплохим, но появляются издержки передачи данных и самой распределённой системы.
Объём кеша, доступного на стороне prefill, уменьшается: его теперь держат три экземпляра вместо четырёх.
Возможность независимой оптимизации уже появилась, но ещё не использована. Следующие изменения направлены прежде всего на вычисление длинных контекстов в prefill.
Оригинальный кадр 17872 подтверждает 2,27 RPS (−34%) и cache hit 93,7% по запросам / 95,4% по длине для 3P1D. Это обязательный отрицательный результат эксперимента.
Слайд фиксирует 2,27 RPS (−34%) для трёх prefill-экземпляров и одного decode; cache hit — 93,7% по запросам и 95,4% по длине.
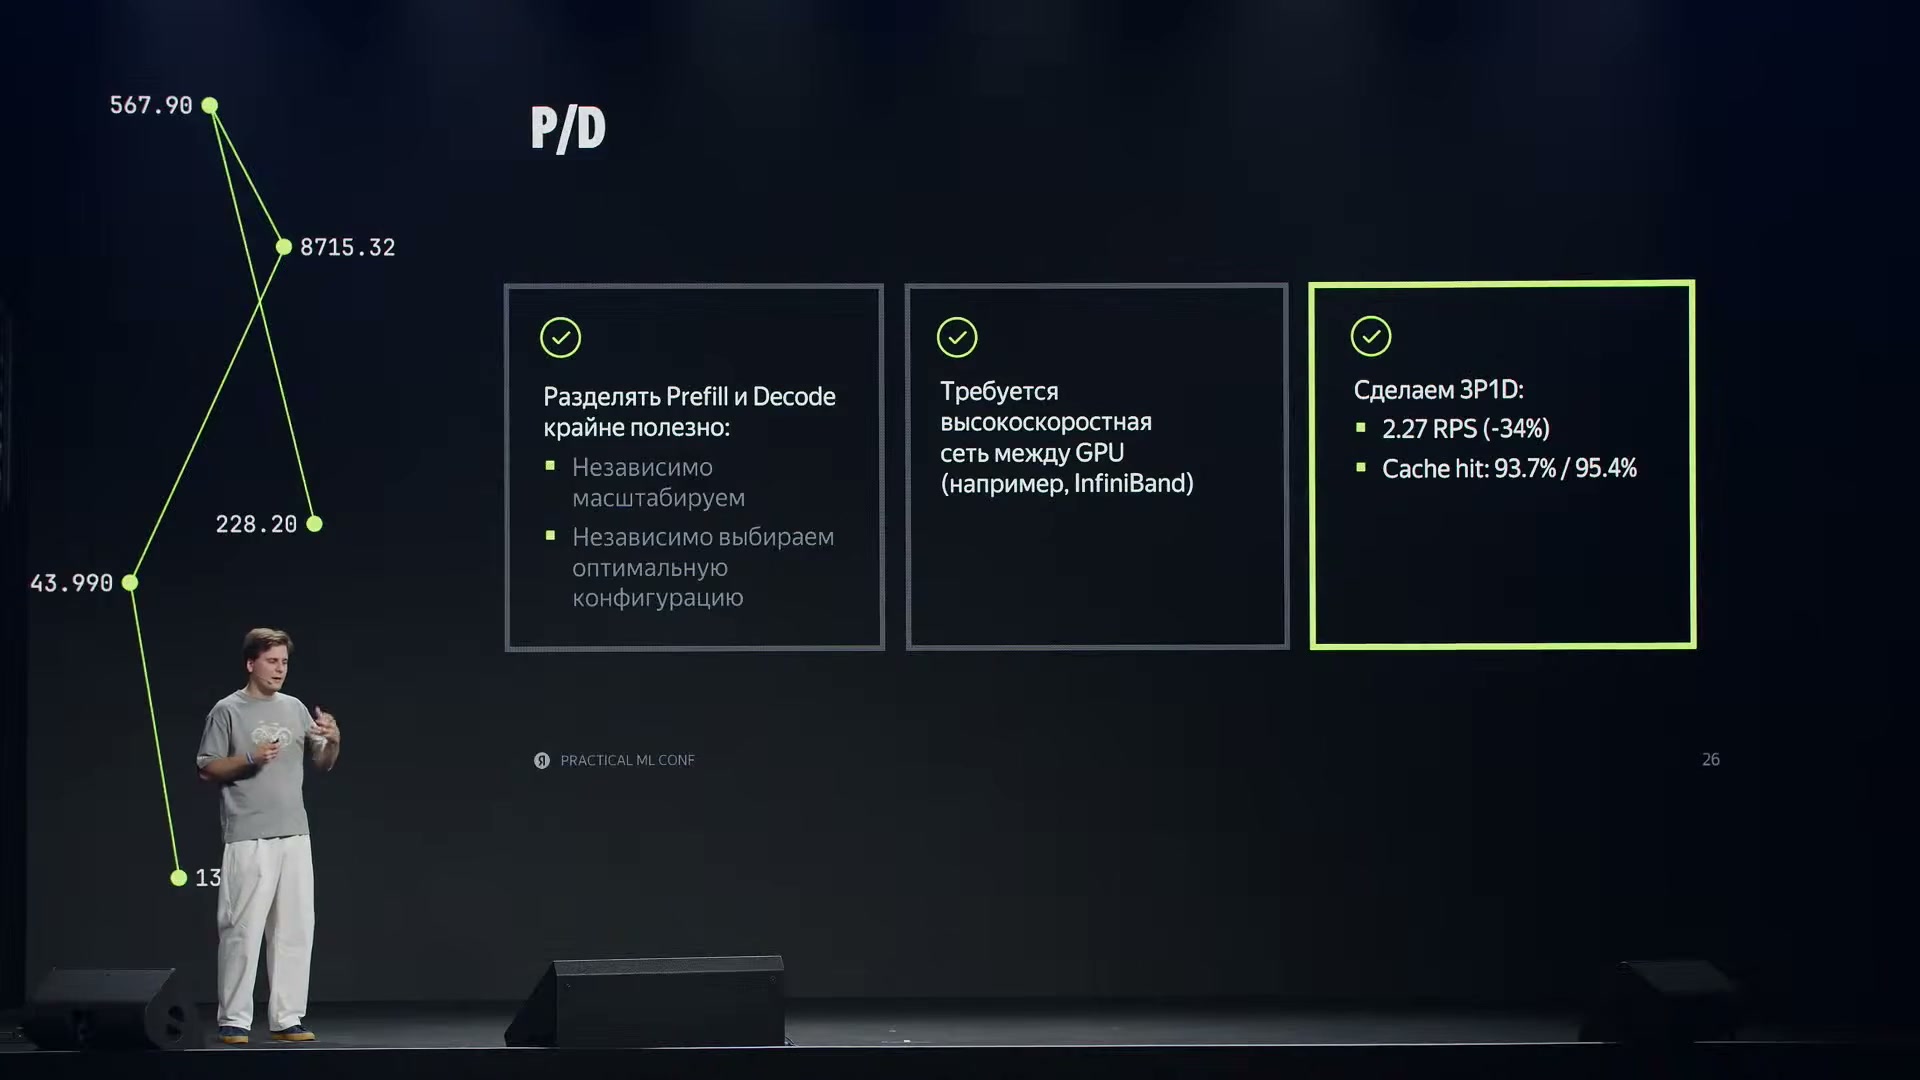
Разделение на три prefill-инстанса и один decode-инстанс ухудшило показанную пропускную способность на34%. Это неудачный вариант конкретного эксперимента, не вывод о любых P/D-системах.
Источник: Яндекс · исходный докладКак ZigZag балансирует длинный контекст
Контекстный параллелизм, Context Parallelism, распределяет обработку контекста между GPU; во время вычислений карты обмениваются необходимыми данными.
Наивный мысленный вариант — отдать каждой из четырёх GPU последовательную четверть контекста. Он повторяет прежнюю ошибку предположения об одинаковой стоимости разных позиций.
Начальная часть обрабатывается быстрее, последняя оказывается самой тяжёлой. Остальные карты простаивают, пока завершает работу GPU с концом контекста.
Стратегия ZigZag сочетает ранние и поздние части: автор иллюстрирует её первым и последним токенами на одной карте, вторым и предпоследним — на другой.
Так выравнивается суммарная сложность. Объяснение дано как мысленная модель распределения, а не точное описание размеров блоков в реализации SGLang.
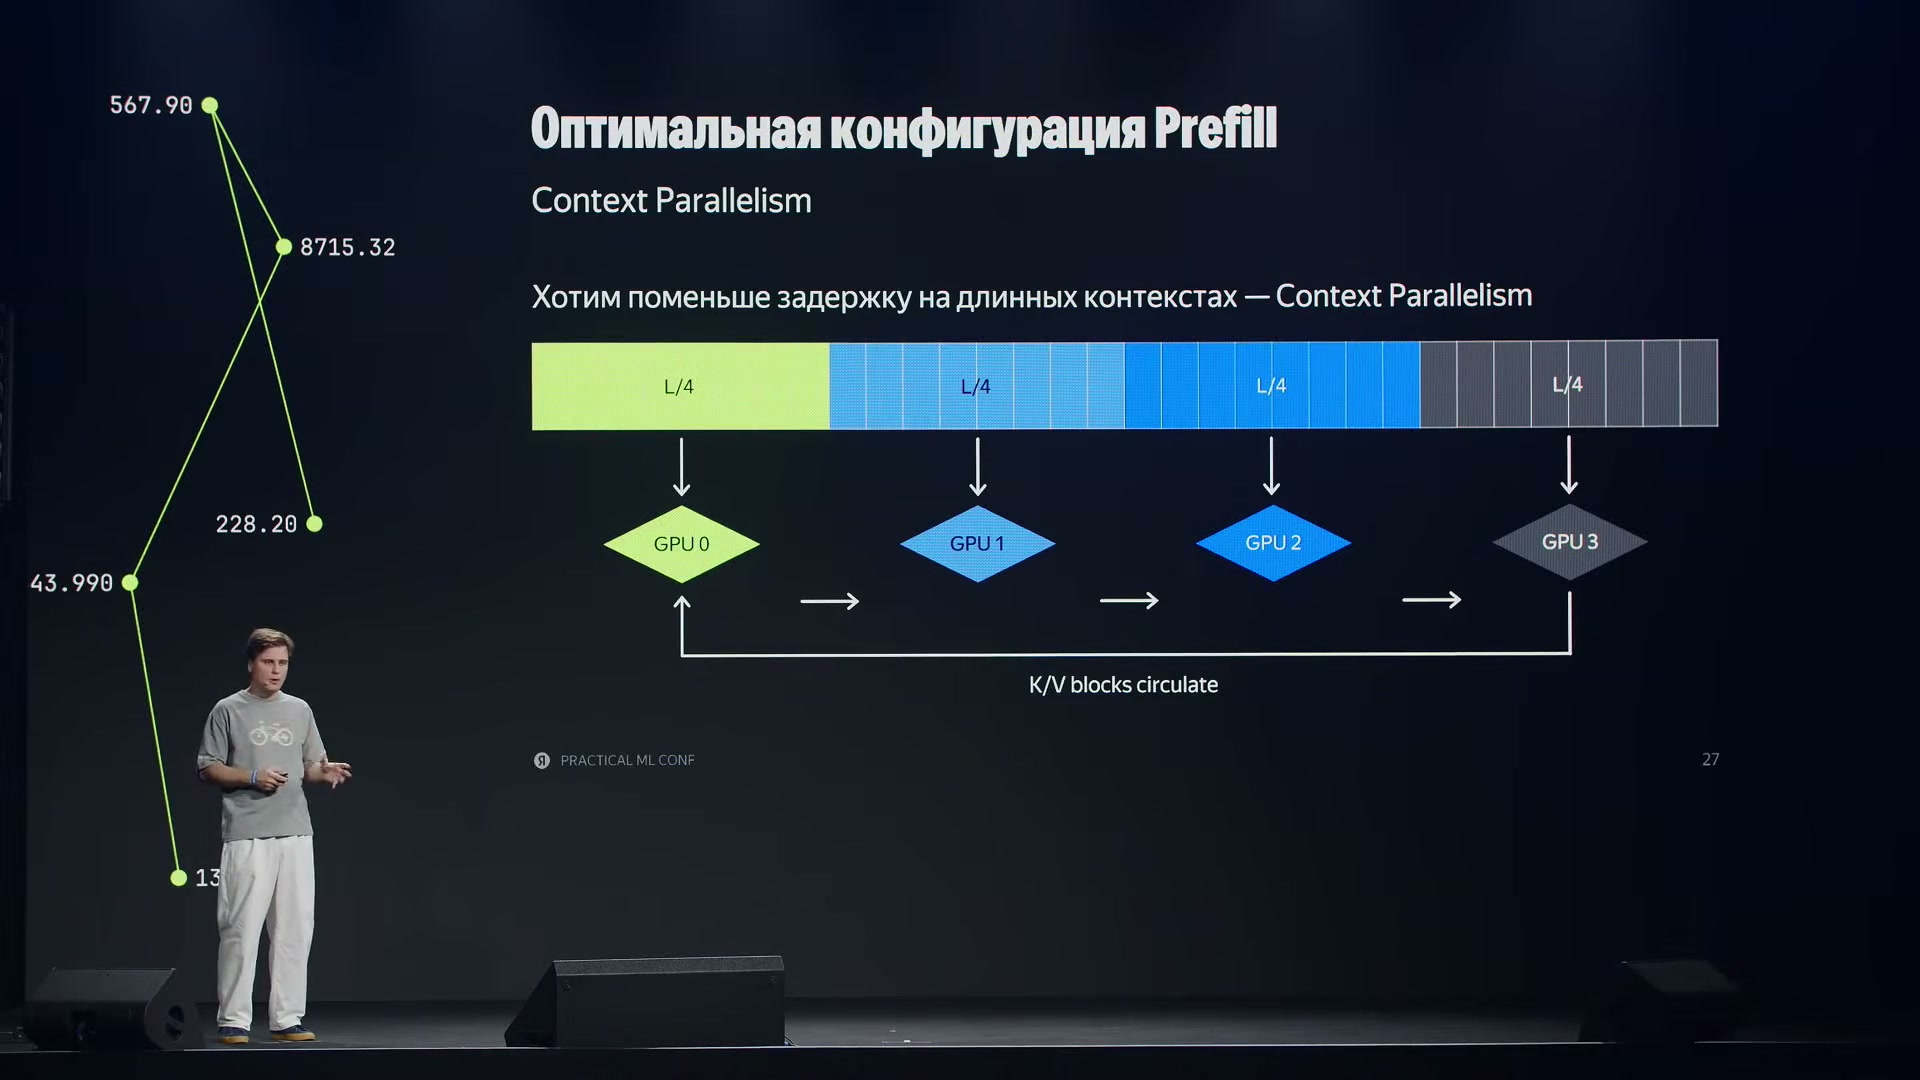
Context Parallelism распределяет обработку длинного контекста между GPU.
Источник: Яндекс · исходный доклад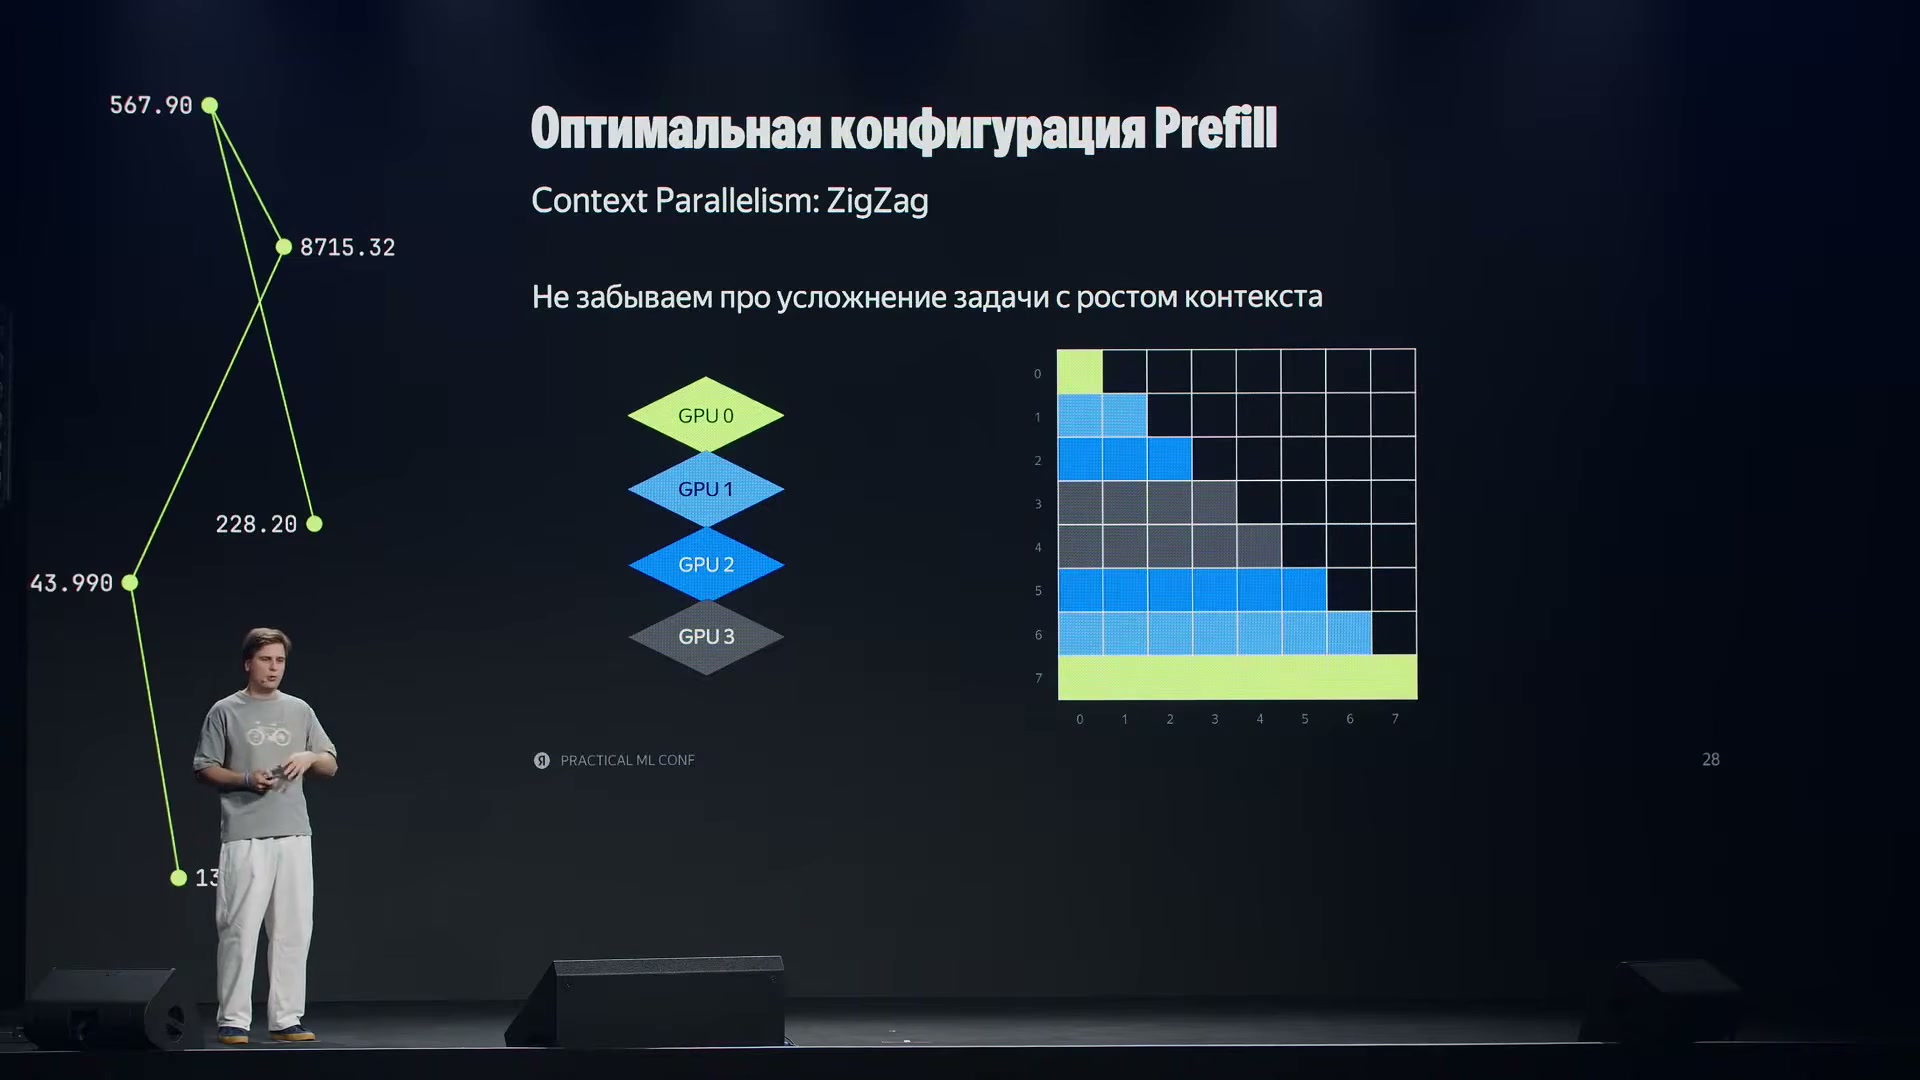
Распределение частей контекста по ZigZag уменьшает перекос работы между GPU.
Источник: Яндекс · исходный докладЦена контекстного параллелизма — память кеша
В описываемой реализации для алгоритма кеш реплицируется между участвующими процессами, или рангами. Простой вариант физически хранит одинаковые данные на разных рангах и синхронизирует их.
По наблюдению автора, после включения Context Parallelism доступная ёмкость кеша одного экземпляра уменьшается в n раз в зависимости от числа GPU.
Несмотря на эту цену, результат серии заметно улучшается и становится лучше совмещённого варианта с маршрутизацией. Сама маршрутизация сохраняется.
Автор сравнивает прежнее попадание в кеш выше 93% с примерно 91% после этого шага и видит запас для дальнейшего улучшения за счёт ёмкости кеша.
Сокращение кеша описывает данную реализацию, а не обязательное свойство всех вариантов Context Parallelism.
При четырёх рангах наблюдается именно четырёхкратное уменьшение GPU KV-cache при четырёх рангах. ZigZag балансирует вычислительную стоимость ранних и поздних участков, но сам по себе не устраняет репликацию кеша.
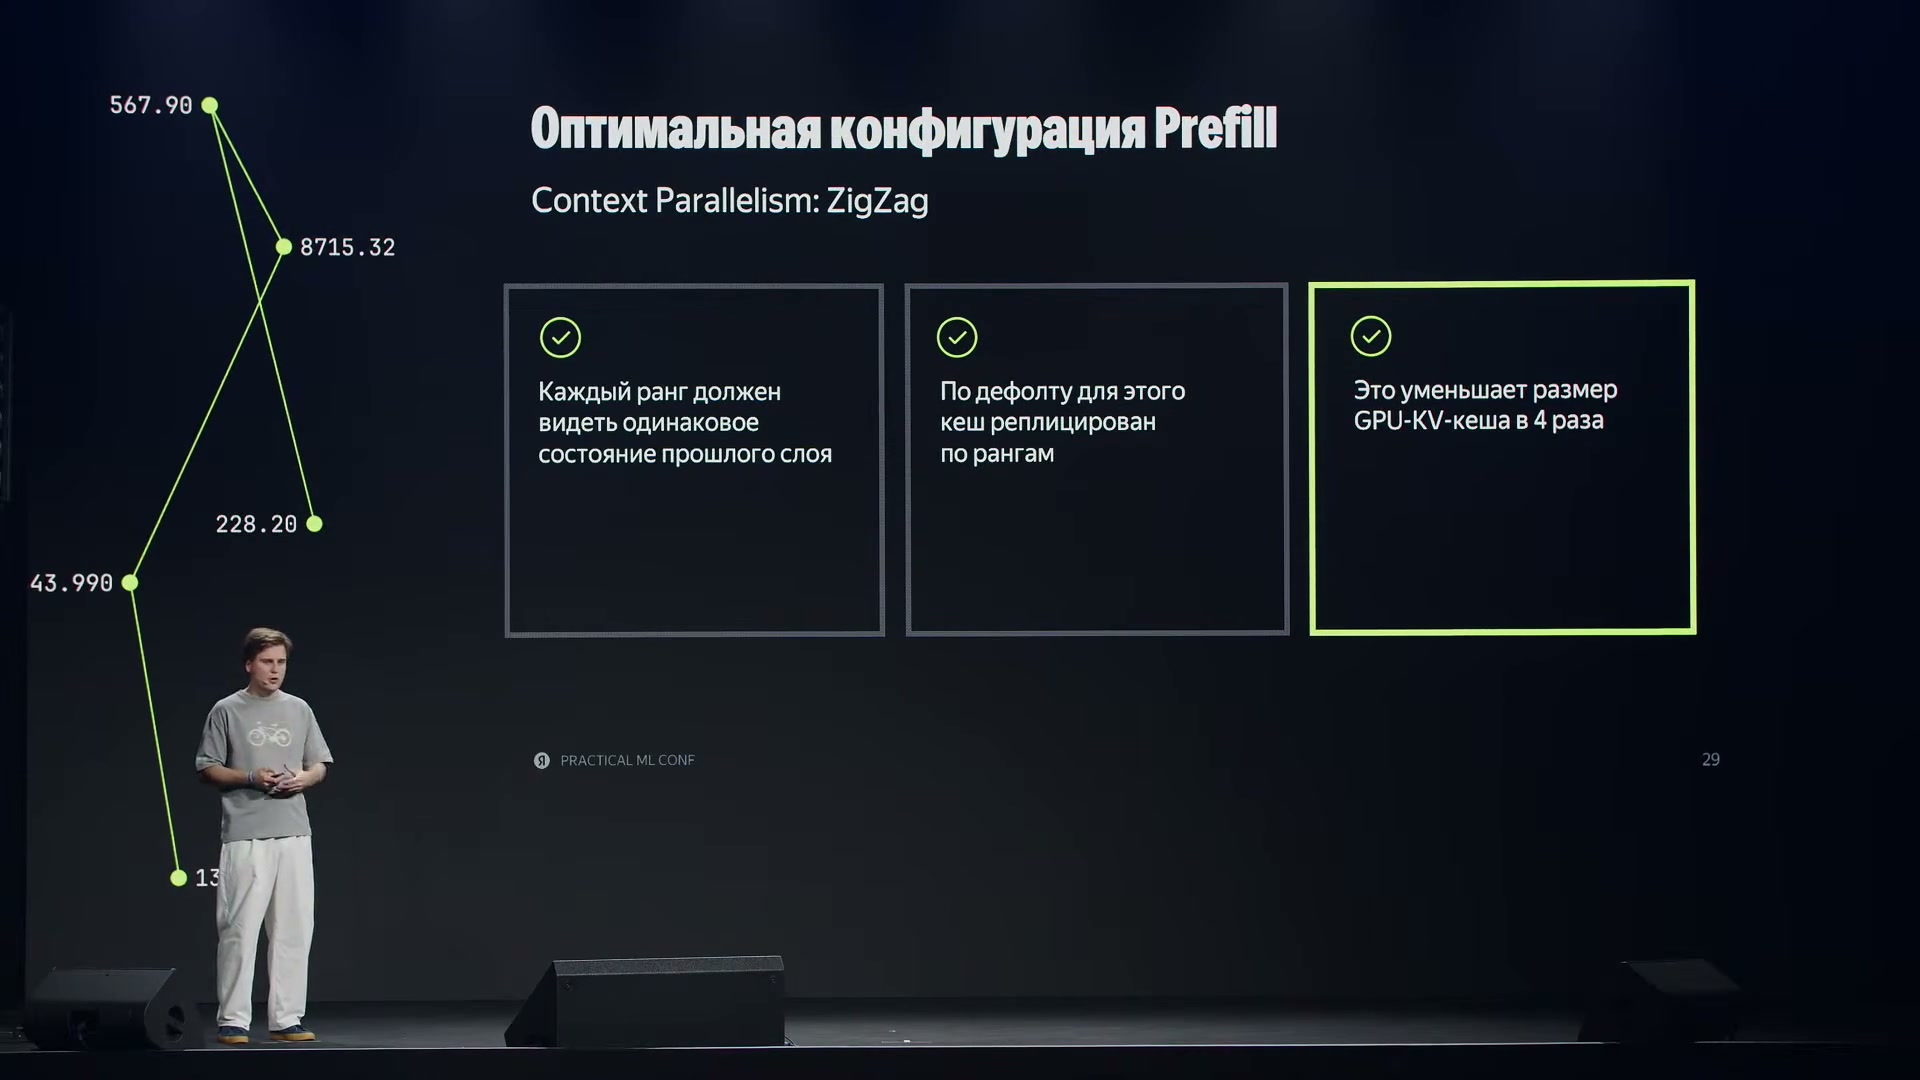
Результат выбранной конфигурации Context Parallelism: изменение размера GPU-кеша и пропускной способности.
Источник: Яндекс · исходный докладLayerSplit: распределение кеша по слоям
Вместо одинакового хранения всего KV-cache на каждом ранге данные распределяют по слоям между GPU и передают остальным тогда, когда соответствующий слой нужен вычислению.
Автор сообщает о потере примерно 3% вычислительной пропускной способности при увеличении доступной ёмкости KV-cache более чем втрое. Эти два числа характеризуют компромисс реализации, а не конечный RPS всей системы.
По словам автора, готовой открытой реализации для DeepSeek тогда не было. У модели несколько компонентов внимания: нужно отдельно решать, какие распределять и как перекрывать их передачи.
Команда реализовала вариант сама, затронув вычислительные ядра и движок, и отправила запрос на включение изменений в SGLang. Автор говорит, что это произошло в тот же день, что и аналогичное предложение для GLM; это не подтверждение включения в конкретный выпуск.
Добавление LayerSplit к предыдущей конфигурации серии даёт ещё около 100% по её показателю пропускной способности. Автор объясняет выигрыш улучшением попадания в кеш и уменьшением повторного prefill, несмотря на небольшое удорожание отдельных вычислений.
Схема показывает разделение слоёв между CP-0 и CP-1, Broadcast данных, Indexer и Sparse Attention; передачи стараются перекрыть вычислениями. Ускорение всей конфигурации обусловлено экономией повторного prefill, несмотря на небольшие издержки обмена.
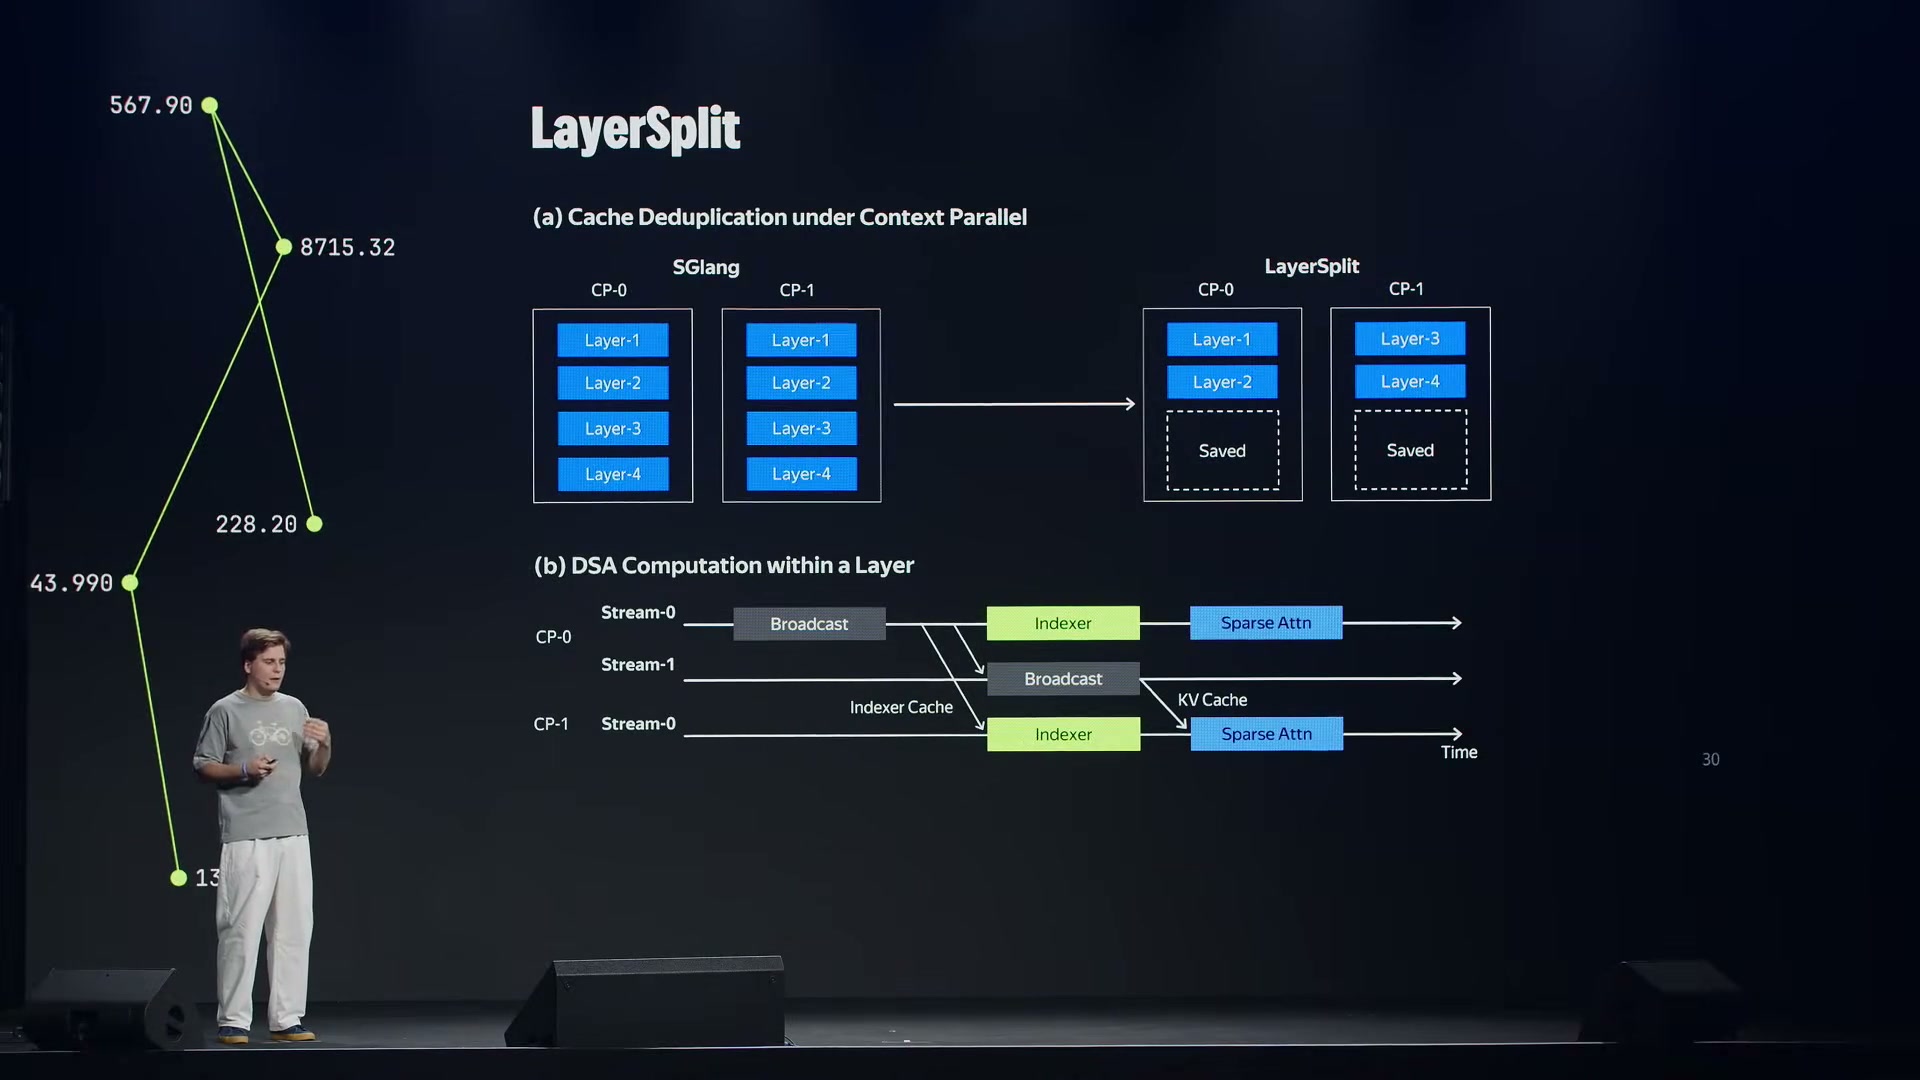
LayerSplit связывает распределение кеша по слоям с распределёнными вычислениями.
Источник: Яндекс · исходный докладОбщий L3 для пауз и перегруженных экземпляров
При паузе на десять минут или час локальный кеш может быть вытеснен, после чего возобновившаяся сессия требует повторной обработки длинного контекста.
До добавления общего уровня и GPU-кеш, и CPU-кеш принадлежат отдельному рабочему процессу. Между такими процессами нет обмена сохранённым контекстом.
Если экземпляр с нужным префиксом уже занят, маршрутизатор выбирает между увеличением очереди на нём и отправкой запроса на другой экземпляр с повторным prefill.
Общий третий уровень, L3, делает сохранённый KV-cache доступным разным экземплярам. Команда использует Mooncake.
В эксперименте добавляют только 1 ТБ оперативной памяти CPU: два экземпляра по 512 ГБ, без дополнительных GPU, и возможность общего доступа к кешу.
После уже выполненных оптимизаций прирост оказывается небольшим: автор описывает приближение к плато и высокое попадание в кеш. Итоговых чисел он здесь вслух не называет; затем переходит от конечной метрики к внутреннему расходу памяти.
После добавления 1 ТБ DRAM: 9,79 RPS (+7% к предыдущей конфигурации); cache hit 94,4% по запросам и 95,4% по длине. GPU не добавляли.
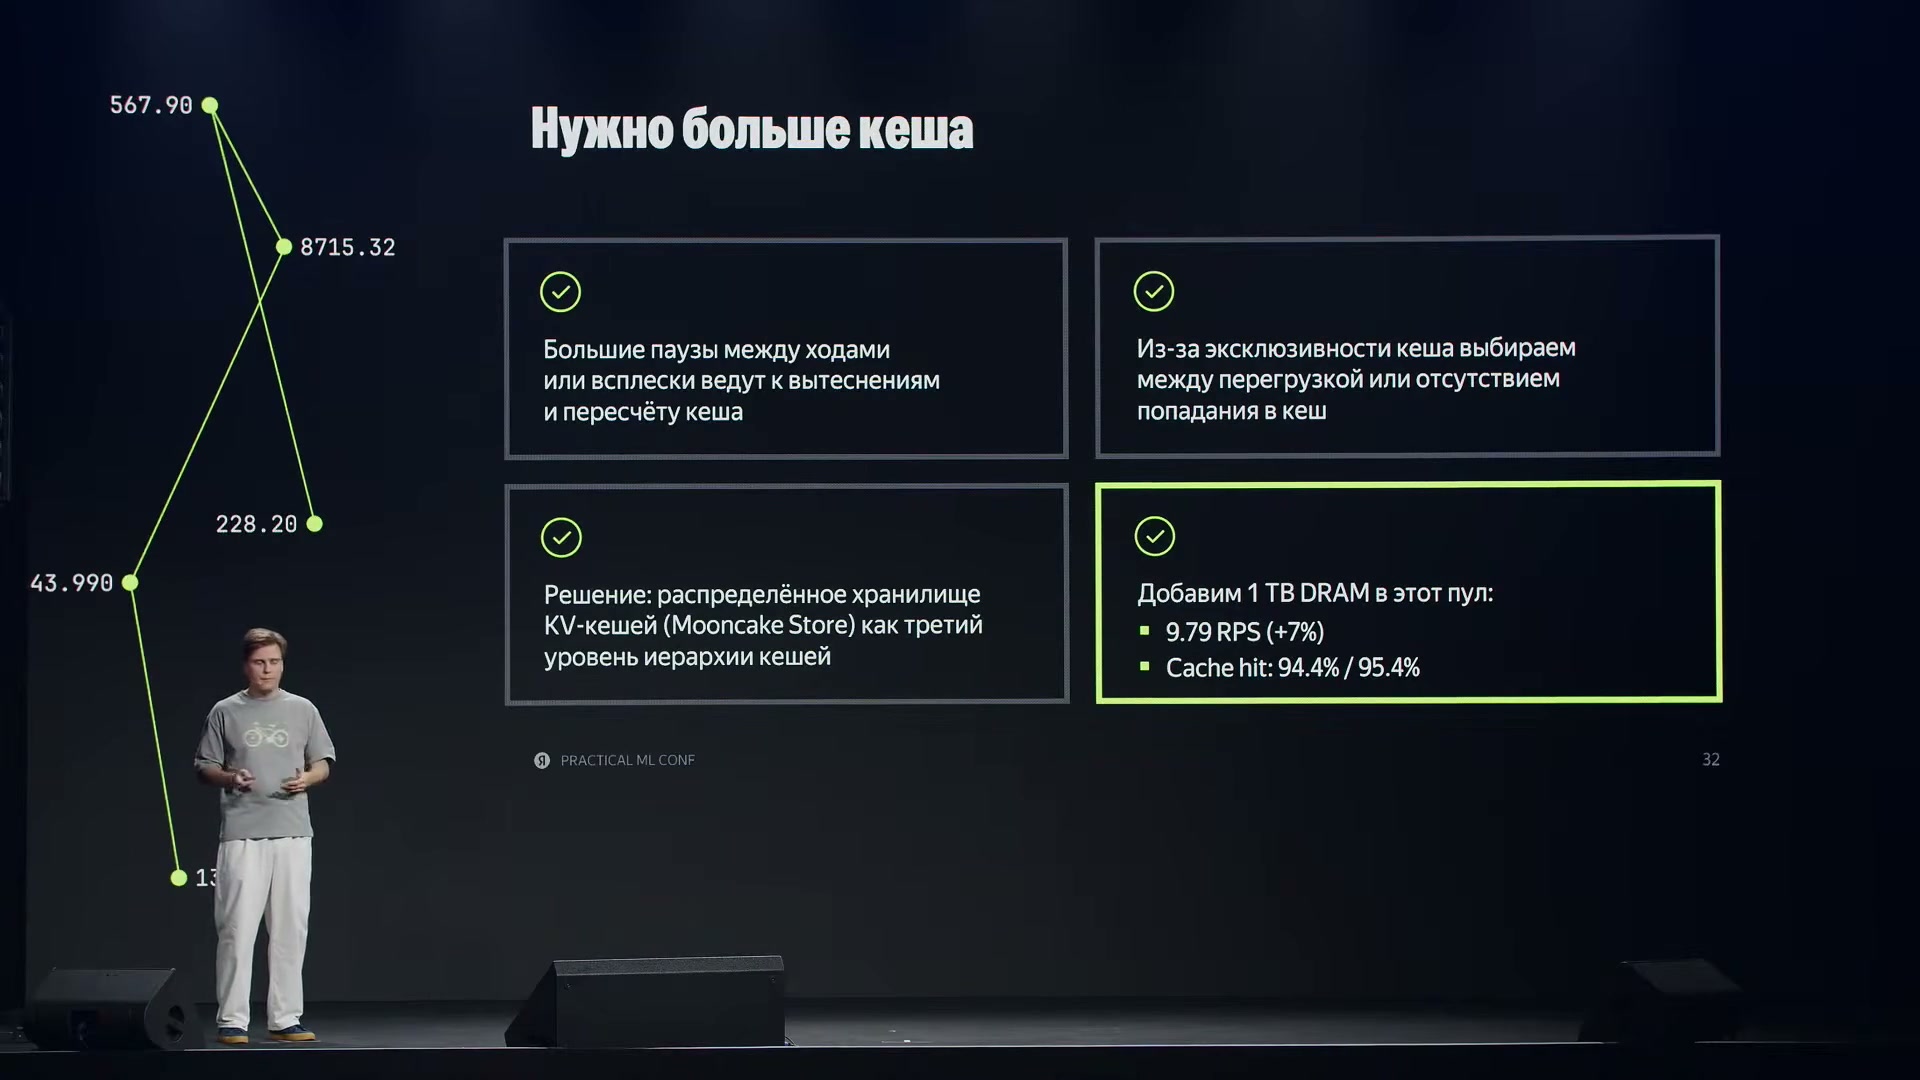
Третий уровень KV-кеша использует дополнительную DRAM. Выбор объёма связан с паузами между шагами агента.
Источник: Яндекс · исходный докладПочему SWA раздувает распределённый кеш
Для миллиона токенов автор наблюдает около 18 ГБ в L3 на основной ветке SGLang на момент доклада, тогда как калькулятор KV-cache с параметрами DeepSeek V4 Flash показывает примерно 3 ГБ.
При разборе записей около 80% объёма приходится на кеш внимания со скользящим окном, SWA. Автор противопоставляет его несжатое хранение уже сжатым представлениям других компонентов внимания модели.
В техническом отчёте DeepSeek автор нашёл сравнение стратегий хранения SWA в распределённом хранилище. Команда уже применила в рабочей системе вариант с периодическими контрольными сохранениями.
SWA сохраняют не для каждой позиции, а через определённый интервал; повторно используемая длина контекста в L3 округляется к сохранённым границам. Это компромисс между ёмкостью и полнотой повторного использования, а не округление процента запросов.
После изменения автор называет 4–5 ГБ вместо 18 ГБ на тот же миллион токенов. Сокращение относится к хранению KV-cache в L3, а не к памяти весов модели или всей установки.
Доклад · 05:05:13Что изменилось после L3 в рабочей системе
В момент включения L3 в рабочей системе уже был Context Parallelism, но ещё не было LayerSplit; при первом сравнении остальная система не менялась.
По словам автора, суммарный за день cache hit вырос с 55% до 80% после добавления L3. Затем отдельным следующим изменением LayerSplit поднял его с 80% до 90%.
Это иной порядок внедрения, чем в демонстрационной серии, где L3 добавляли после LayerSplit. Две последовательности и их базы сравнения нельзя объединять.
Автор предположительно связывает дополнительное улучшение с округлениями при хранении SWA. Слово «скорее всего» сохраняет статус объяснения, а не доказанной единственной причины.
Кеш дольше переживает паузы между шагами: после возвращения пользователя удаётся избежать части повторного prefill. Автор описывает это как более быструю и дешёвую обработку, без денежной оценки или измерения выручки.
На графике измеряется Cached-токены, % — доля от input-токенов. На графике показаны дневные значения июня 2026 года и рост примерно от 55% к 80% после L3. Затем автор отдельно сообщает рост до 90% после LayerSplit. Это показатели по длине входа, а не доля запросов с попаданием.
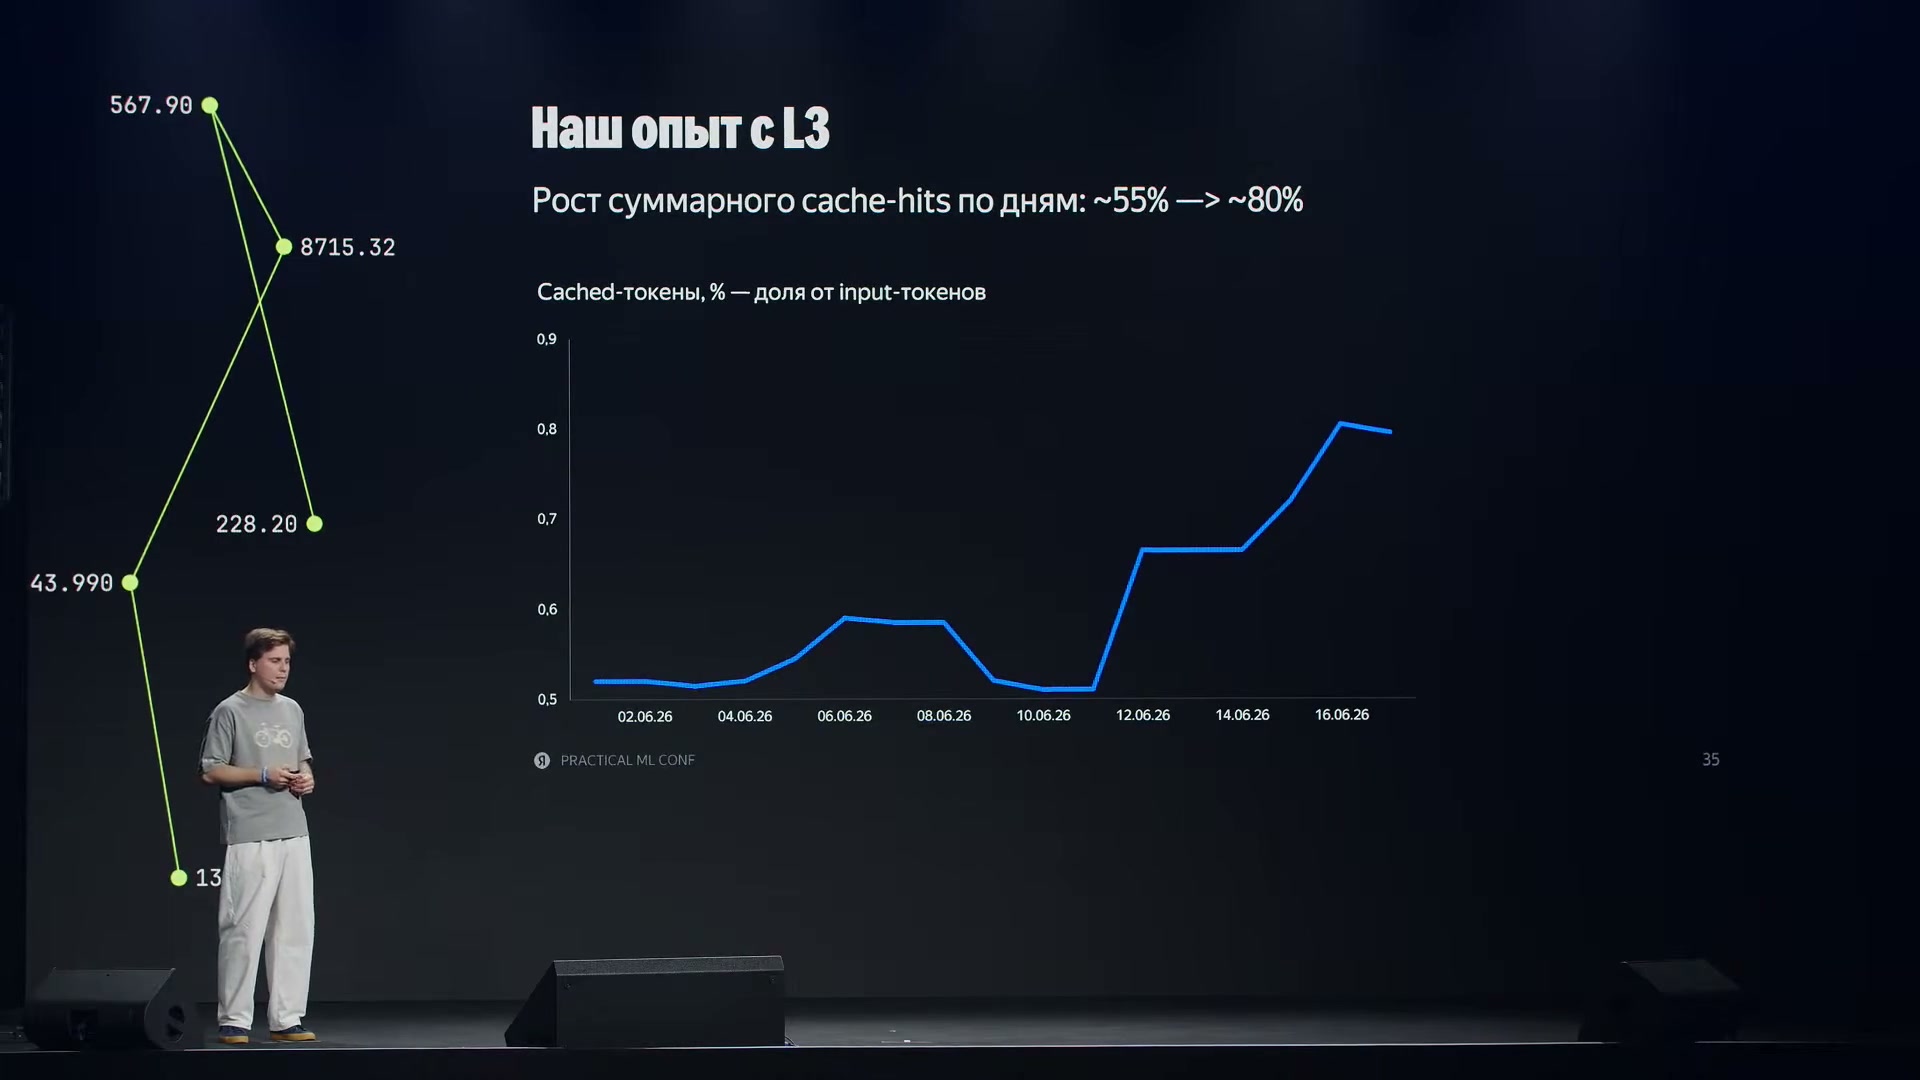
Накопление данных в L3-кеше меняет суммарный cache hit; на графике показан отдельный показатель по длине.
Источник: Яндекс · исходный докладПрактические выводы о цене гарантий
Требование к задержке нужно обсуждать с продуктом до расчёта ресурсов: по предупреждению автора, гарантия может потребовать втрое больше оборудования, чем ожидается. Её можно пересмотреть либо осознанно принять эту цену.
Реальные всплески следует включать в оценку ресурсов, а агентные сессии — в методику измерений. Пуассоновский тест не заменяет проверку рабочего потока.
Маршрутизация требует прежде всего программных изменений; разделение стадий — быстрой сети; LayerSplit — работы с движком и вычислительными ядрами; L3 — дополнительной оперативной памяти и обмена кешем.
Все результаты относятся к выбранной модели, GPU, конфигурациям и нагрузке. Отрицательный результат простого разделения стадий столь же важен для карты оптимизаций, как положительные результаты кеширования.
В заключении автор подчёркивает четыре вывода: пересматривать стоимость строгих гарантий, учитывать всплески в рабочем потоке, воспроизводить агентные паттерны в бенчмарках и подбирать оптимизации под реальную нагрузку.
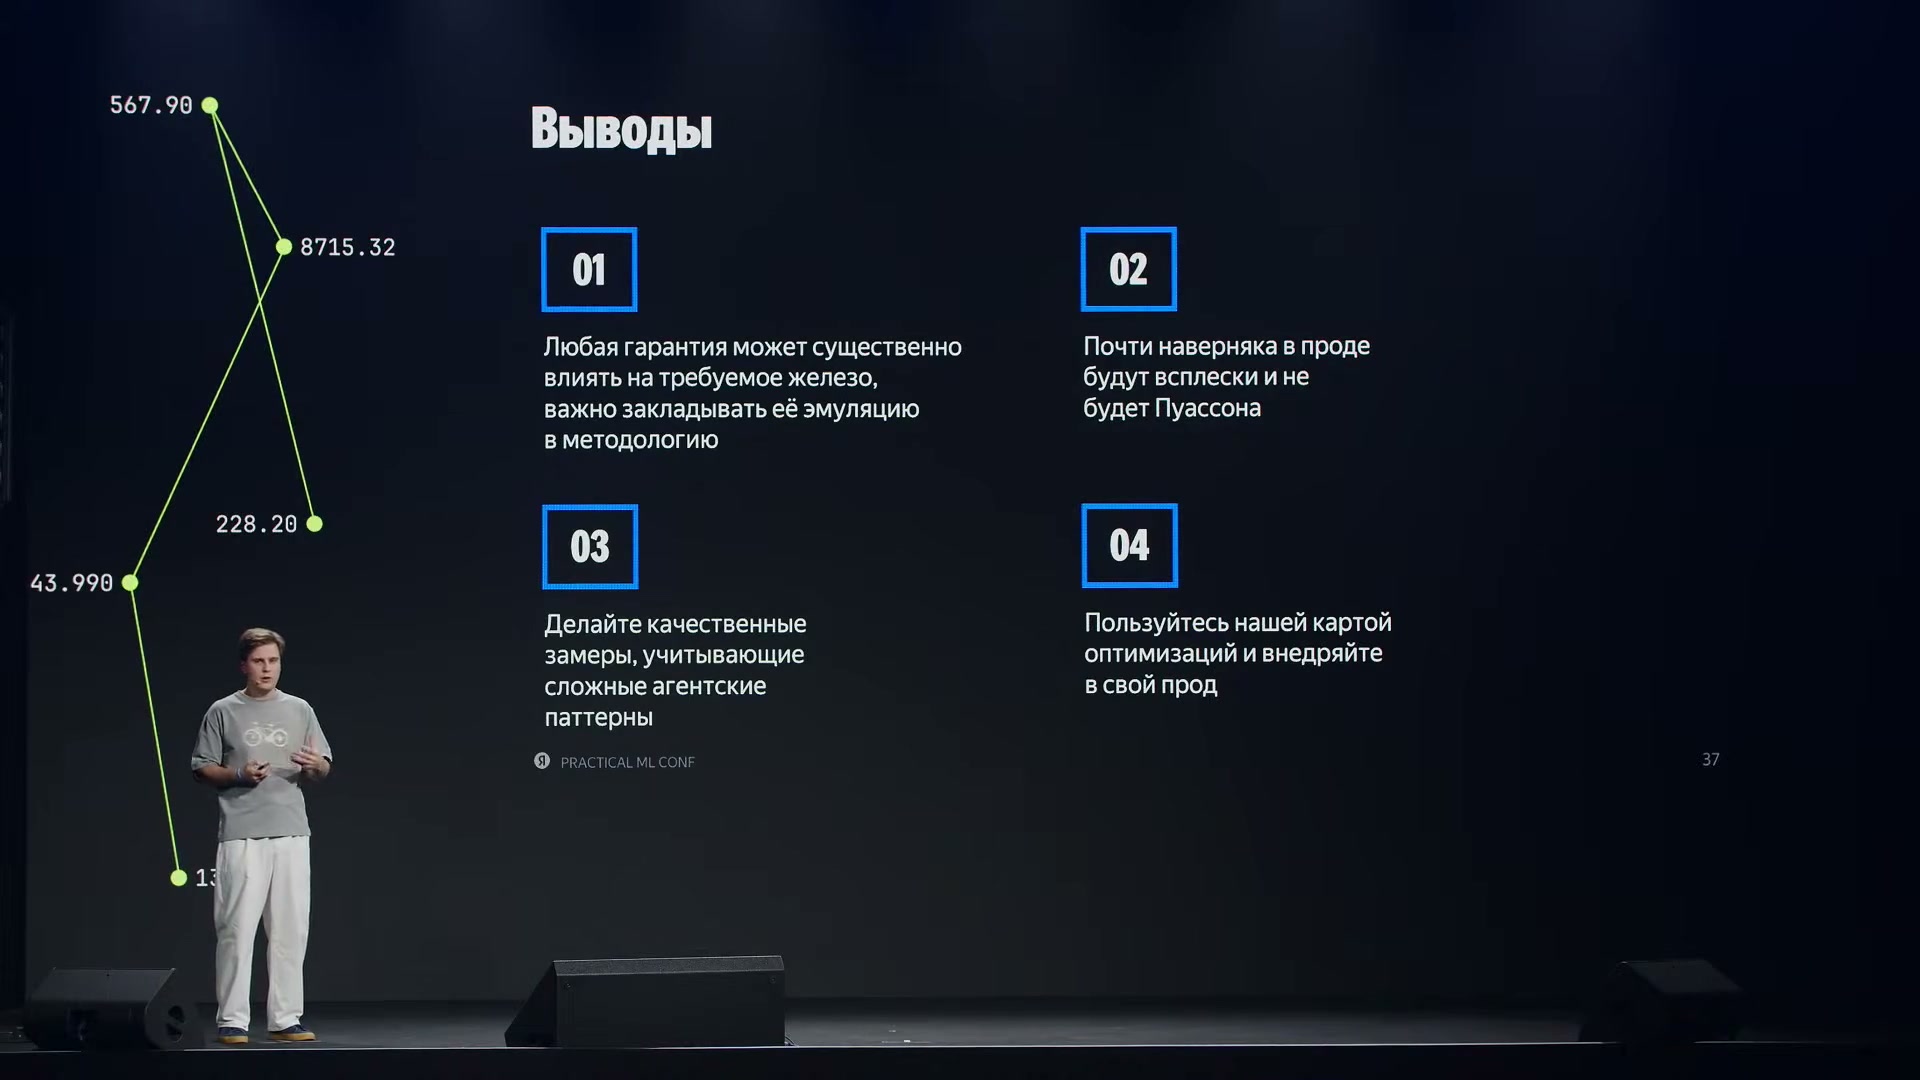
Выводы доклада: оценивать ресурсы, учитывать неравномерный трафик и применять подходящие виды кеширования.
Источник: Яндекс · исходный докладПочему команда выбрала SGLang
Для DeepSeek команда использует SGLang, но в целом старается выбирать движок под модель, а не придерживаться одного инструмента безусловно.
По опыту автора, для больших моделей и распределённых сценариев выбор чаще оказывается в пользу SGLang: его результаты в замерах команды лучше.
В качестве архитектурной причины автор выделяет встроенную в движок иерархию кешей и разделение prefill/decode.
Это объяснение выбора команды на дату доклада, а не независимое сравнение всех моделей, версий и режимов работы.
Доклад · 05:08:49Как измерили расход SWA
На вопрос о профилировании SWA автор отвечает, что достаточно проследить записи в L3.
Для каждой записи выводят компонент и число байт, затем суммируют объёмы по компонентам.
Это разовая диагностика внутреннего расхода памяти, а не описанный постоянный процесс мониторинга или обязательный специальный профилировщик.
Доклад · 05:09:43Итог: обработка агентной сессии и границы результата
Агентная сессия многократно использует длинный контекст. Экономия возникает, когда сохраняются результаты предыдущих шагов. Поэтому маршрутизация должна учитывать местоположение и ёмкость кеша, а также паузы между запросами.
- 01
Продолжение сессии
Агент формирует очередной запрос с историей прежних шагов и новым фрагментом контекста. Между вызовами он может выполнять инструменты или ждать пользователя.
- 02
Выбор рабочего процесса
NVIDIA Dynamo Router учитывает локальность KV-cache. Для decode команда дополнительно балансирует суммарную длину контекстов текущих запросов, чтобы не исчерпать память.
- 03
Повторное использование кеша
Система использует сохранённый префикс в локальном кеше, а общий L3 на Mooncake помогает получить данные после пауз или на другом экземпляре.
- 04
Обработка нового входа
Prefill вычисляет недостающий хвост. Контекстный параллелизм ZigZag распределяет сложность между GPU, а LayerSplit сокращает дублирование кеша по рангам.
- 05
Генерация ответа
Decode последовательно создаёт новые токены, используя KV-cache. Результат возвращается агенту, который может выполнить следующий инструмент и вновь обратиться к модели.
Оценка ресурсов и нагрузочное тестирование выполняются отдельно от этого пути. Для 10 RPS и P99 TTFT не более пяти секунд расчёт последовательно вырос с 36 до 40 и 56 GPU; учёт всплесков добавил ещё около 50%. В отдельном эксперименте на 16 GPU использовался более мягкий P95. Простое разделение 3P1D ухудшило пропускную способность до 2,27 RPS, зато последующие оптимизации кеша и вычислений позволили повысить её; добавление 1 ТБ DRAM дало 9,79 RPS.
В рабочей системе L3 поднял долю повторно используемых входных токенов примерно с 55% до 80%, затем LayerSplit — до 90%. Результаты относятся к DeepSeek V4 Flash, конкретным GPU, SLO и агентным трассам. Вывод — моделировать всплески, сохранять кеш и проверять изменения на сессиях: даже перспективная оптимизация способна ухудшить результат.
Выводы доклада: оценивать ресурсы, учитывать неравномерный трафик и применять подходящие виды кеширования.
Источник: Яндекс · исходный доклад