Разбор готов
Huawei: как DFlash и DSpark превращают блочную генерацию в ускорение vLLM
Когда движок vLLM обслуживает запросы к языковой модели, скорость ответа зависит не только от размера нейросети. Важно, сколько полезного текста удаётся получить за каждый её запуск и сколько времени уходит на подготовку вычислений. Команда Huawei работала над способом ускорить генерацию: небольшая вспомогательная модель предлагает несколько токенов — единиц, из которых складывается текст, — а основная модель проверяет их вместе. DFlash и DSpark делают такие предложения блоками, но преимущество этой архитектуры легко потерять на проверке кандидатов, размещении памяти и ожидании между процессорами. Разберём путь от устройства этих моделей и сравнительных измерений до конкретных изменений в vLLM: динамического выбора длины, подготовки кеша, асинхронного исполнения и управления графами вычислений.
Материал полезен ML-инженерам, которые ускоряют применение языковых моделей или хотят разобраться, что происходит внутри движка генерации. На примере Huawei видно, как связаны качество вспомогательной модели, размер пакета запросов и реальная стоимость исполнения — и почему удачный локальный эксперимент ещё не означает принятую доработку библиотеки.
Видео · на русском
Диффузионный драфтинг в спекулятивном декодинге: DFlash и DSpark — от модели до вывода в продакшнСтанислав Илюшин · Опубликовано: 19 сентября 2026 г.
Исходный доклад · Открыть оригинал
Какую часть системы меняла команда
Основа главы — доклад Станислава Илюшина из Huawei «Диффузионный драфтинг в спекулятивном декодинге: DFlash и DSpark — от модели до вывода в продакшн» на конференции Яндекса Practical ML Conf 2026. В нём обсуждаются архитектуры драфтеров, измерения скорости, интеграция в vLLM и ограничения, которые проявились при этой работе.
Инженерный продукт в этой истории — движок применения языковых моделей. Команда работает с vLLM и направлением для Ascend, ускорителей Huawei. В рассказе различаются GPU-направление, ориентированное на графические процессоры, и NPU-направление для специализированных нейросетевых ускорителей. Разработчики взаимодействуют с участниками проекта из NVIDIA и Red Hat, а основные ветки синхронизируют два-три раза в месяц.
Поэтому задача шире, чем запуск одной модели на одном устройстве. Поддержку нового драфтера нужно согласовать с общей организацией памяти и выполнения запросов. Автор отдельно обозначает вклад команды: она реализовывала поддержку моделей и динамическую проверку в движке, а не была автором исходных исследовательских статей. Рассказ относится к vLLM и Ascend; реализацию аналогичных возможностей в SGLang команда в этом докладе не разбирает.
Доклад · 02:15:48Считать нужно стоимость полезного токена
Обычная языковая модель генерирует продолжение последовательно: следующий токен зависит от уже полученного текста. Такой способ называют авторегрессионным. В режиме, с которого начинает докладчик, вычислительные мощности ускорителя используются не полностью: значительная часть работы связана с чтением весов модели и сохранённого контекста из памяти.
Часть контекста хранится в кеше ключей и значений внимания — KV-cache. Механизм внимания связывает обрабатываемую позицию с доступными ей частями текста, а кеш сохраняет ранее вычисленные представления. При последовательной генерации очередной дорогой проход основной модели приносит только один новый токен.
Спекулятивный декодинг предлагает изменить это соотношение. Небольшая вспомогательная модель, или драфтер, заранее предлагает несколько кандидатов. Основная, или целевая, модель проверяет их совместно и определяет, какое начало предложенного продолжения можно принять. Такое начало последовательности называется префиксом. Один проход основной модели теперь может дать несколько полезных токенов.
В историческом отступлении автор вспоминает ранние попытки блочного декодинга в 2018 году: распространению подхода тогда мешало качество. Следующий поворот он связывает с работой Google примерно четырьмя годами позже и поддержкой температурного семплирования — выбора токенов из распределения с параметром, меняющим его концентрацию. После этого появились многочисленные варианты драфтеров, включая Medusa и семейство EAGLE. Дальнейший вопрос состоял уже не просто в том, как предложить больше токенов, а в том, какой способ предсказания лучше работает на ограниченном окне продолжения.
Для ответа на этот вопрос в докладе используется TPOT — время на один полезный выходной токен. Под стоимостью здесь понимается время вычисления, а не денежная цена оборудования. Обозначим размер пакета одновременно обрабатываемых запросов через b, а число рассматриваемых кандидатов через k. D(b, k) — время работы драфтера, V(b, k) — время проверки основной моделью. Ожидаемое число полезных токенов за шаг проверки обозначено G(k).
Формула со слайда: TPOT = [D(b, k) + V(b, k)] / G(k), где G(k) = 1 + Σᵢ₌₁ᵏ pᵢ. Здесь pᵢ — вероятность принятия кандидата на позиции i. Единица учитывает дополнительный, или бонусный, токен основной модели. Таким образом, знаменатель включает не только принимаемые предложения драфтера, но и этот дополнительный выход. Если времена D и V выражены в миллисекундах, результат получается в миллисекундах на токен.
Среднюю длину принятого продолжения называют acceptance length. От неё отличается per-position acceptance — принятие на отдельных позициях блока. Две модели могут иметь одинаковую среднюю длину, но разную стоимость генерации и проверки. Они также могут по-разному распределять полезность между первыми и последними позициями. Поэтому ни скорость самого драфтера, ни одна средняя метрика принятия по отдельности ещё не объясняют итоговый TPOT.
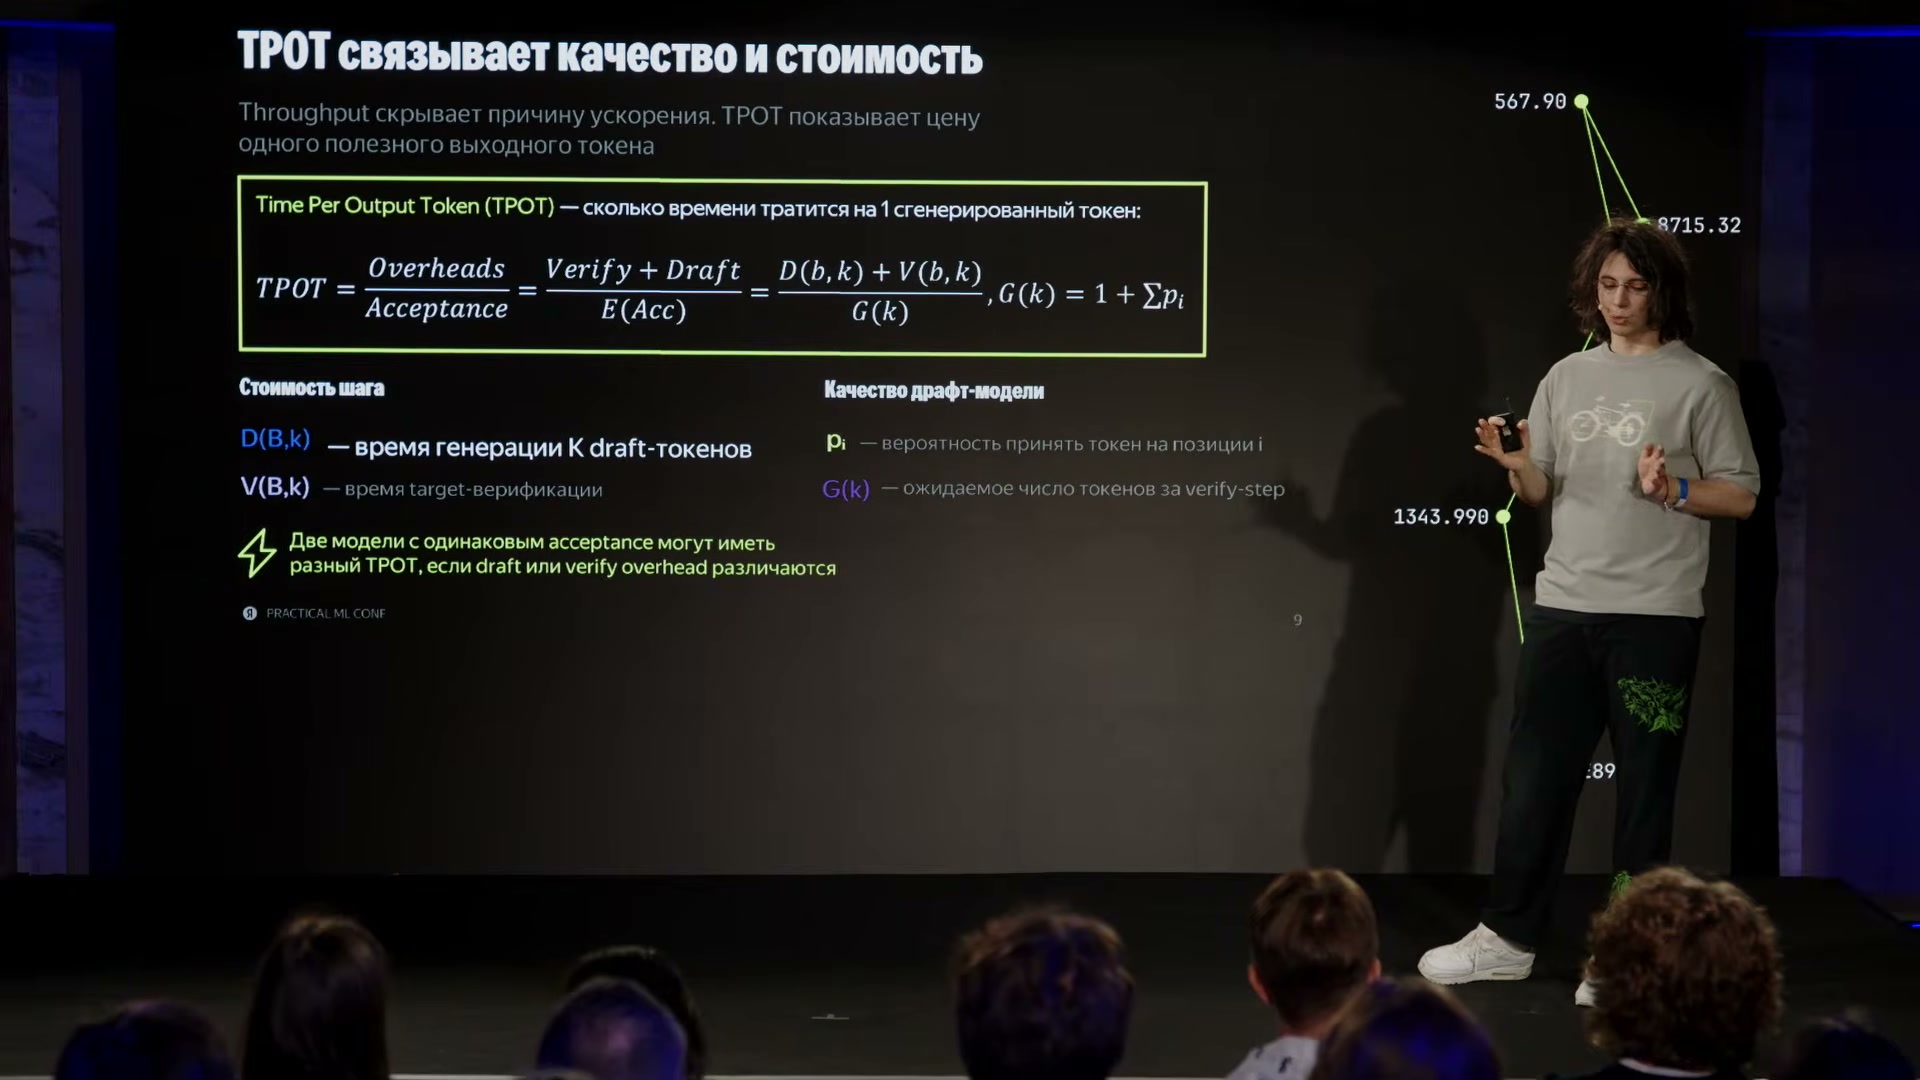
TPOT связывает время драфтинга и проверки с ожидаемым полезным выходом. В G(k) входит дополнительный токен основной модели.
Источник: Станислав ИлюшинОт последовательных шагов к совместной обработке блока
Обсуждаемые в докладе EAGLE 3 и MTP, то есть предсказание нескольких следующих токенов, построены вокруг последовательного применения драфтера. Слой внимания используется повторно, а внутренние векторные представления — скрытые состояния — передаются между шагами. Чтобы предложить K кандидатов, такая схема выполняет K последовательных шагов.
По наблюдению автора, многие доступные EAGLE обучались на три шага вперёд, значительно реже — на семь. Увеличение разрешённого числа кандидатов само по себе не расширяет освоенный моделью горизонт. Если предложить модели, обученной на короткое продолжение, генерировать более длинный блок, качество дальних позиций может заметно снизиться. Число разрешённых кандидатов в докладе называется бюджетом драфтинга.
DFlash получает несколько позиций совместно за один проход модели. На входе есть известный опорный токен и маски — служебные позиции, которые предстоит заполнить. Внутри блока используется двунаправленное внимание: представления позиций могут взаимодействовать между собой, а не только с предшествующими позициями. Контекст основной модели передаётся через ключи и значения внимания; на слайде этот способ обозначен как KV-injection. Для DFlash показан один параллельный диффузионный шаг.
DSpark сохраняет параллельный блок, но добавляет последовательное уточнение предсказаний. В устном объяснении это однослойная рекуррентная сеть, RNN, которая передаёт состояние между соседними позициями. Её задача — улучшить согласованность кандидатов и профиль принятия. Кроме того, у DSpark есть отдельный выходной модуль оценки уверенности, confidence head. Позже эта оценка используется для управления бюджетом проверки.
DFlash2 переносит локальную обработку зависимостей внутрь модели с помощью свёрточных блоков. Свёртка смешивает информацию соседних позиций; на слайде это называется local CNN mixing. Мотивация — сохранить пользу совместного уточнения с меньшими затратами на последовательную часть. Так различие внутри семейства оказывается не в самом факте блочной генерации, а в том, как восстанавливаются зависимости между одновременно предсказываемыми позициями.
Поэтому выражение «весь блок за один проход» описывает важное преимущество, но не делает внутреннюю работу всех трёх моделей одинаковой. У DFlash основной механизм — совместное внимание, у DSpark к нему добавляется последовательное уточнение, у DFlash2 — локальное свёрточное смешивание. Эти части по-разному влияют и на принятие кандидатов, и на время самого драфтера.
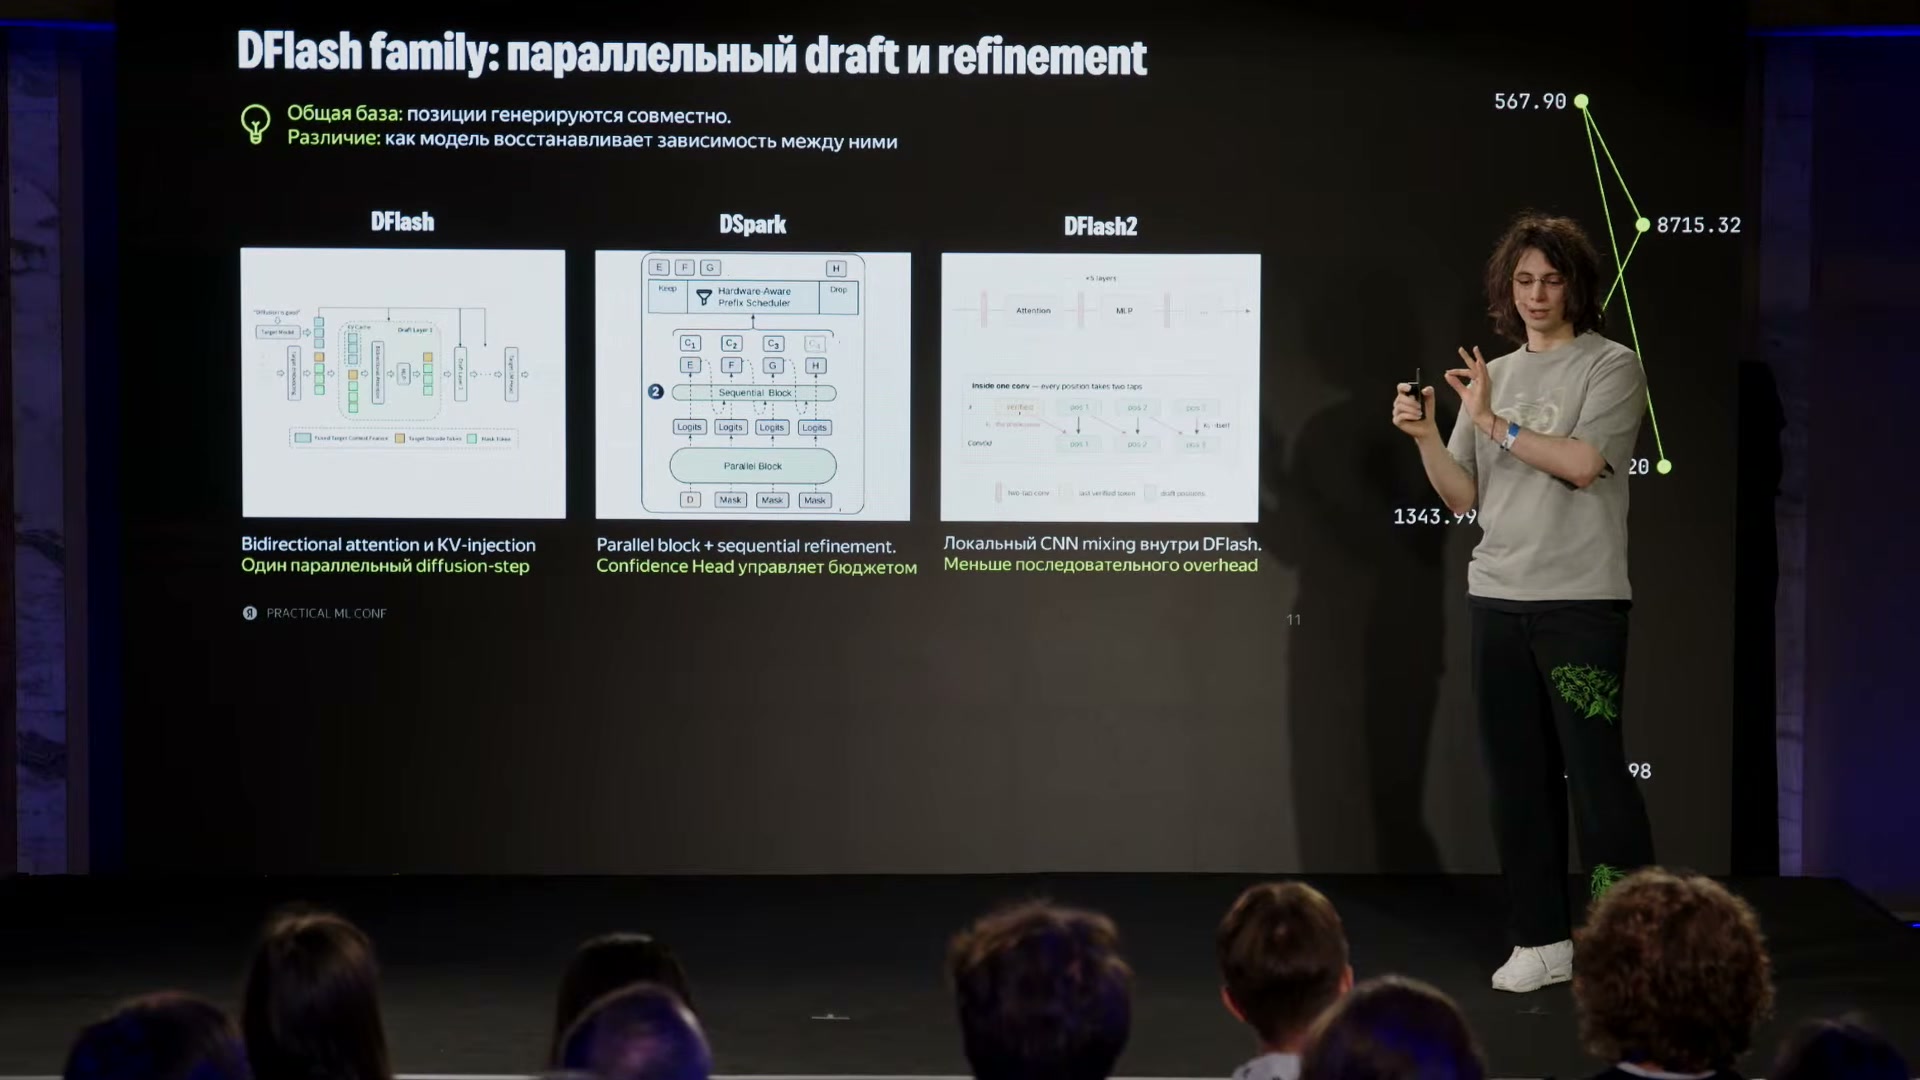
DFlash, DSpark и DFlash2 совместно обрабатывают позиции, но по-разному уточняют зависимости: внимание, последовательный блок и локальное свёрточное смешивание.
Источник: Станислав ИлюшинЧто показывают принятие по позициям и средняя длина
Прежде чем сравнивать архитектуры, команде пришлось выбрать конкретные обученные версии. Автор проверил около десяти открытых EAGLE и обнаружил, что популярность по скачиваниям и отметкам пользователей плохо помогала найти сильный вариант. В его проверке наиболее удачным оказался сравнительно малоизвестный драфтер. Это существенная часть условий: результат относится к выбранным весам, а не только к названию семейства.
На графике принятия по позициям EAGLE-3 начинает примерно с 70%, ко второй позиции опускается примерно к 60%, а на третьей находится около 50%. Уровня около 40% кривая достигает примерно к шестой позиции; на седьмой–девятой она уже ниже 40%. Таким образом, заметное падение начинается рано, но порог 40% пересекается значительно позже второй позиции.
Остальные кривые помогают разделить разные поколения блочного подхода. DFlash на этом графике выше EAGLE-3, но ниже MTP. DSpark и DFlash-2 сохраняют более высокий профиль, близкий к MTP и несколько превосходящий его на показанных позициях. Это объясняет, зачем понадобились дополнительные способы согласования соседних предсказаний: совместная генерация уже сокращает последовательную работу, а уточнение помогает дольше сохранять полезность продолжения.
У встроенного MTP есть важное преимущество происхождения: разработчик основной модели может обучать его вместе с ней ещё на стадии предварительного обучения. Автор приводит в пример Alibaba и Moonshot. Команда, которая затем обучает внешний драфтер для готовой модели, начинает с других условий. Встроенный MTP поэтому остаётся самостоятельным вариантом, а результаты DFlash и DSpark нужно рассматривать для конкретной пары основной и вспомогательной моделей.
Следующий слайд сводит измерения acceptance length для линейки Qwen. В нём перечислены десять наборов данных: GSM8K, MATH, AIME25, MBPP, HumanEval, LCB, MT-Bench, Alpaca, ArenaHard и TextVQA. Числа показывают среднюю длину принимаемого продолжения в токенах. Названия моделей в таблице — Qwen3-8B, Qwen3.5-9B и Qwen3.8-27B; для вариантов DFlash используется общая строка DFlash(2).
Таблицу можно прокрутить по горизонтали.
Для Qwen3-8B наибольшее из приведённых значений у DSpark — 4.56 против 3.67 у DFlash(2) и 1.99 у Eagle3. Для Qwen3.5-9B DFlash(2) и MTP дают близкие значения: 3.85 и 3.83. Максимум всей таблицы, 4.70, относится к DFlash(2) с Qwen3.8-27B; у MTP для этой модели указано 4.21. Эти величины характеризуют принятую длину, а не ускорение в соответствующее число раз.
Происхождение весов остаётся важным и после выбора архитектуры. Автор отдельно обсуждает сравнение DFlash2 с независимо обученной версией DSpark: такой результат зависит от качества воспроизведения DSpark, а не только от различий моделей. В представленном исследовании основное внимание уделено Qwen размером до 27 миллиардов параметров. Более крупные DeepSeek и GLM команда тоже использует, но связанные с ними проблемы выходят за рамки этого сравнения.
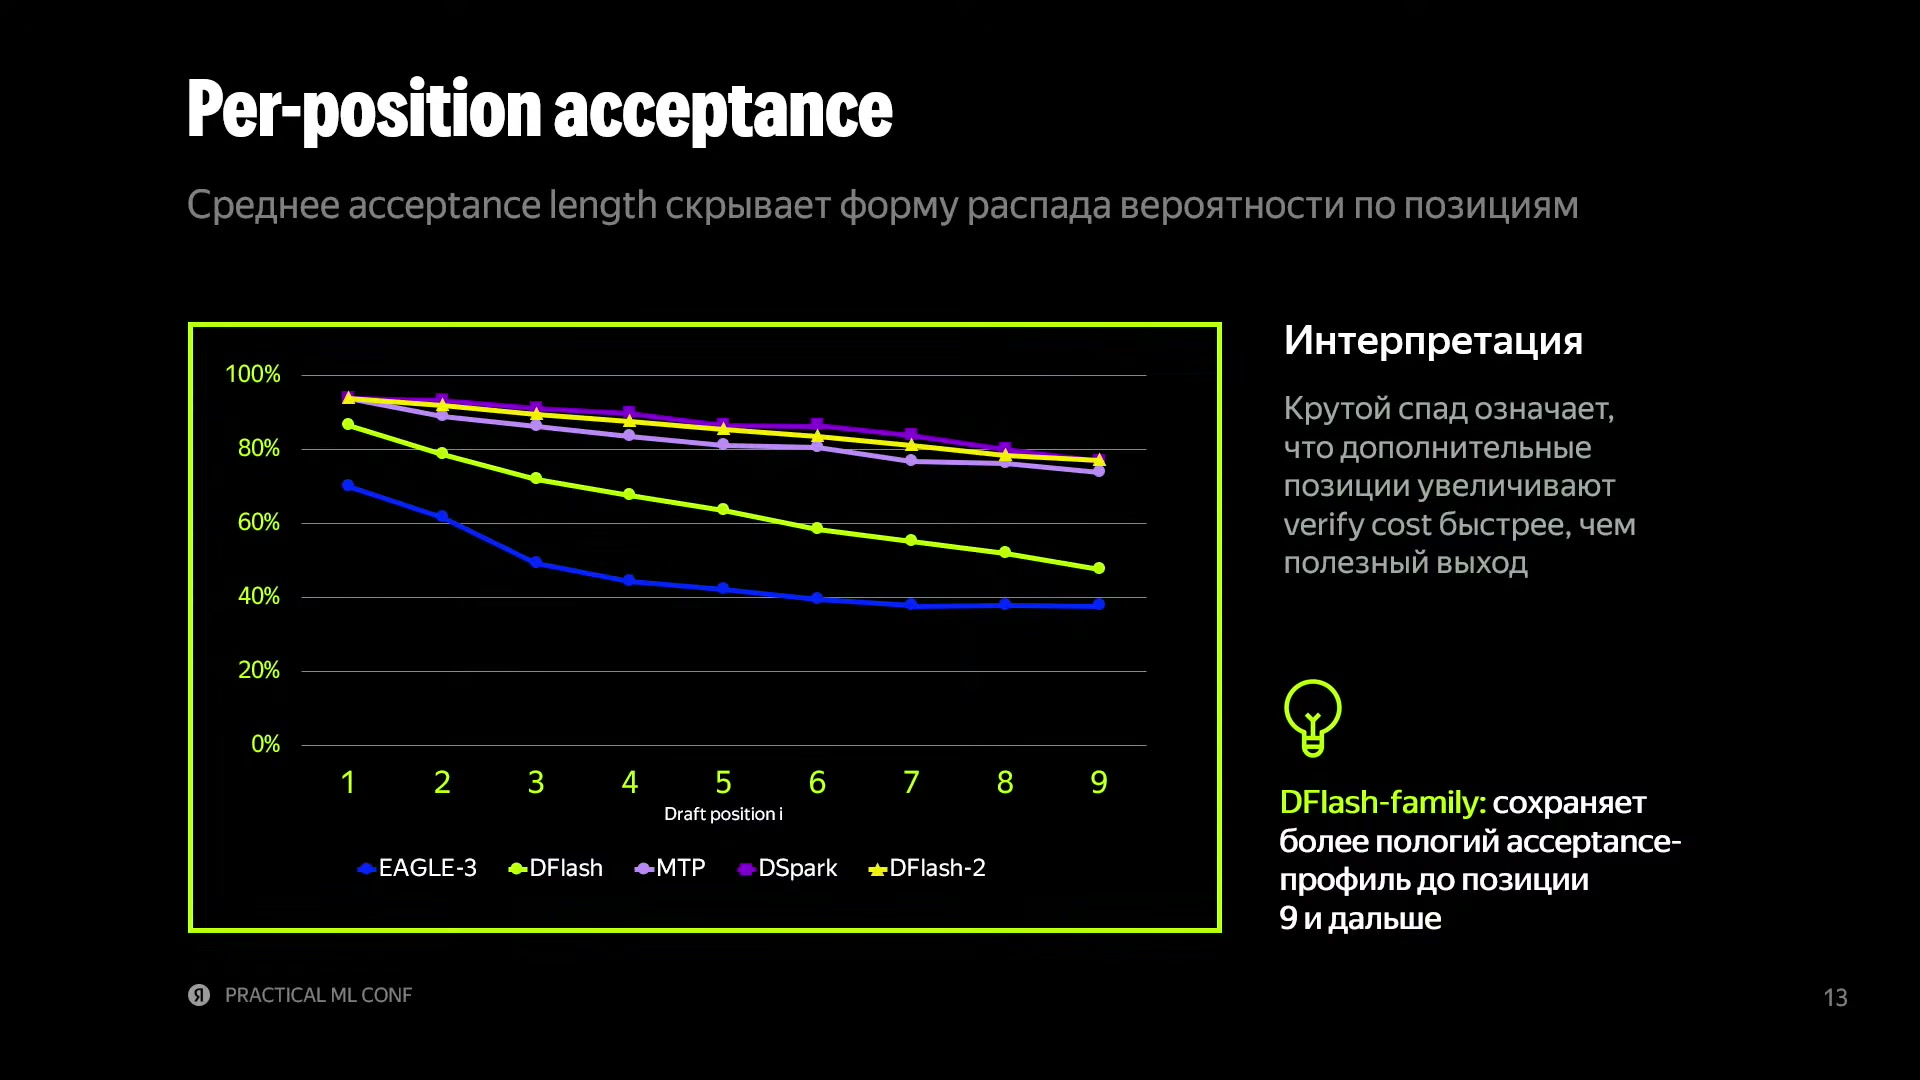
Профиль принятия показывает полезность каждой позиции. EAGLE-3 приближается к 40% примерно на шестой позиции; DSpark и DFlash-2 сохраняют более высокий профиль в показанном окне.
Источник: Станислав Илюшин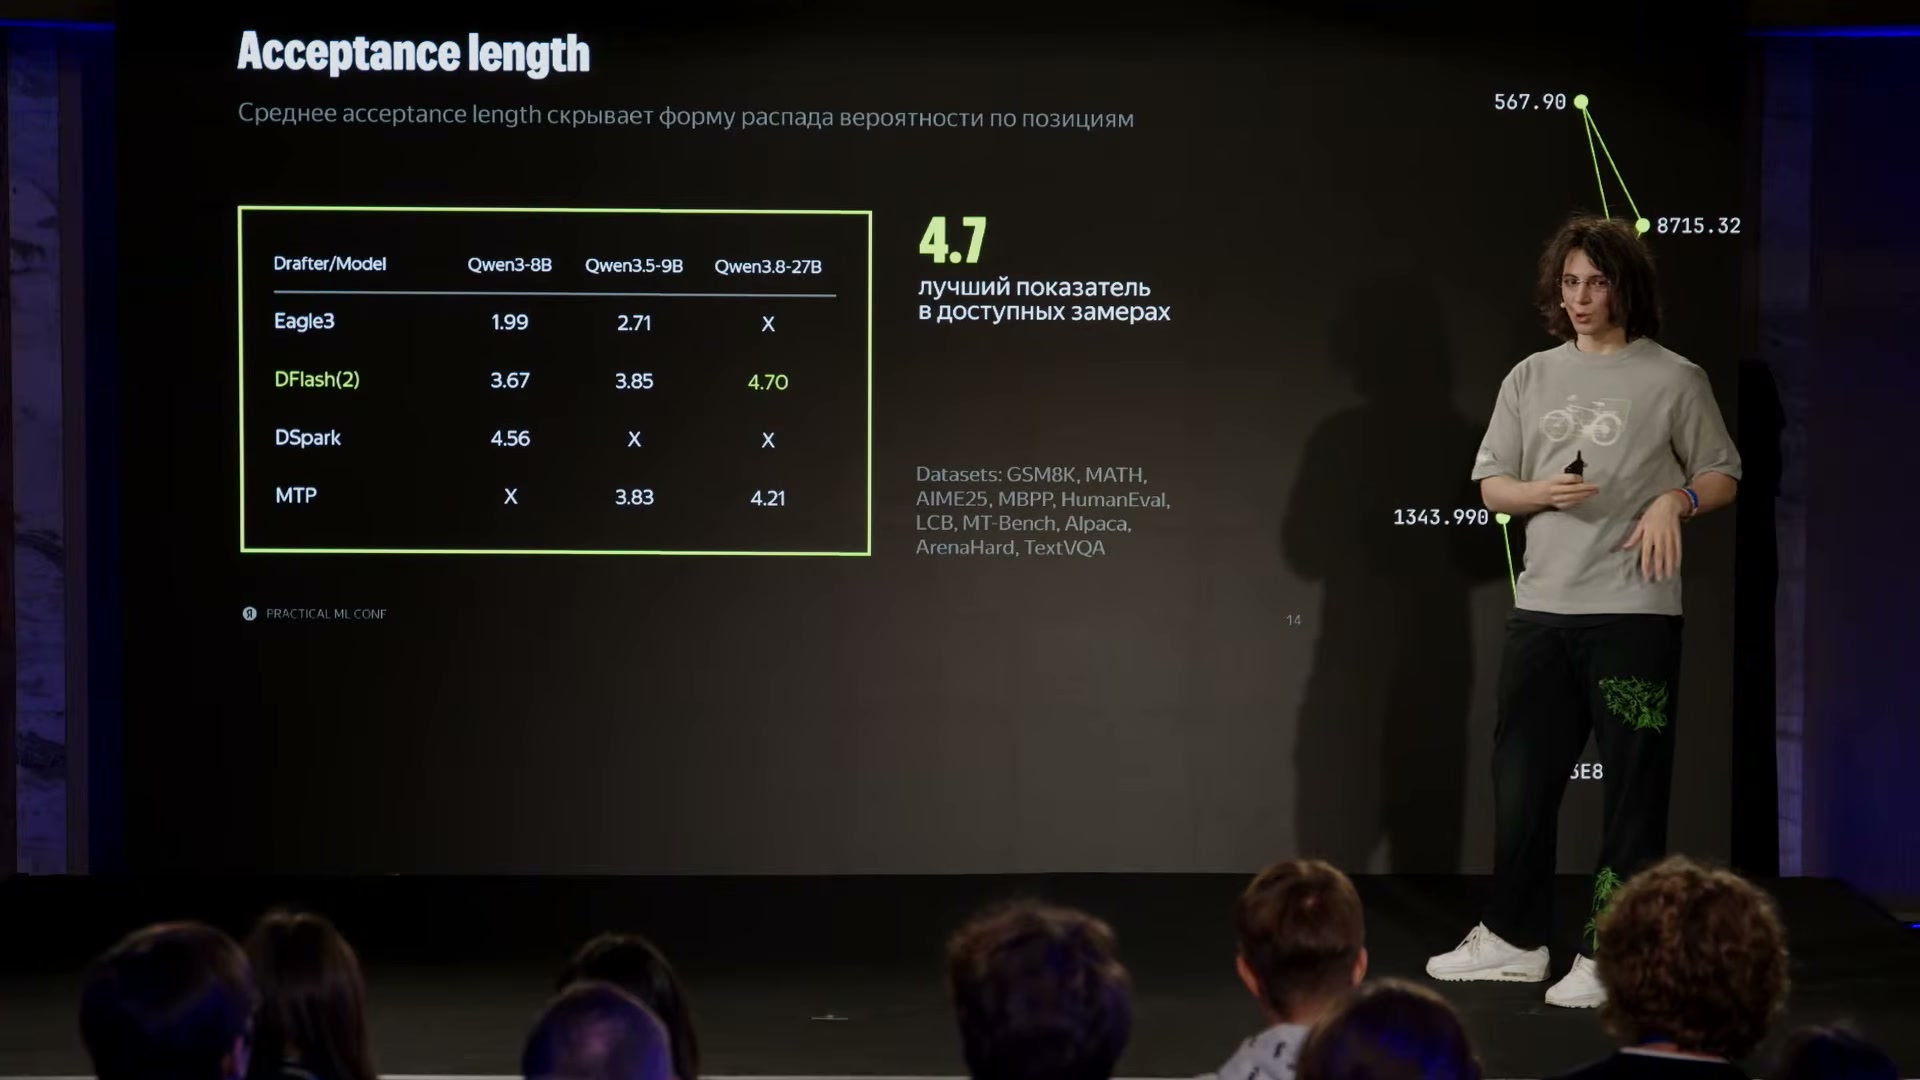
Acceptance length для трёх целевых моделей. Значение 4.70 относится к DFlash(2) с Qwen3.8-27B и выражает длину принятого продолжения, а не коэффициент ускорения.
Источник: Станислав ИлюшинПочему длинный блок теряет выгоду при росте нагрузки
Теперь к качеству кандидатов добавляется размер батча — число запросов, обрабатываемых совместно. На следующем графике используются Next-SWE-Trajectories и ускоритель Ascend 910A2. Бюджет фиксирован: K=9. По вертикальной оси показана системная пропускная способность в токенах в секунду, то есть суммарный выход всего пакета, а не скорость одного отдельного запроса.
При BS=128, где BS обозначает размер батча, на слайде указаны ускорения относительно основной модели: 1.43× для DSpark и 1.22× для DFlash. При BS=256 для DFlash остаётся 0.99× — практически равенство с основной моделью, с небольшим проигрышем. У EAGLE-3 кривая в показанном диапазоне батчей располагается ниже основной модели. Абсолютное число токенов в секунду при росте батча при этом может увеличиваться: отсутствие ускорения означает проигрыш соответствующему базовому запуску, а не обязательное падение самого потока.
Причина — удорожание верификации, проверки кандидатов основной моделью. На небольшом батче дополнительные позиции ещё могут обходиться относительно дёшево. На большом батче эти позиции добавляются сразу во множестве запросов. Тогда прирост полезного продолжения перестаёт компенсировать дополнительные вычисления. Длина принятого продолжения может оставаться больше одного токена, а ускорение уже исчезает.
В обсуждении слушатель обращает внимание на условия эксперимента: девять кандидатов — не обязательно выгодная настройка для авторегрессионного драфтера. Автор соглашается, что для EAGLE это не оптимальный бюджет, и далее показывает результат динамического выбора длины. Его сравнение также ограничено доступными для запуска весами: специально обученный EAGLE размером 2 миллиарда параметров с окном семь шагов, который обсуждался в статье о DSpark, на момент выступления не поддерживался в рассматриваемом запуске vLLM.
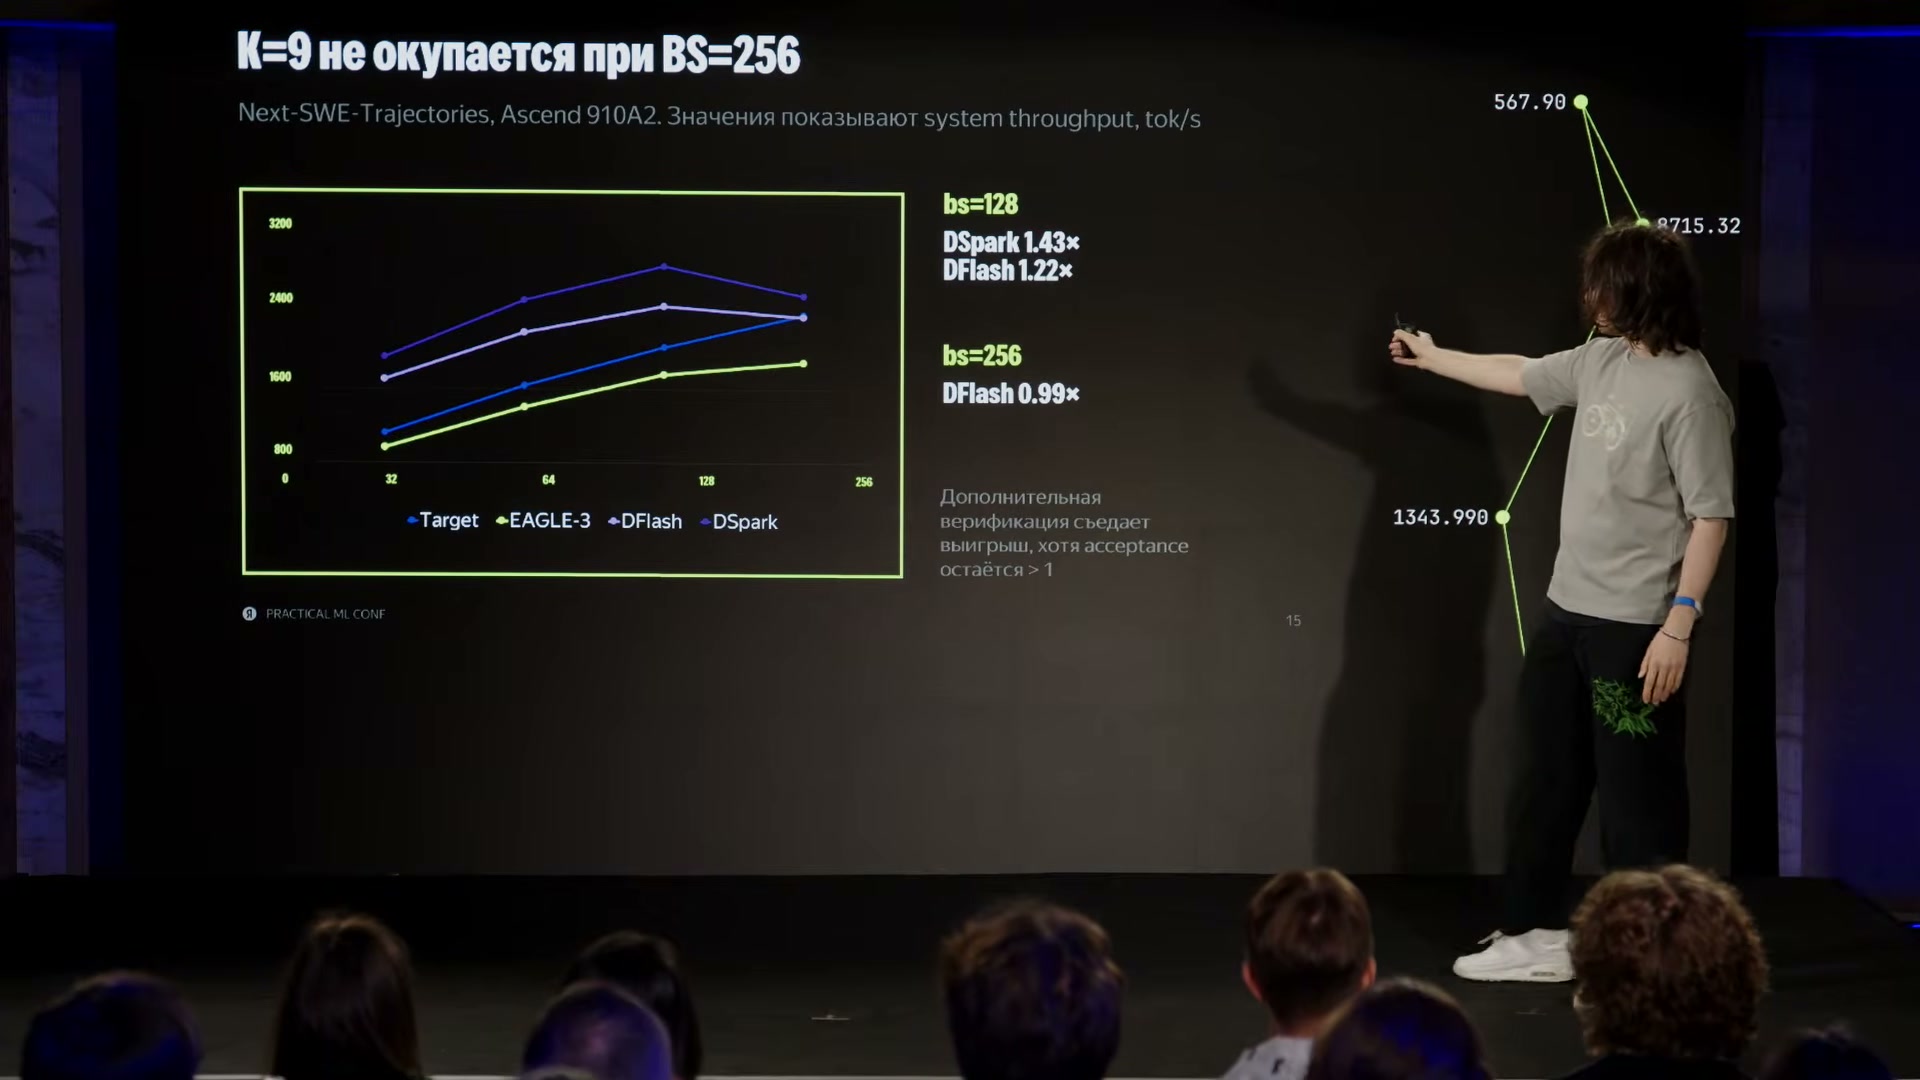
Next-SWE-Trajectories, Ascend 910A2, K=9. При BS=128 DSpark даёт 1.43×, DFlash — 1.22× относительно основной модели; при BS=256 у DFlash остаётся 0.99×.
Источник: Станислав ИлюшинДинамический бюджет: сколько кандидатов стоит проверять
Драфтер может предложить длинный блок, но основной модели необязательно проверять его целиком. Например, DFlash выдаёт 16 кандидатов, а контроллер выбирает для каждого запроса более короткое начало. Полный размер предложения и выбранная длина проверки — разные величины. Именно выбор эффективной длины в докладе называется адаптивной, или динамической, верификацией.
Задача контроллера непосредственно следует из TPOT: k* = argminₖ [D(b, k) + V(b, k)] / G(k). Запись argmin означает выбор того k, при котором выражение минимально. Контроллер ищет не самое длинное и не самое уверенное предложение само по себе, а наиболее дешёвый полезный выход при текущем размере батча и стоимости вычислений.
Для добавления одной позиции на слайде записан порог: pₖ₊₁ > G(k) · ΔC / C(k). Здесь C(k) = D(b, k) + V(b, k), а ΔC — дополнительная стоимость перехода от k к k+1. Смысл условия: вероятность получить ещё один полезный токен должна быть достаточно большой по сравнению с относительным ростом затрат. Оно получается из сравнения стоимости токена до добавления позиции и после него: [C(k) + ΔC] / [G(k) + pₖ₊₁] < C(k) / G(k).
Аппаратная часть меняет этот порог. На слайде с Qwen3-8B, H20 и TP1 сравниваются режимы 25% active drafts и 100% active drafts. TP1 обозначает степень тензорного параллелизма один: вычисления этого типа не разделены между несколькими ускорителями. В устном примере автор сопоставляет четыре и 16 кандидатов и говорит, что при батче 64 проверка четырёх обходится примерно вдвое дешевле. Чем дороже становятся дополнительные позиции, тем выше требование к их принятию.
Для измерений на Ascend приведён профиль стоимости при нескольких размерах батча. При BS=256 переход от пяти кандидатов к девяти увеличивает указанную стоимость с 230 до 330, а в столбце порога для девятой позиции стоит 45%. При меньшей нагрузке требования мягче. Временная единица этой таблицы не подписана, поэтому её абсолютные значения рассматриваются в шкале слайда, а множители — как относительный рост стоимости.
Таблицу можно прокрутить по горизонтали.
Следом автор сравнивает фиксированный и динамический бюджеты при BS=256. Эти измерения сделаны на Model Runner V1 — варианте компонента vLLM, который управляет выполнением модели. Базовый авторегрессионный запуск основной модели, Target AR, даёт 2411 токенов/с. В таблице ниже приведена системная пропускная способность для каждого драфтера.
Таблицу можно прокрутить по горизонтали.
Динамический выбор улучшил все три показанных варианта. EAGLE-3 и DFlash перешли от результата ниже основной модели к результату выше неё. DSpark выигрывал и с фиксированным бюджетом, а динамика подняла его пропускную способность с 2614 до 3120 токенов/с. Если разделить 3120 на базовые 2411, получится около 1,29×: это рассчитанное отношение к Target AR, а не отдельный эксперимент.
Вывод относится к конкретной проверке на большом батче: спекулятивный декодинг может сохранять преимущество при высокой нагрузке, если ограничивать невыгодную проверку. При этом оптимальная длина зависит от драфтера и аппаратной стоимости. Условия сравнения моделей с фиксированным бюджетом и результат работы адаптивного контроллера отвечают на разные вопросы.
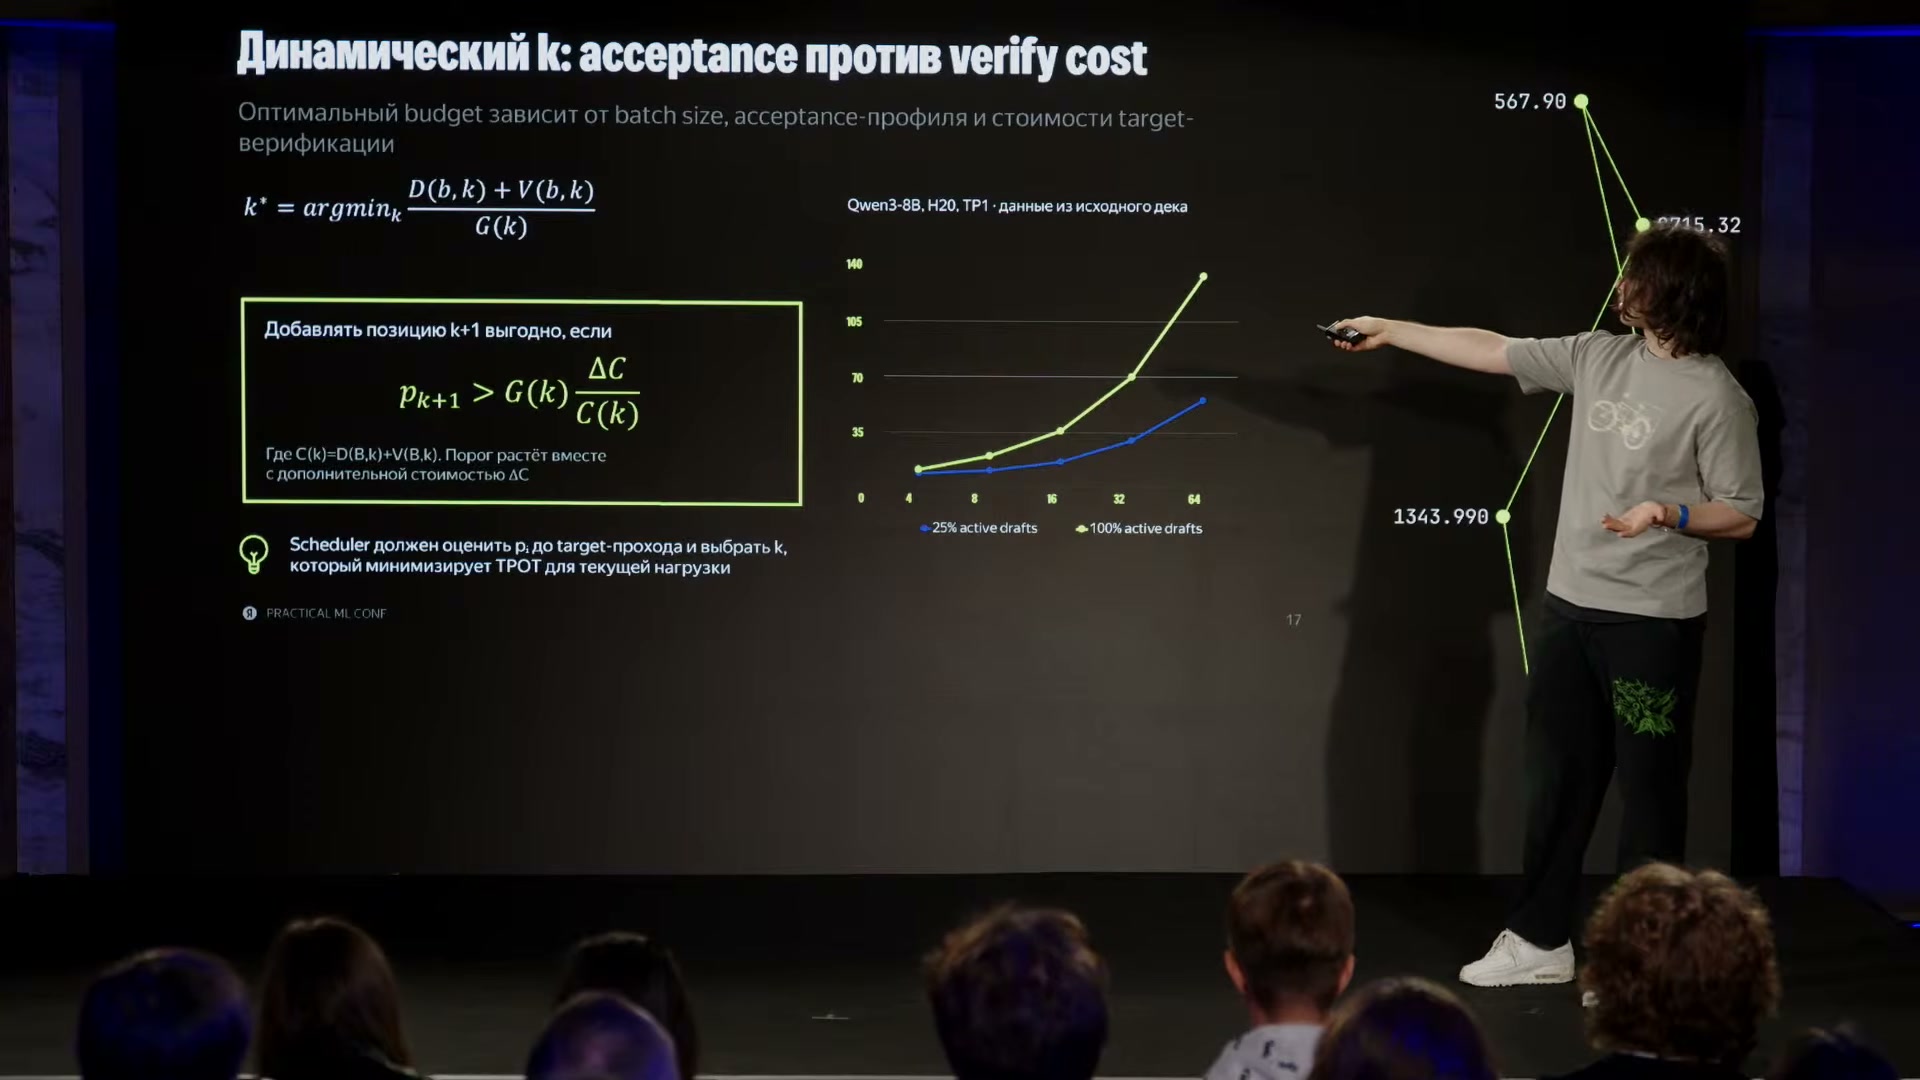
Дополнительная позиция полезна, когда ожидаемый выигрыш перекрывает рост стоимости шага. Рядом показано сравнение режимов Qwen3-8B на H20 при TP1.
Источник: Станислав Илюшин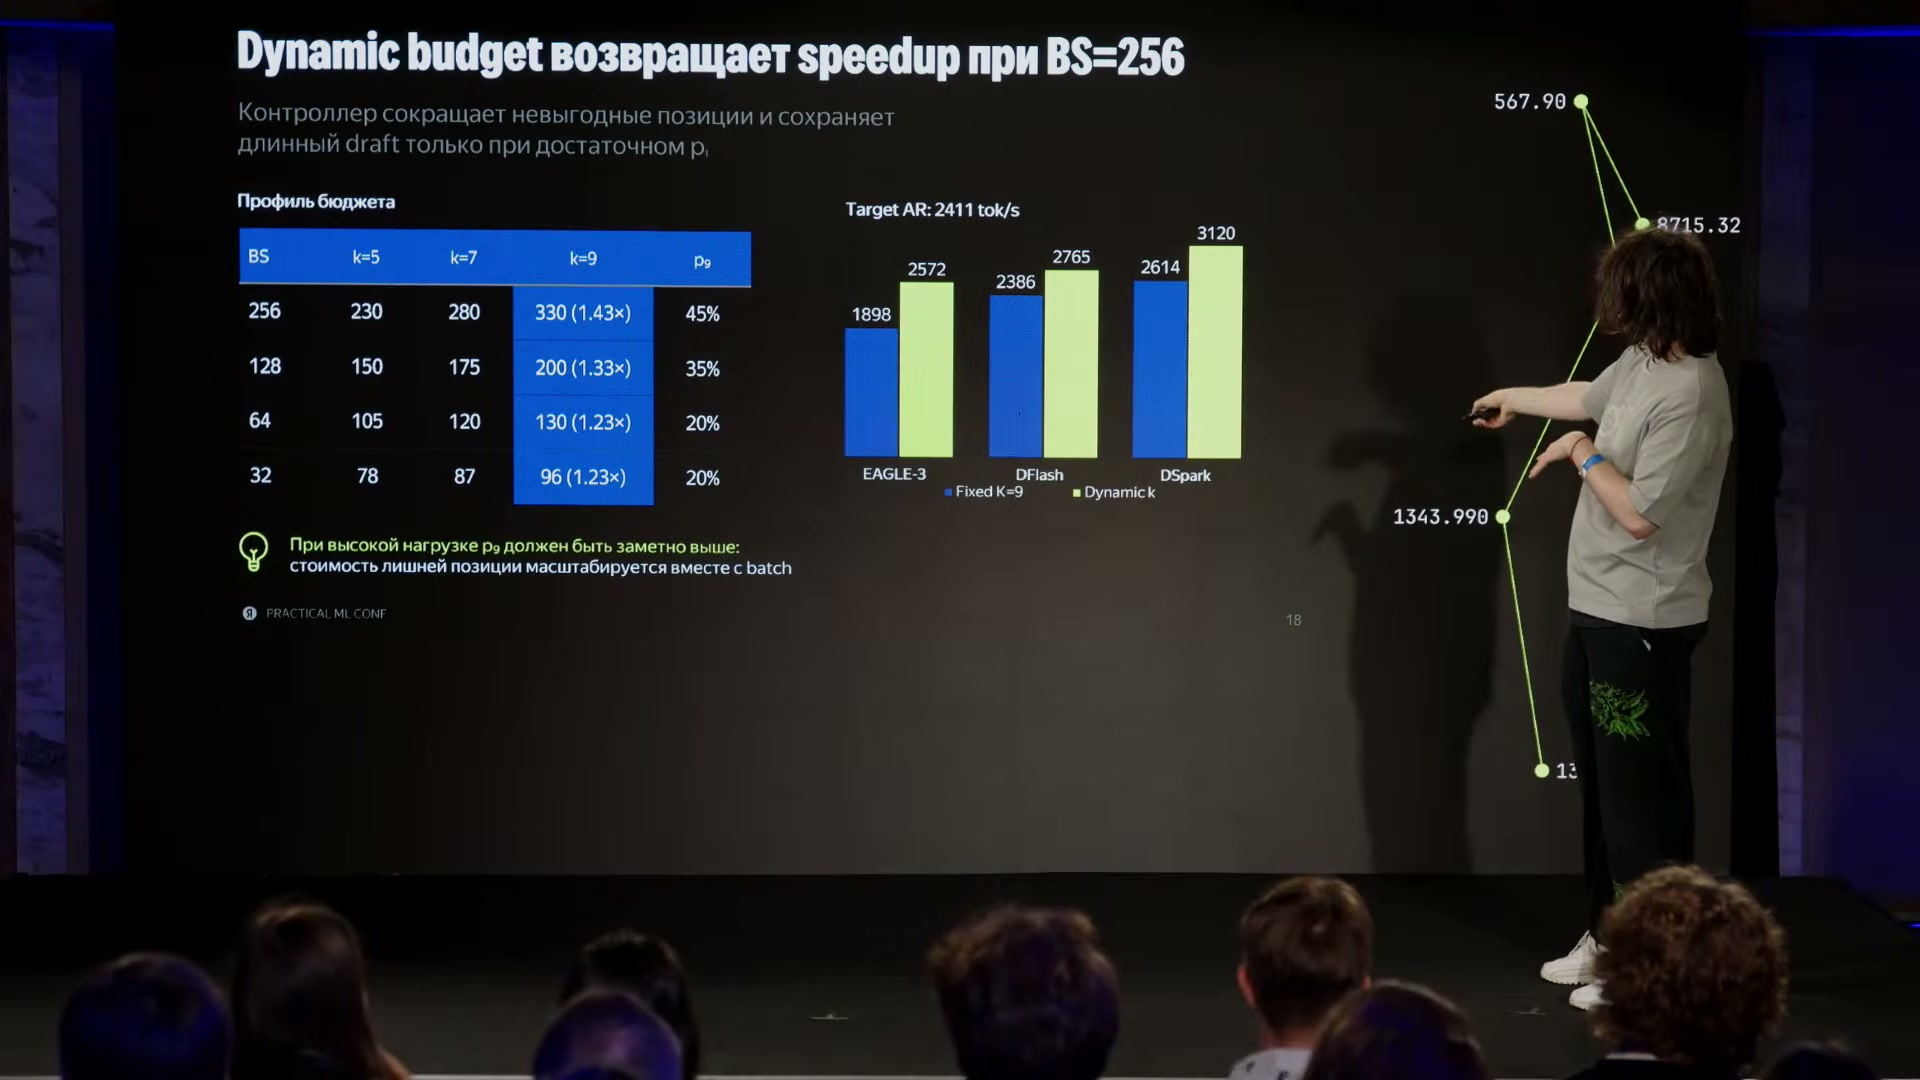
При BS=256 динамический бюджет повышает пропускную способность всех трёх драфтеров. DSpark достигает 3120 токенов/с при Target AR 2411 токен/с; измерения относятся к V1.
Источник: Станислав ИлюшинАрхитектура определяет и выигрыш, и сложность интеграции
Промежуточное сравнение доклада связывает результаты с устройством моделей. У обсуждаемых EAGLE и MTP основная последовательная работа приходится на повторные шаги драфтера. У семейства DFlash блок обрабатывается совместно, но остаются собственные расходы на внимание, смешивание соседних представлений и дополнительное уточнение. Выигрыш возникает из соотношения этих затрат с полученным профилем принятия.
Есть и различие для движка. Последовательный драфтер естественно продолжает причинный KV-cache, в котором новая позиция опирается на предшествующие. Блочная модель требует заранее подготовленных временных позиций и служебных данных для блоков разной длины. Поэтому переход от одного способа генерации к другому меняет не только нейросеть: меняется организация каждого её запуска.
Автор выделяет перспективное сочетание: параллельный блок, лёгкое уточнение и выбор длины с учётом оборудования. Отдельно Huawei исследует гипотезу о преимуществе совместного предсказания на ограниченном окне продолжения. На момент доклада это исследовательское направление; инженерные результаты ниже связаны с конкретно реализованными механизмами, а не с завершённым доказательством этой гипотезы.
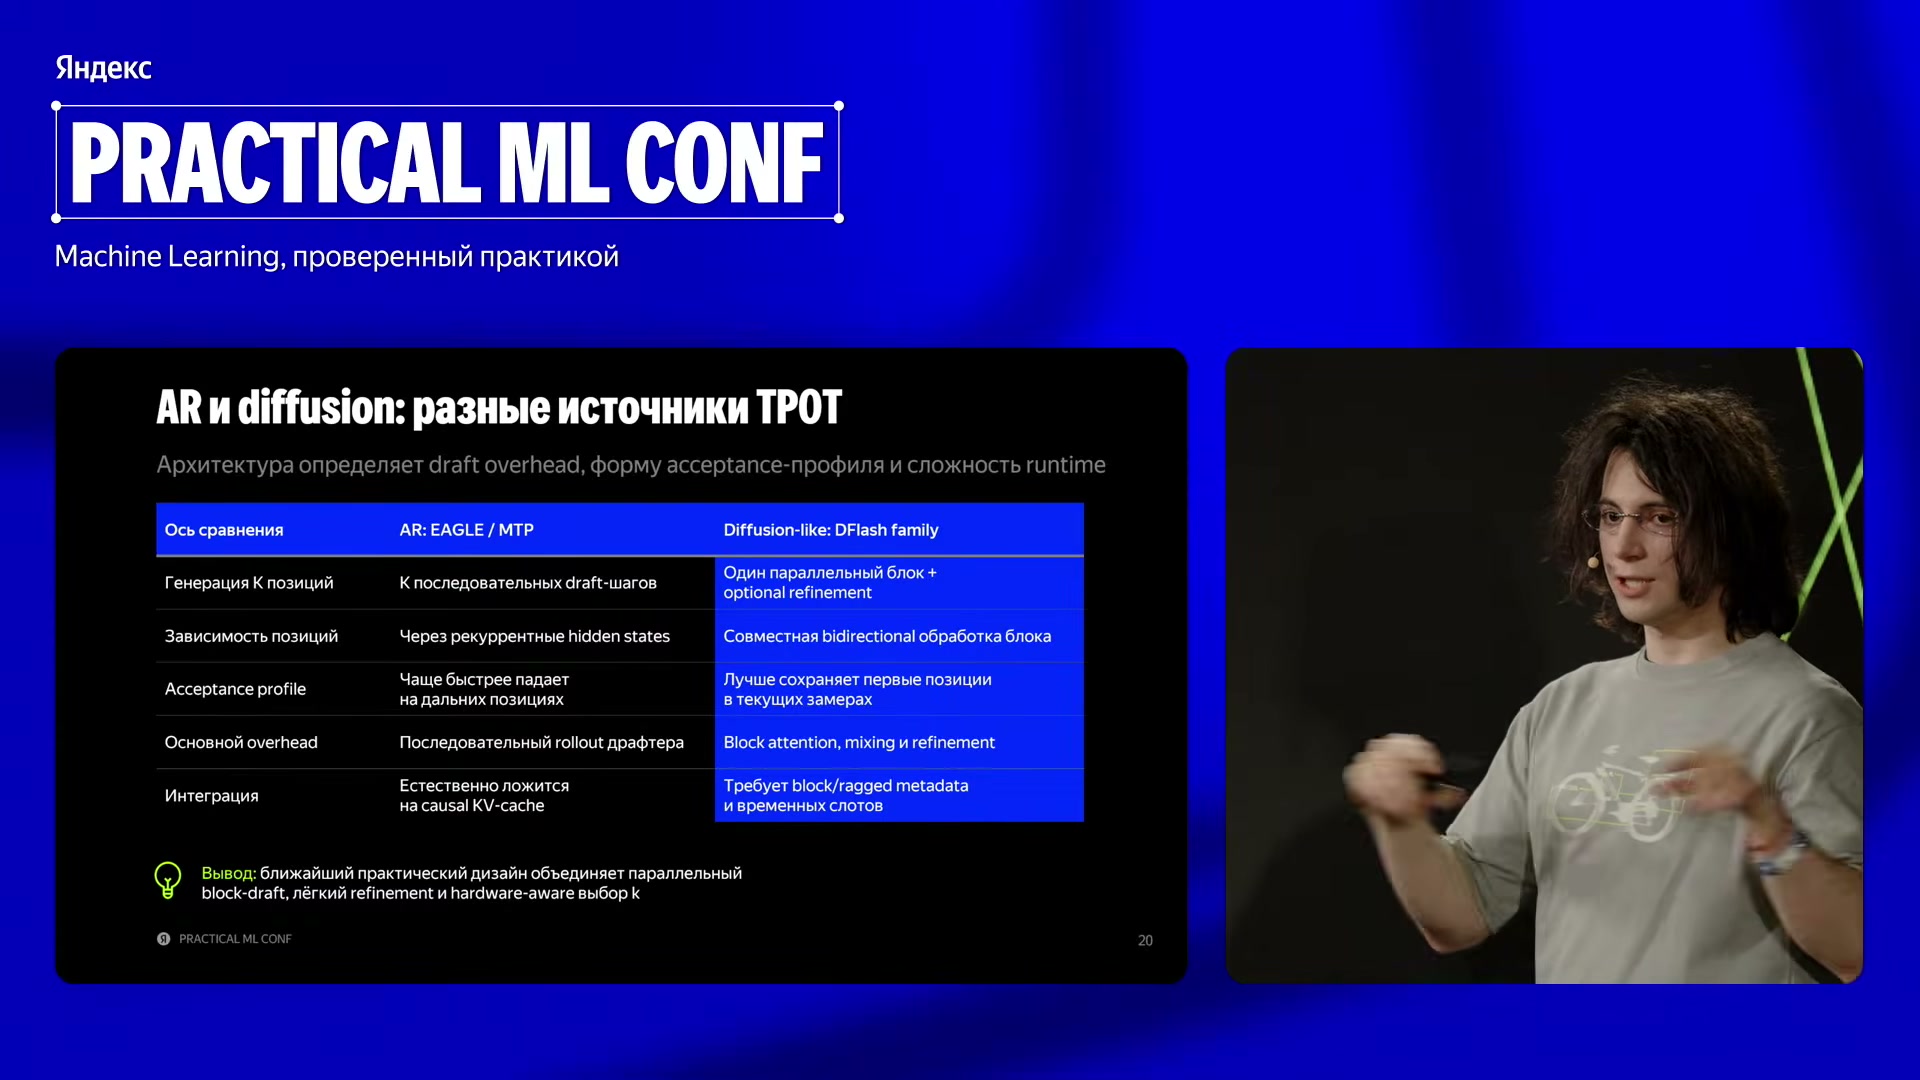
Последовательные и блочные драфтеры по-разному расходуют время и требуют разной организации памяти. Совместная генерация переносит часть сложности в обработку блока и его интеграцию.
Источник: Станислав ИлюшинКонтекст основной модели и временный блок нужно готовить отдельно
Первая часть интеграции касается того, какие данные получает драфтер. В описанной конфигурации EAGLE скрытые состояния основной модели берутся с трёх слоёв, объединяются и преобразуются в контекст драфтера. Для DFlash автор описывает использование пяти слоёв и разделение кеша на две части.
Постоянная часть, persistent cache, получается из скрытых состояний основной модели. Преобразования драфтера переводят их в ключи и значения внимания. Во время обработки нового блока эта часть остаётся фиксированной опорой: она описывает уже известный контекст. На схеме готовые позиции и слоты контекста копируются без повторного расчёта.
Временная часть, temporary cache, относится к текущему предложению. В DFlash на вход подаются опорный токен, anchor, полученный на предыдущем шаге основной модели, и маски. Для трёх кандидатов на схеме используются четыре входные позиции: опорный токен и три маски. После совместного прохода кандидаты извлекаются из выходов маскированных позиций.
Движок заранее готовит для этого блока входные значения, позиционные индексы и места в кеше. Для B запросов и K кандидатов в показанной схеме DFlash получается B × (K + 1) входных позиций, обозначенных как query tokens. Подготовка всего пакета выполняется одним вычислительным ядром на Triton — средстве разработки операций для ускорителя. Здесь ядро означает отдельную низкоуровневую вычислительную функцию.
Так подготовка постоянного контекста отделяется от подготовки нового блока. Основная модель предоставляет опору, а движок организует места, в которых драфтер совместно обработает будущие позиции. Разделение становится особенно важным, когда эти позиции физически лежат в разных участках памяти.
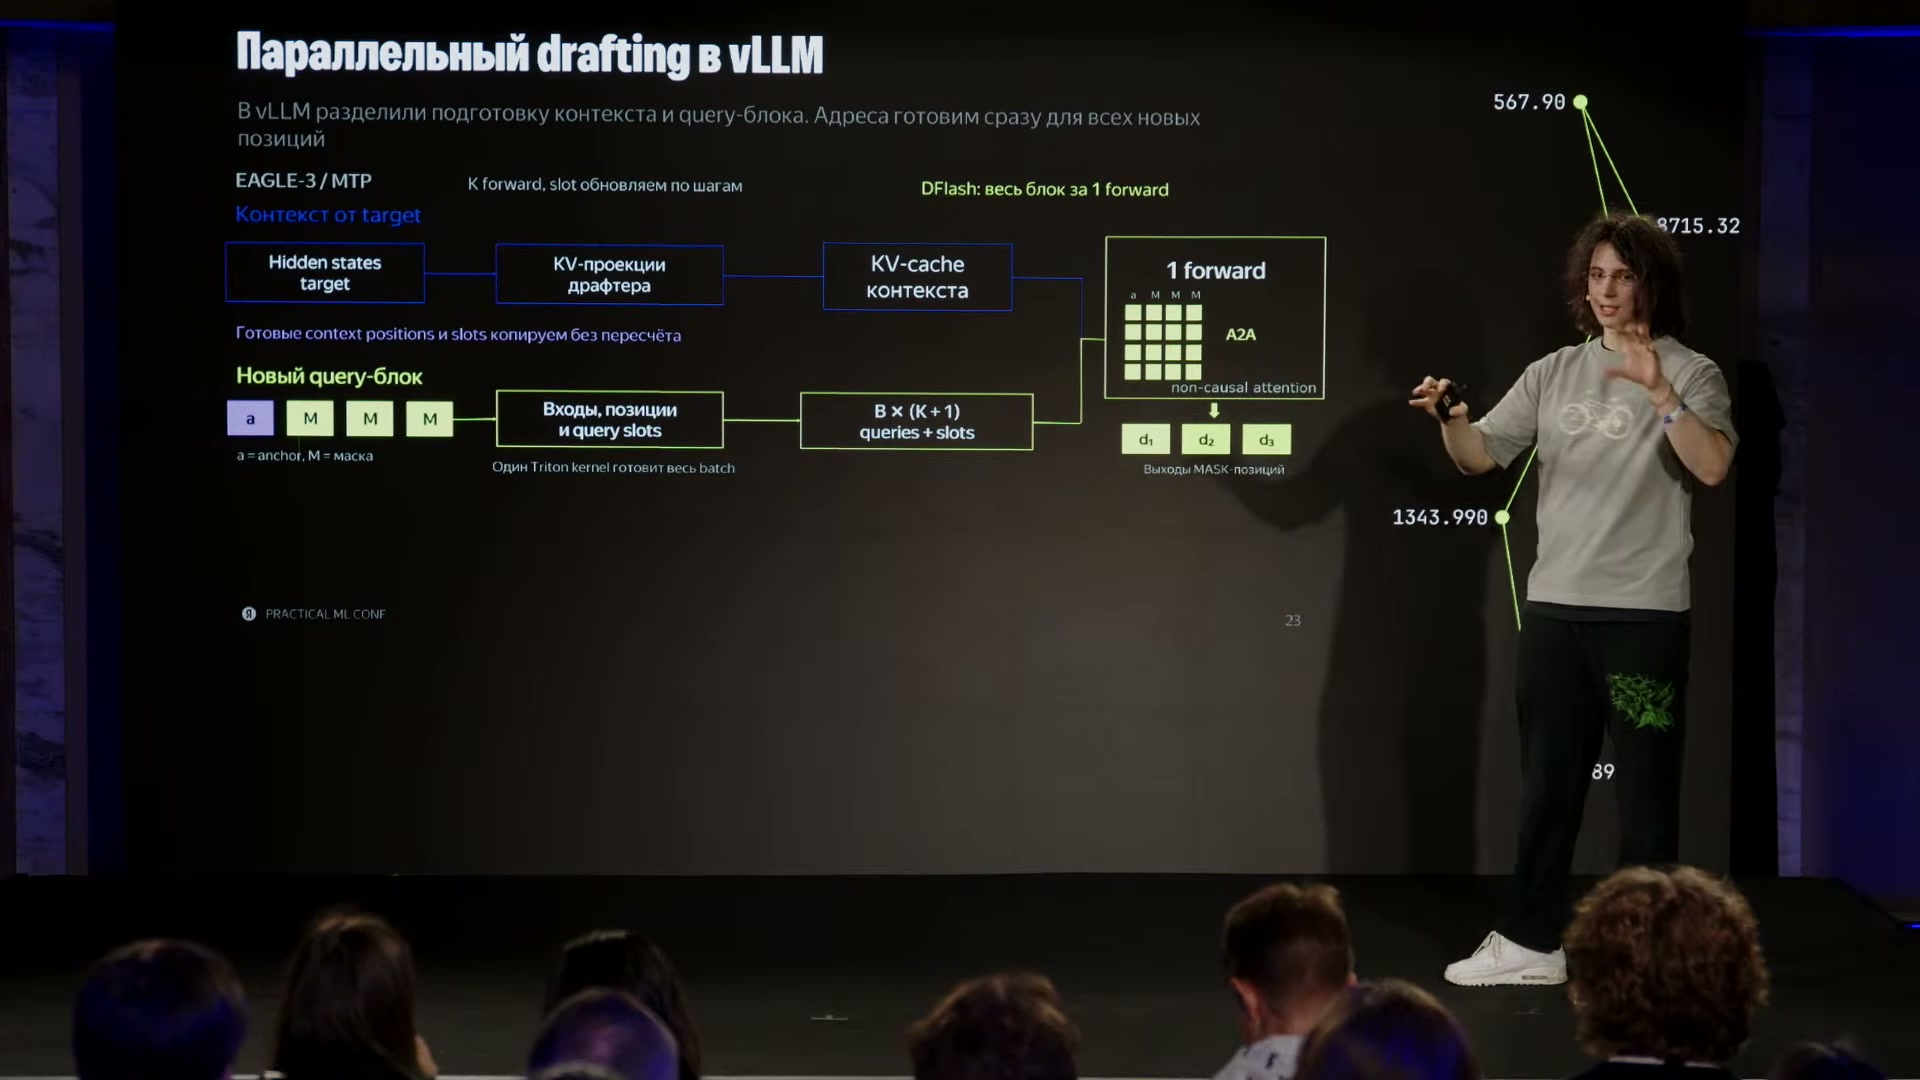
Контекст основной модели готовится отдельно от нового блока. Для DFlash адреса и позиции B × (K + 1) входных токенов подготавливаются сразу для всего пакета.
Источник: Станислав ИлюшинПоложение в тексте и адрес в памяти — разные сведения
При работе с мультимодальными моделями, которые обрабатывают не только текст, команде пришлось изменить формирование позиционных индексов. В докладе речь идёт о RoPE — способе передать модели информацию о положении токена. В простом текстовом случае, который описывает автор, последовательность таких индексов удобно связывалась с физическим количеством токенов.
Для мультимодального случая прежнее соответствие перестало подходить. Команда разделила физическое размещение данных и позиционные индексы, использованные основной моделью. Драфтер наследует нужную позиционную информацию от основной модели, а адресация кеша продолжает отвечать за то, где лежат данные. Эти две задачи больше не опираются на одно и то же упрощённое правило.
В ответах на вопросы автор подтвердил улучшение на изображениях. Величина эффекта и отдельная метрика в докладе не приведены. Для истории интеграции важен сам найденный источник проблемы: правильное физическое размещение токена ещё не означает, что драфтер получил правильную информацию о его позиции.
Доклад · 02:32:48Как один блок пересекает несколько страниц памяти
Следующее ограничение связано с PagedAttention — организацией работы с кешем через страницы памяти. Для модели последовательность остаётся логически непрерывной, но её физические данные могут быть распределены по разным страницам. Таблица блоков, block table, выбирает физическую страницу, а отображение слотов, slot mapping, указывает конкретную ячейку токена.
На слайде позиции 4, 5, 6 и 7 соответствуют слотам 28, 29, 30 и 31 на физической странице 7. Следующая группа позиций находится уже на физической странице 1: позиция 8 попадает в слот 4. Поэтому переход от соседней позиции 7 к позиции 8 означает переход от слота 31 к слоту 4, а не к следующему физическому адресу.
В последовательной схеме это можно обслуживать по шагам. На примере запроса A опорный токен использует слот 31, затем входы следующих шагов — слоты 4 и 5. После одного прохода движок успевает подготовить адрес следующей позиции. Сдвиг входов и скрытых состояний сопровождается очередным обновлением слота.
DFlash требует подготовить весь блок до единственного прохода. Если нужно сразу обработать 16 позиций, среди них могут оказаться переходы на другие страницы и разные отображения слотов. Линейного продолжения одного адреса недостаточно: движок должен заранее рассчитать размещение всех позиций и избежать конфликтов в памяти.
Команда реализовала такую подготовку. Это изменение само по себе не описывается отдельным процентом ускорения: оно делает блочную генерацию совместимой с управлением памятью vLLM. В более широком объяснении автора страничная организация также нужна для гибкого объединения работы над запросами, включая обработку входного текста, prefill, и пошаговую генерацию продолжения, decode.
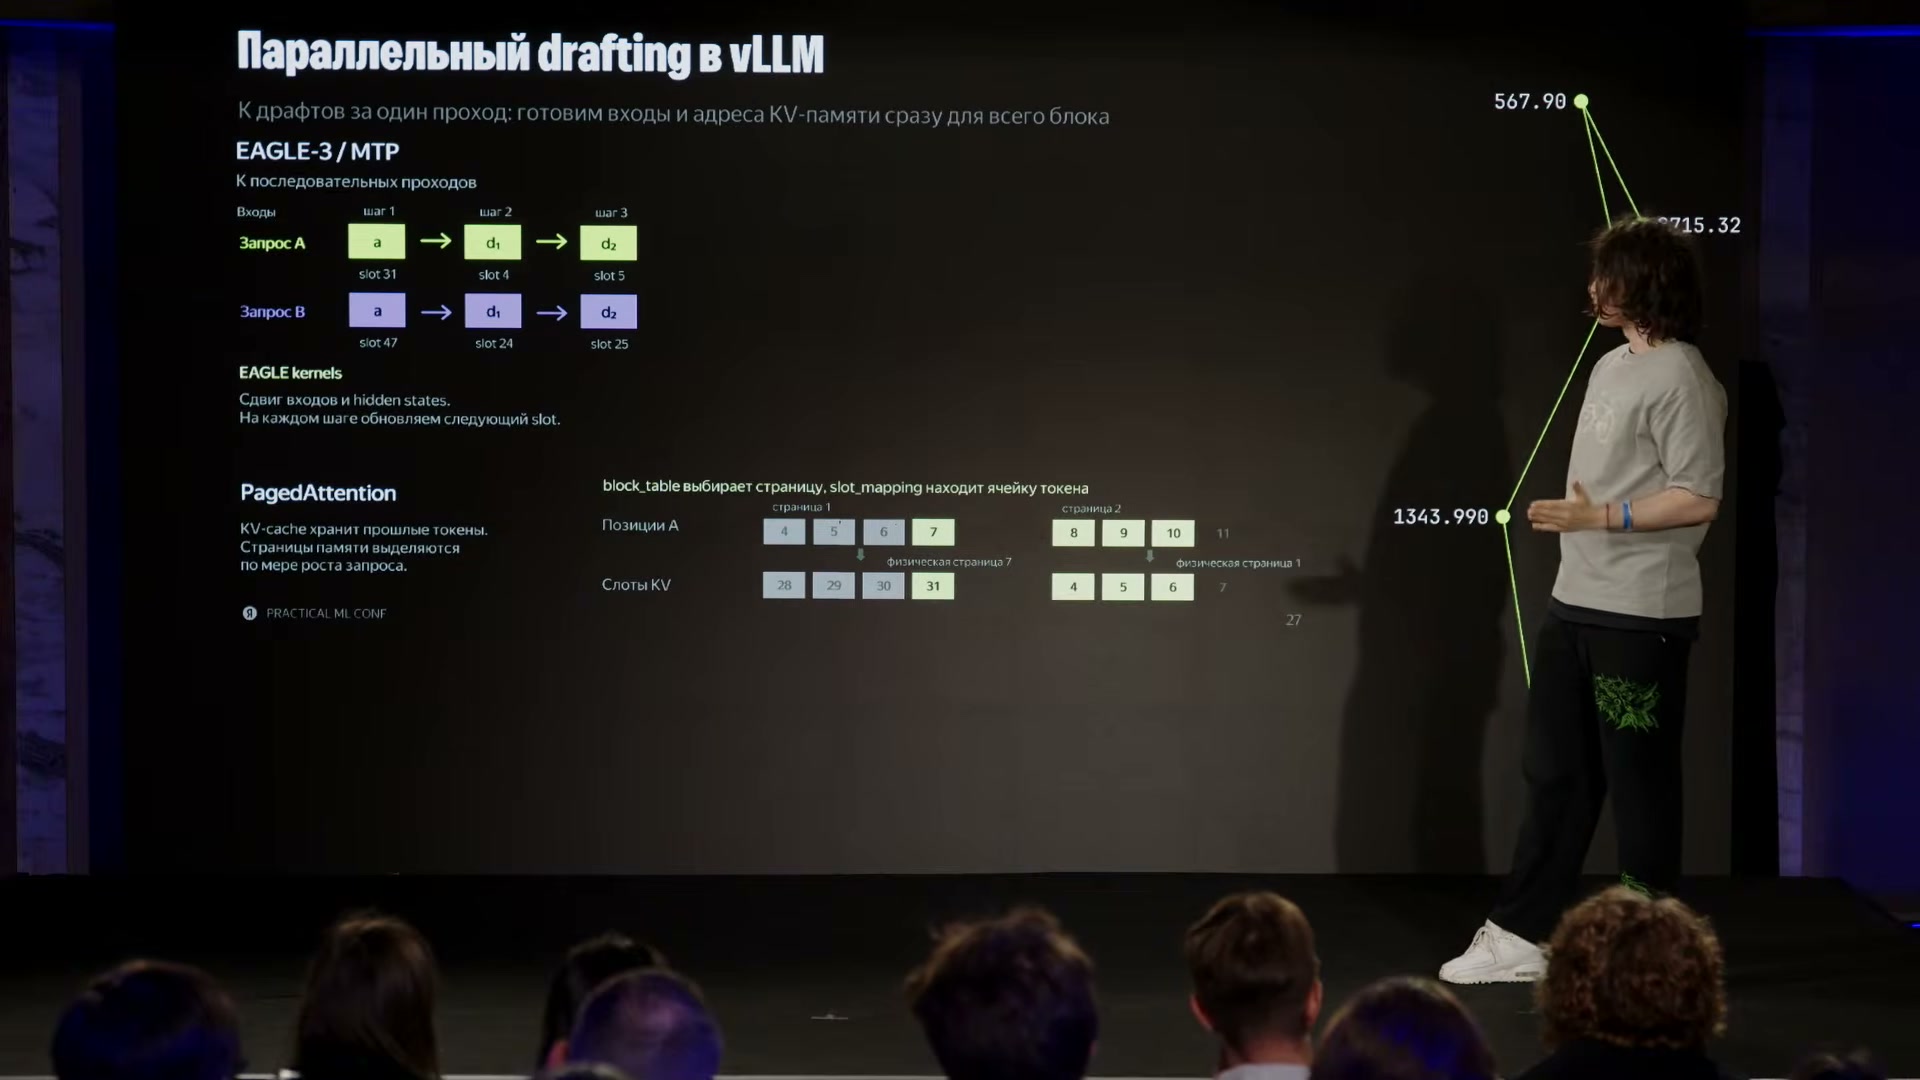
Соседние логические позиции могут находиться на разных физических страницах. В примере переход между страницами меняет слот 31 на слот 4.
Источник: Станислав ИлюшинВ V1 выбор длины создавал ожидание между устройством и CPU
После поддержки блочной генерации возникает следующая зависимость: длина проверки определяется результатом работы драфтера. У DSpark confidence head получает скрытые состояния и выдаёт оценку уверенности для кандидата. В примере автора значение 0,8 означает предсказание высокой вероятности его принятия. Это сигнал для контроллера до проверки основной моделью.
Расчёт драфтера идёт на GPU или NPU, а центральный процессор, CPU, участвует в подготовке следующего запуска и нужных массивов данных — тензоров. Обычно эти работы стараются перекрывать по времени. Но в первой реализации динамической верификации на Model Runner V1 CPU сначала должен узнать, сколько кандидатов оставлено у каждого запроса.
Пока DSpark не завершил расчёт, точных длин нет. Затем сведения передаются с устройства на CPU, там читаются длины и обрезаются подготовленные тензоры. Только после этого основная модель получает нужные участки для проверки. Такая передача с устройства на управляющий процессор обозначается D2H, device-to-host; в данном месте она создаёт ожидание.
Даже с этим ожиданием реализация давала выигрыш: именно к V1 относятся результаты динамической проверки с 3120 токенами/с у DSpark. Следующая доработка направлена на устранение этой зависимости при подготовке запуска, а не на изменение уже измеренных значений задним числом.
Доклад · 02:37:47V2 заранее определяет общий размер, а границы меняет на ускорителе
В асинхронной реализации Model Runner V2 общий объём следующего запуска оценивается заранее. Для этого используются прошлые оценки уверенности и профиль стоимости. Автор также описывает усреднение недавних длин: например, история 10, 12 и 10 даёт ориентир около 11 для следующего шага. Это позволяет подготовить память до появления свежего результата драфтера.
На схеме показан отдельный конкретный пример: три запроса и заранее выбранный бюджет восемь кандидатов. Основной модели нужна ещё одна позиция на каждый запрос для дополнительного токена. Поэтому CPU уже знает общий размер запуска: 8 + 3 = 11 входных позиций.
После получения свежих оценок ускоритель распределяет восемь кандидатов между запросами: четыре для A, три для B и один для C. С дополнительной позицией на каждый запрос длины становятся [5, 4, 2]. Их сумма по-прежнему равна 11. Меняется внутреннее разбиение общего массива, а не размер, который должен заранее подготовить CPU.
Границы задаются смещениями, offsets. Для длин [5, 4, 2] на слайде указаны [0, 5, 9, 11]: первый запрос занимает участок от 0 до 5, второй — от 5 до 9, третий — от 9 до 11, не включая правую границу. Так основная модель различает последовательности внутри общего массива. Одного списка выбранных кандидатов без этих границ было бы недостаточно.
На момент выступления автор называл V2 недавно завершённой реализацией, для которой ещё не измерили скорость. Кроме того, выполнение зависит от конкретной реализации операций внимания, или attention backend: не все такие реализации поддерживают изменение внутренних длин в полном графовом режиме FULL. Асинхронная организация решает зависимость размеров от текущего расчёта, но сохраняет требования к низкоуровневым операциям.
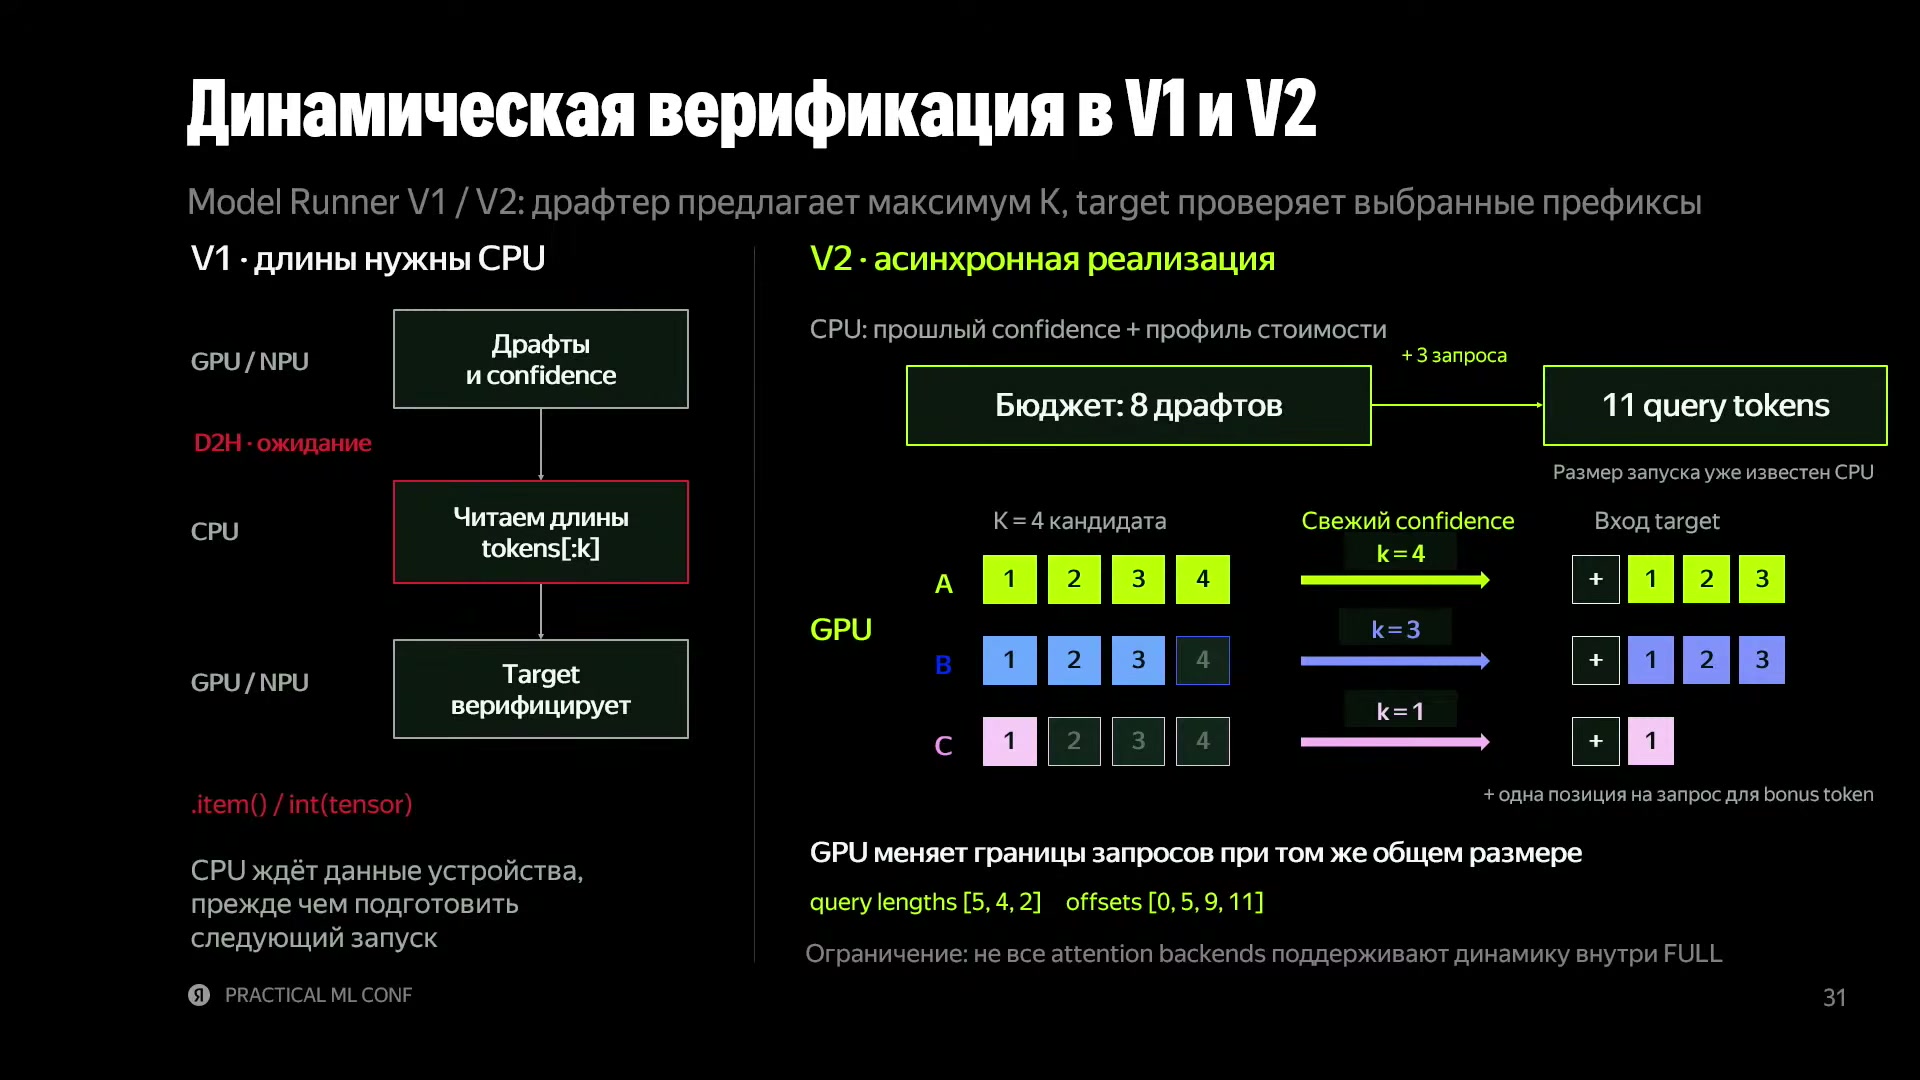
V1 читает свежие длины на CPU, а V2 заранее готовит общий объём и меняет границы на ускорителе. В примере длины [5, 4, 2] дают смещения [0, 5, 9, 11].
Источник: Станислав ИлюшинКак оценить полезность продолжения без отдельной головы
У DFlash отдельного confidence head нет. Команда использует уверенность из предсказанного распределения токенов. Сначала модель выдаёт логиты — численные оценки возможных токенов до преобразования в вероятности. Операция softmax переводит эти оценки в распределение, а в качестве cᵢ берётся его максимальное значение для позиции i.
На слайде приведена эквивалентная запись: cᵢ = 1 / Σᵥ exp(zᵢᵥ − maxᵤ zᵢᵤ), где zᵢᵥ — логит токена v на позиции i. Вместо сохранения всего промежуточного распределения достаточно сразу получить одно максимальное нормированное значение. Для этого команда реализовала объединённое ядро fused max-softmax на Triton.
Размер экономии показан на конкретном примере: N=1024 позиции, словарь V=131072 токена, числа FP32 — по 32 бита. Полный промежуточный массив softmax занимает 512 MiB, а вектор из одной оценки уверенности на позицию — 4 KiB. Речь именно об устранении большого промежуточного массива и связанных обращений к памяти; логиты, веса модели и остальной кеш остаются частью вычисления.
DSpark получает cᵢ другим путём: через confidence head и sigmoid — преобразование выхода в диапазон от нуля до единицы. Затем обе схемы используют оценки для всего начала последовательности. Вероятность сохранения префикса, survival probability, оценивается накопленным произведением: p̂ᵢ = c₁ · c₂ · … · cᵢ. Поздняя позиция оценивается вместе с теми, которые должны быть приняты перед ней.
В примере со слайда cᵢ равны 0.90, 0.80, 0.70 и 0.50. Накопленные произведения после округления составляют 0.90, 0.72, 0.50 и 0.25. Эти оценки используются при выборе заданного числа наиболее полезных позиций, top-K, в пределах подготовленного бюджета; смещения сохраняют принадлежность выбранных продолжений запросам.
Уверенность здесь служит оценкой будущего принятия, а окончательное решение остаётся за основной моделью. Контроллеру нужна не просто высокая оценка префикса: он сопоставляет ожидаемый выход со временем запуска, которое в реальном движке зависит ещё и от подготовленных графов.
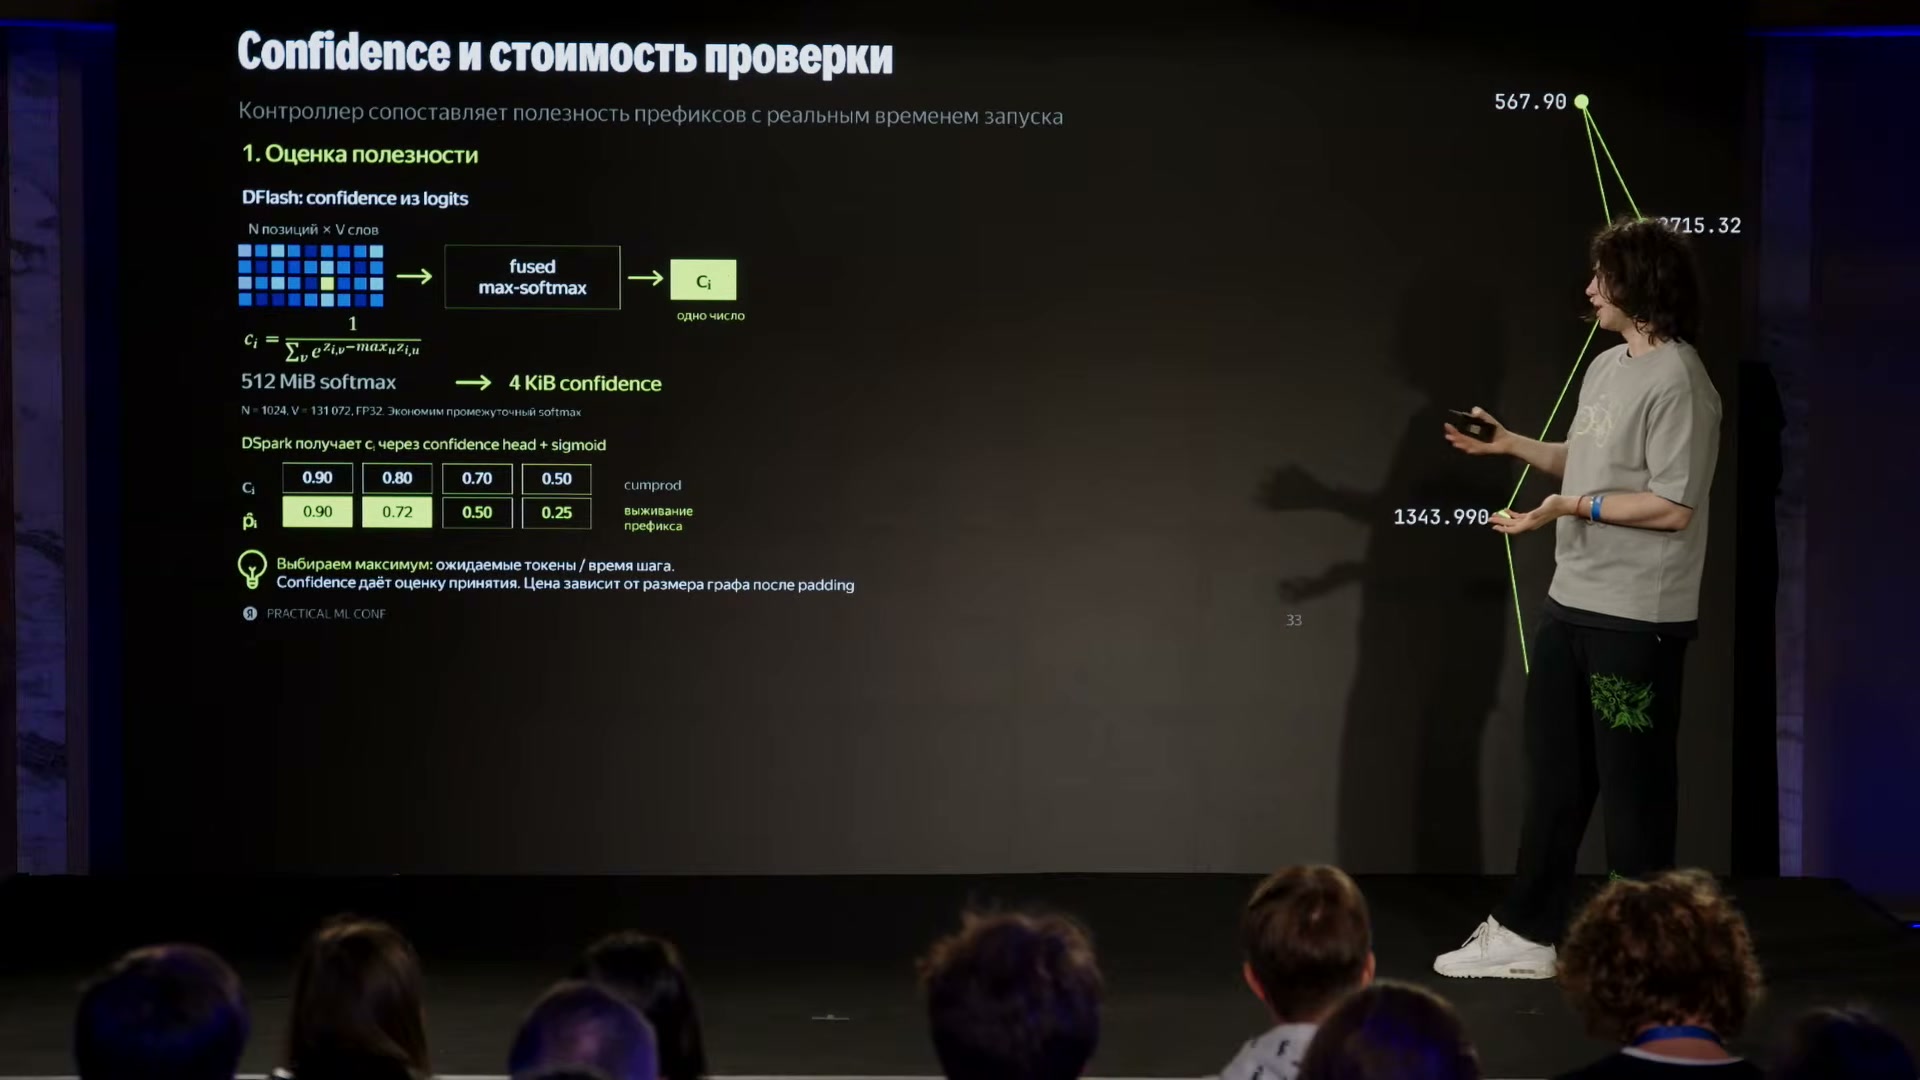
DFlash получает уверенность через fused max-softmax, DSpark — через отдельный выходной модуль. В примере N=1024, V=131072, FP32 промежуточные 512 MiB softmax заменяются вектором confidence размером 4 KiB.
Источник: Станислав ИлюшинРеальная стоимость меняется ступенями, а не по одному токену
Для выбора выгодного бюджета нужно знать реальное время исполнения. В движке оно зависит от подготовленных графов вычислений. Граф сохраняет последовательность операций и используемые буферы, чтобы затем воспроизводить вычисление с меньшим числом управляющих запусков со стороны CPU. На GPU в докладе используются CUDA Graphs, а для Ascend обсуждается соответствующий графовый путь.
Подготовленные графы рассчитаны на определённые размеры входа. Эти варианты размеров называются graph buckets. Если фактический вход меньше подходящего размера графа, его дополняют до этого размера — выполняют padding. Поэтому два разных количества полезных позиций могут приводить к запуску одного и того же графа.
На слайде приведён наглядный пример: и 184, и 160 входных токенов основной модели используют граф размера 192. Удаление 24 позиций в таком случае само по себе не переводит запуск на более дешёвую ступень. А 128 токенов уже позволяют выбрать меньший граф. Контроллеру важно учитывать именно этот переход, а не считать стоимость линейной функцией числа оставленных кандидатов.
Профиль времени подготовленных размеров измеряется при старте. На его основе контроллер сопоставляет ожидаемое число полезных токенов со стоимостью фактически выбранного запуска после дополнения. Ступенчатая линия на слайде показывает устройство такой зависимости: это схема стоимости, а не отдельный график измеренных задержек.
В устном примере при максимальном батче 64 и девяти кандидатах размер проверки достигает 64 × (9 + 1) = 640 позиций. Если среди подготовленных размеров есть 32, 64 и 128, бюджет 65 уже требует перехода к большему графу. Альтернативой становится выполнение без подходящего полного графа, но у него есть собственная цена управляющих запусков. Именно поэтому удаление невыгодных кандидатов и ускорение фактического выполнения — не одно и то же действие.
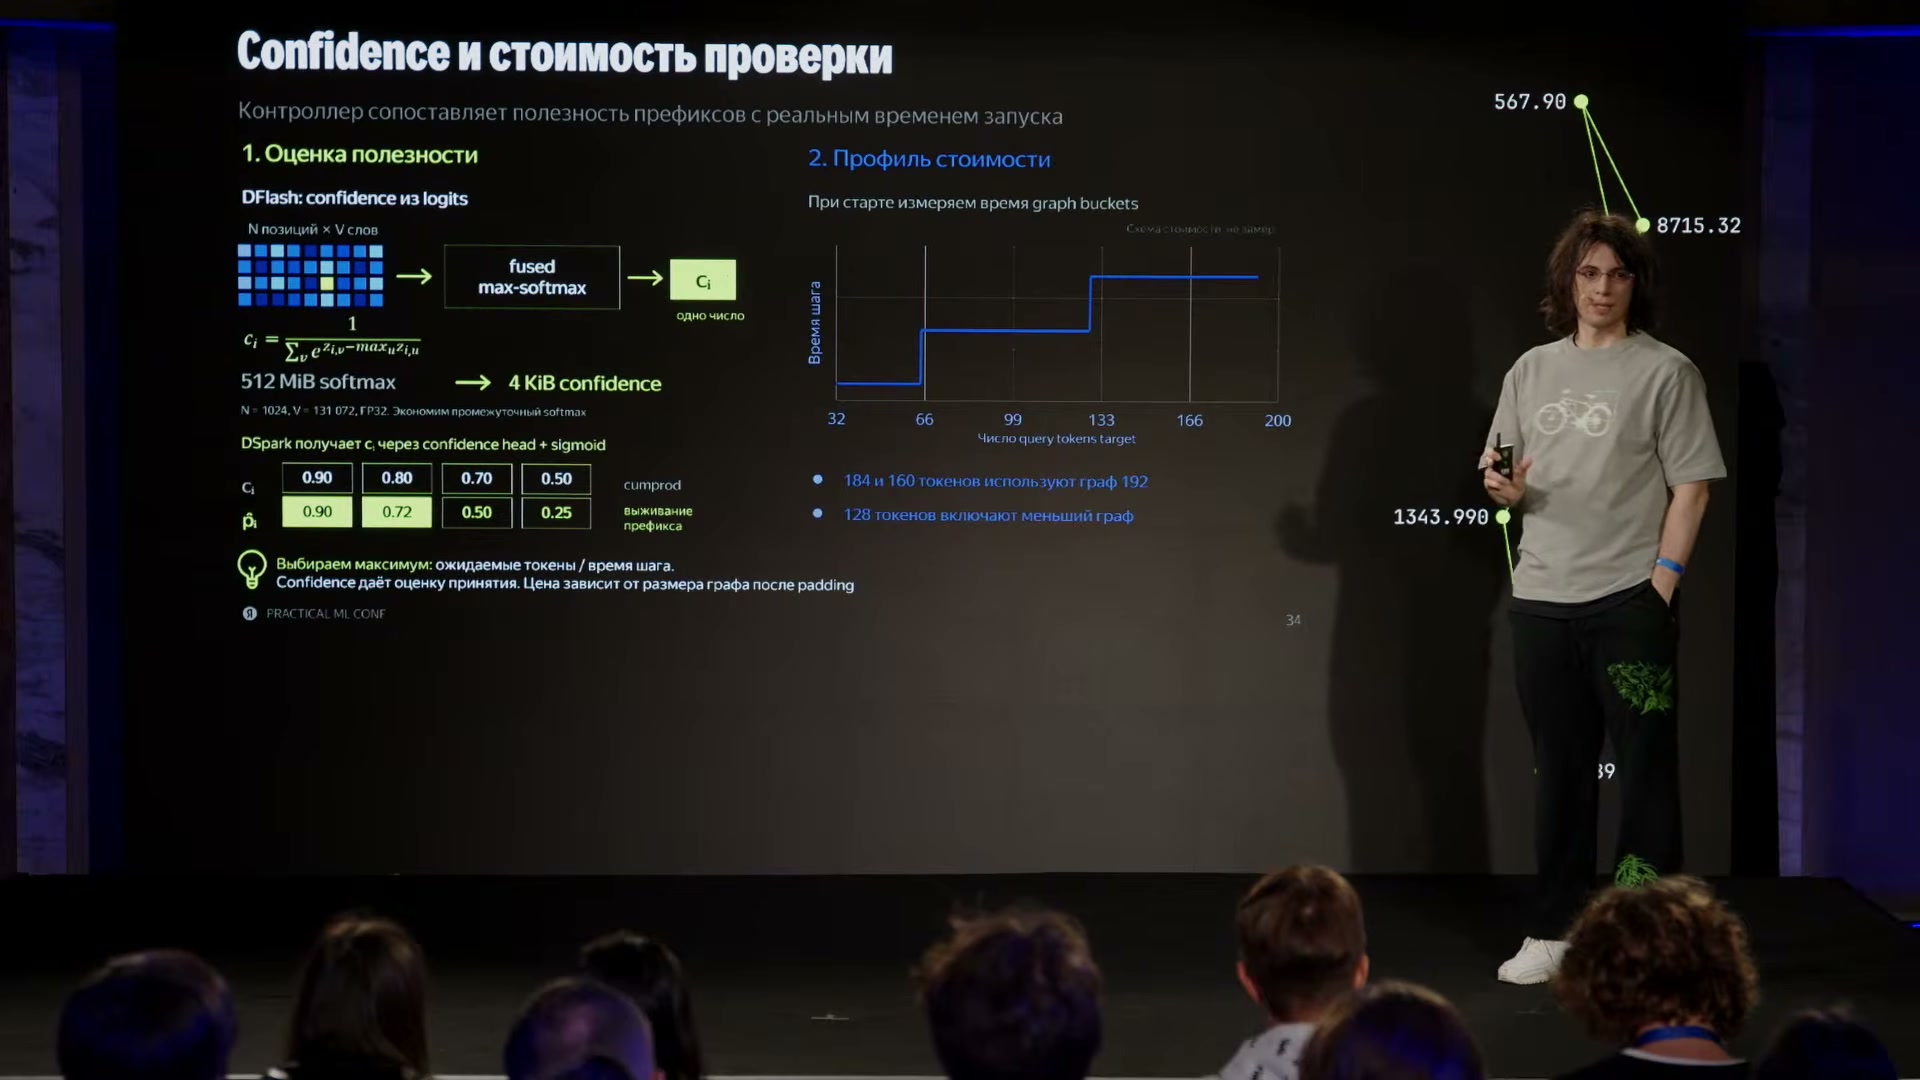
Стоимость определяется графом после дополнения входа. И 184, и 160 токенов используют граф 192, тогда как 128 токенов переводят вычисление на меньший граф.
Источник: Станислав ИлюшинОтдельный графовый путь DSpark: выигрыш, который не вошёл в основную ветку
Последний эпизод интеграции начинается с различия между Eager и FULL. В режиме Eager отдельные вычислительные ядра запускаются управляющими вызовами с CPU. В FULL заранее подготовленная последовательность воспроизводится одним запуском графа. На схеме внутри FULL по-прежнему видны отдельные kernel 1, kernel 2 и attention: сокращается управление их запуском, а не исчезают сами операции.
У DFlash для трёх кандидатов нужны четыре входные позиции: опорный токен и три маски. Кандидаты извлекаются из выходов масок. DSpark обучен иначе: первый кандидат можно получить уже из позиции опорного токена. Поэтому для тех же трёх кандидатов ему достаточно трёх входных позиций — опорного токена и двух масок.
Из-за этого размер входа DSpark короче на одну позицию на запрос. Основная модель для проверки по-прежнему использует K+1 позиций, а драфтер DSpark — K. Прежний общий диспетчер графов, то есть компонент выбора подготовленного графа, передавал одинаковые размеры обеим частям. Когда размеры разошлись, это стало препятствием для полного графового пути драфтера.
Команда разделила диспетчеры основной модели и DSpark. В примере со слайда B=16 и K=7. Проверка основной модели использует 16 × 8 = 128 входных позиций, а проход драфтера — 16 × 7 = 112. При этом контекст для драфтера сохраняет 128 скрытых состояний основной модели. Размер нового блока и объём доступного контекста здесь снова выполняют разные роли.
По рассказу автора, такая доработка дала 10% ускорения. Полные условия этого отдельного измерения не приведены. Изменение затрагивало около десяти ключевых файлов, включая компонент выполнения модели и управление графами. Сопровождающие проект разработчики сочли объём переработки и будущей поддержки слишком большим, поэтому предложенное изменение не приняли в основную ветку.
Это не история отсутствующего прототипа: команда реализовала решение и получила локальный результат. Но измеренный выигрыш остался результатом предложенной доработки, а не выпущенной общей оптимизацией vLLM. В открытом движке стоимость сопровождения оказалась отдельным ограничением, наряду со стоимостью вычислений.
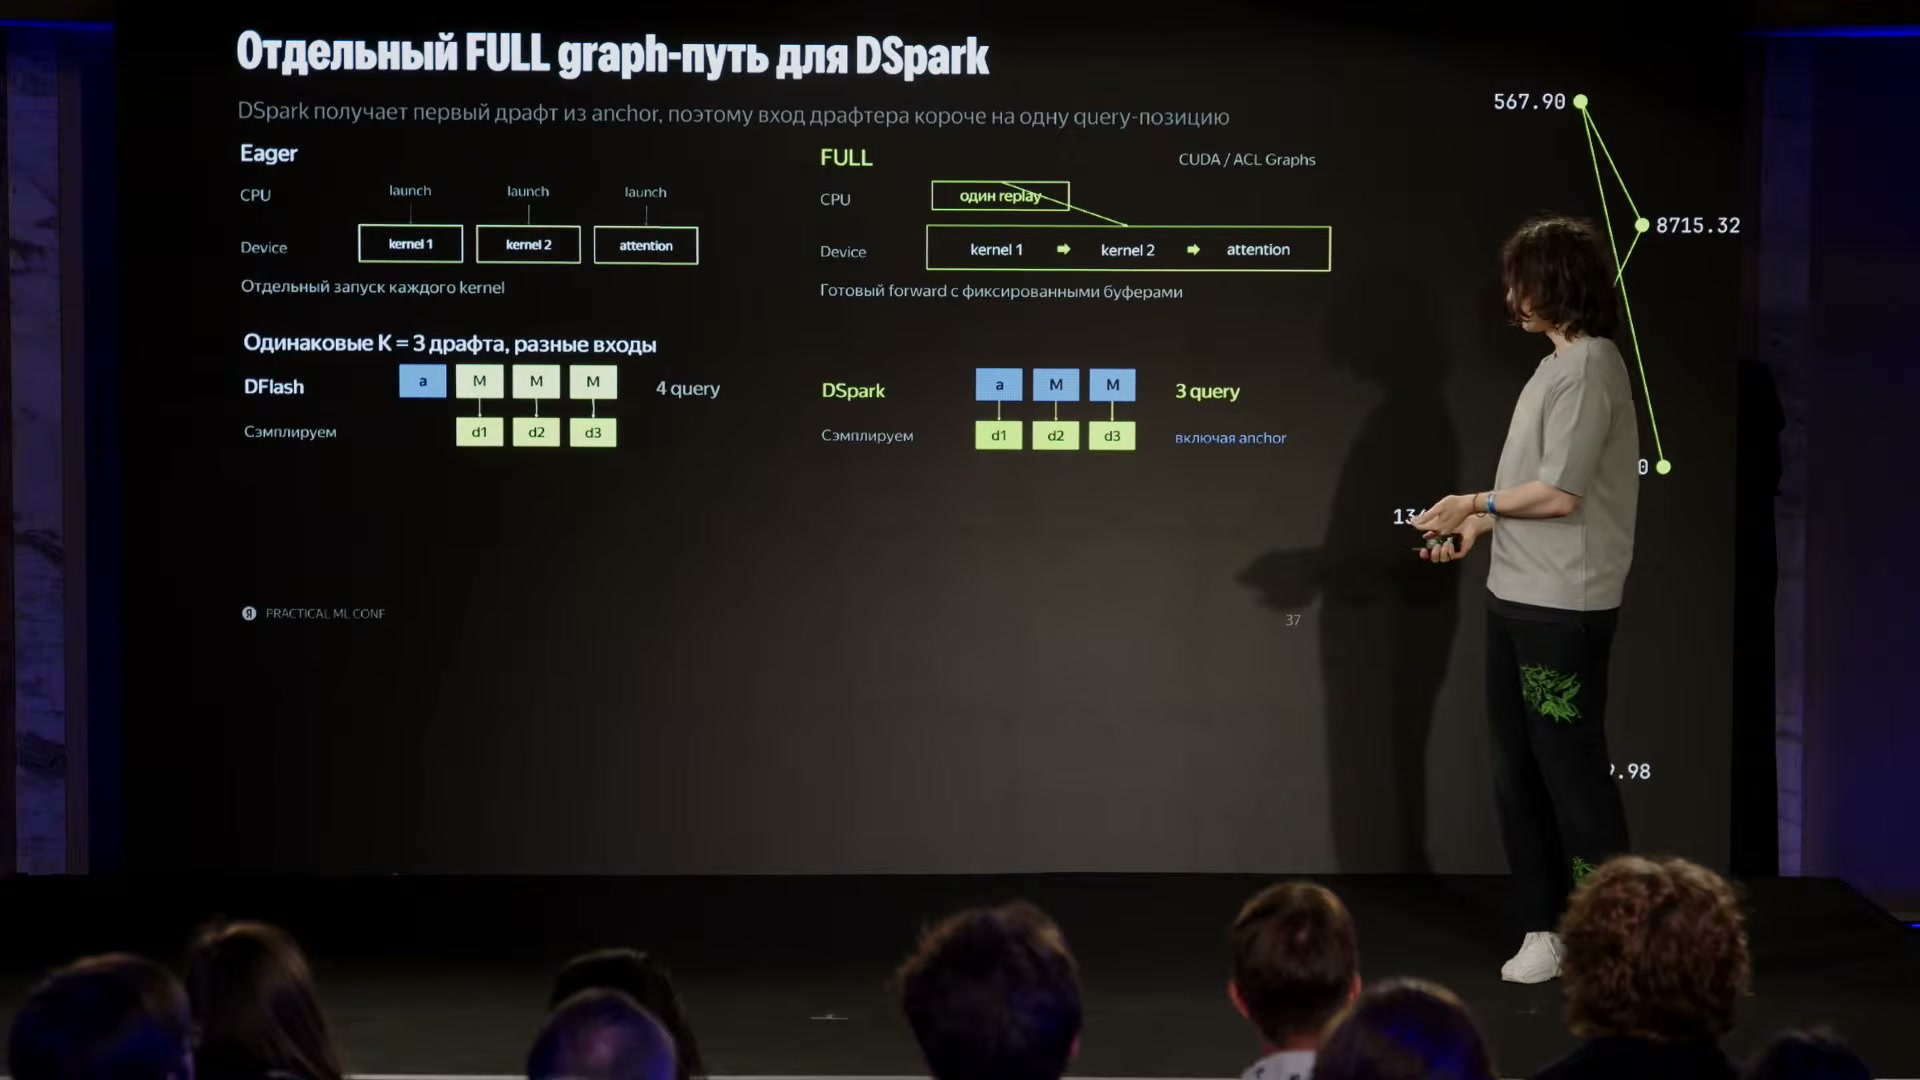
Для трёх кандидатов DFlash обрабатывает четыре входные позиции, а DSpark — три, поскольку использует выход опорного токена. FULL воспроизводит подготовленную последовательность ядер одним запуском графа.
Источник: Станислав Илюшин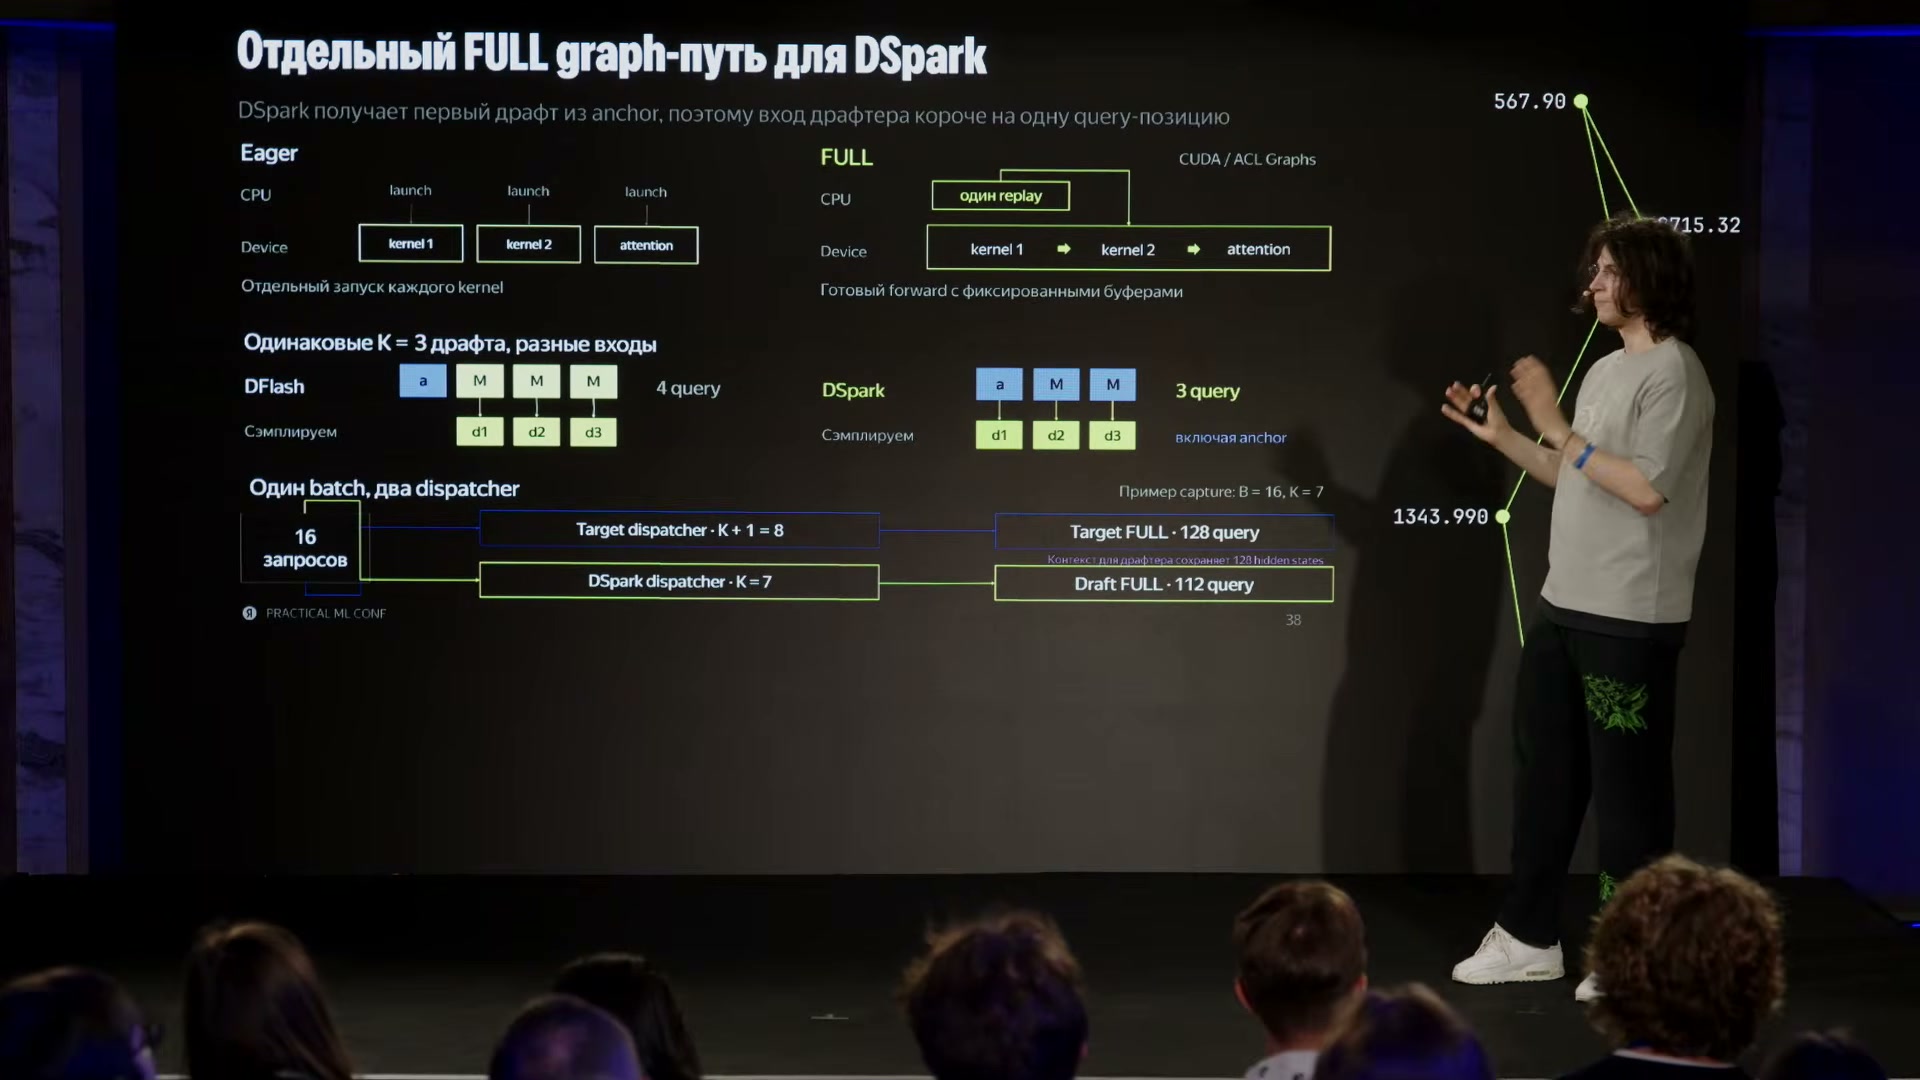
В предложенном разделении диспетчеров при B=16 и K=7 основная модель использует граф на 128 входных позиций, DSpark — на 112. Эта доработка не вошла в основную ветку.
Источник: Станислав ИлюшинАрхитектуру ещё нужно суметь обучить
В ответах на вопросы обсуждение возвращается от движка к обучению. Команда исследовала изменение числа слоёв DSpark и наблюдала улучшение качества при увеличении глубины. Говоря об этом масштабировании, автор связывает результат прежде всего с acceptance length. Подробный разбор экспериментов он относит к возможной будущей статье.
При этом главным ограничением он называет рецепт обучения. По его оценке на момент выступления, официальные коды обучения DFlash и DSpark не были опубликованы, а воспроизвести качество исходного DSpark удалось ограниченному числу команд. Huawei приводится как пример такого воспроизведения.
EAGLE автор считает более простым для обучения. Для DFlash, DSpark и DFlash2 получение удачных весов само по себе остаётся заметной работой: преимущества схемы на рисунке становятся доступными только после успешного обучения. Полного рецепта — состава данных, всех целей обучения и настроек — доклад не раскрывает. Этот процесс происходит отдельно от описанной выше генерации и проверки кандидатов.
Ещё один вопрос касался выбора скрытых состояний основной модели, передаваемых драфтеру. Автор связал обсуждаемый вариант с движком AngelSlim. Идеи адаптации для vLLM и Ascend у команды были, но их отложили ради более приоритетных задач. Это направление осталось планом интеграции, а не частью измеренного решения.
Доклад · 02:49:51Какие ограничения остались у моделей с другим состоянием
В последней части вопросов обсуждаются GDN — слои, для которых движок должен отдельно обслуживать состояние и специальные вычислительные операции. Это добавляет ещё один уровень интеграции: правильной подготовки обычного кеша внимания уже недостаточно.
Первая проблема осталась нерешённой. Динамическая проверка DSpark отправляет разное число кандидатов для разных запросов. В описанных автором реализациях необходимые операторы GDN не поддерживали этот режим ни на GPU, ни на NPU. Поэтому уже работающий контроллер длины не обеспечивал готового запуска такой связки на моделях с GDN. Доработкой операторов занималась другая команда.
Вторая проблема касалась группировки слоёв и была исправлена. Прежний механизм объединял слои в общую группу, но для GDN и полного внимания требовалась разная организация. При первоначальном запуске такое объединение нарушило индексацию и привело к ошибке работы с памятью. Команда стала формировать отдельные группы для соответствующих слоёв, после чего эта часть заработала.
Эти результаты относятся к разным уровням системы: исправленная адресация не снимает ограничения на динамическую длину проверки. Автор также отмечает наличие сторонних весов DSpark и предполагает, что некоторые из них могли проверяться на собственных ядрах или в другом способе выполнения. Его замечание относится к совместимости с обсуждаемым движком, а не к измеренной оценке всех таких моделей.
Дальнейшую работу команда связывала с поддержкой динамики для GDN, KDA и моделей Mamba. Ожидание продвижения в ближайшие месяцы прозвучало как прогноз. На момент доклада подтверждённый итог этой части — исправленная группировка памяти и оставшаяся потребность в новых возможностях операторов.
Доклад · 02:51:57Итог: быстрый драфтер и быстрый шаг генерации — разные задачи
Команда Huawei прошла путь от поддержки блочных драфтеров к настройке всего шага генерации. DFlash сокращал число последовательных проходов, DSpark улучшал согласованность кандидатов, а динамический бюджет убирал слишком дорогие позиции. Для этого пришлось разделить контекст и временный блок, подготовить адреса всех токенов заранее и связать выбор длины с реальной стоимостью проверки. Следующими ограничениями стали ожидание данных на CPU и размеры подготовленных графов исполнения.
- 01
Получить контекст
Основная модель передаёт скрытые состояния обработанного текста и опорный токен. Драфтер получает из этих состояний постоянный контекст своего внимания.
- 02
Подготовить блок
Движок формирует входные позиции драфтера и назначает им индексы и адреса кеша, учитывая переходы между физическими страницами памяти.
- 03
Предложить кандидатов
Драфтер обрабатывает позиции совместно. DSpark дополнительно уточняет предсказания; модель или отдельный выходной модуль формирует оценки уверенности в кандидатах.
- 04
Выбрать проверяемые префиксы
Контроллер сопоставляет ожидаемое принятое продолжение со стоимостью запуска. Он выбирает длины префиксов, а смещения задают границы запросов в общем массиве.
- 05
Проверить и продолжить
Основная модель проверяет выбранные кандидаты. Принятое продолжение и дополнительный токен становятся основой следующего цикла; обучение в этот процесс не входит.
В измерении V1 при батче 256 DSpark достиг 3120 токенов/с с динамическим бюджетом против 2614 при фиксированном K=9 и 2411 у основной модели. Асинхронная V2 была реализована, но ещё не измерена. Отдельную оптимизацию графов с заявленными 10% ускорения не приняли в основную ветку. Оставались воспроизводимость обучения и поддержка динамических длин операторами GDN. Итог зависит от сочетания модели, нагрузки и движка: высокая доля принятия полезна тогда, когда её удаётся превратить в более дешёвый выходной токен.
Доклад · 02:18:31