Разбор готов
Авито — развитие трансформерного item-энкодера
На главной Авито рекомендательная система должна выбрать подходящие пользователю объявления из большого каталога. Сначала она отбирает кандидатов, а затем упорядочивает их. Один из компонентов отбора превращает признаки объявления в числовое представление — его называют item-энкодером. Команда хотела научить этот компонент лучше учитывать связи между признаками, сохранив обучение без отдельного запоминаемого вектора для каждого объявления. Однако заменить архитектуру оказалось недостаточно: сначала пришлось исправить подготовку данных и стабилизировать обучение, затем разобраться с расходом памяти, компиляцией и устройством вычислений на видеокарте. Разберём весь этот путь до проверки новой модели в A/B-тесте, включая неудачные эксперименты и условия, в которых сработали оптимизации.
Материал полезен инженерам рекомендательных систем и ML-инженерам, которые знакомы с обучением нейросетей и хотят понять, как развивается отдельный компонент большой модели. Здесь особенно важны диагностика нестабильности, выбор между скоростью и памятью и проверка того, как несколько полезных изменений взаимодействуют друг с другом.
Видео · на русском
Как мы развивали трансформерный item-энкодер в рекомендательной моделиДмитрий Веснин · Опубликовано: 19 сентября 2026 г.
Исходный доклад · Открыть оригинал
Какую часть рекомендаций меняла команда
Основа главы — доклад Дмитрия Веснина «Как мы развивали трансформерный item-энкодер в рекомендательной модели» на Practical ML Conf 2026. Это история команды Авито: от постановки задачи и исправления обучения до разработки нового энкодера и продуктового эксперимента. Основной рассказ занимает отрезок 02:17:03–02:47:28; ограничения дополнительно обсуждаются в ответах на вопросы до 02:51:04.
В описанной системе рекомендации строятся в два этапа. Сначала модель отбора кандидатов сокращает миллионы доступных объектов до сотен или тысяч подходящих пользователю объявлений. Затем начинается ранжирование — упорядочивание выбранных кандидатов. Работа команды относится к первому этапу.
Модель отбора учитывает последовательность действий пользователя и состоит из двух основных частей. Item-энкодер превращает признаки объявления в векторное представление, или эмбеддинг. Энкодер пользователя получает последовательность таких векторов из истории и строит представление самого пользователя. Обучение должно сделать этот вектор близким к представлениям объявлений, с которыми у пользователя возможны положительные взаимодействия — действия, считающиеся целевыми в задаче.
На схеме обучения хорошо видны две ветви. По верхней признаки исторических объявлений проходят через item-энкодер и превращаются в векторы e₁, …, eₜ. Энкодер пользователя обрабатывает эту последовательность и возвращает вектор u. По нижней признаки следующего положительного объявления проходят через тот же item-энкодер, образуя вектор e₊. Векторы u и e₊ поступают в функцию потерь L(u, e₊) — численную оценку ошибки, которую обучение старается уменьшить.
Следующее положительное объявление в этой схеме служит ответом для обучения, а не частью входной истории пользователя. Обе ветви используют общий способ кодирования объектов, поэтому представления исторических и целевых объявлений согласуются между собой. Подробнее то, с какими отрицательными примерами сравнивается положительный объект, станет важно при разборе ошибок данных.
В исходной модели item-энкодер был построен на архитектуре DCNv2, а энкодер пользователя — на трансформере. Трансформер связывает элементы последовательности так, чтобы представление каждого могло учитывать другие элементы. Команда решила изменить именно построение вектора объявления, сохранив общую последовательность: представления объектов, представление пользователя, отбор кандидатов.
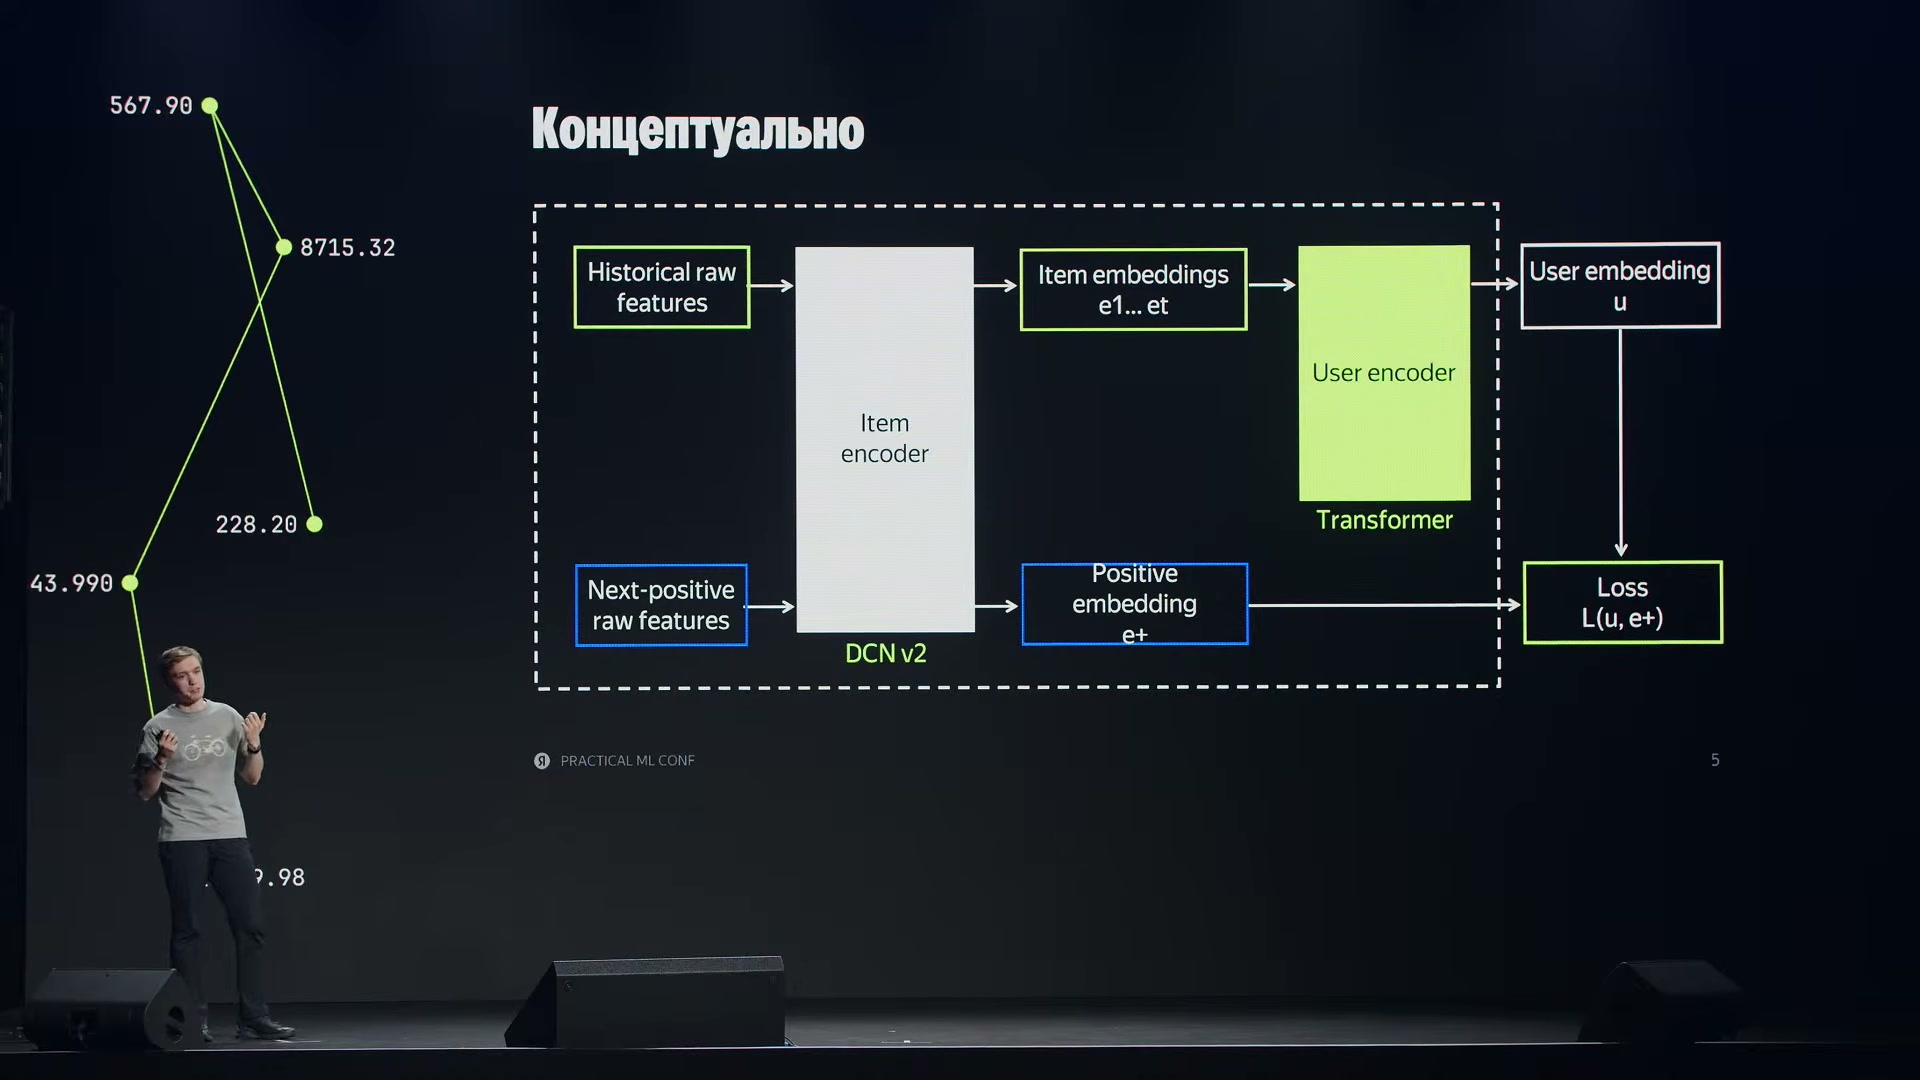
Общая схема обучения: один item-энкодер строит векторы исторических объявлений и следующего положительного объекта. История проходит через user-энкодер, а векторы пользователя и целевого объекта встречаются в функции потерь.
Источник: Дмитрий Веснин, Авито · Practical ML Conf 2026Почему решили отказаться от DCNv2
Чтобы объяснить выбор архитектуры, докладчик сначала сравнивает три способа обучать item-энкодер. Ключевое различие — откуда он получает знания об объявлении и меняются ли его параметры вместе с остальной рекомендательной моделью. Совместное обучение компонентов под итоговую задачу называется сквозным, или end-to-end.
Таблицу можно прокрутить по горизонтали.
Команда использовала третий вариант: item-энкодер обучался совместно с энкодером пользователя и не получал отдельную обучаемую память по item ID — идентификатору объявления. В качестве признаков для такого подхода автор называет текст, изображения и атрибуты. Идея состоит в том, чтобы извлекать полезные закономерности из свойств объекта, а не опираться на уже выученный вектор знакомого объявления.
В этой постановке выразительность энкодера особенно важна. Модель должна распознавать полезные сочетания признаков: одного присутствия каждого признака по отдельности может быть недостаточно. В исходной схеме DCNv2 входной вектор признаков проходил через несколько слоёв взаимодействий, Cross Layers, затем через полносвязную нейронную сеть, MLP, и выходное преобразование Project, после которого получался вектор объявления.
Слой взаимодействий сочетает исходный вектор признаков с преобразованным результатом предыдущего слоя. На слайде это записано как xₗ₊₁ = x₀ ⊙ (Wₗxₗ + bₗ) + xₗ. Здесь x₀ — исходные признаки, xₗ — вход текущего слоя, Wₗ и bₗ — обучаемые параметры, а ⊙ означает поэлементное умножение. Последнее слагаемое возвращает в результат вход слоя. Такая конструкция явно создаёт взаимодействия исходных признаков с уже вычисленными представлениями.
Другой способ связать признаки — механизм внимания, attention. Он позволяет каждой позиции входа учитывать информацию других позиций. В предложенной замене признаки представлены последовательностью входных векторов — токенов признаков. Несколько слоёв трансформера обрабатывают эту последовательность, а специальная позиция CLS собирает итоговое представление объявления.
Здесь важно различать две последовательности. Внутри item-энкодера находятся токены признаков одного объявления. На входе энкодера пользователя — векторы разных объявлений из истории. Команда меняла обработку первой последовательности, чтобы улучшить представления, из которых затем строится вторая.
Так появилась гипотеза заменить DCNv2 трансформерным энкодером. Но в существующем обучении уже были проблемы стабильности и скорости. Более сложная архитектура добавила бы новые причины сбоев, поэтому сначала решили разобраться с исходной системой.
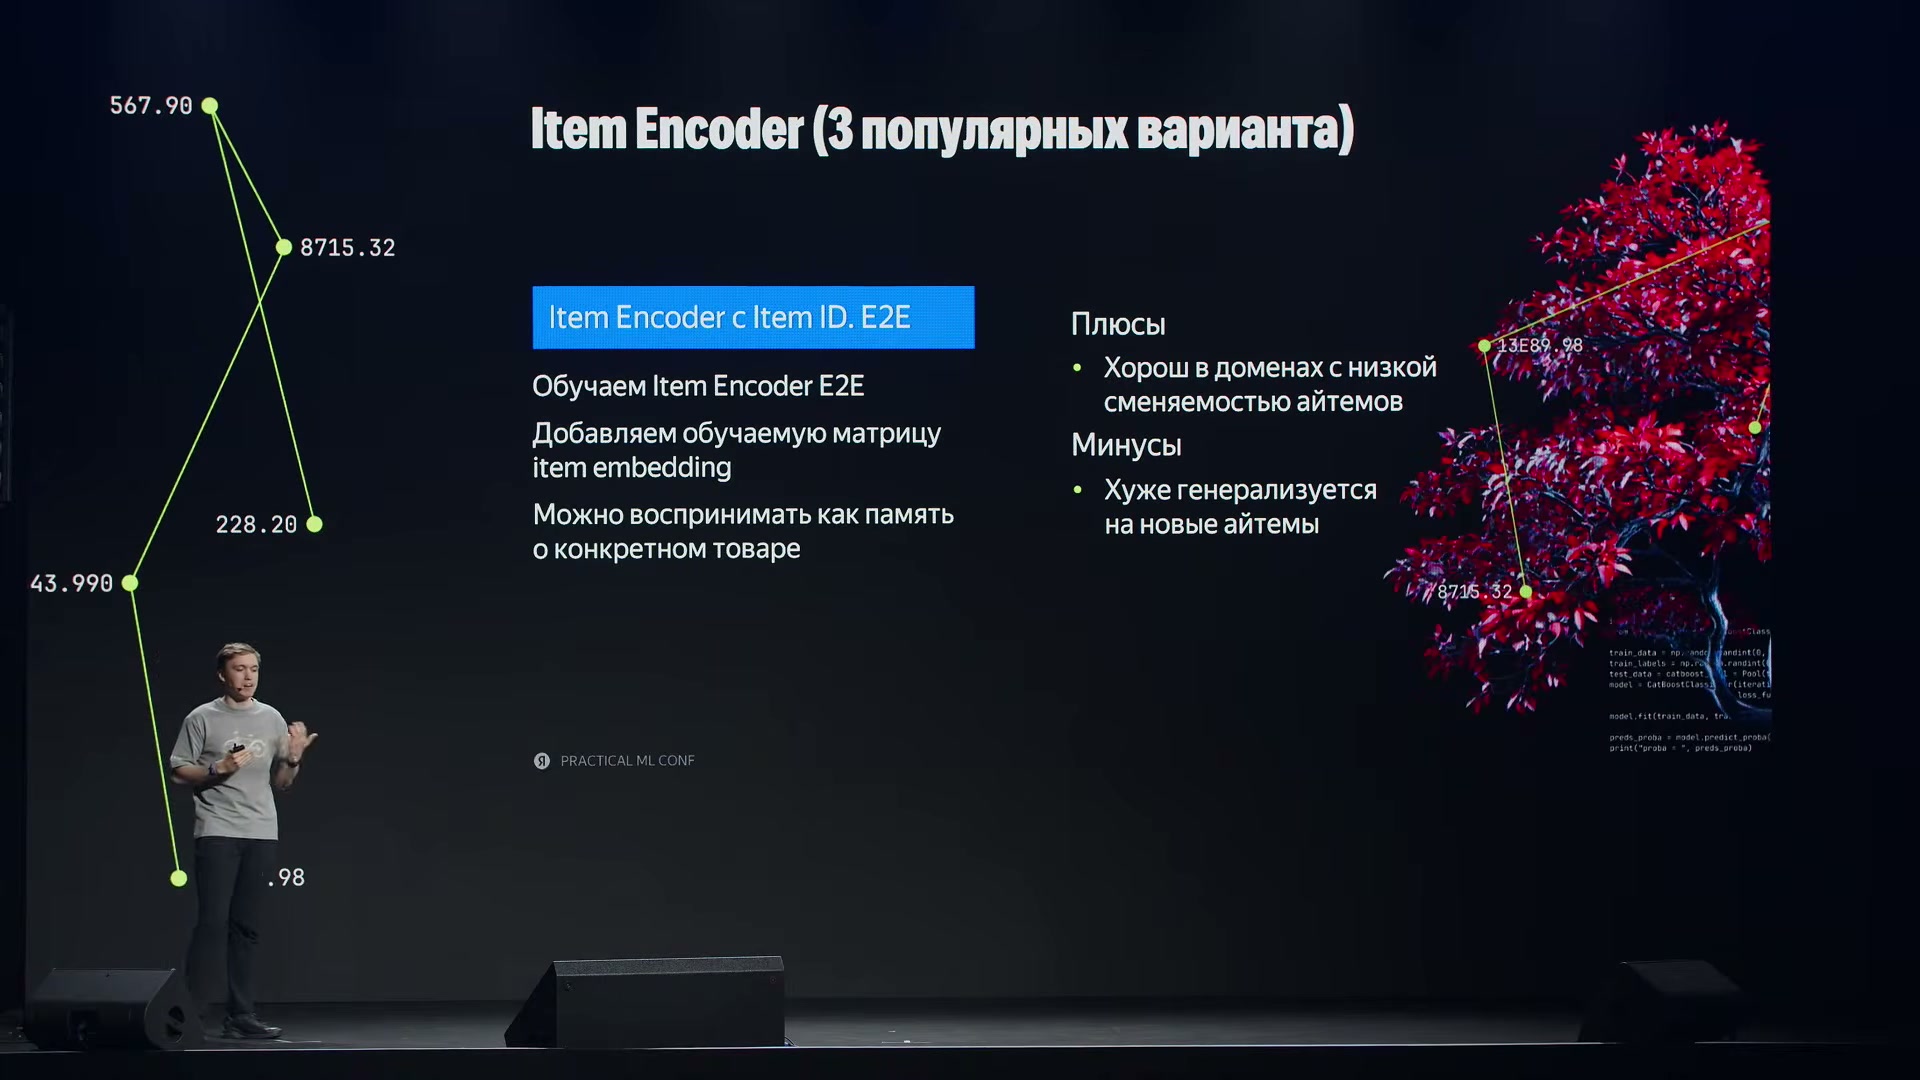
Обучаемая таблица векторов добавляет память о конкретных объектах. Команда выбрала другую постановку — совместное обучение только по признакам, без отдельного вектора для каждого item ID.
Источник: Дмитрий Веснин, Авито · Practical ML Conf 2026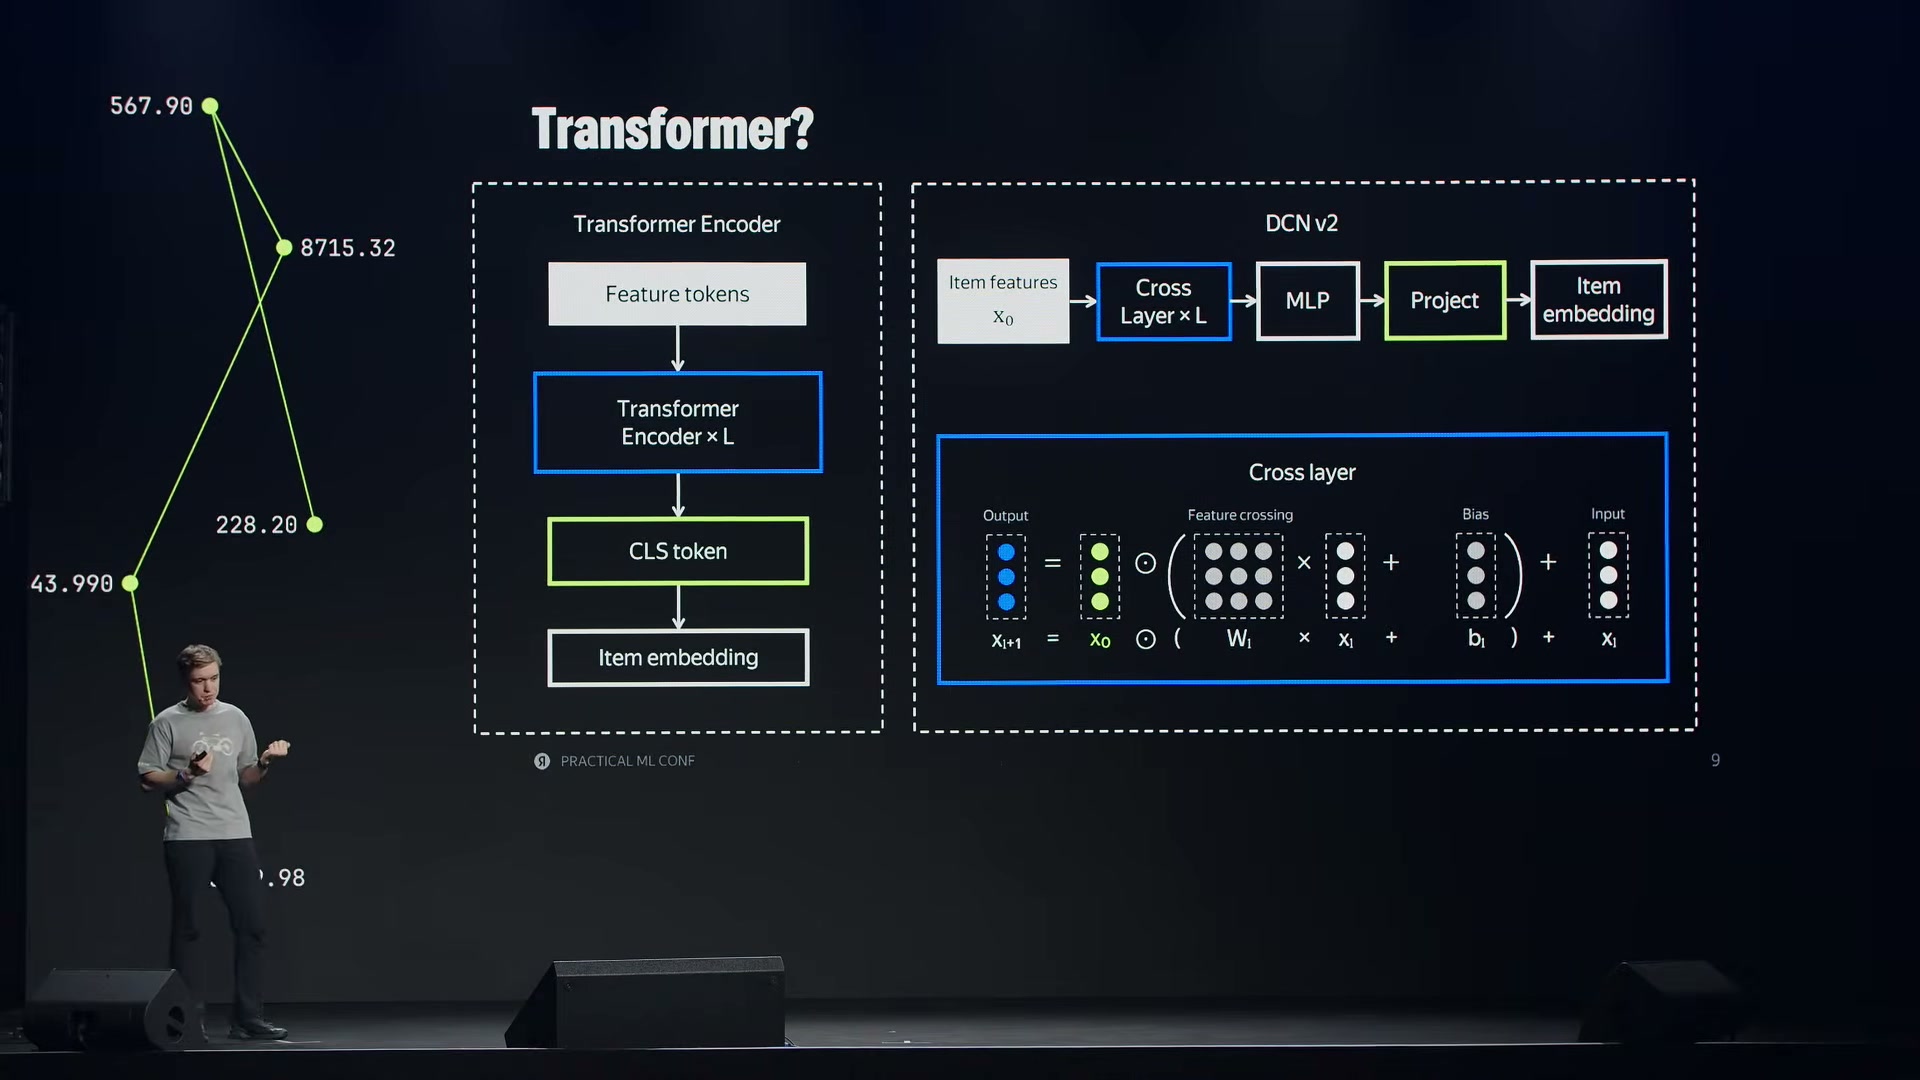
Два способа связать признаки объявления. DCNv2 использует Cross Layers, MLP и выходное преобразование; трансформер обрабатывает токены признаков и собирает итоговый вектор в CLS.
Источник: Дмитрий Веснин, Авито · Practical ML Conf 2026Что обнаружили после отключения ограничения градиентов
Первым объектом проверки стало ограничение градиентов, gradient clipping. Градиенты показывают, как менять параметры модели, чтобы уменьшать ошибку. Ограничение не позволяет слишком большим значениям бесконтрольно влиять на обновление параметров. В исходном обучении оно помогало справляться с резкими выбросами, но оставляло открытым вопрос, почему эти выбросы возникали.
Команда отключила ограничение и примерно около десятитысячного шага увидела резкий скачок функции потерь, после которого обучение уже не восстанавливалось. Вместо немедленного возвращения прежней настройки инженеры добавили сохранение данных и промежуточных числовых массивов — тензоров — в моменты сбоев. Это позволило перейти от наблюдения графика к исследованию конкретных обучающих примеров.
Причину автор объясняет на двух строках одного пакета обучающих примеров, или batch. В обеих строках находится одинаковая история пользователя: A → B → C. В разобранном примере такие истории дают одинаковые векторы пользователя, u₁ = u₂. Следующий объект собственной строки функция потерь считает положительным примером, а следующие объекты других строк пакета использует как отрицательные — объекты, которые модель должна оценивать ниже.
Если строки дублируются, один и тот же объект D оказывается положительным примером в своей строке и отрицательным для её копии. Это ложный отрицательный пример: объект подходит пользователю, но обучение требует снизить его оценку. При этом модель уже может быть уверена, что D — хороший кандидат.
На слайде уверенность показана численно. Оценку пары до преобразования называют логитом; сигмоида переводит её в число p от 0 до 1. Для обеих копий D получается p = 0,99. Однако вклад в функцию потерь зависит ещё и от метки: положительный пример штрафуется через −log(p), отрицательный — через −log(1 − p).
Таблицу можно прокрутить по горизонтали.
Вместо небольшого штрафа за правильный уверенный ответ модель получает большой штраф за тот же объект с ошибочной меткой. Когда таких противоречий накапливалось достаточно много, команда наблюдала разрушительный скачок функции потерь. Этот пример показывает вклад отдельных пар; общая организация функции потерь в докладе подробно не раскрывается.
За появлением одинаковых историй стояли две ошибки подготовки данных. Недостаточное перемешивание набора приводило к тому, что в один пакет попадало несколько историй одного пользователя. Дополнительно в источнике данных были повторяющиеся события, из-за которых дублировалось содержимое самих историй. Вместе эти ошибки существенно повышали вероятность срыва.
После исправления обеих ошибок самые тяжёлые скачки исчезли. Однако некоторая нестабильность сохранилась. Команда устранила конкретный источник противоречивых примеров, но следующий этап исследования уже относился к тому, как обновляются параметры модели.
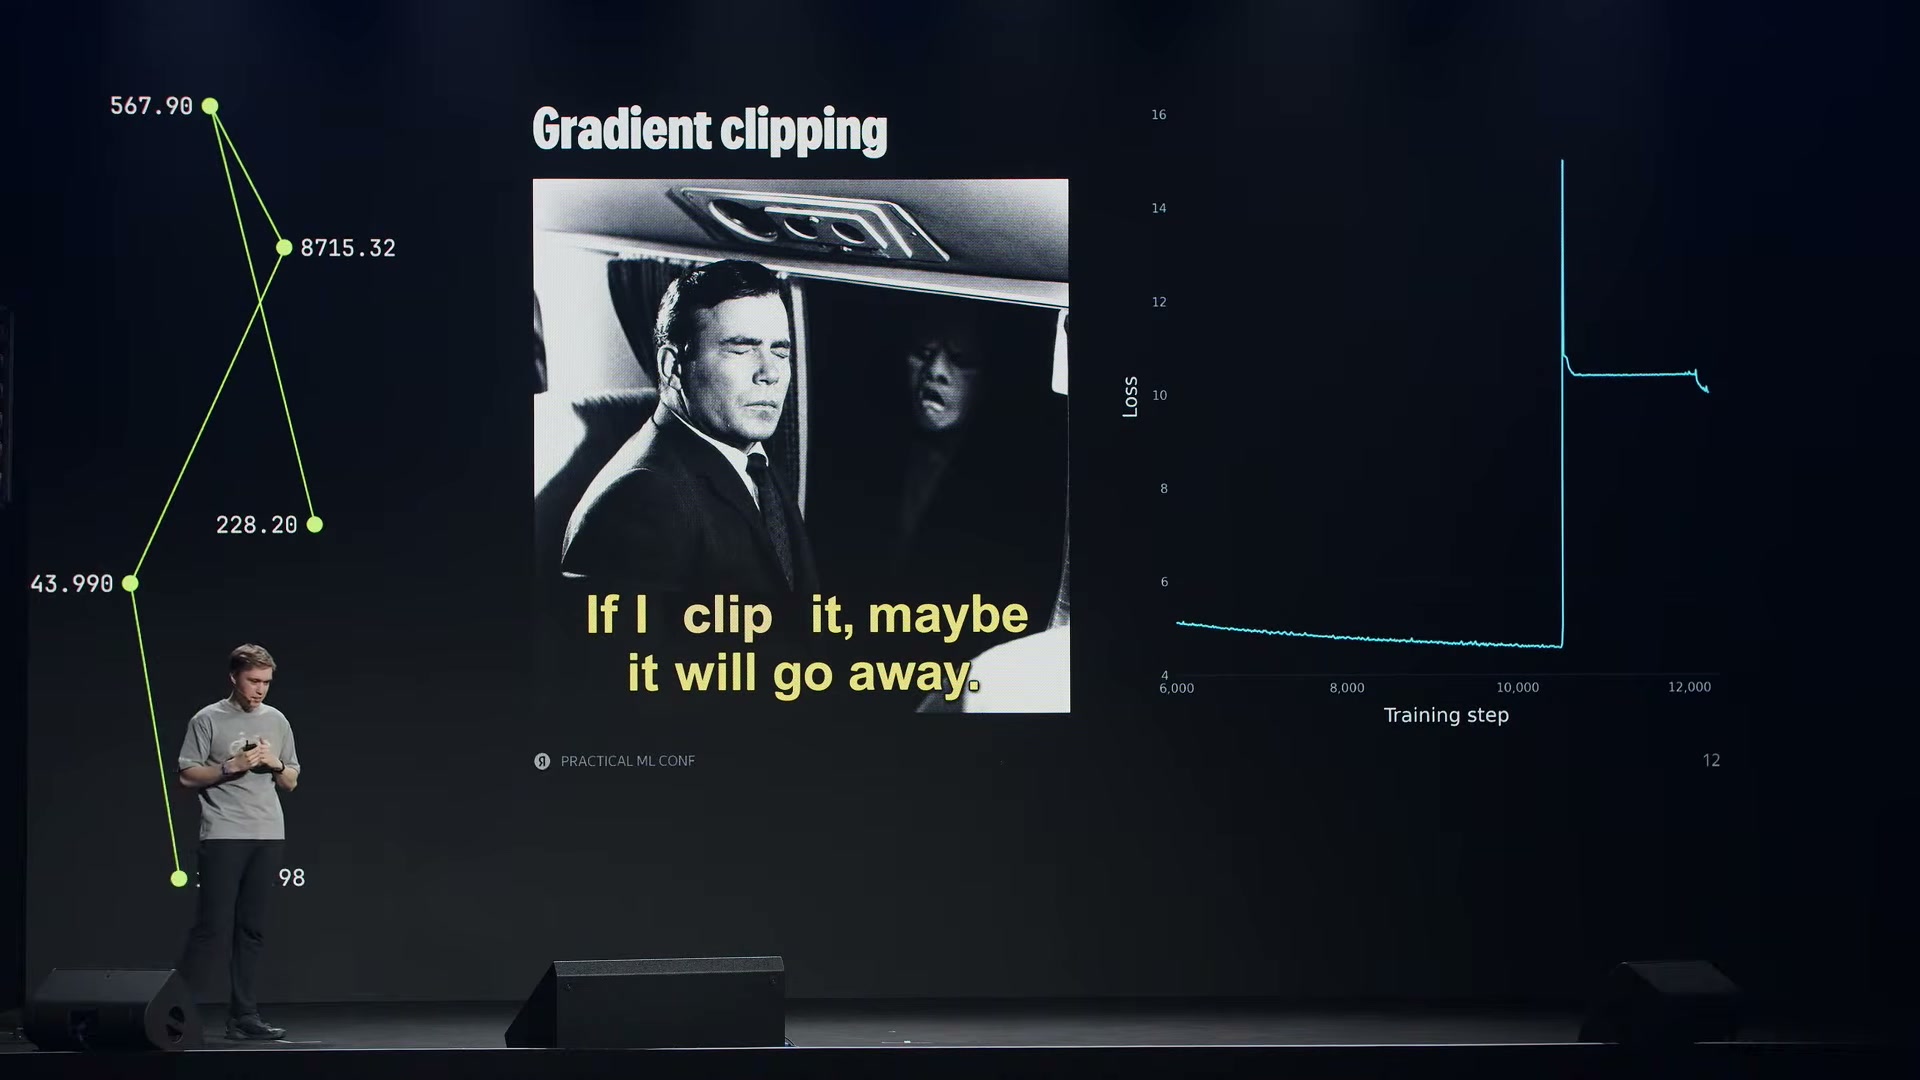
После отключения ограничения градиентов примерно около десятитысячного шага возникает скачок функции потерь. Исследование данных в момент срыва вывело команду на ошибки подготовки примеров.
Источник: Дмитрий Веснин, Авито · Practical ML Conf 2026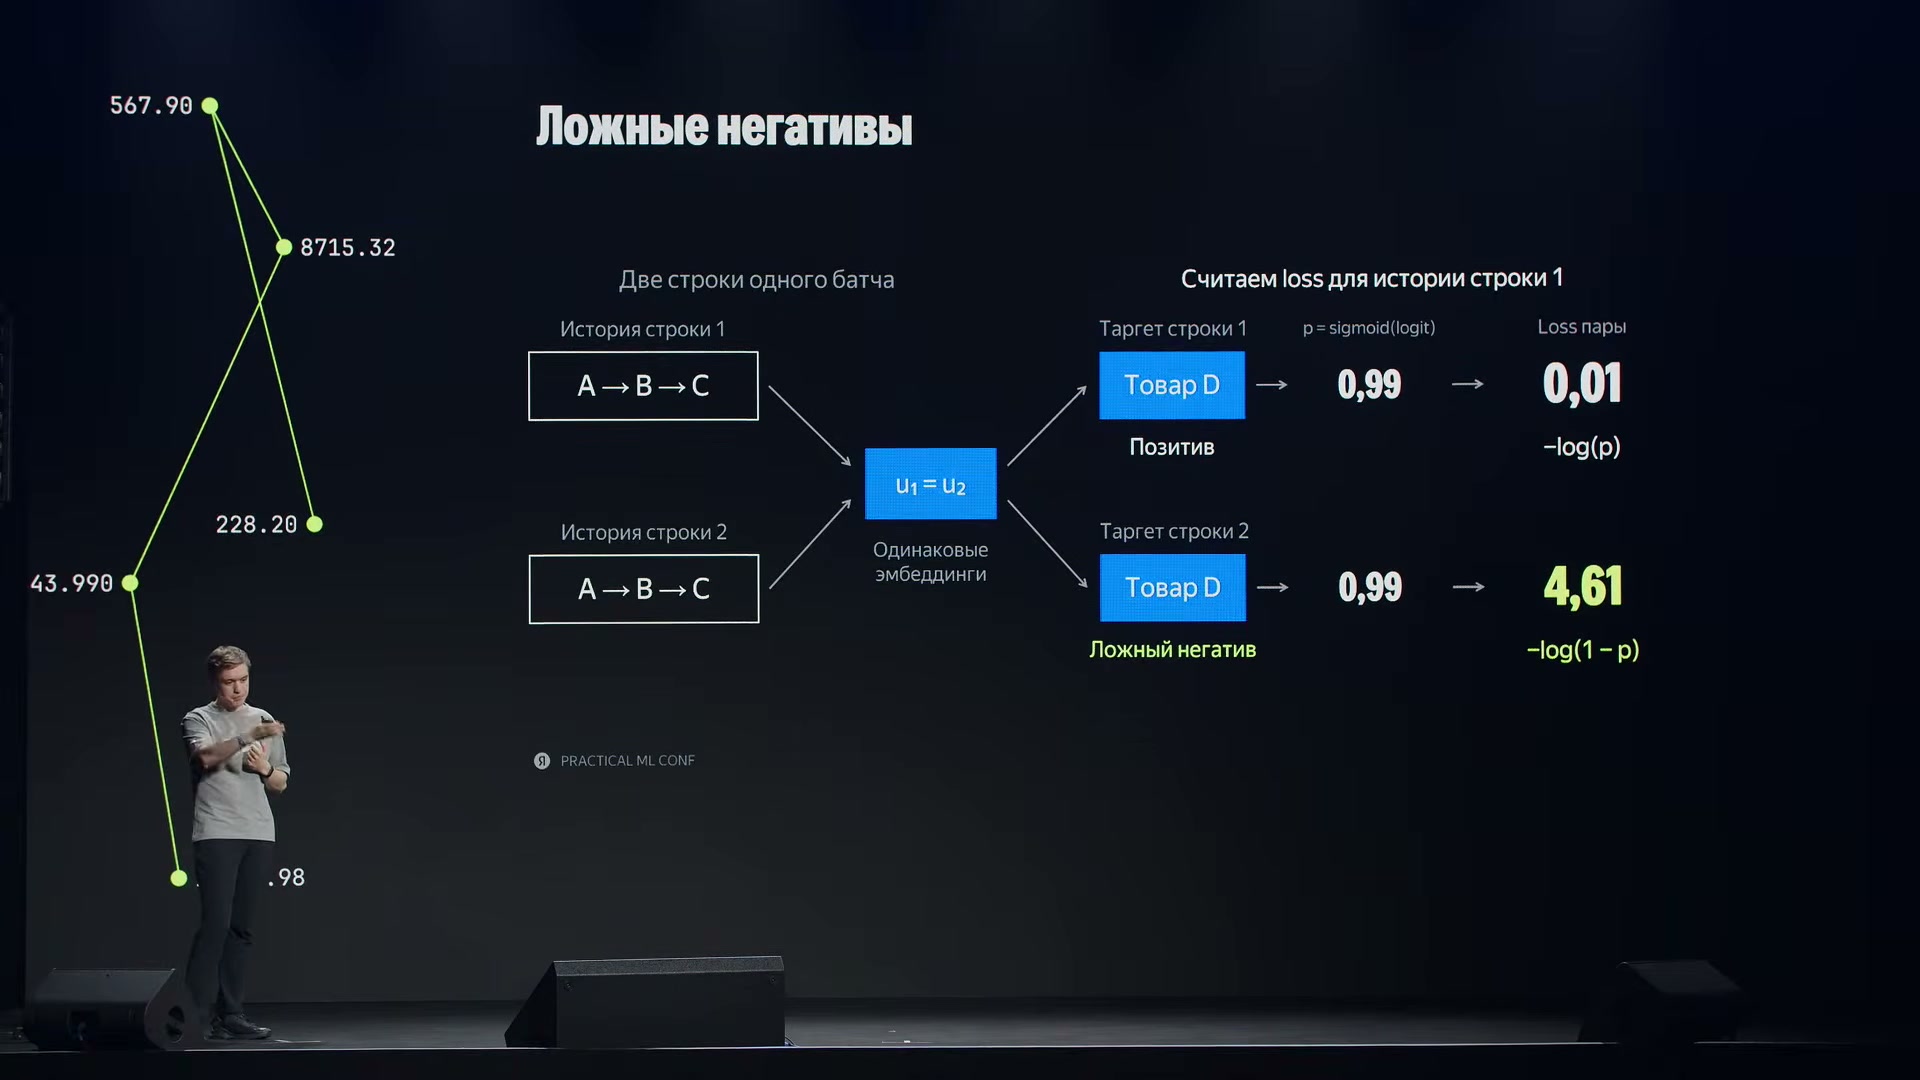
Один и тот же D при p = 0,99 даёт потерю 0,01 как положительный пример и 4,61 как ложный отрицательный. Дублирующиеся строки создают противоречивые требования к одинаковым представлениям.
Источник: Дмитрий Веснин, Авито · Practical ML Conf 2026Как настройка Adam завершила первый этап стабилизации
Следующая идея пришла из исследования оптимизатора Adam — алгоритма, который использует градиенты для обновления параметров модели. В пересказе докладчика исследователи разбирались, почему Adam выигрывает у более простых методов, и обнаружили полезное соотношение двух его параметров: β₁ = β₂. Такое равенство оставалось близким к оптимальной настройке при изменении размера пакета, шага обучения и набора данных.
Параметры β₁ и β₂ управляют тем, как оптимизатор усредняет информацию о градиентах. Проверить предложенное изменение было сравнительно просто. Команда использовала β₁ = β₂ = 0,95 и получила сразу несколько улучшений: обучение стало устойчивее, итоговая функция потерь снизилась, а метрики качества на данных вне пользовательского эксперимента выросли.
Докладчик отмечает любопытную деталь: в первоначальном исследовании влияние равенства параметров на стабильность не было особенно выделено. По его словам, примерно через год появились другие работы и разборы, обсуждавшие именно этот эффект. В собственной задаче команда обнаружила пользу от настройки раньше, чем получила развёрнутое объяснение её влияния на устойчивость.
Итог этого этапа складывался из нескольких действий: отключили ограничение градиентов, исправили ошибки данных и изменили параметры Adam. Обучение стало стабильным без clipping, а совокупный прирост Recall составил около 5%. Recall, или полнота, показывает, какую долю нужных объектов удаётся найти.
На итоговом слайде указан именно совокупный результат, ещё до замены item-энкодера. Размер выдачи для Recall, исходное значение и способ расчёта прироста не раскрыты, поэтому сохраняем авторскую запись +5%, без перевода в процентные пункты и без выделения вклада одной настройки.
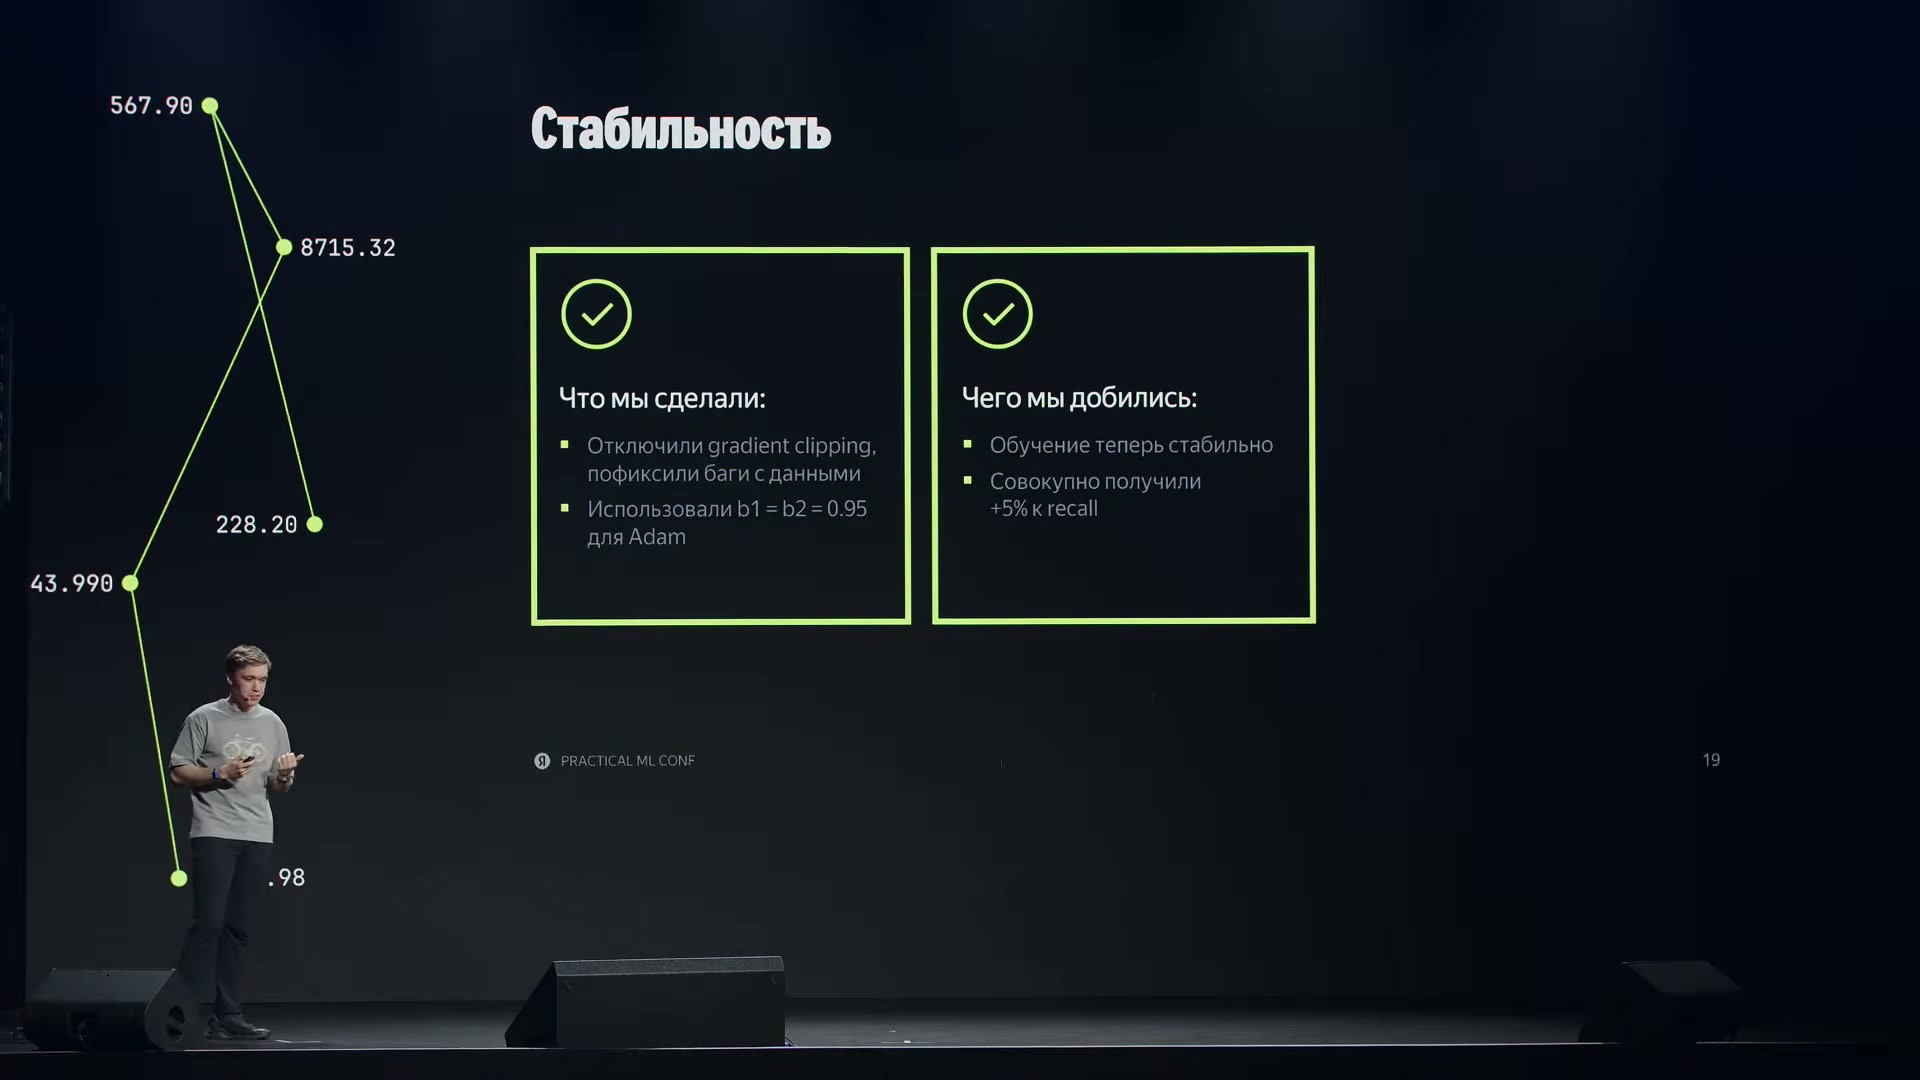
Исправление ошибок данных и настройка Adam β₁ = β₂ = 0,95 дали стабильное обучение без clipping и совокупные +5% к Recall.
Источник: Дмитрий Веснин, Авито · Practical ML Conf 2026Почему дополнительные вычисления иногда ускоряют обучение
После стабилизации команда перешла к скорости. Объяснение начинается с устройства памяти видеокарты. Быстро выполнить арифметическую операцию недостаточно: данные нужно ещё прочитать и записать. В рассматриваемой иерархии большой объём доступен в глобальной памяти HBM, а значительно более быстрые регистры имеют небольшой объём. Поэтому производительность зависит и от того, сколько раз промежуточные результаты перемещаются между уровнями памяти.
Автор показывает простой пример: к входным значениям три раза подряд применяют сигмоиду. При обычном выполнении каждый вызов отдельно читает и записывает данные в HBM. Кроме того, для обучения сохраняются промежуточные результаты вычислений — активации.
Когда модель вычисляет выход по входу, она выполняет прямой проход, forward. Затем обратный проход, backward, рассчитывает градиенты. Для этого ему нужны промежуточные результаты прямого прохода. Если они сохранены в HBM, при обратном проходе их приходится снова читать из этой памяти.
Компиляция через torch.compile позволяет иначе организовать вычисления. В разобранном примере появляется программа на Triton — языке для вычислений на видеокарте. Вместо отдельных обращений к HBM после каждого преобразования промежуточные операции могут работать с данными в регистрах.
Компилятор может изменить и обратный проход: не читать некоторые заранее сохранённые активации, а вычислить их повторно. Арифметической работы становится больше, но исчезает часть дорогих обращений к памяти. При подходящем соотношении этих затрат пересчитать значение оказывается быстрее, чем сохранить его и затем прочитать.
На примере с тремя сигмоидами torch.compile примерно вдвое ускорил суммарный прямой и обратный проходы и примерно вдвое уменьшил пиковое потребление видеопамяти. Это небольшой демонстрационный пример, который объясняет механизм ускорения. Следующим шагом было применить тот же инструмент к рабочей рекомендательной модели.
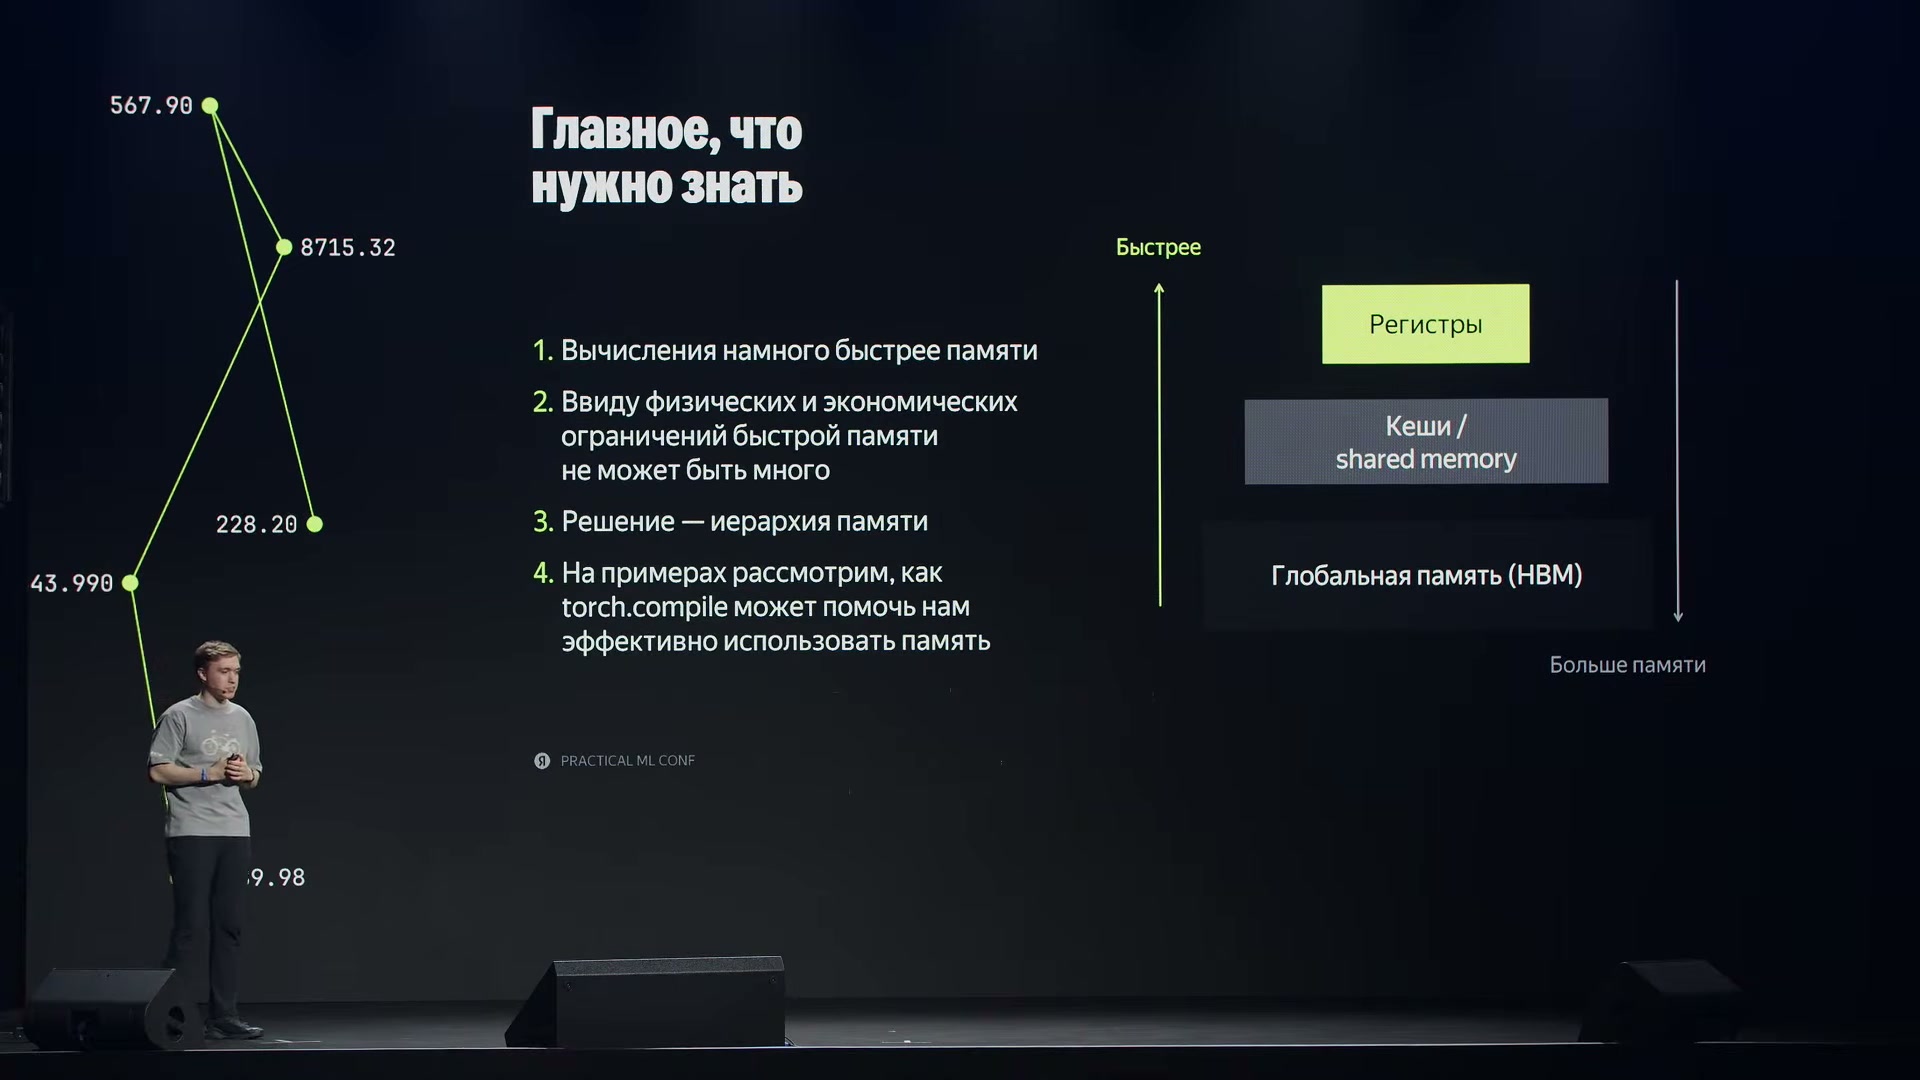
Иерархия памяти видеокарты: большой объём глобальной памяти сочетается с небольшим объёмом быстрых регистров. Сокращение перемещений данных становится одним из источников ускорения.
Источник: Дмитрий Веснин, Авито · Practical ML Conf 2026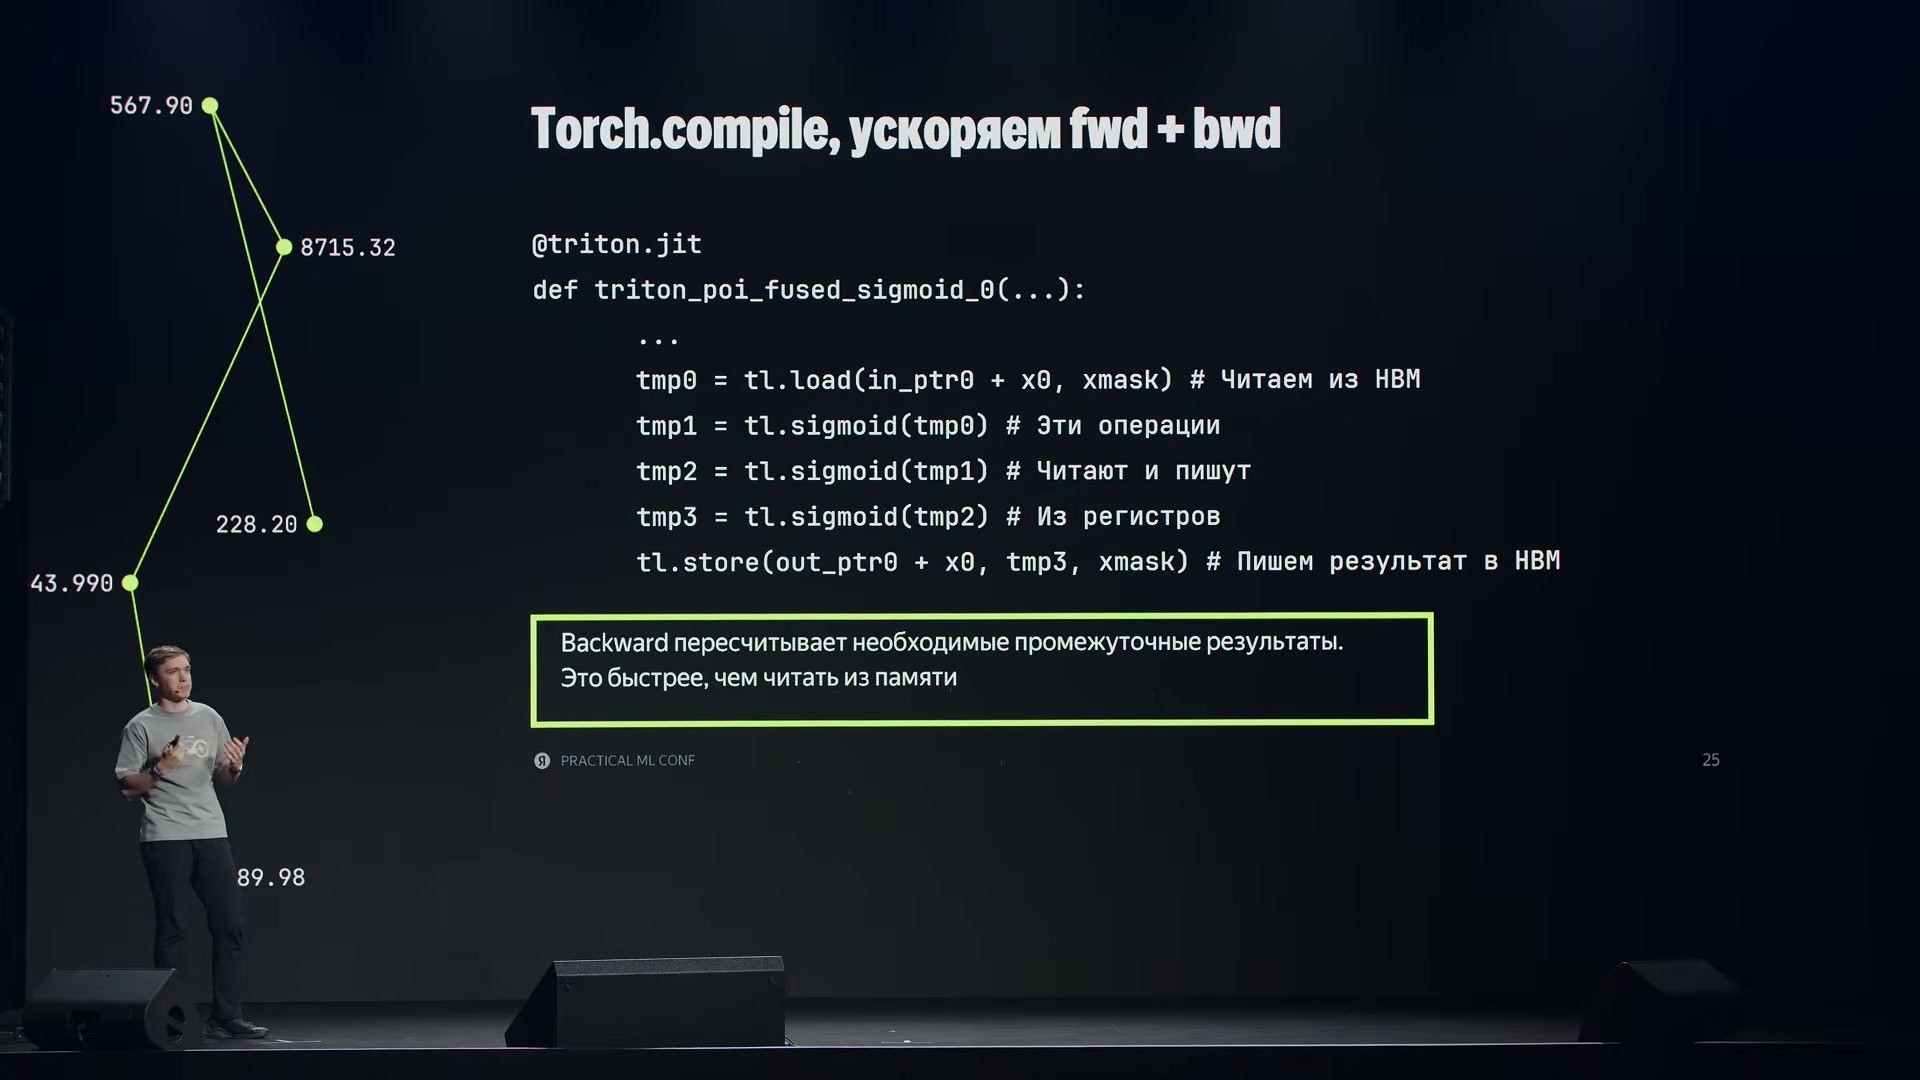
Скомпилированное ядро оставляет промежуточные сигмоиды в регистрах и пересчитывает нужные значения в обратном проходе. Это сокращает обращения к глобальной памяти.
Источник: Дмитрий Веснин, Авито · Practical ML Conf 2026Что потребовалось для компиляции рабочей модели
В реальной модели компиляция оказалась сложнее демонстрационного примера. Не всегда получается собрать все операции в единый вычислительный граф — связное описание зависимостей между вычислениями. В местах, которые компилятор не может включить в такой граф, возникают разрывы, graph breaks. Тогда часть программы работает в обычном режиме, а часть — в скомпилированном.
Докладчик предлагает начинать с отдельных логических модулей, а не с компиляции всей модели целиком. Для этой системы естественными границами стали item-энкодер и энкодер пользователя. Сообщения о разрывах графа и повторных компиляциях помогали понимать, какие участки действительно компилируются и где выполнение возвращается к обычному режиму.
Одних сообщений было достаточно не всегда. В более сложных случаях приходилось разбирать сгенерированный код Triton, а отдельные участки исключать из компиляции. Такой подход позволял сохранить ускорение остальной модели, не превращая поддержку одного проблемного фрагмента в условие работы всей системы.
Команда сталкивалась и с ошибками самого инструмента. Автор отдельно упоминает обращения к разработчикам PyTorch через сообщения об ошибках в репозитории. Но компиляция всё же дала существенный результат уже на подготовительном этапе, до разработки нового item-энкодера.
Теперь у команды была более устойчивая и менее требовательная к памяти основа для следующего эксперимента. Важно сохранить порядок этой истории: ускорение в 4,68 раза относится к применению компиляции на рабочей модели, а не к последующей замене DCNv2 трансформером.
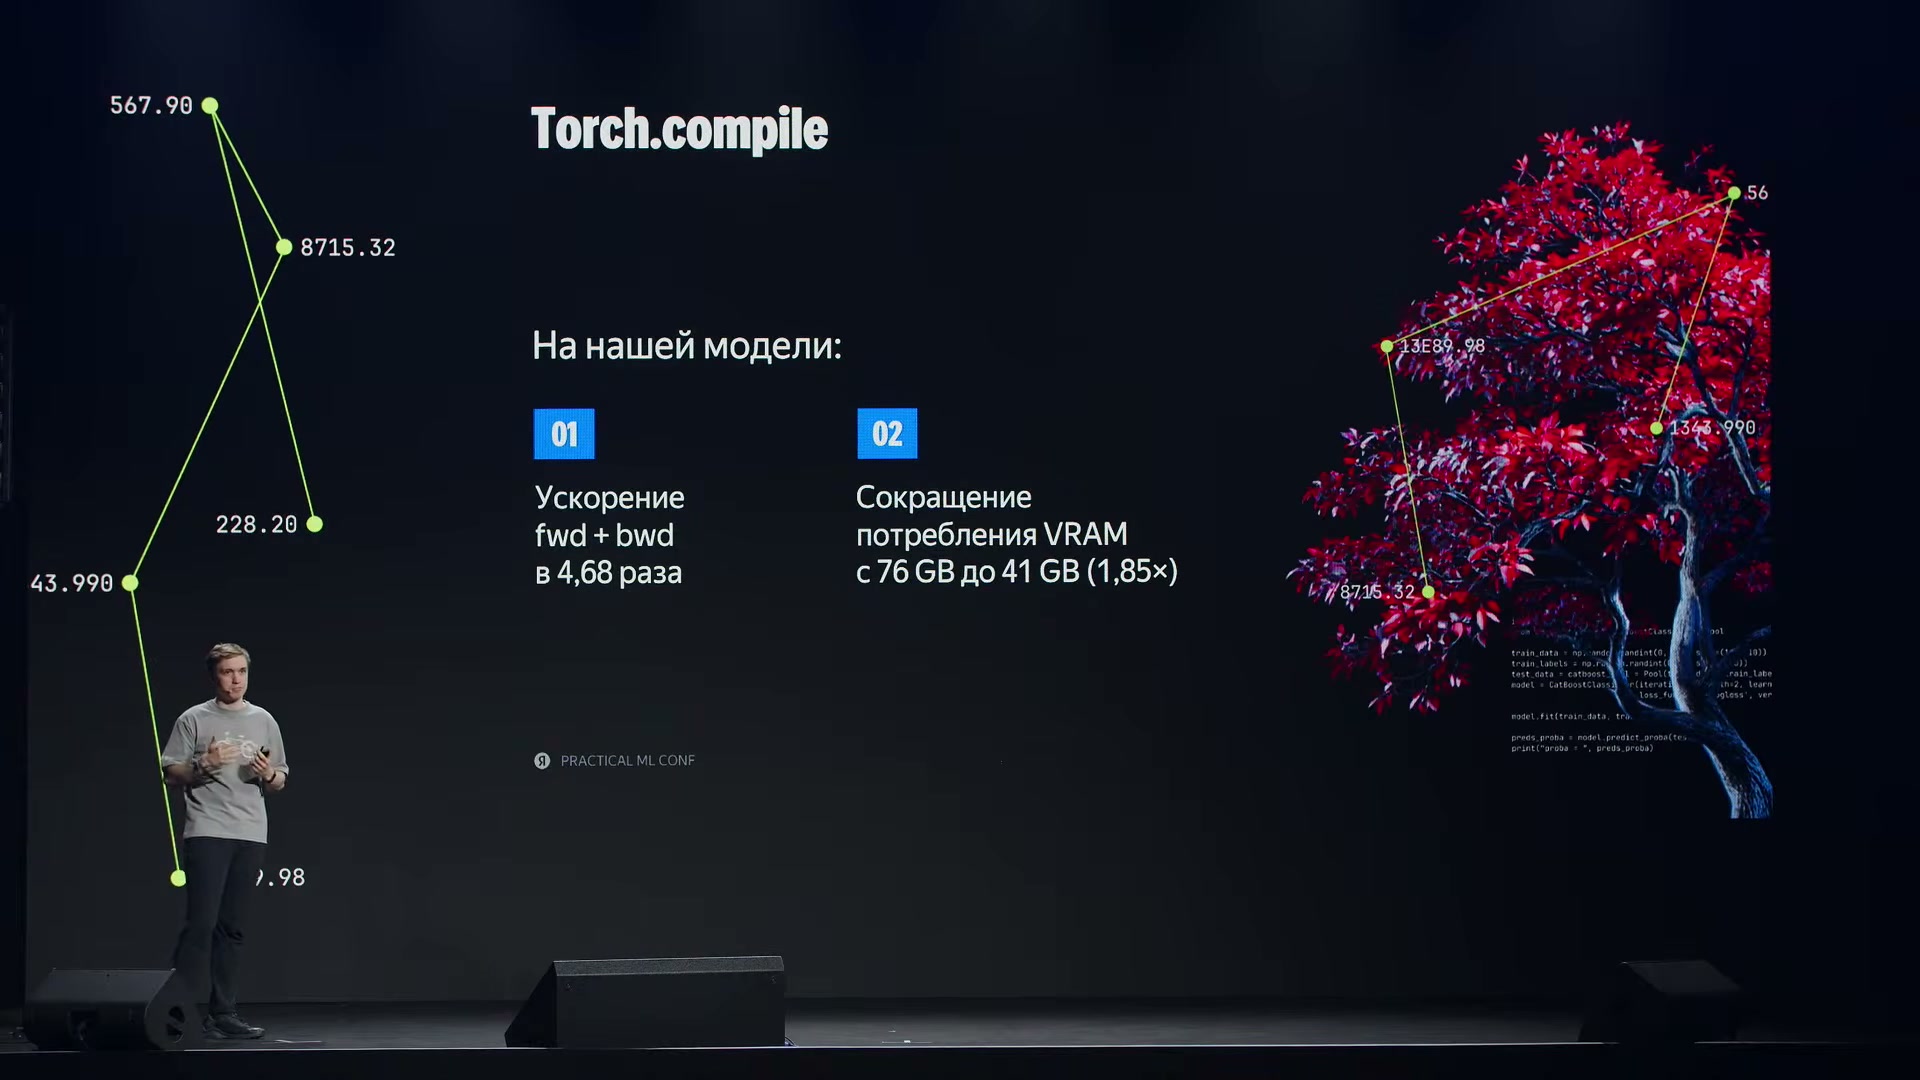
Компиляция рабочей модели ускорила fwd + bwd в 4,68 раза и сократила потребление VRAM с 76 GB до 41 GB, то есть в 1,85 раза.
Источник: Дмитрий Веснин, Авито · Practical ML Conf 2026Новый трансформер и первый рост активаций
Вернувшись к основной гипотезе, команда выбрала собственную реализацию трансформерного энкодера. По опыту автора, встроенный класс PyTorch было неудобно изменять под нужную конфигурацию: существенные доработки фактически превращали его в собственный класс. Поэтому вместо постепенного приспособления готовой реализации решили сразу собрать ту структуру, которую хотели исследовать.
Архитектуру строили не как буквальное воспроизведение исходного трансформера 2017 года. Автор перечисляет модификации нормализации и полносвязный блок со SwiGLU; такой набор изменений в докладе назван Transformer+. Полносвязный блок, FFN, преобразует представления внутри слоя. SwiGLU организует его через две ветви, одна из которых управляет проходящим сигналом другой; конкретное выражение этого блока понадобится позже при локализации ошибки компиляции.
Саму операцию внимания сначала взяли из PyTorch через SDPA — интерфейс вычисления внимания по масштабированным скалярным произведениям. На этом этапе задача состояла в том, чтобы собрать и обучить новый энкодер. Разработка собственной быстрой операции внимания появилась позже, после измерений.
После запуска обнаружились слишком большие значения на выходах item-энкодера и энкодера пользователя. Автор приводит максимальные абсолютные значения активаций порядка 6000. Проверка отдельных частей модели показала, что основной вклад в рост вносит FFN.
Команда добавила RMSNorm — нормализацию по среднеквадратичному значению — на выходе этого блока, чтобы сдержать рост значений. После изменения максимальные абсолютные значения снизились примерно до 100–200. Одновременно уменьшилась функция потерь, и модель стала обучаться лучше. Числа здесь характеризуют величину активаций, а не качество рекомендаций.
Так удалось снять первую проблему нового энкодера. Но более сложная архитектура занимала слишком много видеопамяти, а команда хотела увеличить пакет обучающих примеров. Следующий вопрос был уже не о форме функции, а о том, какие промежуточные результаты действительно стоит хранить до обратного прохода.
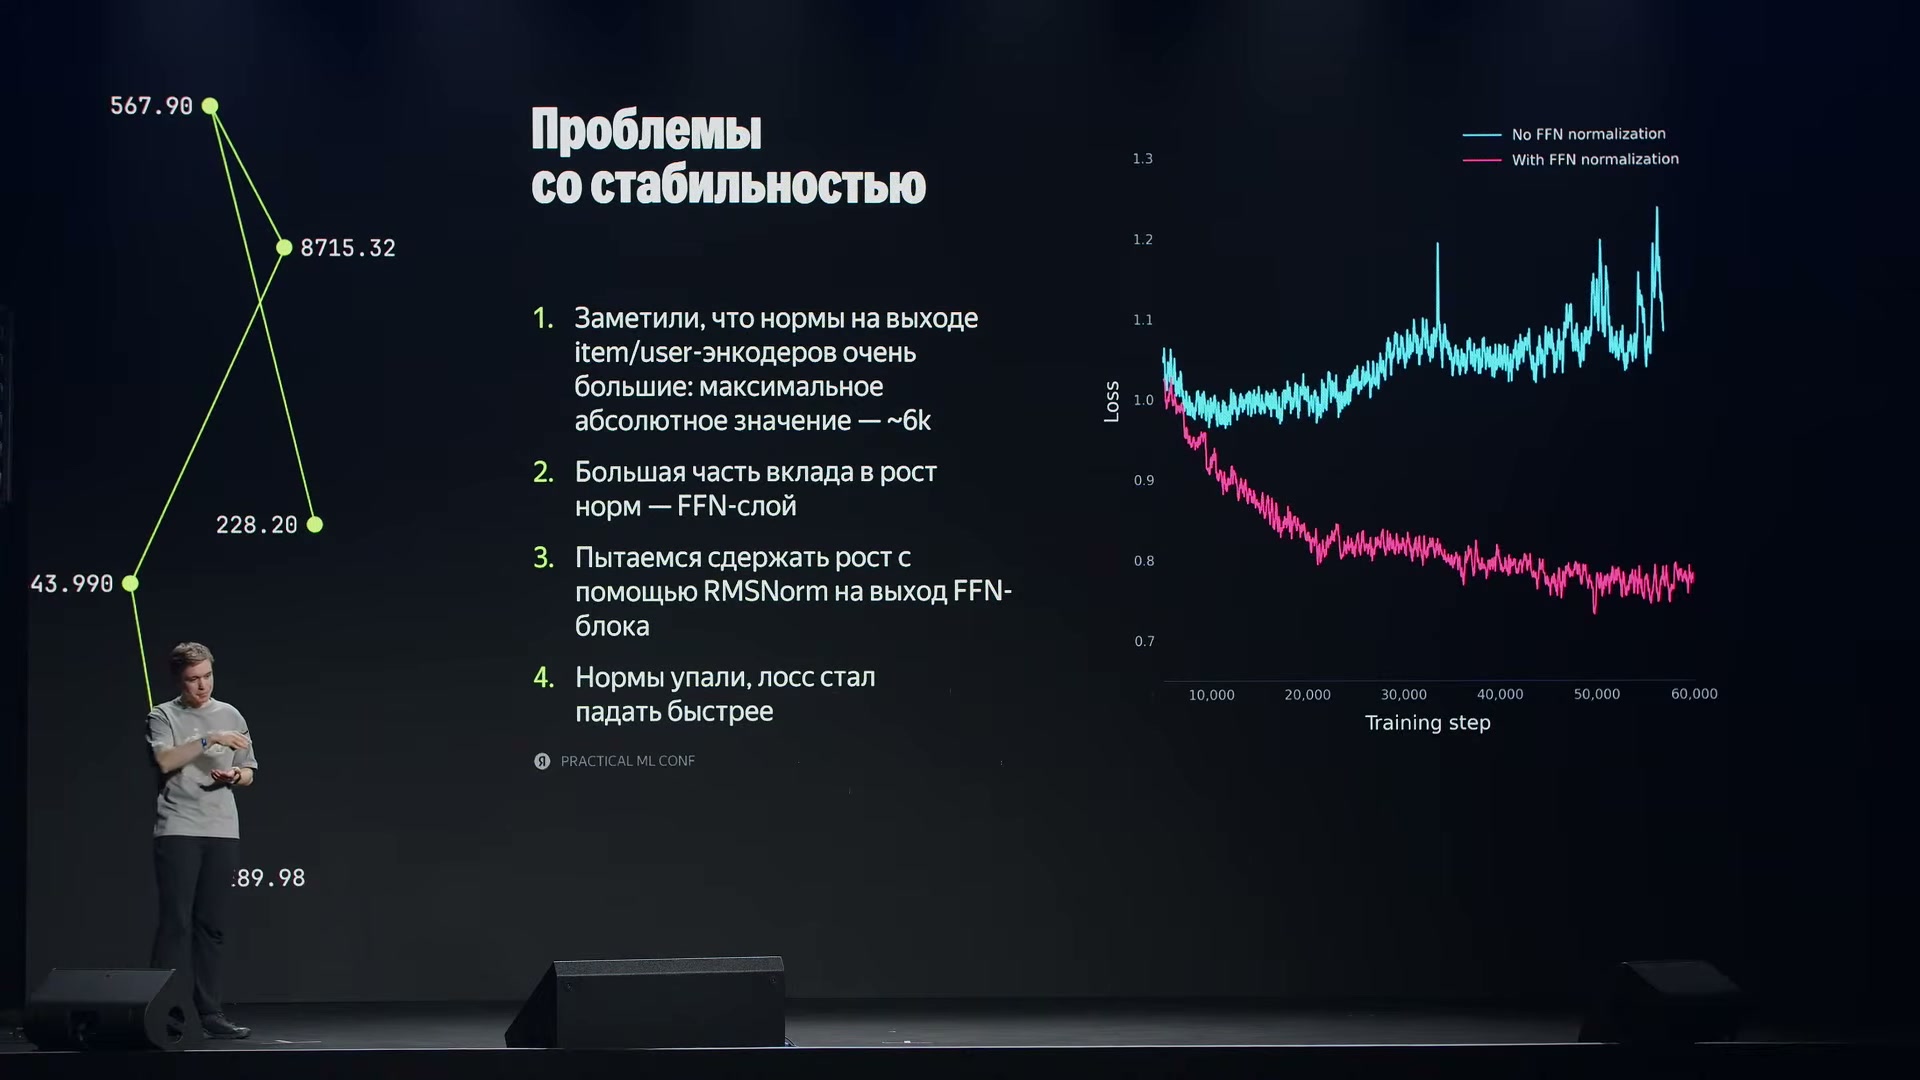
Нормализация RMSNorm на выходе FFN сдержала рост активаций. На графике функция потерь с нормализацией устойчиво снижается, тогда как без неё начинает расти.
Источник: Дмитрий Веснин, Авито · Practical ML Conf 2026Почему память экономили именно внутри item-энкодера
При совместном обучении два энкодера получают разную по объёму работу. Если в пакете n пользователей и для каждого обрабатывается история примерно из k объявлений, энкодер пользователя работает с n историями, а item-энкодеру нужно обработать порядка n × k позиций с объявлениями. Поэтому существенную экономию памяти логично было искать именно в item-энкодере.
Для этого команда использовала пересчёт активаций, activation checkpointing. Вместо сохранения всех промежуточных результатов прямого прохода часть результатов не сохраняют, а получают заново во время обратного прохода. Здесь checkpointing относится к организации вычислений, а не к сохранению файла с весами модели.
Остаётся выбрать область пересчёта. Можно пересчитывать целый слой трансформера, несколько слоёв или только определённый тип блока внутри каждого слоя. Чем больше вычислений приходится повторять, тем сильнее может замедлиться обучение. Но и освобождаемая память зависит от того, какие активации перестали сохранять.
Таблицу можно прокрутить по горизонтали.
Столбец «Соотношение» показывает размен памяти на время: процент уменьшения пиковой VRAM делят на процент замедления проходов. Например, для FFN получается 45,01 / 11,20 ≈ 4,02. Это характеристика компромисса, а не коэффициент ускорения.
В сравнении хорошо видно, почему команда выбрала пересчёт FFN в каждом слое. Пересчёт внимания уменьшал пиковую память на 24,72% при замедлении на 18,67%. Пересчёт FFN давал более крупную экономию — 45,01% — при меньшем замедлении, 11,20%. Среди проверенных вариантов у него оказалось и наибольшее соотношение экономии к замедлению.
Выбор был сделан под конкретные размеры входных тензоров. На коротких проверках сочетание изменений выглядело удачным: памяти хватало лучше, а цена дополнительных вычислений была приемлемой. Однако позднее именно изменение границ пересчёта помогло проявиться другой проблеме — взаимодействию checkpointing с компиляцией.
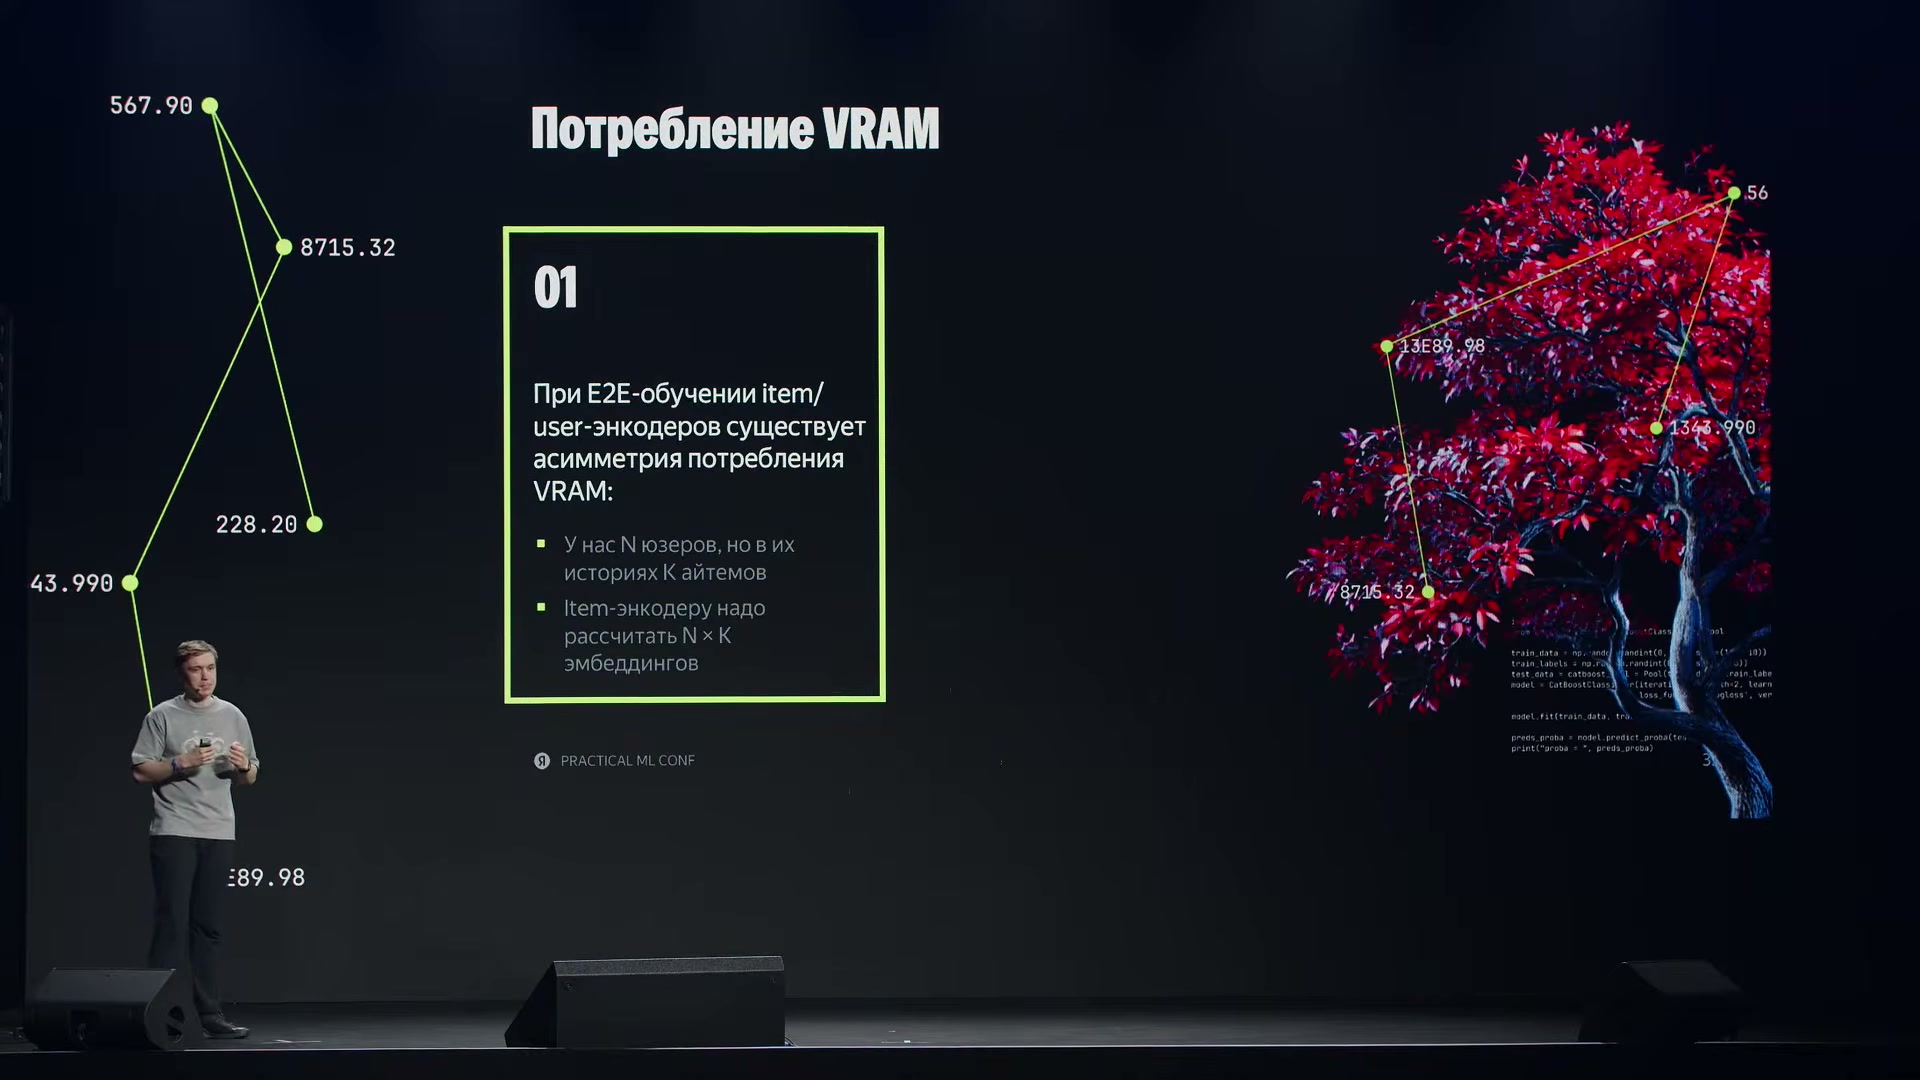
Для n пользователей с историями по k объектов item-энкодер обрабатывает порядка n × k позиций. Эта асимметрия объясняет, почему экономию памяти искали прежде всего в нём.
Источник: Дмитрий Веснин, Авито · Practical ML Conf 2026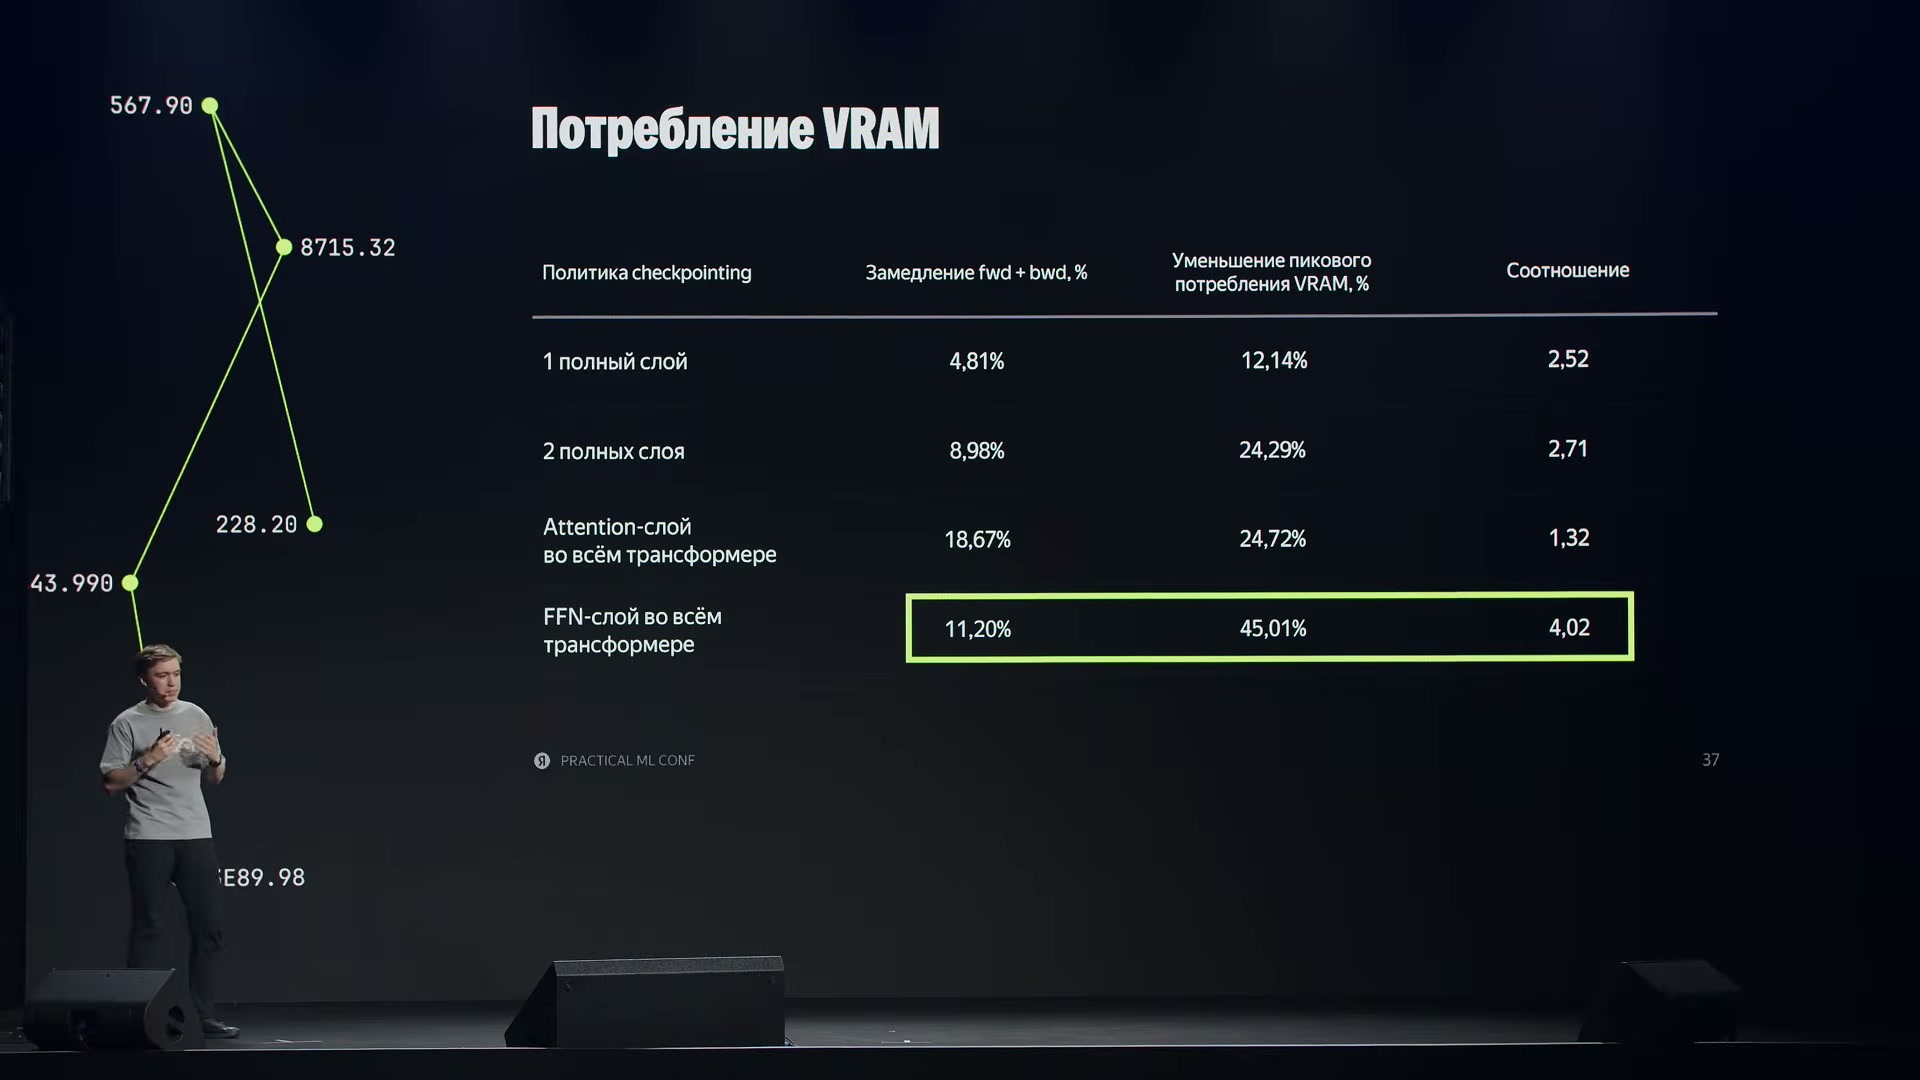
Среди четырёх вариантов checkpointing пересчёт FFN во всех слоях дал наиболее выгодное соотношение: 45,01% экономии пиковой VRAM при замедлении fwd + bwd на 11,20%.
Источник: Дмитрий Веснин, Авито · Practical ML Conf 2026Поздний срыв: как пересчёт активаций маскировал проблему компиляции
После оптимизаций команда продолжила менять систему, в том числе формат набора данных. Через некоторое время в обучении снова появились резкие выбросы градиентов. Первую попытку разобраться направили на механизм внимания: подключили отладчик и посмотрели промежуточные значения в его первом слое.
Внимание использует запросы Q и ключи K — представления, через сопоставление которых определяется связь между позициями. Несколько параллельных способов такого сопоставления называют головами внимания. В исследованном слое у двух из восьми голов обнаружили большое добавочное смещение, bias, в преобразовании ключей K.
Команда убрала добавочные смещения из всех линейных слоёв. Срыв произошёл позже, но не исчез. Далее проверили дополнительную нормализацию внутри механизма внимания и Gated Attention — вариант с управлением проходящим сигналом. Оба подхода тоже не решили проблему. Не помогло и возвращение ограничения градиентов.
К этому моменту в модели накопилось много изменений: компиляция, пересчёт активаций, новый формат данных и другие доработки. Вместо дальнейшего добавления стабилизирующих приёмов команда стала поочерёдно возвращаться к предыдущим вариантам и проверять, при каком сочетании возникает срыв.
Сначала выяснилось, что старый набор данных тоже не обеспечивал устойчивости: обучение срывалось после примерно 100 тысяч шагов. Ранее запуски не доводили до этой точки, поскольку такое обучение занимало несколько дней. Получалось, что проблема существовала и до смены формата данных, но короткие проверки её не обнаруживали.
Размер пакета тоже влиял на момент проявления. При увеличении пакета нестабильность возникала раньше, при уменьшении — позже. Поэтому более длинный спокойный участок графика ещё не означал, что причина устранена: изменение могло лишь отодвинуть срыв.
Таблицу можно прокрутить по горизонтали.
На слайде FFN со SwiGLU записан как FFN(x) = w3(swish(w1(x)) ⊙ w2(x)). Здесь w1 и w2 — обучаемые преобразования входа, swish — нелинейное преобразование, а результаты двух ветвей перемножаются поэлементно. Преобразование w3 применяется уже к полученному произведению. Именно выполнение w3 команда исключила из компиляции, сохранив само преобразование в модели.
Таким образом, прежний пересчёт целых слоёв маскировал проблему, связанную с torch.compile. Более экономный вариант изменил условия её проявления. В итоге команда сохранила большую часть компиляции и вернула нужные варианты пересчёта активаций, ограничившись небольшим исключением внутри FFN.
Точную первопричину автор при этом не считает установленной. Сравнение кода до и после точечного отключения компиляции показывало главным образом изменение порядка операций. Почему этого оказалось достаточно, до конца не выяснили. Практическим результатом стал работающий локальный обход, а объяснение исходного сбоя осталось открытым.
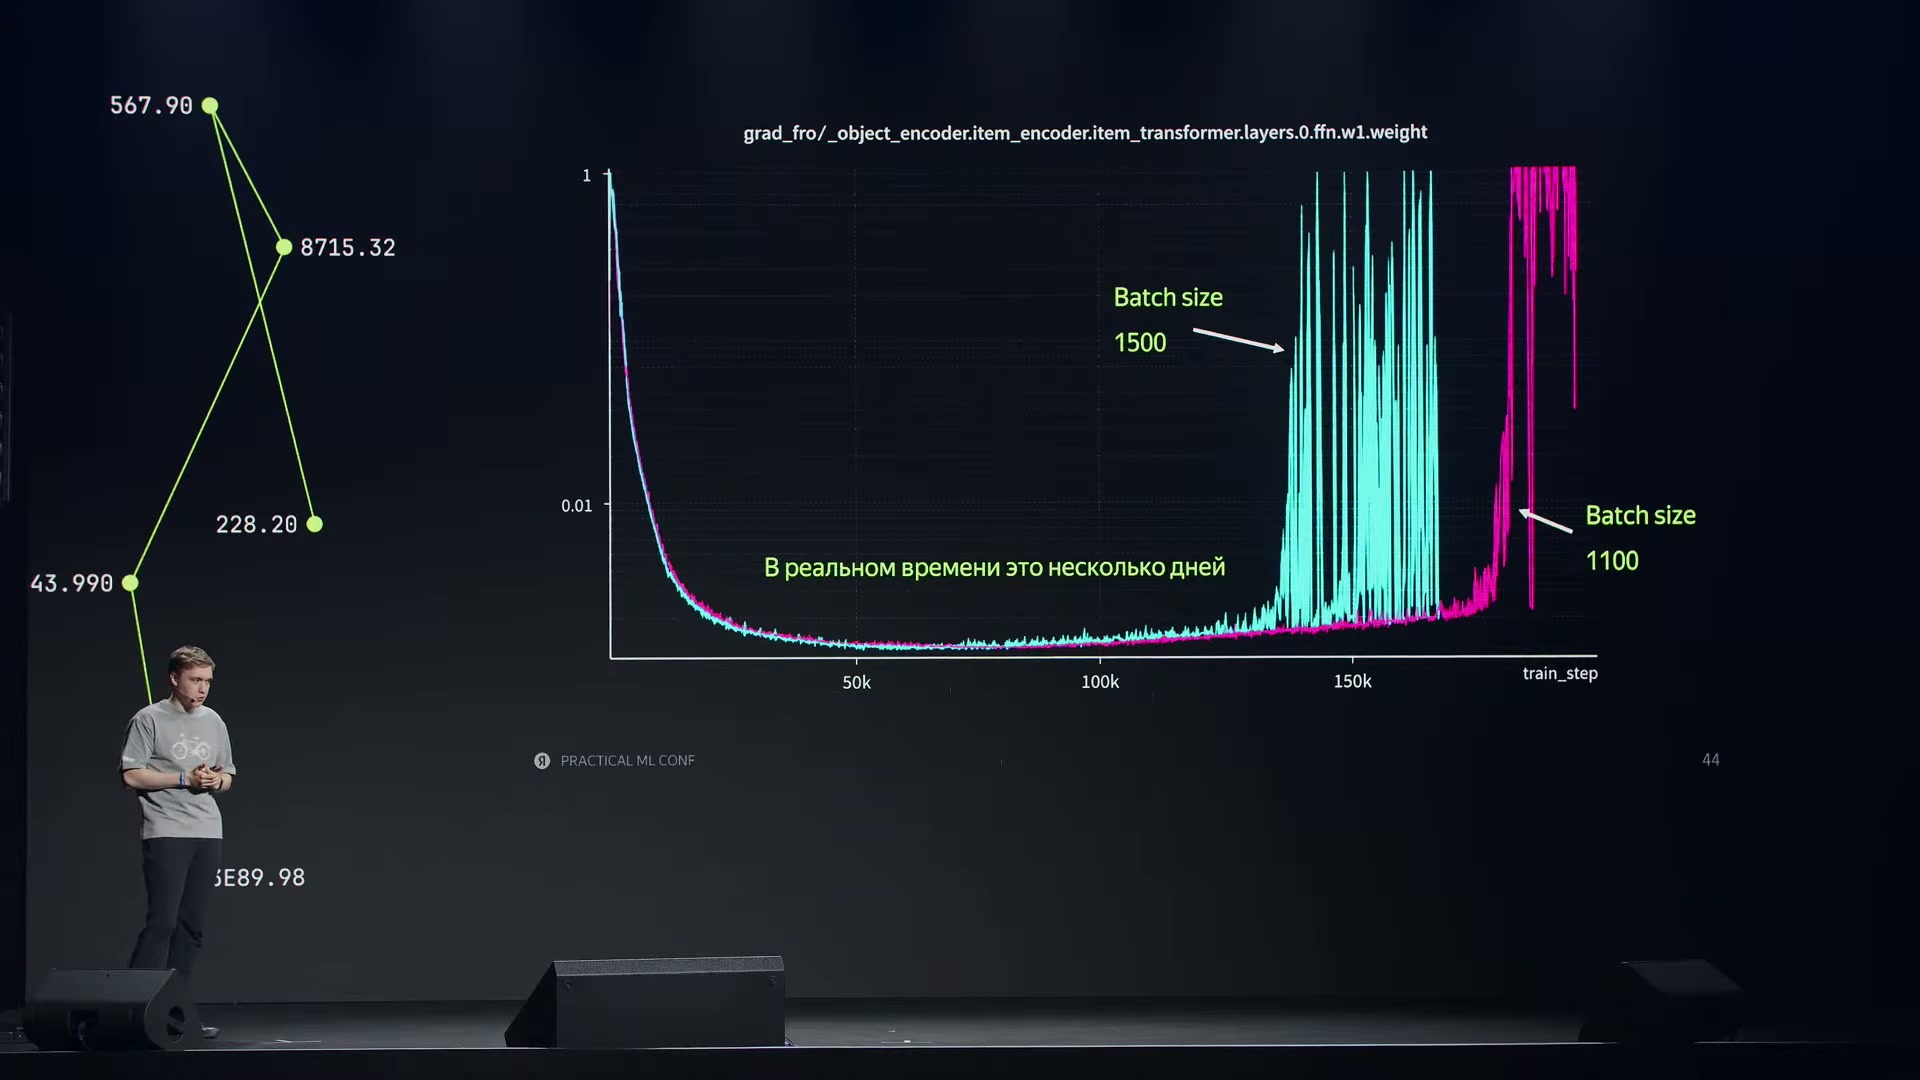
Размер пакета меняет момент проявления нестабильности: увеличение приближает срыв, уменьшение отодвигает его. Более спокойное начало обучения ещё не означает устранения причины.
Источник: Дмитрий Веснин, Авито · Practical ML Conf 2026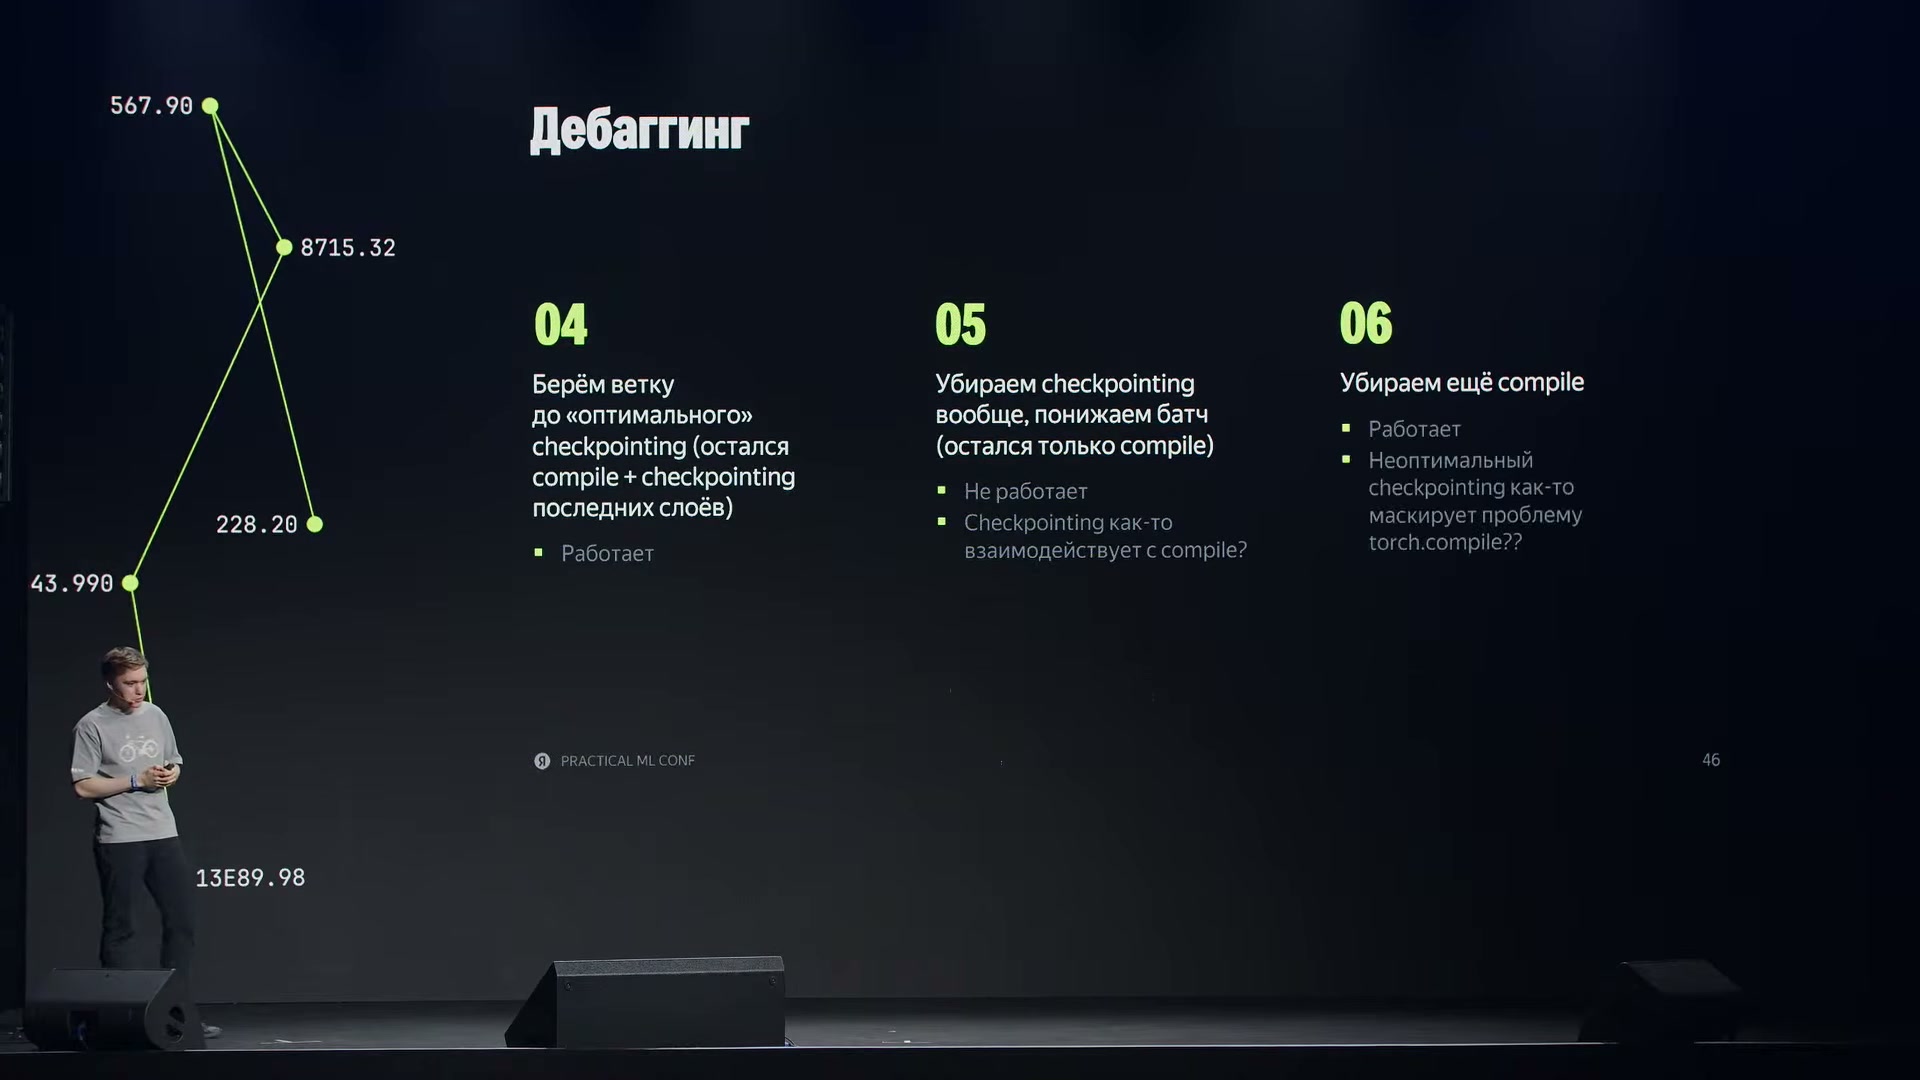
Откаты checkpointing и компиляции показали их взаимодействие: пересчёт целых слоёв скрывал сбой, который проявлялся при других сочетаниях настроек.
Источник: Дмитрий Веснин, Авито · Practical ML Conf 2026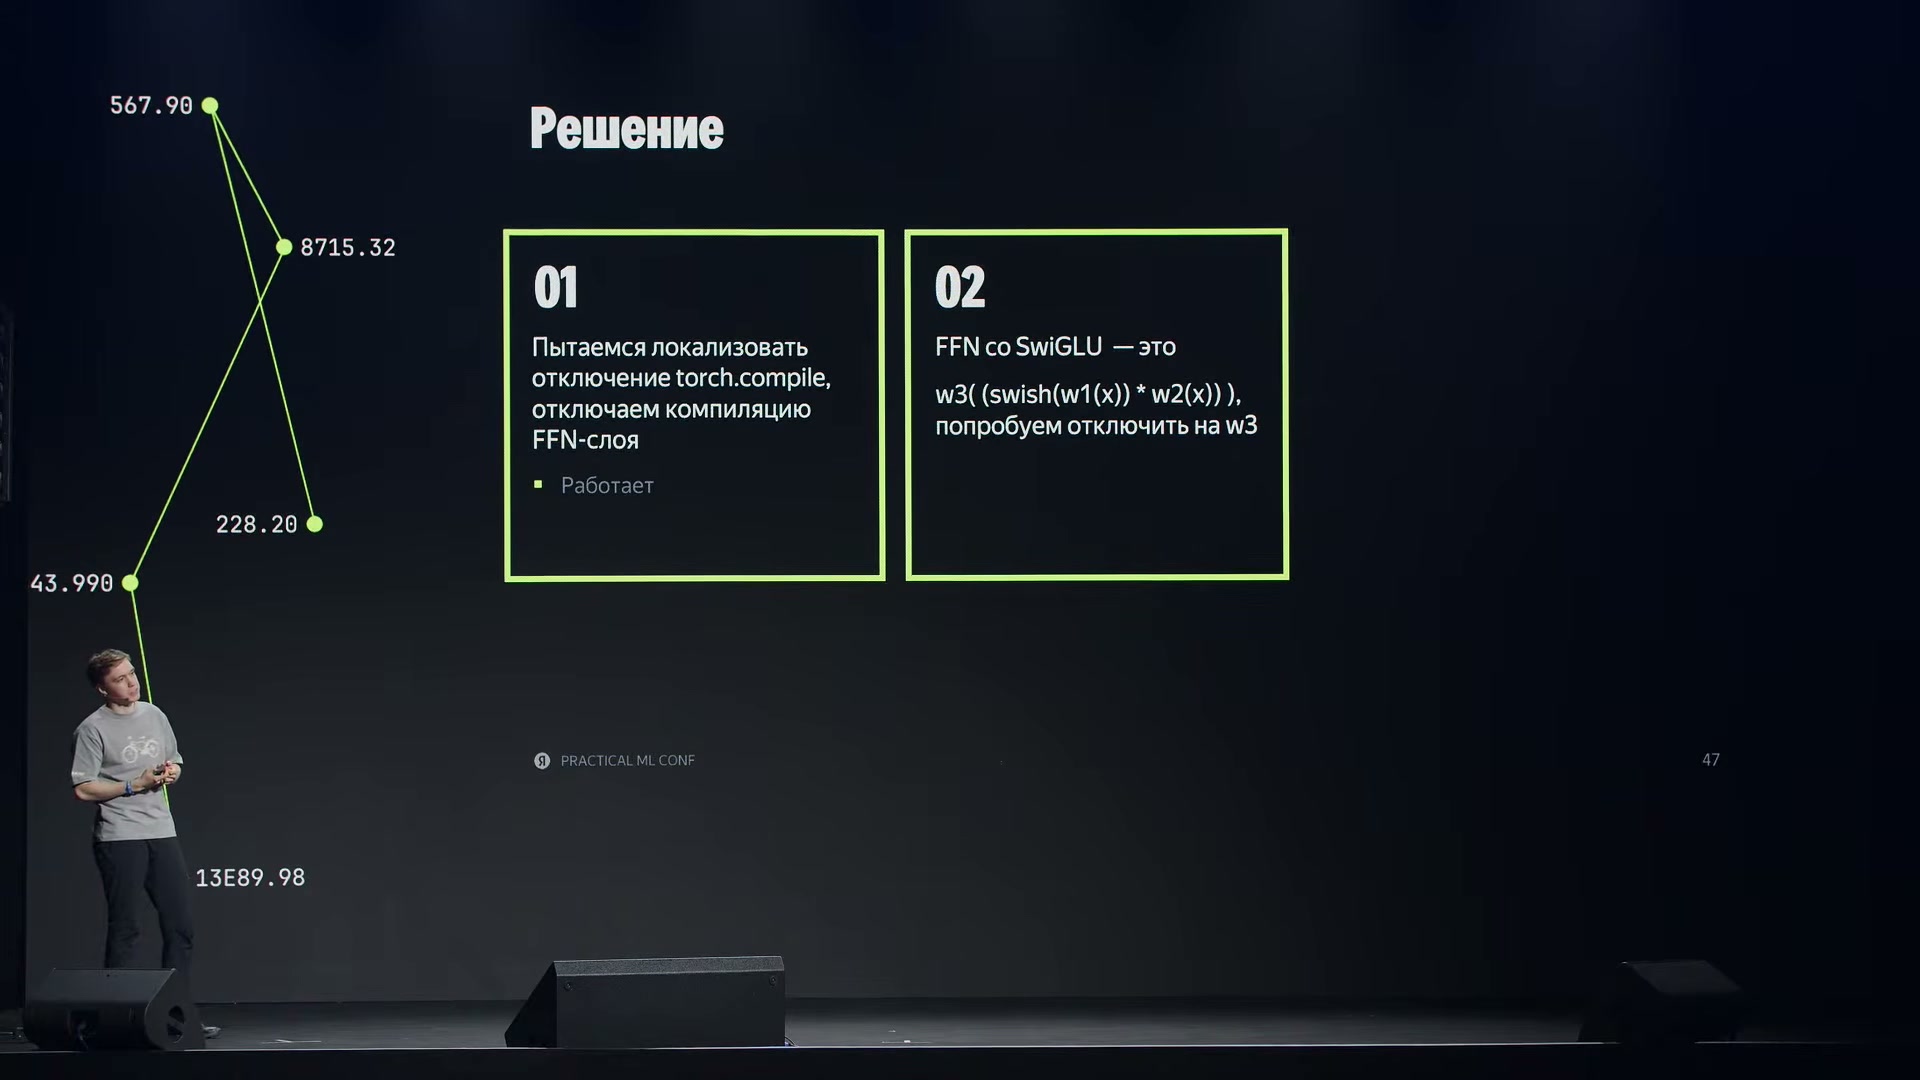
В FFN со SwiGLU преобразование w3 применяется к произведению двух ветвей. Исключение только w3 из torch.compile позволило сохранить остальную компиляцию и восстановить обучение.
Источник: Дмитрий Веснин, Авито · Practical ML Conf 2026Не вычислять один и тот же вектор повторно
Следующее ускорение использовало свойство пользовательских историй. Популярные объявления встречаются у многих пользователей, поэтому истории внутри одного пакета пересекаются. Это связано со смещением к популярным объектам, popularity bias: часть каталога получает заметно больше взаимодействий, чем остальные объекты.
Если одно объявление встречается в нескольких историях пакета, запускать для него item-энкодер при каждом вхождении — повторять одну и ту же работу. Команда стала вычислять векторы только для уникальных объявлений среди историй всех пользователей пакета. Полученное представление затем используется в тех позициях, где встречается соответствующее объявление.
Это другой вид повторов, не тот, который ранее ломал функцию потерь. Тогда ошибочно дублировались события и обучающие строки. Здесь речь о нормальном пересечении историй разных пользователей: популярное объявление действительно могло встретиться нескольким людям. Убирается повторное вычисление его представления, а не факт присутствия в истории.
На слайде результат сформулирован так: прямой и обратный проходы стали на 20% быстрее, а потребление видеопамяти уменьшилось на 30%. Экономия появляется непосредственно в обучении на пакетах, где есть пересечения по объявлениям.
При этом исходная постановка без обучаемой таблицы по item ID сохранилась. Представление по-прежнему строится из признаков объекта. Команда лишь переиспользует уже рассчитанный вектор внутри пакета вместо повторного запуска энкодера.
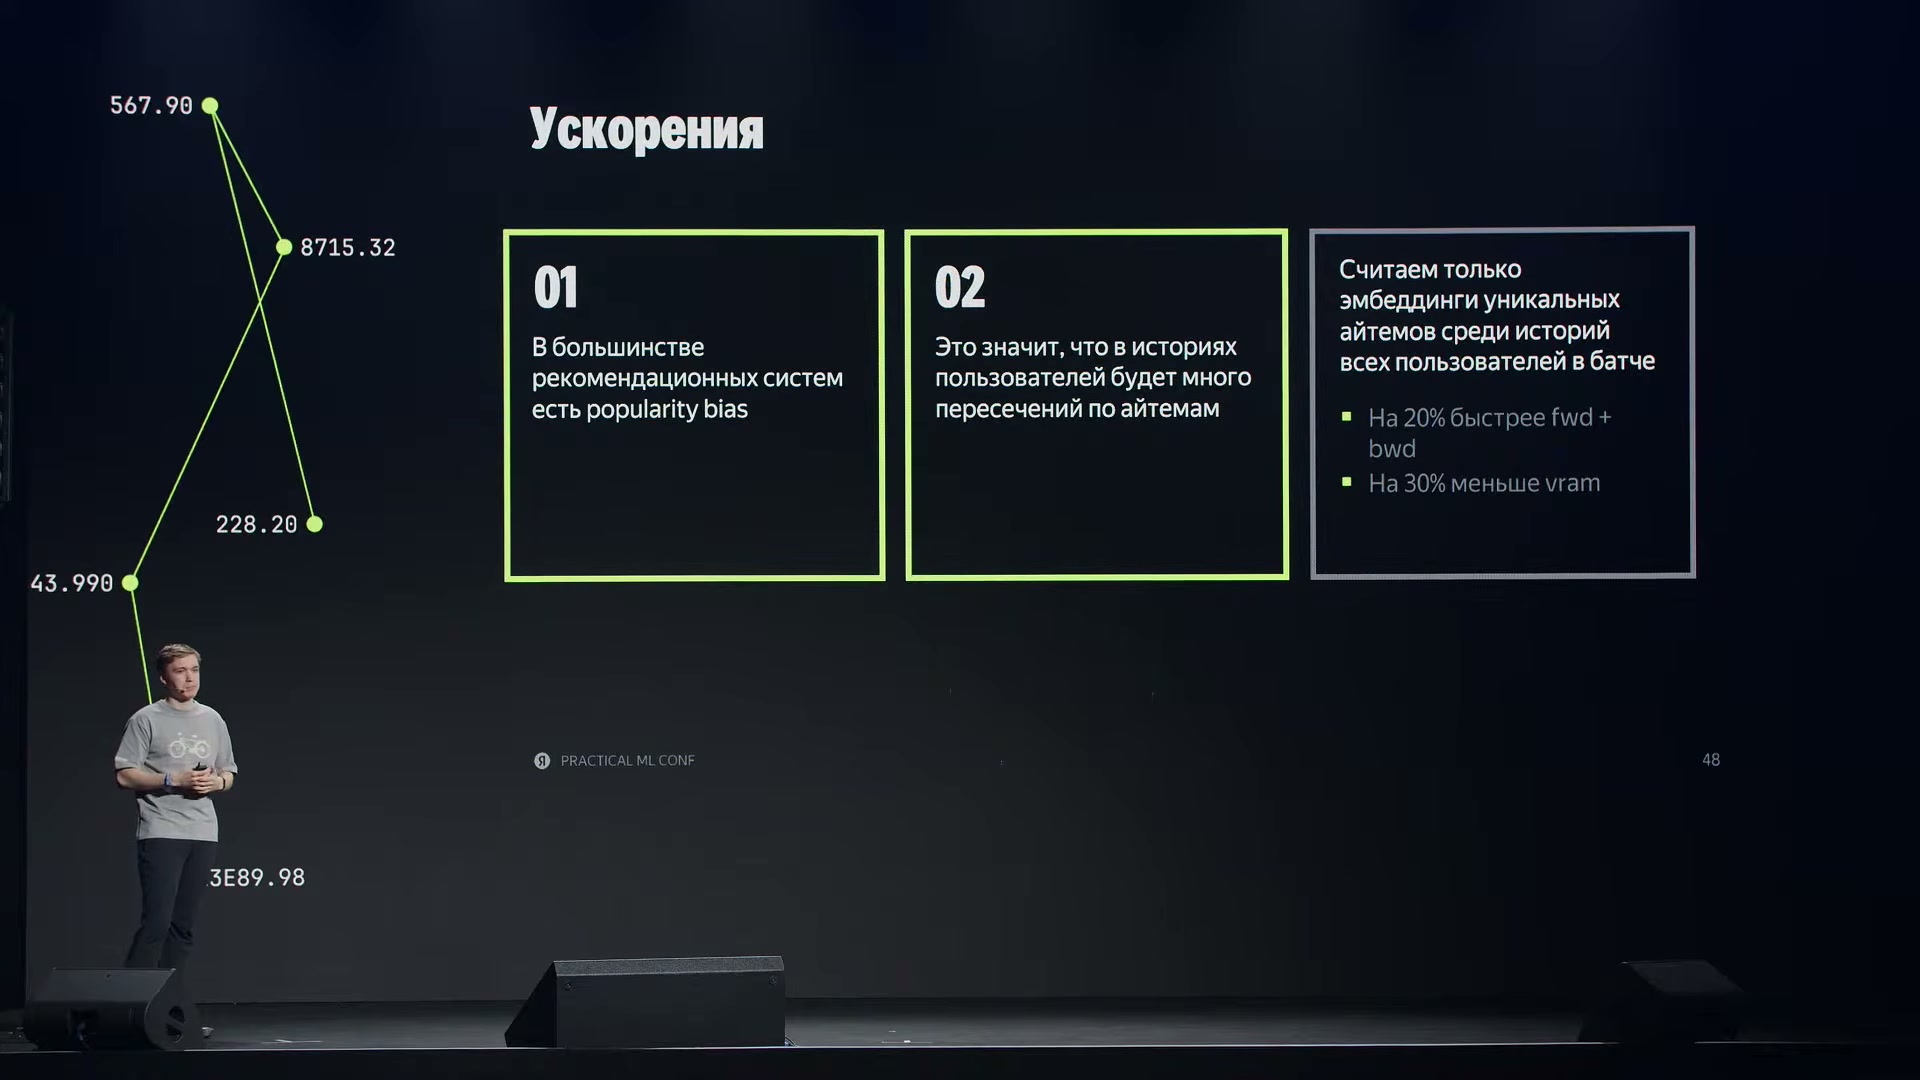
Векторы уникальных объявлений вычисляются один раз на пакет и переиспользуются в пересекающихся историях. Результат: на 20% быстрее fwd + bwd и на 30% меньше VRAM.
Источник: Дмитрий Веснин, Авито · Practical ML Conf 2026Зачем последнему слою нужен только один результат
Трансформерный item-энкодер получает последовательность токенов признаков, но наружу отдаёт одно представление объявления — состояние специального токена CLS. Пока вычисления идут через промежуточные слои, разные позиции участвуют в формировании друг друга. На выходе последнего слоя ситуация меняется: остальные результаты уже не используются.
Поэтому команда поставила вопрос: зачем в последнем слое рассчитывать запросы Q и результаты внимания для всех позиций? Достаточно вычислить полный результат внимания для CLS, сохранив ему доступ к информации остальных токенов.
Остальные позиции не исчезают из входа модели: они остаются источником информации для итогового представления. Оптимизация убирает расчёт тех выходов последнего слоя, которые дальше не нужны. Это отличает её от сокращения всей входной последовательности или пропуска обработки признаков в предыдущих слоях.
Такое изменение уменьшило суммарное время прямого и обратного проходов на 5%. Здесь на слайде явно указано сокращение времени, −5% fwd + bwd time. Следующее ускорение уже касалось не количества используемых выходов, а реализации самой операции внимания.
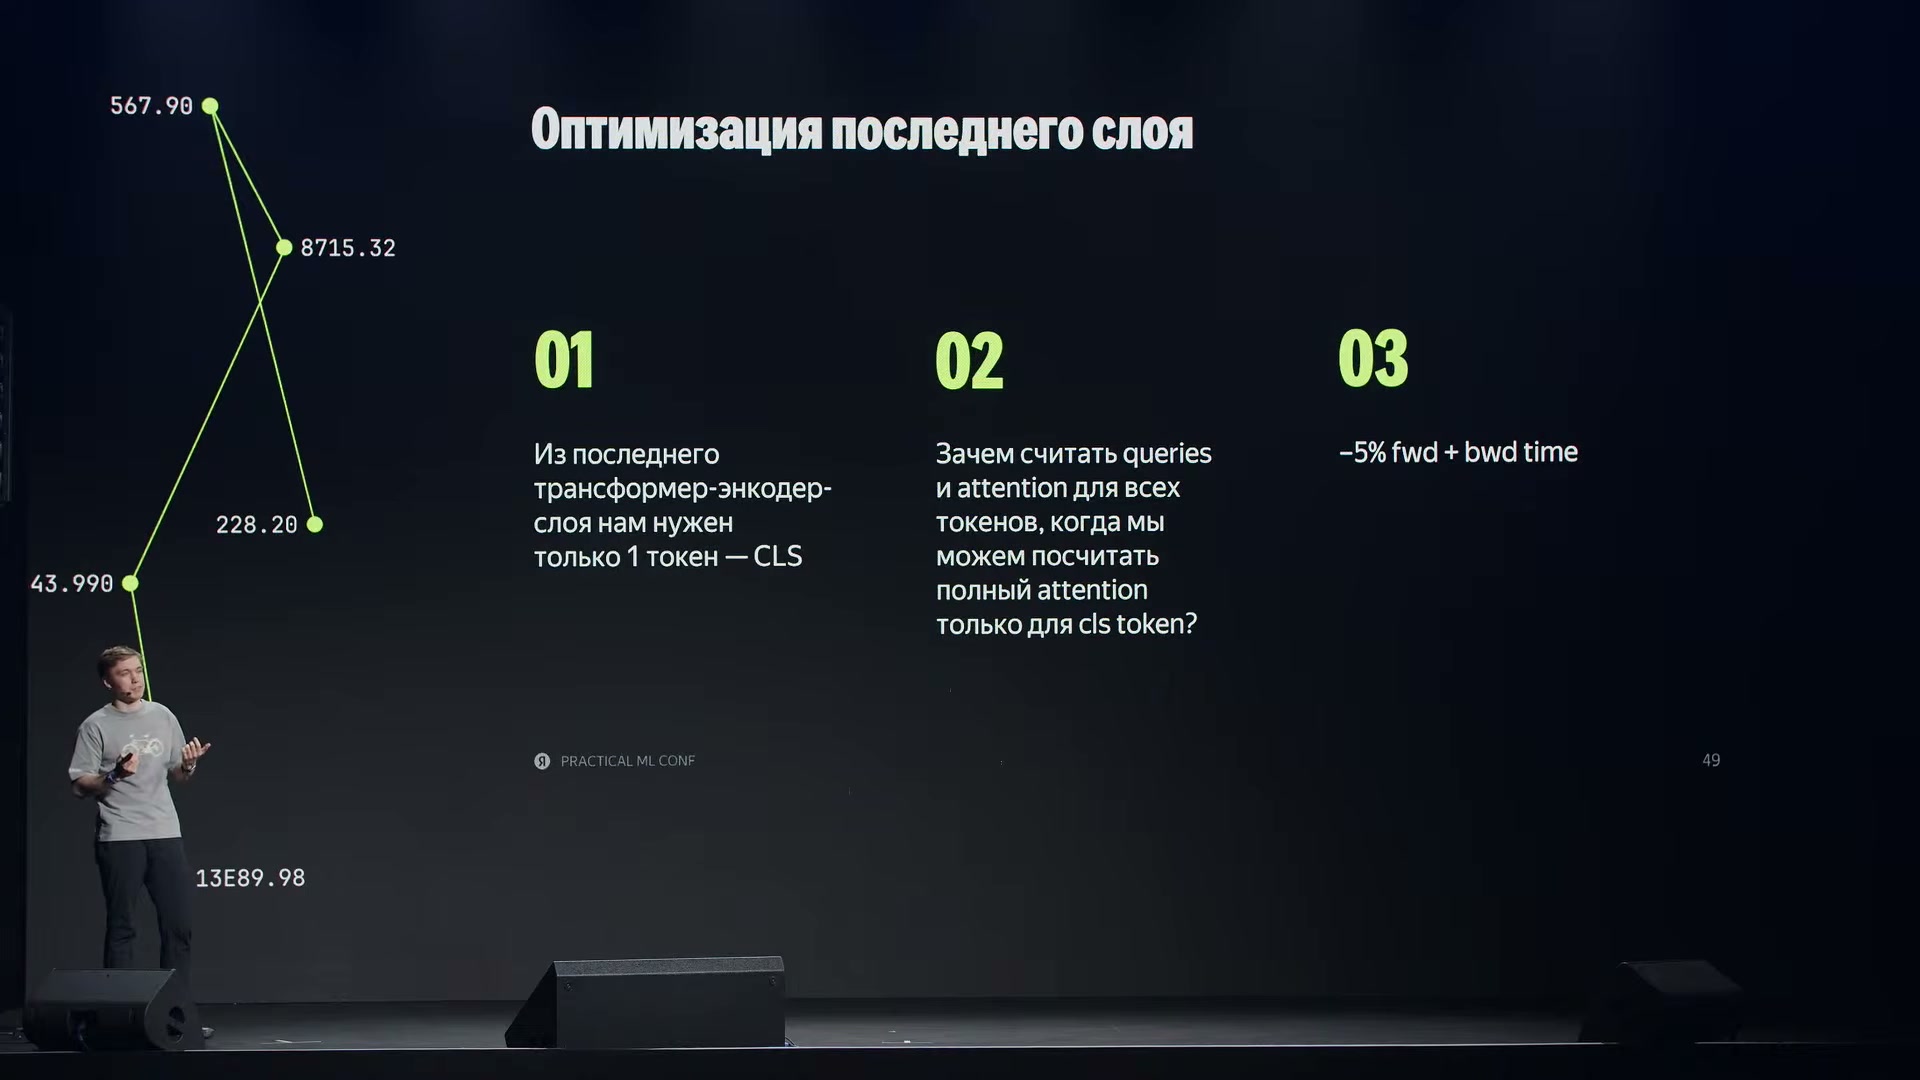
Из последнего слоя нужен только CLS. Расчёт запросов и внимания лишь для этой позиции уменьшил время fwd + bwd на 5%, сохранив доступ к информации остальных токенов.
Источник: Дмитрий Веснин, Авито · Practical ML Conf 2026Почему Flash Attention 2 оказался не самым быстрым вариантом
После устранения лишних вычислений команда сравнила реализации внимания. Интерфейс SDPA может выбирать backend — конкретную реализацию, которая выполняет операцию на видеокарте. В описанной конфигурации item-энкодер не использовал маски, ограничивающие связи между позициями, и по умолчанию выбирался Flash Attention 2.
На коротких последовательностях item-энкодера этот выбор оказался не самым быстрым. При длинах 32–64 другая реализация, Memory Efficient Attention, примерно вдвое быстрее выполняла суммарный прямой и обратный проходы внимания. Речь идёт о числе токенов внутри представления объявления, а не о длине пользовательской истории.
Автор объясняет результат обработкой данных плитками — блоками фиксированного размера. Группа потоков видеокарты, thread block, обрабатывает несколько запросов Q и последовательно проходит по блокам ключей K и значений V. Значения V содержат информацию, которую внимание переносит между позициями. Размеры плиток задаются при компиляции вычислительной программы.
Таблицу можно прокрутить по горизонтали.
Когда последовательность короче плитки, часть предусмотренной работы не приносит полезного результата. В показанной конфигурации блок на 128 запросов оказывается велик для входа длиной 32–64. Более известная и сложная реализация поэтому уступает другой на конкретных небольших входах.
Из этого наблюдения выросла следующая гипотеза. Обе сравниваемые реализации рассчитаны и на более длинные последовательности, тогда как item-энкодеру нужна узкая область размеров. Значит, можно попробовать собственную операцию внимания, в которой не будет возможностей и вычислительной организации, избыточных для этой задачи.
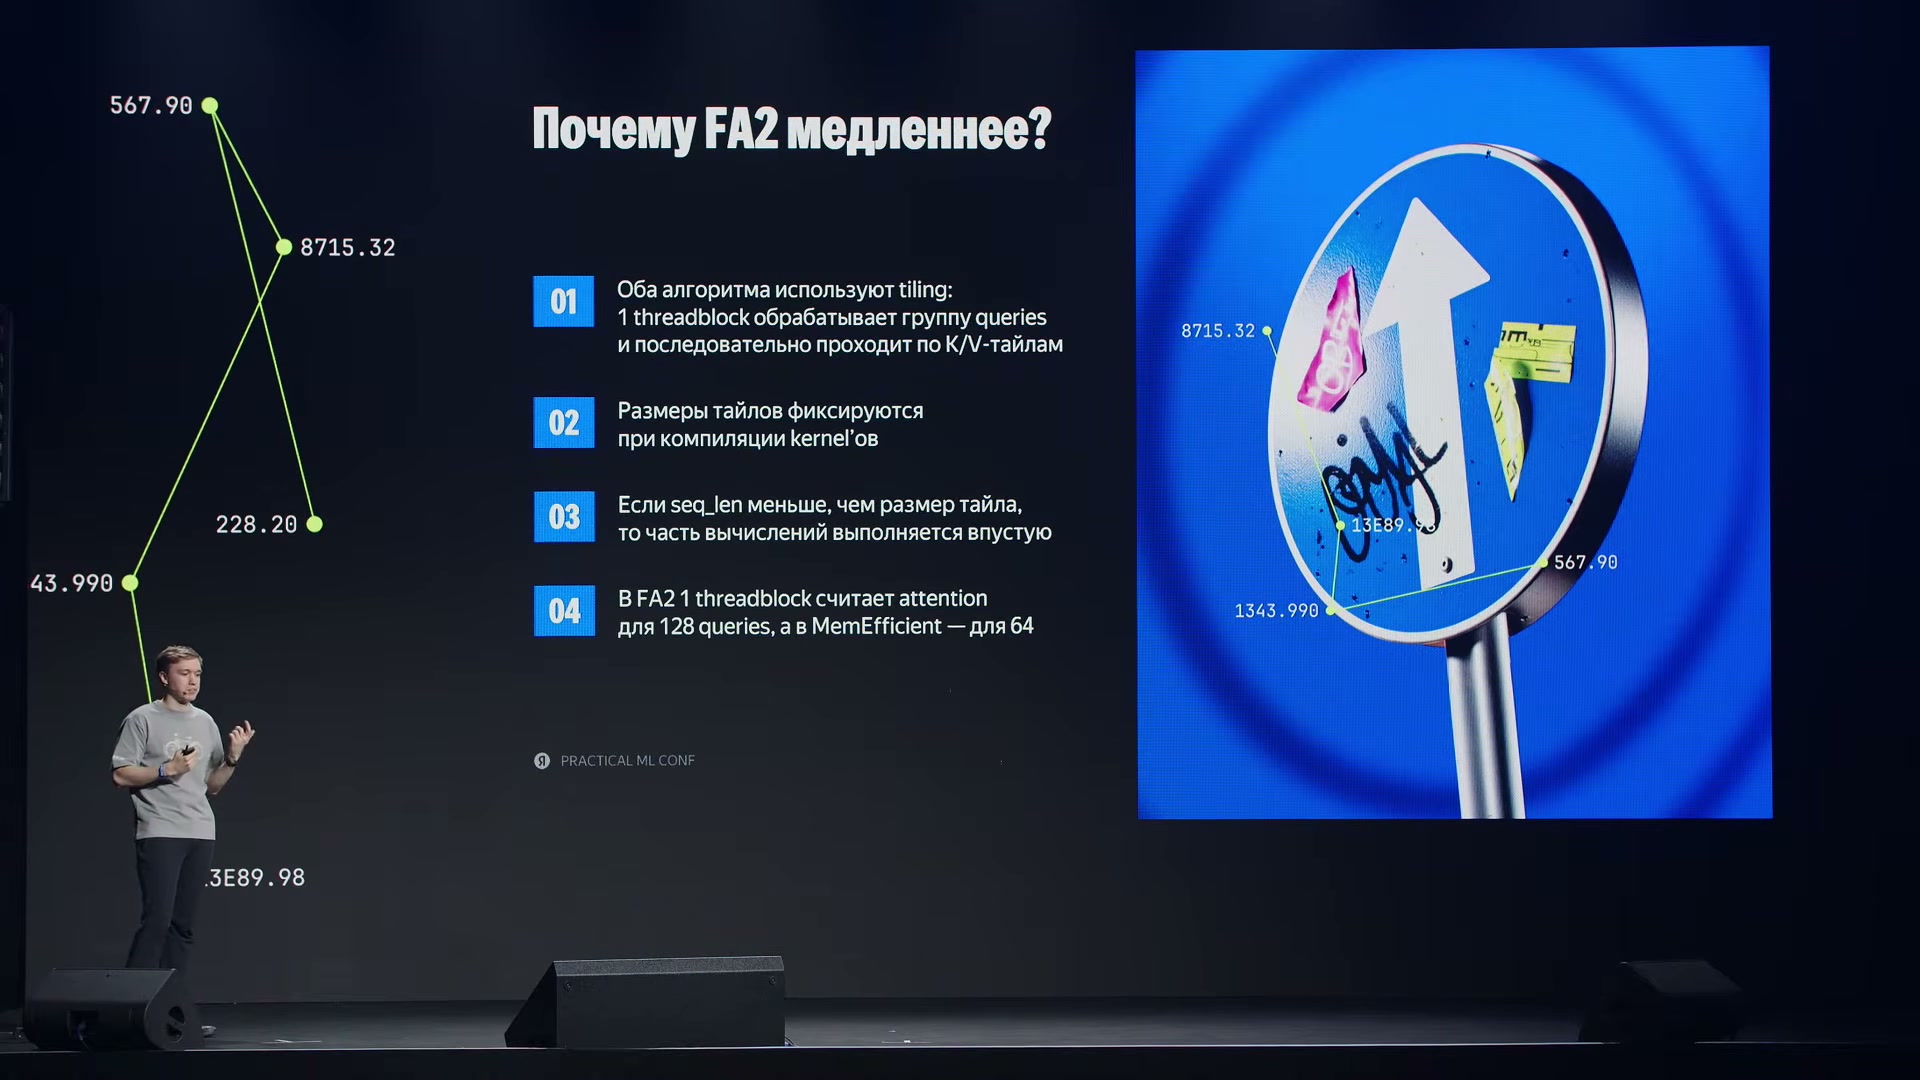
На последовательностях длиной 32–64 размер плитки влияет на полезную работу: в рассмотренной конфигурации Flash Attention 2 обрабатывает 128 запросов на блок, а Memory Efficient Attention — 64.
Источник: Дмитрий Веснин, Авито · Practical ML Conf 2026Собственная операция внимания под короткие последовательности
Команда написала вычислительное ядро, kernel, на Triton. Ядро — программа, которая выполняет конкретную часть вычислений на видеокарте. Специализация опиралась на ограничения item-энкодера: короткие последовательности, отсутствие масок и отсутствие необходимости в dropout — случайном отключении части значений во время обучения.
Матрицу сопоставлений запросов и ключей, Q × Kᵀ, решили вычислять целиком, без дальнейшего разбиения на плитки. При целевых длинах она достаточно мала для такого подхода. Вместе с обработкой по плиткам отпала необходимость в online softmax — способе вычислять нормировку, последовательно обрабатывая части матрицы.
Это отказ именно от online softmax, а не от softmax вообще. Softmax превращает оценки совместимости в нормированные веса внимания; слово online здесь относится к организации вычислений по частям. Когда небольшая матрица обрабатывается целиком, специальная схема накопления по плиткам уже не нужна.
Одну из оптимизаций обратного прохода команда сохранила: матрицу Q × Kᵀ не хранили после прямого прохода, а рассчитывали заново, когда требовались градиенты. Так собственное ядро сочетало более простую организацию внимания с уже знакомым разменом — дополнительные вычисления вместо хранения промежуточного результата.
Результаты сравнили для нескольких длин последовательности и размерностей головы внимания. Размерность головы, Head_dim, — число координат в представлении одной головы, а не количество голов. Столбец Ours vs best показывает ускорение собственного ядра относительно лучшего из сравниваемых вариантов.
Таблицу можно прокрутить по горизонтали.
На целевых длинах 32 и 64 выигрыш существенный: от 2,41× до 3,59× в показанных конфигурациях. При длине 128 преимущество уже гораздо меньше — 1,17× и 1,15×. Отдельно на том же слайде указан результат для обучения модели в целом: ускорение на 45%. Это другой уровень измерения, чем время одной операции внимания.
При дальнейшем увеличении длины специализированное решение проигрывает. В устном пояснении автор отмечает, что на длине 256 и далее собственное ядро становится значительно медленнее Flash Attention 2. Поэтому результат этой работы — эффективная реализация для коротких последовательностей, а не универсальная замена существующим вариантам внимания.
Все ускорения в этой истории относятся к разным изменениям и разным участкам вычислений: демонстрационному примеру, проходам модели или операции внимания. Они не складываются в общий процент и не описывают задержку выдачи рекомендаций. Для воспроизведения замеров также потребовались бы не раскрытые в докладе сведения об оборудовании, точности вычислений и полных размерах входов.
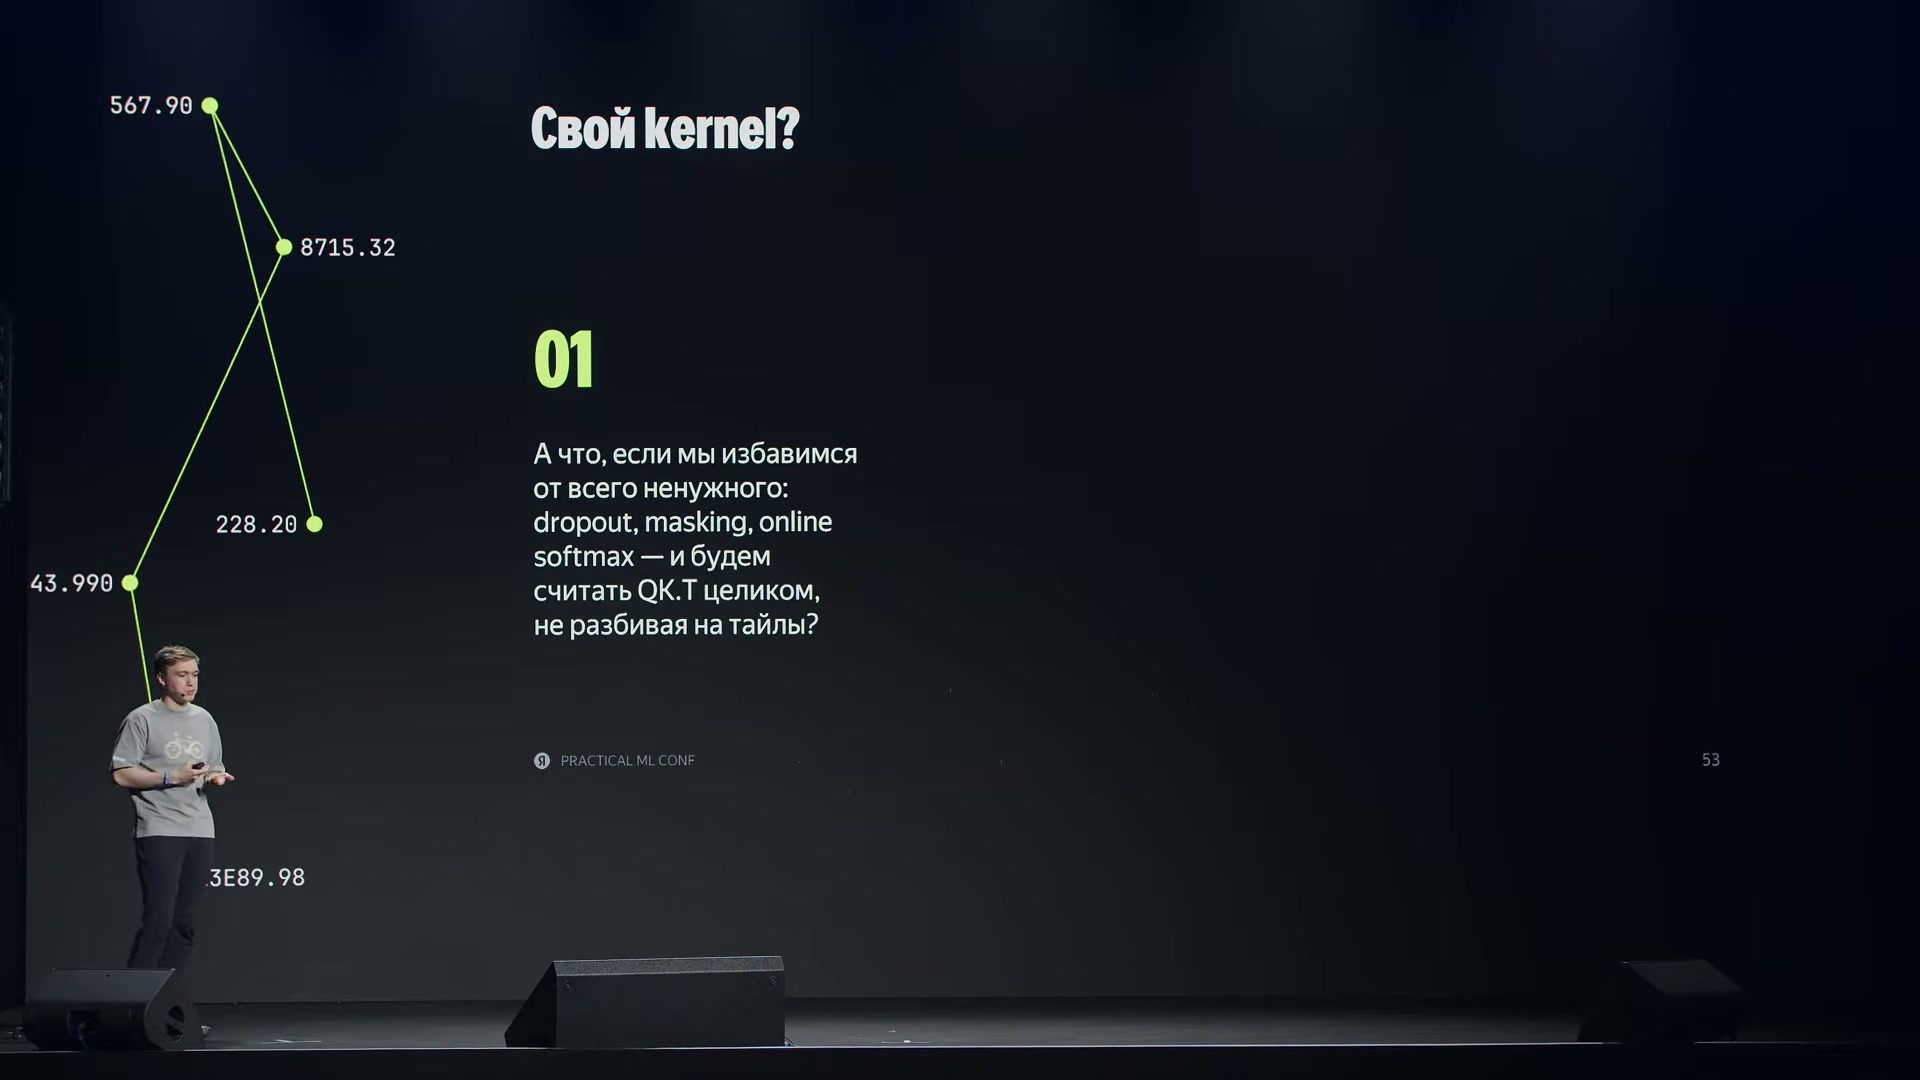
Короткая последовательность позволяет считать Q × Kᵀ целиком. Собственное ядро обходится без dropout, масок и online softmax; речь идёт об отказе от обработки нормировки по частям, а не от softmax.
Источник: Дмитрий Веснин, Авито · Practical ML Conf 2026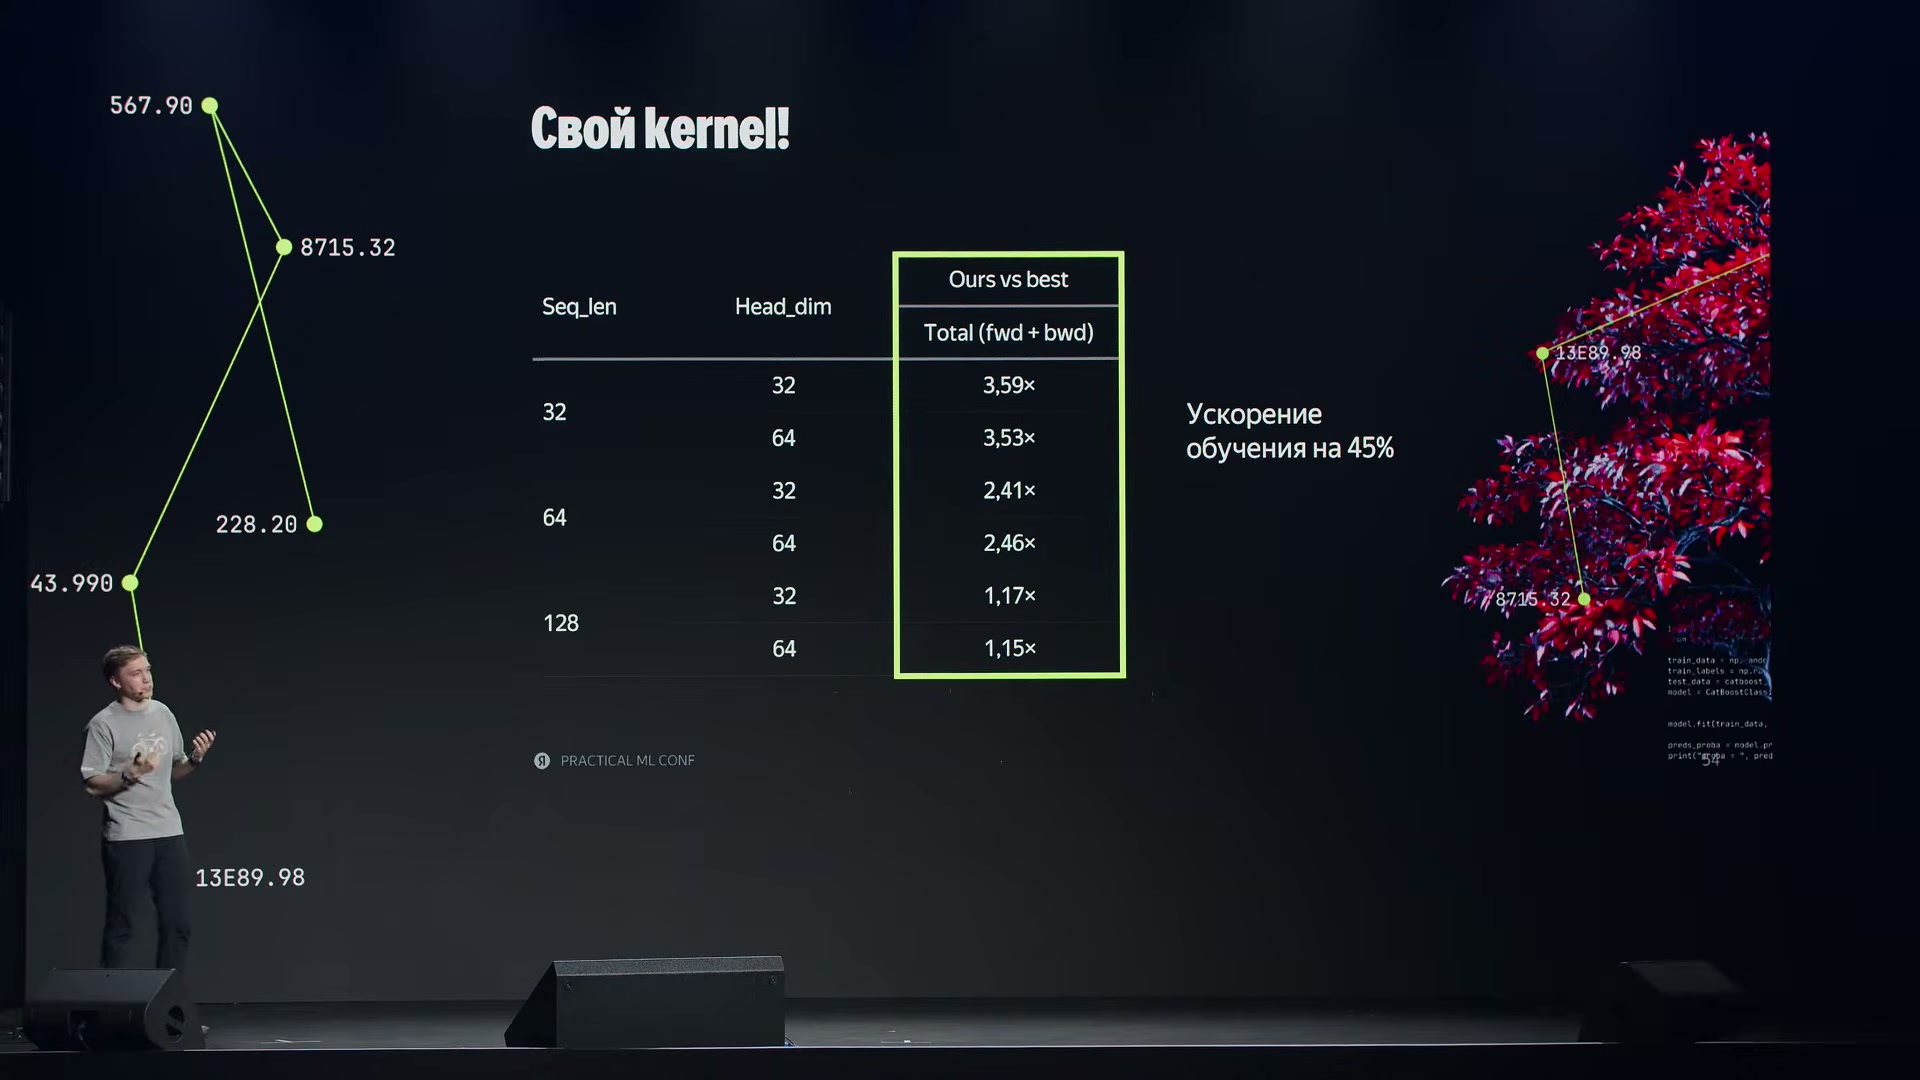
Собственное внимание ускоряет fwd + bwd в 3,53–3,59 раза при длине 32 и в 2,41–2,46 раза при длине 64. При длине 128 выигрыш уменьшается до 1,15–1,17 раза. Отдельный результат для обучения модели — ускорение на 45%.
Источник: Дмитрий Веснин, Авито · Practical ML Conf 2026Что показала проверка в продукте
После разработки нового item-энкодера, восстановления устойчивости и ускорения обучения команда обучила модель и проверила её в A/B-тесте — сравнении вариантов системы на разных группах. Теперь оценивались не величина активаций и не время проходов, а изменения в поведении пользователей и результатах продукта.
Три показателя отражают разные стороны результата. Первая метрика относится к числу покупателей, вторая — к выручке конкретных монетизационных инструментов, третья — к переходу от показа объявления к контакту в указанном движке. Вместе они показывают, как изменение компонента отбора кандидатов отразилось на продуктовых метриках.
В исходной архитектуре item-энкодер использовал DCNv2, а новая версия — трансформер. Однако точный состав контрольной конфигурации, длительность теста, объём выборки, исходные уровни метрик и доверительные интервалы не раскрыты. Поэтому здесь сохранены сами заявленные процентные изменения без пересчёта в абсолютные значения или процентные пункты.
Эксперимент проверял подготовленную новую версию модели. Отдельного A/B-разложения на вклад внимания, настроек обучения и каждой вычислительной оптимизации в докладе нет. История показывает путь к работающему варианту и его результат, а не изолированную оценку одного изменения при полностью неизменной остальной системе.
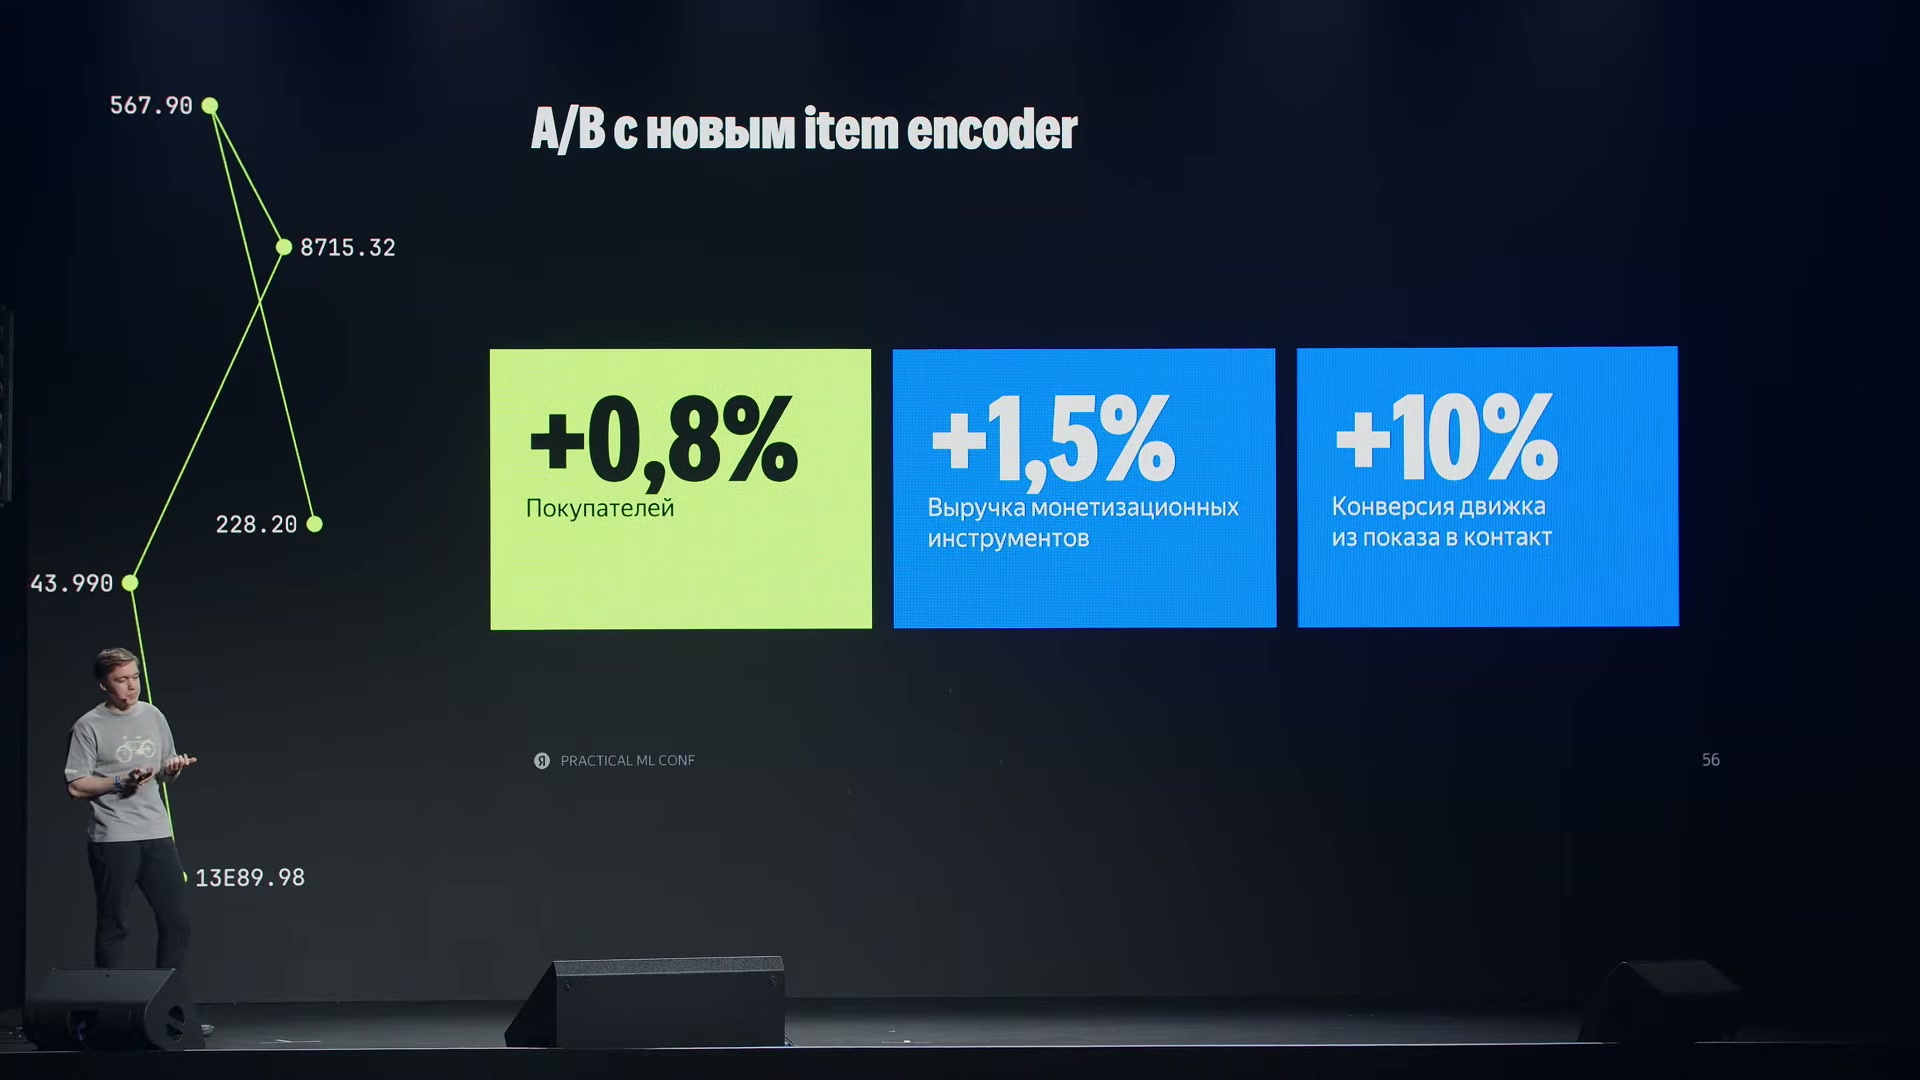
A/B-тест модели с новым item-энкодером: +0,8% покупателей, +1,5% выручки монетизационных инструментов и +10% конверсии движка из показа в контакт.
Источник: Дмитрий Веснин, Авито · Practical ML Conf 2026Какие выводы команда связывает со своими экспериментами
В итогах доклада автор положительно оценивает совместное обучение энкодеров. При этом инженерная история состоит не только в выборе более сложной архитектуры. До её замены команда исправила ошибки подготовки данных, которые создавали противоречивые обучающие примеры. Отключение ограничения градиентов помогло обнаружить причину, скрытую за внешне более спокойным обучением.
Другая полезная идея пришла из исследования, не посвящённого рекомендательным системам. Равенство параметров Adam было простой гипотезой, которую удалось быстро проверить. В этом случае чтение исследований дало не готовую новую модель, а небольшое изменение уже работающего процесса обучения.
Выводы о скорости опираются на понимание оборудования. Компиляция помогла сократить обращения к памяти, а пересчёт активаций — освободить память ценой дополнительной работы. Выбор лучшего варианта checkpointing потребовал сравнить несколько областей пересчёта. Собственное внимание стало выгодным после того, как команда учла фактические размеры входов и увидела избыточную работу универсальных реализаций.
Отдельный вывод касается взаимодействия изменений. Новый формат данных раньше проявил нестабильность, которая существовала и на старом. Экономный пересчёт FFN иначе взаимодействовал с компиляцией, чем пересчёт целых слоёв. Последовательное возвращение к предыдущим вариантам оказалось полезнее, чем дальнейшее добавление способов стабилизации поверх неизвестной причины.
Собственная реализация трансформера была удобна потому, что команда понимала, какие части хочет менять. Специализированное ядро было выгодно потому, что условия задачи позволяли отказаться от лишней универсальности. В обоих случаях решение выросло из конкретного ограничения: из необходимости свободно менять архитектуру или из короткой длины последовательностей, на которой выполнялось обучение.
Доклад · 02:45:54Что осталось за пределами успешного A/B-теста
Вопросы после доклада добавляют важную перспективу. Один из слушателей спрашивает, почему улучшения рекомендательных систем не всегда создают для пользователя столь же заметное впечатление, как изменения больших языковых моделей. Докладчик не даёт точного объяснения. Он признаёт разрыв между положительными результатами A/B-тестов и изменением продукта, которое люди сами заметили бы и оценили.
Другой вопрос касается смещения к популярным объявлениям и длинного хвоста — множества объектов, которые встречаются и получают внимание значительно реже. Ранее популярность помогла ускорить обучение: пересечения историй позволили переиспользовать векторы. Но это вычислительная выгода, а не решение проблемы чрезмерного предпочтения популярных объектов.
По словам автора, работа со смещением проходила в два этапа. На первом его немного уменьшили, и результат оказался приемлемым. На втором ослабили значительно сильнее, после чего A/B-тест дал отрицательный результат. Конкретные методы и численные изменения метрик для этих двух этапов не приведены.
Сложность автор связывает с продуктовыми ограничениями: снижение смещения само по себе недостаточно, если одновременно ухудшаются важные для компании показатели. На момент рассказа команда намеревалась продолжать работу над неудачным вариантом, но готового решения не представила.
Таким образом, развитие item-энкодера решило часть задач качества и обучения, но не завершило работу над рекомендациями. Предпочтение популярных объявлений, внимание к длинному хвосту и заметность улучшений для самого пользователя остались отдельными вопросами.
Доклад · 02:48:20Итог: путь команды и работа полученной системы
Команда Авито хотела сделать представления объявлений выразительнее и заменить DCNv2 трансформером. Путь к этой замене начался с исправления данных и настройки Adam, продолжился компиляцией и экономией памяти, а затем привёл к расследованию позднего срыва обучения. После локального отключения компиляции в w3 команда вернула устойчивость и сократила лишние вычисления: повторную обработку одинаковых объявлений, ненужные выходы последнего слоя и избыточную работу внимания на коротких последовательностях.
- 01
Получить признаки
Модель получает признаки объявлений. Отдельной обучаемой таблицы векторов по идентификаторам в выбранной постановке нет: представление строится из доступных свойств объекта.
- 02
Построить векторы объявлений
Трансформерный item-энкодер связывает токены признаков механизмом внимания. Представление CLS становится вектором объявления; в последнем слое вычисляется внимание только для этой позиции.
- 03
Обработать историю
Энкодер пользователя принимает последовательность векторов объявлений из истории и строит представление интересов пользователя.
- 04
Отобрать кандидатов
Модель использует близость представлений пользователя и объявлений, чтобы сократить миллионы объектов до сотен или тысяч подходящих кандидатов.
- 05
Передать на ранжирование
Следующий этап рекомендательной системы получает кандидатов и упорядочивает их. Его устройство остаётся за пределами доклада.
Это применение уже обученной модели. Подготовка данных, настройка оптимизатора и пересчёт активаций относятся к отдельному процессу обучения.
В A/B-тесте заявлены +0,8% к числу покупателей, +1,5% к выручке монетизационных инструментов и +10% к конверсии движка из показа в контакт. Подробные параметры эксперимента и вклад отдельных изменений не раскрыты. Вычислительные решения тоже имеют границы: собственное внимание рассчитано прежде всего на длины 32–64, а причина сбоя компиляции осталась неясной. Более сильное снижение смещения к популярным объявлениям привело к отрицательному A/B-тесту, поэтому работа над длинным хвостом продолжилась.
Доклад · 02:18:18