Разбор готов
Яндекс — AgentOps в продакшене: от моделей поддержки к конструктору агентов
В поддержку контентных сервисов Яндекса приходят с вопросами о подписках, возвратах и других проблемах, которые раньше помогали решать операторы и заранее подготовленные сценарии. Языковые модели позволили учитывать историю разговора, отвечать по базе знаний и обращаться к инструментам, но одного подключения модели оказалось недостаточно. Нужно было ускорить ответы, сохранить обслуживание при сбоях, разделить вычислительные ресурсы между поддержкой и внутренними задачами, а затем устранить задержки в создании новых сценариев. Разберём весь этот путь: маршрутизацию обращений, распределение задач между моделями, ускорение генерации, инфраструктуру доступа и внутренний конструктор Conclave AI. Организацию разработки и эксплуатации таких агентов здесь будем называть AgentOps.
Материал полезен инженерам машинного обучения и разработчикам серверной части, которые встраивают языковые модели в действующий сервис, а также продуктовым менеджерам, отвечающим за автоматизацию поддержки. Он показывает, как связаны скорость моделей, устойчивость инфраструктуры, качество помощи пользователю и процесс подготовки новых сценариев.
Видео · на русском
AgentOps в продакшене: инфраструктура для LLM-агентов и автоматизация поддержкиИван Насонов · Опубликовано: 14 июля 2026 г.
Исходный доклад · Открыть оригинал
Продукт: поддержка шести сервисов и миллионы обращений
Поддержка объединяет шесть сервисов: Кинопоиск, Музыку, Афишу, Книги, Яндекс Плюс и Плюс AdTech. На момент доклада она получает 75 тысяч обращений ежедневно и примерно 2,5 миллиона в месяц. За этим потоком стоят конкретные задачи: разобраться с подпиской, вернуть деньги, найти нужный аккаунт или продолжить решение вопроса, который не удалось закрыть самостоятельно.
Если автоматический сценарий не помогает, к диалогу подключается оператор. Поэтому задача команды — не просто научить модель составлять сообщения. Автоматизацию нужно встроить в существующую поддержку: определить проблему, выбрать подходящий способ помощи, выполнить необходимые действия и сохранить передачу обращения сотруднику.
В основе разбора — доклад Ивана Насонова об инфраструктуре языковых моделей в поддержке Яндекса. В нём последовательно решаются две задачи. Сначала команда организует работу моделей в пользовательском сервисе, затем меняет процесс создания агентов. Второе становится необходимо, когда техническая инфраструктура уже готова, а новые сценарии по-прежнему появляются слишком медленно.
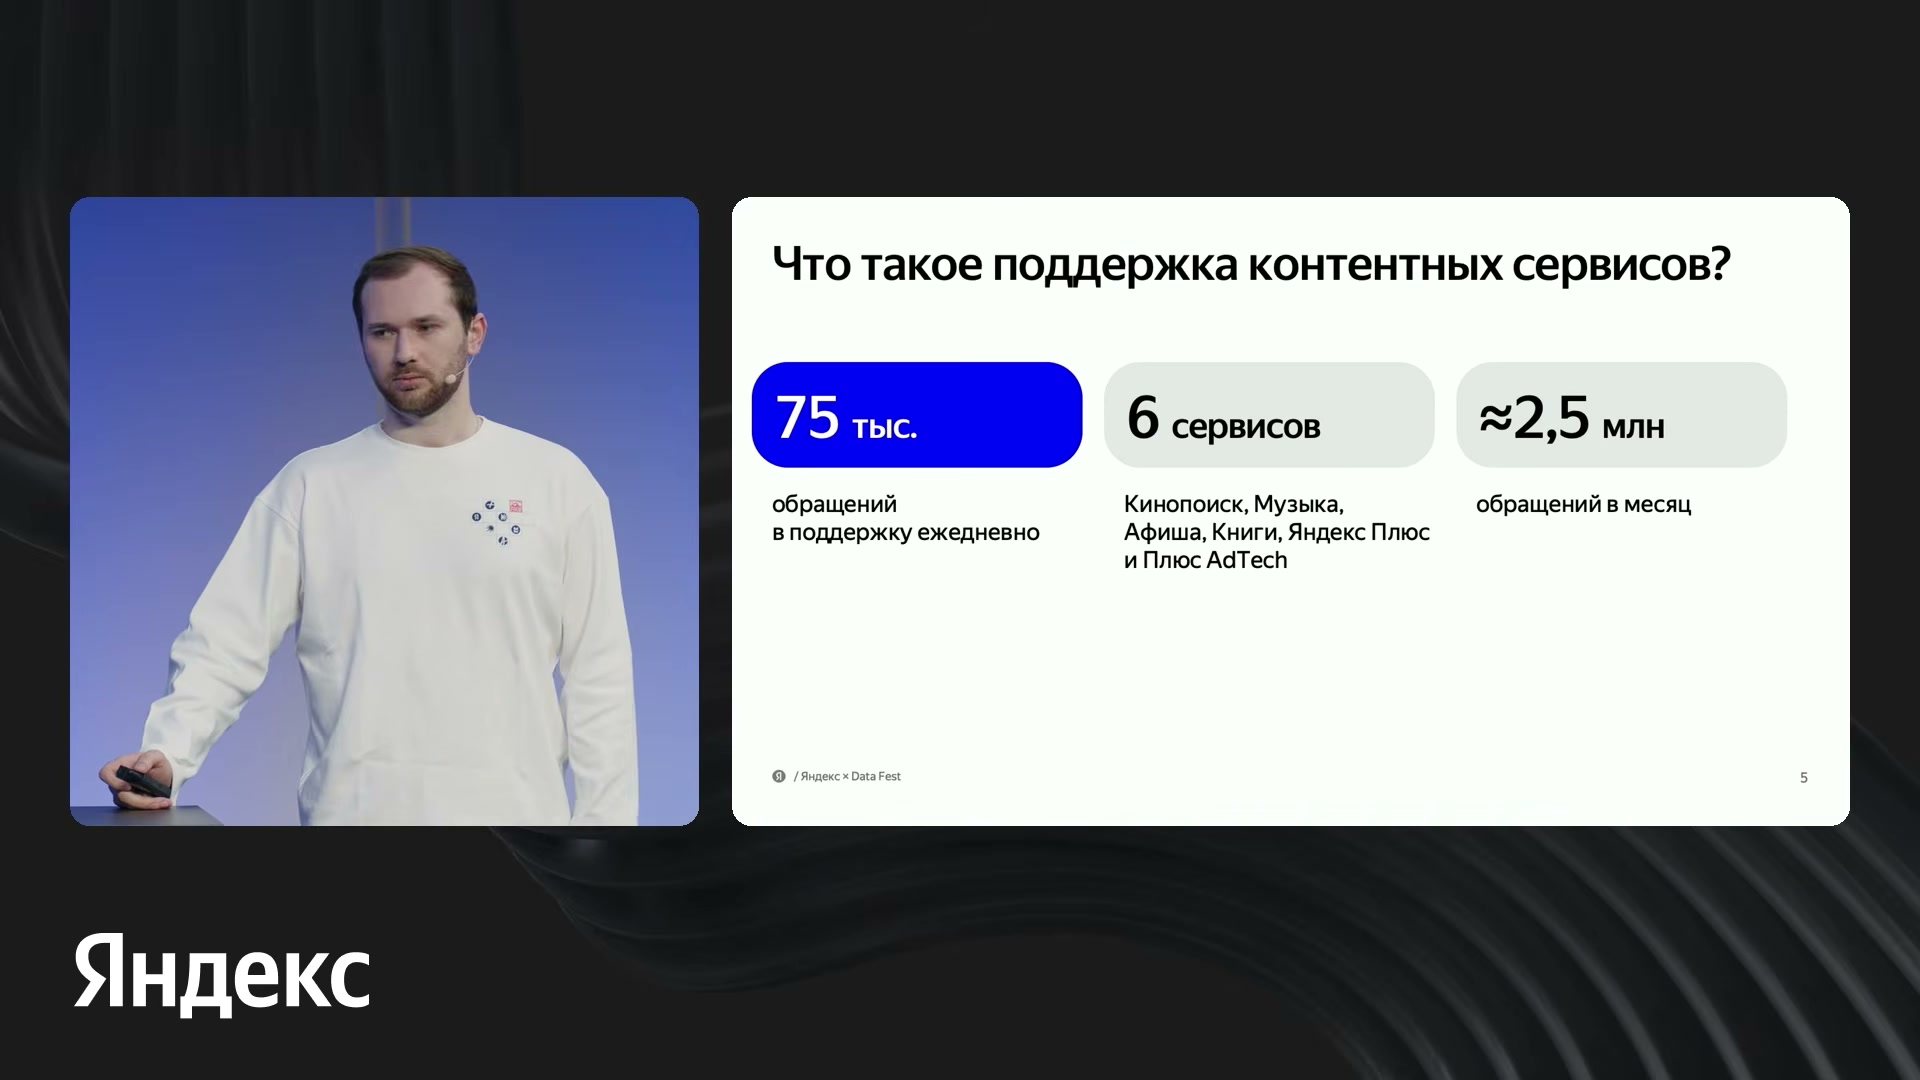
Поддержка шести контентных сервисов получает 75 тысяч обращений ежедневно и примерно 2,5 миллиона в месяц.
Источник: Иван НасоновОт кнопок и графов к десяткам языковых агентов
Автоматизация начиналась не с языковой модели. Более чем за пять лет до доклада поддержка использовала заранее заданный граф: набор сообщений, кнопок и переходов между ними. Описание сценариев находилось в конфигурационном файле, а инструкции выполнялись внутри серверной части на Python. Пользователь выбирал кнопку, например для возврата или поиска аккаунта, и проходил подготовленную последовательность. Если решить вопрос не удавалось, подключался оператор.
Следующий этап получил название Smart Suggest + ML. Вместо самостоятельного поиска нужной ветки пользователь мог описать проблему текстом, а модель определяла её тему. Такая задача называется классификацией: из предусмотренных вариантов нужно выбрать подходящий. Для неё использовали сравнительно простые трансформерные энкодеры — модели, которые превращают текст в числовое представление. Их обучали на коротких пользовательских обращениях и использовали для направления в нужную часть графа.
На этом же этапе появились действия внутри сценариев и поиск аккаунта. Поддержка постепенно переставала быть только навигацией по сообщениям: определение проблемы связывалось с дальнейшей обработкой обращения.
Примерно за год–полтора до доклада появились подсказки ещё во время набора сообщения — Realtime Smart Suggest. Система искала подходящую проблему по уже введённому тексту и предлагала пользователю возможное направление. Для этого использовали Lucene, инструмент полнотекстового поиска. На исторической схеме этот этап прямо описан как обычный полнотекстовый поиск: появление подсказки до отправки сообщения не требовало запуска языкового агента.
Весной 2025 года команда начала внедрять большие языковые модели, или LLM. Они способны учитывать текст разговора и формировать ответ, а не только выбирать одну из известных тем. Первого агента автор относит примерно к марту того же года. Агентом здесь называется система, в которой модель ведёт сценарий, выбирает дальнейшие действия и обращается к подключённым знаниям и инструментам.
Создание первого агента оказалось долгим и трудным процессом. К моменту доклада в работающем сервисе уже использовались десятки LLM-агентов, но прежние модели и графы не исчезли. Поддержка стала продуктом с несколькими способами обработки обращений, собственной архитектурой и накопленной экспертизой, которую команда применяет и при работе с другими сервисами Яндекса.
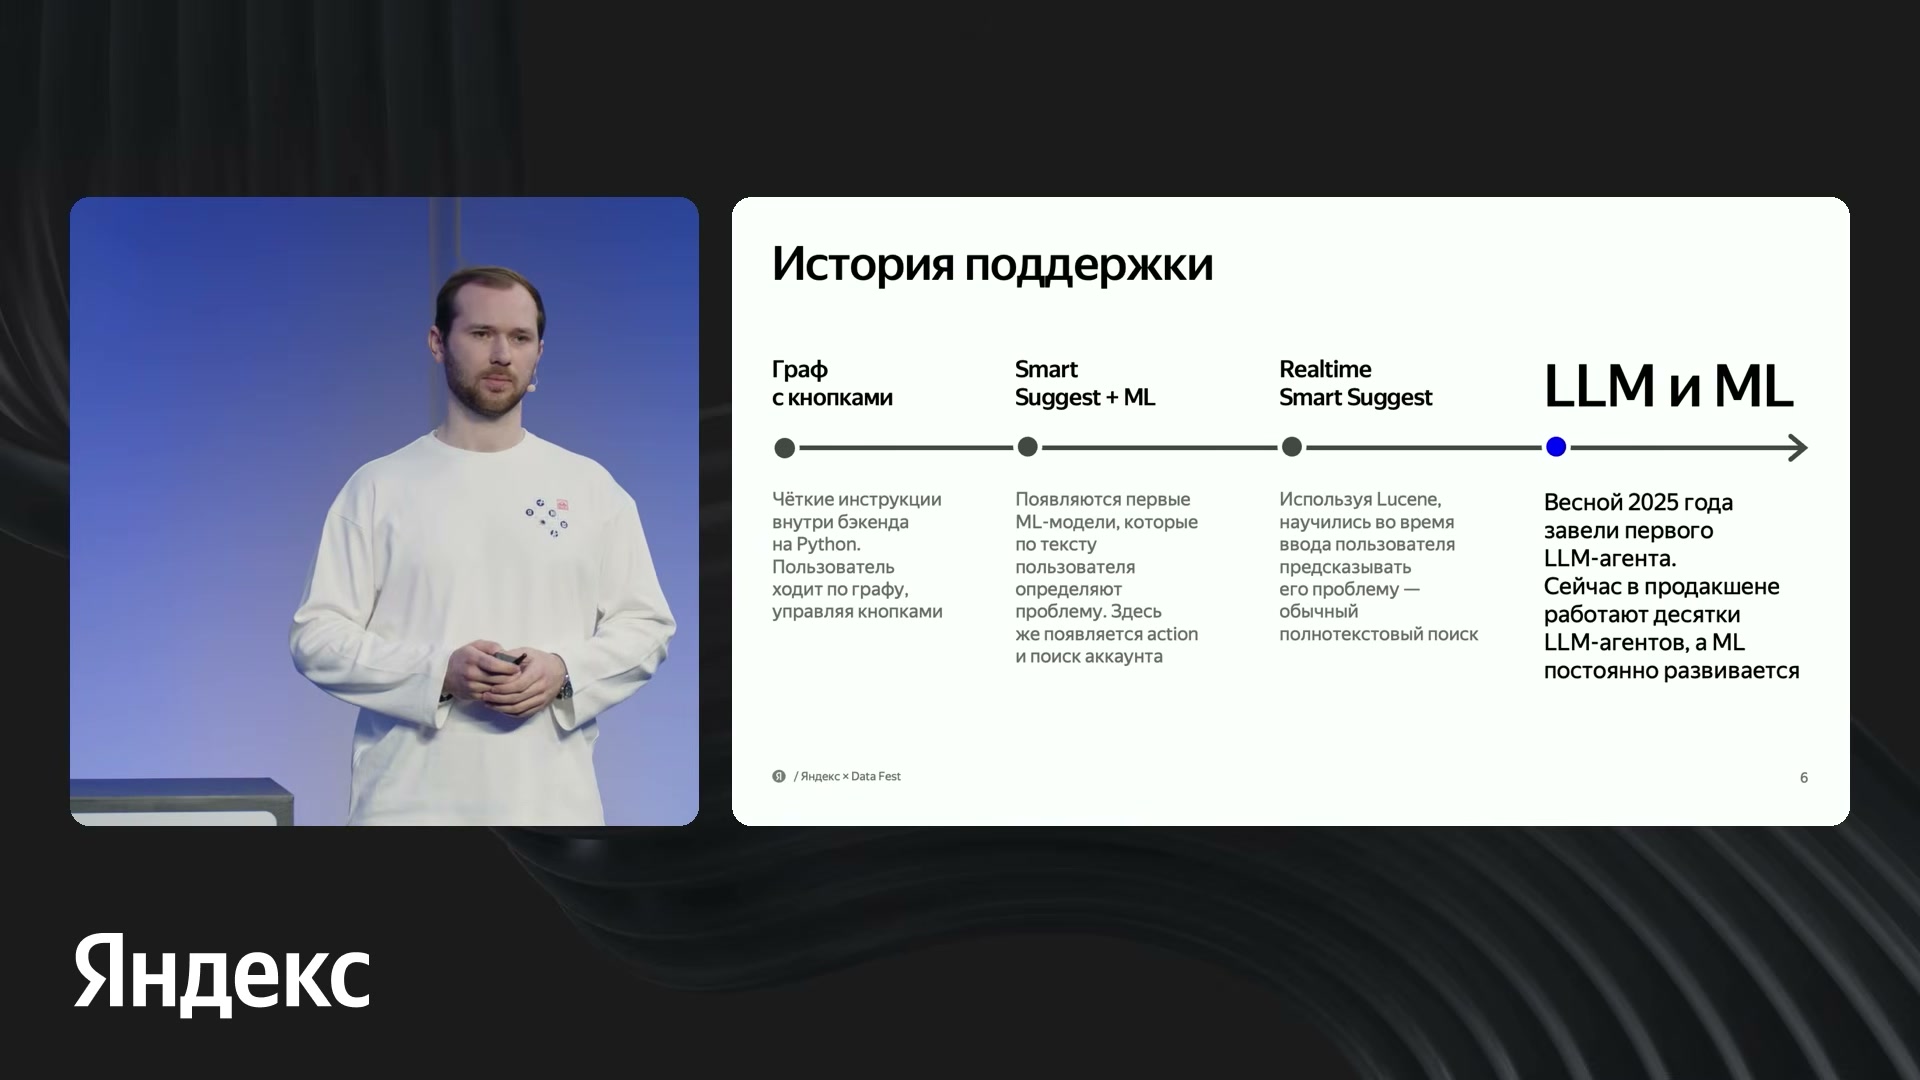
Автоматизация развивалась последовательно: граф с кнопками, классификация текста, подсказки на Lucene во время ввода и затем языковые агенты.
Источник: Иван НасоновКак обращение попадает к нужному сценарию
Путь обращения начинается с лёгкого классификатора. Он пытается определить, с какой проблемой пришёл пользователь. Для этой задачи не обязательно запускать большую генеративную модель: сначала требуется выбрать тему, а не составить подробный ответ.
Если классификатор не справился, недостаточно уверен или выбрал класс, означающий отсутствие подходящей проблемы среди известных вариантов, диалог передают языковой модели-классификатору. Это запасной путь обработки, или fallback. Его важное отличие — доступ ко всей истории взаимодействия, а не только к последней короткой реплике.
Автор приводит пример: человек завершил сценарий возврата денег, но теперь хочет купить другой тариф. Последняя реплика связана с предыдущим разговором, хотя дальнейший маршрут должен измениться. Модель с доступом к истории может определить, к какому сценарию направить пользователя и требуется ли помощь оператора.
После определения темы система выбирает между готовой инструкцией и агентом. В первом случае пользователь продолжает работу с подготовленным графом. Во втором агент получает доступ к базе знаний по соответствующей проблеме. Поиск нужных материалов перед формированием ответа называется RAG: модель использует найденную информацию в разговоре с пользователем.
Таким образом, языковая модель выполняет разные роли: может уточнять маршрут обращения и может непосредственно помогать внутри выбранного сценария. Это не обязательный проход каждого сообщения через одного универсального агента. Обе ветки автоматизации сохраняют выход к оператору, если вопрос пользователя не удалось решить.
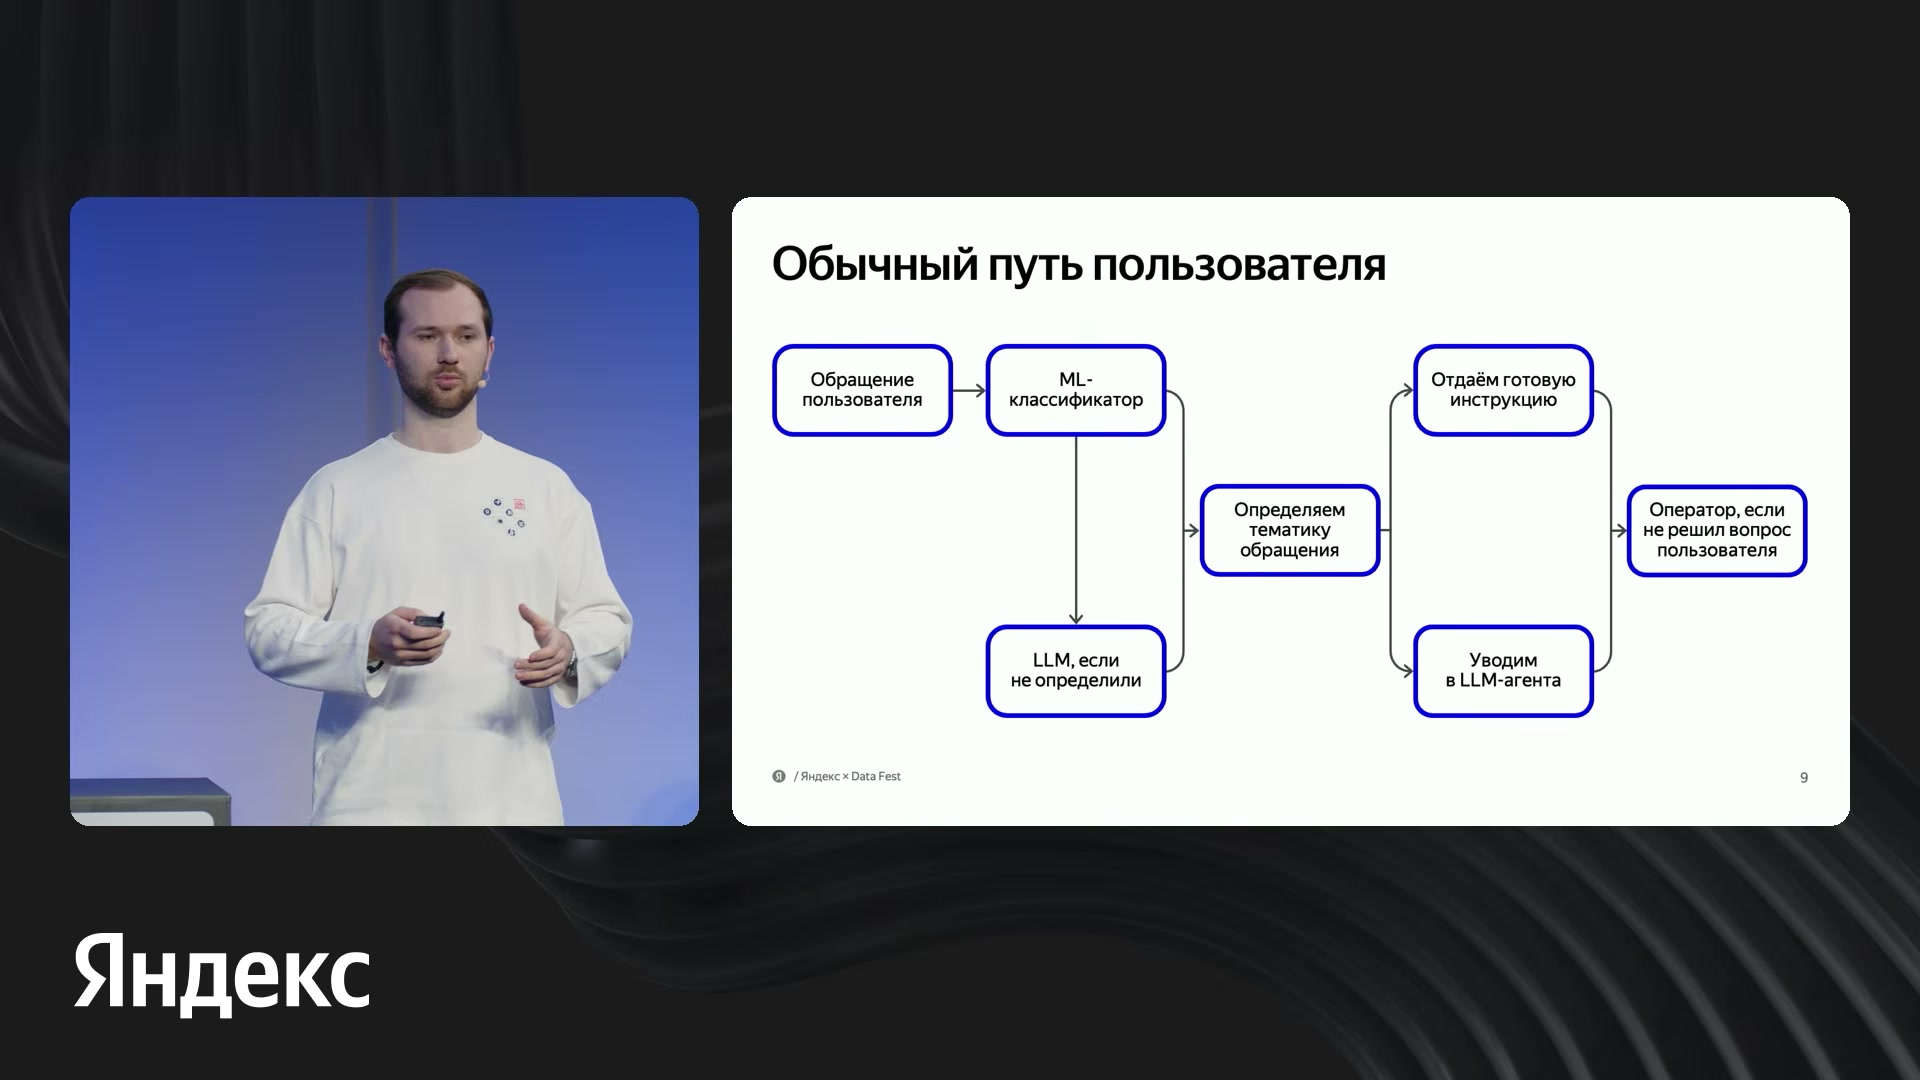
Языковая модель уточняет тему, когда не справился лёгкий классификатор. Затем система выбирает готовую инструкцию или агента, сохраняя передачу нерешённого вопроса оператору.
Источник: Иван НасоновКакие модели работают в поддержке и за что отвечают
Команда разделяет модели на три группы. Лёгкие решения быстро определяют тему и обрабатывают задачи, для которых не требуется большой генеративный ответ. Средние языковые модели обслуживают быстрые чат-боты, уточняют классификацию и проверяют формулировки. Крупные модели используются в сложных сценариях и при работе с накопленными диалогами.
В обозначениях размеров буква B означает миллиарды параметров. Embedder — модель, которая строит векторное представление текста; для этой группы указан диапазон 0.5–1.5B. В генеративных группах также присутствуют модели со смесью экспертов, или MoE: внутри такой архитектуры есть несколько вычислительных модулей, из которых для обработки выбирается часть. Это архитектура одной модели, а не система из нескольких самостоятельных агентов.
Таблицу можно прокрутить по горизонтали.
Команда использует как собственные продукты Яндекса, так и открытые решения. В группе генеративных моделей автор отдельно называет Алису и модели с открытым исходным кодом. Выбор зависит от качества на конкретной задаче. Размер сам по себе не определяет, какую работу нужно поручить модели: важны её роль в сценарии и требования к скорости.
Один из примеров разделения работы — отдельная проверка финального ответа. Основной агент может выполнять длинный сценарий с большим контекстом и множеством инструментов. В таком процессе он способен упустить важное ограничение: например, включить в ответ конфиденциальную информацию или неправильную ссылку.
Для заключительной проверки используется более быстрая модель. Она отвечает за манеру общения, или Tone of Voice, сокращённо ToV. Но её роль шире стилистической правки: модель получает итоговый ответ основного сценария, проверяет его с опорой на собственный контекст и базу знаний, затем корректирует формулировку перед отправкой пользователю. Подготовка ответа и его дополнительная проверка оказываются разными задачами.
Крупные модели нужны не только для пользовательского разговора. Им поручают оценку диалогов: модель рассматривает обращение целиком и определяет, удалось ли решить проблему. Такой компонент называется LLM-Judge — языковая модель выступает в роли оценщика. Команда применяет оценку как вне текущего обслуживания пользователя, так и во время работы системы.
Ещё одна задача крупных моделей — помощь с разметкой. Они распределяют обращения по темам, чтобы облегчить работу разметчиков и улучшать другие модели поддержки. Это работа с данными для оценки и развития системы, а не обязательный шаг каждого ответа пользователю.
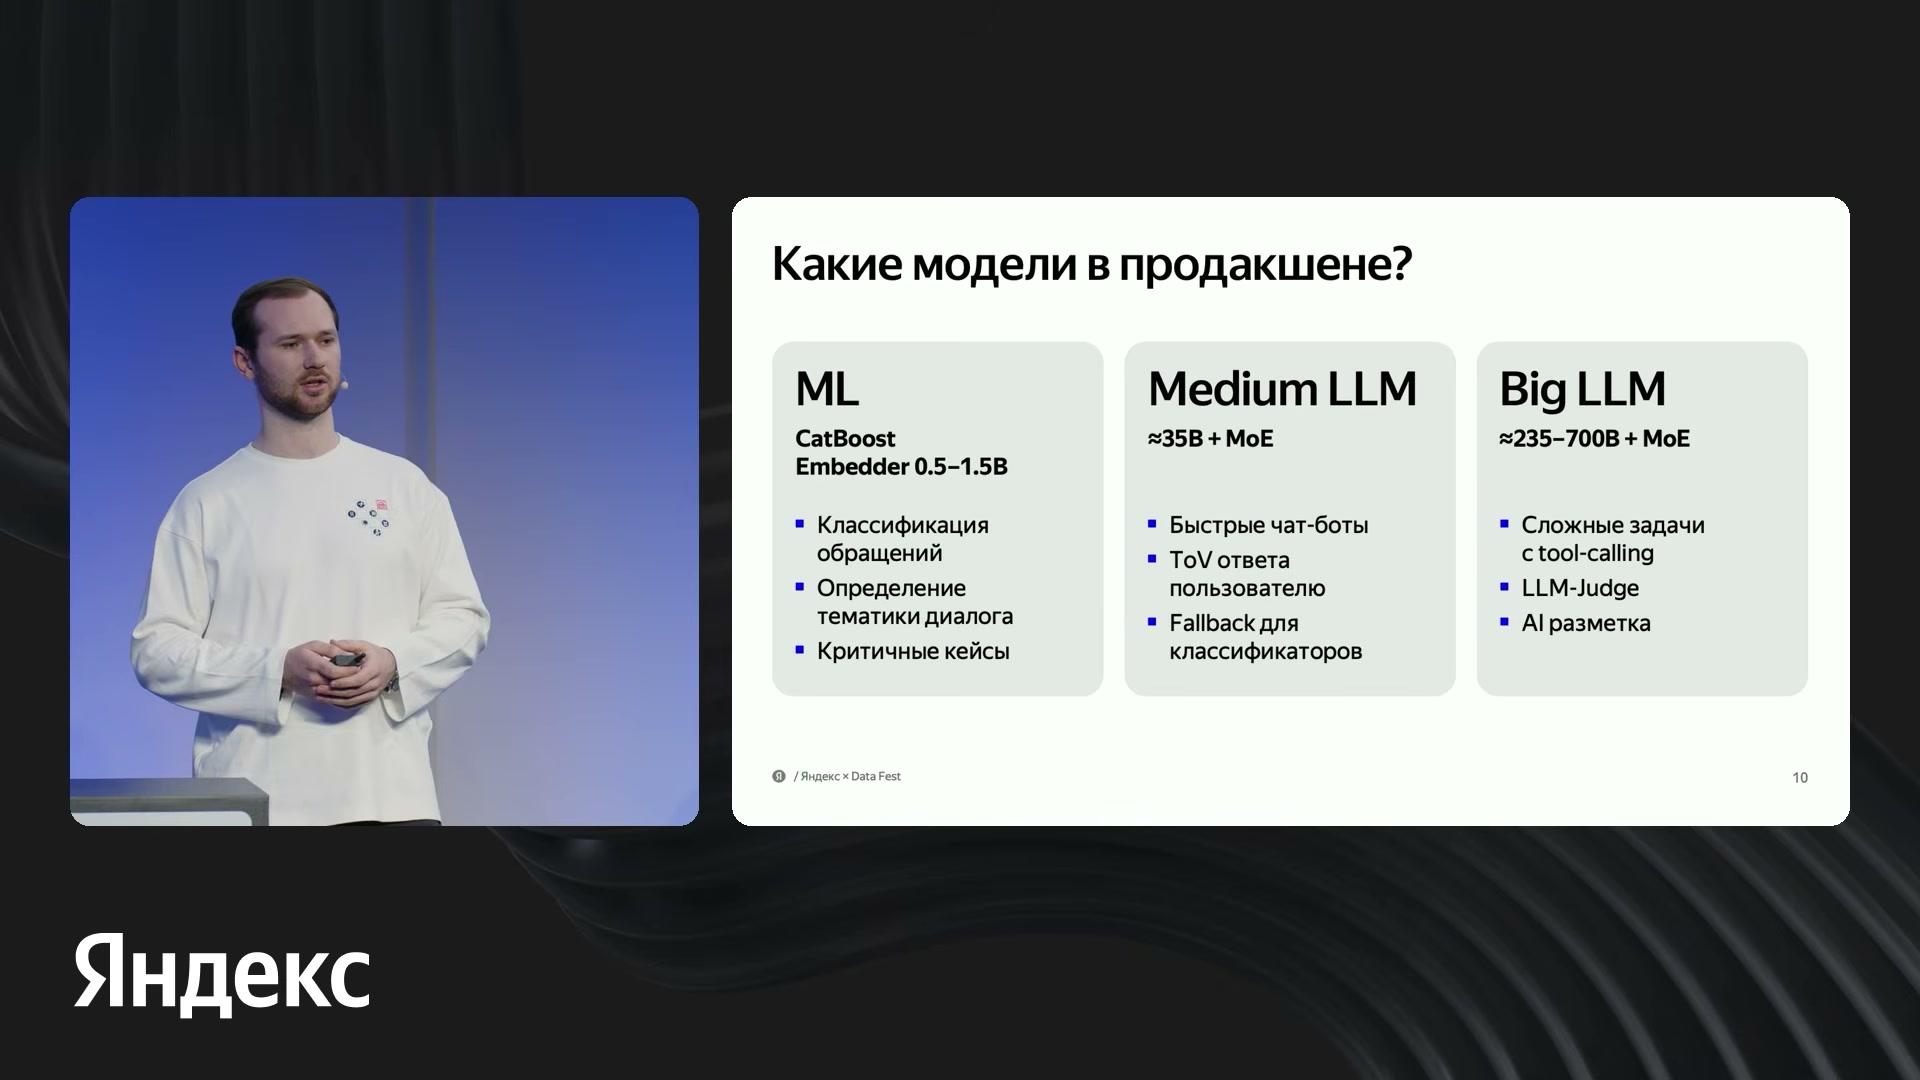
CatBoost и Embedder 0.5–1.5B, Medium LLM ≈35B + MoE и Big LLM ≈235–700B + MoE обслуживают разные задачи — от классификации до сложных действий и оценки диалогов.
Источник: Иван НасоновТри требования: скорость, устойчивость и распределение ресурсов
Выбрать модели недостаточно: нужно организовать их применение к поступающим запросам. Этот процесс называют инференсом. Команда выделяет три постоянные задачи: быстро отвечать пользователям, сохранять работу сервиса при изменении нагрузки и сбоях, а также контролировать доступ к вычислениям.
Для задержки ответа установлен ориентир: не позднее 5 секунд на 90-м перцентиле, или P90. Перцентиль описывает границу распределения: в значение P90 укладываются 90% измерений. Такой ориентир учитывает не только обычные, но и более медленные ответы.
Нагрузка на поддержку меняется в течение суток: днём обращений больше, ночью меньше. Кроме этой регулярной разницы бывают всплески, связанные с событиями в продукте. Например, после повышения стоимости подписки в поддержку может одновременно прийти много пользователей. К этому добавляются инфраструктурные риски: проблемы со связностью дата-центра и учения на кластерах.
Третья задача названа биллингом. Здесь она включает контроль количества токенов и разделение внутренних и пользовательских запросов. Токен — единица текста, с которой работает языковая модель. Учитывать приходится и входной текст, и сгенерированный ответ.
К одним и тем же моделям обращается не только поддержка. Аналитики, менеджеры и другие сотрудники тестируют решения и выполняют внутренние задачи. Запросы из работающего пользовательского сервиса должны иметь более высокий приоритет, но внутреннюю работу тоже нельзя полностью останавливать. Поэтому правила доступа к моделям становятся самостоятельной частью инфраструктуры.
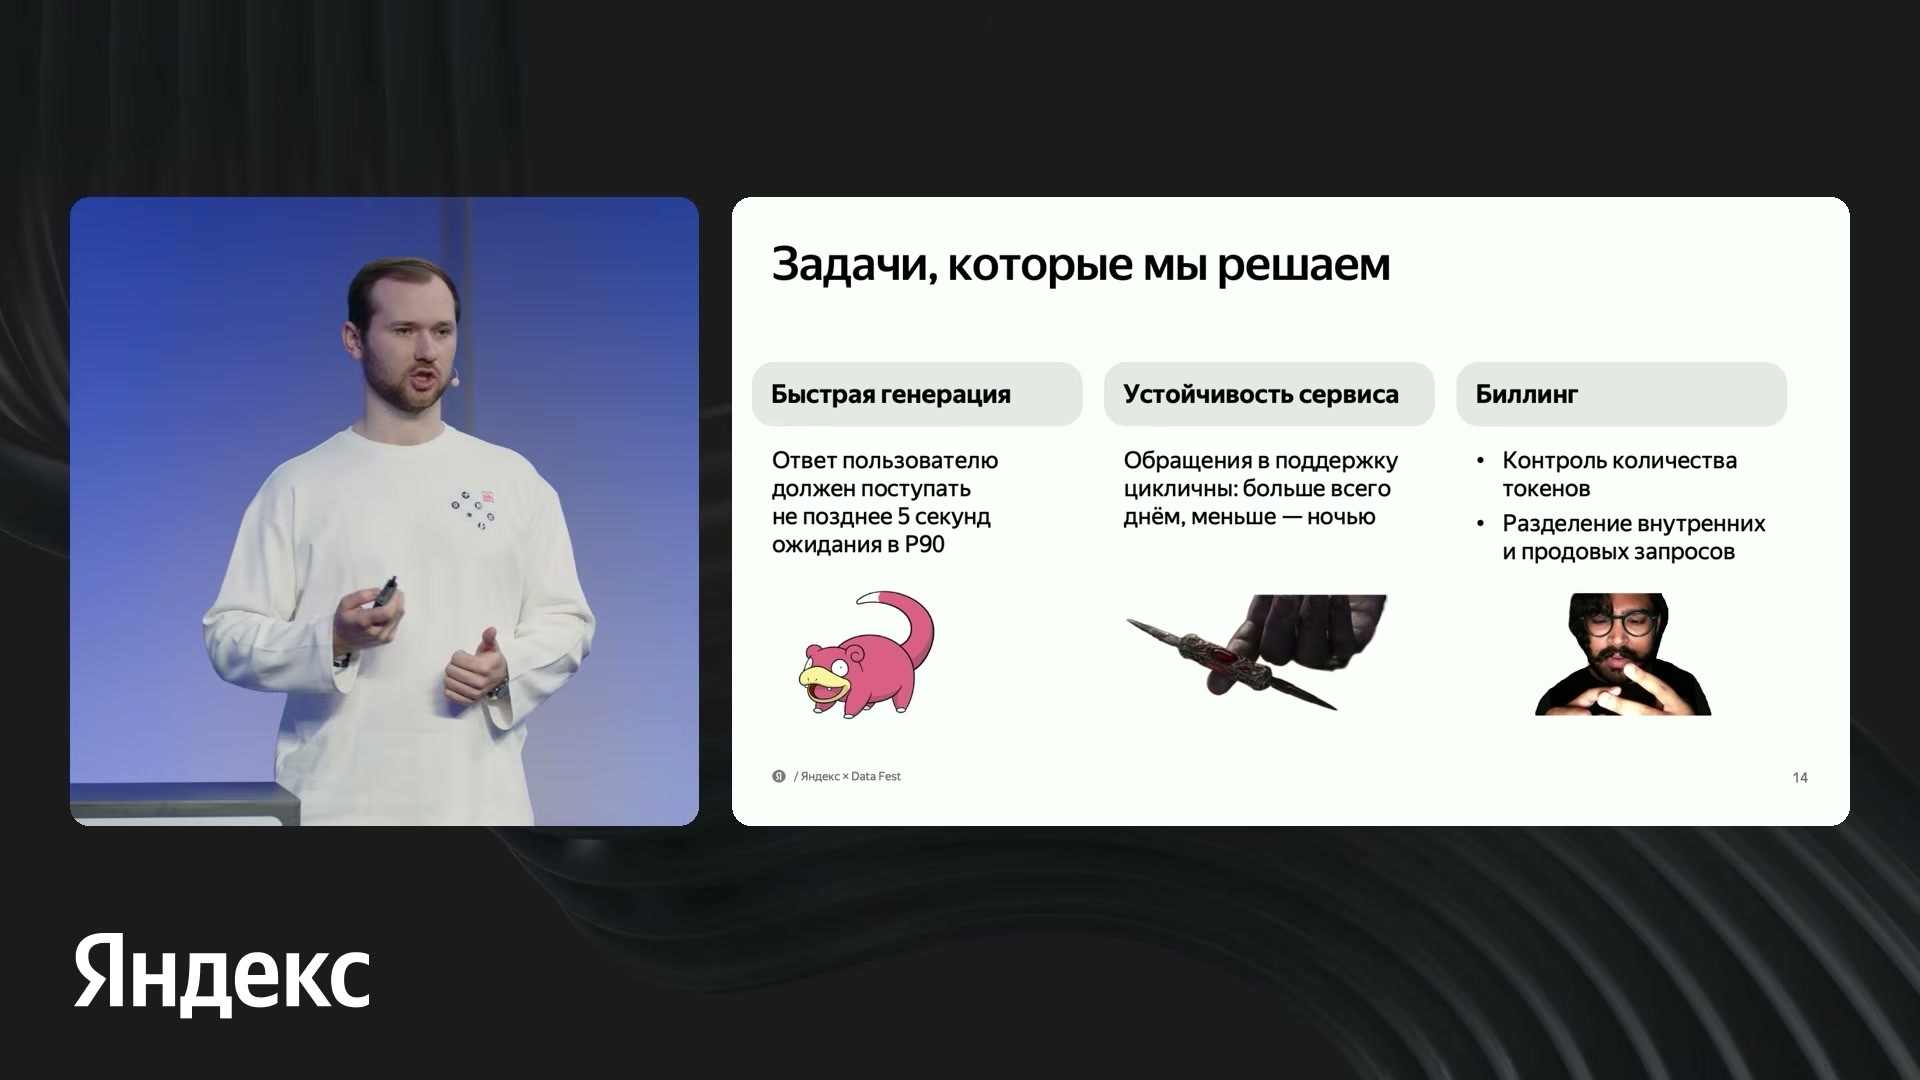
Требования к системе объединяют ответ не позднее 5 секунд по P90, устойчивость при переменной нагрузке и контроль потребления моделей.
Источник: Иван НасоновКак ускоряли генерацию: шесть групп приёмов
Ускорение строится из нескольких изменений, которые действуют на разные части вычислений. Одни уменьшают объём данных, другие организуют совместную обработку запросов, третьи позволяют повторно использовать уже выполненную работу. Команда применяет эти приёмы вместе.
Работу модели удобно разделить на две стадии. Сначала она обрабатывает входной текст — эта стадия называется prefill. Затем последовательно генерирует продолжение — decode. Результаты обработки уже известного текста сохраняются в кеше ключей и значений внимания, или KV-cache. Это позволяет использовать их при дальнейшей генерации, не вычисляя ту же часть заново.
Квантизация весов и квантизация кеша относятся к разным данным. Веса — параметры самой модели. KV-cache — промежуточные результаты конкретных обработок. Для кеша указан E4M3: формат с четырьмя битами экспоненты и тремя битами мантиссы. Поэтому выражение «модель квантизована» не заменяет отдельного описания того, как хранится её кеш.
Работа с кешем особенно важна в поддержке, где несколько запросов могут содержать одну и ту же историю разговора. Сохранённые вычисления полезны не только при генерации продолжения внутри одного вызова, но и при повторной обработке совпадающего начала текста. С этим связана и последующая настройка маршрутизации: запрос желательно доставить туда, где нужный кеш уже доступен.
При этом команда не использовала дистилляцию — обучение меньшей модели воспроизводить поведение более крупной. Автор объясняет это тем, что для текущих задач пока хватает квантизации. Это выбор объёма необходимых изменений, а не отрицательный результат эксперимента с дистиллированной моделью.
Таким образом, ускорение не сводится к уменьшению модели. В решении одновременно меняются числовое представление, порядок обработки запросов, организация стадий генерации и использование кеша. После этого остаётся обеспечить доступность вычислений и правильную доставку запросов.
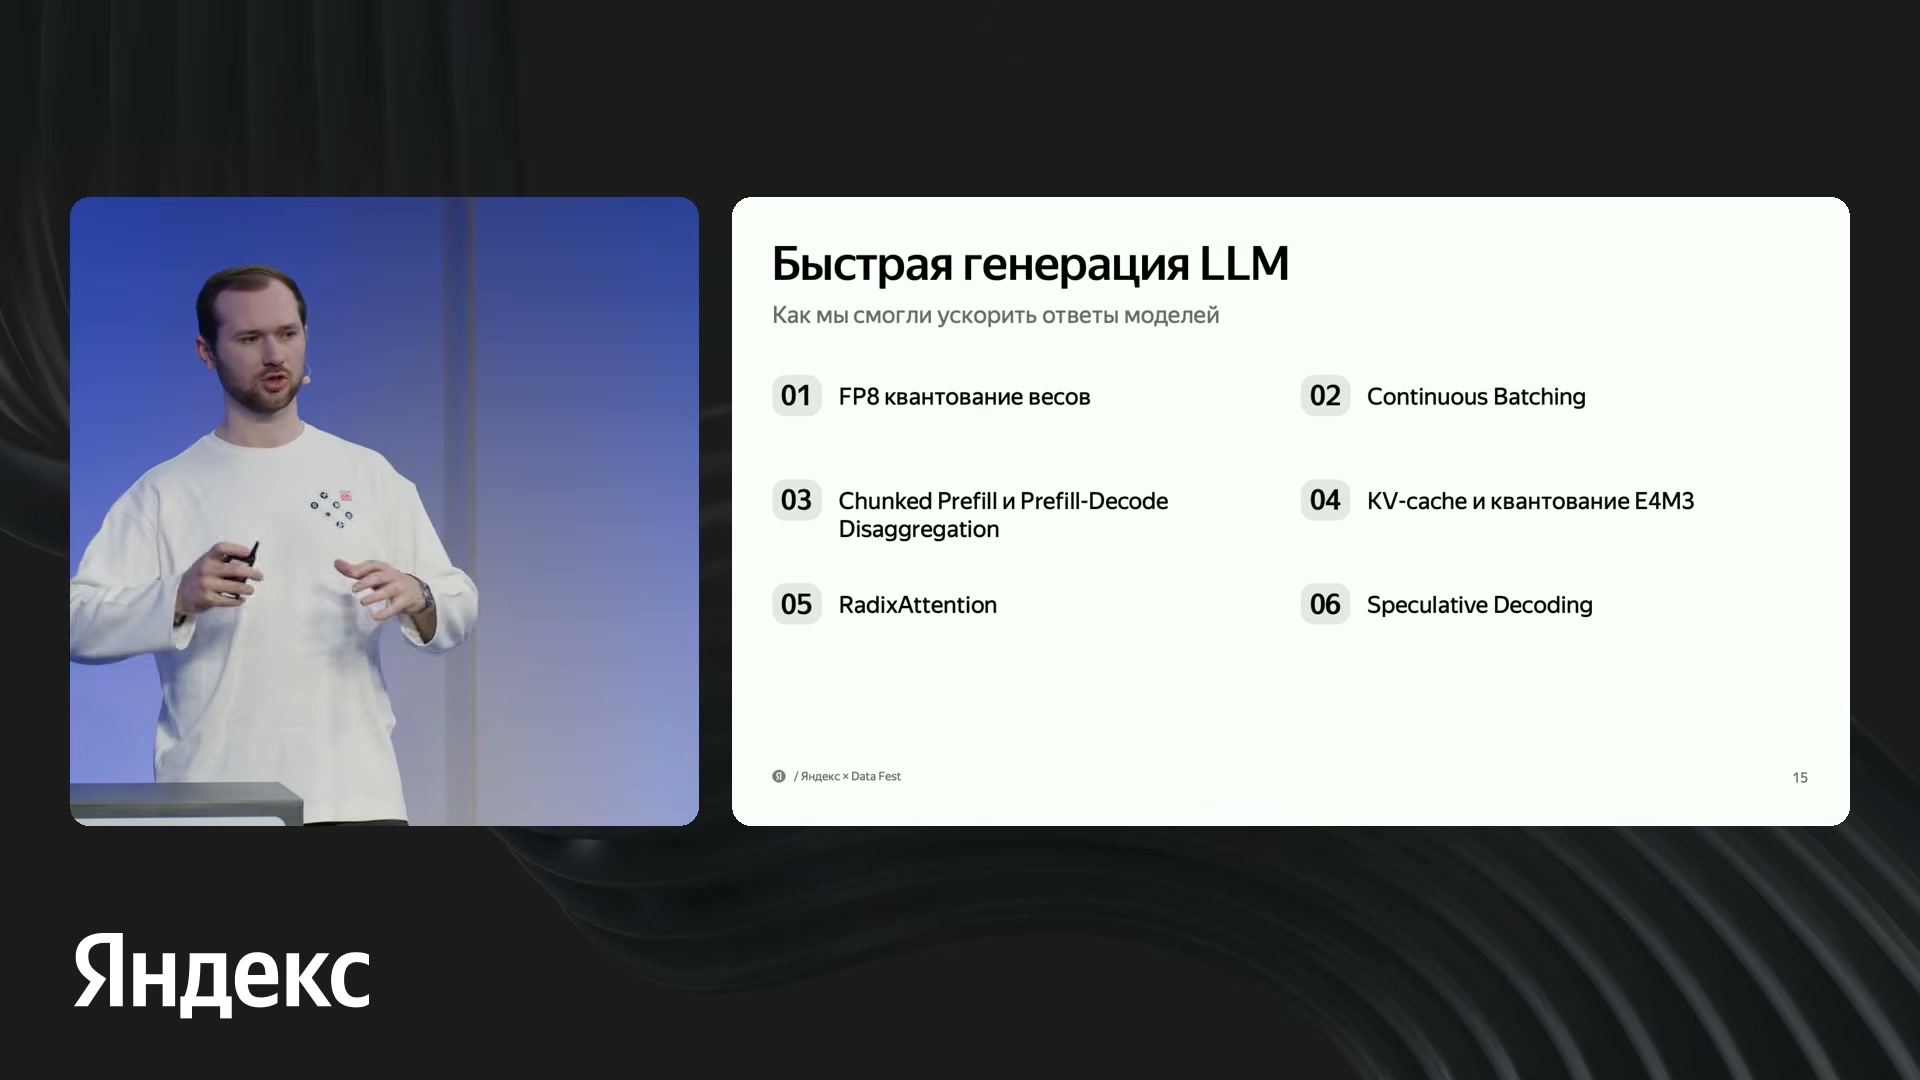
Ускорение сочетает FP8 для весов, непрерывную пакетную обработку, работу со стадиями prefill и decode, кеш E4M3, RadixAttention и спекулятивную генерацию.
Источник: Иван НасоновДва дата-центра и балансировка запросов
Для устойчивости модели разворачивают в двух дата-центрах. Если одна площадка отключится, оставшаяся должна продолжить обслуживание. Это не означает сохранения прежней производительности: ресурсов станет меньше, система сможет обрабатывать меньше запросов или будет отвечать медленнее.
Смысл решения — избежать полного прекращения автоматической поддержки. Автор иллюстрирует это ответом за 4 секунды вместо 2 секунд: некоторое ухудшение предпочтительнее ситуации, когда автоматизация перестаёт помогать. Эти значения служат примером поведения при отказе, а не отдельным измерением аварийного режима.
Запросы распределяет HAProxy — балансировщик, который направляет обращения к соответствующим сервисам моделей. Команда использует его на прикладном уровне, обозначаемом L7. На этом уровне можно учитывать содержимое запроса: адрес и тег, по которому выбирается нужная модель.
Размещение на нескольких площадках и балансировщик решают разные части задачи. Первое сохраняет возможность обслуживания при потере дата-центра. Второе выбирает направление запроса. Для многошагового разговора к этому добавляется ещё одно требование: по возможности использовать место, где уже обрабатывался предыдущий контекст пользователя.
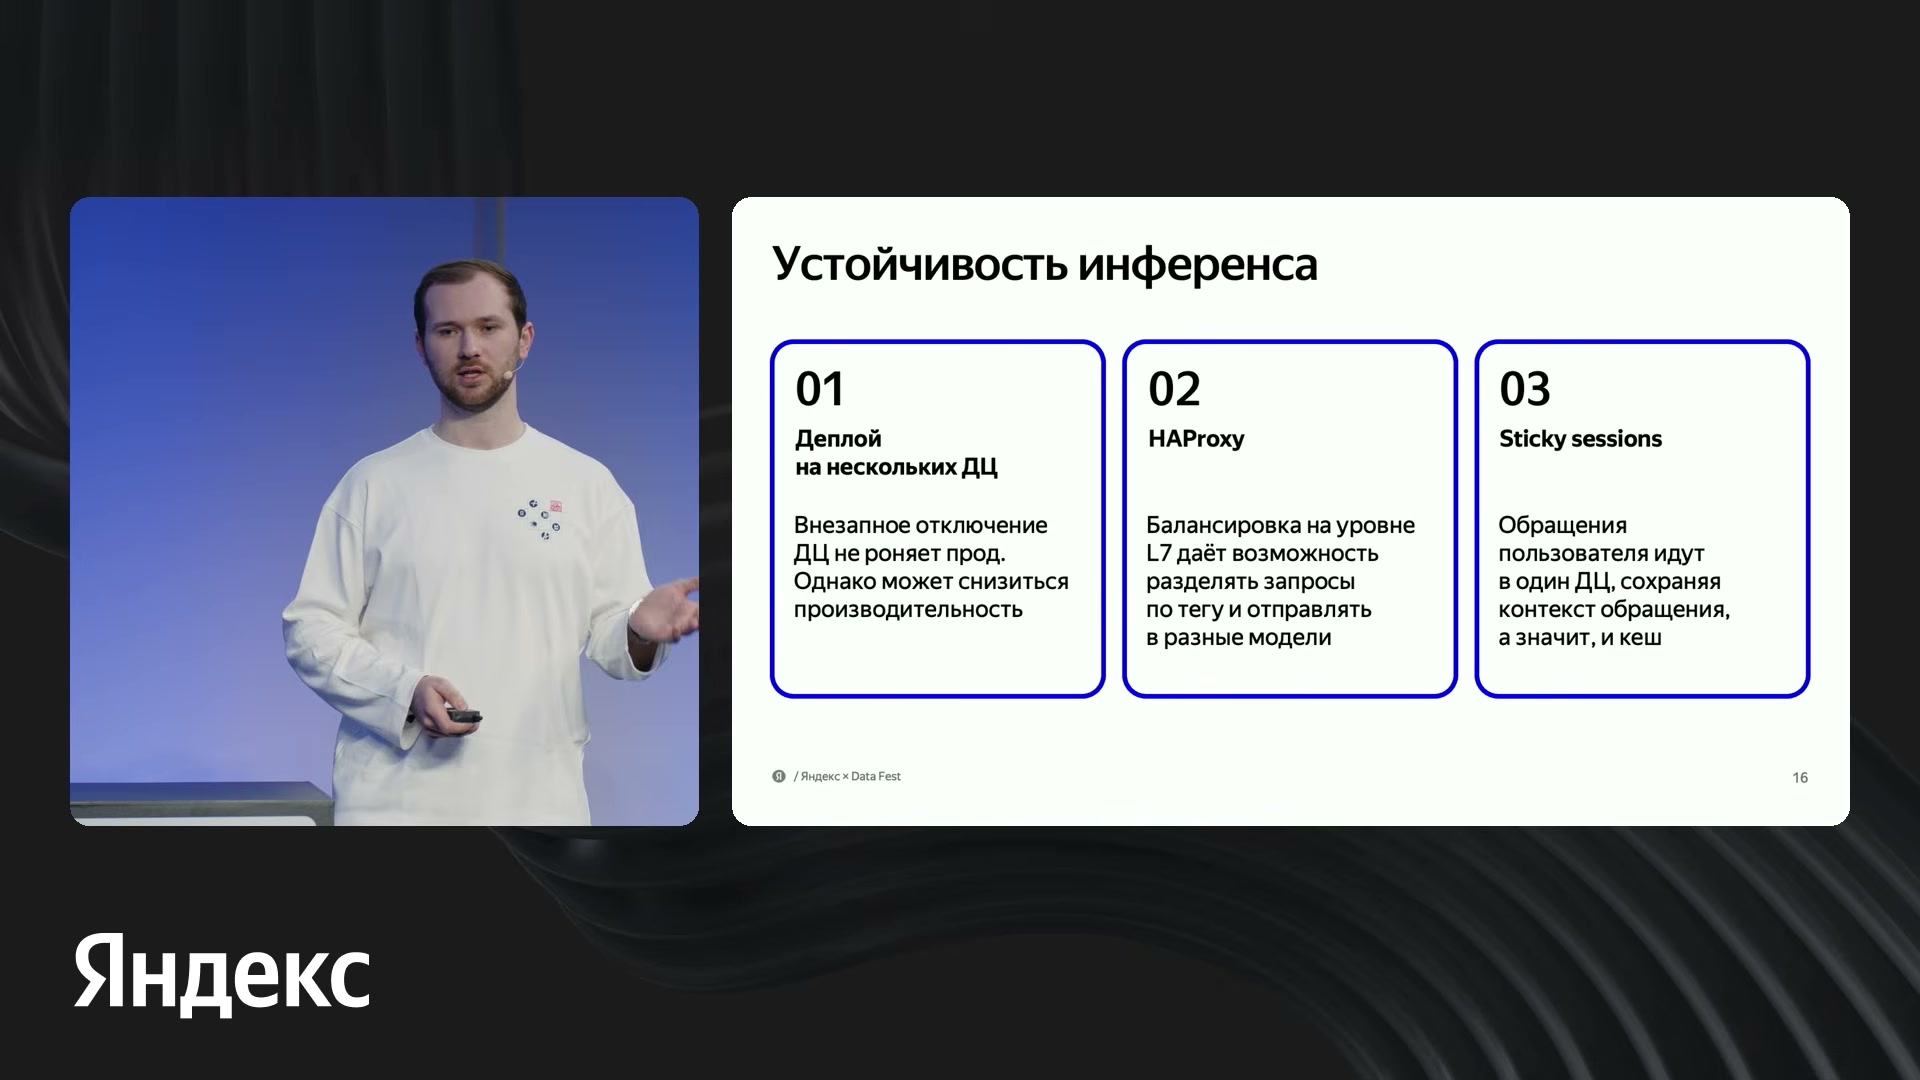
Несколько дата-центров сохраняют обслуживание при отказе, HAProxy выбирает модель, а закрепление запросов помогает повторно использовать контекст и кеш.
Источник: Иван НасоновПочему повторные запросы закрепляют за исполнителем
Во время одного сценария пользователь обращается к модели несколько раз. В новых запросах повторяется история разговора, которую система уже обрабатывала. Если запрос направить к исполнителю с подходящим кешем, часть предыдущих вычислений можно использовать повторно.
Для этого применяется закрепление запросов — sticky sessions. На схеме устойчивости оно описано как направление обращений пользователя в один дата-центр с сохранением контекста и кеша. В финальной архитектуре механизм закрепления подписан как sticky by x-forwarded for. Привязка должна помогать повторным запросам попадать к уже подготовленным вычислениям, а не каждый раз начинать обработку на произвольном исполнителе.
У такого подхода есть цена. Если учитывать предыдущую обработку пользователя, запросы нельзя распределять совершенно свободно. Автор прямо говорит о некотором ухудшении возможностей масштабирования ради роста технических показателей. Команда сознательно выбирает повторное использование кеша вместо максимальной свободы перераспределения каждого следующего запроса.
Здесь соединяются два решения из разных частей системы. Оптимизация инференса сохраняет и повторно использует промежуточные результаты, а маршрутизация повышает вероятность того, что следующий запрос сможет ими воспользоваться. Доступность нескольких площадок остаётся необходимой, но обычное распределение запросов учитывает не только наличие свободного исполнителя.
Доклад · 00:11:06LiteLLM: учёт токенов, доступ к моделям и приоритеты
Для биллинга команда рассматривала два пути: написать собственный сервис или использовать готовое решение с открытым исходным кодом. Собственная реализация позволяла бы отвечать ровно на требования бизнеса, но её пришлось бы разрабатывать и поддерживать. В итоге решили сначала попробовать LiteLLM, а к самостоятельной разработке вернуться, если готовый инструмент не подойдёт.
LiteLLM используется как общий шлюз между приложениями и моделями. Для этой задачи важны авторизационные ключи, учёт входящих и исходящих токенов, а также ограничения частоты запросов в зависимости от приоритета потребителя. Это позволяет разделять нагрузку поддержки и внутренние запросы сотрудников.
Шлюз также может предоставлять единый программный интерфейс, или API, для разных моделей. В докладе отмечены адаптеры, совместимые с форматом OpenAI, для моделей других поставщиков и возможность перейти к другой модели как к запасному варианту. Совместимость интерфейса описывает способ обращения к моделям, а не определяет, какие модели команда обязана использовать.
Инструкции, которые задают поведение модели, называют промптами. Возможность хранить их и подключать защитные проверки дополняет учёт нагрузки. MCP, также упомянутый среди возможностей шлюза, — протокол подключения инструментов и ресурсов к агентам. Перечисленные возможности описывают выбранный инструмент; основной результат внедрения автор связывает с биллингом, авторизацией и распределением запросов.
Пробное внедрение оказалось подходящим, поэтому команда продолжила работу с LiteLLM. Пользовательские запросы получили более высокий приоритет, а внутренние задачи остались в той же общей инфраструктуре. LiteLLM не заменил HAProxy: шлюз отвечает за доступ и правила обслуживания, а балансировщик — за дальнейшее направление запроса.
Пакетный API шлюза и непрерывное объединение запросов при инференсе — разные уровни системы. Первый задаёт способ передать набор обращений через интерфейс. Второй определяет, как исполнитель модели организует их вычисление. В архитектуре поддержки эти возможности не следует считать одним и тем же механизмом.
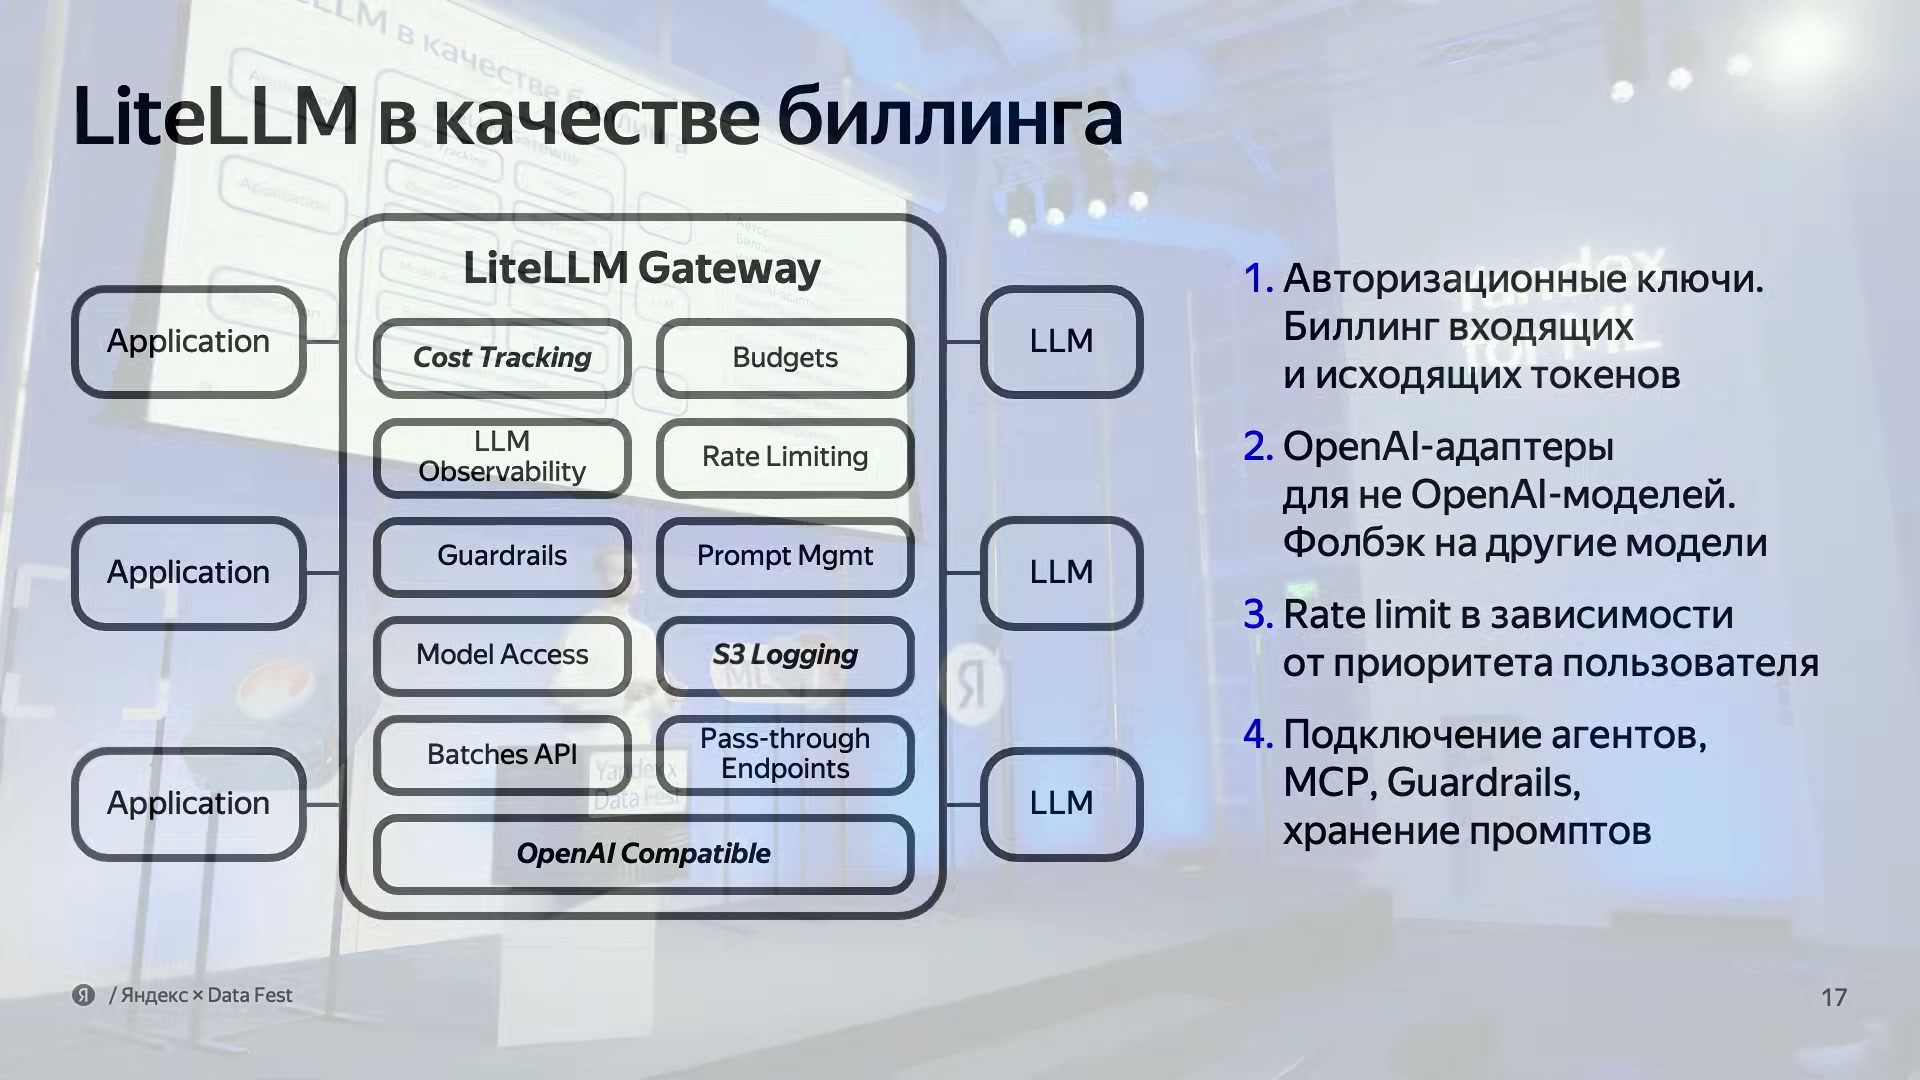
LiteLLM Gateway объединяет доступ к моделям, учёт входящих и исходящих токенов, ограничения по приоритету и дополнительные средства управления вызовами.
Источник: Иван НасоновИтоговая архитектура: конфигурация моделей и путь запроса
Финальная схема содержит две связанные последовательности. Одна подготавливает сведения о моделях и обновляет настройки балансировщика. Другая обслуживает запросы клиентов. Обновление конфигурации не является шагом, который пользователь должен проходить заново при каждом сообщении.
- 01
Собрать исходные сведения
В компонент Discovery поступают данные из models.yaml и источника, обозначенного YP/YT/static list.
- 02
Сформировать описание моделей
Discovery подготавливает models.json — результат сбора сведений, который используется дальше в настройке.
- 03
Обновить балансировщик
Следующий блок называется Jinja + reload HAProxy: описание проходит через шаблонизацию, после чего обновляется конфигурация HAProxy.
Discovery здесь отвечает за сбор сведений об исполнителях моделей. Имена models.yaml и models.json обозначают конфигурационные данные, а Jinja используется для подготовки настроек по шаблону. Эта ветка схемы объясняет, откуда балансировщик получает информацию для маршрутизации; она отделена от самих вычислений языковой модели.
- 01
Пройти через LiteLLM
Клиент обращается к шлюзу, который проверяет доступ и применяет правила обслуживания. Для запросов продакшена автор описывает отсутствие ограничения RPS на этом слое.
- 02
Передать запрос в HAProxy
Между LiteLLM и HAProxy показан локальный переход, подписанный localhost hop.
- 03
Выбрать модель и исполнителя
Далее используется X-Model-Name и указанное на схеме распределение leastconn / sticky by x-forwarded for. Запрос направляется к одному из рабочих исполнителей модели.
X-Model-Name задаёт выбор модели. Название leastconn означает выбор по наименьшему числу соединений, а sticky by x-forwarded for обозначает закрепление по соответствующему значению запроса. На схеме показаны два рабочих исполнителя — Worker 1 и Worker 2. Это иллюстрация маршрутизации, а не подсчёт всех экземпляров моделей в сервисе.
Отсутствие ограничения RPS для пользовательских запросов в LiteLLM — правило доступа, а не неограниченная вычислительная мощность. Реальную нагрузку обслуживают размещённые в дата-центрах модели. В итоге доступ к вычислениям, конфигурация маршрутов, выбор модели и использование кеша остаются отдельными задачами, которые соединены общей архитектурой.
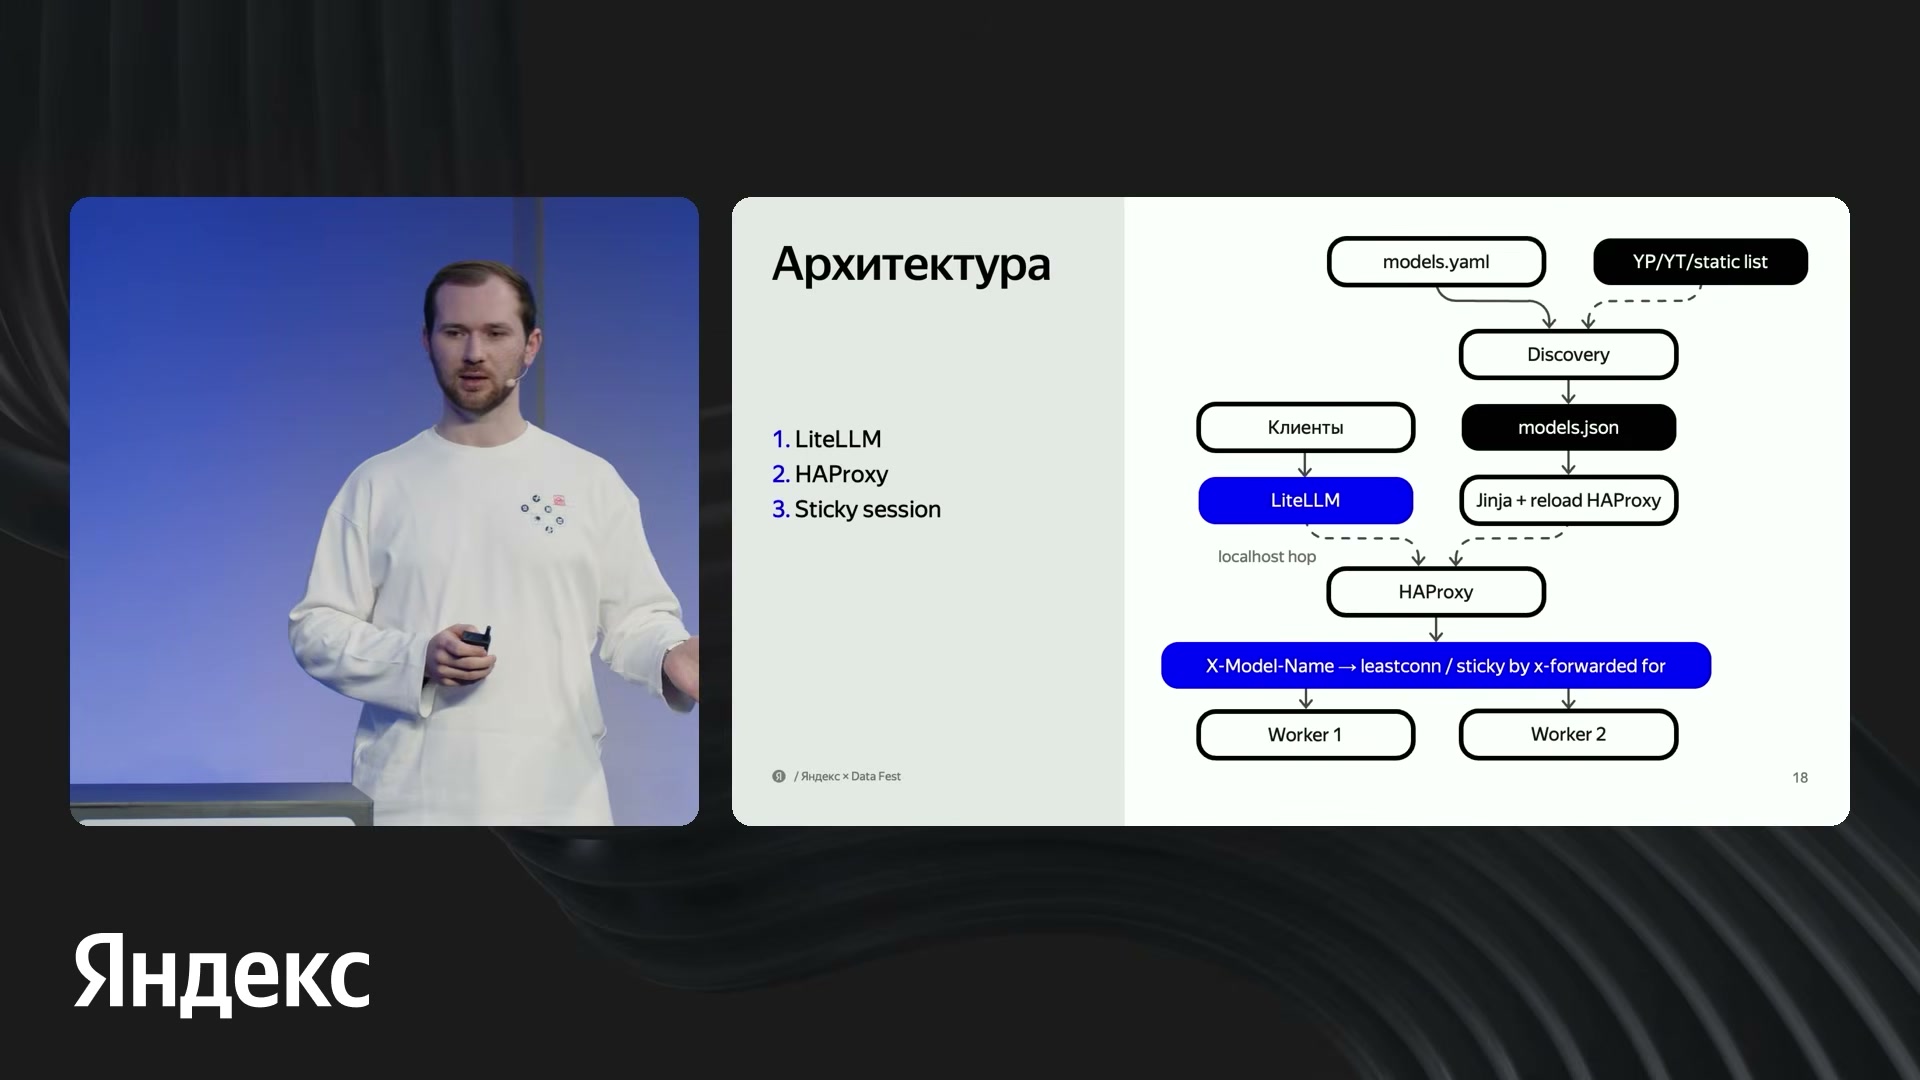
Конфигурационная ветка обновляет HAProxy через Discovery, models.json и Jinja. Клиентские запросы проходят через LiteLLM и балансировщик к исполнителям модели.
Источник: Иван НасоновТехнические результаты: запросы, задержка ответа и время одного токена
Получившаяся система выдерживает нагрузку 10 запросов в секунду, или 10 RPS. Автор описывает её как высокую для сервиса моделей и связывает такие ситуации со всплесками обращений, например после изменения стоимости подписки. При этой нагрузке задержка ответа составляет примерно 2 секунды по P50 и 5 секунд по P90.
P50 — медиана: середина распределения измерений. P90 характеризует более медленную часть ответов. В технических итогах эти значения относятся к ожиданию ответа, тогда как отдельное значение 8 миллисекунд по P50 подписано как генерация одного токена на инференсе. Это разные масштабы измерения: ответ состоит из последовательности токенов, а запрос к сервису не равен одному токену.
Таблицу можно прокрутить по горизонтали.
Значение 8 миллисекунд не означает, что пользователь получает весь ответ за это время. Оно также не является количеством токенов в секунду. Аналогично, 10 RPS описывают запросы, поступающие к сервису моделей, а не скорость выдачи токенов. Задержка ответа и время одного токена показывают разные свойства работы системы.
Рост на 110% относится именно к количеству запросов в LLM с ноября 2025 года. Это другой объект подсчёта, чем обращения пользователей в поддержку: внутри одного диалога модель может вызываться несколько раз. Поэтому рост нагрузки на LLM нельзя автоматически считать таким же ростом всей поддержки.
Сокращение времени ответа на 95% — ещё один результат, а не другая запись медианы в 2 секунды или времени токена в 8 миллисекунд. Вместе показатели описывают увеличение объёма работы моделей и уменьшение ожидания ответа. Они относятся к решению команды в целом, а не к отдельному приёму квантизации, кеширования или балансировки.
Доклад не уточняет границы измерения задержки ответа, оборудование и длину запросов. Для сокращения времени на 95% не названы исходная задержка и период сравнения; ноябрь 2025 года указан только для роста количества вызовов LLM.
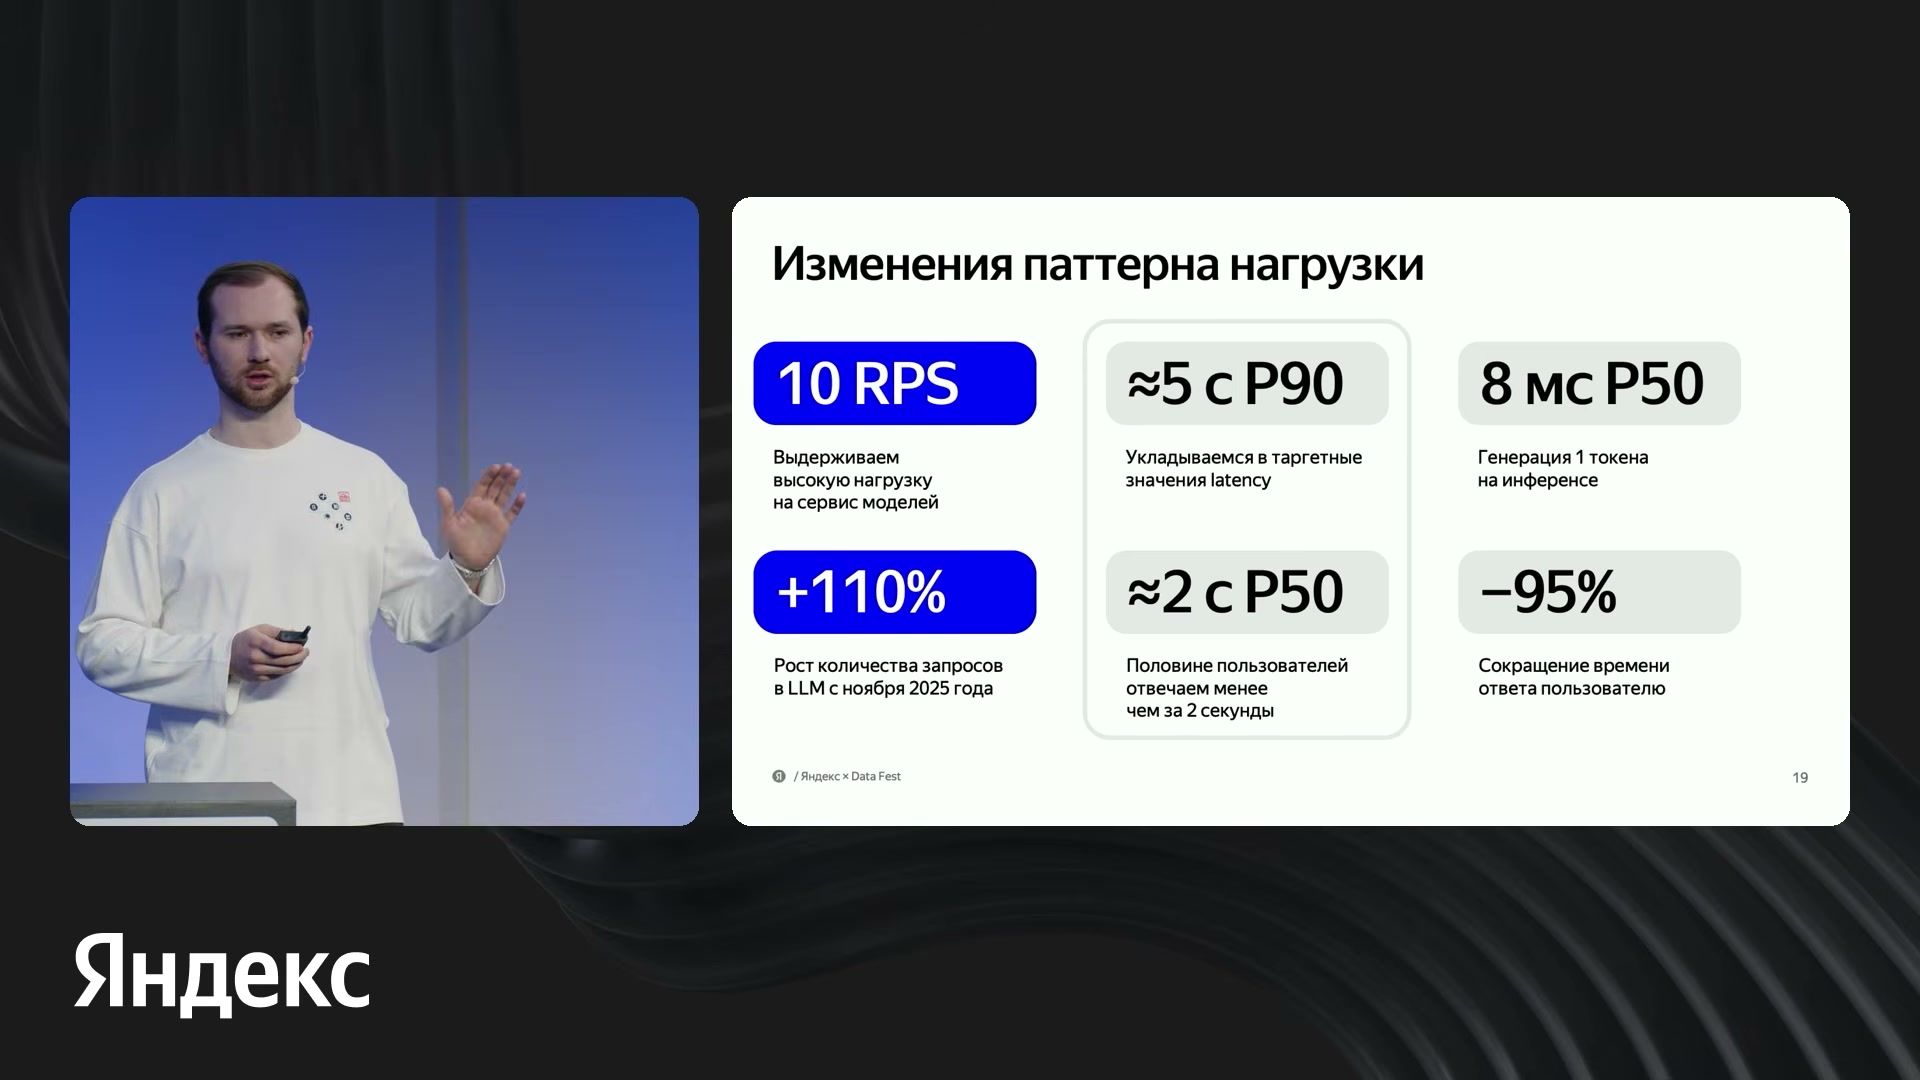
При 10 RPS задержка ответа составляет около 2 секунд по P50 и 5 секунд по P90. Отдельно показаны 8 миллисекунд по P50 на один токен, рост запросов в LLM на 110% с ноября 2025 года и сокращение времени ответа на 95%.
Источник: Иван НасоновПочему быстрой инфраструктуры оказалось недостаточно
После технических улучшений команда столкнулась с другим ограничением. Модели уже могли достаточно быстро работать в пользовательском сервисе, но это само по себе не обеспечивало развитие автоматизации. Для новых проблем требовалось создавать и внедрять новые сценарии.
Их выпуск проходил через взаимодействие продуктовых менеджеров, тестировщиков, разработчиков серверной части и специалистов по машинному обучению. Даже если отдельного агента было несложно подготовить технически, объём работы ограничивался количеством людей, которые могли довести его до действующей поддержки.
При этом продуктовые менеджеры хорошо понимали, как должна выглядеть помощь пользователю: какие действия нужны в конкретной проблеме, как разрешать конфликт и какой ответ уместен. Но это понимание приходилось передавать остальным участникам разработки. По словам автора, исходный замысел не всегда удавалось донести без искажений.
Отсюда возникла идея внутреннего сервиса Conclave AI. Вместо того чтобы каждый раз превращать требования менеджера в отдельную техническую реализацию, команда решила дать ему инструмент для непосредственной подготовки агента. Целью стало ускорение создания и внедрения сценариев, а не очередное сокращение времени генерации.
Доклад · 00:14:02Conclave AI: создание агента, инструменты и проверка поведения
Conclave AI предоставляет интерфейс, в котором агент создаётся на основе шаблонов. Автор описывает подготовку как работу в несколько кликов. За самим внутренним продуктом также стоит продуктовый менеджер с техническим опытом.
В форме «Создать агента» задаются название и описание, при необходимости выбирается общая последовательность обработки — workflow. Форма предназначена для настройки ключевых параметров агента, включая языковую модель и системную инструкцию. Отдельно выбираются инструменты, которые агент сможет вызывать.
Инструмент здесь — доступное агенту программное действие, а не текстовая рекомендация пользователю. Интерфейс позволяет явно включать нужные действия; выбранные элементы передаются модели как tools/functions. На показанном экране есть инструменты, связанные с возвратом денег, отменой подписок и сопоставлением аккаунтов.
Менеджеру больше не нужно для каждой заготовки проходить прежний путь с ручной подготовкой конфигураций и подключением адресов сервисов моделей через разработчиков серверной части. Он может работать непосредственно с поведением будущего агента и набором доступных действий.
Для проверки предусмотрена песочница — отдельная среда, где можно посмотреть, как отвечает подготовленный агент. Менеджер знает ожидаемое поведение поддержки и получает возможность самостоятельно сравнить его с результатом. Описание сценария и первая проверка оказываются рядом, вместо того чтобы проходить через несколько последовательных передач между ролями.
Если сценарию нужна информация из базы знаний, в конструкторе подключают RAG. Это дополнительная возможность для соответствующих задач, а не обязательное требование к каждому агенту. Conclave AI объединяет подготовку поведения, выбор инструментов, пробные диалоги и подключение знаний; дальнейшие инженерные проверки при этом сохраняются.
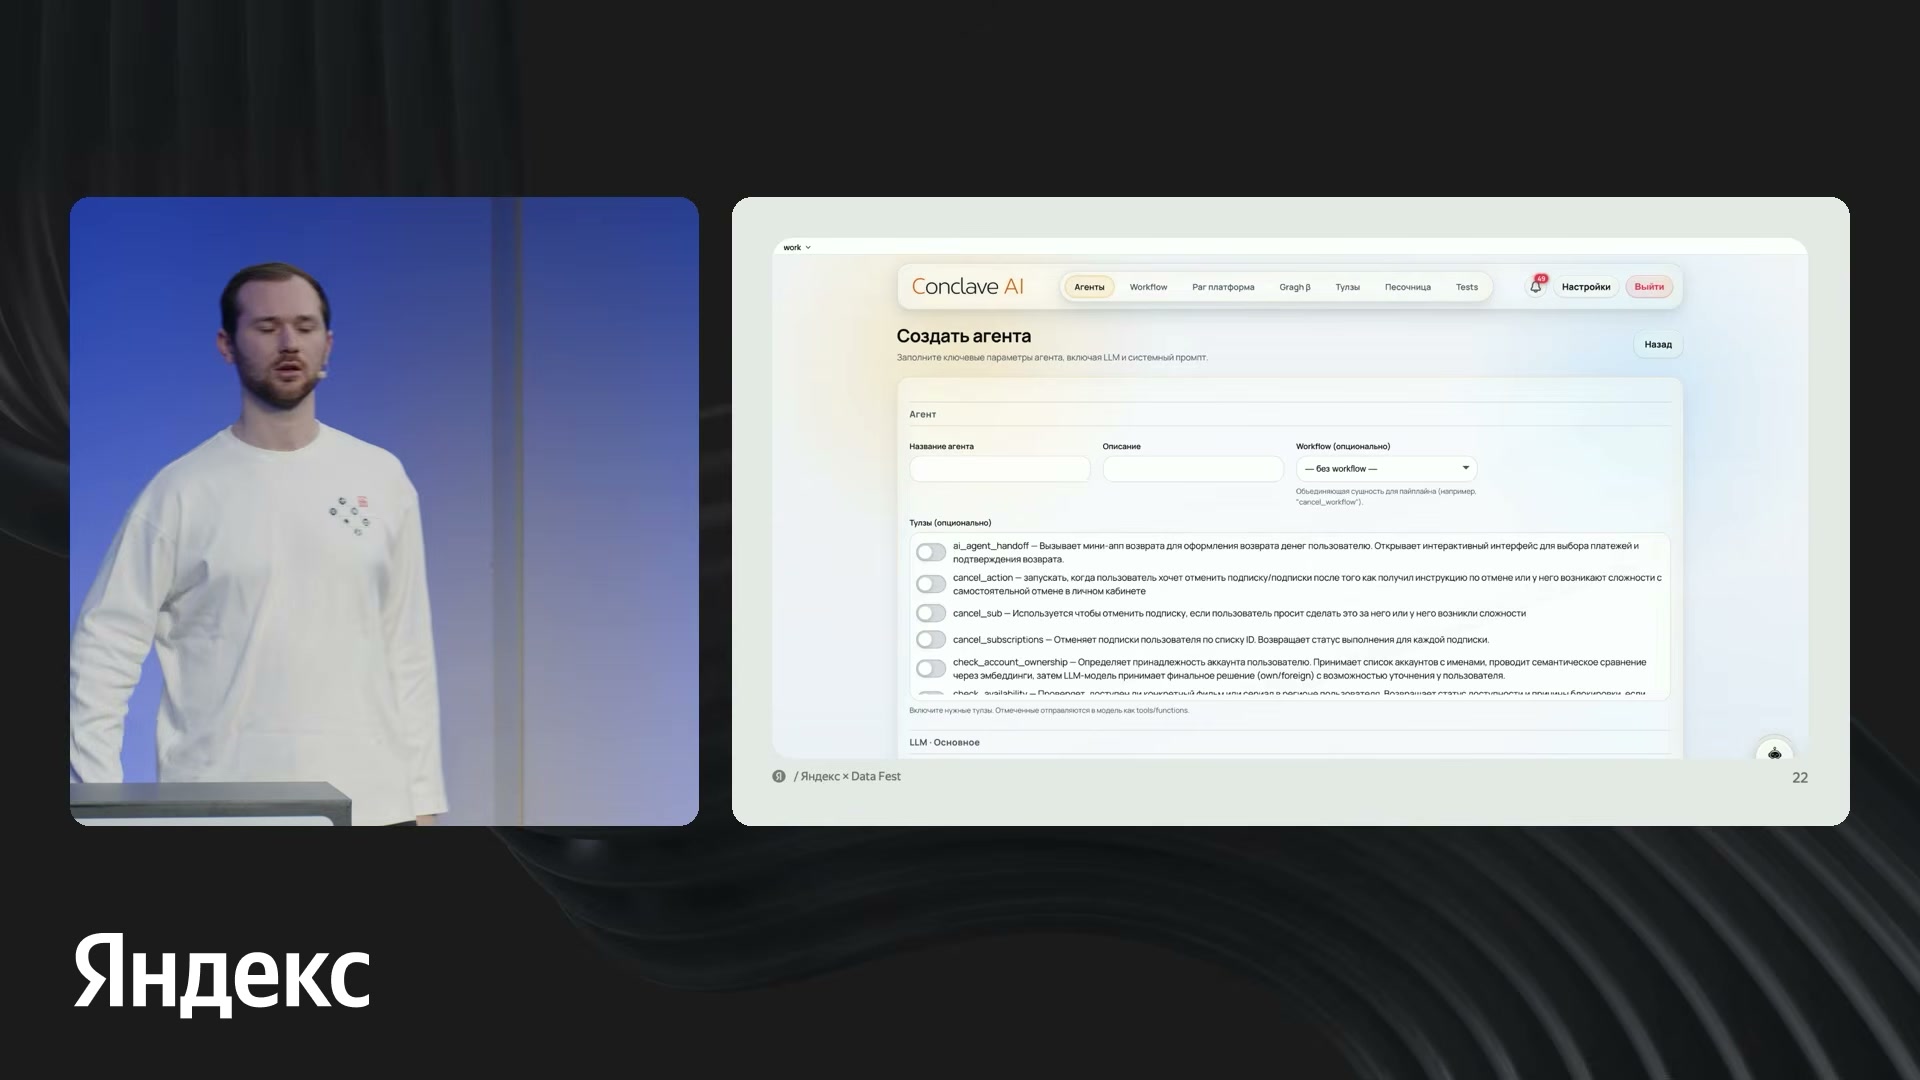
В Conclave AI агент получает описание, связь со сценарием и выбранные инструменты. На форме показаны действия для возвратов, отмены подписок и работы с аккаунтами.
Источник: Иван НасоновКак из отдельных блоков собирают сценарий поддержки
Подготовленный агент становится частью общей последовательности обработки обращения. В конструкторе её собирают из блоков и соединяют переходами. Автор сравнивает такой способ работы с Нирваной: результат одного шага определяет, куда передать обработку дальше.
В показанном примере открыт сценарий cancel_workflow — «Отмена подписки». На рабочем поле находятся классификатор CLASSIFIER, агент LLM_AGENT, действие ACTION и маршрутизация ROUTE. В библиотеке также доступны переключение SWITCH и заметка. Это позволяет описывать не только текст агента, но и его место среди других операций поддержки.
Переходы имеют разные типы. Основная линия выполнения обозначена next, ветвления и маршруты инструментов — intent. Запасные переходы fallback и retryFallback представлены пунктиром. Различение связей помогает отделять обычное продолжение сценария от альтернативного пути обработки.
Результат можно сохранить в интерфейсе или сохранить и скачать в YAML — текстовом формате конфигурации. Таким образом, визуальный редактор не отменяет конфигурационное представление сценария, а позволяет подготовить его без ручного описания всей последовательности.
В одной последовательности можно использовать несколько агентов. Такая организация называется многоагентной системой: работу выполняет не один универсальный компонент, а несколько связанных агентов. В докладе также упоминается взаимодействие агента с агентом. Для поддержки это продолжение той же идеи разделения задач, которая ранее использовалась при выборе моделей.
Упрощение сборки не означает немедленного выпуска без проверок. Автор отдельно сохраняет тестирование и проверку со стороны серверной разработки. Менеджер получает прямой доступ к подготовке поведения, но включение сценария в действующий сервис остаётся инженерной задачей.
По оценке команды, Conclave AI ускорил создание агентов и повысил их качество. Объяснение связано с ответственностью: менеджер непосредственно задаёт то поведение, которое хочет видеть в продукте, вместо многократной передачи замысла между ролями. Ответственность за продуктовый смысл сценария сосредоточили в одной роли, не исключая остальных участников из тестирования и внедрения.
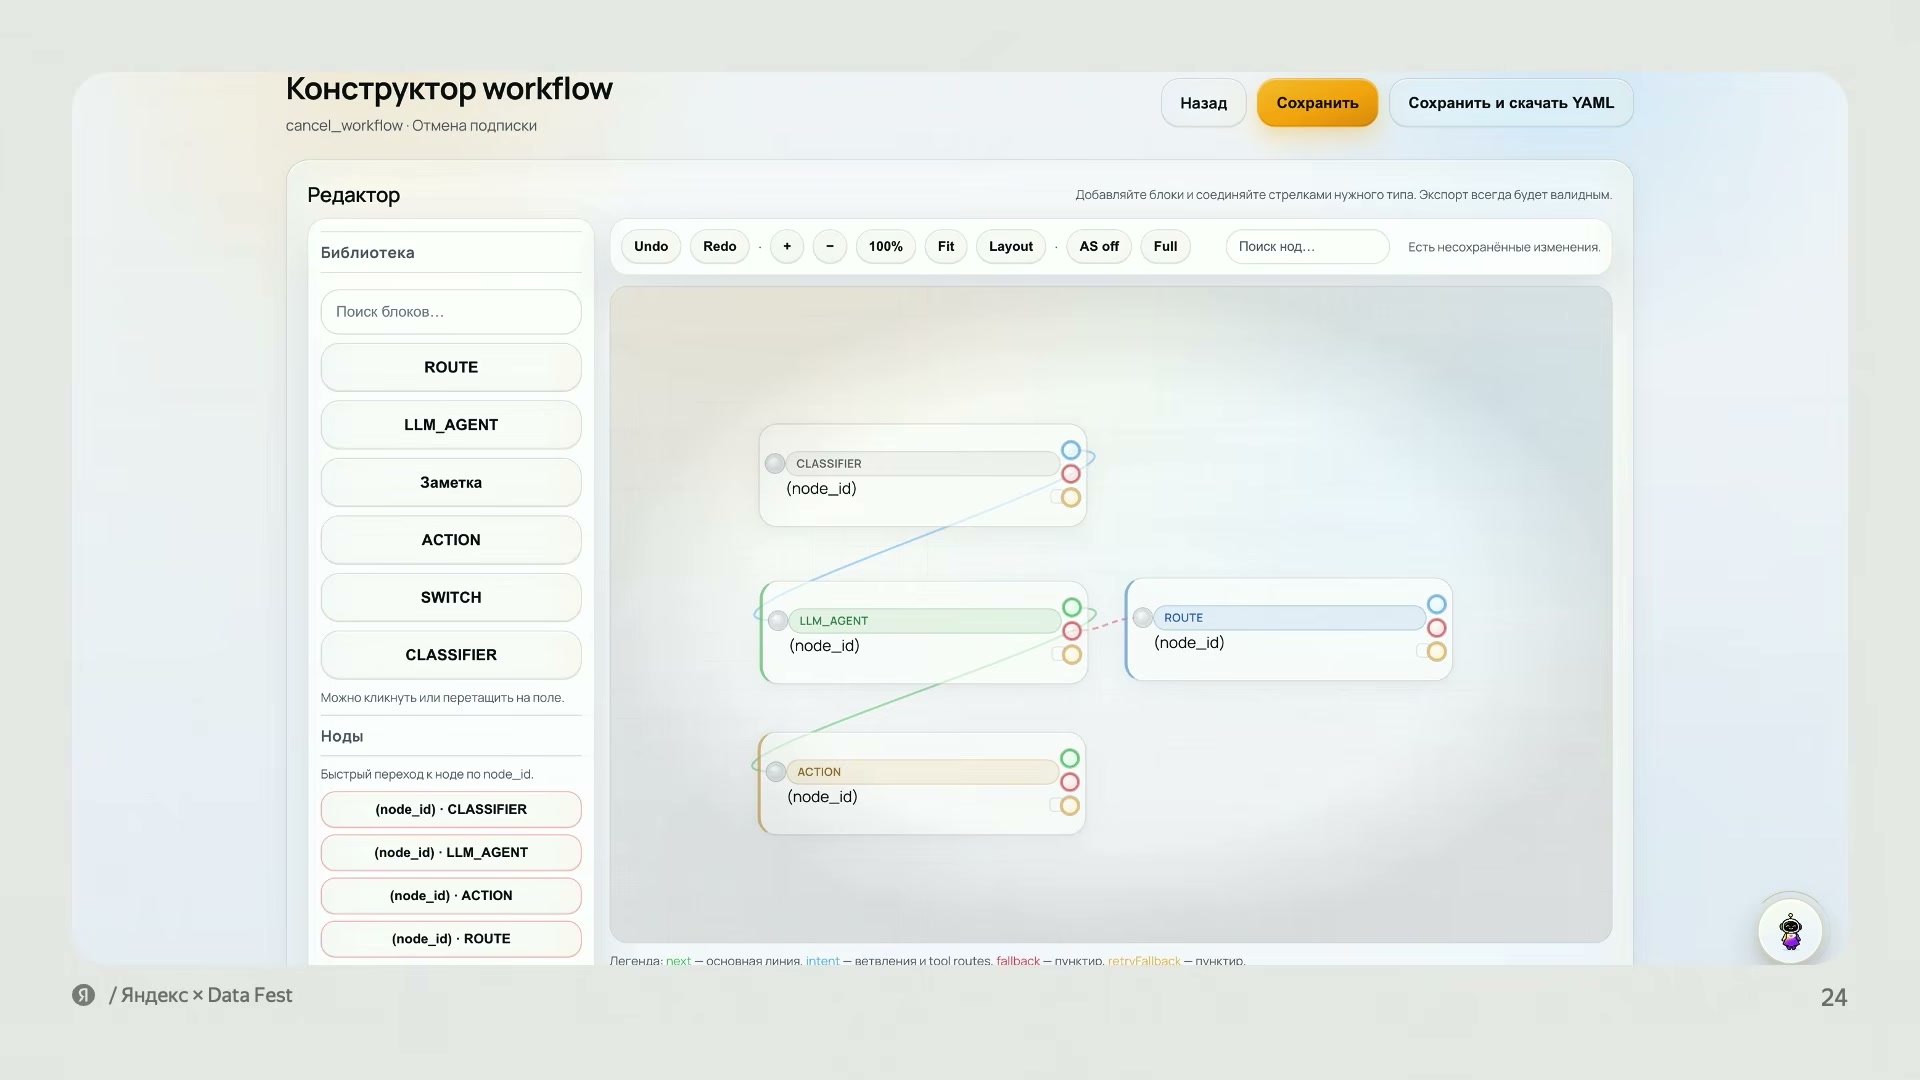
Сценарий отмены подписки собирается из классификатора, агента, действия и маршрутизации. Редактор различает типы переходов и позволяет сохранить конфигурацию в YAML.
Источник: Иван НасоновПродуктовые результаты: автоматизация, решение проблемы и обратная связь
В конце доклада команда переходит от скорости моделей к результатам поддержки. Здесь важно различать несколько сторон работы: обрабатывается ли обращение без человека, удалось ли полностью решить проблему, какую оценку поставил пользователь и возвращается ли он с повторным обращением.
Решения, в которых человек вообще не подключается и работает только агент, обозначены как LLM-Only. По словам автора, в них уходит около 12% всех обращений. Более широкий показатель — обращения, в которых участвуют LLM: их примерно 34%. Участие языковой модели не требует, чтобы весь диалог прошёл без оператора.
Пользовательская оценка называется CSAT. В данном сервисе это обратная связь по обращению на шкале с максимумом 5 — звёздочки, которые предлагают поставить после общения. Поэтому изменение на 0,3 относится к пунктам этой шкалы, а не к процентам.
Таблицу можно прокрутить по горизонтали.
Два значения +10% описывают изменения показателей, а ≈12% и ≈34% — доли обращений. Это не взаимозаменяемые числа. Рост автоматизации LLM-Only не означает, что итоговая доля таких обращений равна 10%, а участие LLM не означает полного решения проблемы.
Доли обращений без человека и с участием LLM также не нужно складывать: они описывают разные условия обработки, а не две объявленные независимыми группы. Повторное обращение и пользовательская оценка дают ещё два самостоятельных взгляда на результат. Быстрый ответ, использование модели и довольный пользователь — связанные, но разные свойства работы поддержки.
Итог состоит из технических и продуктовых изменений одновременно. Инфраструктура выдерживает названную нагрузку с приведёнными задержками, часть обращений проходит без человека, а языковые модели участвуют в более широком наборе диалогов. Команда сообщает об улучшении автоматизации, полного решения проблем и обратной связи пользователей и продолжает развивать сценарии поддержки.
Для двух значений +10% автор не уточняет, относительные это проценты или процентные пункты. Период наблюдения, контрольная группа и доверительные интервалы не приведены. Для повторных обращений не указаны окно наблюдения и точный знаменатель, поэтому эти результаты нельзя трактовать как полностью описанный A/B-тест.
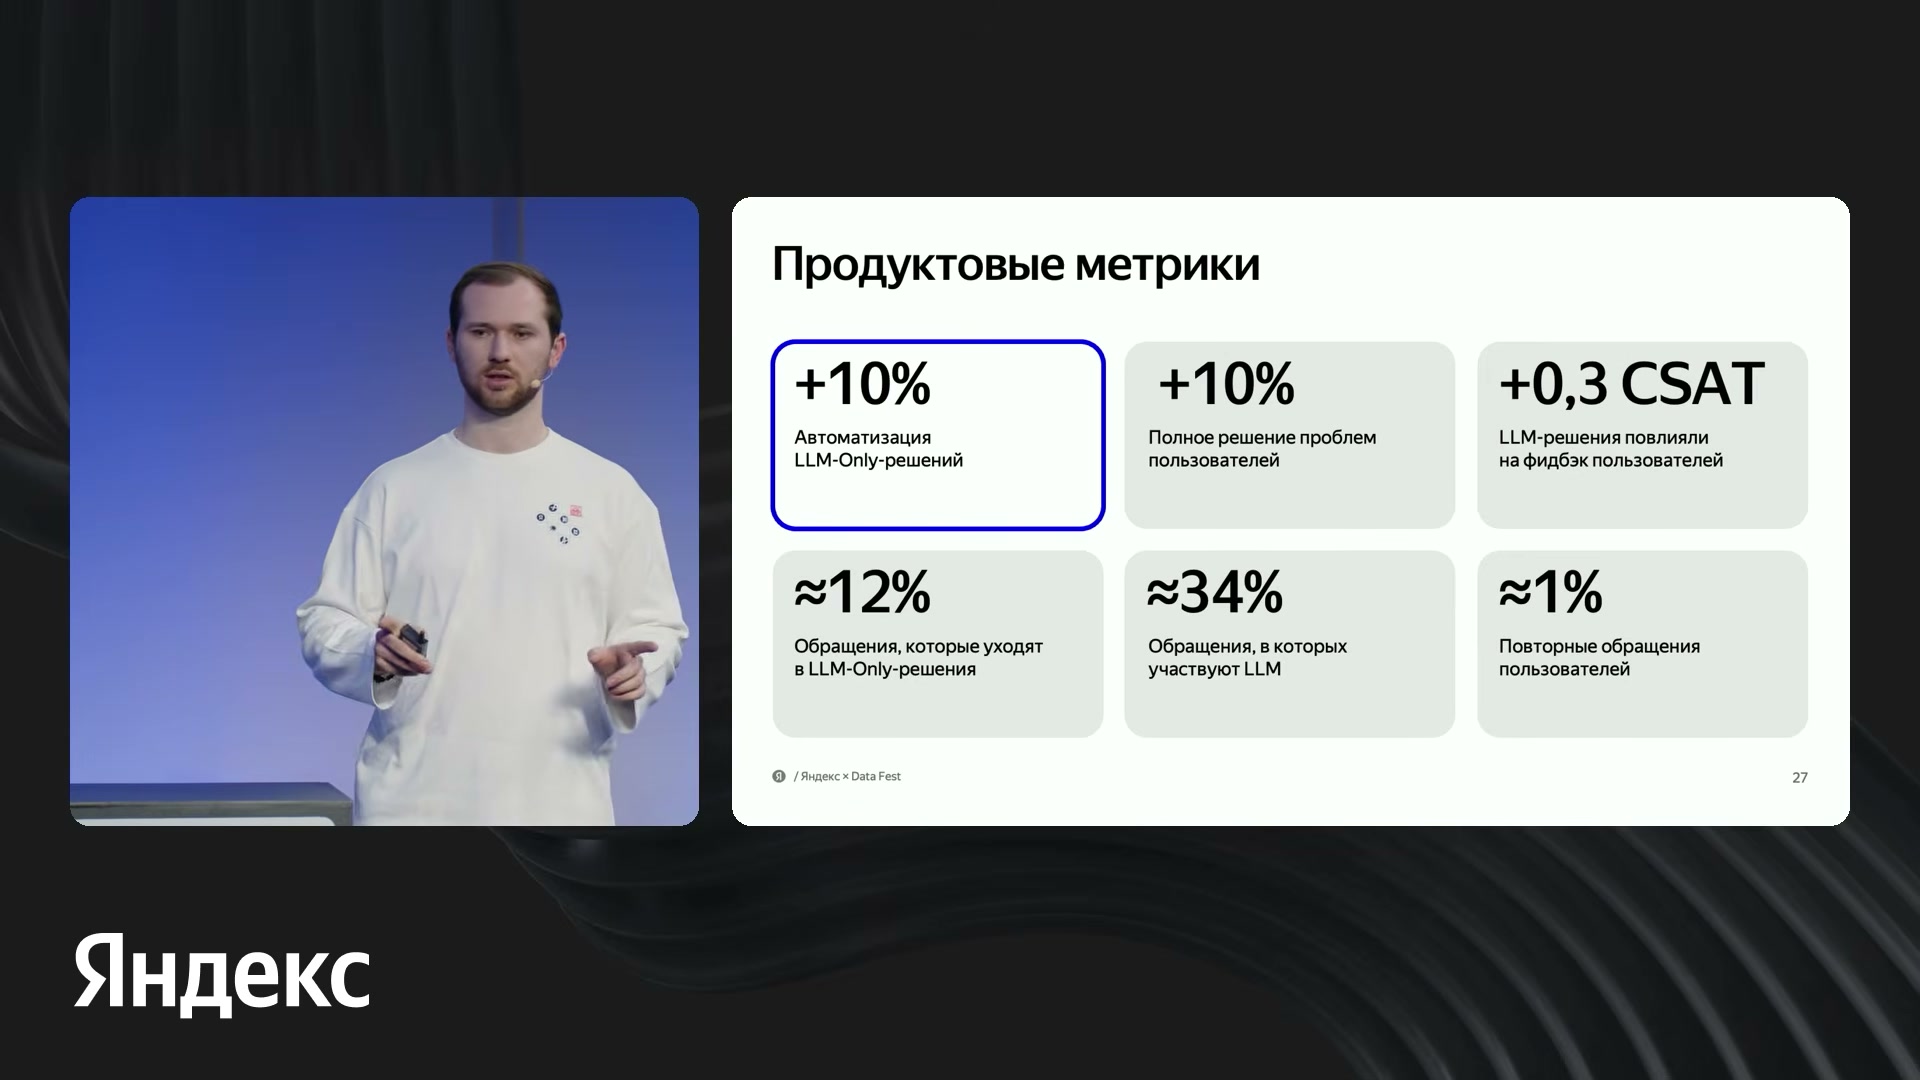
Продуктовые итоги: +10% автоматизации LLM-Only, +10% полного решения проблем, +0,3 CSAT; около 12% обращений уходят в LLM-Only, примерно в 34% участвуют LLM, повторные обращения составляют около 1%.
Источник: Иван НасоновИтог: подготовка агентов и работа инфраструктуры дополняют друг друга
Команда прошла путь от графов с кнопками к поддержке, где лёгкие модели, языковые модели и операторы решают разные части задачи. Быстрой генерации оказалось недостаточно: развитие ограничивал ручной выпуск сценариев. Поэтому к общей инфраструктуре добавили Conclave AI. Подготовка системы включала обучение классификаторов на обращениях, выбор моделей, настройку их выполнения и создание агентов. Менеджеры собирают сценарии и проверяют их в песочнице; тестирование и проверка серверной части остаются отдельными этапами подготовки.
- 01
Определить тему
Лёгкий классификатор получает обращение и пытается определить его тему.
- 02
Обслужить вызов модели
Когда нужна языковая модель, LiteLLM проверяет доступ и приоритет, а HAProxy направляет запрос к нужной модели и исполнителю.
- 03
Уточнить маршрут
При неуверенной первичной классификации языковая модель рассматривает весь диалог и уточняет, какой сценарий нужен пользователю.
- 04
Выполнить сценарий
Система выдаёт готовую инструкцию либо запускает агента с тематической базой знаний и доступными инструментами. Его вызовы моделей проходят через ту же инфраструктуру.
- 05
Проверить ответ
В сценариях с ToV-компонентом отдельная модель проверяет и корректирует финальную формулировку перед отправкой пользователю.
- 06
Подключить оператора
Если автоматическая обработка не решила проблему, обращение передают оператору.
При нагрузке 10 запросов в секунду задержка ответа составила около 2 секунд по P50 и 5 секунд по P90. Отдельный показатель генерации одного токена — 8 миллисекунд по P50. Около 12% обращений уходят в решения без человека, а примерно в 34% участвуют LLM. При отказе дата-центра производительность может снижаться; закрепление запросов ради кеша ограничивает свободу балансировки. Конструктор упрощает подготовку агентов, но не отменяет проверку сценариев и участие операторов.
Доклад · 00:18:21