Разбор готов
Meta — KernelEvolve: как агент ищет быстрые вычислительные ядра и накапливает опыт
Один рекламный запрос в Meta может задействовать несколько моделей ранжирования. Чтобы они быстро обрабатывали данные на GPU NVIDIA, AMD или собственных чипах MTIA, инженерам нужны специально настроенные вычислительные ядра — короткие программы, которые выполняют операции модели на конкретном устройстве. Модели развиваются, у чипов появляются новые поколения, а ручная оптимизация каждой комбинации занимает недели. Готовых библиотек недостаточно для множества специальных операций. Meta построила KernelEvolve: агент генерирует варианты ядер, запускает их через систему испытаний, исследует результаты и выбирает следующую попытку. Разберём архитектуру этого поиска, работу с аппаратной документацией, проверки корректности и скорости, накопление навыков и отдельно организованное дообучение небольших моделей.
Глава полезна ML-инженерам, разработчикам инференса и ускорителей, специалистам по компиляторам и тем, кто проектирует агентов для инженерных задач. На конкретном случае видно, как совместить генерацию кода, аппаратные измерения, поиск по дереву и долговременную память без подмены реальной проверки ответом языковой модели.
Статья · на английском
KernelEvolve: How Meta’s Ranking Engineer Agent Optimizes AI InfrastructureGang Liao и соавторы · Опубликовано: 2 апреля 2026 г.
Почему оптимизация ядер стала отдельной инженерной задачей
Когда рекламная система Meta обрабатывает запрос, ей нужно получить оценки от моделей ранжирования и выполнить множество операций над тензорами. Под тензором здесь понимается массив чисел, из которого модель строит свои вычисления. Между описанием операции в PyTorch или другом высокоуровневом коде и реальной работой ускорителя находится вычислительное ядро — небольшая программа, использующая инструкции конкретного чипа. От её реализации зависят время обработки запроса, загрузка оборудования и скорость обучения модели.
Для одной матричной операции можно выбрать разные способы размещения данных в памяти, разбиения вычислений на блоки и запуска параллельных потоков. Удачный способ для одного ускорителя и одной формы тензора может оказаться плохим для следующей версии модели. Поэтому оптимизация ядра обычно требует последовательности опытов: написать вариант, скомпилировать, проверить численный результат, измерить время, разобраться в аппаратных ограничениях и повторить.
Масштаб задачи Meta описывает произведением трёх факторов: типы и поколения оборудования × архитектуры моделей × виды операций. Каждый новый ускоритель добавляет работу по существующим моделям; каждая новая архитектура приносит новые операции и новые размеры входов. В результате нужно сопровождать тысячи конфигураций. Ручная настройка специалистами по GPU и компиляторам превращается в препятствие и для внедрения нового оборудования, и для экспериментов с моделями.
KernelEvolve встроен в более широкий Ranking Engineer Agent. Другой его компонент, ML Exploration, исследует сами модели ранжирования: предлагает и запускает эксперименты с их архитектурой. KernelEvolve решает следующую задачу — помогает эффективнее выполнить операции выбранных моделей на доступных ускорителях. Область применения агента шире рекламы, но статья рассматривает прежде всего рекламную инфраструктуру Meta.
The Challenge: The Bottleneck of Explosive Kernel GrowthПочему один оптимизированный код не подходит всем ускорителям
В парке Meta есть GPU NVIDIA и AMD, собственные ускорители Meta Training and Inference Accelerator (MTIA) и обычные процессоры (CPU). Они различаются набором инструкций, устройством вычислительных блоков и тем, как данные перемещаются между уровнями памяти. Даже если математическая операция та же самая, порядок чтения данных и распределение работы между исполнителями приходится подбирать заново.
Различия есть и внутри одного семейства. По описанной в статье дорожной карте MTIA, за два года предусмотрены четыре поколения чипов в диапазоне MTIA 300–500. С поколениями меняются вычислительные возможности, пропускная способность памяти и поддерживаемые числовые форматы. Реализация, отлаженная под прежнюю архитектуру, может работать медленнее на следующей; перенос кода ещё не равен переносу производительности.
Отсюда требование к KernelEvolve: при генерации ядра учитывать конкретную аппаратуру и её документацию. Универсальная задача «ускорить оператор» распадается на практические задачи для определённых моделей чипов. Позже увидим, как агент получает спецификации неизвестного ему оборудования через поиск по базе знаний.
Hardware HeterogeneityКак новые рекламные модели расширяют набор операций
Меняется не только аппаратная платформа. Авторы прослеживают развитие рекомендательных моделей Meta: от архитектур, активно использующих таблицы векторных представлений (эмбеддингов), к моделям последовательностей, анализирующим историю действий с помощью механизма внимания, затем к Generative Ads Recommendation Model (GEM) и более поздней Meta Adaptive Ranking Model, которая переносит в рекламу масштаб и подходы, характерные для больших языковых моделей.
Каждый новый класс модели использует операции, которые были не нужны предыдущему. При этом прежние системы не исчезают одномоментно: разные семейства работают одновременно, а обработка одного рекламного запроса может задействовать несколько из них. Поэтому недостаточно оптимизировать несколько популярных операций для одного поколения моделей. Необходимо поддерживать расширяющийся набор вычислений на нескольких типах оборудования.
Model Architecture VariationПочему библиотек cuBLAS и cuDNN недостаточно
Библиотеки производителей уже содержат хорошо оптимизированные реализации массовых операций: умножения матриц (GEMM), свёрток и стандартных функций активации. Однако «умножение матриц» не описывает полностью условия работы. При обучении операция может выполняться на большом пакете примеров, а во время рекламного запроса — на другой форме тензора и с другими ограничениями по задержке. На стадиях ранжирования встречаются разные размеры входов, поэтому оптимальный способ выполнения меняется.
Есть и длинный хвост специальных операций. Перед вызовом модели данные могут проходить хеширование признаков — преобразование значений в компактные идентификаторы, разбиение чисел по интервалам (bucketing) или обрезку слишком длинных последовательностей. В самих моделях появляются объединённые вычисления взаимодействий признаков и специализированные разновидности внимания. Такие операции часто зависят от конкретной архитектуры и не входят в стандартные библиотеки.
Если для операции нет реализации на ускорителе, часть обработки может выполняться на CPU. Тогда приходится передавать данные между разными исполнительными средами, что добавляет задержку. Другой вариант — запустить неудачно оптимизированный код на GPU, который использует лишь небольшую часть его возможностей. По наблюдению авторов, автоматический подбор параметров компилятором и объединение операций тоже не охватывают весь набор аппаратных платформ, форм тензоров и специализированных вычислений.
Это исходная причина автоматизации. Для многочисленных редких операторов недели ручной настройки обходятся слишком дорого, хотя их суммарный вклад в рабочую систему существенен. Перекомпиляция ядра под новый чип не гарантирует, что оно вообще запустится или сохранит скорость.
Kernel Diversity Beyond Standard LibrariesТри ограничения — три архитектурных решения
KernelEvolve строится вокруг измеряемого поиска реализаций. Языковая модель предлагает программный код, специальные задания его проверяют, а результаты испытаний определяют следующий ход поиска. Это позволяет работать и с известными типовыми операторами, и с новыми вычислениями, для которых ещё нет удачной реализации.
Таблицу можно прокрутить по горизонтали.
Авторы выделяют шесть взаимосвязанных частей: синтезатор кода на основе LLM, движок поиска по дереву, базу знаний с извлечением материалов, автоматическую оценку ядер, общую основу для накопления данных и отдельное дообучение специализированных моделей. Первые четыре участвуют непосредственно в очередной итерации оптимизации; два последних позволяют использовать результаты многих итераций и сессий.
How KernelEvolve Addresses These ChallengesКак job harness замыкает цикл генерации и испытаний
Работа начинается с описания оператора, целевой аппаратной платформы и цели по производительности. Система строит набор возможных реализаций и ведёт длительный поиск. Ключевой компонент этого процесса — job harness: механизм, который организует отдельные задания на сборку, исполнение и анализ кандидатов. Он нужен потому, что компиляция низкоуровневого кода может занимать минуты, отдельные задания падают из-за ошибок программы или инфраструктуры, а результаты разных запусков нужно привести к виду, понятному поисковому алгоритму.
Для каждого предложенного ядра harness организует компиляцию, сверку результата с эталоном, измерение производительности на оборудовании, профилирование и подготовку диагностического отчёта. Если кандидат не компилируется или вычисляет неверный результат, его нельзя считать готовой оптимизацией. Если выполняется правильно, но медленно, профиль помогает понять, что ограничивает скорость. Полученные сигналы вместе с историей поиска возвращаются в генератор следующего варианта.
На первой оригинальной схеме синий контур идёт от постановки задачи через внешнее дерево поиска к конкретной сессии генерации, удалённому выполнению и отчёту об эффективности, который возвращается в дерево. Слева расположена база знаний, снизу — пул MTIA, NVIDIA, AMD и CPU для испытаний. Справа отдельно показаны общее хранилище и контур обучения моделей: красные стрелки обозначают подготовку обучающих данных и обучение, а не новый запуск дообучения на каждом шаге проверки ядра.
Схема также показывает возможные языковые модели и способы дообучения внутри соответствующих компонентов. Её важно читать как устройство взаимодействия частей системы, а не как утверждение, будто каждое ядро последовательно проходит через все нарисованные модели и методы обучения. Практический смысл архитектуры — объединить дорогие аппаратные проверки и многократные попытки генерации в один управляемый поиск.
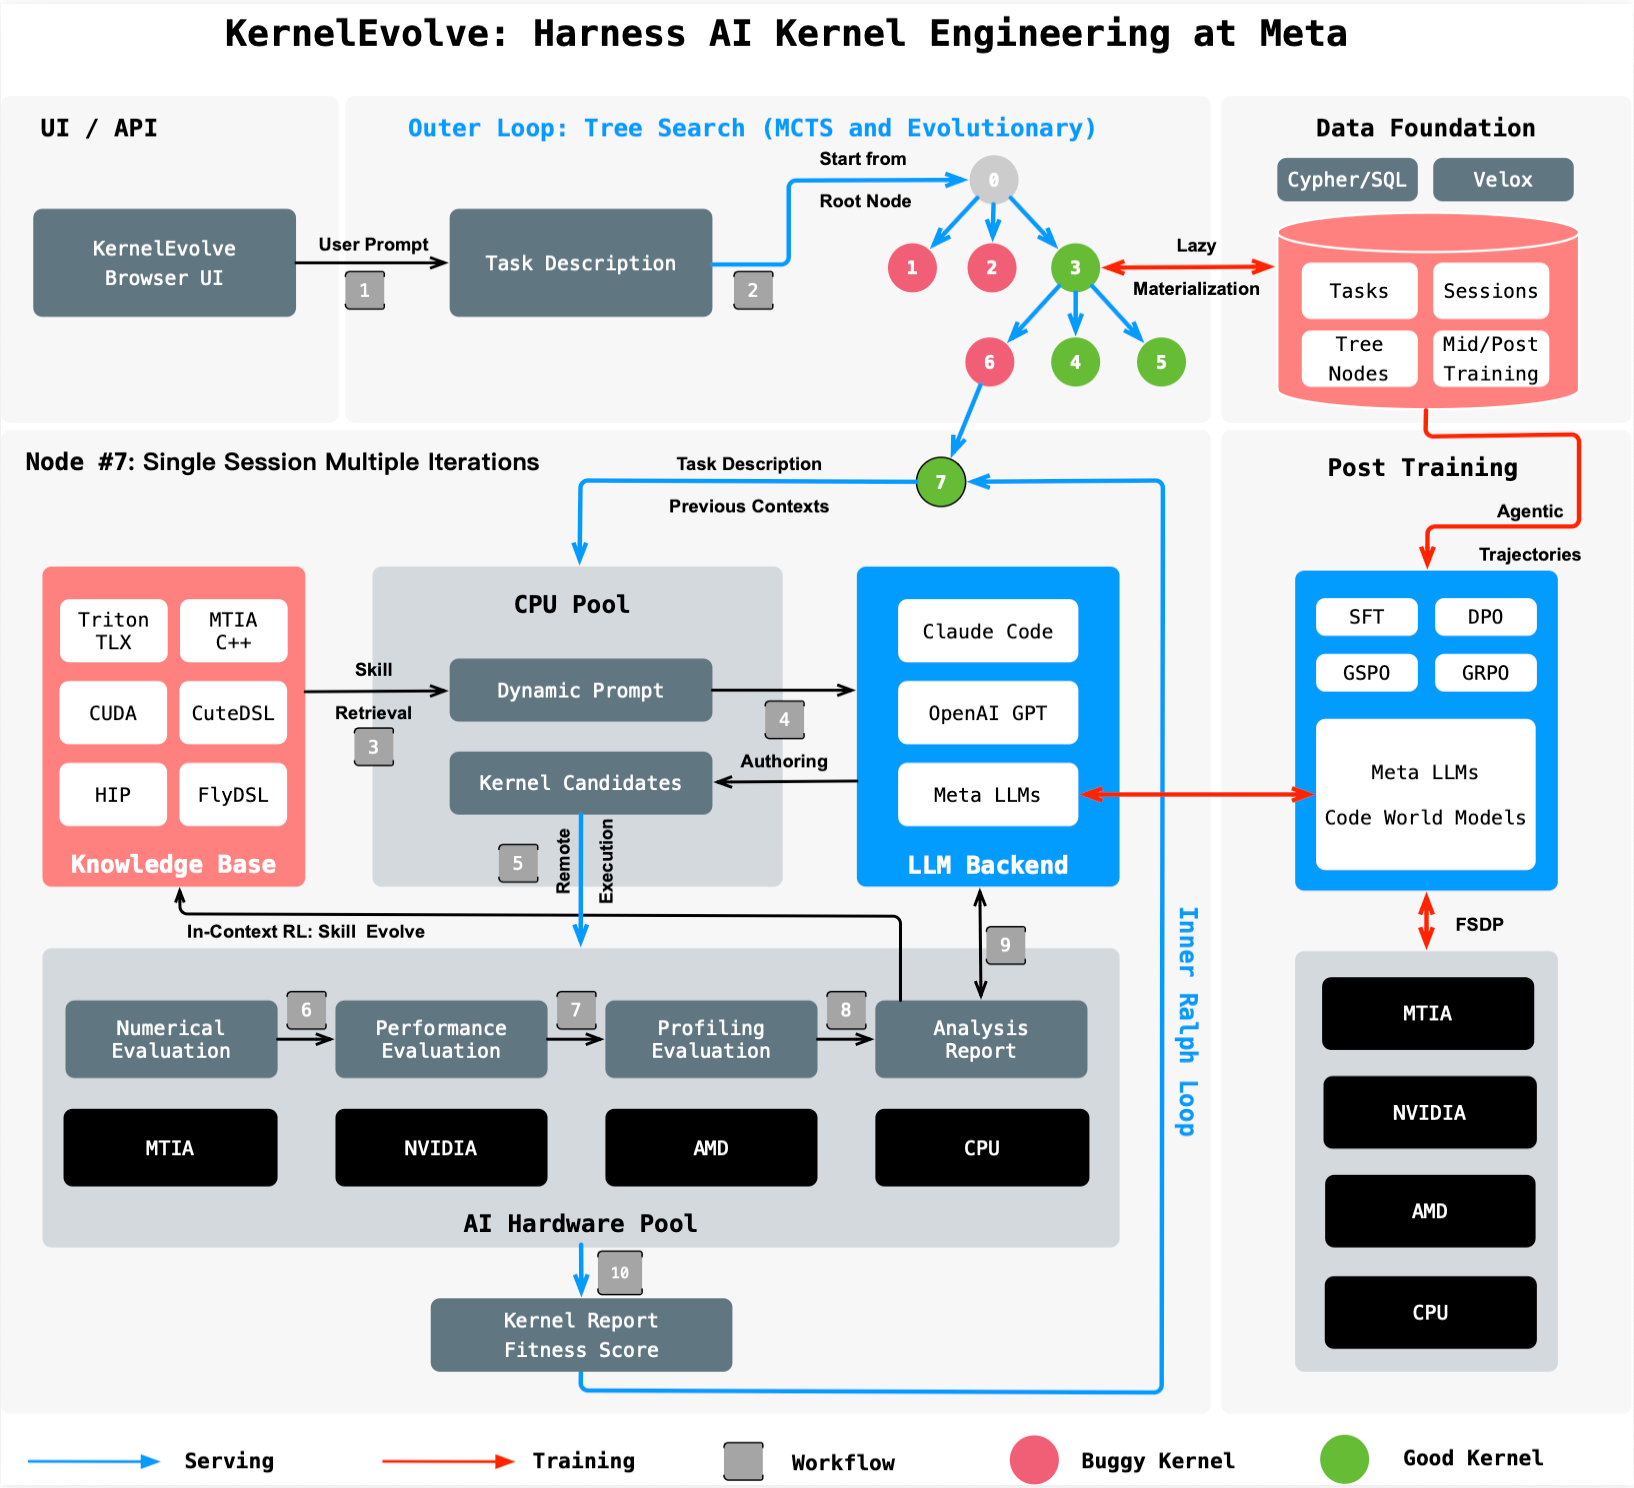
Общая схема KernelEvolve: поиск кандидатов, генерация кода, проверка, профилирование и накопление данных разделены на компоненты.
Источник: Оригинальная иллюстрация · Meta KernelEvolveКак LLM предлагает следующий вариант ядра
Синтезатор — языковая модель, которой поручено написать исполняемую реализацию нужной операции. Ей доступны языки разного уровня. Triton, TLX, CuTe DSL и FlyDSL позволяют выражать параллельные вычисления средствами специализированных языков (DSL), а CUDA, HIP и MTIA C++ дают более прямой доступ к определённым аппаратным платформам. Выбор формы кода зависит от того, что требуется от оператора и что поддерживает целевая система.
Вход синтезатора меняется от итерации к итерации. Вместе с описанием операции он получает выявленные ограничения оборудования, сообщения компилятора, результаты проверки чисел, профили времени и историю удачных или неудачных вариантов. Если предыдущий вариант оказался ограничен работой с памятью, следующая попытка может опираться на этот диагноз и подходящие рекомендации из базы знаний. Если компилятор отверг конструкцию, в контекст попадает информация об ошибке.
Это единый динамический способ подготовки запроса к LLM для отладки, проверки корректности и ускорения. Система не требует отдельного набора промптов под каждую аппаратную платформу и каждую стадию работы. Конкретная языковая модель для всех производственных запусков в статье не закреплена; важен контракт между генерацией кода и измеряющим контуром.
LLM SynthesizerДерево поиска: родитель, соседи и перезапуск без истории
Один успешный ответ LLM редко показывает, какая реализация будет самой быстрой. KernelEvolve рассматривает каждую новую версию ядра как узел дерева поиска. Из уже испытанного варианта можно построить несколько продолжений: поменять способ разбиения операции на блоки, перераспределить работу или выбрать иной путь оптимизации. Движок оценивает результат каждой ветки, развивает перспективные направления и при необходимости возвращается к другим узлам.
Для организации перебора авторы называют поиск по дереву Монте-Карло (Monte Carlo tree search, MCTS) и эволюционные стратегии. Первый позволяет распределять попытки между уже удачными направлениями и новыми вариантами; вторые развивают существующие кандидаты последовательными изменениями. Статья описывает используемые семейства методов, но не задаёт здесь единую формулу выбора следующего узла.
Особенность KernelEvolve — настраиваемый оператор памяти узла. У новой попытки могут быть разные источники контекста. Она может наследовать цепочку решений родителя и продолжать конкретную удачную оптимизацию; сопоставить варианты-соседи одного родителя и выяснить, чем различаются их результаты; объединить родительскую траекторию со сведениями о соседях; либо начать с чистого контекста, чтобы выйти из тупика. В последнем случае очищается история, передаваемая выбранной веткой, а не обязательно вся общая база аппаратных знаний.
Так поиск не превращается в набор независимых запросов к LLM. Удачные последовательности изменений углубляются, соседние попытки помогают отделить полезный приём от неудачного, а перезапуски поддерживают разнообразие направлений, когда улучшения прекращаются. Даже неверные кандидаты важны: их ошибки и диагностические данные подсказывают, каких изменений не стоит повторять.
Вторая оригинальная иллюстрация — экран графа исследования. На нём видны связи между узлами, варианты с ошибками и улучшенные реализации, выбранная вершина, её родитель и потомки; справа показан список лучших результатов данного поиска. Картинка помогает понять родство попыток и работу с ветками. Числа рядом с вершинами относятся к показанному графу и не являются измерениями общего прироста пропускной способности Meta.
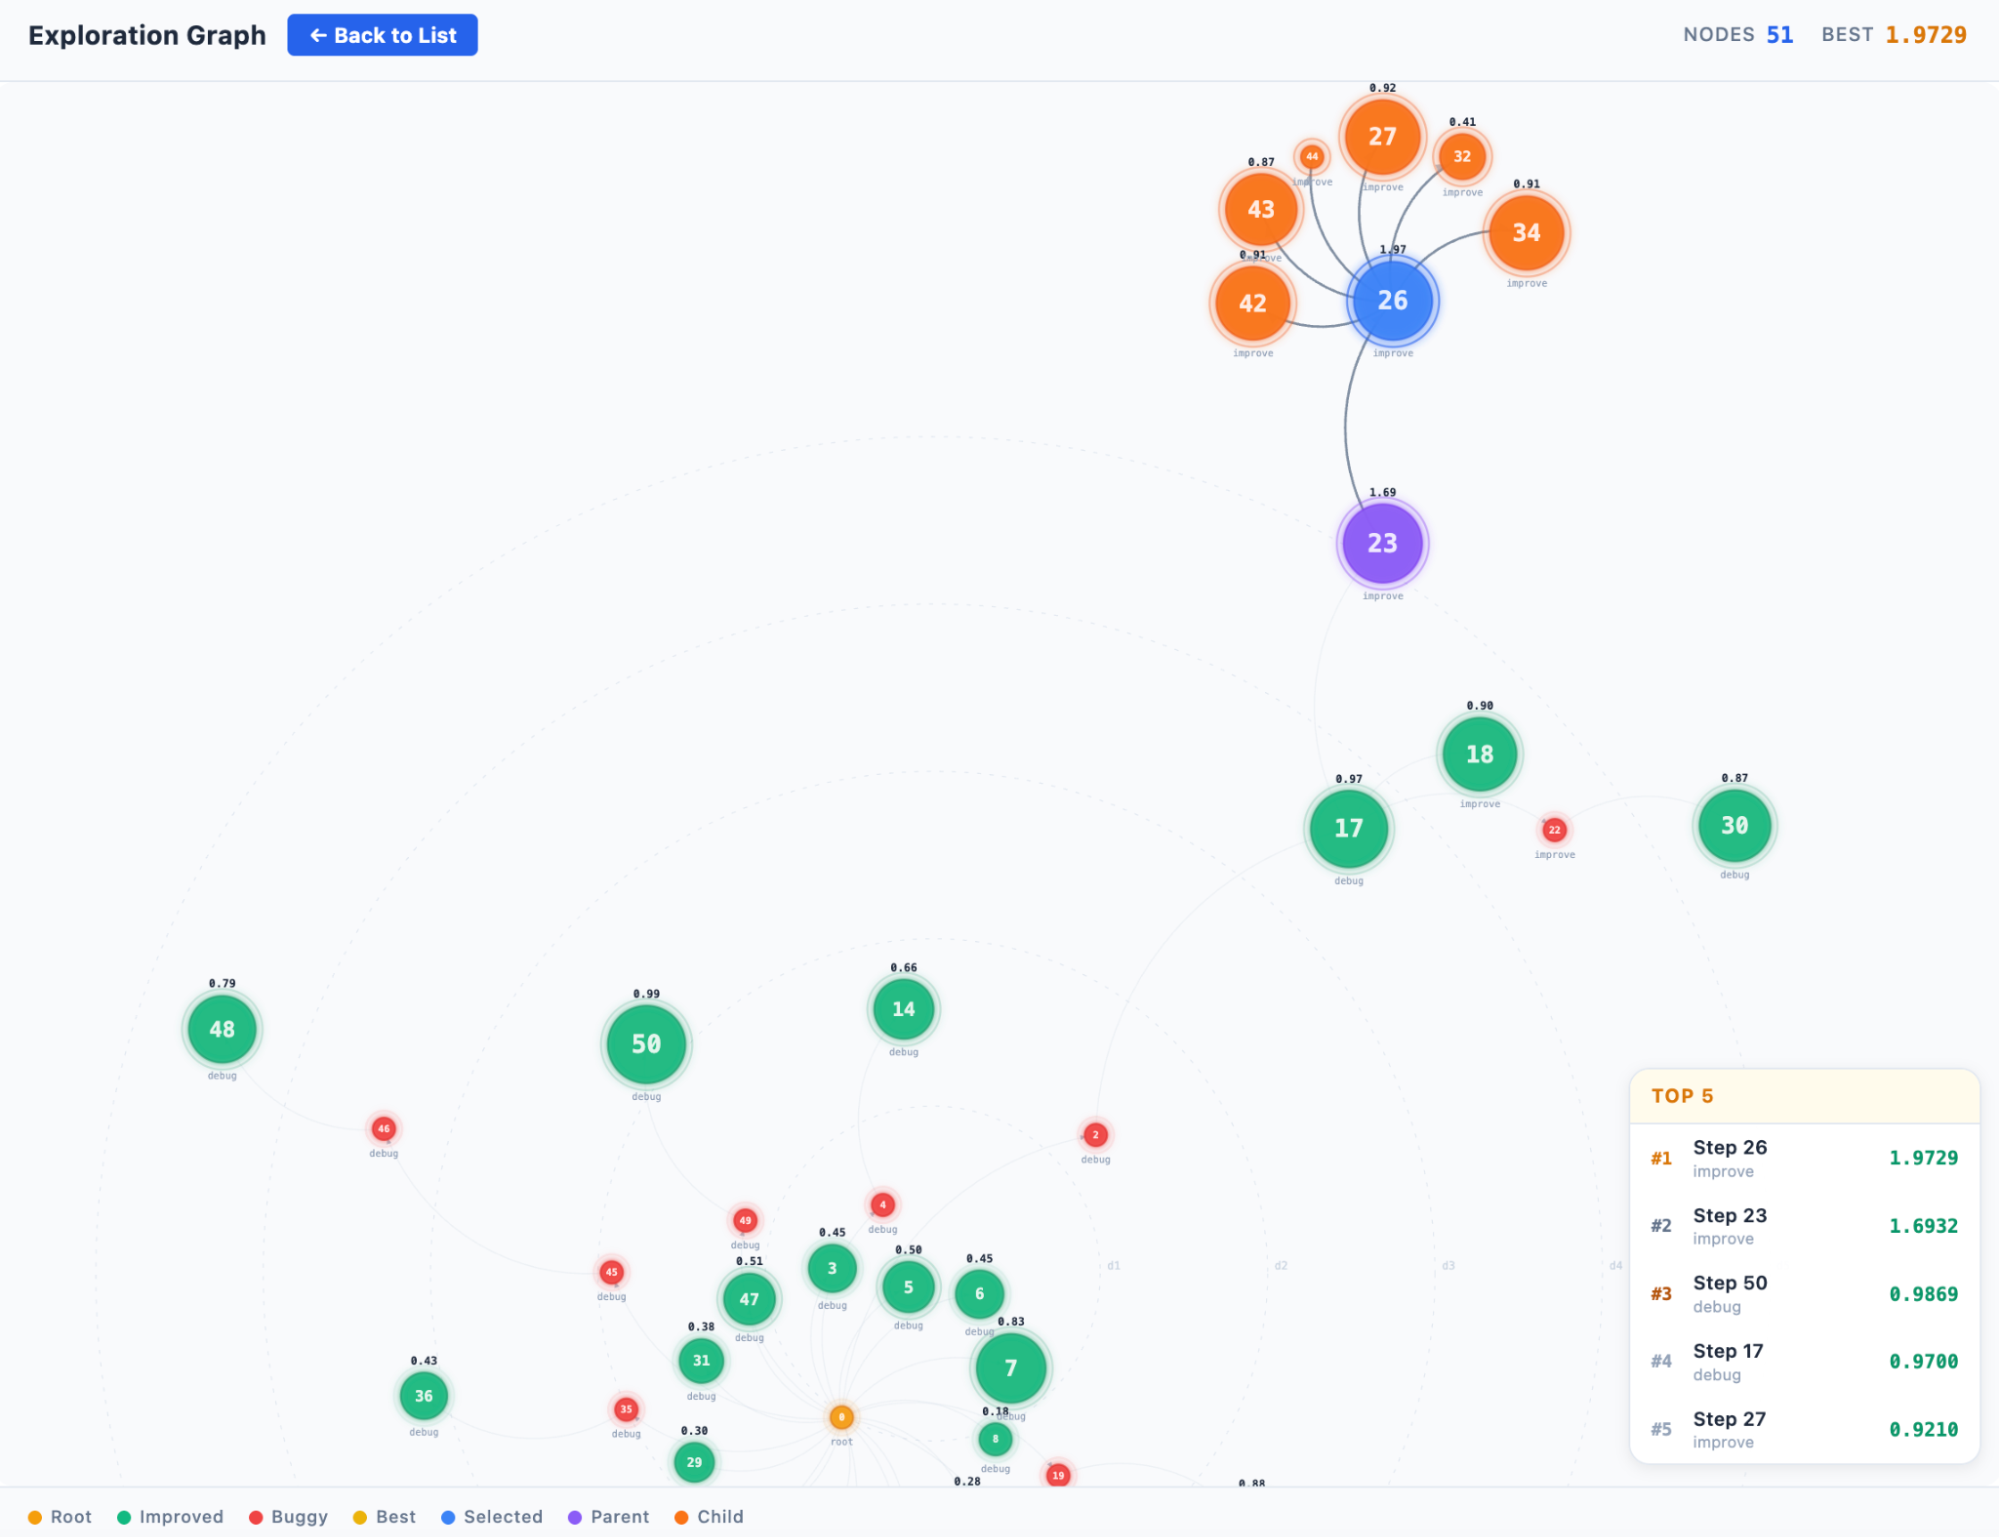
Дерево поиска хранит удачные и неудачные варианты; сведения о родительских и соседних узлах помогают выбирать следующие попытки.
Источник: Оригинальная иллюстрация · Meta KernelEvolveАппаратные знания и библиотека повторно используемых навыков
Чтобы писать код под разные ускорители, модель должна знать ограничения конкретной платформы. KernelEvolve поддерживает иерархическую базу знаний из трёх типов материалов. Первый — правила корректности, которым должна удовлетворять реализация. Второй — общие способы отладки и настройки скорости, пригодные на нескольких платформах. Третий — документация аппаратуры: устройство памяти, наборы инструкций и особенности выполнения операций на отдельных чипах.
Нужные материалы подбираются по текущему состоянию работы — это поиск документов перед очередной генерацией кода, известный как retrieval-augmented generation (RAG). Например, если профилировщик показывает ограничение пропускной способностью памяти, система поднимает сведения об иерархии памяти и соответствующих способах оптимизации. При ошибке компиляции полезнее руководство по синтаксису и отладке выбранного языка. Полученный фрагмент документации становится частью контекста LLM.
База пополняется и после успешных оптимизаций. Из пройденных траекторий система извлекает компактные навыки: например, удачную схему размещения блоков вычисления или эвристику, которая помогла исправить конкретную ошибку. Эти навыки сохраняются, а позже вновь подбираются по типу задачи. В статье этот способ назван in-context reinforcement learning: будущий поиск получает более содержательный контекст и может сделать меньше пробных шагов.
Здесь навыки накапливаются без изменения весов языковой модели. Агент использует библиотеку во время генерации, как инженер использует предыдущие заметки и документацию. Обучение новых весов на собранных траекториях — другой механизм, который описан отдельно.
Retrieval-Augmented Knowledge BaseКак проверяют корректность и сравнивают скорость ядер
Каждый вариант должен пройти две разные проверки. Первая отвечает на вопрос, вычисляет ли он правильный результат для заданной операции и входов. Авторы описывают строгую сверку с эталонными реализациями, вплоть до побитовой точности. Вторая проверка измеряет эффективность исполнения: удалось ли ускорить выполнение на нужном оборудовании и нужных формах входных тензоров. Быстрый код с неверным результатом непригоден, а правильный код без выигрыша ещё не решает задачу оптимизации.
TritonBench используется для проверки численной корректности относительно реализаций PyTorch и для измерения ускорения на формах входов, встречающихся в рабочих нагрузках. Поэтому сравнение выполняется с определённым эталоном и в определённых условиях. Скорость одной микрооперации на искусственном входе нельзя автоматически переносить на весь запрос модели: там возникают запуск ядер, обмен данными и синхронизация.
Набор инструментов дополняет численную проверку несколькими уровнями профилирования. PyTorch Profiler помогает увидеть временную последовательность работы системы: время запуска ядер и ожидания между процессором и ускорителем. NVIDIA Nsight Compute (NCU) показывает, насколько заняты вычислительные ресурсы GPU, какую пропускную способность даёт память и какие инструкции исполняются. Proton исследует задержки инструкций и работу конвейера внутри ядра. Для MTIA применяется MTIA Insight со счётчиками вычислительных блоков и памяти.
Таблицу можно прокрутить по горизонтали.
PE в описании MTIA — вычислительный элемент ускорителя; DPE, SFU и MLU — названия его специализированных исполнительных блоков. Счётчики показывают, простаивают ли эти части, ограничено ли ядро доступом к данным и насколько равномерно используется устройство. Все эти измерения относятся к исполнению проверяемого ядра. Это часть выполнения инженерного задания агентом, а не отдельная офлайн-оценка качества текста, который сгенерировала LLM.
Automated Evaluation FrameworkКак компилятор и профилировщики превращают измерения в диагноз
Измерить, что вариант A быстрее варианта B, полезно, но недостаточно для осмысленного следующего шага. KernelEvolve нужен ответ, почему один вариант выигрывает. Проблема может быть в нехватке пропускной способности памяти, в количестве вычислений или в низкой загрузке исполнительных ресурсов. От причины зависит, какую часть кода стоит менять.
Для этого Meta объединяет инструменты через компиляторный контур. Проверки организованы как граф заданий: преобразования компилятора добавляют инструментирование на уровне промежуточного представления MLIR, профилировщики собирают показатели, а синтез трасс собирает из них структурированный диагностический отчёт. Отчёт вместе с результатами корректности и производительности поступает обратно в поисковый движок и контекст синтезатора.
Так замыкается инженерная петля: компилятор сообщает, что код можно исполнить; проверка убеждается, что он считает то же, что эталон; оборудование показывает скорость и причину ограничения; LLM получает конкретное основание для следующей правки. Показанное авторами сравнение ускорения «в 1,2 раза» служит иллюстрацией того, как мало говорит голая цифра без профиля, а не отдельным результатом на производственной нагрузке.
Automated Evaluation FrameworkОбщий опыт между инженерами, заданиями и поколениями чипов
Дерево поиска полезно внутри конкретной задачи, но Meta стремится не терять результаты после её завершения. Каждая сессия пополняет общую основу данных: сохраняются сведения о рассмотренных вариантах, измерениях и найденных способах оптимизации. Например, при удачном разбиении вычисления на блоки — tiling — для одного семейства операторов последующая сессия может начать с этого решения и проверить, работает ли оно для похожей задачи.
Авторы описывают эффект накопления: первые попытки требуют трудного исследования незнакомого пространства решений, а следующие пользователи получают более сильные исходные варианты. Это важно для новых версий тех же моделей и для новых аппаратных поколений. В заключительном описании архитектуры прямо упомянуто долговременное хранение деревьев поиска и реализаций ядер.
Здесь полезно различать два уровня сохранения опыта. Внутри дерева находятся конкретные родительские и соседние кандидаты со своей историей. На уровне общей основы данных накапливается опыт разных задач; библиотека навыков делает из него повторно используемые рекомендации. Наличие этих сведений ещё не означает, что языковая модель переобучилась: при повторном использовании она получает подходящий материал в контексте следующего задания.
Shared Data FoundationВторой путь улучшения: отдельное дообучение небольших моделей
Проверки ядер дают ещё один вид результата — последовательности действий самого агента. В них остаются рассуждения о возможной оптимизации, изменения кода, ошибки компиляции и исполнения, а затем оценки корректности и скорости. Авторы называют эти последовательности агентными траекториями. Они отличаются от обычного набора исходных программ тем, что содержат путь поиска и обратную связь о каждой попытке.
На таких данных Meta отдельно дообучает небольшие специализированные модели с помощью агентного обучения с подкреплением (agentic RL). В этом методе модель получает сигнал о полезности действий, а здесь источник сигнала — измеренная производительность сгенерированного ядра. Цель состоит в том, чтобы модель лучше выбирала преобразования и приходила к хорошим решениям за меньшее число шагов поиска и токенов рассуждения.
Получается два разных способа совершенствовать KernelEvolve. Библиотека навыков накапливает удачные приёмы и подставляет их в новые запросы без изменения весов LLM. В контуре post-training накопленные траектории используются уже для изменения весов специализированной модели. Эти процессы могут дополнять друг друга, но дообучение не запускается как обязательная стадия при каждой проверке нового ядра.
Meta связывает этот цикл с возможностью самостоятельно обслуживать более компактные модели, которые сохраняют полезные способности больших моделей при меньшей цене исполнения. Статья описывает направление работы и сам принцип обучения на реальных измерениях; сравнения конкретных размеров моделей или отдельной численной оценки выигрыша post-training в ней нет.
Agentic Reinforcement LearningКак агент пишет ядра для закрытой платформы MTIA
Особенно наглядный случай — собственные чипы MTIA. Их спецификации и привычные приёмы программирования отсутствуют в общедоступных обучающих корпусах. По объяснению авторов, стандартный помощник по написанию кода не получает из своего предварительного обучения достаточных сведений об инструкциях, памяти и правилах программирования MTIA.
KernelEvolve решает эту проблему подготовкой доступной агенту аппаратной документации. В базу знаний добавляются руководства по архитектуре, описания инструкций, характеристики иерархии памяти и рекомендации по настройке производительности. Когда задача нацелена на MTIA, поисковый компонент извлекает подходящие материалы, а синтезатор использует их при написании очередного варианта ядра. Так знания об аппаратуре появляются в контексте генерации, даже если исходная LLM с этим оборудованием не встречалась.
Принцип можно применить к следующему поколению ускорителей: после подготовки технических документов система получает возможность начать поиск реализаций без написания каждой из них вручную. Это не отменяет компиляции, численной сверки и профилирования на реальном целевом чипе. Наоборот, измеряющий контур остаётся необходимым, чтобы проверить, действительно ли сгенерированный код подходит новому устройству.
Enabling Proprietary AI ChipsЧто показали проверки на KernelBench и операторах ATen
Meta приводит две серии проверок на наборах операций. Они нужны, чтобы показать, способен ли агент получать рабочие реализации, а не просто выдавать правдоподобный исходный код. Здесь следует различать успешность конечного поиска в наборе заданий и качество каждого промежуточного кандидата: в дереве допускаются ошибки, которые система должна обнаружить.
Таблицу можно прокрутить по горизонтали.
KernelBench оценивает и правильность результата, и ускорение относительно указанного PyTorch-эталона. В опыте с ATen авторы отдельно говорят о полной корректности на заявленных сочетаниях операций и устройств. Это результаты сравнения ядер в конкретных проверках; ниже приведены другие числа — изменения пропускной способности целой модели при обучении и инференсе.
KernelEvolve’s Impact Across Benchmark and ProductionПроизводственные результаты: два разных ускорения и стоимость разработки
В рабочих нагрузках влияние оптимизированных ядер Meta измеряла уже на уровне моделей. Пропускная способность показывает, сколько работы система успевает выполнить за единицу времени при данных условиях. Её не следует путать с задержкой одного ядра или с количеством пользователей, увидевших рекламу.
Таблицу можно прокрутить по горизонтали.
Это два самостоятельных результата: первый касается применения Andromeda на NVIDIA, второй — обучения рекламной модели на MTIA. Они не складываются и не описывают общую скорость всей инфраструктуры Meta или рост выручки. В статье говорится, что KernelEvolve оптимизирует код, обслуживающий триллионы инференс-запросов ежедневно. Такой масштаб характеризует применение оптимизируемого кода в промышленной системе; сам агент не выполняет подбор ядра во время каждого рекламного запроса.
Ещё один результат — скорость инженерной работы. По сравнению с неделями ручной настройки, отладки ошибок и анализа профилей Meta сообщает о выполнении типичной для описанных задач оптимизации за часы автоматического поиска. Это освобождает инженеров для проектирования новых моделей и определения целей оптимизации. При этом точные поколения ускорителей, состав замеренных нагрузок и распределение выигрыша по операторам в статье не детализированы: опубликованные проценты описывают представленные случаи, а не гарантию для любого ядра.
Единая система заявлена для NVIDIA GPU, AMD GPU, MTIA и CPU. Само наличие этих платформ в перечне означает поддержку создания реализаций; аналогичные +60% или +25% для всех четырёх типов оборудования в статье не заявлены.
KernelEvolve’s Impact Across Benchmark and ProductionКак инженеры запускают поиск и получают итоговое ядро
Инженер передаёт KernelEvolve целевую операцию, тип оборудования и желаемую производительность. Система извлекает требования и технические рекомендации для этой платформы, затем просит синтезатор предложить реализации. Дальше выполнение переходит к заданиям на удалённых вычислительных ресурсах: кандидат компилируется, проходит проверку правильности, измерение скорости и профилирование. Диагностический отчёт возвращается в дерево поиска, где выбираются следующие направления оптимизации.
Поиск повторяется, пока не достигнута заданная цель, не закончился допустимый бюджет или не прекратился прогресс. Результатом становится лучший из прошедших проверку вариантов, пригодный для последующего внедрения в рабочую систему. Для ускорения перебора Meta использует распределённую инфраструктуру, которая, по описанию авторов, может оценивать тысячи кандидатов параллельно. Упоминание сотен альтернатив в общей постановке и тысяч параллельных оценок относится к разным уровням описания масштаба, а не к фиксированному количеству запусков каждого задания.
Сохранённые деревья и реализации доступны для последующих версий модели и поколений чипов. Важно разделять три времени: создание и испытание ядра в цикле агента; самостоятельное дообучение небольших языковых моделей на накопленных траекториях; выполнение уже выбранного ядра внутри обучения или инференса рекламной модели. Результаты проверки принадлежат первому процессу, а рабочий рекламный запрос использует уже подготовленный код.
How It All Fits TogetherКуда Meta собирается расширять агентную оптимизацию
Идея KernelEvolve опирается на три приёма: структурированный поиск действий, получение специализированных знаний по мере необходимости и измерение результата на реальном исполнении. Авторы считают, что такую схему можно перенести на гибридный поиск архитектур моделей, оптимизацию компиляторов, управление памятью и настройку системных конфигураций. В статье это направления дальнейшего развития, а не новые результаты производственных экспериментов.
В общей концепции Ranking Engineer Agent компонент ML Exploration предлагает более удачные модели, а KernelEvolve помогает довести их вычислительные операции до эффективного исполнения на доступных платформах. Авторы отсылают за подробностями к отдельной работе «KernelEvolve: Scaling Agentic Kernel Coding for Heterogeneous AI Accelerators at Meta» для ISCA 2026. Рассмотренная здесь архитектура и числа основаны на инженерной статье Meta.
Looking AheadИтог: как KernelEvolve находит и проверяет ускоренное ядро
Meta столкнулась с ростом числа вычислительных ядер: рекламные модели усложняются, формы тензоров различаются между задачами, а парк ускорителей включает NVIDIA, AMD и MTIA. Ручная настройка каждого сочетания занимает много времени. KernelEvolve превращает оптимизацию в повторяемый поиск, в котором языковая модель предлагает код, а специализированные задания проверяют его исполнением.
- 01
Постановка задачи
Инженер задаёт оператор, целевой ускоритель и требование к скорости.
- 02
Подбор знаний
Система извлекает ограничения корректности, аппаратную документацию и полезные навыки прежних поисков.
- 03
Генерация кандидатов
LLM создаёт варианты ядра; дерево поиска использует опыт родителя, соседей или новый старт.
- 04
Проверка исполнением
Harness компилирует код, сравнивает результаты с эталоном, измеряет производительность и собирает профили оборудования.
- 05
Следующая попытка и результат
Диагностика возвращается в поиск. После достижения цели, исчерпания бюджета или остановки прогресса система выбирает лучший проверенный вариант.
Опыт сохраняется двумя разными путями: библиотека навыков улучшает будущие запросы без изменения весов LLM, а накопленные траектории отдельно используются для дообучения небольших моделей с подкреплением. Последнее не входит в исполнение отдельного задания по оптимизации.
В KernelBench авторы заявляют успешное прохождение 250 задач; для 160 операций ATen на трёх платформах — корректность всех 480 сочетаний. В рабочих моделях Meta сообщает о приросте пропускной способности инференса Andromeda более 60% на NVIDIA относительно уже оптимизированной базы и о приросте обучения рекламной модели более 25% на MTIA. Эти измерения относятся к разным моделям и условиям. Главный вывод — проверяемый цикл поиска и повторное использование опыта позволяют быстрее создавать аппаратно-специфический код; дальнейшее расширение на компиляторы и другие задачи пока заявлено как направление развития.
How It All Fits Together