Разбор готов
vLLM: как разделить обработку запроса, генерацию и CPU-операции
В сервисе с потоковыми ответами языковой модели длинный новый запрос может задержать пользователей, которым модель уже начала выдавать текст. Обычный сервер vLLM делит один GPU между обработкой входного контекста и пошаговой генерацией, а на том же узле выполняет токенизацию, подготовку диалога и разбор результата. По мере роста параллельной нагрузки особенно заметными становятся редкие длинные паузы между токенами. Инженер из IBM Research Мартин Хики показывает два способа разнести эти операции: выделить отдельные GPU для prefill и decode и перенести работу с текстом на CPU-сервер. Разберём передачу KV-кеша, устройство API, настройку и измерения. На испытательных L40S разделение резко улучшило хвост задержки между токенами, но замедлило появление первого токена — именно этот компромисс определяет выбор архитектуры.
Материал полезен инженерам, которые разворачивают LLM через vLLM, обслуживают потоковые чаты и агентные запросы, измеряют задержки на GPU или отвечают за маршрутизацию и масштабирование инференса. Особенно пригодится тем, кому нужно отличить выигрыш от изоляции prefill от цены KV-передачи, настроить обработку запросов без GPU и оценить систему по времени первого токена, хвосту задержки и выполнению целевых порогов.
Статья · на английском
Taking vLLM Apart: A Practical Guide to Disaggregated ServingMartin Hickey · Опубликовано: 29 сентября 2026 г.
Почему длинный запрос задерживает остальные ответы
Представим сервис с потоковыми ответами языковой модели. Пока несколько пользователей получают текст по одному токену, приходит новый запрос с длинной историей переписки. Сервер переключается на её обработку, и уже идущая выдача на мгновение замирает. С ростом параллельной нагрузки такие паузы начинают определять качество сервиса, даже если обычный ответ выглядит быстрым.
В стандартном vllm serve соседствуют два разных режима вычислений. Сначала модель обрабатывает входные токены и строит внутренние представления контекста — этот этап называется prefill. Он требует много вычислений и влияет на время до первого токена (TTFT). Затем модель генерирует новые токены по одному — decode. Для него существенна скорость чтения весов из памяти ускорителя; интервал между последовательными токенами называют ITL. Когда длинный prefill выполняется на том же GPU, что и decode других запросов, последние ждут освобождения ресурсов.
При этом на GPU-узле работает ещё и центральный процессор. Он применяет шаблон диалога к ролям и сообщениям, разбивает текст на токены, превращает сгенерированные токены обратно в текст, выделяет рассуждения модели и структурированные вызовы инструментов. Эта работа не требует графического ускорителя, но расходует ресурсы машины, которую арендуют прежде всего ради GPU.
Мартин Хики рассматривает два независимых изменения vLLM: распределить prefill и decode между отдельными экземплярами модели и вынести подготовку входа и разбор выхода на CPU-сервер. Их можно применять по отдельности или совместно. Ключевой вопрос на протяжении всего разбора — окупает ли снижение задержек дополнительные сетевые передачи и сложность эксплуатации.
One Server Doing Three Unrelated JobsДва разделения внутри одной системы
Первое разделение называют P/D: один экземпляр модели принимает входной контекст и создаёт кеш внимания, другой продолжает генерацию. Кеш ключей и значений внимания (KV-cache) хранит для обработанных токенов данные, которые нужны следующим шагам модели. Без передачи этих данных decode не сможет продолжить вычисление с того места, где остановился prefill. Поэтому между экземплярами нужен специальный механизм передачи KV-блоков.
Второе разделение касается представления данных. CPU-обработчик /render принимает обычный запрос в формате OpenAI, применяет шаблон диалога, выполняет токенизацию и, если нужно, подготовку мультимодального содержимого. GPU-движок получает уже идентификаторы токенов и возвращает идентификаторы результата. CPU-обработчик /derender восстанавливает ответ OpenAI, правильно разделяя обычный текст (content), рассуждения (reasoning) и вызовы инструментов (tool_calls). Режим движка, работающего только с идентификаторами токенов, в командах обозначен --tokens-only.
На оригинальной схеме верхняя строка показывает обычный процесс: CPU-операции окружают prefill и decode на одном GPU-узле. В нижней строке четыре логические стадии разнесены: /render на CPU, prefill на GPU, decode на GPU, /derender снова на CPU. Стрелки с надписью tokens обозначают передачу идентификаторов, а отдельная стрелка KV cache — перенос большого кеша между GPU-стадиями. Подпись RDMA показывает типичный вариант быстрого обмена, но не описывает физическое соединение конкретного испытательного стенда. Обе крайние CPU-стадии может обслуживать один сервер vllm launch render, так что четыре этапа не обязательно означают четыре сервера.
Таблицу можно прокрутить по горизонтали.
Два разделения решают разные проблемы. Отдельный GPU для prefill изолирует потоковую генерацию от тяжёлой обработки входов; отдельный CPU-сервер убирает токенизатор и парсеры с GPU-машин. Вынос CPU-работы сам по себе не устраняет конкуренцию между prefill и decode.
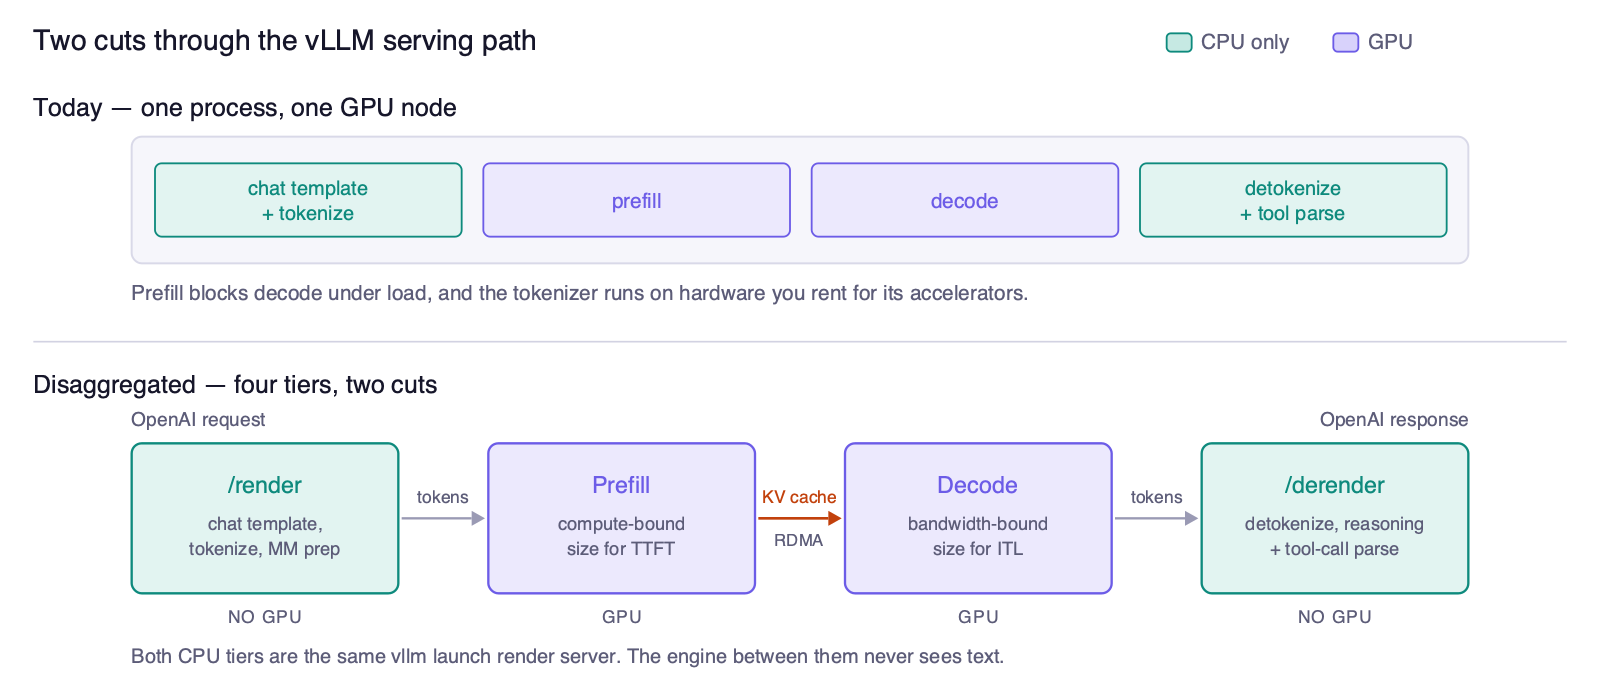
Два разделения в serving: prefill отдельно от decode, а подготовка запроса и результата — на CPU frontend. Между GPU-пулами передаётся KV-кеш.
Источник: Оригинальная иллюстрация · vLLM / IBM ResearchПочему передача KV-кеша становится решающей
Объём переносимого состояния растёт вместе с длиной контекста и устройством модели. В примере автора Llama-3.1-70B при BF16 хранит около 320 КиБ KV-кеша на один токен; для входа длиной 10 тысяч токенов это примерно 3 ГБ. Даже при пропускной способности линии 400 Гбит/с идеальное время передачи такого объёма составляет около 65 мс до любых накладных расходов. Вся эта задержка добавляется до первого токена, а значит непосредственно влияет на TTFT.
Перемещением блоков занимается KV-коннектор. В статье перечислены NIXL, LMCache, Mooncake, FlexKV, AMD MoRI-IO и MultiConnector, позволяющий связывать механизмы друг с другом; на момент публикации доступно более десятка коннекторов. Для передачи между узлами используют, в частности, RDMA — прямой удалённый доступ к памяти через подходящую сеть. Внутри узла важны поддержка прямого обмена между GPU, NVLink или другой быстрый путь. Выбор коннектора не отменяет требований к самому соединению.
Подход расширяется и на другие границы вычислений. Отдельно от P/D в vLLM рассматриваются вынесение мультимодального энкодера, AFD-плагин для разделения механизма внимания и полносвязной части у моделей со смесью экспертов (MoE), а также передача состояния Mamba при P/D для гибридных моделей с пространством состояний (SSM). Это соседние возможности архитектуры, а не состав собственного эксперимента автора: в нём обмен между prefill и decode выполнен через NIXL.
The Dimensions — «Llama-3.1-70B in BF16 stores 320 KiB per token»Выигрыш измеряют соблюдением порогов задержки
При разделении тех же GPU абсолютное число генерируемых токенов в секунду не обязано вырасти. Главная цель здесь — полезная пропускная способность, или goodput: сколько запросов в секунду система способна обслуживать, одновременно выполняя заданные требования ко времени первого токена и к промежуткам между последующими токенами. Эти требования называют SLO — целевыми показателями сервиса. Высокий общий throughput без соблюдения задержек не гарантирует хороший goodput.
Отдельные пулы позволяют настраивать два ограничения независимо. Вычислительно тяжёлому prefill может подойти распараллеливание одной модели на несколько GPU (tensor parallelism), а decode — собственный размер пакетов одновременных запросов и другая конфигурация ресурсов. Пока генератор работает со своими запросами, длинный новый контекст не занимает его GPU. Это даёт возможность удерживать хвост ITL при росте нагрузки.
Более простой компромисс существует и без выделенного GPU: длинный prefill можно выполнять частями (chunked prefill), чередуя их с шагами decode. Такой приём уменьшает паузы, но размер частей приходится подбирать под длины запросов и характер нагрузки. Раздельные стадии создают более жёсткую изоляцию; за неё платят дополнительной передачей KV-кеша, ещё одним сервисом и новыми сценариями отказа.
What It Buys You and What It Costs — «The pitch isn't peak throughput.»Как сравнивали две конфигурации L40S
Собственный нагрузочный эксперимент автора проводился на одном сервере с двумя NVIDIA L40S по 48 ГБ каждая. Ускорители подключены через PCIe, NVLink между ними нет. Модель — Qwen2.5-7B-Instruct, входы длиной примерно восемь тысяч токенов, ответы — по 256 токенов. Для каждой предложенной интенсивности подавали 100 запросов с пуассоновским потоком поступлений; повторное использование кеша общих префиксов было отключено. По горизонтальной оси результатов отложена предлагаемая интенсивность, от 0,2 до 2 запросов в секунду, а не гарантированная фактическая скорость завершения ответов.
Таблицу можно прокрутить по горизонтали.
Сравнение контролирует число и тип GPU, однако вариант DP=2 — не самый сильный возможный совмещённый сервер. Параллельные процессы внутри одного vllm serve могут задерживать друг друга. Сам автор отмечает, что две полностью независимые реплики модели за балансировщиком могли бы работать лучше; такого контроля в приведённом опыте нет. Поэтому измерения отвечают на вопрос о двух конкретных конфигурациях, а не доказывают превосходство P/D над любым устройством совмещённого сервиса.
Почему одинаковая медиана скрывает сильные паузы
Задержка между токенами — не одна постоянная величина. Медиана описывает типичный промежуток: половина наблюдений короче неё. Девяносто девятый перцентиль (p99) показывает границу, ниже которой находятся 99% наблюдений; по нему хорошо видны редкие, но заметные пользователю остановки потока.
На оригинальном графике фиолетовым обозначен совмещённый сервер с DP=2, зелёным — P/D из одного prefill и одного decode через NIXL. Сплошные линии показывают p99 ITL, пунктирные — медиану ITL. Вплоть до нагрузки 1 запрос/с медианы в обеих схемах близки: 21–24 мс. Однако у совмещённого сервера хвост растёт намного быстрее.
Таблицу можно прокрутить по горизонтали.
При минимальной интенсивности 0,2 запроса/с у совмещённой схемы p99 ещё около 23 мс, но уже при 0,4 запроса/с подскакивает до 169 мс. На участке 0,4–0,6 запроса/с его p99 примерно в шесть раз выше P/D. У P/D p99 на всём показанном диапазоне остаётся примерно в интервале 25–52 мс; точка при 2 запросах/с подписана как 50 мс и не является максимумом всей зелёной линии.
Причина различия соответствует устройству этапов: длинные входы заставляют общий GPU временно переключаться на prefill, прерывая уже начатую генерацию. Отдельный decode такого вмешательства не испытывает. Рисунок подтверждает снижение хвоста ITL именно в этом опыте. Среднее ITL, общая задержка ответа, TTFT и goodput на графике не представлены — из близости пунктирных линий их вычислить нельзя.
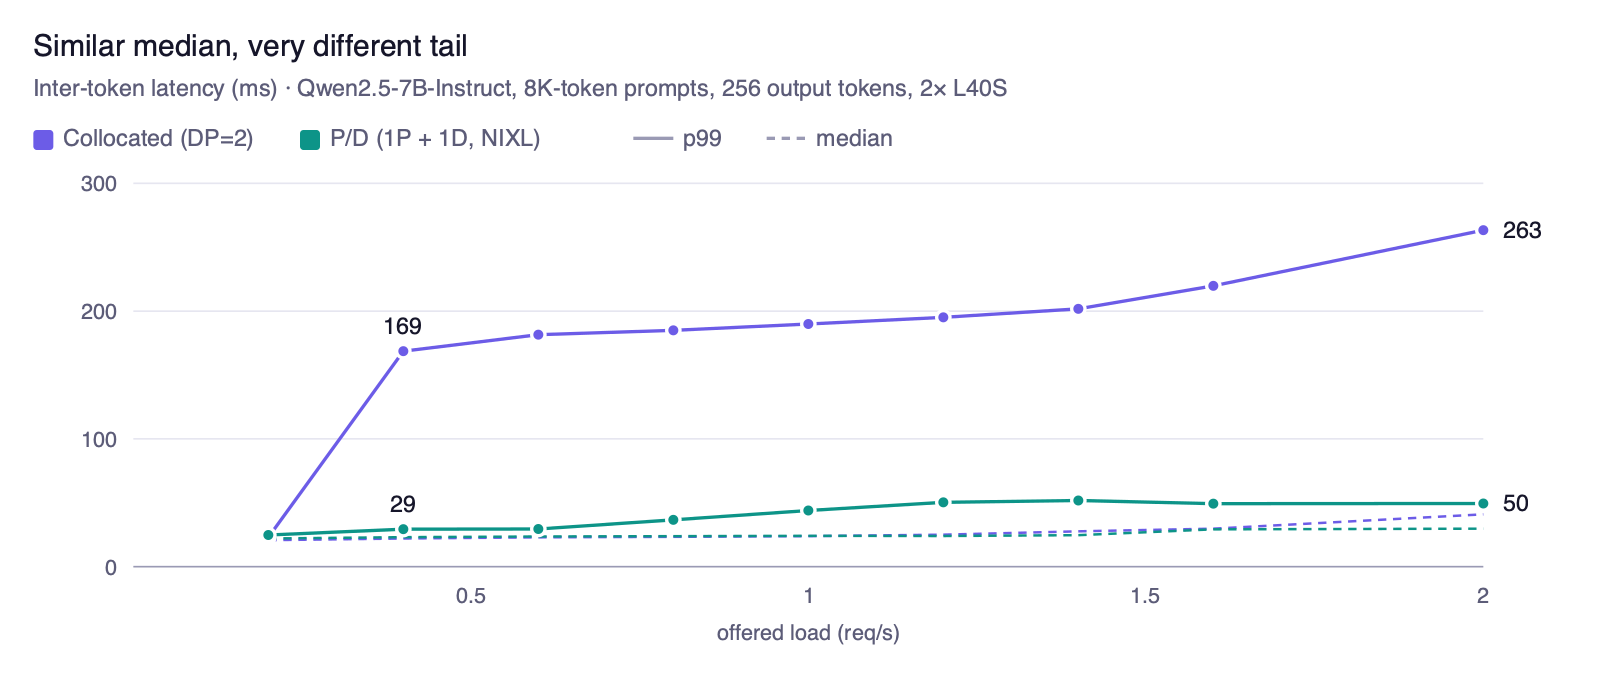
Медиана задержки между токенами остаётся близкой, но её 99-й перцентиль заметно снижается при разделении prefill и decode.
Источник: Оригинальная иллюстрация · vLLM / IBM ResearchЧто показали два внешних сравнения
Чтобы показать, что P/D может улучшать не только хвост ITL, но и выполнение ограничений по всему запросу, автор приводит два отдельных замера других команд. В них используются иные модели, ускорители и соединения. Результаты дополняют опыт на L40S, но не являются дополнительными точками его графика.
Таблицу можно прокрутить по горизонтали.
У AMD единицей успеха считается запрос, который одновременно прошёл два порога: быстрый первый токен и быстрые последующие. В сравнении llm-d представлены среднее и p95 времени ответа от начала до конца. Эти величины отличны от p99 ITL на графике L40S. Их нельзя складывать с локальным выигрышем или трактовать как подтверждённый эффект на пользовательском трафике той же системы.
Общий смысл внешних примеров — быстрый транспорт KV-кеша позволяет получить выигрыш в полезной пропускной способности. Но у испытательного стенда с L40S как раз обнаружилась противоположная ситуация.
What It Buys You and What It Costs — «Goodput goes up when the transfer is fast.»Когда ускорение генерации проигрывает первому токену
На стенде с двумя L40S не работал прямой обмен данными GPU-to-GPU: проверка nvidia-smi topo -p2p r возвращала NS вместо OK. Приблизительно восьмитысячный вход Qwen2.5-7B создавал около 470 МБ KV-кеша, исходя из 56 КиБ на токен. До декодера кеш добирался примерно за 1,3 секунды. Именно этот дополнительный этап перед первым ответом перевесил выгоду от изоляции decode.
При низкой нагрузке 0,2 запроса/с медианное время до первого токена составило 2,2 секунды для P/D против 0,7 секунды у совмещённого сервера. Заданный порог TTFT в 2 секунды P/D не выдержал ни на одной из проверенных интенсивностей, хотя p99 ITL оставался низким. Это ключевой неудачный результат эксперимента: хороший хвост интервалов между токенами сам по себе не означает, что система выполняет оба условия обслуживания.
Автор не сводит 1,3 секунды к ограничению полосы PCIe. Даже если переносить данные через оперативную память, теоретическая передача 470 МБ по PCIe 4.0 должна занимать десятки миллисекунд. Значительную часть времени дают накладные расходы вокруг копирования, в том числе то, что decode обнаруживает завершение передачи при очередной проверке между собственными шагами вычисления. Это диагностическое объяснение автора, а не детальная разбивка 1,3 секунды по операциям.
Поэтому практическая последовательность обратная соблазну сначала мерить throughput: сперва проверить транспорт. На одном узле команда nvidia-smi topo -p2p r показывает, доступно ли чтение между выбранными GPU; OK предпочтительнее NS. Затем стоит пропустить по одному несколько длинных запросов и найти в логах decode строку KV Transfer metrics, особенно Avg xfer time. Если там сотни миллисекунд, сначала устраняют узкое место. Между узлами подходящим быстрым соединением могут быть InfiniBand или RoCE с RDMA, внутри узла — NVLink либо поддерживаемый P2P.
nvidia-smi topo -p2p r
# Затем: длинные запросы по одному и проверка Avg xfer time
# в строке KV Transfer metrics на стороне decode.
Медленный или неправильно настроенный сетевой путь мешает не только передаче KV: на нём могут пострадать и коллективные GPU-операции. Решение о P/D принимают после измерения фактического переноса, а не только по схеме сети или пиковой полосе интерфейса.
What It Buys You and What It Costs — «Every first token pays for the transfer.»Какие нагрузки оправдывают дополнительный CPU-сервер
Вынесение шаблонов и токенизации с GPU-узла делает CPU-обработку отдельной, обычно дешёвой масштабируемой услугой. На том же оборудовании применение шаблона и токенизация диалога длиной около девяти тысяч токенов для Qwen2.5-7B занимали примерно 15 мс процессорного времени. Один сервер render с настройками по умолчанию обслуживал до 73 запросов/с, загружая немного больше одного ядра. При потоке 0,4 запроса/с, на котором у совмещённого GPU уже заметно ухудшался хвост ITL, на простую подготовку входа уходило менее 1% одного CPU-ядра.
Такой результат относится к подготовке текста. Обработка изображений и особенно потоковый разбор рассуждений или вызовов инструментов могут нагружать CPU намного сильнее; их стоимость понадобится учитывать отдельно. Разделение облегчает и управление мощностями: CPU-реплики масштабируют по их собственным метрикам, не докупая для токенизатора GPU.
Цена P/D — дополнительный сервис и возможность отказа во время передачи кеша; при объединении с render/derender действуют уже три или четыре логических компонента. Поэтому выбор строится вокруг профиля реальных запросов и требуемых задержек, а не вокруг числа выделенных этапов.
What It Buys You and What It Costs — «The CPU tier is cheap.»Как запустить prefill и decode отдельно
Начиная с vLLM 0.30.0 автор показывает минимальную конфигурацию из трёх процессов: сервер prefill, сервер decode и маршрутизирующий прокси. Для быстрой проверки соединения используется Qwen3-0.6B: маленькая модель быстро загружается и позволяет проверить правильность обмена. Но она обрабатывает вход настолько быстро, что на ней почти не проявляется конфликт prefill с decode. Для измерения выигрыша нужна более крупная модель, в статье предлагается класс 7B.
Первый процесс закрепляют за GPU 0 и настраивают NixlConnector как производителя KV-блоков (kv_producer), второй — за GPU 1 в роли потребителя (kv_consumer). Порты 8100 и 8200 принадлежат экземплярам vLLM. Переменная VLLM_NIXL_SIDE_CHANNEL_PORT задаёт служебные каналы NIXL: в примере 5600 и 5601, по одному уникальному порту на worker данного хоста. UCX_NET_DEVICES=all присутствует в обоих примерах.
# Терминал 1 — prefill, GPU 0
CUDA_VISIBLE_DEVICES=0 UCX_NET_DEVICES=all VLLM_NIXL_SIDE_CHANNEL_PORT=5600
  vllm serve Qwen/Qwen3-0. --port 8100
  --kv-transfer-config '{"kv_connector":"NixlConnector","kv_role":"kv_producer"}'

# Терминал 2 — decode, GPU 1
CUDA_VISIBLE_DEVICES=1 UCX_NET_DEVICES=all VLLM_NIXL_SIDE_CHANNEL_PORT=5601
  vllm serve Qwen/Qwen3-0. --port 8200
  --kv-transfer-config '{"kv_connector":"NixlConnector","kv_role":"kv_consumer"}'

# Терминал 3 — учебный прокси (из репозитория vLLM)
python tests/v1/kv_connector/nixl_integration/toy_proxy_server.py
  --port 8192
  --prefiller-hosts localhost --prefiller-ports 8100
  --decoder-hosts localhost --decoder-ports 8200
Клиент обращается к прокси на порту 8192 как к обычному интерфейсу OpenAI. Для каждого запроса прокси сначала отправляет запрос в prefill, выставляя max_tokens=1 и kv_transfer_params: {"do_remote_decode": true}. Prefill вычисляет KV-кеш, временно сохраняет блоки и возвращает kv_transfer_params с указанием на них. Затем прокси передаёт исходный запрос в decode вместе с этими параметрами. Decode забирает нужные блоки по NIXL и генерирует основной ответ.
Значение max_tokens=1 в первом вызове — часть протокола передачи управления, а не ограничение длины ответа пользователю. Процесс на стороне prefill должен вычислить и удержать контекст, после чего генерация продолжается на другом экземпляре. Учебный прокси расположен в дереве tests/; для разработки и проверки он удобен, но автор отдельно предупреждает, что это не готовый промышленный маршрутизатор. Для работающего кластера указаны llm-d и NVIDIA Dynamo.
Как удерживать кеш и переживать сбои
Разделённая система должна договориться не только о том, откуда забрать KV-кеш, но и о том, сколько времени хранить его в ожидании второй стадии. Параметр kv_lease_duration внутри kv_connector_extra_config по умолчанию равен 30 секундам. Пока действует этот срок, prefill удерживает соответствующие блоки для decode. При нагрузке и очередях именно его приходится подбирать с учётом реального времени передачи и ожидания.
Если забрать кеш не удалось, действует kv_load_failure_policy. Значение fail, выбранное по умолчанию, завершает запрос ошибкой. Вариант recompute позволяет экземпляру decode самому пересчитать недостающие KV-блоки. Это сохраняет возможность ответить, но платой становится дополнительная задержка и вычисления. Такая страховка не превращает медленный или постоянно неисправный транспорт в быстрый.
В схеме P/D без отдельного CPU-render можно убрать повторную токенизацию входа. После первого вызова /v1/chat/completions prefill уже знает реальные ID входных токенов. Если передать return_token_ids: true, в ответе будут prompt_token_ids. Decode получает их через kv_transfer_params вместе с указателями на KV и не разбирает те же исходные сообщения заново. Это полезная локальная оптимизация P/D, но она не равна полноценному выносу обоих CPU-этапов на /render и /derender.
from openai import OpenAI

model = "Qwen/Qwen3-0.6B"
messages = [{"role": "user", "content": "What is 17 * 23?"}]
prefill_client = OpenAI(base_url="http://localhost:8100/v1", api_key="EMPTY")
decode_client = OpenAI(base_url="http://localhost:8200/v1", api_key="EMPTY")

prefill = prefill_client.chat.completions.create(
    model=model,
    messages=messages,
    max_tokens=1,
    extra_body={
        "return_token_ids": True,
        "kv_transfer_params": {"do_remote_decode": True},
    },
)

response_stream = decode_client.chat.completions.create(
    model=model,
    messages=messages,
    stream=True,
    extra_body={
        "kv_transfer_params": {
            **prefill.kv_transfer_params,
            "prompt_token_ids": prefill.prompt_token_ids,
        }
    },
)
for chunk in response_stream:
    print(chunk.choices[0].delta.content or "", end="")
Работающий обмен — только начало настройки. Число серверов каждой стадии, параллелизм, размер пакета запросов и доступная память под KV зависят от модели и нагрузки. В статье для дальнейшего выбора топологии упоминается отдельный разбор P/D для Qwen3.8-2.4T; он служит ориентиром по подбору ресурсов, а не описывает модель собственного испытания на L40S.
Running Prefill/Decode — «Three settings worth knowing early.»Как не пересчитывать диалог на каждом ходе
Однонаправленная передача KV из prefill в decode подходит для одного запроса, но в переписке создаёт лишнюю работу. После первого ответа decode хранит кеш не только входа, но и сгенерированного продолжения. Prefill этот ответ не вычислял. Когда приходит следующая реплика, вход для prefill содержит предыдущий ответ, и без дополнительного механизма эту часть истории приходится обрабатывать заново.
Для диалогов и агентных циклов автор предлагает включать bidirectional_kv_xfer на обоих экземплярах. Теперь prefill может получить уже посчитанные блоки обратно от decode и обработать только добавившиеся токены. Прокси должен знать, какие блоки относятся к одной переписке; для этого клиент передаёт conversation_id, а маршрутизатор сопоставляет ему накопленное состояние. Выгрузка KV-кеша на отдельный носитель или общий кеш вроде LMCache и Mooncake дополняют эту идею, если контекст велик и запросы распределяются между экземплярами.
Есть опасная граница корректности. У моделей с явными рассуждениями KV, оставшийся у decode после ответа, может содержать внутренние токены размышлений. Шаблон диалога Qwen3 при подготовке следующего хода способен убрать эти фрагменты. Тогда новый текстовый контекст уже не совпадает по токенам с тем префиксом, для которого сохранён кеш. Повторное использование такого состояния может дать неправильный ответ, а не просто замедление. На дату статьи vLLM автоматически не обнаруживает несовпадение; проблема зафиксирована как #43094.
Поэтому перед двусторонним обменом проверяют правило построения следующего промпта, сохранность всех токенов общего префикса и поведение reasoning-шаблона. Для оценки пользы на реальных чатах автор советует сравнивать TTFT не только первого обращения, но и, например, пятого хода: именно на растущей истории должно проявляться сокращение повторных вычислений.
Multi-Turn: Stop Recomputing the ConversationЗачем движку работать только с токенами
Вынесенный CPU-контур меняет границу между приложением и моделью. После /render GPU-движок видит точные идентификаторы токенов, а после генерации возвращает такие же идентификаторы без преобразования в текст. Так обработка пользовательского формата и вычисления нейросети перестают требовать одного процесса и одного набора CPU-ресурсов.
У этого интерфейса есть последствия помимо экономии вычислений. Маршрутизатор может направить запрос на ту реплику, где уже хранится совпадающий префикс KV-кеша, сравнивая настоящие токены, а не угадывая совпадение по текстовым строкам. В задачах обучения с подкреплением и проверки модели можно сохранить именно те ID, которые движок получил и выдал: после превращения токенов в строку её повторная токенизация не всегда возвращает ту же последовательность. Эти возможности следуют из открытого токенового интерфейса; сам роутер или обучающий контур отдельно ещё нужно организовать.
В мультимодальных запросах на CPU-стадию переносятся распаковка изображения и работа модельного процессора. Если используется отдельный мультимодальный энкодер (encoder disaggregation), обработанные тензоры направляются ему, а в prefill передают только необходимые метаданные. Размер тензоров после обработки бывает больше исходного файла, поэтому лимиты на тела запросов и объём передаваемых данных следует задавать по промежуточному представлению, а не по размеру загруженной картинки.
Простейший вариант этого второго разделения состоит из двух серверов: vllm launch render без GPU выполняет шаблонизацию, токенизацию и парсеры, а vllm serve --tokens-only на GPU выполняет только генерацию. Флаги парсинга рассуждений и инструментов указывают render-серверу, потому что именно он формирует окончательную структуру ответа.
# CPU-сервер преобразования запросов и ответов
vllm launch render Qwen/Qwen3-0. --port 8100
  --reasoning-parser qwen3
  --enable-auto-tool-choice
  --tool-call-parser hermes

# Отдельный GPU-движок: только идентификаторы токенов
vllm serve Qwen/Qwen3-0. --tokens-only --port 8200
Оба специализированных режима сразу открывают интерфейсы масштабирования. Если же нужен обычный vllm serve, который одновременно обслуживает OpenAI-запросы и дополнительные пути /render, /derender, /inference/v1/generate, эти пути по умолчанию выключены. Для их включения предусмотрен --enable-scale-out. Порты 8100 и 8200 в данном примере относятся к render и tokens-only engine; это другая конфигурация, чем предыдущие 8100/8200 для prefill и decode.
Три обращения от диалога до ответа
Без раздельных prefill и decode токеновый интерфейс образует три последовательных HTTP-вызова. Первый переводит исходный запрос OpenAI в generate_request с полем token_ids. Второй отправляет эти токены в GPU-движок через /inference/v1/generate и получает generate_response. Третий передаёт ответ на CPU в /v1/chat/completions/derender, где составляются обычные поля OpenAI ChatCompletionResponse.
import httpx

model = "Qwen/Qwen3-0.6B"
render_url = "http://localhost:8100"
engine_url = "http://localhost:8200"
chat_request = {
    "model": model,
    "messages": [{"role": "user", "content": "What is 17 * 23?"}],
    "max_tokens": 2048,
}

with httpx.Client(timeout=60.0) as client:
    # 1. OpenAI-запрос -> ID токенов, CPU
    generate_request = client.post(
        f"{render_url}/v1/chat/completions/render", json=chat_request
    ).json()

    # 2. ID токенов -> ID токенов, GPU
    generate_response = client.post(
        f"{engine_url}/inference/v1/generate", json=generate_request
    ).json()

    # 3. ID токенов -> OpenAI-ответ, CPU
    response = client.post(
        f"{render_url}/v1/chat/completions/derender",
        json={
            "model": model,
            "generate_response": generate_response,
            "prompt_tokens": len(generate_request["token_ids"]),
            "chat_request": chat_request,
        },
    ).json()

print(response["choices"][0]["message"])
Для корректного разбора результата важно передать в /derender первоначальный chat_request. Он содержит список доступных инструментов, tool_choice, настройку include_reasoning и другие сведения, без которых нельзя воспроизвести разделение ответа на content, reasoning и tool_calls. Если для модели задан парсер, но этого контекста нет, сервер возвращает HTTP 400. Это явная защита от ситуации, когда служебная разметка вызова инструмента незаметно попала бы в обычный текст.
Здесь сетевые переходы происходят в одном порядке на каждый запрос; никакого обучения или подготовки индекса во время ответа нет. CPU-компонент знает формат общения, GPU-компонент выполняет модель, а приложение связывает их вызовы.
Running the GPU-Less Frontend — «Then it's three hops — render, generate, derender»Как устроен разбор потоковых ответов
Для потокового ответа нельзя дождаться окончания генерации, а затем один раз разобрать весь текст. Запрос с stream: true проходит через /render, и этот признак сохраняется в обращении к tokens-only engine. Тот выдаёт поток фрагментов — чанков. Приложение передаёт каждый generate_chunk в /derender, получает соответствующий фрагмент OpenAI-ответа и отправляет его пользователю.
Поскольку запросы к /derender независимы, накопленное состояние потока возвращается самому клиенту. Первый вызов получает stream_state: null, последующие — состояние из предыдущего результата. Вместе с каждым чанком снова отправляются chat_request и полные prompt_token_ids. Для нескольких одновременно генерируемых вариантов (n > 1) состояние ведут отдельно для каждого индекса варианта ответа.
import httpx
import json

model = "Qwen/Qwen3-0.6B"
render_url = "http://localhost:8100"
engine_url = "http://localhost:8200"
chat_request = {
    "model": model,
    "messages": [{"role": "user", "content": "What is 17 * 23?"}],
    "max_tokens": 2048,
    "stream": True,
}

with httpx.Client(timeout=60.0) as client:
    generate_request = client.post(
        f"{render_url}/v1/chat/completions/render", json=chat_request
    ).json()
    prompt_token_ids = generate_request["token_ids"]
    stream_state = None  # для n > 1 — отдельное состояние на каждый choice

    with client.stream(
        "POST", f"{engine_url}/inference/v1/generate", json=generate_request
    ) as stream:
        for line in stream.iter_lines():
            if not line.startswith("data: ") or line == "data: [DONE]":
                continue
            derendered = client.post(
                f"{render_url}/v1/chat/completions/derender",
                json={
                    "stream": True,
                    "model": model,
                    "generate_chunk": json.loads(line[len("data: "):]),
                    "stream_state": stream_state,
                    "prompt_tokens": len(prompt_token_ids),
                    "prompt_token_ids": prompt_token_ids,
                    "chat_request": chat_request,
                },
            ).json()
            stream_state = derendered["stream_state"]
            for choice in derendered["chunk"]["choices"]:
                print(choice["delta"].get("content") or "", end="", flush=True)
Сервер render не закрепляет состояние отдельного потока за своим процессом. Следующий чанк разрешено отправить любой его реплике, потому что клиент приносит всё необходимое состояние. Это удобно для балансировки, но имеет цену: перенос повторяющегося контекста и повторная работа парсера на каждом фрагменте. Для простого преобразования токенов в текст такой маршрут существенно дешевле, чем для ответов с рассуждениями и вызовами инструментов.
StreamingКак масштабировать CPU-слой без ошибок формата
Так как /render и /derender не хранят состояние отдельного запроса между HTTP-вызовами, CPU-серверы можно размещать за обычным балансировщиком и увеличивать число реплик по их загрузке. Для потока ответственность за передачу stream_state лежит на вызывающем приложении. Благодаря этому количество CPU-серверов подбирается отдельно от количества GPU-движков.
Критически важно совпадение конфигураций: модель, токенизатор, --chat-template, --default-chat-template-kwargs, --reasoning-parser, --tool-call-parser и --enable-auto-tool-choice должны соответствовать друг другу на этапах подготовки и разбора. Если различается шаблон или парсер, система может вернуть иное разделение content, reasoning, tool_calls, чем обычный vllm serve, причём без явной ошибки. Это проблема правильности ответа, а не только производительности.
Параллельная работа CPU задаётся флагом --renderer-num-workers, значение по умолчанию — один worker. В этих работниках выполняются шаблонизация, токенизация, мультимодальная подготовка и повторный разбор истории потока. Простые 15 мс CPU на девятитысячный вход не являются мерой стоимости потокового parsing: при одновременной генерации длинных рассуждений один worker может насытиться. Число работников либо CPU-реплик нужно подбирать под реальные разобранные потоки, а не только под частоту входных запросов.
Отдельные CPU-реплики позволяют убрать парсинг с GPU-хостов, но не освобождают от мониторинга загрузки процессора, размеров запросов и соответствия шаблонов. Подробная причина дороговизны разбора потоковых ответов рассматривается ниже.
Deploying the Render TierКак собрать четыре этапа в три сервера
Два независимых разделения можно совместить. На CPU поднимают один vllm launch render, который обеспечивает /render и /derender. Два экземпляра vllm serve --tokens-only работают на разных GPU: первый создаёт KV, второй выдаёт токены. Получаются четыре логических этапа и три сервера. Для передачи кеша используют тот же NIXL: /inference/v1/generate принимает kv_transfer_params аналогично обычным маршрутам OpenAI.
# CPU, обслуживает и /render, и /derender
vllm launch render Qwen/Qwen3-0. --port 8000
  --reasoning-parser qwen3
  --enable-auto-tool-choice
  --tool-call-parser hermes

# GPU 0, только токены: prefill / производитель KV
CUDA_VISIBLE_DEVICES=0 UCX_NET_DEVICES=all VLLM_NIXL_SIDE_CHANNEL_PORT=5600
  vllm serve Qwen/Qwen3-0. --tokens-only --port 8100
  --kv-transfer-config '{"kv_connector":"NixlConnector","kv_role":"kv_producer"}'

# GPU 1, только токены: decode / потребитель KV
CUDA_VISIBLE_DEVICES=1 UCX_NET_DEVICES=all VLLM_NIXL_SIDE_CHANNEL_PORT=5601
  vllm serve Qwen/Qwen3-0. --tokens-only --port 8200
  --kv-transfer-config '{"kv_connector":"NixlConnector","kv_role":"kv_consumer"}'
В этой конфигурации уже недостаточно учебного прокси из предыдущего примера: он поддерживает /v1/completions и /v1/chat/completions, но не управляет полным четырёхшаговым tokens-only маршрутом. Приложение должно явно выполнить вызовы в нужном порядке. Текущая демонстрация vLLM даёт необходимые API, однако встроенного сквозного механизма для всей цепочки автор не описывает.
import httpx

model = "Qwen/Qwen3-0.6B"
render_url = "http://localhost:8000"
prefill_url = "http://localhost:8100"
decode_url = "http://localhost:8200"
chat_request = {
    "model": model,
    "messages": [{"role": "user", "content": "What is 17 * 23?"}],
    "max_tokens": 2048,
}

with httpx.Client(timeout=60.0) as client:
    # 1. CPU: OpenAI-запрос -> исходные token IDs
    generate_request = client.post(
        f"{render_url}/v1/chat/completions/render", json=chat_request
    ).json()

    # 2. GPU prefill: вычислить KV, удержать блоки
    prefill_response = client.post(
        f"{prefill_url}/inference/v1/generate",
        json={
            **generate_request,
            "sampling_params": {
                **generate_request["sampling_params"],
                "max_tokens": 1,
            },
            "kv_transfer_params": {"do_remote_decode": True},
        },
    ).json()

    # 3. GPU decode: получить KV по NIXL, выдать token IDs
    generate_response = client.post(
        f"{decode_url}/inference/v1/generate",
        json={
            **generate_request,
            "kv_transfer_params": prefill_response["kv_transfer_params"],
        },
    ).json()

    # 4. CPU: token IDs -> структура ответа OpenAI
    response = client.post(
        f"{render_url}/v1/chat/completions/derender",
        json={
            "model": model,
            "generate_response": generate_response,
            "prompt_tokens": len(generate_request["token_ids"]),
            "chat_request": chat_request,
        },
    ).json()

print(response["choices"][0]["message"])
Обратите внимание на порядок: render вычисляет входные токены, prefill сохраняет KV-блоки, decode забирает их и выполняет основную генерацию, derender восстанавливает ответ. Это маршрут одного запроса; настройка сервиса и нагрузочная оценка выполняются отдельно. На исходной схеме показана именно такая композиция, а не запуск всех четырёх шагов на производственном трафике.
Putting Both Splits TogetherКакие проекты берут на себя маршрутизацию
Управлять двумя GPU-пулами, размещением KV-блоков, отказами и маршрутизацией сложнее, чем запустить три учебные команды. В статье перечислены проекты, которые решают разные части этой задачи. Их полезно различать по роли, а не воспринимать как взаимозаменяемые реализации полного CPU- и GPU-конвейера.
При этом снаружи decode может быть не только vLLM, если механизм передачи кеша обеспечивает нужную совместимость; TileRT приведён как конкретный пример. Отдельные платформы закрывают оркестрацию P/D, но в изложенной версии vLLM объединённый путь /render → prefill → decode → /derender всё ещё требует явного управления со стороны вызывающего кода либо более высокого уровня инфраструктуры.
Почему потоковый разбор может стать узким местом
CPU-подготовка входа оказалась дешёвой, но обратный путь для длинных рассуждений и вызовов инструментов значительно дороже. Парсеры хранят внутреннее состояние, которое в рассматриваемой реализации нельзя сериализовать как работающий объект. Поэтому при поступлении каждого чанка /derender создаёт новый парсер и снова пропускает через него накопленную историю токенов, чтобы восстановить контекст обработки.
Автор отдельно разбирает рост стоимости. На каждый чанк передаётся история длиной O(n), повторное воспроизведение парсера требует O(n) вызовов, а некоторые реализации parse_delta, в частности для Hermes и DeepSeek-R1, повторно просматривают уже накопленный текст. Для длинной генерации такая композиция даёт описанный в статье порядок O(n³) работы с символами. Это свойство конкретного пути с потоковым парсером, а не всякой детокенизации или самой нейросети.
В отдельном измерении на reasoning-выводе длиной несколько тысяч токенов потоковый разбор через вынесенный слой расходовал приблизительно в девять раз больше CPU по сравнению с парсингом внутри процесса модели при одинаковой нагрузке. Медиана полной задержки ответа (end-to-end p50) выросла примерно на 15%. Это другой эксперимент и другие метрики, чем график p99 ITL на L40S. Для снижения повторной работы запланирован кеширующий слой (#57571), но в описанной версии оптимизация ещё не введена.
Есть и сетевые издержки. При разборе чанков клиент снова и снова отправляет полные prompt_token_ids. Для входа в 100 тысяч токенов и генерации одной тысячи токенов автор оценивает долю входа примерно в 99% тела каждого такого запроса. Простая детокенизация без парсера этой проблемы не имеет. Важно профилировать именно тот маршрут, который реально используется: на одном worker потоки с парсингом рассуждений могут насытить CPU задолго до предела обычного /render.
Какие ограничения интерфейсов ещё остаются
Часть недоработок касается не скорости, а структуры ответов. Пакетный /derender при разборе вызова инструмента не всегда выставляет finish_reason: "tool_calls"; исправление на дату публикации ожидается в #47931. Кроме того, выходной обработчик самостоятельно создаёт идентификаторы вызовов инструментов вместо сохранения тех, которые сформировал парсер. Это может быть важно потребителям, сопоставляющим разные части одного вызова.
В режиме tokens-only логарифмы вероятностей токенов (logprobs) возвращаются с текстовыми заглушками вида "token_id:N". Такой формат позволяет передавать значения, но скрывает естественный целочисленный идентификатор; предложение возвращать реальные ID обсуждается в #57574. Отдельный открытый вопрос #56851 — не стоит ли /inference/v1/generate для некоторых клиентов сразу отдавать текст или результат derender, убирая дополнительный HTTP-переход.
Развитие интерфейсов обсуждается в четырёх RFC: #42729 — пакетная детокенизация, #47161 — потоковая детокенизация, #22817 — режим «токены на входе и на выходе», #34407 — вынесенный frontend. Это планы и открытые обсуждения на дату статьи, а не описание уже завершённой реализации каждого предложенного изменения.
Для оценки зрелости связки важно держать отдельно три вещи: корректность структуры ответа OpenAI, расходы CPU на повторный парсинг и стоимость дополнительного сетевого перехода. Улучшение одной из них не гарантирует автоматического исчезновения двух остальных.
What's Still Left To Do?Как проверить архитектуру на своей нагрузке
Автор предлагает начинать с проверки связности, но не делать выводы по маленькой модели. Qwen3-0.6B удобна для первых запросов к двум экземплярам, однако её prefill почти не мешает decode, поэтому заметного эффекта от разделения ждать не стоит. После успешной передачи кеша имеет смысл использовать модель класса 7B и длинные входы, сопоставимые с теми, которые действительно дают паузы на общем GPU.
Порядок проверки таков: сначала измерить Avg xfer time и убедиться, что KV передаётся достаточно быстро. Затем запустить одинаковую нагрузку через P/D-прокси на :8192 и через совмещённый vllm serve --data-parallel-size 2 на тех же GPU. Последовательно повышать --request-rate, фиксируя TTFT, p99 ITL и goodput. В собственном замере с восьмитысячными входами резкий рост p99 ITL совмещённого сервера появлялся уже при 0,4 запроса/с.
vllm bench serve
  --model Qwen/Qwen2.5--Instruct
  --port 8192
  --dataset-name random
  --random-input-len 8192
  --random-output-len 256
  --ignore-eos
  --request-rate 0.4
  --num-prompts 100
  --percentile-metrics ttft,tpot,itl
  --metric-percentiles 50,99
  --goodput ttft:2000 tpot:30
Здесь --request-rate 0.4 — предлагаемая частота поступления запросов, а не уже достигнутый goodput. Случайный набор задаёт входы 8192 токена и выходы 256 токенов, --ignore-eos позволяет не обрывать генерацию по токену завершения. Показатели собираются отдельно: TTFT — ожидание первого токена; ITL — интервалы между токенами; TPOT — среднее время на последующий токен в запросе. Опция --metric-percentiles 50,99 задаёт нужные перцентили, а --goodput ttft:2000 tpot:30 — пороги в миллисекундах для TTFT и TPOT. Последний аргумент не задаёт порог p99 ITL.
Если повторять прогоны с одинаковым --seed, на всех сравниваемых серверах надо выставить --no-enable-prefix-caching. Иначе при очередной интенсивности часть промптов попадёт в ранее построенный кеш, их prefill станет проще и эксперимент скроет именно помехи длинного входа, которые должен измерить. Это правило чистого синтетического сравнения; в настоящем диалоге кеширование префиксов и двусторонняя передача, наоборот, могут быть необходимыми оптимизациями.
Для чатов и агентных цепочек следует отдельно проверить bidirectional_kv_xfer, сравнивая, например, пятый ход диалога с первым и проверяя совпадение токенового префикса. Для систем на Kubernetes автор рекомендует готовые средства llm-d или Dynamo вместо учебного прокси. Для моделей, которые потоково выдают рассуждения и вызовы инструментов, предварительно измеряют загрузку CPU render/derender и только затем выбирают число работников и реплик.
Итог: где разделение действительно помогает
Разделённое выполнение vLLM решает две самостоятельные задачи. Prefill можно убрать с GPU, который уже генерирует ответы другим пользователям, а подготовку запросов и разбор результатов — перенести на CPU-сервер. Вместе эти изменения образуют четыре логических этапа при трёх серверах. Такой маршрут полезен прежде всего там, где длинные входы мешают потоковой выдаче, а передача кеша достаточно быстра.
- 01
Подготовка запроса
CPU-обработчик `/render` применяет шаблон диалога, разбивает сообщения на токены и возвращает их идентификаторы.
- 02
Обработка контекста
Экземпляр prefill на GPU вычисляет KV-кеш по входным токенам и временно удерживает блоки для передачи.
- 03
Передача кеша
Приложение передаёт параметры расположения KV-блоков экземпляру decode; тот получает их через NIXL.
- 04
Генерация ответа
GPU decode использует полученный контекст и последовательно создаёт идентификаторы выходных токенов.
- 05
Сборка результата
CPU-обработчик `/derender` преобразует токены в ответ OpenAI, выделяя текст, рассуждения и вызовы инструментов.
На двух L40S с Qwen2.5-7B-Instruct, примерно восемью тысячами входных и 256 выходными токенами P/D снизил p99 ITL с 169 до 29 мс при 0,4 запроса/с и с 263 до 50 мс при 2 запросах/с. Медианы оставались близкими. Но перенос около 470 МБ KV занимал 1,3 секунды: при 0,2 запроса/с медианный TTFT вырос с 0,7 до 2,2 секунды, и двухсекундный порог для P/D не соблюдался.
Это контролируемое сравнение с DP=2, а не результат клиентского внедрения. Быстрый KV-канал, сильная контрольная конфигурация и проверка сразу TTFT, ITL и goodput определяют смысл дальнейших испытаний. Для многоходовых диалогов важно совпадение кешированного контекста с новым промптом; для потокового разбора инструментов — стоимость CPU. Внешние измерения AMD и llm-d подтверждают возможности подхода в других условиях, но не отменяют найденный автором предел собственного стенда.
Where To Start — «compare p99 ITL, TTFT and goodput.»