Сотрудник хочет найти замену офисному ПО и понять порядок закупки. Он спрашивает корпоративного ассистента, а правила лежат в разных документах, детали нужно уточнить у ответственных, следующие действия связаны с согласованиями и внутренними системами. Убедительный ответ о том, «как обычно закупают программы», ещё не решает эту задачу. Авито разбирает такую ситуацию на примере «Виталика» — корпоративного ассистента с доступом к знаниям и инструментам компании.
Разберём, как в опубликованных инженерных историях устроены выбор действий, поиск знаний, вызовы инструментов, сохранение состояния и долговременная память. Затем сравним способы проверки результата и предложим маршрут чтения без необходимости изучать все четырнадцать глав подряд. Обзор пригодится разработчикам LLM-приложений, ML-инженерам и техническим лидам, которым нужно выбирать архитектуру под конкретный рабочий процесс, а не по популярности названия технологии. Архитектуры и результаты относятся к периоду, описанному авторами; даты публикаций и оригиналы указаны в карточках разборов.
Короткий основной путь: Виталик → Genie → LinkedIn: архитектура → Anthropic: длительные задачи → HLTM → Dream. На первом проходе достаточно этих разделов; подробный порядок и ответвления будут в конце.
1. От вопроса к завершённой работе
В обычном чате результатом считается текст. В рабочем процессе важнее другое: агент должен опереться на применимые сведения, сделать разрешённые действия, вовремя привлечь человека и показать, на каком этапе находится задача. У «Виталика» путь начинается с разговора и загруженных материалов, продолжается проектом с общими знаниями и только затем может превратиться в специализированного агента с владельцем, инструментами и эталонами проверки. Поэтому полезный проект — ещё не автоматически готовый исполнитель.
Не каждой задаче нужен свободный поиск следующего шага. Если порядок известен — определить тему обращения, открыть нужную ветку, проверить ответ и передать результат — его удобнее закрепить в последовательности операций. В поддержке Яндекса есть редактируемые маршруты с классификаторами, действиями, запасными переходами и агентами внутри сценария. В Genie уточнение вопроса, выбор источников, поиск и генерация тоже следуют заранее заданному порядку, хотя некоторые шаги выполняют языковые модели. Название «агентный RAG» не превращает этот процесс в произвольное планирование.
Другой предел — работа, продолжающаяся долго после первого обращения. LinkedIn Hiring Assistant отдельно обеспечивает быстрый диалог о требованиях и фоновый поиск кандидатов. Человек утверждает важные изменения, а исполнитель может возвращаться к задаче после новых событий. Из сопоставления этих историй следует практический критерий: прежде чем выбирать агентный SDK, определить, что считается завершением, какие шаги можно доверить системе и где потребуется подтверждение человека.
2. Шесть разных значений «памяти»
Слово «память» в описаниях агентов обозначает слишком разные объекты. Вход текущего вызова модели ограничен контекстным окном; состояние задачи может жить дольше одного вызова; корпоративные документы находят через поиск, а пользовательские предпочтения получают из его прошлых взаимодействий. Даже если всё хранится в базе и затем попадает в промпт, у каждого вида сведений свой срок жизни, владелец, правило обновления и способ проверки.
Таблицу можно прокрутить по горизонтали.
В архитектуре «Виталика» отдельно названы история диалога, рабочее состояние и долговременные сведения. Для системы это не терминологическая тонкость: процесс может ждать одобрения после закрытия чата, но вовсе не должен превращать промежуточный статус заявки в «любимое предпочтение» сотрудника. И наоборот, память о прошлой работе рекрутера не заменяет текущий список кандидатов и статус проверки конкретной вакансии.
Особенно легко ошибиться с KV-cache — кешем ключей и значений внимания. Яндекс в докладе об инференсе использует повторяемость длинных запросов между шагами агентной сессии, чтобы экономить вычисления. Кеш можно разместить и разделить между исполнителями, но он не решает, переехал ли человек, какой факт устарел и кто вправе видеть документ. Это задача другого уровня системы.
3. Кто выбирает следующий шаг
Управление задачей удобно сравнивать по тому, кто определяет порядок действий. В «Виталике» PortalManager готовит конфигурацию, дерево доступных агентов, сессию и трассировку, а ADK Runner исполняет цикл: модель выбирает разрешённый инструмент, получает ответ и решает, продолжать ли. Это способ ReAct — чередование выбора и действия в установленных системой границах. Само подключение инструмента не освобождает систему от необходимости назначить ему владельца и проверить право вызова.
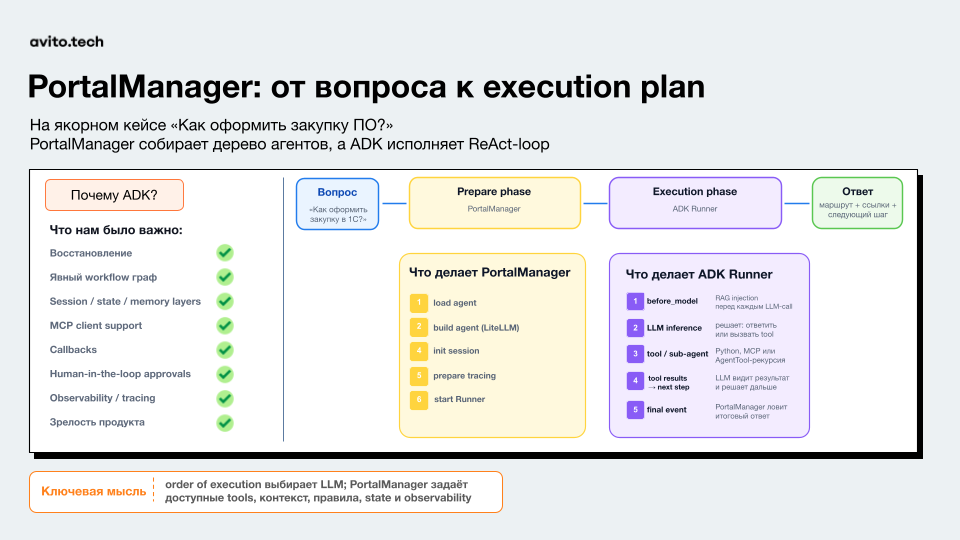
Схема «Виталика» помогает отделить подготовку состава агентов и контекста от исполнения. Настройка доступа и состояния не должна зависеть только от очередного свободного ответа модели.
Источник: Оригинальная иллюстрация · АвитоДля длинного подбора кандидатов LinkedIn применяет другой принцип: планировщик разбивает цель на подзадачи, исполнитель работает с ними и при необходимости возвращает управление для пересмотра плана. Внутри отдельной подзадачи возможен ReAct. Семь специализированных подагентов представлены инструментами центрального ведущего агента; это не семь независимых почтовых ящиков с собственными пользовательскими диалогами. Так можно отдельно контролировать полноту плана и гибкость локальных действий.
Таблицу можно прокрутить по горизонтали.
В Anthropic Research ведущий агент раздаёт независимые направления поиска, исполнители возвращают сжатые результаты, а отдельный CitationAgent помогает привязать итоговые утверждения к источникам. Параллельность оправдана, когда работу действительно можно разделить: широкому исследованию она может помочь, но короткий сценарий закупки или переход между сессиями сами по себе её не требуют. Многосессионная работа и многоагентность — разные решения.
4. Откуда берутся основания ответа
Правильная последовательность шагов бессильна, если входные сведения неверны. Инженеры Uber Genie столкнулись с таблицами политик: при извлечении из PDF значение теряло заголовок, а при разбиении текста исключение оказывалось в другом фрагменте. Поиск мог найти похожую политику, но не ту, которая применима к определённой роли или региону. Поэтому команда перешла к более структурированному получению Google Docs, обогащению таблиц и метаданным на уровне документа и фрагмента.
Здесь важно различить два времени. Заранее документ извлекают, сохраняют структуру таблицы, добавляют пояснения и готовят индекс. Во время вопроса Query Optimizer уточняет формулировку, Source Identifier выбирает вероятные документы, затем объединяются векторный поиск и поиск BM25 по словам; после удаления дублей фрагменты собирают в порядке исходного документа. Генератор получает исходный вопрос и подготовленные поисковые сведения. Не нужно заново запускать загрузчик при каждом сообщении.
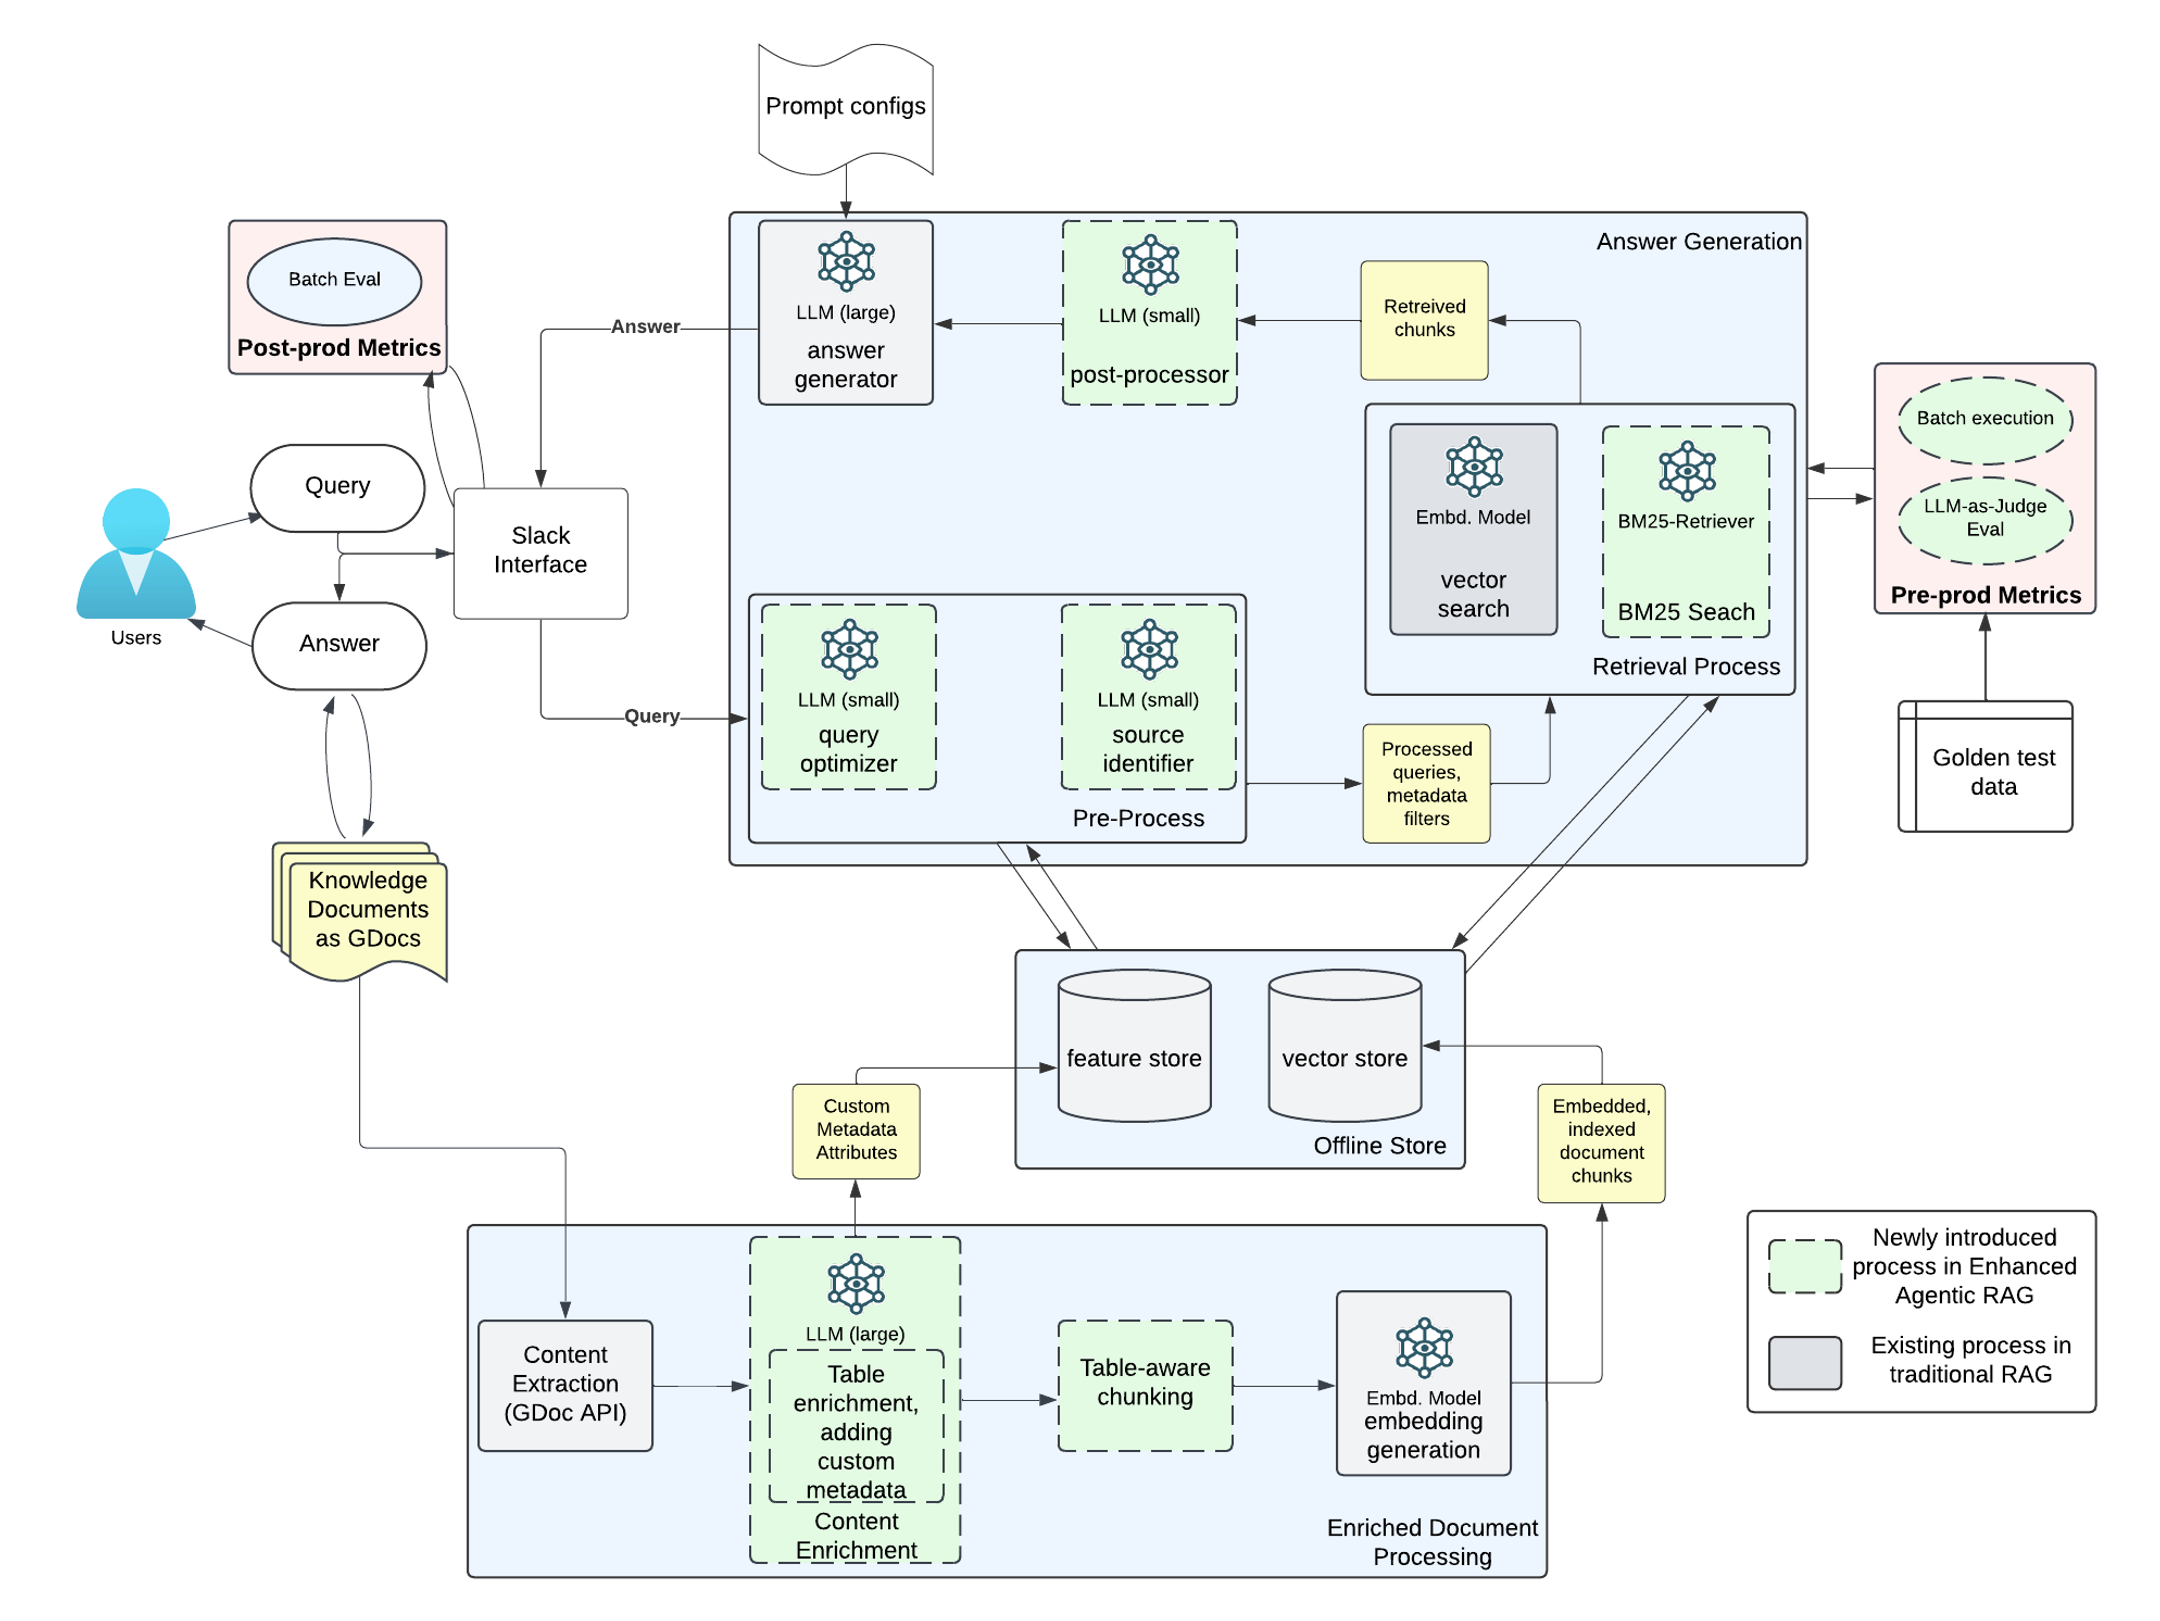
Схема Genie различает предварительное извлечение и индексирование документов, обработку запроса и пакетную оценку новых версий. Эти три работы нельзя считать одной длинной цепочкой онлайн-вызова.
Источник: Оригинальная иллюстрация · UberIntercom Fin решает более узкую проблему: уже найденные фрагменты надо поставить в полезный для ответа порядок. Команда обучила специализированный переранжировщик на оценках LLM-учителя, затем проверяла его на фиксированном наборе, воспроизведении старых разговоров и живом A/B-тесте. Воспроизведение учитывает конкретный бюджет — первые 1500 токенов контекста Fin, а не только место документа в абстрактном списке. Это пример, когда не требуется перестраивать всю агентную систему ради улучшения поиска.
Для аналитического агента OpenAI содержание источника — ещё и смысл таблиц: какие соединения допустимы, где лежит каноническое определение метрики, что менялось в коде. Система собирает шесть слоёв контекста: использование таблиц, человеческие пояснения, знания из кода, документацию, исправления и сведения, полученные непосредственно во время выполнения. Последний слой позволяет проверить текущую схему, если подготовленный индекс устарел. По этим кейсам вывод один: сперва исправлять происхождение, применимость и проверяемость контекста, а не увеличивать число рассуждающих агентов.
5. Инструменты и полномочия
Поиск отвечает на вопрос «что известно», инструмент — «какое действие разрешено выполнить». Авито выносит подключения корпоративных сервисов в MCP Hub, чтобы PortalManager не превращался в набор прямых интеграций. MCP задаёт единый способ описать доступный вызов, но не отменяет вопрос о том, кто владеет инструментом и от чьего имени действует агент.
В Uber MCP Gateway управление каталогом отделено от исполнения: реестр хранит описание и владельцев, шлюз переводит обращения к существующим API или проксирует нативные MCP-серверы. Владелец должен разрешить публикацию; перед каждым конкретным вызовом система проверяет полномочия человека, сервиса или агента. Дополнительно предусмотрены ограничения частоты и очистка чувствительных данных в ответе. Сам факт, что метод появился в каталоге, не означает, что любой сотрудник вправе им пользоваться.
Большой каталог создаёт следующую проблему: тысячи схем инструментов и длинные результаты могут занять весь контекст модели. Omni MCP раскрывает возможности по мере необходимости — сначала подходящий сервер, затем инструмент и его схему. Response Projection убирает ненужные поля уже в шлюзе, но не доказывает сокращение вычислений внутри вызываемого сервиса. В Code Mode агент-программист может сохранить большой ответ в файл и выбрать нужные строки, вместо того чтобы загрузить всё в промпт.
Есть и более простой ход: не давать модели несколько почти одинаковых способов сделать одно действие. OpenAI описывает сокращение пересекающихся инструментов после первоначальной версии. Для проектирования полезно проверить четыре вещи: понятность назначения инструмента, права вызывающего, возможность проверить и повторить действие, размер результата, возвращаемого в контекст. Максимальное число инструментов само по себе целью не является.
6. Как продолжать после паузы и сбоя
Долгая работа не должна существовать только в потоке токенов одного чата. В LinkedIn Hiring Assistant за рекрутером закреплён экземпляр агента с собственным почтовым ящиком сообщений. Платформа доставляет события и результаты независимо от одного HTTP-запроса; интерфейс получает изменения задач и промежуточные результаты. Это помогает различать «пользователь сейчас разговаривает» и «поиск кандидатов всё ещё выполняется». При возобновлении важны подтверждённые требования, оставшийся план и решения человека, а не полная стенограмма всех вызовов.
Anthropic в эксперименте с длительной разработкой показала ещё более приземлённое решение. Первый запуск готовит проверяемый список функций и состояние проекта; следующие сессии читают журнал прогресса и git, берут небольшой незавершённый участок, запускают проверку и сохраняют результат. Автоматического сжатия длинного чата оказалось недостаточно: агент мог попытаться сделать слишком много за один раз либо преждевременно решить, что проект закончен. Поэтому хранить нужно и намерение, и свидетельство реально проверенной работы.
Проверка не должна ограничиваться фактом успешной компиляции. В демонстрации Anthropic использовались сквозные браузерные сценарии, но Puppeteer MCP не показывал агенту нативные alert-окна; это оставляло слепую зону. Такая история учит проверять собственные средства контроля. Не все ошибки видны агенту, даже если он добросовестно выполняет тест.
В Anthropic Research другая нагрузка: ведущий агент распределяет поиск, получает промежуточные результаты, система сохраняет точки продолжения, повторяет допустимые операции после ошибок и записывает трассы. При выпуске новой версии применяются rainbow deployments: старая и новая конфигурации некоторое время сосуществуют, чтобы не ломать начатую работу. При этом текущая координация подагентов остаётся синхронной: самый медленный исполнитель задерживает весь раунд. Состояние и восстановление нужны даже без параллельных подагентов; усложнять архитектуру стоит после проверки реальной потребности в них.
7. Что сохранять между задачами
Допустим, рекрутер в нескольких прошлых проектах выбирал один регион и формат работы. В новом проекте это может помочь предложить исходные требования, но сами прошлые проекты нельзя заменять неоспоримым ярлыком «так он хочет всегда». Нужны источники, время и возможность исправить вывод. Здесь начинается долговременная память: не бесконечный чат, а отобранные сведения, пригодные в следующем обращении.
Athena Tia объясняет базовую разницу через Zep. Эпизодическая память сохраняет событие — что было сказано и когда; семантическая извлекает факты, сущности и отношения. Временной граф позволяет учитывать, когда система узнала о связи и когда она была действительна. Это полезный учебный пример разделения накопления и использования прошлого контекста. Но статья Athena описывает внутренний эксперимент: из четырёх возможных сочетаний включения записи и подачи памяти одно независимо не проверили из-за устройства настройки; опубликованные автором проценты не равны эффекту массового внедрения.
LinkedIn HLTM решает более структурированную задачу в Hiring Assistant. Дерево памяти следует реальной принадлежности: контракт или аккаунт, учётное место рекрутера, проект. Для каждого узла заранее создают три представления: отдельные пары «поле — значение», короткие вопросы с готовыми ответами и сводку. Информация агрегируется от проектов к владельцу, поэтому широкий вопрос о привычках не требует каждый раз заново читать десятки отдельных вакансий. При ответе три вида сведений ищутся независимо; возвращаются ссылки на узлы, из которых получен вывод.
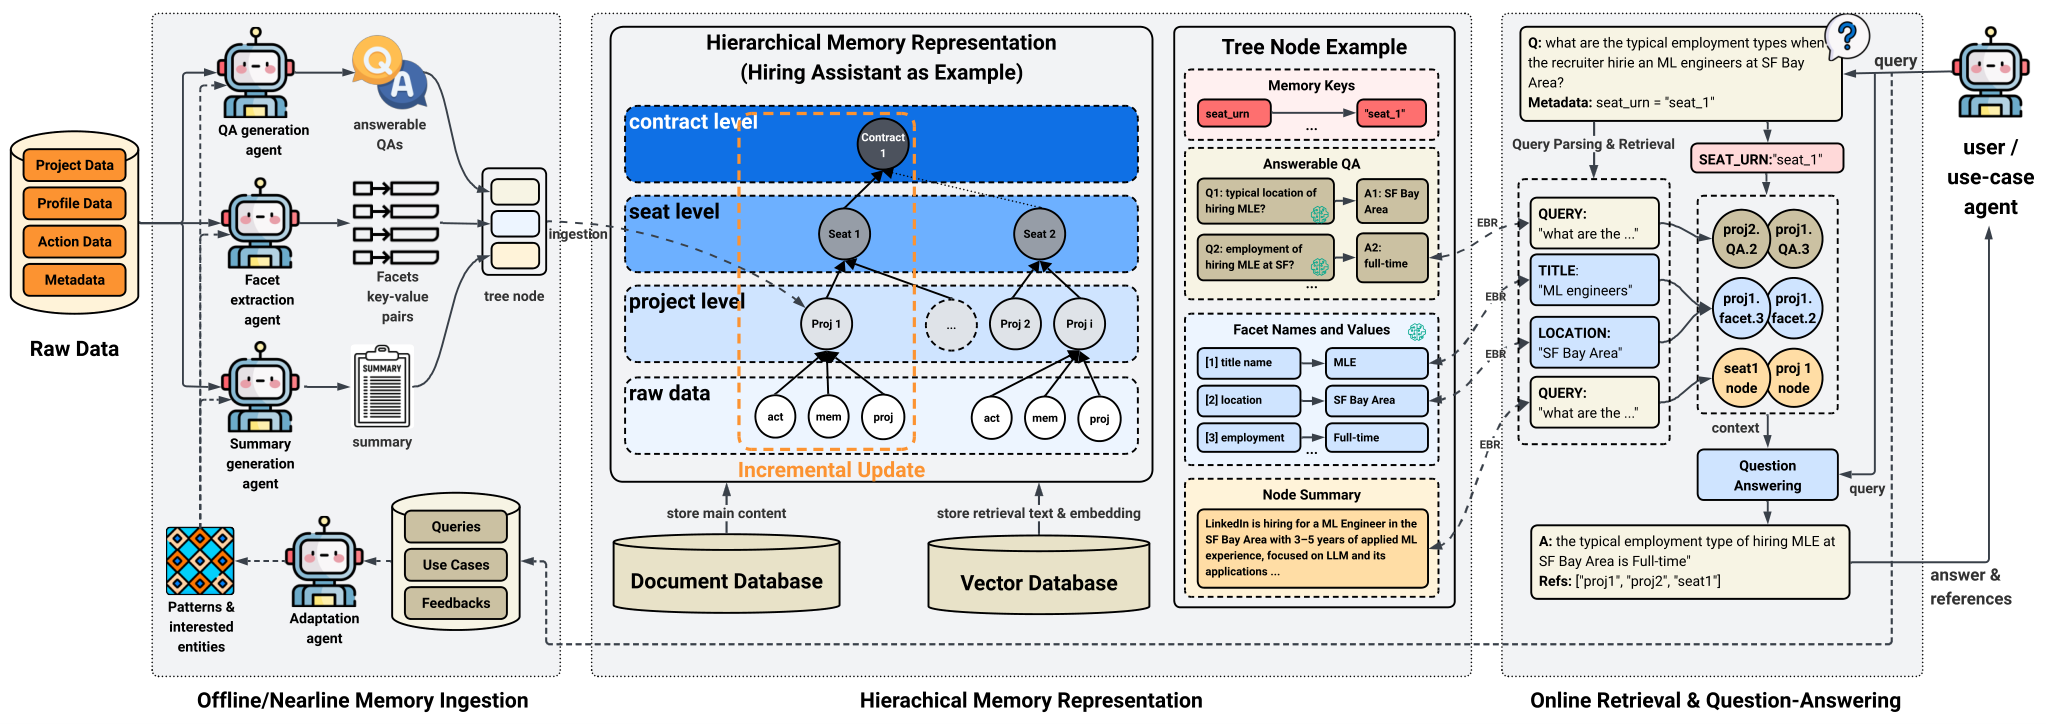
Схема HLTM разделяет предварительное построение фактов, вопросов и сводок и поиск во время диалога. Корпоративная иерархия здесь одновременно помогает обобщать проекты и ограничивать доступ.
Источник: Оригинальная иллюстрация · LinkedInOpenAI сохраняет иной тип полезной памяти — не привычку человека, а исправления аналитической логики, например требование сопоставлять строку эксперимента точно, а не приблизительно. Meta KernelEvolve пополняет библиотеку повторно используемых приёмов оптимизации по успешным траекториям поиска. Оба механизма переносят опыт в следующие задания, но это не персональный профиль. Веса основной модели от сохранения записи не обязаны меняться.
8. Как память обновляется и сохраняет границы
Память со временем портится: появляются записи об одном факте разными словами, новый адрес соседствует со старым, а разовый интерес принимают за устойчивую привычку. Поэтому надо отдельно проектировать запись, обслуживание сохранённого и чтение. При записи система видит текущую реплику и ограниченный набор старых фактов; она не может гарантировать обнаружение всех прежних противоречий. При чтении требуется решить, нужны ли актуальные сведения или вся история изменений.
Mem0 Dream различает три операции. Merge допустим, если новая запись полностью поглощает смысл прежней, а не просто тематически похожа. Supersede означает явную замену того же факта, например после переезда. Прежние версии остаются в истории: поглощённые записи по умолчанию скрыты, заменённые по умолчанию доступны, а параметры include_merged и latest_only позволяют менять видимость. Synthesize создаёт осторожное обобщение на основании нескольких независимых наблюдений и сохраняет их идентификаторы. Объединение и замещение принимаются при записи, а синтез выполняется отдельной еженедельной работой. Это описание механизма поставщика, не опубликованный независимый тест прироста качества.
При удалении недостаточно стереть первоначальную фразу, если она успела попасть в производную сводку. HLTM обновляет изменённый проект и цепочку его предков до корня, не пересчитывая соседние ветви; при удалении пересобираются затронутые родительские знания. На полном производственном наборе LinkedIn авторы две недели сравнивали полную и инкрементальную индексацию. По их оценке, работающий конвейер сократил число вызовов LLM на 80–90% относительно полной пересборки. Это экономия подготовки памяти, не ускорение одного чатового ответа.
Ещё важнее границы доступа. HLTM сначала получает идентификатор допустимого корпоративного поддерева и до смыслового поиска исключает чужие проекты из всех трёх каналов. Инструкция модели «не отвечай про чужих» не заменяет такой фильтр. В OpenAI агент наследует права пользователя на таблицы и документы; Uber MCP проверяет полномочия при вызове инструмента. Это три разные точки защиты: выбор источников, чтение данных и исполнение действия. Сведения о предпочтениях тоже должны оставаться исправляемыми и управляемыми человеком.
9. Проверки, выпуск изменений и работа сервиса
Оценивать агента одним числом «точность ответа» недостаточно. Система может найти неправильный регламент, верно назвать инструмент, но передать ему неверные параметры; корректно сгенерировать SQL, но выбрать неподходящую таблицу; оставить проект почти законченным и сообщить об успехе. Поэтому проверять полезно отдельно выбор источника, вызовы и права, фактическое состояние после действия, итог для пользователя и устойчивость работы.
Авито различает проверки вызовов функций, RAG, MCP-инструментов и доменного агента: 85% на схеме — целевой ориентир, а не достигнутый показатель. В Genie эксперты подготовили контрольные вопросы и эталоны, а модель-судья помогла проверять новые варианты пакетно. Для более чем ста вопросов о безопасности и приватности с корпусом более сорока политик авторы сообщают +27% приемлемых ответов и −60% неверных советов относительно прежнего уровня. Это относительные изменения ответов в их проверке, а не процентные пункты, онлайн A/B или экономия времени сотрудника. С недель до минут сократилась именно оценка экспериментов.
Таблицу можно прокрутить по горизонтали.
В лабораторном рекрутинговом наборе на 868 вопросах, требующих обобщения, HLTM получила долю правильных ответов 0,892 против 0,833 у HippoRAG. На остальных 473 вопросах, требующих поиска, F1 составила 0,782 против 0,617 у ReadAgent. Это разные части набора и разные системы сравнения. В продуктовых диалогах при использовании памяти наблюдали на 5–10 процентных пунктов меньше негативных оценок, но ведущий агент сам решал, когда обращаться к памяти. Не переносим лабораторные числа на интерфейс и не называем наблюдательную разницу рандомизированным эффектом. Athena и Dream полезны для понимания устройства памяти, но сила опубликованных измерений у них иная.
Эксплуатация добавляет собственные критерии. Anthropic Research описывает точки продолжения, повторы допустимых действий, трассировки и постепенный выпуск конфигураций. В поддержке Яндекса для указанной нагрузки 10 запросов в секунду названы задержки около 2 секунд по медиане и 5 секунд по P90; нужны также приоритет пользовательских запросов, запасная площадка и работа конструктора с проверкой сценария до выпуска. Инференс Яндекса показывает полезный отрицательный опыт: простое физическое разделение обработки входа и генерации ответа ухудшило пропускную способность в запросах в секунду на 34% относительно предыдущего варианта эксперимента. Разделение вычислений само по себе ещё не оптимизация.
Наконец, Meta KernelEvolve проверяет сгенерированное ядро сначала на правильность вычисления и лишь затем на ускорение. Заявленные улучшения пропускной способности отдельных моделей на конкретных устройствах нельзя приравнять к качеству разговорного агента. По этим кейсам хороший выпуск требует измерений под свою задачу: допустимость, завершение, задержка, стоимость, сбои и возможность отката, а не сравнение чужих процентов из несовместимых экспериментов.
10. Маршрут чтения под свою задачу
Основной маршрут специально короткий. На первом проходе достаточно указанных разделов: каждый добавляет одну способность, которой не хватало предыдущему типу решения. Полные главы стоит открывать позже, когда соответствующая инженерная задача появилась в собственном проекте.
- 1. «Виталик»: путь от чата к агенту. Разобраться, что делает проект долговечным, зачем нужен владелец процесса; затем разделить PortalManager и Runner и посмотреть проверки по слоям. После этого понятно, к чему подключаются знания и инструменты.
- 2. Genie: почему ошибка возникает до поиска. Прочитать сохранение таблиц и выбор источников. Важно уметь назвать две отдельные причины плохого ответа: испорченный документ и неподходящая политика.
- 3. LinkedIn: планирование и исполнение. Связать сообщения экземпляра агента с событиями интерфейса и согласованием изменений. Увидеть, почему состояние длительной работы не помещается в одну реплику.
- 4. Anthropic harness: список проверяемых функций. Перейти к запуску следующей сессии и сквозной проверке. Понять, что именно должен оставить предыдущий исполнитель, чтобы следующий не гадал о готовности.
- 5. LinkedIn HLTM: память по владельцам. Прочитать три формы записи, границу доступа и обновление ветвей. Это переход от сохранения задачи к сохранению знаний для следующей задачи.
- 6. Mem0 Dream: поддержание порядка. Уточнить видимость истории и условия фоновой работы. Главное — не превращать похожесть в ложное слияние и не стирать сведения, необходимые для истории.
Если интересует именно память, начните с Athena: запись и подача памяти, затем прочтите HLTM о правах и обобщениях и Dream о конфликтах и истории. В качестве расширения — память исправлений OpenAI и навыки Meta: они показывают, что повторно используемый опыт не обязательно является фактом о человеке.
Если вы отвечаете за эксплуатацию, после harness переходите к Uber MCP: реестр, владельцы и разрешения, Anthropic Research: восстановление и версии, OpenAI: проверки вычислений и Яндекс AgentOps: создание и выпуск сценариев. Читайте их выборочно: проблемы авторизации, долгой задачи, SQL или нагрузки требуют разных инструментов.
Если узкое место — RAG, после Genie откройте FinRank, воспроизведение разговоров и A/B-тест. Если узкое место — вычислительная цена, дополнительно нужны кеширование агентных сессий Яндекса и оптимизация ядер Meta. Это факультативные ветки, не части одного общего агентного продукта.
Заключение
Разборы объединяет не единая модная архитектура, а необходимость довести задачу до проверяемого результата. Рабочий помощник должен понимать, какие сведения применимы, кто разрешил действие, что уже выполнено и какой прошлый опыт действительно относится к новой ситуации. Это видно на разных задачах: закупке, вопросах о правилах, подборе кандидатов, поиске сведений и оптимизации кода. Ниже — учебное обобщение цикла, а не схема какой-либо одной компании.
- 01
Определить цель и границы
Получить вопрос и разрешённый рабочий контекст, уточнить критерий завершения и решения, которые остаются за человеком.
- 02
Восстановить состояние
Найти текущий план, выполненные шаги и ранее утверждённые решения; при необходимости извлечь разрешённые долговременные сведения.
- 03
Получить основания
Поискать подходящие документы и факты, проверить источник, актуальность, принадлежность и допустимость данных.
- 04
Выбрать и выполнить действия
По фиксированному маршруту или управляемому плану вызвать разрешённые инструменты, записать результаты и предусмотреть паузу, ошибку или согласование.
- 05
Проверить и завершить
Оценить результат действия и конечное состояние, показать доказательства, оставить пригодный для продолжения журнал и вернуть управление пользователю.
Подготовка поискового индекса, обучение моделей и фоновый синтез обобщений — отдельные процессы. Во время обращения агент извлекает уже подготовленные сведения; новые факты могут попадать в память при записи, как в Dream, без полного переобучения или пересборки. Получение памяти для ответа и обслуживание её содержимого решают разные задачи. Выбор между фиксированным процессом, одним агентом с инструментами и несколькими параллельными исполнителями определяется сложностью задачи и ценой ошибок. Результаты опубликованных глав разнородны: от инженерных демонстраций и механизмов поставщика до лабораторных сравнений и продуктовых измерений; одинаковой точности или выигрыша в другом сервисе они не обещают. Для начала хватит шести глав основного маршрута. Дальше стоит выбрать одну ветку — память, эксплуатацию, качество RAG или вычислительную стоимость — и проверять решения на своих сценариях.
Первоисточники
Обзор собран по опубликованным разборам. Подробности измерений, исходные иллюстрации и ссылки на разделы находятся в соответствующих главах.
- От LLM-портала до фабрики внутренних агентов: как в Авито строят корпоративного ассистента «Виталик»
- Enhanced Agentic-RAG: What If Chatbots Could Deliver Near-Human Precision?
- Building the agentic future of recruiting: how we engineered LinkedIn’s Hiring Assistant
- Effective harnesses for long-running agents
- Hierarchical Long-Term Semantic Memory for LinkedIn’s Hiring Agent
- Dream: Background memory consolidation for AI agents
- Enhancing Athena Agents with Persistent Memory — A Case Study
- Designing MCP Gateway: Uber’s MCP Management Platform
- How we built our multi-agent research system
- Inside our in-house data agent
- AgentOps в продакшене: инфраструктура для LLM-агентов и автоматизация поддержки
- How We Built a World-Class Reranker for Fin
- KernelEvolve: How Meta’s Ranking Engineer Agent Optimizes AI Infrastructure
- Строим экономически эффективный инференс LLM для агентских (и не только) сценариев