Разбор готов
Intercom: как Fin построил собственную модель переранжирования
Когда человек обращается в поддержку через Fin AI Agent от Intercom, система ищет подходящие статьи базы знаний и использует их, чтобы составить ответ. Быстрый поиск по векторным представлениям текста находит похожие фрагменты, но не всегда правильно различает их смысл: найденный материал ещё нужно оценить относительно конкретного вопроса. Раньше порядок результатов уточняла коммерческая модель Cohere Rerank-v3.5. Она обеспечивала хорошее качество, однако обходилась дорого. В статье от 11 сентября 2025 года инженер Intercom рассказывает, как команда построила собственный переранжировщик на ModernBERT, обучила его на оценках LLM и последовательно проверила качество на внутреннем наборе запросов, исторических разговорах и в живом A/B-тесте.
Разбор полезен ML-инженерам и разработчикам RAG-систем, которые выбирают между внешним сервисом переранжирования и собственной моделью. Особенно интересны устройство модели, обучение на метках LLM, проверка при ограниченном бюджете контекста и связь офлайн-метрик с реальными решениями обращений.
Статья · на английском
How We Built a World-Class Reranker for FinRamil Yarullin · Опубликовано: 11 сентября 2025 г.
Как вопрос превращается в ответ Fin
Человек пишет Fin, например спрашивает, как восстановить пароль или где найти счета. Сначала Fin сводит содержание разговора к короткому поисковому запросу. Эта формулировка нужна, чтобы искать материалы в базе знаний, а не сопоставлять с документами весь разговор целиком.
Статьи справки и небольшие фрагменты текста заранее преобразуют в числовые векторы — эмбеддинги. Поисковый компонент строит вектор нового запроса и сравнивает его с сохранёнными векторами. Такая операция помогает быстро найти близкие по содержанию документы, но близость векторов не всегда передаёт нюанс вопроса: среди похожих фрагментов один может отвечать по существу, а другой лишь упоминать те же слова.
Поэтому следующий этап получает 40 лучших кандидатов из векторного поиска. Переранжирование означает, что более внимательная модель заново оценивает соответствие каждого из этих фрагментов вопросу и переставляет их в порядке полезности. После этого фильтр бюджета контекста оставляет материалы, которые помещаются во входную часть генерации ответа; Fin опирается на них при составлении сообщения пользователю.
На оригинальной схеме показан путь от вопроса к векторному поиску, затем к переранжировщику, упорядоченным фрагментам и генерации ответа. Пример со сбросом пароля иллюстрирует использование материалов базы знаний. Индекс на схеме подготовлен заранее: его построение не запускается заново при каждом пользовательском вопросе.
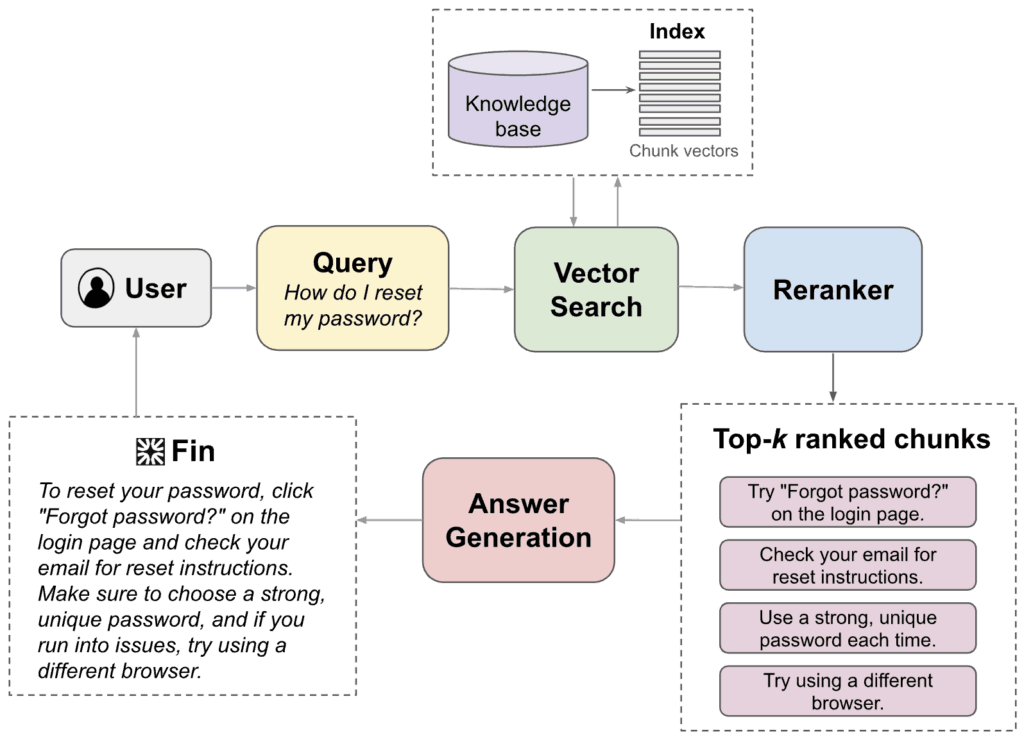
Путь вопроса в Fin: поиск по базе знаний, повторное ранжирование фрагментов и подготовка ответа.
Источник: Оригинальная иллюстрация · IntercomПочему команда отказалась от прежних вариантов
На этапе повторного ранжирования Intercom использовала Cohere Rerank-v3.5. Эта коммерческая модель обеспечивала хорошее качество, но стоимость её вызовов стала существенной. Для Fin было важно сохранить точность выбора источников, поскольку именно они влияют на содержание ответа пользователю.
Команда уже проверяла открытые модели BGE-large и BGE-m3. По оценке авторов, они не достигли необходимого уровня качества. Другой вариант — поручить ранжирование большой языковой модели (LLM), способной подробно сопоставлять вопрос с документами. При непосредственном использовании такого переранжировщика возникали проблемы с задержкой ответа. Статья не приводит отдельной таблицы этих экспериментов, поэтому их результат — именно описанные авторами причины отказа от вариантов.
Так сформировались требования к собственной модели: не уступать Cohere по качеству, достаточно быстро работать на обычных GPU и позволять команде самостоятельно изменять компонент. Область задачи намеренно сузили до поддержки клиентов на английском языке. Такая специализация важна: модели предстояло различать типовые для Fin вопросы и фрагменты справки, а не одинаково хорошо ранжировать любые тексты на всех языках.
Why Build Our Own Reranker?Как Fin-cx-reranker оценивает вопрос и фрагмент
Основой Fin-cx-reranker стал ModernBERT-large — трансформер-кодировщик, который строит числовые представления токенов с учётом соседнего текста. Токен — часть текста, полученная при разбиении входа для модели. В отличие от генератора, который последовательно пишет ответ, этот кодировщик обрабатывает поданный текст и отдаёт набор представлений, пригодных для дальнейшей оценки.
В статье перечислены свойства исходного ModernBERT 2024 года: поддержка контекста длиной до 8192 токенов вместо 512 у классического BERT, относительное и вращательное кодирование позиции, активации GeGLU и более экономные механизмы внимания. Автор также упоминает предварительное обучение примерно на 2 трлн токенов и преимущество ModernBERT над BERT, RoBERTa и DeBERTaV3 на задачах BEIR и GLUE в 3–8 процентных пунктов. Это характеристики и результаты базового семейства моделей, а не измеренный прирост самого Fin-cx-reranker относительно Cohere.
Для оценки одного кандидата модель получает последовательность [CLS] {query} [SEP] {passage[i]} [SEP]. Здесь query — короткий поисковый запрос, passage[i] — i-й фрагмент базы знаний, а специальные токены [CLS] и [SEP] обозначают начало и границы частей входа. Вопрос и фрагмент проходят через ModernBERT совместно. Благодаря этому представление каждого токена может учитывать обе части текста; модель сравнивает их содержательнее, чем простым вычислением близости двух заранее готовых векторов.
ModernBERT выдаёт вектор для каждого токена. Из этих векторов берут среднее, исключив позиции дополнения (padding), добавленные для выравнивания длины. Такой способ называется mean pooling. Полученный общий вектор проходит через линейный слой, который выдаёт одно число — оценку релевантности sᵢ. Оценки сорока пар позволяют отсортировать кандидатов. На оригинальной иллюстрации отдельно показаны последовательность с [CLS] и [SEP], ModernBERT, скрытые представления с подписью H = 1024 и переход к одному итоговому числу. Именно совместная обработка запроса и документа отличает этот этап от исходного векторного поиска.
Такое подробное сравнение выполняется лишь для уже отобранных кандидатов. Векторный поиск решает задачу быстрого сужения большого набора материалов, а Fin-cx-reranker решает следующую — выбрать лучший порядок внутри небольшого списка. Базу знаний при этом не нужно заново кодировать ModernBERT при каждом обращении.
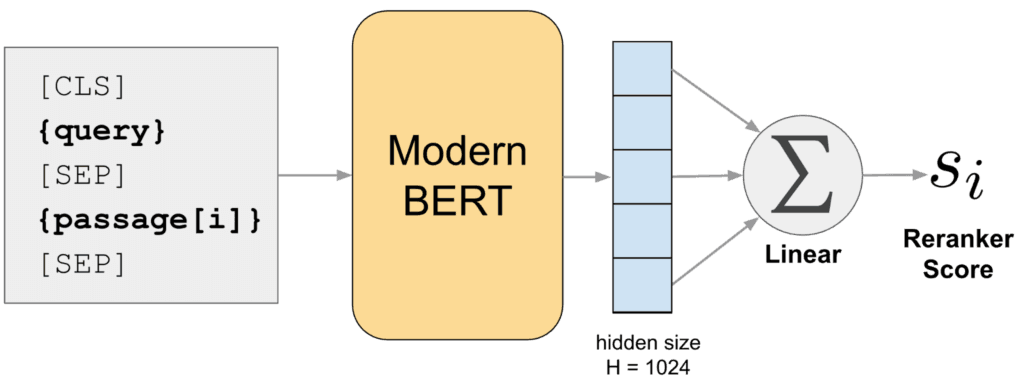
ModernBERT получает вопрос вместе с фрагментом документа; усреднение представлений и линейный слой дают оценку релевантности.
Источник: Оригинальная иллюстрация · IntercomНа каких данных и чьих оценках обучали модель
Для обучения Intercom собрала 400 000 реальных запросов Fin. Каждому запросу соответствовало 40 фрагментов-кандидатов, то есть в сумме получилось 16 млн пар «запрос — фрагмент». Эти пары относятся к обучению переранжировщика; позже автор описывает отдельные выборки для проверки качества.
Чтобы объяснить новой модели, какие фрагменты полезнее, команда применяла переранжировщик на основе LLM, оценивающий отдельные пары «запрос — фрагмент» (pointwise). По этим оценкам учитель выстраивал кандидатов от наиболее релевантного к наименее релевантному. Так у каждого фрагмента появлялось место в списке: первое место означает наибольшую релевантность по мнению учителя.
Такое обучение переносит в специализированный энкодер порядок, который задаёт более дорогая языковая модель. Учитель нужен при подготовке разметки, а во время ответа пользователю работают ModernBERT и простой выходной слой. Для реализации обучения команда использовала библиотеку Hugging Face Transformers.
Важно различать две роли LLM в этой истории. Здесь LLM служит источником обучающих меток. Позднее, при внутренней офлайн-оценке, применяется отдельная процедура построения эталонного порядка — двухэтапный LLM-оракул с дополнительным учётом подтверждённых решений обращений. Эти две процедуры нельзя считать одной и той же разметкой.
Training DetailsПочему модель учится сравнивать фрагменты попарно
Модель должна научиться не просто выдавать большие или маленькие числа, а ставить более полезный фрагмент выше менее полезного. Поэтому Intercom выбрала RankNet — функцию потерь для обучения порядку объектов по парам. Для каждого запроса LLM-учитель задаёт ранг rᵢ фрагмента i: чем меньше rᵢ, тем выше он стоит. Сам переранжировщик предсказывает численную оценку sᵢ, и у хорошей пары она должна быть выше у фрагмента с лучшим рангом.
В опубликованной формуле перебираются кандидаты i и j. Если учитель считает i лучше j, то есть rᵢ < rⱼ, функция потерь увеличивается, когда оценка sⱼ приближается к sᵢ или превосходит её. Минимизируя сумму таких штрафов, модель учится сохранять заданный учителем относительный порядок. Числовое значение ранга не обязательно должно совпадать с оценкой модели.
Функция потерь из статьи в её общей записи: K — число кандидатов; rᵢ — место у учителя; sᵢ — оценка модели. Индикатор равен единице только для пары, в которой учитель ставит i выше j.
Представим два найденных фрагмента о восстановлении пароля. Учитель поставил инструкцию с нужным действием выше общего текста о входе в аккаунт. Если обучаемая модель дала общей статье большую оценку, штраф RankNet возрастёт. Если инструкция получает более высокий балл, штраф уменьшается. Это пример того, как действует функция потерь; в статье он не приводится как отдельный эксперимент.
График из статьи показывает ход обучения: сначала функция потерь заметно снижается, затем убывает медленнее и колеблется около более низкого уровня. Горизонтальная ось не подписана единицами, поэтому нельзя приписывать отметкам на ней конкретное число эпох или запросов. Снижение обучающей ошибки говорит о лучшем воспроизведении предпочтений учителя; улучшение реальных ответов команда проверяла отдельно.
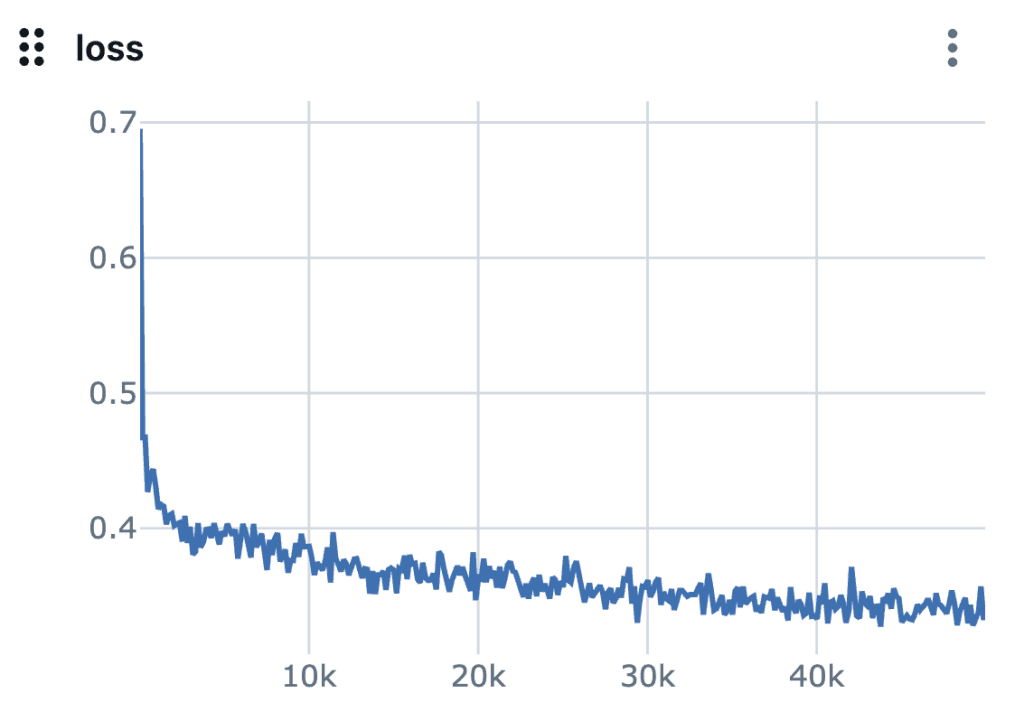
Кривая функции потерь RankNet при обучении. Снижение ошибки обучения само по себе не показывает эффект на пользовательских ответах.
Источник: Оригинальная иллюстрация · IntercomПервая проверка: внутренний бенчмарк FinRank-en-v1
Intercom проверяла результат последовательно: сначала на фиксированном наборе запросов, затем при воспроизведении исторических разговоров и, наконец, в A/B-тесте на живом трафике. На первом этапе нужен был общий эталон, по которому можно сопоставить порядок фрагментов у нового переранжировщика и Cohere Rerank-v3.5.
Для FinRank-en-v1 собрали 3000 реальных англоязычных запросов более чем из 1000 клиентских приложений, с 40 кандидатами на каждый запрос. Эталонное ранжирование получали от двухэтапного LLM-оракула. Для вопросов с подтверждённым решением проблемы — hard resolution — фрагменты, на которые ссылался Fin, перемещали вверх эталонного списка. Таким образом эталон объединял оценку LLM и дополнительный сигнал из состоявшихся обращений.
Использовались четыре метрики. MAP показывает, насколько высоко в среднем оказываются релевантные фрагменты; NDCG@10 сильнее учитывает порядок и ценность верхних десяти позиций; Recall@10 измеряет полноту попадания релевантных материалов в первые десять результатов. Kendall tau характеризует согласованность двух порядков. Все четыре оценивают качество ранжирования относительно этого внутреннего эталона.
Таблицу можно прокрутить по горизонтали.
Собственная модель оказалась лучше Cohere по всем четырём опубликованным метрикам. Особенно важно, что сравнивались одни и те же запросы и кандидаты, поэтому разница относится к изменению порядка фрагментов. Однако такая оценка сама по себе ещё не показывает, какие материалы фактически попадут в ограниченный контекст Fin и станет ли больше успешно завершённых разговоров.
FinRank-en-v1: Offline internal benchmark:Вторая проверка: что попадает в контекст реального разговора
Следующий этап приблизил проверку к работе Fin. Команда выбрала 1500 недавних разговоров поддержки из 685 клиентских приложений и воспроизвела их через зафиксированную версию RAG-конвейера (frozen RAG pipeline). При таком сравнении остальные части обработки остаются одинаковыми: можно оценить, как новый порядок найденных материалов влияет на набор источников, который увидит генератор ответа.
В Fin важна не только позиция фрагмента в списке, но и ограничение размера входного контекста. Поэтому здесь считали точность (precision) и полноту (recall) процитированных фрагментов, попавших в первые 1500 токенов доступного Fin контекста. Обозначение @1500 tok указывает именно на бюджет токенов, а не на число документов. Авторы также использовали эту проверку, чтобы оценить перенос качества на приложения вне обучающего распределения.
Таблицу можно прокрутить по горизонтали.
В этом испытании обе метрики у Fin-cx-reranker выше. Для инженера такой результат дополняет таблицу FinRank: улучшение порядка не остаётся только абстрактным совпадением с эталоном, а помогает наполнить ограниченный контекст нужными источниками. При этом речь идёт о воспроизведении уже состоявшихся разговоров, поэтому окончательный эффект на решение проблем клиентов нужно было измерить в живом продукте.
Backtesting production conversationsТретья проверка: Resolution Rate на живом трафике
Последним этапом стал двухвариантный A/B-тест, охвативший 1,5 млн реальных разговоров. В одном варианте использовался прежний Cohere Rerank-v3.5, в другом — Fin-cx-reranker. Такой эксперимент показывает последствия замены переранжировщика для пользователей, а не только согласованность его оценок с заранее подготовленной разметкой.
Основной опубликованный вывод связан с Resolution Rate — долей обращений, в которых удалось решить вопрос клиента. По заявлению Intercom, новый переранжировщик дал статистически значимое улучшение этой метрики при p < 0.01. Точная величина прироста не раскрыта по конкурентным причинам. Поэтому из размера выборки нельзя вычислить ни процент дополнительно решённых разговоров, ни абсолютное число таких обращений.
Задержка, по результатам авторов, не изменилась; для неё указана медиана P50 около 150 мс. Это характеристика приведённого сравнения, а не обещание неизменности всех процентилей задержки при любой нагрузке. Получился важный для команды результат: более релевантные материалы для ответов Fin при сохранении указанного уровня скорости.
Границы опубликованной оценки стоит помнить вместе с результатами. Эталон FinRank создан с участием LLM и сигналов подтверждённого решения; в бэктесте не расшифровано значение величин после знака «±»; онлайн-эксперимент сообщает направление и статистическую значимость улучшения Resolution Rate, но не его размер. Эти ограничения не отменяют трёх проверок, а показывают, какие именно выводы подтверждены каждой из них.
Online A/B testing:Экономия на переранжировании и следующие изменения
После внедрения собственного Fin-cx-reranker Intercom сообщила о снижении расходов на переранжирование на 80%. Здесь существенно название компонента: речь идёт о стоимости повторной сортировки найденных фрагментов. Весь RAG-конвейер продолжает выполнять поиск по векторам, фильтрацию контекста и генерацию ответа; уменьшение расходов на один из этапов не означает аналогичной экономии на всём Fin.
Кроме затрат, команда получила больше свободы менять модель под свои задачи и сократила зависимость от внешнего сервиса. На момент публикации сравнение проводилось с Cohere Rerank-v3.5, а результат относился прежде всего к английской клиентской поддержке — области, для которой обучали собственный переранжировщик.
Дальше автор описывает два уже начатых направления работы: повторную разметку обучающих примеров с помощью более сильных моделей, чтобы улучшить качество учительских меток, и расширение переранжировщика на языки помимо английского. Это планы развития, а не опубликованные результаты новых экспериментов. Основной урок кейса — полезность специализированной модели, которую оценивают по всей цепочке от порядка документов до успешного ответа пользователю.
What’s NextИтог: путь запроса и что доказали эксперименты
В Fin собственный переранжировщик заменил коммерческую модель на одном участке RAG-системы. Задача осталась прежней: из найденных материалов базы знаний выбрать те, которые помогут ответить на конкретное обращение. Для этого Intercom обучила ModernBERT на оценках LLM-учителя и проверила, как изменение порядка источников отражается на работе продукта.
- 01
Формулировка запроса
Fin сводит разговор с клиентом к короткому вопросу, подходящему для поиска по базе знаний.
- 02
Быстрый поиск
Запрос превращается в вектор; среди заранее рассчитанных векторов фрагментов система находит 40 кандидатов.
- 03
Повторное ранжирование
Fin-cx-reranker совместно читает вопрос и каждый фрагмент, усредняет представления токенов и присваивает оценку релевантности.
- 04
Отбор контекста
Кандидатов сортируют по оценке; фильтр оставляет подходящие фрагменты в пределах доступного бюджета токенов.
- 05
Ответ клиенту
Fin генерирует ответ с опорой на отобранные материалы и отправляет его пользователю.
Обучение и подготовка поискового индекса происходят отдельно от этого пути. Качество проверяли тремя способами: на внутреннем FinRank-en-v1, при воспроизведении 1500 разговоров и в A/B-тесте на 1,5 млн реальных разговоров. В офлайн-сравнении новая модель опередила Cohere Rerank-v3.5 по всем четырём опубликованным метрикам; онлайн Intercom получила статистически значимый рост Resolution Rate без изменения заявленной медианной задержки около 150 мс.
Расходы на само переранжирование, по данным компании, снизились на 80%. Размер прироста Resolution Rate не опубликован, а работа с другими языками и более сильной разметкой оставалась следующей задачей. Этот кейс показывает, как улучшение одного небольшого этапа поиска проверять по качеству источников и реальному исходу обращения.
What’s Next