Разбор готов
Uber — Genie: как улучшили ответы внутреннего помощника с помощью EAg-RAG
Инженер Uber задаёт вопрос во внутреннем Slack: какое правило хранения или передачи данных действует в его ситуации? Помощник Genie должен быстро найти ответ во внутренних документах и указать источник. Но похожие политики различаются по роли сотрудника и региону, а сложные таблицы при извлечении из PDF теряют заголовки и исключения. Поэтому обычный поиск похожих фрагментов приводил к неполным и неверным советам. В статье от 29 мая 2025 года команда Uber показывает, как перестроила подготовку документов, добавила уточнение вопроса, выбор источников и два вида поиска, а затем ускорила проверку качества ответов. Разбор последовательно объясняет устройство этой системы, её оценку и ограничения.
Полезно инженерам, которые строят поиск по внутренним документам, корпоративных помощников и RAG для областей с точными правилами и исключениями. Особенно важны сохранение структуры таблиц, разделение подготовки документов и обработки запроса, выбор применимой политики, а также проверка ответов экспертами и LLM-as-Judge.
Статья · на английском
Enhanced Agentic-RAG: What If Chatbots Could Deliver Near-Human Precision?Arnab Chakraborty, Christopher Settles, Adi Raghavendra и соавторы · Опубликовано: 29 мая 2025 г.
Genie: когда дежурному нужен точный ответ, а не похожий текст
Genie — внутренний помощник Uber: сотрудники задают вопросы в Slack, а он ищет ответы в корпоративных документах и сопровождает их ссылками на источники. По описанию авторов, Genie помогает обрабатывать тысячи обращений в разных каналах поддержки и сокращает число типовых вопросов, которые приходится разбирать дежурным инженерам и профильным экспертам.
Платформа Genie уже позволяла доменным командам настроить собственного бота за ночь: подключить инженерную wiki, PDF-документы из Terrablob, Google Docs и другие материалы, настроить загрузку, обработку, хранение векторов, поиск и генерацию. Тем не менее удобство запуска ещё не означало, что ответ безопасно использовать как совет по инженерной безопасности или защите данных.
Эксперты Uber по безопасности и приватности (subject matter experts, SME) собрали контрольный набор более чем из 100 вопросов на основе обращений инженеров. К Genie подключили свыше 40 PDF-документов с внутренними правилами и проверили ответы на этих вопросах. Эксперты обнаружили пропуски, неточности и случаи, когда система не извлекала нужную деталь. По их оценке, качества было недостаточно для расширения бота на все соответствующие каналы Slack.
Проверка выявила две причины слабых ответов: при загрузке терялись важные детали документов, а поиск не всегда выбирал применимое правило. Сначала команда занялась качеством исходных материалов.
IntroductionПочему обычного RAG оказалось недостаточно и где проходит граница двух контуров
Поиск с последующей генерацией ответа — RAG (Retrieval-Augmented Generation) — устроен так: документы заранее разбивают на фрагменты и представляют числовыми векторами; по запросу находят близкие фрагменты; языковая модель отвечает с опорой на найденный текст. Такой способ позволяет использовать внутренние документы без необходимости помещать их целиком в каждый запрос к модели. Но он зависит от того, что смысл документа сохранился при обработке и поиск нашёл именно нужное правило.
В запросах по внутренним политикам не хватает одного совпадения по теме. Пользователь может не уточнить территорию, категорию данных или свою роль; в похожих документах могут действовать разные исключения. Если поиск приносит близкий по словам, но неприменимый фрагмент, даже хорошо сформулированная инструкция к генерации не устраняет ошибку исходных сведений.
Авторы назвали расширенную архитектуру EAg-RAG — Enhanced Agentic RAG. На исходной схеме (рисунок 1) два самостоятельных участка работы. Снизу — подготовка и обогащение документации заранее; сверху — последовательность операций при поступлении сообщения из Slack. Между ними два вида хранилищ: векторное для фрагментов и хранилище заранее вычисленных сведений о документах. Пакетная оценка качества изображена отдельно от выдачи ответа сотруднику.
На рисунке 1 зелёным выделены новые этапы: обогащение таблиц и метаданных, разбиение с учётом структуры, уточнение запроса, выбор документов, BM25 и подготовка найденного контекста. Серые блоки показывают этапы традиционного RAG. Для уточнения запроса, выбора документов и постобработки схема использует небольшие LLM; для обогащения таблиц и генерации ответа — крупные.
Агенты здесь выполняют определённые действия: уточняют вопрос, выбирают подходящие документы и приводят найденные фрагменты в порядок. Эти шаги образуют последовательную схему обработки обращения.
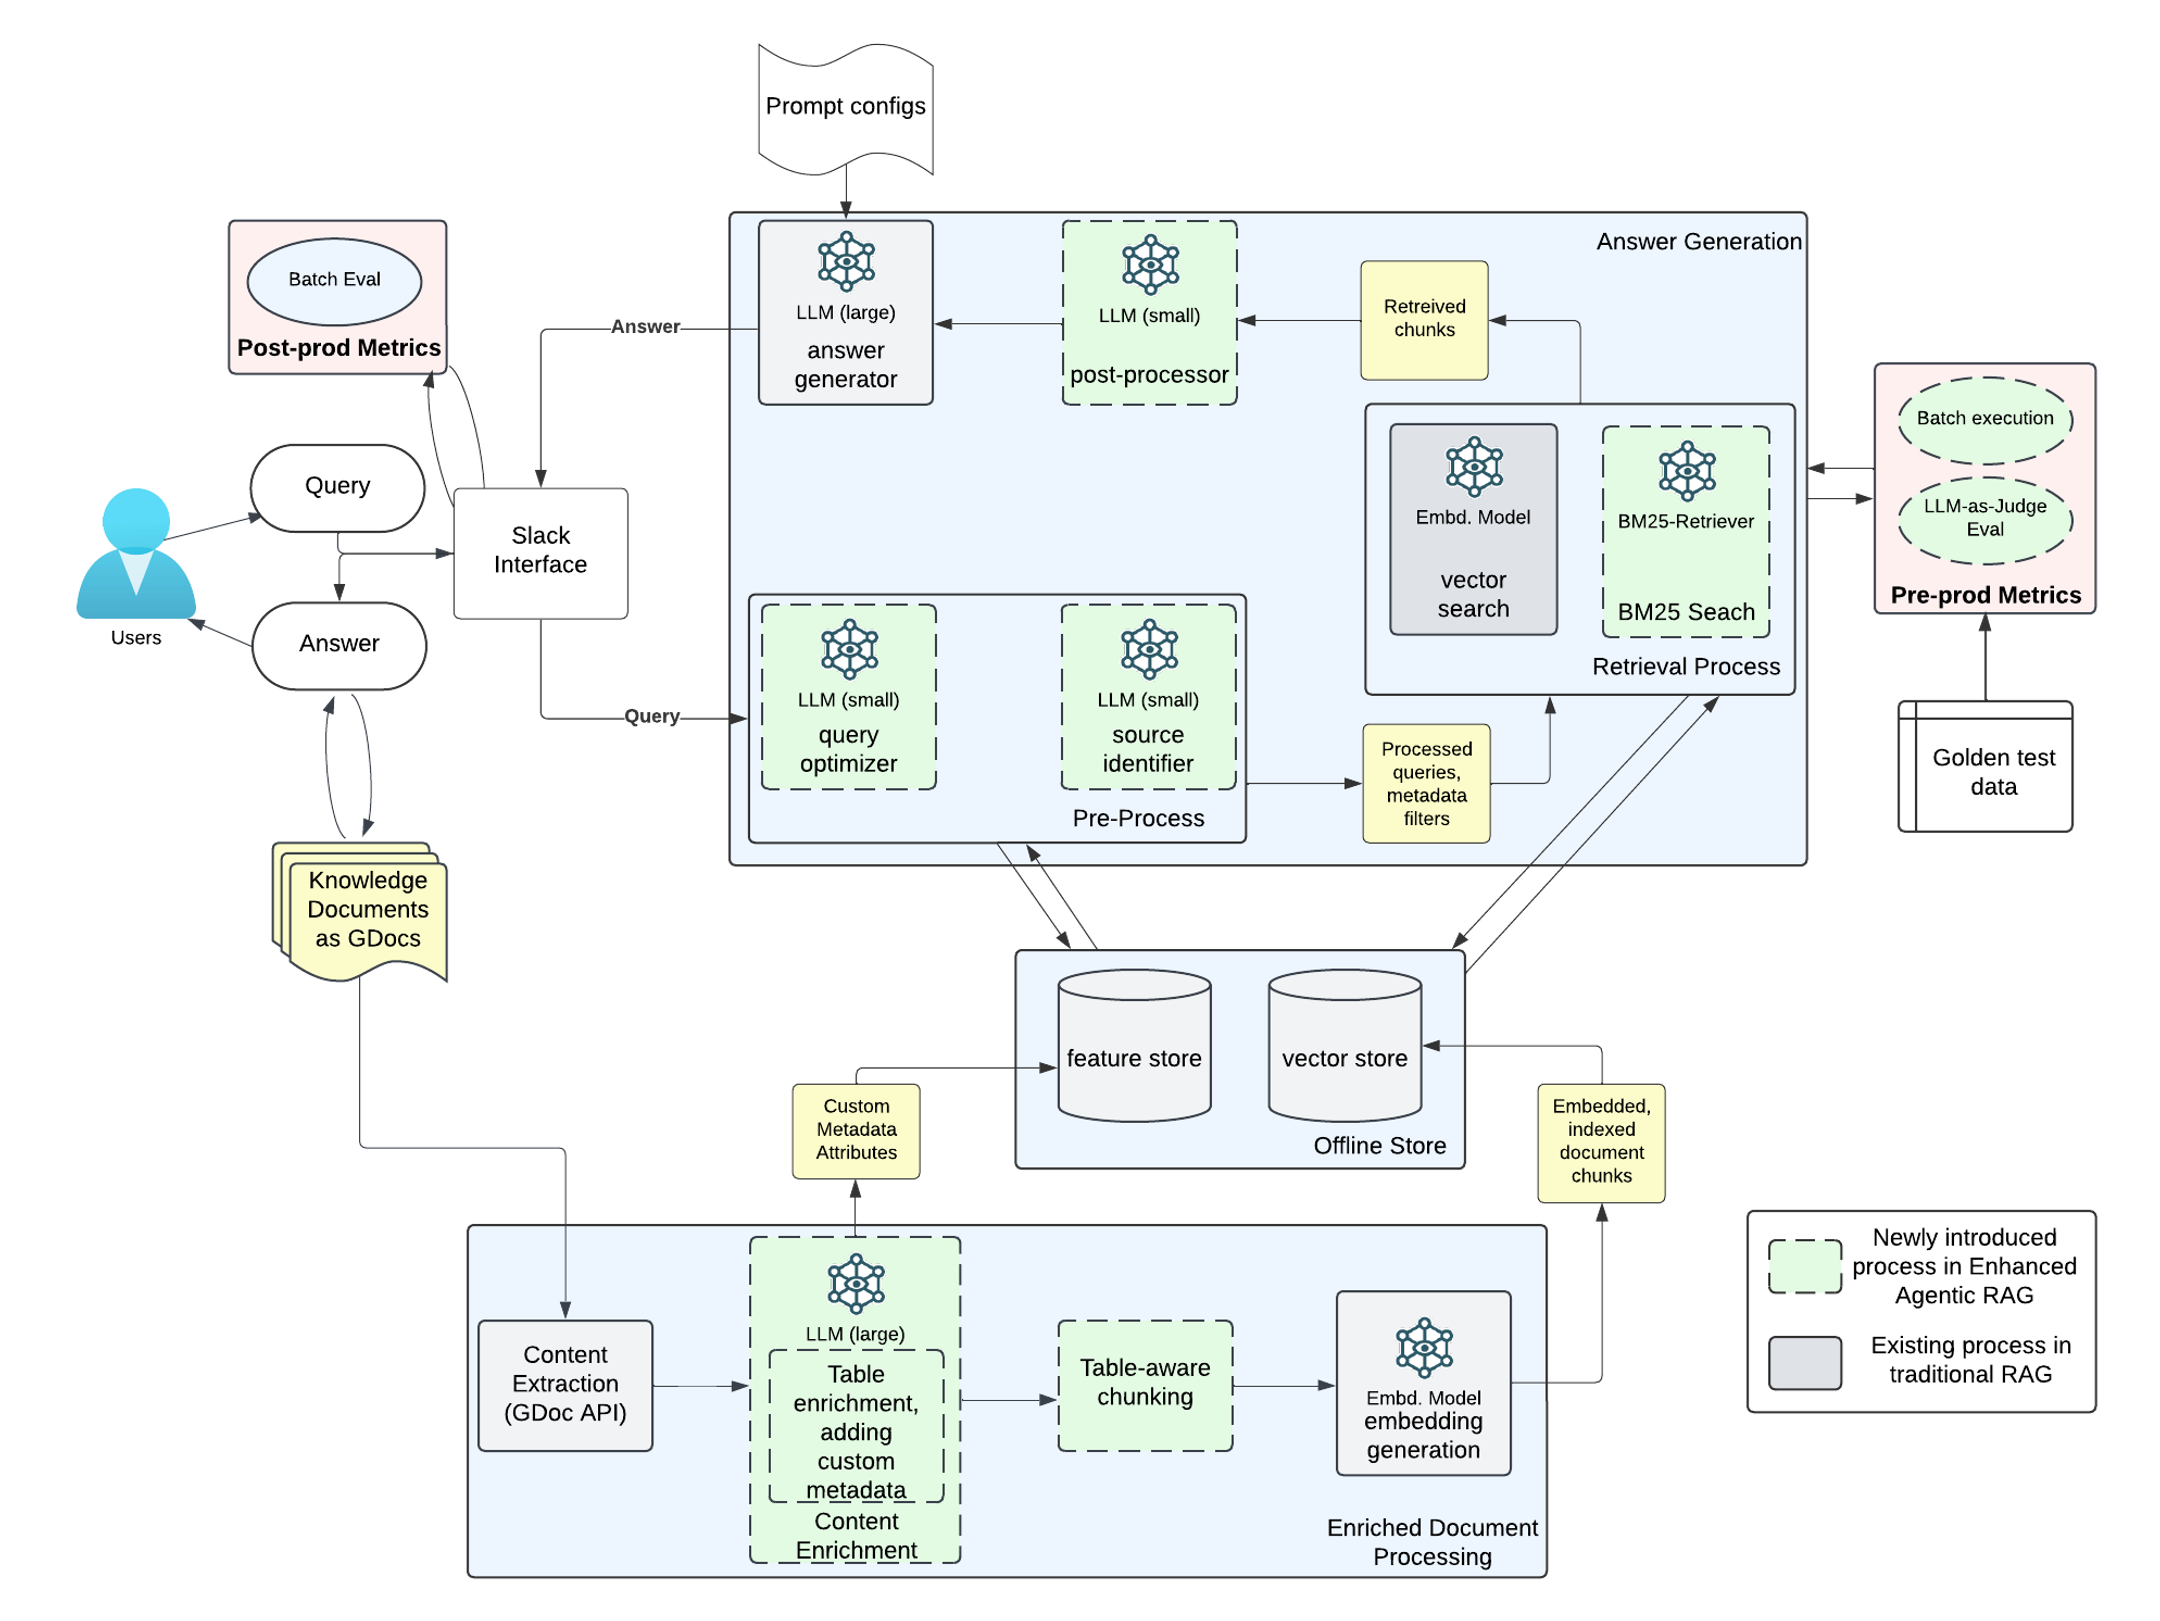
Полная схема EAg-RAG: подготовка документов выполняется отдельно, а запрос пользователя проходит через уточнение, выбор источников, поиск и подготовку ответа.
Источник: Оригинальная иллюстрация · UberОткуда брались ошибки: PDF разрушал смысл таблиц
Работу начали с проверки текста, который получался из внутренних документов ещё до вычисления векторных представлений — эмбеддингов. Множество PDF-политик содержало маркированные списки, таблицы со сложной структурой и вложенные ячейки. Некоторые таблицы растягивались более чем на пять страниц. В таких материалах значение отдельной ячейки нельзя понимать без названия строки, названия столбца и нередко соседних исключений.
Обычные загрузчики SimpleDirectoryLoader из LlamaIndex и PyPDFLoader из LangChain при извлечении текста теряли исходное форматирование. Содержимое ячейки могло превращаться в отдельную строку без связи с заголовком «политика по умолчанию» или «исключения». После этого разбиение документа на небольшие фрагменты для поиска — chunking — ещё сильнее разделяло значения, которые должны были читаться вместе.
Проблема проходила по всей цепочке. Сначала извлечение уничтожало отношения между элементами таблицы; затем разбиение помещало заголовок и правило в разные фрагменты; после построения векторов семантический поиск — поиск по смысловой близости — мог не найти правильное исключение, потому что оно уже не содержало указания, к какому правилу относится. Языковая модель получала неполный контекст и могла уверенно выдать неверный совет.
Команда пробовала не только простые загрузчики, но и PdfPlumber, PyMuPDF и LlamaIndex LlamaParse. Некоторые инструменты извлекали таблицы аккуратнее, однако универсального решения для всех рассматриваемых политик найти не удалось.
Enriched Document ProcessingПереход в Google Docs: структура стала доступнее, но не исправилась сама собой
Вместо дальнейшей борьбы со всеми особенностями PDF команда перешла на Google Docs и HTML-представление документов. Это давало более удобную исходную структуру для извлечения содержимого. Для чувствительных внутренних правил был важен и встроенный в Google Docs контроль доступа: метаданные о разрешениях можно включать в индекс и учитывать при ответе, чтобы не показывать запрещённые сведения.
Даже после перехода на HTML стандартное извлечение таблиц в Markdown — обычный текст с обозначениями заголовков, списков и таблиц — оставалось проблемой. Авторы проверяли html2text и Markdownify из LangChain. Они обнаружили, что простое преобразование формата не сохраняет все структурные связи: изображение таблицы «в виде текста» не обязательно равнозначно таблице, где строка и столбец определяют смысл значения.
Enriched Document ProcessingИскусственная таблица показывает, что именно должен помнить поиск
Чтобы объяснить дефект, авторы создали демонстрационную таблицу (рисунок 2). У неё три столбца: тип политики, общее правило и исключения. Среди намеренно абсурдных примеров — доставка сообщений о происшествиях голубями, сроки хранения «до изобретения путешествий во времени» и политика о настоящем печенье. Это выдуманный материал для демонстрации обработки, а не действующие требования или правила Uber.
Одна ячейка раздела Cookie Policy содержит ещё одну таблицу: виды печенья и условия «сбора». Это существенно сложнее плоского списка строк. Если из текста исчезают уровни вложенности и заголовки, поиск может найти выражение «Only if», но не понять, к какому виду печенья или к какой основной политике относится условие.
На этом вымышленном примере легко проверить главное: сохранились ли после извлечения связи между типом политики, общим правилом и его исключениями.
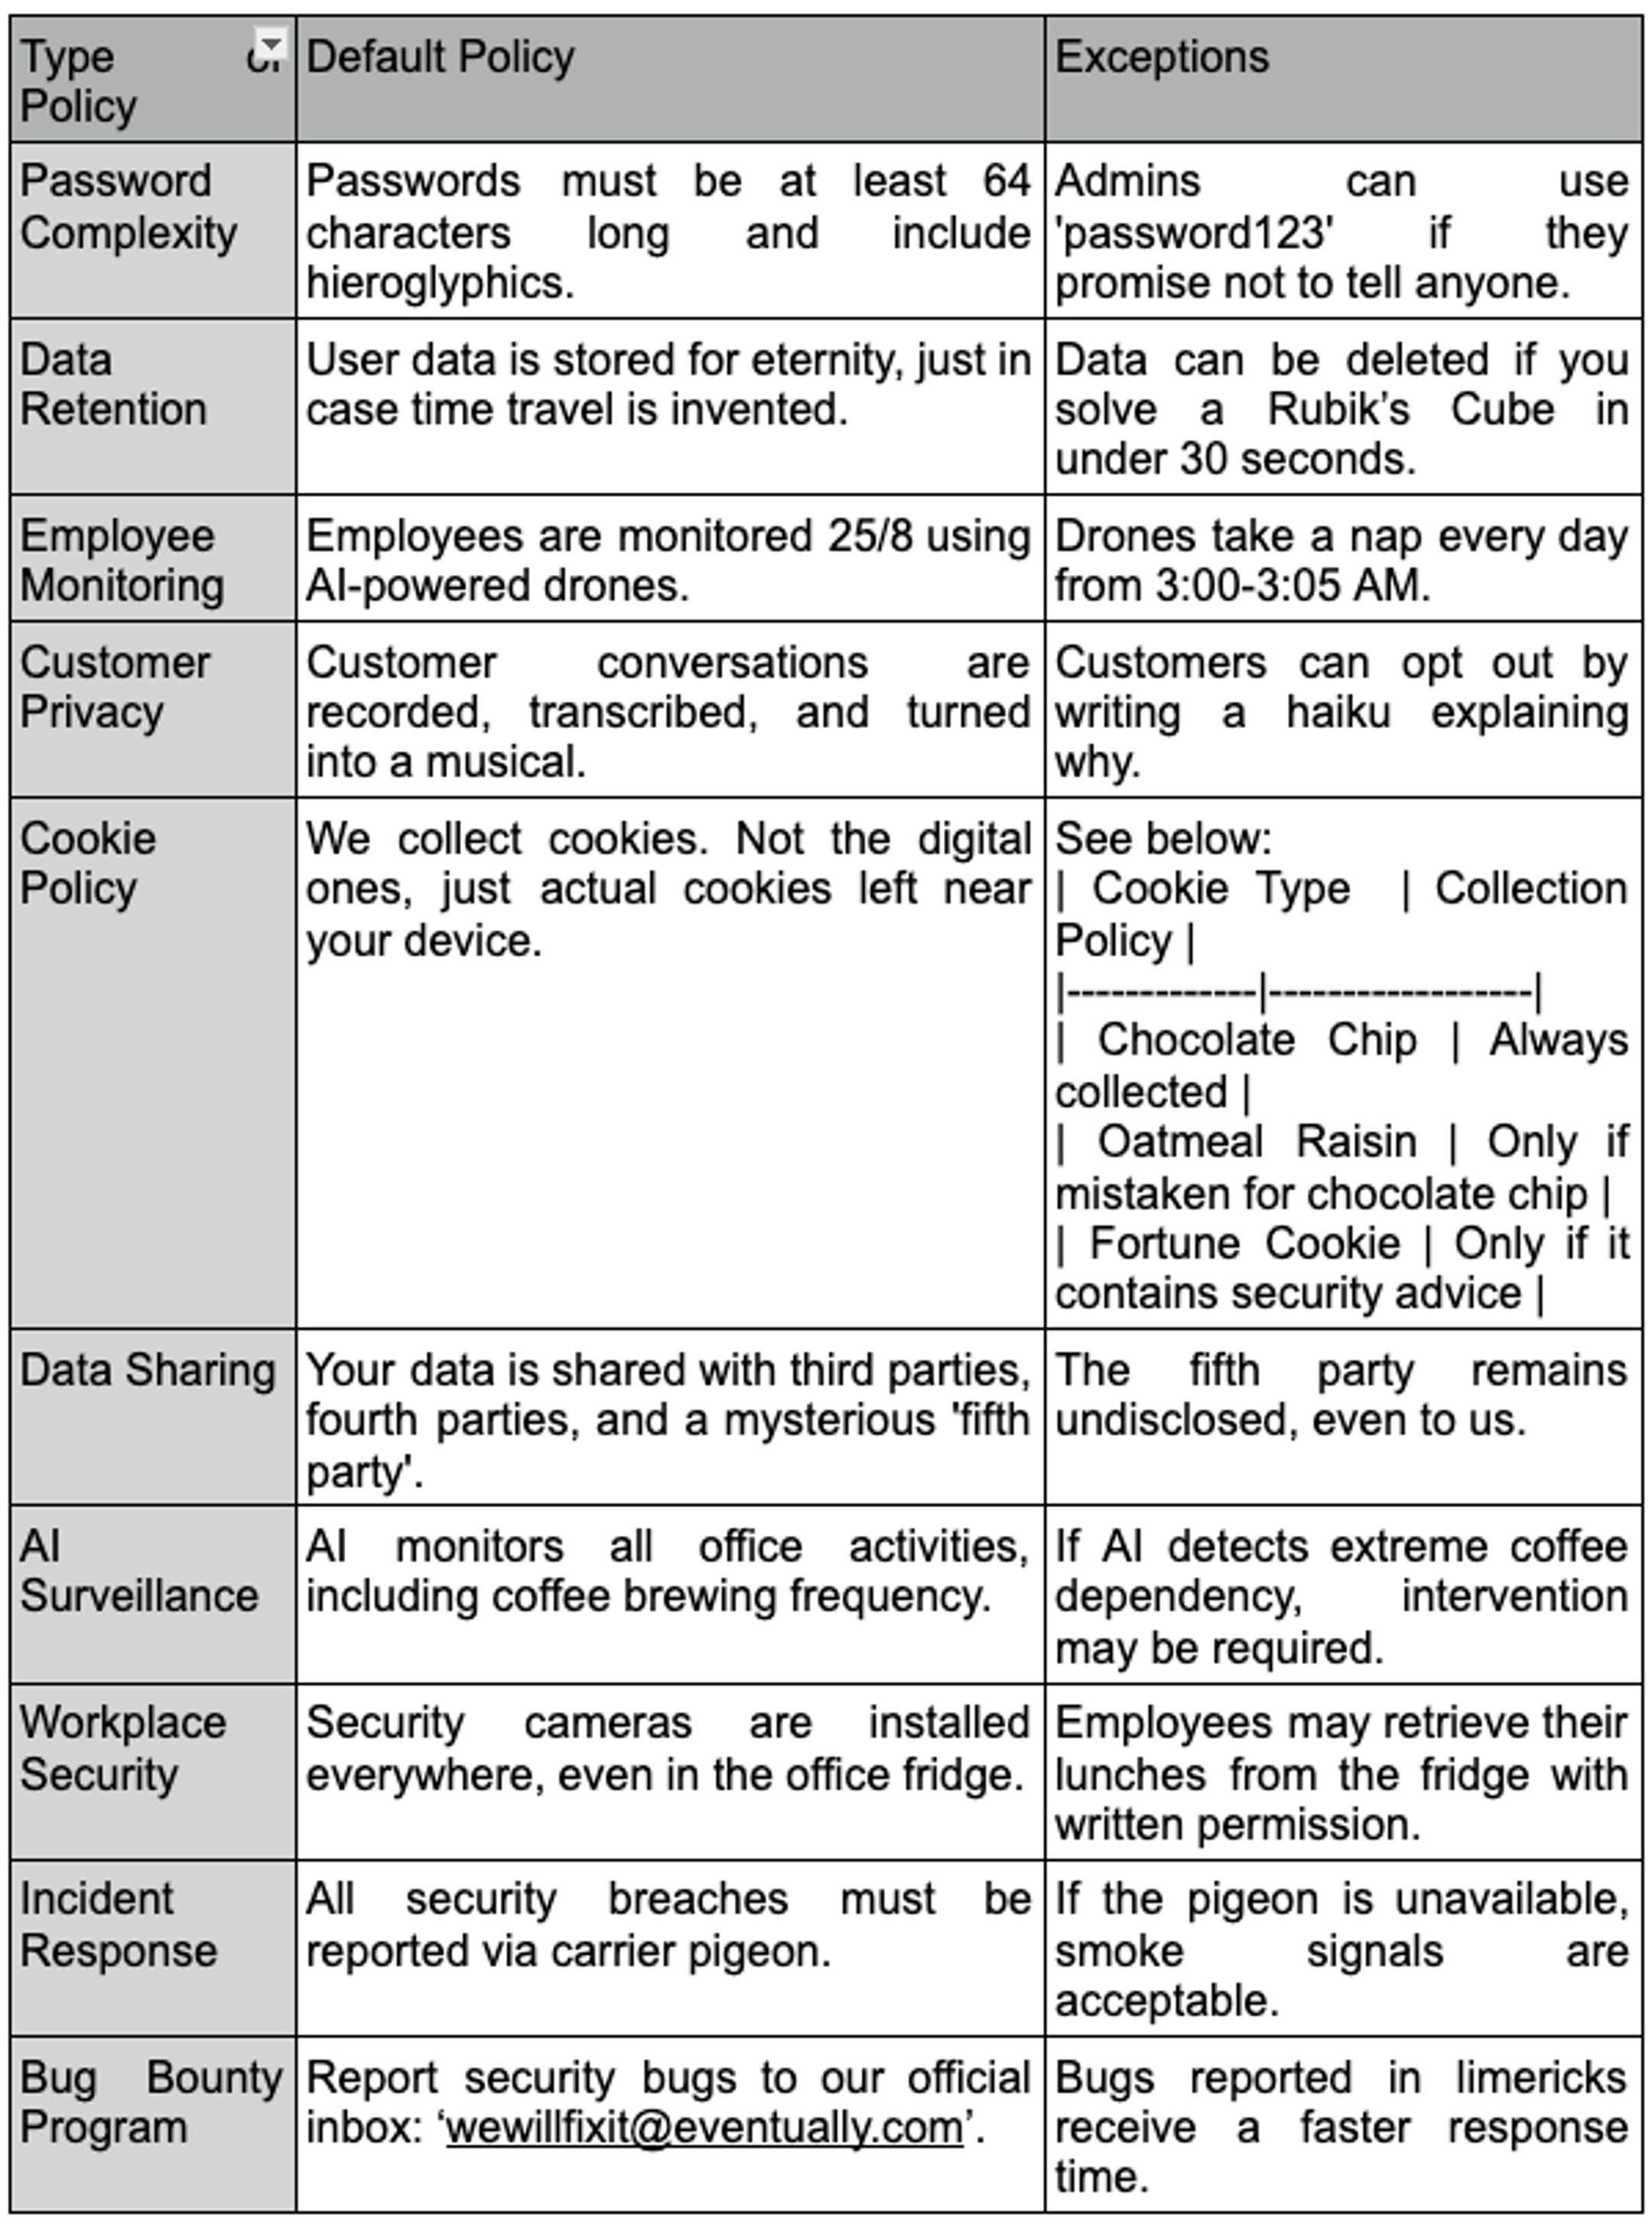
Искусственная таблица политик из статьи Uber. Её используют для проверки извлечения вложенных ячеек, а не как реальные правила компании.
Источник: Оригинальная иллюстрация · UberКак html2text и MarkdownTextSplitter разделили связанные данные
Авторы пропустили созданный Google-документ через html2text, получили текст с разметкой Markdown и затем разделили его при помощи MarkdownTextSplitter. Две части результата — Split: 1 и Split: 2 — показаны на рисунке 3. У первой части заметны названия столбцов, после которых вместо аккуратных строк идут значения, перемежающиеся отдельными символами вертикальной черты.
Вложенная таблица про Cookie Policy особенно хорошо обнаруживает сбой. В конце первого фрагмента появляется часть перечня видов печенья, но строка про Fortune Cookie оказывается уже в начале второго фрагмента, после чего идут другие политики. Таким образом, условие из ячейки «исключения» физически отрывается от соответствующей политики, а строка вложенной таблицы — от её заголовков.
Даже если слова исключения остались в индексе, поиск может вернуть их отдельно от нужной строки и заголовка. Тогда генератор получает формально подходящий текст, но без сведений о том, к какому правилу относится найденное условие.
Важно различать две последовательные операции: преобразование документа в текст и разбиение уже извлечённого текста. Проблема возникала на обоих уровнях. Одной заменой алгоритма разбиения нельзя исправить колонку или заголовок, если загрузчик уже выбросил соответствующую связь.
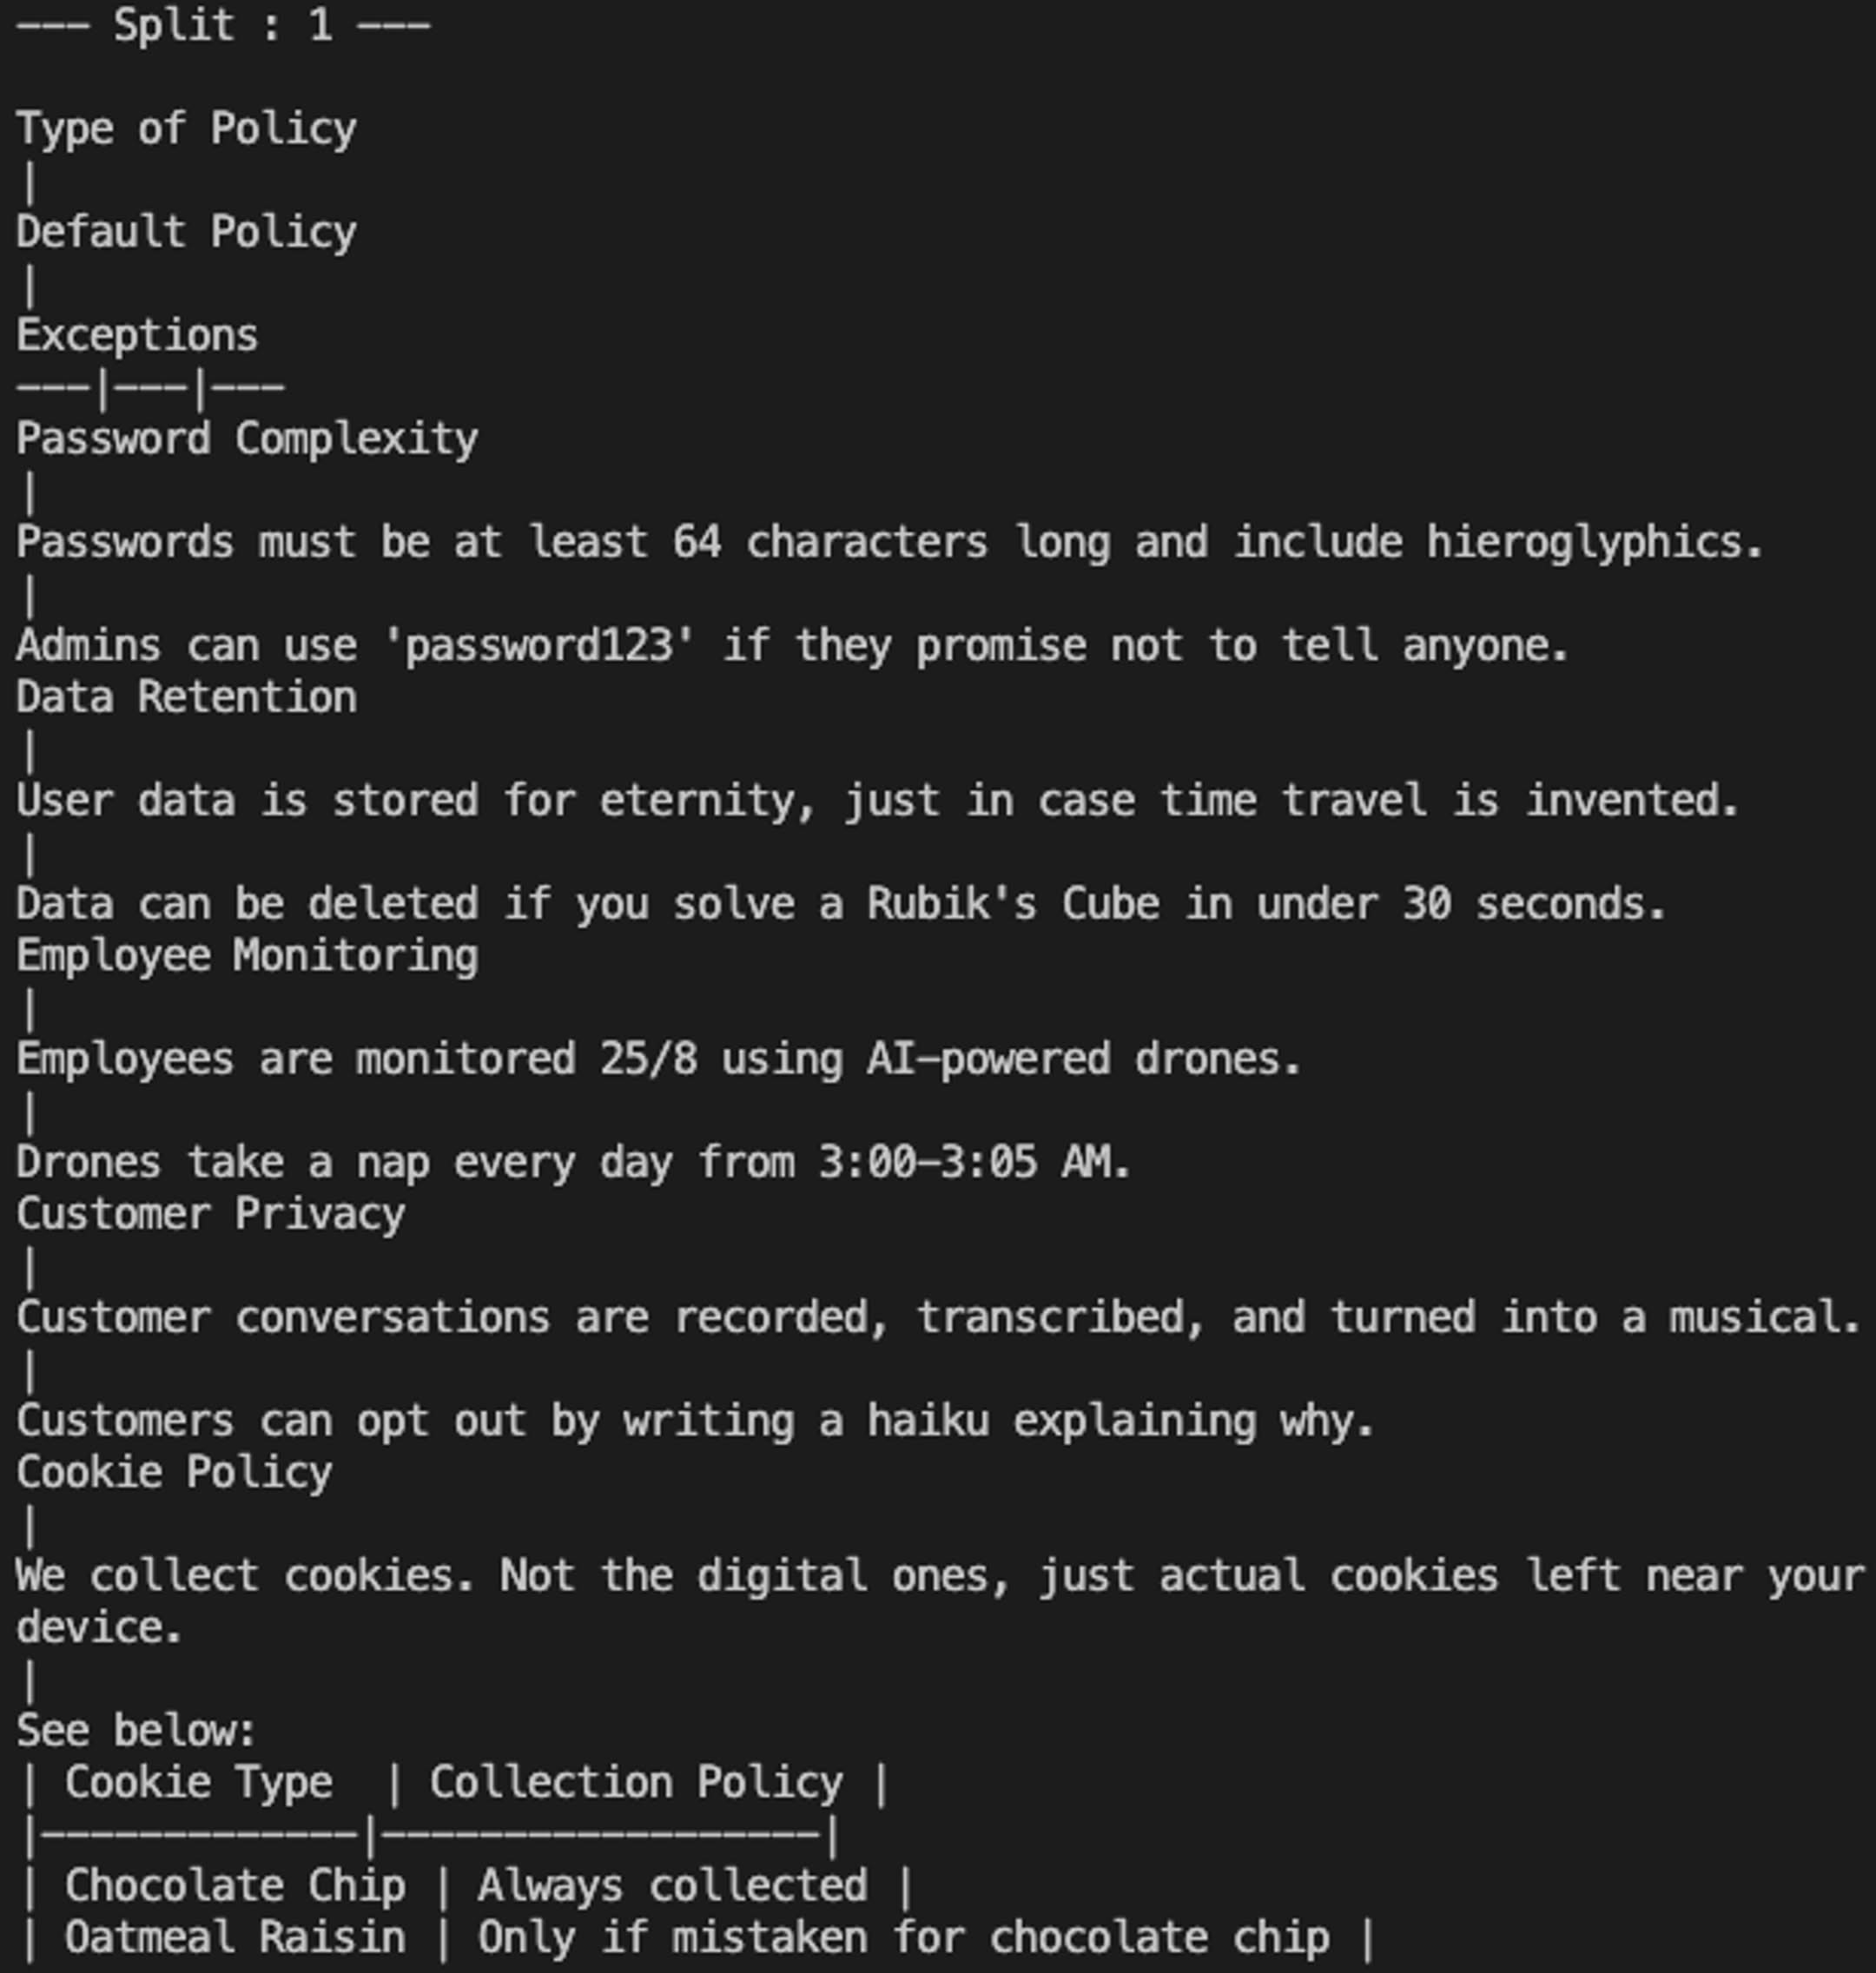
Первый фрагмент после обычного преобразования таблицы: значения теряют связь с типом политики и исключениями.
Источник: Оригинальная иллюстрация · Uber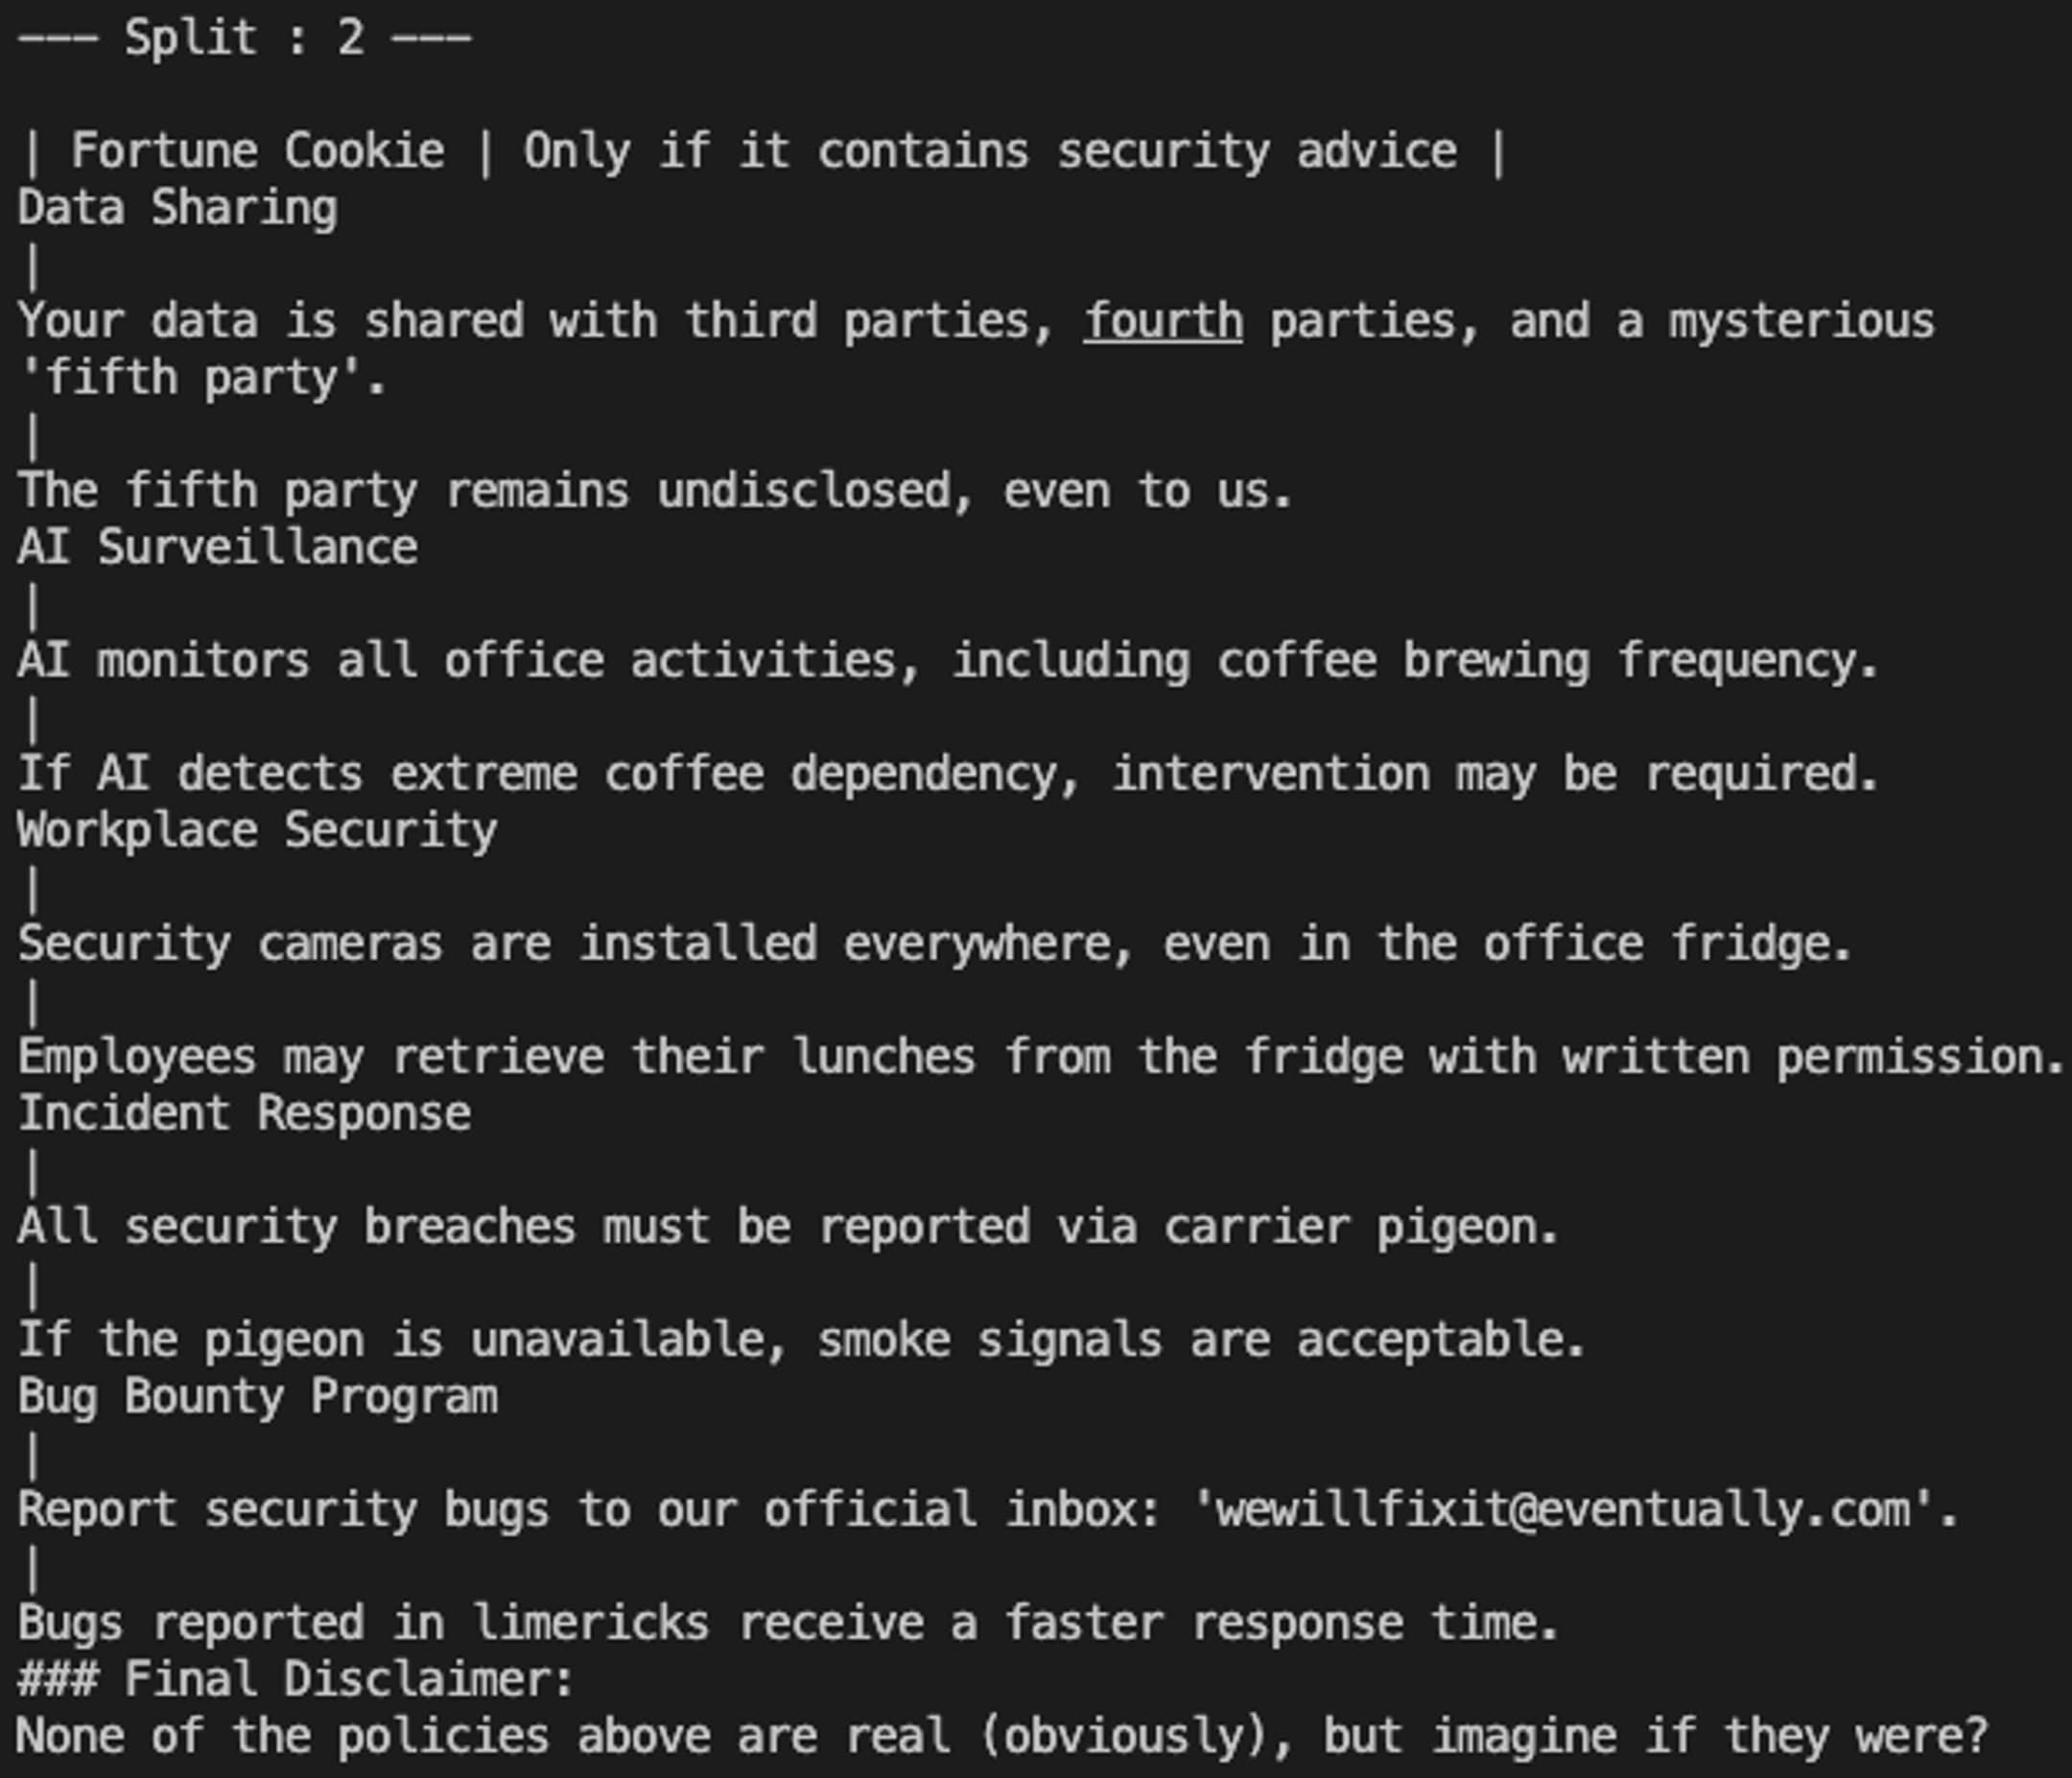
Второй фрагмент той же таблицы после разбиения: структура исходных строк и столбцов также нарушена.
Источник: Оригинальная иллюстрация · UberСобственный загрузчик и обогащение таблиц
Команда написала загрузчик Google Docs на Python API Google. Он рекурсивно извлекает абзацы, таблицы и оглавление, а не просто превращает весь документ в одну строку. Структурные элементы, включая списки и таблицы, затем проходят дополнительное обогащение: языковая модель получает извлечённое содержимое и преобразует таблицы к пригодной для дальнейшей обработки Markdown-разметке.
Фрагменты, содержащие таблицу, получают специальные идентификаторы в метаданных. Процедура разбиения учитывает эти признаки и старается не разрывать таблицу на независимые куски. К таблице добавляются краткое резюме в две строки и несколько ключевых слов. Они нужны не вместо ячеек, а рядом с ними: краткое описание помогает семантическому поиску связать вопрос с таблицей, а полный структурированный фрагмент позволяет найти конкретное значение или исключение.
На рисунке 4 показан результат обработки того же макета: перед таблицей появились краткое описание и список ключевых выражений; сама таблица сохранена внутри одного фрагмента, включая вложенный перечень в Cookie Policy. В отличие от двух предыдущих снимков, строки снова связаны со своими столбцами.
Авторы предлагают применять похожее обогащение и к обычному тексту, которому перед построением эмбеддингов полезно придать более явную структуру.
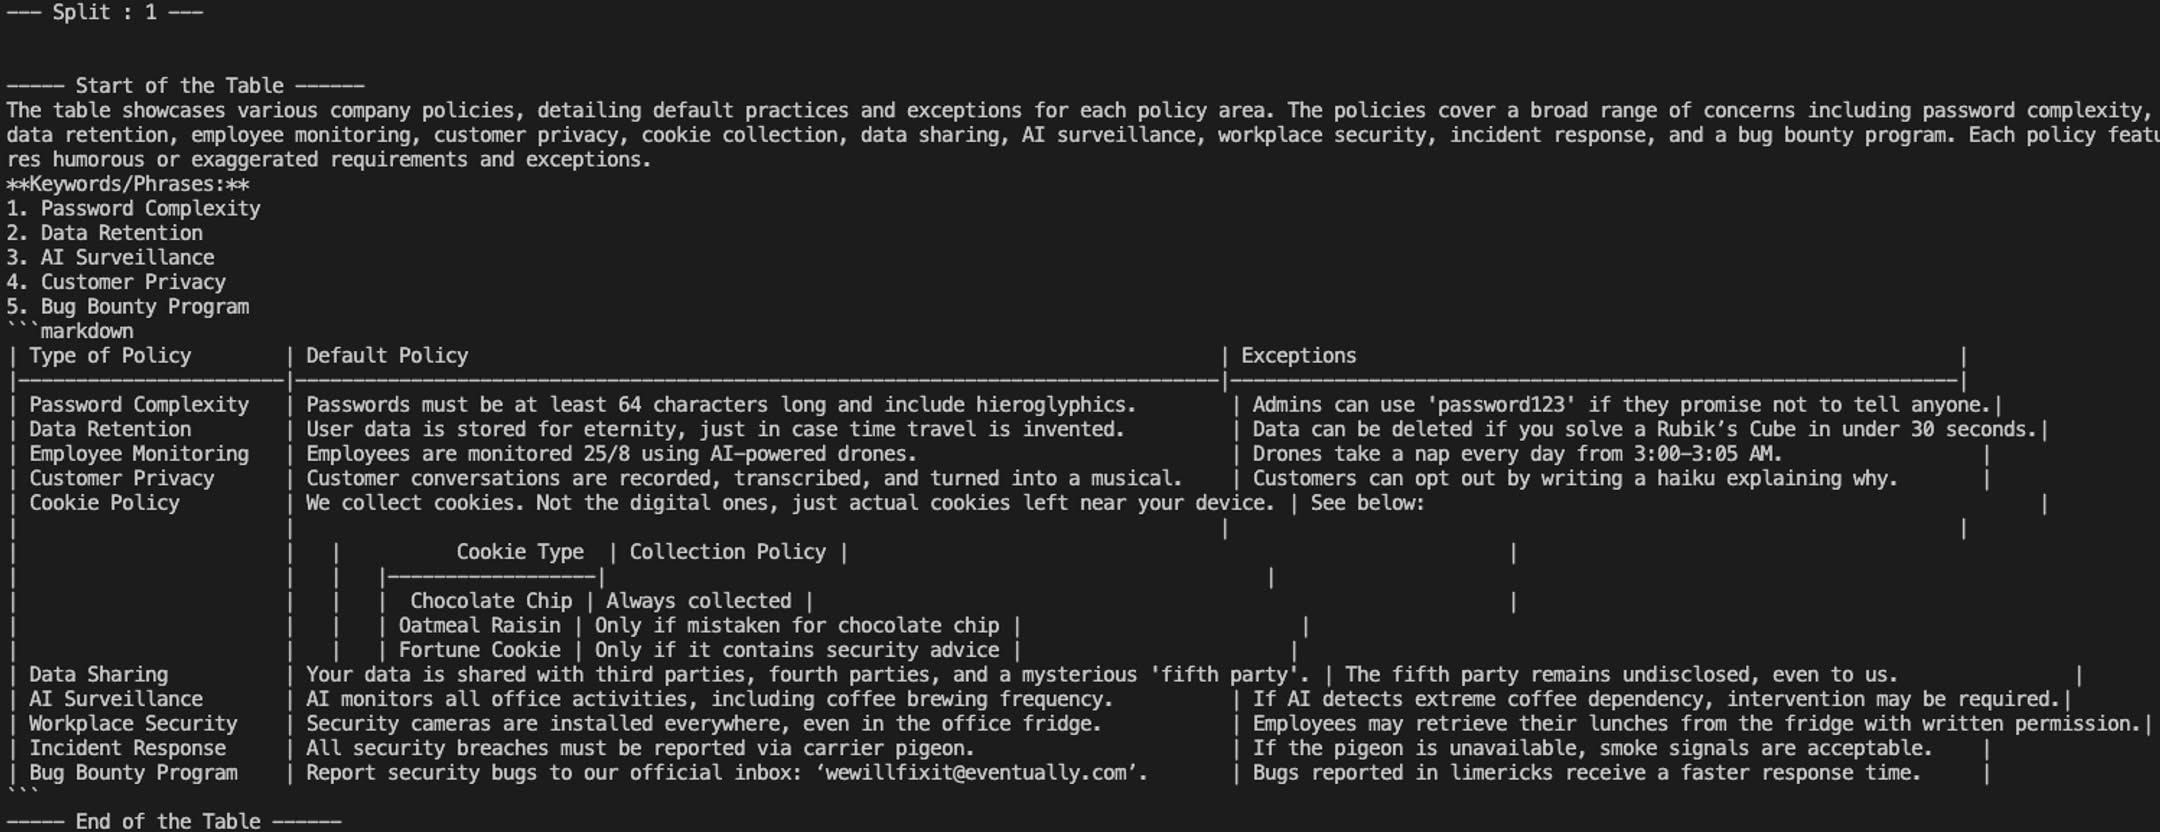
Результат собственного загрузчика и форматирования моделью: структура таблицы сохраняется вместе с контекстом.
Источник: Оригинальная иллюстрация · UberМетаданные нужны не только для красивых ссылок
После восстановления структуры команда расширила метаданные. Помимо обычных полей — названия документа, URL и идентификаторов — языковая модель готовила краткое содержание всего документа, часто задаваемые вопросы (FAQ) и ключевые слова. Эти признаки дают поисковой системе дополнительные формулировки смысла и помогают вспомогательным агентам выбрать правильный источник.
Метаданные готовят на разных уровнях. Резюме целого документа одинаково для всех его фрагментов, а FAQ и ключевые слова добавляют после разбиения — с привязкой к содержимому конкретного фрагмента. Для сложных таблиц дополнительно сохраняют собственные краткие описания и ключевые слова рядом с табличными данными.
Таблицу можно прокрутить по горизонтали.
Обогащение работает в двух местах. Одни метаданные помогают агентам уточнять запрос и приводить найденный контекст в порядок, а FAQ и ключевые слова участвуют непосредственно в поиске. При этом сам ответ строится на сохранённых фрагментах документов, где находятся исходные правила и исключения.
Enriched Document ProcessingЧто остаётся после офлайн-подготовки
После извлечения, обогащения и разбиения документы индексируются: для каждого фрагмента вычисляется векторное представление и сохраняется в векторном хранилище. Индекс позволяет по смыслу вопроса найти близкий текст, не пропуская языковую модель через весь корпус документов при каждом обращении сотрудника.
Отдельно в офлайн-хранилище признаков (feature store) сохраняются результаты предварительной обработки: списки документов с названиями и резюме, а также FAQ. Во время обработки вопроса их можно быстро передать моделям, уточняющим запрос и выбирающим политики. На общей схеме поэтому два хранилища и разные стрелки: одно выдаёт фрагменты для поиска, другое — сведения о структуре корпуса для управляющих шагов.
Обе группы данных готовятся заранее. Когда сотрудник пишет в Slack, система использует уже сохранённые фрагменты и списки документов, вместо того чтобы заново разбирать Google Docs для каждого вопроса.
Enriched Document ProcessingПочему выбрать похожий фрагмент ещё не значит найти правильную политику
Когда приходит вопрос, простой RAG выполнил бы семантический поиск и сразу передал найденные фрагменты генератору ответа. Для политик Uber это давало ошибки даже при корректно сохранённом тексте. Документы могли по-разному регулировать сроки хранения, категории данных и порядок передачи сведений в зависимости от географии и роли сотрудника.
Вопрос может относиться к одному из нескольких похожих документов. Семантический поиск хорошо находит тексты про хранение данных, но сама близость не отвечает на вопрос, какой из них применим именно к обсуждаемой ситуации. Поэтому команда добавила отдельные шаги перед извлечением: сначала привести вопрос к более определённому виду, затем сузить пространство документов, в которых следует искать правило.
Здесь нужны два последовательных решения: сначала определить, какие документы относятся к вопросу, а затем найти точное правило внутри них. Для первого шага команда добавила отдельных агентов.
Agentic RAG Answer GenerationДва агента до поиска: уточнить вопрос и определить источники
Первый агент, Query Optimizer, получает сообщение пользователя. Если формулировка неполная или неоднозначная, он уточняет её для целей поиска. Если вопрос состоит из нескольких частей, он разбивает его на несколько более простых поисковых запросов. Это не разговорный ответ сотруднику, а внутреннее преобразование входа, чтобы поиск нашёл более подходящие документы.
Второй агент, Source Identifier, анализирует подготовленный вопрос и выбирает документы, в которых вероятнее всего находится ответ. Оба агента используют заранее созданный список названий, резюме и FAQ из хранилища признаков. Source Identifier также получает few-shot-примеры — несколько образцов выбора источника, включённых прямо в его инструкцию.
На выходе этого этапа — уточнённый вопрос и названия выбранных документов. Поиск ограничивают этим набором, чтобы отсечь похожие, но неприменимые политики. Поэтому точность выбора источника важна: пропущенный здесь документ уже не попадёт в результаты следующего поиска.
Важно, что исходный текст вопроса не пропадает после уточнения. На финальном этапе генератор получает и первоначальный запрос, и вспомогательные подготовленные запросы. Так архитектура сохраняет намерение пользователя, одновременно используя более удобные для поиска формулировки.
Agentic RAG Answer GenerationДва способа найти фрагменты: векторы и BM25
После выбора набора документов система ищет подходящие фрагменты двумя способами. Векторный поиск сопоставляет смысл запроса со смыслом подготовленных частей политик. Дополнительный компонент BM25 опирается на совпадения слов и их информативность; он полезен, когда важно найти характерное название правила, термин или уточнение, которое трудно восстановить только по близости векторов.
Обогащение документов теперь помогает и BM25: резюме, FAQ и ключевые слова добавляют формулировки, по которым вопрос может совпасть с нужным фрагментом. Так улучшение подготовки таблиц и текста напрямую связано с точностью поиска.
Результаты векторного поиска и BM25 объединяют в один набор (union). В него попадают фрагменты, найденные хотя бы одним из способов; затем общий набор передают на обработку контекста.
После объединения возможны повторы: оба механизма могут вернуть один и тот же фрагмент. Поэтому дальше используется не немедленная генерация ответа, а специальная операция подготовки найденного контекста.
Agentic RAG Answer GenerationПосле поиска: убрать повторы, восстановить порядок, сформировать ответ
Post-Processor Agent выполняет две явно названные операции. Во-первых, он удаляет повторяющиеся фрагменты, попавшие одновременно из векторного поиска и BM25. Во-вторых, выстраивает найденный контекст с учётом положения фрагментов в исходных документах. Это помогает читать соседние части политики в их исходной последовательности, а не только в произвольном порядке выдачи двух поисковиков.
Для технических правил порядок особенно важен: определение, основное требование и исключение могут идти друг за другом в документе, а поиск возвращает их в порядке близости к вопросу. Восстановление исходной последовательности помогает читать связанные фрагменты вместе.
После этого генератор ответа — на общей схеме более крупная LLM — получает первоначальный запрос, уточнённые вспомогательные запросы, подготовленные фрагменты и специальные инструкции. Сформированный ответ со ссылками на внутренние документы возвращается сотруднику в Slack.
Таким образом, во время пользовательского запроса порядок фиксирован: подготовка вопроса, выбор документов, объединённый поиск, очистка и упорядочивание найденного, генерация ответа. Никаких вызовов обучения модели или повторной индексации на этом пути статья не описывает.
Agentic RAG Answer GenerationНеудачные улучшения и новая узкая часть: оценка изменений
До перехода к EAg-RAG команда пробовала традиционные способы повысить точность: менять инструкции генератору, параметры поиска и загрузчики PDF, включая более сложный LlamaParse. Авторы описывают два системных затруднения. Многие варианты давали лишь небольшую прибавку качества, после чего результаты выходили на плато. А надёжное сравнение версий всё ещё требовало большого участия экспертов по безопасности и приватности.
Гибкий конструктор Genie позволял быстро собирать опытные конфигурации, однако ручное рассмотрение ответов специалистами могло занимать недели. В таком режиме проверить много гипотез о разбиении документов, метаданных и шагах поиска трудно. Поэтому авторы меняли сразу две стороны процесса: архитектуру ответа, чтобы появилось больше мест для целевого улучшения, и процесс оценки, чтобы быстро понять направление следующего эксперимента.
Пакетная автоматическая оценка сократила проверку экспериментальной конфигурации с недель до минут. Речь о времени оценки очередной версии бота, а не о задержке ответа в Slack. Благодаря этому команда могла быстрее сравнивать варианты и выбирать следующие изменения.
ChallengesКак проверяли качество: эталон эксперта и модель-судья
Для ускорения экспериментов Uber использовала LLM-as-Judge — языковую модель, которая оценивает ответы бота по заданным правилам. На рисунке 5 показан общий принцип из работы Gu и соавторов 2024 года: модель рассматривает проверяемый ответ x вместе с контекстом C и формирует оценку E. Uber применила эту идею к пакетной проверке ответов по внутренним политикам.
В прикладной процедуре человек задаёт ориентир. Сначала профильные эксперты один раз подготавливают качественные ответы на вопросы контрольного набора или пишут замечания к прежним ответам бота. Эти ответы и замечания служат эталоном SME. Далее очередная версия бота пакетно обрабатывает тестовые вопросы. На последнем шаге отдельный вызов языковой модели сравнивает выдачу с эталоном по инструкции оценивания.
Таблицу можно прокрутить по горизонтали.
Судья получает не только вопрос и идеальный ответ, но и дополнительный контекст из документов, извлечённый через актуальный конвейер RAG. Авторы рассчитывают, что он поможет модели учитывать особенности внутренних политик и точнее оценивать сложные советы. На рисунке 6 виден полный пакетный маршрут: контрольные вопросы поступают в бот, ответы и найденные тексты — в оценочный запрос; эталон SME и примеры дополняют этот запрос, а модель возвращает оценки, объяснения и сводку.
Каждый ответ модель-судья оценивает по шкале от 0 до 5, где 5 — высшая оценка, и сопровождает балл объяснением. По этим объяснениям команда видит, какие ошибки остались в новой версии Genie и какие изменения стоит проверить в следующем эксперименте.
Такую оценку выполняют пакетно при сравнении версий Genie, отдельно от обработки обращения сотрудника в Slack.
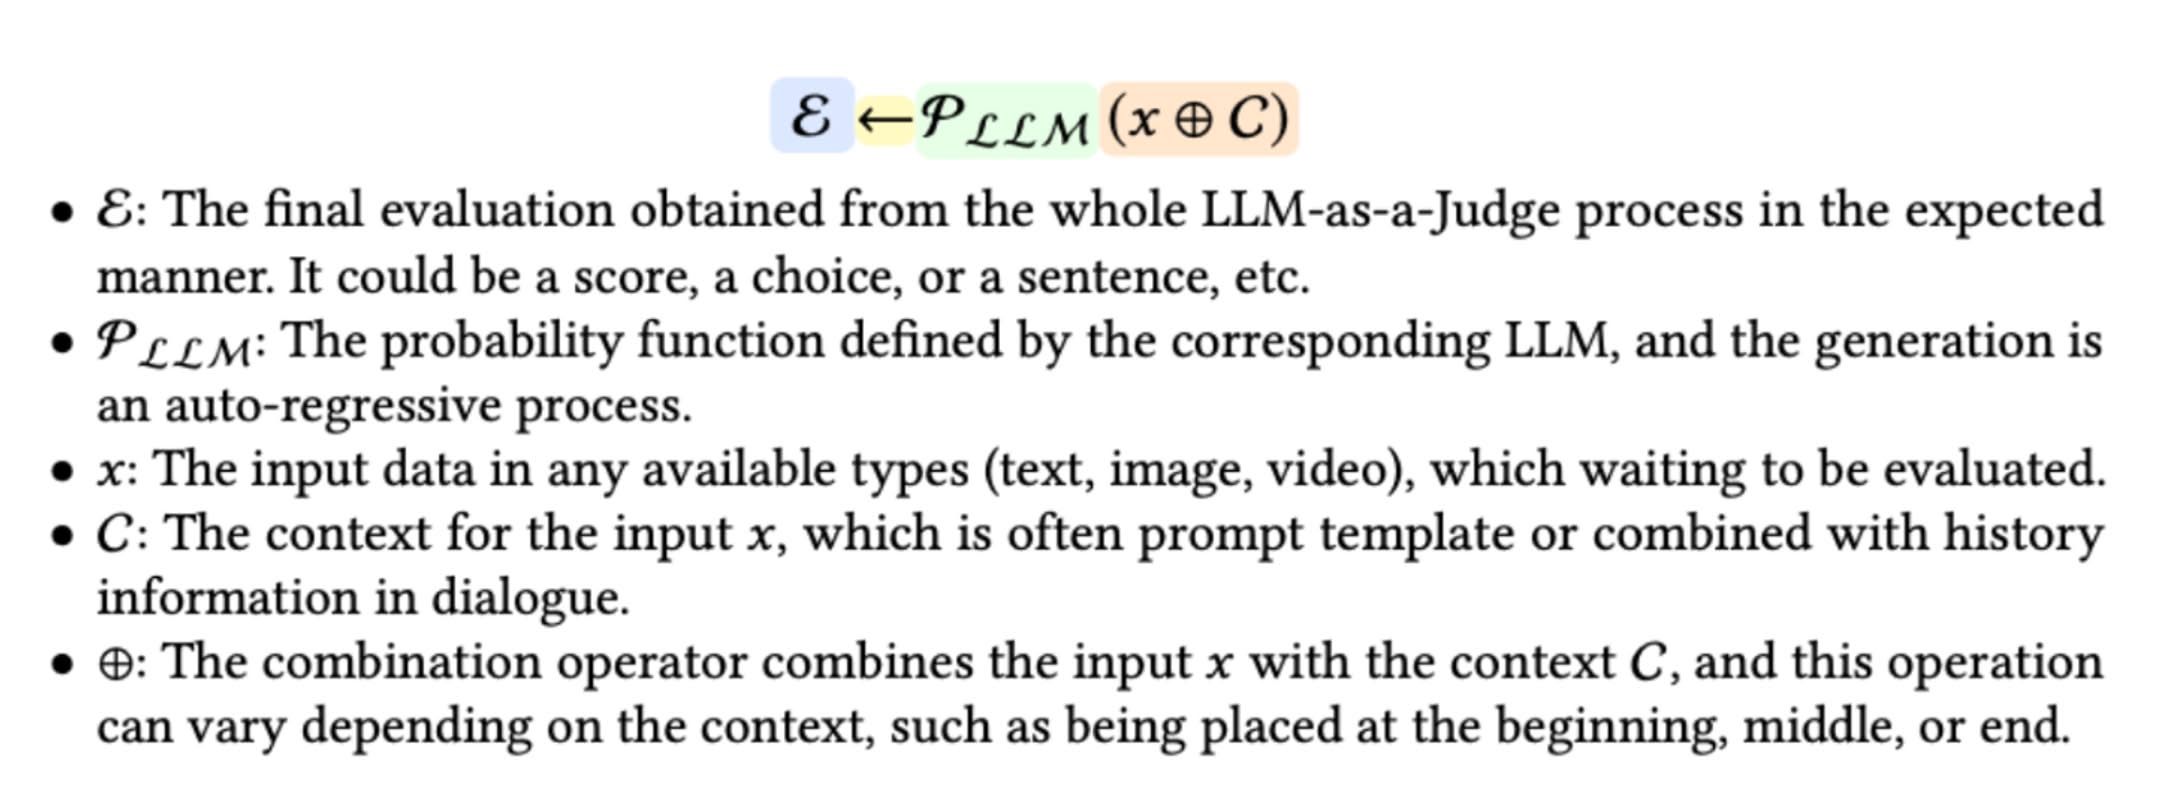
Схема LLM-as-a-Judge из работы Gu и соавторов: оценка ответа зависит от запроса, контекста и модели-судьи.
Источник: Оригинальная иллюстрация · Uber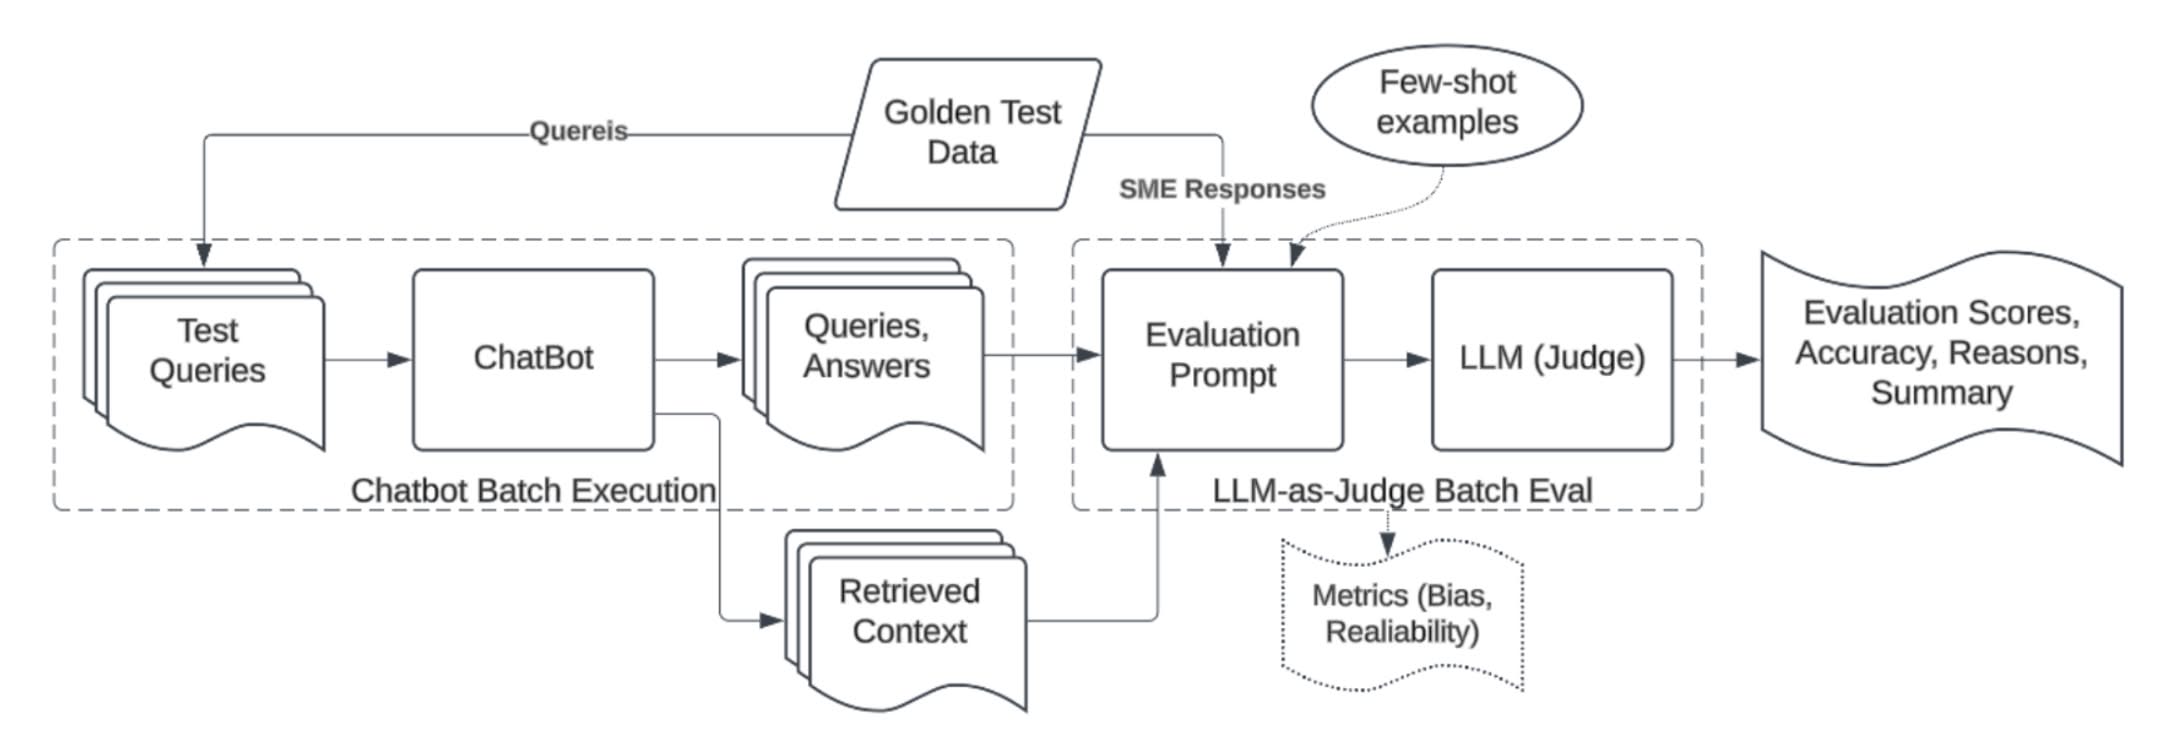
Автоматическая пакетная оценка: ответы бота сравниваются с экспертными эталонами, а оценки сопровождаются объяснениями.
Источник: Оригинальная иллюстрация · UberИз чего собрана реализация и почему это пока последовательный процесс
Большую часть компонентов EAg-RAG команда построила на Langfx — внутреннем сервисе Uber на основе LangChain, входящем в платформу Michelangelo. Для разработки агентов и управления порядком их работы использовались LangChain и LangGraph.
В опубликованной реализации LangGraph связывает этапы последовательно: уточнение запроса, выбор документов, поиск, подготовку контекста и генерацию ответа. Возможности ветвлений и повторных проходов оставляют пространство для будущего развития системы.
Улучшения оформлены как настраиваемые компоненты Michelangelo Genie. Благодаря этому другие команды Uber могут применять ту же схему для своих документов и вопросов, не разрабатывая каждый шаг заново.
Developing Agentic RAG Using LangChain and LangGraphЧто измерили и почему нельзя превратить результат в бизнес-метрику
Главный опубликованный числовой результат относится к проверке Genie на вопросах инженерной безопасности и приватности. При переходе от традиционной конфигурации RAG к EAg-RAG авторы сообщили, что показатель приемлемых ответов вырос на 27% относительно прежнего уровня, а показатель неверных советов снизился на 60% относительно прежнего уровня. Это два разных показателя качества ответов, а не скорость работы или финансовый эффект.
Таблицу можно прокрутить по горизонтали.
Относительный рост на 27% означает увеличение исходного показателя в 1,27 раза; относительное снижение на 60% — уменьшение до 40% исходного значения. Начальные доли не опубликованы, поэтому по этим изменениям нельзя восстановить абсолютное число приемлемых ответов или ошибочных советов.
Условия сравнения ограничены опубликованным материалом: более 100 вопросов, сформированных экспертами, и корпус более 40 PDF-политик для выбранных команд. Не указаны точный объём набора, определения приемлемости и ошибочного совета, исходные абсолютные доли, интервалы неопределённости, статистические проверки и вклад отдельных компонентов. Данных, позволяющих утверждать рост выручки, удержания сотрудников или иной бизнес-метрики, нет.
Авторы также отмечают снижение нагрузки на дежурных инженеров и профильных экспертов и возможность расширить помощника на несколько каналов поддержки. Численный замер экономии рабочего времени не приведён. Улучшения сделаны настраиваемыми компонентами Michelangelo Genie, которые могут использовать другие команды Uber; отдельных результатов для других доменов в статье нет.
MotivationКакие функции авторы только планировали
На дату статьи, 29 мая 2025 года, собственный загрузчик Google Docs и обогащение документов работали с текстом. В дальнейшем команда хотела научить их извлекать и обогащать изображения и другое мультимодальное содержимое.
Для сложных вопросов, требующих нескольких последовательных находок, авторы предлагают Chain-of-RAG: выполнить поиск, использовать полученную информацию для следующего шага и при необходимости повторить цикл. Это развитие текущей схемы, где запрос уточняется один раз перед поиском.
Ещё один предложенный шаг — self-critique: дополнительный агент после генерации проверяет ответ и при необходимости уточняет его, чтобы уменьшить число неподтверждённых утверждений. Также авторы хотят оформить некоторые операции как инструменты, которые модель сможет выбирать по типу и сложности вопроса.
Так система могла бы перейти от заранее заданной последовательности операций к выбору инструментов и нескольким шагам поиска в зависимости от вопроса.
Next StepsИтог: как Genie готовит политики, отвечает и проверяет качество
Команда Uber улучшала не саму способность языковой модели красиво формулировать ответы, а качество сведений, которые к ней поступают. Для Genie оказалось недостаточно подключить PDF, выполнить поиск похожих фрагментов и передать их генератору: сложные таблицы теряли заголовки и исключения, а похожие политики относились к разным ситуациям. Поэтому изменили как предварительную подготовку документов, так и путь конкретного обращения из Slack.
- 01
Подготовка документов заранее
Google Docs извлекаются собственным загрузчиком; таблицы и метаданные обогащаются, фрагменты индексируются и сохраняются вместе с документальными артефактами.
- 02
Уточнение вопроса
Query Optimizer приводит неоднозначную формулировку к поисковым запросам; Source Identifier выбирает вероятные документы по названиям, резюме и FAQ.
- 03
Поиск фрагментов
В отобранных источниках выполняются векторный поиск и BM25; наборы найденных фрагментов объединяются.
- 04
Подготовка контекста
Post-Processor Agent удаляет повторы и восстанавливает последовательность фрагментов внутри исходных документов.
- 05
Ответ в Slack
Генератор получает исходный вопрос, уточнённые запросы, найденный контекст и инструкции, затем формирует ответ сотруднику.
Оценка не является шестым шагом каждого запроса. Отдельно от него эксперты подготовили эталоны для контрольного набора, а LLM-as-Judge сравнивала с ними пакетные ответы новых версий. Авторы сообщают о сокращении проверки экспериментов с недель до минут, относительном росте приемлемых ответов на 27% и относительном снижении неверных советов на 60%.
Эти числа относятся к более чем 100 вопросам о безопасности и приватности и корпусу более 40 политик; исходные доли, знаменатели и вклад каждого нововведения не опубликованы. Заявленное снижение нагрузки специалистов не подтверждено отдельной открытой таблицей бизнес-показателей. На дату статьи работающая последовательность не включала мультимодальность, итеративный Chain-of-RAG и self-critique: всё это обозначено как возможное развитие.
Conclusion