Разбор готов · Исследование
Athena Intelligence: как Tia получила постоянную память между диалогами
Представьте рабочего помощника Athena: вчера вы объяснили ему, кто отвечает за проект и как создаются пространства для новых клиентов, а сегодня он снова просит всё рассказать. Именно так агенты Athena первоначально работали без постоянной памяти: отдельный разговор мог быть полезным, но следующий не сохранял нужного контекста. В статье от 28 февраля 2025 года Tithi Agrawal описывает внутренний опыт с агентом Tia. Её знакомили с реальными рабочими процессами через беседы, сохраняли сведения в Zep и проверяли, может ли она использовать их позже. Разберём, чем эпизоды отличаются от извлечённых фактов, как устроен временной граф, что показали переключатели памяти и почему заявленные результаты ещё нельзя считать доказательством качества при массовом использовании.
Материал полезен разработчикам LLM-агентов, персональных и корпоративных помощников, которым нужно сохранять контекст между сессиями. Особенно важны разделение записи и использования памяти, работа с меняющимися фактами и осторожная оценка внутренних экспериментов.
Статья · на английском
Enhancing Athena Agents with Persistent Memory — A Case StudyTithi Agrawal · Опубликовано: 28 февраля 2025 г.
Почему Athena забывала предыдущие разговоры
Представим рабочего ИИ-помощника, которому однажды объяснили, какие письма вы предпочитаете, как устроена ваша команда и какие задачи вы ведёте. Пока эти сведения находятся в текущем диалоге, помощник может на них опираться. Но если следующий разговор начинается без доступа к прежней истории, пользователю приходится повторять то же самое. Именно такую проблему описывает Athena Intelligence: её агенты первоначально не сохраняли сведения, сообщённые в предыдущих сессиях.
На первом снимке пользователь сообщает Athena имя, место проживания — Нью-Джерси — и любимый цвет, фиолетовый. В текущем разговоре агент использует эти сведения. Но в следующей сессии на вопросы о месте проживания и цвете отвечает, что такой информации у него нет. Пользователю приходится повторять уже сказанное.
Постоянная память нужна именно для такой непрерывности: агент может учитывать предпочтения, прошлые задачи и исправления, не заставляя пользователя каждый раз восстанавливать контекст. Автор связывает это с более естественным общением, персонализацией и постепенным укреплением доверия.
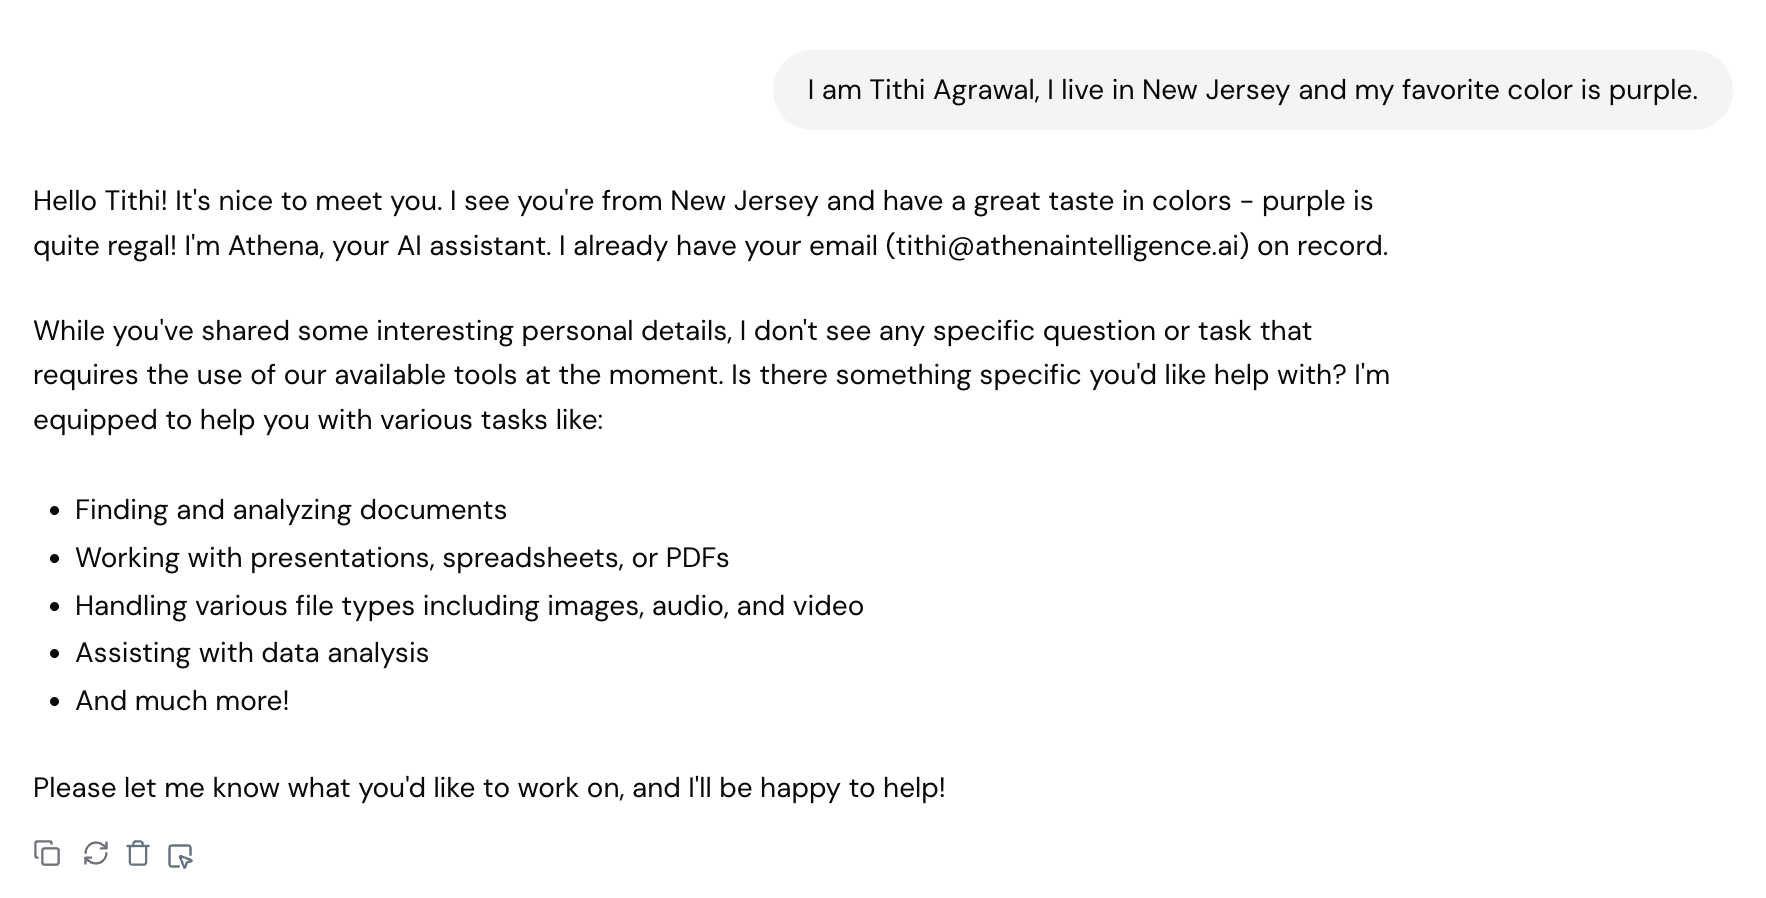
Первый разговор без постоянной памяти: пользователь сообщает агенту сведения о себе.
Источник: Оригинальная иллюстрация · Athena Intelligence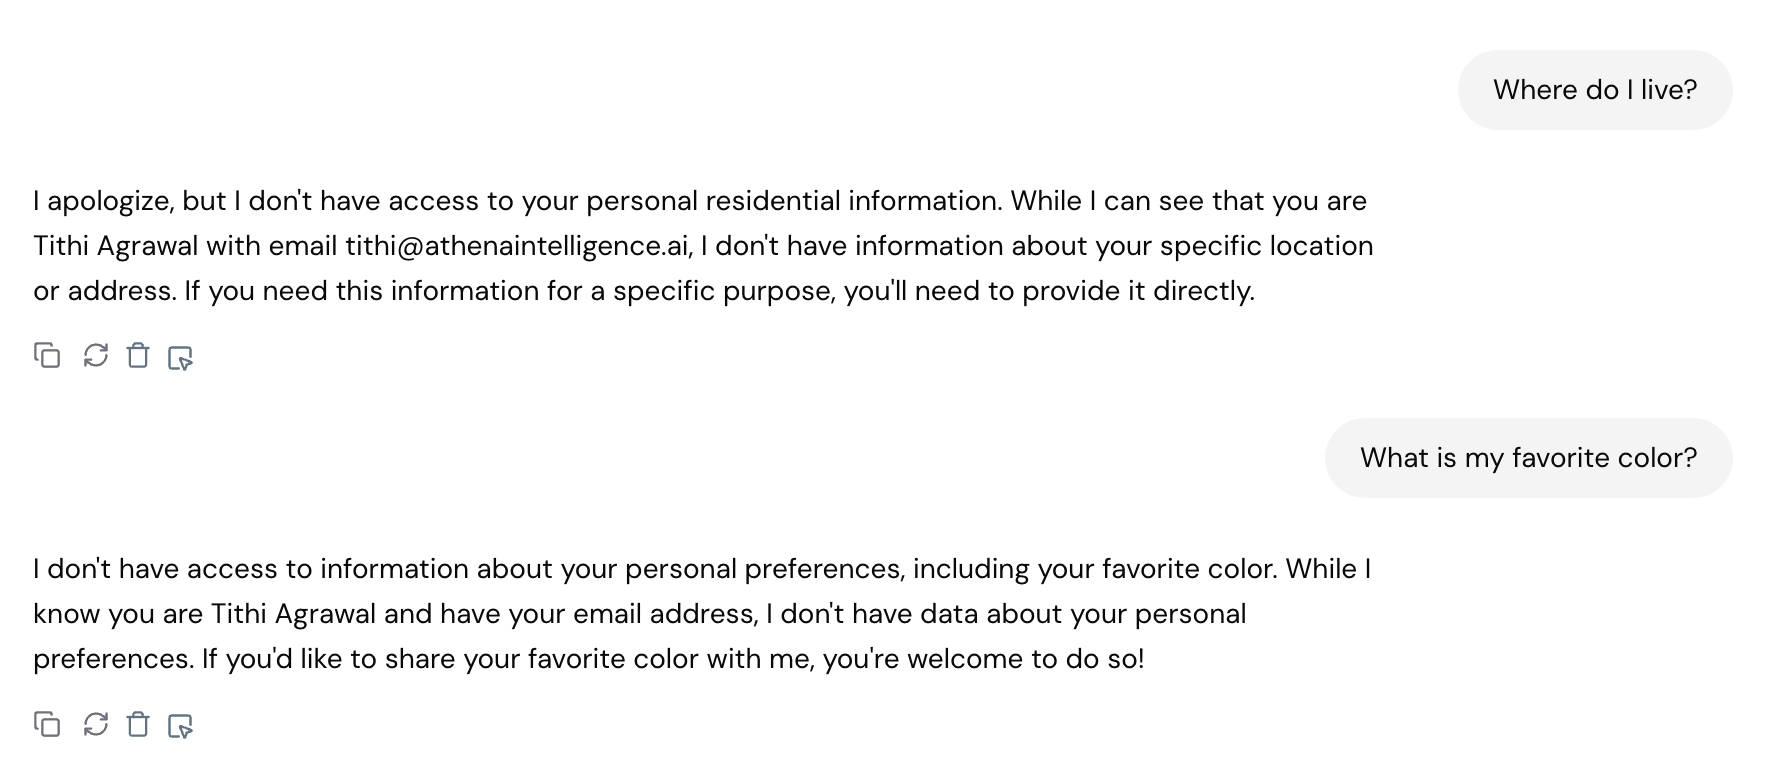
Новая сессия без памяти: агент не может восстановить сообщённые ранее сведения.
Источник: Оригинальная иллюстрация · Athena IntelligenceПочему обычного ответа недостаточно для длительной задачи
Та же проблема становится серьёзнее в проекте, где важно помнить не только факты о человеке, но и уже принятые решения. В статье приведён пример: пользователь просит составить стратегический план поиска инвестиционных возможностей среди технологических компаний средней капитализации. Athena даёт общий план — определить цели и допустимый риск, провести исследование рынка и выполнить дальнейшие шаги.
Позже пользователь спрашивает, какие этапы они уже прошли и с чего продолжать сегодня. Без доступа к прежним сессиям агент не восстанавливает ход работы: он просит заново предоставить документ, заметки или перечисление выполненных шагов. Сам по себе первоначальный хороший план не решает задачу продолжения — для неё нужны сведения о ходе работы и его изменениях.
На иллюстрациях виден переход от подробного первого плана к просьбе заново предоставить материалы. Автор отмечает, что забывание мешает учитывать прежние решения, возвращаться к уже найденным подходам и замечать повторяющиеся темы. Для длительной работы важно сохранять не только исходную задачу, но и ход её выполнения.
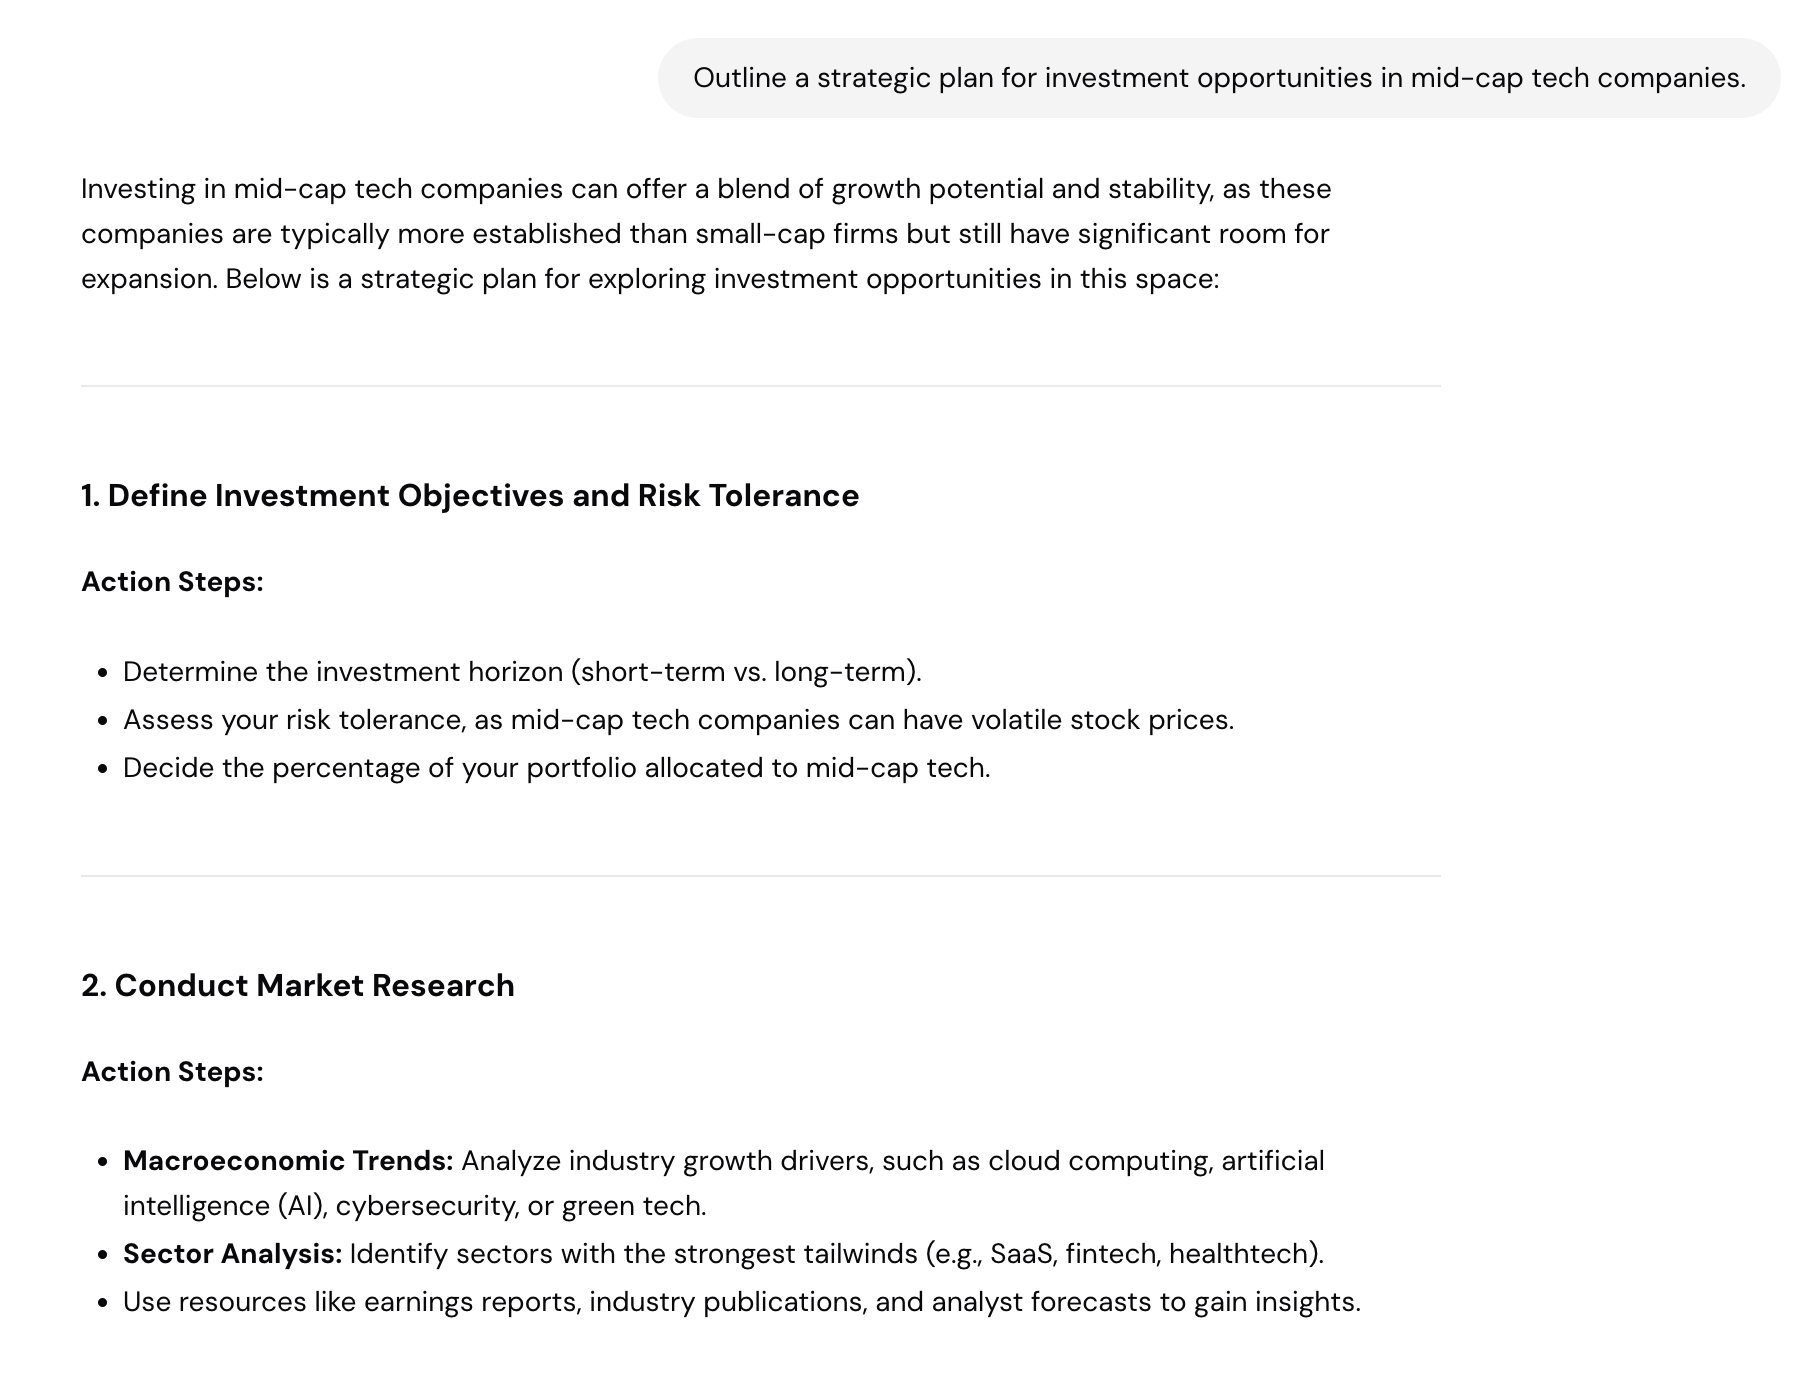
Без постоянной памяти агент предлагает общий план работы над длительным проектом.
Источник: Оригинальная иллюстрация · Athena Intelligence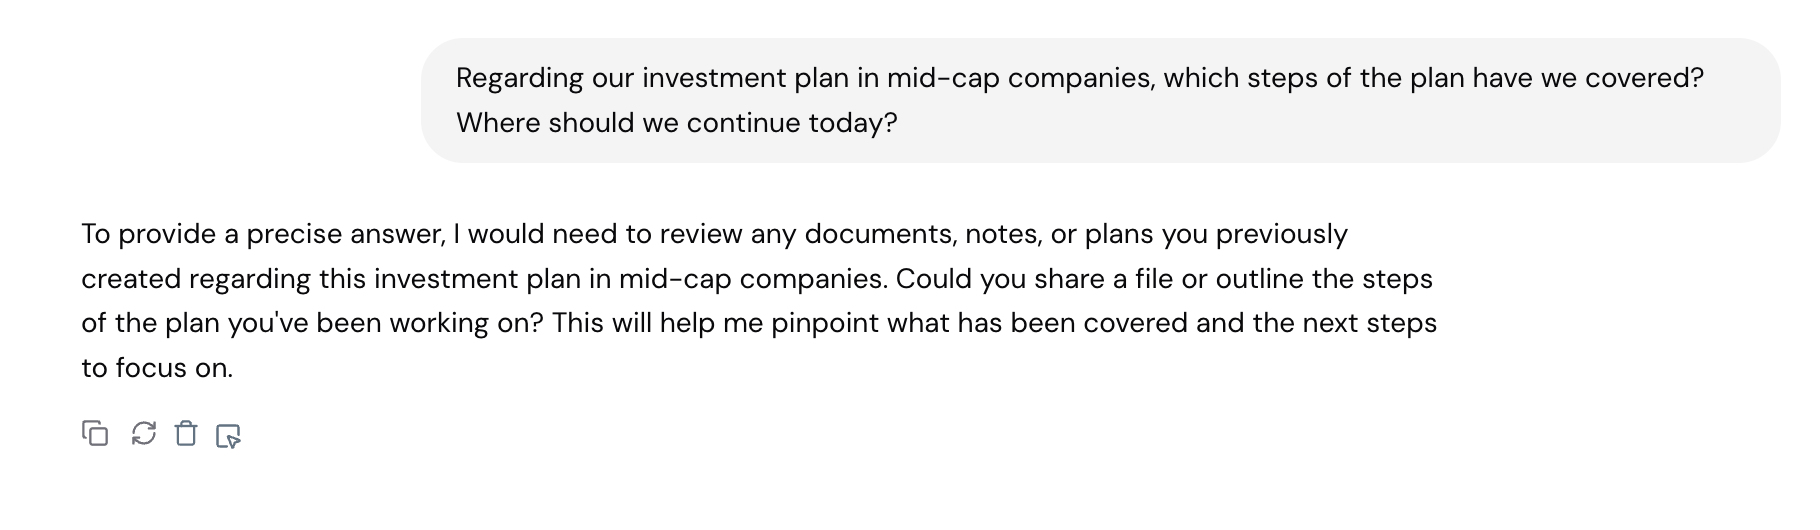
При продолжении проекта агент без памяти не знает, какие шаги уже были выполнены.
Источник: Оригинальная иллюстрация · Athena IntelligenceИстория сессии, эпизоды и обобщённые факты — разные вещи
Athena подключила слой памяти Zep. В статье выделены два вида долговременных записей. Эпизодическая память (episodic memory) сохраняет конкретное событие взаимодействия: исходное сообщение, текст, файл или JSON и время события. Семантическая память (semantic memory) хранит извлечённые из подобных эпизодов сущности, факты и связи между ними. Это не одно и то же, что история сообщений, показанная модели в текущем диалоге: история сессии помогает ответить прямо сейчас, а постоянная память должна переживать границу между диалогами.
Первый пример — любимый цвет. В текущей сессии фраза «мой любимый цвет — фиолетовый» доступна среди сообщений. Если сохранить её в Zep вместе со временем, получится эпизод: можно восстановить, что именно и когда сказал пользователь. Из него можно извлечь семантический факт: «пользователь предпочитает фиолетовый». Для будущих ответов такой факт удобнее дословной реплики; если предпочтение изменится, понадобятся и новые сведения.
Второй пример — рабочий процесс. Во время знакомства с Tia автор рассказывает, что при заведении пространства для нового клиента загружают стандартные папки и материалы. Разговор, в котором это объяснили, — текущая история; сохранённая реплика с моментом её получения — эпизод; извлечённая связь «создание клиентского пространства предполагает подготовку стандартных папок и материалов» — семантическое знание. Поэтому позднее Tia может учитывать описанный ранее порядок работы, даже если пользователь не повторил его целиком.
Семантическая память не означает, что агент самостоятельно проверил истинность извлечённых сведений. Она помогает повторно использовать сказанное раньше. Также не стоит называть любую систему поиска документов долговременной персональной памятью: здесь существенны межсессионное накопление взаимодействий, извлечение фактов о пользователе и рабочих процессах и последующее использование этих фактов.
Background; What are Memories?Зачем Zep строит граф с учётом времени
Вместо одного бесконечного текста истории Zep представляет знания как граф. Вершины обозначают сущности или фрагменты памяти, а рёбра — отношения между ними. Автор перечисляет эпизодические вершины с исходными данными, семантические вершины с извлечёнными сущностями и их описаниями, а также вершины сообществ (community nodes), объединяющие тесно связанные сущности. Граф нужен, чтобы находить не только отдельное упоминание, но и связь между разрозненными беседами.
Ключевое дополнение — время. У связи можно сохранить период её действительности и момент, когда она перестала быть верной. Например, сначала сотрудник отвечал за направление, а позже перешёл на другую роль. Оба разговора остаются частью истории, но для вопроса о текущих обязанностях нужна актуальная связь.
Поэтому важно различать два времени: когда система узнала факт и когда описанное отношение действительно существовало. Временной граф позволяет хранить изменения, не стирая историю прежних состояний, и учитывать их при поиске воспоминаний.
Temporal Knowledge GraphsКак сведения из разговоров превращаются в память
Построение памяти — отдельный путь обработки данных, а не действие, которое непременно нужно заново выполнять при каждом вопросе. Zep принимает эпизоды: сообщения, расшифровки разговоров или файлы. При записи к ним добавляются временные сведения. Затем система извлекает сущности и отношения: например, кто входит в команду, чем занимается и как устроен рабочий процесс.
Из полученных сведений Zep строит связанную структуру. Эпизодический подграф хранит исходные данные, семантический — извлечённые и сопоставленные сущности и факты, а подграф сообществ объединяет тесно связанные сущности. При пополнении графа система учитывает появление и утрату актуальности отношений.
- 01
Получить эпизод
Zep принимает сообщение, текст, файл или другой описанный в статье входной материал и сохраняет сведения о времени.
- 02
Выделить сведения
Из эпизода извлекаются сущности и утверждения об отношениях между ними.
- 03
Собрать граф
Исходные эпизоды, обобщённые сущности и группы связанных сущностей организуются в три подграфа.
- 04
Учесть изменения
Для отношений отслеживаются временные характеристики, включая утрату актуальности.
Здесь «извлечение» означает выделение фактов из ранее сказанного, а не поиск ответа в момент нового пользовательского запроса. Эта разница пригодится ниже: накопление можно разрешить или запретить отдельно от использования уже сохранённых воспоминаний.
How do Memories work?Как память используется при новом вопросе
Когда поступает новый запрос, агенту не нужно помещать в контекст модели всю накопленную историю. Слой памяти ищет подходящие вершины и связи графа, а затем уточняет порядок результатов. В описании Zep упомянуты косинусное сходство векторных представлений и полнотекстовый поиск; повторное ранжирование помогает поднять наиболее уместные воспоминания.
Выбранные воспоминания передаются агенту как дополнительный контекст для языковой модели. Поэтому система может ответить с учётом прошлого диалога, а не полагаться исключительно на текущую реплику. Поиск памяти здесь отличается от обычного RAG по корпоративным документам: часть разыскиваемых данных возникла из предыдущих взаимодействий с пользователем и была преобразована в эпизоды и факты. При этом наличие поисковой операции само по себе ещё не делает любую RAG-систему персональной памятью.
На исходной схеме агент Athena обменивается запросами и ответами с поставщиком языковой модели, получает сообщения и другие данные, а также отдельно обращается за подходящими воспоминаниями. Так видно основное разделение: память накапливается вне языковой модели и добавляется к её контексту, когда это нужно для ответа.
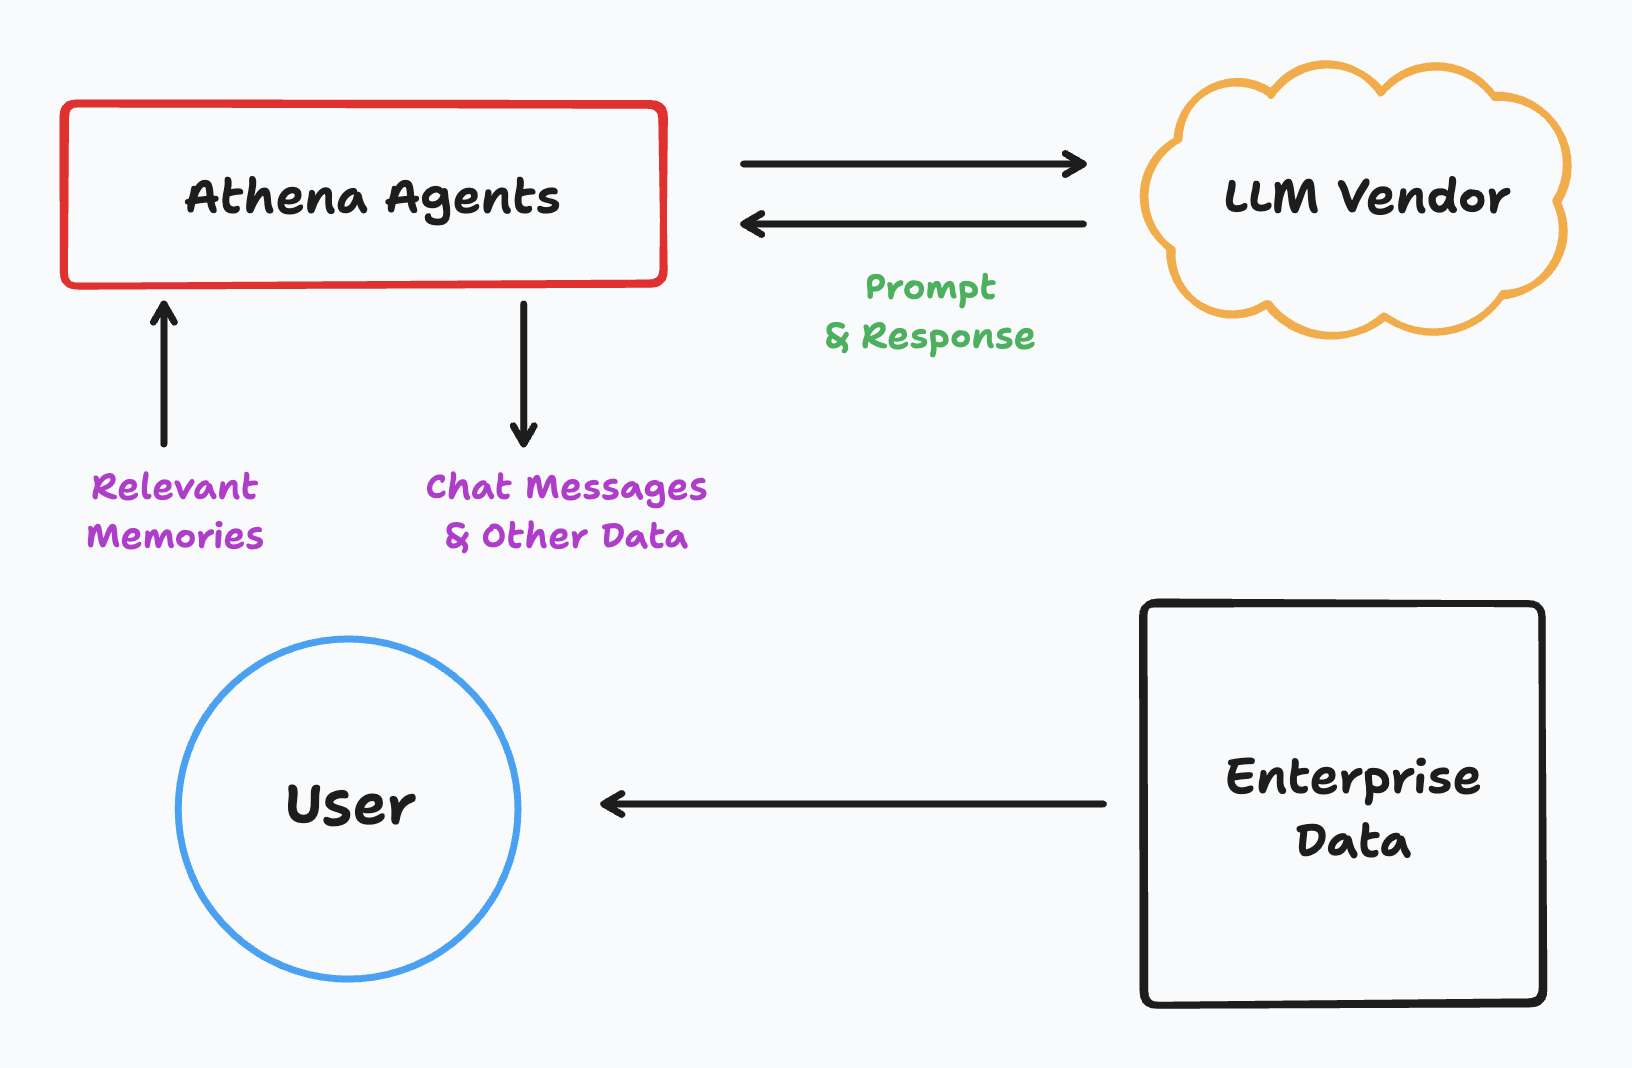
Схема Athena: сообщения, корпоративные данные и выбранные воспоминания поступают в контекст языковой модели.
Источник: Оригинальная иллюстрация · Athena IntelligenceКак автор познакомил Tia со своей работой
Для исследования автор создала в Athena агента Tia, который должен был помогать ей в повседневной работе. Знакомство началось с разговоров о её обязанностях и компании. В статье это названо training, но Tia не обучали изменением весов языковой модели: Zep сохранял диалоги и постепенно пополнял граф знаний.
В первом цикле автор рассказала о своих обязанностях в Athena Intelligence, самой компании, сотрудниках и их задачах. Из этих разговоров возник первоначальный граф. На снимке видны сущности и подписанные связи между человеком, его ролью, компанией и видами помощи, которые может оказывать агент.
Во втором цикле Tia рассказали, как создают рабочие пространства для новых клиентов: в них добавляют типовые папки и относящиеся к клиенту материалы. Далее в разговоры вошли работа над внутренней документацией, маркетинговые публикации для LinkedIn, Twitter, блогов и рассылок, сведения о клиентах Athena Intelligence и автоматизируемых для них процессах. Источник показывает промежуточные состояния графа, а в конце — итоговую визуализацию.
На последнем приложенном снимке граф заметно плотнее: вокруг общих понятий собрались новые связи, появились и отдельные небольшие группы. Изменение хорошо показывает, как последовательные разговоры расширяли рабочий контекст Tia.
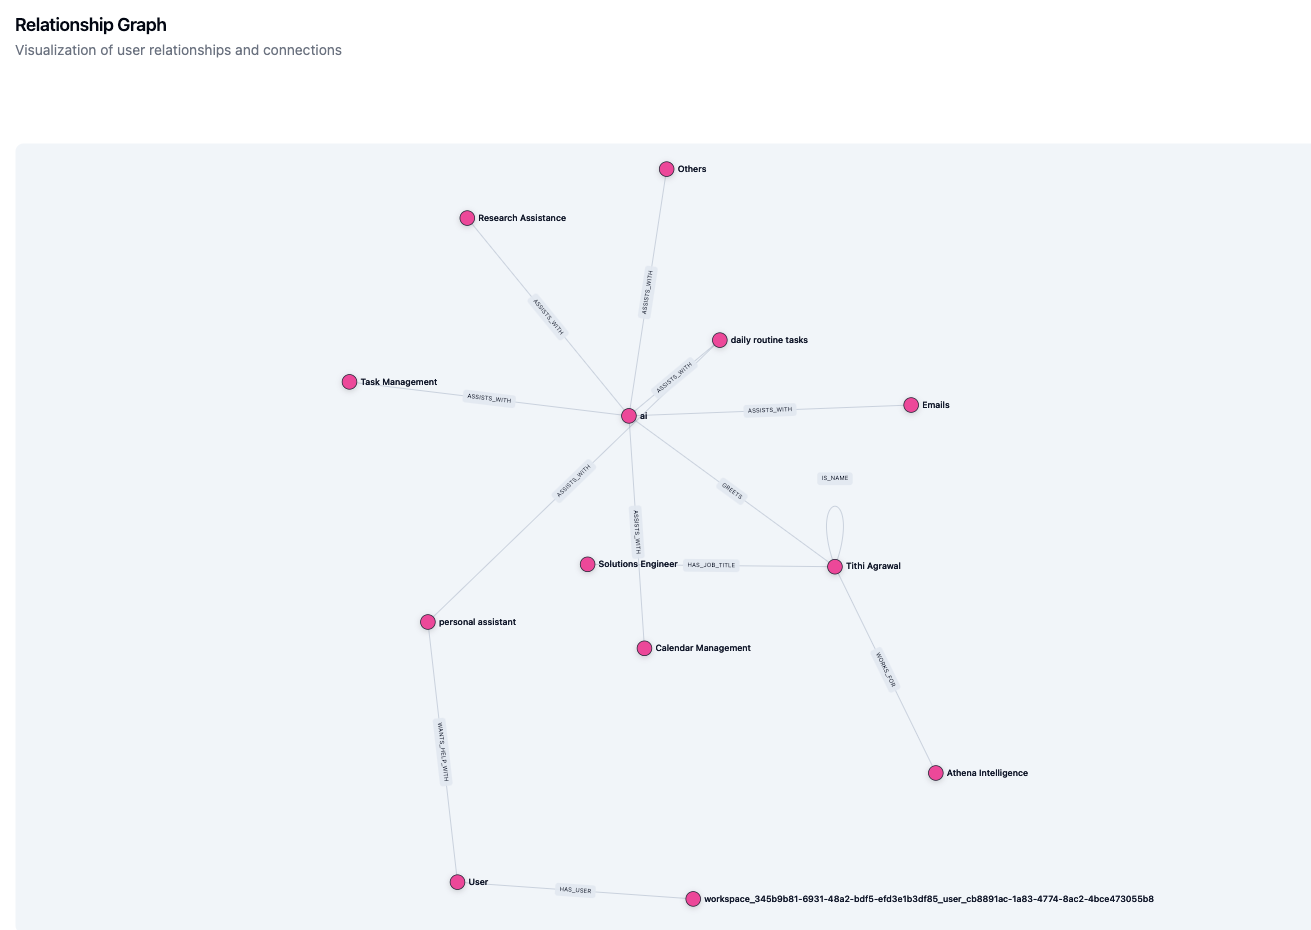
Граф после первого этапа знакомства Tia с рабочим контекстом автора.
Источник: Оригинальная иллюстрация · Athena Intelligence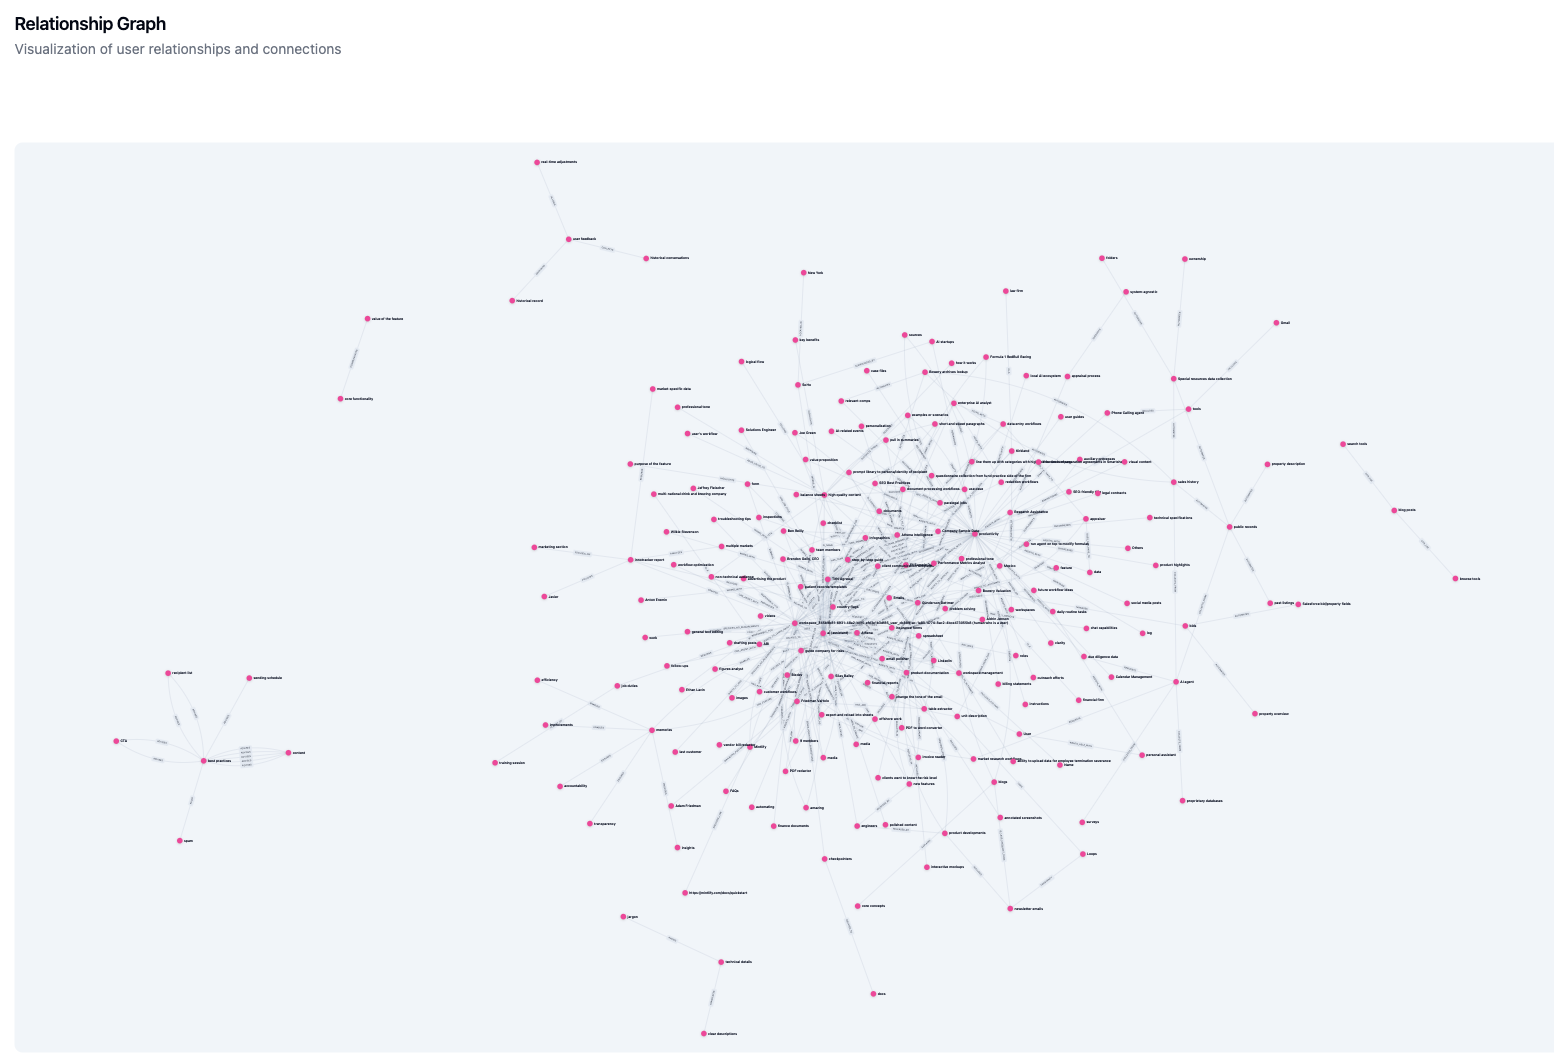
Граф после нескольких этапов знакомства с процессами и командой. Рост графа сам по себе не измеряет качество ответов.
Источник: Оригинальная иллюстрация · Athena IntelligenceПроверка: новое рабочее пространство для клиента
После знакомства с рабочими процессами автор стала задавать Tia практические вопросы. Один из них — помочь создать пространство для гипотетического клиента, юридической фирмы. В ответ Tia обращается к воспоминаниям о создании рабочих пространств, организации документов и первичной настройке работы юридической фирмы; затем предлагает структуру папок для практик, клиентских дел, шаблонов, справочных материалов и административных задач.
На снимке видны обращения к поиску воспоминаний, предложенная структура папок и отметка интерфейса «New Folder created». При этом юридическая фирма в запросе названа гипотетическим клиентом. Пример показывает, как Tia использует прежние сведения при составлении плана и выполнении отдельного действия.
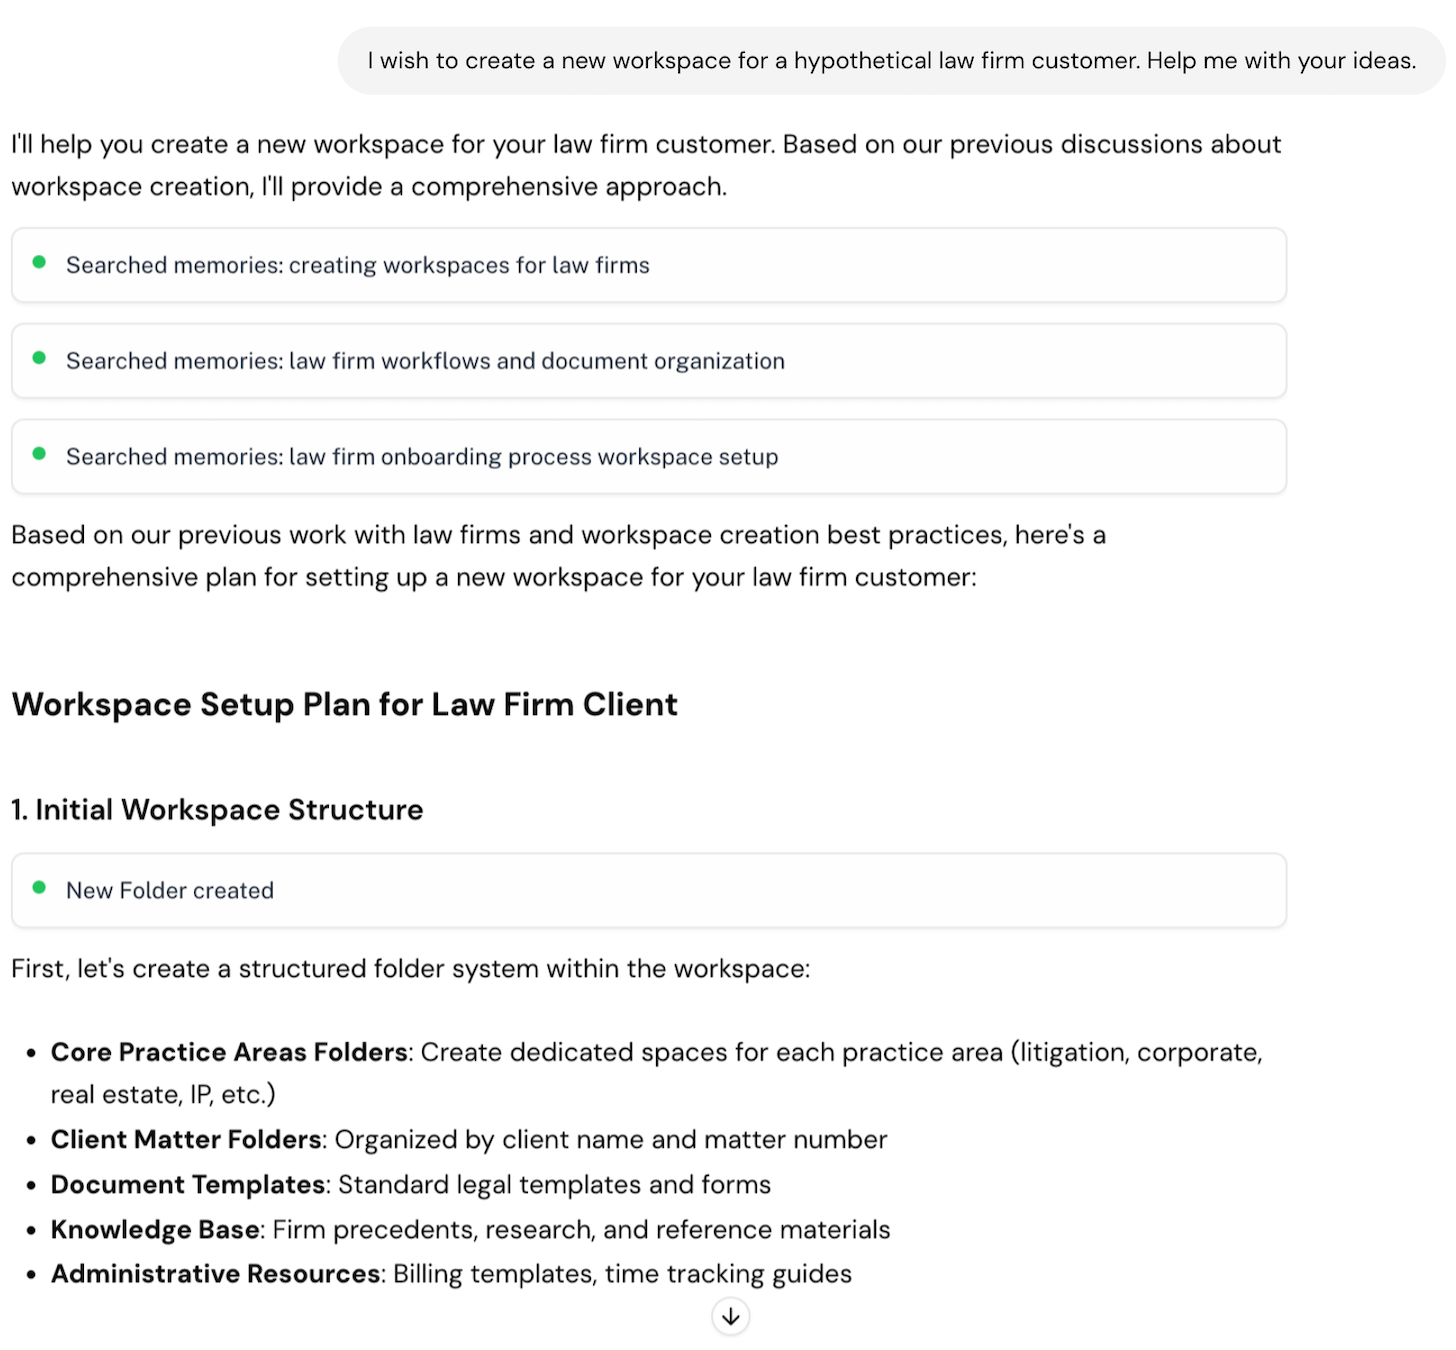
Внутренний эксперимент: Tia ищет воспоминания при подготовке нового рабочего пространства.
Источник: Оригинальная иллюстрация · Athena IntelligenceПроверки знания команды и подготовки документации
Затем автор проверяла, что Tia помнит о сотрудниках Athena Intelligence: кто какую роль занимает и за какие задачи отвечает. Такие сведения полезны в повседневной работе, когда вопрос касается не общих знаний, а конкретной команды и распределения обязанностей.
Ещё одна задача — подготовить текст официальной документации Athena Intelligence. Автор оценивала, насколько ответы точны, ясны и соответствуют принятому в компании стилю. Здесь память помогает учитывать не только факты, но и ранее обсуждённые правила и рабочий контекст при создании текста.
Таким образом, в проверках память использовали по-разному: для создания рабочего пространства, ответов о сотрудниках и подготовки документации. Во всех трёх случаях Tia должна была применить сведения, полученные в предыдущих разговорах, к новой просьбе.
Testing Tia’s KnowledgeДва переключателя: собирать сведения или использовать их
В интерфейсе Athena автор показывает два отдельных переключателя. Memory Collection отвечает за накопление памяти из взаимодействий: новые сведения могут попадать в историю и граф. Memory Injection отвечает за подачу ранее сохранённых сведений в контекст ответа. Это разные операции. Можно продолжать сохранять новые события, но не позволять агенту вспоминать их при ответе; обратный режим тоже был предусмотрен как отдельная комбинация для проверки.
В статье слово Collection местами описывает работу с историей разговоров в широком смысле. В настройках и проверках разделение конкретнее: Collection отвечает за накопление новых сведений, Injection — за добавление сохранённых воспоминаний в будущий ответ.
На оригинальном снимке оба переключателя включены. Пользователь может отдельно остановить сохранение новых разговоров или запретить обращение к ранее собранной памяти при ответе. Это позволяет управлять двумя разными этапами работы агента.
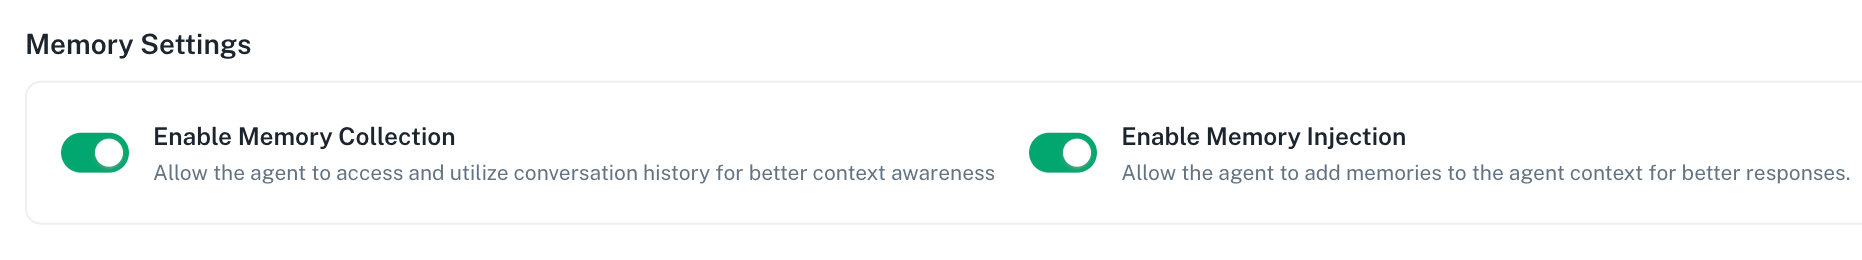
Два независимых переключателя: сбор воспоминаний и их использование в следующих ответах.
Источник: Оригинальная иллюстрация · Athena IntelligenceЧетыре сочетания настроек и что удалось проверить
У двух переключателей четыре возможных сочетания. Автор проверила три из них; четвёртое — подача памяти без нового сбора — не удалось воспроизвести в использованной настройке. Ниже все четыре режима и результаты проверок.
Таблицу можно прокрутить по горизонтали.
В третьем варианте автор сообщает о поездках команды во Францию, Сан-Франциско, Детройт и Колумбус. На первом снимке Tia реагирует на это сообщение, но при новом вопросе о посещённых направлениях отвечает, что для уточнения ей понадобятся письма, календарь или другие материалы. Это иллюстрация того, что получение реплики сейчас и доступность её в будущих ответах — не одно и то же. В статье прямо сказано, что функцию search_memories выключили.
В четвёртом варианте речь заходит о DataStax. Автор описывает сведения о партнёрстве, а на снимке спрашивает, участвовала ли Athena в мероприятии DataStax. Поскольку сбор и подача памяти отключены, Tia вместо обращения к прежним разговорам выполняет несколько поисков в интернете. Здесь показан именно выбор источника ответа, а не установление факта участия.
Для второго сочетания возникло ограничение настройки: включённая Injection автоматически вызывала Collection response в формате, удобном для языковой модели. Поэтому отдельно проверить чтение сохранённой памяти при выключенном сборе новых сведений автор не смогла.
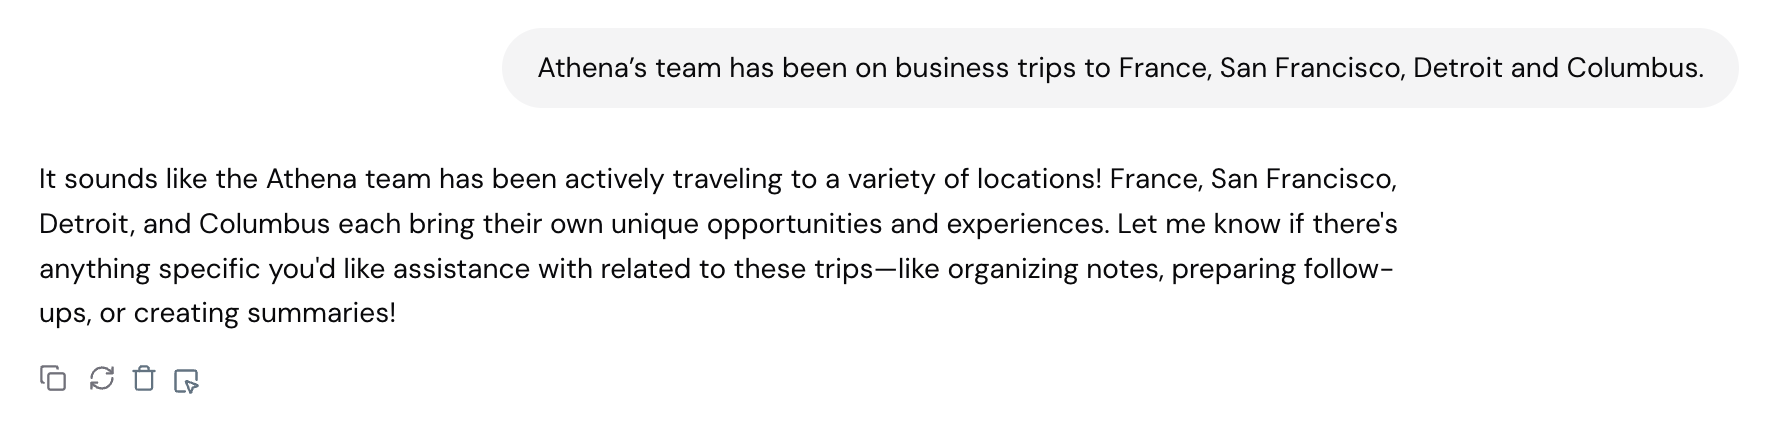
При включённом сборе и отключённом использовании агент получает сведения о поездках.
Источник: Оригинальная иллюстрация · Athena Intelligence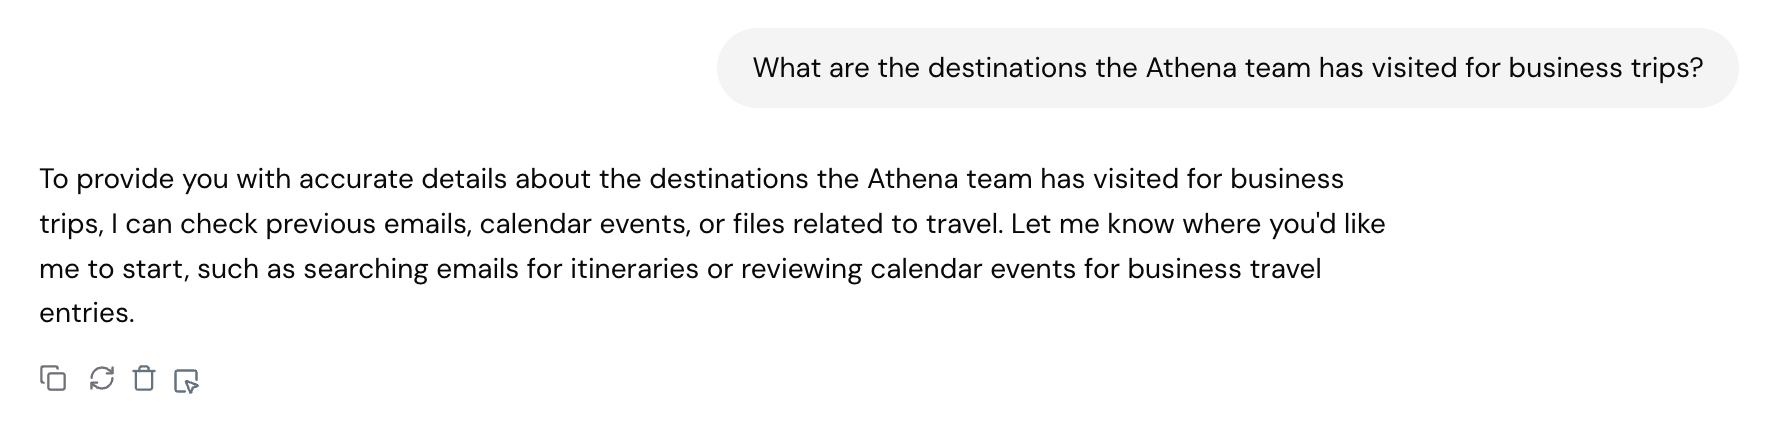
В следующем вопросе агент не использует сохранённые сведения, когда поиск воспоминаний отключён.
Источник: Оригинальная иллюстрация · Athena Intelligence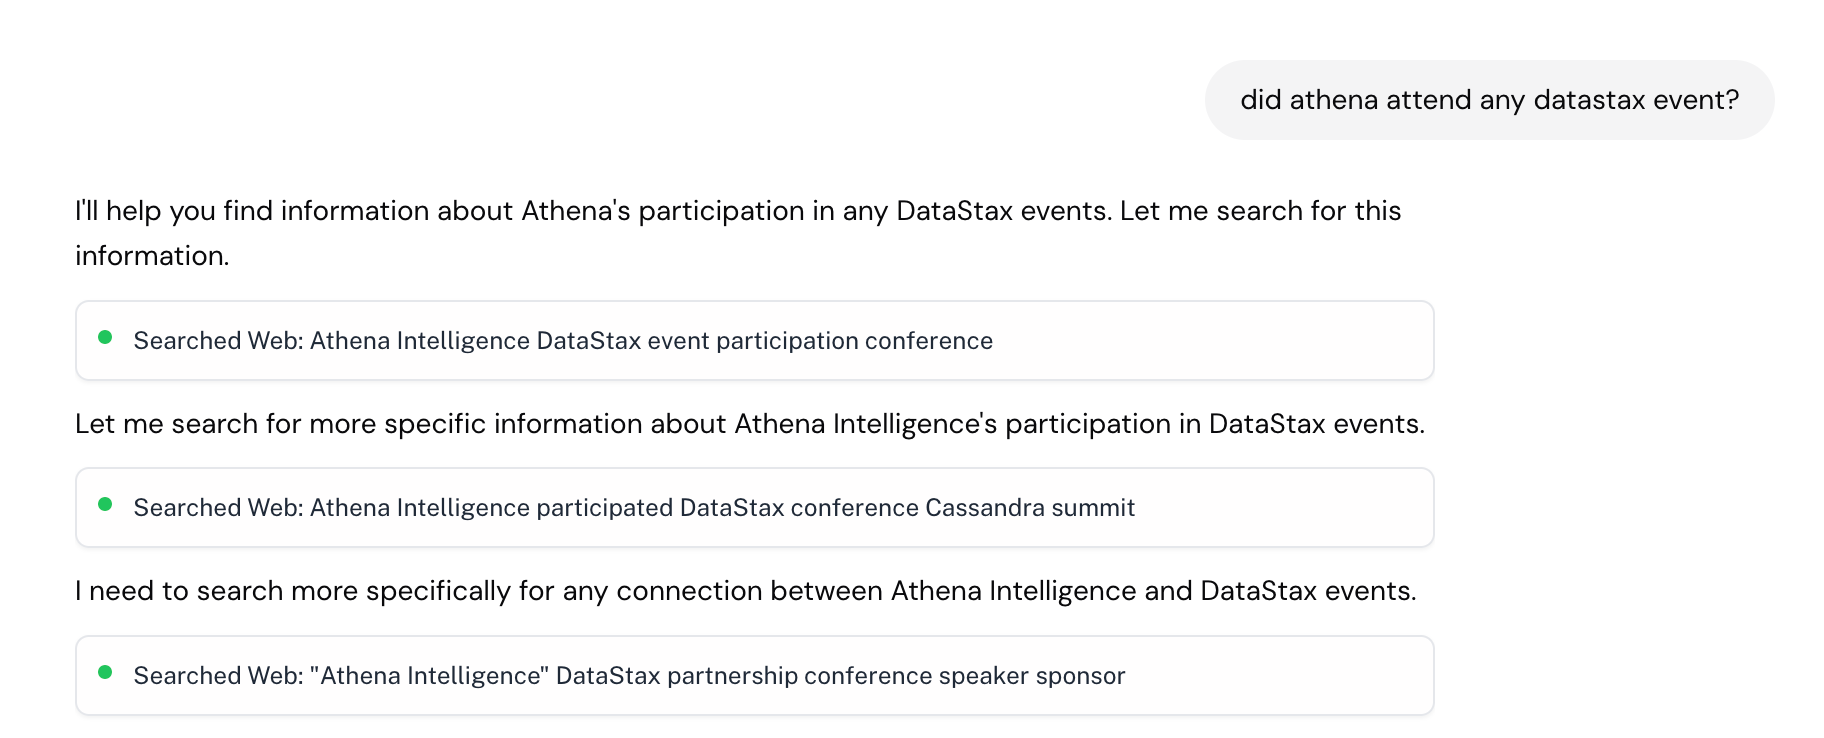
При отключённых сборе и использовании памяти агент вместо воспоминаний обращается к внешнему поиску.
Источник: Оригинальная иллюстрация · Athena IntelligenceЧто означают заявленные 97% и 91%
Автор приводит два результата внутренних проверок Tia. При ответах с использованием накопленных воспоминаний заявлена точность 97%. В отдельной задаче агент исправил 91% несоответствий в файле, опираясь на память. Первая оценка относится к вопросам по прошлым разговорам, вторая — к исправлению противоречий в документе.
Знаменатели обеих оценок и процедура подсчёта не раскрыты: неизвестны число вопросов и расхождений, критерии правильного ответа, способ проверки исправлений и контрольный результат без памяти. Поэтому 97% и 91% следует читать как сообщённые автором результаты этого опыта, а не как ожидаемую точность на других задачах.
Observations; Performance MetricsЧто показывает граф за три часа — и чего не показывает
За три часа знакомства Tia с рабочими процессами граф вырос с 13 вершин и 12 связей примерно до 160 вершин и 220 связей. Первые значения автор приводит точно, конечные — приблизительно. Это показывает, как быстро разговоры пополняли структуру памяти.
На оригинальном графике две серии — Nodes и Edges — соединяют начальное состояние и состояние через три часа. Он показывает увеличение числа вершин и связей; качество найденных воспоминаний оценивается отдельно, по ответам агента.
Более того, рост сам по себе подводит автора к следующей проблеме: чем плотнее граф, тем больше нерелевантных связей может попадать в поиск. Поэтому число вершин — полезная характеристика накопления информации, но без отдельной проверки выдаваемых воспоминаний не становится метрикой полезности памяти.
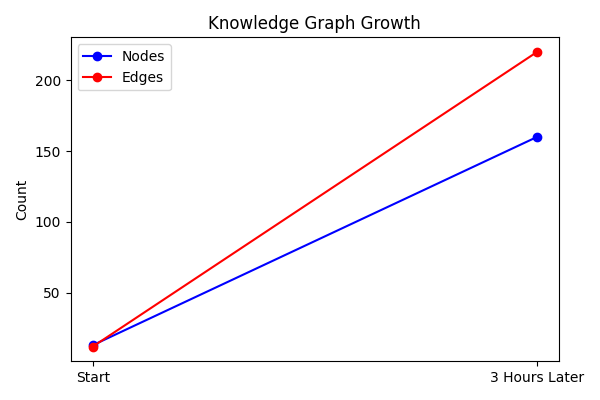
Заявленный рост графа за три часа: приблизительно от 13 до 160 узлов и от 12 до 220 связей. Это наблюдение внутреннего эксперимента.
Источник: Оригинальная иллюстрация · Athena IntelligenceКакие свойства системы автор наблюдала качественно
Автор выделяет четыре группы наблюдений. Во-первых, Tia могла обращаться к материалам прежних разговоров и не всегда требовала повторного объяснения. Во-вторых, связанные вершины и рёбра давали способ собирать сведения из разных сообщений в общую картину. В-третьих, агент мог связывать части истории без прямой просьбы пользователя открыть определённую сессию и отвечать с учётом накопленного контекста.
Временная структура позволяет связывать факты с моментом их появления, а также отмечать отношения, которые изменились или перестали действовать. Для помощника, который помнит коллег, проекты и рабочие процессы, это важно: ответ о текущем положении дел должен учитывать обновления, а не только первые упоминания.
Четвёртое наблюдение автор называет Continuous Learning — непрерывным обучением. В опыте Tia это пополнение графа новыми сведениями, сохранение контекста между сессиями и использование прежних взаимодействий в будущих ответах. Речь идёт о накоплении памяти, а не о дообучении параметров языковой модели.
ObservationsГлавная обнаруженная проблема: шум и плотность графа
По мере накопления знаний возникла новая трудность: граф становился всё плотнее, а вместе с полезными воспоминаниями поиск мог возвращать лишние связи и повторяющиеся сведения. Такой шум мешает выбрать контекст, действительно нужный для очередного ответа.
Первое направление дальнейшей работы — управлять объёмом графа. Автор предлагает архивировать редко используемую информацию, оставлять наиболее значимые связи и выстраивать иерархию хранения. Прореживание должно уменьшить количество лишнего контекста, который приходится просматривать при поиске воспоминаний.
Вторая группа — улучшать выбор воспоминаний в момент поиска. Предлагается учитывать свежесть в сравнении с давними сведениями, различать важность типов информации, исключать дубликаты и устаревшие факты, а также рассчитывать оценку соответствия воспоминания конкретному вопросу. Эти направления перекликаются с временной структурой графа: старое утверждение может быть важным для истории проекта, но не подходить для ответа о текущем состоянии.
OpportunitiesГде заканчиваются доказательства этого кейса
История Tia показывает работоспособную для автора идею: разговоры можно сохранять в отдельной памяти, извлекать из них связи и позднее возвращать подходящий контекст агенту. Для этого показаны реальные примеры диалогов, графы и проверки поведения при разных настройках. Но это один описанный внутренний опыт, не отчёт о массовом клиентском внедрении, нагрузочном тесте или подтверждённом изменении бизнес-метрик.
Для переноса подхода на другие задачи предстоит отдельно оценить задержку и стоимость поиска, расход контекста, ошибки извлечения, работу с устаревшими сведениями и сравнение с другими способами хранения истории. Эти вопросы остаются за пределами описанного опыта.
Главный урок кейса — полезная память состоит не только из поиска по прошлым сообщениям. Нужно сохранять эпизоды и факты, учитывать изменения во времени, отдельно управлять записью и подачей сведений и проверять, какой контекст действительно помогает отвечать.
MethodologyИтог: как Tia использует память между разговорами
Внутренний опыт Athena Intelligence показывает, как агент Tia перестал зависеть только от текущего разговора. Автор знакомила его со своими обязанностями, командой, созданием клиентских пространств, документацией и рабочими процессами. Эти сведения сохранялись через Zep в виде эпизодов и извлечённых связей между сущностями. Подготовка памяти — отдельный процесс: новые сообщения записываются, из них выделяются факты, а граф пополняется с учётом времени. Ни обучения весов LLM, ни постоянного помещения всей истории в каждый запрос статья не описывает.
- 01
Получить вопрос
Tia принимает запрос пользователя, которому могут понадобиться сведения из предыдущих сессий.
- 02
Найти воспоминания
Слой Zep ищет относящиеся к вопросу эпизоды, вершины и связи накопленного графа.
- 03
Уточнить результаты
Поиск и повторное ранжирование отбирают более подходящий контекст; временные сведения помогают различать меняющиеся факты.
- 04
Добавить контекст
При включённой Memory Injection выбранная память передаётся агенту вместе с текущей задачей.
- 05
Сформировать ответ
Языковая модель использует полученные сведения; сам факт их подачи не гарантирует правильности.
Автор демонстрирует помощь с рабочим пространством, знания о команде и подготовку документации. Для ответов с памятью заявлены 97% accuracy, для исправления несоответствий в файле — 91%, но выборки и протоколы подсчёта не раскрыты. За три часа граф вырос с 13 вершин и 12 связей примерно до 160 и 220 соответственно; это рост объёма знаний, не доказательство их качества. Одна из четырёх комбинаций переключателей осталась непроверенной. Плотность графа уже создаёт риск шума, а прореживание, архивирование и более точный выбор воспоминаний названы планами. Следовательно, статья подтверждает ограниченный внутренний эксперимент с полезными наблюдениями, а не универсальную точность или масштабное внедрение.
Conclusion