Разбор готов
Т-Банк — Commodity LLM: массовый инференс и организация сервисов
В Т-Банке продуктовые команды обращаются к общему внутреннему сервису языковых моделей. Он позволяет обрабатывать чувствительные данные внутри компании, запускать собственные модели и управлять задержкой ответа. Первую версию удалось быстро построить на мощных GPU и готовых библиотеках, но собственный токен обходился в среднем в четыре–пять раз дороже покупки через OpenRouter. Александр Мисевич показывает, почему одинаковый программный стек не гарантирует одинаковую цену: многое зависит от повторного использования контекста, маршрутизации, устойчивости инфраструктуры и очередей. Разберём эксперименты, неудачные подходы, измеренные компромиссы и то, как команда ускорила выбор и выпуск новых моделей.
Инженерам ML-инфраструктуры, разработчикам LLM-сервисов и техническим руководителям, которым важно совместить экономию GPU, требования к задержке, доступность и скорость выпуска моделей.
Видео · на русском
Commodity LLM: как мы строим инфраструктуру и процессы для массового инференса LLMАлександр Мисевич · Т-Банк · Опубликовано: 19 сентября 2026 г.
Исходный доклад · Открыть оригинал
Зачем банку собственный сервис
Автор начинает с опыта оптимизации CPU в Intel, обучения и инференса в Huawei; с 2022 года, по его словам, занимается оптимизацией AI-моделей в Т-Банке вместе с командой. Commodity LLM описан как общий внутренний сервис: команда разворачивает популярные модели, которыми могут пользоваться другие команды компании.
Требование оставлять чувствительные данные внутри компании — исходное ограничение, названное докладчиком. Собственная инфраструктура позволяет запускать дообученные модели и непопулярные открытые модели, отсутствующие в каталоге внешнего поставщика.
Сервис диверсифицирует риск недоступности облачных API. Команда сохраняет компетенции обучения, дообучения, проверки, оптимизации и развёртывания, а также контролирует компромисс между задержкой, скоростью и доступностью.
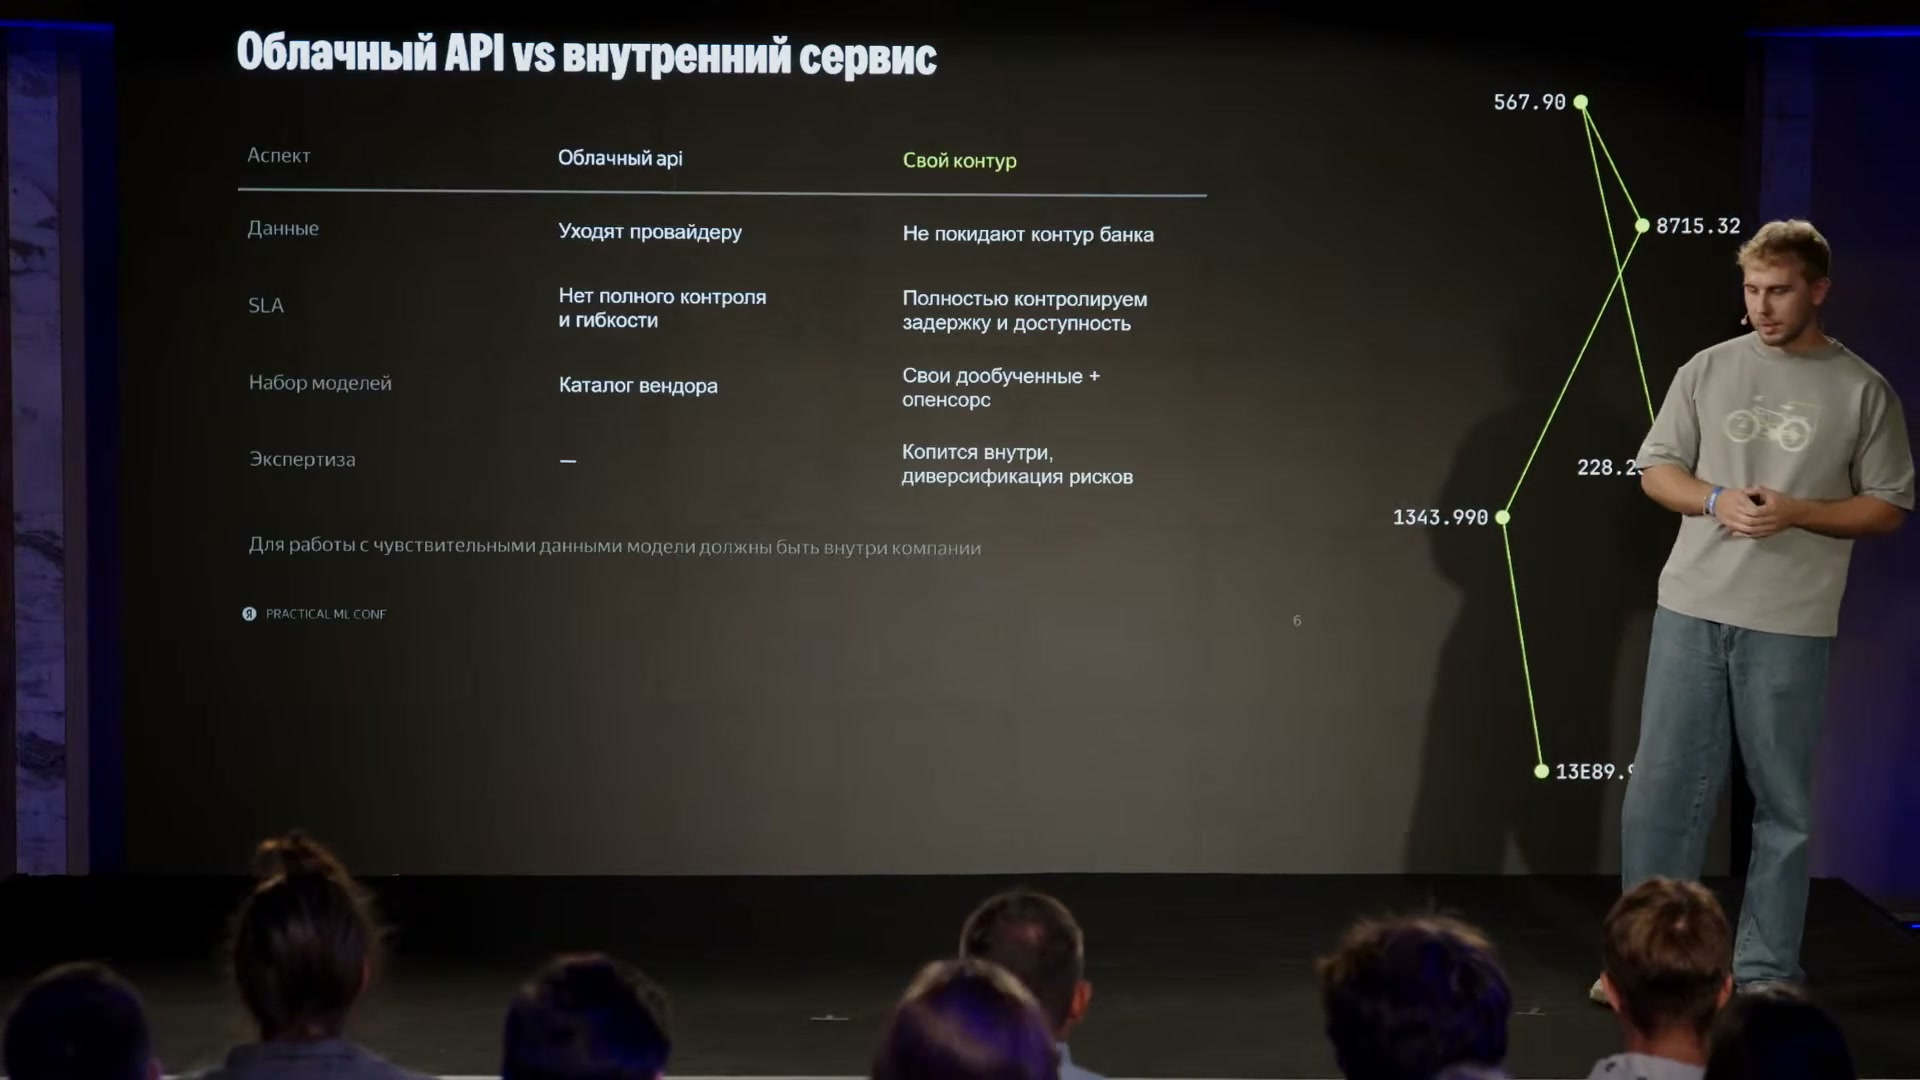
Команда сравнивает облачный API и собственный сервис по доступности, SLA, конфигурации и срокам поддержки моделей.
Источник: Т-Банк · исходный докладПочему свой токен оказался дороже
Команде требовался быстрый запуск. Она взяла производительное оборудование, экосистему NVIDIA, готовые вычислительные ядра и движки инференса; автор также отмечает доступность открытых рецептов для разных моделей, карт и типов нагрузки. Первоначальная схема: развернуть модели и открыть пользователям доступ через прокси. Функционально она работала, поэтому неэффективность обнаружилась при разборе экономики.
В среднем по всем моделям внутренний инференс стоил в 4–5 раз дороже покупки тех же токенов через OpenRouter; для одной из трёх наиболее потребляемых моделей в первый месяц разрыв достигал 20×. График показывает, как разрыв сокращался за три месяца. Это сравнение с предложениями OpenRouter на дату доклада, а не с сегодняшними тарифами.
Таблицу можно прокрутить по горизонтали.
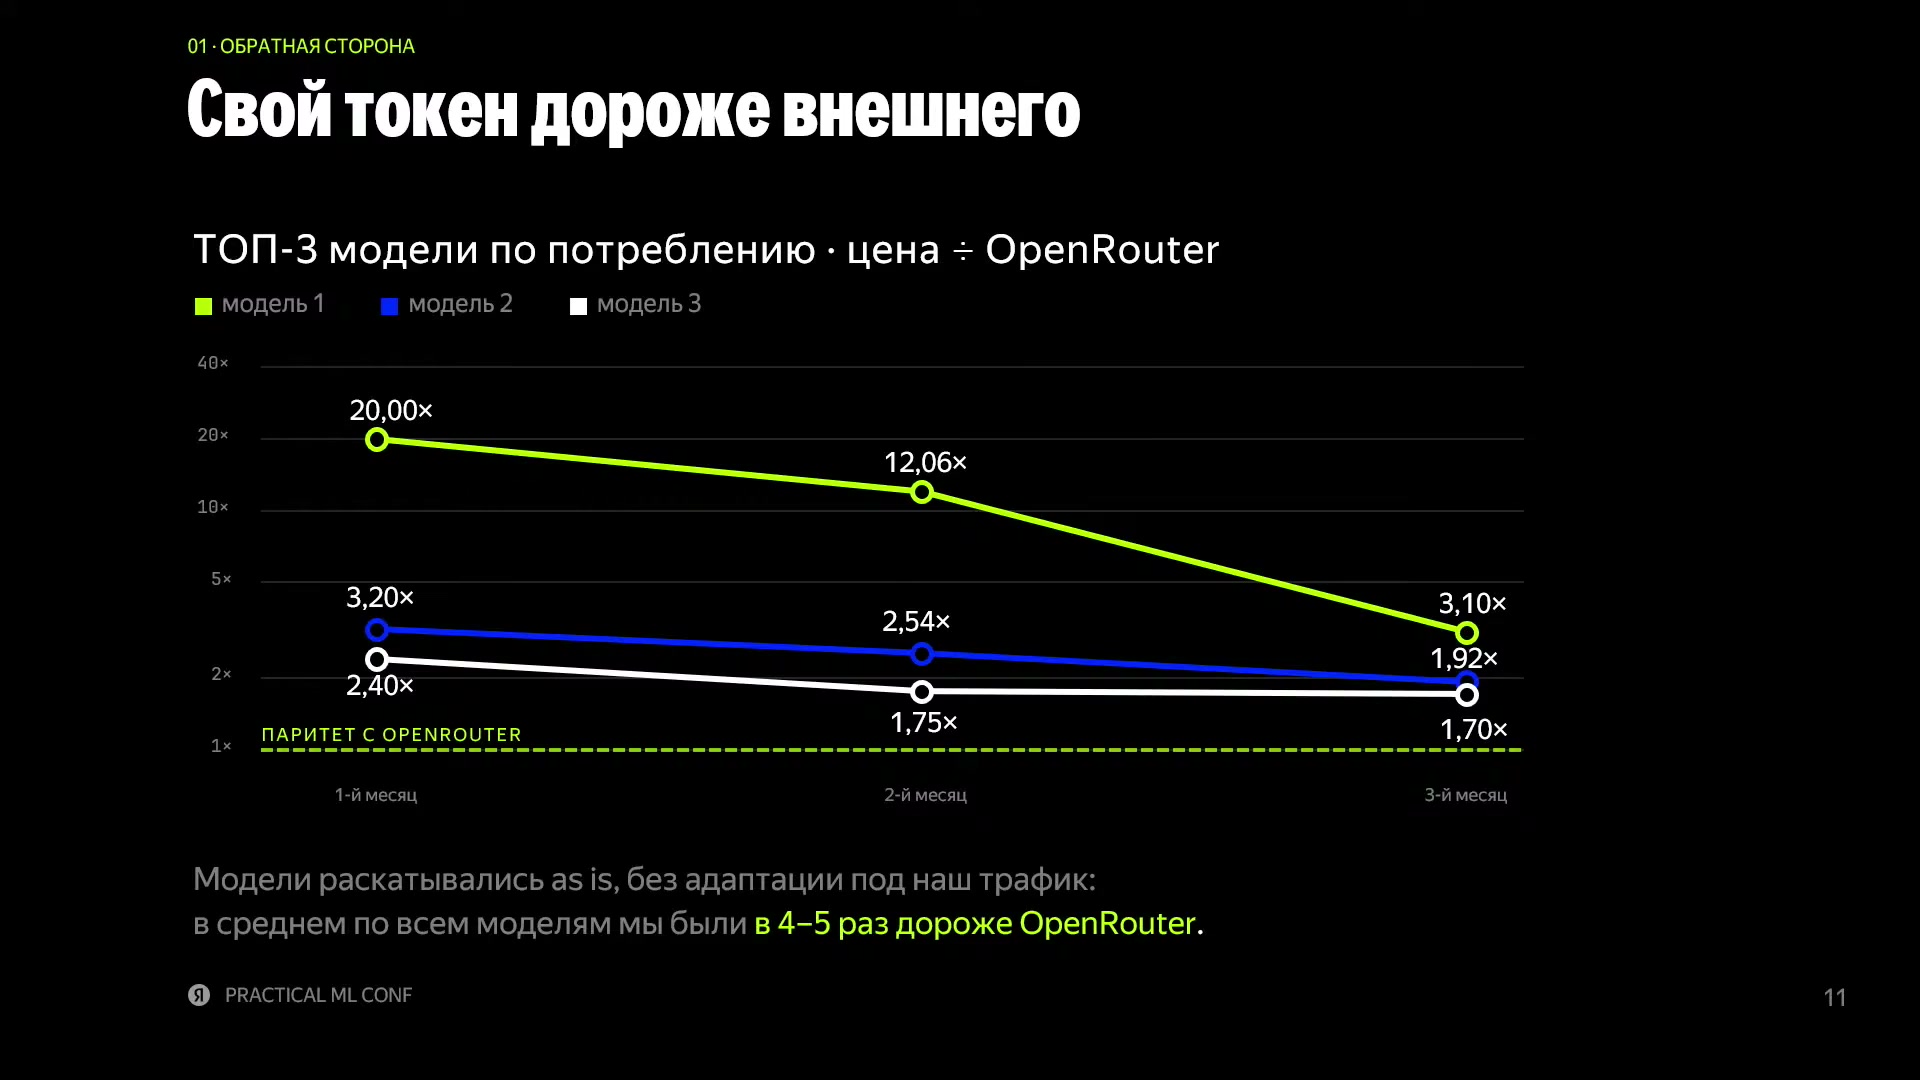
Сравнение стоимости токена на слайде относится к моменту подготовки доклада и указанным моделям, а не к текущим ценам.
Источник: Т-Банк · исходный доклад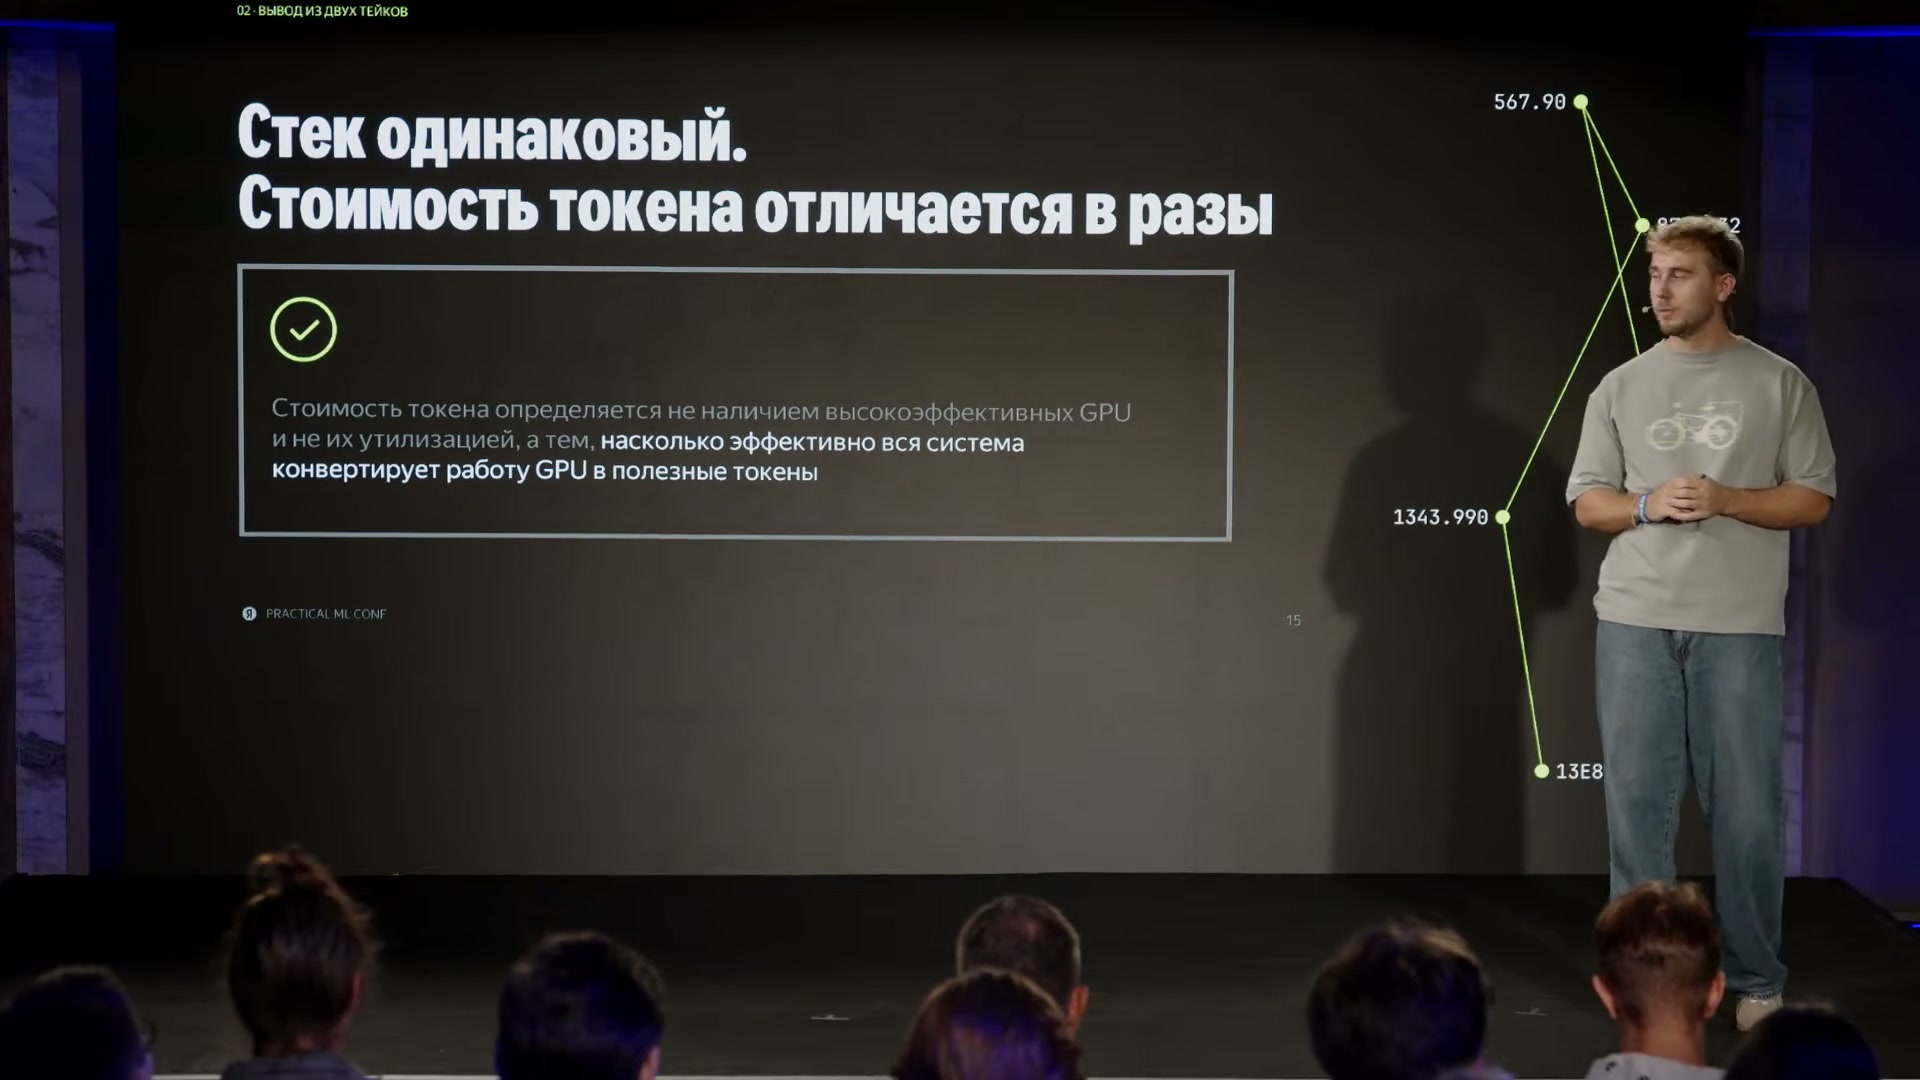
Одинаковый набор библиотек сам по себе не даёт одинаковую стоимость токена: важна организация работы GPU.
Источник: Т-Банк · исходный докладСкорость появления новых моделей
Автор иллюстрирует частоту появления новых сильных моделей списком релизов за январь–февраль 2026 года; это исторический пример, не перечень актуальных моделей. Если выбор и развёртывание занимают слишком много времени, следующая сильная модель выходит раньше, чем компания внедрит предыдущую.
Поэтому в докладе решаются две связанные задачи: уменьшить стоимость токена и сократить время от выбора сильной модели до её появления во внутреннем сервисе.
Доклад · 04:35:43Где искать резерв производительности
Модель, движок инференса и GPU — лишь минимальный набор для запуска. Хорошая загрузка карты сама по себе ещё не доказывает экономичность сервиса. Нижний уровень — оборудование и низкоуровневое ПО, включая закрытые компоненты NVIDIA. По оценке автора, этот уровень уже хорошо оптимизирован поставщиком.
Среда выполнения включает вычислительные ядра, механизмы внимания, квантизацию и движки вроде vLLM, SGLang и TRT-LLM. Ещё выше расположен уровень организации системы: маршрутизация, планирование запросов, реплики, KV-cache, разделение фаз обработки и масштабирование. Открытые проекты предоставляют компоненты, а их сочетание команда выбирает под свой трафик и оборудование.
Выбор и интеграция зависят от модели, оборудования, инфраструктуры и трафика. Чем выше уровень, тем меньше готовых решений; команда работала и со средой выполнения, и с организацией системы.
Одинаковый набор библиотек сам по себе не даёт одинаковую стоимость токена: важна организация работы GPU.
Источник: Т-Банк · исходный доклад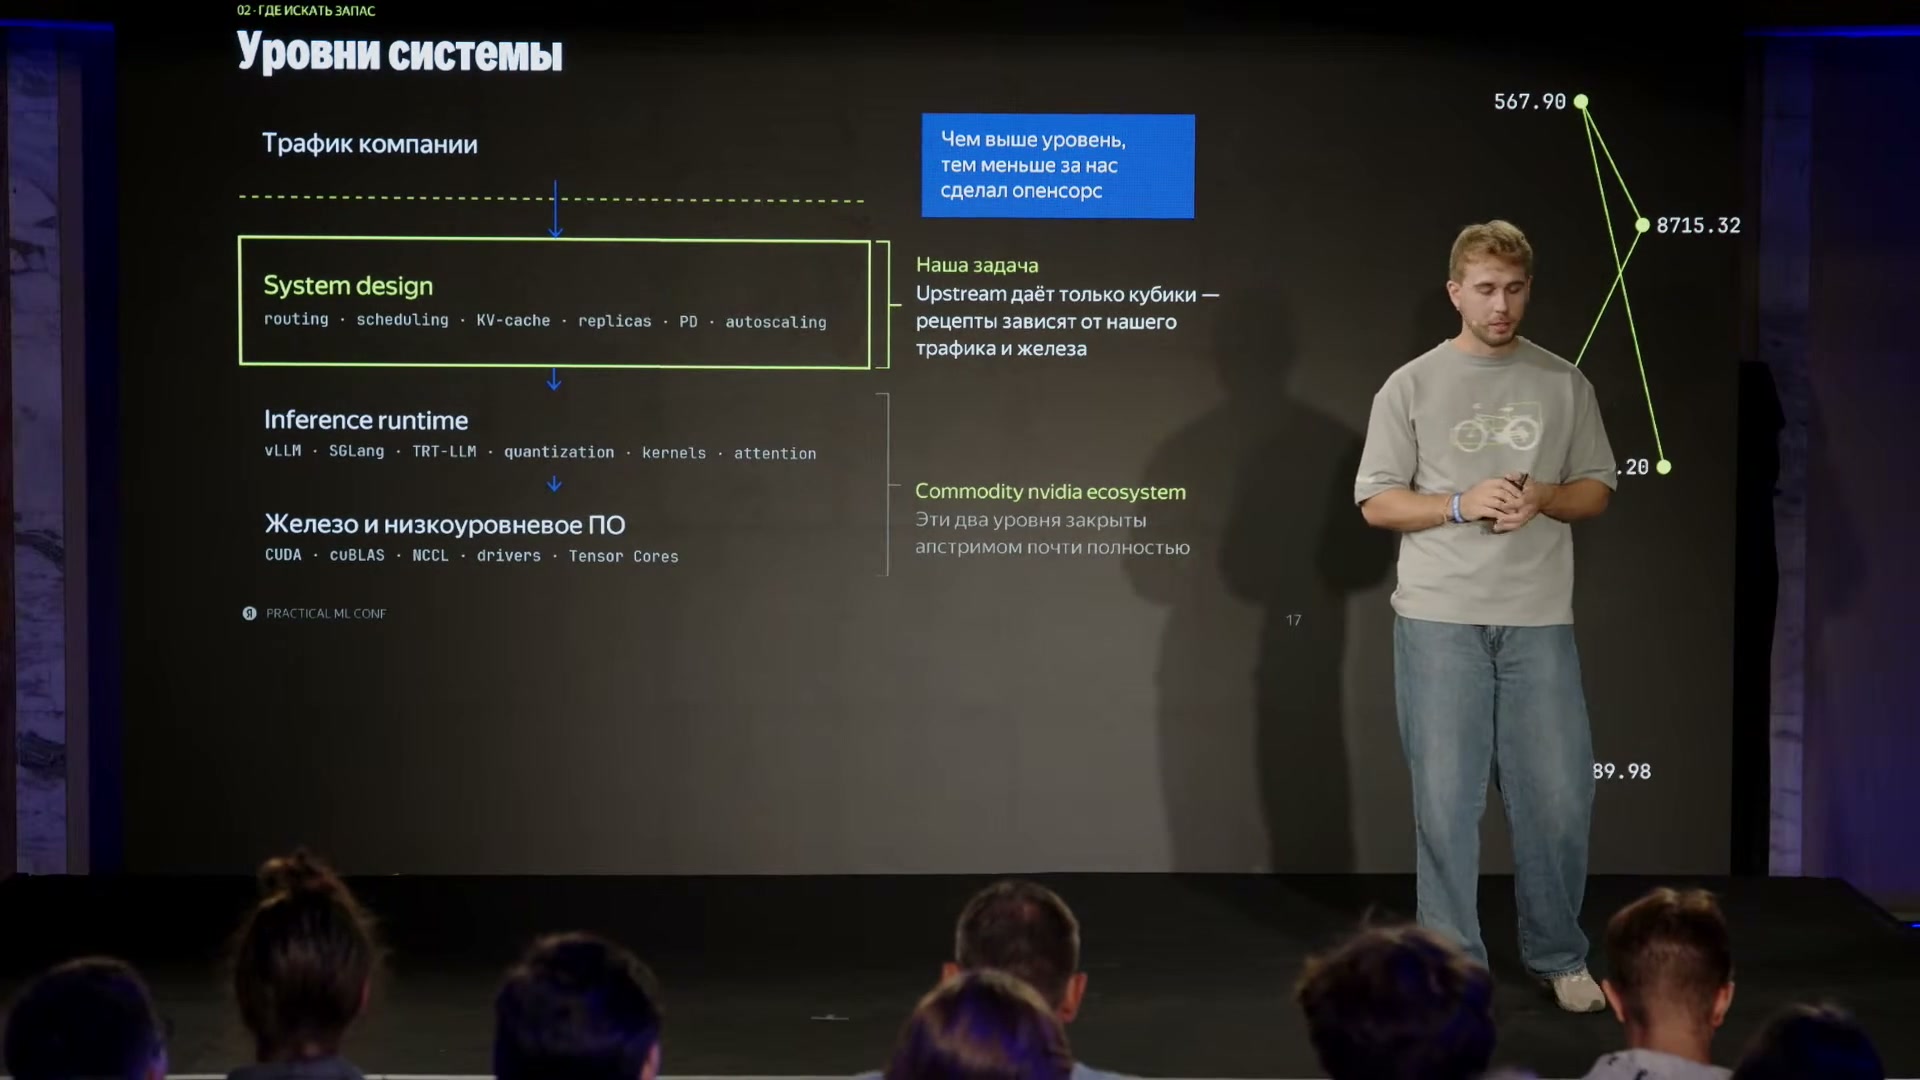
Система разделена на пользовательский трафик, system design, inference runtime и низкоуровневые вычисления.
Источник: Т-Банк · исходный докладЧто показал анализ трафика
Prefill — обработка входных токенов перед генерацией; decode — генерация новых токенов. В описанном сервисе основная работа GPU приходилась на prefill. Рост агентских сценариев, по словам автора, увеличивает длину контекстов и объём обработки входа.
Причинная цепочка оптимизации: меньше заново обработанных токенов → меньше необходимых вычислительных ресурсов → ниже стоимость для пользователей внутреннего сервиса. Это вывод для данного профиля нагрузки.
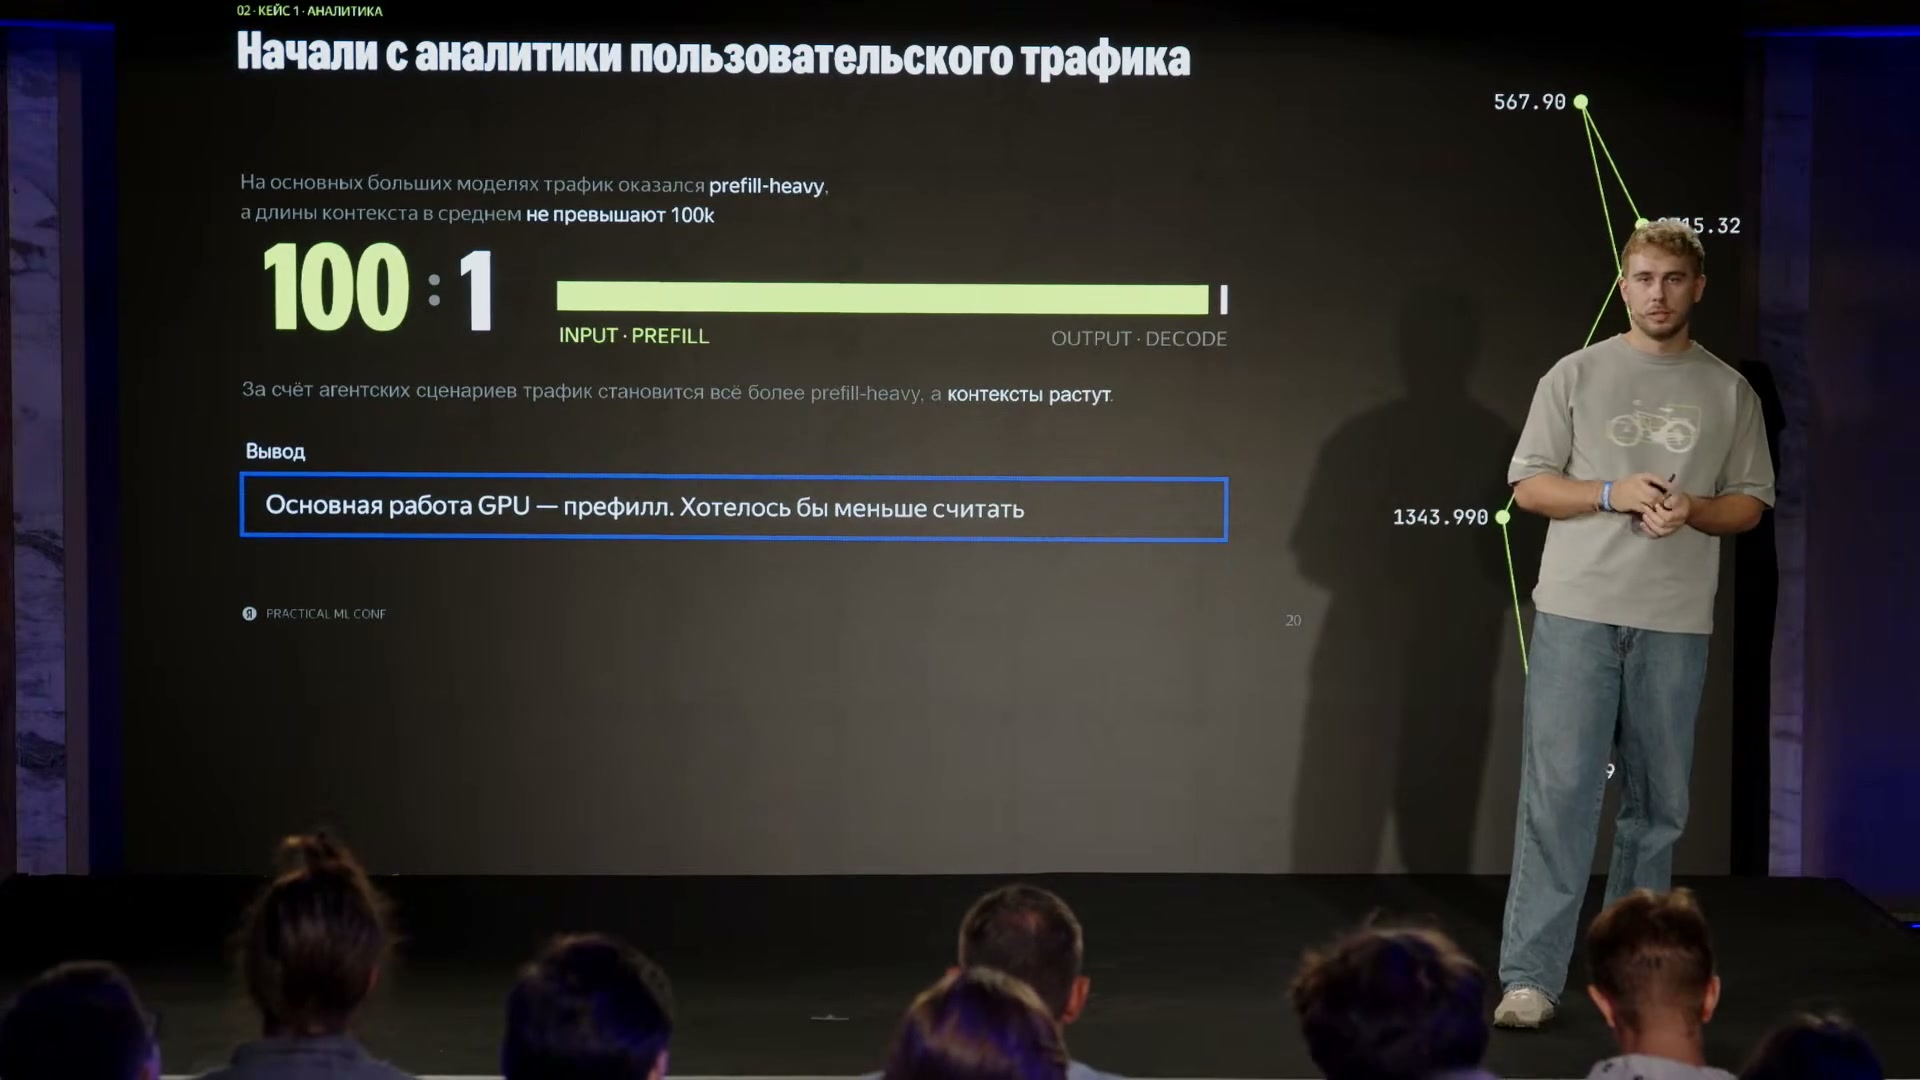
Анализ входных и выходных токенов показал характер конкретной нагрузки; соотношение не переносится на любой сервис.
Источник: Т-Банк · исходный докладПочему кеш использовался редко
Анализ показал большое количество повторяемых системных промптов: в устном объяснении автор называет 95%. На больших моделях попадание в кеш ключей и значений внимания (KV-cache) составляло примерно 10%. Этот кеш хранит результаты обработки уже прочитанных частей текста, чтобы не вычислять их заново. Точное значение попаданий автор округляет, поскольку оно связано с количеством узлов сервиса.
Первый запрос сессии создавал кеш на одной карте, а следующий мог уйти на другую, где нужного кеша не было. Наличие локального кеширования не решало задачу межузлового переиспользования. Без маршрутизации с учётом кеша или его передачи между узлами сервис заново считал значительную часть уже выполненной работы.
Анализ входных и выходных токенов показал характер конкретной нагрузки; соотношение не переносится на любой сервис.
Источник: Т-Банк · исходный докладОбмен кешем через Mooncake
Рассматривались два пути: направлять запросы одной сессии на карту с нужным кешем либо передавать кеш туда, где запрос будет исполняться. В описании автора Mooncake отслеживает местонахождение KV-cache и передаёт его по высокопроизводительным соединениям InfiniBand. В их условиях передача оказывалась быстрее повторного вычисления.
После внедрения Mooncake попадание в KV-cache выросло примерно вчетверо, стоимость токена снизилась более чем втрое, а время до первого токена (TTFT) сократилось приблизительно вдвое. Это эффект этапа обмена кешем. Простая маршрутизация в тестах давала меньшую долю попаданий и требовала учитывать не только наличие кеша, но и загрузку GPU.
Большой выигрыш получен интеграцией готовой библиотеки, без написания собственной среды выполнения или CUDA-ядер. Следующие эпизоды показывают, почему интеграция всё же потребовала серьёзной доработки.
Доклад · 04:41:27Сетевые сбои и восстановление
На инфраструктуре с примерно тысячей соединений временно пропадали линии InfiniBand — иногда более чем на пять секунд. В худшем случае это вызывало свыше 10⁴ ошибок передачи KV-cache: неисполненные запросы и буферы накапливались, а сервис перегружал сам себя.
Восстановление требовало полного перезапуска кластера продолжительностью около 40 минут и нарушало требования доступности. Вместе с разработчиками Mooncake команда реализовала обход неработающей линии через другие соединения или GPU вместо массовых повторных попыток; после восстановления связи передача возвращалась на оптимальный путь.
Исправление было передано в основной проект Mooncake. Это пример того, как библиотека, хорошо работающая при небольшом масштабе, потребовала дополнительной устойчивости в инфраструктуре банка.
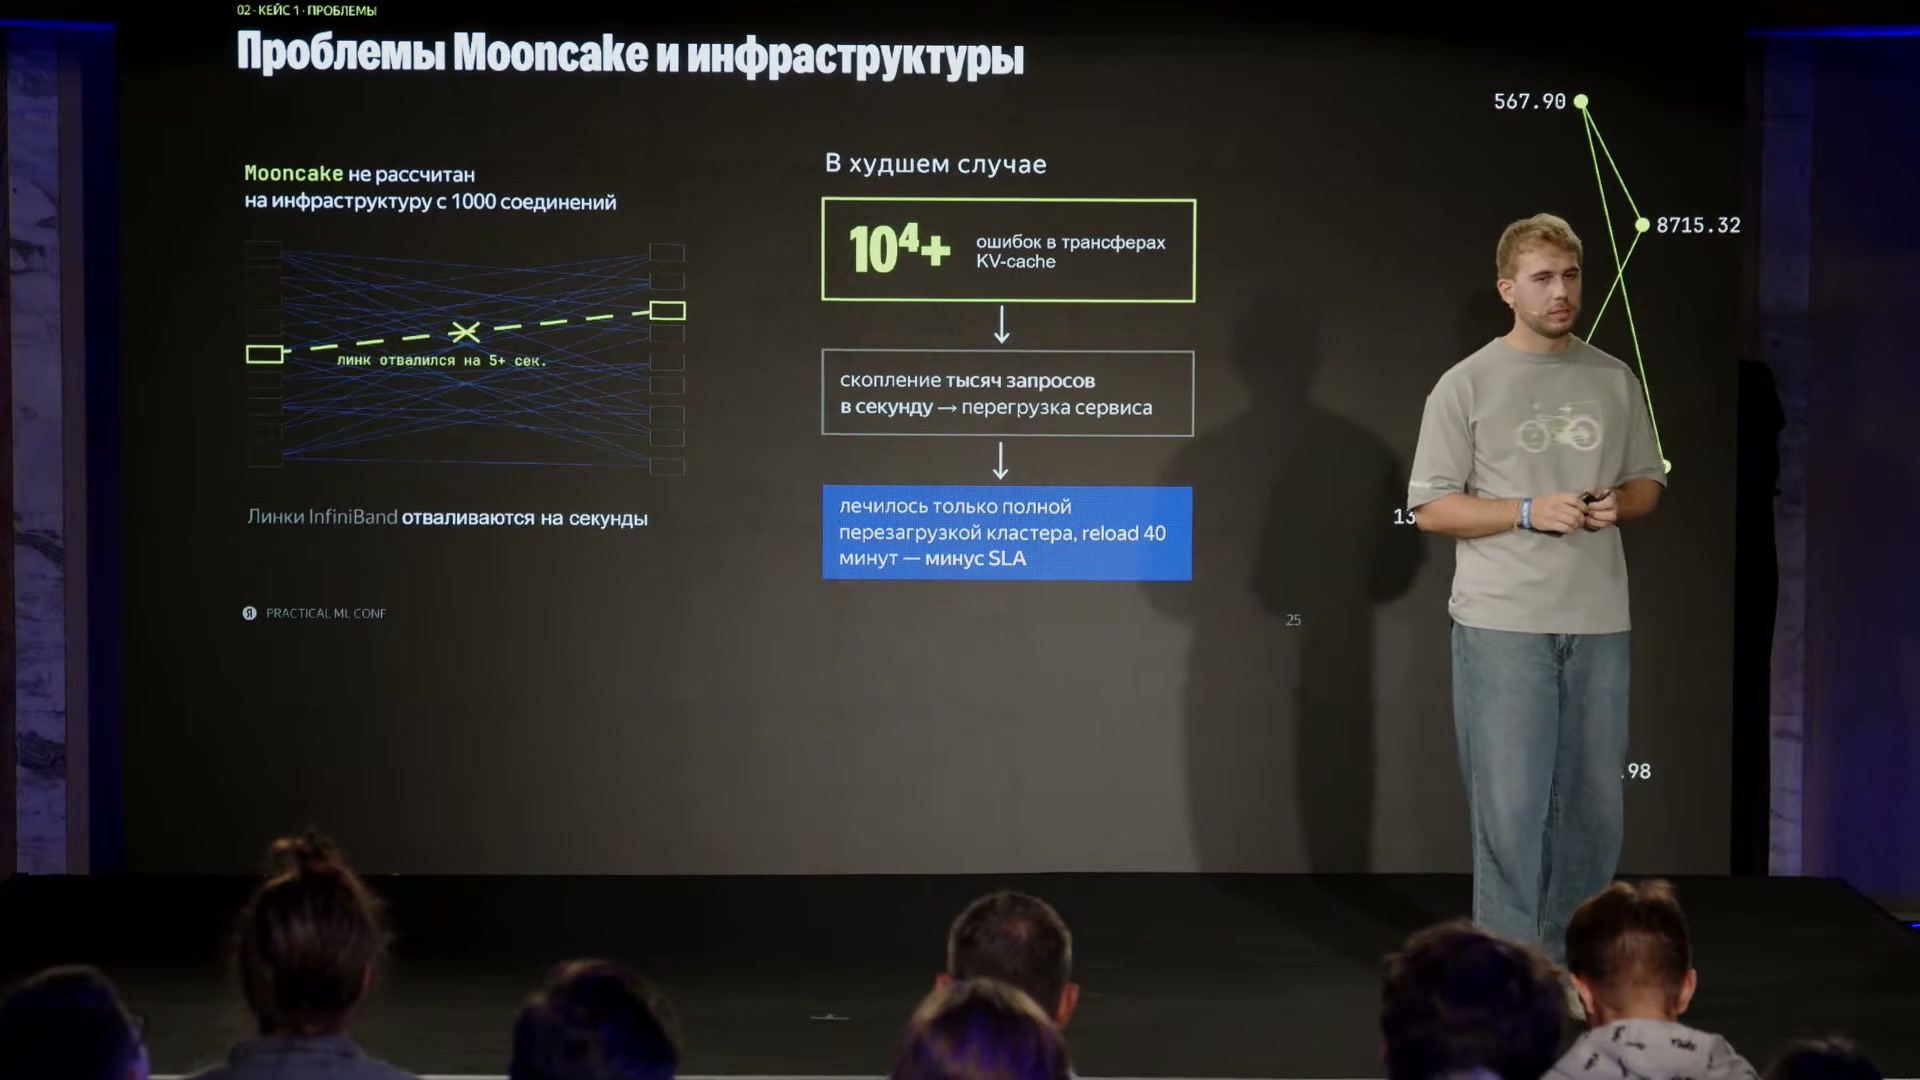
Нагрузочная проверка Mooncake и инфраструктуры выявляет ограничения, которые не видны на небольшом числе запросов.
Источник: Т-Банк · исходный докладОшибка выбора клиентского порта
При запуске SGLang поднимался клиент Mooncake, который взаимодействовал с управляющим компонентом Mooncake и участвовал в передаче кеша. Клиент случайно выбирал порт. Если порт был занят, он завершался вместо повторной попытки и останавливал вместе с собой сервис модели; соответствующий узел не поднимался.
На слайде указан диапазон случайного выбора порта SGLang: 12 300–14 300. При занятом порте Mooncake-клиент завершался и останавливал сервис модели. Команда подготовила локальное исправление, зарегистрировала проблему и направила PR в SGLang.
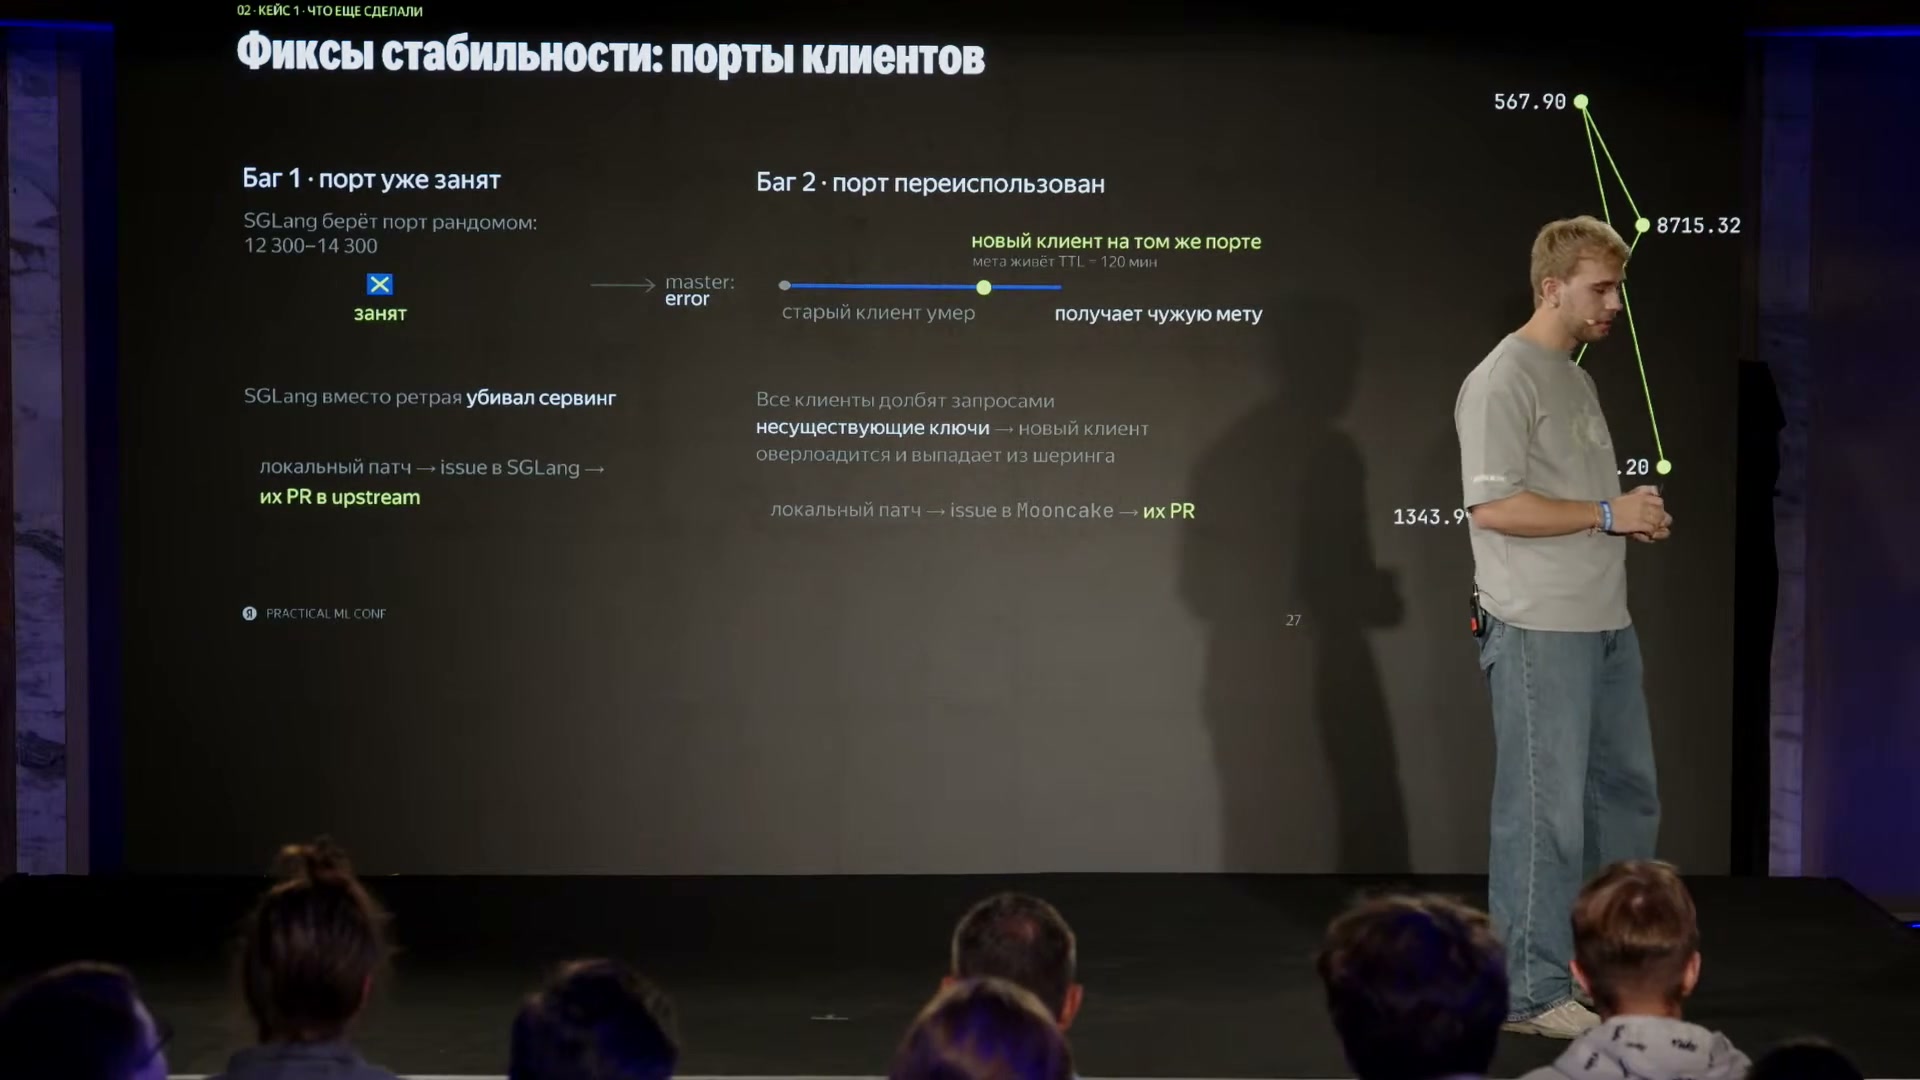
Ошибки интеграции и различия между клиентскими библиотеками проявляются при работе с реальной инфраструктурой.
Источник: Т-Банк · исходный докладУстаревшие метаданные клиента
Управляющий компонент Mooncake продолжал хранить старые метаданные после смерти клиента и запуска нового. Другие клиенты считали, что у нового процесса есть прежний KV-cache, и посылали ему запросы. Новый клиент перегружался и выпадал из совместного использования кеша.
Старые метаданные могли жить ещё 120 минут. При повторном использовании порта другие клиенты обращались к несуществующим ключам кеша, перегружали новый процесс и выводили его из обмена. Команда подготовила локальный патч, issue и PR в Mooncake.
Ошибки интеграции и различия между клиентскими библиотеками проявляются при работе с реальной инфраструктурой.
Источник: Т-Банк · исходный докладNUMA и скрытая потеря скорости
Во внутреннем облаке статическую привязку процессов к CPU-ядрам вводили для CPU-задач, не учитывая NUMA-топологию — разделение сервера на области с разной близостью процессоров, памяти и устройств. Процесс SGLang мог работать на CPU в одном NUMA-узле и обслуживать GPU в другом. Между ними появлялся дополнительный путь передачи данных.
На слайде указана потеря производительности до 25%. Для рассматриваемых CPU AMD показаны восемь NUMA-групп, для Intel — две; при случайном размещении на Intel автор приводит шанс правильного попадания 50%. Команда отключила принудительную привязку в Kubernetes и стала назначать NUMA самостоятельно средствами bash и SGLang.
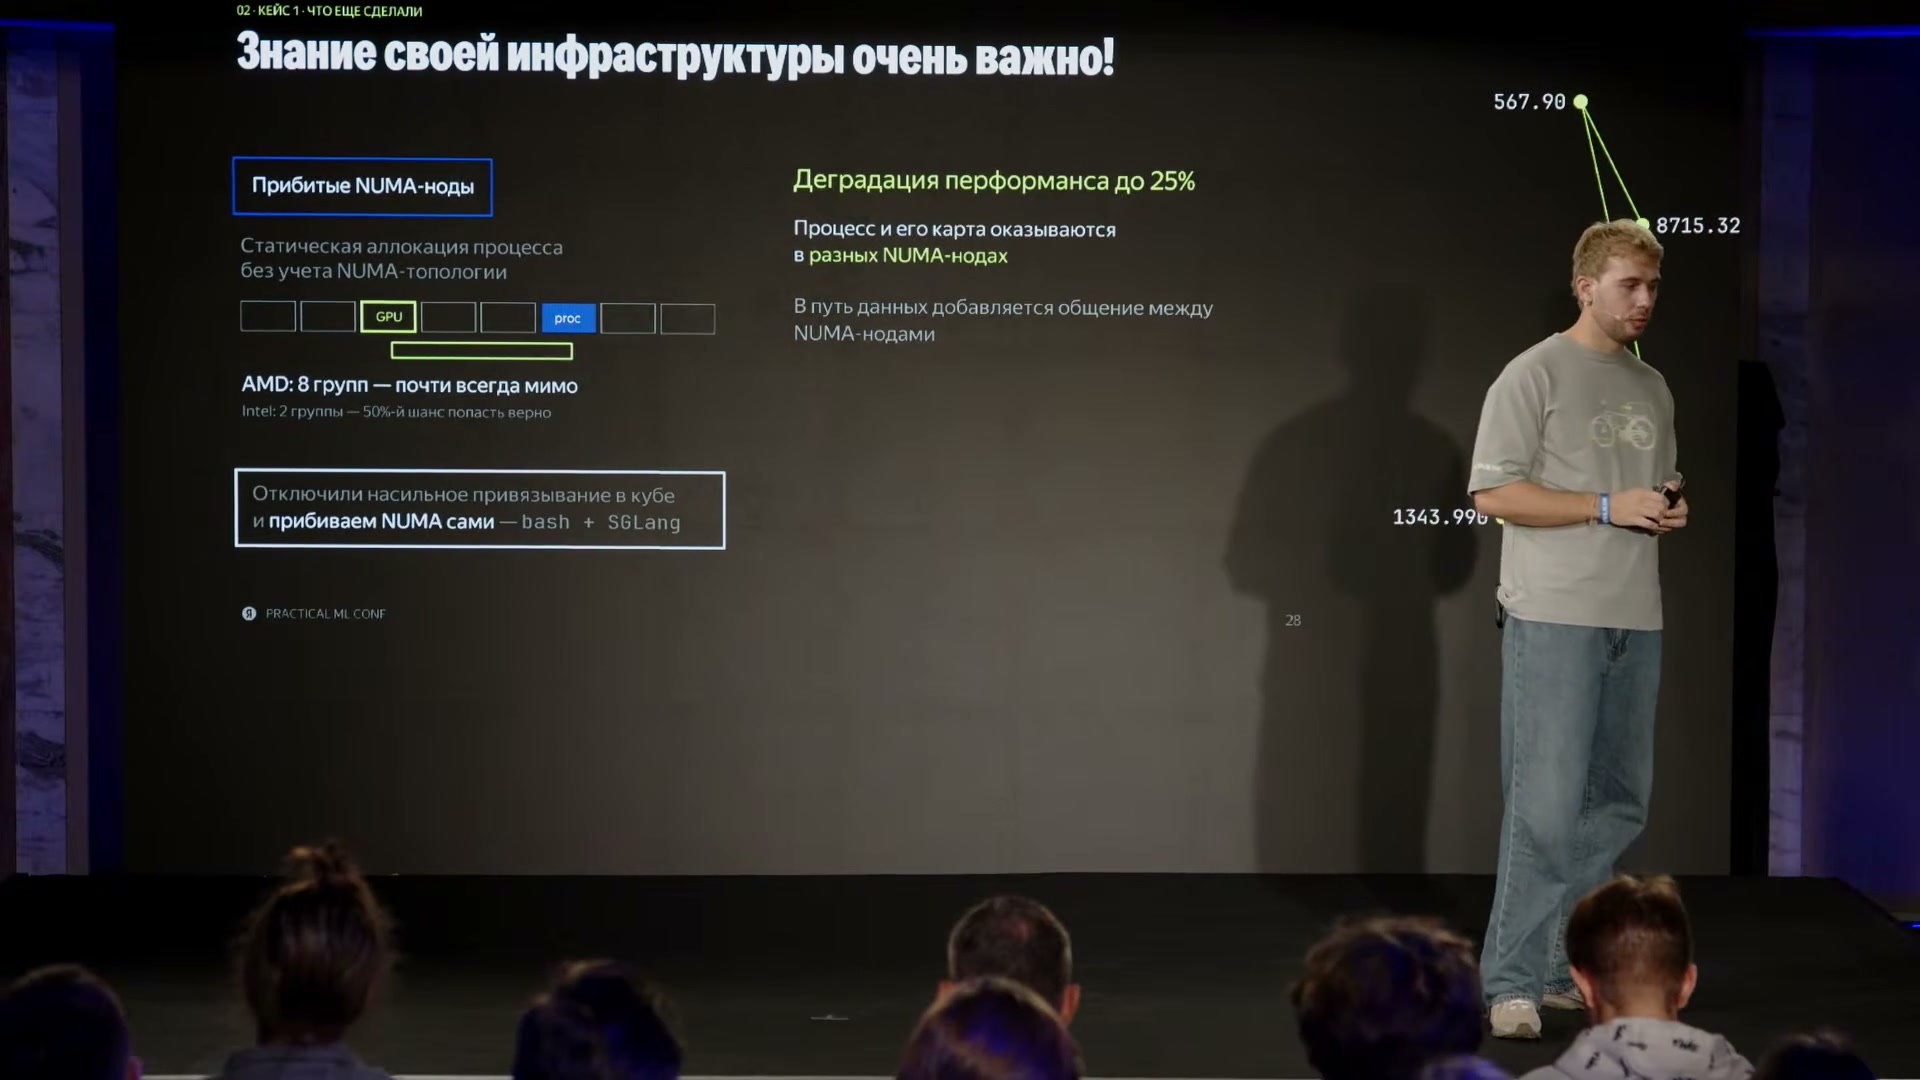
Особенности AMD-инфраструктуры и настройки обмена данными влияют на производительность.
Источник: Т-Банк · исходный докладМаршрутизация между кластерами и внутри
Кластеров несколько, а Mooncake в описанной схеме работает внутри одного кластера. Между кластерами нет необходимых высокопроизводительных соединений для такого обмена кешем. Если запросы одного клиента уходят в разные кластеры, внутрикластерный обмен не обеспечивает переиспользование между ними. Внешний уровень маршрутизации должен учитывать эту границу.
Внутри кластера маршрутизация на узел с нужным кешем уменьшает объём передачи по InfiniBand и нагрузку на сеть. Межкластерная маршрутизация нужна потому, что Mooncake обменивается кешем только внутри кластера. Это два уровня выбора пути запроса, а не два уровня хранения кеша.
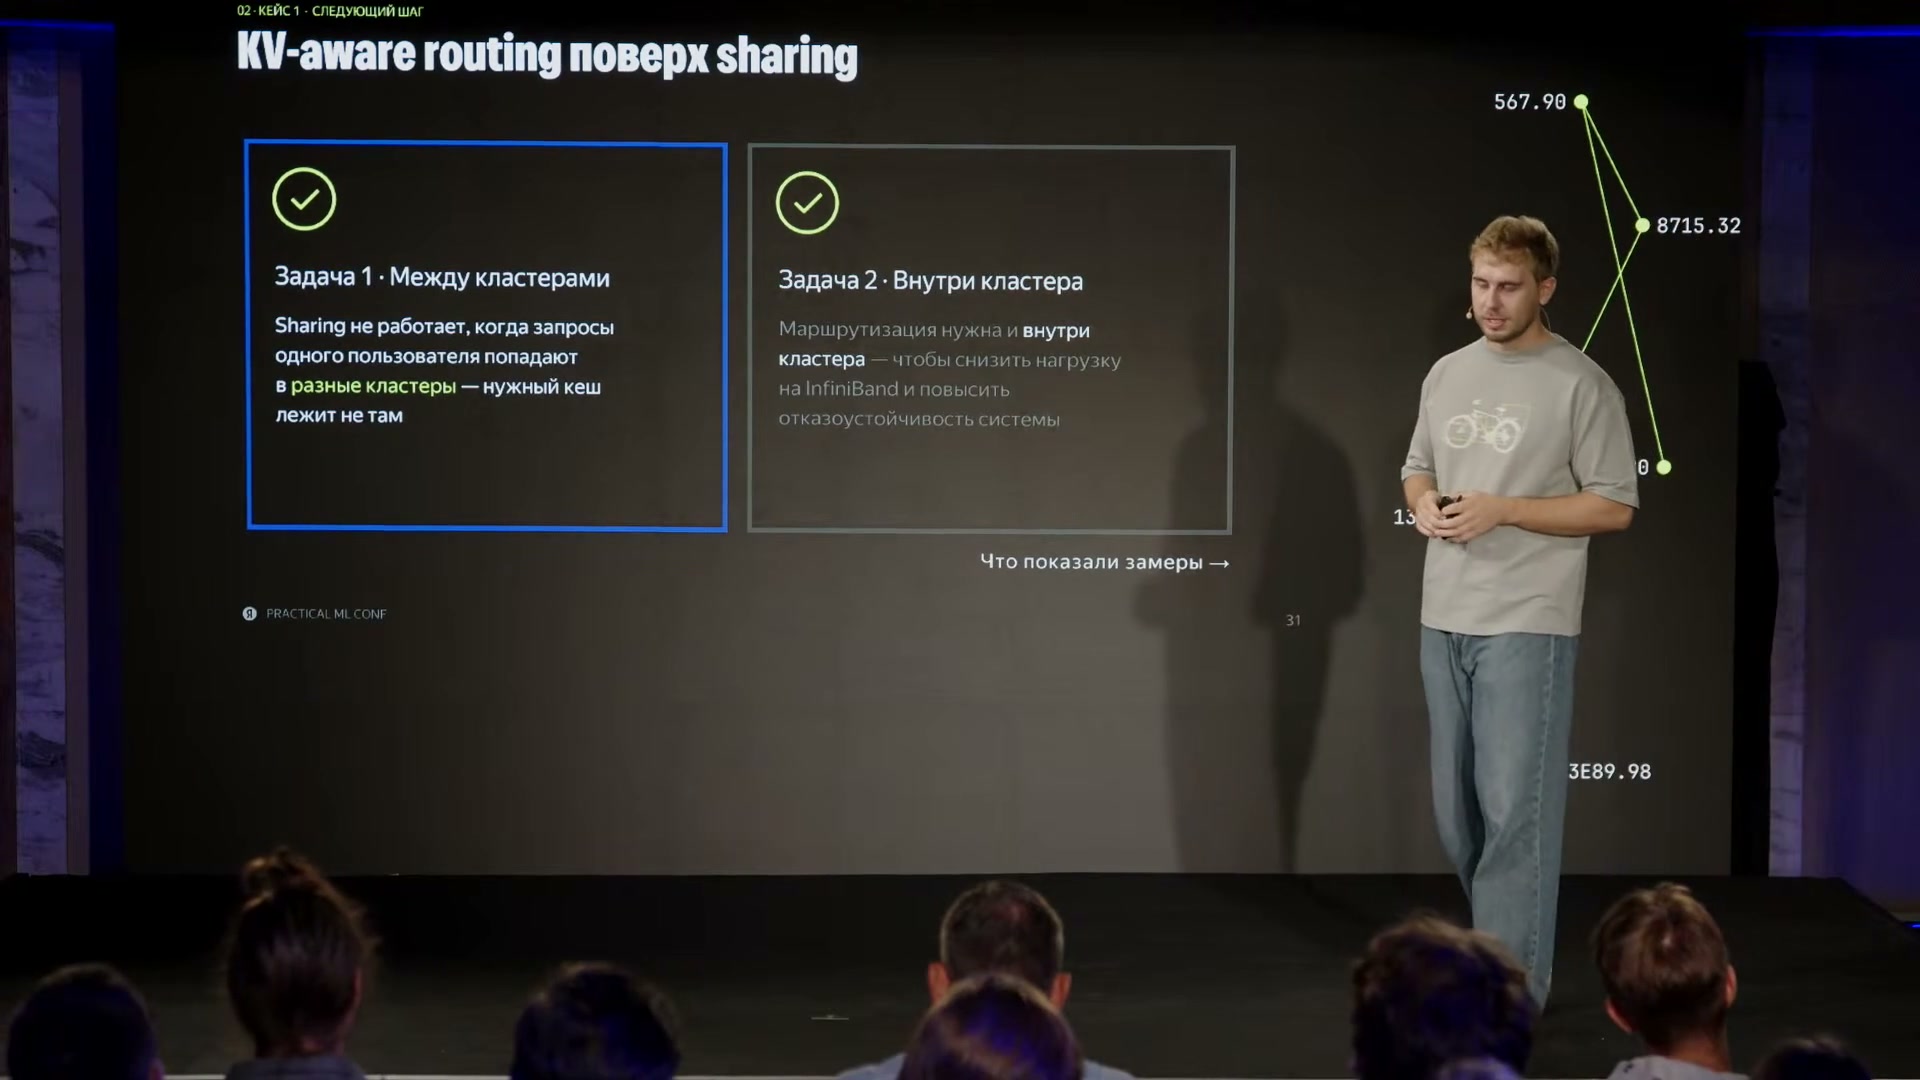
KV-aware routing организуется на двух уровнях: между кластерами и внутри кластера.
Источник: Т-Банк · исходный докладЦена маршрутизации с учётом кеша
Попадания в кеш немного выросли: небольшие запросы не участвовали в обмене через Mooncake, но роутер мог направлять их на прежнюю карту и переиспользовать локальный кеш. Время до первого токена немного ухудшилось. Автор связывает это с тем, что некоторые GPU оказывались слегка перегружены при выборе маршрута.
Объём данных, передаваемых по InfiniBand, в докладе сократился в пять раз. Это не пятикратное ускорение сервиса и не пятикратное снижение стоимости.
На базе SGL Model Gateway: cache hit 80,1% → 82,3%; Mean TTFT 0,79 → 0,86 с (ухудшение); Prefetched tokens 201 → 36 kk. Снижение передачи по InfiniBand примерно в пять раз; это не пятикратное ускорение.
Таблицу можно прокрутить по горизонтали.
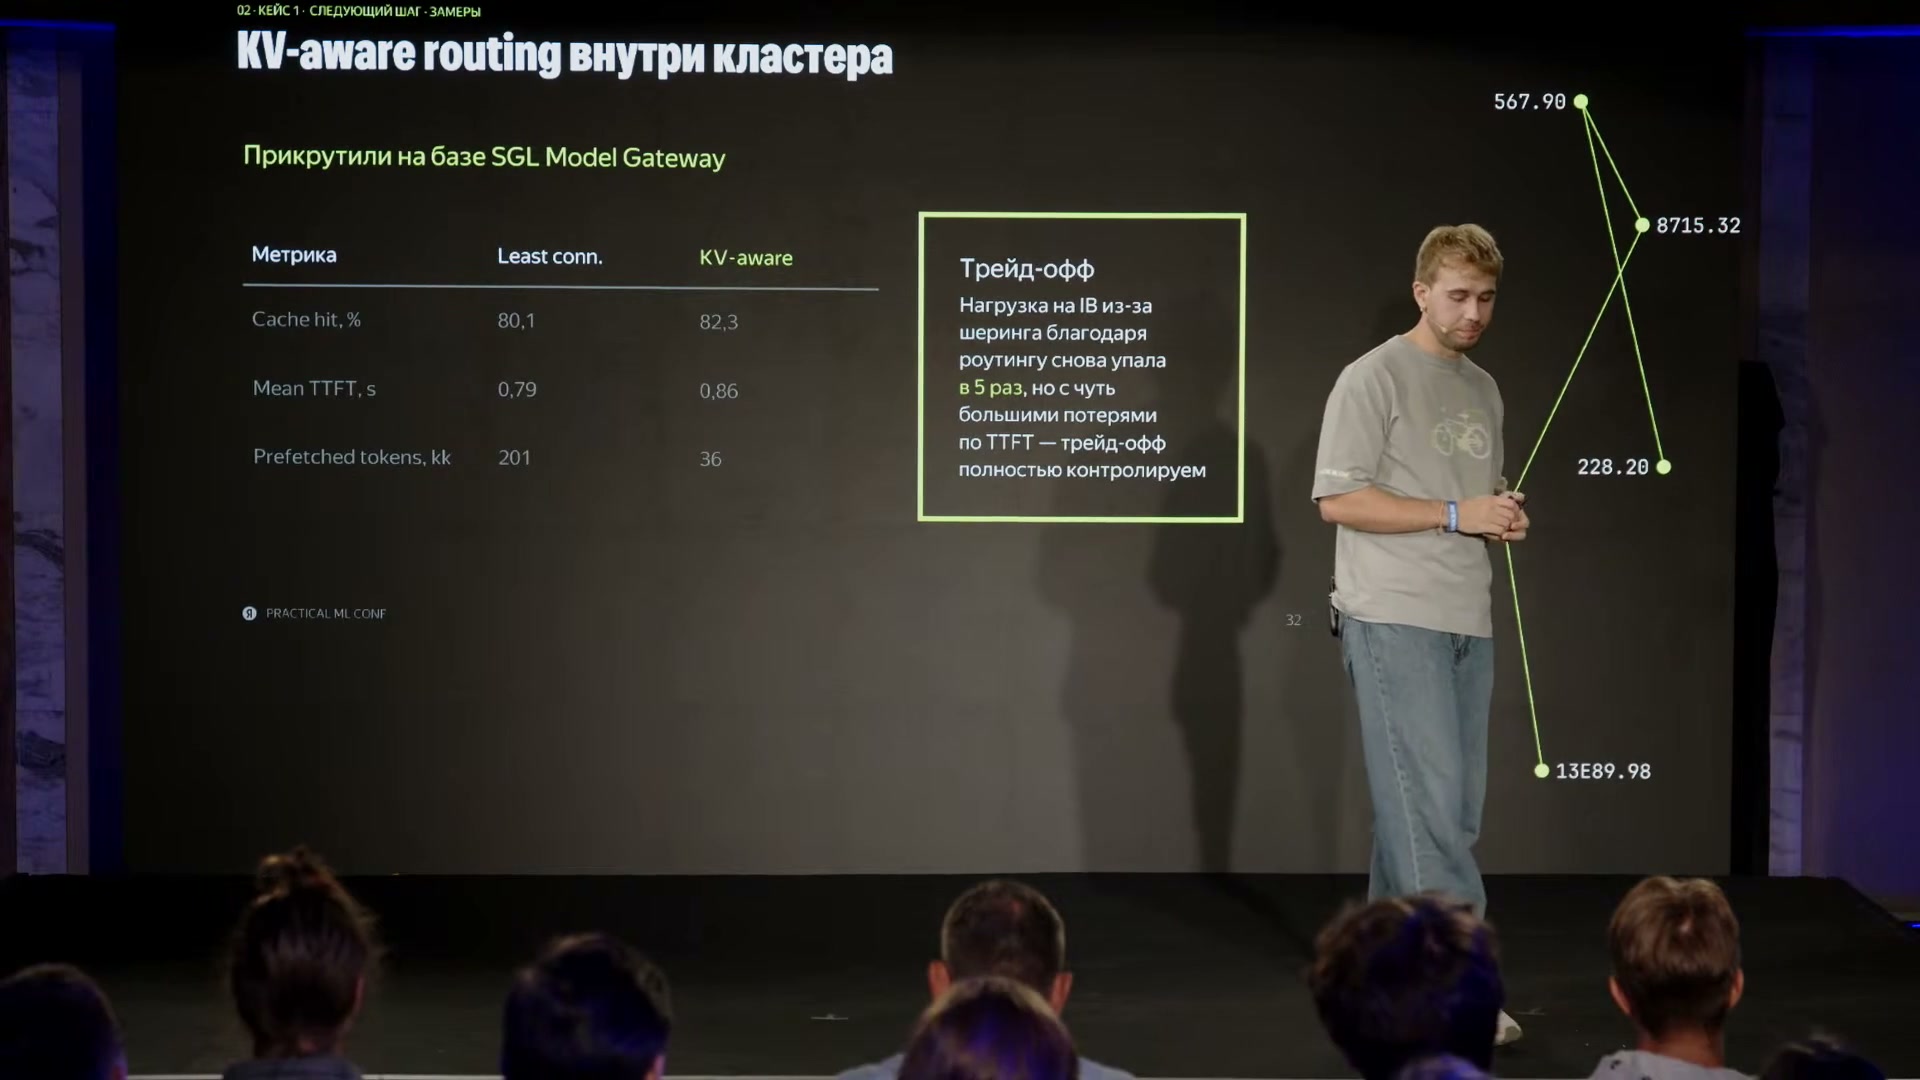
Сравнение least-connections и KV-aware routing: на слайде указаны конкретные метрики и условия результата.
Источник: Т-Банк · исходный докладУсложнение архитектуры и планы
Автор прямо признаёт добавление компонентов и точек отказа. Улучшение эффективности не означает автоматического упрощения эксплуатации. На момент выступления команда работала над отдельным исполнением обработки входа и генерации — prefill/decode disaggregation.
Второе направление — горизонтальное масштабирование ресурсов с помощью Kubernetes. В основной части детали не раскрываются, поскольку работа не завершена. Эти направления не включаются в список уже доказанных причин достигнутого снижения стоимости. В первом ответе на вопрос автор отдельно ограничивает ожидаемую пользу самого разделения фаз.
Доклад · 04:49:09Интеграция быстрых ядер Tencent
Tencent выпустила библиотеку высокопроизводительных операторов HPC-Ops под архитектуру NVIDIA Hopper. Команда самостоятельно встроила их в SGLang. На собственном трафике прирост пропускной способности на одну карту достигал 10%, тогда как внешнее заявление разработчиков доходило до 50%.
Позднее SGLang добавил поддержку этих операторов самостоятельно; в устном рассказе автор оценивает интервал примерно в полтора месяца. Интеграция принесла реальный, но умеренный выигрыш при заметной стоимости разработки и сопровождения.
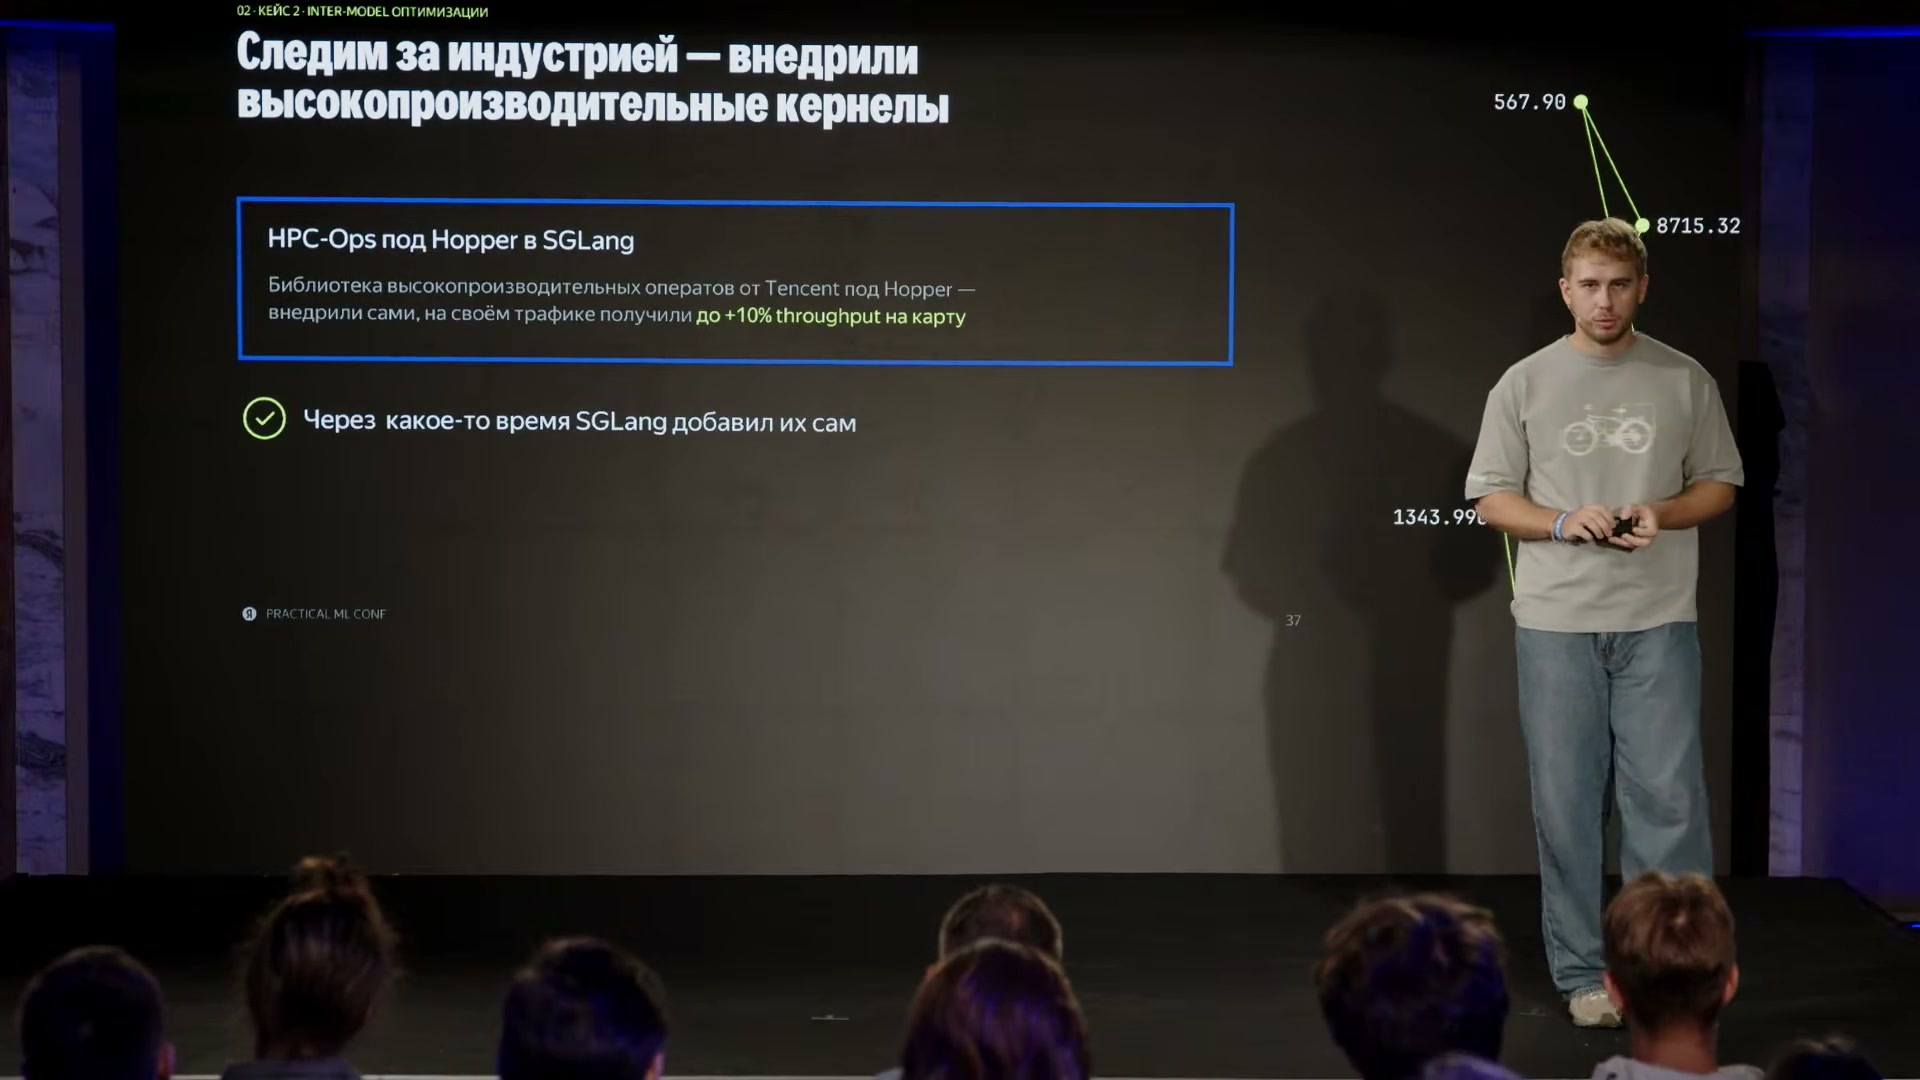
Обновления SGLang и высокопроизводительных kernels рассматриваются как часть постоянной работы над сервисом.
Источник: Т-Банк · исходный докладКогда нужны собственные ядра
Автор перечисляет собственные архитектуры, нестандартные механизмы внимания, необычное использование KV-cache и особые среды выполнения. Другой мотив — необходимость получить решение прямо сейчас, не ожидая изменений в основном проекте.
Команда занимается такими задачами не только в стандартных LLM, но и в других трансформерах, например в аудиодомене. Для операций, не сводящихся к матричным умножениям, автор отдельно предлагает попробовать генерацию вычислительных ядер кодовым помощником. Название помощника распознано как «колод-код»; это совет автора, не измеренный результат этого кейса.
Слайд перечисляет собственные архитектуры, операции не GEMM, нестандартные механизмы внимания, необычные раскладки KV-cache и нестандартные среды выполнения.
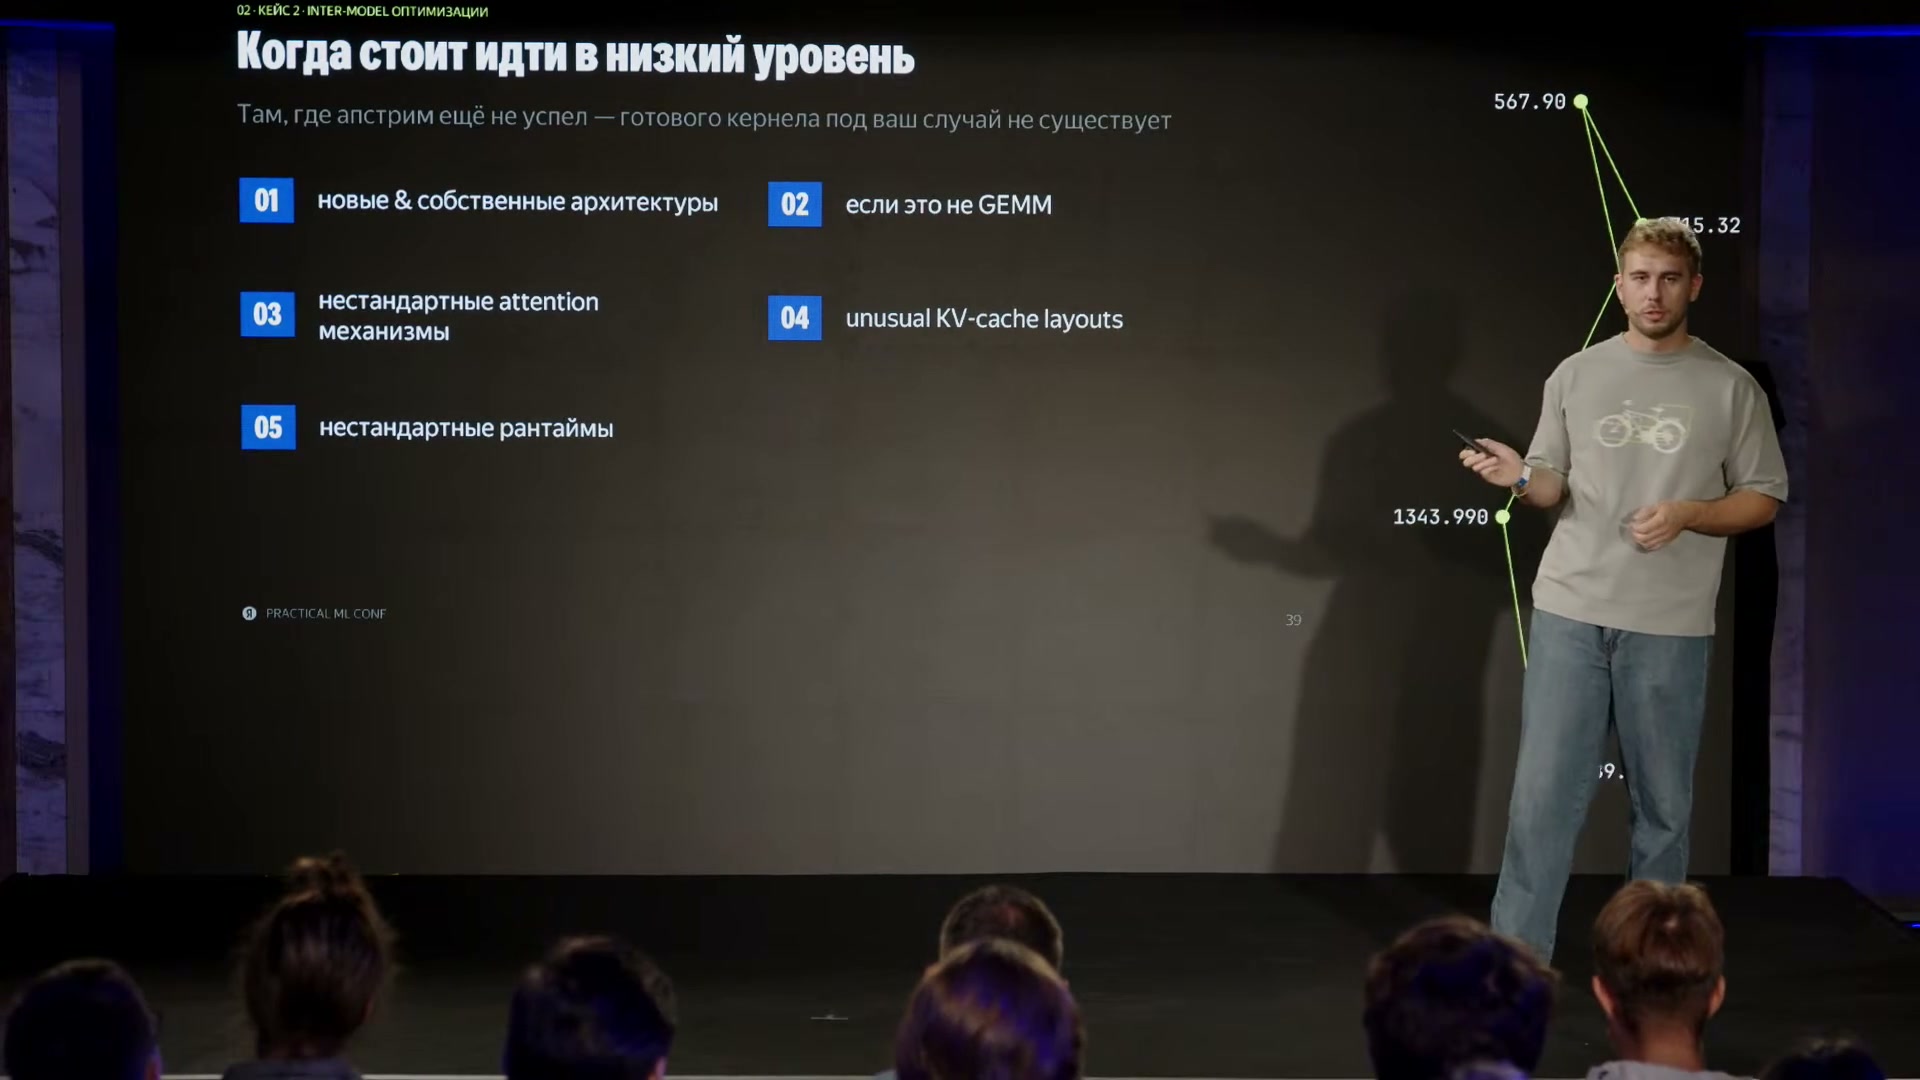
Собственные низкоуровневые изменения оправданы в перечисленных на слайде ситуациях; это не универсальный первый шаг.
Источник: Т-Банк · исходный докладВсплески запросов и очереди
Запросы приходят одиночно или всплесками. Если ресурсов на всплеск не хватает, очередь растёт и требования к задержке перестают выполняться. В объяснении докладчика TTFT складывается из времени вычисления и ожидания. Поэтому быстрое исполнение одного запроса ещё не гарантирует приемлемого времени до первого токена под нагрузкой.
Автор описывает компромисс между резервом простаивающего оборудования и резким ростом задержки при высокой загрузке. Это подводка к конкретному эксперименту с параллельным исполнением, не универсальная количественная модель очереди.
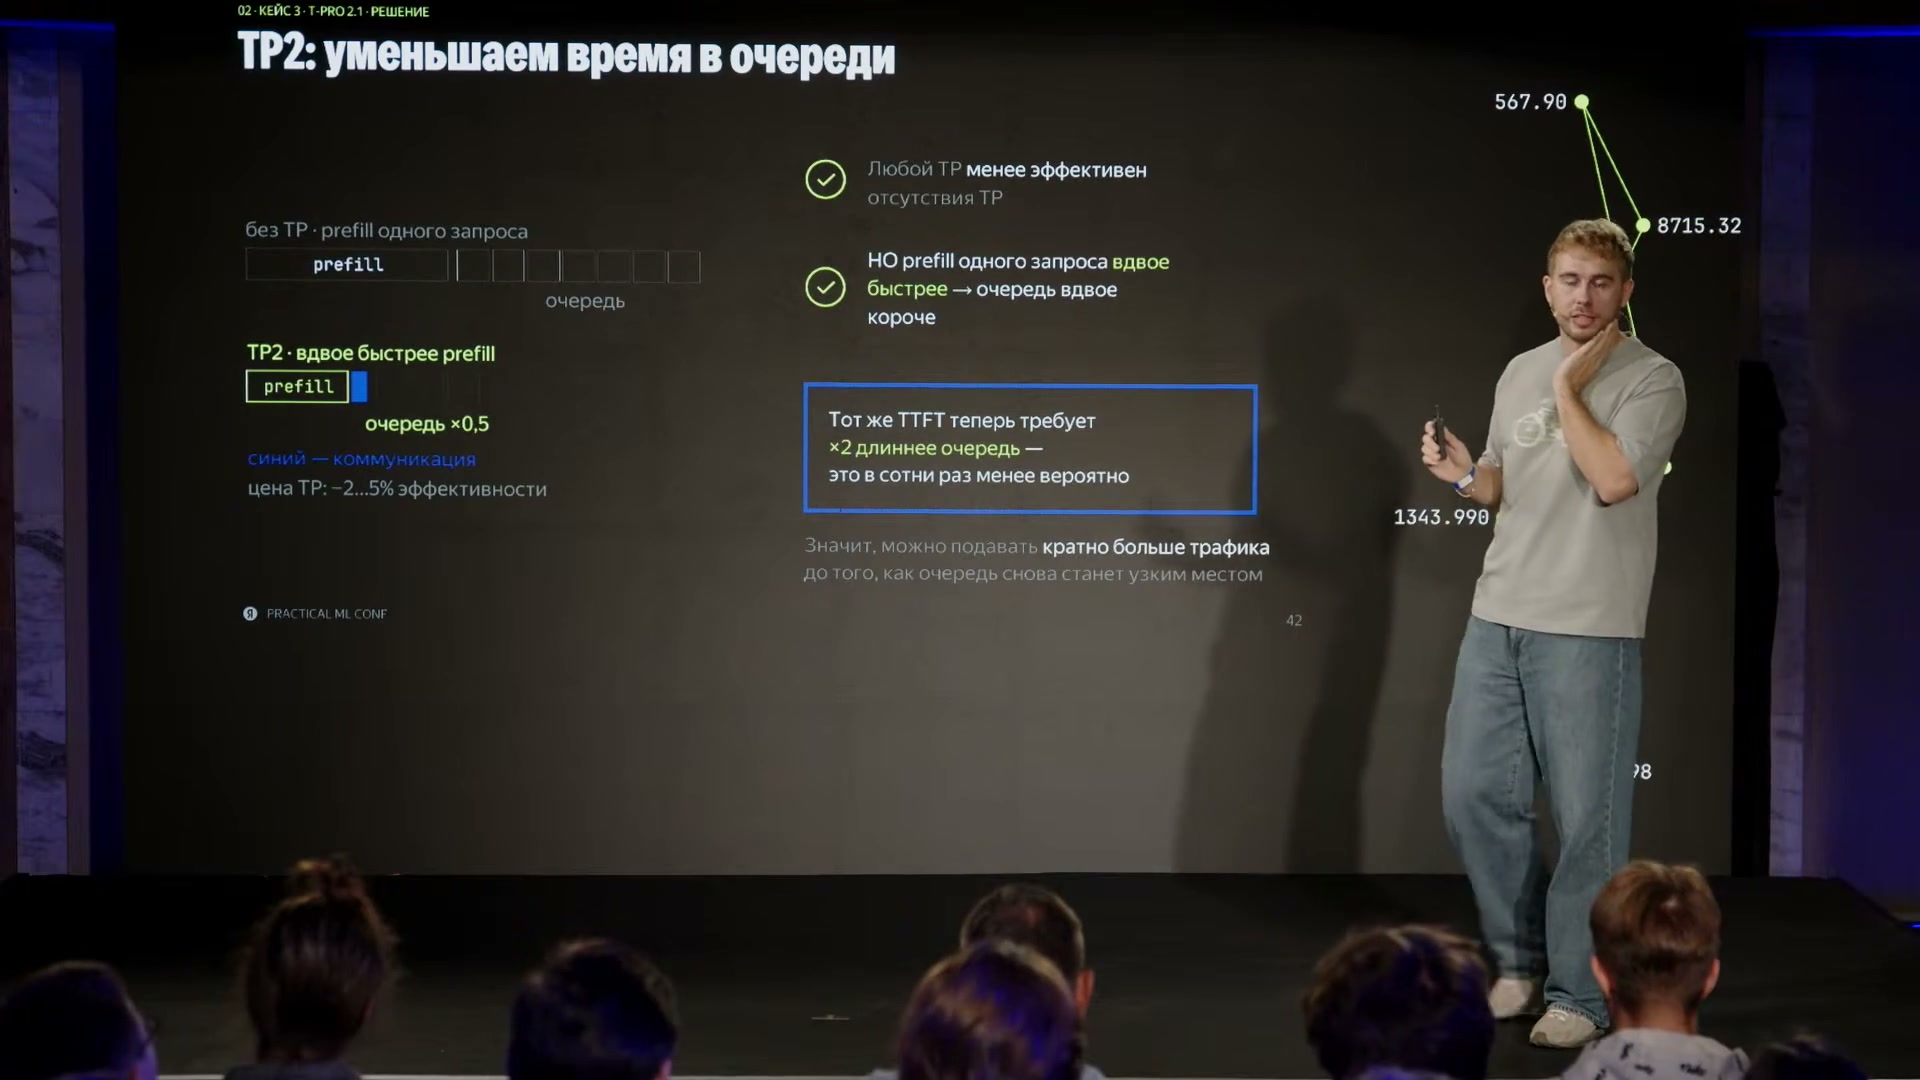
Tensor Parallelism меняет время ожидания запросов в очереди на конкретной конфигурации.
Источник: Т-Банк · исходный докладTensor Parallelism для T-Pro 2.1
Tensor Parallelism здесь означает распределение вычислений с весами модели между картами. Изменение сделали настройкой уровня параллелизма, а не заменой модели. Цена решения — время на межкарточные коммуникации, во время которых GPU могут простаивать. Поэтому отсутствие такого параллелизма тоже имеет преимущества.
Под высокой нагрузкой вычислительно тяжёлый prefill одного запроса распределяется на большее число ресурсов. Автор объясняет этим сокращение очереди и рост нагрузки, допустимой при прежних требованиях к задержке. Сохраняются условия: конкретная внутренняя модель, исходно помещающаяся на одной GPU, переход к двум картам, всплески и высокая доля prefill.
На слайде T-Pro 2.1: TP2 ускоряет prefill одного запроса примерно вдвое, сокращает очередь ×0,5, при этом коммуникации снижают эффективность на 2–5%. В речи автор говорит об удвоении допустимого трафика при прежнем SLA и тех же ресурсах; схема не раскрывает физическую топологию.
Tensor Parallelism меняет время ожидания запросов в очереди на конкретной конфигурации.
Источник: Т-Банк · исходный докладКак достигли ценового паритета
Автор объясняет близость к ценам OpenRouter высокой повторяемостью своего трафика: даже при более глубокой оптимизации у внешних провайдеров внутренний сервис может конкурировать за счёт большего переиспользования кеша. Это объяснение автора, а не отдельный проверенный замер чужой инфраструктуры. В итог входят работа с кешем и маршрутизацией, настройка движков, интеграция быстрых операторов и другие упомянутые изменения. Более значительный вклад автор приписывает организации системы.
Накопленная экспертиза ускорила доводку стоимости новых моделей: раньше она занимала месяцы, теперь экономичный режим иногда достигается сразу, а в других случаях — примерно через месяц после запуска. Это отдельный срок от времени публикации модели в сервисе. На итоговом слайде показан паритет 1:1 с исторической стоимостью OpenRouter.
Порядок действий в выводе автора: сначала оптимизировать организацию системы и правильно использовать готовое ПО, затем при необходимости углубляться в вычислительные ядра. Срок экономической доводки не равен сроку выпуска модели.
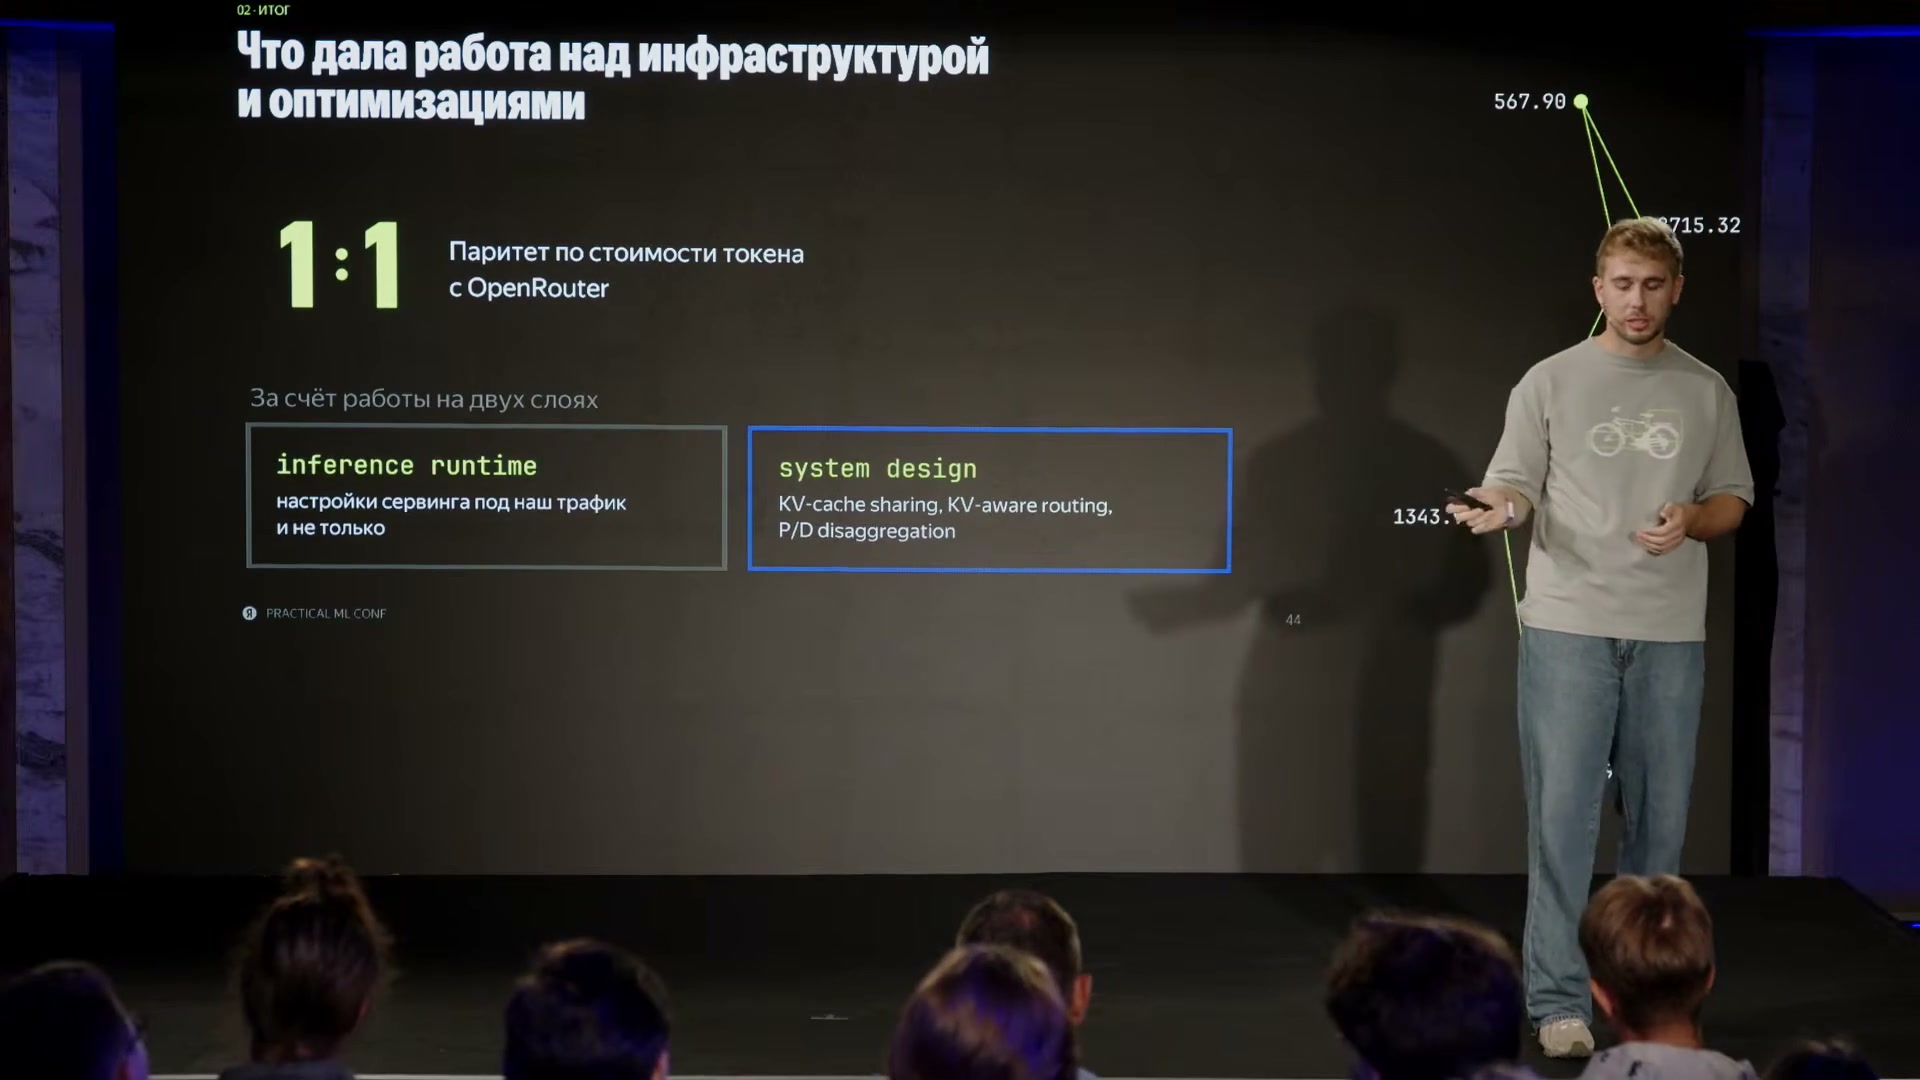
Сопоставление стоимости собственного токена и внешнего API — результат совокупной работы с runtime и system design.
Источник: Т-Банк · исходный докладКак выбирают новые модели
Список кандидатов проходит проверки качества и производительности. По результатам решают, какие модели включать в массовый сервис, а какие исключать из него. Критерий включения — место среди наиболее экономически эффективных вариантов, а не лидерство только по качеству.
Быстрый выбор позволяет продуктам раньше получать новое качество, а инфраструктурной команде — раньше начинать доводку стоимости.
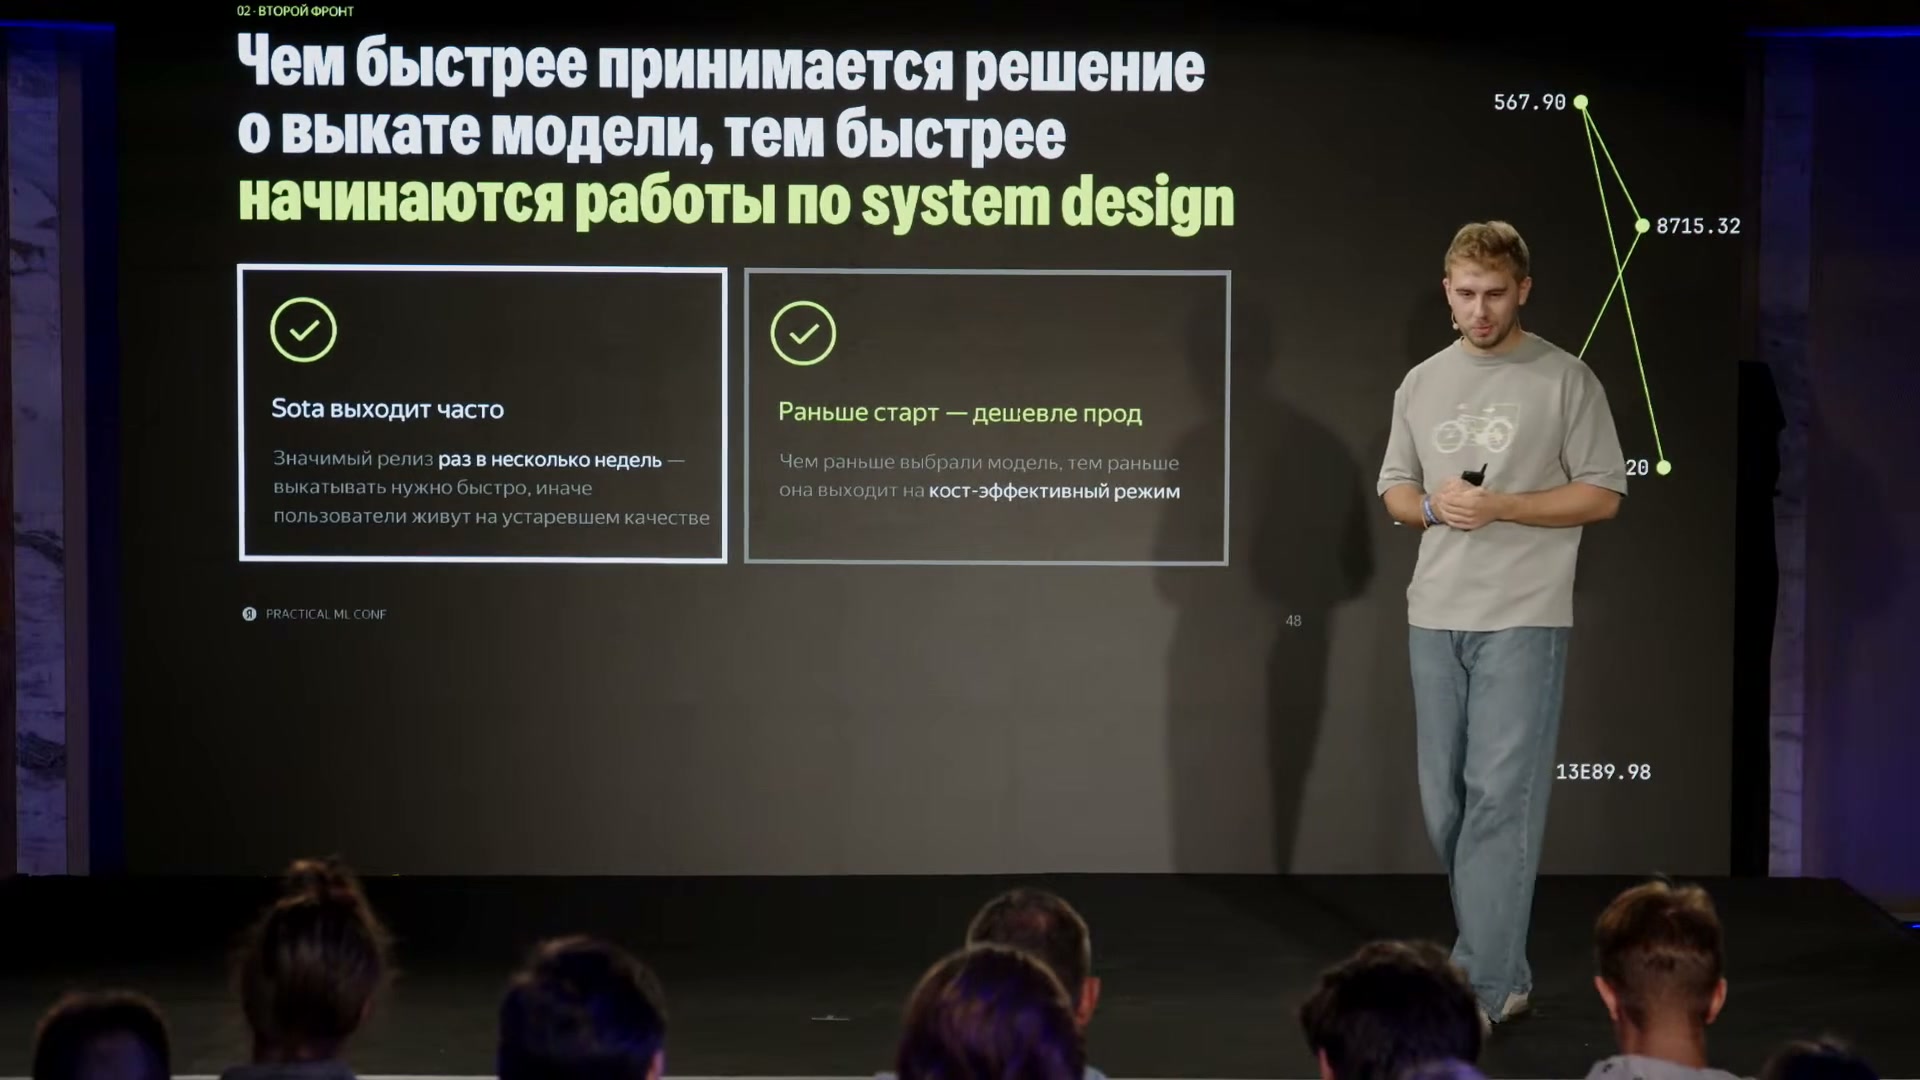
Быстрый выбор модели помогает раньше перейти к настройке организации исполнения.
Источник: Т-Банк · исходный докладT-index: объединение оценок качества
Качество модели проверяют множеством бенчмарков. Сначала оценки внутри тематических групп объединяют в подиндексы, включая Instant для быстрых ответов и Reasoning для задач с рассуждением. Затем взвешивают доступные подиндексы и получают T-index — единый показатель качества.
Веса отражают актуальные задачи компании. В формуле сумма берётся только по присутствующим подиндексам, а знаменатель нормирует их веса. Стоимость токена в T-index не входит: её сопоставляют с качеством отдельно.
Взвешенное среднее по присутствующим подиндексам качества; стоимость отдельно.
Таблицу можно прокрутить по горизонтали.
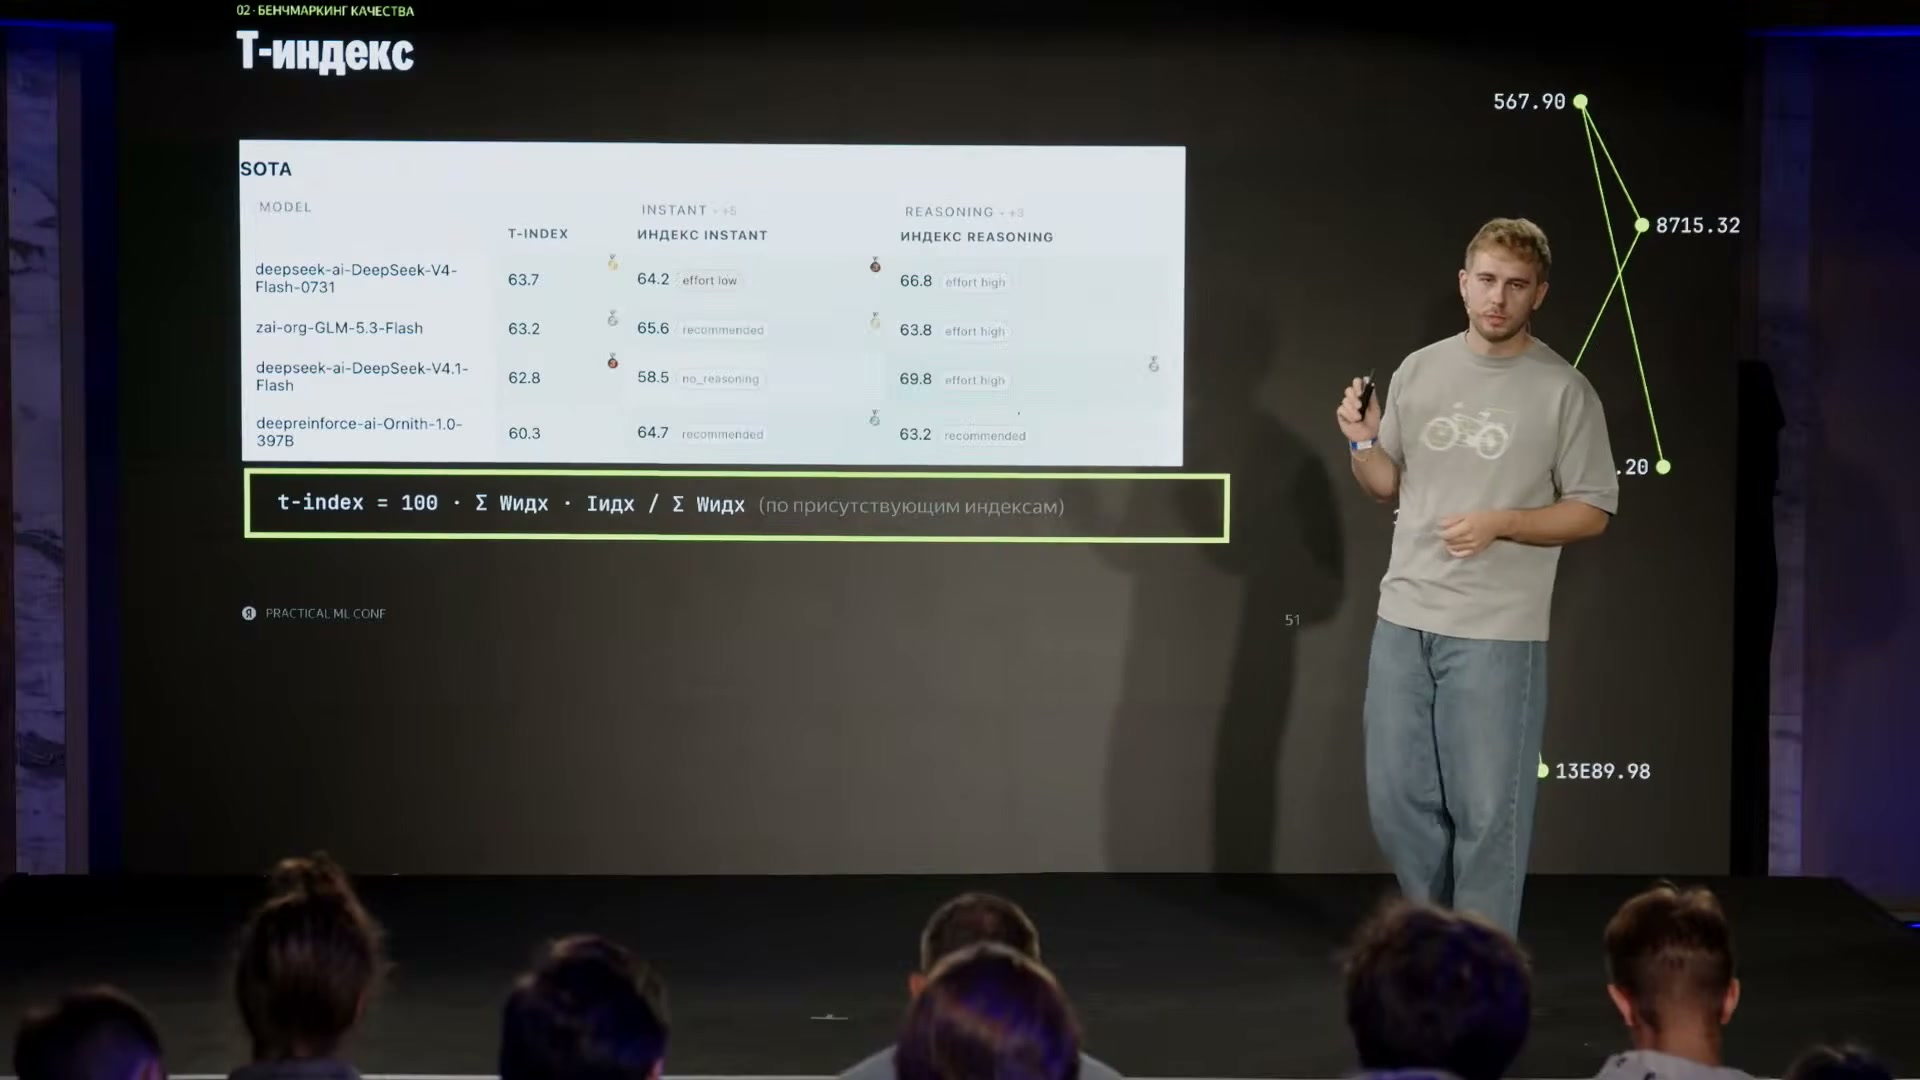
T-index — агрегированный показатель качества с взвешиванием присутствующих подиндексов. Стоимость в показанную формулу не входит.
Источник: Т-Банк · исходный докладКак измеряют производительность
В зависимости от цели сравнивают число запросов в секунду, RPS, или число токенов в секунду. Эти показатели не объявляются взаимозаменяемыми. Одна модель на другом оборудовании или с другими настройками движка может иметь другую производительность; результат закрепляют за полной проверяемой конфигурацией.
Основная нагрузка — реальные производственные данные либо синтетические запросы, воспроизводящие их характеристики. Для отдельного изучения фаз используют синтетические запросы с преобладанием обработки входа или генерации. Такие тесты не подменяют измерение на реальном смешанном трафике.
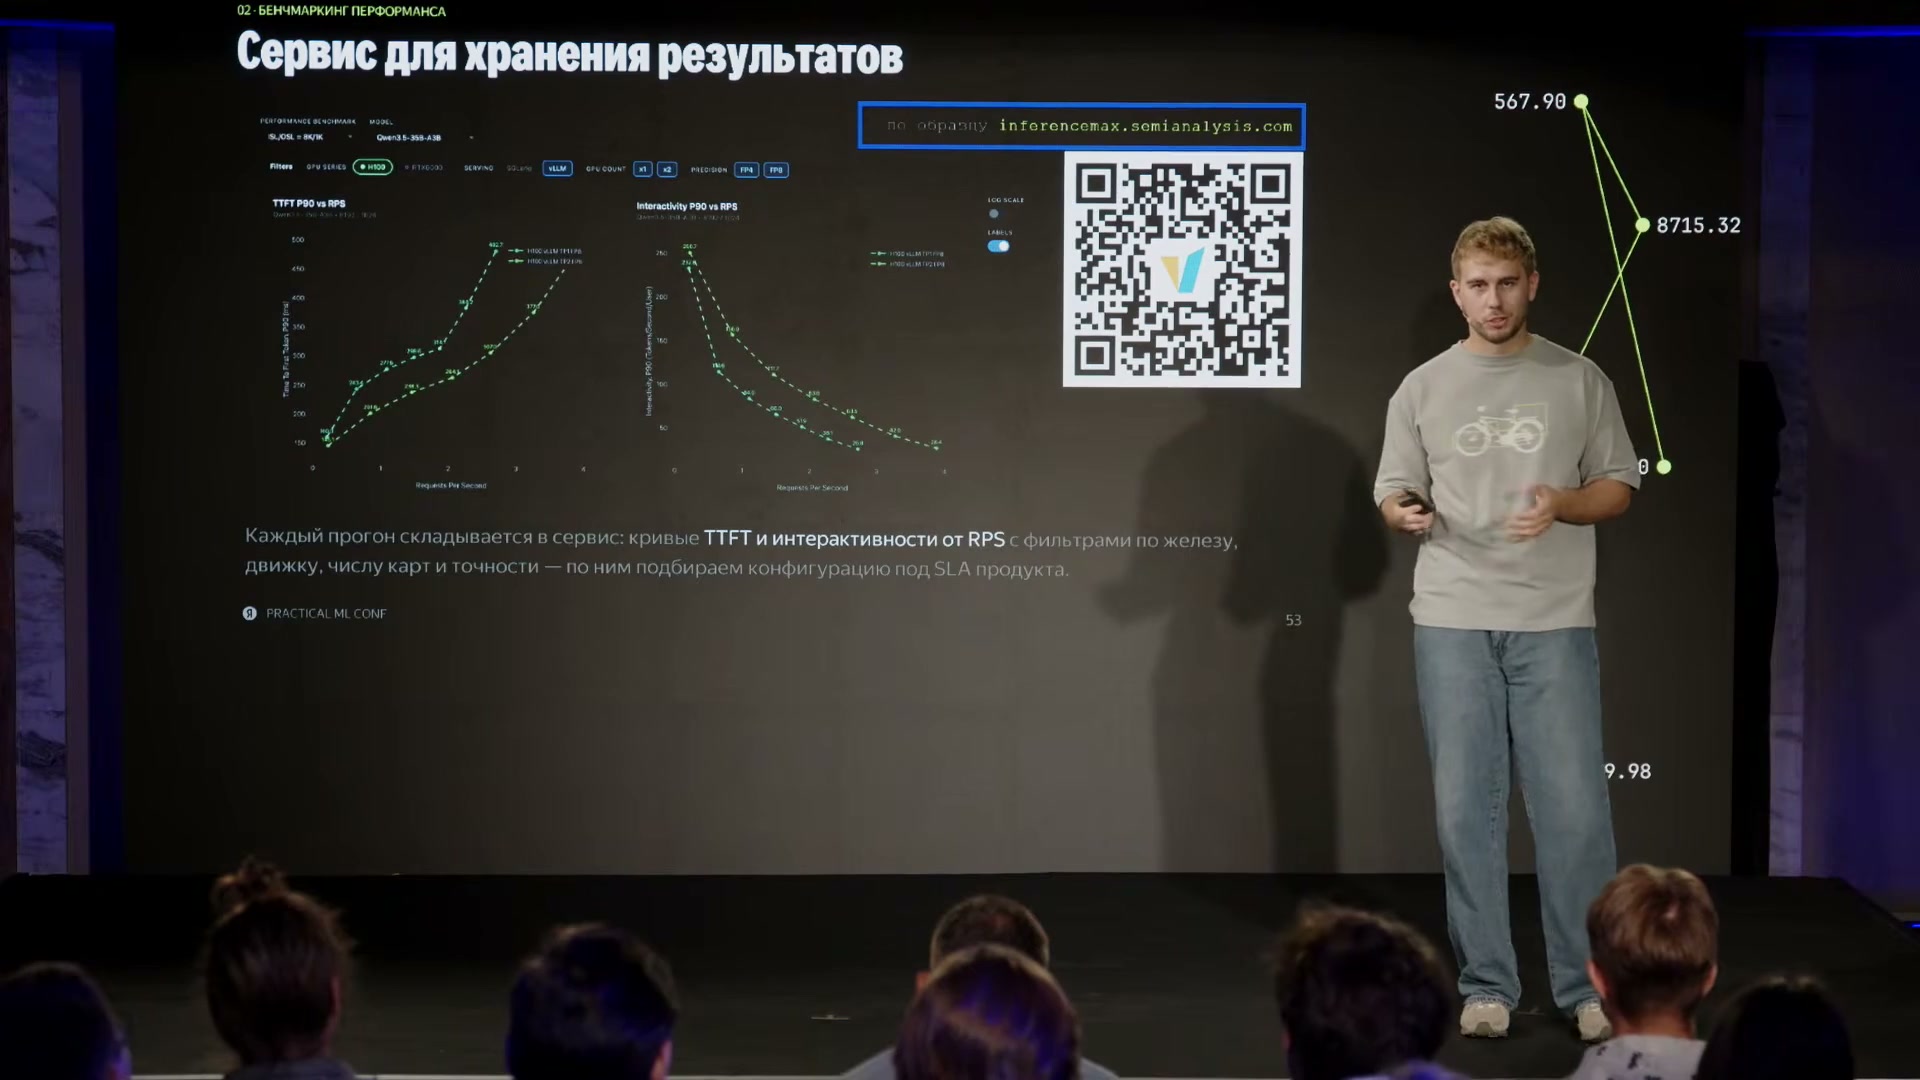
Сервис хранит результаты тестирования конфигураций и показывает распределения метрик.
Источник: Т-Банк · исходный докладСервис хранения результатов испытаний
Сервис оценки (evaluation-service) объединяет запуск проверок, хранение результатов и их просмотр. Здесь это обозначение внутреннего инструмента из доклада. Автор называет ориентиром Inference X, но объясняет необходимость своего решения более широким набором моделей и интересом к альтернативному оборудованию.
Интерфейс показывает отдельные зависимости TTFT P90 от RPS и Interactivity P90 от RPS, позволяя сравнивать хвостовые задержки при разной нагрузке. Результаты фильтруют по оборудованию, движку, числу GPU и точности вычислений. Это испытания конкретных конфигураций, а не измерения пользовательского запроса при каждом обращении.
Сервис хранит результаты тестирования конфигураций и показывает распределения метрик.
Источник: Т-Банк · исходный докладЕдиный процесс выпуска моделей
Если участники работают раздельно, появляются дублирующие инструменты и процессы, а срок вывода модели растёт. Общая доска результатов делает понятным пользователям и разработчикам, почему одну модель включили в сервис, а другую нет.
Выбор только по качеству может направлять ограниченные ресурсы на слишком дорогие варианты. Участие специалистов, отвечающих за сервис и оптимизацию инференса, позволяет учитывать стоимость на этапе выбора, а не разбираться с ней лишь после развёртывания.
Доклад · 05:00:02Итоговая экономия и скорость выпуска
В начале доклада автор говорит о снижении стоимости токена в четыре раза и чуть больше; в финале повторяет четырёхкратное снижение стоимости инференса. Срок выхода модели в сервис назван на уровне одной недели. Автор прямо оговаривает, что модель может ещё не находиться в экономически эффективном режиме.
Общий результат нельзя получать умножением коэффициентов отдельных эпизодов: у обмена кешем, маршрутизации, интеграции ядер и Tensor Parallelism разные сравнения и условия. Финальные выводы связывают техническую и организационную части: сначала работать на уровне системы, а отлаженные инструменты и совместный процесс использовать для своевременного выпуска моделей.
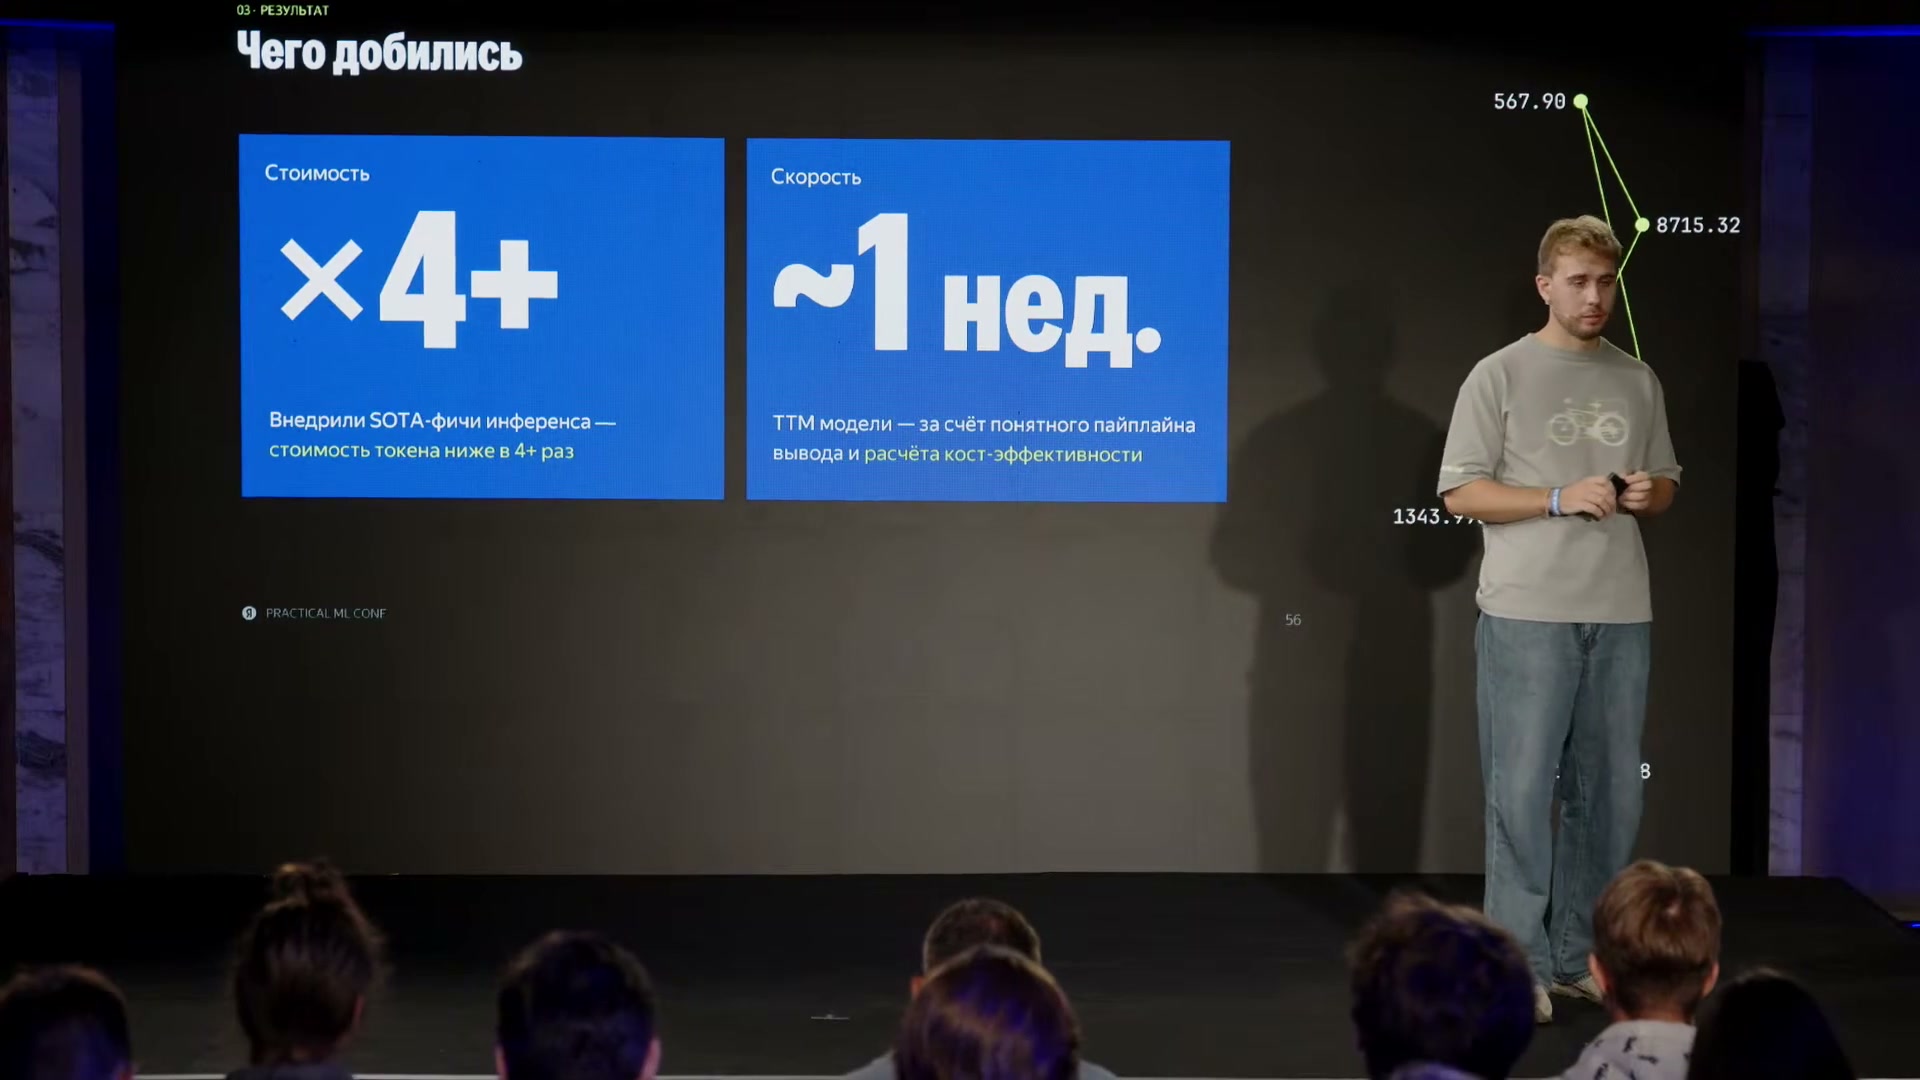
Команда подводит итог: сокращение стоимости и времени запуска. Условия и границы результатов сохраняются в тексте.
Источник: Т-Банк · исходный докладВопрос о разделении prefill и decode
Вопрос: почему при работающем InfiniBand и доработках Mooncake не перейти сразу к разделению prefill/decode, от которого слушатель ожидает большего эффекта? Ответ привязан к трафику компании: выделяя карты под decode, можно забрать ресурсы у доминирующего prefill. Сам факт разделения не гарантирует роста пропускной способности.
Разделение фаз устраняет их взаимное влияние: длинная обработка входа может задерживать выдачу следующих токенов. Это особенно заметно по хвостовым задержкам генерации, например на 90-м и 99-м перцентилях. Но при преобладании prefill выделение GPU под decode само по себе не обещает увеличения пропускной способности.
Ожидаемая польза для команды — возможность отдельно настроить узлы обработки входа и генерации и независимо менять их число. Для prefill автор прямо упоминает ориентир по TTFT; для decode — отдельное управление. Работа над разделением продолжается. Автор ожидает эффект от доступных благодаря ему настроек и других возможностей, а не обещает самостоятельный выигрыш одной лишь перестановки фаз.
Доклад · 05:02:24Вопрос о параллелизме и внимании
Слушатель спрашивает, как Tensor Parallelism на двух картах сочетается с механизмом внимания и не требует ли дублирования KV-cache. Александр отвечает применительно к показанному примеру T-Pro 2.1: включение параллелизма там работало без обсуждаемых затруднений.
Докладчик связывает Tensor Parallelism с линейными слоями и противопоставляет ему параллелизм по контексту, связанный с вниманием. Это сохраняется как объяснение из дискуссии, не как универсальное определение всех реализаций. Слушатель в конце возражает, что классический Tensor Parallelism мог работать с обычным вниманием по головам. Эта реплика сохраняет существенную оговорку к ответу.
В конце слушатель напоминает, что классический Tensor Parallelism может делить вычисления обычного внимания по головам. Обсуждение заканчивается без подробной схемы распределения кеша; практический результат в докладе относится к T-Pro 2.1.
Доклад · 05:04:51Как устроен сервис после изменений
Общий сервис Т-Банка начинался с мощных GPU и готовых движков, но повторно рассчитывал длинные входные контексты. Команда изучила свой трафик, обнаружила большой резерв в переиспользовании кеша и перенесла основную оптимизацию с отдельных операций на организацию исполнения. Совместное использование KV-cache, маршрутизация и устранение инфраструктурных отказов оказались важнее простой замены вычислительных ядер.
- 01
Приём запроса
Продукт обращается к общей модели через внутренний сервис; чувствительные данные остаются в контуре банка.
- 02
Выбор кластера
Маршрутизация направляет связанную сессию в кластер, где доступен её контекст.
- 03
Выбор GPU
Внутрикластерный роутер учитывает расположение кеша и загрузку, уменьшая лишние передачи.
- 04
Передача KV-cache
Mooncake при необходимости переносит уже рассчитанный контекст по InfiniBand, обходя временно недоступные соединения.
- 05
Расчёт ответа
Среда выполнения обрабатывает недостающий вход и генерирует токены; настройки параллелизма влияют на очередь и задержку.
Отдельно от обработки запроса новые модели проходят проверку качества по T-index и нагрузочные испытания на конкретном оборудовании и настройках. Результаты хранятся в сервисе оценки, после чего команда решает, какую модель выпустить. Эти проверки не повторяются при каждом пользовательском обращении.
В докладе заявлены снижение стоимости токена более чем в четыре раза, паритет с историческим предложением OpenRouter и выпуск модели примерно за неделю. Эксперимент с маршрутизацией одновременно улучшил попадание в кеш и немного ухудшил средний TTFT; добавленные компоненты усложнили систему. Разделение prefill/decode и горизонтальное масштабирование ещё разрабатывались. Неделя означает срок выпуска, а не гарантированную экономичность любой новой модели; достигнутые коэффициенты относятся к нагрузке и инфраструктуре команды.
Команда подводит итог: сокращение стоимости и времени запуска. Условия и границы результатов сохраняются в тексте.
Источник: Т-Банк · исходный доклад