Разбор готов
LinkedIn: как долговременная память HLTM помогает Hiring Assistant
Рекрутер начинает новый поиск ML-инженера в LinkedIn Hiring Assistant. Ассистенту нужно уточнить место работы, формат занятости и другие требования, но часть предпочтений уже проявилась в прежних проектах рекрутера. Спрашивать обо всём заново неудобно, а передавать языковой модели всю историю проектов при каждом обращении слишком долго и дорого. В корпоративной системе к этому добавляется принципиальное ограничение: данные разных рекрутеров и клиентов должны оставаться раздельными. Команда LinkedIn создала HLTM — иерархическую долговременную семантическую память. Она заранее превращает проекты и действия в компактные знания, связывает их с бизнес-объектами, а во время диалога ищет только среди доступных пользователю сведений. Разберём устройство дерева, три способа хранения фактов, поиск с указанием источников, обновления памяти и то, как авторы проверяли систему в лаборатории и работающем продукте.
Разбор полезен ML- и AI-инженерам, которые проектируют память для агентов, корпоративный поиск по внутренним данным или персонализированные помощники. Особый интерес представляют разделение предварительной обработки и ответа пользователю, организация прав доступа до поиска, проверка качества памяти и обновление большого индекса без полной пересборки.
Публикация · на английском
Hierarchical Long-Term Semantic Memory for LinkedIn’s Hiring AgentZhentao Xu, Shangjin Zhang, Emirhan Poyraz и соавторы · Опубликовано: 29 апреля 2026 г.
Почему Hiring Assistant вспоминает прошлые проекты
Hiring Assistant помогает рекрутерам находить кандидатов, оценивать их и начинать общение. При запуске нового проекта у ассистента возникает задача калибровки: понять, кого именно хочет нанять человек. В требованиях есть явно названные параметры и привычки, которые можно восстановить по предыдущим вакансиям и работе с кандидатами. Долговременная память нужна именно для этой второй части: она хранит устойчивые сигналы между диалогами, а не заставляет пользователя вновь объяснять одинаковые предпочтения.
На оригинальном снимке интерфейса рекрутер запускает проект Machine Learning Engineer. Ассистент задаёт HLTM вопрос на обычном языке, получает ответ со ссылками на использованные сведения и обновляет поля требований. В показанном примере выделены регион San Francisco Bay Area и гибридный формат работы. Это иллюстрация конкретного пользовательского сценария: память даёт сведения, а ассистент применяет их к форме нового проекта.
Здесь нас интересует внутренний сервис памяти. Сам Hiring Assistant организован как система с ведущим агентом, который планирует действия и вызывает специализированные инструменты. О его общей многоагентной архитектуре достаточно знать одно: когда для решения задачи нужны прошлые предпочтения, ведущий агент обращается к HLTM. Основное инженерное решение статьи — как такую память подготовить, найти и обновить с учётом корпоративных прав доступа. Исследование подготовили Zhentao Xu, Shangjin Zhang, Emirhan Poyraz и соавторы для KDD 2026 (DOI: 10.1145/3770855.3818432).
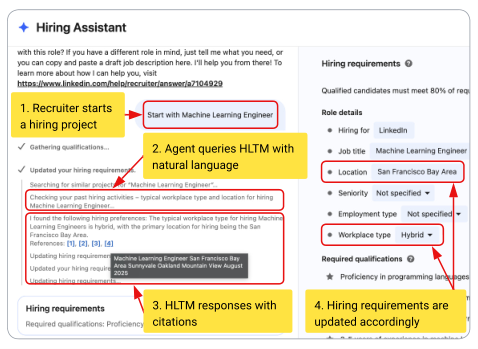
Hiring Assistant использует найденную память с цитатами при уточнении требований рекрутера.
Источник: Оригинальная иллюстрация · LinkedInПочему обычной истории агента недостаточно
Первая сложность — масштаб. История рекрутера складывается из проектов, сведений о кандидатах, действий и других структурированных и свободных текстов. Во вторую очередь важна скорость: интерактивному помощнику нельзя каждый раз передавать модели десятки тысяч токенов истории и ждать, пока она заново извлечёт нужные закономерности. Авторы поэтому стремятся выполнить основную тяжёлую работу заранее, а в диалоге оставить короткий и предсказуемый путь поиска.
Ещё три требования связаны с эксплуатацией. Память обязана учитывать права доступа между компаниями, рекрутерами и проектами и поддерживать удаление данных. Она должна подстраиваться под меняющиеся вопросы: сегодня важны города найма, завтра — типы занятости или требования к квалификации. Наконец, для каждого ответа желательно знать, откуда получились факты, иначе трудно отлаживать неверные предпочтения и поддерживать соответствие первичным документам после их правок.
Исследования памяти агентов решают отдельные части этих задач. MemGPT и MemOS управляют обменом между контекстом модели и внешним хранилищем; Mem0 хранит отдельные воспоминания; MemoryBank учитывает давность взаимодействий; ReadAgent создаёт короткие опорные выдержки; SCM выбирает, когда запоминать, изменять и извлекать сведения. GraphRAG, HippoRAG, A-Mem и G-Memory связывают факты в графы, а RAPTOR, TreeRAG и MemTree используют древовидную организацию.
Для Hiring Assistant авторы выделяют слабые места готовых принципов организации. Кластеризация похожих документов не обязана соблюдать корпоративную принадлежность; построение некоторых графовых индексов требует многочисленных вызовов LLM; получение общего ответа из множества листьев может оказаться медленным; свёртка по общим знаниям модели способна пропускать предметные детали. Отсутствие явных идентификаторов первичных сведений затрудняет проверку результата. HLTM объединяет несколько уже известных идей, но ставит границы владения данными в основу самого дерева.
1. Introduction; 2. Related WorkДерево памяти повторяет границы владения
Вместо построения дерева по смысловому сходству документов LinkedIn берёт корпоративную схему. На верхнем уровне находятся контракт или организационный аккаунт, ниже — учётное место рекрутера в сервисе (seat), затем его проекты найма. История действий, память о кандидатах и документы проекта служат исходными данными для узлов. На архитектурной иллюстрации поэтому отдельно подписаны contract level, seat level, project level и raw data. В формальном дереве бизнес-памяти нижними узлами считаются проекты; кружки сырых данных под ними показывают прикреплённые источники, а не обязательные самостоятельные вершины.
Дерево записывается как T = (V, E): V — узлы бизнес-сущностей, E — связи родителя с дочерним узлом. Каждый узел владеет памятью своей сущности и имеет устойчивый идентификатор, по которому можно восстановить происхождение сведений. Один проект связан с одним разрешённым путём владения, поэтому данные разных рекрутеров не приходится смешивать при смысловой кластеризации.
У схемы есть два практических следствия помимо приватности. Изменение проекта затрагивает его собственный узел и предков, но не соседние ветви; число перестраиваемых узлов определяется высотой дерева, а не общим количеством узлов при полном обходе. Кроме того, появление новых данных не вынуждает заново группировать все документы по близости эмбеддингов. При семантическом кластерном дереве новые тексты могут менять состав групп, а отказ от перегруппировки со временем ухудшает их соответствие данным.
Оригинальная схема показывает три раздельные части: слева агенты заранее извлекают и упаковывают знания, в центре данные организованы по уровням владения и записаны в документное и векторное хранилища, справа разрешённый запрос находит узлы и получает ответ. Пунктирная связь снизу относится к последующей адаптации памяти по накопленным обращениям; она не означает, что данные и модель переобучаются при каждом вопросе.
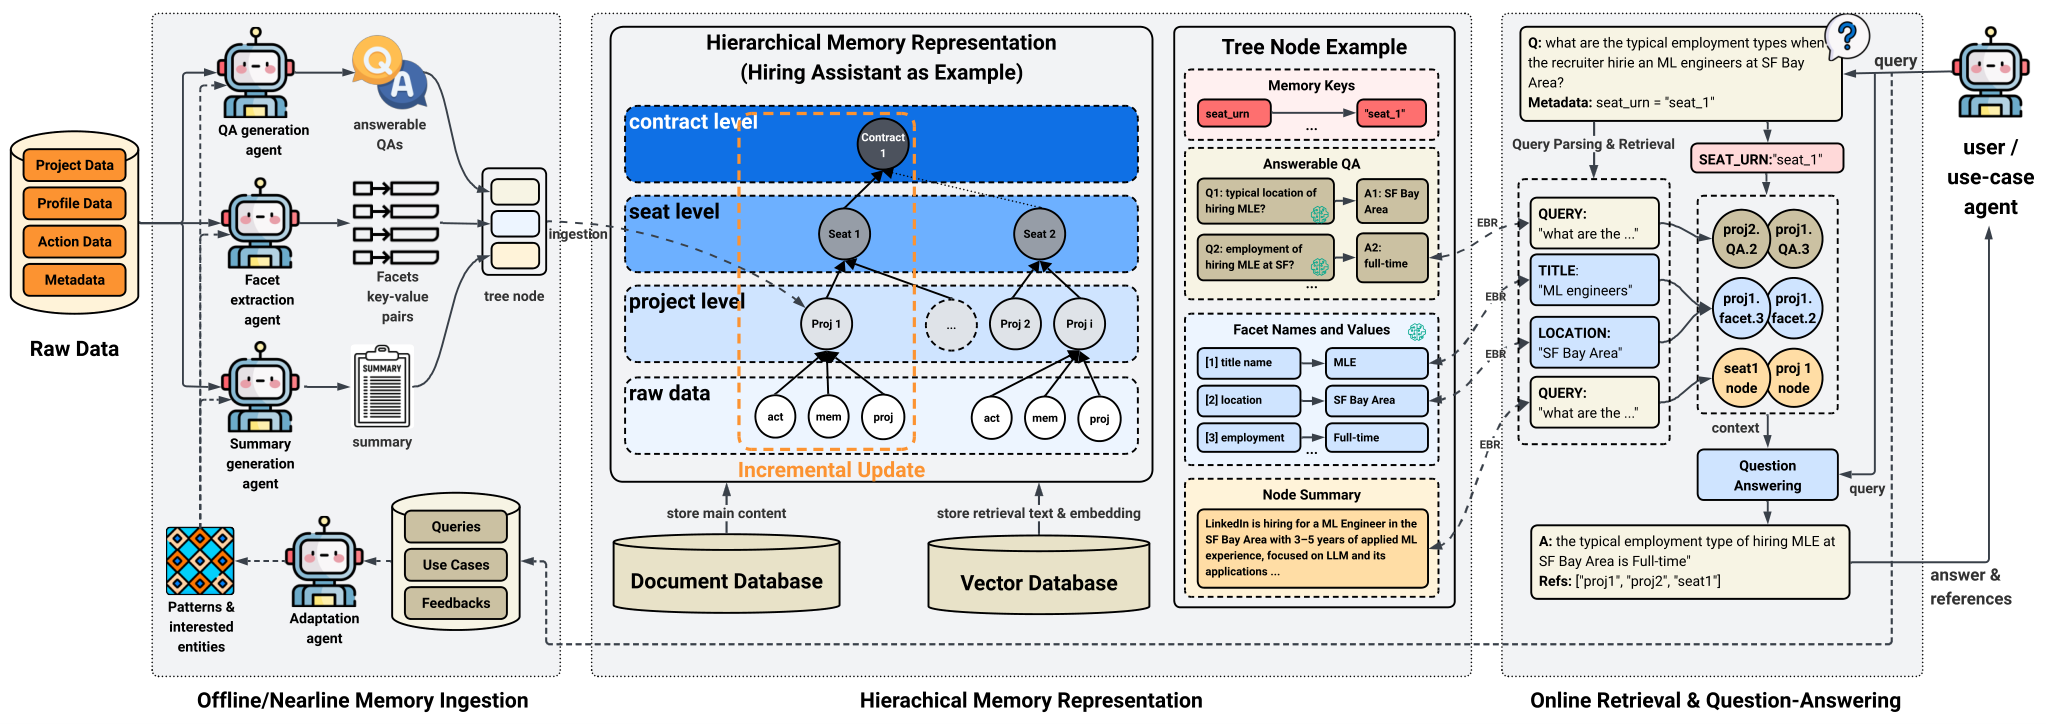
Общая схема HLTM: подготовка памяти, иерархическое представление знаний и поиск для ответа на новый вопрос.
Источник: Оригинальная иллюстрация · LinkedInТри вида знаний в каждом узле
Сырой документ неудобен для большинства запросов: в нём много разрозненных подробностей, а один абзац сжатого текста не всегда содержит нужное поле или формулировку. Поэтому каждому узлу v HLTM сопоставляет три представления M_v = (F_v, Q_v, S_v): факты в виде пар «поле — значение» (facets), заранее подготовленные пары «вопрос — ответ» (QA) и текстовую сводку (summary). В зависимости от вопроса наиболее полезным окажется разный вид знания.
Таблицу можно прокрутить по горизонтали.
Для фактов языковая модель извлекает плоский словарь: каждому названию поля соответствует строковое значение без вложенных объектов. Векторное представление (эмбеддинг) — набор чисел, позволяющий сравнивать близость текстов по смыслу — вычисляется для строки вида «location: SF Bay Area». Полный набор фактов остаётся в документном хранилище, а поисковые строки с эмбеддингами — в векторном индексе. Такой формат хорошо подходит для городов, должностей и требований к работе, но не удерживает весь смысл сложных событий.
Генератор QA получает данные узла и заранее составляет короткие однозначные вопросы, на которые эти данные действительно отвечают. В опубликованной инструкции он должен создать 5–10 самодостаточных пар, добавить пояснение (rationale) и указать source — ID исходного документа. В индекс помещают эмбеддинги вопросов, а найденная пара возвращает уже подготовленный ответ. Этот режим авторы называют think-fast: часто задаваемый вопрос удаётся сопоставить с готовым знанием, прежде чем запускать финальную генерацию.
Для неоднозначных и повествовательных сведений работает агент сводок. Сначала он пишет содержательный абзац, сохраняя важные детали и ID документов, если они доступны. Затем отдельная инструкция сжимает абзац до одного предложения: оно удобно для поиска по вектору, тогда как развёрнутый текст пригодится языковой модели при ответе. В приложении к статье приведены шаблоны всех трёх инструкций. Это конкретные форматы извлечения и записи данных, а не обучение новой языковой модели под каждого рекрутера.
3.3. Memory Representation; Appendix A.1. Facet Extraction; Appendix A.2. Question–Answer Generation; Appendix A.3. Summary GenerationКак отдельные проекты превращаются в предпочтения
Допустим, рекрутер несколько раз искал ML-инженеров в одной географии и предпочитал определённый формат работы. Отдельный проект содержит только часть картины, а широкий вопрос «кого этот рекрутер обычно нанимает?» требует объединить сведения из разных проектов. Можно было бы во время запроса найти множество исходных документов и сразу попросить LLM обобщить их. Авторы объясняют, почему это плохо масштабируется: длинное чтение увеличивает время и стоимость, важные сигналы теряются в шуме, а общий вопрос не обязательно похож в векторном пространстве на конкретную вакансию.
HLTM делает объединение заранее, снизу вверх. Сначала создаётся память проектов. Для каждого узла seat агент получает подготовленные представления дочерних проектов и формирует собственные F, Q и S. Затем та же операция применяется к более высокому уровню контракта. В результате система уже хранит не только сведения о конкретном проекте, но и обобщённую картину интересов его владельца.
При создании родительской памяти LLM предлагают собрать семантически близкие факты, объединить повторы, согласовать противоречия и при необходимости убрать малозначимые детали, редко встречающиеся в нескольких дочерних узлах. Такое сжатие помогает отвечать быстро, хотя качество сводки всё равно зависит от извлечённых данных и работы модели. Поэтому тезис о «без потерь» в названии инкрементального индексирования нельзя переносить на смысловую полноту каждой сокращённой записи.
Получается содержательное различие между глубинами дерева: проект отвечает на вопрос о конкретном поиске, учётное место рекрутера — о привычках по нескольким проектам, а родительский узел — о более широкой совокупности. Сами границы доступа при этом сохраняются: наличие общей памяти на высоком уровне не даёт рядовому рекрутеру права искать её вне своего разрешённого поддерева.
3.4. Hierarchical Memory AggregationКак готовые представления попадают в индекс
Подготовка памяти — самостоятельный процесс вне диалога. Из данных проектов, профилей, действий и метаданных агенты извлекают факты, составляют QA и сводки. Следующий проход объединяет дочерние воспоминания в представления более высоких узлов. Основное текстовое содержимое записывают в документное хранилище; короткие поисковые тексты, вопросы и их эмбеддинги — в векторное. Устойчивые идентификаторы узлов связывают извлечённые сведения с исходными бизнес-объектами.
Авторы отдельно называют фактическую производственную основу LinkedIn: пакетная обработка при помощи PySpark и внутренние документное и векторное хранилища. PySpark позволяет обрабатывать и распределять большие объёмы данных по параллельным задачам. Выбор этой инфраструктуры согласуется с целью переносить тяжёлые вызовы LLM на предварительный этап. Исследовательский стек для сравнительных таблиц будет описан отдельно: его Python-библиотека и API моделей не должны автоматически считаться компонентами боевого сервиса.
На стадии подготовки у каждой формы памяти своя цена. Факты и короткие вопросы проще искать, но они могут упустить обстоятельства решения. Подробная сводка охватывает больше связей, однако тратит вычисления на обобщение. Разделение представлений и возможность независимо готовить ветви позволяют заранее заплатить за эти операции, чтобы в момент пользовательского запроса лишь выбрать уже построенные записи.
3.1. Overview; 3.3. Memory Representation; 4.4. Implementation DetailsКак память подстраивается под вопросы
Рекрутеры задают разные вопросы, и со временем их интересы меняются. Если построение памяти полагается только на представления языковой модели о том, что обычно важно при найме, она может плохо подготовить ответы на реальные обращения продукта. Поэтому HLTM использует петлю адаптации: периодически рассматривает накопленный поток вопросов и извлекает повторяющиеся формулировки и названия значимых атрибутов.
Типичные шаблоны вопросов становятся подсказками для агента, который создаёт пары QA. Если люди часто спрашивают о предпочтительном типе занятости, это помогает заранее составлять соответствующие вопросы из первичных документов. Имена часто интересующих полей можно также передать агенту извлечения фактов и агентам сводок, чтобы они обращали внимание на нужные характеристики. На схеме эта петля получает Queries, Use Cases и Feedbacks и передаёт найденные паттерны обратно в процесс подготовки памяти.
Чтобы не перестраивать индекс под единичный случай, система оставляет лишь паттерны с достаточным количеством независимых употреблений — minimum support. В чувствительной среде авторы допускают ручное согласование изменений перед выпуском в конвейер индексации. Адаптация происходит периодически и меняет содержание готовой памяти. Во время отдельного запроса ассистент пользуется подготовленным индексом; здесь не требуется заново учить веса генеративной модели на пользовательских данных.
3.6. Adaptation via Query Pattern Analysis; Figure 3. Overview of HLTMКак обновлять память без полной пересборки
Содержимое проектов меняется: добавляются взаимодействия, исправляются сведения, появляются новые проекты, а устаревшие записи могут удаляться. Полная переиндексация заставила бы заново создавать все представления, сводки и эмбеддинги, даже если изменился один проект. HLTM отслеживает множество затронутых листьев V*: для каждого пересчитывает его собственное представление, затем последовательно обновляет родителей до корня. Соседние ветви, не затронутые изменением, не трогают.
Для удаления одного лишь исключения исходного документа недостаточно, потому что его сведения могли попасть в родительскую сводку. В экспериментальной процедуре авторы удаляли устаревшие листья, добавляли новые и обновляли изменённые, после чего пересчитывали соответствующие цепочки предков. Каждый родитель строится по актуальным дочерним воспоминаниям. Поэтому инкрементальное дерево должно совпадать с полной пересборкой на том же снимке данных. Здесь слово lossless, «без потерь», характеризует эквивалентность двух способов построения индекса, а не гарантирует дословное сохранение всех фактов внутри LLM-сводки.
Эту эквивалентность проверяли отдельно на полном производственном наборе данных LinkedIn: на протяжении двух недель параллельно выполняли полное и инкрементальное индексирование и сравнивали полученные деревья. Топология и содержимое совпали с учётом недетерминированности генерации, измеримого ухудшения качества индекса не было. Работающий более шести месяцев инкрементальный конвейер, по оценке авторов, сократил число вызовов LLM и расходы на 80–90% относительно полной пересборки.
Таблицу можно прокрутить по горизонтали.
Числа в таблице относятся к обработке полного производственного набора при двух стратегиях. В описании самого механизма авторы отдельно говорят о желаемой свежести отдельных изменений в пределах нескольких минут. Эти два масштаба времени не следует путать с задержкой ответа на чатовый вопрос: во время ответа индекс уже подготовлен.
3.7. Lossless Incremental Nearline Indexing; Appendix D. Incremental Indexing Evaluation; Table 8. Incremental indexing evaluation on LinkedIn’s production dataset.Сначала определяется доступная область памяти
Во время диалога HLTM получает не только текст вопроса, но и деловую идентичность, в рамках которой разрешён доступ. На исходной схеме у запроса указан метаданный идентификатор seat_urn: "seat_1". Он задаёт учётное место рекрутера и тем самым границу поиска. Для запроса по конкретному проекту граница сужается ещё сильнее. Система выбирает корневой узел этой области и допускает к поиску лишь его самого и принадлежащих ему потомков.
Пусть T_v — поддерево с корнем v. В статье оно определяется как часть T, состоящая из {v} и всех Desc(v), то есть его потомков. Это жёсткая фильтрация кандидатов ещё до семантического поиска. Если v соответствует рекрутеру, документы другого рекрутера не попадают в множество, где рассчитывается близость. При запросе уровня проекта не используются соседние проекты. На более широком уровне обращаться к общим узлам можно только при наличии соответствующего разрешения.
Разрешённый набор узлов: сам бизнес-объект v и его потомки. Все три поисковых канала работают внутри этой области.
Это отличие от инструкции в промпте вроде «не отвечай о чужих проектах»: запрещённые данные вообще не поступают в поисковую выборку и не должны попасть в контекст ответа. По смыслу HLTM развивает идею collapsed-tree retrieval из RAPTOR: можно сравнивать узлы разных глубин в одном пространстве поиска, но только внутри разрешённого поддерева. Одно дерево служит запросам разного масштаба без повторного построения индекса на каждом уровне.
3.5. Memory Retrieval and Answer Generation; 3.5.1. Identity-scoped Subtree Filtering; 4.7. Privacy DiscussionТри независимых способа найти сведения
После ограничения области HLTM должна ответить, какие из допустимых воспоминаний действительно относятся к вопросу. Одно векторное сравнение не всегда справляется: запрос может перечислять строгие условия, задавать типичный вопрос о прежних проектах или просить обобщить историю. Поэтому система использует три взаимодополняющих поисковых компонента — по фактам, по заранее подготовленным вопросам и по сводкам. Для каждого узла они вычисляют собственную оценку соответствия и возвращают наиболее полезные записи своего типа.
В поиске по фактам запрос сначала разбирают на пары «поле — значение». Например, вопрос о типичных условиях найма инженеров в San Francisco Bay Area можно разложить на «title: software engineer» и «location: San Francisco Bay Area». Каждая пара становится маленьким отдельным запросом к индексу уже извлечённых полей. Близость сравнивается косинусом угла между эмбеддингами: чем ближе направление векторов, тем больше смысловое сходство.
Для одного поля запроса система берёт k самых близких фактов конкретного узла; затем усредняет оценки по выбранным фактам и всем полям запроса. Такой подсчёт не заставляет оценку ухудшаться только из-за большого числа других, не относящихся к вопросу фактов внутри проекта. Узлы с наибольшей полученной оценкой дают контекст из своих F_v.
Оценка по полям: q — вопрос, F_q — извлечённые из него требования, F_v — сохранённые факты узла v, TopK — k наиболее близких фактов для одного требования.
Поиск QA устроен иначе. Языковая модель уже составила для каждого узла набор вопросов с ответами; теперь ищут самый близкий к текущему вопрос из этого набора. Оценка узла равна максимальному косинусному сходству с одним подготовленным вопросом. Найденная пара приносит в контекст не только похожий вопрос, но и ответ, полученный из данных при индексировании.
Оценка по готовым вопросам: выбирается вопрос q′ из QA-памяти узла, наиболее близкий к новому запросу q.
Третий компонент сравнивает запрос с поисковой сводкой узла. Он полезен, когда человек спрашивает о привычках в целом, а ни одно отдельное поле или готовый вопрос не охватывает нужной ситуации. Узлы сортируются по косинусному сходству с краткой сводкой, после чего в контекст можно передать её содержательную версию.
Оценка по сводке: сравниваются представления вопроса и заранее подготовленной сводки узла.
Итогом становятся три набора top-k: F_k(q), Q_k(q) и S_k(q). В обозначениях статьи предусмотрены отдельные лимиты k_facet, k_QA и k_summary. Поэтому «многосигнальный поиск» здесь означает сочетание нескольких видов содержимого, а не обязательный обучаемый ранжировщик с суммой трёх оценок. На иллюстрации найденные проекты и узел рекрутера составляют контекст, с которым дальше работает генерация ответа.
3.5.2. Multi-signal Retrieval; Facet-based Retrieval; Answerable-QA Retrieval; Summary-based RetrievalКак ответ связывается с первичными сведениями
Когда поиск закончен, HLTM передаёт языковой модели текущий вопрос и содержимое трёх найденных наборов. Модель формулирует ответ на основе контекста. В статье это описано как генерация с подстановкой найденных сведений в запрос (in-context learning): LLM использует память при построении ответа, но её веса при этом не обучаются заново.
На вход финальной модели поступают вопрос и выбранные факты, пары QA и сводки; на выходе — текст ответа и ссылки на узлы памяти.
Ссылки — не произвольные внешние URL. Это идентификаторы узлов дерева, на которые опирается ответ: проект, учётное место рекрутера или другие доступные сущности. По ним можно найти происхождение предпочтения, проверить связь с первоначальными записями и разбирать случаи неверного ответа. Например, на архитектурном рисунке ответ о типичной полной занятости сопровождается Refs с идентификаторами проектов и рабочего места рекрутера. Значения на рисунке демонстрируют форму ответа, а не статистику точности.
В опубликованном шаблоне ответа Appendix A.4 задан JSON с полями rationale, answer и citation. Поле citation содержит упорядоченный список идентификаторов узлов, которые уже находятся в предоставленном контексте. Для подготовки QA в отдельном промпте предусмотрено поле source с ID исходного документа, а для сводок — сохранение таких ID по возможности. Вместе с устойчивыми бизнес-идентификаторами это создаёт путь от ответа к подтверждающим записям.
На интерфейсном примере эти ссылки позволяют ассистенту показать, из каких прошлых проектов взяты требования к новой вакансии. Такая наблюдаемость особенно важна для корпоративных сценариев: исправление проекта или удаление данных затем должно затронуть как детальную память, так и родительские сводки, из которых могло происходить утверждение.
3.5.3. Answer Generation with Retrieved Context; Appendix A.4. Question AnsweringКакие данные использовали для проверки
Сначала авторы собрали исследовательский набор из истории использования LinkedIn Hiring Assistant. В нём есть прежние проекты найма, взаимодействия с кандидатами, обезличенные данные проектов и кандидатов. Вопросы двух видов. Одни просят обобщить несколько проектов и определить предпочтения — например, характерные должности, локации и квалификацию. Другие требуют извлечь конкретный проект или подтверждающий фрагмент. Для каждого вопроса создали экспертный эталон ответа.
Чтобы уменьшить зависимость качества от одного разметчика, каждый эталон независимо составляли не менее трёх специалистов по предметной области; при разногласии использовали решение большинства. Отдельно оценили LongMemEval-s — публичный набор о долговременной памяти в диалоге. Он проверяет обновление ранее известных фактов, вопросы по нескольким сеансам общения, сведения и предпочтения из отдельных сеансов, а также временные связи.
Таблицу можно прокрутить по горизонтали.
Эти корпуса нужны для сравнения методов по одинаковым вопросам и эталонам, а не для обучения LLM в момент диалога. LinkedIn-набор проверяет прежде всего повторное использование рекрутерских предпочтений; LongMemEval-s показывает, работает ли подход за пределами одной предметной области. В обоих случаях число запросов и объём истории описывают исследовательскую выборку, а не размер всего производственного индекса.
4.1. Dataset; Table 1. Dataset summary statistics.Как определяли качество и стоимость памяти
Одно и то же содержание можно выразить разными словами, поэтому команда использует несколько метрик. Token-F1 оценивает баланс между словами, которые правильно совпали с эталоном, и словами, которые были лишними или пропущенными. BLEU-1 дополняет его сравнением отдельных слов с акцентом на точность. Для вопросов, где нужна конкретная информация, отдельно считают precision — долю подходящих среди найденных результатов, recall — долю обнаруженных нужных результатов, и их гармоническое среднее F1.
Смысловую правильность summary-ответов измеряли языковой моделью-судьёй (LLM-as-a-judge). Ей показывали вопрос, ответ системы и экспертный эталон; просили сравнивать факты, включая числа и названия сущностей, опираясь только на эталон. Выход — число от 0 до 1 и краткое обоснование. Такой подход позволяет оценивать смысл без требования дословно копировать эталон, но нуждается в проверке согласия с людьми.
Для этого около 200 троек «вопрос — ответ» независимо оценили по 2–4 эксперта. Согласованность между экспертами по квадратично взвешенному коэффициенту κ Коэна превысила 0,8; модель-судья при сравнении с решением большинства достигла того же порога. Это отдельное исследование надёжности судьи, а не метрика точности самой памяти.
Стоимость авторы рассматривают в двух режимах. При построении индекса важно время подготовки большого числа документов и возможность распределить работу между параллельными заданиями. При выполнении вопроса считают задержку до ответа, число вызовов LLM и число потраченных токенов — включая переписывание вопроса, планирование, обработку при поиске и финальную генерацию. Там, где алгоритмы поддерживают параллельную работу, используют фиксированную конкурентность. Для всех методов токены считают одинаковым токенизатором o200k_base.
4.2. Evaluation Metrics; 4.2.1. Performance Metrics; 4.2.2. Deployment MetricsС какими способами памяти сравнивали HLTM
Для простой исходной точки использовали три варианта. Full-context подаёт LLM всю доступную историю или её часть, влезающую в контекстное окно. Обычная RAG заранее делит документы на фрагменты одинаковой длины и во время вопроса ищет близкие фрагменты по эмбеддингам. Schema Filter извлекает табличные поля из документов и по полям запроса выбирает подходящие документы для финального ответа. Последний вариант показывает, что даёт сама корпоративная схема без иерархических сводок и трёх представлений HLTM.
Более сложные сравнения включают графовые GraphRAG, HippoRAG и A-Mem; систему SimpleMem; древовидную RAPTOR; методы Mem0 и ReadAgent. Итого в основной таблице — десять базовых методов и HLTM. TreeRAG и MemTree обсуждаются как близкие исследования, но их численного сравнения авторы не проводят, потому что на момент работы не было доступных запускаемых публичных реализаций.
Здесь особенно важно различить готовый продукт и эксперимент. Рабочая HLTM в LinkedIn использует PySpark для предварительной загрузки и собственные документное и векторное хранилища. Для статьи инженеры отдельно переимплементировали HLTM как Python-библиотеку, чтобы проверять её в одинаковых условиях с другими способами памяти. Сравнение запускалось на Python 3.12 через Azure OpenAI Service API; эмбеддинги рассчитывала text-embedding-3-large, главной языковой моделью была GPT-4o mini. Кроме неё использовали четыре открытые модели: Gemma 3 27B, Qwen3 32B, GLM-4 32B и GLM-4.5 Air 106B.
Во всех сравнениях между подходами фиксировали основную LLM, модель векторизации, условия обслуживания и доступное окно контекста. Для baseline использовали исходные настройки открытых реализаций, если не оговорено иное; результаты усредняли по трём запускам. Такой протокол позволяет сравнить конструкции памяти при общем экспериментальном стенде, но названные GPT-4o mini, Azure API и text-embedding-3-large — параметры этого стенда, а не подтверждённый перечень внутренних моделей и сервисов промышленного Hiring Assistant.
4.3. Baselines; 4.3.1. Basic Baselines; 4.3.2. Advanced Baselines; 4.4. Implementation DetailsЧто получилось на запросах Hiring Assistant
На собственном наборе LinkedIn сравнили, насколько хорошо методы отвечают на вопросы об общих предпочтениях и насколько полно находят нужные проекты и подтверждающие сведения. Главные показатели для этих задач разные: для обобщения — смысловая правильность ответа относительно экспертного эталона, для точечного поиска — F1 извлечения. Ниже приведена вся исходная таблица для основной модели GPT-4o mini, включая простые методы, графовые индексы и разные виды внешней памяти.
Таблицу можно прокрутить по горизонтали.
Для обобщающих вопросов HLTM получила правильность 0,892 ± 0,007, тогда как самая сильная альтернативная строка — HippoRAG с 0,833 ± 0,010. Разница равна 0,059 по шкале от 0 до 1; авторы описывают итог как улучшение более чем на 5%. Для вопросов на извлечение HLTM достигла F1 = 0,782 ± 0,014, лучший базовый вариант ReadAgent — 0,617 ± 0,015. Здесь разница составляет 0,165 шкалы, а текст статьи называет выигрыш более чем 10%. Эти значения нельзя подменять долями негативных оценок пользователей: это лабораторные метрики на размеченных вопросах.
Оба ключевых сравнения прошли критерий знаковых рангов Уилкоксона с p < 10⁻⁷. Авторы также указывают меру размера эффекта Клиффа: δ = +0,058 для правильности обобщения против HippoRAG и δ = +0,328 для F1 извлечения против ReadAgent. Это полезное дополнение к статистической значимости: сила превосходства в двух задачах не одинаковая.
Из таблицы видна цена выбора метрики. Например, RAPTOR имеет хороший Token-F1 при обобщении (0,539), но заметно уступает по смысловой правильности и точечному поиску. Полный контекст хорошо покрывает некоторые нужные документы, однако ввод большой истории сам по себе не гарантирует точного вывода. HLTM выигрывает по показанным ключевым метрикам на этом наборе и в этих условиях; оценка скорости и числа токенов вынесена в отдельное сравнение.
4.5.1. Overview; 4.5.2. Quality Analysis; Table 2. LinkedIn dataset answer performanceЧто изменилось на разговорной памяти
Чтобы понять, зависит ли выигрыш только от структуры рекрутерских проектов, авторы применили те же способы памяти к LongMemEval-s. В этой задаче важны не вакансии, а длительная история диалога. Вопрос может попросить вспомнить сообщение пользователя, сопоставить несколько сеансов общения, учесть изменившийся факт или рассуждать о последовательности событий во времени.
Таблицу можно прокрутить по горизонтали.
HLTM получила общую правильность 0,778 ± 0,019 против 0,716 ± 0,020 у лучшей альтернативы A-Mem — абсолютная разница 0,062. Авторы кратко описывают преимущество как 6%. HLTM лидирует во всех шести типах вопросов. Особенно показательно сопоставление нескольких сессий: 0,632 против 0,556 у A-Mem. Именно такую задачу помогает решать предварительное объединение информации между узлами.
Отдельные конкуренты при этом остаются сильными в своих сценариях: обычная RAG достигает 0,923 по вопросам об ассистенте в одной сессии, а A-Mem и HippoRAG — 0,946 на том же типе. Основной вывод здесь состоит в более ровной совокупной работе HLTM на разных разновидностях долговременной памяти. Это дополнительный тест универсальности конструкции, а не новое промышленное внедрение LinkedIn за пределами найма.
4.5.2. Quality Analysis; Table 3. LongMemEval-s answer accuracyКакие части HLTM дают выигрыш
Обычное сравнение с другими системами не объясняет, какая именно часть HLTM приносит улучшение. Авторы поэтому провели абляции: по очереди убирали агрегацию по дереву и подсказки от повторяющихся вопросов, затем оставляли только один из трёх видов памяти. Все варианты проверяли на том же наборе LinkedIn. Такой опыт показывает, насколько итоговое качество зависит от внутренней конструкции, а не только от выбора LLM.
Таблицу можно прокрутить по горизонтали.
Без агрегации поиск ограничивается листовыми узлами. Правильность обобщения падает с 0,892 до 0,850, а F1 извлечения — с 0,782 до 0,618. То есть родительские сводки полезны не только для широких вопросов: подготовленная связь между проектами улучшает и поиск подтверждений. Если убрать адаптацию к реальным паттернам запросов, правильность становится 0,829, а F1 — 0,593. Это сильное снижение показывает, что одной хорошей структуры дерева недостаточно, когда содержание памяти формируется без учёта того, о чём спрашивают в продукте.
Из отдельных представлений сводки дают наиболее сильную пару основных метрик: правильность 0,850, поисковый F1 = 0,730. Только факты дают 0,809 и 0,599; только QA — 0,710 и 0,646. Но итоговое сочетание всех трёх оказывается лучше: 0,892 и 0,782. Есть любопытная оговорка к слову «лучше»: одна лишь summary-память показывает recall 0,877 ± 0,014, чуть выше общего recall HLTM 0,874 ± 0,014. Преимущество полной системы проявляется в совокупности точности и полноты, а не в механическом улучшении каждой ячейки таблицы.
В таблице абляций для HLTM указано 0,892 ± 0,008 по правильности обобщения, тогда как в основной сравнительной таблице — 0,892 ± 0,007. Среднее совпадает; стандартную ошибку в двух опубликованных таблицах сохраняем в исходном виде.
4.6. Ablation Study and Analysis; Table 4. HLTM ablation resultsНасколько результат зависит от языковой модели
В основном тексте численные результаты показаны на GPT-4o mini. Приложение B.1 проверяет тот же принцип памяти на четырёх дополнительных генеративных моделях: Gemma 3 27B, Qwen3 32B, GLM-4 32B и GLM-4.5 Air 106B. Для каждой модели отдельно сравнивают правильность обобщающего ответа и F1 точечного поиска. Речь идёт о разных основных LLM в лабораторном стенде, а не о последовательных обновлениях единого производственного сервиса.
Таблицу можно прокрутить по горизонтали.
Таблицу можно прокрутить по горизонтали.
Во всех десяти столбцах — пять моделей и две задачи — HLTM выше лучшего базового метода. Для проверки различий использовали критерий Уилкоксона с поправкой Бонферрони на множественные сравнения. Звёздочки в строке HLTM означают уровни значимости: * — p < 0,05, — p < 0,01, * — p < 0,001. Для правильности на GLM-4 32B указан уровень *, для остальных показанных результатов HLTM — ***. В этом дополнительном сравнении GraphRAG и SimpleMem не включены из-за чрезмерной задержки; в основной таблице качества они присутствуют.
Устойчивость ранжирования методов при разных LLM поддерживает вывод, что существенная часть выигрыша связана с организацией памяти: бизнес-деревом, агрегацией и несколькими представлениями знаний. Она не превращает отдельный лабораторный результат в гарантию такой же правильности на любой архитектуре модели или любом продукте.
Appendix B.1. Performance Metrics; Table 5. Performance metrics across modelsСколько времени и токенов тратит поиск
В интерактивной работе качество нужно сопоставить с временем ответа. Приложение B.2 измеряет длительность всей стадии вопроса на экспериментальном стенде, среднее число вызовов LLM и число обработанных токенов. Последний показатель дан в тысячах токенов и включает все обращения к модели при ответе. Ниже показаны полные результаты отдельно для обобщающих вопросов и для извлечения конкретных сведений. Запись «среднее ± SEM» относится к распределению по вопросам, а не к погрешности часов или числу пользователей.
Таблицу можно прокрутить по горизонтали.
Таблицу можно прокрутить по горизонтали.
HLTM тратит на запрос на обобщение в среднем 3,01 ± 0,06 секунды и 3,91 ± 0,05 тысячи токенов, а на точечный поиск — 3,46 ± 0,07 секунды и 4,26 ± 0,07 тысячи токенов. В обоих случаях зафиксировано в среднем два вызова LLM. Для сравнения, HippoRAG на обобщающих запросах потребляет 11,40 ± 0,18 тысячи токенов при 6,87 ± 0,14 секунды. GraphRAG при том же виде вопросов использует 30,30 ± 0,52 тысячи токенов и отвечает за 11,11 ± 0,16 секунды. Авторы формулируют экономию HLTM по токенам относительно графовых методов как минимум 50%.
HLTM не является самым быстрым и самым дешёвым методом в каждой строке: Mem0 и RAPTOR тратят на стадию запроса меньше времени и токенов, но заметно уступают по правильности и полноте. Вывод о границе Парето состоит в более выгодном сочетании задержки, затрат и качества, а также возможности распараллелить подготовку индекса. В статье этот компромисс иллюстрируют отдельные графики качества относительно времени ответа и времени индексирования относительно времени ответа; здесь численные сравнения опираются на исходные таблицы, а не на приблизительное чтение точек графика.
Измеренные секунды относятся к вызову экспериментальных реализаций при фиксированной конкурентности. Показатели всего рабочего диалога Hiring Assistant, включая интерфейс, сеть и решения ведущего агента, здесь отдельно не измерялись. Также число токенов при ответе нельзя складывать или отождествлять со стоимостью периодического построения всей памяти — это разные стадии системы.
4.5.3. Latency and Cost Analysis; Appendix B.2. Deployment Metrics; Table 6. Deployment efficiency metrics across query typesКак проверяли изоляцию разных рекрутеров
Жёсткое ограничение поддерева имеет отдельную проверку в приложении C. Авторы создали лабораторный набор с проектами из разных учётных мест рекрутеров и контрактов и задали методы поиска с естественно-языковыми ограничениями принадлежности. Это намеренно сложный вариант: по смыслу документы могут быть похожими, однако пользователь вправе получить только проекты своей области.
Проверяли две разновидности попадания чужих сведений. Query-wise leakage ratio — доля вопросов, хотя бы один результат по которым относится к чужому проекту. Entity-wise leakage ratio — средняя доля чужих сущностей среди возвращённых. Первая метрика отвечает на вопрос «как часто случилась хотя бы одна утечка по запросу?», вторая — «какую часть результата она занимает?».
Таблицу можно прокрутить по горизонтали.
HLTM показала 0,0% по обеим метрикам. Другие реализации в этих экспериментальных настройках возвращали чужие сущности с разной частотой — от Schema Filter до графовых и древовидных индексов. Например, у RAPTOR хотя бы один чужой проект появлялся в 90,0% вопросов, у GraphRAG — в 92,0%. Суть вывода не в том, что конкретные сторонние продукты обязательно имеют такие уязвимости, а в механизме контроля: семантический поиск по общему набору с одним лишь текстовым указанием владельца не заменяет структурной фильтрации кандидатов до получения результата.
Для HLTM запрет обеспечивается бизнес-идентификатором и допустимым поддеревом, общим для поиска фактов, QA и сводок. Такой способ позволяет одной базе обслуживать вопросы уровня проекта и рекрутера, сохраняя изоляцию владельцев. Эксперимент подтверждает это свойство в описанном тесте, но не заменяет инженерные проверки полномочий, удаления и управления учётными записями реальной корпоративной платформы.
4.7. Privacy Discussion; Appendix C. Privacy Isolation Evaluation; Table 7. Privacy leakage rates across memory systemsЧто показала работа памяти в продукте
HLTM не осталась только схемой из исследования. Авторы сообщают, что с начала 2026 года она полностью внедрена как долговременная семантическая память LinkedIn Hiring Assistant и использовалась в реальных процессах найма более шести месяцев. При работе рекрутера ведущий агент решает, когда уместно обратиться к истории предпочтений: например, во время уточнения требований к новому проекту. Сервис памяти возвращает релевантные сведения с привязкой к источникам, а основной ассистент использует их при разговоре и работе с требованиями.
Для первоначальной оценки влияния на продукт команда рассмотрела более 3 000 подходящих диалогов. Память была вызвана более чем в 40% сессий — её не запускают автоматически при каждом сообщении, решение принимает ведущий агент по содержанию разговора. Затем изучили негативную обратную связь во время калибровки требований на более чем 1 000 учётных мест рекрутеров.
В сессиях с обращением к HLTM доля негативных оценок оказалась ниже на 5–10 процентных пунктов. Различие значимо по z-критерию для двух долей, p < 0,01. Это именно процентные пункты доли негативных отзывов: их нельзя заменить словами «на 5–10%» или перенести на правильность ответов лабораторной модели. Поскольку ведущий агент сам выбирает ситуации для вызова памяти, наблюдательное сравнение сессий не следует выдавать за доказанный причинный эффект рандомизированного A/B-теста.
В производственной среде данные памяти ограничены окружением рекрутера. В статье отдельно указано, что они не используются для обучения языковых моделей, создающих контент, а заказчики сохраняют контроль над хранимой памятью и её управлением. Это согласуется с двумя ключевыми механизмами HLTM: поиском внутри бизнес-области и обновлением всех производных представлений после изменения источников.
5. Production Use Case; Figure 6. HLTM’s Production Use Case in LinkedIn’s Hiring AssistantОграничения результатов и дальнейшие направления
Экспериментальные таблицы убедительно показывают преимущества HLTM на рассмотренных вопросах, однако их числа привязаны к конкретным наборам данных, языковым моделям и способам измерения. Исследовательские секунды — задержка обработки одного вопроса на унифицированном стенде; это не отдельное измерение полного времени реакции интерфейса Hiring Assistant. Данные о работе продукта дают другую картину — частоту обращения к памяти и обратную связь рекрутеров. Для неё авторы не описывают случайное распределение сессий по группам. Также в статье нет полной спецификации производственного оборудования, пропускной способности и абсолютных расходов, достаточной для переноса этих чисел на любую инфраструктуру.
У системы есть и содержательные границы. Генерация сжатых фактов, готовых ответов и сводок всё ещё зависит от правильности работы LLM и от того, что сохраняется при агрегировании. Ссылки на узлы облегчают разбор ответа, но сами по себе не доказывают истинность каждого предложения. Жёсткая фильтрация по бизнес-идентификатору решает задачу поиска внутри разрешённого поддерева; полная корпоративная модель аутентификации и изменения полномочий описывается за пределами этого исследования. Важное свойство инкрементальной индексации — соответствие полной пересборке текущего набора, а не абсолютная полнота любого сокращённого текста.
Дальнейшие направления авторы формулируют как планы: учёт более сложных связей между разными сущностями, работа с мультимодальными сигналами и применение HLTM в других агентных задачах. Они также хотят глубже связать память с компонентами, которые строят планы и управляют поведением агента. В опубликованном внедрении показана долговременная память именно для рекрутинговых сценариев; новые возможности следует рассматривать как продолжение работы.
6. Conclusion; 4.5.2. Quality Analysis; 4.7. Privacy DiscussionИтог работы HLTM в Hiring Assistant
В LinkedIn Hiring Assistant долговременная память нужна, чтобы новый поиск кандидатов опирался на историю решений рекрутера. HLTM заранее превращает документы и действия в три вида знаний, организованные по владельцам: контракт, учётное место и проект. Агрегация помогает увидеть устойчивые предпочтения, а периодическая адаптация и обновление ветвей поддерживают полезность памяти. Эти подготовительные операции выполняются отдельно от диалога. Во время одного пользовательского запроса система действует следующим образом.
- 01
Граница доступа
Ведущий агент передаёт вопрос с идентификатором учётного места рекрутера или проекта. HLTM выбирает разрешённое поддерево и исключает сведения других владельцев ещё до поиска.
- 02
Разбор вопроса
Система извлекает из текста нужные атрибуты и значения, например должность и регион. Исходная формулировка сохраняется для поиска по вопросам и сводкам.
- 03
Поиск представлений
В доступных узлах сравниваются векторы отдельных фактов, подготовленных вопросов и кратких сводок. В поиске участвуют как проекты, так и обобщающие узлы допустимой области.
- 04
Отбор контекста
Каждый поисковый канал возвращает наиболее подходящие записи. Из найденных фактов, пар вопрос–ответ и сводок формируется контекст с идентификаторами узлов.
- 05
Ответ и происхождение
Языковая модель формулирует ответ по выбранной памяти и возвращает ссылки на узлы. Hiring Assistant использует результат для уточнения требований нового проекта.
На лабораторных данных LinkedIn HLTM превосходит сравниваемые методы по смысловой правильности обобщений и F1 точечного поиска, сохраняя небольшую задержку вопроса в условиях исследовательского стенда. Абляции показывают вклад иерархической агрегации, адаптации и сочетания трёх представлений. Отдельная проверка подтвердила изоляцию данных в специальном наборе с несколькими рекрутерами.
В работающем продукте память используется с начала 2026 года; среди сессий с её вызовом наблюдали меньшую долю негативных оценок при настройке найма. Это свидетельство практической полезности, но сравнение не представлено как рандомизированный эксперимент. Дальнейшие планы — мультимодальная память, рассуждения между сущностями и более тесная работа с планировщиком агента.
6. Conclusion; 3.5. Memory Retrieval and Answer Generation; 5. Production Use Case