Пользователь Авито загружает фотографию объявления, на которой случайно остался телефон или адрес сайта. Самый простой модерационный ответ — отклонить снимок. Но продукт теряет полезный контент, а человеку приходится исправлять публикацию вручную. Вместо этого система может сначала найти нарушение, затем определить его точную область и дорисовать только закрытый фрагмент фона. Этот пример хорошо показывает, что GenAI в продукте начинается не с кнопки «вызвать модель». До генерации нужны решение о том, что вообще можно исправлять автоматически, локализация, подготовка входа и запасной сценарий; после неё — проверка качества, ограничений и стоимости.
В видео и речи та же логика становится ещё заметнее. Несколько секунд ролика требуют многократных проходов тяжёлой модели, согласованности кадров и иногда звука, работы с памятью GPU, декодирования и постобработки. А синтетическая картинка для обучения — вообще не продуктовый ответ пользователю, а способ изменить датасет. Ниже разберём изображения, видео и речь как инженерные системы: что делает модель, что остаётся вокруг неё, где помогают сжатое представление и диффузия, как сокращают число шагов, что реально измерили авторы и где заканчивается демонстрация, исследование или отдельный рабочий компонент. Обзор рассчитан на ML-инженеров и разработчиков, которые знают базовое машинное обучение, но не обязаны заранее разбираться в генеративных моделях.
На чём основан обзор
Сначала определяем статус результата
1. Сначала выбрать действие продукта, а уже потом генеративную модель
Слово «генерация» скрывает разные задачи. В Авито модель не создаёт фотографию с нуля: она получает уже существующий снимок и должна изменить только запрещённую область. В Adobe Firefly запрос запускает конвейер создания видео. В FastVideo модель генерации остаётся внешней по отношению к главной идее проекта: фреймворк организует стадии, несколько GPU и быстрые вычислительные реализации. В Kandinsky 6.0 задача ещё шире — совместно получить короткое видео и звук, синхронизированные по событиям и времени. ЕвроХим использует генерацию иначе: не для ответа конечному пользователю, а для подготовки редких обучающих примеров. Поэтому переносимый вопрос звучит не «какую GenAI-модель взять?», а «какое действие должно произойти с данными и что считается ошибкой этого действия?».
Таблицу можно прокрутить по горизонтали.
Управляемость тоже задаётся до выбора метрики. Чем больше продукт фиксирует заранее — маску, первый кадр, длительность, разрешение, текстовое условие, — тем меньше свободы остаётся генератору и тем понятнее, что проверять. Но дополнительные условия создают собственные ошибки. В Авито слишком узкая маска оставляет часть нарушения, слишком широкая заставляет модель дорисовывать лишнее. В исторической генерации видео по изображению (I2V) Kandinsky 4.0 первый пользовательский кадр при применении приходит из другого распределения, чем обычные первые кадры обучающих видео; авторы связывают это с нестабильными генерациями. У Kandinsky 6.0 исходное изображение задаёт условие совместной генерации видео и звука (I2AV), а высокое разрешение вообще вынесено в последующее увеличение разрешения. Поэтому «больше контроля» не является бесплатной функцией: каждый новый вид условия требует своих данных, способа кодирования и проверки, что модель действительно сохраняет заданное, а не только делает визуально правдоподобный ролик.
2. Диффузия, скрытое представление и число шагов — без магии
Начнём с простой картинки. Генеративной модели неудобно многократно работать прямо со всеми пикселями каждого кадра. Поэтому изображение или видео часто сначала сжимают в более компактный внутренний код — скрытое представление, или латент. Декодер потом превращает этот код обратно в кадры. В Kandinsky 4.0 видеоавтоэнкодер (VAE) из CogVideoX сжимает пространство в 8 раз по каждой оси и время в 4 раза; это конкретная историческая конфигурация, а не обязательные коэффициенты для любой модели.
Диффузионная генерация в учебном приближении выглядит как постепенное исправление шумного состояния. На каждом шаге сеть оценивает, как сдвинуть текущее скрытое представление ближе к будущему результату. Чем больше шагов, тем больше вызовов тяжёлой сети и тем выше задержка; но просто выбросить шаги нельзя — качество может резко упасть. Поэтому число шагов становится самостоятельной инженерной ручкой рядом с размером модели, разрешением и длительностью ролика.
Сжатие и дистилляция решают разные проблемы. Сжатое представление уменьшает размер данных, над которыми работает генератор. Дистилляция, напротив, учит новую «модель-ученика» воспроизводить поведение более дорогой модели за меньшее число вычислений. Исторический Kandinsky 4.0 Flash сокращал дорогую многошаговую генерацию через отдельную процедуру дистилляции LADD; в парном сравнении людьми (SBS) быстрая версия уступала полной 480p-модели по общему предпочтению, 0,42 против 0,58. Свежий Kandinsky 6.0 использует другой многостадийный путь дистилляции до 10 вычислений основной сети и отдельно восстанавливает потерянную резкость. Эти числа нельзя объединять в единый рейтинг: модели, режимы и проверки разные.
3. Изображение в продукте: исправить локально и уметь отказаться
В Авито генерация встроена в каскад модерации. Контакты встречаются примерно на 1% фотографий, а средняя нагрузка описана как около 1 500 запросов в секунду (RPS) с пиками до 10 000. Поэтому тяжёлый детектор не запускают на каждом снимке: сначала быстрый классификатор старается не пропустить подозрительное изображение, затем детектор ищет конкретный прямоугольник с нарушением. Только после локализации появляется выбор действия — размыть область, восстановить её или отправить случай в другой путь.
Размытие хорошо сохранял остальную фотографию, но оставлял заметную полосу. Для более крупных текстовых нарушений команда перешла к inpainting: модель получает снимок и маску, считает содержимое внутри маски неизвестным и достраивает продолжение фона. Это не «бережное редактирование по определению». Неповреждённые области сохраняются потому, что генерация ограничена маской; внутри неё модель всё равно может создать артефакт. И если детектор не накрыл букву целиком, фрагмент останется после восстановления. Автор описывал уточнение маски через SAM как внедряемое на дату статьи в феврале 2025 года, без опубликованного финального эффекта.
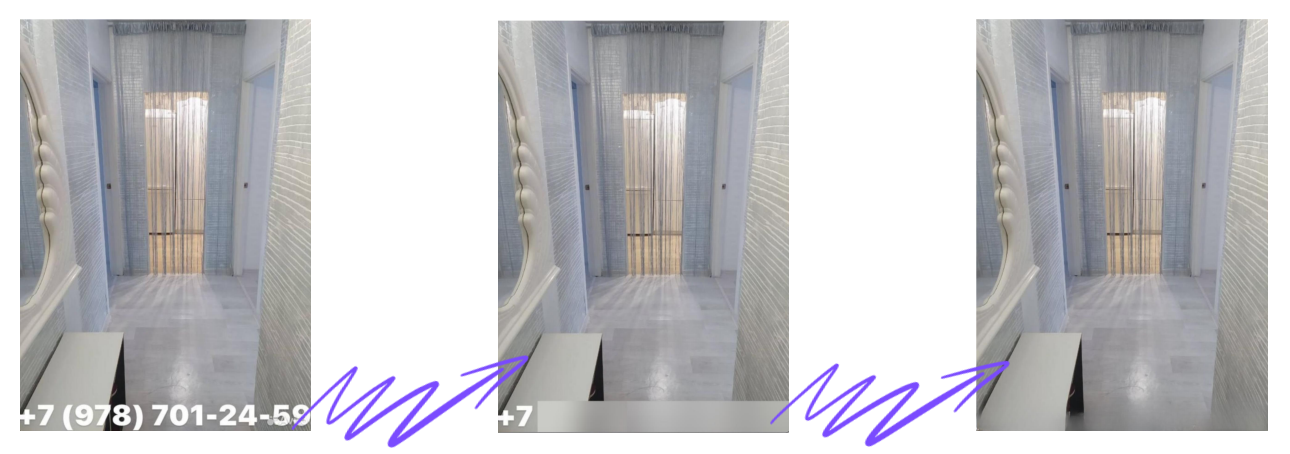
Авито: размытие скрывает телефон, а inpainting достраивает фон внутри маски. Вывод — генеративная модель меняет локальную область, но качество всей операции всё равно зависит от правильной локализации.
Источник: Владимир Морозов · Авито · исходный материалВыбор самой модели тоже был инженерным компромиссом. ZITS++ получила лучшие значения в опубликованной таблице PSNR/SSIM/FID/LPIPS, но LaMa в отдельном сравнении была существенно быстрее: 103,8 мс на изображение против 383,2 мс у ZITS++; железо и разрешение для этого сравнения не указаны. В финальной схеме блок inpainting подписан примерно как 26 RPS и 550 мс. Это задержка блока, а не p95 всего пути фотографии. Когда автоматическое исправление небезопасно, остаются ручная проверка и блокировка. Именно такой запасной сценарий отличает рабочее редактирование от обещания «модель сама всё починит».
4. Синтетические данные — это не zero-shot и не доказательство качества на реальности
У ЕвроХима генератор используется до обучения прикладной CV-модели. Если в реальных данных есть только жёлтые каски, Fooocus помогает получить варианты других цветов; если редки пожары или нарушения СИЗ, можно создать дополнительные сцены без опасной съёмки. Такой пример расширяет покрытие обучающего набора, но вместе с ним появляется новый риск: синтетическое изображение может иметь текстуры, свет, лица или артефакты, которых не будет на настоящей камере. Поэтому генерацию нужно проверять глазами и, главное, оценивать конечную модель на реальных отложенных данных.
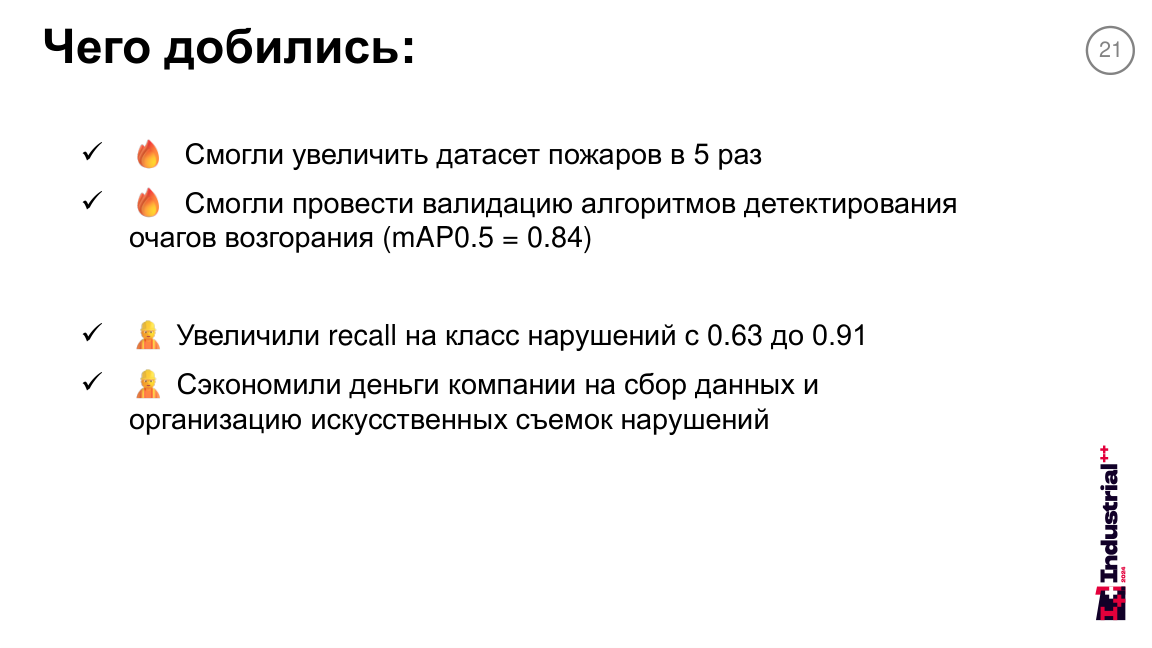
ЕвроХим: увеличение датасета в 5 раз, mAP0.5 = 0,84 и recall 0,63→0,91 относятся к разным показателям. Слайд не раскрывает полного устройства контрольных выборок и не доказывает производственный бизнес-эффект.
Источник: Исходные слайды · 21Zero-shot отвечает на другой вопрос. Если специализированного датасета ещё нет, предобученной модели дают текстовое описание нового класса или подсказку и проверяют гипотезу без отдельного обучения на размеченных примерах этой задачи. В докладе CLIP используется как пример классификации, Grounding DINO и YOLO-world — детекции, а SAM-подобные модели — сегментации. Схема «zero-shot-детектор → бокс → SAM → маска» может ускорить PoC или автоматическую разметку, но не превращает прототип в промышленную систему. Указанные сроки — две недели для PoC номеров и месяц для аналитики СИЗ — именно сроки прототипов. Это полезная историческая ветка октября 2024 года про дефицит данных, а не свидетельство полного внедрения.
5. Видео: основная модель — только середина конвейера
В Adobe Firefly три вида входа — текст, изображение и видео — сначала проходят свои энкодеры, а затем сходятся в общем диффузионном трансформере (DiT). После неё скрытое представление нужно декодировать, увеличить до нужного разрешения и постобработать. На опубликованной схеме над выходом написано «5 s / 24 fps / 1080p»: это длительность, частота кадров и разрешение результата, а не пять секунд вычислений. Такая граница особенно важна при чтении любых ускорений: оптимизация DiT не обязана столь же сильно ускорить декодер, увеличение разрешения или CPU-постобработку.
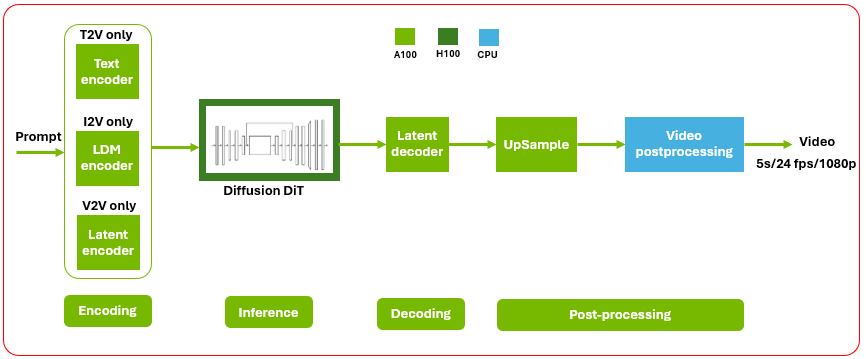
Adobe Firefly: генерация видео — последовательность разных вычислительных стадий. Поэтому результат ускорения основной диффузионной части нельзя автоматически переносить на весь путь запроса.
Источник: NVIDIA / Adobe · исходная иллюстрацияИсторический Kandinsky 4.0 в декабре 2024 года разделял генерацию видео по тексту (T2V), её быструю Flash-версию, генерацию по картинке (I2V) и отдельное добавление звука к видео (V2A). V2A анализировала готовый видеоряд, генерировала спектрограмму и через вокодер получала в основном звуки событий внутри сцены; данные специально очищались от человеческой речи. Это важный контраст с Kandinsky 6.0, где два связанных CrossDiT-потока видео и аудио обмениваются информацией в каждом блоке и учатся совместной временной согласованности.
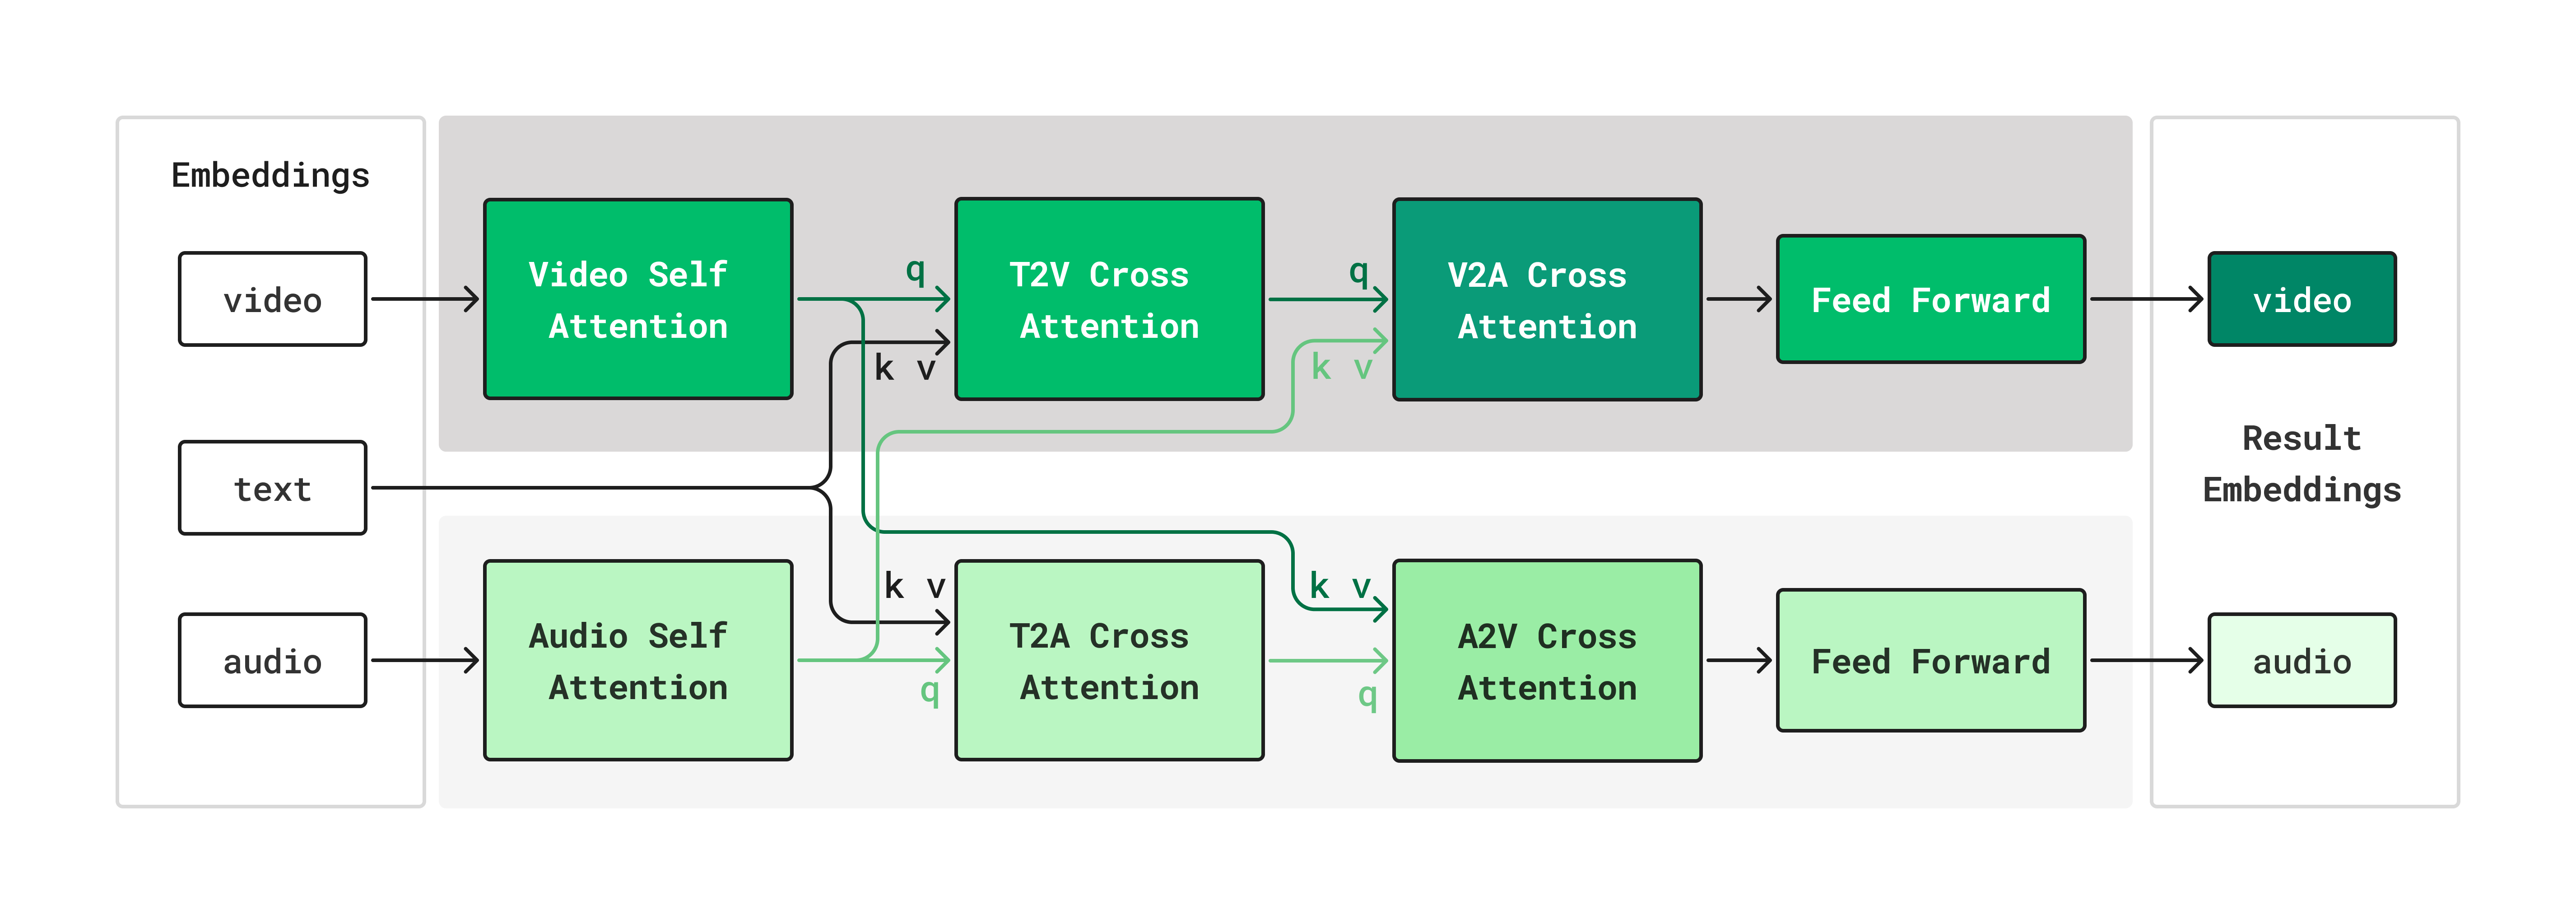
Kandinsky 6.0: видео и звук уточняются двумя связанными потоками, а не независимым генератором видео с поздним добавлением аудиодорожки. Это архитектура исследовательской системы, а не доказанный продуктовый бизнес-эффект.
Источник: Оригинальная иллюстрация · Kandinsky 6.0 VideoУ K6 цена такой совместности видна в границах результата: Lite имеет 3 млрд параметров, Pro — 29 млрд; ролики ограничены примерно пятью секундами, базовое видео генерируется в стандартном разрешении (SD), а Full HD получается отдельным конвейером увеличения разрешения с обработкой перекрывающихся областей в скрытом представлении. То есть «модель выдаёт Full HD» не означает, что основная сеть нативно работает в 1080p. Технический отчёт датирован октябрём 2026 года, авторы публикуют веса и код, но материал не измеряет окупаемость, пользовательский трафик или бизнес-метрики. Поэтому это свежая исследовательская ветка совместного аудиовидео, а не доказательство законченного коммерческого внедрения.
6. Как ускоряют генерацию: исполнение модели, параллелизм и меньше вызовов сети
Первый путь — оставить математическую задачу почти прежней и быстрее исполнить вычислительный граф. В Adobe модель экспортировали в ONNX, затем выполняли через TensorRT: сначала с 16-битными числами BF16, позже с частью вычислений в 8-битном FP8. Квантизация после обучения уменьшает точность представления чисел, поэтому качество проверяли отдельно от скорости. Имитация FP8 в PyTorch показывает численный эффект более грубого формата, но сама по себе не измеряет ускорение реального низкоточного выполнения.
Второй путь — инфраструктурный. FastVideo V1 не является новой коммерческой видеомоделью: это открытый инженерный фреймворк, который разделяет описание модели, стадии конвейера и низкоуровневые реализации. Для Wan2.1 он раскладывает генерацию на проверку входа, кодирование текста, условия, расписание шагов, подготовку латентов, многократное удаление шума и VAE-декодирование. При нескольких GPU проект берёт на себя выбор стратегии параллелизма на уровне интерфейса; статья не раскрывает точную схему разбиения для каждого числа устройств.
Таблицу можно прокрутить по горизонтали.
Третий путь — уменьшить число дорогих вызовов сети через дистилляцию. Он способен дать более крупный выигрыш, но меняет саму модель и поэтому требует проверки качества. Именно здесь особенно легко перепутать пропускную способность и качество: более короткая траектория может сгладить текстуры, ухудшить движение или следование условию. Kandinsky 4 показывает это напрямую в человеческом сравнении Flash с полной моделью. Kandinsky 6 отдельно проверяет дистиллированную версию и полную Pro: среднее предпочтение 51/49 в одном I2AV-тесте статистически не даёт основания объявить ученика лучше; сопоставимого сквозного замера ускорения дистиллированной базы в той же проверке нет.
7. Речь: профилирование и меньше шагов генерации
В видеопереводе Яндекса синтез речи (TTS) проходит цепочку «текст → аудиотокены → мел-спектрограмма → звуковая волна». Сначала ускорили вычисление внимания стандартной функцией PyTorch (SDPA) и стали переиспользовать неизменные поправки к позициям. Это сохранило совместимость со старыми весами. Другой способ кодирования позиций, RoPE, открыл FlashAttention, но на этих размерах тензоров оказался медленнее лучшего варианта SDPA с кешем. Затем модель-ученика обучили воспроизводить результат двух проходов учителя за один — CFG-дистилляция. Эта ветка дошла до продакшена. Далее число шагов сократили с 10 до 6 без переобучения, затем с 6 до 3 через поэтапную дистилляцию. В парном прослушивании не выявили значимого различия с 10-шаговым вариантом; это не доказывает полного равенства качества. По итогам работы декодер ускорился примерно в 3,5 раза, весь TTS — в 1,5 раза, использование GPU сократилось примерно на четверть.
8. Данные и обучение живут вне пользовательского запроса
Большая часть работы GenAI происходит задолго до того, как пользователь нажмёт «сгенерировать». Нужно собрать и очистить данные, получить описания, определить редкие домены, построить обучающие пары, выбрать разрешения и длительности, обучить базовую модель, затем при необходимости провести дообучение, обучение с наградой (RL), дистилляцию и квантизацию. В Kandinsky 4.0 файлы и метаданные разделяли между S3 и SQL, сцены фильтровали и подписывали, а для российского культурного кода часть описаний готовили вручную. Это историческая ветка о полной подготовке обучающих данных, а не шаг обработки одного запроса.
В Kandinsky 6.0 к готовому видеопотоку добавляют отдельно обученный аудиопоток, затем CrossDiT учится связывать модальности, после чего идут дообучение на примерах, обучение с наградами и дистилляция. Для увеличения разрешения существует собственная модель и собственные данные деградаций. Такая многослойность объясняет, почему «одна модель на проде» часто является удобным сокращением: веса, кодеки, текстовые энкодеры, декодеры и увеличение разрешения могут обучаться и оптимизироваться отдельно.
Синтетика тоже относится к подготовке. У ЕвроХима она добавляет редкие сцены; у видеомоделей синтетическими могут быть подписи, деградации или движение камеры. Полезность синтетики проверяется не тем, насколько красиво выглядит отдельный пример, а тем, улучшает ли она целевую модель на данных, похожих на реальную эксплуатацию. Если генератор систематически делает «слишком чистые» пожары, лица или текстуры, детектор может научиться распознавать особенности генератора вместо нужного явления.
9. Оценка: автоматические метрики, люди и продукт отвечают на разные вопросы
Генеративное качество многомерно. В Авито PSNR, SSIM, FID и LPIPS дополняли просмотром изображений; одна метрика не объясняет, заметен ли артефакт человеку и сохранился ли смысл фотографии. Для видео добавляются движение, временная стабильность, соответствие промпту, речь, звук и синхронизация. Kandinsky 4 использовала модифицированные автоматические проверки и масштабные Side-by-Side-сравнения; Kandinsky 6 разделяет визуальные вопросы, аудио и решение задачи, допускает ничьи и N/A. Отсюда главное правило: нельзя придумать один универсальный порог FID, FVD, MOS или «качества GenAI» для всех продуктов.
Таблицу можно прокрутить по горизонтали.
Числа нужно читать вместе с условиями. У FastVideo график скорости не содержит численной оценки качества, поэтому авторское «с сохранением качества» остаётся заявлением, а не отдельным доказательством равенства. У Adobe качество FP8 проверяли процедурно, но публичной итоговой таблицы визуального качества нет. У K6 сравнения с конкурентами дают смешанную картину: модель сильнее по некоторым визуальным или речевым критериям и слабее по другим; большое число ничьих тоже информативно. У Авито продуктовый итог описан качественно — меньше ручного потока и мало жалоб, — но точной денежной дельты или единой KPI нет. Эти условия определяют, какой вывод можно сделать из результата.
10. Маршрут чтения: от рабочего редактирования к тяжёлому видео
Основной маршрут оставляет впереди источники 2025–2026 годов и постепенно увеличивает сложность системы. Исторические ветки 2024 года лучше читать после него — как объяснение данных, обучения и ранних компромиссов.
- 1. Авито: локальное исправление → граница маски. Увидеть полный продуктовый контур: найти нарушение, локализовать, изменить только нужную область и сохранить ручной запасной путь.
- 2. Оригинал Яндекса по TTS. Карточка есть в очереди; подробный разбор готовится. Продовая ветка: дистилляция и ускорение.
- 3. Adobe Firefly: конвейер → ускорение. Отделить диффузионную часть от остального сервиса и качество квантизации от реальной скорости.
- 4. FastVideo V1: стадии → измерения на Wan2.1. Понять инфраструктурный слой между архитектурой модели и GPU-ядрами.
Свежая исследовательская ветка — Kandinsky 6.0: совместное аудиовидео, отдельное увеличение разрешения и подробная человеческая оценка, но без доказанного бизнес-эффекта. Исторические ветки: Kandinsky 4.0 показывает путь от данных и латентной видеодиффузии к быстрой версии, а ЕвроХим — как генератор применяется к данным и чем это отличается от zero-shot-прототипирования.
Заключение
GenAI в продукте — это не одна модель, а управляемое преобразование с чёткой границей ответственности. Для изображения важны область редактирования и запасной путь; для видео — скрытое представление, многократные шаги, декодирование, разрешение и согласованность времени; для совместного аудиовидео добавляется синхронизация событий и речи. Ускорение может происходить при исполнении модели, распределении вычислений или в самой траектории генерации, поэтому любой множитель нужно привязывать к конкретному блоку, железу и режиму.
- 01
Проверить вход и условия
Система определяет режим: локальное редактирование, текст-в-видео, изображение-в-видео или совместная генерация; недопустимый или неуверенный случай может уйти в запасной сценарий.
- 02
Построить условия и скрытое состояние
Текст и референсы кодируются, а изображение или видео при необходимости переводятся в более компактное латентное пространство.
- 03
Выполнить генеративные шаги
Диффузионная модель выполняет несколько шагов или короткую дистиллированную траекторию. Локальное восстановление фотографии может проходить одним вызовом модели; область изменения задаёт маска.
- 04
Декодировать и довести формат
Латенты превращаются в пиксели или звук; отдельные блоки могут увеличить разрешение, собрать тайлы, выполнить вокодирование и постобработку.
- 05
Проверить результат и вернуть ответ
Система применяет технические проверки и продуктовые правила; сомнительный результат отклоняется, повторяется или передаётся в другой контур.
Обучение, подготовка реальных и синтетических данных, калибровка квантизации, дистилляция, бенчмарки и человеческая разметка находятся вне этого пользовательского пути. Их задача — заранее подготовить вариант системы и доказать, что ускорение не разрушило нужные свойства. Автоматические метрики помогают диагностировать отдельные качества, человеческая оценка ловит воспринимаемые дефекты, а продуктовые метрики проверяют реальный эффект. Сравниваемые кейсы не дают универсального победителя: Авито показывает контролируемое исправление, Adobe и FastVideo — разные уровни ускорения, Kandinsky — эволюцию видеогенерации и синхронизации, ЕвроХим — роль генерации в данных. Практический вывод — проектировать не «вызов GenAI», а весь маршрут вход → условие → генерация → декодирование → проверка с явными ограничениями по качеству, памяти, задержке и цене.
Первоисточники
Основа обзора — шесть опубликованных разборов и исходная статья Яндекса о речи. Условия измерений и оригинальные иллюстрации можно проверить в главах и первоисточниках.
- Автомодерация изображений: как исправлять нарушения, сохраняя количество и качество контента
- Использование Zero-shot и искусственных данных в проектах по компьютерному зрению
- Optimizing Transformer-Based Diffusion Models for Video Generation with NVIDIA TensorRT
- FastVideo V1: A Unified Framework for Accelerated Video Generation
- Kandinsky 4.0 — новая модель генерации видео
- Kandinsky 6.0 Video: Foundation Models for Synchronized Video and Audio Generation
- Как мы ускоряли диффузионный декодер TTS