Kandinsky 4.0: данные, видеодиффузия и быстрая версия модели
Генерация видео требует одновременно управлять движением, следовать тексту и укладываться в память при обучении и запуске. Авторы раскрывают устройство четырёх моделей: текст–видео, быстрой Flash, изображение–видео и видео–звук.
Статья · на русском
Kandinsky 4.0 — новая модель генерации видеоVArkhipkin · Опубликовано: 13 декабря 2024 г.
Подготовка данных — отдельная система
Медиа хранят в S3, а пути, метаданные, оценки фильтров и описания — в SQL-базе. Это позволяет CPU- и GPU-обработчикам брать задания независимо и продолжать работу при отказе отдельной машины.
Видео режут на сцены, убирают слишком короткие фрагменты, дубликаты, неподходящую яркость, избыток текста и статичные сцены. Дорогие фильтры не запускают, если ранняя проверка уже отвергла пример. Качество движения и границы сцен проверяли с разметчиками.
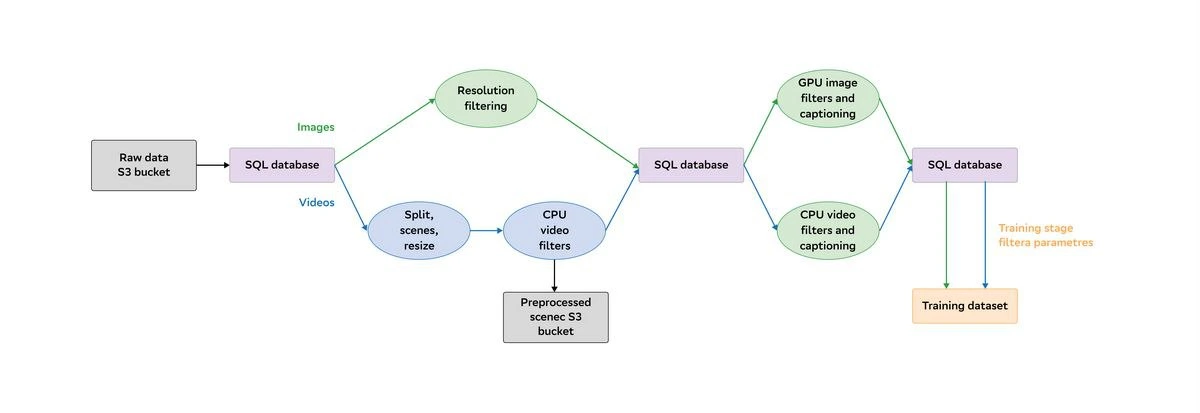
Конвейер подготовки видеоданных.
Источник: Иллюстрация из оригиналаОписать видео правильно сложнее, чем просто запустить VLM
Для большинства сцен создавали описания мультимодальными моделями и сравнивали их на собственном наборе с человеческими оценками. Для редких культурных объектов автоматические описания оказывались хуже: таких сущностей могло не быть в обучении модели.
Поэтому часть русского и постсоветского культурного материала собирали и описывали вручную. В статье указаны 117 тысяч сцен и 450 тысяч изображений в этой части работы. Это отдельная редакторская и разметочная задача, а не свойство архитектуры генератора.
Этот фрагмент в оригиналеПочему выбрали MMDiT
Видео сначала сжимает 3D VAE из CogVideoX, текст кодирует T5. Основная модель учится удалять шум из сжатого представления видео с учётом текста. Авторы сравнили несколько трансформерных вариантов: некоторые хорошо рисовали кадр, но давали движение, похожее на анимацию неподвижной картинки.
Выбрали MMDiT: текстовые и визуальные элементы взаимодействуют через общее внимание. При переходе от 480p к HD полное внимание заменили чередованием локального и глобального, чтобы уменьшить стоимость. Положение элементов видео задаётся по пространству и времени.
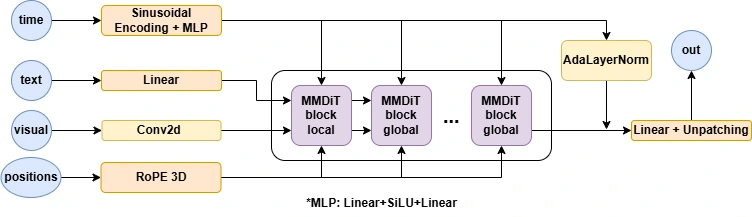
Архитектура диффузионного трансформера.
Источник: Иллюстрация из оригиналаКак не заставлять GPU ждать
Видео различаются по длине. Если каждый GPU получает обычный пакет одинаковых по длине роликов, короткий пакет заканчивается раньше и ждёт длинный на другой карте. Авторы стали объединять разные ролики по временной оси до общего размера пакета. По их измерению, пропускная способность обучения по числу видео выросла в 2,6 раза.
Подгрузку также разделили на S3, промежуточное хранилище и буферы по соотношению сторон. Это позволяет подавать готовый пакет, пока другие ещё загружаются. Для памяти и скорости применяли FSDP, пересчёт активаций и Flash Attention.
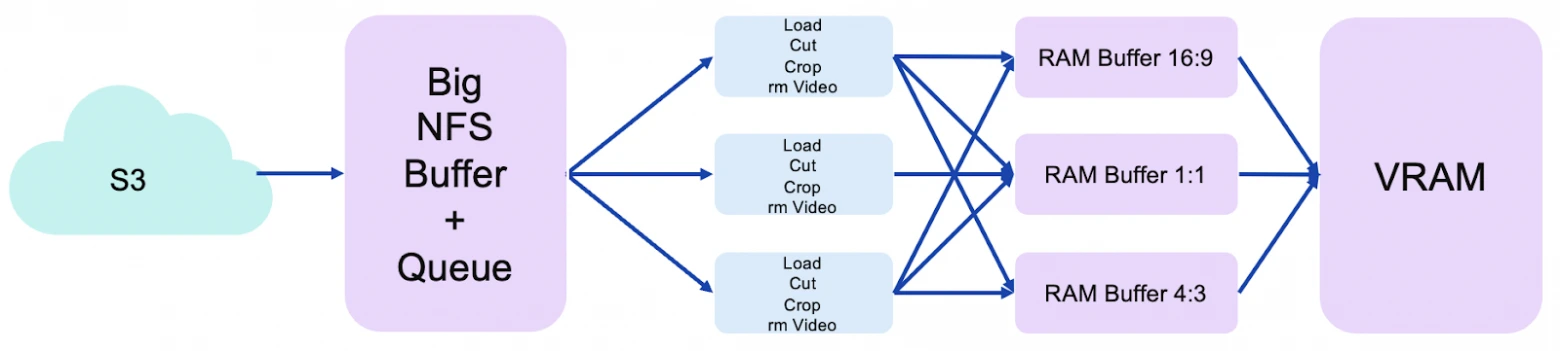
Загрузка данных в GPU через буфер.
Источник: Иллюстрация из оригиналаЧто меняет версия Flash
Обычная T2V требует многократного прохода большой модели при удалении шума. Flash получает более короткий путь через состязательную дистилляцию LADD: генератор учится с помощью дискриминатора. Главные трудности — устойчивость такого обучения и память, поэтому генератор и дискриминатор разнесли по группам процессов.
Для 12-секундного результата на одной H100 в BF16 опубликованы 11 секунд для 480p и 45 секунд для HD. На восьми H100 — 5 и 22 секунды соответственно. Это конкретные режимы, а не одинаковая скорость для любого разрешения и оборудования.
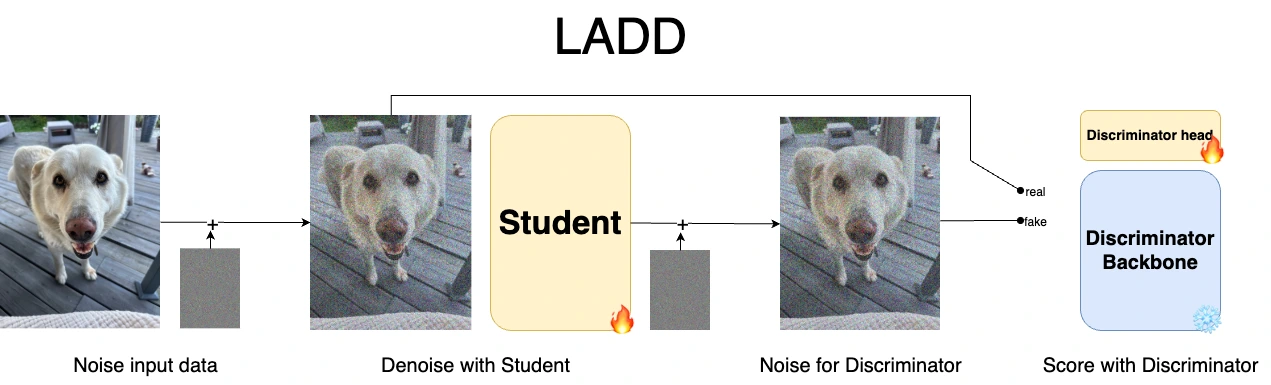
Дистилляция для версии Flash.
Источник: Иллюстрация из оригиналаИзображение и звук — ещё два разных режима
В I2V исходная картинка становится первым кадром, а шум удаляют из остальной последовательности. Авторы отмечают ограничение: пользовательские изображения могут отличаться от первых кадров тренировочных видео и давать нестабильный результат.
Для V2A визуальные признаки с временными отметками связывают с генерацией звуковой спектрограммы. Данные отдельно очищают от нежелательных звуков и речи. В попарном сравнении на 2000 видео разметчики предпочли решение Kandinsky в 1101 случае, FoleyCrafter — в 899. Это тест звука, его нельзя смешивать с оценкой качества T2V.
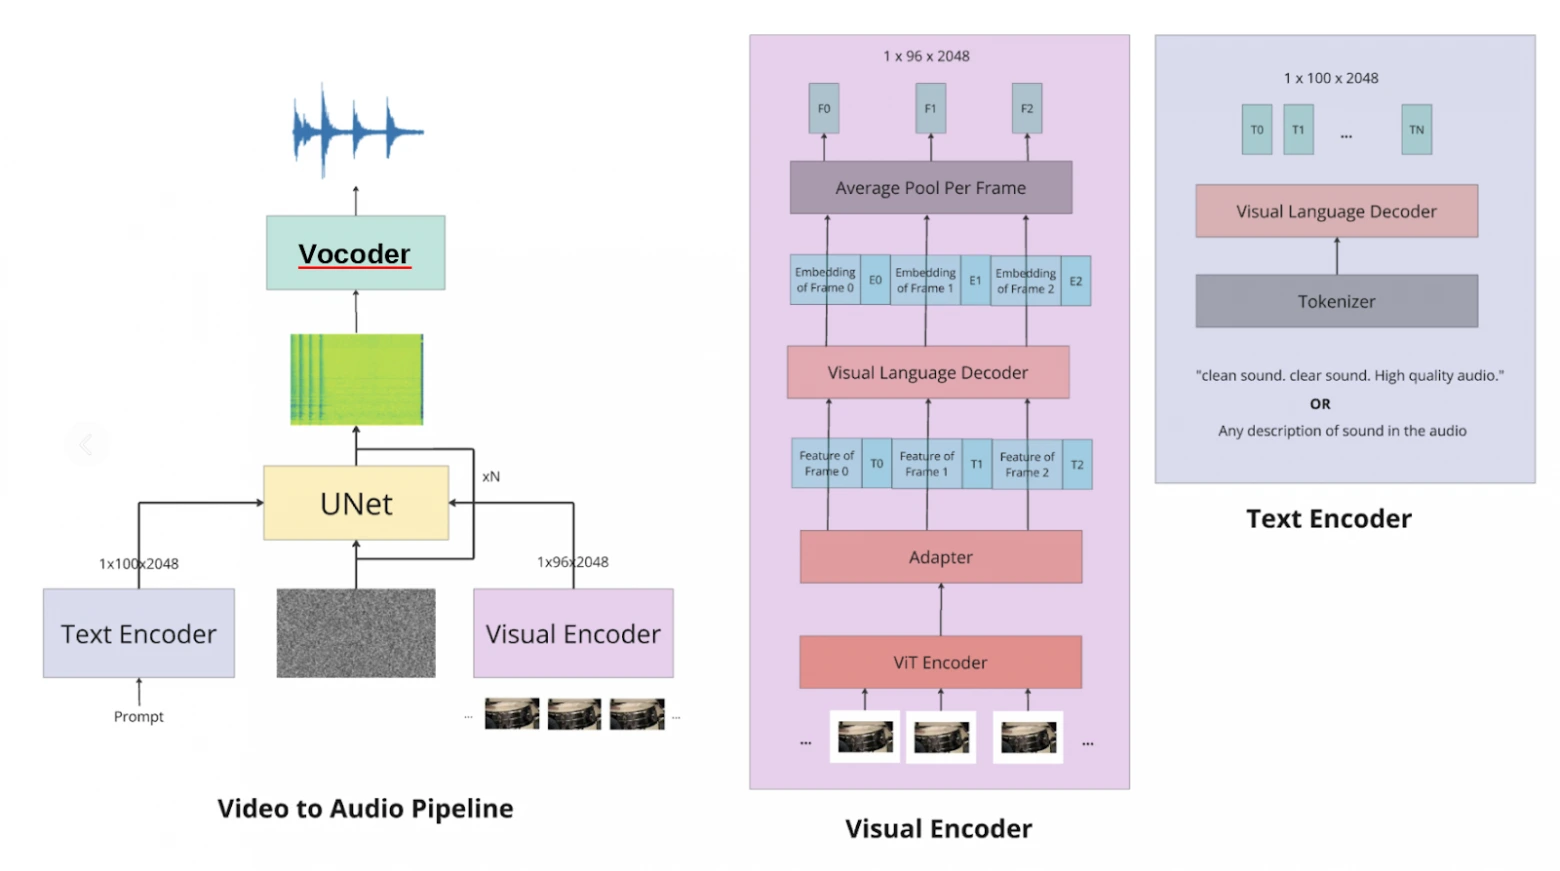
Конвейер генерации звука по видео.
Источник: Иллюстрация из оригинала