Разбор готов · Исследование
Kandinsky 6.0 Video: как совместно генерируют видео и звук
Пользователь описывает сцену: персонаж произносит реплику, а его движения и звуки должны совпадать по времени. Обычный видеогенератор создаёт кадры, но не решает задачу синхронной речи, музыки и звуков событий. Команда Kandinsky построила модель с двумя связанными потоками, один из которых отвечает за изображение, другой — за аудио. В этом разборе проследим путь от подготовки корпусов и обучения CrossDiT до RL, сокращения числа шагов генерации и отдельного увеличения разрешения. Разберём также проверки качества, стоимость вычислений и ограничения опубликованного исследования.
Разбор для ML-инженеров и исследователей мультимодальных генеративных моделей: как совместить аудио и видео, организовать обучение, награды и дистилляцию, а затем оценить результат и требования к памяти.
Публикация · на английском
Kandinsky 6.0 Video: Foundation Models for Synchronized Video and Audio GenerationTeam Kandinsky и соавторы · Опубликовано: 4 октября 2026 г.
Задача и границы системы
Исследовательская задача: генерировать согласованные видео и звук, сохранив возможности видеомодели Kandinsky 5.0. Требуется не просто добавить звуковую дорожку: изображение, речь, события и эмоции должны совпадать по смыслу и времени. T2AV означает генерацию аудио и видео по тексту; I2AV дополнительно использует исходное изображение.
Семейство включает Lite с 3 млрд и Pro с 29 млрд параметров. Заявлены ролики до 5 секунд со звуком 44 кГц и синхронизацией губ. Базовая генерация имеет SD-разрешение; Full HD получается отдельной моделью увеличения разрешения, а не нативной генерацией 1080p.
Основа решения — два связанных потока CrossDiT; затем раздельное и совместное предварительное обучение, дообучение на отобранных примерах, RL и дистилляция. Качество проверяют автоматическими метриками и парными человеческими сравнениями.
Архивная публикация arXiv датирована 4 октября 2026 года; на титуле технического отчёта указано 6 октября 2026 года.
Авторы заявляют выпуск весов, кода и интеграции с diffusers под MIT. Это технический исследовательский отчёт, а не доказательство окупаемости или масштабного промышленного внедрения.
Исследование опирается на предыдущие работы по генерации изображений и видео. Визуальная линия: диффузия и flow matching, латентная генерация, переход от U-Net к трансформерам, временные расширения изображений и масштабные видеомодели. Для Kandinsky непосредственная база — CrossDiT Kandinsky 5.0; отдельными направлениями названы эффективное внимание, VAE без характерных артефактов, управление временем и культурные данные.
Аудиовизуальная линия сопоставляет последовательное озвучивание готового видео с совместной генерацией: flow-подходы, иерархическая пространственно-временная синхронизация, тримодальные и двухпоточные трансформеры. Kandinsky выбирает два потока с готовой видеомоделью и аудио с нуля; Ovi и LTX — архитектурный контекст, не дополнительные собственные эксперименты.
Для улучшения готовой модели авторы рассматривают усреднение весов, обучение с наградами OmniNFT и несколько способов дистилляции. Для SR фоном служат синтетические деградации, диффузионное восстановление и устранение временных дефектов. Собственная комбинация — LU плюс текстово-независимый SR-DiT с двумя вызовами.
В связанных исследованиях обсуждается и создание голоса по образцу записи, но в число описанных режимов Kandinsky 6.0 такая возможность не включена.
AbstractКак готовили изображения, видео и звук
Визуальные данные: переиспользовать коллекции Kandinsky 5.0, ужесточить фильтры и обновить описания. Инфраструктуру подготовки расширили: разбиение таблиц и балансировка поддерживают тысячи параллельных обработчиков; векторные индексы — кластеризацию аудиовизуальных представлений.
T2I содержит 50 млн изображений. Сохранены фильтры водяных знаков и большого количества текста, перцептивное удаление дублей, балансировка объектов и сцен через YOLOv8 и CLIP, оценки TOPIQ и Q-Align, отбор сложных композиций через SAM 2.
T2V содержит 20 млн сцен. Дополнительно исключаются нестандартная частота кадров и переходы между сценами, найденные TransNetV2. DOVER и Q-Align оценивают качество; VideoMAE и MS-SSIM помогают контролировать разнообразие движения и временную избыточность.
Для обеих коллекций Qwen3-235B-A22B создаёт русские и английские описания, Qwen3-30B-A3B переписывает их на четырёх уровнях подробности. У видеоподписей удаляют вводные фразы и символы вне русского и английского алфавитов.
Звуковой поток сначала получает самостоятельный корпус, затем — пары с проверенным соответствием видео. T2A: 40 млн дорожек длиной 5–20 секунд, извлечённых из видеоколлекции Kandinsky 5.0. Тишину, повреждённые и низкокачественные записи исключают; Qwen3-30B-A3B описывает речь, музыку, звуки и акустику окружения.
Из 7 млн аудиовизуальных сегментов отбирают записи с чистым и согласованным звуком. Помимо амплитуды, динамического диапазона и клиппинга проверяют соответствие движения и событий звуку. Для сцен с видимым говорящим показатель LSA, оценивающий совпадение речи и движения губ, должен быть не ниже 3 по шкале 0–5; для аудиовизуальных событий Desync, характеризующий рассинхронизацию, — ниже 0,1 по шкале 0–1. Сцены без видимых лиц также сохраняют: они составляют около четверти T2AV-корпуса.
Визуальная часть наследует DOVER, Q-Align, CRAFT, YOLOv8 и CLIP-фильтры. Пороги фильтрации обучающего корпуса не следует смешивать с итоговыми значениями метрик моделей.
Gemma-4-E4B-it извлекает реплики в маркерах <S>...<E>; Qwen3-30B-A3B создаёт звуковое описание в <AUDCAP>...<ENDAUDCAP>. Qwen3.5-35B-A3B объединяет их с визуальным содержанием в подробное описание сцены.
Для генерации по изображению отбирают не любой кадр, а подходящее начало продолжения. I2AV-набор содержит 116 000 пар: первый кадр сцены и описание ожидаемого аудиовизуального продолжения.
Gemma-4-E4B-it и Qwen3-Omni-30B-A3B готовят звуковые описания. Qwen3.5-35B-A3B объединяет их с метками движения камеры; затем подпись переписывают на четырёх уровнях подробности.
Качество первого кадра проверяют Qwen3-VL-Embedding-2B, набором PyIQA — clipiqa+, topiq_nr, musiq-koniq, dbcnn, qalign, niqe, brisque, ilniqe, pi и другими метриками — и дисперсией лапласиана для обнаружения размытия.
Qwen3-VL-8B-Instruct проверяет смысловую пригодность: начало или пауза действия вместо его пика, хорошо видимый и не обрезанный основной объект, отсутствие пустого или переходного кадра. Корпус используется в предварительном обучении и последующем дообучении.
2.1 Data Processing InfrastructureОтбор примеров для дообучения и увеличения разрешения
SFT и RL используют небольшие тщательно отобранные наборы, а не весь предварительный корпус. Две стадии SFT разделяют улучшение изображения и синхронизацию. Обе используют 11 доменов: people action, animals, cartoons, people speech, music, food, nature, art, architecture, interiors, tech.
На первом этапе используют 4663 сцены, на втором по напечатанному итогу — 7686: набор расширяется неравномерно по доменам. Например, музыкальных записей остаётся столько же, тогда как примеров речи и мультфильмов становится больше.
Таблицу можно прокрутить по горизонтали.
К техническим видеофильтрам добавляют Meta Audiobox Aesthetics: качество производства, сложность, привлекательность и полезность звука. Домены определяют по визуальным представлениям Qwen2.5-VL-32B-Instruct и звуковым Qwen3-Omni-30B-A3B.
После технического отбора работают специалисты по проверке качества и киноэксперты. Они оценивают эстетику, операторскую работу, чистоту звука, смысловое соответствие и синхронизацию губ. Описания готовят Gemma-4-E4B-it, Qwen3-Omni-30B-A3B и Qwen3.5-35B-A3B, затем получают четыре уровня подробности.
RL-набор — 2984 записи из SFT-коллекции. Есть русские и английские T2AV-описания; 100% записей содержат аудиоподпись. Текстовые представления заранее вычислены, но сами варианты генерации и награды получают во время RL.
Данные для увеличения разрешения объединяют реальные высококачественные видео и синтетическое движение камеры. 150 000 уникальных клипов поступают из трёх источников: 100 000 из 4K-коллекции, около 35 000 из высококачественной части Kandinsky 5.0 T2V и 15 000 синтетических клипов из Aesthetic-4K.
Синтетический клип создаётся движением пространственного окна по неподвижному изображению вдоль выбранной траектории камеры. Это не самостоятельная генерация движения объектов.
В Kandinsky-коллекции исключают компрессионные артефакты и полосы в плавных градиентах, затем применяют Q-Align. Для 4K-коллекции Q-Align дополняют детектором ряби и шумоподобных структур.
Число уникальных исходных клипов отличается от числа пар HQ/LQ после вырезания фрагментов и внесения искажений. Подготовка этих пар и обучение SR разобраны отдельно.
Russian Cultural Code содержит 1.2 млн изображений и 530 тыс. видеосцен: язык, вера, историческая память, природа, архитектура и другие культурно значимые элементы.
Для примеров подготовлены точные названия объектов и подробные описания. Используются и русские, и английские подписи.
RCC включают в предварительное T2V-обучение и через изображения в совместное T2AV-обучение. Это механизм обогащения данных; отдельной численной оценки культурной точности в результатах данного отчёта нет.
2.7 Supervised Fine-Tuning DatasetsДва потока CrossDiT и связь модальностей
Два несимметричных CrossDiT-потока обмениваются информацией в каждом блоке. Видео- и аудиопотоки имеют одинаковую глубину, но разные ширины скрытых представлений и полносвязных слоёв. Между ними добавлены двунаправленные слои внимания; исходная архитектура потоков наследуется от Kandinsky 5.0.
В Lite параметры распределены как 2B видео + 0.6B аудио + 0.4B межмодальных связей; в Pro — 19B + 5B + 5B. Глубина составляет соответственно 32 и 60 блоков.
Таблицу можно прокрутить по горизонтали.
В каждом потоке есть самовнимание, внимание к тексту, внимание к другой модальности и полносвязный подслой. По текстовому описанию блоков у потоков собственные преобразования текста и времени диффузии; время управляет масштабом, сдвигом и вентилями подслоёв.
Направления межмодального внимания легко перепутать: в авторских обозначениях V2A запрос Q строит из видео, а ключи K и значения V берёт из аудио; A2V делает наоборот — аудио обращается к видео. Это различие существенно для ограничения градиентов на RL-этапе.
Позиционное кодирование RoPE учитывает время и пространство видео и одномерную временную позицию аудио. Индекс видеокадра нормируют как N_frame/(fps/24), чтобы положение соответствовало времени при разной частоте кадров. Это позволяет привязать движение и звук к единому времени даже при небольшой разнице частоты кадров.
Базовый генератор и SR работают с разными сжатыми представлениями; их кодеки нельзя объединять в один. Базовое видео кодирует и декодирует Hunyuan VAE; аудио — автоэнкодер MMAudio с частотой 44 кГц. В Table 2 указаны 16 каналов визуального входа/выхода и 40 каналов звукового входа, размер видеопатча (1,2,2).
Текст кодируют Qwen2.5-VL-7B-Instruct и CLIP ViT-L/14. Для Qwen указаны максимум 1024 токена и размер представления 3584; для CLIP — 77 и 768. Это модели обусловливания генератора, не большие модели разметки корпусов.
Отдельный SR использует K-VAE: 64 канала, пространственное сжатие в 16 раз и временное в 4 раза. Для T=4n+1 кадров форма равна T′×H/16×W/16×64, где T′=(T−1)/4+1; 121 кадр превращается в 31 латентный кадр.
Переход к SR включает декодированное базовое видео и его отдельное кодирование K-VAE. Коэффициенты K-VAE нельзя автоматически приписывать Hunyuan VAE или аудиокодеку: таких характеристик для них данный текст не задаёт.
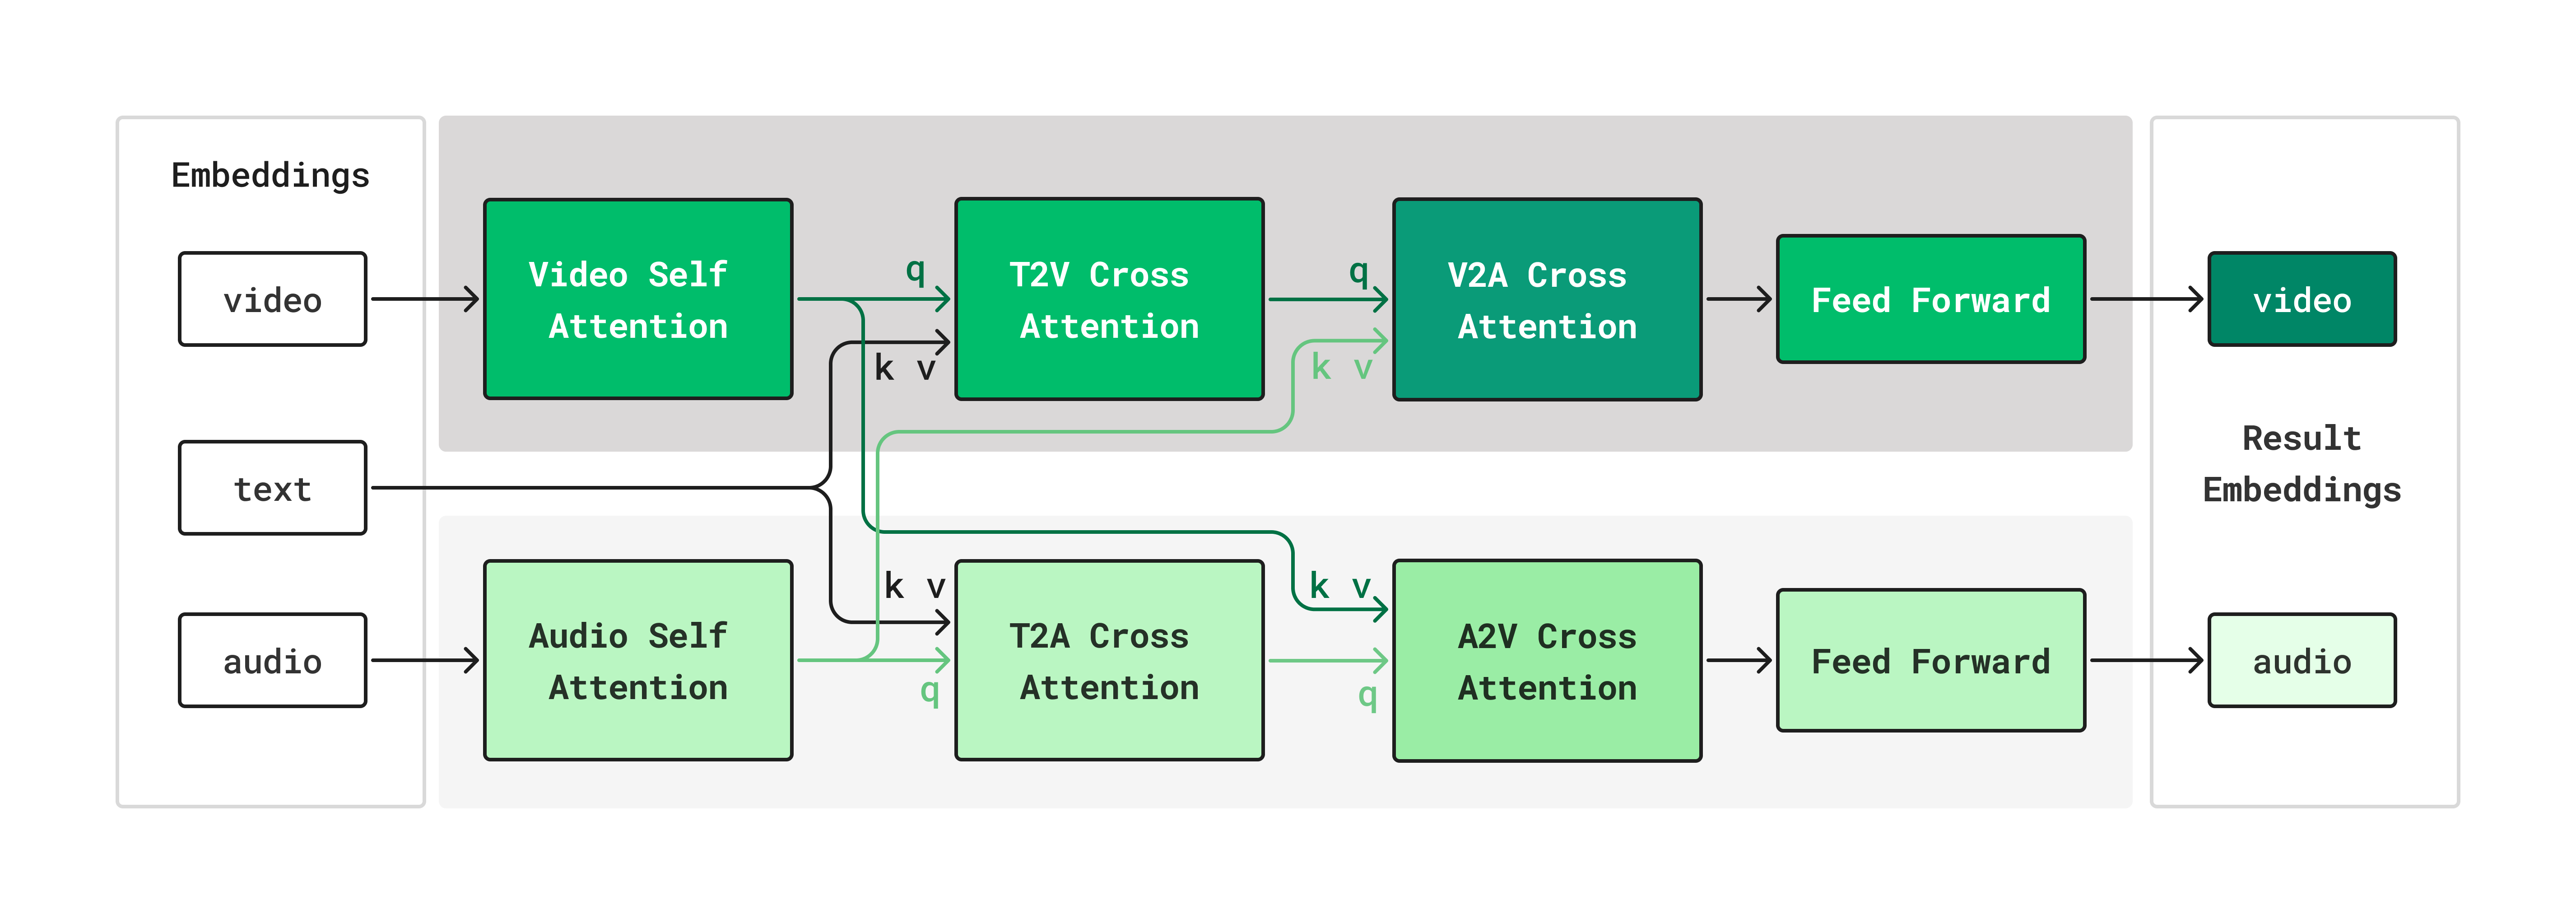
Два потока CrossDiT: видео и звук обмениваются информацией через cross-attention.
Источник: Оригинальная иллюстрация · Kandinsky 6.0 Video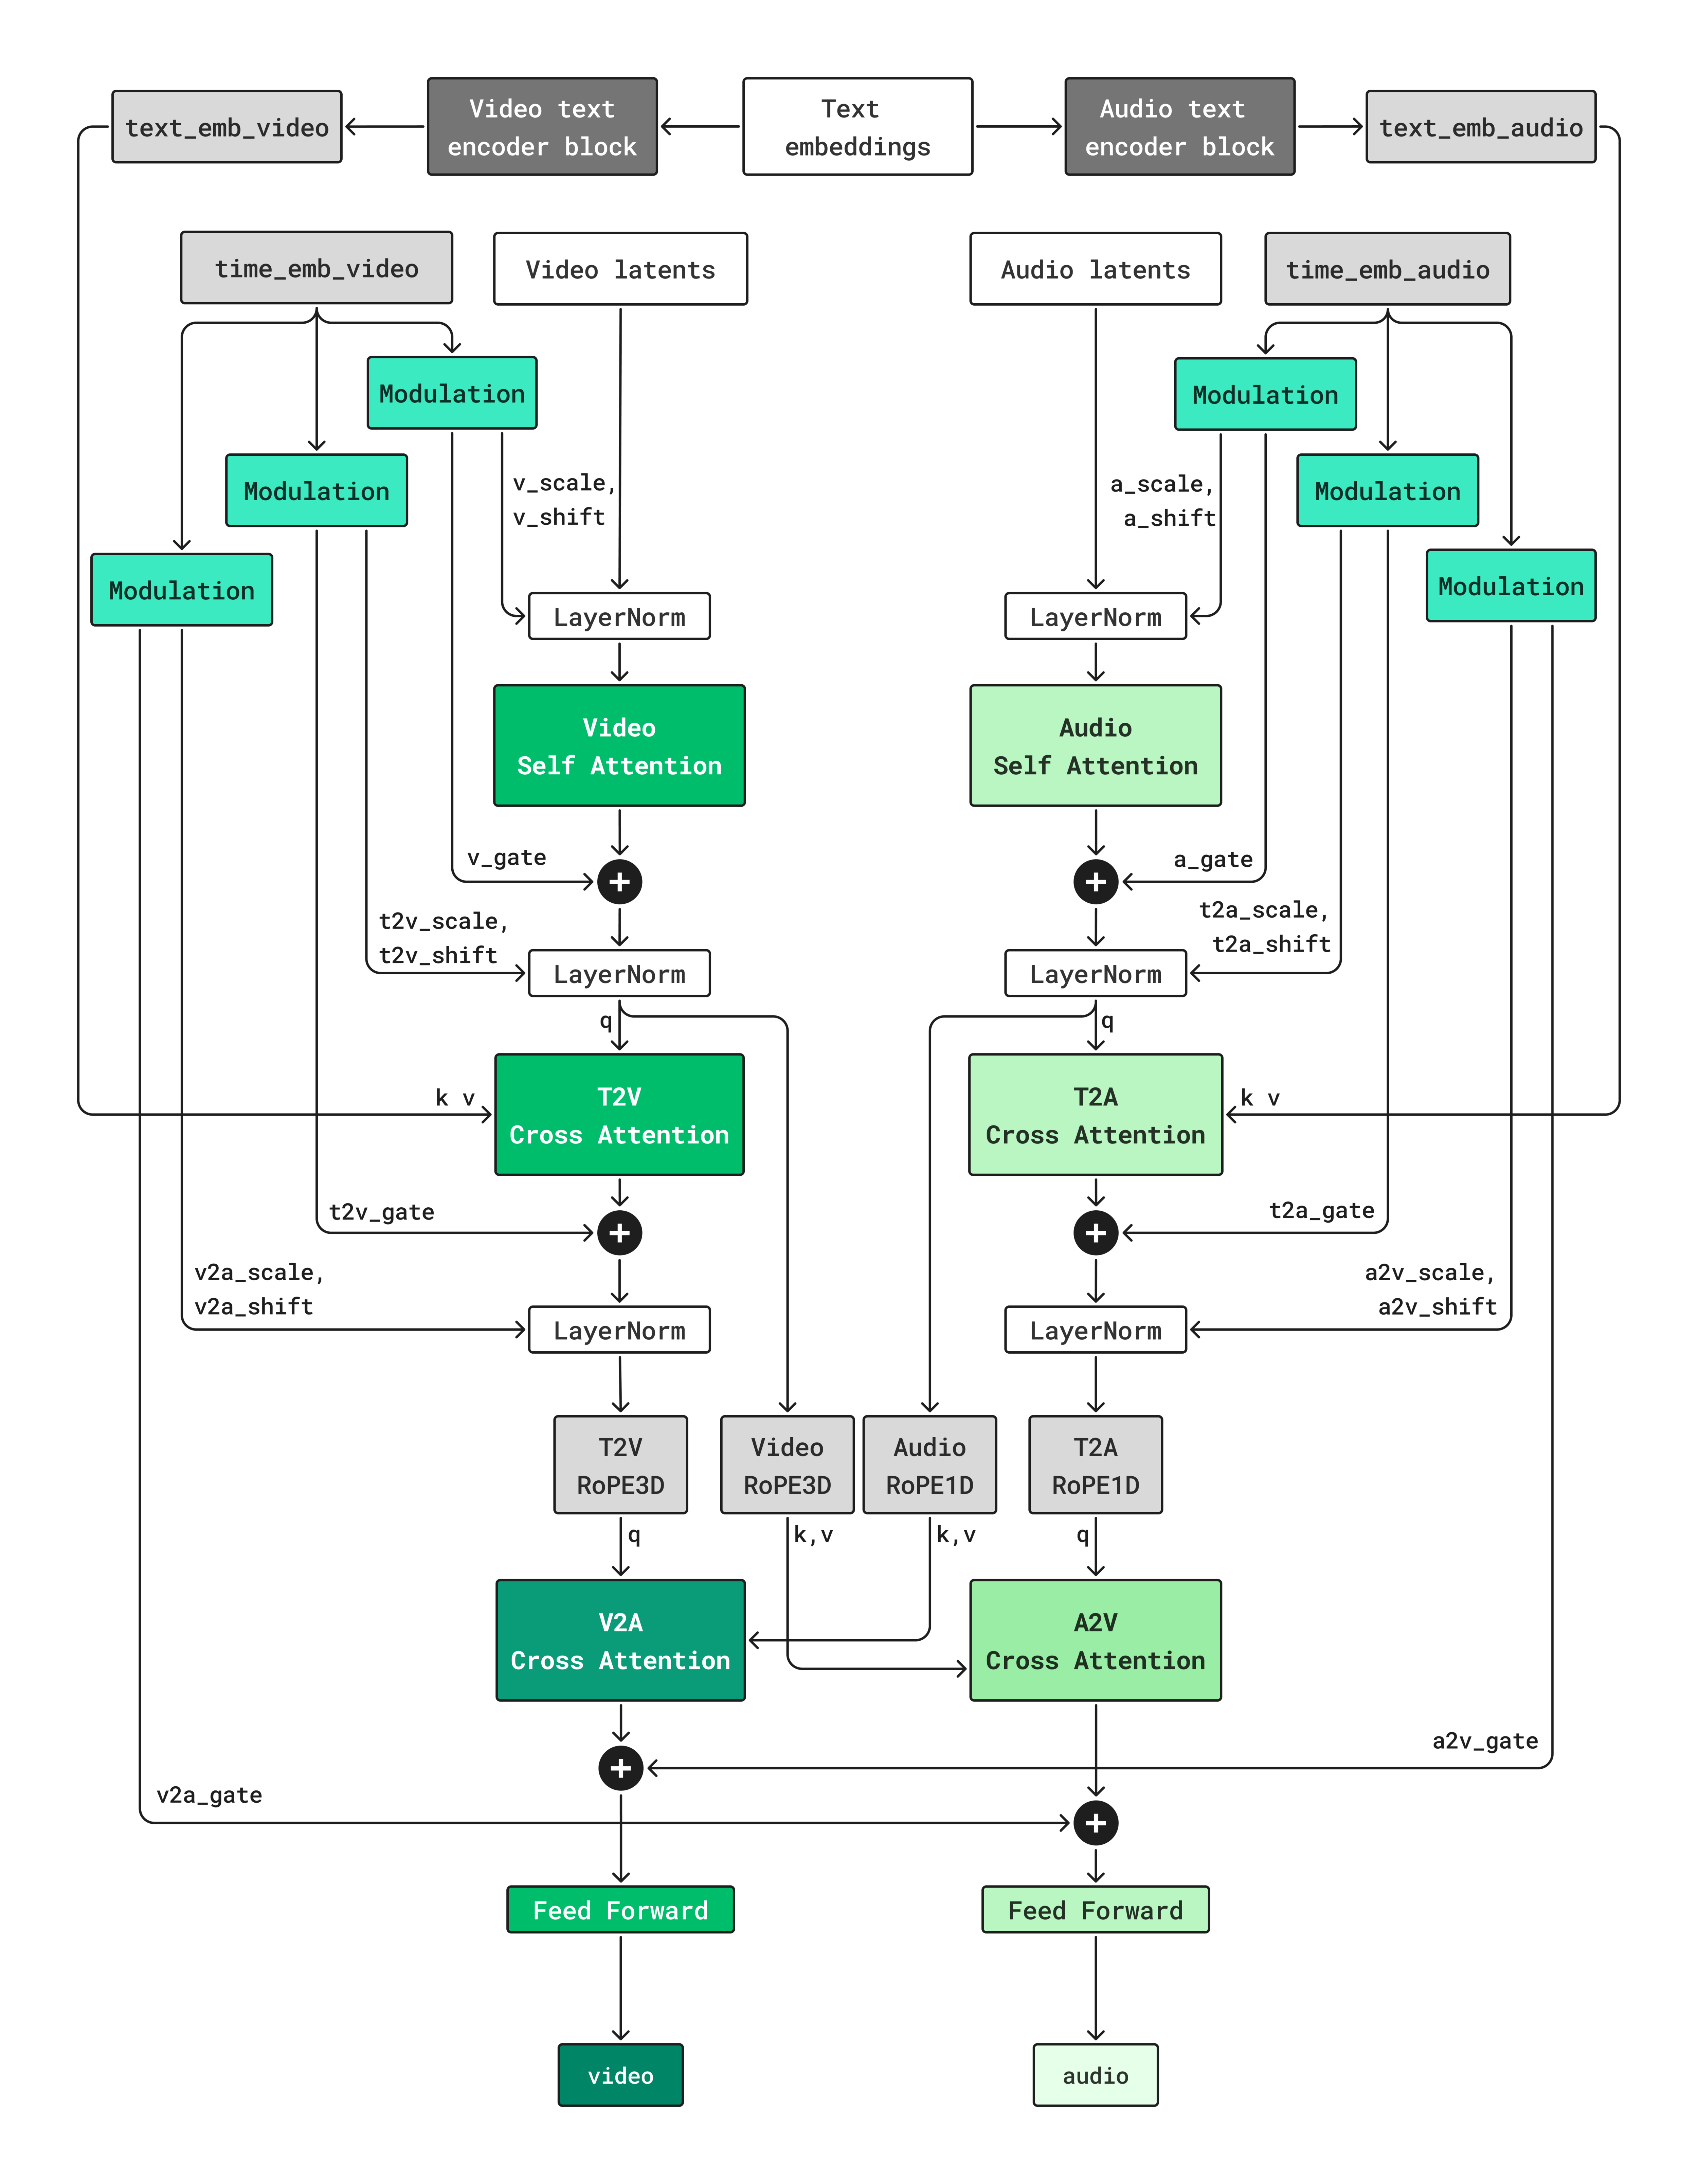
Подробное устройство блока CrossDiT и обмена между модальностями.
Источник: Оригинальная иллюстрация · Kandinsky 6.0 VideoПредварительное обучение и генерация по изображению
Раздельное предварительное обучение подготавливает аудио с нуля и адаптирует уже обученное видео. Все стадии предварительного обучения используют flow matching с MSE: модель учится предсказывать поле скоростей перехода между состояниями. Аудиовеса случайно инициализированы нормальным распределением; видео начинается с соответствующей Lite/Pro-модели Kandinsky 5.0 на SD после 45 тыс. шагов.
Lite: 40 тыс. шагов T2A на аудиоподписях, затем 2 тыс. на T2AV-подписях; параллельно видео продолжает обучение 20 тыс. шагов на T2AV-подписях. Pro: соответственно 30 тыс., 4 тыс. и 14 тыс. шагов.
Переход к аудиовизуальным подписям происходит ещё до соединения потоков. На каждой стадии обе размерности обучаются на одинаковых данных, но число шагов и параметры оптимизации могут различаться.
Для звуковой ветви пакет задаётся через длительность аудио: в таблице используются записи 128×640 и 256×640 секунд. Для видео указан эффективный пакет 1024 примера: 2×512 у Lite и 1×1024 у Pro. Это разные способы задания объёма данных за шаг, поэтому их нельзя непосредственно приравнивать к числу клипов.
Для продолжения обучения T2A основной текст указывает 5–20 секунд, а таблица 3 — интервал [2,31] секунд. Это разночтение параметра исходного отчёта; оно не меняет последовательности стадий обучения.
На совместном этапе CrossDiT учится связывать звук и движение: подготовленные ветви объединяют новыми двунаправленными слоями внимания. Lite проходит 57,5 тыс. шагов T2AV и ещё 4 тыс. смешанного T2AV/I2AV-обучения; Pro — 49 тыс. и ещё 5 тыс. Для Pro первые 46 тыс. шагов основной совместной стадии идут с learning rate 5×10⁻⁵, последние 3 тыс. — с 2,5×10⁻⁵; этот темп сохраняют и в смешанной стадии. Для Lite завершающая стадия использует 10⁻⁵.
На финальной стадии 25% примеров используют I2AV. Для Lite в основном T2AV указаны пакет 256, до 121 кадра и 23–25 кадров/с; параметры оптимизации и распределения приведены в таблице 3.
Режим independent_time независимо выбирает время диффузии для звука и видео. По объяснению авторов, это нужно для обусловливания одной модальностью другой — audio-to-video и video-to-audio; это не отдельный доказанный результат оценки таких режимов.
Пакет может содержать только аудио, только видео, изображения или пары со звуком. Изображения также несут RCC-знания. Конкретные вероятности Table 3 различаются по стадии и размеру, поэтому общий перечень допустимых типов не означает одинаковую долю каждого.
Вычисления ведутся в bfloat16. Сохраняются смесь подробности промптов 0.7/0.15/0.1/0.05, русско-английские RCC-подписи и отдельные распределения геометрий; окончательное разрешение выдачи не подменяет геометрию обучения.
В I2AV исходный кадр задаётся временем и маской; обучаемое обозначение роли оказалось дополнительным сигналом. Латент исходного кадра присоединяют к видеопоследовательности по временной оси и задают ему собственную позицию RoPE. Дополнительный канал маски равен 1 для условия и 0 для кадров, из которых надо удалять шум.
После разбиения на патчи добавляют два обучаемых вектора роли: emb_ref для исходного кадра и emb_video для зашумлённого видео. Так модель получает дополнительное указание назначения токенов.
При проверках во время генерации отключение этих векторов или разложение на общую и ролевую части мало меняло результат. Заметное влияние появлялось при многократном искусственном усилении ролевой части. Это частичная избыточность, а не доказанная бесполезность при обучении: отдельного обучения без TRE не проводили.
Маска из единиц почти полностью блокировала удаление шума; маска из нулей позволяла генерировать, но вызывала артефакты, особенно в первом латентном кадре. Изменение позиции исходного кадра на t4, t8 и далее переносило его условие в соответствующую часть видео.
Авторы связывают временную привязку прежде всего с RoPE, разделение условия и генерируемых токенов — с маской, а TRE считают дополнительным, частично дублирующим признаком.
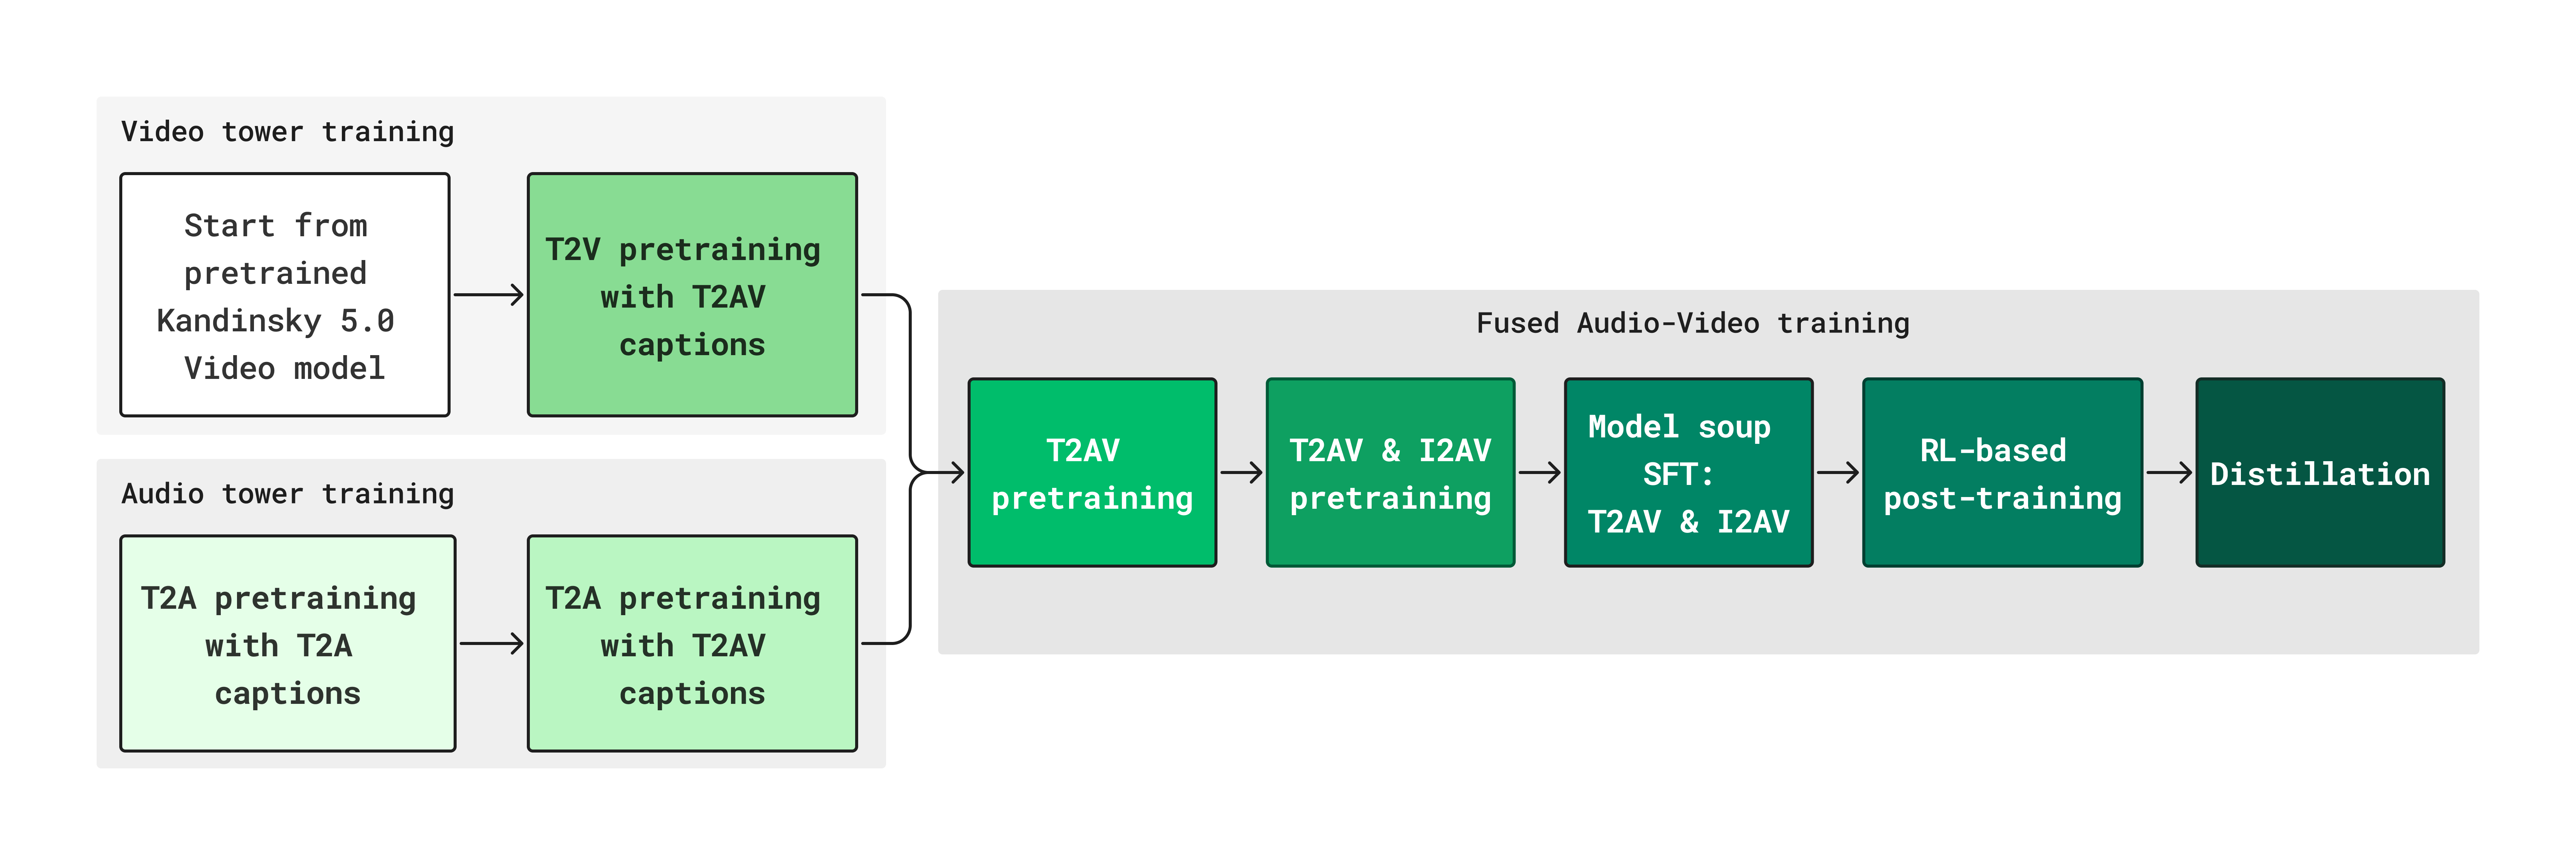
Последовательность обучения: подготовка звукового потока, совместное обучение, дообучение, RL и дистилляция.
Источник: Оригинальная иллюстрация · Kandinsky 6.0 Video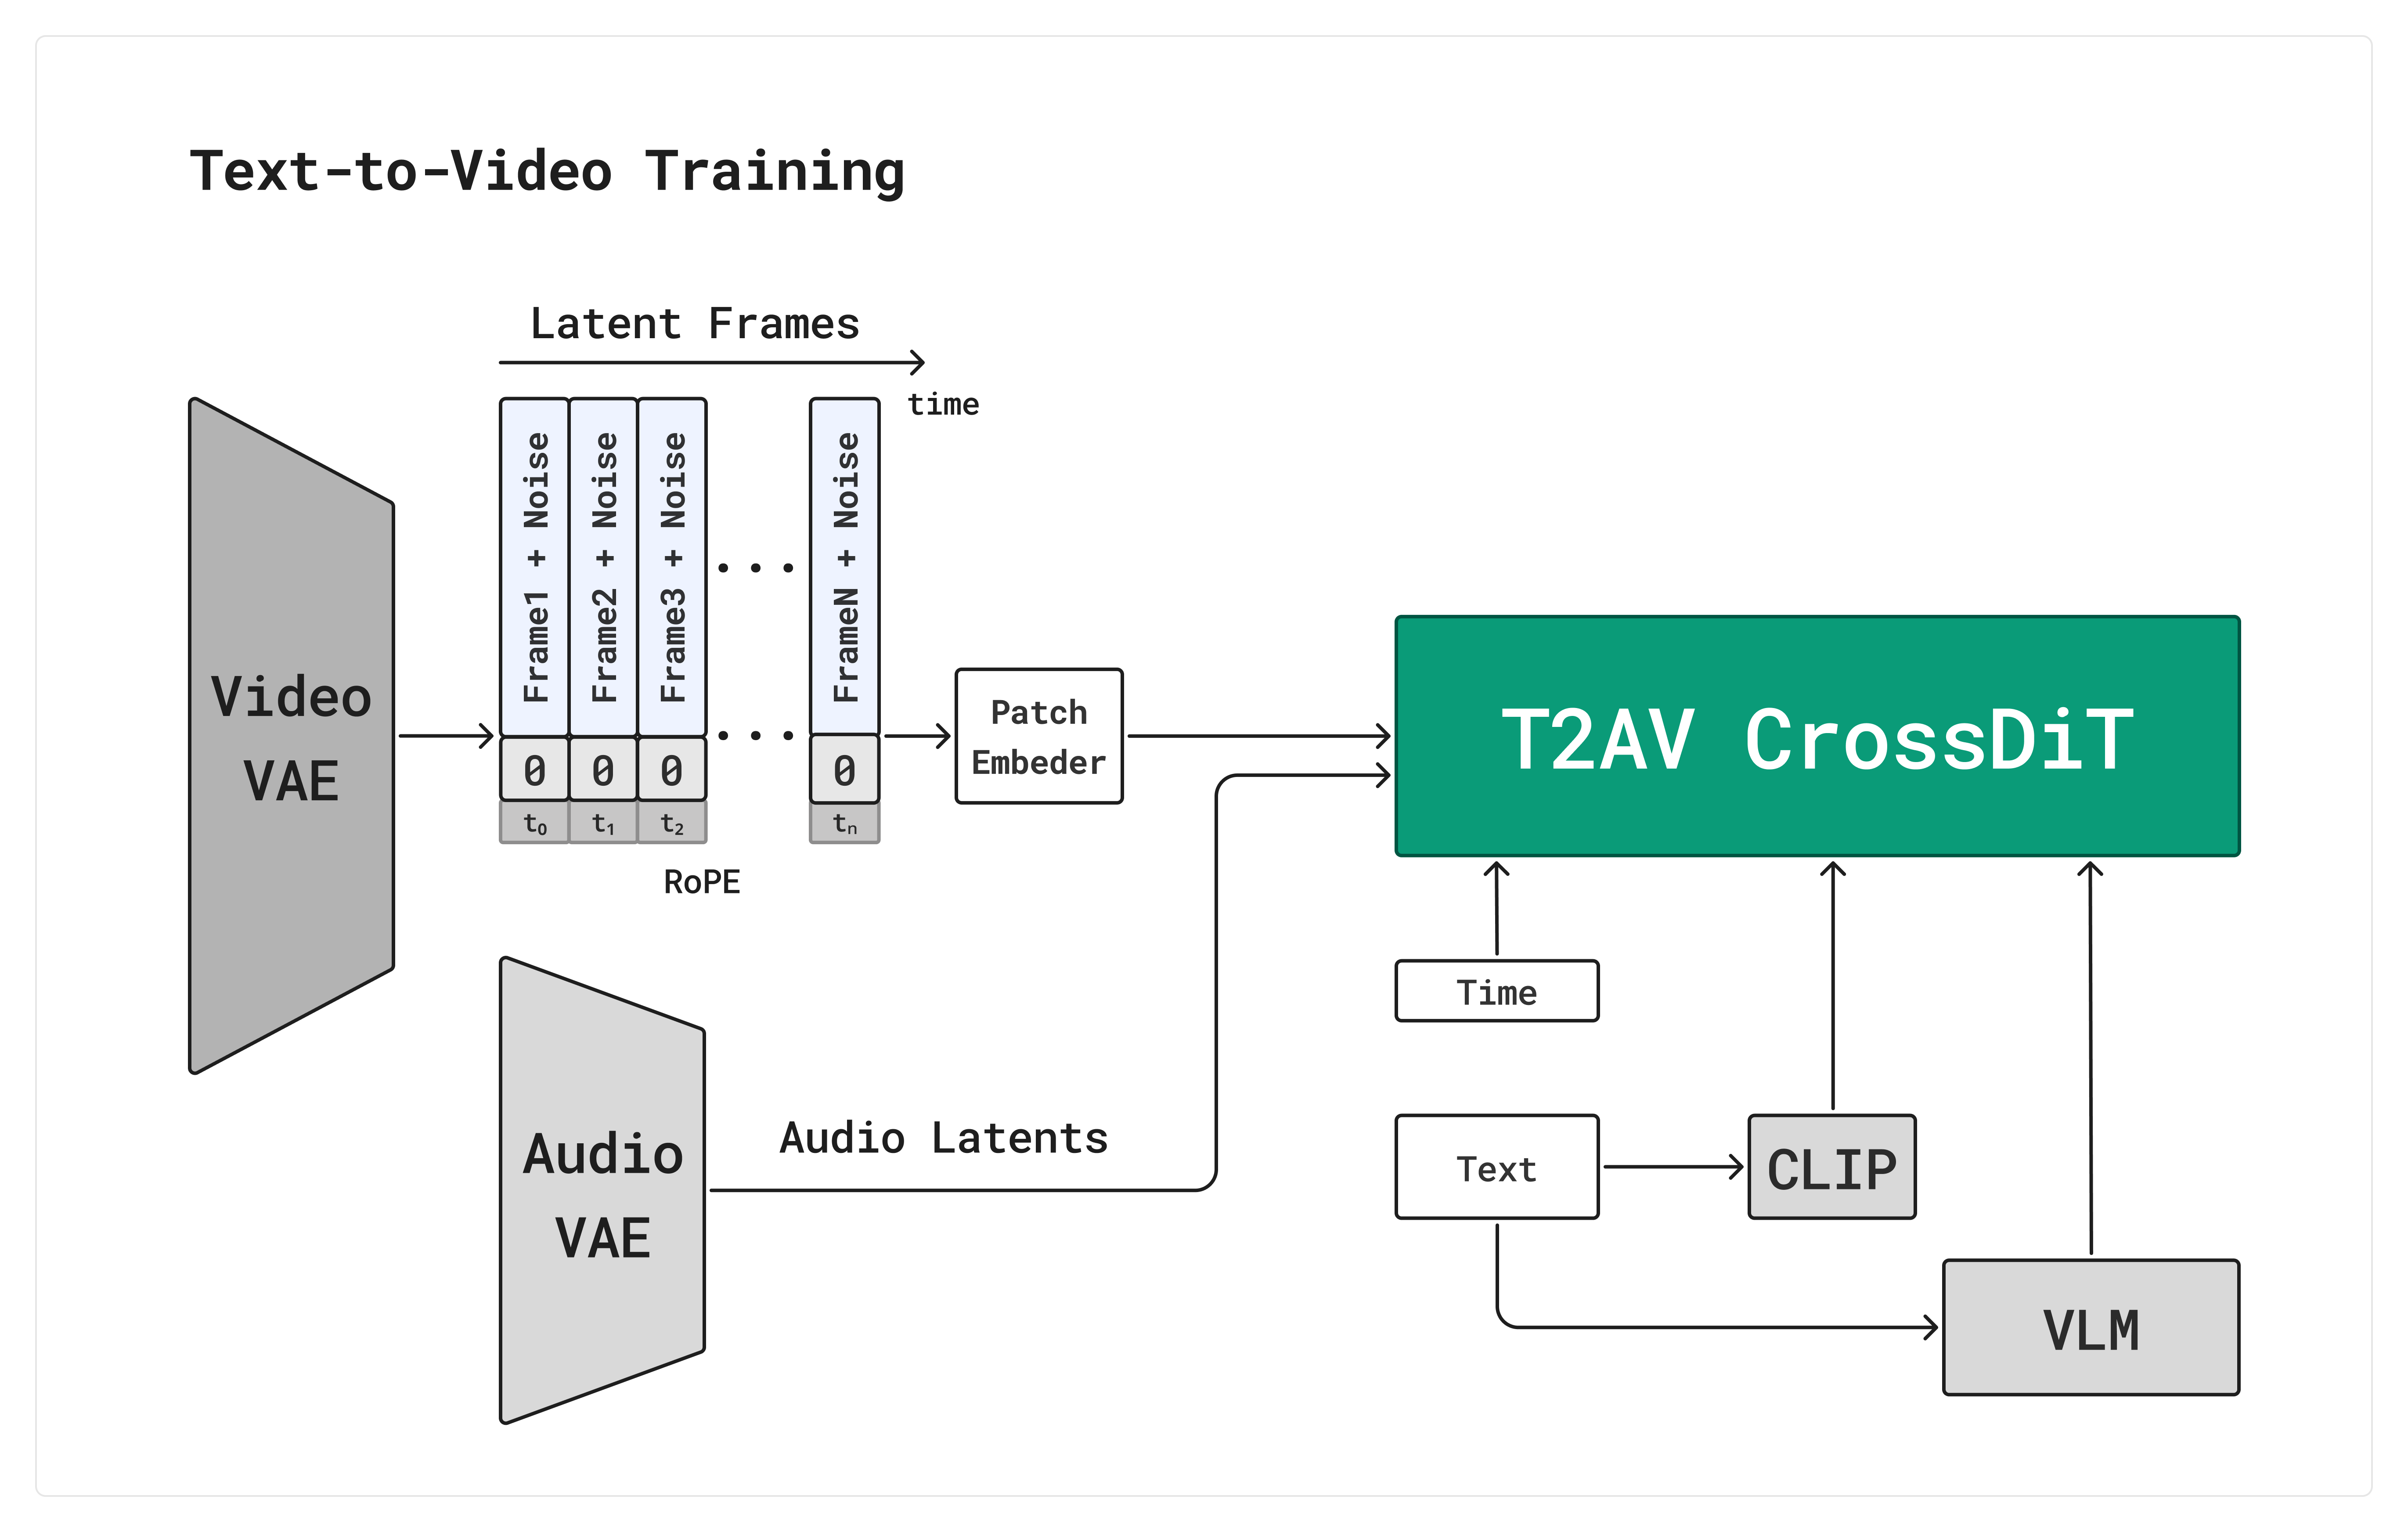
Обучение генерации видео и звука по тексту: входы и условия для CrossDiT.
Источник: Оригинальная иллюстрация · Kandinsky 6.0 Video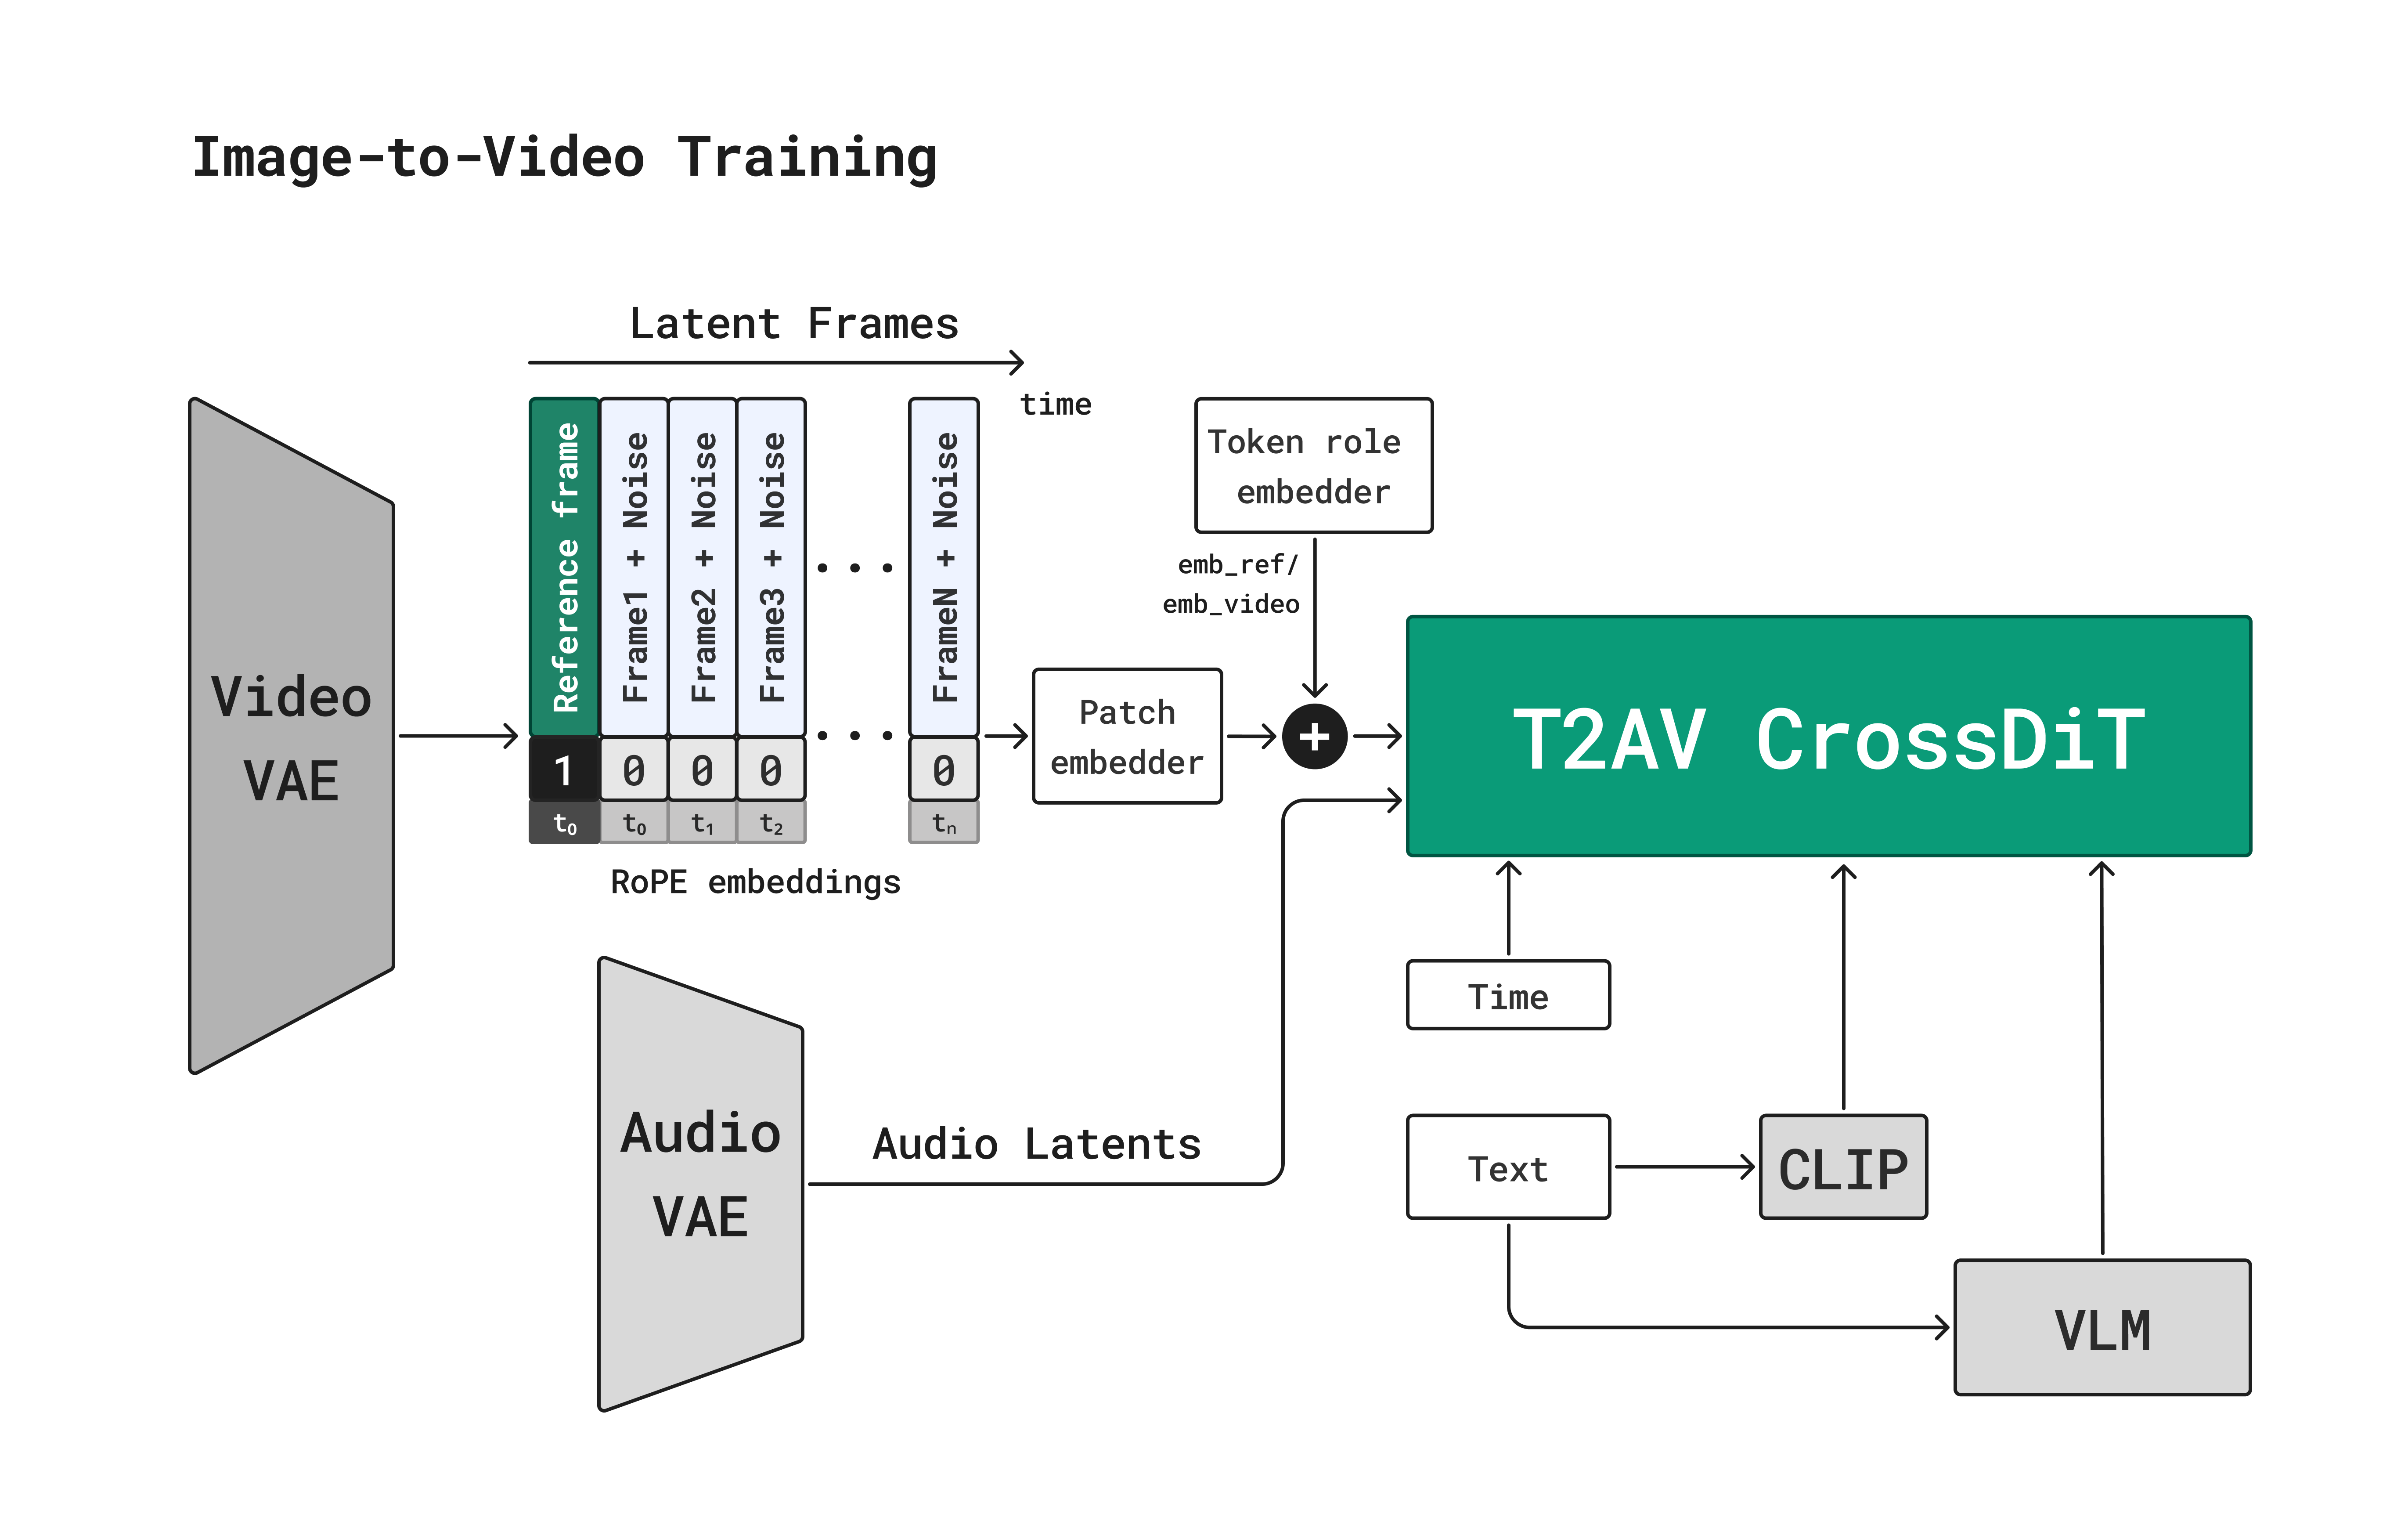
Обучение генерации по исходному изображению: роли кадров и дополнительные условия.
Источник: Оригинальная иллюстрация · Kandinsky 6.0 VideoДвухэтапное SFT и объединение моделей
Дообучение ведут по доменам в две стадии; усредняют финальные веса, а не продолжают обучение общей промежуточной модели. Для каждого из 11 доменов независимо дообучают отдельную модель и сохраняют эти ветви на протяжении обеих стадий. Итоговый model soup — равномерное усреднение весов после второй стадии; процедура одинакова для Lite и Pro.
На Stage 1 улучшают изображение: заморожены аудиопоток, межмодальные связи и аудио-текстовые модули. Аудио проходит через замороженную ветвь, но оптимизируется только видеопотеря. Используют learning rate 1e-5, смесь подробности промптов как при предварительном обучении и T2AV/I2AV в долях 75/25%.
Останавливаются на 7000 шагах — визуально лучшей итерации до переобучения. Промежуточный soup из 11 моделей нужен только для измерения качества, а не как начальная точка второй стадии.
Stage 2 начинается с каждого доменного Stage 1-чекпойнта. Размораживают все модули; learning rate для видео и общих модулей 1e-5, для аудиокомпонентов 1e-6. Потери: 0.85×video + 0.15×audio + 1.0×face.
Face loss — видеопотеря только в области лица в латентном пространстве, а не отдельная приведённая в отчёте модель синхронизации. После 5000 шагов с теми же долями режимов усредняют 11 доменных моделей.
4.3 Supervised Fine-TuningКак выбирают награды для видео, звука и синхронизации
RL использует собственные генерации по тексту и обучает LoRA поверх замороженной SFT-модели. Адаптируется OmniNFT, исходно предложенный для LTX-2 19B. Всё RL-обучение проходит только в T2AV, без изображений-условий; последующая проверка I2AV показывает перенос, а не прямое обучение этому режиму на RL-стадии.
Русский или английский промпт выбирают с равной вероятностью через хеш индекса примера и эпохи, одинаково на распределённых процессах. Оценщикам всегда передают английские метаданные. Речевые примеры повторяют в 1.5 раза чаще.
Промпт объединяет описание изображения с <AUDCAP>...<ENDAUDCAP>; буквальную речь помещают в <S>...<E>. Для каждого промпта генерируют варианты с разными случайными начальными состояниями: Pro — 10, Lite — 8.
Ролики для RL имеют 512×768 пикселей и 31 латентный кадр, то есть 121 кадр/около 5 секунд при 24 кадрах/с. DPM2 использует 20 шагов, CFG=1 и noise level=0: при этих настройках случайность группы задаётся только seed.
LoRA с r=16 и alpha=32 добавляется ко всем линейным слоям трансформерных блоков обоих потоков, включая self-, text- и cross-modal attention и FFN. Текстовые, временные и модуляционные эмбеддинги не адаптируют. Обучается 199 млн параметров Pro или 47 млн Lite; адаптер и оптимизатор начинают с нуля.
Одной награды недостаточно: удачное изображение может сопровождаться невнятной речью, а понятная речь — не совпадать с движением губ. Поэтому восемь оценщиков разделены на визуальное качество, качество звука и синхронизацию. Первые две группы воздействуют на соответствующие потоки, а награды синхронизации — на оба.
Таблицу можно прокрутить по горизонтали.
LatentSync-gated равен s_LS×(0.5+0.5×s_ASR), где s_ASR=max(0,1−WER), а s_LS — оценка StableSyncNet. Так оценку губ модулируют разборчивостью речи той же генерации.
Из каждой сырой награды вычитают среднее по вариантам одного промпта, но делят на стандартное отклонение по всему пакету. Нижняя граница знаменателя 0.1 не даёт почти одинаковым оценкам породить огромные нормированные преимущества.
Взвешенные преимущества объединяют отдельно для видео и аудио; награды синхронизации входят в обе суммы. После ограничения диапазоном [−5,5] оценку модальности распространяют на все её токены.
Для обновления используют r_token=clamp((adv/5+1)/2,0,1). Это преобразованная относительная оценка генерации, не вероятность её объективной правильности и не независимая награда, измеренная для каждого патча.
На схеме LatentSync-gated обозначен как Audio, но в описании алгоритма его оценка входит в синхронизационные награды обоих потоков. Именно так устроена маршрутизация градиента в обучении.
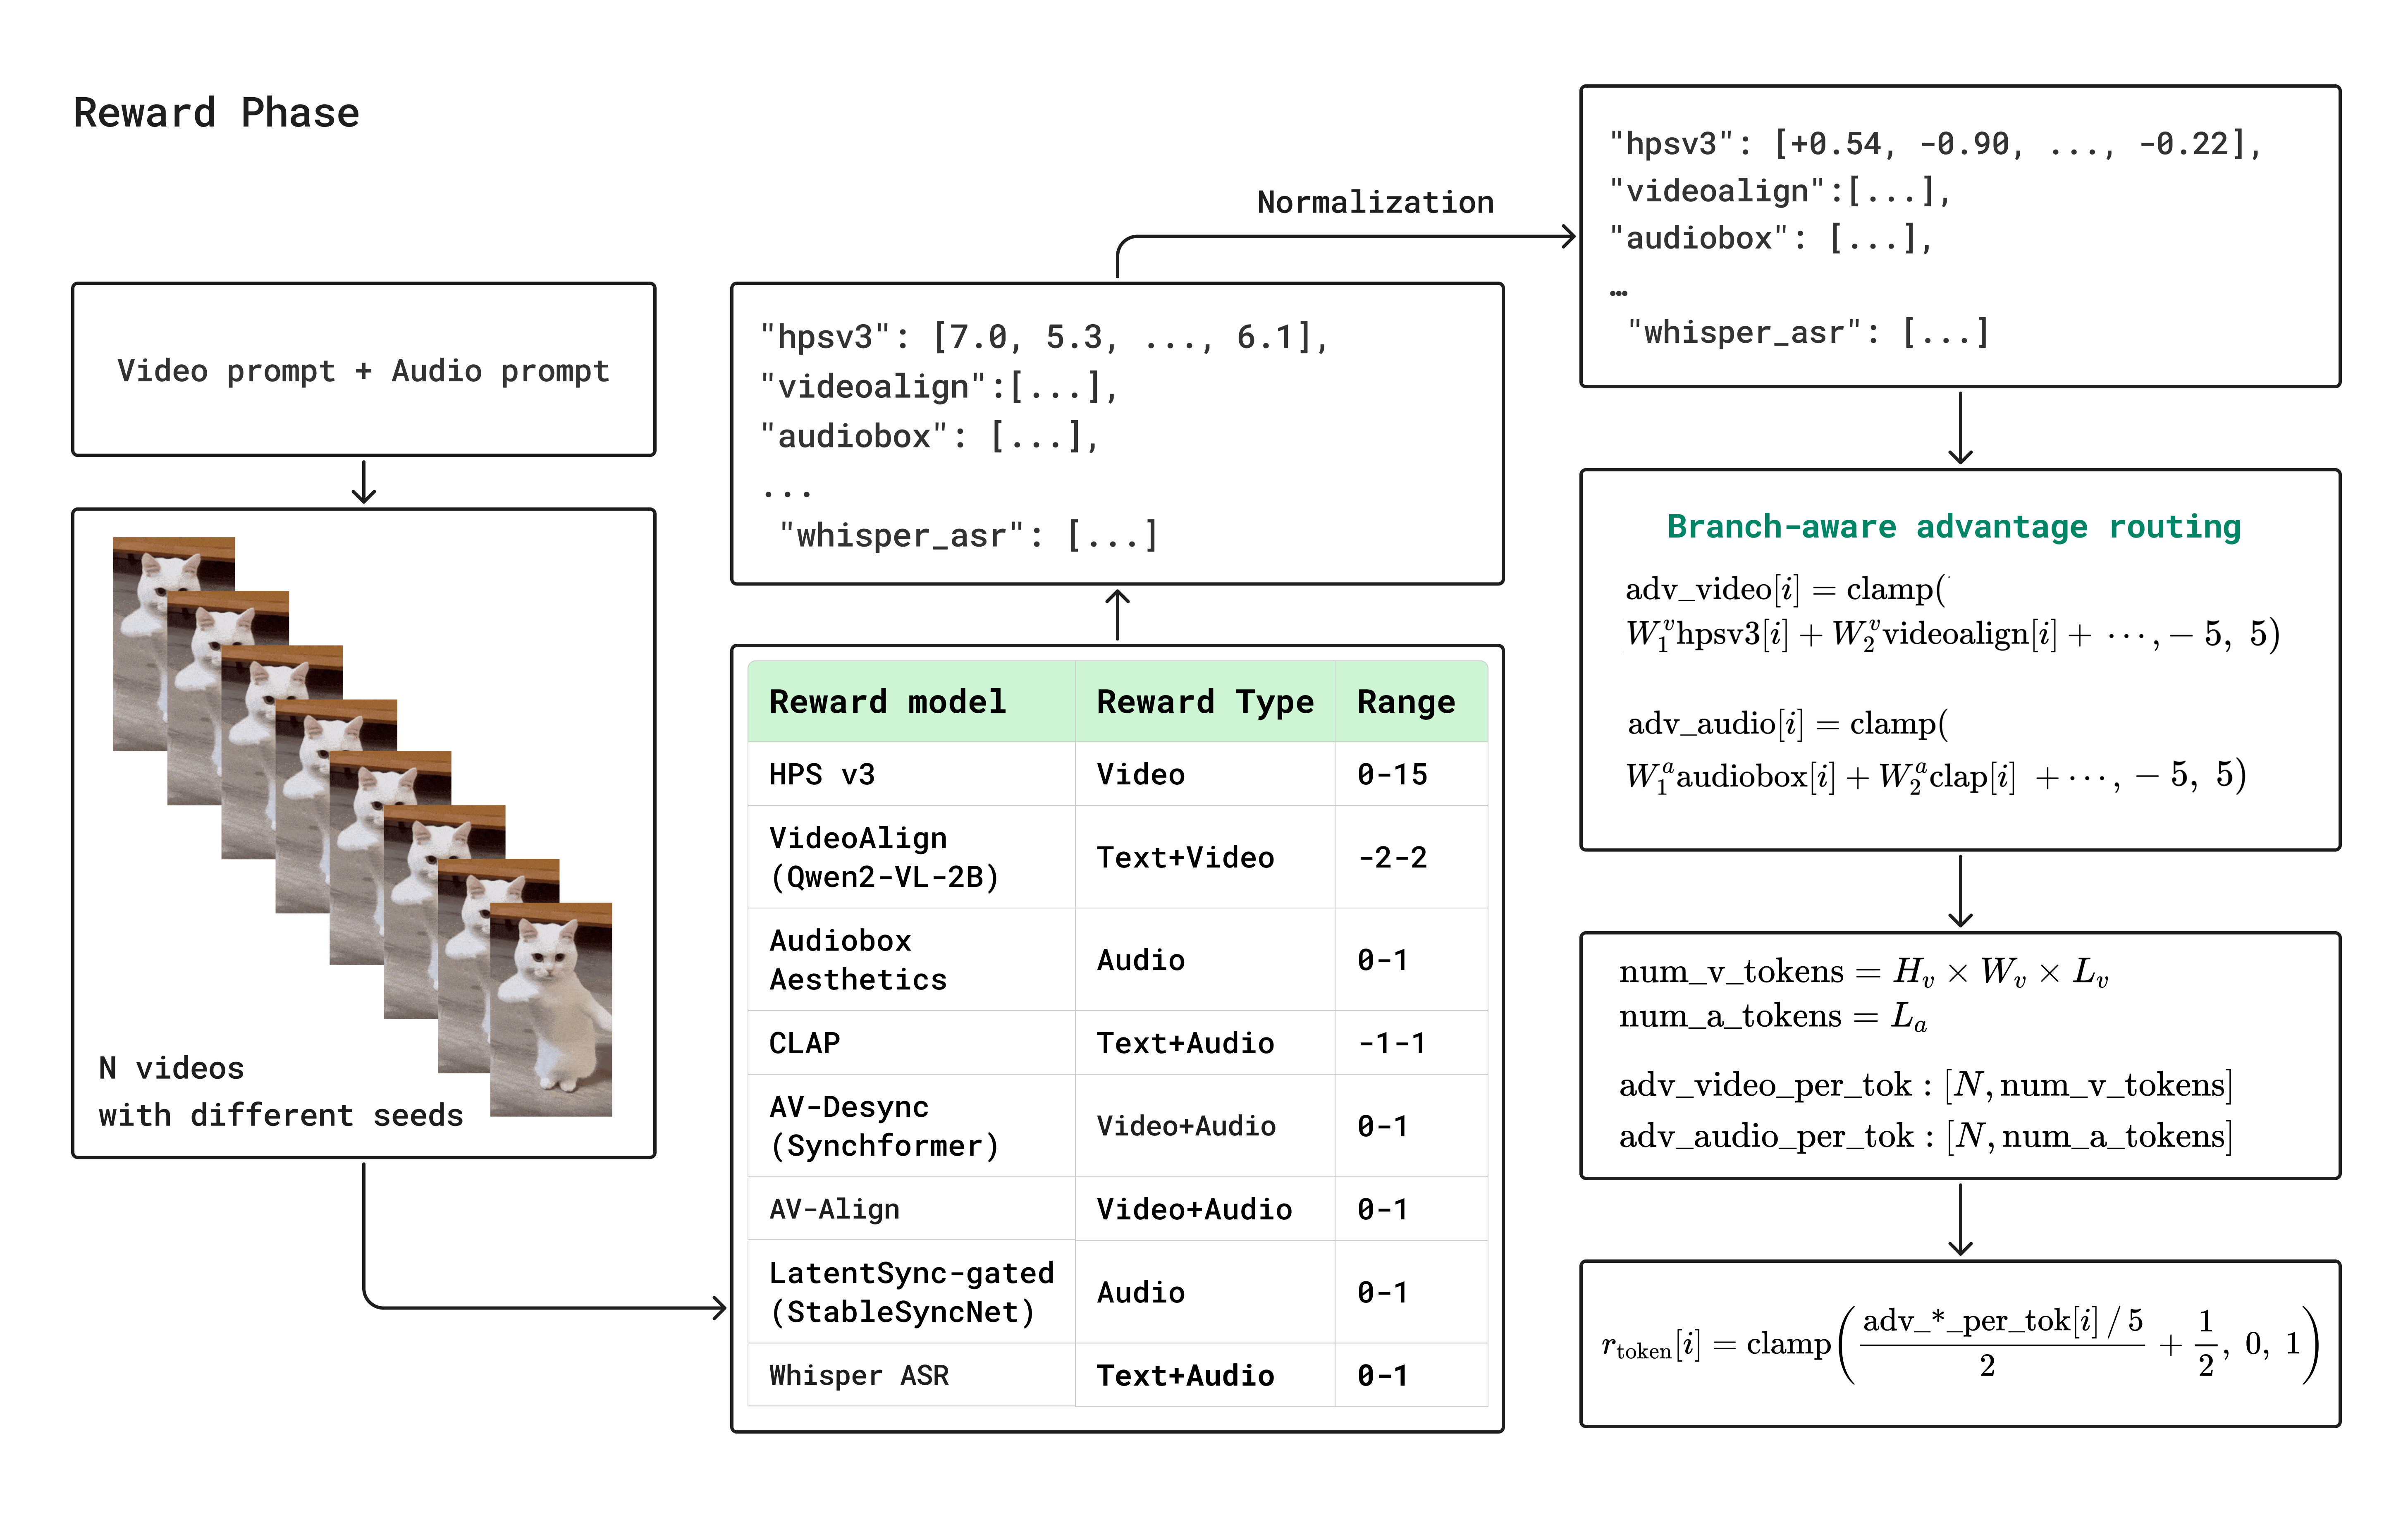
Разные оценки качества объединяются при формировании награды, с отдельным маршрутом для ветвей.
Источник: Оригинальная иллюстрация · Kandinsky 6.0 VideoКак обновляют модель с помощью RL
RL-обновление сопоставляет текущую политику, её сглаженную копию и исходную SFT-модель. Чистый латент сгенерированного примера x0 повторно зашумляют. Для каждого варианта делают 8 случайных выборок из 8 наиболее шумных времён 20-шагового расписания. Предсказания получают от текущей LoRA, старой LoRA и замороженной SFT-базы.
Положительное предсказание pos=b_mix×x_cur+(1−b_mix)×x_old, отрицательное neg=(1+b_mix)×x_old−b_mix×x_cur. При b_mix=1 получаются x_cur и 2×x_old−x_cur. Это DPO-подобное сравнение предсказаний, а не перенесённая без изменений формула языкового GRPO.
Для pos и neg считают MSE относительно x0 и каждую потерю делят на среднее абсолютное отклонение соответствующего предсказания от x0 внутри примера. По токенам смешивают r_token×loss_pos+(1−r_token)×loss_neg, затем усредняют с пространственными весами attn_w.
Регуляризатор, названный авторами KL, реализован как MSE(x_cur,x_ref). Полная потеря — mean(policy+1e-4×KL). Здесь обозначение KL относится к квадратичной ошибке между текущим и опорным предсказаниями.
Старая LoRA обновляется раз в эпоху как EMA текущей: коэффициент d растёт от 0 на 1e-3 за шаг оптимизатора до предела 0.5. AdamW использует learning rate 3e-5, разогрев 5 эпох, косинусное снижение до 5e-6 за 300 эпох и ограничение нормы градиента 1.
Чтобы оптимизация изображения не испортила звуковые представления, авторы ограничивают видеоградиент на пути V2A, где видеотокены обращаются к ключам и значениям аудио. Для Pro множитель равен 0 у блока 0, 0,1 у блоков 1–10, 0,3 у блоков 50–59 и 1 у остальных. Для Lite соответствующие зоны — блок 0 (0), блоки 1–5 (0,1) и 22–26 (0,3), остальные без ослабления. Индексация блоков начинается с нуля.
Зоны из LTX-2 напрямую не перенеслись. Собственное расписание получили отключением межмодальных ключей/значений по блокам с измерением рассинхронизации и измерением проникновения видеоградиента в аудиопоток.
Пространственные веса потери получают из A2V-внимания, где аудиозапросы обращаются к видеопатчам, на части шагов удаления шума. Лица, руки и инструменты обычно получают больший вес; усиление ограничено 1.5 раза и переносится с сетки патчей на сетку потери пространственным unpatchifying.
Итоговый RL-чекпойнт — не последняя эпоха. Выбирают лучший средний взвешенный reward в скользящем окне из пяти эпох, уменьшая влияние случайного удачного измерения.
Речевой эффект RL измерен на отложенных промптах, но зависит от распознавателя и набора. На отдельном речевом тесте с 64 промптами и 3 случайными начальными состояниями WER Pro падает с 0.235 после SFT до 0.124 после RL: авторы сообщают относительное снижение на 47%. У Lite — с 0.179 до 0.127, снижение на 29%. Для обоих парный тест Уилкоксона даёт p<1e-3.
WER вычисляет Whisper-large-v3, который также участвует в наградах RL. Поэтому это не полностью независимый от оптимизации оценщик.
На публичных Harvard sentences из 100 промптов Pro улучшает WER с 0.251 до 0.180, p=0.005. Это дополнительная проверка на другом наборе, не основание смешать её значения с первым тестом.
В итоговом сравнении раздела 7.1 WER считают уже Qwen3-ASR-1.7B на речевой части VABench. Разные распознаватели и корпуса означают, что эти числа нельзя непосредственно сравнивать с WER из RL-раздела.
На рисунке обновление старой LoRA сокращённо подписано словом default, а регуляризатор — MSE без индекса текущей модели. Точные определения в тексте: старая LoRA усредняется с текущей θ_cur, а регуляризатор сравнивает предсказания x₀^cur и x₀^ref; токенные MSE при этом нормируются на среднее абсолютное отклонение.
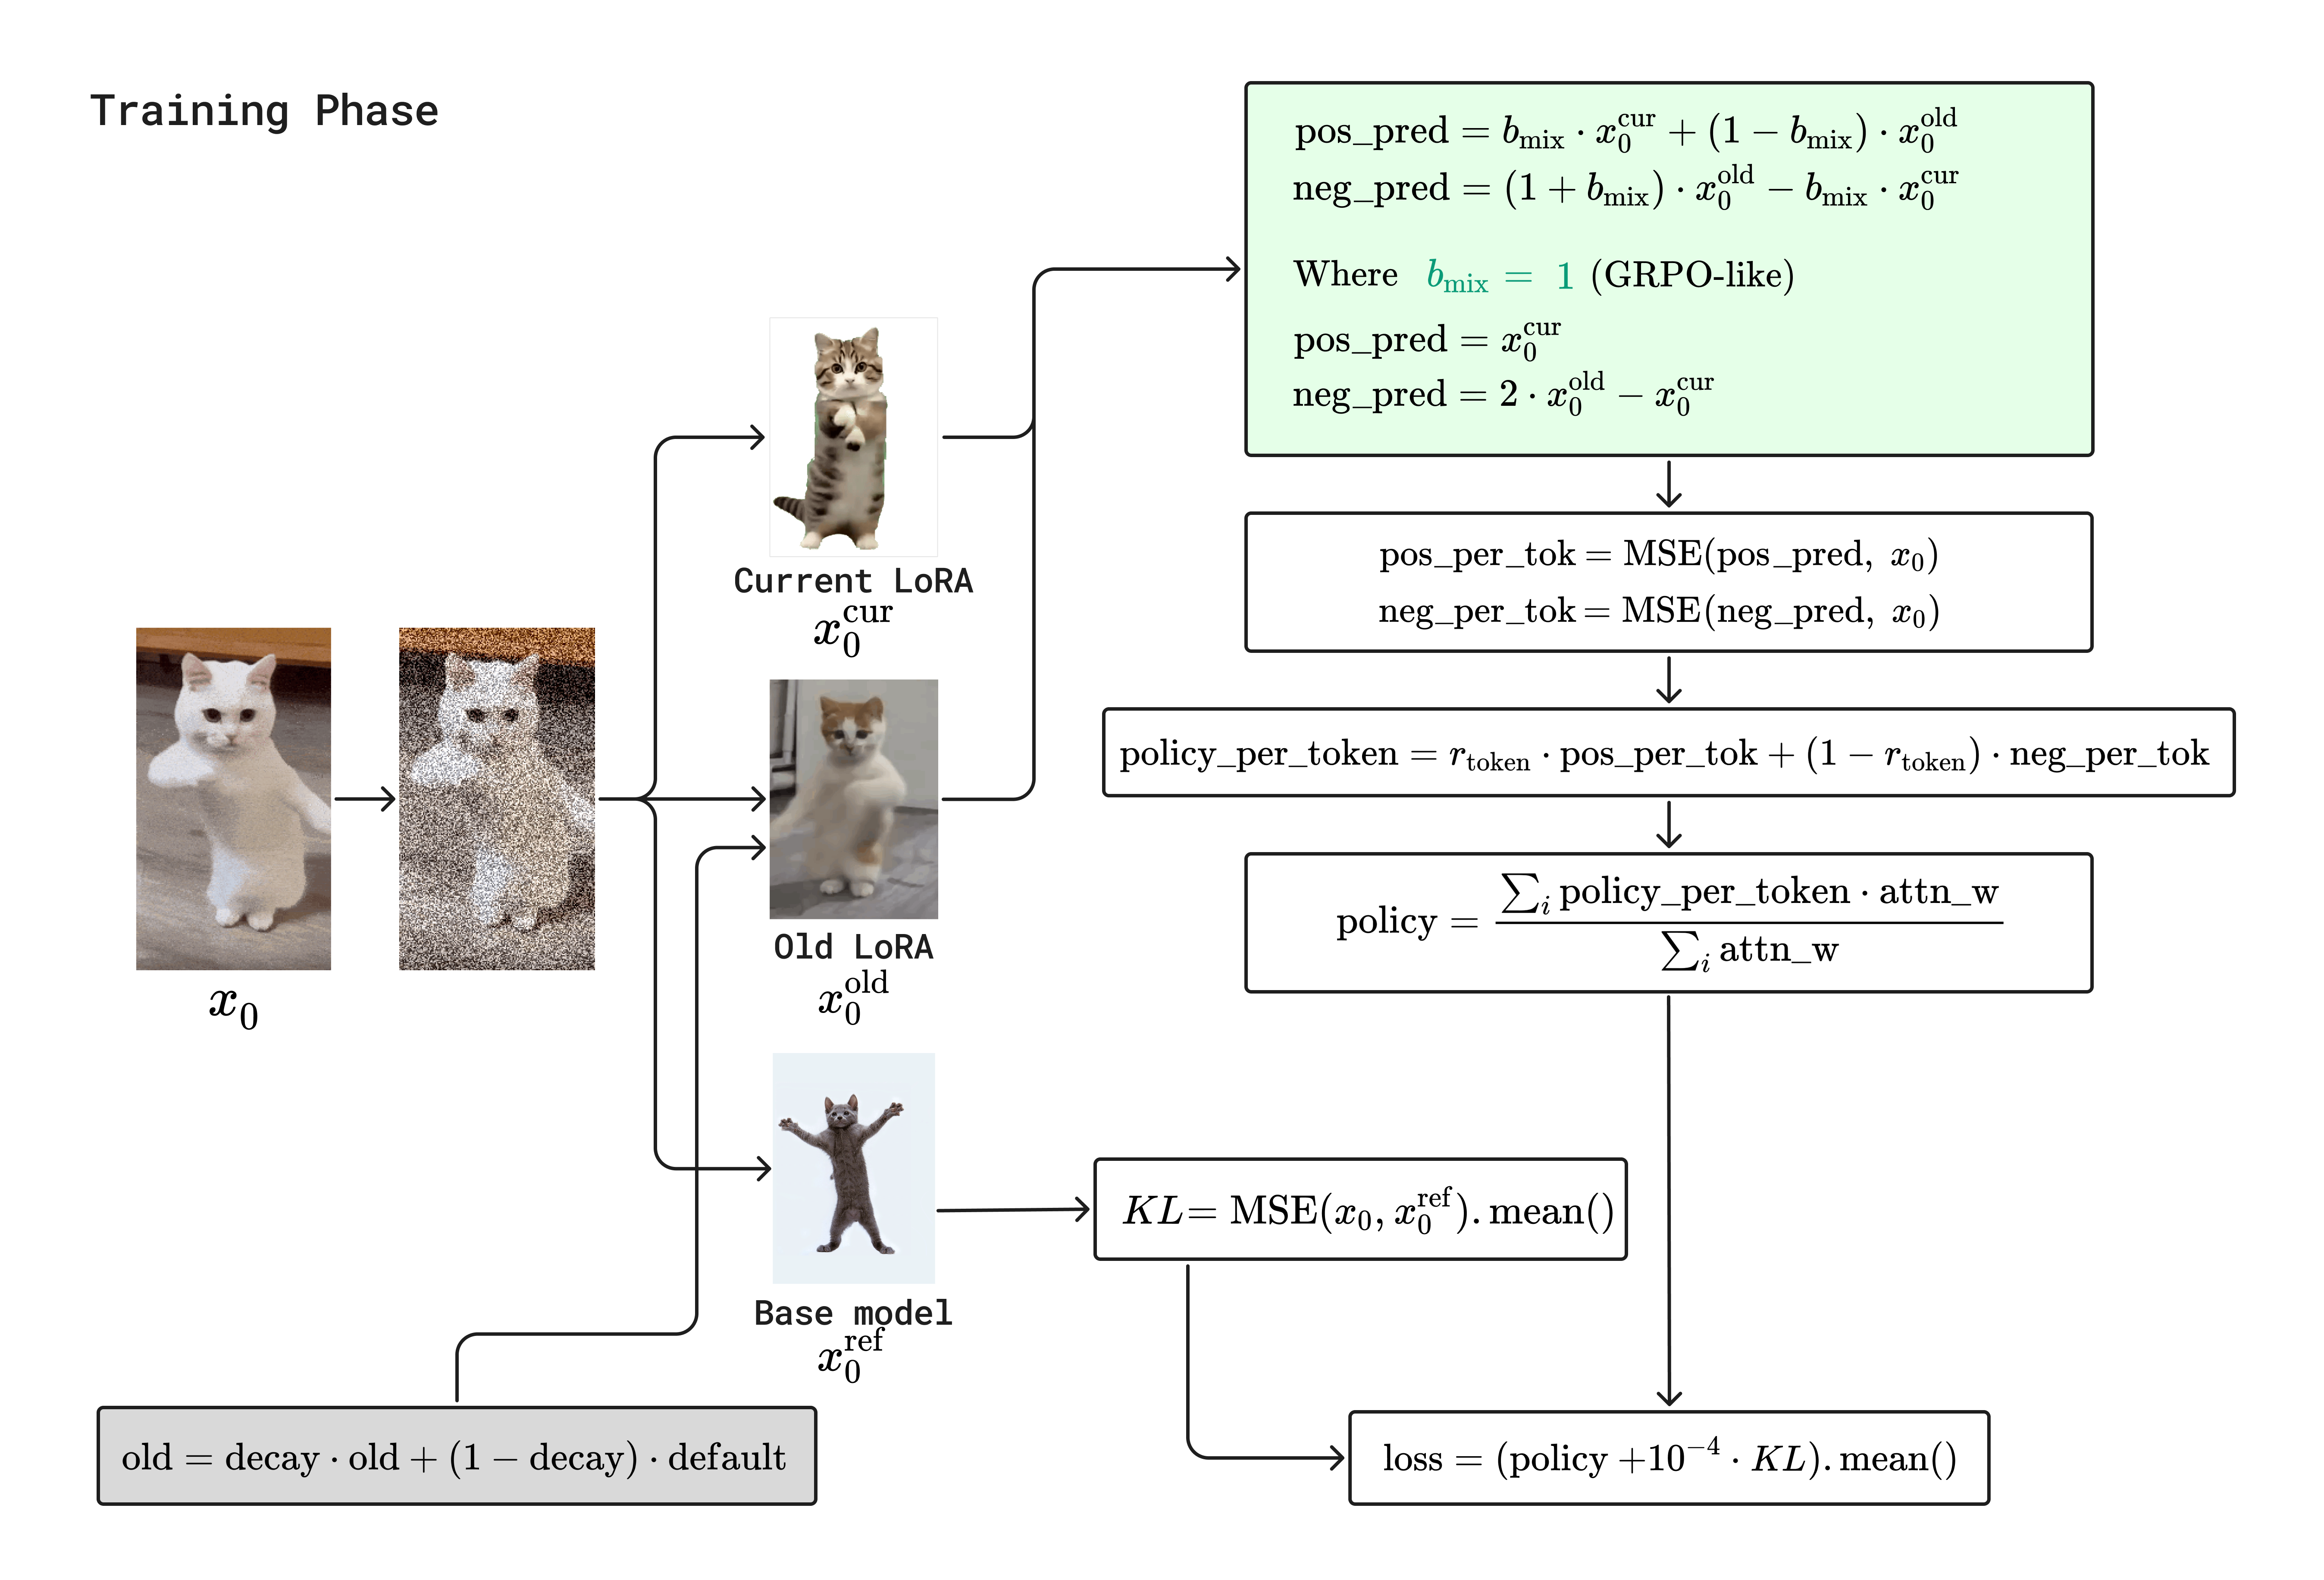
Схема RL-этапа: старое состояние политики, награды и ограничения обновления.
Источник: Оригинальная иллюстрация · Kandinsky 6.0 VideoПочему и как сокращали число шагов генерации
Метод дистилляции выбирали по устойчивости, разнообразию и стоимости, а не только по числу шагов. Сравнивали DMD, DMD2, SID, Phased Consistency, CFG distillation, π-Flow и Parallel Decoding Distillation. Для DMD/DMD2/SID наблюдали схлопывание и потерю мод генерации; вычисления учителя, вспомогательной оценки score и оптимизация требовали существенно больше GPU, особенно для видеолатентов.
CFG-дистилляция и методы согласованности были полезными базовыми вариантами, но меняли динамику движения и распределение результатов. Для требуемой малошаговой генерации их гибкости и производительности оказалось недостаточно.
Из π-Flow и PDD авторы выбрали π-Flow: наиболее надёжная сходимость и сохранение траектории учителя. Обучение на состояниях собственных генераций ученика уменьшает расхождение между обучением и применением; имитация локальных решений меньше склонна к схлопыванию, чем агрессивное согласование распределений в их опытах.
Качество π-Flow всё равно ограничено учителем. Его траекторию с classifier-free guidance можно передать напрямую, без отдельной CFG-дистилляции; сам метод не решает потерю мелких деталей при укрупнении шагов.
При сильном сжатии ролики сглаживаются, теряют высокочастотную текстуру и локальный контраст даже при сохранённых композиции и движении. Дополнительное согласование траектории не устраняет это надёжно, поэтому нужен второй этап на реальных данных с состязательной потерей.
π-Flow сжимает генератор до 10 вычислений сети, постепенно переходя к собственным траекториям ученика. Ученик инициализирован основной сетью учителя и учится по L2-регрессии воспроизводить его направляемое поле скоростей. Итоговый генератор использует 10 NFE — вычислений нейросети при генерации, а не 10 слоёв.
Обучение идёт от off-policy-режима через смешанный к on-policy: сначала стабилизируется приближение к учителю, затем модель учится исправлять состояния, возникающие в собственном процессе генерации.
Для 4000 итераций отношение трёх режимов равно 1:1:2. Указаны n_grid=10, policy steps=128, AdamW с learning rate 3e-6, пакет 64 и 10 равномерных интервалов интегрирования.
Полученная модель служит начальной точкой Sim-LADD. На этой стадии авторы наблюдали сохранение движения и аудио, но локальная имитация учителя ещё не возвращала мелкие детали.
Sim-LADD восстанавливает резкость на состояниях реальной генерации ученика. В обычном LADD промежуточное состояние получают зашумлением чистого примера. Sim-LADD получает его из обратной траектории удаления шума самим учеником, чтобы дискриминатор видел состояния, встречающиеся при применении.
Вместо распространения градиента через всю цепочку используют DRaFT-k по последним пяти шагам из десяти. По наблюдению авторов, качество сопоставимо с полной цепочкой, а расход памяти существенно ниже; дополнительно применяют gradient checkpointing.
Реальные и сгенерированные латенты повторно зашумляют перед извлечением признаков. Это стабилизирует состязательное обучение, уменьшает переобучение дискриминатора и позволяет обойтись без явного R1-штрафа. Распределение уровня шума — LogitNormal(−3.5,1.0).
Hinge loss вычисляют по признакам промежуточных слоёв. Новые головы дискриминатора — Fused Transformer Decoder blocks с отдельными видео- и аудиооценками; токены изображения-условия удаляют перед расчётом логитов. В тексте одновременно названы frozen teacher backbone и обновление всех параметров дискриминатора; точная граница их разделения требует уточнения.
AdamW используют для обеих сторон: learning rate генератора 8e-7, дискриминатора 1.5e-6, пакет 8, ограничение нормы градиента 1, 300 шагов. Роль этапа — восстановить текстуру и воспринимаемую чёткость, потерянные при сжатии траектории.
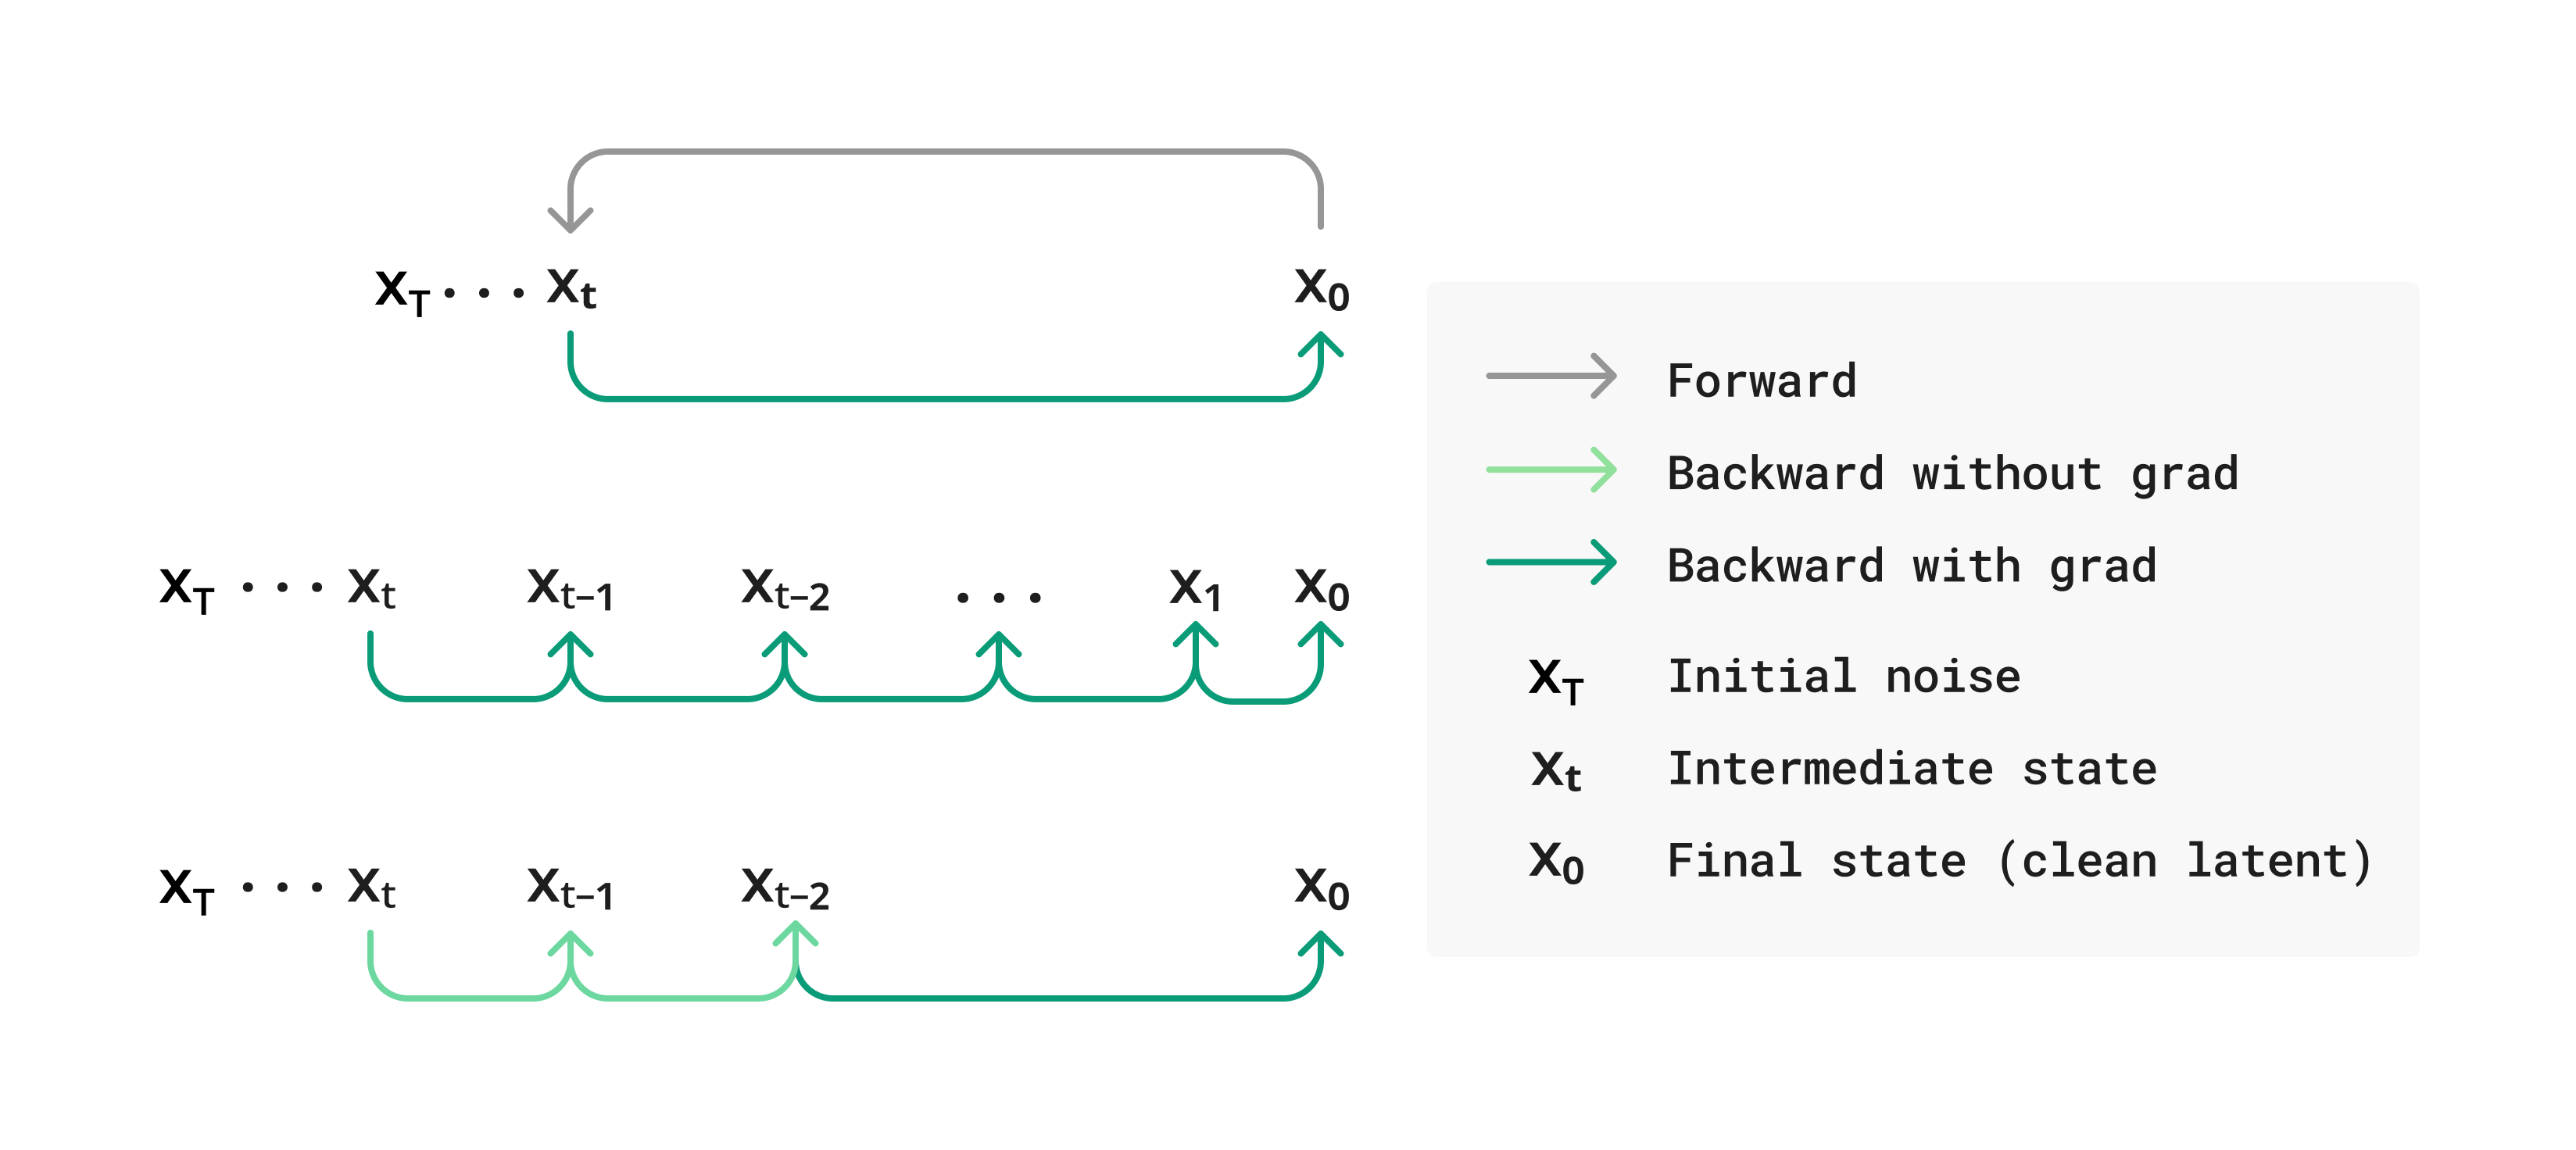
Схема вычислений и передачи градиентов при дистилляции.
Источник: Оригинальная иллюстрация · Kandinsky 6.0 Video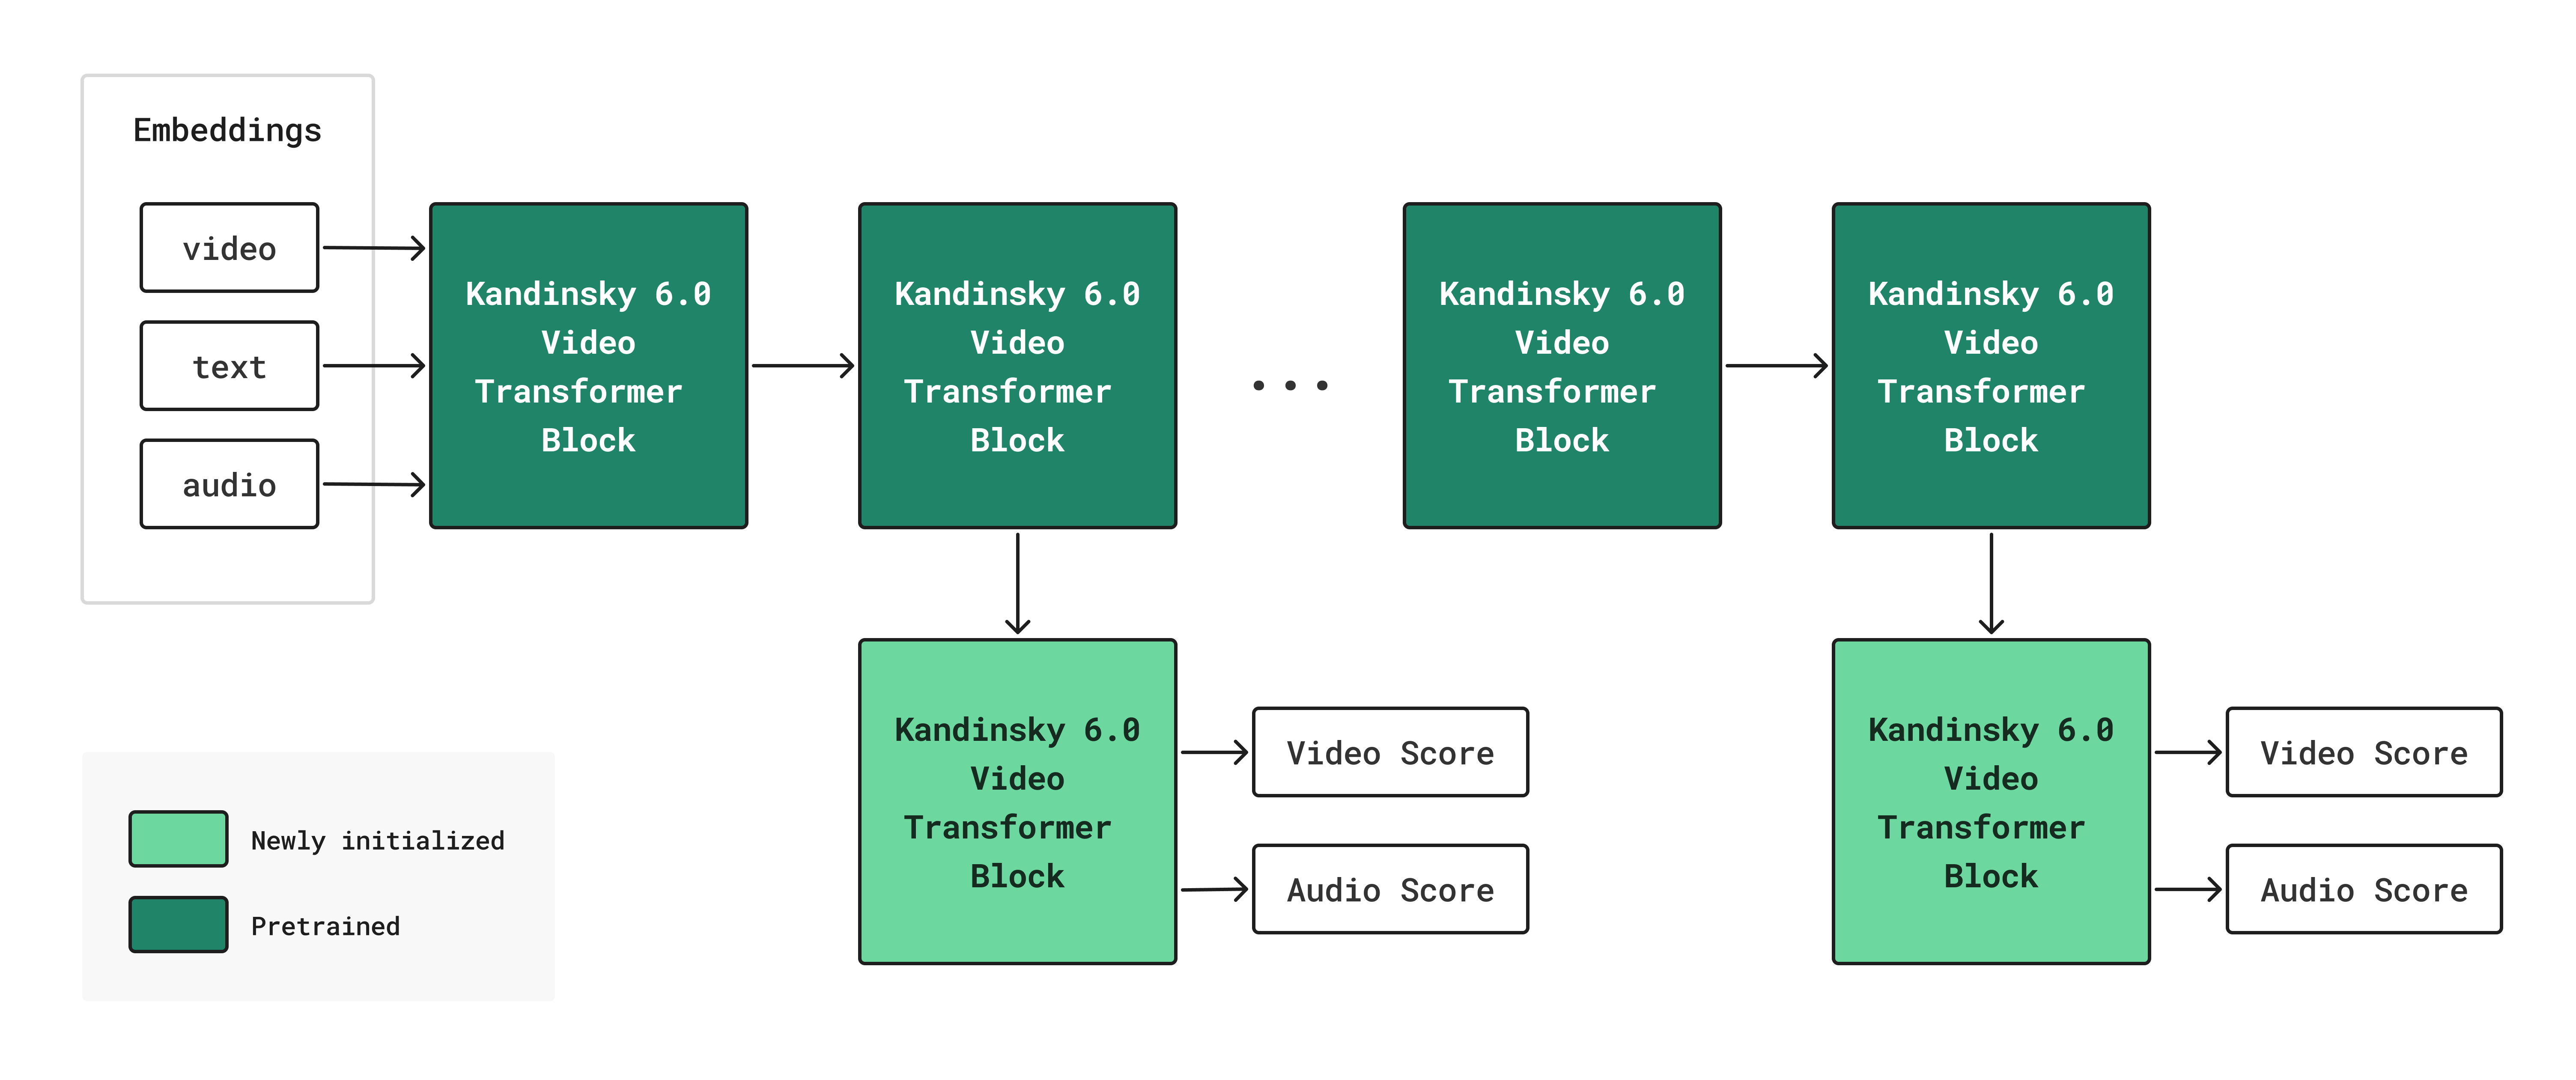
Часть модели сохраняется из предварительно обученного генератора, другая обучается для оценки результата.
Источник: Оригинальная иллюстрация · Kandinsky 6.0 VideoАрхитектура SR-DiT и Latent Upscaler
SR-DiT восстанавливает детали без текста в более крупной сетке K-VAE. SR состоит из отдельно обученных компонентов: детерминированный Latent Upscaler увеличивает пространственную сетку с сохранёнными искажениями, затем SR-DiT удаляет искажения и восстанавливает детали. Один SR-DiT обслуживает ×2 и ×4; у LU отдельные ветви для масштабов.
SR-DiT начинается с текстово-независимого SFT-чекпойнта Kandinsky 5.0 Video Lite в пространстве K-VAE. У него 32 блока, ширина 1792, 28 голов по 64, FFN 7168 и представление времени 512; около 1.413B параметров со стандартным выходом.
Текстовых энкодеров и внимания к тексту нет. Вместо агрегированного текстового условия используется обучаемая константа pooled bias; на блок приходится шесть модуляций — масштаб, сдвиг и вентиль для самовнимания и FFN — вместо девяти в текстово-условной архитектуре.
Вход объединяет 64 канала зашумлённого видео, 64 канала опорного HQ-латента первого кадра и один канал маски: всего 129. Без опоры последние две части нулевые. Патч (1,1,1) соответствует одной ячейке; проекция 129→1792.
Блок использует остаточные связи, LayerNorm без обучаемого affine, adaLN-Zero, RMSNorm запросов/ключей внутри головы, 3D RoPE с разбиением (16,24,24), общий для всех блоков, и FFN 1792→7168→1792 с GELU без bias. Плотное FlashAttention заменяют NABLA на второй стадии.
Стандартная голова 1792→64 предсказывает скорость. При DX-дистилляции её расширяют до 1792→640: десять 64-канальных выходов при неизменной основной сети. Это добавляет около 1.03 млн параметров, а не десять отдельных SR-моделей.
Latent Upscaler заменяет многократное увеличение и кодирование пиксельных тайлов одной работой в латентном пространстве. Без LU каждый увеличенный пиксельный тайл нужно отдельно кодировать K-VAE. С LU исходный клип кодируют один раз, после чего вырезают и увеличивают латентные тайлы; временное разрешение не меняется, выход остаётся 64-канальным.
Ветвь ×4 наследует геометрию декодера K-VAE: входная Conv3d 64→2048, пять ResBlock ширины 2048, увеличение ×2, три блока с переходом к 1024, ещё ×2, три блока с переходом к 512 и выход ModRMSNorm–SiLU–Conv3d 512→64. Примерно 1.44B параметров, около 79% в первых пяти блоках.
ResBlock содержит два узла ModRMSNorm–SiLU–Conv3d без bottleneck; при уменьшении ширины остаточная связь использует проекцию 1×1×1. Нормировки модулируются исходным LQ-латентом, приведённым к текущей сетке ближайшим соседом. Увеличение выполняется ближайшим соседом с последующими свёртками.
Свёртки 3×3×3 имеют симметричное временное дополнение копиями крайних кадров. При переносе весов причинного K-VAE-декодера временные ядра сдвигают для этой симметричной области.
Для одинакового выходного тайла вход ×2 содержит вчетверо больше пространственных ячеек, чем вход ×4. Чтобы не выполнять все пять широких блоков на большей сетке, ×2 получает укороченное начало и только одно увеличение.
В ×2 копируют вход, первый и пятый широкие ResBlock как адаптеры, свёртки первого upsampling без самого resizing и оставшуюся часть ×4 как отдельные модули. Случайно инициализированных параметров нет; исходная ×4 заморожена, копии ×2 обучаются с первого шага. Активный путь ×2 содержит около 0.763B параметров и не выполняет путь ×4.
На схеме SR-DiT ширина промежуточного слоя FFN подписана как 1768; в тексте архитектуры — 7168. В расчётах выше использовано текстовое значение, сам оригинал приведён без исправлений.
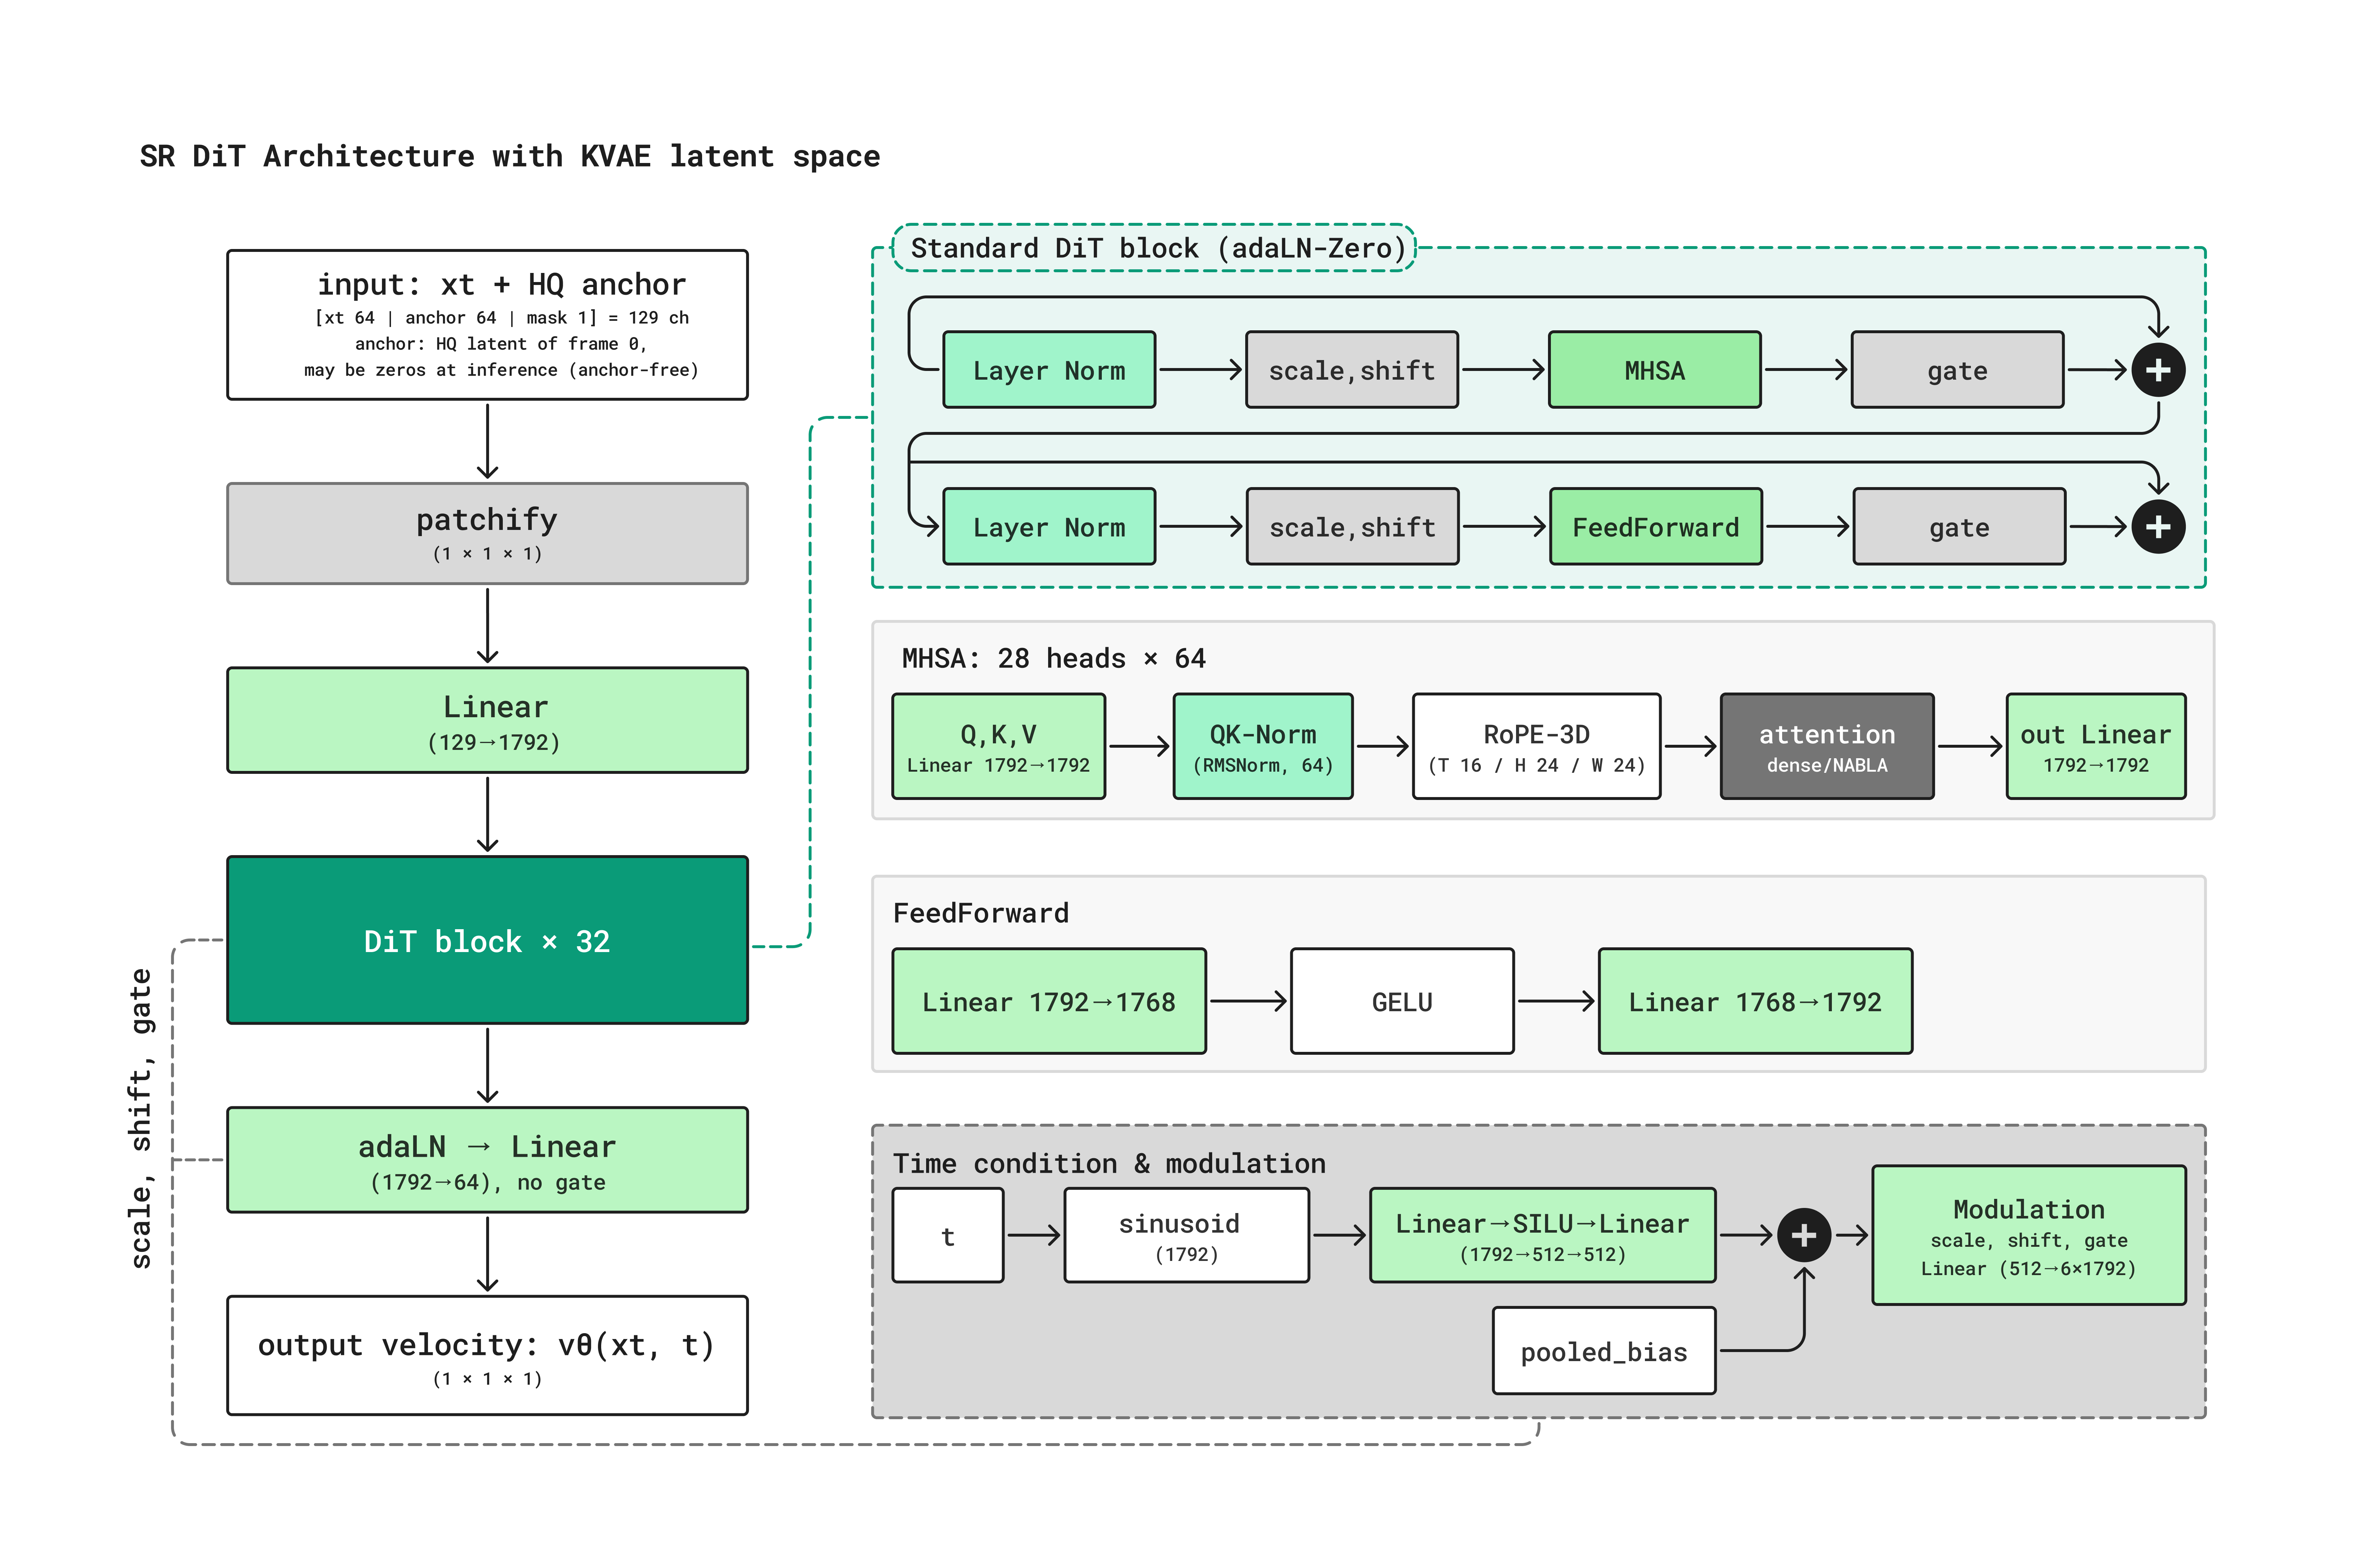
Архитектура модели увеличения разрешения в латентном пространстве.
Источник: Оригинальная иллюстрация · Kandinsky 6.0 Video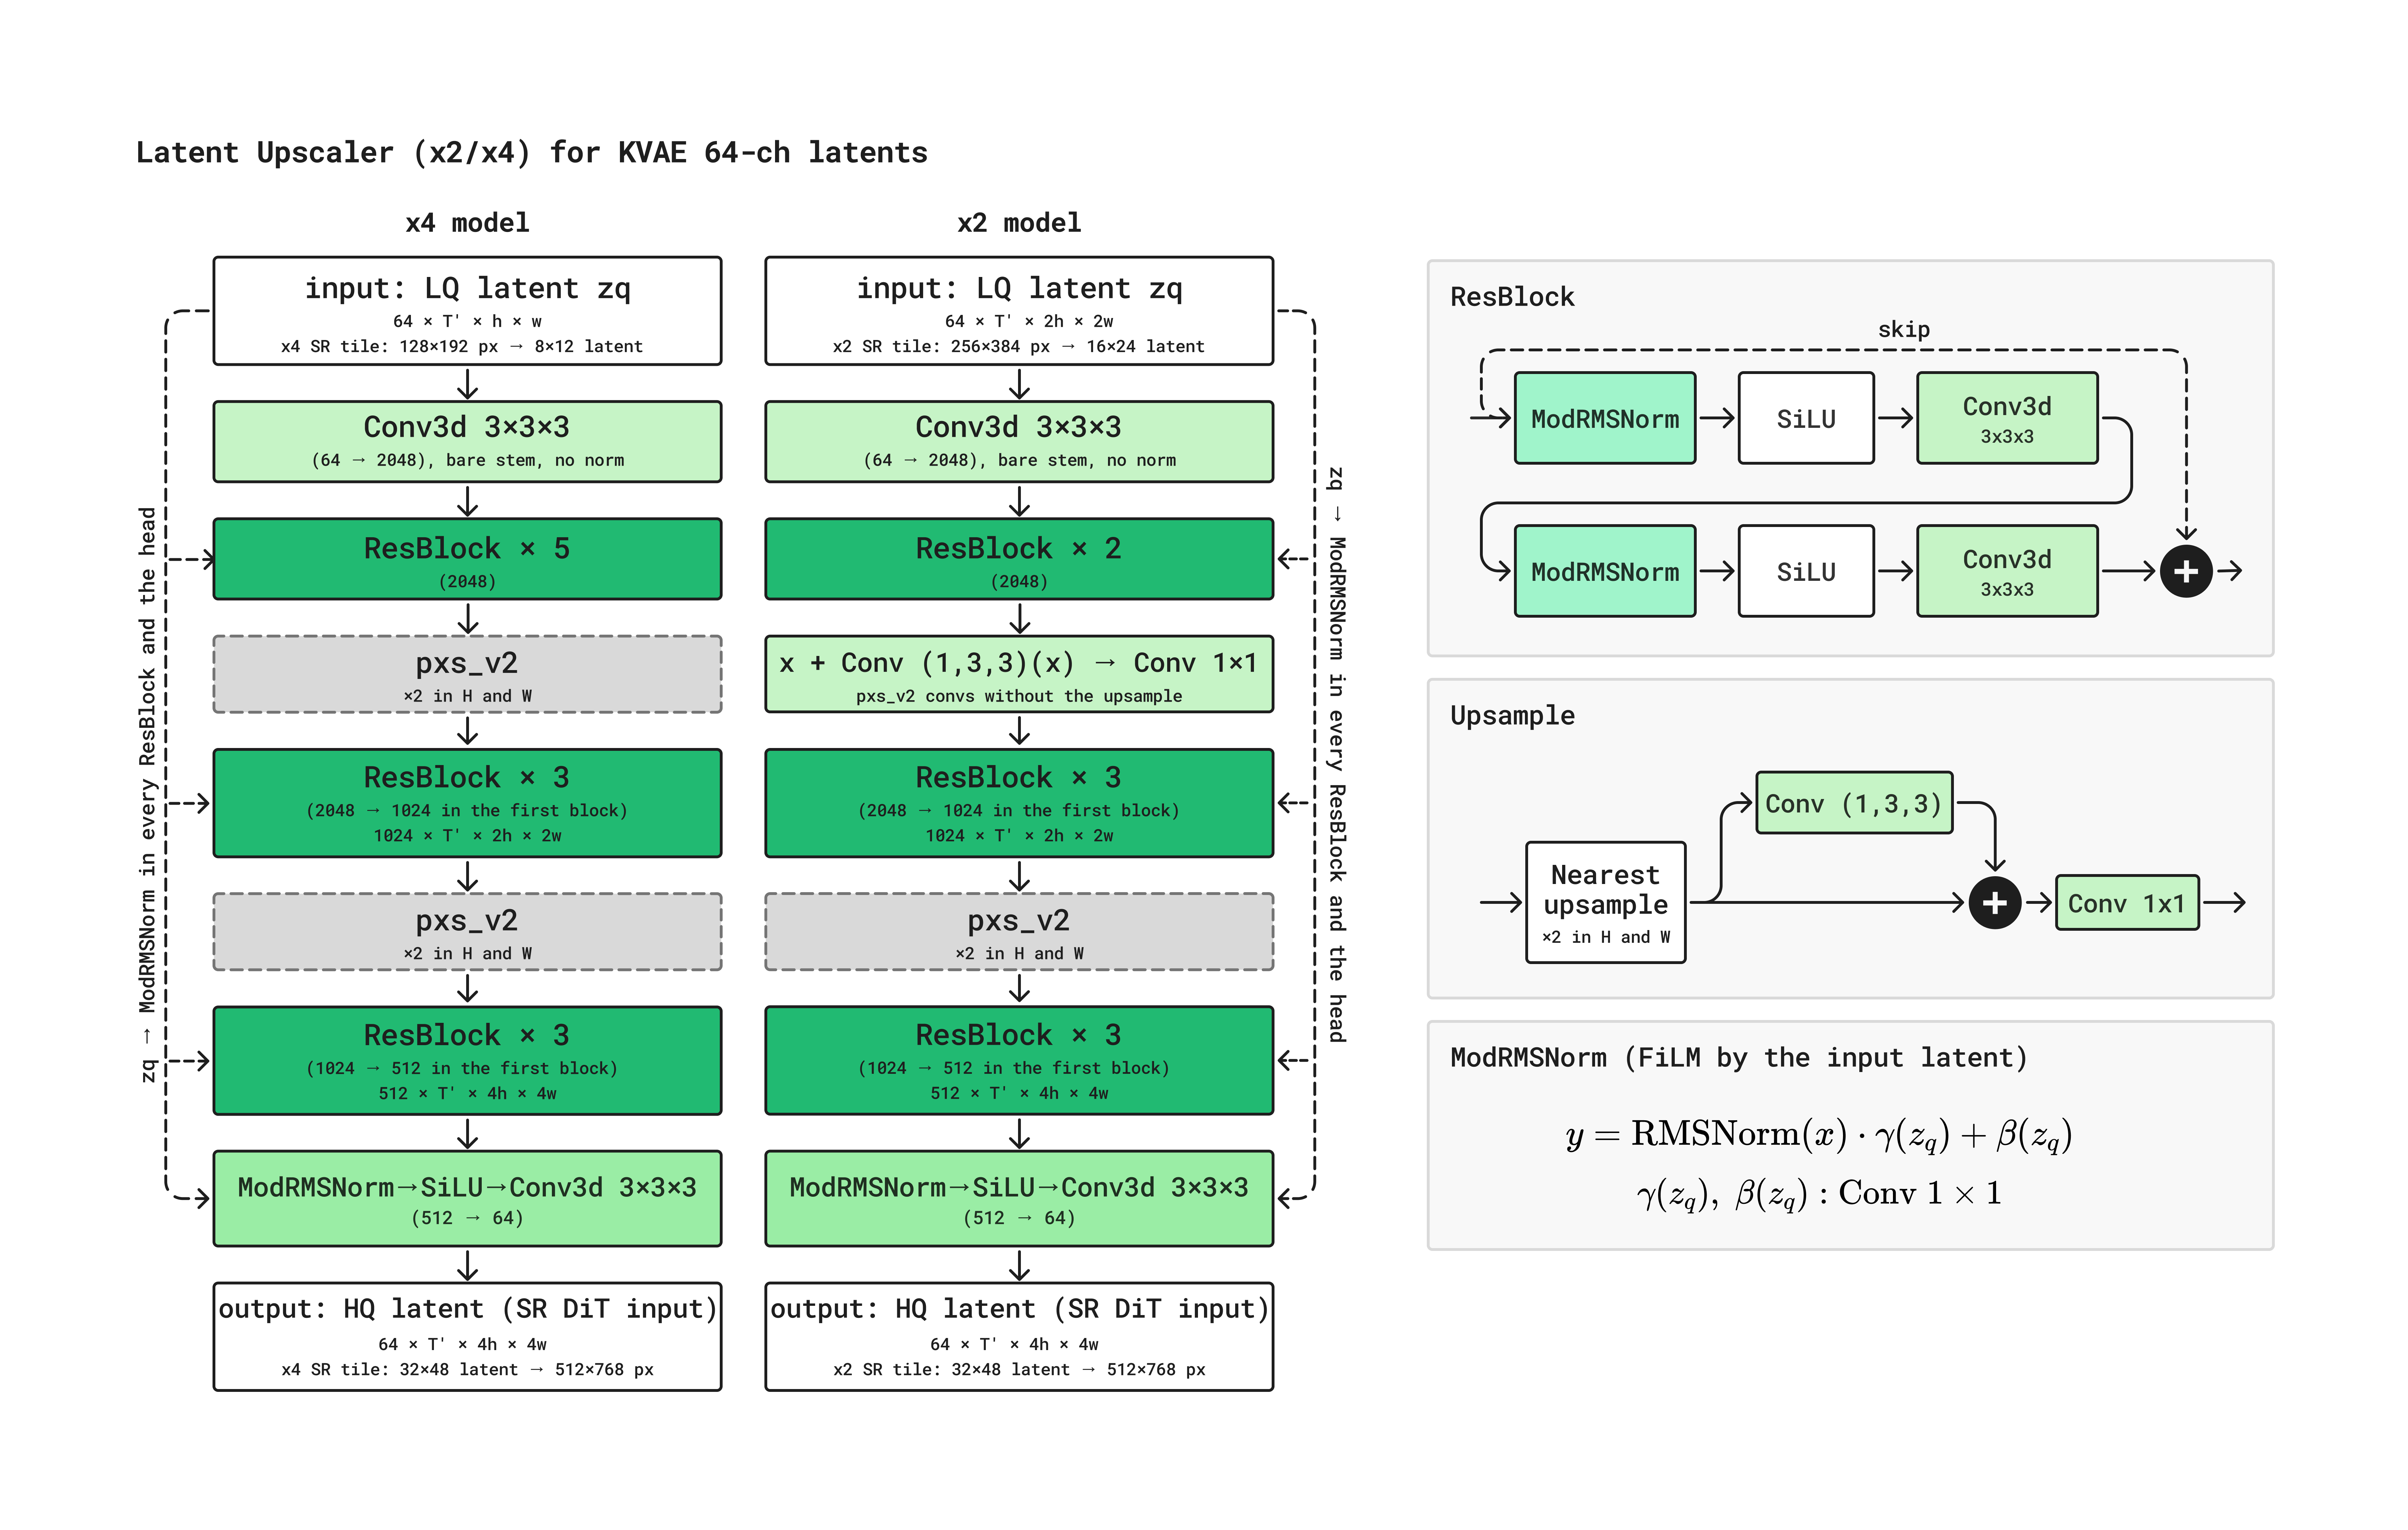
Латентный upscaler изменяет пространственное представление до окончательного декодирования.
Источник: Оригинальная иллюстрация · Kandinsky 6.0 VideoДанные, функции потерь и обучение сверхразрешения
Искажения для SR моделируют отдельно ухудшение картинки и нарушения движения. Из исходных видео выбирают фрагменты 512×768, 512×512 или 768×512 пикселей, сохраняя временную последовательность. Пробуют центр, случайную область, область по оптическому потоку или с высокой детализацией; порядок случайный с заданными весами. Первый прошедший проверки фрагмент принимают, иначе видео пропускают.
До вырезания исключают тёмные рамки; фрагменты проверяют на избыточную темноту, полосы и компрессию пространственными и временными мерами. Эти проверки дополняют фильтрацию целых клипов.
Видеоадаптация Real-ESRGAN использует два этапа размытия, изменения размера, гауссовского/пуассоновского шума и JPEG, с видеокомпрессией на первом и в финальном блоке. Второй этап слабее; порядок финальных операций компрессии и resize с необязательным sinc-фильтром меняют случайно.
Параметры blur/resize и сила шума общие между кадрами, сам шум независимый, JPEG-качество меняется плавно. Эта ветвь не деформирует геометрию специально. Пониженное разрешение ×2/×4 возвращают bilinear-увеличением к HQ-размеру перед кодированием для SR-DiT; низкое разрешение сохраняют для LU.
Сильная CreativeVR-подобная деградация сначала деформирует пространственную сетку полем, меняющимся между двумя случайными сетками. Затем в случайном порядке применяет три или четыре операции: направленное размытие, смешивание соседних кадров, выпадение кадров с интерполяцией и пространственно-временное уменьшение с восстановлением размера и длины.
Для временной ветви искажённый клип сразу сохраняет HQ-геометрию и кодируется для SR-DiT. Отдельное bilinear-уменьшение даёт вход LU. SR-DiT учится degraded-to-clean, LU — degraded-to-degraded: задачи не взаимозаменяемы.
Цель SR сочетает восстановление латента, пиксельных деталей и подавление решётчатых артефактов. Сначала к LQ-латенту добавляют шум: z̃_LQ=sqrt(1−s²)×z_LQ+s×epsilon, s=0.7. Учебное состояние x_t=(1−t)×z_HQ+t×z̃_LQ; целевая скорость — z̃_LQ−z_HQ, оптимизируется MSE по всем параметрам SR-DiT.
На первых двух стадиях u равномерно выбирают из [0,1], затем t=5u/(1+4u). Чистый латент оценивают как ẑ_HQ=x_t−t×v_theta и декодируют замороженным K-VAE, сохраняя градиент к SR-DiT.
Пиксельные потери при t≤0.7: L1 с весом 0.6, LPIPS/VGG с 0.35, HFP с 1.0 и MFS с 1.0. HFP сравнивает высокочастотные Haar-поддиапазоны LH/HL/HH с общим случайным сдвигом на 0 или 1 пиксель; MFS сравнивает FFT-амплитуды на гармониках 16-пиксельной сетки K-VAE.
HFP отвечает за мелкие детали, MFS специально направлена против периодической решётки. Для ограничения памяти декодируют случайный кроп 256×256, максимум четыре последовательных латентных кадра максимум двух примеров на GPU.
HQ-опора занимает только первую временную позицию, её положение показывает маска. На стадиях 1–2 опору вместе с маской обнуляют с вероятностью 0.15. В текущем инференсе обе всегда нулевые; использование HQ-первого кадра от отдельного image SR названо будущим вариантом.
SR обучают последовательно с плотным вниманием, NABLA и двухвызовной DX-политикой. Все три стадии проходят на 8 H100, с AdamW, betas=(0.9,0.95), weight decay=1e-3, clipping=1, s=0.7 и равновероятной смесью ×2/×4. Исходные последовательности имеют 20–31 латентный кадр; на GPU упаковывают 124 кадра, эквивалент четырёх полных 31-кадровых клипов.
Stage 1: плотное внимание, learning rate 1e-5, 500 шагов разогрева, EMA=0.999, сдвиг времени 5.0. Для продолжения выбирают шаг 7250; примерно 4.5 дня.
Stage 2: заменяют внимание на NABLA. Top-CDF порог P снижают с 0.95 до 0.8 за 200 шагов; добавляют локальное STA-окно 11×7×7 блоков времени/высоты/ширины, каждый пространственный блок содержит 8×8 латентных токенов. Ещё 6000 шагов, learning rate 1e-5, разогрев 200, около трёх дней.
Stage 3: учитель заморожен, его сеть и ученик инициализированы финальным Stage 2. Расширенную голову ученика инициализируют десятью копиями выхода учителя. Траектория разделена на два сегмента: один вызов сети в начале сегмента выдаёт десять скоростей, которые превращаются в узлы чистого латента для интерполируемой DX-политики.
На обучении учителя вычисляют в восьми состояниях выбранного сегмента; MSE сопоставляет его скорость с локально усреднённой скоростью политики ученика. Внутренняя сетка — 128 подшагов на полную траекторию, минимальное окно усреднения — три подшага. Дополнительных вызовов ученика внутри сегмента нет. Для каждого примера выбирают один сегмент и строят его начальное состояние из HQ и зашумлённого LQ с опорным кадром.
На Stage 3 пиксельные потери используют оценку ẑ0=x_t−sigma_t×u в начале сегмента; остальные узлы контролирует DX-потеря. На этой стадии пиксельные потери действуют при всех уровнях шума, но их веса снижены: L1 — 0,05, LPIPS — 0,026, HFP — 0,16, MFS — 0,033; декодируется один пример на GPU. Отключают dropout HQ-опоры, используют time shift=3.5, final segment size scale=0.5, learning rate 1e-6, warmup=100, накопление двух микропакетов и EMA=0.9999. Финал — 750 обновлений за около 1.5 дня; инференс требует NFE=2 на тайл, не двух элементарных шагов интегрирования.
LU учится увеличивать уже искажённое представление и отдельно получает временную согласованность. Целевой латент LU получен из полноразмерной искажённой версии, а не из чистого HQ. Слабая/синтетическая смесь содержит четыре группы: Kandinsky T2V со слабой деградацией, 4K со слабой Real-ESRGAN-деградацией, движение камеры по изображениям и 4K с временными искажениями. Для ×4 около 218 тыс. пар, для ×2 около 194 тыс.
Обе ветви обучают на 4 GPU, по 124 латентных кадра на GPU. AdamW: betas=(0.9,0.95), weight decay=1e-4, clipping=1, EMA=0.99. Основные потери — латентная Charbonnier с epsilon=1e-3 и пиксельная L1, обе с весом 1.
Пиксельную потерю через замороженный K-VAE считают каждый второй шаг для одного примера на GPU, на кропе 16×24 ячеек и первых девяти латентных кадрах. LPIPS как учебная потеря отключена. Временная потеря сопоставляет межкадровые разности предсказания и цели.
У LU ×4 первые 100 шагов обучают только новые выходные головы. Затем идут три последовательных запуска — 50 тыс., 40 тыс. и 10 тыс. шагов с learning rate 2,2×10⁻⁴, 1,1×10⁻⁴ и 1,1×10⁻⁵. После первых 50 тыс. шагов вес латентной временной L1 поднимают с 0,1 до 0,5 и добавляют пиксельную временную L1 с весом 1, чтобы детали не менялись от кадра к кадру.
Используют μP-подобное масштабирование learning rate скрытых и выходных свёрток на 512/C_in; входные проекции, нормировки, модуляции и bias сохраняют базовую скорость. ×4 занимает около 60 часов на 4 GPU.
Для LU ×2 замораживают исходную ветвь ×4 и сразу обучают все скопированные модули с усиленными временными потерями. Первые 20 тыс. шагов используют более сильные искажения, затем — слабую и синтетическую смесь. Всего обучение длится 40 тыс. шагов при learning rate 2,2×10⁻⁴ и ещё 10 тыс. шагов полировки при 2,2×10⁻⁵ — около двух дней на четырёх GPU.
На учебной схеме написано t ~ U[0,1]. В тексте сначала выбирают u равномерно, затем преобразуют его в t = 5u/(1+4u); это меняет распределение фактических временных точек.
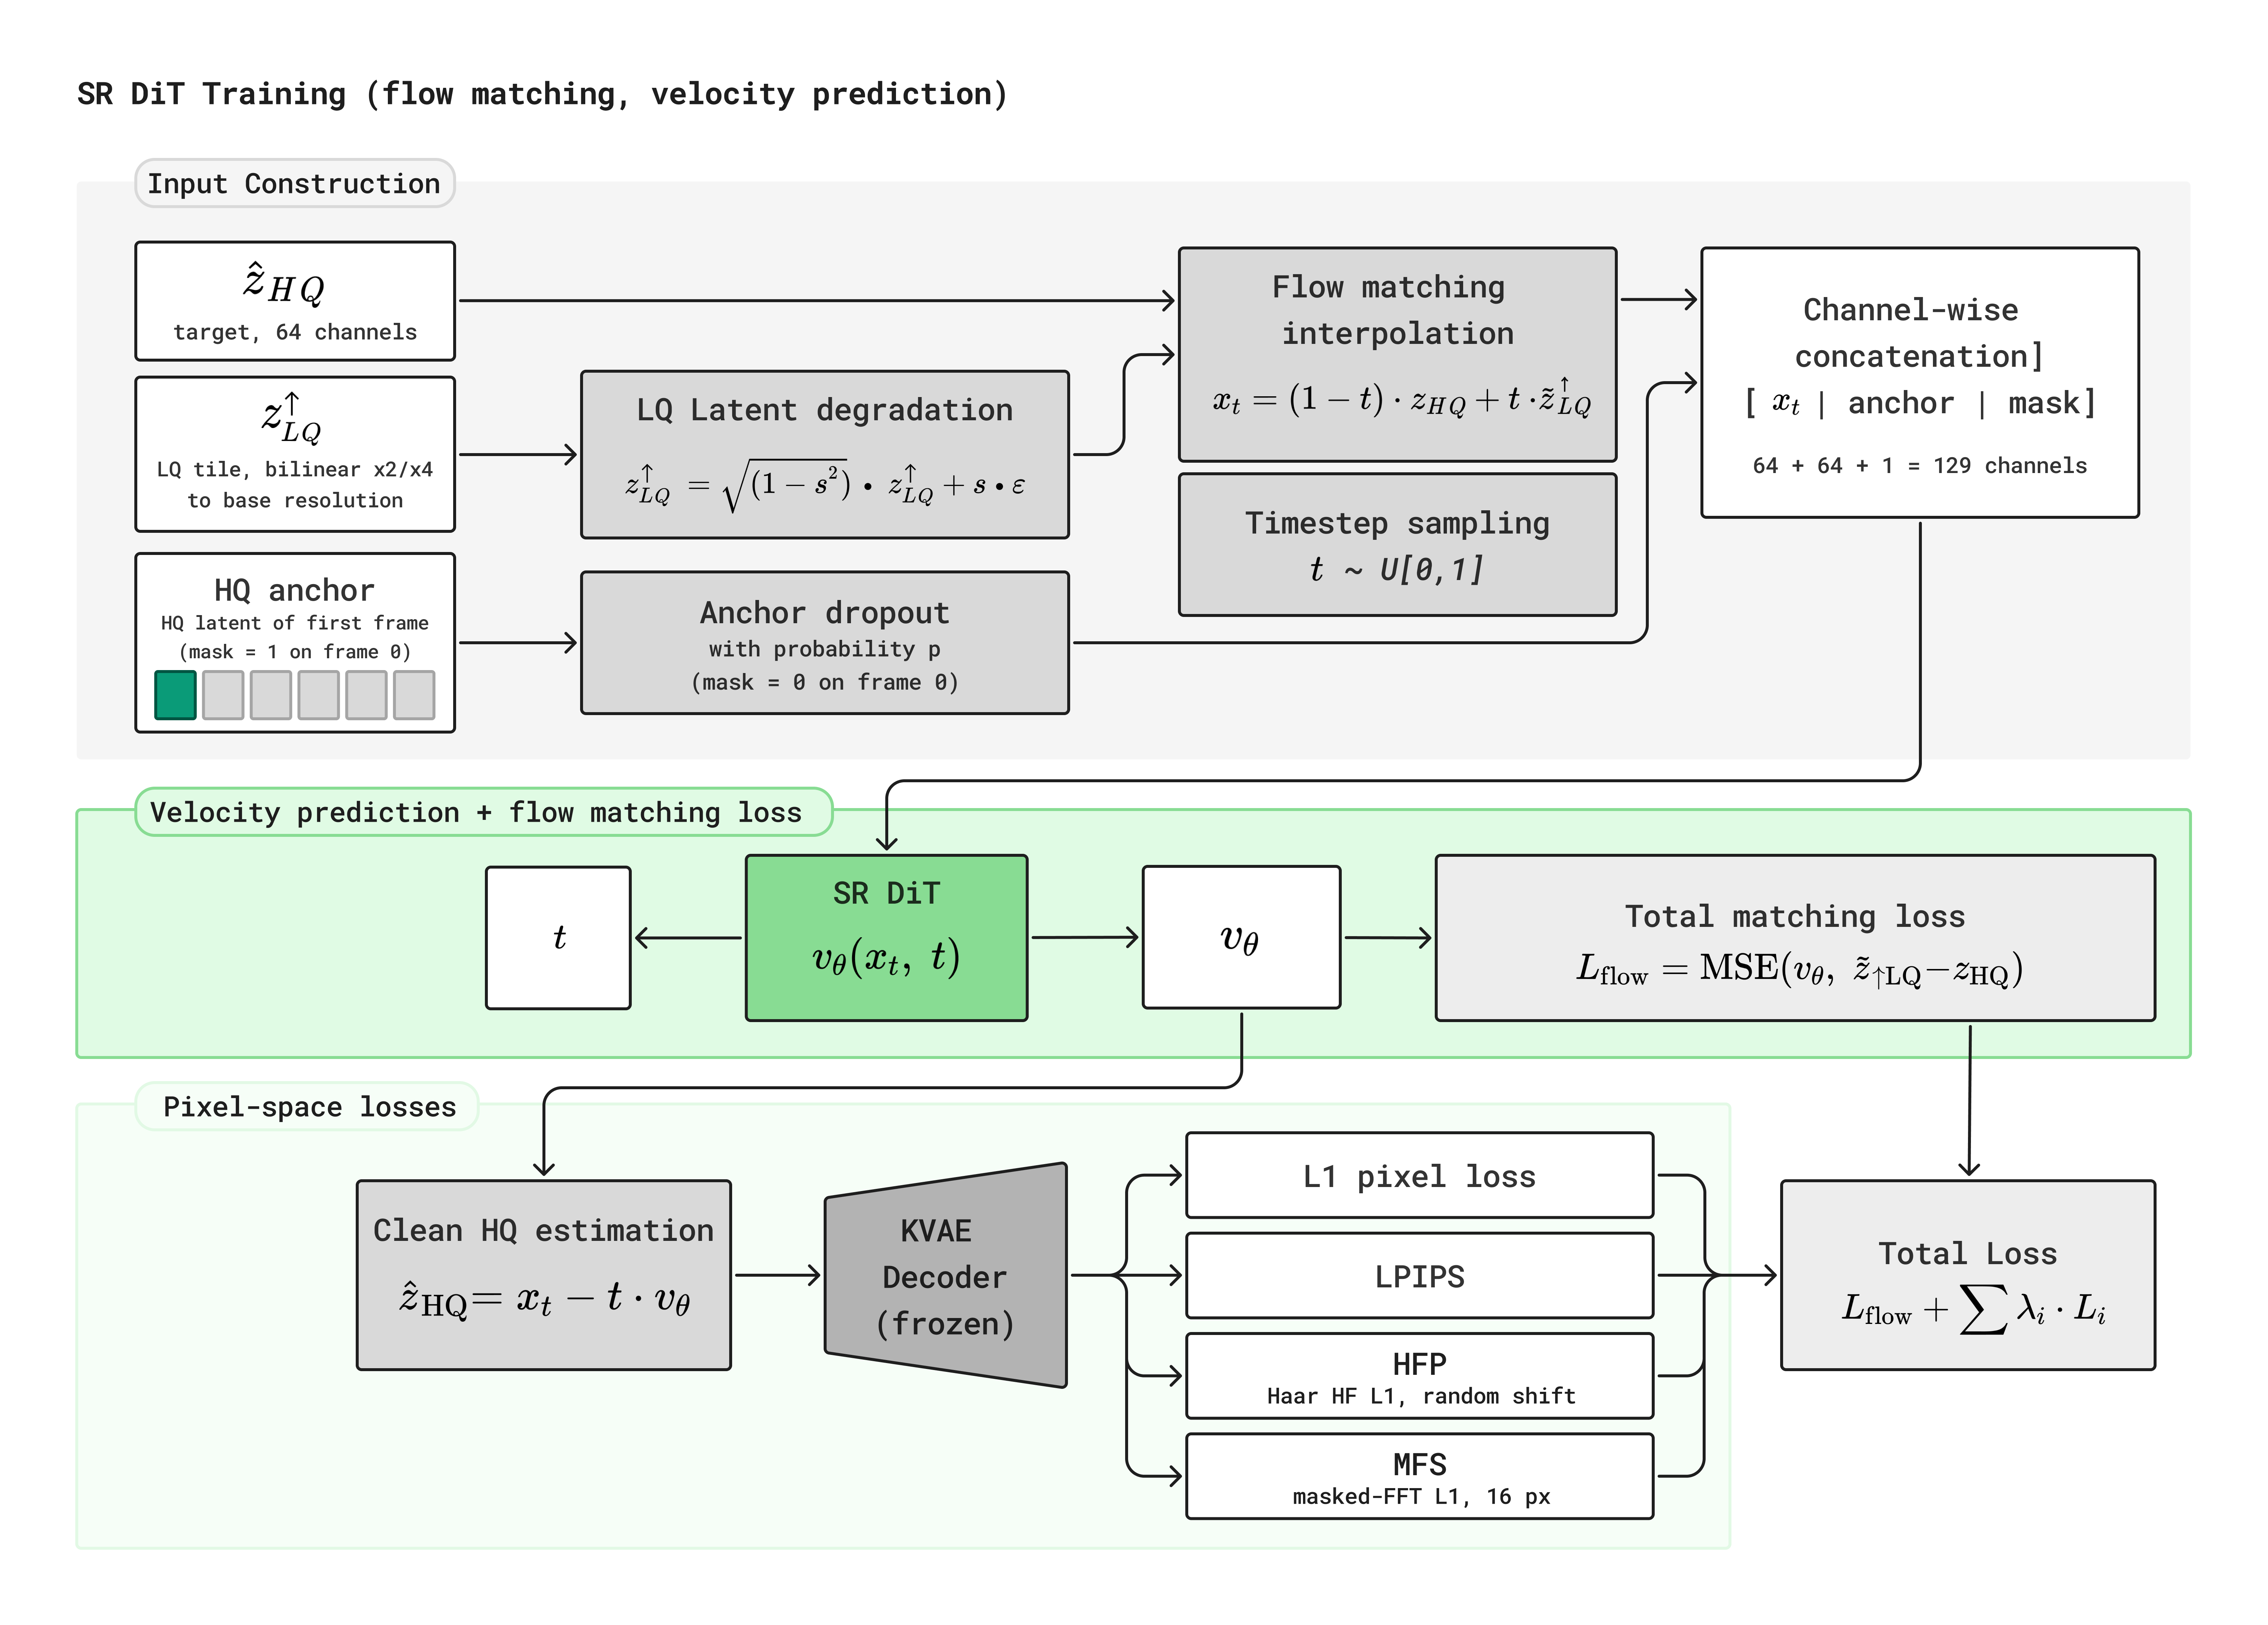
Обучение модели увеличения разрешения: цели в латентном и пиксельном пространствах.
Источник: Оригинальная иллюстрация · Kandinsky 6.0 VideoПроверка качества и временной устойчивости SR
Оценка SR не сводится к росту одной метрики; масштабы проверяют на разных кропах. У сгенерированного видео нет парного чистого HQ-эталона. MUSIQ/KonIQ-10k считают по кадрам, DOVER объединяет техническую ветвь по выбранным фрагментам и эстетическую по пространственно уменьшенному видео в нормированную оценку [0,1], CLIP-IQA даёт дополнительную оценку изображения.
Warp error измеряет остаток между соседними кадрами после компенсации движения RAFT на видимых, не перекрытых областях. Он зависит не только от временных ошибок, но и от детализации и точности потока; сглаживание может искусственно его улучшать.
Laplacian artifact score оценивает лишний высокочастотный отклик в гладких областях, исключая естественные края по Sobel исходного LQ. Он реагирует и на решётчатые артефакты, и на восстановленную детализацию. MUSIQ/DOVER тоже не исчерпывают специфические дефекты SR.
Два набора содержат по 912 кропов из 5-секундных генераций Kandinsky 5.0 Video Lite T2V SFT. Для ×4 исходный кроп 128×192, для ×2 — 256×384; оба доводят до 512×768. Это оценка отдельных фрагментов без сборки полного кадра и смешивания тайлов.
При ×4 MUSIQ и CLIP-IQA растут после следующих стадий, но warp error тоже растёт; Laplacian score сначала ухудшается, затем снижается после дистилляции. При ×2 последовательного улучшения MUSIQ нет. Абсолютные значения разных масштабов не изолируют качество модели, поскольку исходные области различны.
Таблицу можно прокрутить по горизонтали.
Финальный выбор SR-чекпойнта и оценка качества опираются на человеческое парное сравнение и тайлов, и целых кадров, а не на одну автоматическую оценку.
LU лучше прямой интерполяции латентов, но при ×2 не во всех группах лучше увеличения пикселей. На обучении латентную L1 проверяют каждые 2500 шагов, PSNR/SSIM/LPIPS с AlexNet — каждые 10 тыс., а в финальной полировке ×2 — каждые 5 тыс. Чекпойнт выбирают по PSNR декодированного предсказания относительно декодированной полноразмерной искажённой цели.
Отложенный тест содержит 94 не встречавшихся в обучении клипа: 25 Kandinsky со слабыми искажениями, 19 4K с weak Real-ESRGAN, 25 синтетических camera-motion и 25 4K с временными искажениями. Исходники доходят до 7680×4320, но оценка проводится на кропах 512×512, 512×768 или 768×512 с 89–121 кадрами, не на полных исходниках.
В отличие от SR-DiT-валидации, ×2 и ×4 здесь используют одни и те же клипы в том же порядке. Задача остаётся degraded-to-degraded, не восстановлением чистого видео.
База Table 5 сначала декодирует низкоразмерный латент, затем увеличивает видео bilinear в пикселях. ×4-LU выигрывает по среднему PSNR во всех четырёх группах; ×2 выигрывает на синтетическом движении и временной деградации, но проигрывает на обеих группах слабой видеодеградации.
Средний выигрыш LU ×2 в авторской записи — всего +0,11 дБ, а LU ×4 — +1,30 дБ. Отдельная более простая база — bilinear прямо в латентном пространстве — даёт лишь 21.44 дБ при ×2 и 19.76 дБ при ×4; это другой вариант сравнения.
Таблицу можно прокрутить по горизонтали.
Временные проверки LU обнаруживают умеренный рост остаточной ошибки, но не доказывают её единственную причину. На 94 клипах считают RAFT-small по всем соседним кадрам без пространственного уменьшения. Средний warp error LU равен 0.684/0.626 для ×2/×4, у пиксельного bilinear — 0.638/0.587.
Сглаживание и детализация влияют на этот остаток, а целевая искажённая версия сама может содержать временные дефекты. Поэтому такой тест не даёт чистого эталона временного восстановления.
Дополнительный набор — 24 реальных клипа без синтетических искажений: листва, мех, структуры и ткань с движением камеры или объектов. Обе ветви сравнивают на едином выходном холсте; для ×2 включают предварительное увеличение в пикселях.
База сначала кодирует и декодирует исходник тем же K-VAE, затем увеличивает его bilinear. При её среднем warp error около 0.591 LU добавляет 0.026 для ×2 и 0.049 для ×4, примерно 4.4% и 8.3%. Для структур разница ×4 лишь около 0.002; у ткани наибольший абсолютный остаток.
Авторы не приписывают всю временную ошибку исключительно VAE или LU. Числа показывают умеренное среднее увеличение остатка относительно конкретной round-trip-базы.
4.6.5 ValidationКак собирается Full HD и сколько стоит SR
Full HD собирается из перекрывающихся латентных тайлов, а не генерируется базовой моделью целиком. SD-выход базового генератора возвращают без изменений: 864×480, 480×864 или 512×512 в записи width×height. Для Full HD используют маршрут ×2.25: bilinear ×1.125 в пикселях с выравниванием на 16, затем LU/SR ×2. Например, 864×480 превращается сначала в 976×544.
Весь клип кодируют K-VAE один раз. Латент делят на пространственные тайлы с перекрытием не менее 25%; каждый тайл содержит полную временную длину. Рабочие SR-размеры height×width: 512×768, 768×512 или 512×512.
Для landscape рабочая латентная сетка 32×48; вход LU — 16×24 при ×2 либо 8×12 при ×4. Для квадрата это 32×32 на выходе и 16×16/8×8 на входе; для portrait размеры переставлены.
Увеличенный LQ частично зашумляют с s=0.7. Недистиллированный Stage 2 использует Euler, обычно 4–8 NFE; финальный Stage 3 — два вызова SR-DiT на тайл. Между ними DX-политика интегрируется через интерполяцию узлов без новых вызовов сети.
Оба SR-варианта не используют текст и CFG; HQ-опора и маска нулевые. Каждый тайл декодируют K-VAE, перекрытия смешивают нормированным окном Ханна; готовый кадр на CPU приводят к целевому размеру без обрезки.
На оригинальной схеме обработки тайлов показан итерационный цикл Euler, который соответствует варианту до DX-дистилляции. Финальная версия использует два вызова SR-DiT на каждый тайл; число тайлов зависит от разрешения кадра.
Скорость SR зависит от геометрии и количества тайлов; её замеры не равны времени всей генерации. В Table 6 перечислены семь маршрутов для HD, Full HD и 2K с исходным, промежуточным и финальным размером, числом тайлов и временем. Ниже приведены условия измерений.
Все замеры относятся к одному 5-секундному клипу из 121 кадра при 24 кадрах/с на одной H100: LU нужного масштаба, дистиллированный SR-DiT NFE=2, NABLA и декодирование K-VAE через Magi.
Время включает однократное кодирование K-VAE, но исключает финальное изменение размера. Тайлы обрабатываются последовательно, пакет тайлов равен одному. Базовый T2AV/I2AV-генератор в эти времена не входит.
Таблицу можно прокрутить по горизонтали.
Например, Full HD из 864×480 проходит через 1952×1088 к 1920×1080, требует 9 тайлов и 39.6 секунды; маршрут 2K из того же исходника при ×4 требует 30 тайлов и 130.8 секунды. Эти числа нельзя переносить на другой SR-бэкенд или потребительскую карту.
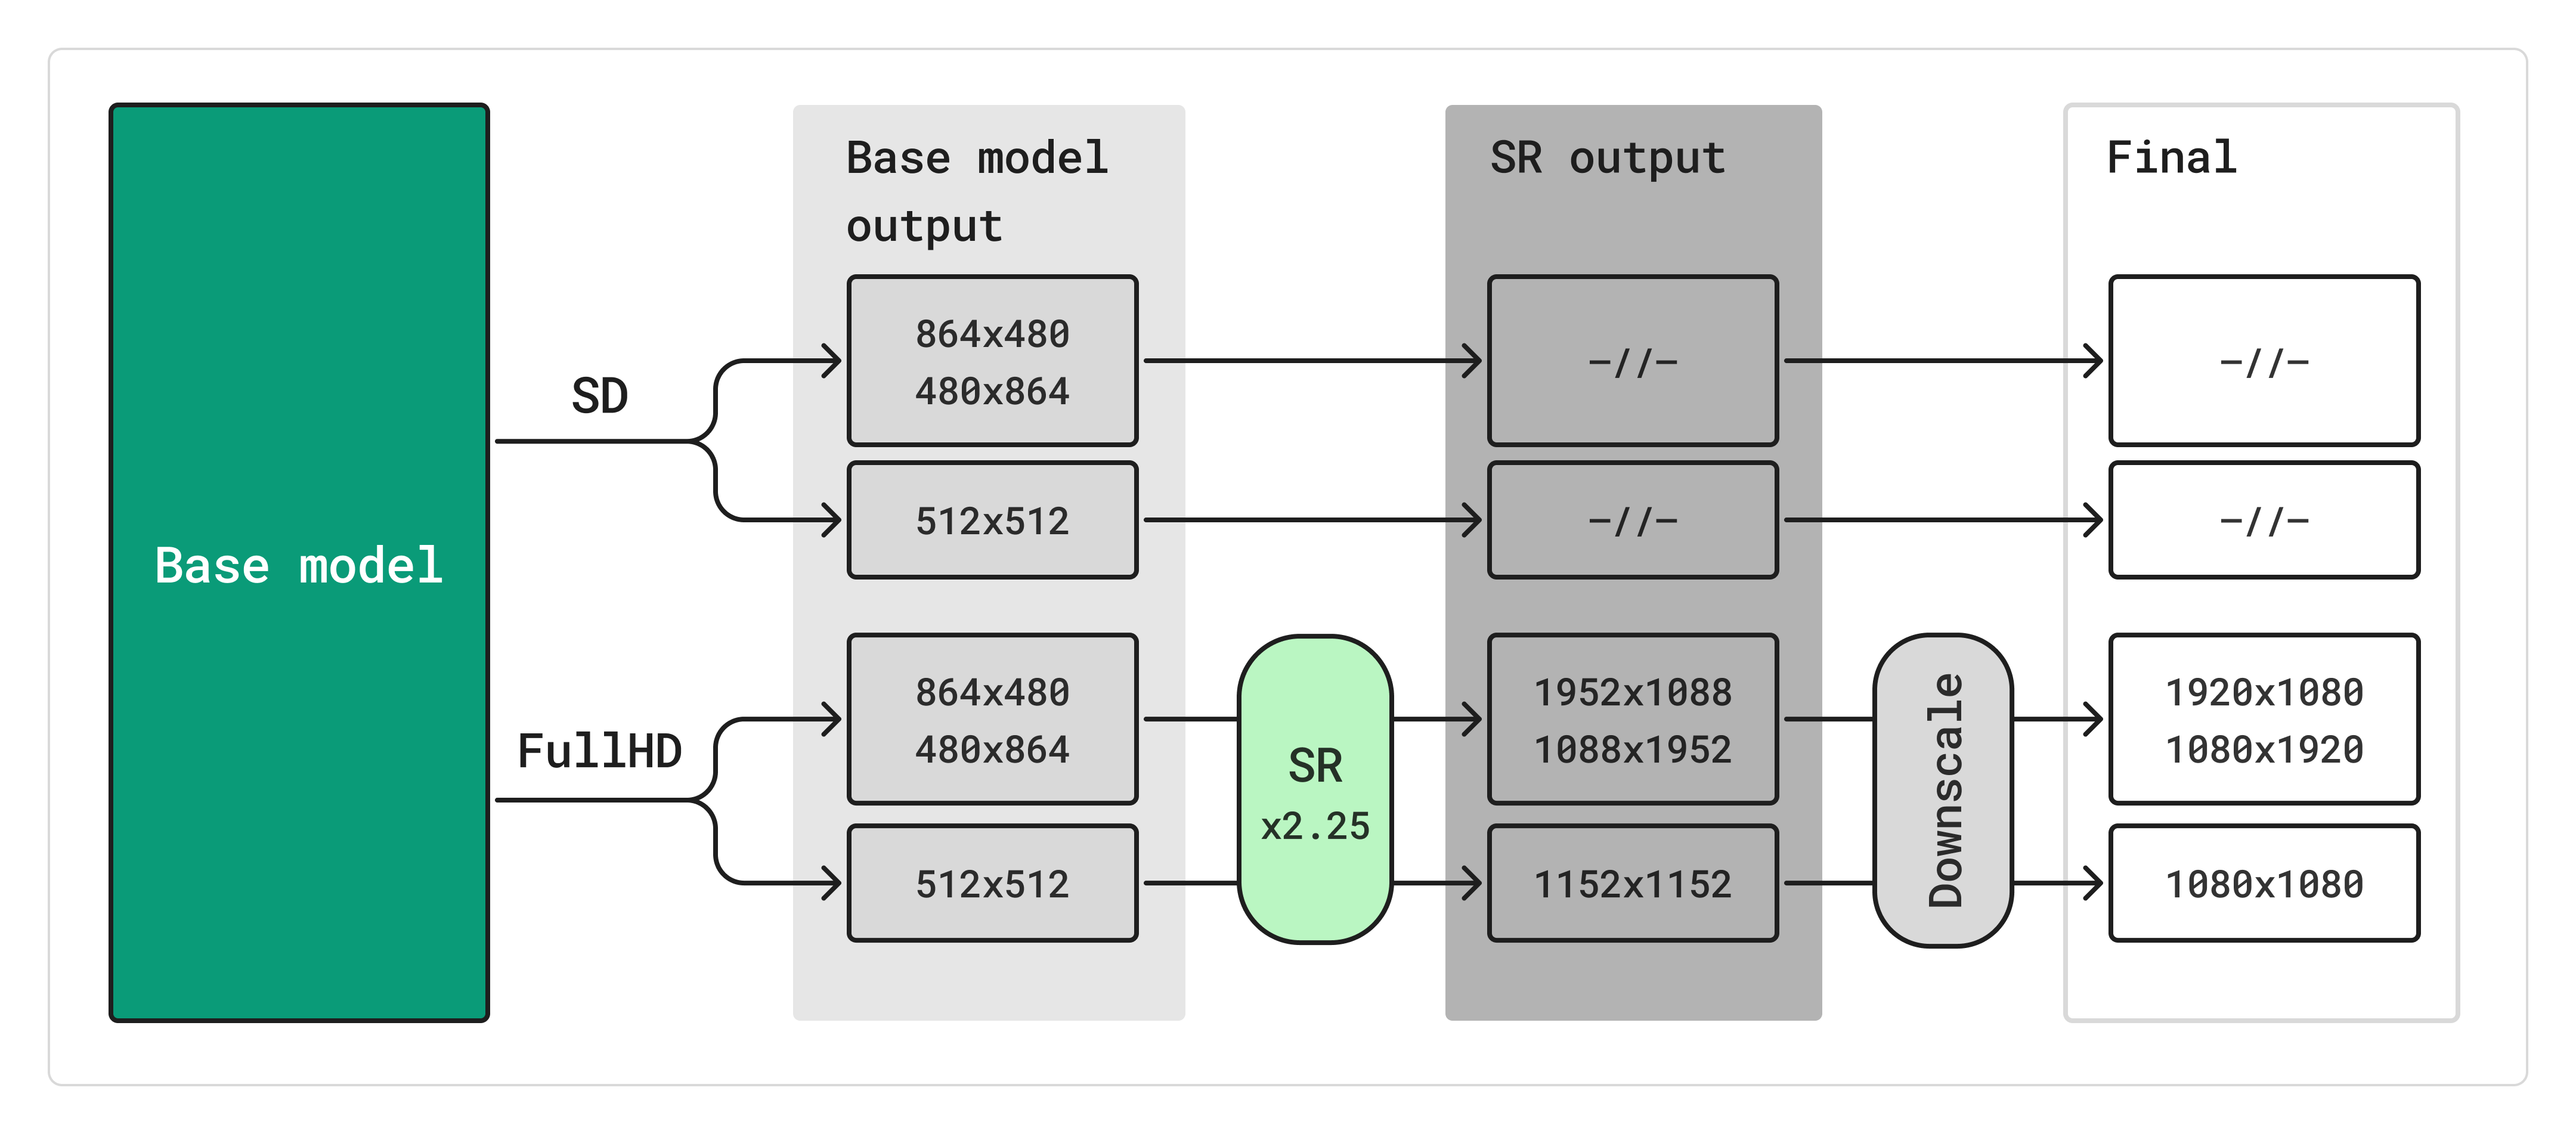
Разные исходные размеры проходят увеличение разрешения и приводятся к итоговому формату.
Источник: Оригинальная иллюстрация · Kandinsky 6.0 Video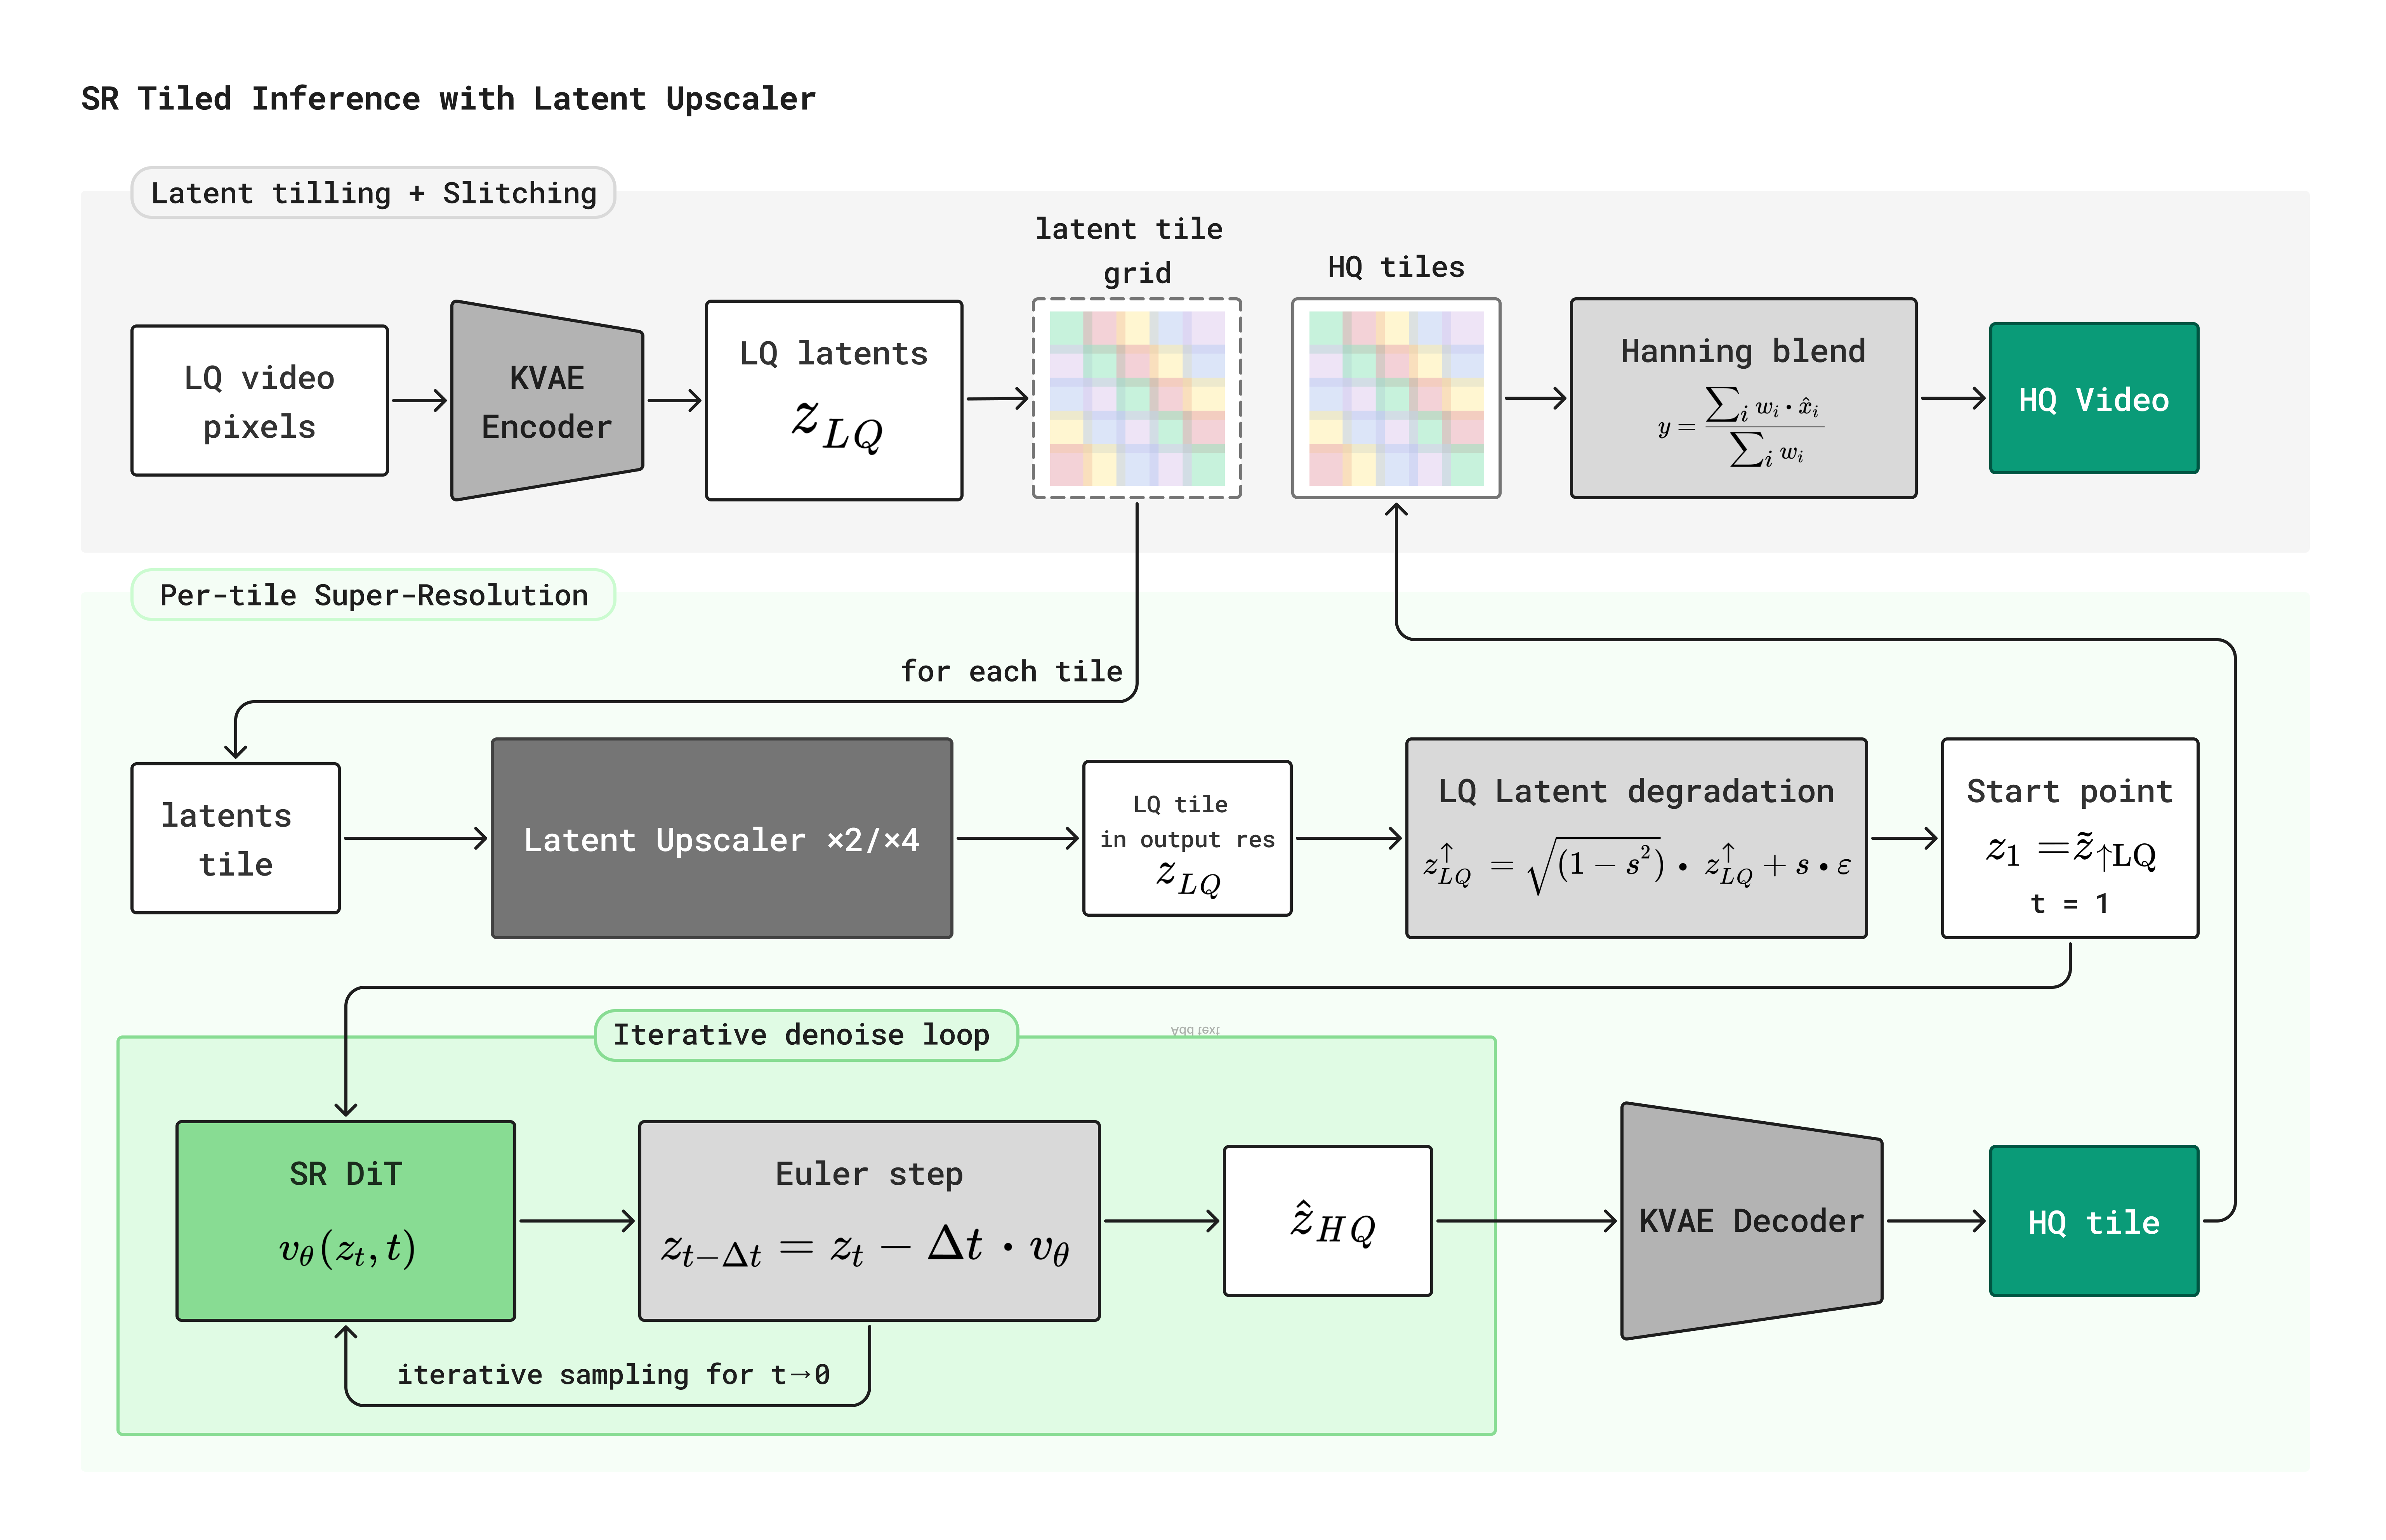
Увеличение разрешения с разбиением изображения на перекрывающиеся части.
Источник: Оригинальная иллюстрация · Kandinsky 6.0 VideoРазмещение весов и работа на ограниченной GPU-памяти
Выгрузка блоков уменьшает GPU-память без уменьшения самой модели, но имеет ограничения совместимости. На Pro SD полностью резидентный запуск достигает 72.8 GiB peak PyTorch allocated. При block offloading на GPU находятся только два трансформерных блока, остальные последовательно передаются из CPU-памяти; механизм одинаков для Lite и Pro.
Передача следующего блока по отдельному CUDA stream перекрывается с вычислением текущего. Эмбеддинги, RoPE и выходные проекции остаются на GPU на время DiT-стадии. Если MagCache пропускает шаг, веса пропускаемых блоков не передаются.
Снижение памяти зависит от режима: примерно 3.4 раза для Pro SD и 1.8 для Pro HD/Full HD; для Lite — около 2 и 1.1. Время на эталонной H100 меняется на несколько процентов. Table 7 относится к стандартному SR-декодированию, не к наиболее экономным пресетам.
Режим предназначен только для инференса. Он несовместим с CUDA graphs, компиляцией всей модели и внешне экспортированными весами, включая Magi SR backend. Авторы указывают PyTorch 2.13 как требование; с 2.10 compiled forward при offloading ломается. Это сведения отчёта, не внешняя проверка версий.
Для базовой модели заявлено совпадение с резидентным вариантом до численной погрешности типа данных: видео в SD, кадры и звук в HD/Full HD. Это не утверждение о побитовом совпадении всего SR-выхода.
Пресеты 16–32 GB ограничивают и декодирование, и текстовый энкодер; достаточной VRAM без RAM недостаточно. Пресеты 32 и 24 GB одинаковы: выгрузка блоков и SR decode segment length 4 frames; дополнительный запас до 32 GB сам по себе скорости не добавляет.
Пресет 16 GB дополнительно делит SR-декодирование на две пространственные полосы, квантует текстовый энкодер в NF4 и освобождает его после кодирования текста.
По Table 9 пиковая allocated-память одинакова для Lite и Pro при данном пресете, поскольку резидентны два блока. Пик определяется также исходной геометрией: HD может занимать меньше памяти, чем SD и Full HD.
Таблицу можно прокрутить по горизонтали.
На реальной 16-GB-карте процесс занимает 15.1 GiB из 15.6 GiB свободных, что не равно только показателю allocated в таблице. Для Pro на этом пресете RSS процесса около 58 GiB.
Оперативная память должна вмещать все веса и их pinned-копии. При вытеснении на диск передача блоков становится ограничена диском и резко замедляется. Уменьшение сегмента декодирования ниже четырёх кадров дальше не помогает: ограничение уже пространственное.
6 Optimizations and Consumer GPU DeploymentУскорение и аппаратные измерения
Ускорение сочетает частичную компиляцию, пропуск шагов и разные реализации внимания. Блоки базового DiT компилируют отдельно через torch.compile; не всю модель. Компиляция включена в Pro-конфигурации, с исключением отдельного замера RTX PRO 6000 в таблице времени.
MagCache пропускает часть шагов по величине обновления. На Pro SD выполняет 49 из 100 прямых проходов и примерно вдвое сокращает базовую стадию; пропуск вычислений взаимодействует с пропуском передачи весов.
На H100 для визуального самовнимания используют FlashAttention 3. На перечисленных RTX 4090/5060 Ti/5080/5090, RTX PRO 6000 и A100 — SageAttention2++; текстовые блоки и перекрёстное внимание используют FlashAttention 2. Для этих замеров авторы объясняют выбор ограничениями поддержки FlashAttention 3.
SR сохраняет собственное внимание из чекпойнта, включая NABLA, и не переключается вместе с базовым генератором. Региональная компиляция декодера SR VAE примерно вдвое сокращает SR-стадию; её отключение снижает измеренный пик памяти с 22,9 до 20,3 GiB.
Нельзя объединять эту конфигурацию с Magi-замерами Table 6 в один идентичный стек: у них разные условия, а block offloading прямо ограничивает совместимость с Magi SR backend.
Для оценки времени авторы проверили семь GPU в шести вариантах Lite/Pro с выходами SD, HD и Full HD. Каждый замер — генерация пятисекундного ролика после прогрева, без загрузки весов и кодирования MP4, с полной недистиллированной базовой моделью. Сравниваются конкретные аппаратно-программные конфигурации, а не изолированная производительность кристаллов.
Таблицу можно прокрутить по горизонтали.
RTX PRO 6000 96 GB, A100 80 GB и H100 80 GB используют module offloading; потребительские карты — block offloading с пресетами 32 GB для 5090, 24 GB для 4090 и 16 GB для 5080/5060 Ti.
Все Pro-строки включают MagCache, региональная компиляция включена кроме RTX PRO 6000. На H100 работает FlashAttention 3, на остальных — SageAttention2++; различаются также CPU–GPU-шины. Поэтому таблица сравнивает аппаратно-программные конфигурации, а не только мощность карт.
Здесь HD иногда генерируется быстрее SD: у него другая исходная геометрия, поэтому разрешение конечного файла само по себе не определяет стоимость. Например, это видно и по H100, и по RTX 5090. Таблица отражает целую конфигурацию GPU, памяти, внимания и компиляции, поэтому относительный порядок карт не следует превращать в рейтинг вычислительной мощности.
На RTX 5090 базовые стадии SD и Full HD с общей геометрией отличаются менее чем на 0.5%. SR-стадия определяется разрешением, а не размером Lite/Pro: около 64 секунд для HD и 96 для Full HD.
Из этих замеров нельзя получить фактическое полное ускорение 10-NFE-генератора: время дистиллированной базы в данной таблице не измерено.
Экономия памяти в SR и квантизация текста имеют разные последствия для результата. Изменение сегментов SR-декодирования, пространственных полос и offloading даёт различия уровня округления: примерно 12% пикселей отличаются на одну единицу яркости, PSNR около 57 дБ; авторы не наблюдают структуры или швов на границах.
Побитовое совпадение SR между режимами offloading не установлено; отключение компиляции декодера не убирает различие. Это отдельная оговорка от заявленного совпадения базового генератора.
NF4 текстового энкодера — единственная настройка пресета, которая меняет само содержание клипа: другое представление промпта приводит к другому видео. Она включена только в 16-GB-пресете.
Обработка того же текста на CPU с полными весами занимает около 10 секунд и воспроизводит выход 32-GB-режима. Квантизация визуального внимания в SageAttention2++ — другой механизм, не привязанный к NF4-пресету.
Table 10 измеряет недистиллированную базовую модель. Показатели 10 NFE для дистиллированного генератора и 2 NFE для SR на тайл относятся к другим режимам и не могут использоваться для пересчёта этих замеров.
6.3 Inference AccelerationАвтоматические оценки видео, аудио и синхронизации
VABench разделяет свойства видео, звука и синхронизации; универсального победителя по всем метрикам нет. Сравниваются финальные после-RL Lite и Pro при 512×768 с LTX 2.5 в двухстадийной Full HD-конфигурации. Это разные разрешения и режимы обработки; результаты не следует представлять как изолированный эффект архитектуры при одинаковом вычислительном бюджете.
В этом сравнении Pro получила лучшие оценки качества речи, эстетики звука, согласования текста с видео и звука с видеорядом, синхронизации губ и визуальной реалистичности. Рассинхронизация у неё оказалась самой низкой. Lite лидирует по согласованию текста со звуком, реалистичности аудио и оценкам качества аудио и видео. Точные названия метрик и значения приведены в таблице.
LTX 2.5 лучше по оценкам следования запросу и выразительности, которые выставляет модель, работающая с изображениями и текстом. В отдельной проверке распознавания сгенерированной речи у неё также ниже доля ошибок — WER. Поэтому улучшение большинства показателей не означает превосходства по каждому критерию.
WER не входит в VABench: на речевом поднаборе аудио распознаёт Qwen3-ASR-1.7B, пунктуацию удаляют и из результата, и из эталона; далее используют jiwer. Здесь WER LTX/Lite/Pro равна 0.099/0.103/0.117 и не сопоставима напрямую с Whisper-WER из раздела RL.
В таблице большее значение лучше для всех метрик, кроме desync и WER. На лепестковой диаграмме эти две оси инвертированы и все значения нормированы, поэтому расстояния до центра нельзя читать как проценты правильных ответов или переносить между разными метриками.
Таблицу можно прокрутить по горизонтали.
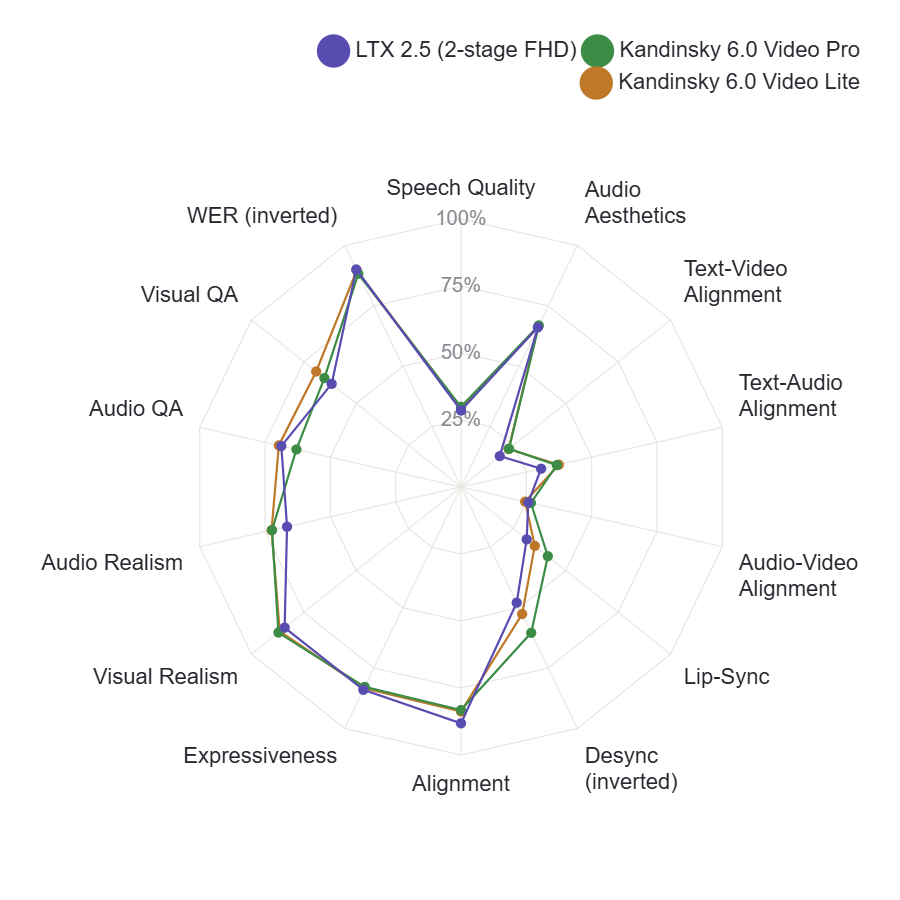
Сравнение качества по нескольким критериям. На осях объединены разные метрики; их нельзя читать как одну общую долю правильности.
Источник: Оригинальная иллюстрация · Kandinsky 6.0 VideoКак проводили парные человеческие сравнения
Человеческая оценка отделяет визуальные вопросы без звука от звука и общей полезности результата. В side-by-side-сравнении два анонимизированных ролика по одному промпту показывают рядом, случайно меняют левую/правую сторону и порядок заданий. Проверяющий может повторять, останавливать, перематывать и увеличивать видео.
Сначала звук отключён. Пять вопросов: общее визуальное качество без учёта промпта; артефакты и непреднамеренные смысловые разрывы; реалистичность движения и физики; следование визуальному промпту; заданное движение камеры.
Затем звук включают: качество речи; синхронизация событий и звуков; общее качество аудио без оценки соответствия запросу; следование звуковому промпту; решение пользовательской задачи целиком. В I2V/I2AV добавляют сохранение исходного изображения.
Визуальное следование запросу учитывает число и свойства объектов, их положение, действия и текст. Качество речи включает разборчивость, естественность и фактическое пение, если оно запрошено; губы и мимику оценивают при видимом говорящем. Ошибки синхронизации или изменения изображения, прямо заданные промптом, не штрафуются.
Ответы предусматривают симметричную ничью и, где нужно, N/A. При отсутствии запроса движения камеры этот вопрос неприменим; при отсутствии речи может быть неприменима речевая оценка. Итог агрегируется большинством голосов; на критерий собирают примерно 200 или больше парных сравнений.
В этих сравнениях высокая доля ничьих означает, что оценщики часто не видели убедительного различия. Поэтому вывод делают по каждому применимому критерию, а не по одной сумме цветных столбцов.
Относительно Kandinsky 5.0 проверяли именно визуальное улучшение, исключив звук из оценки. Pro 6.0 сравнивают с Pro 5.0 в T2V и I2V — режимах, которые поддерживает предшественник. Звук у новой модели генерируется, но игнорируется оценщиками.
При генерации по тексту Pro 6.0 чаще выигрывает по общей визуальной привлекательности, артефактам, движению и следованию запросу; по движению камеры преимуществ меньше. На графике общего визуального качества 58% предпочтений отданы новой модели, 16% — Kandinsky 5.0, ещё 26% — ничья.
При генерации с исходным изображением сохраняется преимущество по общей визуальной оценке: 64% предпочтений у Pro 6.0, 11% у Pro 5.0 и 25% ничьих; отдельно улучшается визуальное соответствие референсу. Авторы характеризуют улучшения общей визуальной оценки и следования запросу как крупные, реалистичности движения — как умеренные.
Это не сравнение качества аудио двух поколений и не количественная оценка вклада одного конкретного этапа обучения.
С Kling и LTX сильные стороны распределены по разным критериям. Kling 2.6: в T2AV и I2AV визуальная эстетика предпочтительнее у Kling; артефакты и реалистичность движения близки. Визуальное следование запросу почти равно в T2AV и немного лучше у Kling в I2AV; звуковое следование запросу явно лучше у Kandinsky в обоих режимах.
Общее качество звука и синхронизация умеренно лучше у Kling, качество речи и решение задачи близки. В I2AV движение камеры лучше у Kandinsky. Общего превосходства над Kling текст не заявляет.
LTX 2.5: Kandinsky предпочтительнее по общему визуальному качеству, артефактам, движению, визуальному следованию запросу и решению задачи. Для общего визуального качества и решения задачи авторы указывают статистическую значимость.
Качество речи также значимо лучше у Kandinsky. Синхронизация, общая аудиооценка и звуковое следование запросу слегка лучше у LTX, но эти три различия незначимы. Движение камеры близко к равенству и информативно лишь для небольшой части запросов, поскольку большинство не задаёт движение.
С Veo 3.1 Fast чистота изображения и сохранение референса противопоставлены следованию запросу и аудио. В T2AV Kandinsky значимо лучше по артефактам и движению камеры. Реалистичность движения слегка лучше, но преобладают ничьи. Общее визуальное качество близко с небольшим преимуществом Veo.
Veo в T2AV лидирует по визуальному следованию запросу, речи, синхронизации, общей аудиооценке, звуковому следованию запросу и решению задачи; значимость заявлена для всех перечисленных преимуществ, кроме качества речи.
В I2AV Kandinsky значимо предпочтительнее по общему визуальному качеству, сохранению исходного изображения, артефактам и движению камеры.
Veo в I2AV значимо лучше по визуальному следованию запросу, синхронизации, общему аудио, звуковому следованию запросу и решению задачи. Движение объектов и качество речи близки к равенству.
Вывод авторов — разделение преимуществ, не общий выигрыш одной модели. Сравнивается именно Veo 3.1 Fast, а не любая версия семейства Veo.
MiniMax H3 и Seedance 2.0 сохраняют сильное визуальное преимущество; речь и синхронизация дают другую картину. MiniMax H3 предпочтительнее в обоих режимах по большинству критериев, со значимыми преимуществами общего визуального качества, артефактов, физики движения, визуального следования запросу, общего аудио, звукового следования запросу и решения задачи.
Kandinsky остаётся близок к H3 по речи, движению камеры и синхронизации: много ничьих и нет значимого различия. В I2AV особенно отмечена близость речи и синхронизации, применимых лишь к части запросов. Авторы прямо называют H3 более сильной моделью на этой проверке.
Seedance 2.0 в T2AV значимо лучше по общей визуальной оценке, артефактам, движению и визуальному следованию запросу. Синхронизация близка, с большим числом ничьих и без значимого различия; речь предпочтительнее у Kandinsky, звуковое следование запросу близко.
В I2AV Seedance лучше по общей визуальной оценке, сохранению изображения, артефактам и визуальному следованию запросу. Движение и синхронизация близки; речь вновь предпочтительнее у Kandinsky, звуковое следование запросу конкурентоспособно.
Преимущество речи не следует распространять на все свойства аудио.
Зелёный цвет означает предпочтение Kandinsky 6.0 Pro, синий — конкурента, серый — ничью. Доли на графиках относятся к отдельным критериям, а не к доле успешных генераций. С Kandinsky 5.0 сравнивают только изображение, поскольку звуковые возможности поколений не одинаковы.
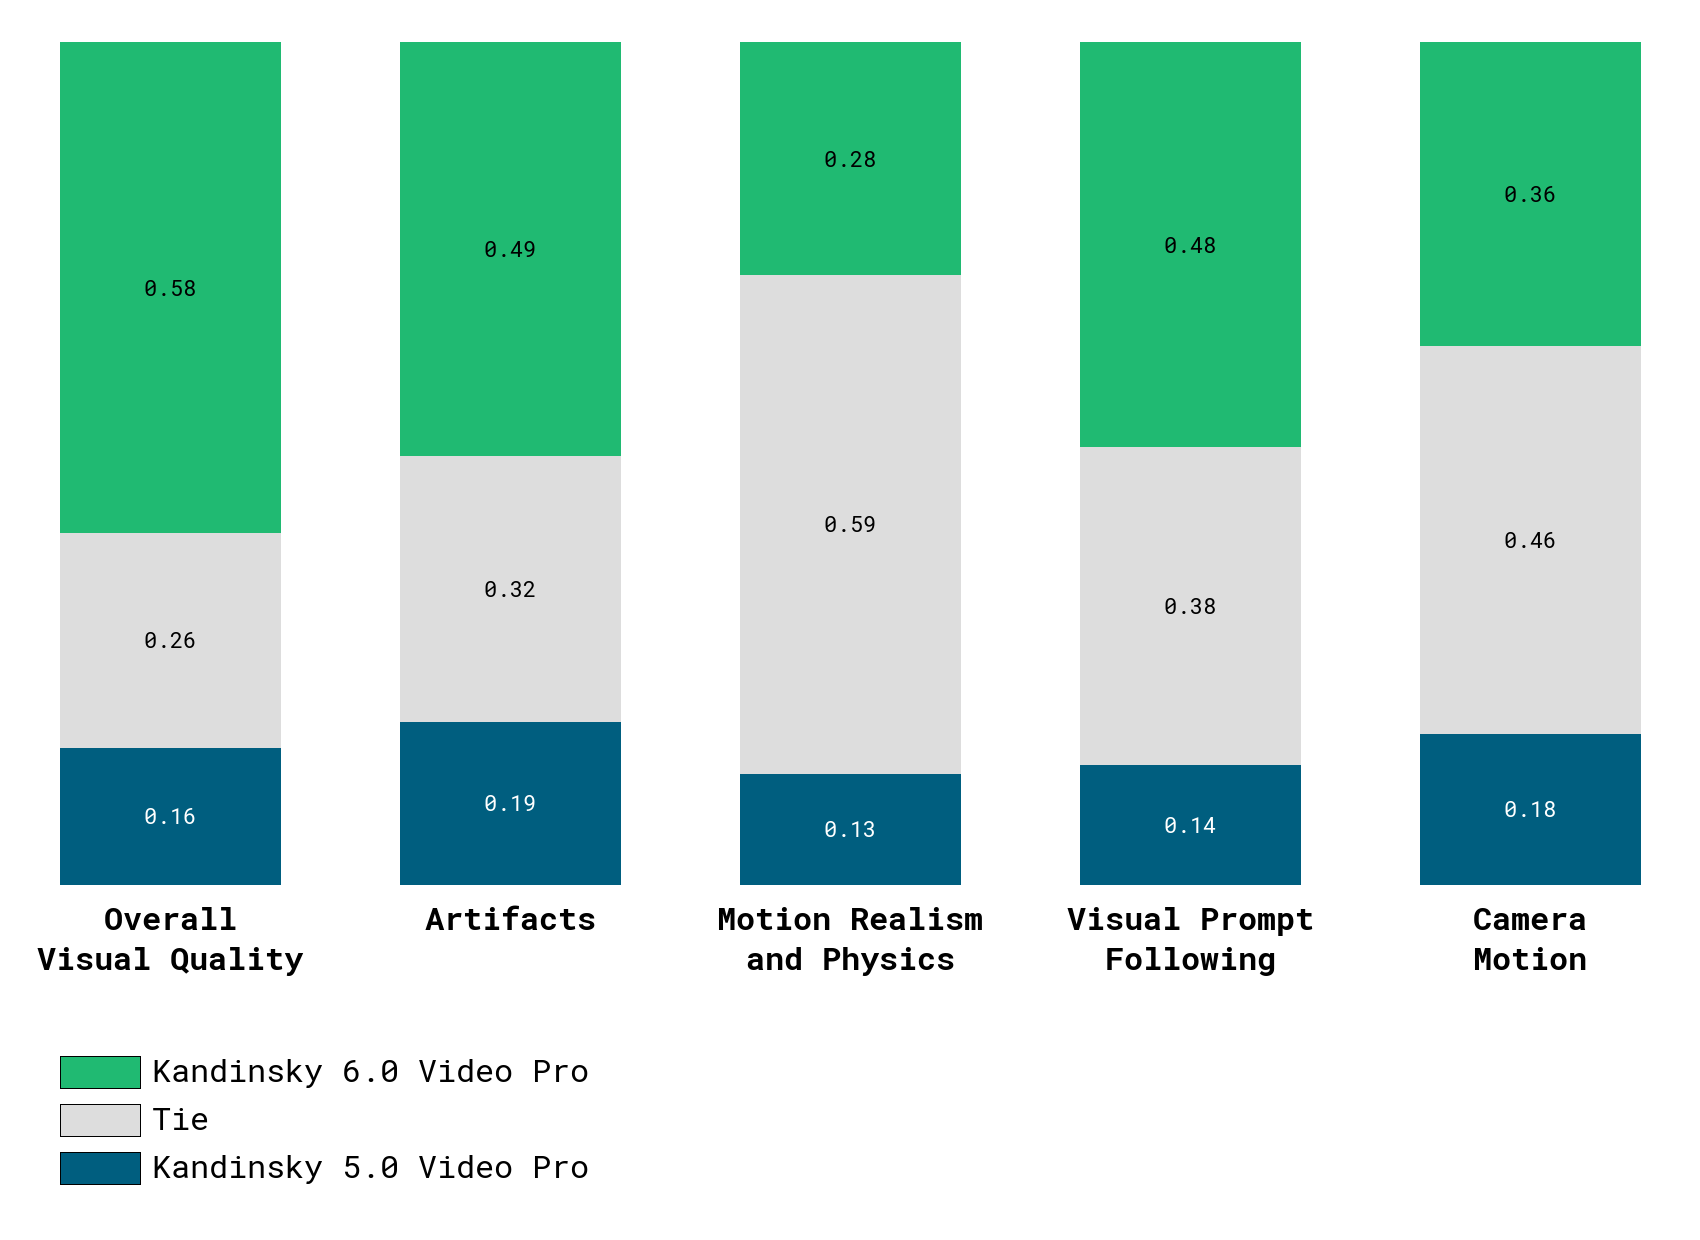
Парное сравнение визуального качества Kandinsky 6.0 Pro и Kandinsky 5.0 Pro для генерации по тексту.
Источник: Оригинальная иллюстрация · Kandinsky 6.0 Video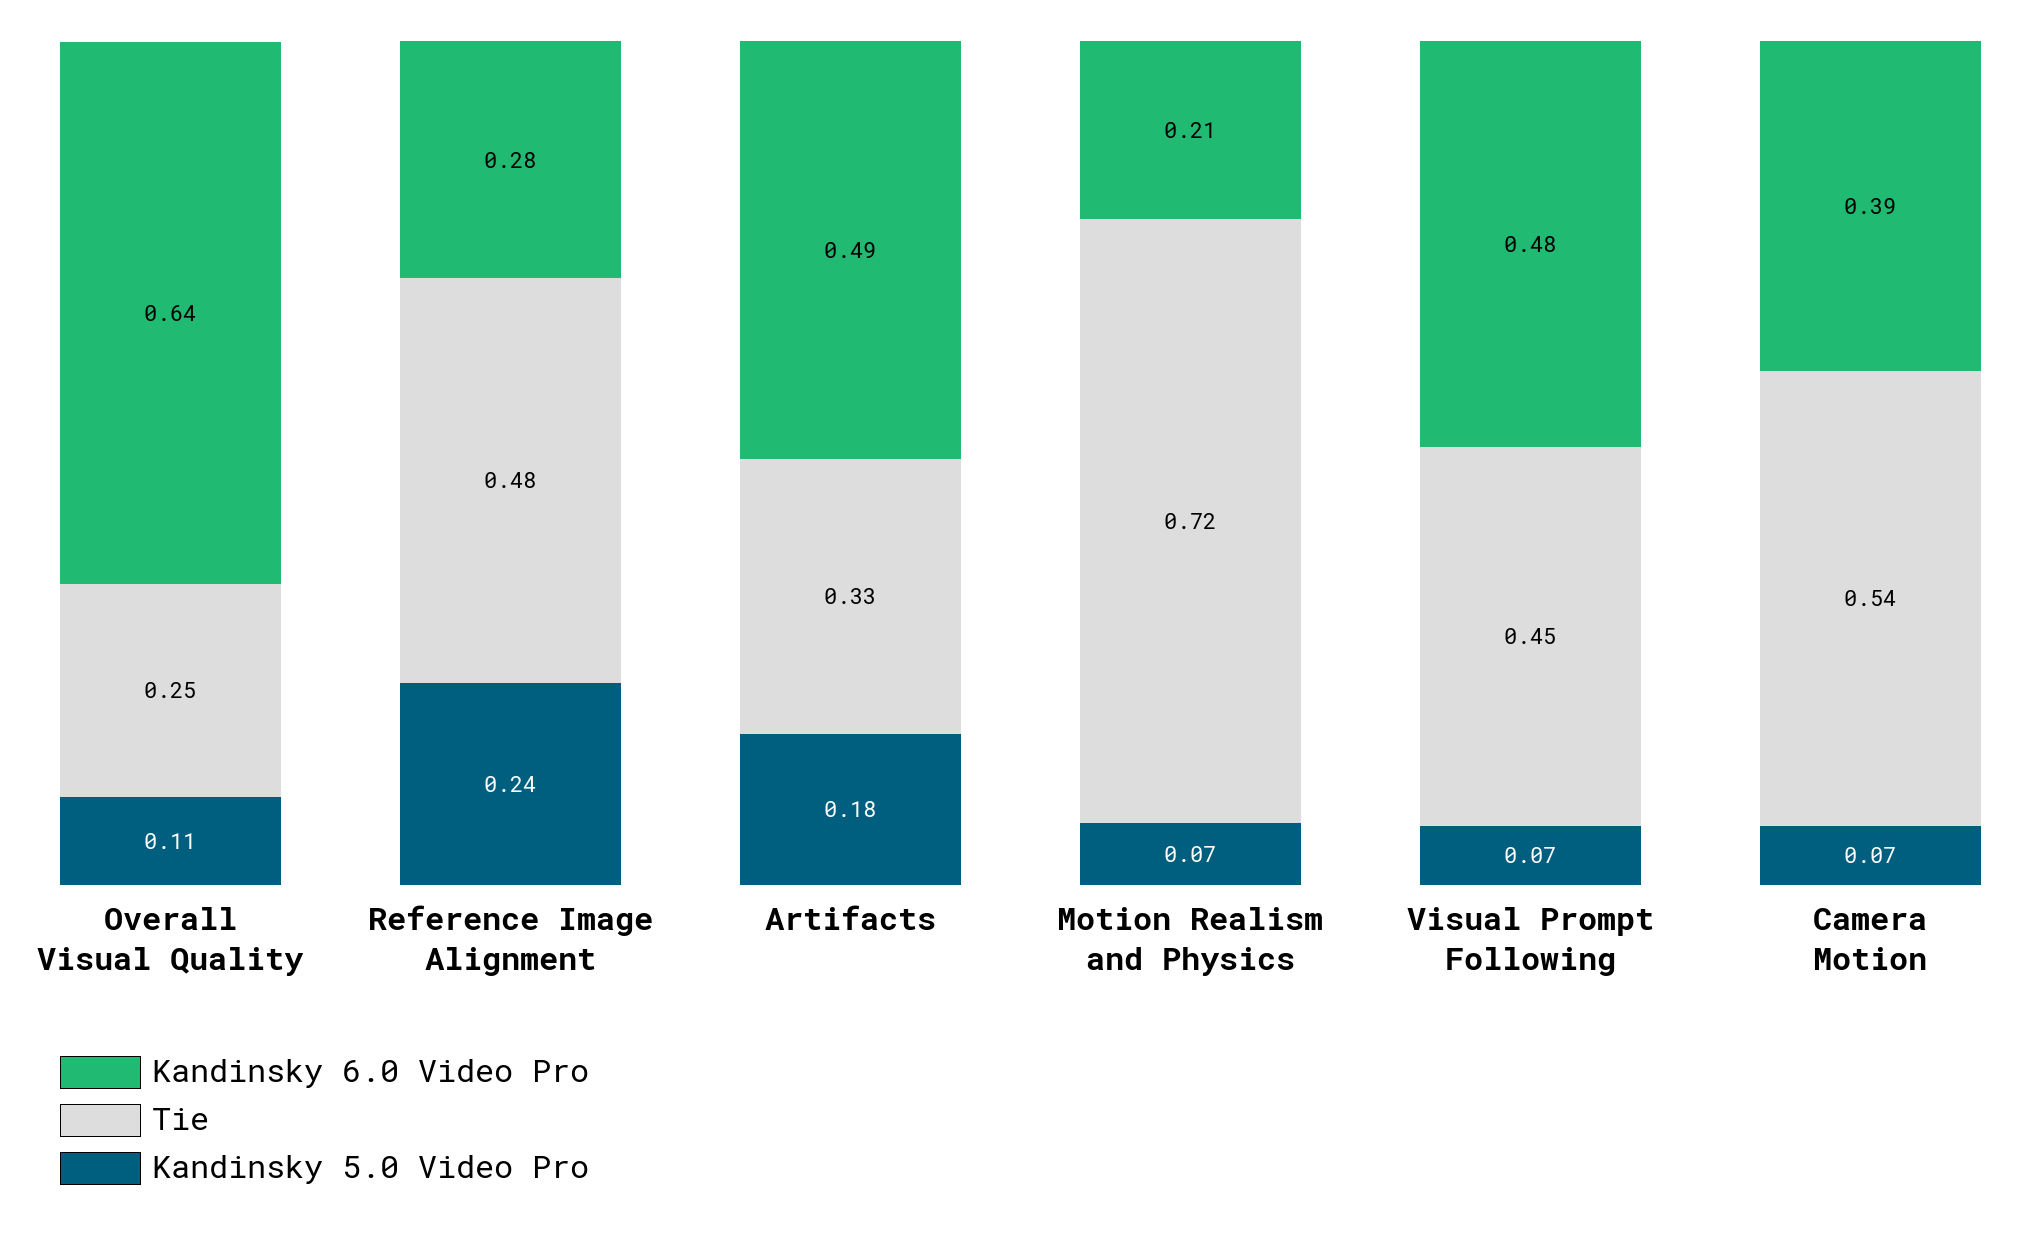
Парное сравнение тех же моделей при условии исходного изображения.
Источник: Оригинальная иллюстрация · Kandinsky 6.0 Video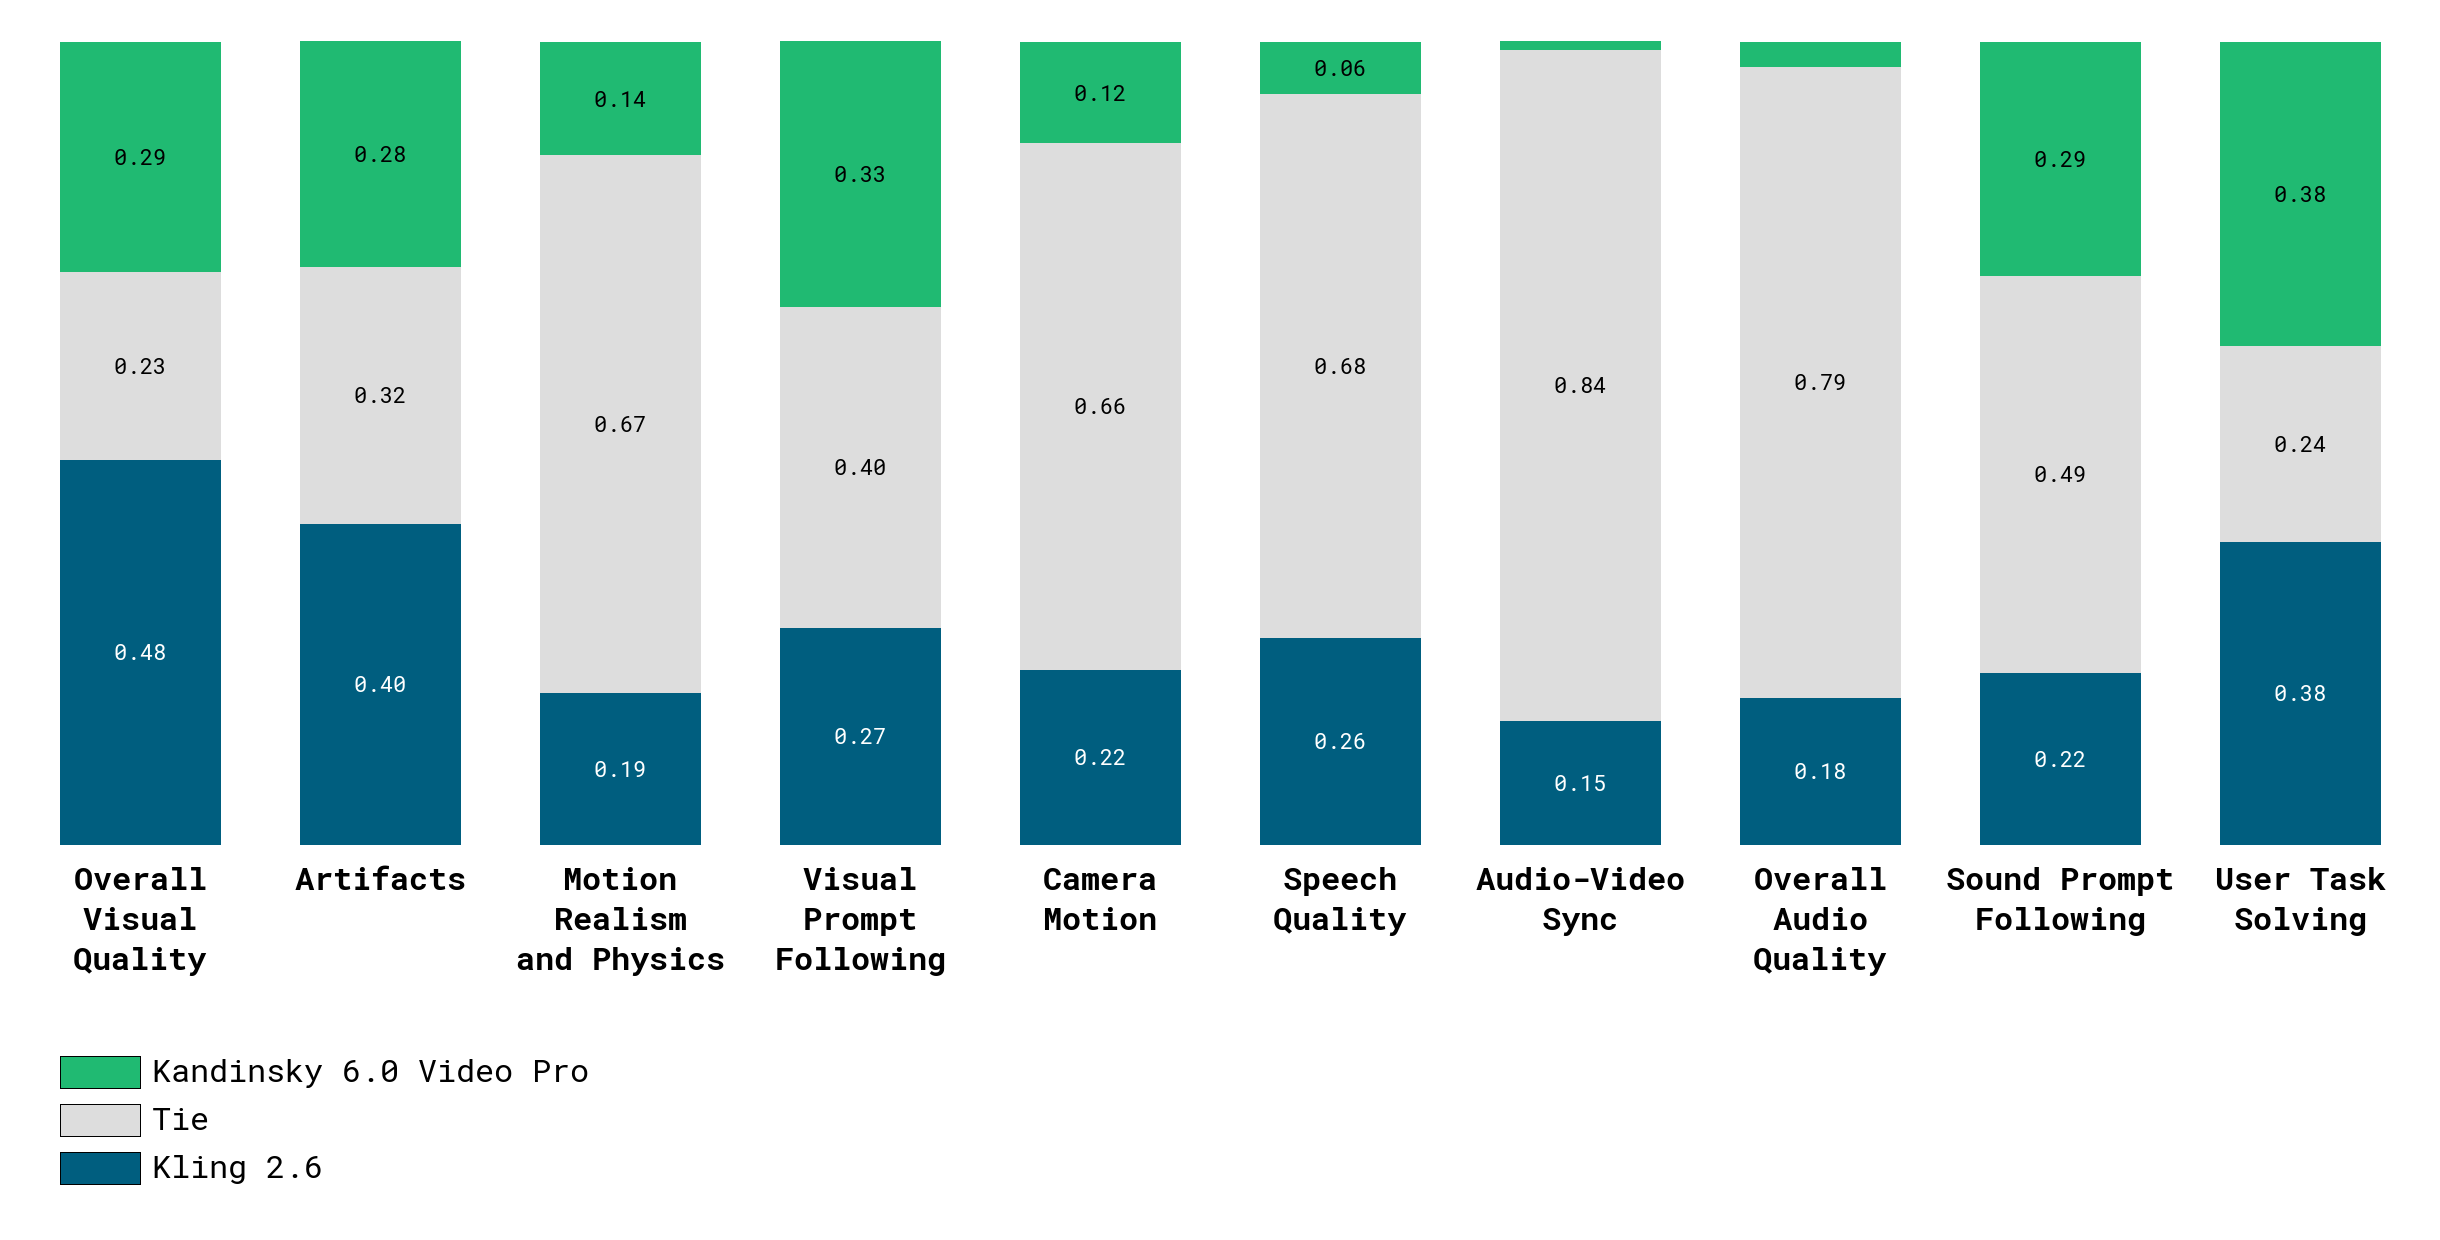
Парное сравнение с Kling 2.6: отдельно показаны победы, ничьи и проигрыши по критериям.
Источник: Оригинальная иллюстрация · Kandinsky 6.0 Video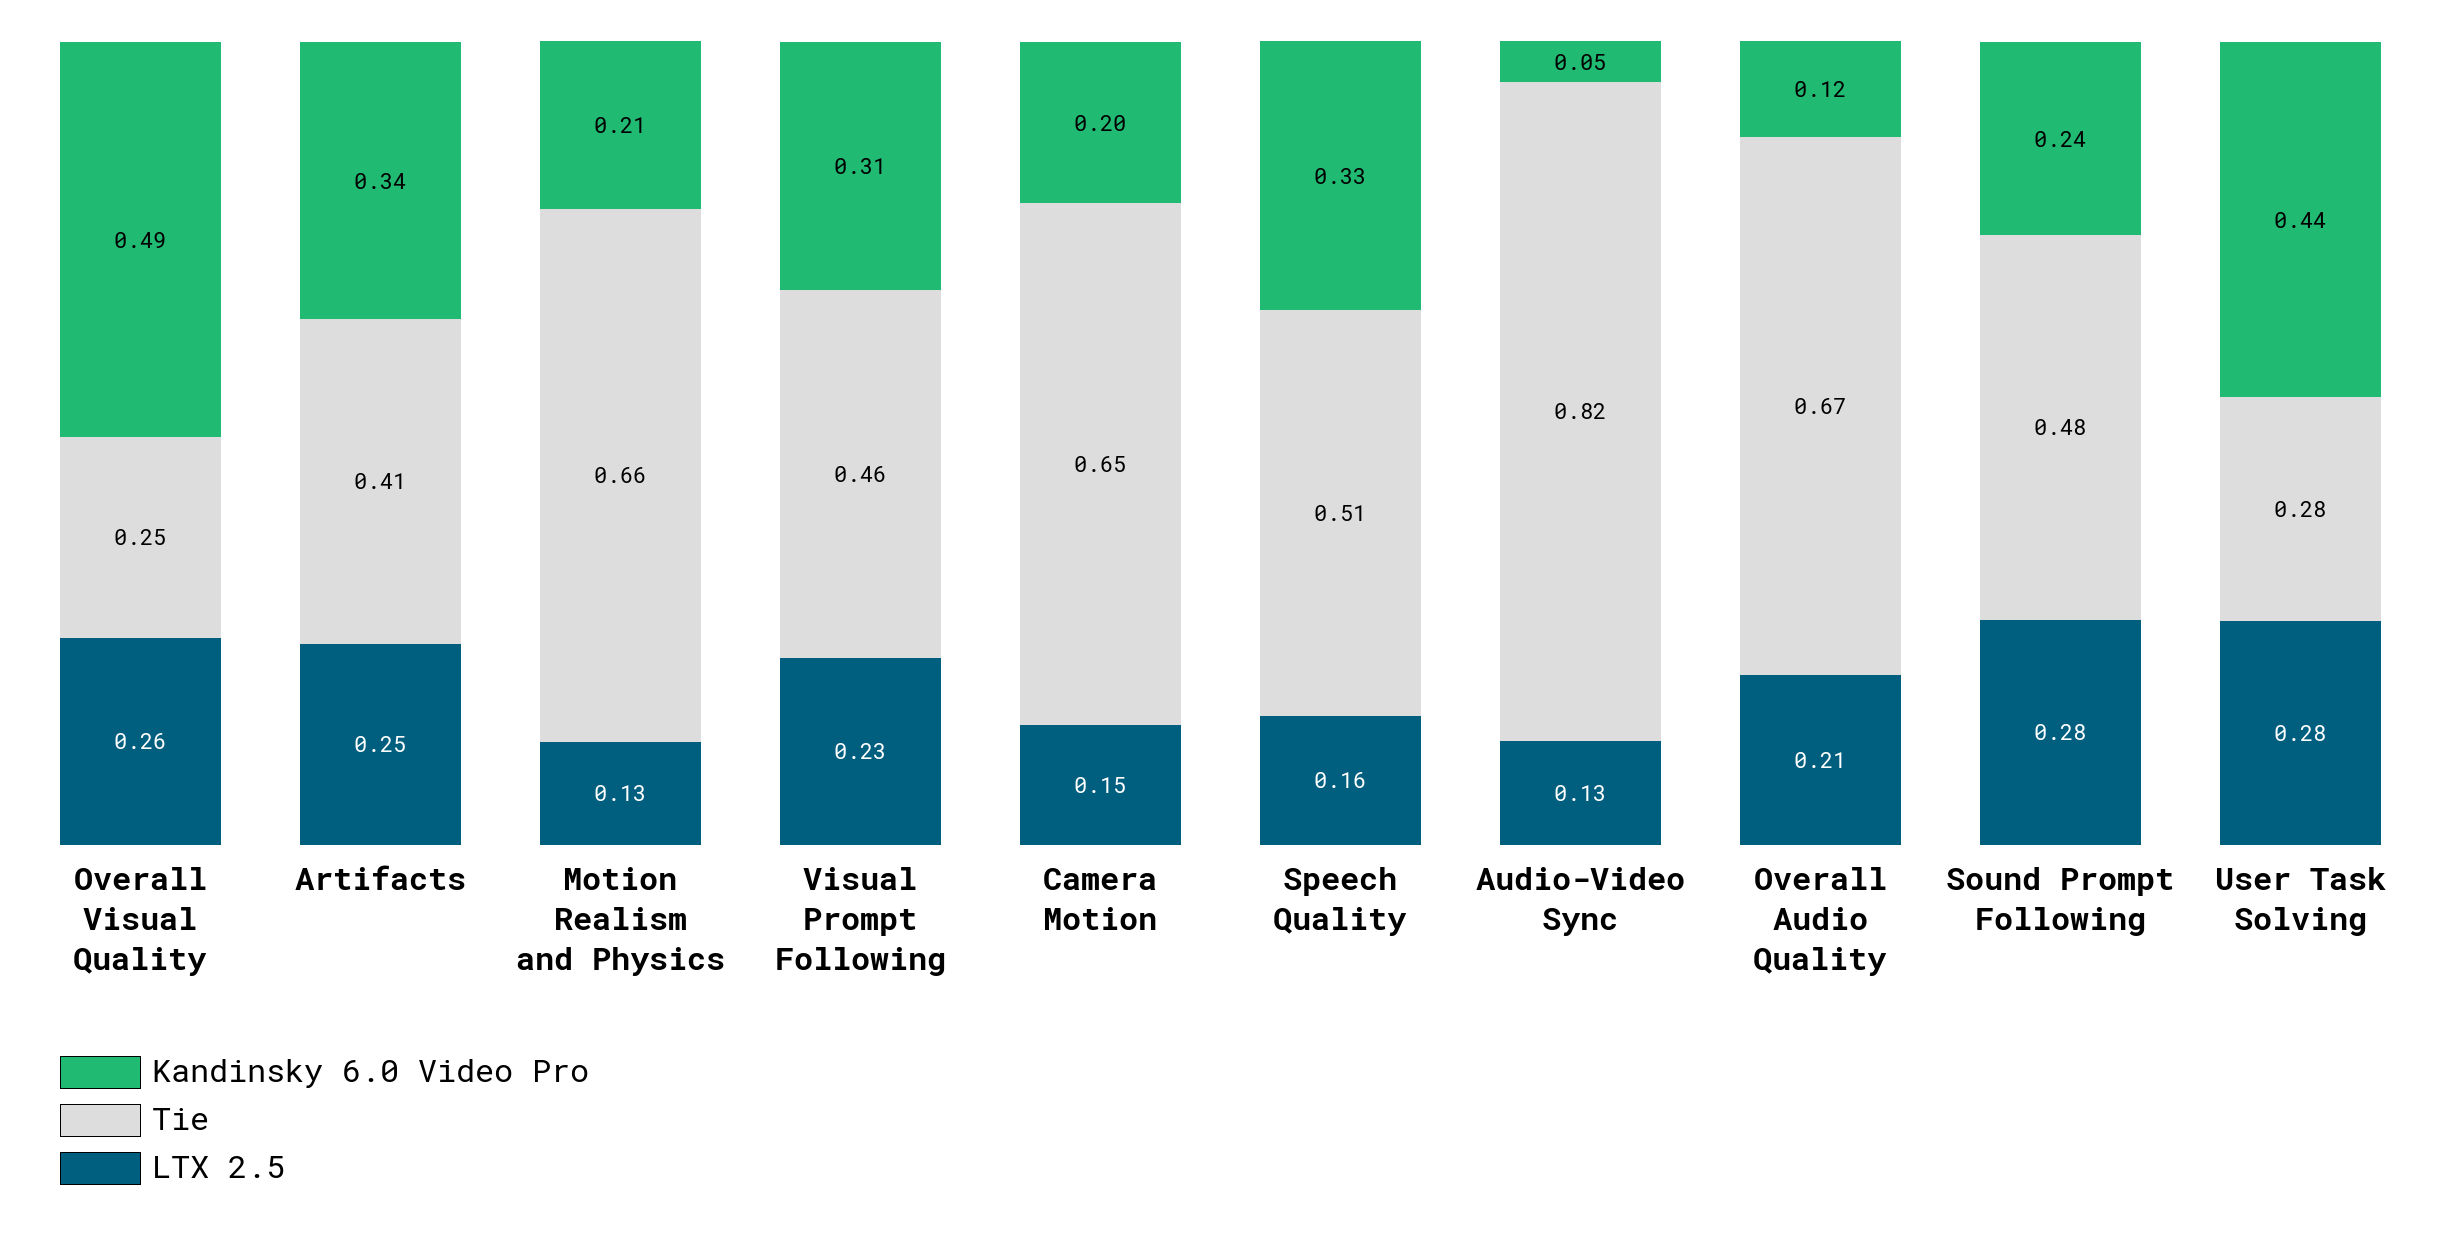
Парное сравнение с LTX 2.5 в указанном в работе сценарии.
Источник: Оригинальная иллюстрация · Kandinsky 6.0 Video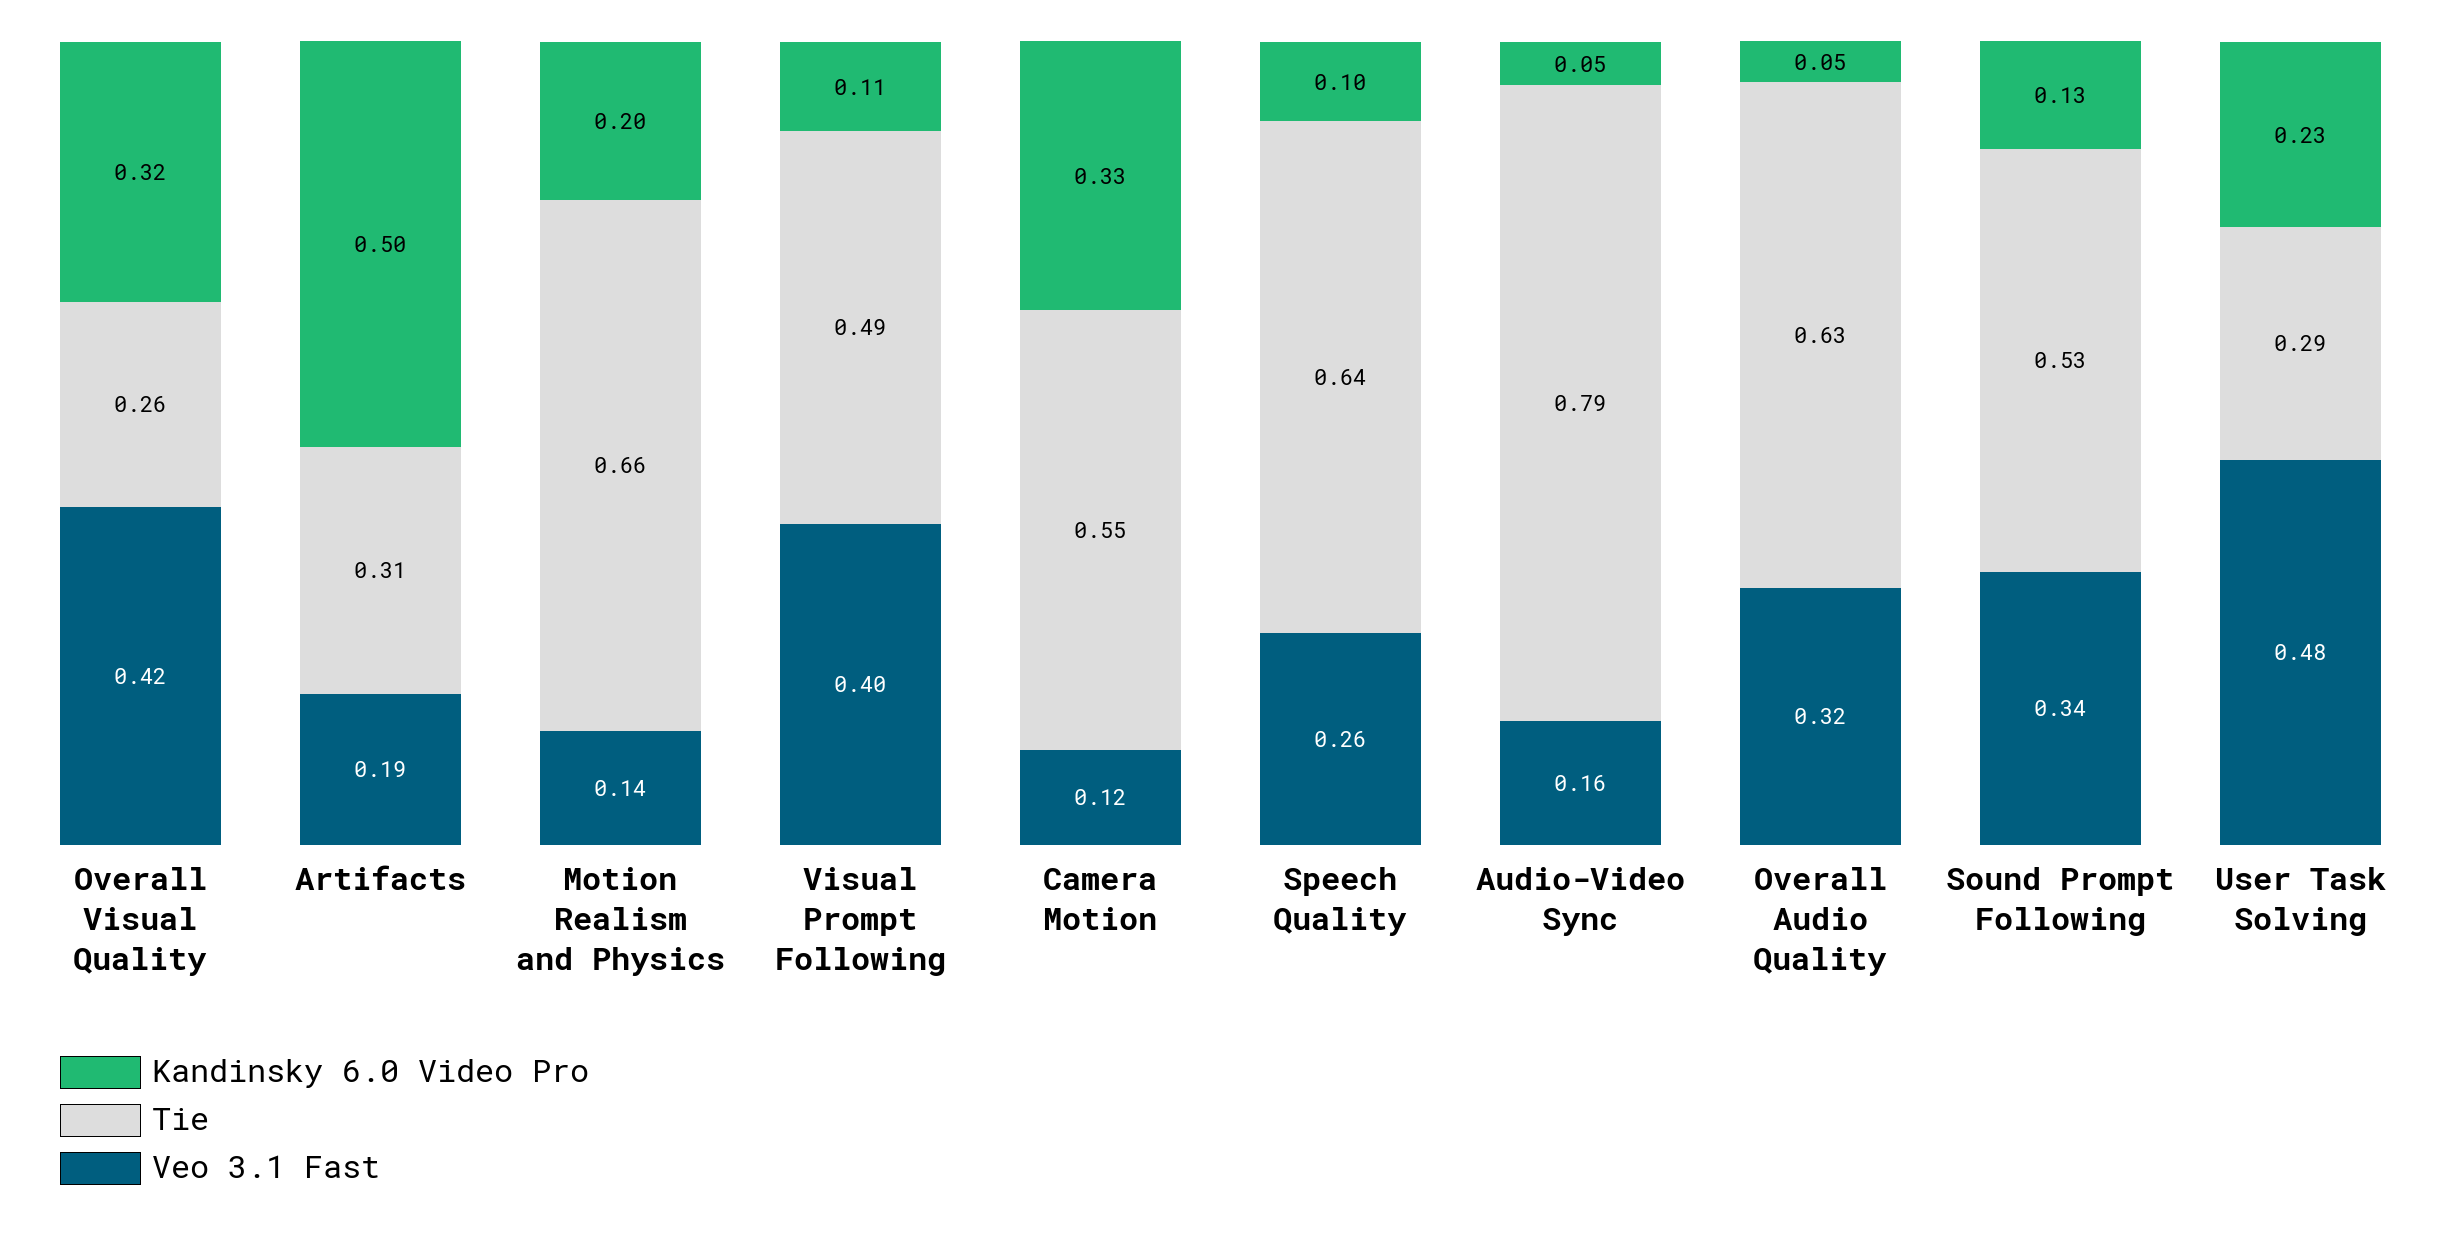
Парное сравнение с Veo 3.1 Fast в указанном в работе сценарии.
Источник: Оригинальная иллюстрация · Kandinsky 6.0 Video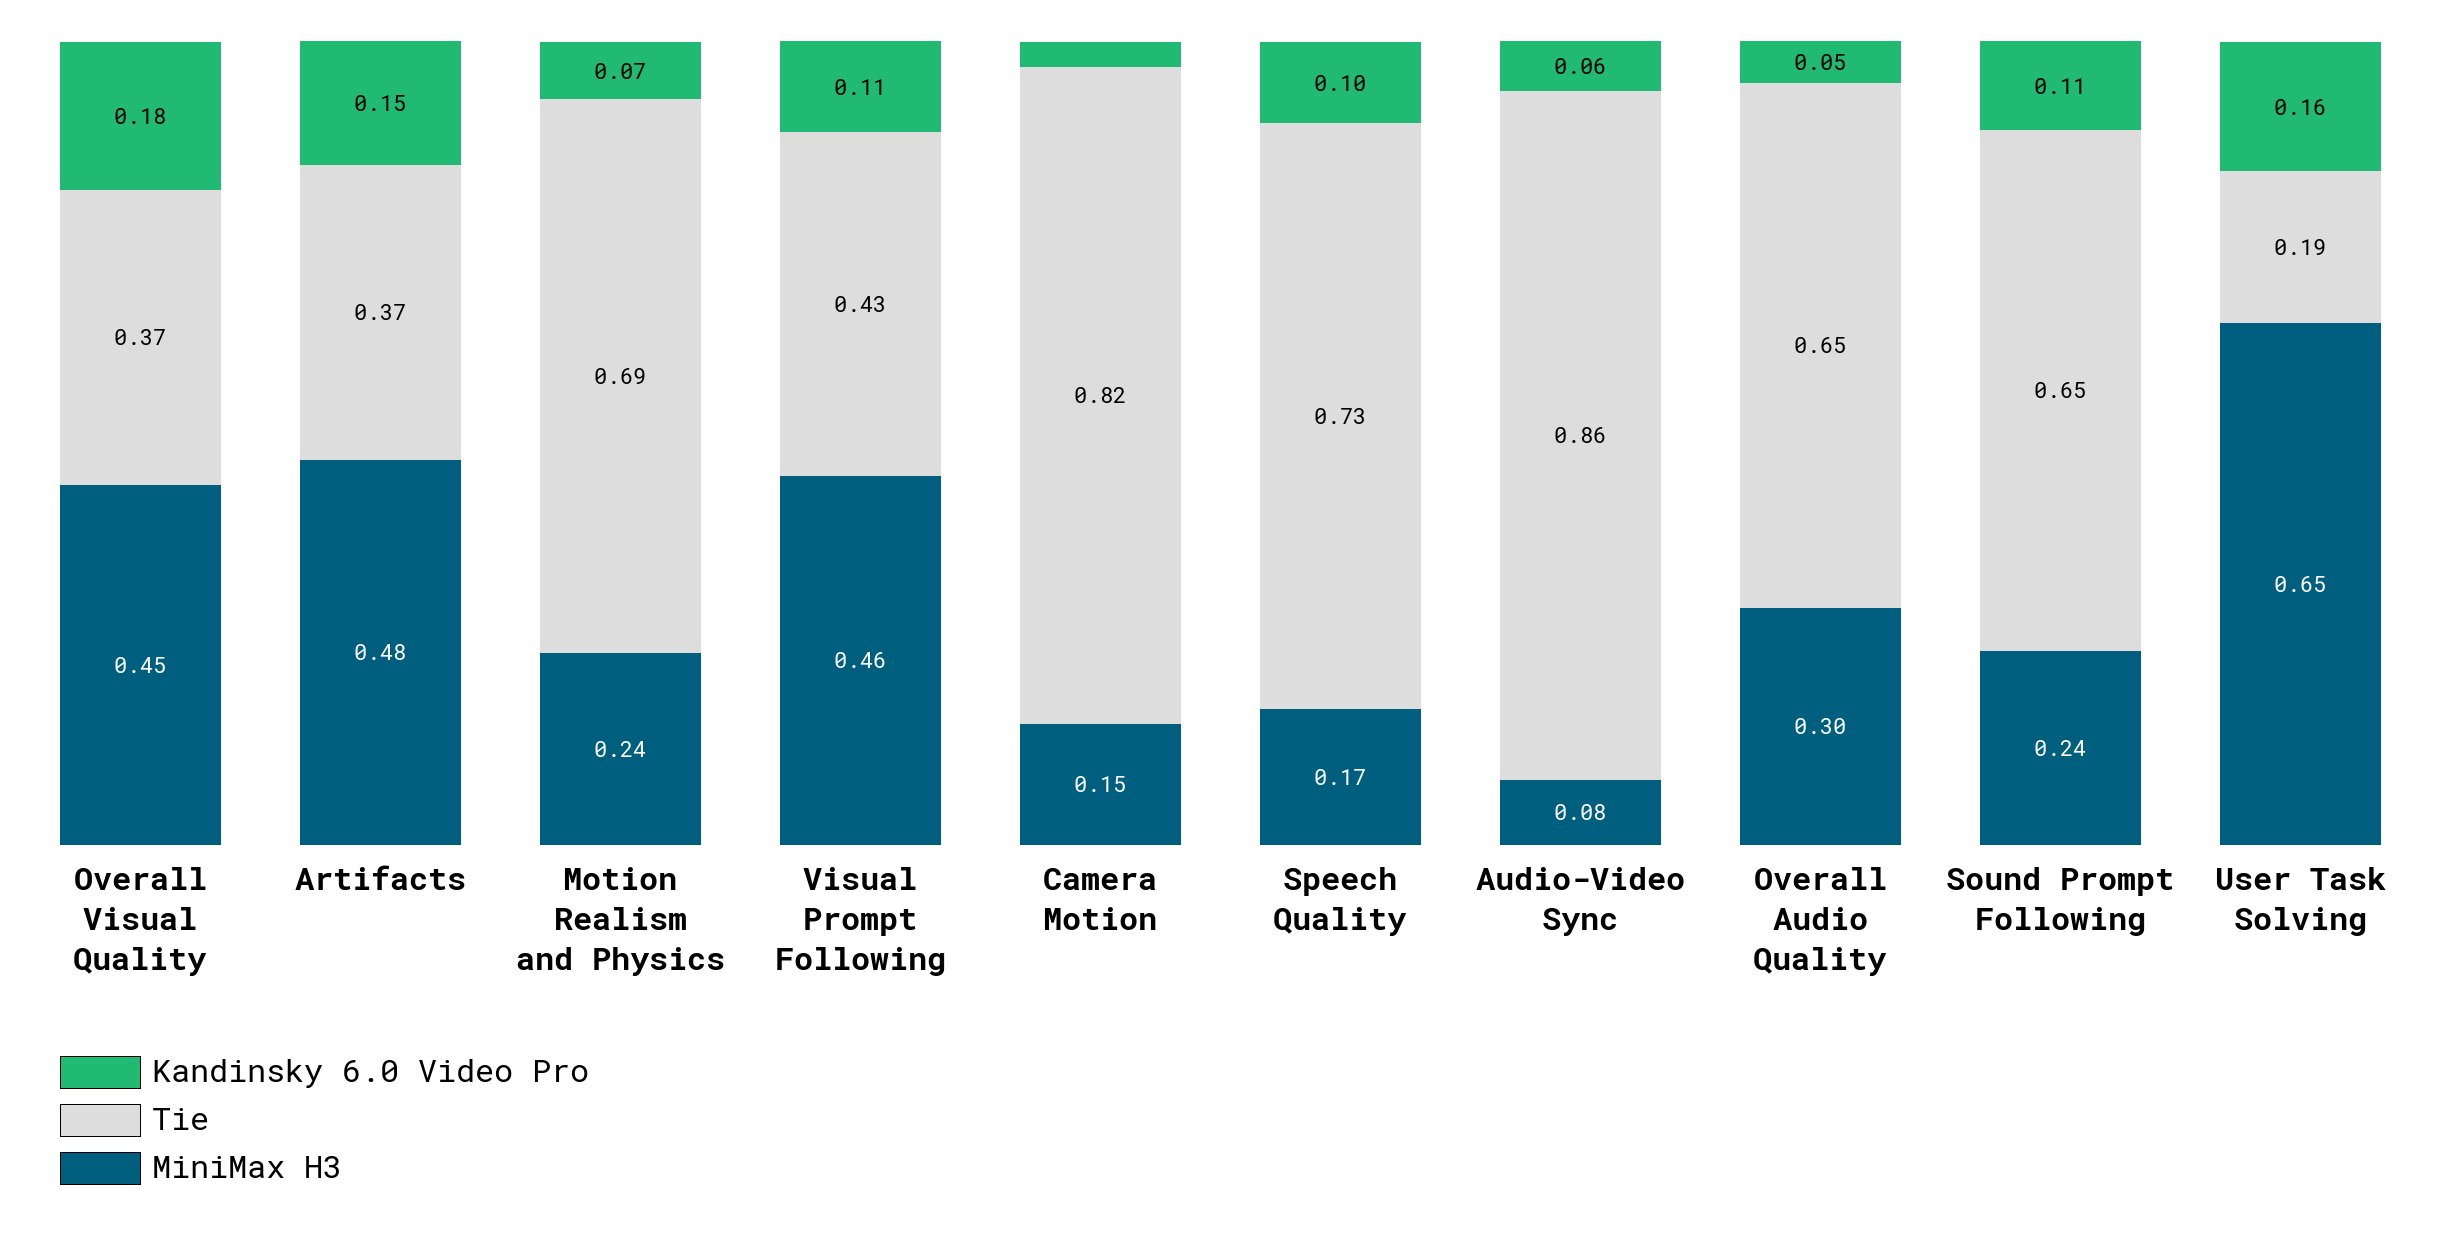
Парное сравнение с MiniMax H3 в указанном в работе сценарии.
Источник: Оригинальная иллюстрация · Kandinsky 6.0 Video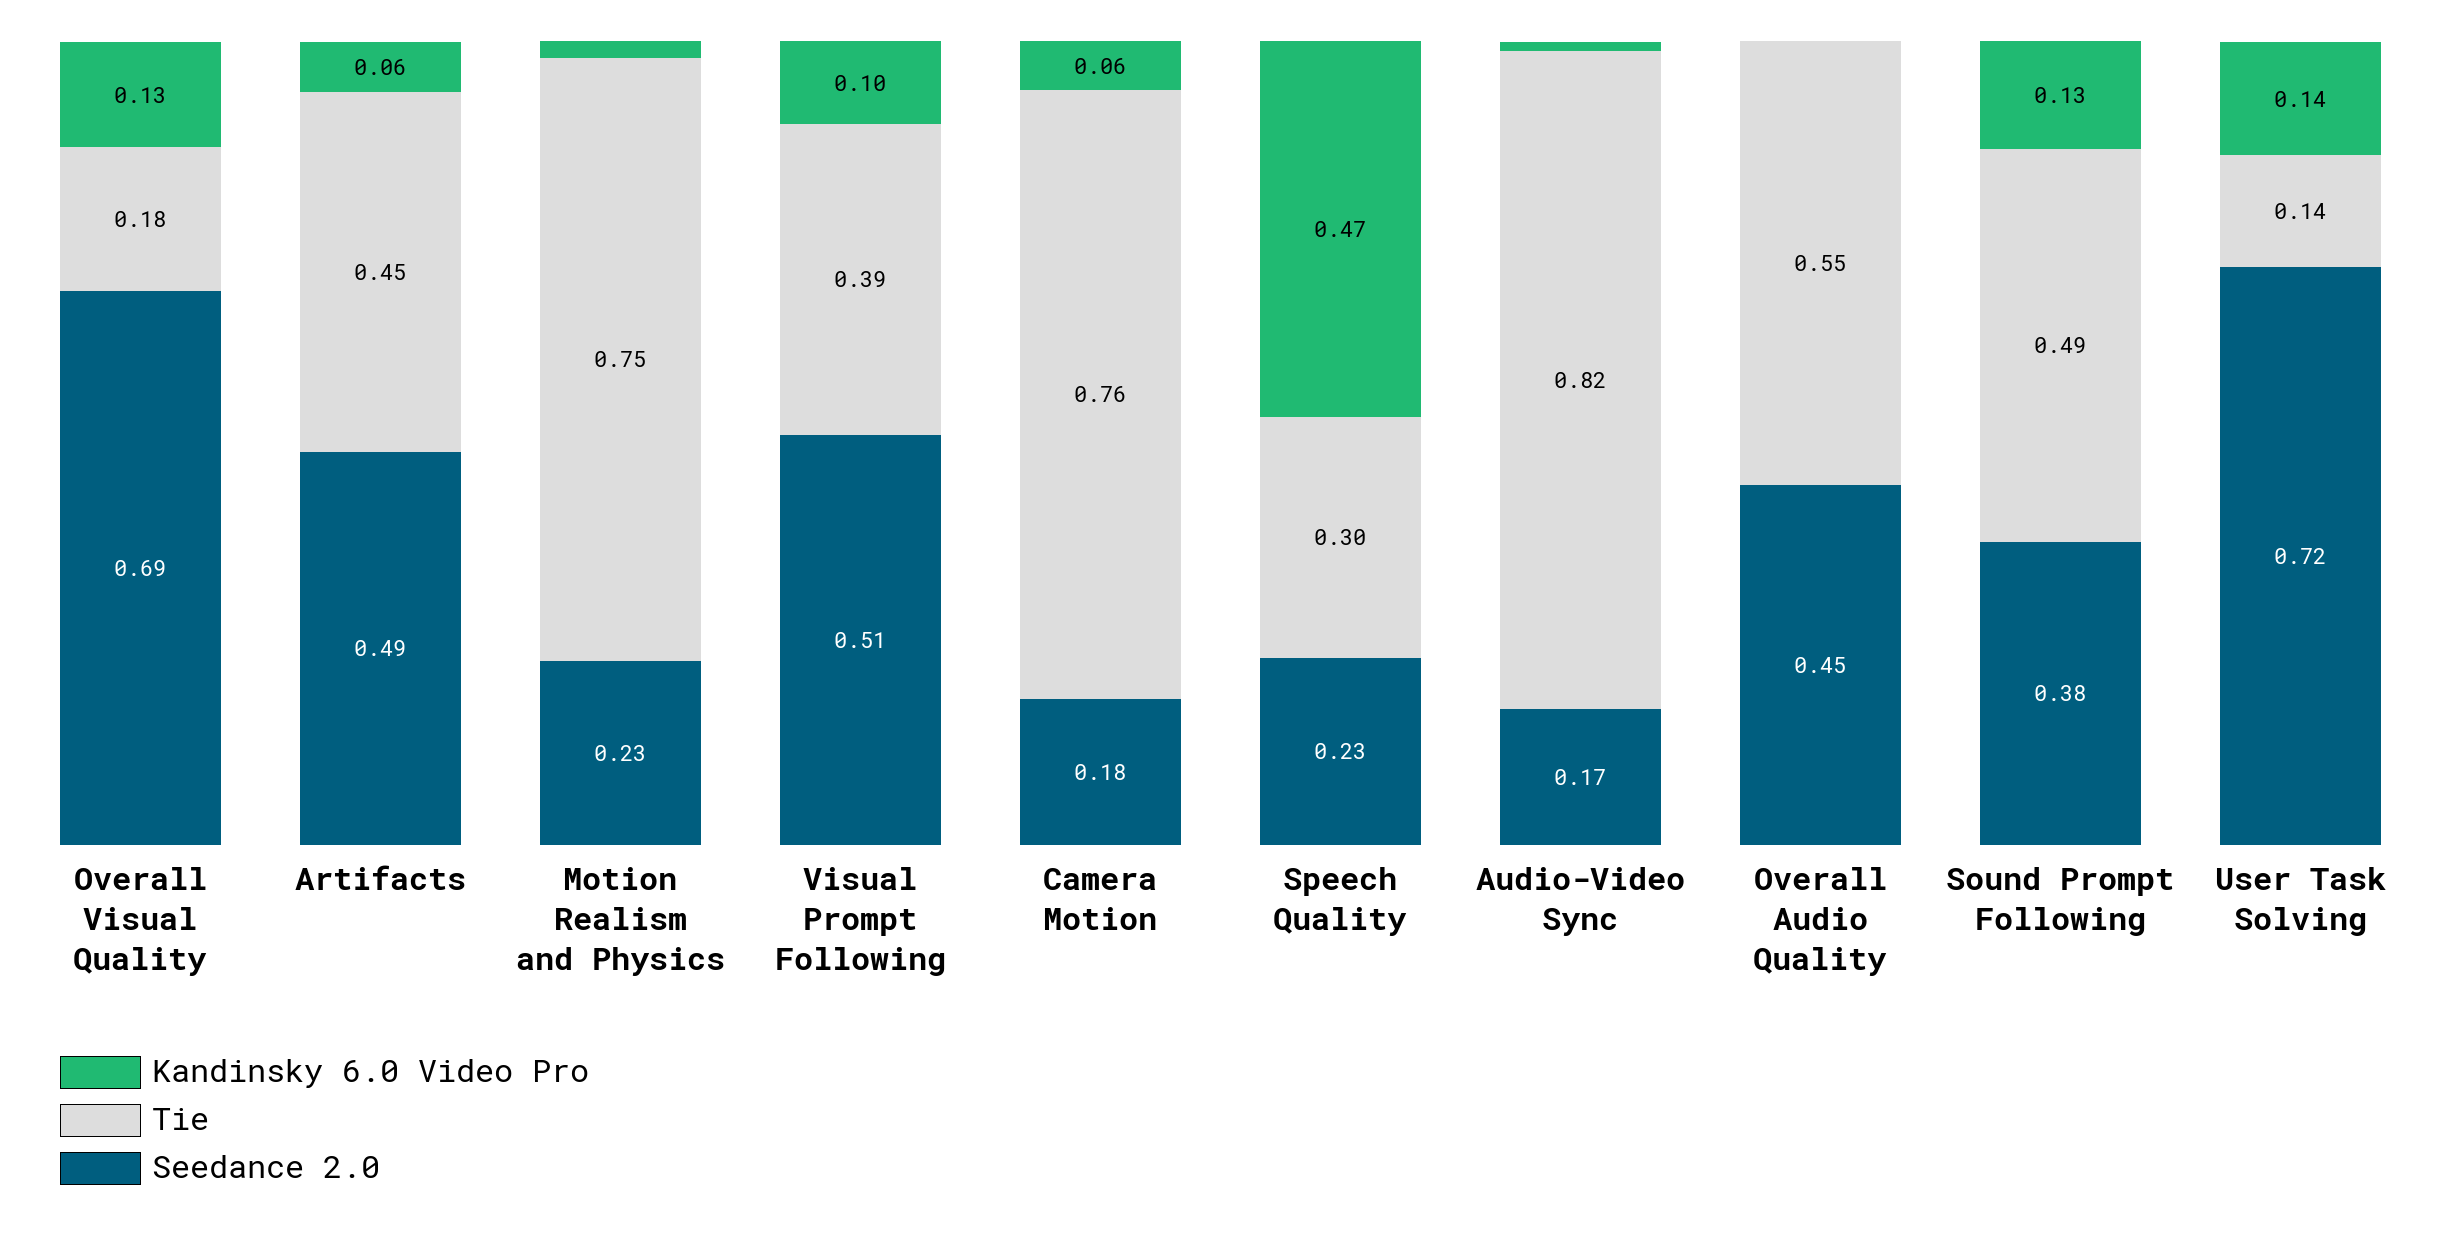
Парное сравнение с Seedance 2.0 в указанном в работе сценарии.
Источник: Оригинальная иллюстрация · Kandinsky 6.0 VideoЧто дали RL и дистилляция в отдельных проверках
Абляция RL против SFT показывает улучшения не только речевого теста, но и общих задач, включая I2AV. Сравнивают SFT- и RL-чекпойнты одной Pro-модели в трёх условиях: T2AV с акцентом на речь, T2AV общего назначения и I2AV общего назначения.
На речевом тесте наиболее выражены значимые улучшения речи, звукового следования запросу и синхронизации; меньше становится ничьих. Визуальное следование запросу и движение также улучшаются, но слабее.
На общем T2AV-наборе существенно улучшаются визуальное качество, движение и визуальное следование запросу; аудиокритерии дают более умеренные положительные изменения. В описанном сравнении специализация на речи не сопровождается ухудшением общей визуальной оценки.
На общем I2AV-наборе улучшаются изображение, движение и синхронизация; следование запросу тоже растёт, непреднамеренных разрывов сцен становится меньше. Это перенос эффекта RL, обученного только в T2AV.
Авторы сообщают уверенное предпочтение RL во всех трёх условиях. Здесь не выделен индивидуальный вклад каждой из восьми наград, gradient surgery или пространственного взвешивания, и такой причинный вывод не добавляется.
Дистиллированная Pro сохраняет качество в проверенном I2AV-сравнении, но небольшое среднее преимущество незначимо. Сравниваются дистиллированная и полная Pro-модели одного и того же этапа обучения в I2AV, а не модели разных размеров или стадий.
Дистиллированная версия предпочтительнее или равна по большинству критериев. Ни одно отдельное различие не достигает значимости на указанных уровнях 0.95 и 0.975.
Среднее предпочтение по всем критериям — 51% против 49% в пользу дистиллированной. Наибольшие преимущества — сохранение исходного изображения и артефакты; полная версия немного лучше следует визуальному запросу и решает задачу целиком.
Это свидетельство сохранения воспринимаемого качества в данном I2AV-тесте, а не доказательство превосходства дистилляции или эквивалентности во всех режимах. Число вызовов сокращено, но отдельный сопоставимый end-to-end-замер её скорости здесь не дан.
Три сравнения RL и SFT сделаны на разных наборах: речевом T2AV, общем T2AV и общем I2AV. Эффект дистилляции проверяется отдельно, на паре Full/Distilled в I2AV, и отвечает на другой вопрос — сохраняется ли качество при меньшем числе вычислений.
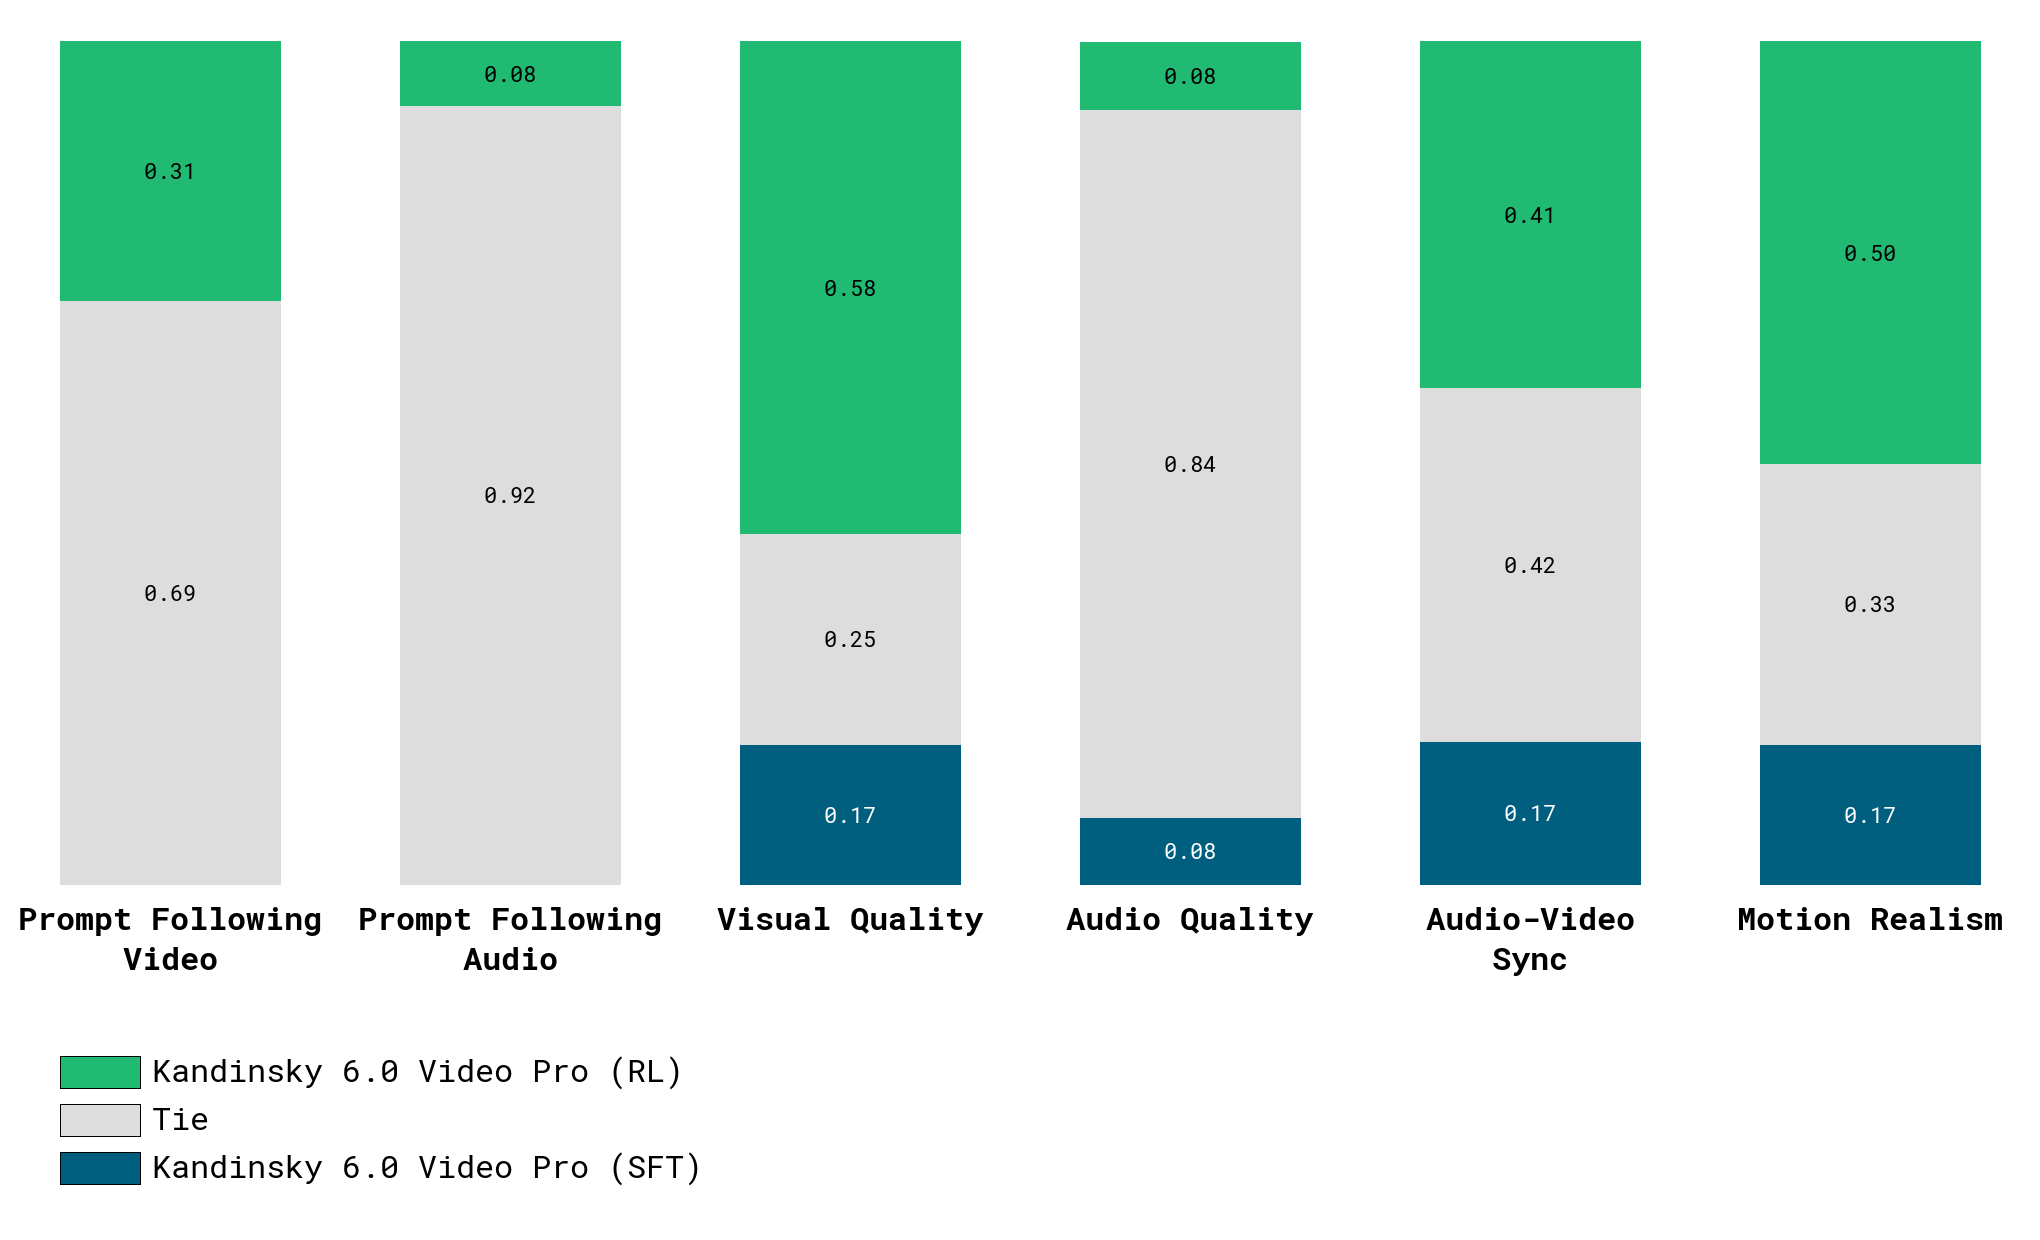
RL и SFT сравниваются на задачах генерации по тексту с акцентом на речь.
Источник: Оригинальная иллюстрация · Kandinsky 6.0 Video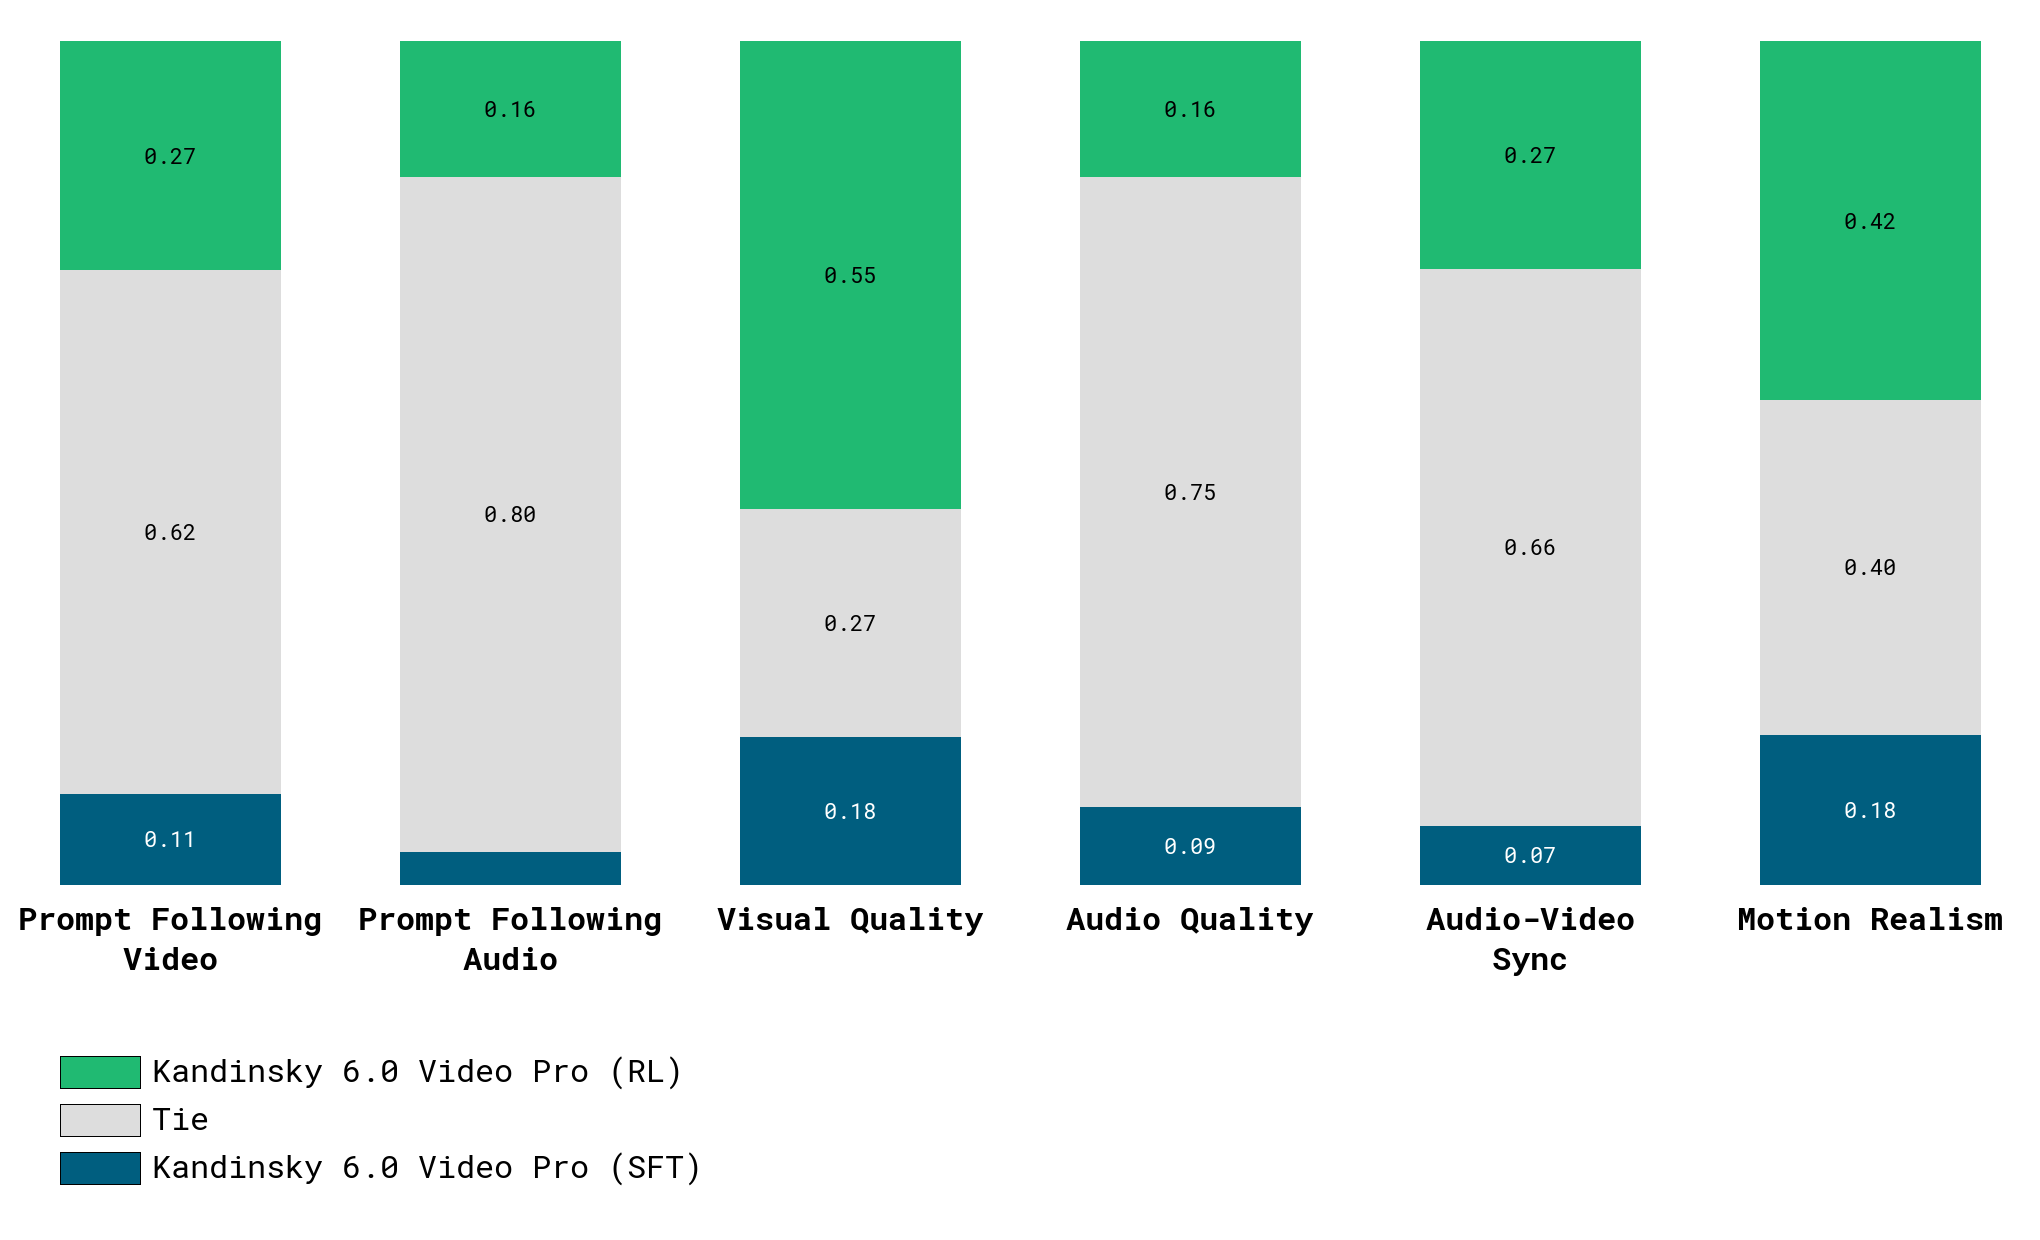
RL и SFT сравниваются на задачах генерации по тексту в общем домене.
Источник: Оригинальная иллюстрация · Kandinsky 6.0 Video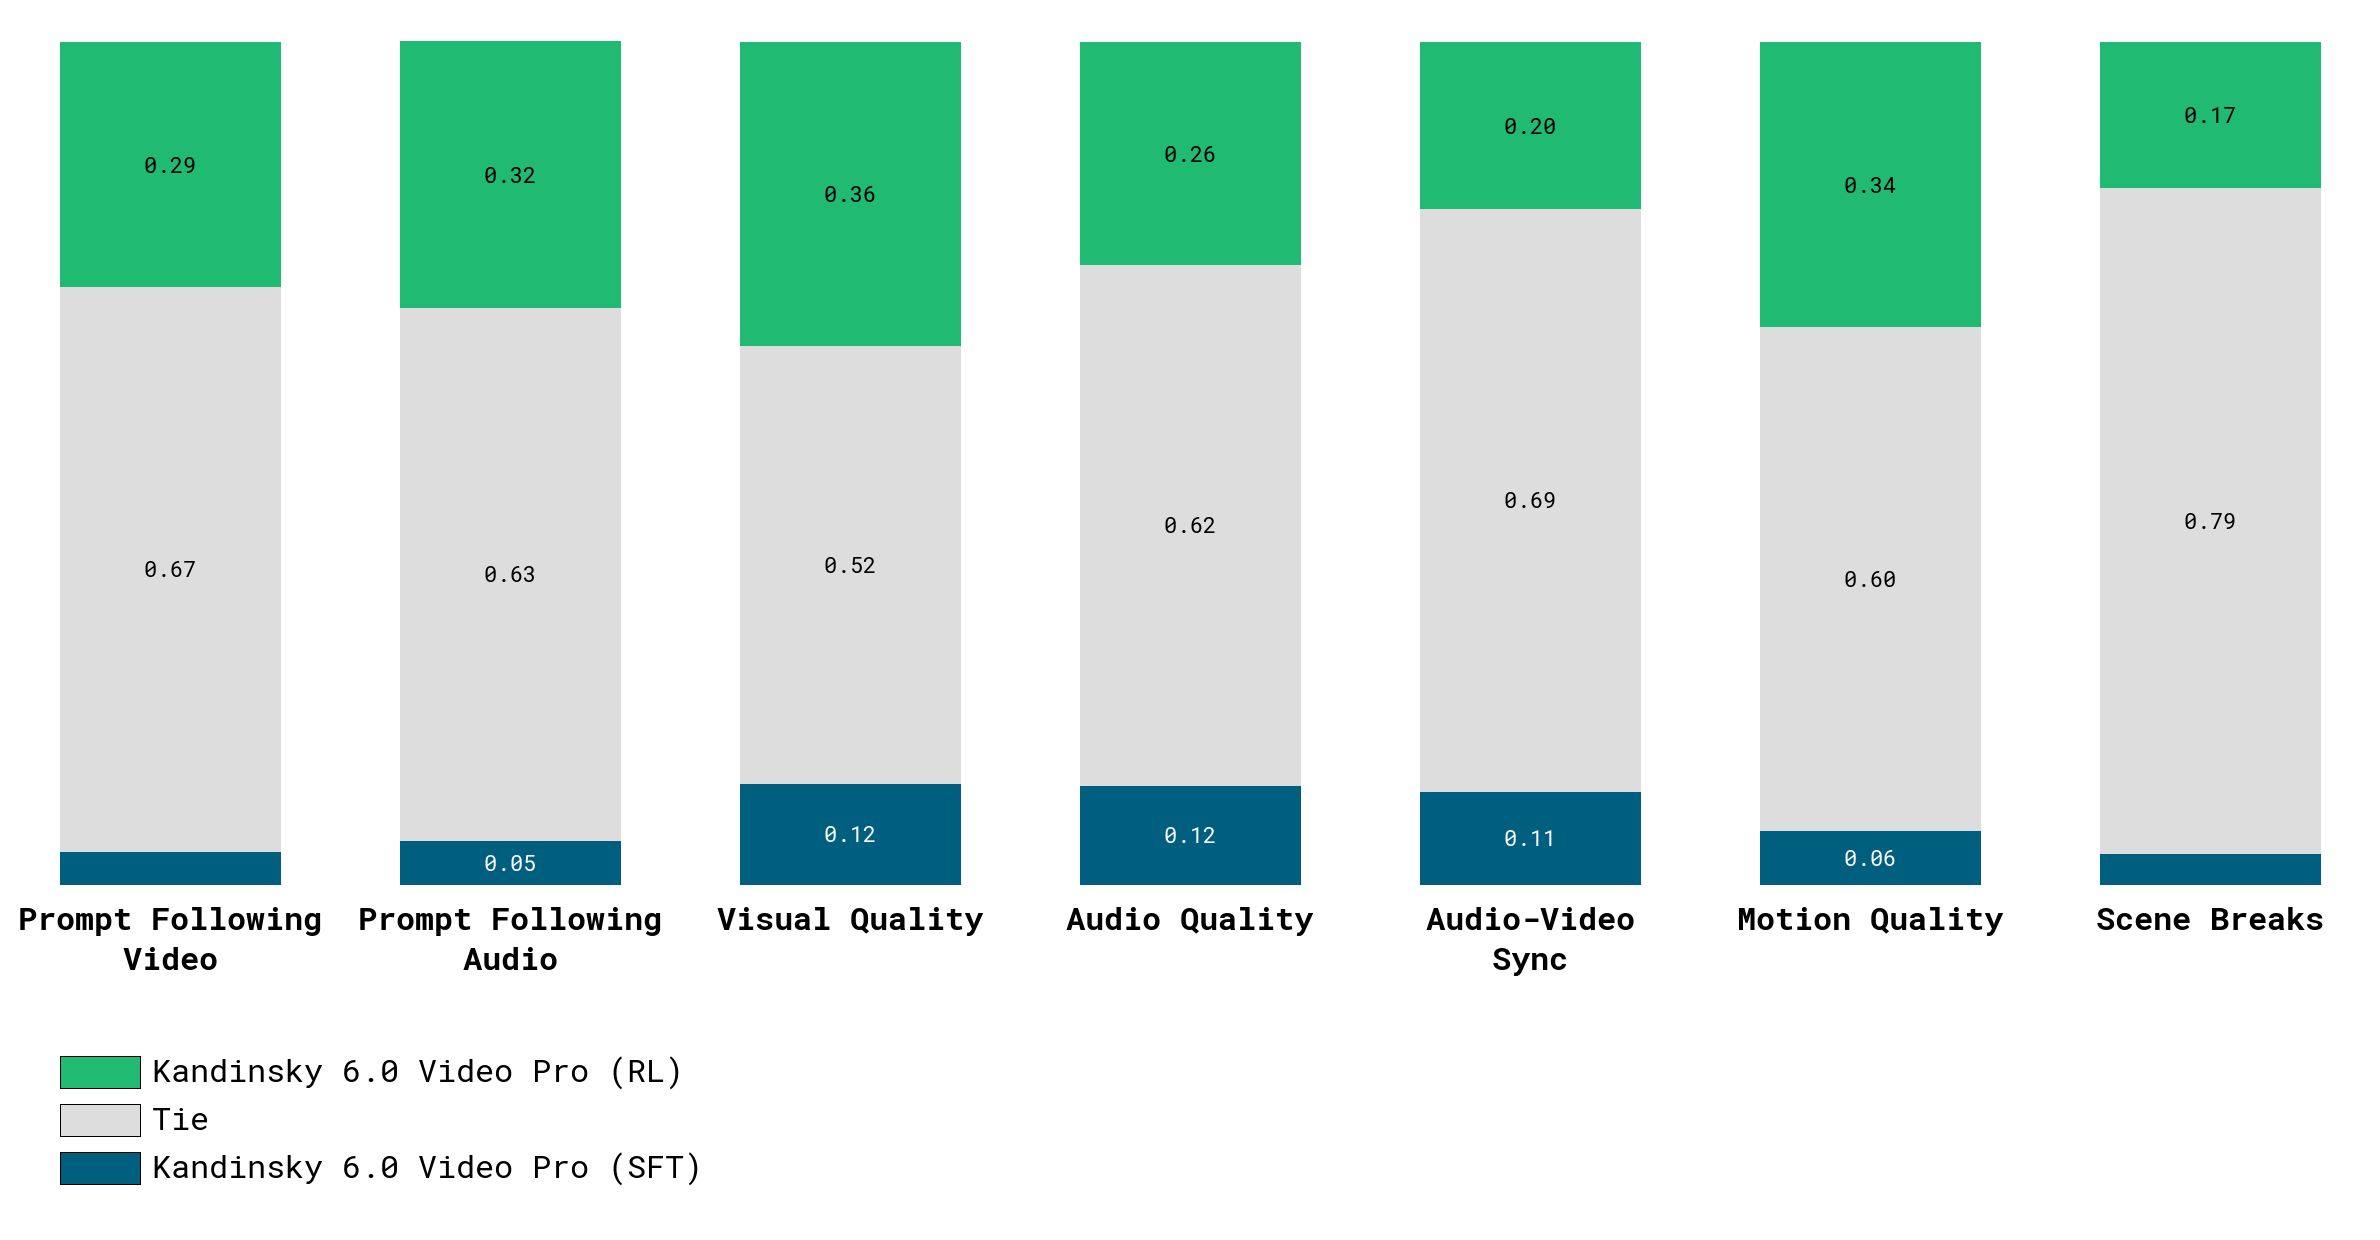
RL и SFT сравниваются в общем домене при генерации по исходному изображению.
Источник: Оригинальная иллюстрация · Kandinsky 6.0 Video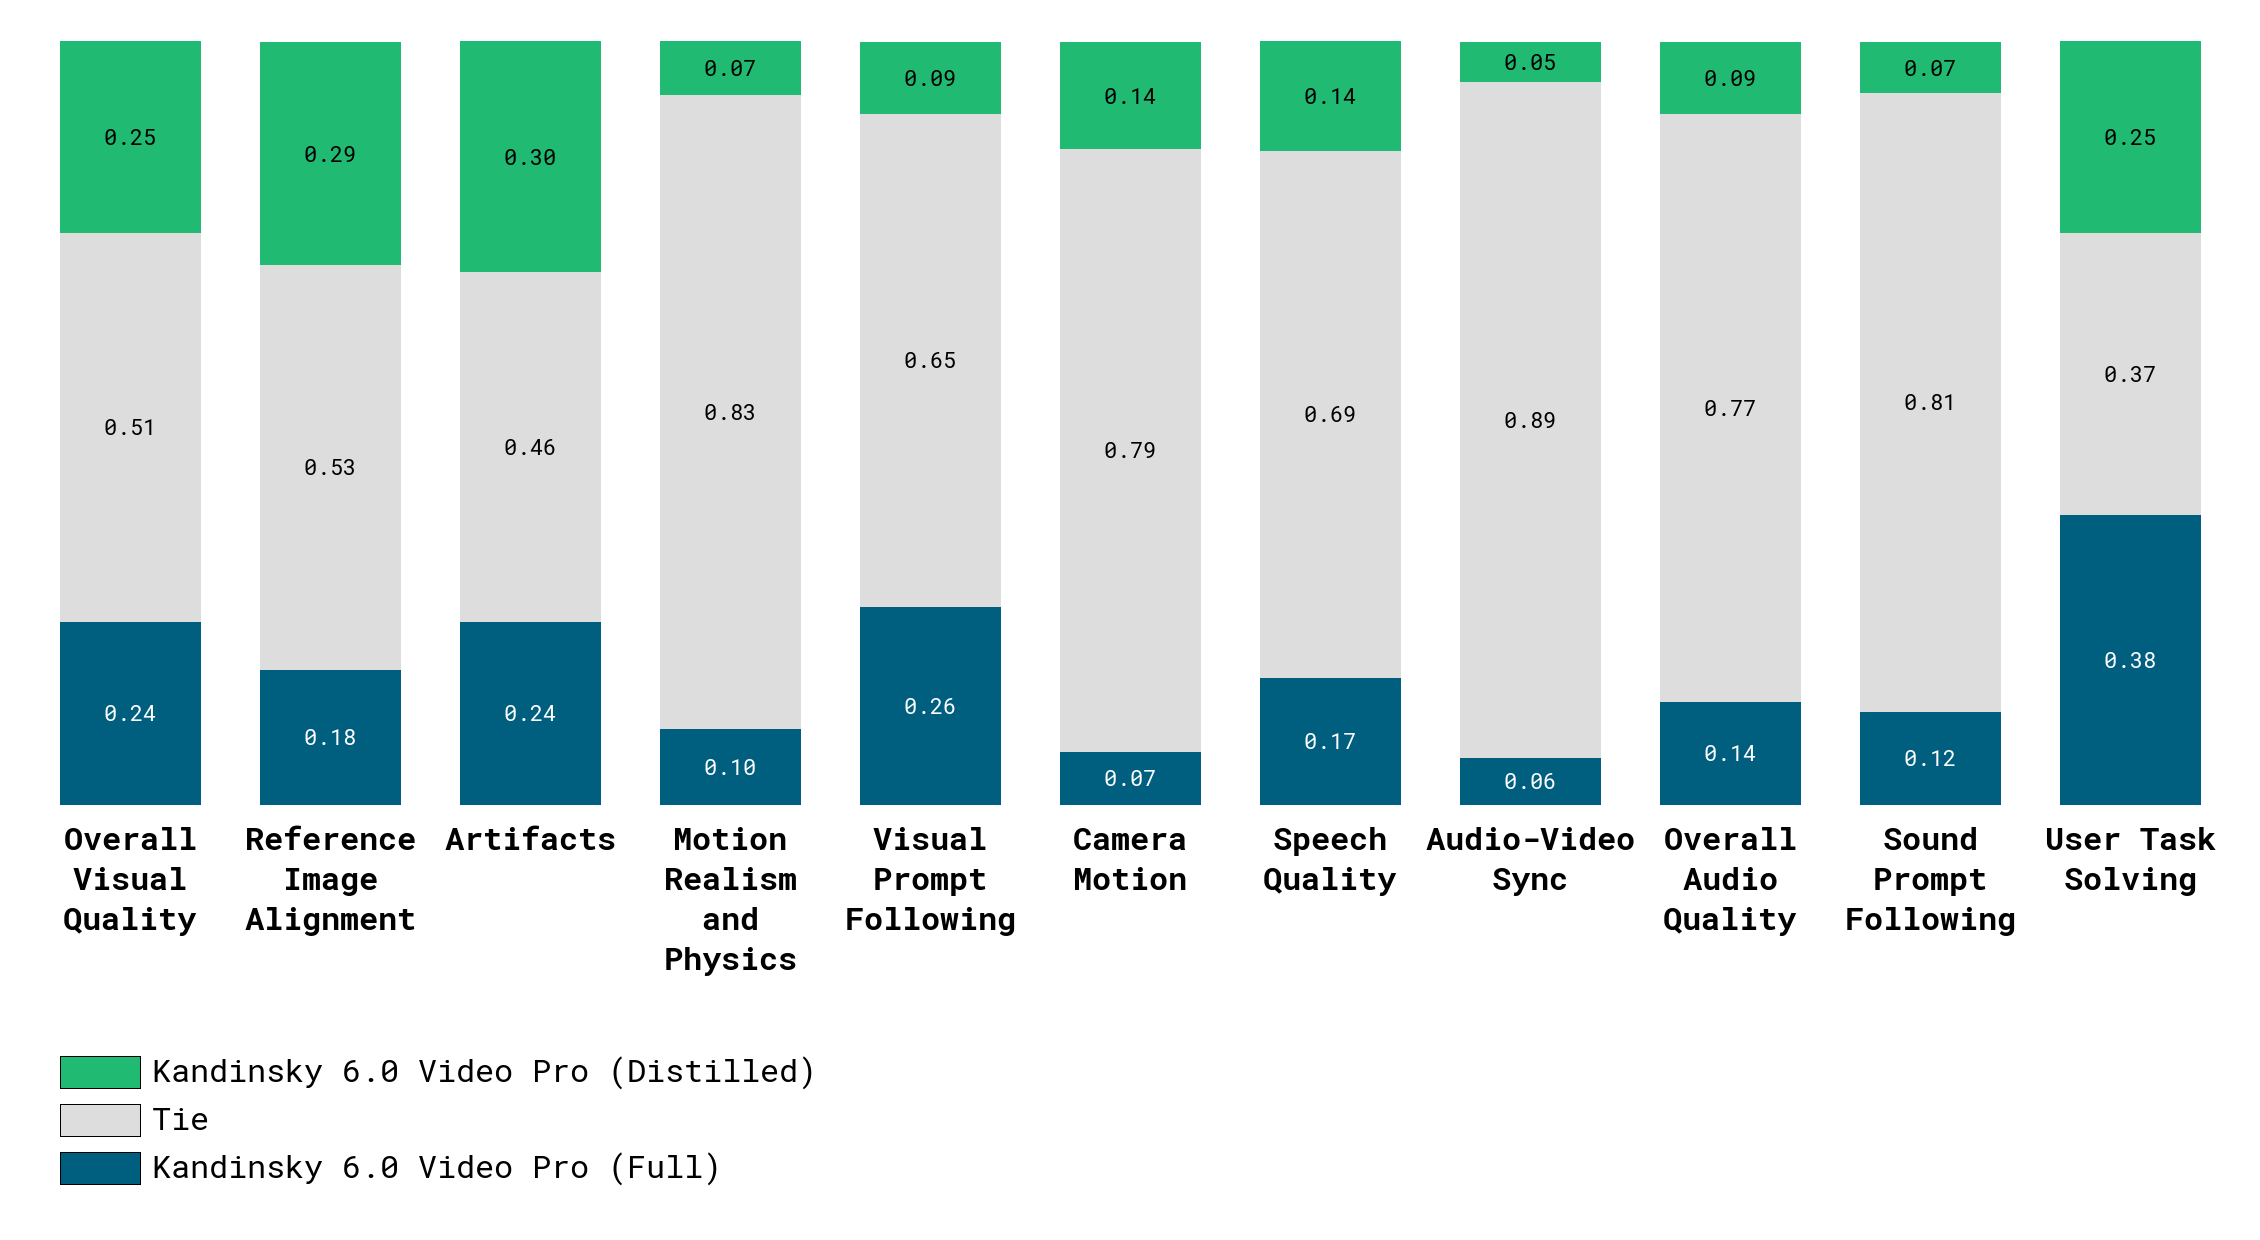
Полная и дистиллированная версии Pro сравниваются по разным аспектам качества.
Источник: Оригинальная иллюстрация · Kandinsky 6.0 VideoЧто показывают примеры видео, звука и увеличения разрешения
Аудиовизуальные примеры показывают замысел проверки речи, музыки и звуков событий, но не заменяют прослушивание. По тексту раздела, примеры обычно созданы Pro и представлены кадрами одного 5-секундного ролика при 24 кадрах/с вместе с формой звуковой волны. Авторы используют их для иллюстрации временного и смыслового соответствия.
Сюжеты с речью: астронавт на планете с кристаллами удивляется увиденному; собака-детектив произносит «I know who it is!»; учёный путает формулу; девочка говорит о желании стать врачом; пират кричит «Land ahead!». В исходных промптах речь отделена маркерами <S>...<E>, фон и эффекты — <AUDCAP>...<ENDAUDCAP>.
Музыкальный пример — уличный гитарист и хлопки толпы; событийный — удары молотком по гвоздю с металлическими и глухими звуками на фоне леса. Это отдельные условия проверки синхронизации, не только lip-sync.
В раскадровках рядом с последовательностью кадров показана форма звуковой волны. По ней можно увидеть моменты повышенной громкости и сопоставить их с кадрами, но о разборчивости речи и тембре звуков судят только по самой записи.
Примеры SR отделяют увеличение сетки LU от добавления деталей полным конвейером. По описанию, слева показан исходный кадр, справа три увеличенных участка. Строки сопоставляют увеличенный вход, декодированные LU ×2/×4 и полные SR ×2/×4.
Figure 30: анимированная «Девочка с персиками» Серова; участки лица и волос, банта, фрукта и ткани. Figure 31: теннис, кадр 111, лицо, ракетка, обувь и покрытие корта. Figure 32: интервью, кадр 121, лицо и очки, рука и ткань пиджака.
Авторы описывают LU как близкий к увеличенному исходнику, а полный SR — как более резкий и детальный; в выбранных примерах ×4 даёт более выраженные текстуры, чем ×2. Это качественное описание отобранных примеров, не доказательство общего превосходства ×4 на всех данных.
Раскадровка с космонавтом сопровождается изображением звуковой волны речи; пример с молотком показывает совпадение видимых ударов и пиков звуковой волны. Статичные картинки демонстрируют структуру примера, но сами по себе не позволяют услышать качество аудио. На примере SR сопоставлены исходный кроп, LU ×2/×4 и SR ×2/×4: увеличение латентной сетки не равно восстановлению деталей.
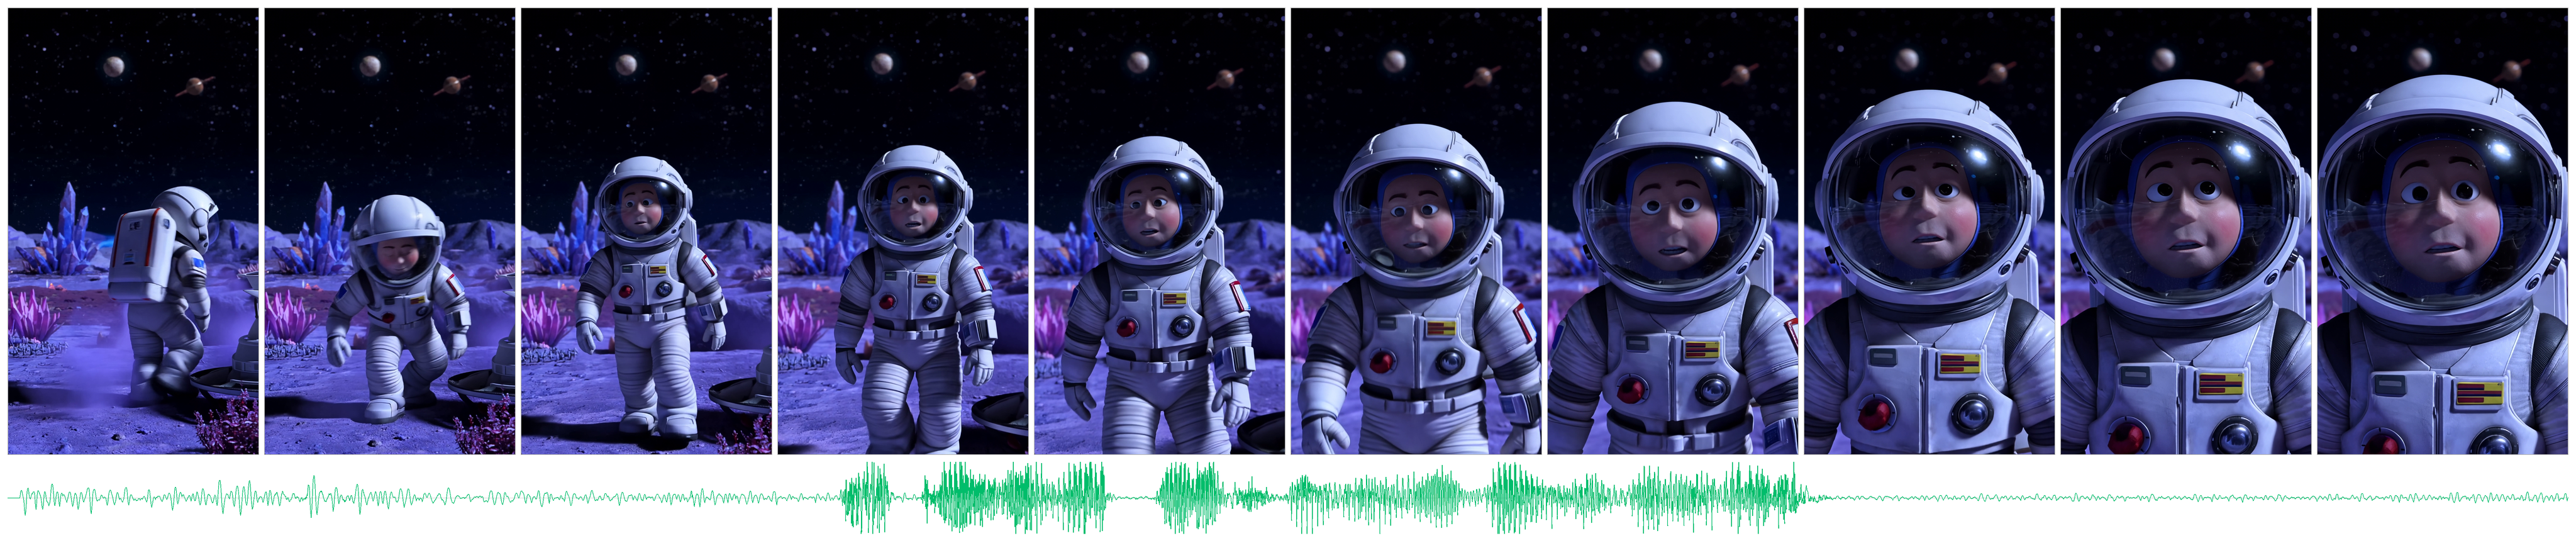
Пример совместной генерации видео и речи из технического отчёта: последовательность кадров и звуковая дорожка.
Источник: Оригинальная иллюстрация · Kandinsky 6.0 Video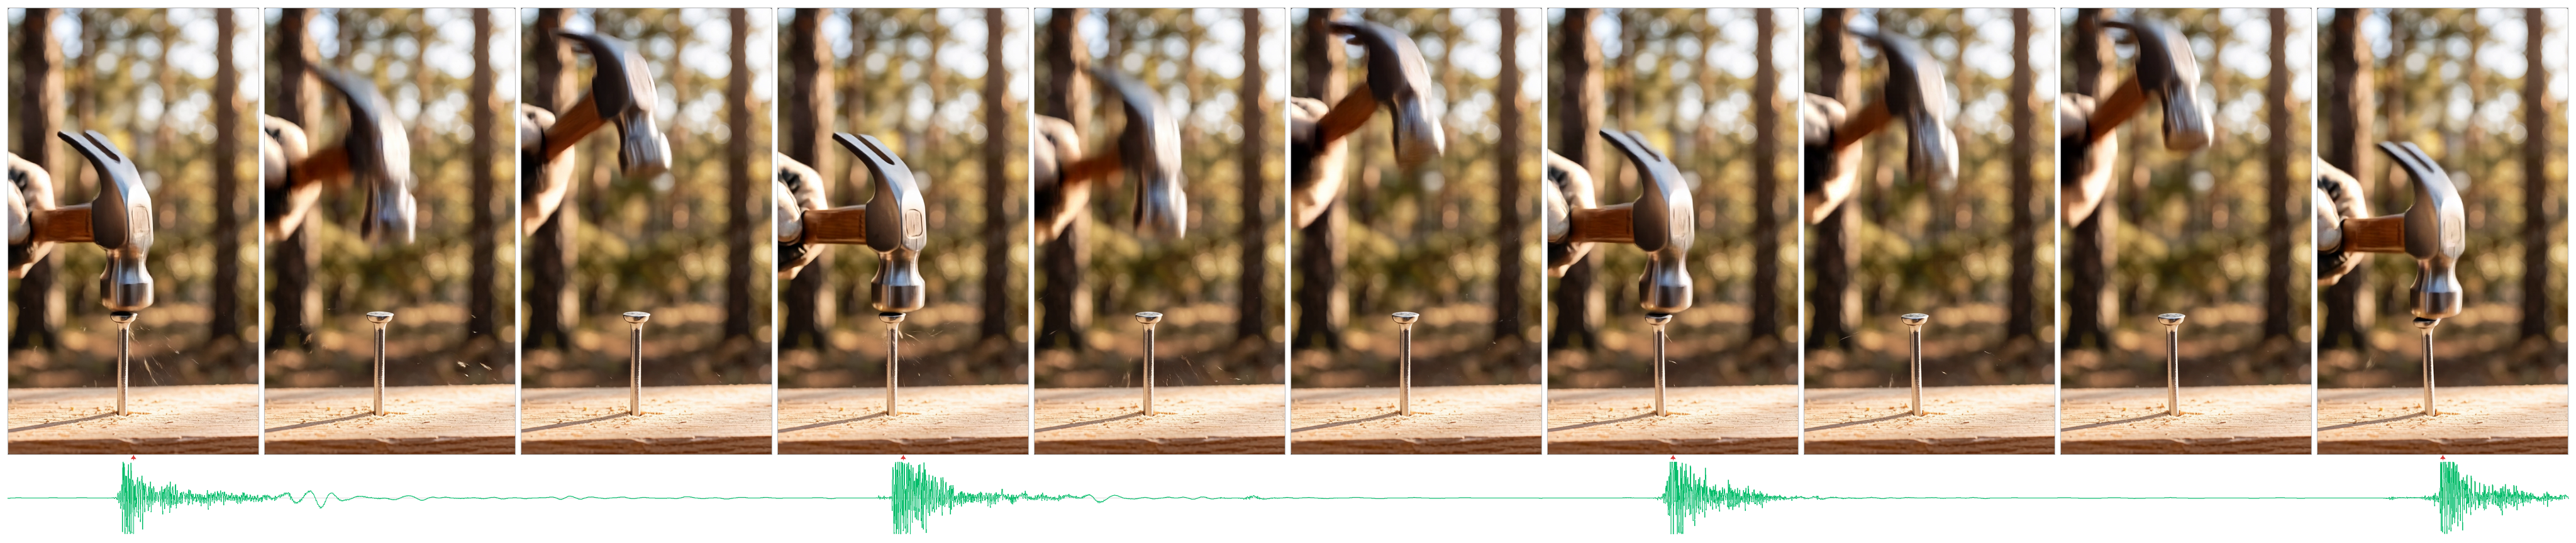
Пример согласования события в кадре со звуком: удары молотка в сгенерированной сцене.
Источник: Оригинальная иллюстрация · Kandinsky 6.0 Video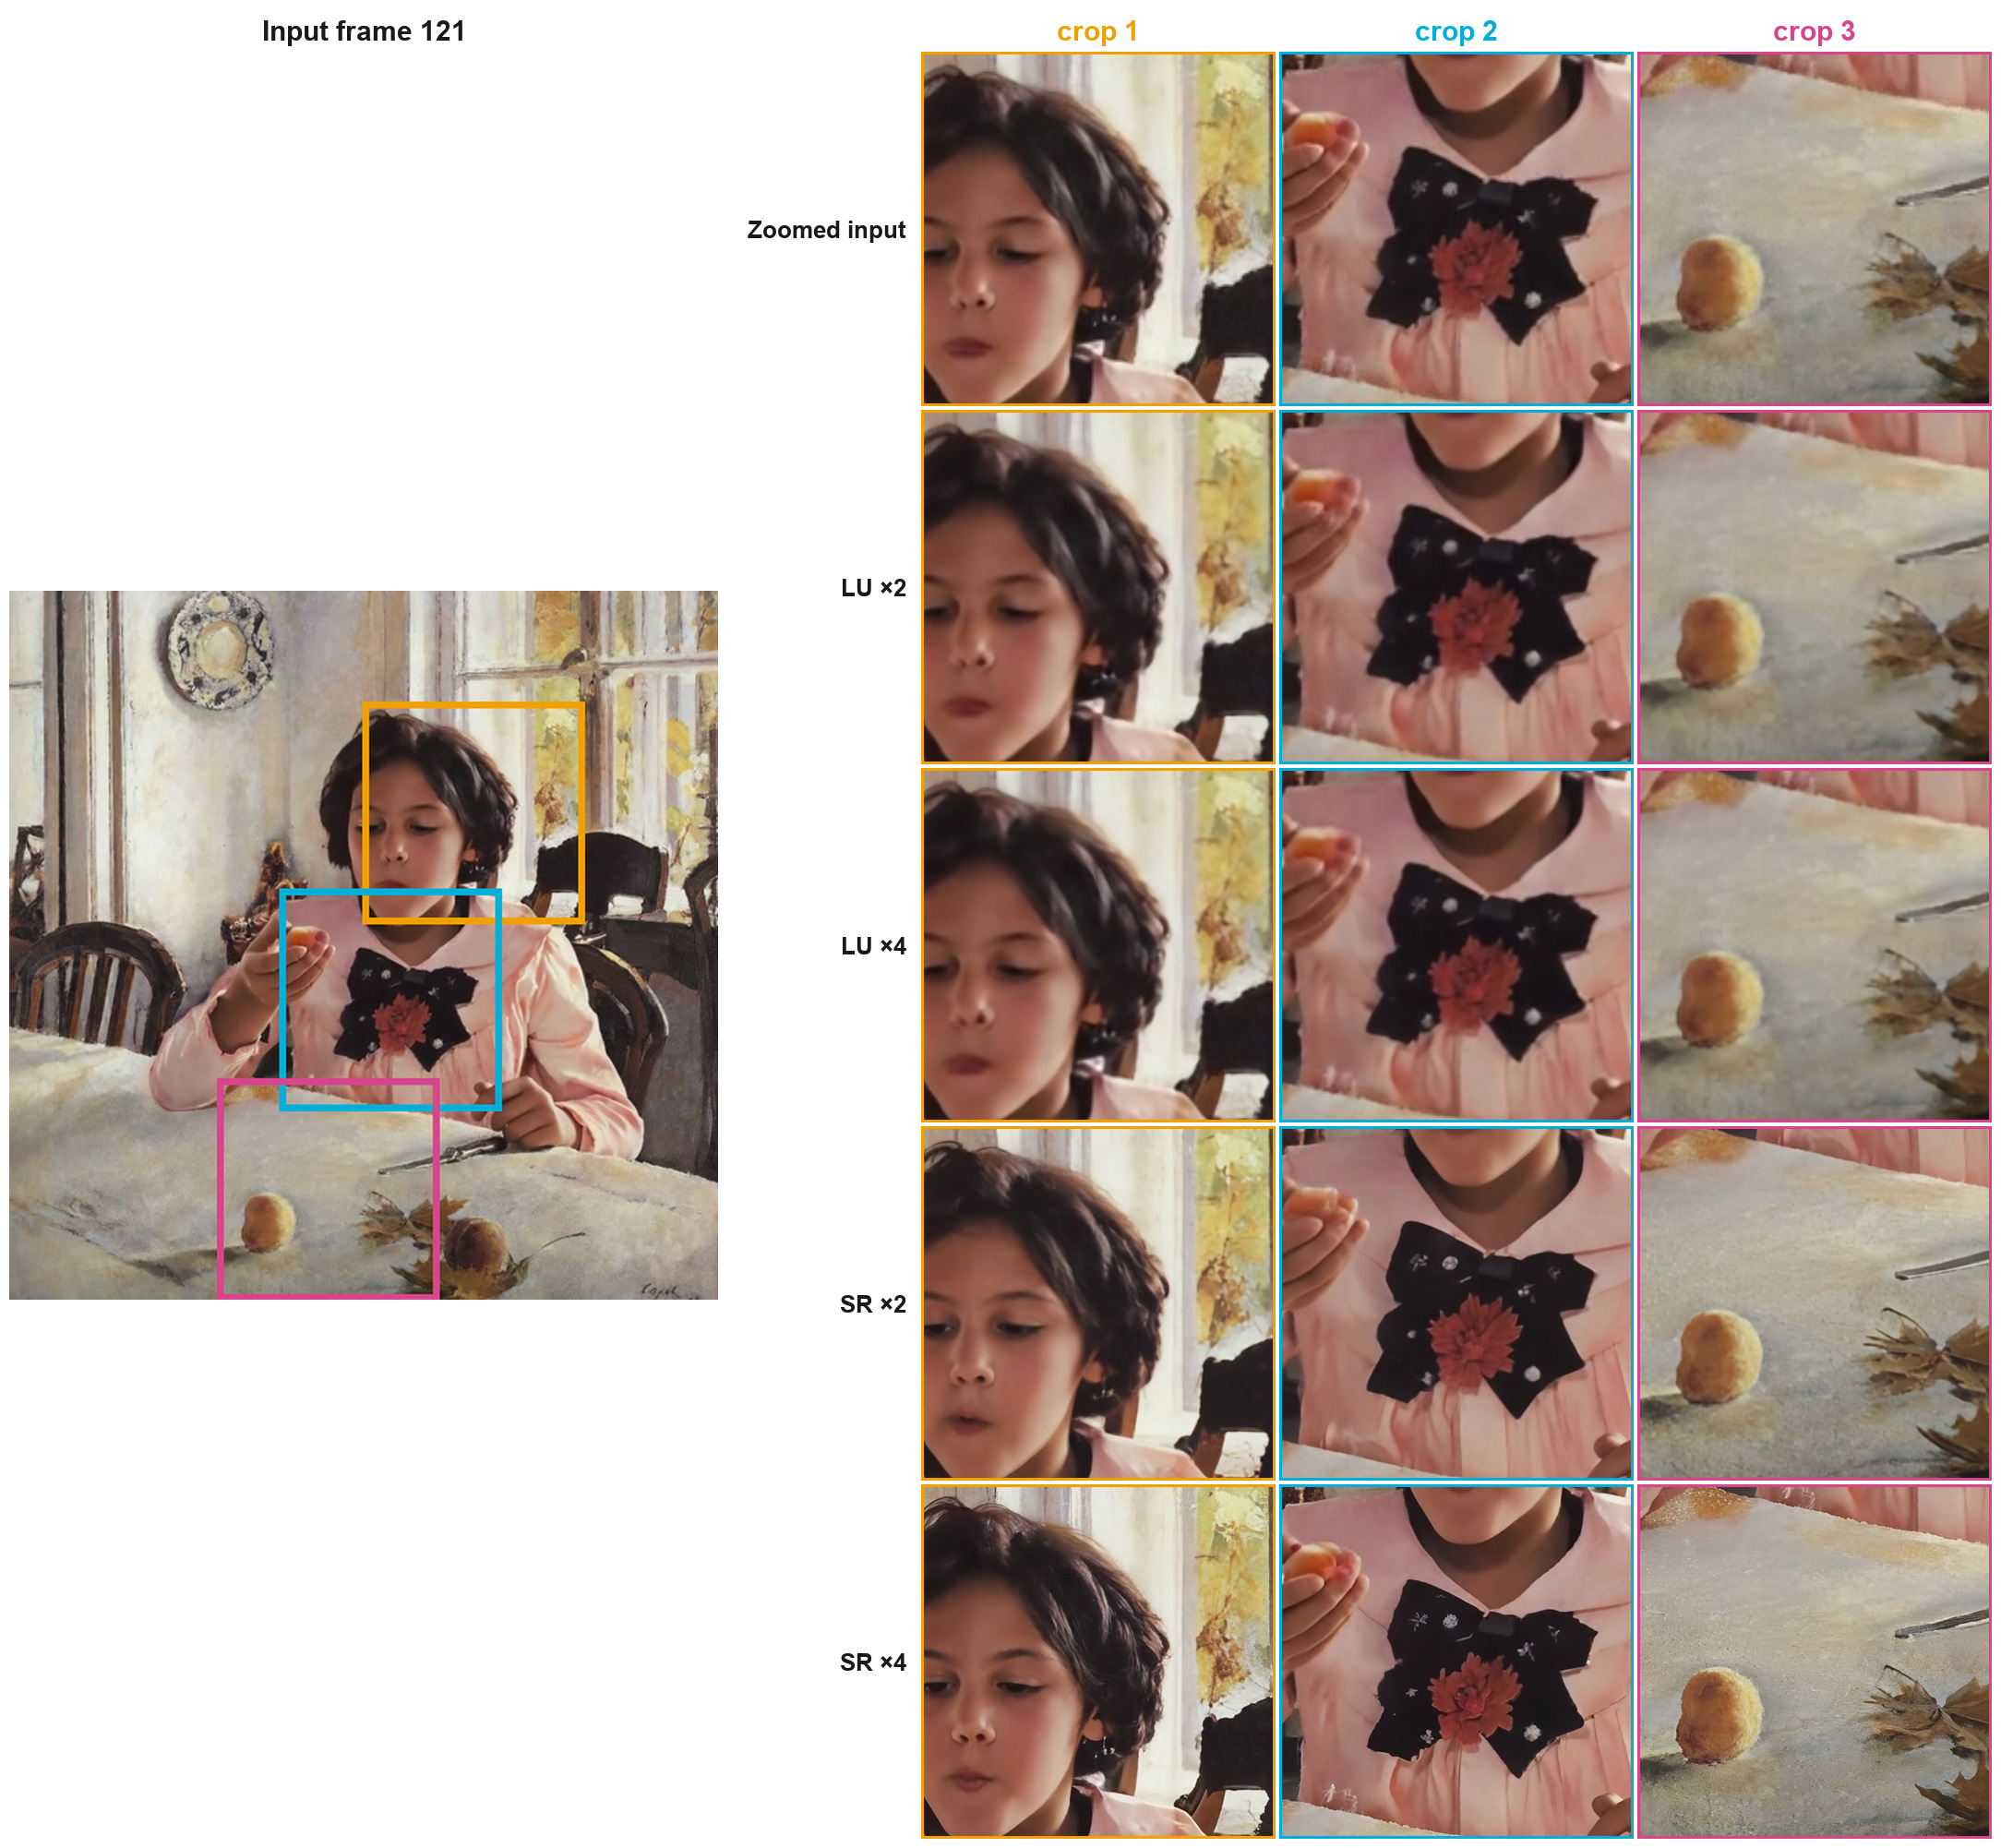
Оригинальный пример увеличения разрешения: исходный кадр, латентное увеличение и SR показаны вместе с увеличенными фрагментами.
Источник: Оригинальная иллюстрация · Kandinsky 6.0 VideoОграничения результата и направления дальнейшей работы
Границы результата: короткий SD-генератор с внешним SR, не решивший все проблемы качества и управления. Авторы прямо ограничивают ролики пятью секундами и нативное разрешение — SD. Full HD появляется через SR; остаётся отставание от сильнейших закрытых моделей по изображению и общему качеству аудио.
Планы: более длинные клипы, более высокое нативное разрешение, дополнительные условия по референсам. В SR предусмотрен интерфейс HQ-первого кадра, но текущая генерация его не использует.
Реалистичная речь и движения губ создают риск обманных подделок, имитации людей, дезинформации, мошенничества и травли. Авторы призывают получать согласие на изображение людей, маркировать синтетический контент и применять модерацию при публичном развёртывании.
Этический раздел также отмечает перекосы представления демографических групп, культур и языков, а также фактические, физические и культурные ошибки. Эти предостережения не являются доказательством наличия в выпущенной модели конкретного защитного механизма.
Исследовательский выпуск и возможность запуска на 16–32 GB GPU не следует превращать в утверждение об окупаемости, промышленном трафике, законченной системе безопасности или гарантированном качестве любого пользовательского запроса.
10 ConclusionИтог: путь от запроса к синхронному ролику
Kandinsky 6.0 Video объединяет создание изображения и звука в одном процессе генерации. Основная инженерная идея — сохранить сильный видеопоток и связать его с отдельно подготовленным аудиопотоком. Для высокого разрешения добавлен самостоятельный этап восстановления деталей.
- 01
Запрос и исходное изображение
Пользователь задаёт текстовую сцену и звук. В I2AV он дополнительно передаёт изображение, которое становится опорным кадром; в T2AV такого кадра нет.
- 02
Подготовка условий
Текстовые энкодеры создают представления запроса, а кодеки задают пространства видео и аудио. Для I2AV добавляются роль и позиция опорного кадра.
- 03
Совместная генерация
Два потока CrossDiT последовательно уточняют латенты видео и аудио, обмениваясь ключами и значениями через перекрёстное внимание. Так звук связывается с движением и событиями.
- 04
Восстановление результата
Видео- и аудиокодеки преобразуют латенты в кадры и звуковую дорожку. Базовый выход остаётся SD; звук синхронизирован с видеорядом.
- 05
Дополнительное Full HD
При выборе высокого разрешения отдельный конвейер кодирует видео в K-VAE, увеличивает латенты, обрабатывает перекрывающиеся тайлы SR-DiT, декодирует их и плавно объединяет.
Качество проверяли двумя способами: автоматическими метриками для изображения, речи и синхронизации и парными оценками людей по отдельным вопросам. В сравнении с Kandinsky 5.0 авторы показали заметное улучшение визуального результата; с современными конкурентами картина неоднородна. В частности, сильные стороны речи и отдельных визуальных критериев соседствуют с уступками по следованию запросу, движению и качеству аудио. Отдельные эксперименты подтверждают пользу RL и позволяют оценить компромисс дистилляции, но результаты разных наборов промптов нельзя объединять. Видеогенератор создаёт короткие клипы, а Full HD требует отдельного увеличения разрешения. Замеры скорости на GPU относятся к указанным аппаратным и программным конфигурациям, причём Table 10 использует недистиллированную основу. Отчёт представляет исследовательскую систему и её публичные компоненты, не измерение экономического эффекта работающего продукта.
10 Conclusion