YandexGPT как RAG-ассистент для техподдержки: решаем проблемы быстрее
Яндекс помогает операторам поддержки быстрее отвечать клиентам с помощью YandexGPT. В докладе — подготовка базы знаний, поиск документов, обучение генерации и результаты внедрения.
Видео · на русском
YandexGPT как RAG-ассистент для техподдержки: решаем проблемы быстрееЛена Вольф · ODS AI Ru · Опубликовано: 20 августа 2025 г.
Исходный доклад · Открыть оригинал
Зачем нужен помощник оператора
Лена Вольф начинает с ограничения полностью автоматической поддержки. У клиентов бывают проблемы, которых нет в документации, эмоционально сложные обращения и вопросы, для решения которых нужно связаться с другими людьми. Поэтому команда решила помогать опытным операторам, сохранив за ними проверку и отправку ответа.
Модель ищет подходящие документы и предлагает подсказку. Оператор может отправить её сразу или отредактировать. Этот инструмент назвали Яндекс Нейросаппорт.
Читать в оригиналеКак собирается запрос к модели
В систему поступает история переписки. Поиск находит документы в базе знаний, а повторное ранжирование помогает выбрать три наиболее подходящих фрагмента. К ним добавляют переписку и доступные сведения: устройство, версию приложения, город, состояние заказа.
Генеративная модель получает инструкцию составить подсказку оператору по этим данным. В примере доклада дата доставки ещё не наступила: ответ должен объяснить, что заказ идёт по плану, а не извиняться за задержку.
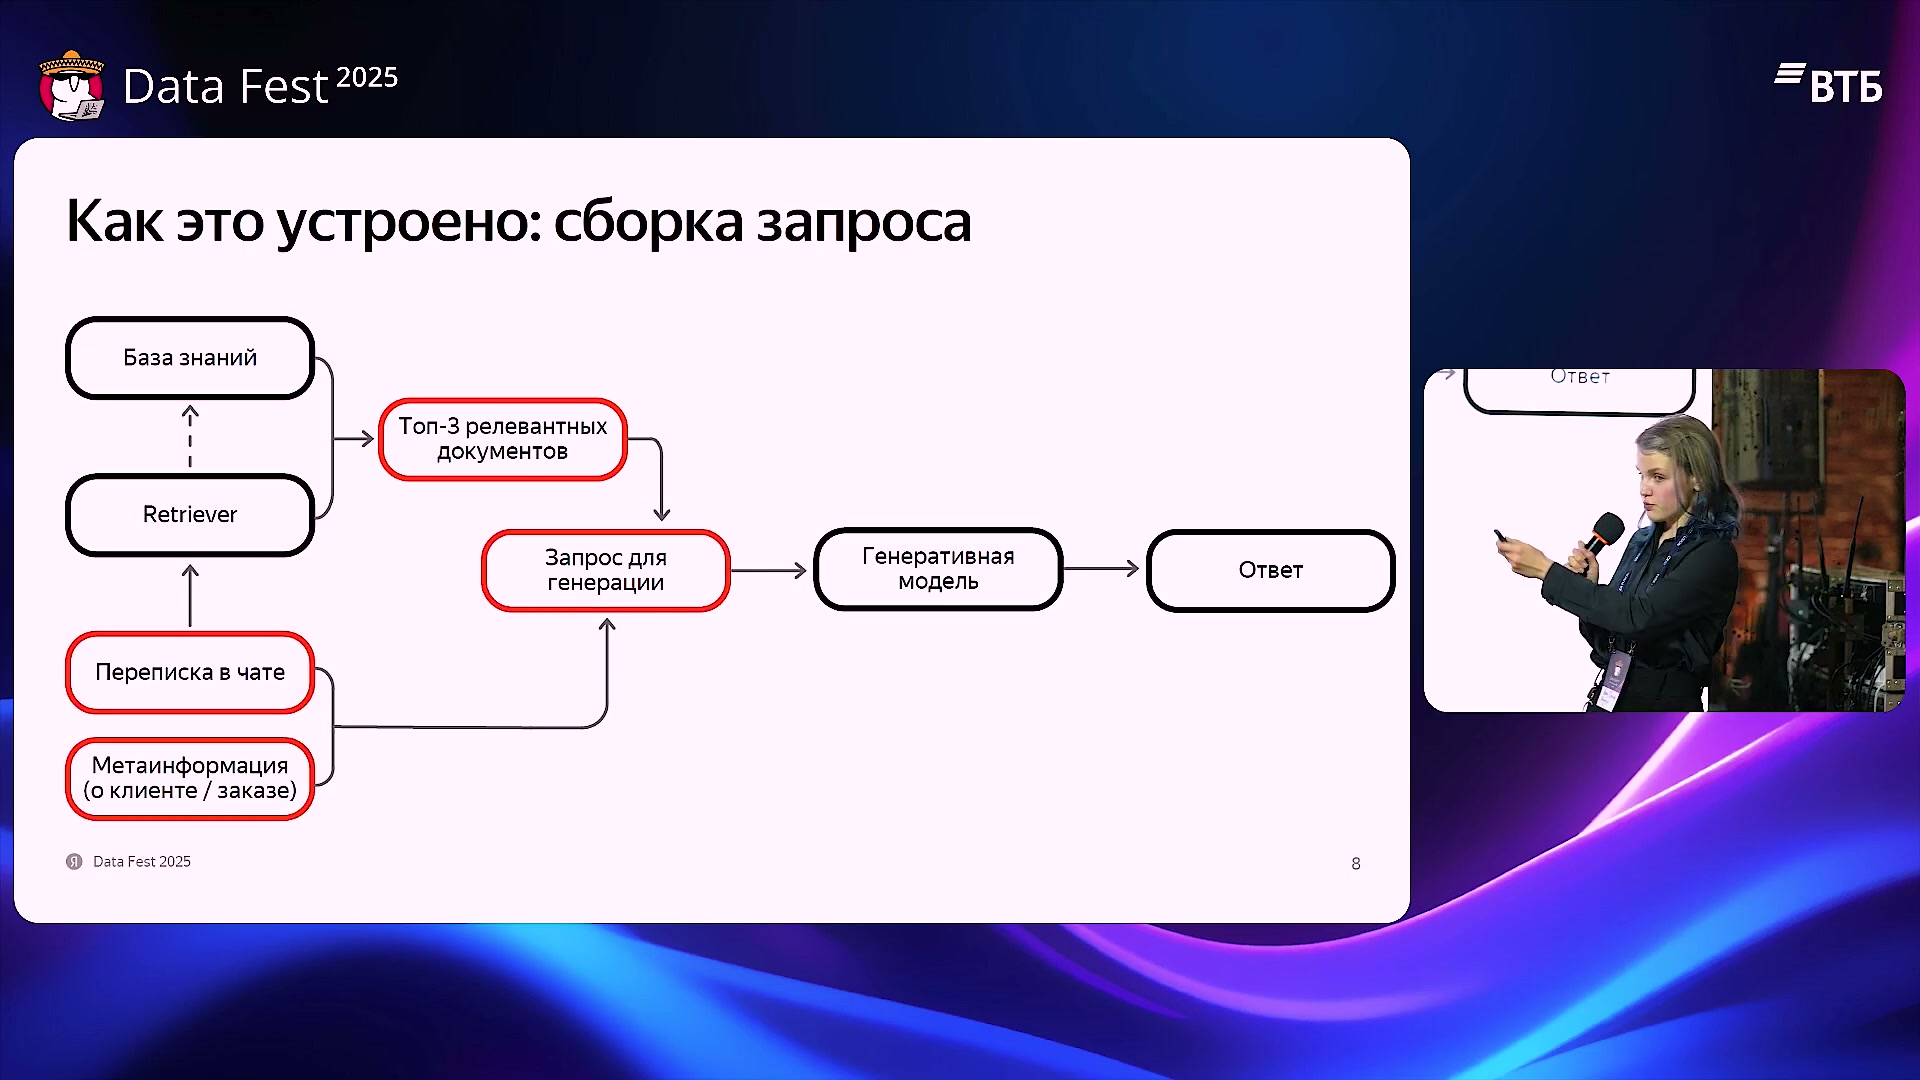
Сборка запроса: переписка, документы и метаинформация. Слайд из доклада Лены Вольф.
Подготовка базы знаний: от фиксированной длины к структуре
В базе оказались длинные документы с множеством ветвлений. Сначала их делили примерно по 500 токенов. Слова не разрывались, но важные фразы и шаблоны ответов могли оказаться в разных фрагментах.
В новой схеме шаблон сохраняют целиком. Если лимит позволяет, добавляют пояснения рядом с ним, затем подраздел и более крупный раздел. Размеры фрагментов становятся разными, зато инструкция сохраняет смысл. Слишком длинные служебные документы и ненужные страницы фильтруют.
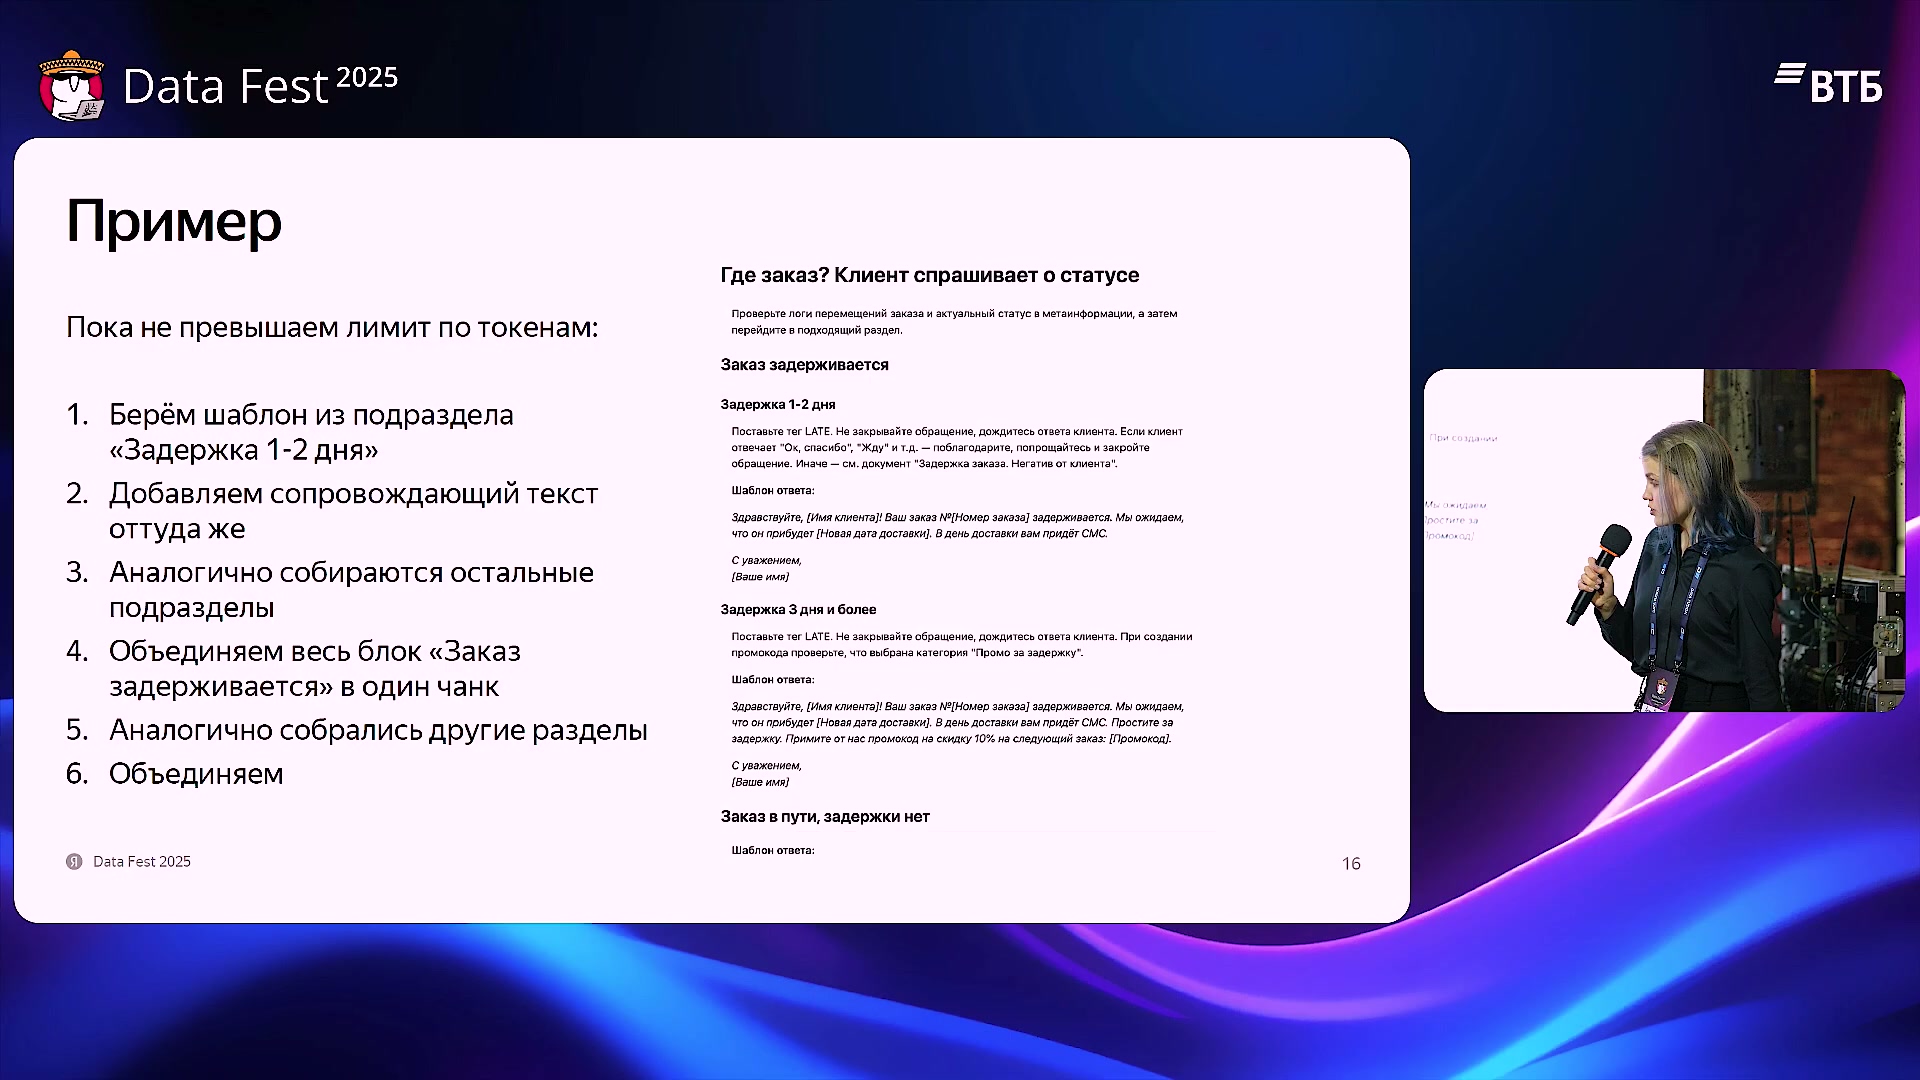
Пример иерархической нарезки инструкции о доставке. Исходный слайд, без перерисовки.
Как улучшали поиск документов
Опытные операторы разметили, какой фрагмент нужен для ответа на конкретный диалог. Поиск оценивали через HitRate@N: оказался ли нужный фрагмент среди первых N результатов. В топ-20 он находился часто, но в тройку для генерации попадал недостаточно хорошо.
Для обучения повторного ранжирования ассессорам давали пары «диалог — фрагмент» из топ-20 и просили оценить наличие решения. Ассессоры проходили обучение, экзамен и контроль качества. Результаты разметки и изменение HitRate@3 показаны прямо на слайде ниже.
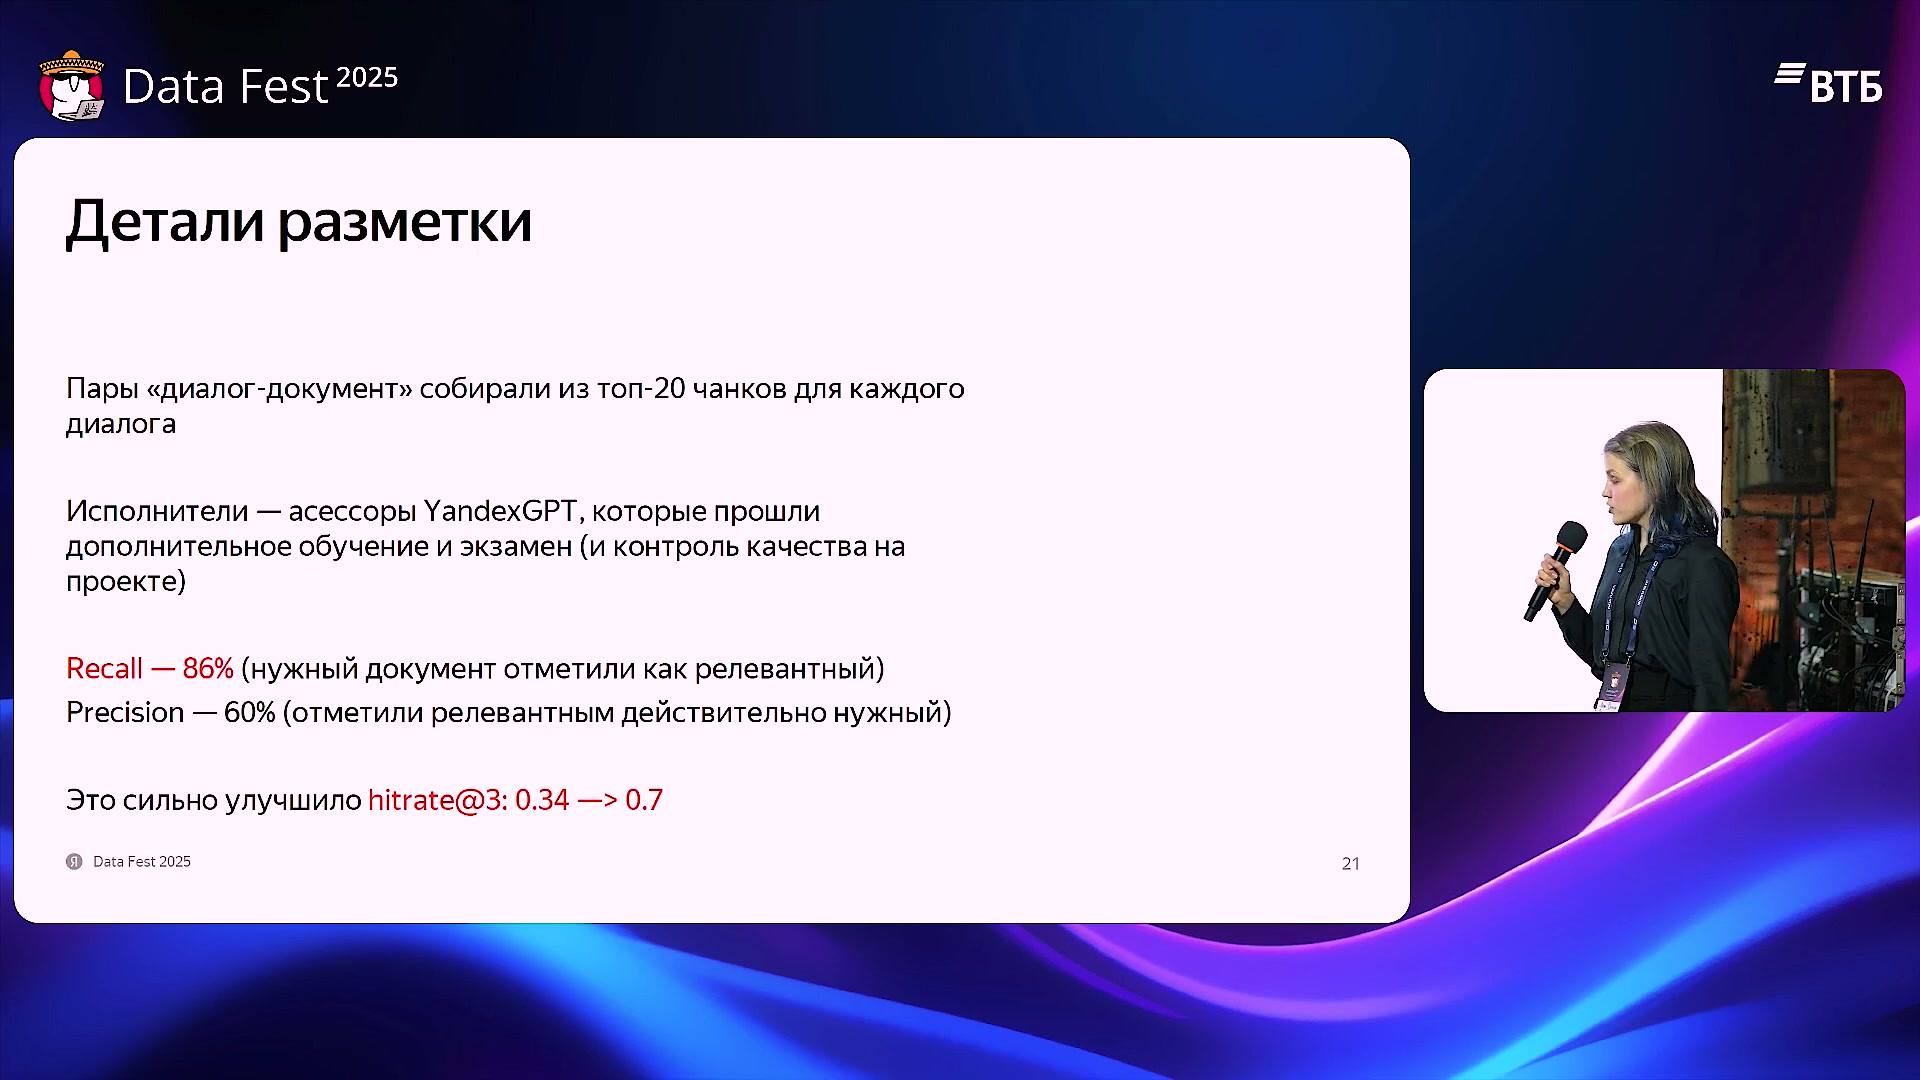
Разметка для ранжирования и HitRate@3: исходные числа на слайде автора.
На чём обучали генерацию
Логи операторов нельзя было использовать без проверки: ответ мог опираться на знания, которых нет в приложенных документах. Кроме того, ссылки операторов вели на целые документы, а система уже работала с фрагментами.
Команда отбирала примеры, где ответ действительно содержался в найденном контексте. Для проверки использовали текстовые эвристики, включая расстояние Левенштейна. Другую часть ответов размечали ассессоры, которым показывали только диалог и выбранные документы.
Если информации не хватает, модель должна отказаться от ответа. Такие отказы распознают и не показывают оператору как подсказку. Опытные сотрудники также оценивали качество генерации; по их замечаниям меняли системную инструкцию и дообучали модель.
Читать в оригиналеЧто получилось после внедрения
На итоговом слайде собраны заявленные результаты: изменение времени ответа, использование подсказок и клиентская оценка. Важно сохранять исходное условие: оператор остаётся в процессе и решает, что отправить клиенту.
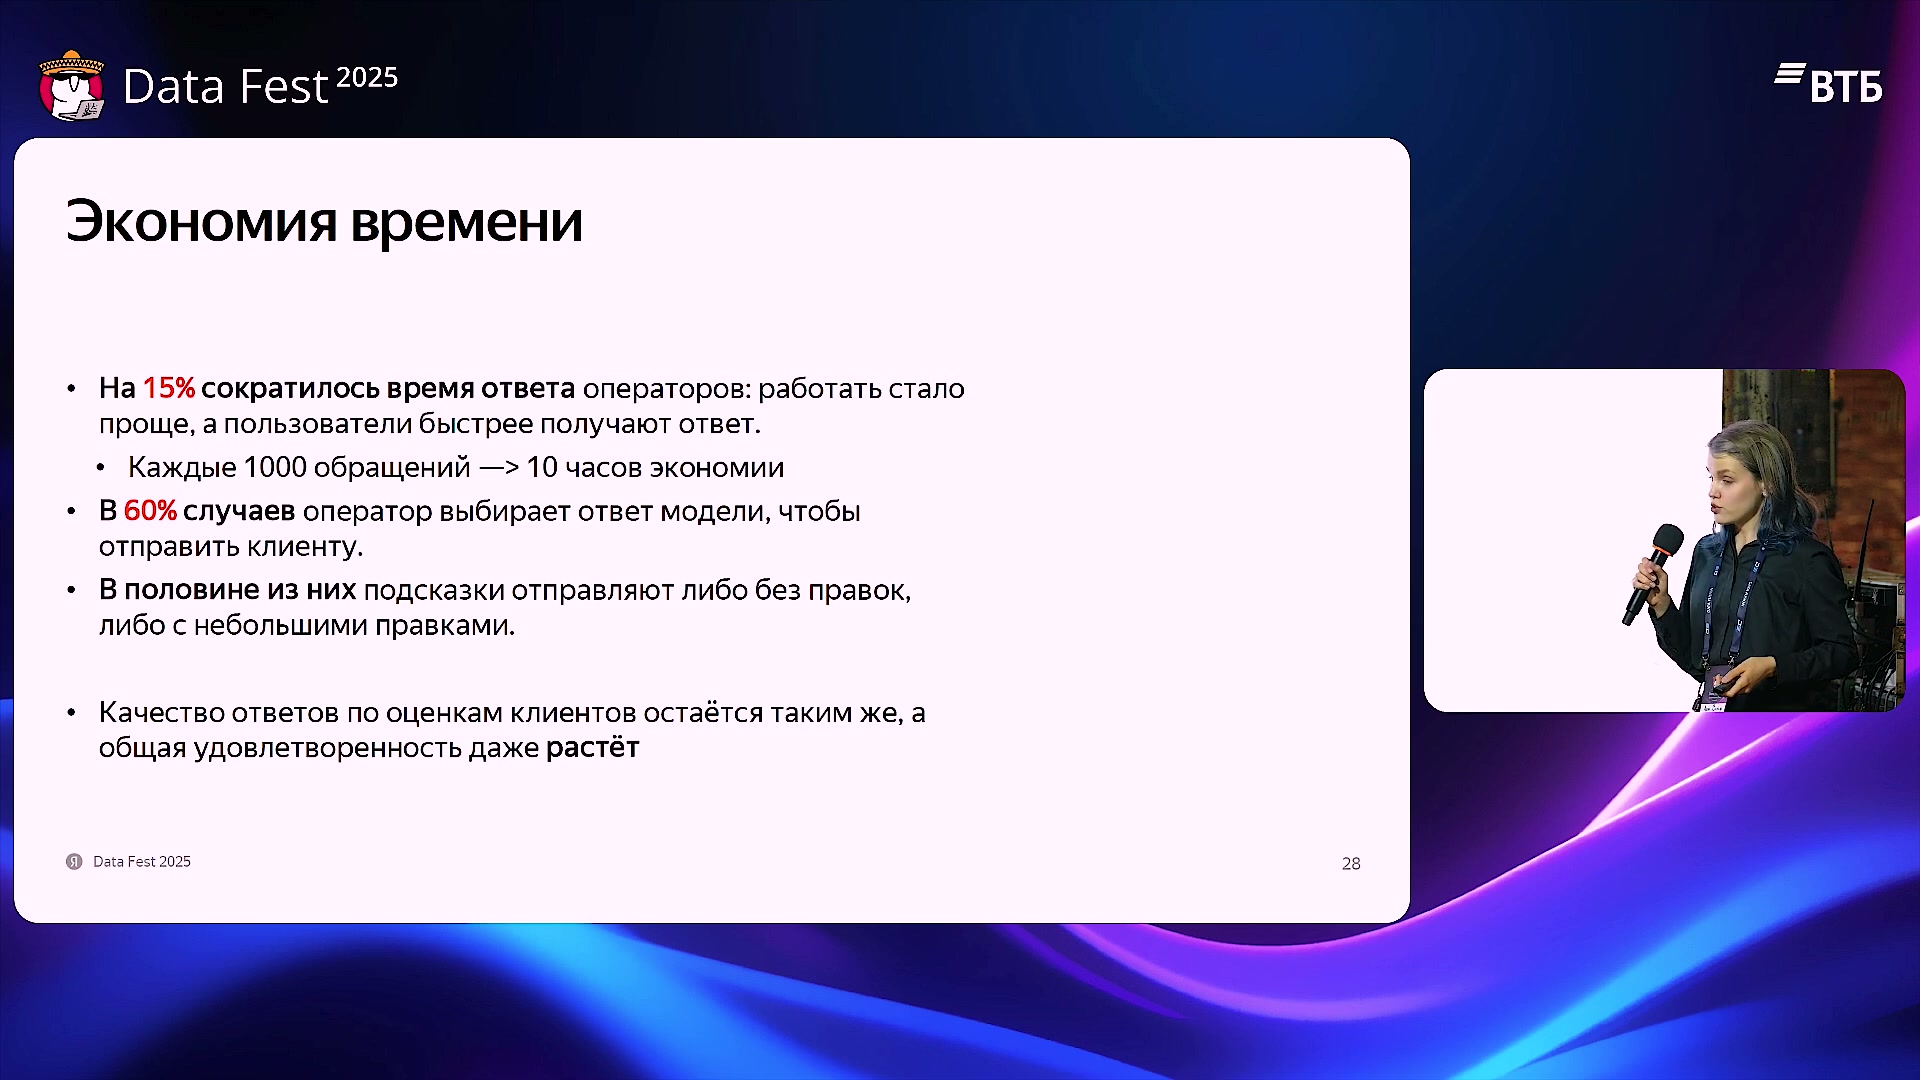
Экономия времени и использование подсказок. Итоговый слайд из исходной записи.
Уточнения из ответов на вопросы
- При коротком ответе на неоднозначный вопрос можно предложить два варианта. Если объяснения длинные, модель задаёт уточняющий вопрос.
- Деградацию качества отслеживают через обратную связь клиентов и повторные обращения.
- Порядок документов проверяли перемешиванием контекста; такие примеры добавляли в обучение.
- Устаревшие документы исключали по пометкам владельцев базы знаний и дополнительным фильтрам.