Сфера: от лексического поиска к помощнику поддержки
Специалистам поддержки нужно находить решения в документах и статьях базы знаний. Поиск по словам плохо справлялся с формулировками запросов. Объединить лексический и векторный поиск, уточнить порядок документов и вернуть ответ вместе с источниками.
Видео · на русском
Дмитрий Баканов | Make Retrieval Smarter: как мы делали умный поиск по базе документовДмитрий Баканов · Опубликовано: 13 августа 2025 г.
Исходный доклад · Открыть оригинал
Поиск должен укладываться в рабочие ограничения
Дмитрий Баканов из Иннотеха рассказывает о поиске в продукте «Сфера». Помощник нужен сотруднику поддержки: найти материалы для типового обращения и подготовить ответ с опорой на них. Изначально работал обычный поиск по словам.
На слайде заданы ограничения: новый документ должен попасть в индекс за 15 минут, ответ — появиться не позднее чем через 10 секунд. Исходная база содержит более 5000 статей и офисных документов. Эти числа описывают требования проекта; доклад не показывает распределение задержек на рабочем трафике.
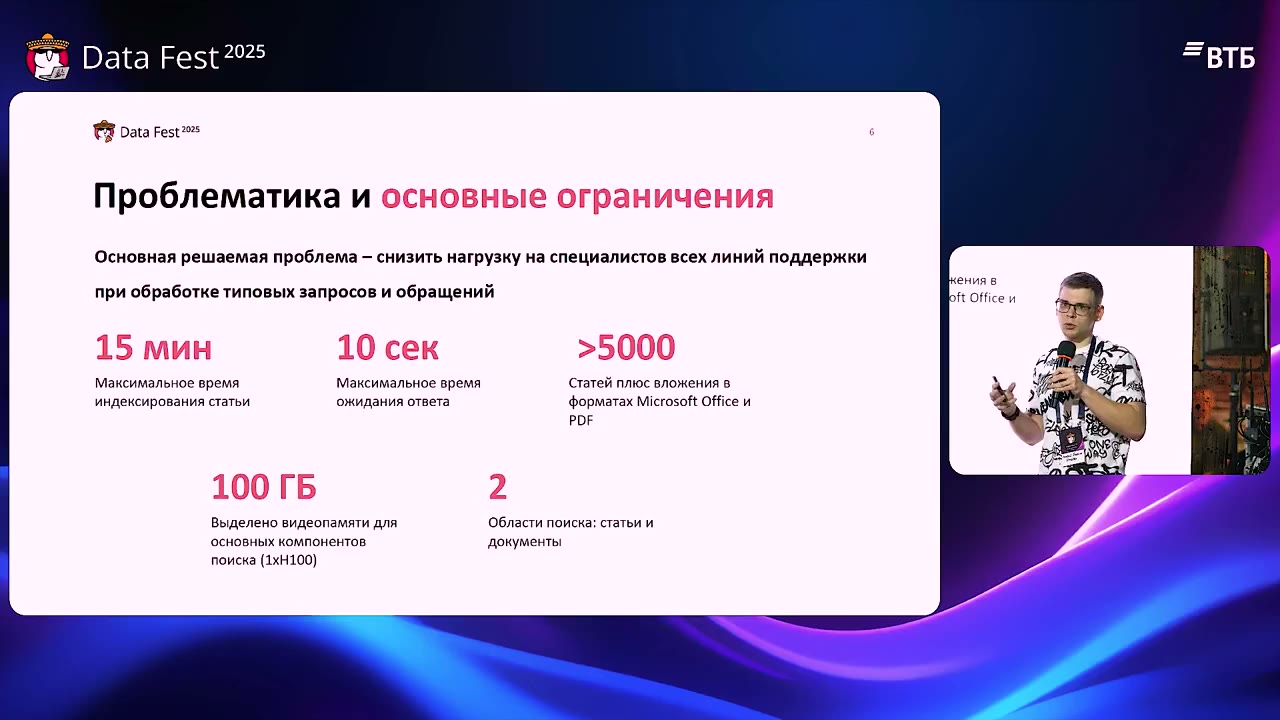
Требования к индексации, времени ответа и ресурсам.
Источник: Кадр из докладаЗапрос расширяют, результаты объединяют по позициям
Сначала система переформулирует вопрос и раскрывает внутренние сокращения с помощью словарей заказчика. Затем ищет по теме и содержимому статьи: одновременно по словам через BM25 и по близости векторов. Найденные документы проходят повторное ранжирование, а языковая модель готовит ответ в потоковом режиме.
Оценки двух видов поиска нельзя просто складывать: у них разные шкалы. Попытка нормализовать их сигмоидой дала низкие метрики. Команда перешла к Reciprocal Rank Fusion — объединению по местам документов в списках, а не по исходным численным оценкам.
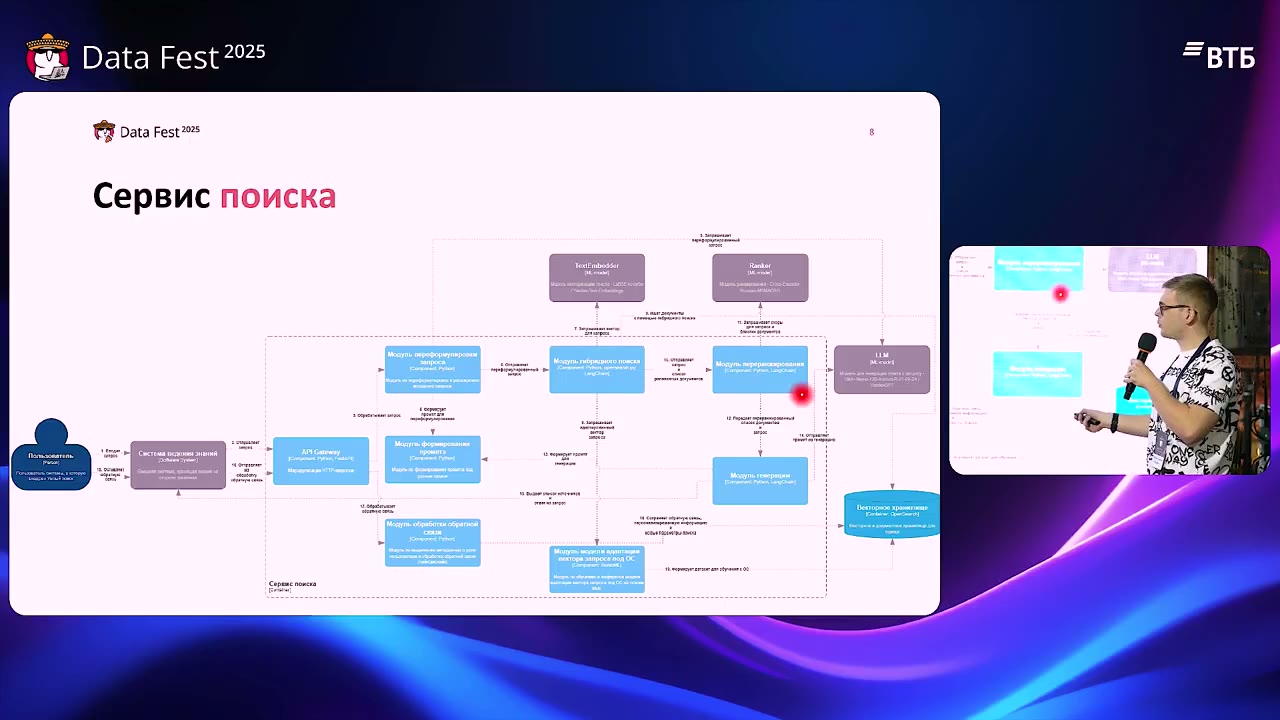
Устройство сервиса поиска.
Источник: Кадр из докладаДля поиска нужен короткий фрагмент, для ответа — более широкий контекст
Документ разбивают на небольшие фрагменты и сохраняют связи с соседними. Поиск идёт по короткому фрагменту, а перед генерацией система добавляет окружающий текст. Так уменьшают шум при поиске, не оставляя модель без необходимых пояснений. Автор называет этот подход Small2Big.
Для повторного ранжирования сравнивают MMR, который учитывает разнообразие фрагментов, и более затратный cross-encoder: модель совместно читает вопрос и найденный текст. Выбор конфигурации зависит от доступных ресурсов.
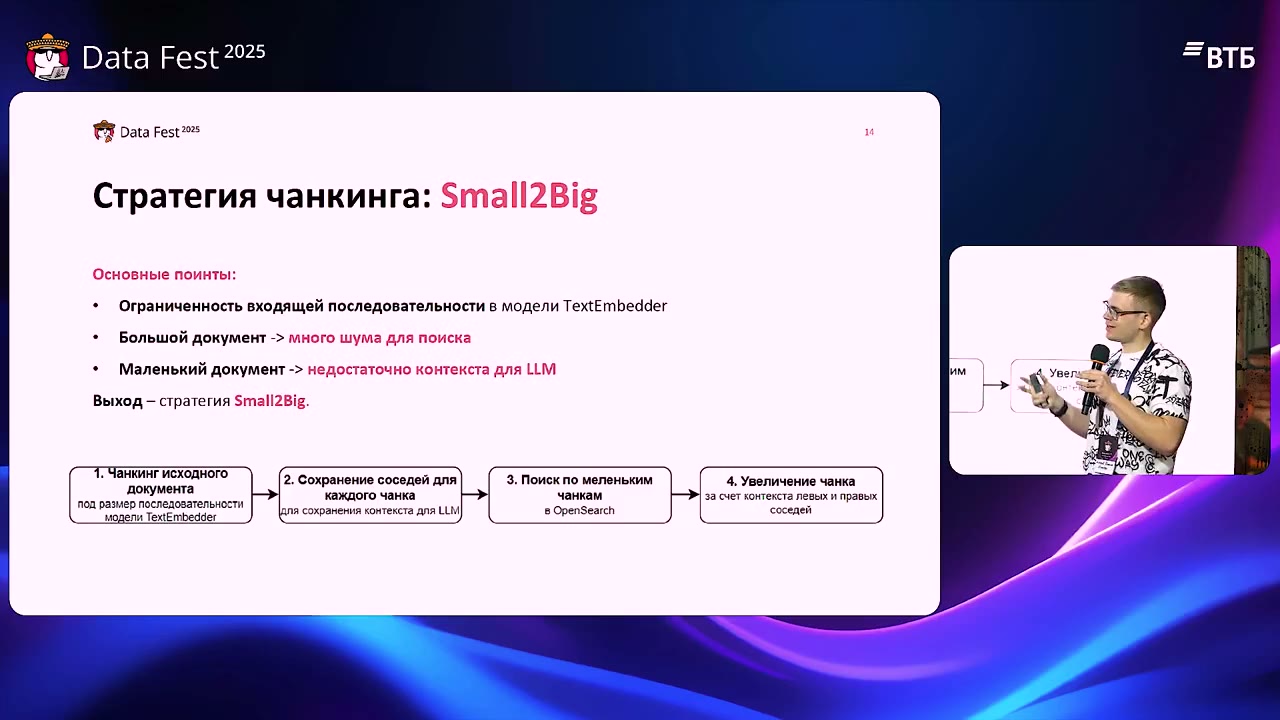
Поиск по коротким фрагментам и восстановление контекста.
Источник: Кадр из докладаОценка поиска и оценка ответа решают разные задачи
Аналитики размечают вопросы и подходящие документы. MRR@5 показывает, насколько высоко находится первый подходящий результат, но не оценивает весь контекст для ответа. Поэтому отдельно добавляют проверку полезности контекста и качества генерации языковой моделью-судьёй. Совпадение слов тоже измеряют, однако правильные перефразировки делают такую оценку неполной.
В таблице доклада исходная конфигурация LaBSE, cross-encoder и Vikhr имеет MRR@5 0,22. Итоговая конфигурация с дообученным LaBSE, cross-encoder и RRF — 0,802. В строках меняется несколько компонентов: приписывать весь прирост одному RRF нельзя. Отдельной строкой показан вариант на моделях Яндекса.
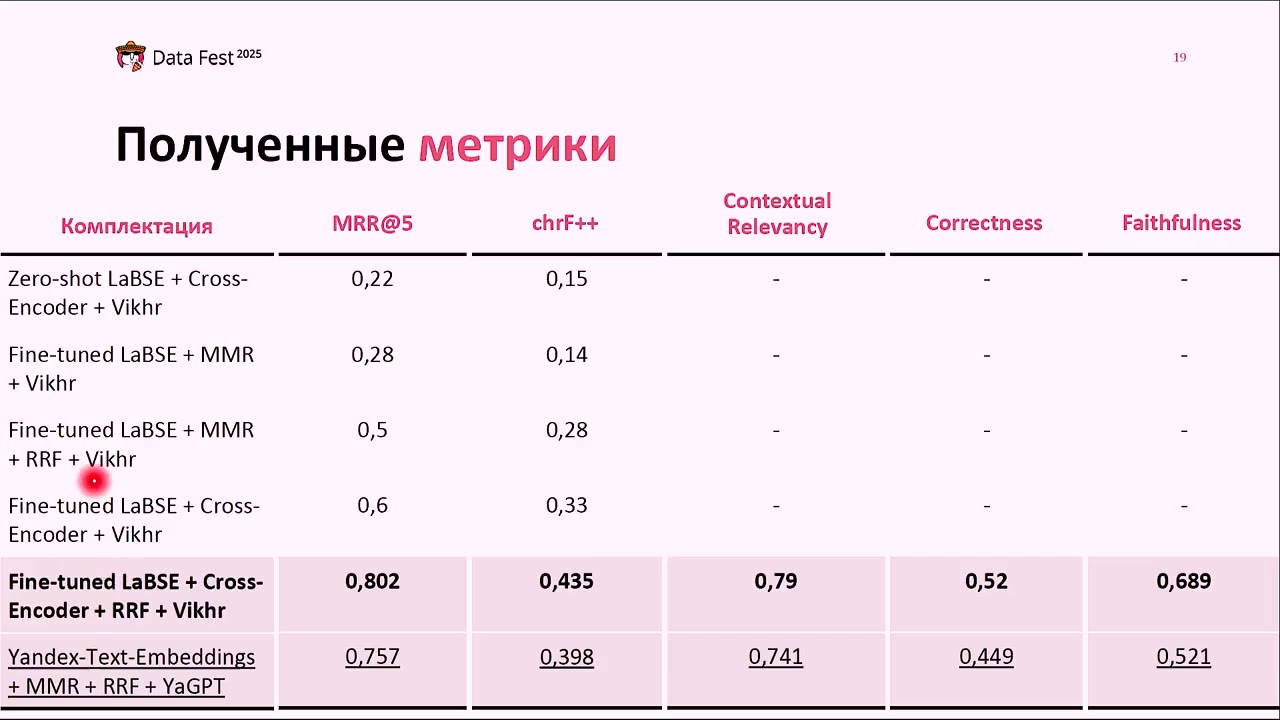
Сравнение конфигураций на размеченной выборке.
Источник: Кадр из докладаЧто внедрили и что ещё оставалось экспериментом
По словам автора, помощник встроен в «Сферу»: пользователь вводит вопрос, получает ответ и ссылки на документы. Система развёрнута в Kubernetes; подготовка документов отделена от обработки запроса.
На момент выступления адаптация вектора запроса по обратной связи ещё экспериментальная. Генерация с промежуточными рассуждениями не дала хорошего результата, и этот вариант отложили. Мультимодальный поиск также назван направлением дальнейшей работы, а не готовой возможностью.
18:45 — фрагмент доклада