Поиск в Лавке: зачем одновременно нужны BM25, DSSM и CatBoost
Покупатель ищет смысл, бренд или ещё не доученный моделью новый товар. Выдача при этом должна учитывать конкретный склад и личные предпочтения. Несколько источников кандидатов дополняют друг друга, после чего отдельные модели фильтруют нерелевантное и ранжируют оставшееся.
Статья · на русском
Разбираем на запчасти поисковый сервис в Яндекс ЛавкеНиколай Смирнов · Опубликовано: 10 июля 2025 г.
Поиск привязан к складу
В описанном сервисе около 100 тысяч товаров и тысячи складов, на каждом доступна лишь часть ассортимента. Поэтому проверку наличия делают рядом с отбором кандидатов, до дорогих признаков.
Для каждого склада хранится компактный вероятностный фильтр. Он быстро отбрасывает отсутствующие ID, допуская ложное присутствие, но не теряя добавленный в фильтр товар. Пользовательские данные поступают из быстрого key-value-хранилища.
Этот фрагмент в оригиналеДанные и модели поставляются отдельно
Сервис написан на C++ с userver. Сведения о товарах и заранее рассчитанные статистики приходят в shard-файле несколько раз в сутки. Признаки запроса записываются в лог и позднее соединяются с пользовательскими действиями по идентификатору запроса.
Ранжирующую модель учат на обновлении корзины. DSSM регулярно дообучают на новом ассортименте: даже хорошо работающая сеть со временем хуже обрабатывает появившиеся названия и бренды.
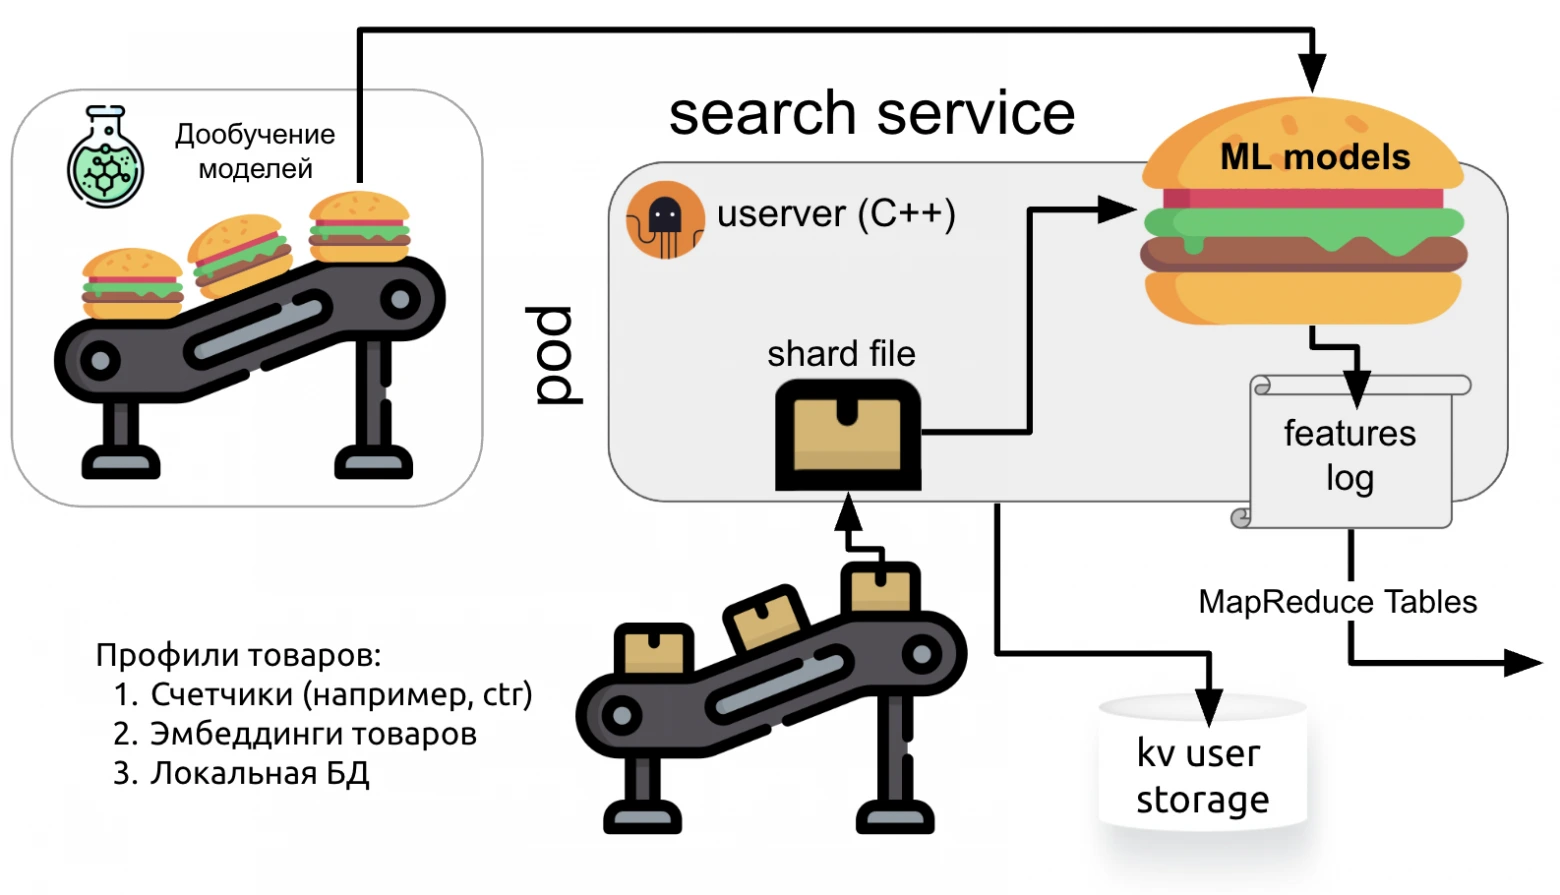
Доставка моделей и признаков в поисковый сервис.
Источник: Иллюстрация из оригиналаТри способа найти кандидата
CartUpdate DSSM обучается связывать запрос с товаром по покупательским действиям. Другая DSSM получает знания от BERT и помогает с пониманием смысла. BM25 ищет совпадения текстовых элементов через инвертированный индекс.
Векторные представления товаров рассчитывают заранее, а запрос — в момент поиска; ближайшие товары находят через HNSW. Но буквальное совпадение остаётся полезным: в примерах статьи новый бренд находил BM25, пока нейросетевые модели ещё не справлялись.
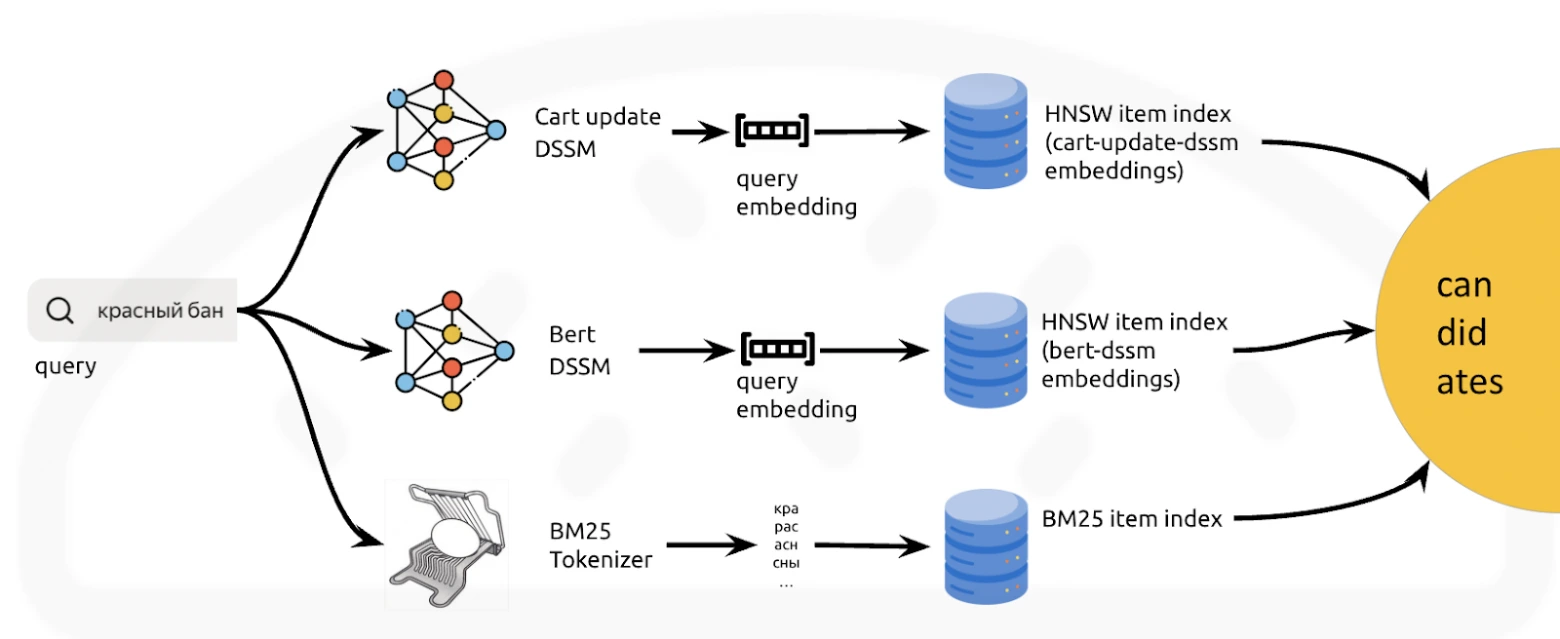
Три источника кандидатов для поисковой выдачи.
Источник: Иллюстрация из оригиналаФильтрация и порядок выдачи решают разные задачи
После объединения кандидатов каждый получает оценки всех источников. Один CatBoost использует их для отсечения нерелевантных товаров по разметке пар «запрос–товар». Особенно важно не путать обязательные свойства вроде отсутствия глютена с просто похожим названием.
Другой CatBoost ранжирует уже допустимые варианты по вероятности целевого действия. Личные счётчики покупок помогают поднять привычный пользователю продукт. Таким образом, семантическая уместность и персональная привлекательность не смешиваются в одну проверку.
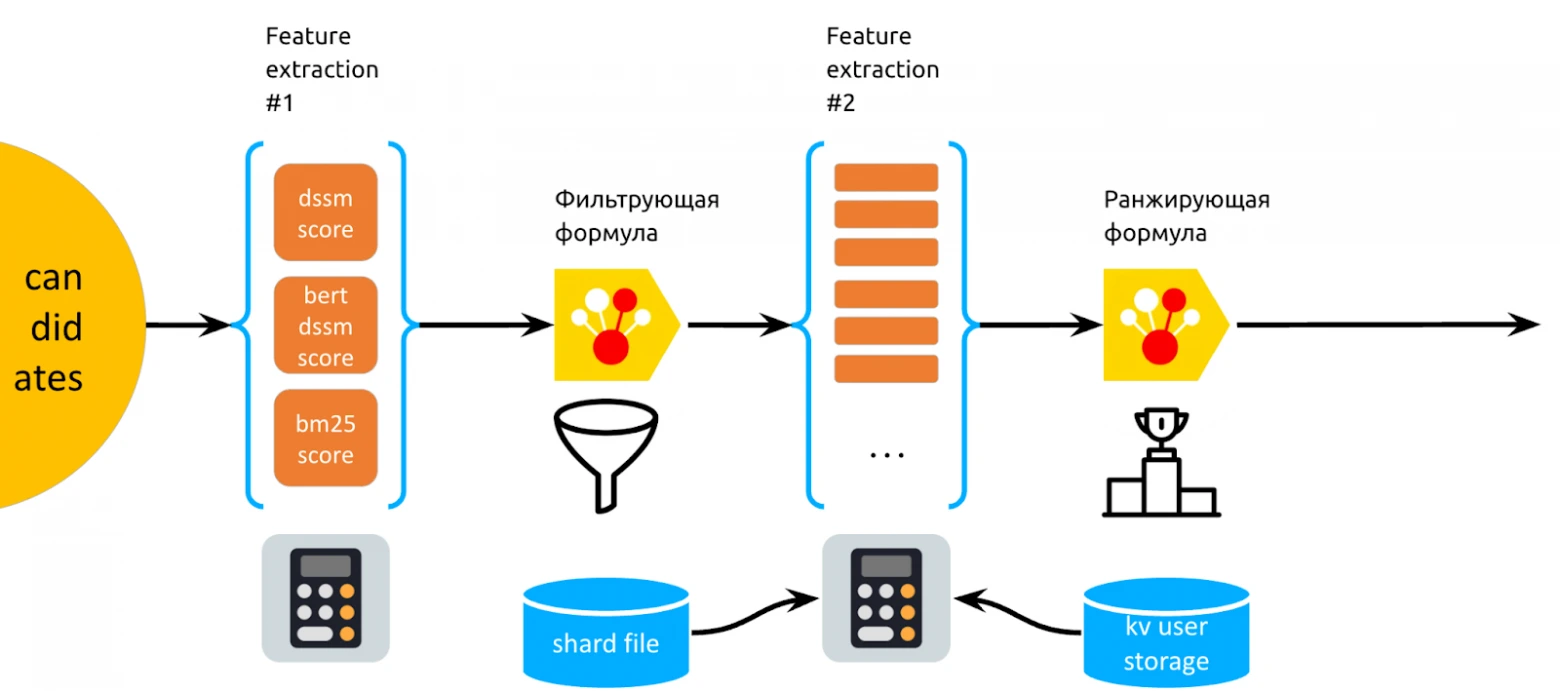
Фильтрация и ранжирование кандидатов.
Источник: Иллюстрация из оригинала