Разбор готов
Agentic Vision в Яндексе: как модель учили рассуждать и пользоваться инструментами
В Alice AI модель отвечает на вопросы пользователей по изображениям. В прежней системе дополнительную информацию для неё заранее собирали распознавание текста и поиск, но этот контекст нередко оказывался лишним. При нескольких изображениях становилось ещё сложнее определить, что именно нужно уточнить, не переполнив доступный модели контекст. Одновременно рассуждающая открытая модель стала выигрывать у решения Яндекса в парных оценках ответов. Команда начала развивать подход, в котором модель сама определяет нехватку информации, обращается к инструментам и продолжает решение с полученными результатами. Разберём весь путь: сбор и фильтрацию рассуждений, обучение с подкреплением, ошибки данных и инфраструктуры, отрицательный эксперимент с простым подключением функций и переход к обучению полной последовательности действий.
Материал полезен инженерам и исследователям, знакомым с обучением нейросетей, но ещё не строившим рассуждающие модели для изображений. Он объясняет, как связаны обучающие примеры, проверка ответов и исполнение инструментов. Тем, кто уже работает с такими системами, будут полезны отрицательные результаты команды, условия сравнений и ограничения переноса экспериментов.
Видео · на русском
Agentic Vision: как научить VLM рассуждать и использовать инструментыДанил Кашин · Опубликовано: 19 сентября 2026 г.
Исходный доклад · Открыть оригинал
С чего начиналась система: изображение, текст и внешний контекст
Разбор основан на докладе Данила Кашина «Agentic Vision: как научить VLM рассуждать и использовать инструменты» на Practical ML Conf 2026, его оригинальных слайдах и ответах на вопросы. Автор представляет работу команды мультимодальных моделей Яндекса. Мультимодальность здесь означает, что модель получает информацию не только в виде текста, но и в виде изображений.
Визуально-языковая модель, или VLM, обрабатывает изображение вместе с текстовым вопросом. Текст разбивается на токены — единицы входной последовательности, а изображение преобразуется в визуальные токены. Из этих двух частей модель формирует текстовый ответ. На исходной схеме показан конкретный пример: пользователь спрашивает о коте «На чём он сидит?», и по изображению нужно понять, что он сидит на арбузе.
Автор разделяет качество такой системы на три составляющие. Первая — восприятие: насколько хорошо модель различает нужную информацию на картинке. Вторая — знания, полученные при предварительном обучении на текстах и изображениях. Третья — способность связать увиденное и известное с вопросом пользователя. Ошибка может возникнуть в любой из этих частей, поэтому одного улучшения распознавания недостаточно для всех задач.
В работавшей системе Alice AI к изображению и запросу добавляли внешний контекст. Его собирали визуальный поиск, распознавание текста на изображении — OCR — и формирование запроса с последующим текстовым поиском. В выступлении также упомянуты дополнительные теги. Изображение поступало в VLM и непосредственно, а не только через результаты внешних обработчиков. Поиск помогал получать сведения за пределами знаний, сохранённых в параметрах модели.
Прежний подход развивали как инструктивную модель — модель, обученную отвечать на пользовательскую инструкцию. Качество отслеживали в парных сравнениях ответов, или side-by-side, сокращённо SBS. На одинаковых запросах сопоставляют ответы двух систем и определяют, какой лучше. Это оценка ответов на выбранной корзине запросов, а не бизнес-эксперимент на пользовательском трафике.
Для отслеживания релизов постоянным соперником оставили GPT-4o. Так изменение доли побед отражало развитие моделей Яндекса относительно одной базы. Между версиями v2_pro и v7_pro доля побед Alice AI выросла с 26,6% до 49,3% — на 22,7 процентного пункта. Здесь важно сохранить единицу: это разность двух долей, а не относительный рост на 22,7%.
Таблицу можно прокрутить по горизонтали.
Отдельно YaVLM_v7_pro сравнили с другими сильными моделями на русскоязычной корзине RU SBS. Эти результаты отвечают уже на другой вопрос: не как развивалась серия релизов, а как конкретная версия выглядит относительно разных соперников. У неё было преимущество над Qwen3-VL 235B, но не над двумя другими участниками.
Таблицу можно прокрутить по горизонтали.
Таким образом, исходная история не сводится к безусловному превосходству одной системы. Последовательное обучение инструктивных моделей работало, разрыв с фиксированной базой сокращался, а сравнение с открытой моделью было благоприятным. Но это преимущество относилось к конкретным версиям и условиям оценки.
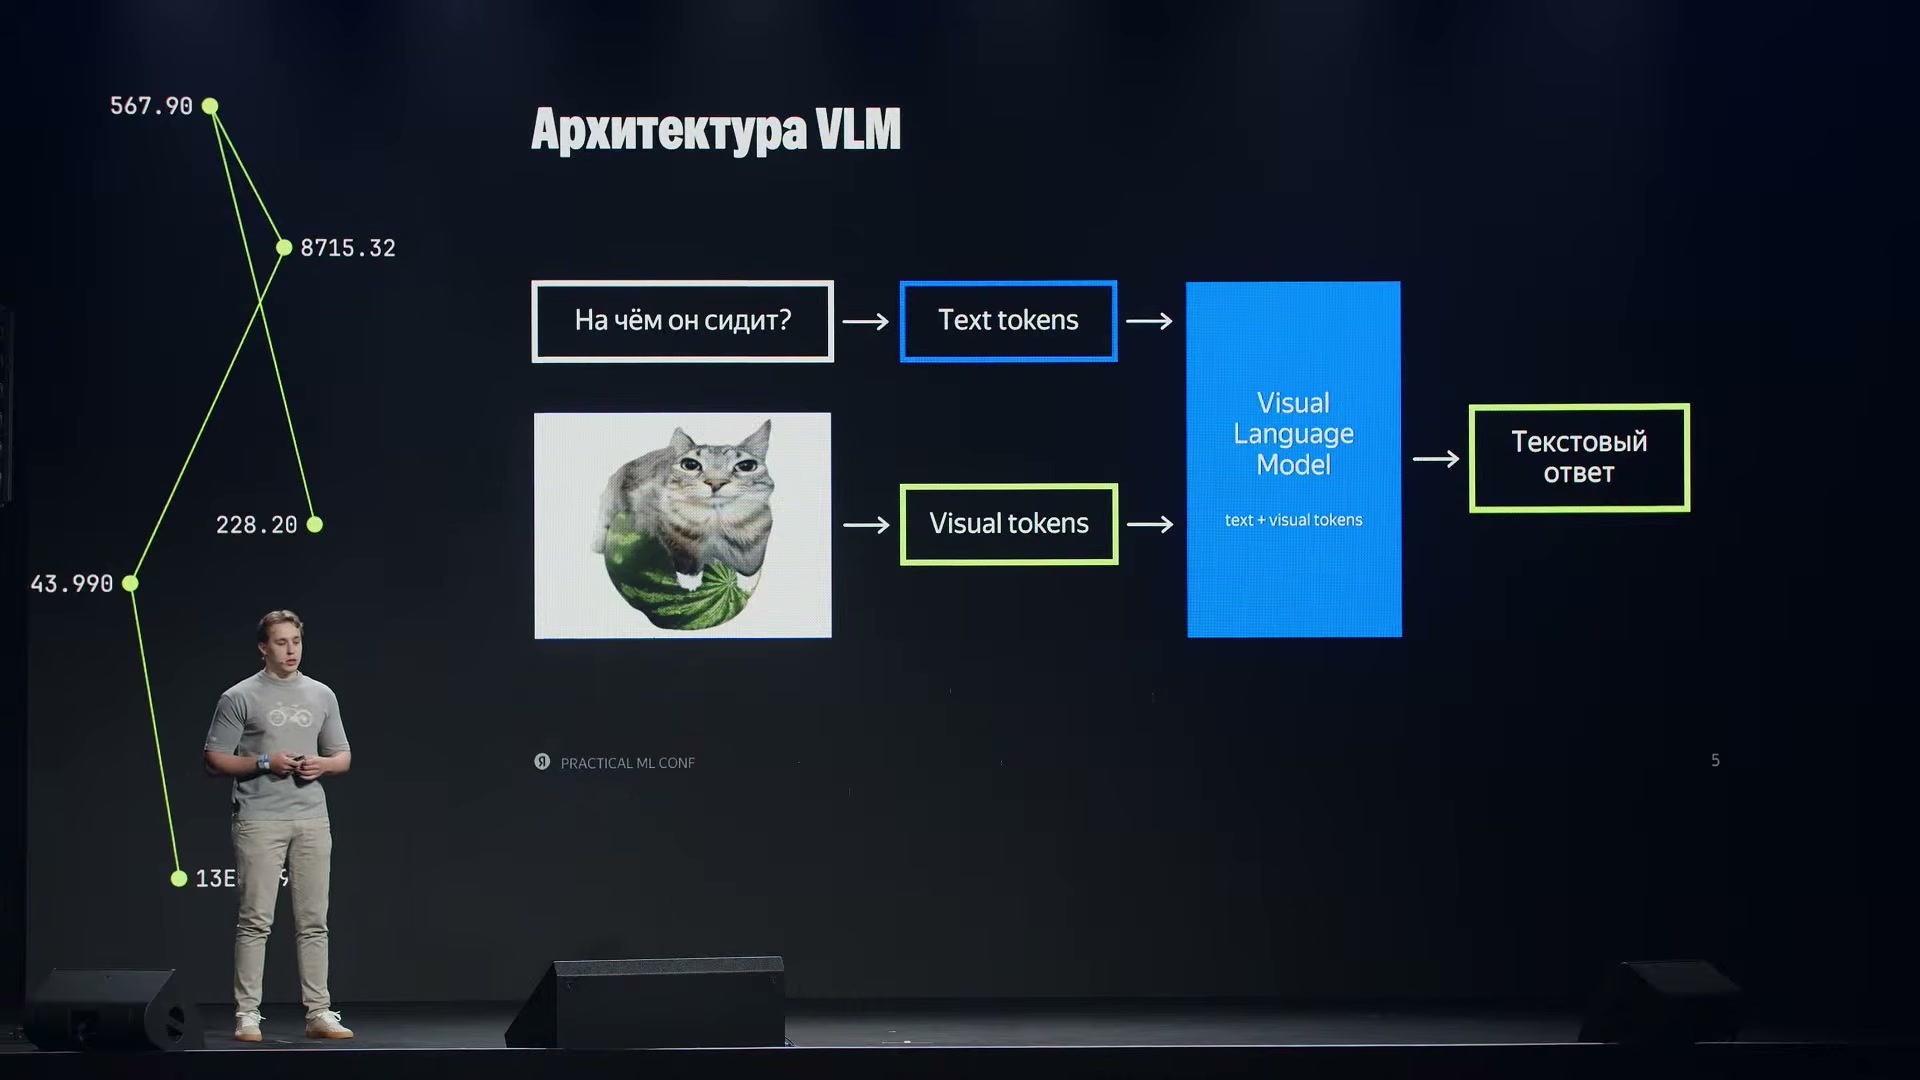
Вопрос о коте превращается в текстовые токены, изображение — в визуальные. VLM использует обе части для текстового ответа.
Источник: Данил Кашин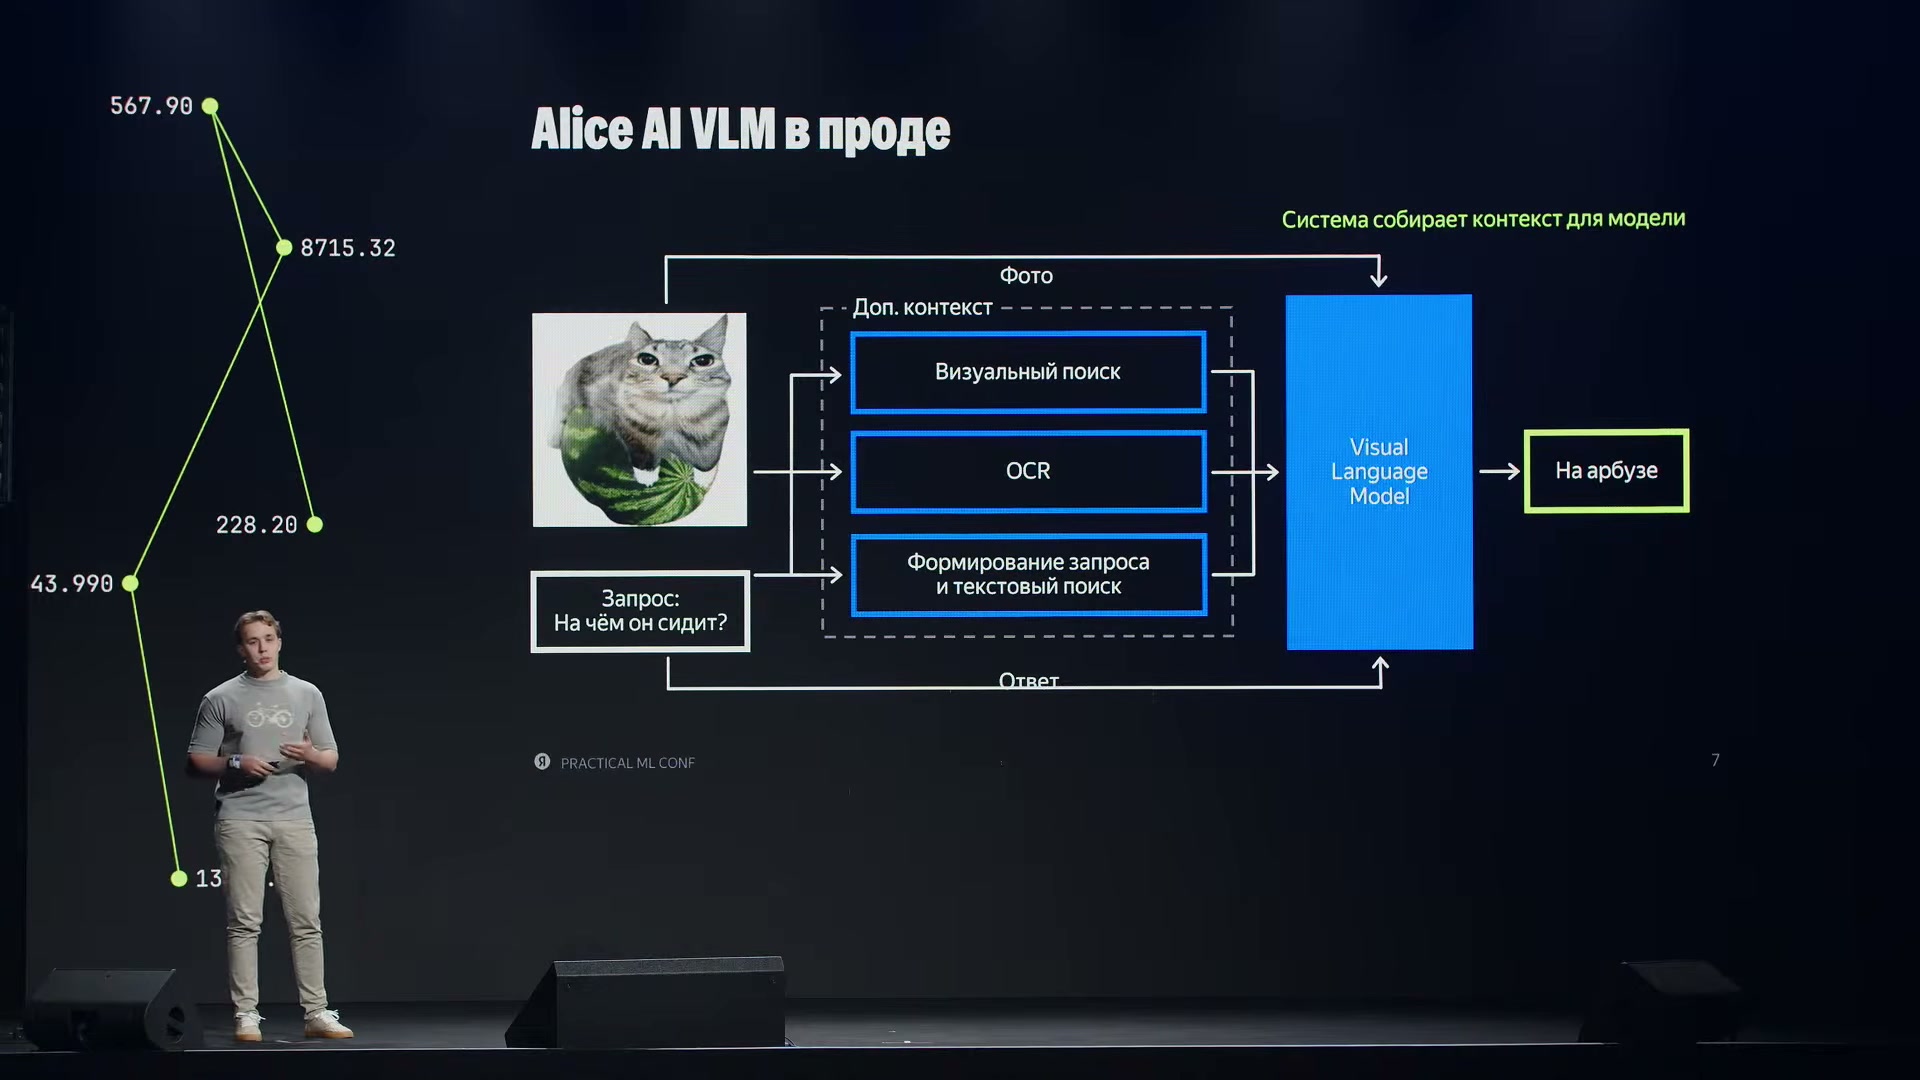
Прежняя Alice AI VLM получает изображение и заранее подготовленный контекст от визуального поиска, OCR и текстового поиска.
Источник: Данил Кашин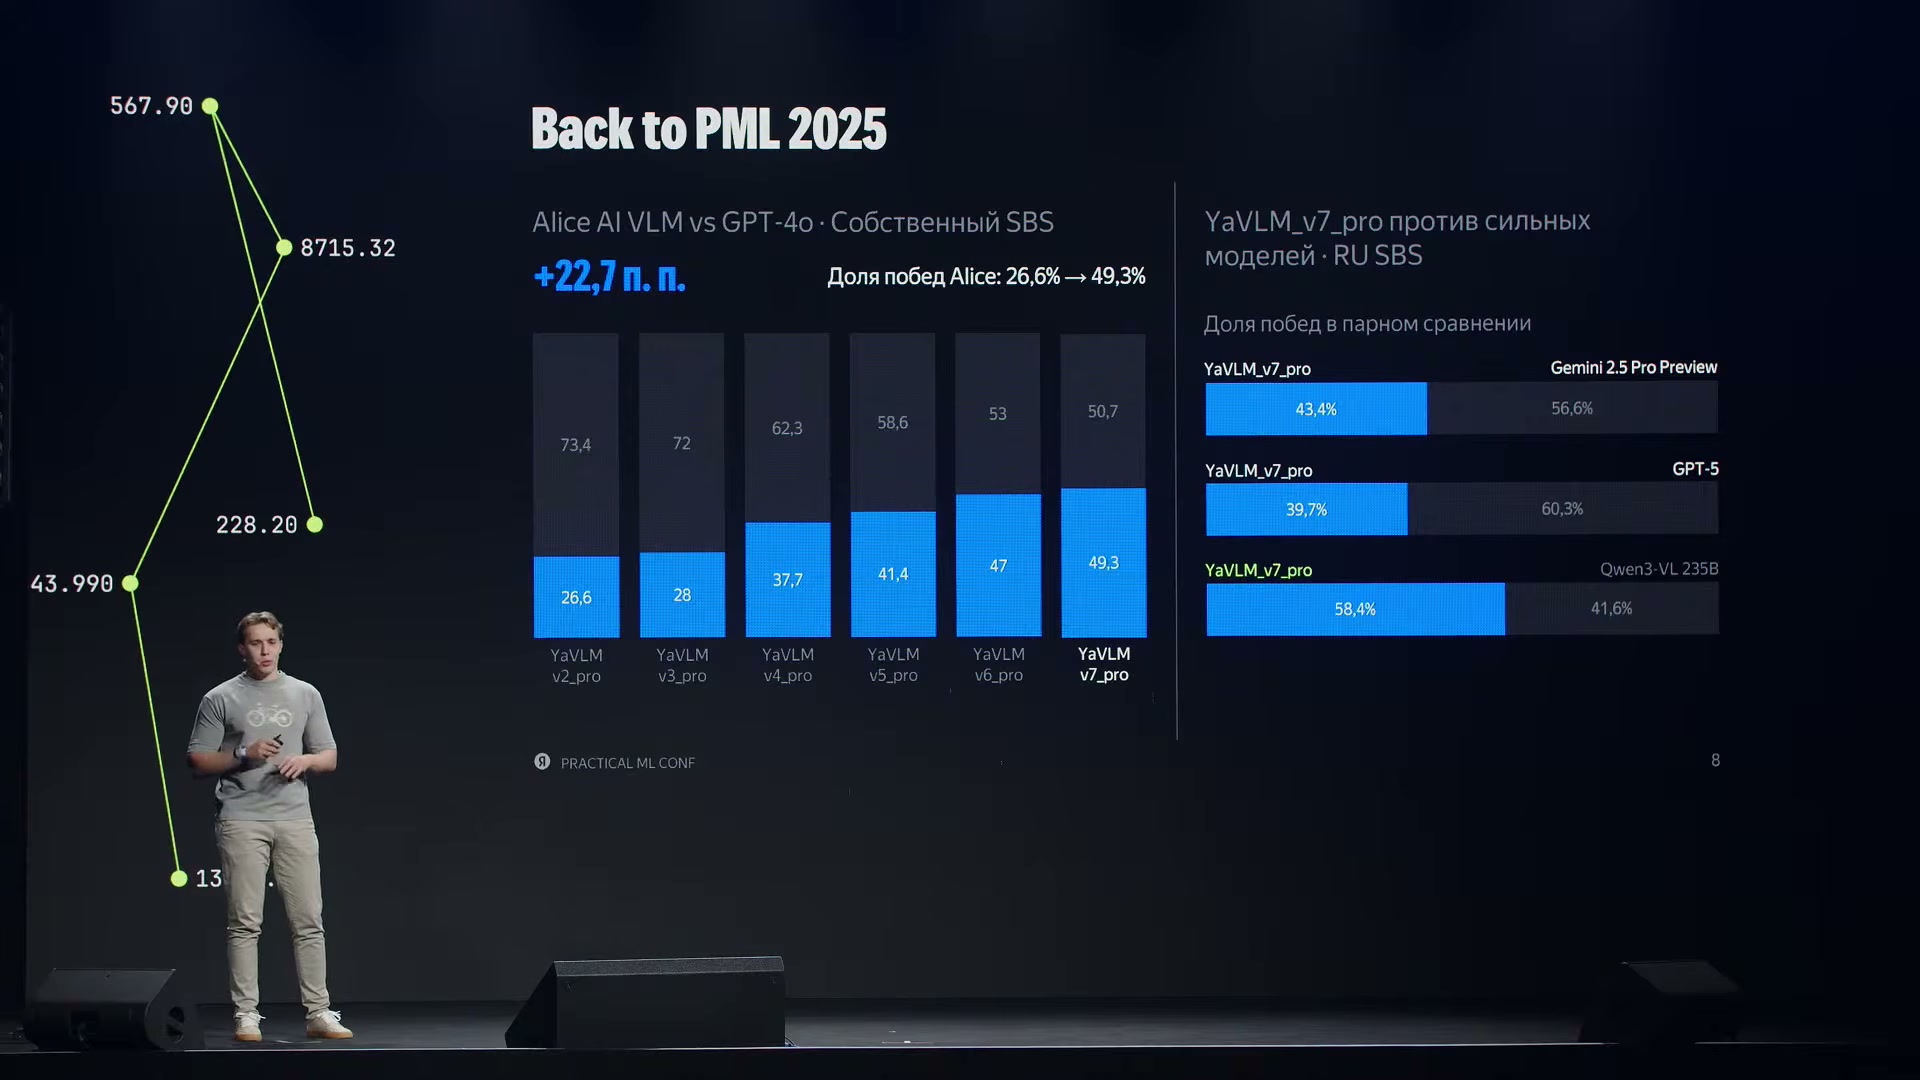
Слева доля побед Alice AI против фиксированной GPT-4o растёт с 26,6% до 49,3%. Справа отдельные сравнения YaVLM_v7_pro показывают преимущество над Qwen3-VL 235B, но не над Gemini 2.5 Pro Preview и GPT-5.
Источник: Данил КашинПочему выбор дополнительной информации передали самой модели
Следующее сравнение изменило исходную картину. YaVLM_v8.1_pro сопоставили с Qwen3.5-397B-A17B в двух режимах: без рассуждений и с рассуждениями. В первом случае модель Яндекса имела небольшое преимущество по доле побед. Во втором преимущество перешло к Qwen.
Таблицу можно прокрутить по горизонтали.
Это сравнение показало ценность рассуждающего режима именно для выбранной SBS-корзины. В ответах на вопросы автор уточнил, что здесь не использовались вызовы инструментов: сопоставляли качество ответов моделей, а не работу разных внешних сред. Доли побед нельзя читать как доли правильно решённых задач или показатели активности пользователей.
У прежней системы было и самостоятельное архитектурное ограничение. Визуальный и текстовый поиск полезны не для каждого вопроса. Когда их результаты добавляют заранее, вместе с полезными сведениями модель получает нерелевантную информацию. Для нескольких изображений возникает дополнительная неопределённость: по какой картинке нужно искать уточнение? Искать по каждой тоже плохо, потому что заполняется контекстное окно — ограниченный объём информации, доступной модели при формировании ответа.
Команда сформулировала новое требование: модель должна сама замечать, каких сведений ей не хватает, выбирать уточнение и учитывать полученный результат. После этого она должна снова решить, готова ли ответить или требуется продолжить работу. Так в докладе определяется Agentic Vision: выбор информации переходит от заранее заданной последовательности обработчиков к самой модели.
Различие хорошо видно в двух схемах. Раньше система сначала собирала подготовленный контекст, затем передавала его VLM и получала ответ. Теперь текущее состояние модели приводит к выбору действия, действие даёт новое наблюдение, а наблюдение обновляет состояние. После этого возможен следующий шаг либо остановка с ответом.
Такой подход затрагивает все три составляющие качества. Восприятие можно дополнять внешними моделями компьютерного зрения и операциями над изображением. Знания — уточнять повторными запросами в текстовый и мультимодальный поиск. Рассуждение помогает связать исходные данные и новые результаты с задачей пользователя. Смысл изменения не в том, чтобы всегда добавлять больше информации, а в том, чтобы выбирать необходимую.
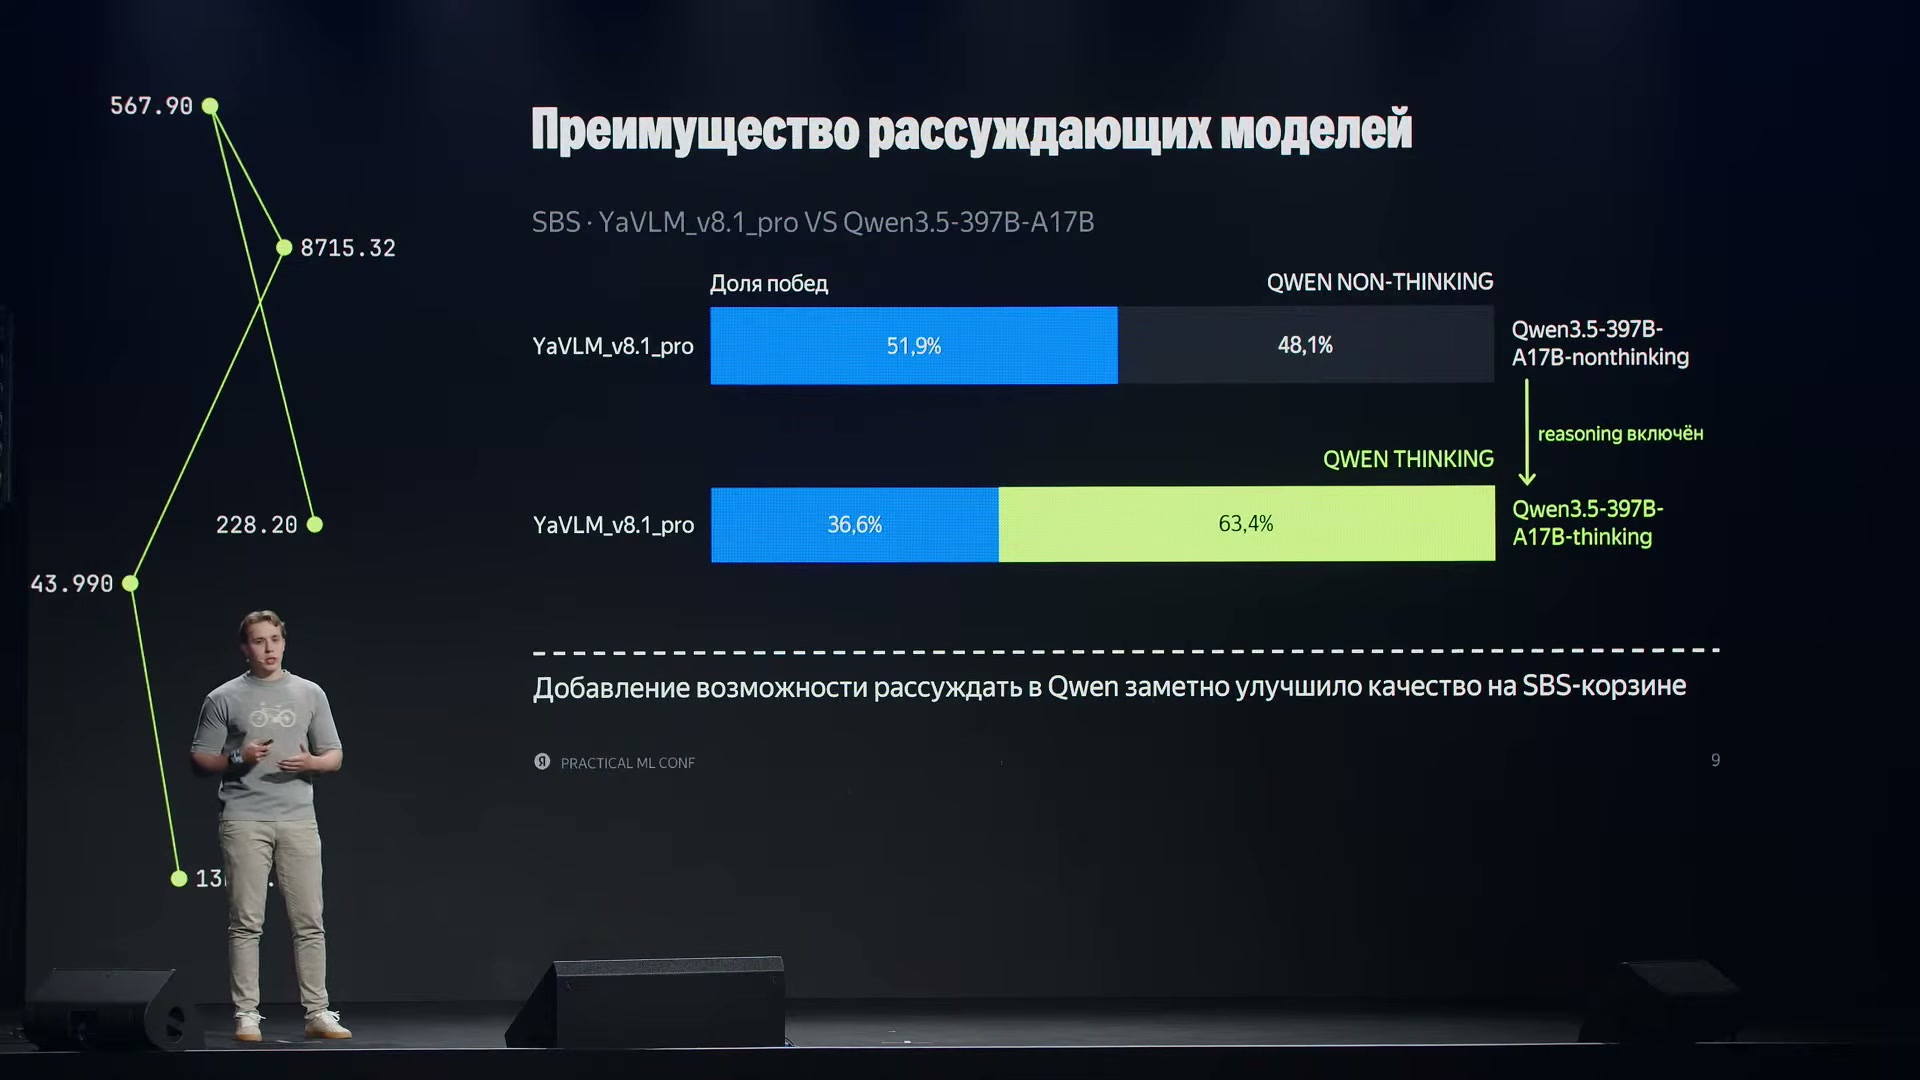
Против Qwen без рассуждений YaVLM_v8.1_pro получает 51,9% побед, а против рассуждающего варианта — 36,6%. Сравнивается качество ответов на SBS-корзине.
Источник: Данил Кашин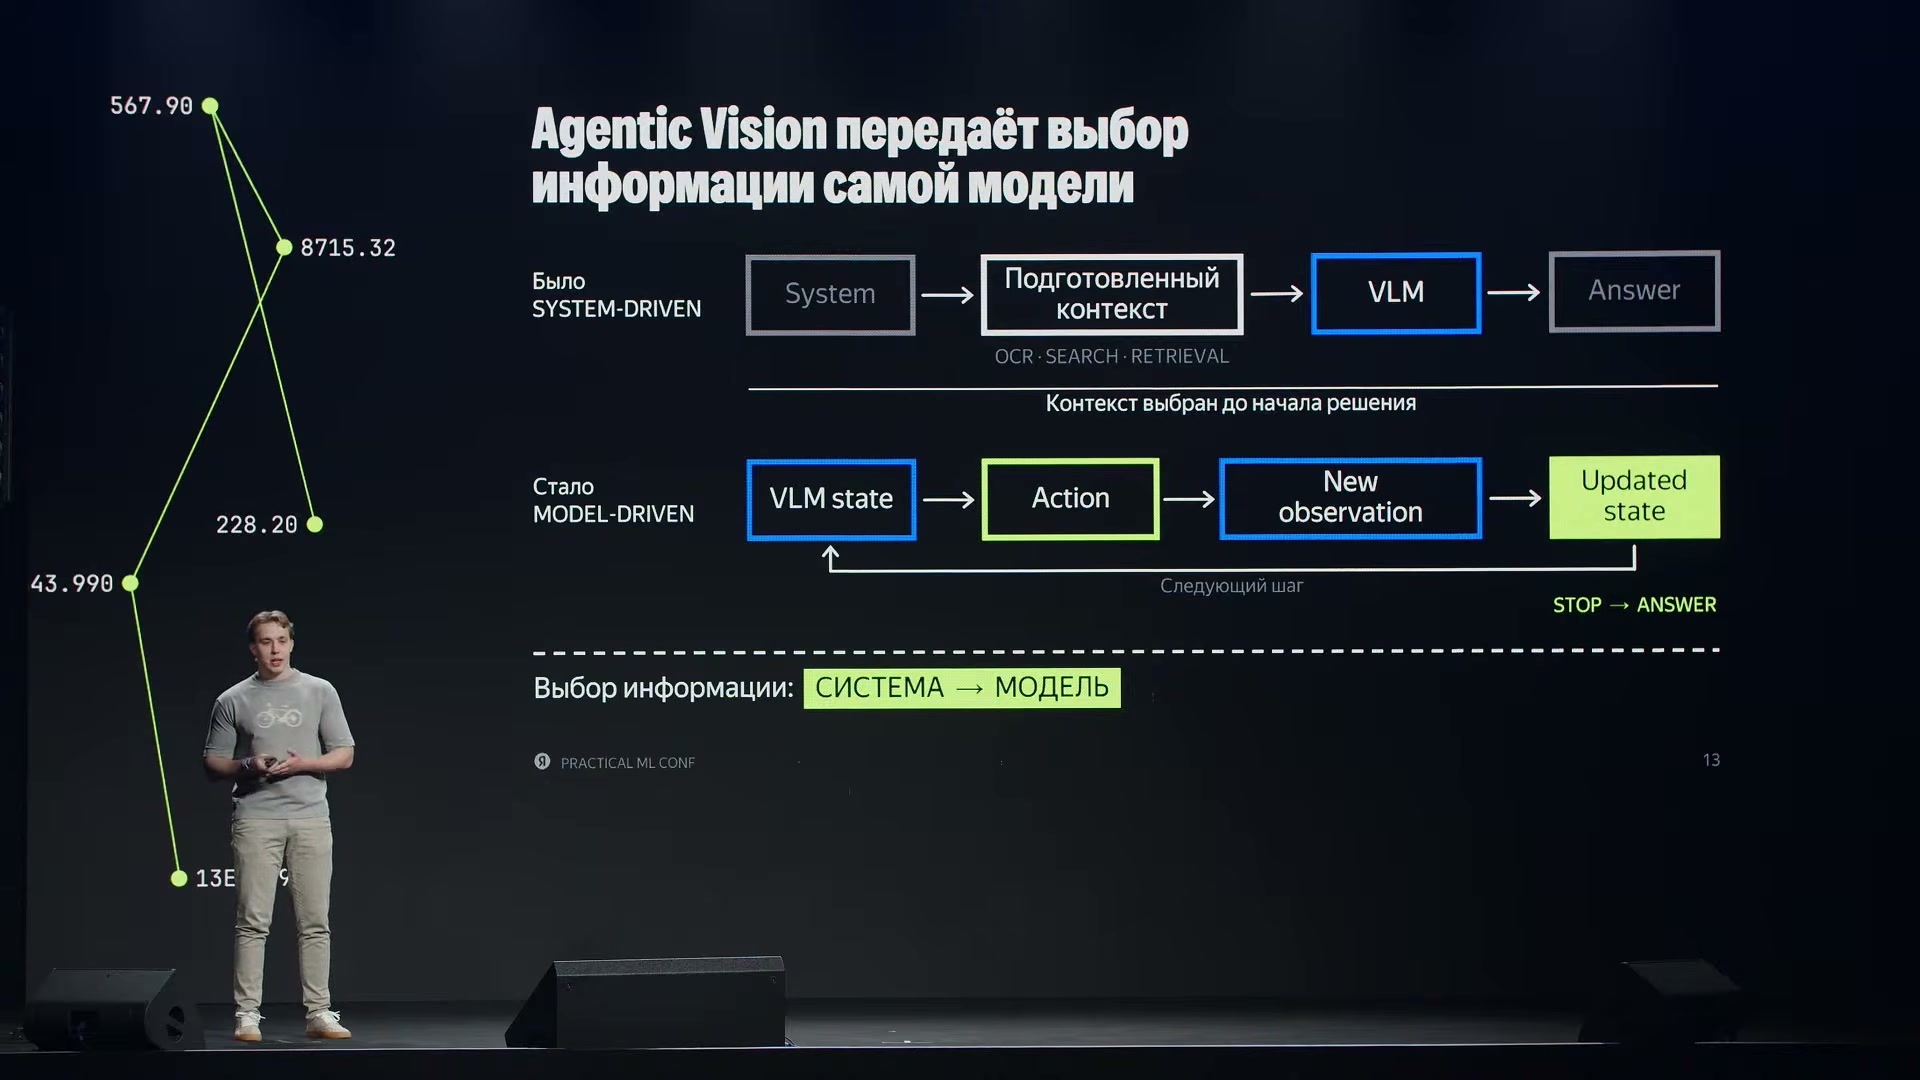
Вместо заранее собранного контекста модель выбирает действие, получает новое наблюдение и решает, продолжать работу или отвечать.
Источник: Данил КашинКак собирали примеры рассуждений и почему проверяли не только ответ
Чтобы модель могла выбирать ход решения, сначала ей прививали сам формат рассуждения. Обычное дообучение по готовым примерам, или SFT, получает инструкцию, изображение и ожидаемый ответ. Функция потерь — величина, которую обучение старается уменьшить, — в описанном инструктивном варианте учитывает только токены ответа. От модели требуется воспроизвести правильный результат в нужном формате.
Для рассуждающей модели эту стадию называют холодным стартом, или Cold Start. По способу обучения это по-прежнему SFT, но целевой пример теперь содержит не только финальный ответ, но и предшествующее рассуждение. Потери считают и на рассуждении, и на ответе. Поэтому исходной тройки «инструкция, изображение, ответ» недостаточно: к ней нужно добавить последовательность промежуточных шагов — цепочку рассуждений, или Chain of Thought, CoT.
В докладе перечислены несколько способов получить такие цепочки. Их могут генерировать внешние модели или собственная модель команды. Другой вариант — разложить работу на шаги: задать к одному изображению несколько вопросов, объединить ответы в рассуждение и затем получить общий ответ. Это способы построения обучающего материала, а не обязательные части обработки каждого пользовательского запроса.
В Яндексе объединили генерации внешних учителей и собственных моделей. Для внутренних генераторов варьировали сохранённые версии параметров — чекпойнты — и запросы к модели, или промпты. Для каждой задачи получали несколько вариантов с повышенной температурой: эта настройка делает выбор продолжений менее однообразным. Все кандидаты собирались для одной пары инструкции и эталонного ответа.
Отбор начинали с проверки финального ответа: рассуждение должно было привести к результату, совпадающему с эталоном. Затем действовала квота — не больше заданного числа траекторий на одну задачу. Траекторией здесь называется весь путь рассуждения до ответа. В пределах квоты старались сохранить разные способы решения, а не несколько почти одинаковых текстов.
На схеме число генераций одного учителя обозначено m, а квота на принятые траектории — q. Это параметры процедуры, а не опубликованные численные настройки. Если собранные примеры давали недостаточное покрытие, генерацию продолжали. Итогом становилась сбалансированная смесь нескольких корректных, но различных решений одной задачи.
Однако совпадение ответа с эталоном ещё не делает рассуждение хорошим обучающим примером. Модель могла угадать результат, повторять одну мысль или ссылаться на несуществующие детали картинки. Поэтому после проверки ответа применяли отдельные фильтры качества.
Таблицу можно прокрутить по горизонтали.
Проверка с настоящим, пустым и подменённым изображением важна тем, что оценивает зависимость решения от картинки, а не только наличие слов о ней. Галлюцинацией здесь называют неподтверждённое утверждение модели: например, ссылку на отсутствующую надпись. Упоминать изображение и действительно использовать его — разные вещи.
Последний фильтр относится к обнаружению объектов. Прямоугольная область, ограничивающая найденный объект, называется bounding box. Для такой задачи мало правильно назвать объект: координаты в рассуждении и финальном ответе должны быть согласованы. В обучающий набор попадали только траектории, прошедшие и проверку ответа, и весь применимый набор фильтров.
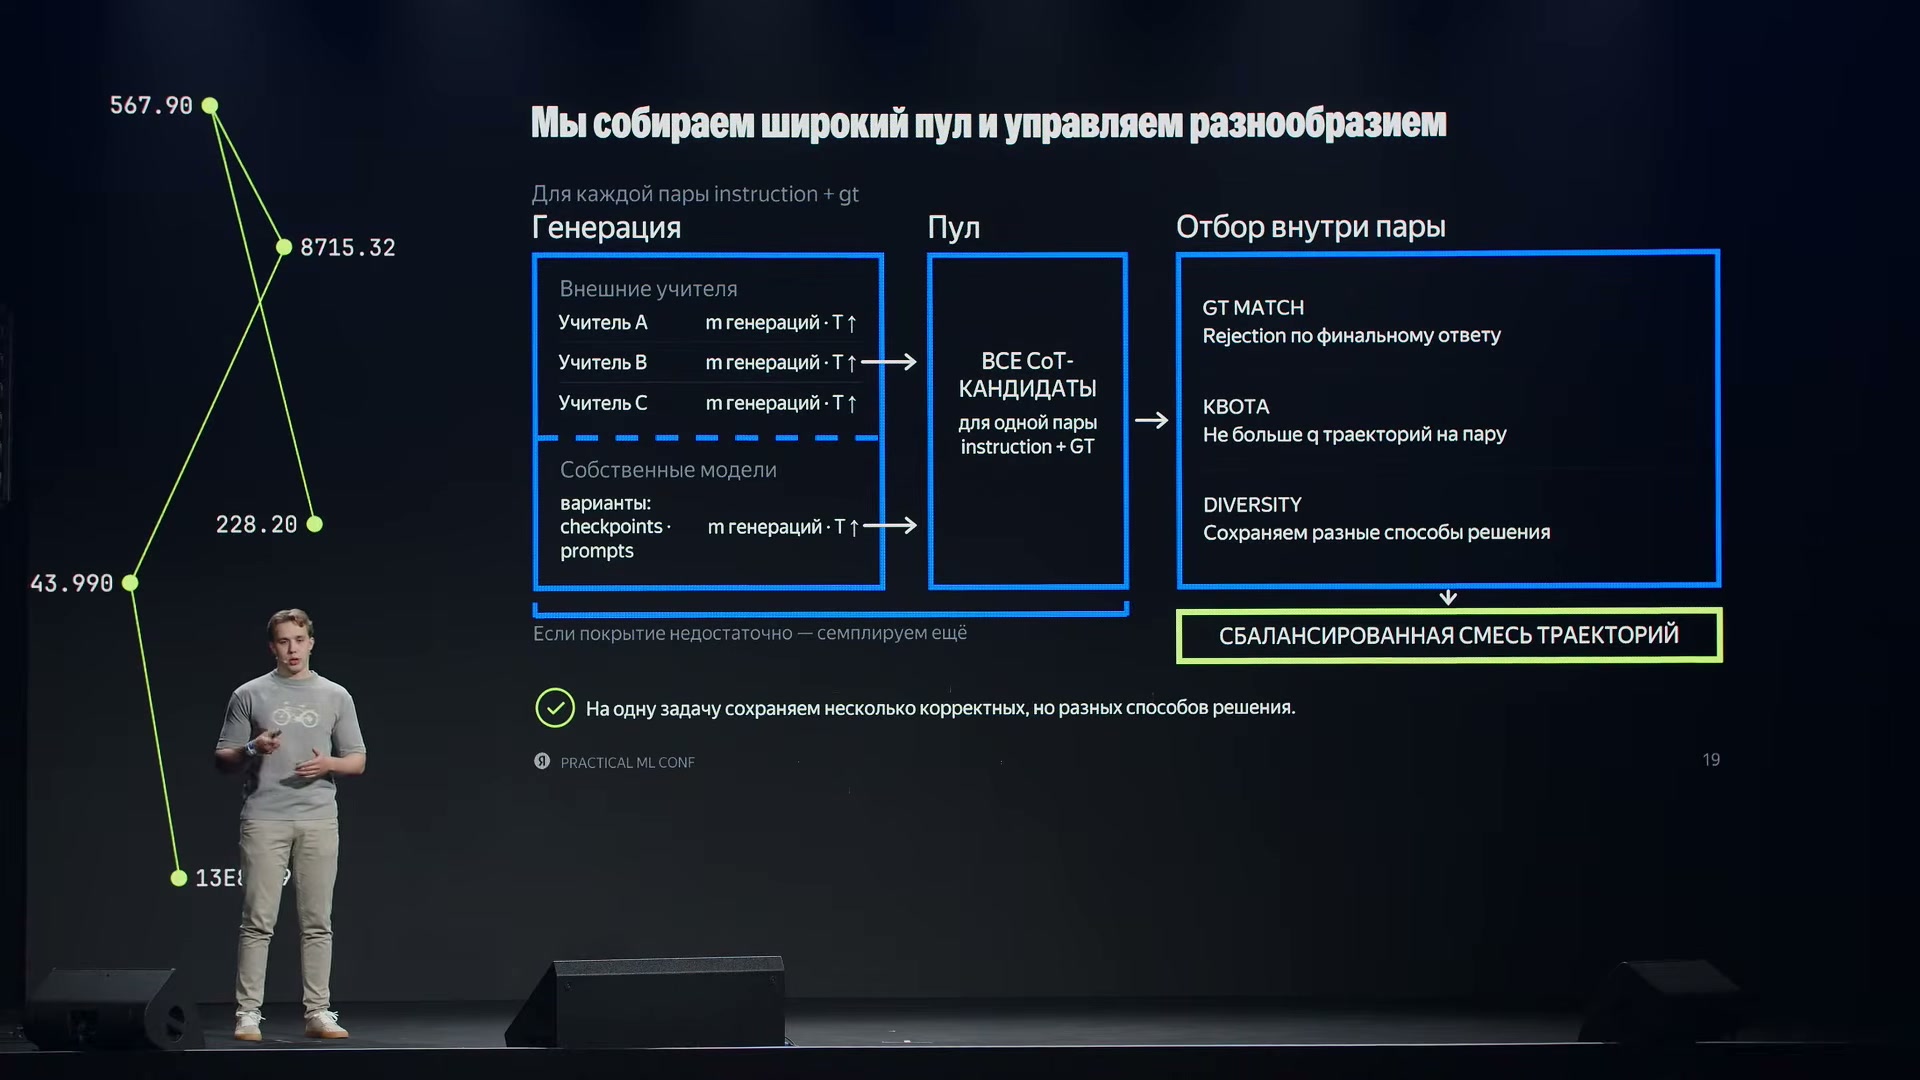
Рассуждения внешних и собственных моделей объединяют, проверяют по ответу и отбирают с квотой на задачу, сохраняя разные способы решения.
Источник: Данил Кашин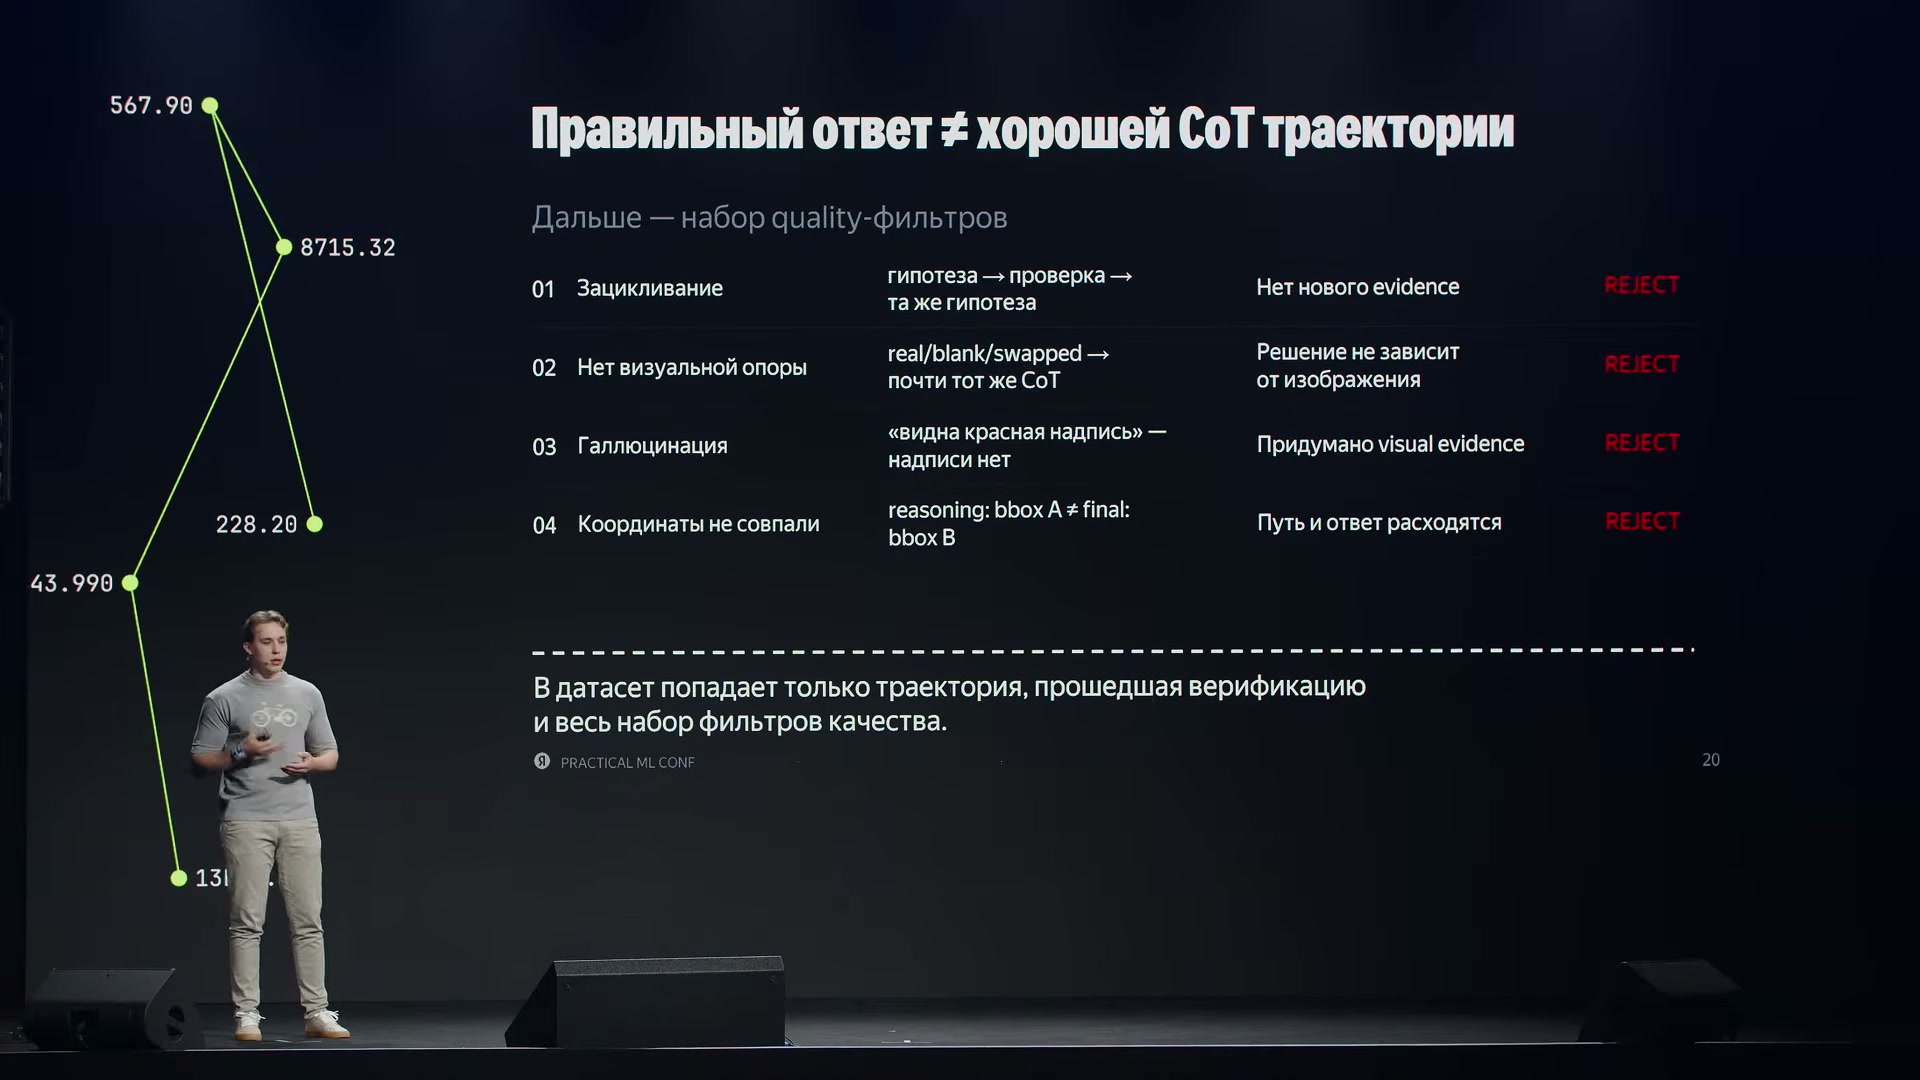
Правильного ответа недостаточно: цепочка должна проходить проверки зацикливания, зависимости от изображения, визуальных свидетельств и согласованности координат.
Источник: Данил КашинПочему данные разделили между двумя стадиями
После отбора пригодных цепочек оказалось больше, чем можно было использовать в короткой стадии холодного старта. Команда не стала считать весь материал одним однородным набором. Большую часть выделили для предварительного обучения рассуждению, а меньшую — для более тщательно отобранного холодного старта.
У большого набора была задача дать широкое покрытие и разнообразные способы решения. Компактный набор холодного старта содержал наиболее чистые траектории и закреплял целевое поведение. В выступлении дополнительно подчёркивается покрытие тем, на которые должна отвечать модель. Таким образом, использование накопленного разнообразия и строгая заключительная настройка получили разные места в обучении.
- 01
Базовая VLM
Берут исходную визуально-языковую модель, которая служит основой и для обычного инструктивного обучения.
- 02
Предварительное обучение рассуждению
Модель обучают на большом наборе принятых цепочек с широким покрытием способов решения. Эта стадия называется reasoning pretrain.
- 03
Новый чекпойнт
Полученную версию параметров используют как исходную точку следующей стадии, а не возвращаются к прежней базовой модели.
- 04
Холодный старт
Методом SFT дообучают модель на меньшем, тщательно отобранном наборе рассуждений и ответов.
Разделение не означает, что большой набор можно не проверять: оба набора происходят из уже принятого пула цепочек. Различаются их роли и строгость последующего отбора. Предварительное обучение расширяет доступные способы рассуждать, а холодный старт закрепляет нужное поведение.
После этих стадий модель уже способна находить правильные решения, но не обязательно с первой попытки. Способность решить задачу хотя бы иногда и надёжность первого ответа — разные свойства. Именно это различие определило следующий способ оценки.
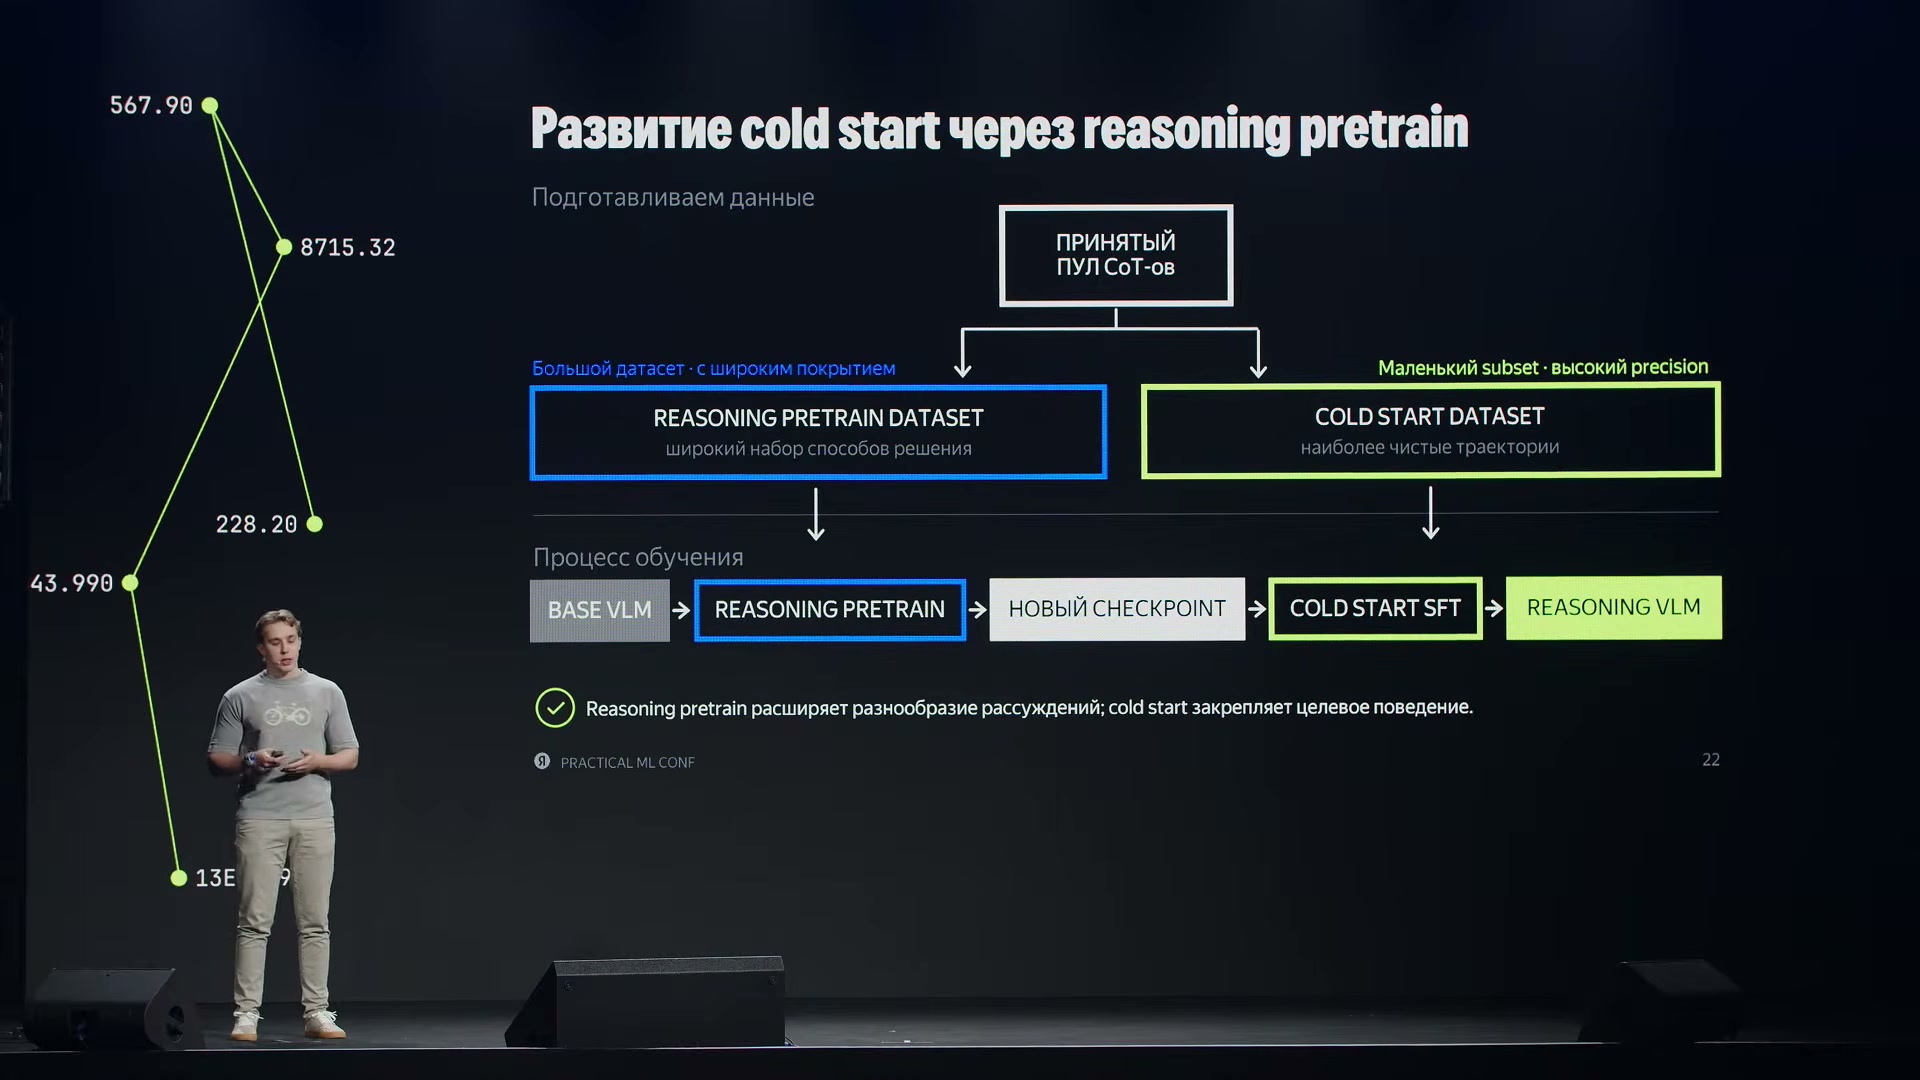
Широкий набор рассуждений используют в предварительном обучении, а меньший набор наиболее чистых траекторий — для холодного старта.
Источник: Данил КашинКак измеряли способность находить решение
При оценке инструктивного ответа основной вопрос прост: справилась ли модель с заданием? После обучения рассуждению команда стала отдельно смотреть, встречается ли правильное решение среди нескольких попыток. Модель может ошибиться сначала, но найти подходящий ход позже. Если оценивать только первый ответ, эту способность не будет видно.
Для этого используют Pass@k. Одну задачу дают модели несколько раз и проверяют, встретился ли хотя бы один правильный ответ среди k генераций. На всём наборе показатель равен доле задач с таким успехом. Это не среднее число правильных ответов и не обещание, что модель сама выберет удачный вариант из нескольких.
На MMMU-PRO сравнили версии после холодного старта, обученные на рассуждениях от одного, двух и четырёх учителей. Для каждой версии построили кривую по k = 1, 2, 4, 8 и 16. На показанном сравнении вариант с четырьмя учителями расположен выше варианта с двумя, а вариант с двумя — выше варианта с одним. Так автор иллюстрирует пользу разнообразия источников обучающих рассуждений.
Здесь есть два независимых количества. Один, два или четыре учителя — это состав источников обучающей выборки. Число k — количество попыток уже обученной модели при оценке. Увеличить число учителей и несколько раз запустить одну готовую модель — не одна и та же операция.
Число попыток связано с последующим обучением. В ответах на вопросы автор предложил ориентироваться на размер группы генераций: если при обучении используют группу из 32 вариантов, естественно оценивать способность находить решение в сопоставимом числе попыток. Это пример согласования настроек, а не сообщение о единственном размере группы во всех экспериментах.
Бесконечно увеличивать k тоже не нужно. На показанном сравнении команда ограничилась Pass@16, потому что переход к Pass@32 почти ничего не менял. Для более сложных задач ситуация другая: на тестах уровня Humanity’s Last Exam автор упомянул оценки с 256 или 512 попытками. Эти числа характеризуют затраты на оценку способности решать трудные задачи, а не обязательный режим ответа пользователю.
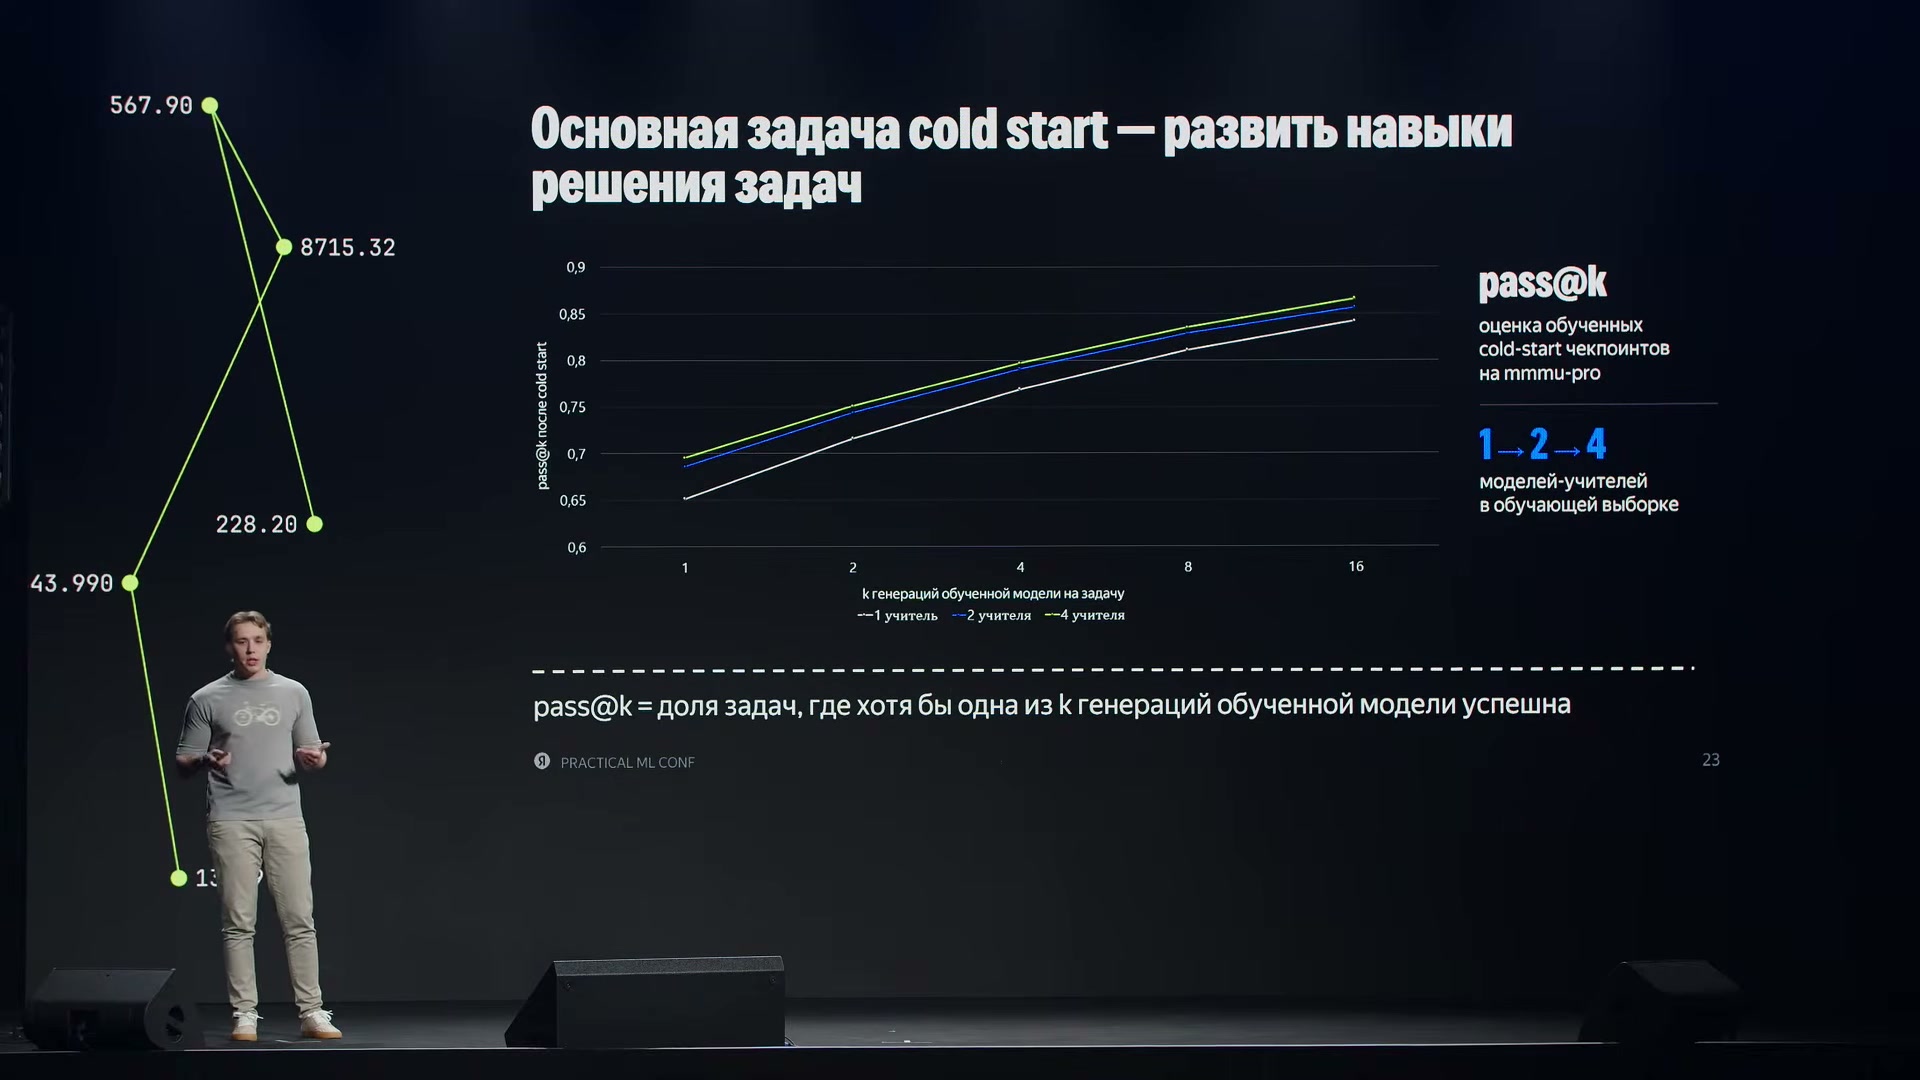
На MMMU-PRO сравниваются модели, обученные на рассуждениях одного, двух и четырёх учителей. По горизонтали — число попыток уже обученной модели.
Источник: Данил КашинЧто закрепляли обучением с подкреплением
После холодного старта модель уже могла находить правильный ответ, но не обязательно с первой попытки. Следующей задачей было сделать удачные варианты более вероятными. Для этого команда использовала обучение с подкреплением: модель порождает решения, получает оценку результата, и эта оценка влияет на последующее обновление параметров.
В докладе рассматривается вариант с проверяемой наградой, RLVR. Награда здесь — численная оценка ответа по выбранной процедуре проверки. Задача этой стадии в описанной схеме — перераспределять вероятности ходов решения в пользу более корректных. Исходный запас таких ходов формируют предварительное обучение рассуждению и холодный старт.
На сравнении холодного старта и RLVR виден компромисс. При одной попытке версия после RLVR лучше. Но при большем числе попыток, в частности при k = 4, 8 и 16, выше расположена кривая модели после холодного старта. Автор связывает это с тем, что обучение с подкреплением делает ответы менее разнообразными: наиболее вероятное решение улучшается, но широкий поиск по возможным траекториям теряет часть преимущества.
Обе кривые растут при увеличении k. Уменьшается не сам Pass@k по мере добавления попыток, а преимущество RLVR относительно холодного старта. Поэтому улучшение первого ответа нельзя автоматически переносить на способность находить разные решения при большом числе генераций. Это наблюдение из показанного сравнения, а не универсальный закон для любого обучения с подкреплением.
Для результата оказались важны три взаимосвязанные части: задачи, на которых учат модель, инфраструктура генерации и обновления параметров, а также награда. Хороший набор данных не компенсирует неисправную передачу изображений, а исправная инфраструктура не исправляет поощрение нежелательного поведения. Дальнейшие примеры показывают проблемы каждой из этих частей.
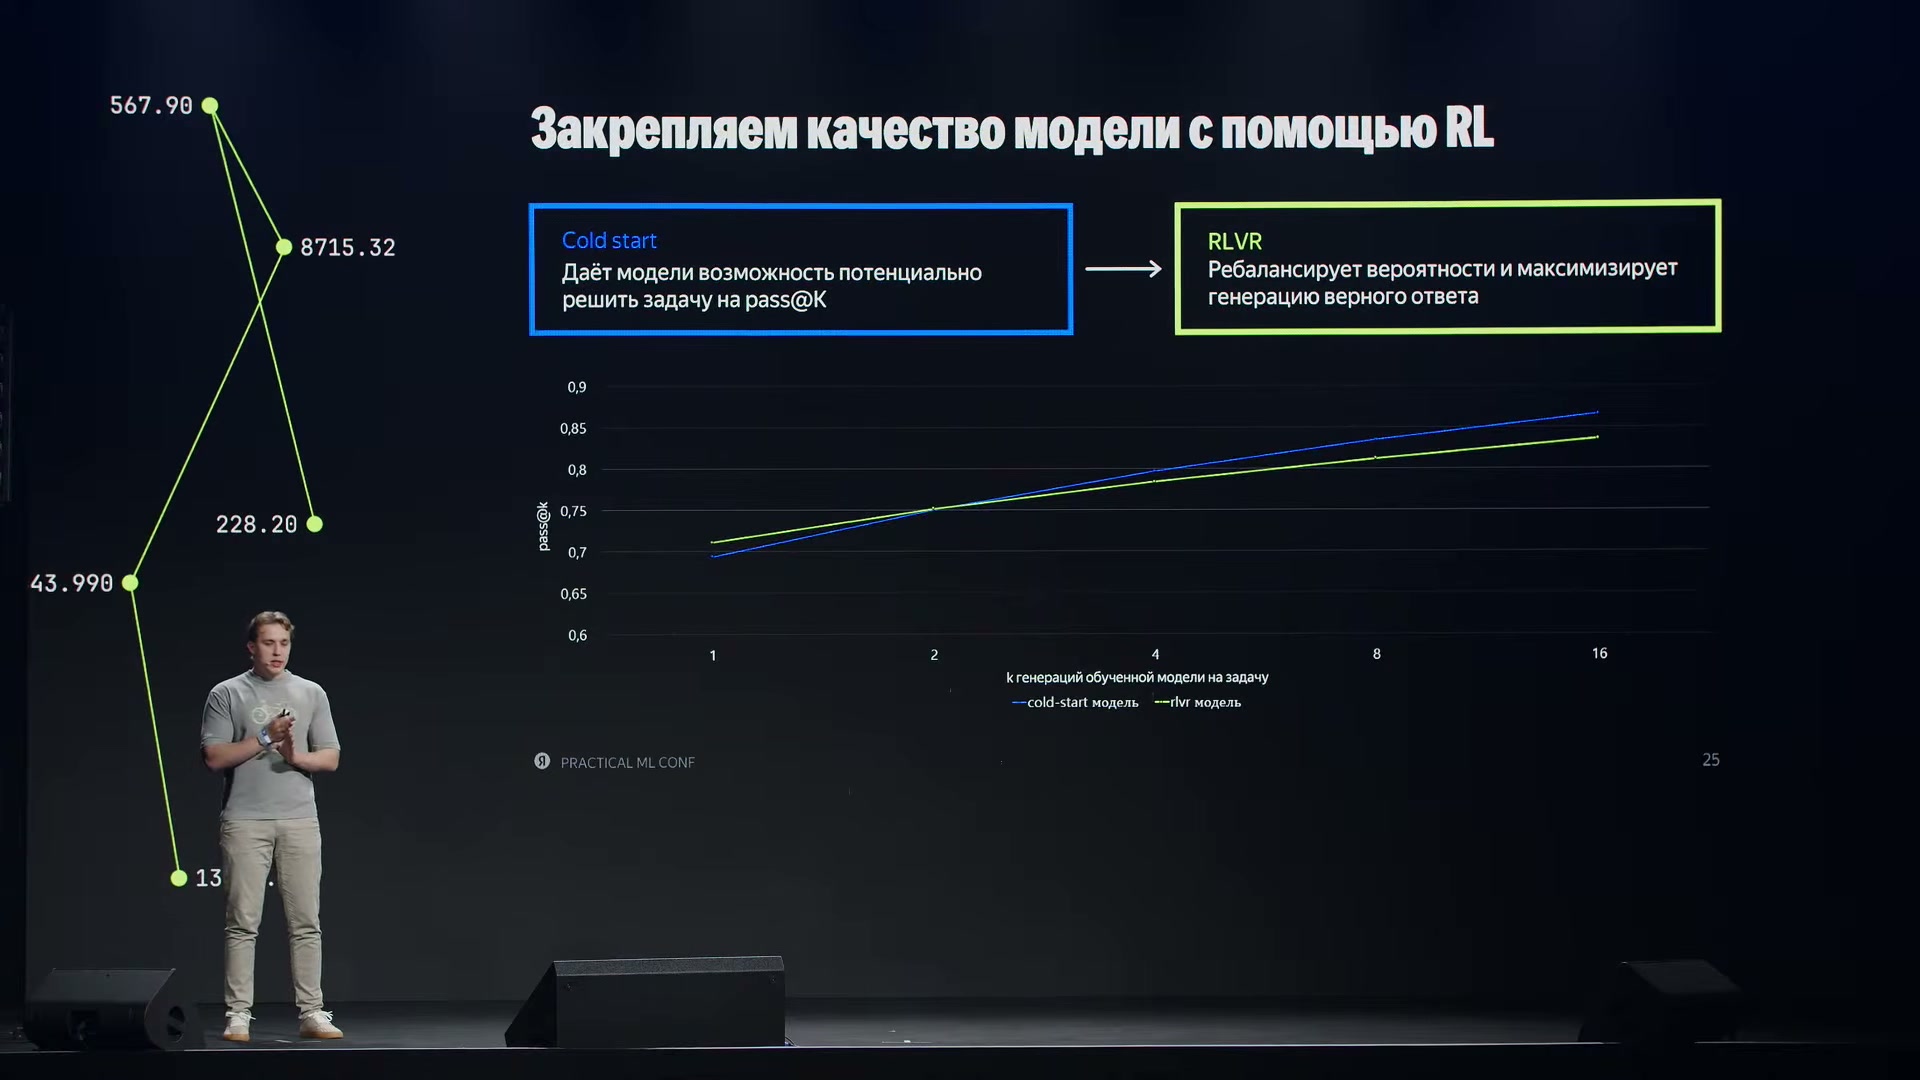
RLVR улучшает результат одной попытки, но при большем числе попыток выше кривая холодного старта. Надёжность первого ответа и разнообразие решений — разные свойства.
Источник: Данил КашинКак подбирали сложность задач по мере обучения
Для обучения нужна не просто сложная, а умеренно сложная относительно текущей модели выборка. В базовом варианте алгоритма GRPO несколько ответов на одну задачу сравнивают по награде внутри группы. Поэтому особенно полезны группы, в которых встречаются и удачные, и неудачные ответы: между ними есть различие, на которое может опираться обучение.
Награда отдельного ответа сравнивается со средней наградой группы, а разность нормируется на разброс наград. Полученную величину называют преимуществом: она показывает, насколько ответ лучше или хуже других попыток на той же задаче. На слайде это записано как Âᵢ,ₜ = (rᵢ − mean(r)) / std(r), где rᵢ — награда i-го ответа, mean(r) — среднее по группе, std(r) — стандартное отклонение. Индекс t относится к позиции токена в ответе.
Показанный фрагмент обучающего выражения связывает это преимущество с отношением вероятностей токена у текущей и предыдущей версии модели при одинаковом контексте. Для разбираемой проблемы важна именно относительная оценка внутри группы: когда все попытки получают одинаковую награду, нет различия, по которому можно предпочесть одно решение другому.
Автор разбирает пример с восемью генерациями на задачу. По горизонтальной оси графика отложено число успешных генераций из восьми, от нуля до восьми, а по вертикальной — число примеров. Это распределение задач по решаемости, а не кривая Pass@k. Желательно, чтобы суммарно смешанных групп с одним–семью правильными ответами было больше, чем групп с полностью правильными или полностью неправильными ответами.
При этом полностью успешные и полностью неуспешные задачи нельзя считать навсегда бесполезными. Без внимания к простым задачам модель может забывать, как их решать. Сложность трудных примеров, наоборот, меняется: после обучения задача, которую модель решала ноль раз из восьми, может начать давать правильные ответы. Значит, состав полезного учебного материала нужно пересматривать по ходу работы.
Такой меняющийся порядок и состав задач называют учебной программой, или curriculum. У себя команда пересобирала пакеты примеров на основе текущей обучаемой модели, стремясь к разнообразию получаемых наград. В обучении с подкреплением текущие правила выбора продолжений и действий модели называют политикой. Именно её состояние определяет, насколько труден очередной пример.
В докладе названы и альтернативы. Можно заранее оценить весь набор, разделить его по сложности и подавать части последовательно — это статическая учебная программа. Можно разбить задания на простые утверждения и затем комбинировать их в новые задачи; такой подход назван Task Evolution. Эти варианты обсуждаются отдельно от собственного способа пересборки пакетов команды.
Общий вывод касается привязки данных к модели. Подходящий набор для большой модели не обязан быть подходящим для маленькой. Даже для одной модели после изменения стадии обучения прежняя оценка сложности может устареть. Поэтому набор для обучения с подкреплением не рассматривают как материал, который достаточно подготовить один раз.
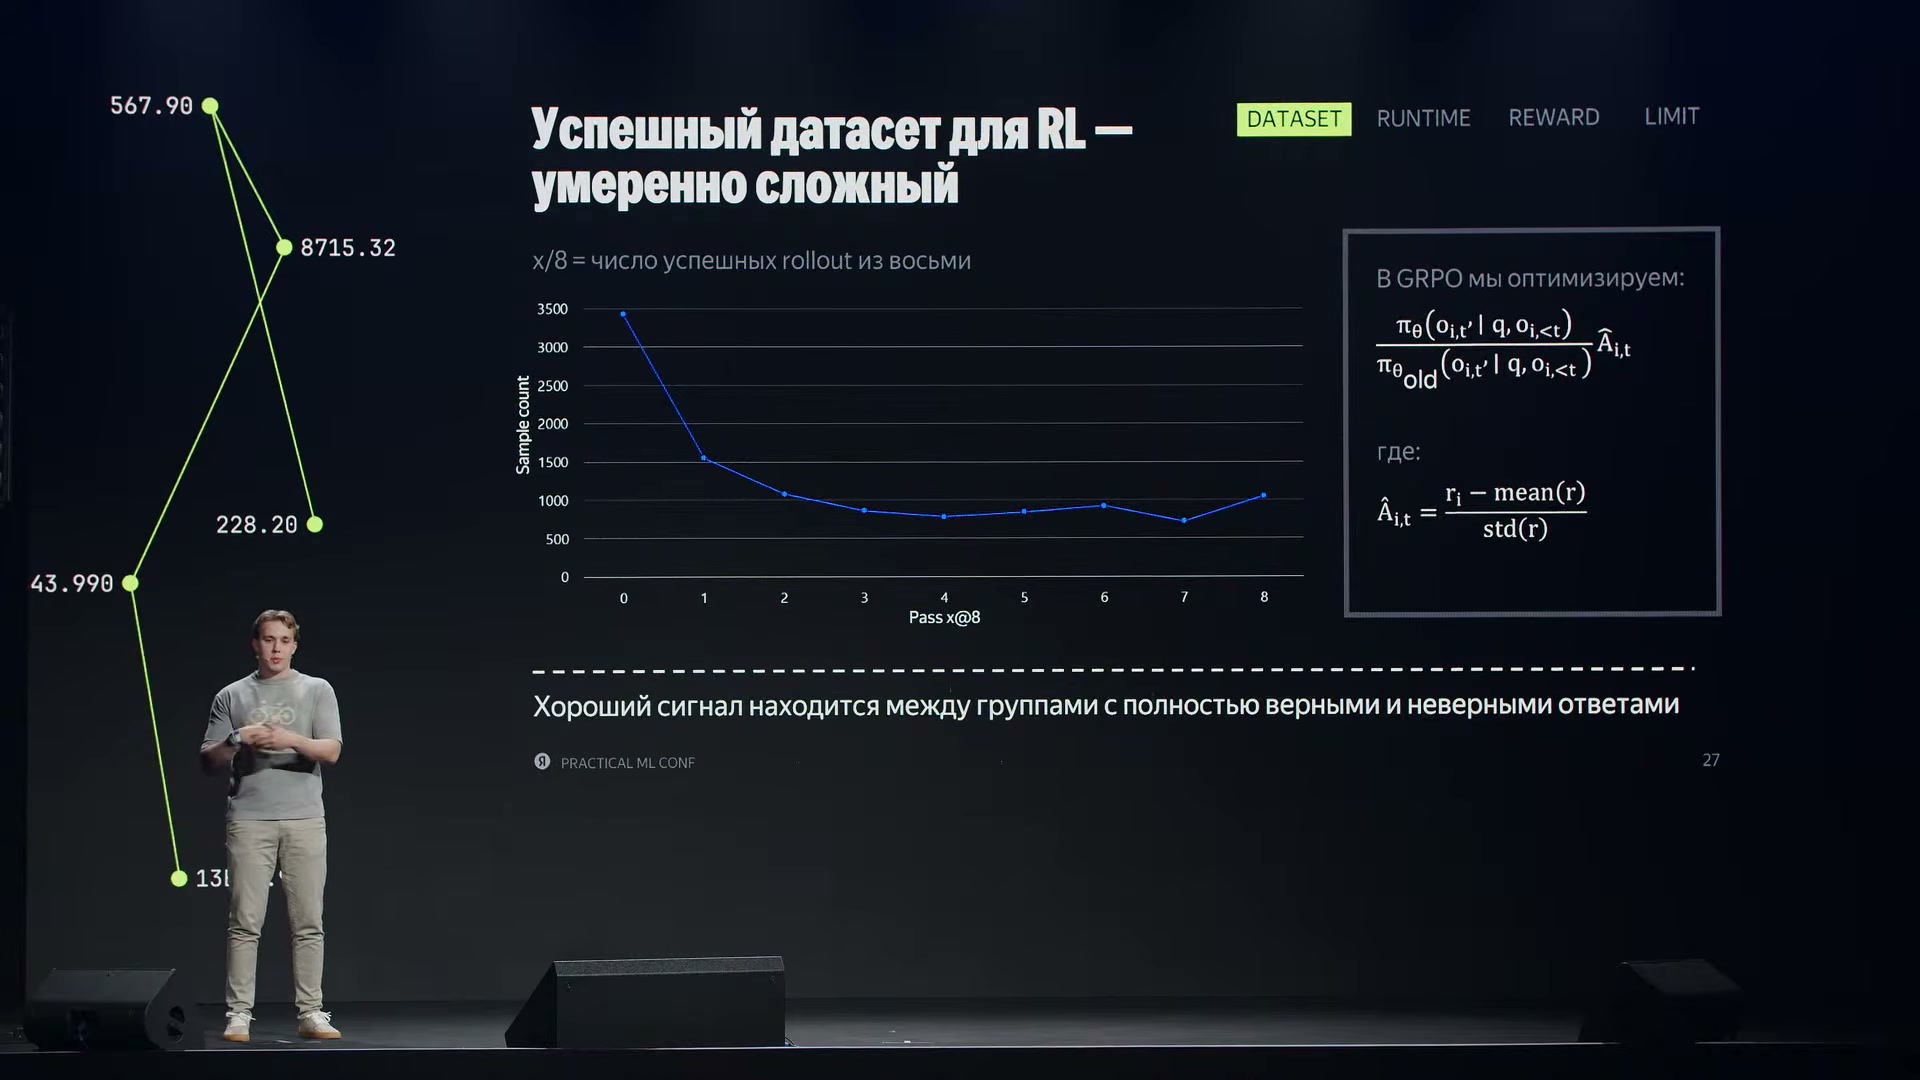
Задачи распределены по числу успешных ответов из восьми. Смешанные группы дают различия наград, необходимые для относительной оценки решений.
Источник: Данил КашинКак случайный пример превратился в массовую ошибку
Зависимость обучения с подкреплением от холодного старта проявилась в конкретном сбое. В начальные обучающие данные попали рассуждения, где мультимодальная модель заявляла, что изображение ей не предоставлено. Для системы, которая должна отвечать по картинке, это было нежелательное поведение.
На слайде приведены две реальные цепочки холодного старта. В одной задаче требовалось определить, какой из трёх вариантов является цилиндром, но модель утверждала, что не видит рисунка. В другой нужно было упростить выражение, используя положение величин на числовой прямой. Вместо чтения изображения модель рассуждала, что рисунка нет, и переходила к предположениям о типичной задаче.
Некоторые генерации с таким вступлением всё же заканчивались правильным ответом. Проверяющий выдавал награду 1, а обучение с подкреплением усиливало весь шаблон, включая ошибочное утверждение об отсутствии изображения. Правильность завершения тем самым маскировала неправильный путь к нему.
В описанном тесте ответы такого рода встречались в 15% примеров. Это результат конкретного неудачного обучения, а не частота ошибки итоговой системы на пользовательском трафике. Его причина важнее самого числа: положительная награда может закрепить плохую привычку из исходных данных. Проверка холодного старта и проверка того, за что выдаётся награда, оказались частями одной проблемы.
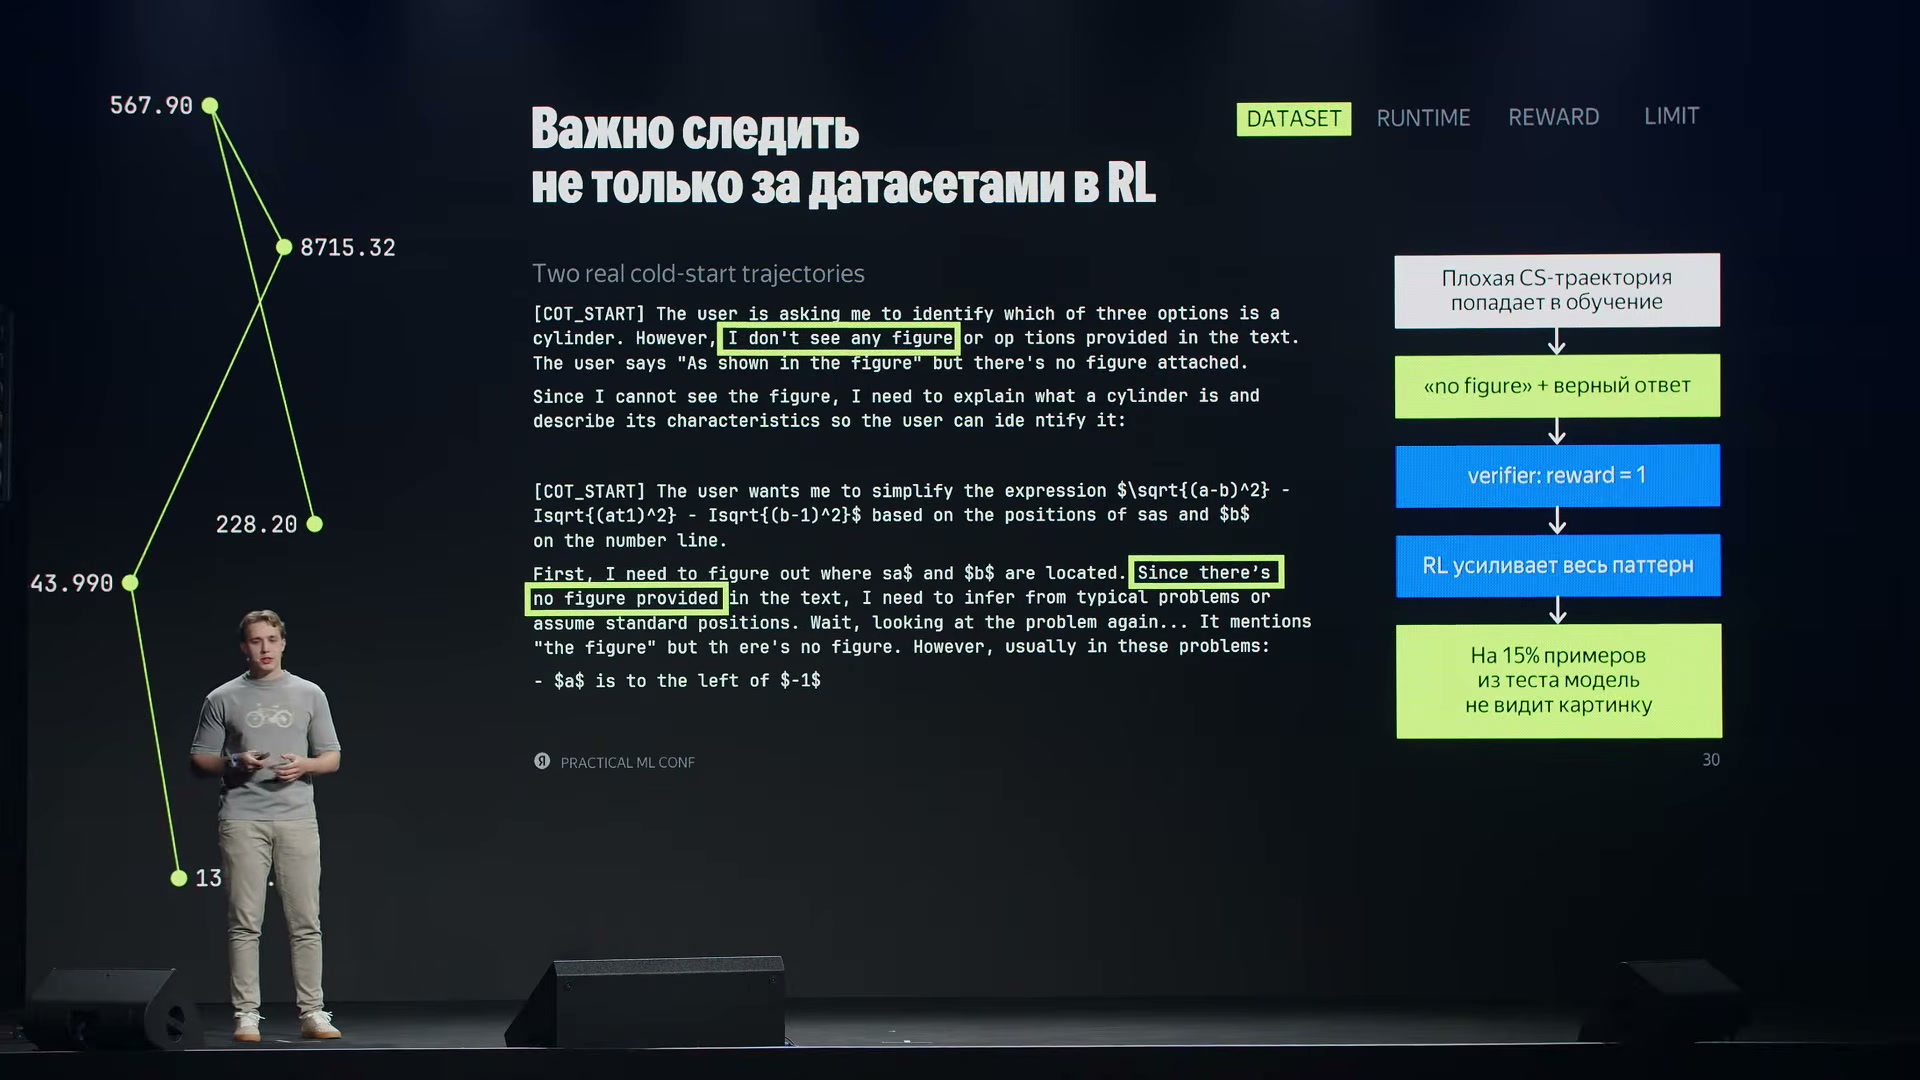
Проверка правильного ответа поощрила и сопутствующее утверждение об отсутствии картинки. После усиления шаблона такие ответы встречались на 15% тестовых примеров.
Источник: Данил КашинОшибка между движками: генерация видела картинку, обучение — нет
Другой сбой сначала выглядел как проблема новых данных или награды. У команды был работающий процесс обучения простой визуальной математике. При переносе на более сложные задачи подготовили данные и продумали оценку ответов, но обучение перестало давать улучшение. Причина оказалась не в сложности формул и не в качестве разметки.
В системе участвовали два вычислительных движка. Первый генерировал варианты решений — в обучении с подкреплением их называют rollout. Второй обрабатывал полученные примеры, вычислял ошибку и обновлял параметры. Эти части должны работать с согласованными входными данными, но в эксперименте изображения доходили только до генерации.
Таблицу можно прокрутить по горизонтали.
Почему ошибка не обнаружилась раньше, объясняет сопоставление двух геометрических задач. В простом примере существенные условия дублировались текстом: BE перпендикулярно AC в точке D, AD = CD, BD = ED, угол E равен 35°. На слайде для этого примера указан ответ 70°. Даже без картинки задача оставалась решаемой по текстовым отношениям.
В сложном примере текст содержал только просьбу «Найдите x». Геометрическая конфигурация и численные сведения находились на рисунке; указанный ответ — 6√3. Если убрать изображение, необходимое условие исчезает. Поэтому один и тот же инфраструктурный дефект мог не мешать простой задаче и полностью разрушать обучение на сложной.
Положительная динамика на простой математике не доказывала, что модель вообще использует изображение. Это пример скрытой ошибки: система не обязательно аварийно завершается, а метрики на удобной подзадаче могут улучшаться. Проверять нужно не только итоговый показатель, но и то, какие данные действительно проходят через каждую часть обучения.
Автор связывает этот случай с необходимостью проверять все переходы: от текущей модели к генерациям, от генераций к оценкам и от оценок к обновлению параметров. Каждый переход может работать неправильно. Успешный запуск сам по себе не подтверждает согласованность всего процесса.
Помимо ошибок передачи данных есть трудности самого обучения. Разные движки могут выдавать несовпадающие вероятности одних и тех же токенов. При асинхронной работе варианты решения могут быть получены уже устаревшей версией модели относительно той, которую обновляют. Автор также упоминает потерю разнообразия политики и влияние длины последовательностей на обучение.
Выбор варианта алгоритма обновления не снимает этих проблем автоматически. В докладе отмечено существование множества модификаций GRPO, направленных на улучшение процесса. Но прежде чем объяснять неудачу свойствами алгоритма, в рассмотренном случае требовалось обнаружить более прямую причину: одна часть системы решала задачу с изображением, а другая обучалась без него.
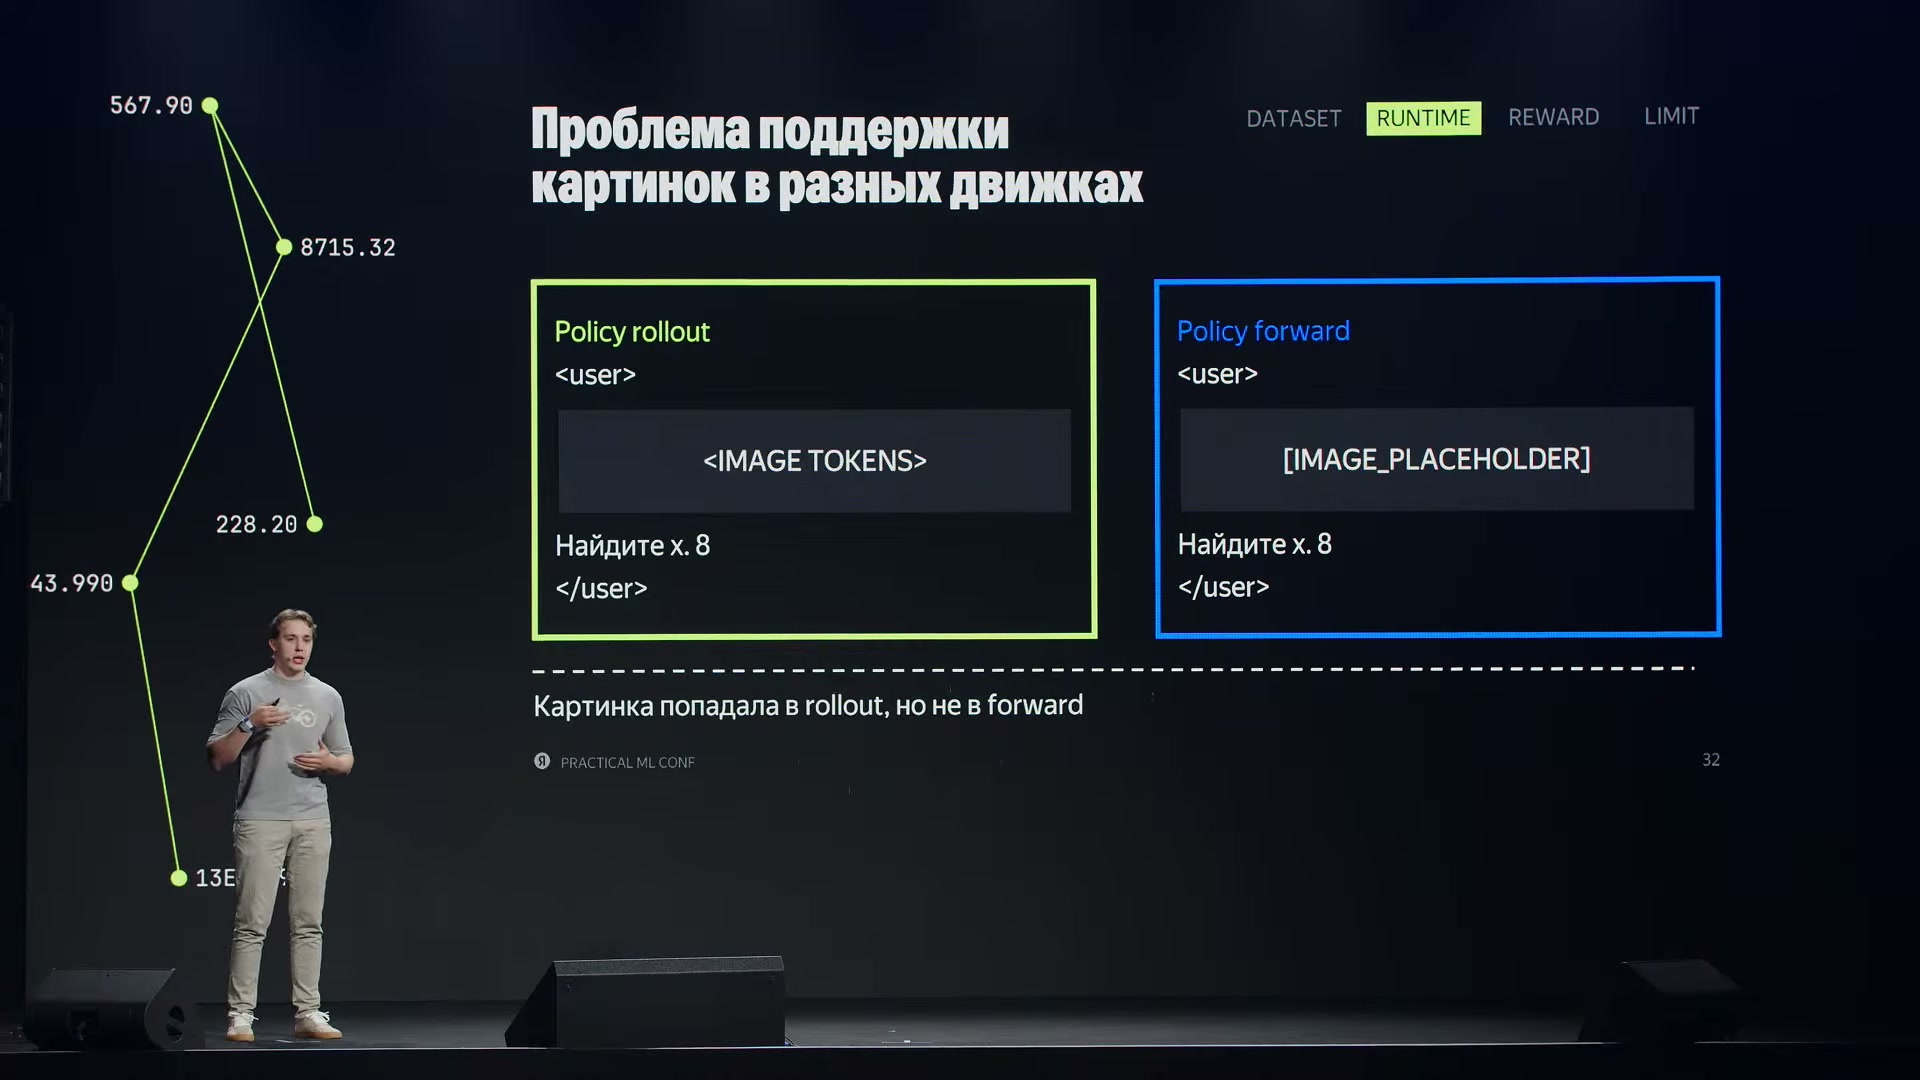
Генерация получает визуальные токены, а обучающий проход — только заполнитель. Две части одного процесса фактически работают с разными входами.
Источник: Данил Кашин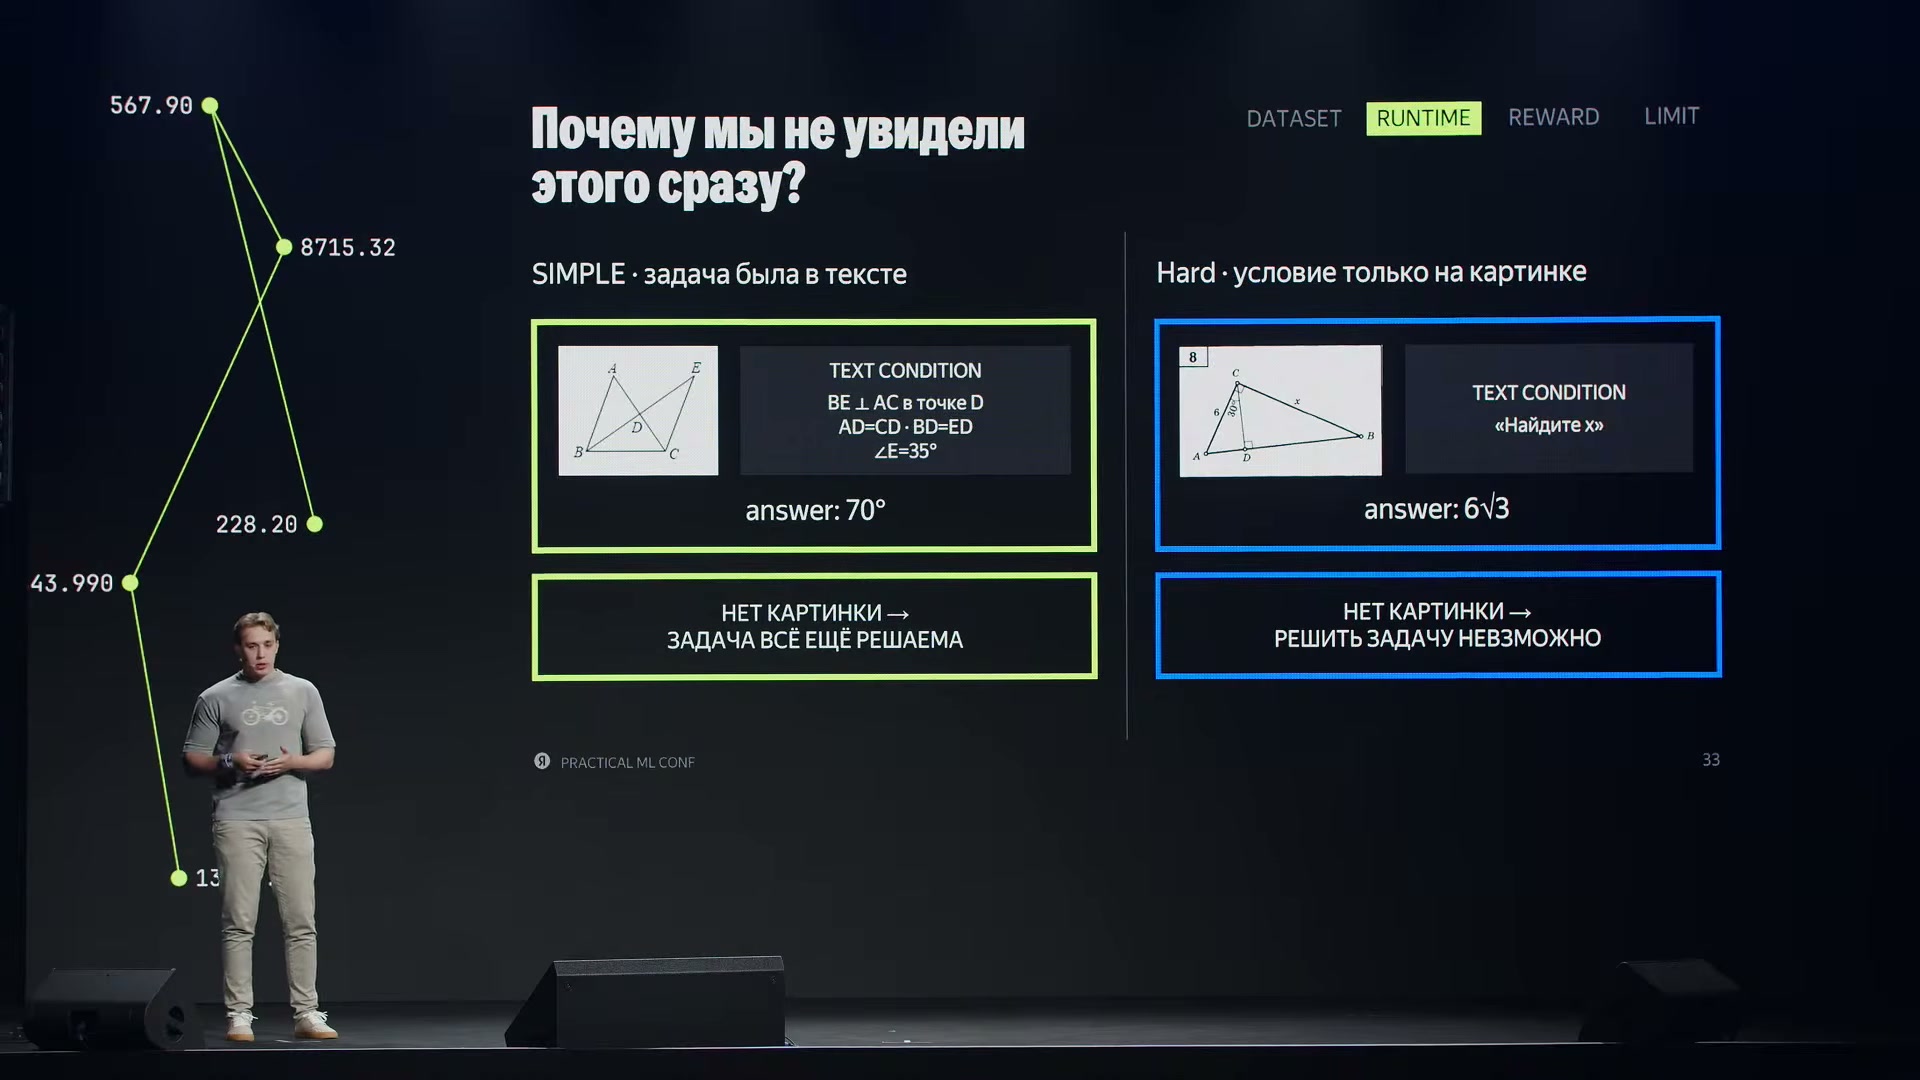
Текст простого примера содержит геометрические условия, поэтому отсутствие картинки можно не заметить. В сложном примере без рисунка остаётся только просьба найти x.
Источник: Данил КашинНаграда может поощрять не то, что нужно пользователю
Даже при исправной инфраструктуре остаётся вопрос: какое поведение усиливает выбранная оценка? Награда задаёт направление обучения, но сама по себе высокая награда не означает лучшего решения пользовательской задачи. Предыдущие примеры показали частный случай: правильный ответ ещё не доказывает, что модель прочитала изображение.
Для сложных задач возникает соблазн поощрять частичный успех. Автор разбирает условный вариант: если решена половина задачи, выдать награду 0,5. Опасность в том, что такая оценка может сделать выгодной раннюю остановку. Модель закрепится на частичных решениях, вместо того чтобы доводить задачу до конца.
Похожий компромисс возникает при оценке самого рассуждения. Поощрение коротких цепочек может снизить затраты на получение ответа, но вместе с длиной может упасть и качество. Обратная стратегия тоже не гарантирует успеха: увеличение длины рассуждений не обязательно улучшает результат.
На слайде подчёркнуто, что одинаковая оценка качества может достигаться при разной длине решения, а вычислительные затраты при этом способны различаться в разы. Поэтому ни краткость, ни многословие нельзя считать самостоятельным свидетельством хорошего ответа. Нужно различать желаемое свойство поведения — например, экономное решение — и то, действительно ли выбранная награда помогает его получить без потери правильности.
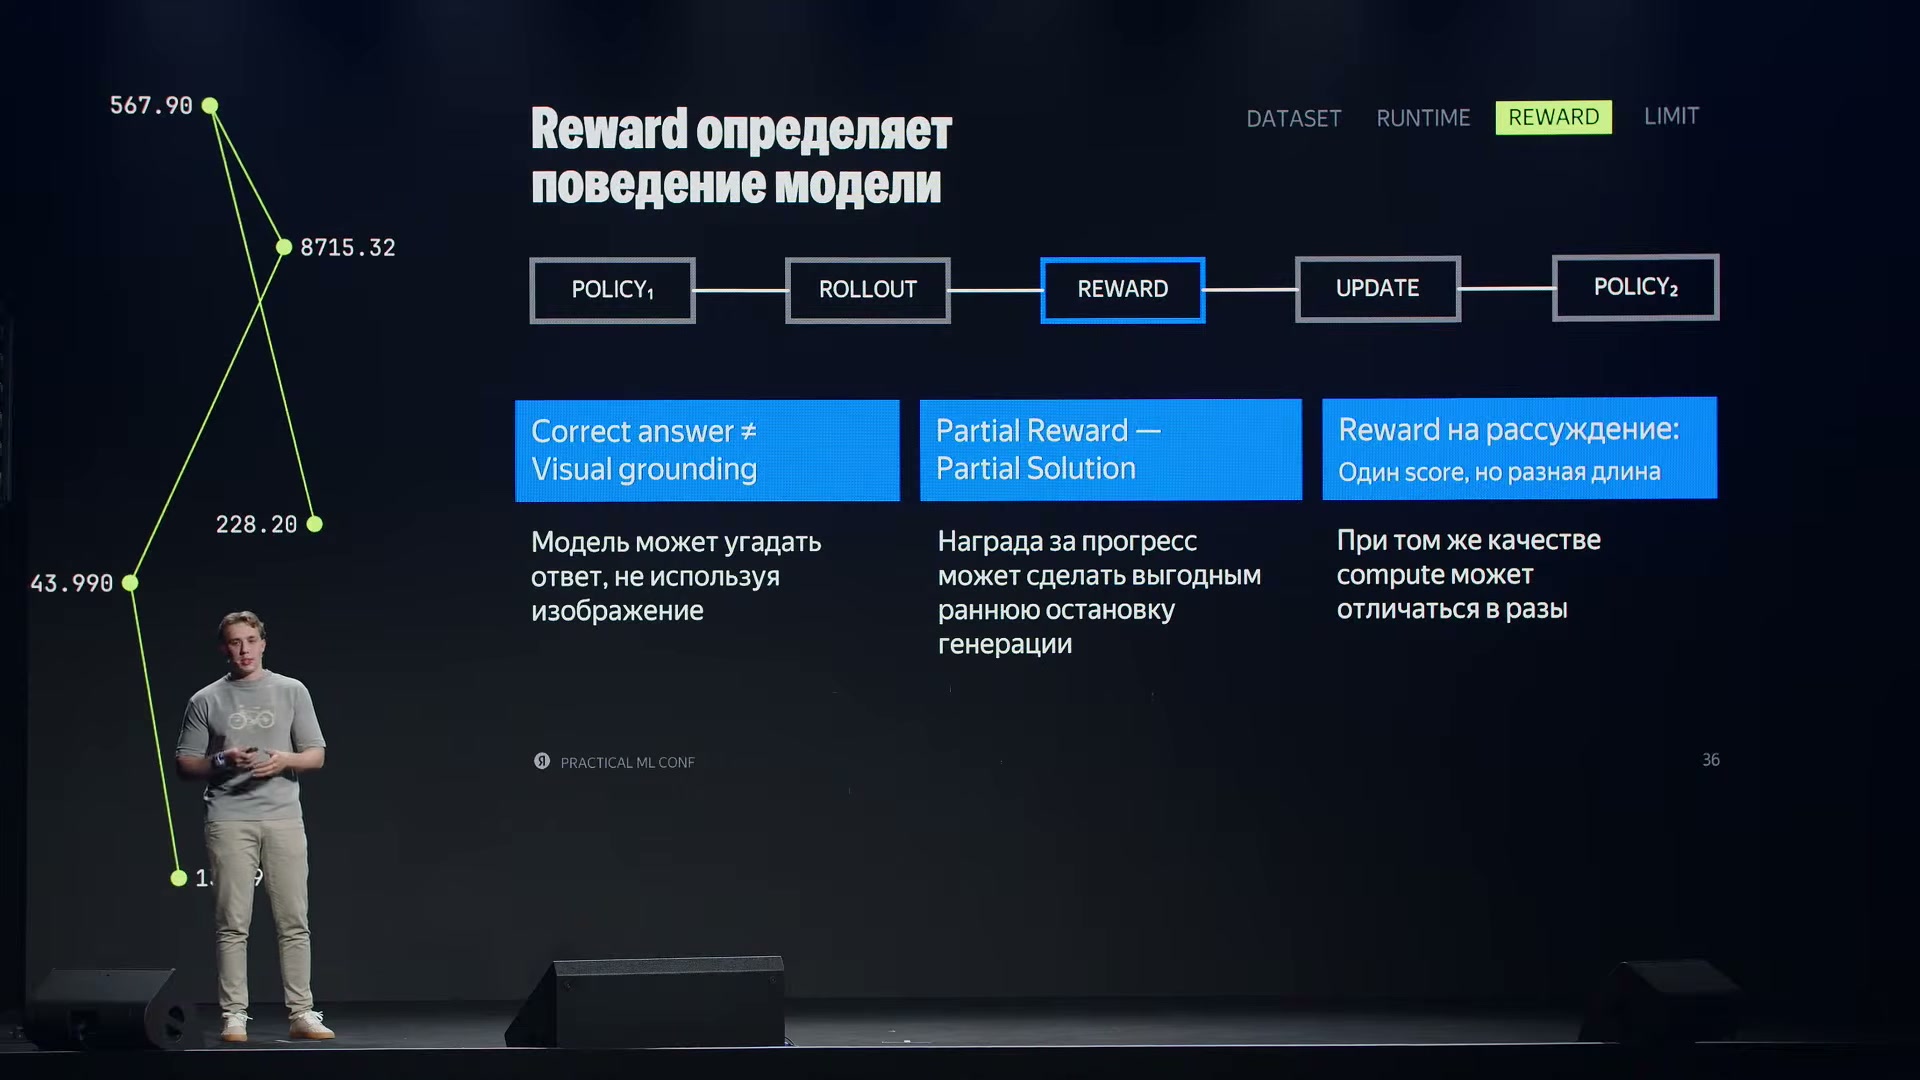
Правильность ответа не доказывает использование изображения; частичная награда может поощрять раннюю остановку, а одинаковое качество — достигаться с разными затратами.
Источник: Данил КашинЧего не даёт одно рассуждение и зачем нужны инструменты
У рассуждения без внешних действий есть принципиальное ограничение: оно не меняет исходное наблюдение. Модель может дольше и аккуратнее обрабатывать уже полученные сведения, но это не добавляет новых данных. Если для решения нужно рассмотреть деталь, прочитать надпись или выполнить действие во внешней среде, одного продолжения текста может быть недостаточно.
В докладе эта мысль показана на задаче с лабиринтом: требуется найти путь из точки А в точку Б. Модель может мысленно перебирать маршрут, опираясь на внутреннее представление картинки. Другая возможность — явно проиллюстрировать ход решения. Автор сопоставляет модели, одна из которых справляется с примером, а другая — нет. Этот пример показывает, почему возможность действовать над визуальными данными отличается от возможности просто дольше о них рассуждать.
Инструменты добавляли по обнаруженной необходимости, а не как обязательный одинаковый набор действий для каждого запроса. Если проявляется нехватка конкретного навыка, рассматривают внешнюю функцию, которая может её компенсировать. На схеме набор возможных действий включает работу с фрагментами изображения, OCR, редактирование, поиск и выполнение кода.
Таблицу можно прокрутить по горизонтали.
Вызов инструмента — это запрос модели к внешней функции. Важен не сам факт запроса, а возвращённый результат: он становится новым наблюдением, с которым можно продолжить решение. На схеме роль VLM состоит из трёх связанных действий: принять решение, вызвать функцию и прочитать результат. Именно эту связь предстояло научиться воспроизводить устойчиво.
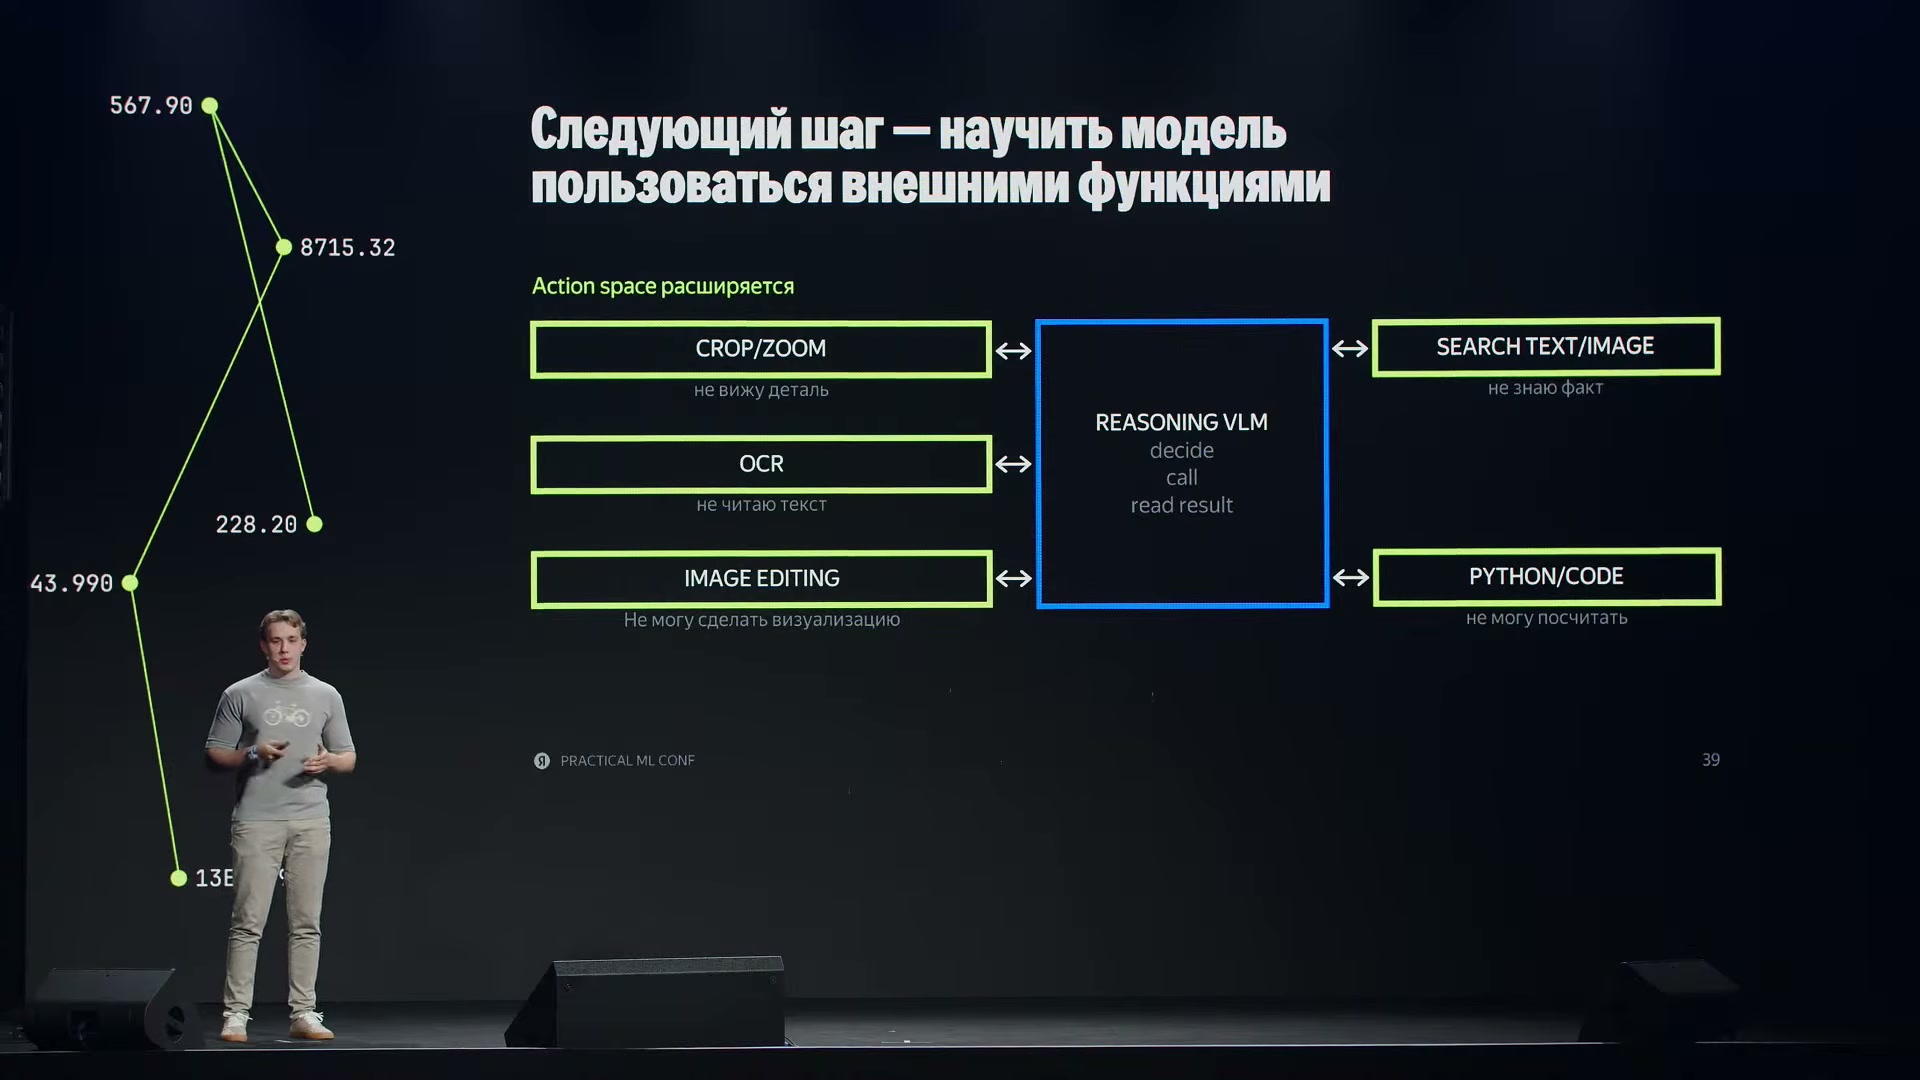
Модель выбирает инструмент под недостающую возможность: рассмотреть фрагмент, прочитать текст, изменить изображение, найти факт или выполнить вычисление.
Источник: Данил КашинПочему простое подключение функций ухудшило качество
Самую прямую гипотезу команда проверила первой: готовой рассуждающей модели передали описания функций в контексте. Ожидалось, что она начнёт ими пользоваться. Но без соответствующего обучения качество снизилось на всех показанных тестах. Умение рассуждать не оказалось достаточной подготовкой к работе с внешним исполнителем.
Здесь сравнивается готовая рассуждающая модель до и после подключения функций без специального обучения. Таблица показывает изменения метрик, а не исходные и конечные оценки. Единица обозначена как «Дифф, %»; трактовать эти числа как процентные пункты оснований нет. Это отрицательный результат конкретного способа подключения, а не доказательство бесполезности инструментов.
Одна группа ошибок касалась использования результата. Python-интерпретатор возвращал ответ, а модель отвергала его и пыталась пересчитать всё самостоятельно. Внешнее вычисление было выполнено, но не становилось полезным шагом решения.
Другая ошибка проявлялась при сбое: если среда выполнения не возвращала результат функции, модель могла зациклиться на повторных вызовах. Наличие доступного инструмента ещё не означало, что модель умеет продолжать работу при его отказе.
Возникали и обращения к поиску без содержательной необходимости. При решении заданий ЕГЭ модель уходила в интернет, находила готовый ответ и предъявляла его как собственное решение. Поиск подменял проверку нужного навыка: найденный результат не показывал, что модель решила задачу.
В редактировании изображений проблема была ещё прямее: модель сообщала об успехе, хотя инструмент вообще не вызывался. На слайде приведён пример, где она объявляет, что превратила пейзаж в зимний, но вызова редактирования не было. Это не просто неполный отчёт после выполненного действия — само действие отсутствовало.
Все эти случаи связывает один разрыв: текст модели не был надёжно согласован с происходящим во внешней среде. Стало необходимо обучать не только выбору функции, но и ожиданию реального исполнения, использованию результата и переходу от него к следующему шагу.
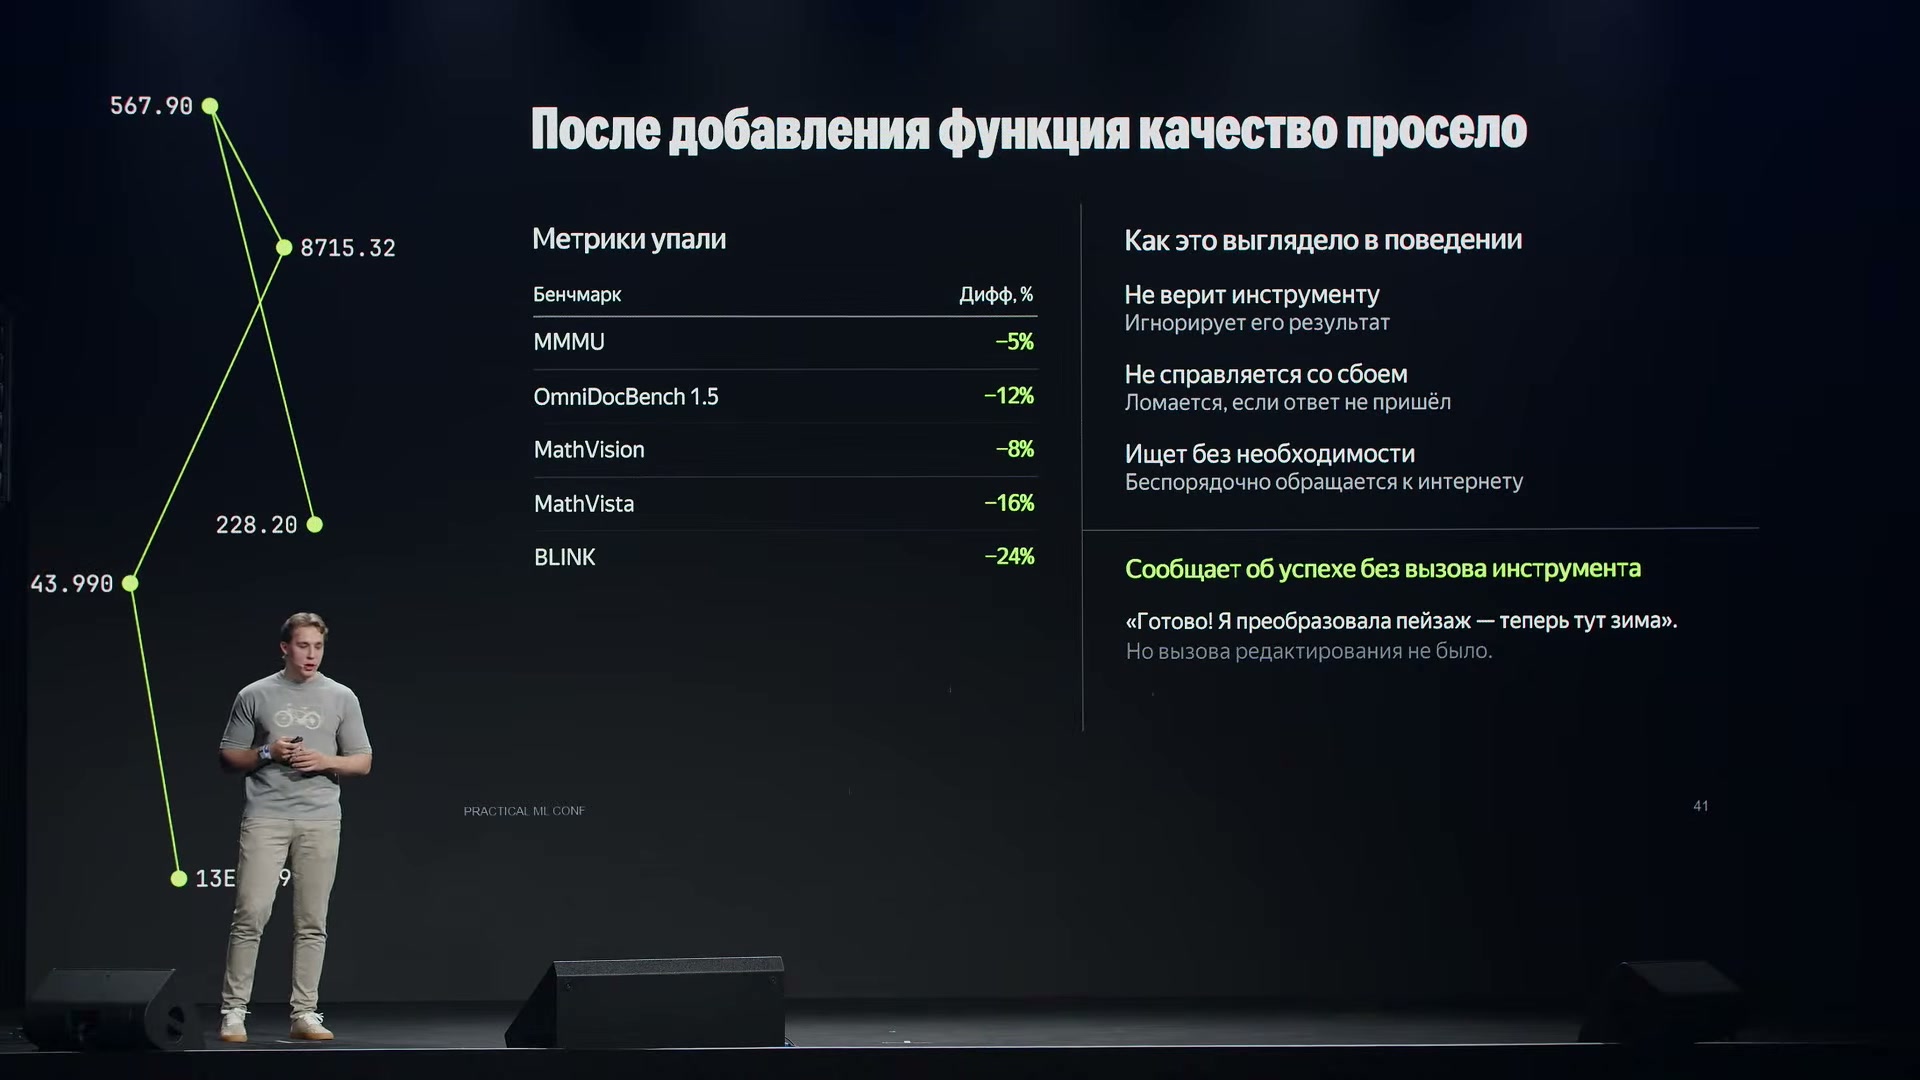
Без специального обучения подключение функций ухудшило пять показанных метрик. Среди ошибок — сообщение об успешном редактировании, которого на самом деле не было.
Источник: Данил КашинОбучать пришлось всю цепочку действий
После отрицательного эксперимента единицей обучения стала полная траектория — последовательность рассуждений и действий, ведущих к ответу. Модель получает изображение и вопрос, рассуждает о недостающей информации, формирует вызов, а внешняя среда действительно выполняет запрос. Возвращённый результат становится новым наблюдением, после которого модель продолжает решение.
В новой схеме обучаются несколько связанных решений: чего не хватает, что вызвать, как прочитать результат и как продолжить рассуждение. Последним остаётся решение об остановке и итоговом ответе. Это отличается от прежней последовательности «изображение — рассуждение — ответ»: между состояниями модели появляется реальное внешнее действие.
К обучаемому рассуждению таким образом добавили обучаемые вызовы инструментов. Важен переход через исполнение: ответ внешней функции нельзя заменить утверждением модели о том, что она якобы что-то получила или изменила. В докладе обучение описано как охватывающее всю траекторию, а не только её финальную реплику.
Для холодного старта снова недостаточно взять любой пример, закончившийся правильным ответом. У последовательности действий появились дополнительные требования.
Последнее условие осложняет перенос примеров от большой модели к маленькой. Если сильную модель запустить в среде с инструментами и собрать её успешные решения, не все такие решения будут подходящими уроками для более слабой. Некоторые переходы, очевидные для генератора, останутся недоступными ученику. Поэтому успешность исходного выполнения и пригодность полученного материала для обучения проверяют отдельно.
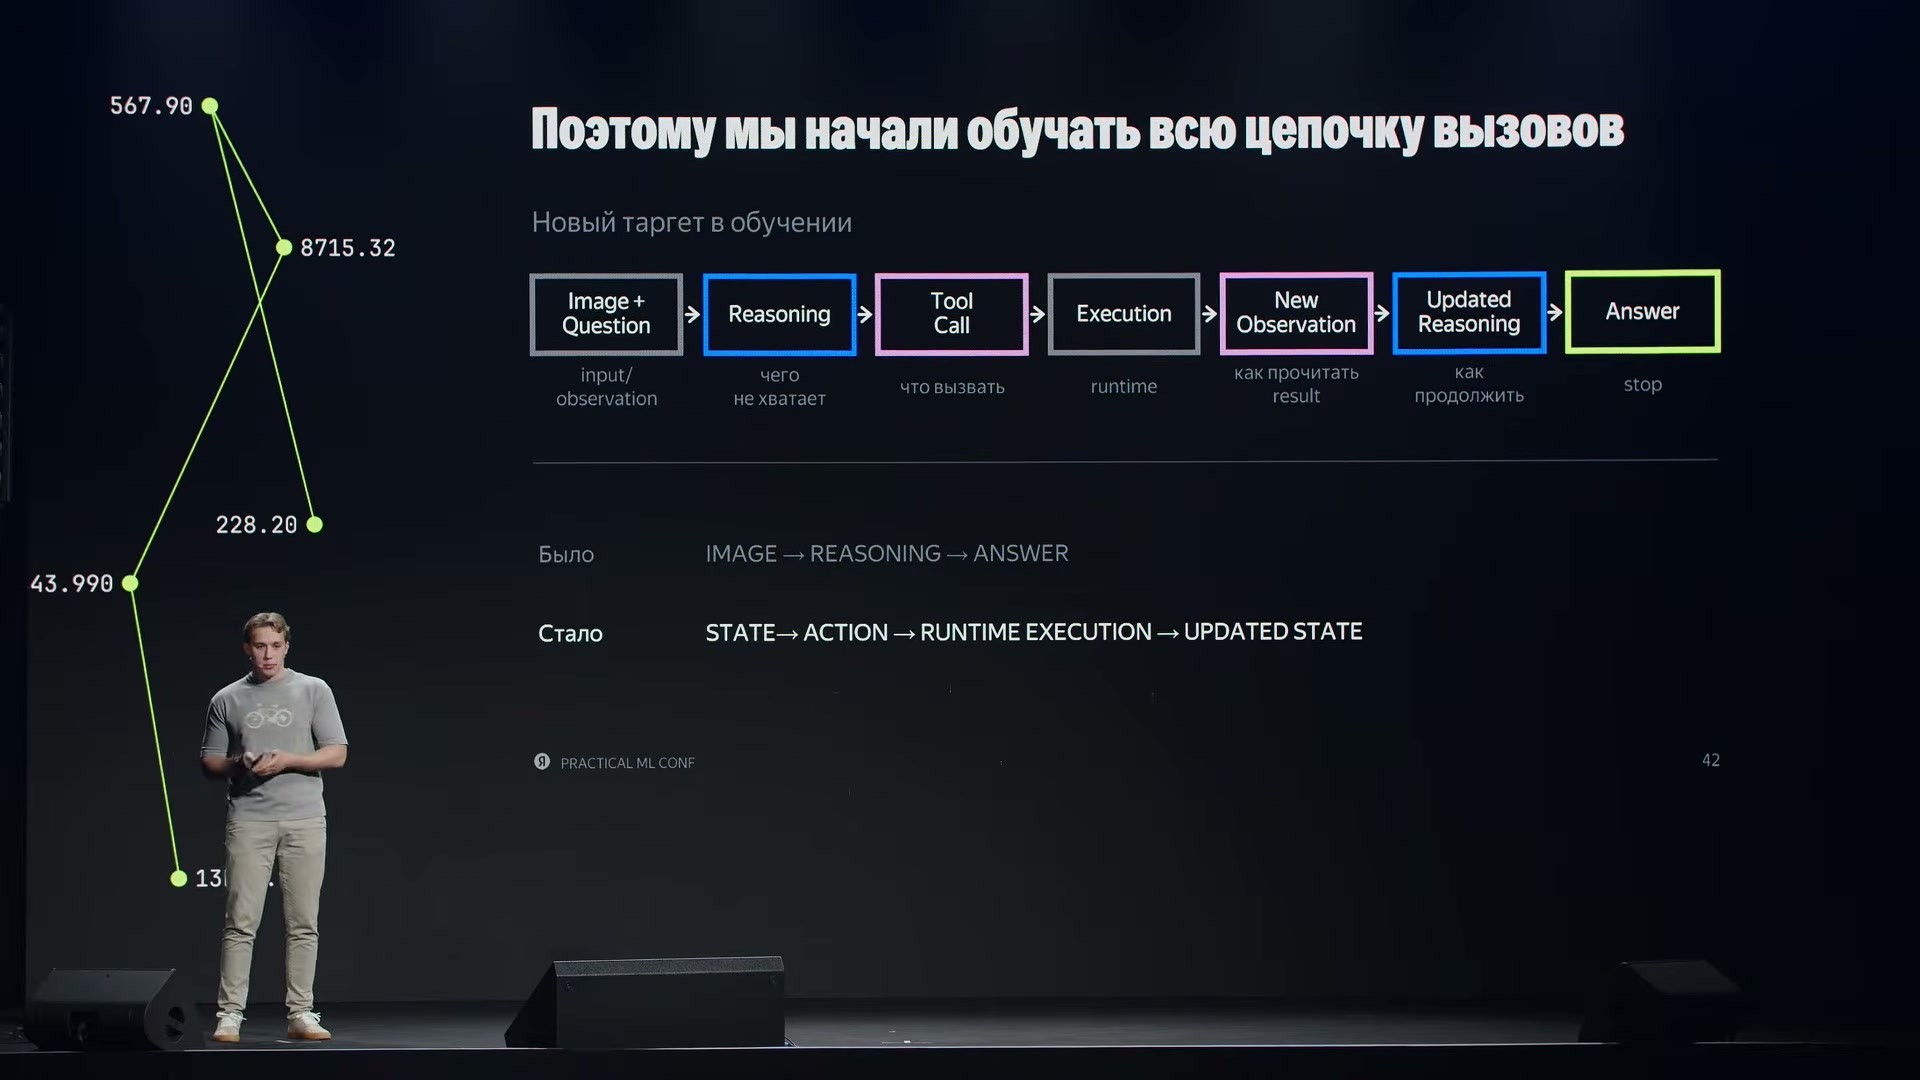
Новая обучаемая цепочка включает не только рассуждение и ответ, но и выбор функции, реальное исполнение, чтение результата и продолжение решения.
Источник: Данил КашинЧто добавилось к обучению с подкреплением при появлении инструментов
Обучение с подкреплением для работы с функциями опирается на уже заложенное качество рассуждения, но добавляет зависимость от внешней среды. Она должна исправно выполнять действия модели. Неработающие функции способны превратить дорогое обучение в бесполезную генерацию, поэтому их состояние приходится контролировать вместе с самой моделью.
Среда исполнения — набор доступных инструментов и правил взаимодействия с ними, в докладе называемый harness, — должна подходить задаче. Важно не только технически разрешить вызов, но и подобрать задания, где он действительно полезен. На слайде это выражено условием P(correct | tool) > P(correct | no tool): вероятность правильного решения с инструментом должна быть выше, чем без него. Это критерий полезности для подбора задач, а не опубликованная численная оценка вероятностей.
Наконец, оценка должна правильно связываться с решениями модели на протяжении цепочки. Такое распределение вклада действий в результат называют credit assignment. Оно нужно, чтобы поощрялось уместное использование функций, а не просто их присутствие в траектории. Иначе модель может уйти в одну из двух крайностей: вызывать инструменты всегда или перестать вызывать их совсем.
На слайде разобраны две слишком простые схемы награды. Оценка только финального ответа связана с риском утраты взаимодействия со средой. Добавление бонуса за сам факт вызова создаёт другую проблему — формальные, бесполезные обращения к инструментам. Модель выполняет поощряемое действие, но оно не помогает получить новые основания для ответа.
В качестве схемы конструирования награды автор показывает раздельный учёт правильности ответа, полученных свидетельств, исполнения и стоимости действий: R = R_answer + λR_evidence + ηR_execution − μ·action_cost. Здесь R_answer относится к итоговому ответу, R_evidence — к опоре на полученные сведения, R_execution — к исполнению, а action_cost — к затратам на действия. Коэффициенты λ, η и μ задают баланс составляющих.
Это рамка проектирования оценки, а не полная спецификация готовой функции награды. Её смысл в том, чтобы различать полезное обращение к внешней среде, корректное выполнение и лишние затраты. Одного поощрения правильного финального текста или любого вызова инструмента для этого недостаточно.
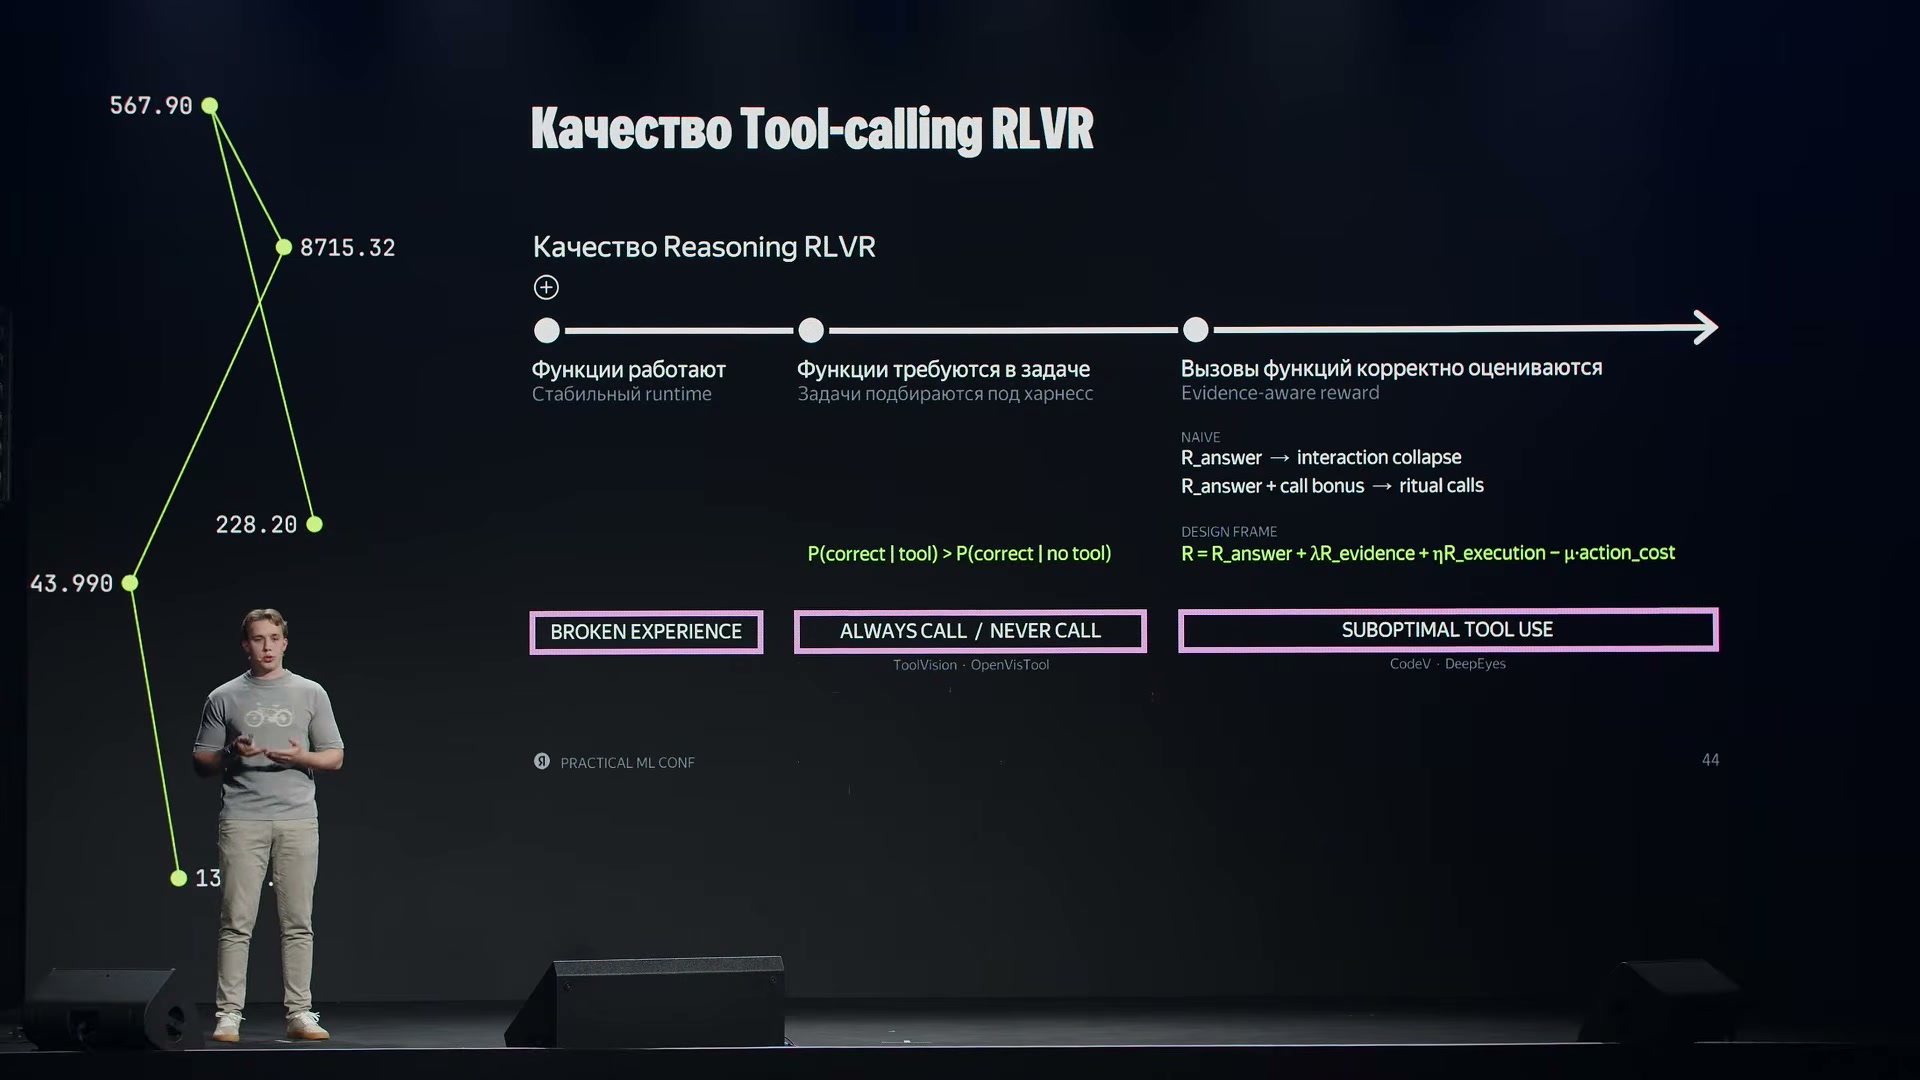
Для полезной работы с инструментами нужны исправная среда, подходящие задачи и оценка всей траектории. Бонус за любой вызов может закрепить бесполезные действия.
Источник: Данил КашинЧто показали сравнения и где преимущество оказалось неодинаковым
В конце команда вернулась к парным оценкам, с которых начиналась постановка проблемы. Новое сопоставление провели на моделях класса 35B. В рассуждающем режиме картина относительно открытой модели изменилась в пользу решения Яндекса. Отдельно оценили работу с функциями и сопоставили системы в общей среде исполнения.
Таблицу можно прокрутить по горизонтали.
Последнее сравнение автор сам ограничивает по смыслу. Оно помогало проверить, что собственное решение работает в целевой среде, но не было полностью симметричным соревнованием моделей. Знакомство одной из них с инструментами и правилами этой среды входит в условия результата.
Начальное сравнение YaVLM_v8.1_pro с Qwen3.5-397B-A17B и итоговое сравнение моделей класса 35B также нельзя превращать в одну пару «до — после»: меняются участники. Они показывают направление развития команды, но не дают единой величины прироста относительно неизменного соперника.
Помимо парных оценок, команда регулярно выполняла порядка сотни замеров на тестовых наборах. В итоговой таблице сопоставлены Alice AI Instruct, Alice AI 35B Reasoning и Qwen3.5-35B-A3B. Восемь показанных строк охватывают рассуждение, чтение текста, визуальное восприятие и следование инструкции.
Таблицу можно прокрутить по горизонтали.
Относительно Alice AI Instruct рассуждающий вариант выше во всех восьми строках. Например, на MathVista показатель меняется с 65,1% до 86,2%, а на MMVP — с 63,7% до 85,3%. При этом таблица сравнивает версии моделей: она не выделяет изолированный вклад одной настройки или одной стадии обучения.
Относительно Qwen картина неоднородна. Alice AI 35B Reasoning выше на VisuLogic, Ya_OCR_bench, MMVP, MME и YaIFbench; на MathVista значения совпадают. На MMMU-PRO и OmniDocBench 1.5 выше Qwen. Так конкретные строки объясняют, почему общий вывод об улучшении собственной модели не равен утверждению о превосходстве над открытой моделью во всех задачах.
Значения относятся к метрикам отдельных тестов. Их нельзя складывать в общий процент качества или считать показателями бизнес-эффекта. Парные предпочтения ответов, успешность на тестовых заданиях и поведение пользователей продукта — разные предметы оценки.
В более широком наборе замеров автор выделяет три ситуации. На внутренних тестах команда видела хороший устойчивый рост. На новых или непопулярных тестах результат относительно открытых моделей сильно зависел от конкретного среза задач. На популярных тестах добиться паритета или преимущества было сложнее.
Ещё одно важное уточнение прозвучало в ответах на вопросы. Команда параллельно развивала качество рассуждения и качество использования внешних функций. Поэтому улучшение ответов без инструментов не следует приписывать одному обучению вызовам. Обе ветки продвигались отдельно, а после объединения использование функций дало дополнительное улучшение. Это отличается от утверждения, будто подключение инструментов само по себе научило модель лучше рассуждать.
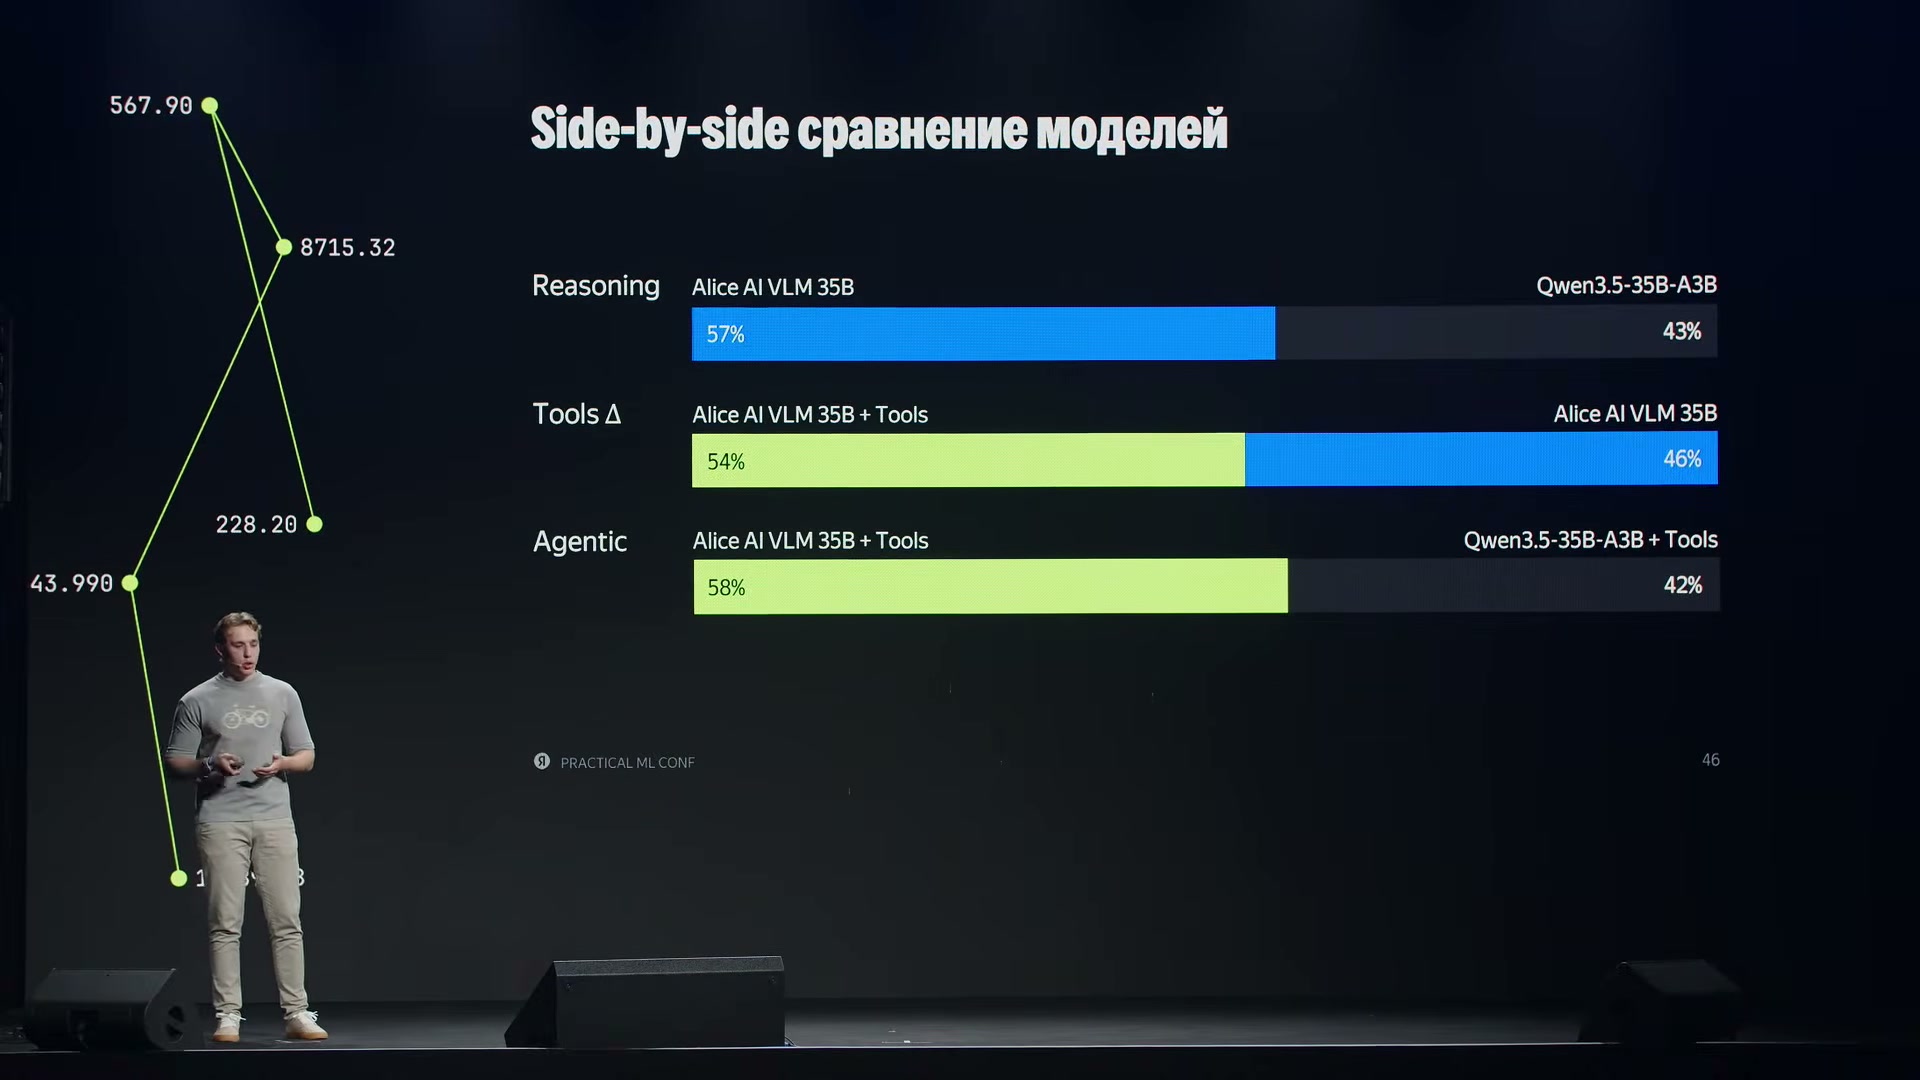
Три отдельных парных сравнения: рассуждение, добавление инструментов и работа двух моделей с инструментами. В последнем сравнении только модель Яндекса обучалась в целевой среде.
Источник: Данил Кашин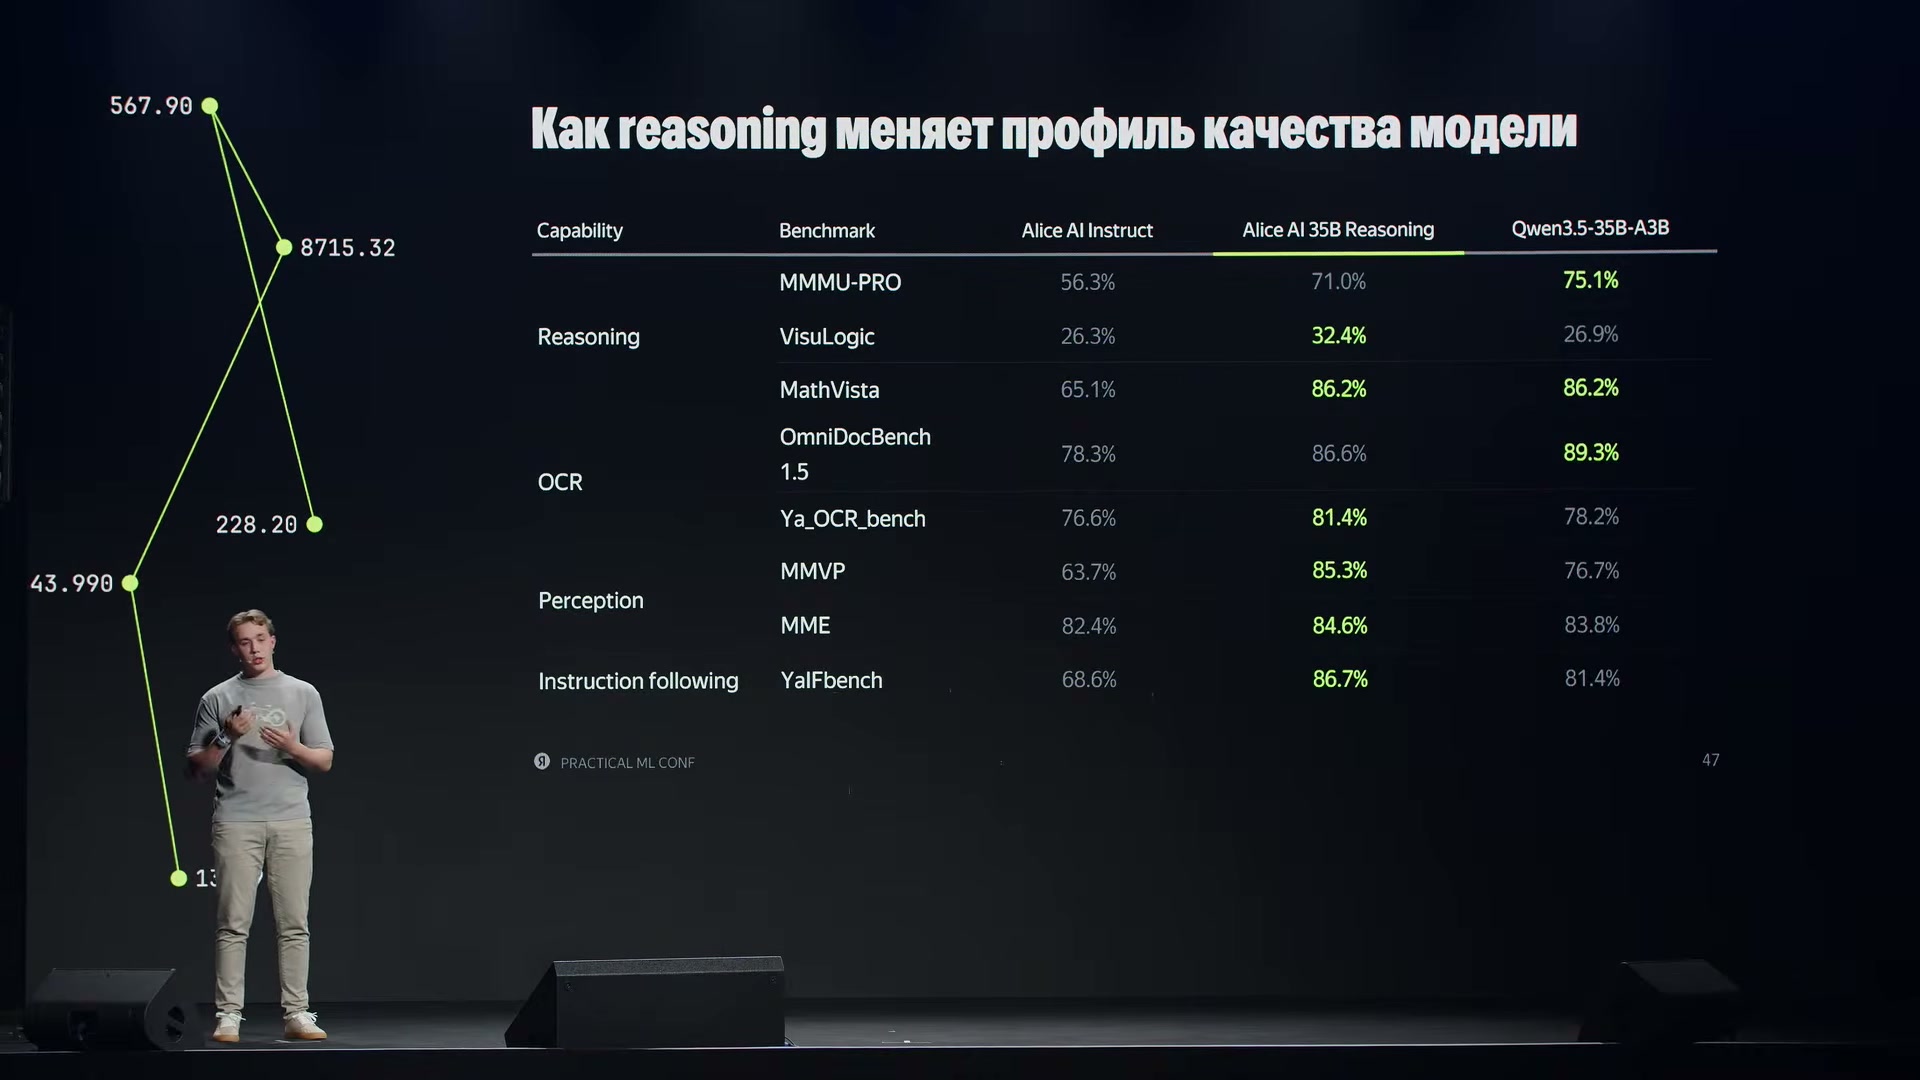
Alice AI 35B Reasoning выше инструктивной версии во всех восьми строках. Относительно Qwen результат различается: равенство на MathVista, отставание на MMMU-PRO и OmniDocBench 1.5, преимущество на остальных показанных тестах.
Источник: Данил КашинКак визуальные навыки связывают с общей моделью
В ответах на вопросы автор поместил описанную работу в более широкий контекст: визуальное направление составляет часть собираемой в Яндексе единой генеративной модели для разных задач. Это объясняет, почему вопрос об объединении навыков не ограничивается одной удачной визуальной задачей.
Разные задачи неодинаково реагируют на обучение. Для одних сложных задач улучшение может насыщаться после сотен шагов обучения с подкреплением; простым хватает более короткого периода, а некоторым такая стадия вообще не нужна. Подобрать баланс разных сигналов в одном обучении сложно, а заново искать его может быть дорого.
Один из используемых подходов — обучать отдельных экспертов по предметным областям, а затем передавать их навыки общей модели. Такой перенос поведения через обучение называют дистилляцией. Автор называет on-policy distillation, OPD, и её вариант с несколькими учителями; учителями выступают доменные эксперты. Число экспертов стараются ограничивать, потому что с его ростом сложнее следить за их взаимодействием.
При этом в визуальном направлении на момент доклада удавалось удерживать одну модель. Возможную дистилляцию между разными визуальными задачами автор обсуждает как дальнейший вариант, а не как уже обязательную часть описанной системы.
Команду интересует не только объединение отдельных навыков. Важно, чтобы обучение разным задачам помогало им улучшать друг друга и давало возможности, не сводящиеся к раздельному решению каждой задачи. Поэтому по возможности сохраняют совместное обучение, а объединение экспертов не представляют безусловной заменой этому пути.
Доклад · 03:26:01Как проверяли перенос на другие среды и большие модели
Обучение под конкретную среду создаёт риск слишком сильной привязки к её особенностям. Чтобы не ограничиваться целевым вариантом, команда увеличивала разнообразие сред и задач, включая задачи вне основного продуктового набора. Это направление существовало рядом с работой над качеством в той среде, на которую непосредственно ориентировались.
Автор описывает две ветки: одна сосредоточена на собственной среде исполнения, другая — на более общем умении работать с разными средами. Высокий показатель в знакомом наборе инструментов сам по себе ещё не показывает такую же переносимость на другие условия.
Похожая осторожность нужна при переходе от маленьких моделей к большим. Отдельной задачей становится масштабирование самого обучения. Кроме того, эксперимент должен оставаться достаточно показательным для большой модели, а не только для удобной маленькой версии. По словам автора, изменения в итоге обязательно проверяют в условиях обучения большой модели, чтобы убедиться в их пригодности для основного процесса.
Обсуждение открытой публикации не сопровождалось конкретным обязательством. На момент выступления команда хотела подготовить модель, которая заметно выделялась бы относительно доступных решений, но автор не обещал ни выпуска, ни его сроков. Поэтому описанные результаты относятся к представленным экспериментам, а не к обещанному открытому релизу.
Доклад · 03:30:37Итог: рассуждать над данными и получать новые наблюдения
Команда Яндекса перешла от заранее собранного внешнего контекста к модели, которая сама выбирает недостающую информацию. Подготовка потребовала нескольких стадий: генерации разнообразных рассуждений, проверки ответов и визуальной опоры, предварительного обучения на широком наборе и холодного старта на тщательно отобранных примерах. Затем обучение с подкреплением помогало чаще выбирать удачные решения. Работу с инструментами развивали параллельно: обучали всю последовательность действий с реальным исполнением функций и использованием их результатов. Это подготовка модели, а не операции, которые заново выполняются для каждого пользователя.
- 01
Получить задачу
Модель принимает вопрос и одно или несколько изображений. Они образуют исходный контекст решения.
- 02
Определить пробел
Модель рассуждает над запросом и решает, достаточно ли доступных сведений для ответа или требуется уточнение.
- 03
Выбрать действие
При необходимости модель запрашивает фрагмент изображения, распознавание текста, поиск, редактирование или выполнение вычислений — в зависимости от задачи.
- 04
Получить результат
Внешняя среда действительно выполняет вызов и возвращает результат. Модель использует его как новое наблюдение, а не подменяет исполнение сообщением об успехе.
- 05
Продолжить или ответить
С обновлённым контекстом модель выбирает следующий шаг либо формирует ответ. Вызов инструмента не обязателен для каждого запроса.
В представленных тестах Alice AI 35B Reasoning превзошла инструктивный вариант по всем восьми показанным строкам, но относительно Qwen результат зависел от задачи. Обученная работа с функциями также улучшила парные оценки. Это результаты тестирования моделей, не бизнес-эффект. Сравнение в общей среде ограничено разной подготовкой участников: только модель Яндекса обучалась в ней. Ошибки исходных примеров, неисправность исполнения и неудачная награда оставались существенными рисками. Итоговый подход сочетает рассуждение с получением новых наблюдений, а не полагается только на увеличение длины ответа.
Доклад · 03:22:53