Разбор готов
Wildberries: как устроен мультимодальный «Поиск по фото»
В «Поиске по фото» Wildberries пользователь может загрузить скриншот, фотографию из галереи или другое изображение и искать товар без точного текстового запроса. Это полезно, когда нужен конкретный предмет, его трудно описать словами или пользователь не знает название и производителя. За простым интерфейсом стоит несколько связанных задач: сначала система находит объект или артикул на фотографии, затем строит общее визуальное представление через SigLIP2, после чего запрос может пойти в одну из трёх ветвей — основной поиск похожих товаров, поиск текстовых тегов или уточнение изображения текстом. Разберём весь путь: данные для Image Retrieval, Attention-голову и MRL, векторный индекс Qdrant, офлайн-генерацию тегов, проекцию текста в пространство изображений, closed-form базовый вариант, обучение текстового уточнения и результаты онлайн-эксперимента.
Материал полезен ML- и CV-инженерам, которые строят поиск по изображениям, мультимодальные retrieval-системы или сервисы с большим векторным каталогом. Особенно интересны практические границы решения: какие вычисления вынесены офлайн, зачем команде одно общее пространство SigLIP2, как сжимают векторы и почему качество тегов нельзя оценивать одной метрикой.
Статья · на русском
CLIP + LLM в проде: мультимодальный «Поиск по фото» для маркетплейсаНикита Романов · Опубликовано: 17 октября 2025 г.
От фотографии к мультимодальному запросу
Сервис рассчитан не только на аккуратные каталожные фотографии. Источником может быть скриншот из социальной сети или браузера, снимок из галереи и вообще изображение, на котором нужный товар занимает лишь часть кадра. Поэтому перед поиском системе нужно понять, какую область фотографии пользователь действительно хочет искать.
На входе работают два сценария детекции. Первый использует модель семейства YOLO для основных объектов и, по описанию команды, охватывает порядка 90% категорий маркетплейса — от одежды до мебели. Второй — E2E OCR, то есть единая модель обнаружения и распознавания текста, заточенная под артикулы. Такой сценарий нужен, например, когда на опубликованном изображении уже присутствует номер товара.
После детекции пользователь выбирает предложенную область изображения. Этот кроп передаётся в общую модель SigLIP2, которая превращает изображение в числовое представление — эмбеддинг. Дальше архитектура расходится на три ветви: основной Image Retrieval для поиска товаров по изображению, векторный индекс текстовых тегов и модель уточнения запроса текстом. Общий визуальный энкодер позволяет этим задачам переиспользовать одно исходное представление изображения.
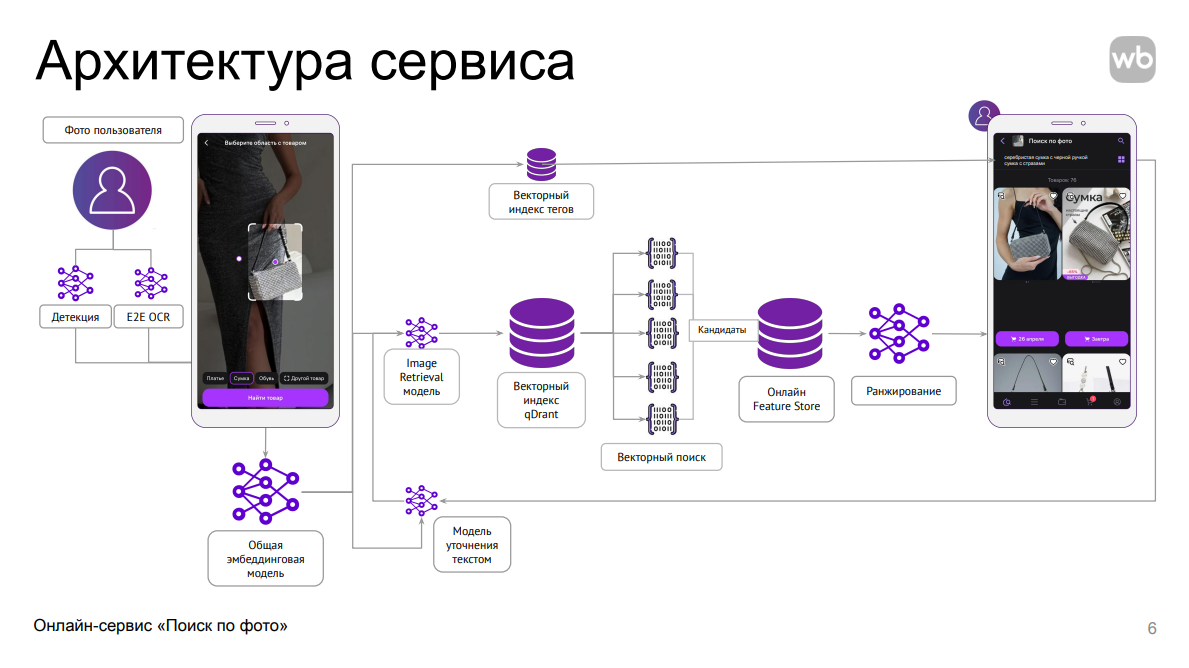
Архитектура онлайн-сервиса: YOLO/E2E OCR выделяют область, общий эмбеддинг изображения расходится в Image Retrieval, индекс тегов и модель уточнения текстом; основной поиск проходит через Qdrant, векторный поиск и ранжирование.
Источник: Никита РомановОсновной поиск и индекс из 400 миллионов товаров
В основном сценарии выход общего визуального энкодера проходит через модель Image Retrieval, после чего получается вектор для поиска по каталогу. Векторы товаров заранее лежат в Qdrant. Внутри индекса используется HNSW — структура для быстрого приближённого поиска ближайших векторов без полного сравнения запроса со всеми товарами.
Найденные векторным поиском товары ещё не являются окончательной выдачей. Кандидаты обогащаются характеристиками товара — в статье перечислены цена, количество отзывов и рейтинг. Затем их упорядочивает бустинговая модель, а уже во время запроса порядок дополнительно корректируется с учётом логистики.
Для векторного хранилища команда сравнивала Redis, Milvus, Weaviate и другие открытые решения. По её нагрузочным тестам Qdrant показал лучший результат: выдерживал большее число запросов в секунду (RPS) при меньшей задержке и позволял перестраивать индекс во время работы. Конкретные значения RPS и условия этого сравнения источник не приводит.
Здесь 250 мс — среднее время всего сервиса от загрузки изображения до готового ответа при описанном индексе, а не только время HNSW. Перцентиль задержки, используемое оборудование и нагрузка в статье не раскрыты.
Абзацы после «После Feature Extractor Backbone идём в модель Image Retrieval» и раздел «Почему мы используем именно Qdrant?»WB 200M: как собирали пары для визуального поиска
Для обучения Image Retrieval команда собрала датасет WB 200M. Положительные пары получают из двух источников одной карточки товара: галерейных фотографий продавца и пользовательских фотографий из отзывов. Задача модели — научиться понимать, что товар остаётся тем же самым, даже если фон, освещение, ракурс и качество съёмки сильно отличаются.
Перед обучением данные проходят несколько стадий очистки. CLIP-подобные модели, в том числе SigLIP2, используются для удаления дублей, шумов и выбросов. В качестве типичного мусора автор перечисляет размерные сетки, рекламу, упаковку и изображения другого товара. Затем пары попадают на разметку, где проверяется главное условие: является ли объект на фотографии A тем же объектом, что и на фотографии B.
Отдельно удаляются или отсеиваются плохо пригодные фотографии: сильно размытые и тёмные кадры, чрезмерная макросъёмка и случаи, когда товар находится слишком далеко. Последний этап аугментации связан с детекцией главного объекта. Во время обучения команда выборочно выделяет его, чтобы эмбеддинговая модель меньше зависела от фона, лица модели и других посторонних деталей карточки.
Раздел «Модель распознавания — основной сценарий», от описания WB 200M до пункта про детекцию главного объекта как последнюю аугментациюSigLIP2, Attention-голова и устойчивое объединение токенов
Перед выбором основы команда сравнивала DFN, BLIP3, SigLIP и другие модели. В текущем варианте она перешла на SigLIP2, который, по данным автора, оказался лучше по основным офлайн-метрикам Precision, F1 и mAP. Приложенный слайд показывает это сравнение на нескольких retrieval- и KNN-метриках, но точные значения каждой точки на радаре не подписаны.
Сам SigLIP2 при обучении Image Retrieval заморожен: его параметры не меняются. Поверх него обучается Attention-голова, а затем применяется MRL с функцией потерь InfoNCE. InfoNCE здесь используется для обучения представлений на соответствующих друг другу примерах: модель должна давать близкие векторы подходящим парам изображений и различать остальные примеры.
Attention-голова сначала уменьшает размерность токенов SigLIP2, нормализует их и обрабатывает многоголовым механизмом внимания. На схеме показаны четыре головы внимания, затем выходная проекция, восемь токенов размерности 512 и Attention Pooling, который сворачивает их в итоговый вектор размерности 512.
Необычная часть архитектуры — UnLearnable Token. Это токены, которые участвуют в вычислении внимания, но сами не обучаются градиентом. Команда инициализирует их через средние по датасету Query-параметры Multi-Head Attention. По наблюдению авторов, такие фиксированные семантические якоря делают обучение устойчивее к коллапсу внимания и улучшают итоговое качество.
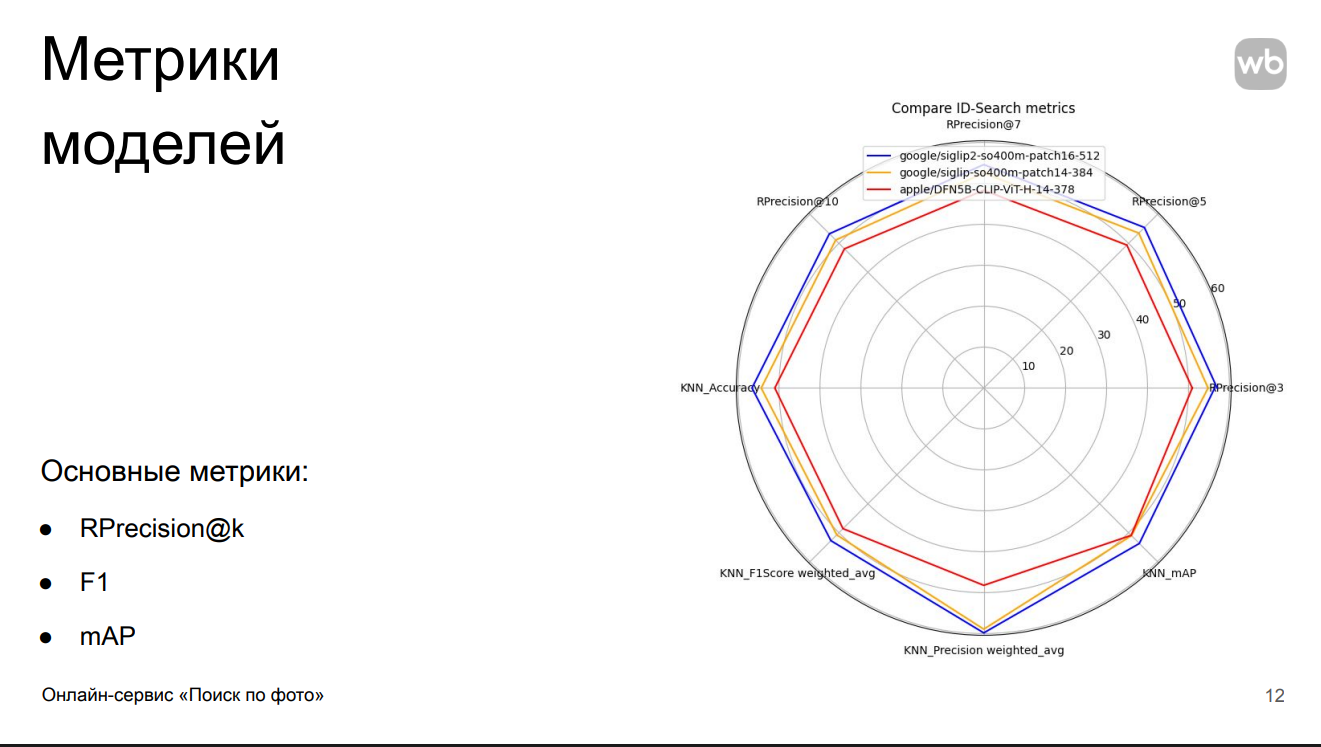
Радар офлайн-метрик сравниваемых визуальных моделей. На слайде показаны RPrecision, KNN Accuracy, weighted F1/Precision и mAP; кривая SigLIP2 выше альтернатив на показанных осях.
Источник: Никита Романов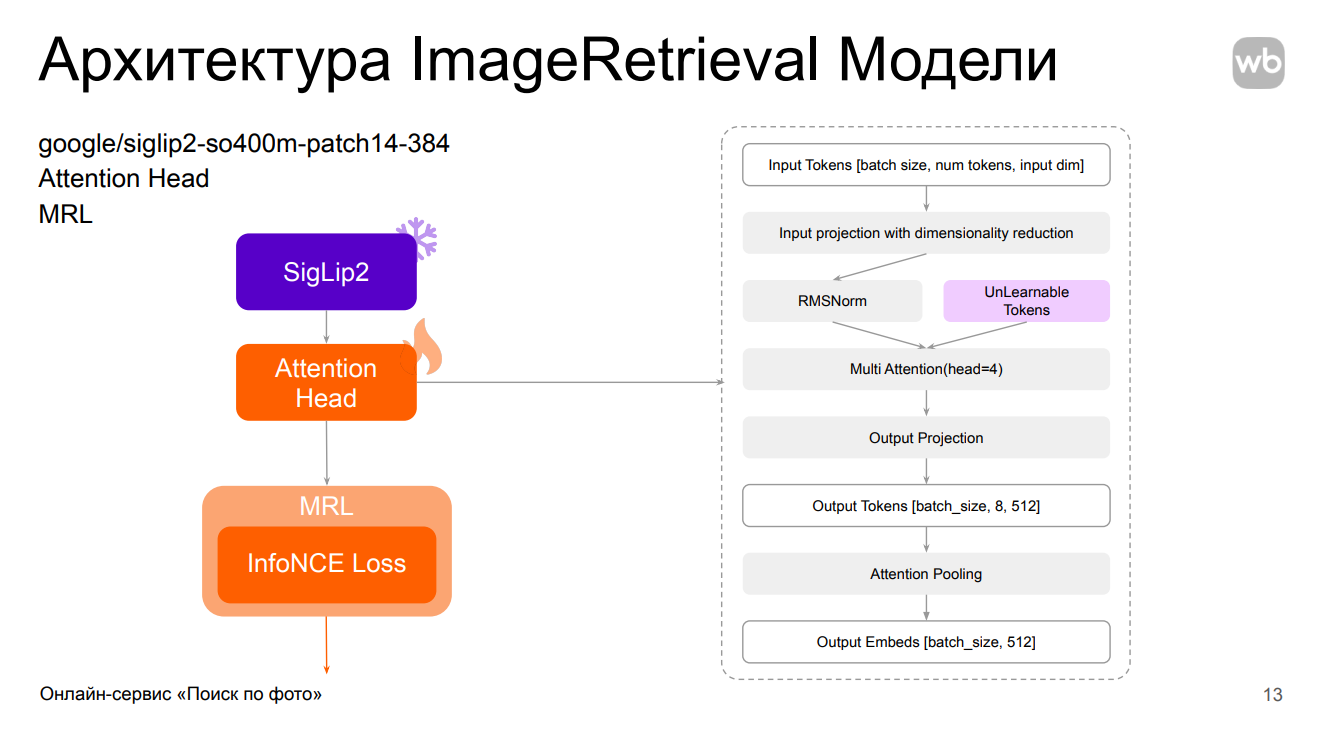
Архитектура Image Retrieval: замороженный SigLIP2, обучаемая Attention-голова и MRL. Внутри головы видны уменьшение размерности, RMSNorm, UnLearnable Tokens, Multi Attention с четырьмя головами, восемь выходных токенов размерности 512 и Attention Pooling.
Источник: Никита РомановMRL: один вектор, несколько рабочих размерностей
Matryoshka Representation Learning, или MRL, заставляет модель сохранять полезную информацию не только во всём эмбеддинге, но и в его более коротких частях. В показанной схеме на вход MRL приходит вектор размерности 512. Для вариантов 512, 256, 128 и 64 независимо считается InfoNCE Loss, после чего четыре значения усредняются в одну функцию потерь.
Для формирования обучающих пакетов команда старается собирать много положительных пар. Одновременно из одного пакета исключаются слишком похожие примеры, а категории выравниваются из-за сильного дисбаланса маркетплейса. Автор напрямую связывает такое сэмплирование с итоговым качеством модели.
Таблицу можно прокрутить по горизонтали.
Таблица относится к отдельному эксперименту с исходной размерностью 1024 и не должна смешиваться со схемой MRL, где показан вход 512 и срезы 512/256/128/64. Точные значения со слайда также уточняют словесное утверждение источника: большинство показанных приростов действительно находятся около 3,3–3,7%, но mAP/10 растёт на 2,48%, а не более чем на 3%.
По описанию команды, MRL ускоряет сходимость, позволяет сжимать векторное пространство и фактически задаёт порядок полезности признаков. На отдельном графике значения для векторов 256 и 512 отличаются лишь на третьем знаке после запятой. Автор использует это как аргумент в пользу более длинного представления в офлайн-задачах и короткого в онлайне и отдельно приводит пример 512 офлайн и 128 онлайн.
Это не единая конфигурация всех экспериментов. Ранее для работающего Qdrant указан вектор размерности 256 в fp16, а финальный онлайн A/B отдельно сравнивает 128 и 256. Поэтому размерности из схемы обучения, офлайн-сравнения и продового эксперимента нужно рассматривать в своих контекстах.
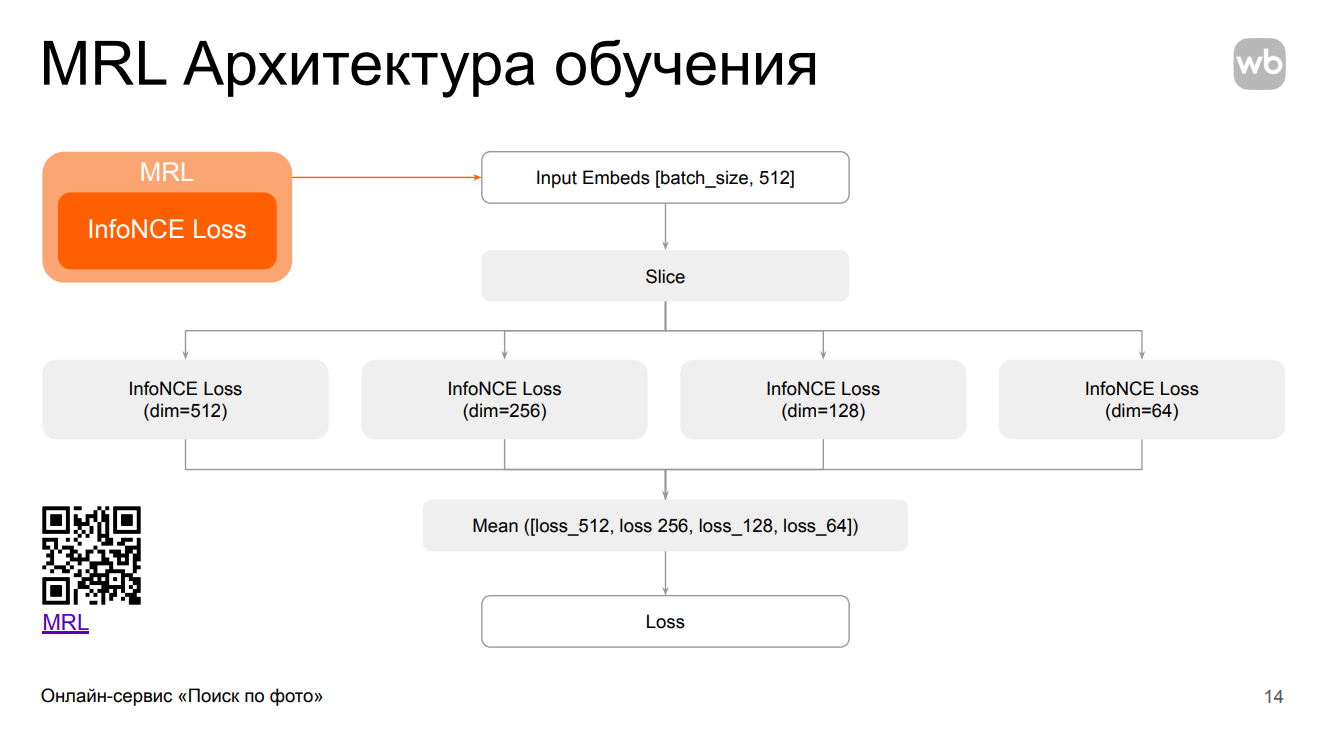
Схема обучения MRL для входного эмбеддинга 512: отдельные InfoNCE Loss на размерностях 512, 256, 128 и 64 усредняются в общий Loss.
Источник: Никита Романов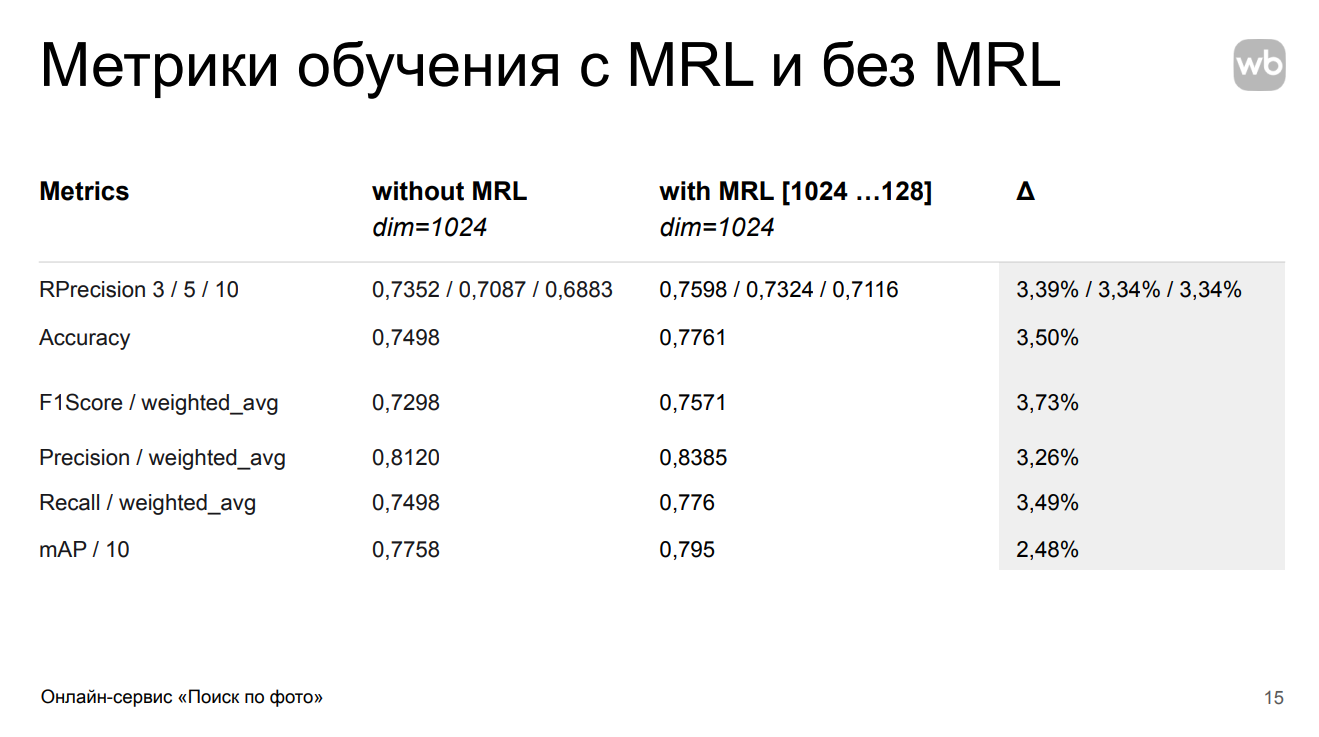
Точная таблица эксперимента dim=1024 без MRL и с MRL [1024 … 128]. Показаны RPrecision 3/5/10, Accuracy, weighted F1/Precision/Recall и mAP/10; mAP растёт на 2,48%, поэтому словесное «более 3% на всех метриках» буквально таблицей не подтверждается.
Источник: Никита Романов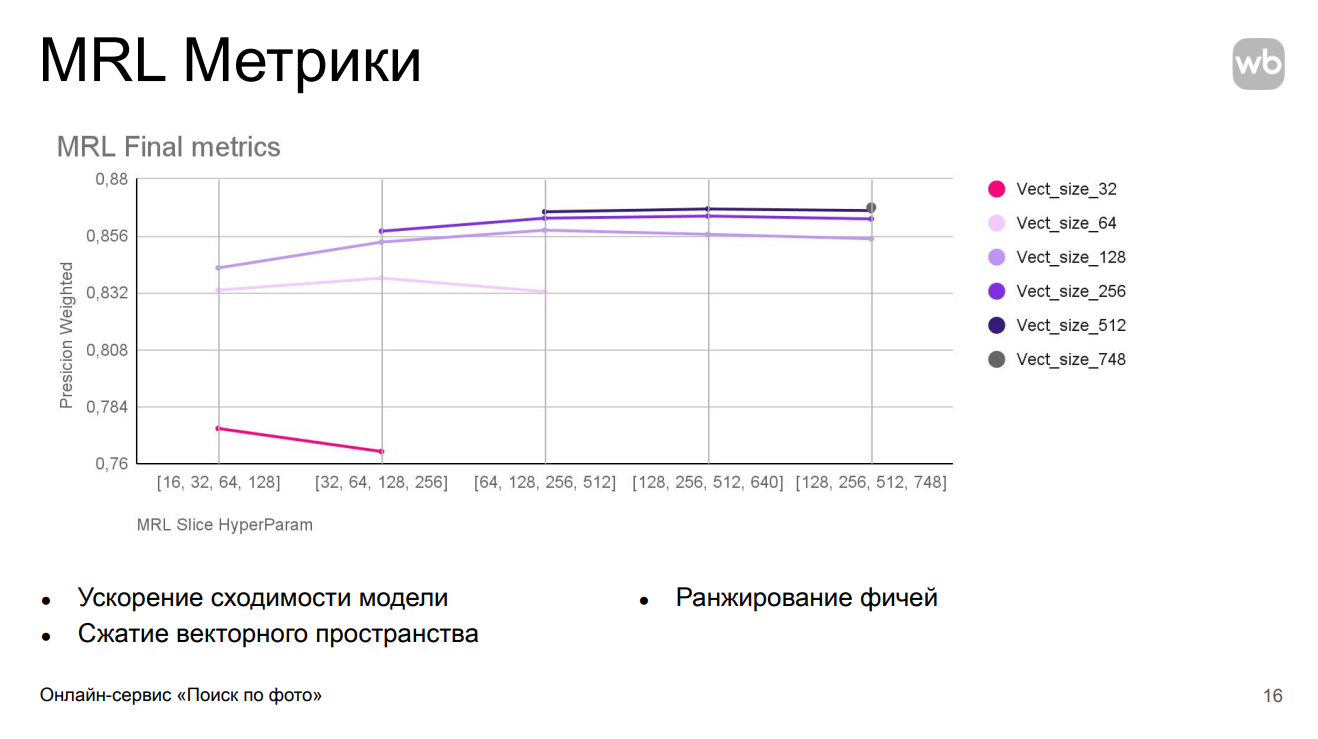
MRL Final metrics для разных наборов срезов и размеров вектора. На графике отдельно присутствуют 32, 64, 128, 256, 512 и 748; линии 256 и 512 находятся очень близко.
Источник: Никита РомановПочему текстовые теги генерируются офлайн
Вторая ветвь системы помогает словами уточнять содержание загруженного изображения. Один пользователь может искать именно квадратную подушку, а цвет считать несущественным; для другого главным будет жёлтый цвет. Поэтому теги должны описывать разные визуальные характеристики и поддерживать разные намерения после первоначального поиска по фотографии.
Все теги команда генерирует заранее. Онлайн-генерацию через языковые и визуально-языковые модели автор считает слишком дорогой и плохо контролируемой по качеству: VLM, то есть модель, которая получает изображение и генерирует текст о нём, может галлюцинировать и предлагать нерелевантные характеристики.
Таблицу можно прокрутить по горизонтали.
В статье второй и третий варианты рассматриваются рядом. Автор отмечает, что VLM-подход в своё время давал лучшие результаты, особенно после появления Qwen 2.5 и Qwen 3, но одновременно подчёркивает его сложность. Это не отменяет последующей фильтрации и постобработки.
Шум у тегов бывает не только техническим. Команда встречала эмоциональные описания, семантически несогласованные фразы, опечатки и слова на другом языке. В итоге было сгенерировано около 1 млн офлайн-тегов разной длины и содержания. Дальше задача формулируется как TagRetrieval — поиск подходящих тегов по вектору изображения.
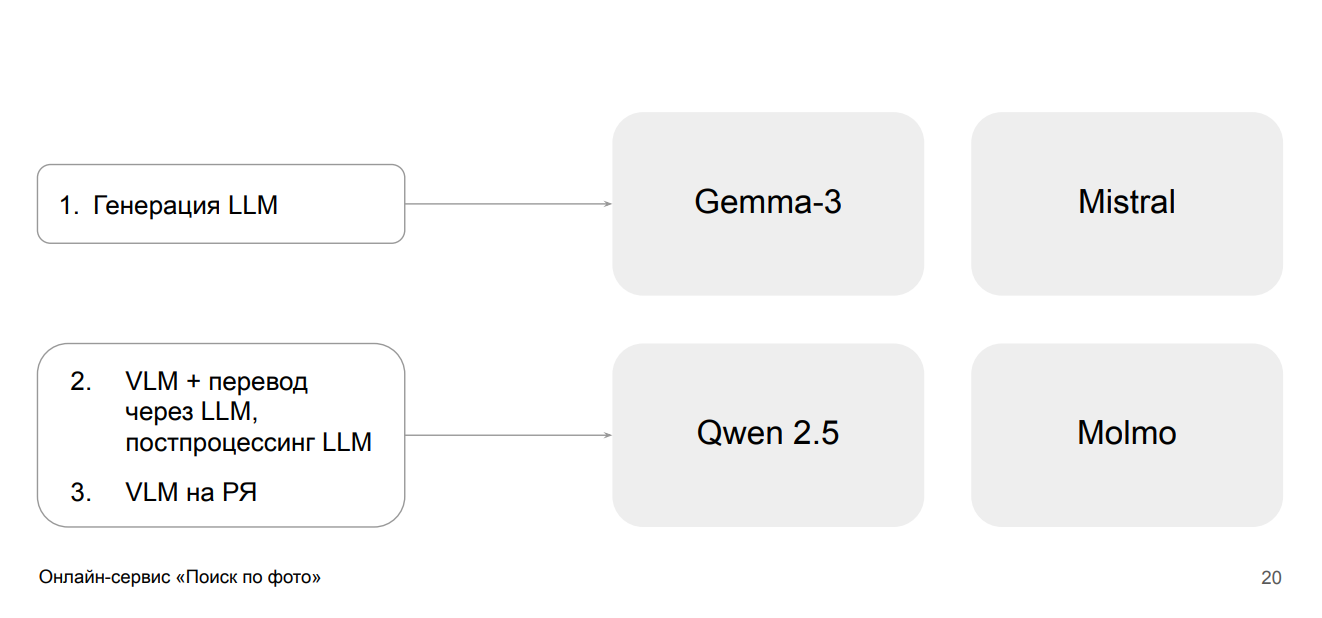
Три направления генерации тегов: LLM-генерация, VLM с переводом и LLM-постобработкой, а также VLM на русском языке. На слайде показаны Gemma-3, Mistral, Qwen 2.5 и Molmo.
Источник: Никита РомановКак текст переносится в пространство SigLIP2
Чтобы не запускать тяжёлую генерацию во время запроса, команда заранее кодирует теги и помещает их в то же пространство, в котором находится изображение. Текст сначала проходит через LLM- или BERT-эмбеддер, изображение — через SigLIP2. Небольшая полносвязная сеть MLP обучается преобразовывать именно текстовое представление в пространство SigLIP2. Визуальное пространство при этом служит целевым, а не перестраивается под текст.
После такого обучения во время пользовательского запроса достаточно один раз получить SigLIP2-эмбеддинг картинки и искать по заранее рассчитанным векторным представлениям тегов. Тяжёлая работа с генеративными моделями остаётся в офлайн-подготовке.
Для быстрой линейной базовой модели команда использует closed-form решение. Интуитивно это способ сразу найти оптимальную линейную матрицу преобразования по всем обучающим парам без итеративного градиентного обучения. Формула на слайде: W* = (XᵀX)⁻¹XᵀY. Поэтому при пакетной обработке можно отдельно накапливать XᵀX и XᵀY, а затем подставить их в эту формулу. Просто перемножить XᵀX на XᵀY, как можно понять из неточного словесного описания в тексте, недостаточно: в формуле присутствует обратная матрица (XᵀX)⁻¹.
Главный недостаток closed-form варианта — требования к оперативной памяти на больших матрицах. Поэтому необходимые произведения накапливаются частями. Это позволяет использовать решение как быстрый базовый вариант даже при большом объёме исходных представлений.
Ещё один приём — ортогональная инициализация пар слоёв. Первый слой инициализируется матрицей Q, парный ему — транспонированной Qᵀ. На схеме перед такими парами также показан предварительно рассчитанный closed-form слой W. По данным автора, ортогональная инициализация ускоряет сходимость в 4 раза и добавляет 2–3% к финальным метрикам.
Качество тегов команда смотрит сразу с нескольких сторон: Word Recall Rate, Word Error Rate и retrieval-метрики. Между ними есть реальный конфликт. Word Recall Rate поощряет более длинные описания, поэтому модель может начать добавлять неподтверждённые детали. Error Rate и retrieval-метрики, наоборот, приходится штрафовать за дополнительные слова, хотя часть таких уточнений может быть полезна пользователю. В источнике это важное ограничение оценки: одной универсальной метрики для качества тегов нет.
Пример из статьи показывает, зачем нужны достаточно подробные теги: для фотографии белого кружевного топа модель извлекает не только описание кружева, но и характеристики аксессуаров и узора. Одновременно этот пример объясняет риск — чем подробнее описание, тем больше пространства для ненужных или ошибочных деталей.
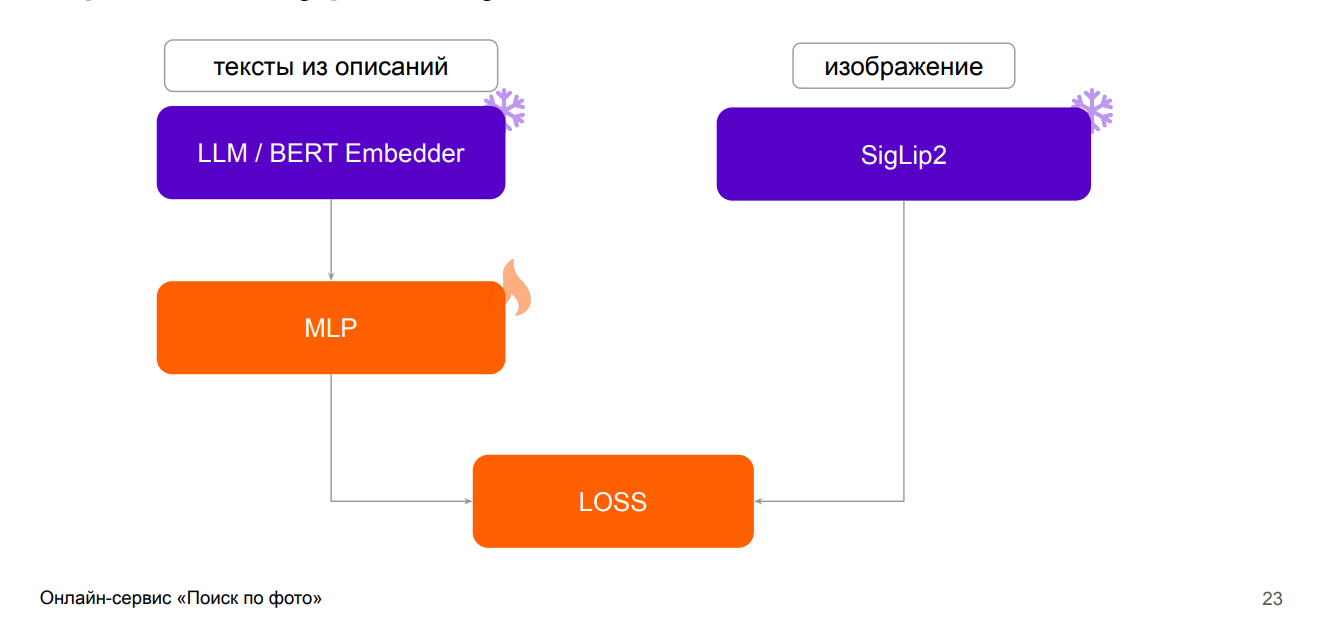
Обучение TagRetrieval: текст проходит через LLM/BERT Embedder и обучаемую MLP, изображение — через замороженный SigLIP2; функция потерь сближает итоговые пространства.
Источник: Никита Романов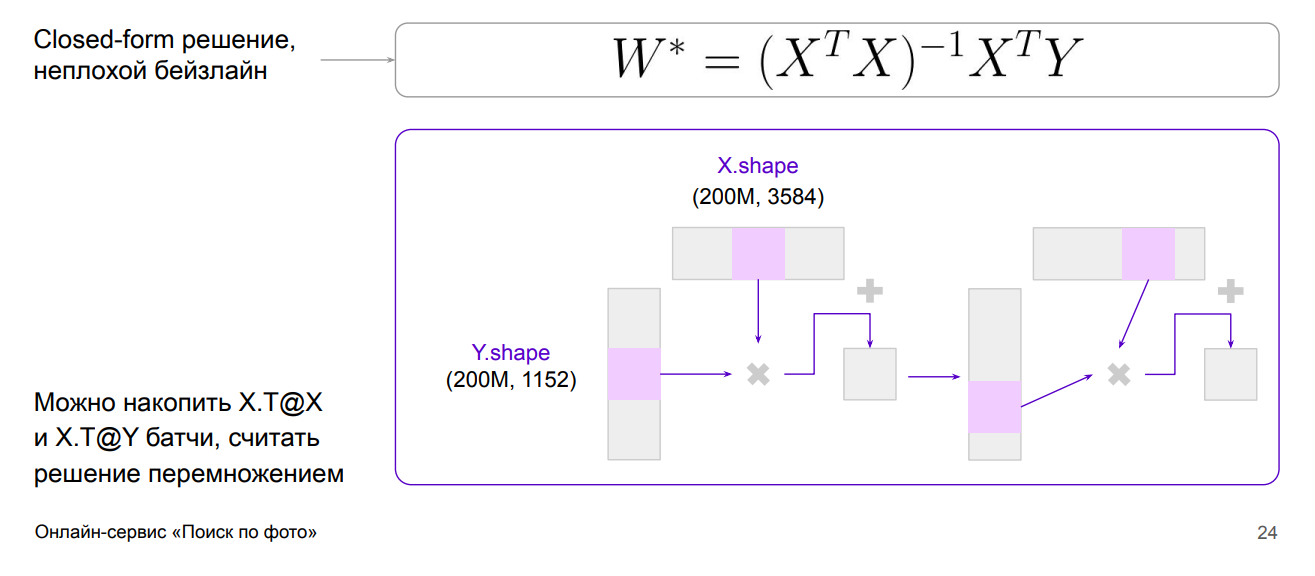
Closed-form базовый вариант с формулой W* = (XᵀX)⁻¹XᵀY. На слайде также показаны X.shape = (200M, 3584), Y.shape = (200M, 1152) и идея пакетного накопления XᵀX и XᵀY.
Источник: Никита Романов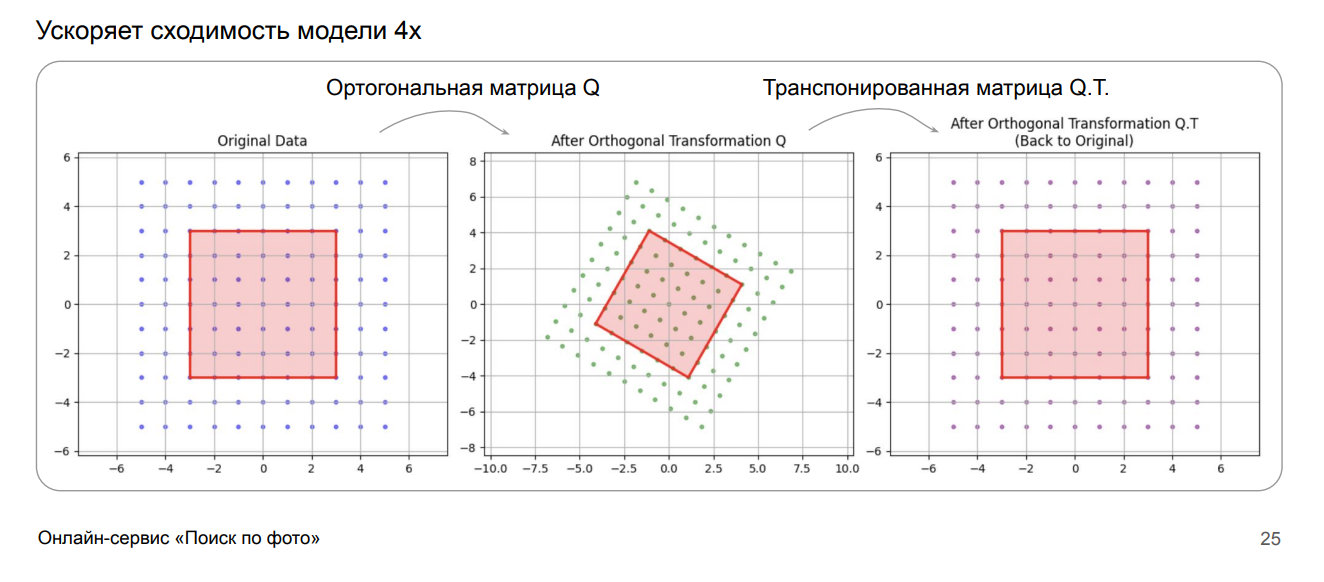
Иллюстрация ортогональной инициализации: преобразование матрицей Q и обратное преобразование Qᵀ; заголовок слайда сообщает об ускорении сходимости модели в 4 раза.
Источник: Никита Романов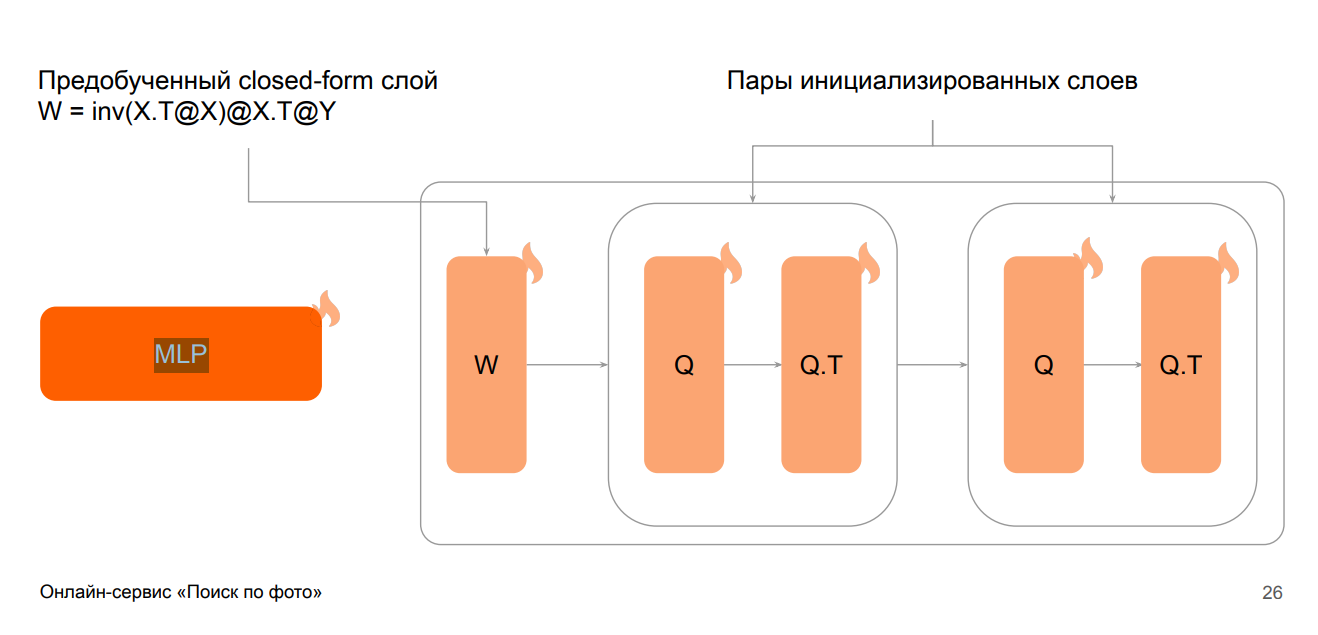
MLP-голова с предобученным closed-form слоем W и парами инициализированных слоёв Q и Qᵀ.
Источник: Никита РомановУточнение текстом: учимся менять одно свойство изображения
Третья ветвь решает более сложную задачу. Допустим, у пользователя есть фотография белой шапки нужной формы, но он хочет такую же красную. Обычный поиск по картинке тянет систему к белым шапкам, а чистый текст теряет информацию о форме. Поэтому входом становится комбинация исходной картинки и текста изменения.
Для обучения собираются триплеты «якорная картинка + текст изменения + целевая картинка». Естественный источник таких примеров — карточка одного товара с вариантами характеристик, например одна и та же модель в разных цветах. Приложенные слайды показывают ту же идею на примере перехода от белого предмета одежды к чёрному после добавления признака «чёрный».
Триплеты можно расширять синтетически: двум изображениям дают VLM с инструкцией описать различие, а полученный текст становится изменением между ними. Ещё один вариант строится целиком из текста. Названия товаров пропускаются через текстовый энкодер SigLIP2 и образуют три представления — якоря, целевого объекта и изменения. Здесь автор отдельно предупреждает о качестве данных: такие тексты могут быть шумными или слишком малоинформативными.
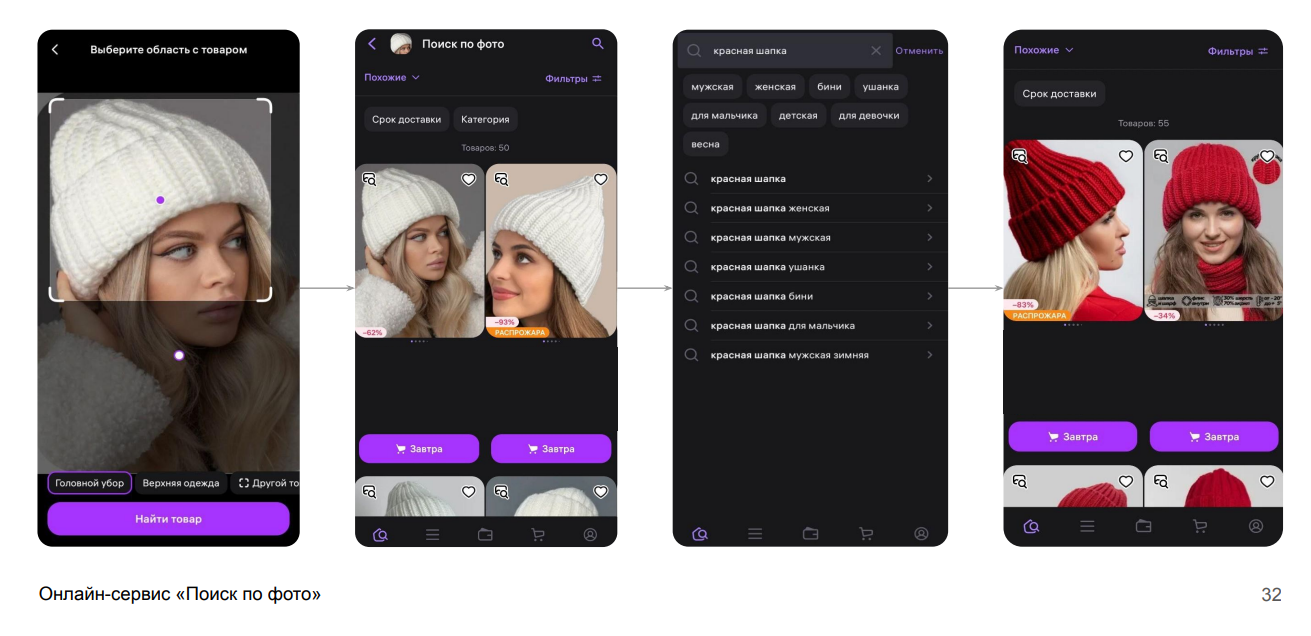
Продуктовый сценарий уточнения: пользователь выделяет белую шапку, получает визуальную выдачу, вводит «красная шапка» и переходит к красным вариантам.
Источник: Никита Романов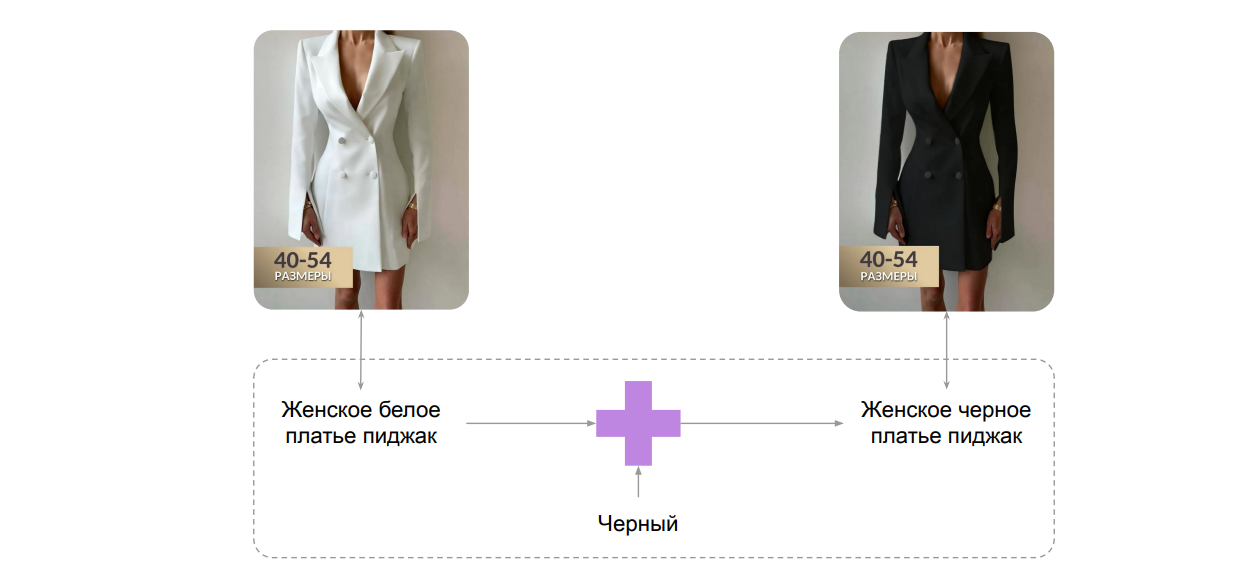
Интуиция операции изменения: представление белого женского платья-пиджака объединяется с признаком «чёрный», чтобы получить представление чёрного варианта.
Источник: Никита РомановКак изменённый запрос возвращается в существующий Image Retrieval
На обучении исходное изображение кодируется замороженным SigLIP2, а текст изменения — отдельным текстовым эмбеддером. Их представления подаются в обучаемую MLP-голову. Цель — получить такой изменённый вектор, который приблизится к SigLIP2-представлению целевой картинки.
Ключевой инженерный плюс состоит в переиспользовании уже построенного товарного индекса. Во время запроса изменённое представление можно снова отправить в Image Retrieval и искать среди заранее рассчитанных товарных векторов Qdrant. Если используется исходный SigLIP2-эмбеддинг плюс отдельная голова изменения текстом, результат сначала возвращается в исходное пространство SigLIP2, а затем проходит существующую проекцию Image Retrieval.
Из-за этого не требуется пересчитывать все товарные векторы только потому, что появился новый вид входа. База остаётся в пространстве Image Retrieval, а разные входные пути учатся приходить к совместимому представлению.
В статье показаны два качественных примера. Имея фигурку Рапунцель и текстовое изменение, система находит фигурку Эльзы того же типа. Во втором случае она ищет планку оперативной памяти с частотой 1 333 МГц; автор отмечает, что модель частично использует визуально распознаваемый текст на товаре. Для офлайн-оценки этой ветви используются Hitrate@k, MRR@k и NDCG@k. Численных значений этих метрик источник не приводит.
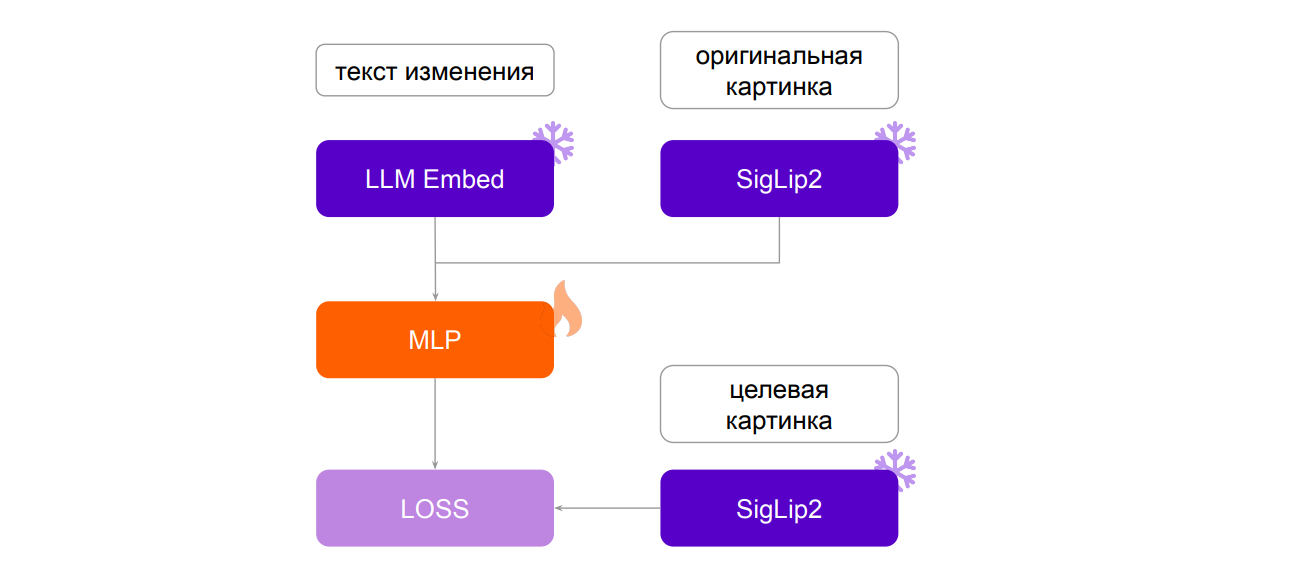
Обучение уточнения текстом: текст изменения и исходная картинка поступают в обучаемую MLP, а целевая картинка через замороженный SigLIP2 задаёт целевое представление.
Источник: Никита Романов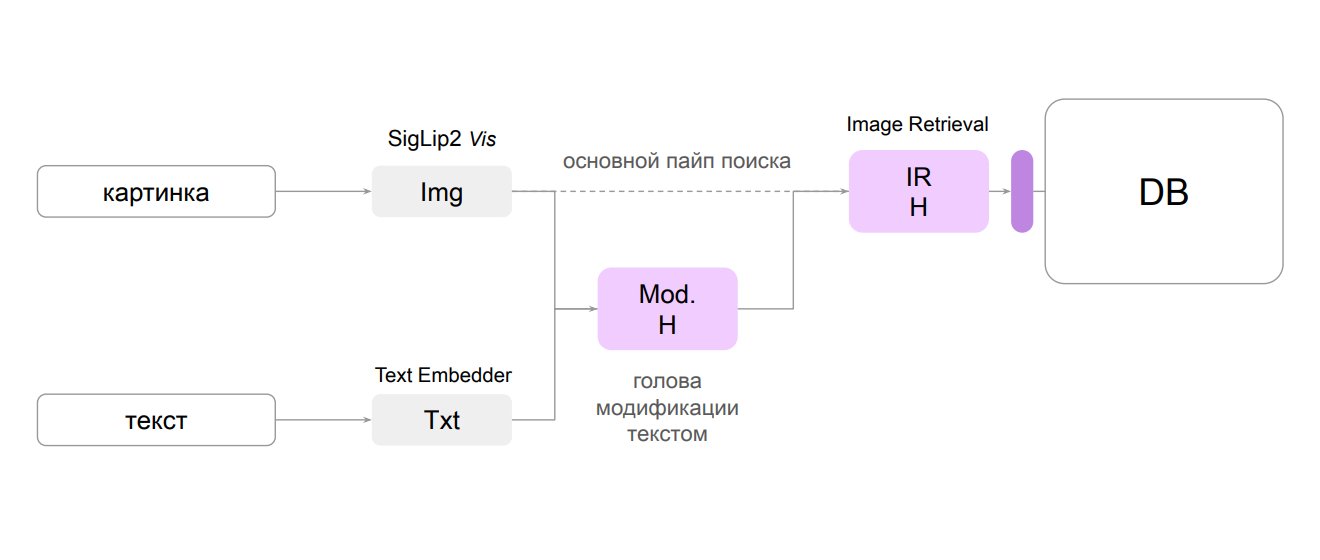
Работа уточнения вместе с существующим поиском: SigLIP2-картинка и текстовый эмбеддинг объединяются головой модификации, затем запрос возвращается в основной путь Image Retrieval и существующую базу.
Источник: Никита Романов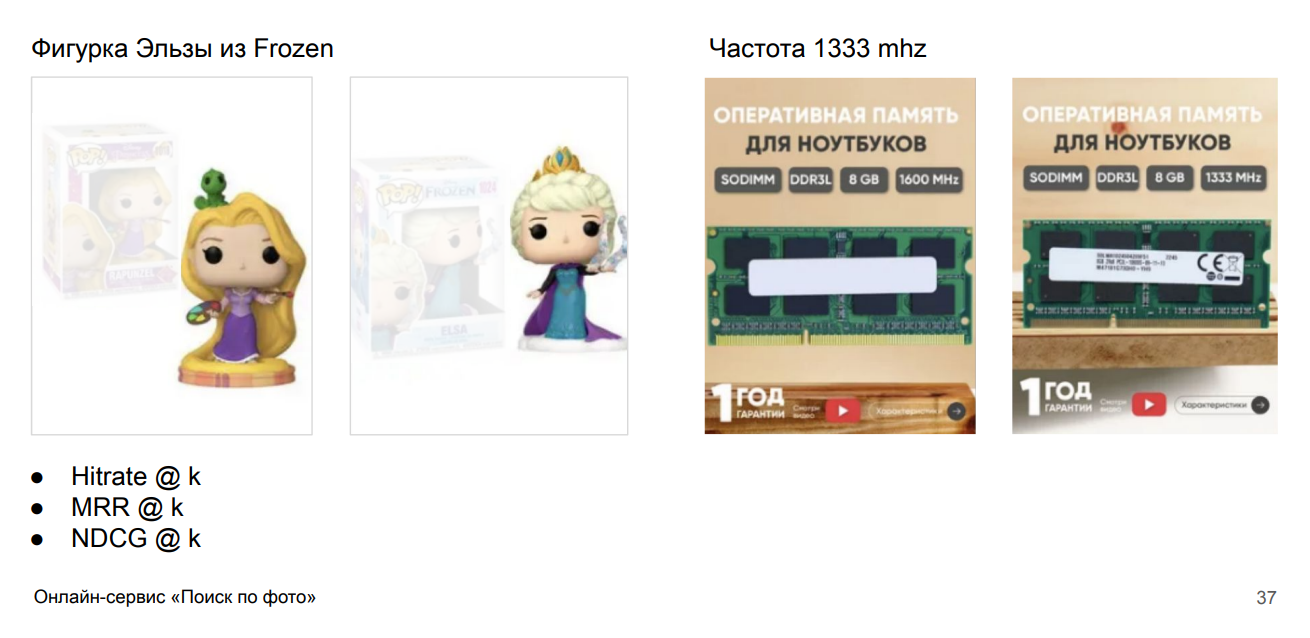
Качественные примеры уточнения: поиск фигурки Эльзы по исходному изображению другой фигурки и поиск оперативной памяти с частотой 1 333 МГц. На слайде перечислены Hitrate@k, MRR@k и NDCG@k.
Источник: Никита РомановОнлайн A/B: 128 против 256 и границы внедрения
Публичные онлайн-числа в статье относятся к Image Retrieval с Attention-головой. Команда сравнивала варианты с размерностью вектора 128 и 256 в fp16 против текущей продовой модели. Значения ниже — изменения бизнес-метрик в обозначениях исходного слайда; длительность эксперимента, размер выборки и доверительные интервалы не опубликованы.
Таблицу можно прокрутить по горизонтали.
На обеих платформах вариант 256 немного выше варианта 128 по каждой показанной метрике, но оба варианта дают положительное изменение относительно контроля. Эти числа нельзя напрямую переносить на теговый поиск или уточнение текстом: это другие модели и другие эксперименты.
У трёх ветвей системы разный уровень публично подтверждённой готовности. Для основного контура статья явно описывает работающий Qdrant с векторами 256 fp16 и приводит A/B новой Image Retrieval-модели против текущей продовой версии. Для двух остальных моделей — тегового поиска и уточнения текстом — автор в конце говорит, что внутренние A/B ещё активно идут. Публичных результатов этих экспериментов в источнике нет. При этом статья не формулирует отдельно, завершён ли полный перевод Image Retrieval на новую Attention-голову после показанного A/B, поэтому такой статус не следует додумывать.
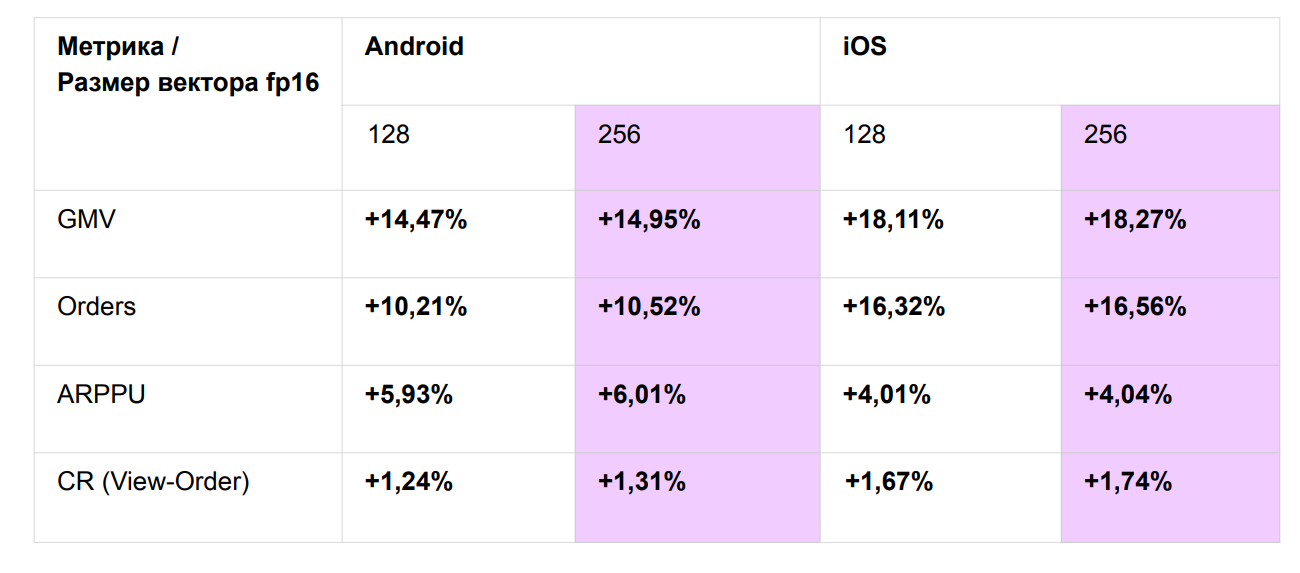
Точная таблица онлайн A/B для Image Retrieval: относительные изменения GMV, Orders, ARPPU и CR (View-Order) на Android и iOS при векторах 128 и 256 fp16.
Источник: Никита РомановИтог: общий визуальный фундамент и три разных сценария поиска
Путь команды начинается с визуального поиска: детектировать нужный объект, получить устойчивый вектор изображения и найти близкие товары в большом каталоге. Затем поверх общего SigLIP2 появились две мультимодальные ветви — поиск текстовых тегов и изменение запроса текстом. Для основного Image Retrieval команда улучшала данные, Attention-голову и обучение через MRL; для тегов — офлайн-генерацию и проекцию текстов в визуальное пространство; для уточнения текстом — триплеты «картинка + изменение + целевая картинка».
Подготовка и обучение происходят отдельно от пользовательского запроса. Товары заранее векторизуются, индекс обновляется примерно пять раз в день, теги генерируются офлайн. На обучении очищаются пары изображений, MRL считает несколько вариантов InfoNCE, а текстовые представления учатся попадать в пространство SigLIP2. Для линейной проекции команда использует closed-form решение; ортогональная инициализация, по данным источника, ускоряет сходимость в 4 раза и даёт 2–3% к финальным метрикам.
- 01
Найти объект
Пользователь загружает фотографию; система детектирует основной объект или распознаёт артикул.
- 02
Построить общий вектор
После выбора области SigLIP2 кодирует изображение в общее визуальное представление.
- 03
Выбрать ветвь
Основной запрос идёт в Image Retrieval; дополнительные сценарии могут использовать индекс тегов или голову изменения изображения текстом.
- 04
Найти кандидатов
Image Retrieval строит поисковый вектор, а HNSW возвращает близкие товары из Qdrant.
- 05
Сформировать выдачу
Кандидаты обогащаются характеристиками товара, ранжируются и дополнительно переранжируются по логистике.
В A/B-тесте нового Image Retrieval против текущей продовой модели все показанные бизнес-метрики выросли: для 256 fp16 GMV составил +14,95% на Android и +18,27% на iOS, Orders — +10,52% и +16,56%. Границы результата важны: длительность теста, размер выборки и доверительные интервалы не опубликованы; для тегов и уточнения текстом сообщается только о продолжающихся внутренних A/B. У тегов есть и компромисс метрик: длинные описания повышают Word Recall Rate, но могут усиливать галлюцинации, тогда как Error Rate и retrieval-метрики способны штрафовать полезные уточнения.
Финальная часть статьи: результаты A/B, статус двух остальных моделей и итоговый абзац