Разбор готов
Как Meta удвоила эффективность обучения GEM на тысячах GPU
Реклама в Instagram и Facebook опирается на множество сигналов: содержание объявления, историю действий человека, его контекст и взаимодействия с рекламой. Модель GEM объединяет эти данные, чтобы учиться предсказывать клики и конверсии. Она содержит триллионы параметров в таблицах эмбеддингов и миллиарды в плотных слоях, а обучение проходит на нескольких тысячах GPU. Прямой перенос привычных оптимизаций больших языковых моделей оказался недостаточным: у историй разная длина, внимание принимает разные формы, распределённые таблицы создают много обмена, а снижение точности может повлиять на качество предсказаний. Meta перестроила и вычислительные ядра, и организацию обучения на кластере. Разберём, почему понадобились JFA, GDPA и BlockAttention, как удалось использовать MXFP8, распределить плотные и разреженные параметры, сократить сетевую конкуренцию и выровнять нагрузку.
Материал полезен инженерам рекомендательных систем, специалистам по обучению больших моделей и разработчикам распределённой GPU-инфраструктуры. На конкретном примере видно, как перейти от ускорения отдельных операций к устойчивой скорости всего обучения и как правильно читать результаты MFU, TFLOPS и QPS.
Статья · на английском
GEM Training: How Meta Doubled the Efficiency of Its LLM-Scale Ads Foundation ModelDarren Liu и соавторы · Опубликовано: 3 августа 2026 г.
GEM: реклама, признаки и гибридная архитектура
В Instagram и Facebook модель GEM помогает рекомендательной системе рекламы оценивать, как человек может отреагировать на объявление. Среди её задач — предсказание вероятности клика (CTR) и конверсии (CVR); на исходной схеме отдельно отмечены CTR для Facebook и Instagram. Для обучения используют сведения о рекламных объявлениях и действия пользователей. Когда таких сигналов много и они сильно различаются по устройству, обработка всех признаков одной стандартной схемой становится дорогой.
У GEM гибридная архитектура. В разреженной части хранятся обучаемые векторные представления идентификаторов и событий — таблицы эмбеддингов с параметрами порядка триллионов. «Разреженные» здесь означает, что на отдельном примере обращаются лишь к части огромных таблиц. Плотная часть содержит миллиарды параметров нейросетевых слоёв, выполняющих умножения матриц и обучение взаимодействия признаков. Эти две части требуют разного распределения между ускорителями: таблицы прежде всего занимают память и вызывают обмен признаками, плотные слои расходуют вычислительные ресурсы.
Признаки также разделены на последовательные и непоследовательные. История действий пользователя — последовательность событий с порядком; место нахождения пользователя или представление рекламного изображения — признаки без временной последовательности. На схеме GEM видны три входные ветви: числовые признаки, списки идентификаторов и последовательности событий. Они преобразуются в представления, затем проходят повторяющиеся слои: между последовательными и непоследовательными признаками рассчитываются взаимодействия, а внутри ветвей работают специализированные модули. Схема прямо подписывает pFFN/cross-attention, Wukong и pooled multi-head/self-attention; это иллюстрация разнообразия операций, а не спецификация числа слоёв.
Такая архитектура объединяет черты рекомендательных моделей и больших языковых моделей (LLM). Однако сами обучающие примеры устроены иначе, чем обычный текст фиксированной формы. Именно от сочетания длинных историй, таблиц представлений и разных механизмов внимания зависят инженерные решения Meta.
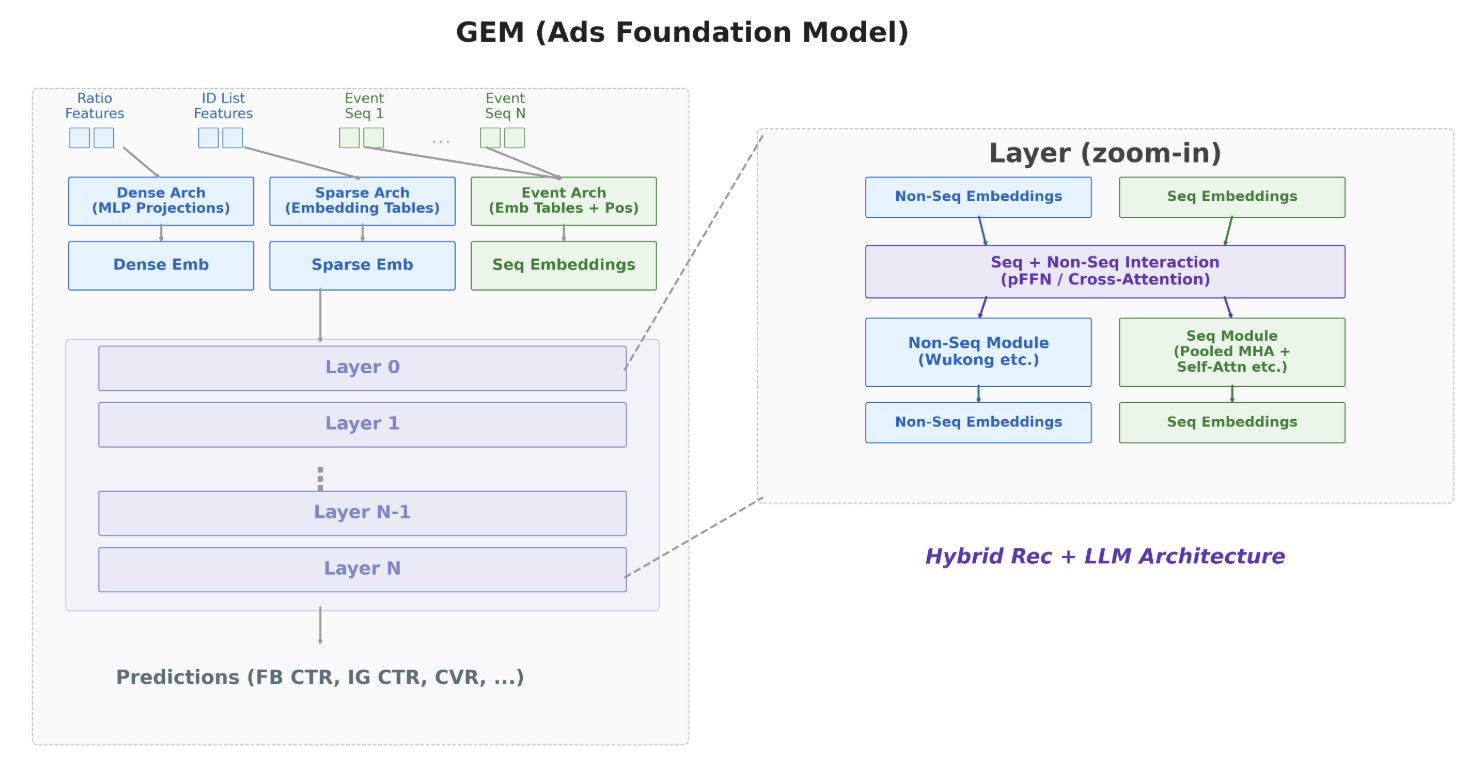
GEM объединяет последовательные и непоследовательные признаки, разреженные таблицы представлений и плотные вычисления.
Источник: Оригинальная иллюстрация · MetaПочему обычные GPU-оптимизации здесь недостаточны
История действий у одного пользователя может содержать сотни событий, у другого — десятки тысяч. Если дополнять все истории фиктивными позициями до общей длины, до 50% вычислений уходит на эти пустые места. Если же не дополнять последовательности, обычное GPU-ядро может неравномерно распределить работу: одни вычислительные блоки закончат короткие истории, пока другие ещё обрабатывают длинные.
Внимание — операция, через которую позиции и признаки обмениваются информацией, — у GEM встречается в нескольких формах. Самовнимание анализирует очень длинную историю, но каждой позиции доступно ограниченное окно соседей. При перекрёстном внимании (cross-attention) длинная сторона запросов Q обращается к коротким ключам K и значениям V, чтобы связывать пользователя с рекламой. При агрегирующем многоголовом внимании (pooled multi-head attention, PMA) ситуация обратная: короткий набор запросов сжимает длинную историю K/V. Из-за этой асимметрии техника, эффективная для длинных прямоугольных матриц LLM, может простаивать на коротких внутренних циклах GEM.
Дополнительная трудность — небольшие размеры представлений в полносвязных слоях (MLP) и операции нормализации: многие из них ограничены скоростью работы с памятью, а не числом доступных умножений. Наконец, обучение для CTR/CVR чувствительно к числовым ошибкам. Простая замена BF16 на меньшую разрядность может повысить скорость матричных операций, но одновременно ухудшить качество прогнозов или устойчивость градиентов.
Challenge 1: Achieving High Per-GPU UtilizationКак разделили вычисления и масштабирование
На нескольких тысячах GPU скорость одного шага обучения задаётся самым медленным участником. Каждый процесс на своей видеокарте (rank) выполняет локальные операции и обменивается параметрами, градиентами или признаками с другими. Даже если одно ядро работает быстро, остальные карты могут ждать сетевой обмен, повторные вычисления из-за нехватки памяти или обработку чрезмерно длинного пакета у одного rank.
Упрощённая модель времени шага из статьи: важен самый медленный rank, а внутри него — то, что дольше при возможном перекрытии, вычисления или обмен.
Meta сформулировала четыре условия хорошего масштабирования: вычислений должно быть достаточно много относительно обмена; обмен нужно перекрывать вычислениями без конкуренции за GPU; повторный расчёт активаций из-за нехватки памяти должен оставаться небольшим; нагрузку нужно выравнивать между rank. Гибрид GEM нарушал каждое условие: триллионные таблицы и плотные эксперты требуют передачи данных, разные слои дают разные окна перекрытия, длинные истории занимают память, а стоимость пакета меняется от набора пользователей.
Для диагностики авторы разделили использование вычислительного потенциала GPU (Model FLOPs Utilization, MFU) на локальную эффективность и эффективность распределённого исполнения. Local MFU показывает, насколько эффективно отдельная видеокарта исполняет слои модели. Scaling Ratio показывает, какая доля этой локальной эффективности сохраняется после распределения на весь кластер.
Local MFU — эффективность вычислений на одном GPU; Scaling Ratio — отношение сквозного MFU к локальному. Это независимые диагностические составляющие одной метрики, а не два отдельно измеренных прироста.
Local MFU определяют по отдельным слоям на одном GPU и усредняют с весами, исключая видимые затраты на обмен и повторные вычисления активаций. Отношение E2E MFU к Local MFU даёт Scaling Ratio. Поэтому новые ядра и точность чисел относятся прежде всего к локальной загрузке, а топология сети, распределение параметров, память и балансировка — к потере эффективности при масштабировании. В статье обе части оптимизируют совместно.
Challenge 2: Scaling Efficiently Across Thousands of GPUsJFA обрабатывает истории без пустых позиций
FlashAttention ускоряет внимание, разбивая матрицы на плитки и переиспользуя быстрые уровни памяти GPU вместо хранения огромных промежуточных матриц. Типичные реализации удобны для плотных последовательностей одинаковой длины. В GEM длины различаются, поэтому команда построила Jagged Flash Attention (JFA): ядро работает непосредственно с «рваными» (jagged) тензорами, не вычисляя фиктивные добавленные токены.
JFA сохраняет необходимые рекомендательной модели возможности: отдельные смещения оценок внимания (attention bias), разные длины Q и K/V и обратный проход для вычисления градиентов. Это важнее, чем ускорить один демонстрационный случай: каждое из этих свойств встречается в реальном обучении GEM.
Разработка прошла четыре поколения. Ранние версии могли проигрывать обычному scaled dot-product attention (SDPA) даже при его неэкономном дополнении до общей длины. Последующие изменения постепенно вывели JFA на уровень сильных CUDA/Cutlass-реализаций на новом поколении GPU. История этих попыток показывает, почему устранение padding само по себе не гарантирует быстрого GPU-ядра.
Jagged Sequence Flash AttentionЧетыре поколения оптимизаций ядра JFA
Первой проблемой стала маска границ рваных последовательностей. Стандартная двумерная проверка недопустимых позиций с установкой −∞ расходовала около 28% выполняемых инструкций вне Tensor Cores — специализированных блоков матричных умножений. Вместо неё инженеры обнулили соответствующие части Q и K при загрузке через Tensor Memory Accelerator (TMA) и скорректировали сумму экспонент вычитанием лишнего вклада. По описанию авторов, операция численно эквивалентна исходной маске, но не тратит столько инструкций на проверку границ.
При обратном распространении ошибки требуется собрать градиент dQ из разных плиток. Авторы пробовали параллелизм по последовательности с атомарными прибавлениями, вариант без него, вариант с пересчётом промежуточных данных и раздельное вычисление dQ и dK/dV. Для характерной нагрузки GEM, где велико произведение размера пакета на количество голов внимания, выиграл вариант без параллелизма по последовательности, но с раздельным расчётом dQ. Он убирает и дорогие атомарные записи, и лишний повтор вычислений: ускорение обратного прохода составило 21–40% в измеренных условиях.
Следующее изменение — переход к Triton Low-Level Extensions (TLX), позволяющим явно разделять группы потоков GPU (warp) по функциям: одни загружают данные, другие выполняют вычисления. Вместе с TMA и постоянными ядрами (persistent kernels), которые сами разбирают очередные задания вместо частых запусков, это дало улучшение TFLOPS на 30–100% для соответствующих вариантов. JFA v4 на TLX оказался на 40–140% производительнее JFA v2 по TFLOPS; авторы проверили выигрыш на производственных распределениях рваных последовательностей с sparsity 0,5.
В оценке вклада JFA приведены ещё две величины другого уровня: относительное увеличение Local MFU на 18,5% и рост QPS обучения на 12%. Они показывают, что ускорение ядра может перейти в эффект для модели; проценты TFLOPS, MFU и QPS не следует складывать — у них разные знаменатели и уровни измерения.
We evolved JFA through four generationsGDPA учитывает реальные формы внимания
У GEM есть самовнимание, PMA и перекрёстное внимание. Их можно представить как два умножения матриц с поэлементной нелинейностью между ними, но нелинейность не всегда равна softmax: встречаются GELU и SiLU. Команда создала обобщённое ядро Generalized Dot-Product Attention (GDPA), чтобы ускорять эти неодинаковые взаимодействия на конкретных формах рекламных данных.
На графиках прямого и обратного проходов сопоставлены производственные измерения исходного ядра (синие точки) и синтетический бенчмарк FMHA (красные точки): отдельно прямой и обратный проходы. При максимальной длине последовательности 200, 500 и 1000 производственные точки нередко оказываются заметно ниже синтетических. Точки на одном значении длины также разбросаны, поскольку форма входа определяется не одной длиной. В тексте описан разрыв по производительности forward в 2,6 раза и до 4 раз в худшем случае. Диаграммы важны как демонстрация расхождения реальных форм с ожиданиями по бенчмарку, а не как сравнение одинаковой операции только по длине истории.
Причины разрыва авторы нашли в очень коротких и несимметричных K/V, переменных длинах и больших размерах пакетов. При таком сочетании привычная конвейерная обработка плиток плохо заполняет GPU: внутренний цикл может завершиться раньше, чем разогреется поток загрузки и вычислений. Оптимизировать пришлось планирование и математическую часть, а не только размер плитки.
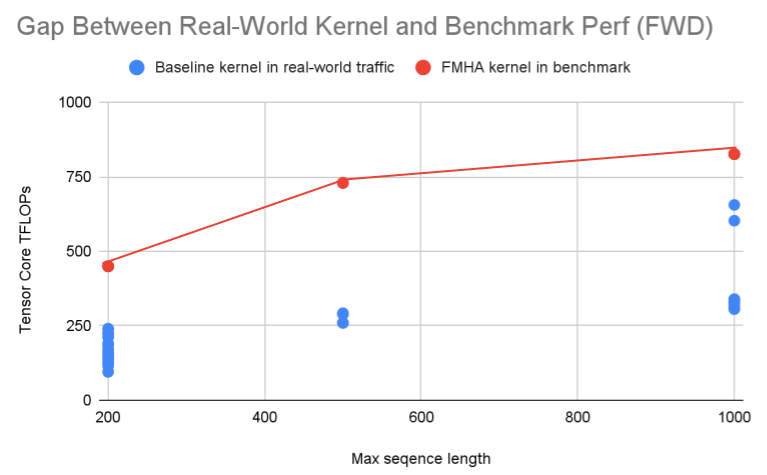
Производительность forward-ядра на реальном трафике отличается от синтетического бенчмарка.
Источник: Оригинальная иллюстрация · Meta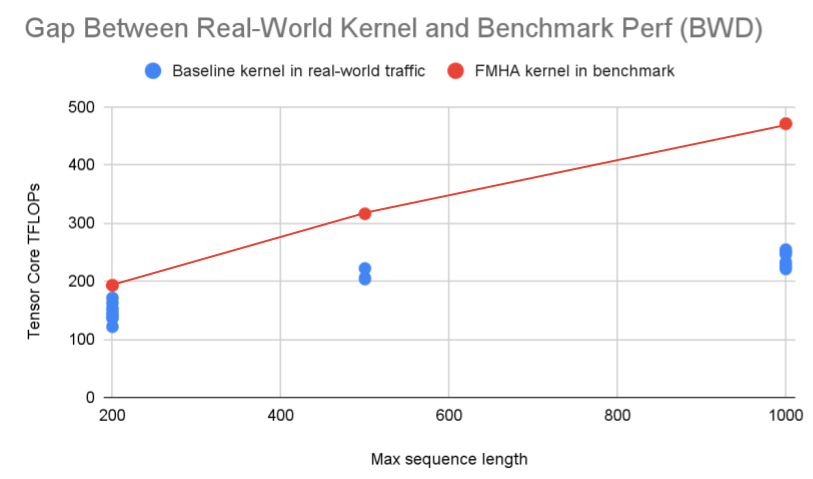
Та же разница наблюдается при обратном проходе; форма данных влияет на достижимую производительность.
Источник: Оригинальная иллюстрация · MetaКак перестроили вычисления внутри GDPA
Первое изменение использует отсутствие обычного softmax там, где архитектура применяет GELU или SiLU. Освободились четыре warp и их регистры, ранее занятые корректировкой softmax. Когда внутренний цикл по коротким K/V содержит только один-два прохода, более широкий внешний программный конвейер возвращает около 10% производительности, терявшихся из-за короткого внутреннего конвейера.
Для рваных историй допустимые плитки вычисляют заранее на CPU. Пустые плитки GPU вовсе не получает, а непустые раскладываются по SM зигзагом, чтобы длинные и короткие участки равномернее попадали на разные вычислительные блоки. Заявленный перекос нагрузки между ними уменьшился примерно с шестикратного до близкого к равномерному.
Вторая скрытая задержка возникала в GELU: реализация через tanh нагружала аппаратные блоки специальных функций GPU (SFU). Авторы заменили её приближением Тейлора шестого порядка, вычисляемым обычными арифметическими устройствами (ALU). Приближение применяют на ограниченном диапазоне значений, который обеспечивает нормализация Q и K (QK-norm); это условие необходимо для численной точности и в прямом, и в обратном ходе.
Результат оптимизированного GDPA: ускорение forward в 2 раза, backward в 1,6 раза относительно базового ядра; в измерении forward достигнуто 1145 TFLOPS в эквиваленте BF16 и около 97% использования Tensor Cores. Для производственных конфигураций с короткими K/V авторы получили до 3,5 раза ускорения forward по сравнению с FlashAttention 4. После применения оптимизированных ядер во всей модели пропускная способность обучения выросла более чем на 30%.
На графиках GDPA показано сравнение gdpa, cutlass_fmha, cutedsl_fa4 и cutedsl_gdpa для перекрёстного внимания при коротких K/V и sparsity 1,0. По горизонтали — длина Q от 256 до 2048. Зелёный cutedsl_gdpa заметно лидирует при прямом проходе на всех показанных длинах и сохраняет преимущество при обратном. Это сравнение ядер в оговорённых формах, поэтому его столбцы нельзя переносить на любые механизмы внимания или объявлять универсальным множителем ускорения GEM.
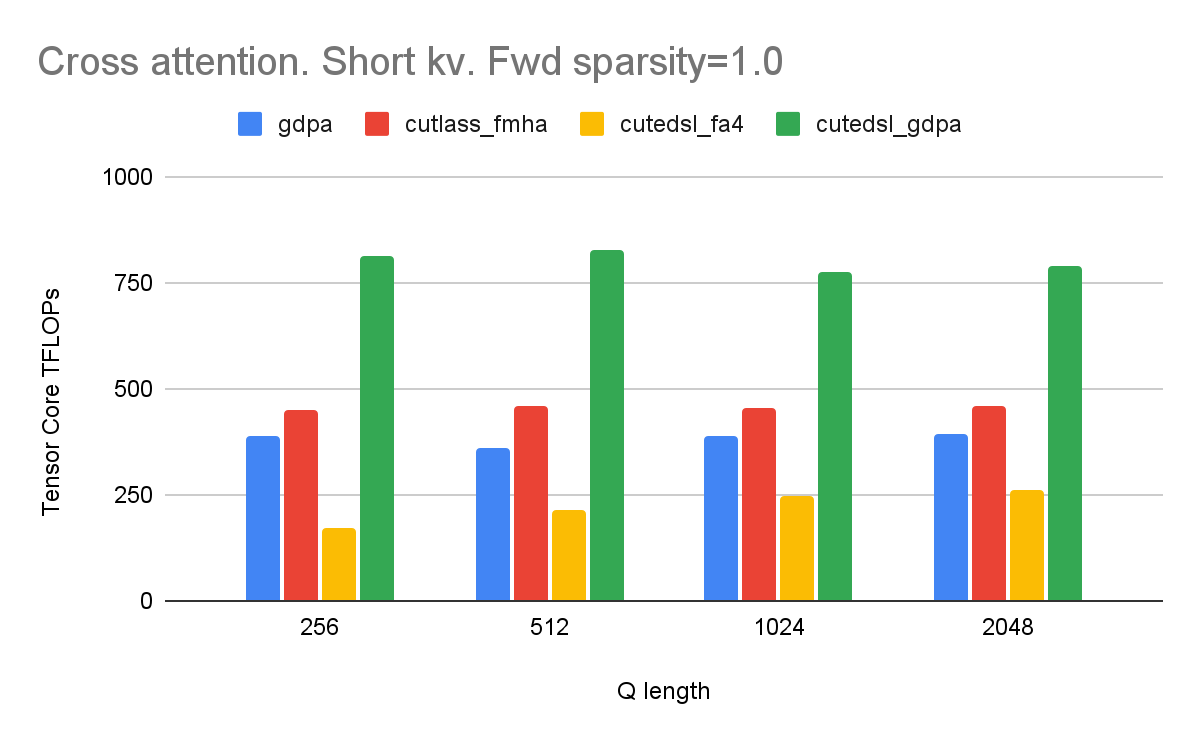
Сравнение вычислителей cross-attention при коротких ключах и значениях: forward.
Источник: Оригинальная иллюстрация · Meta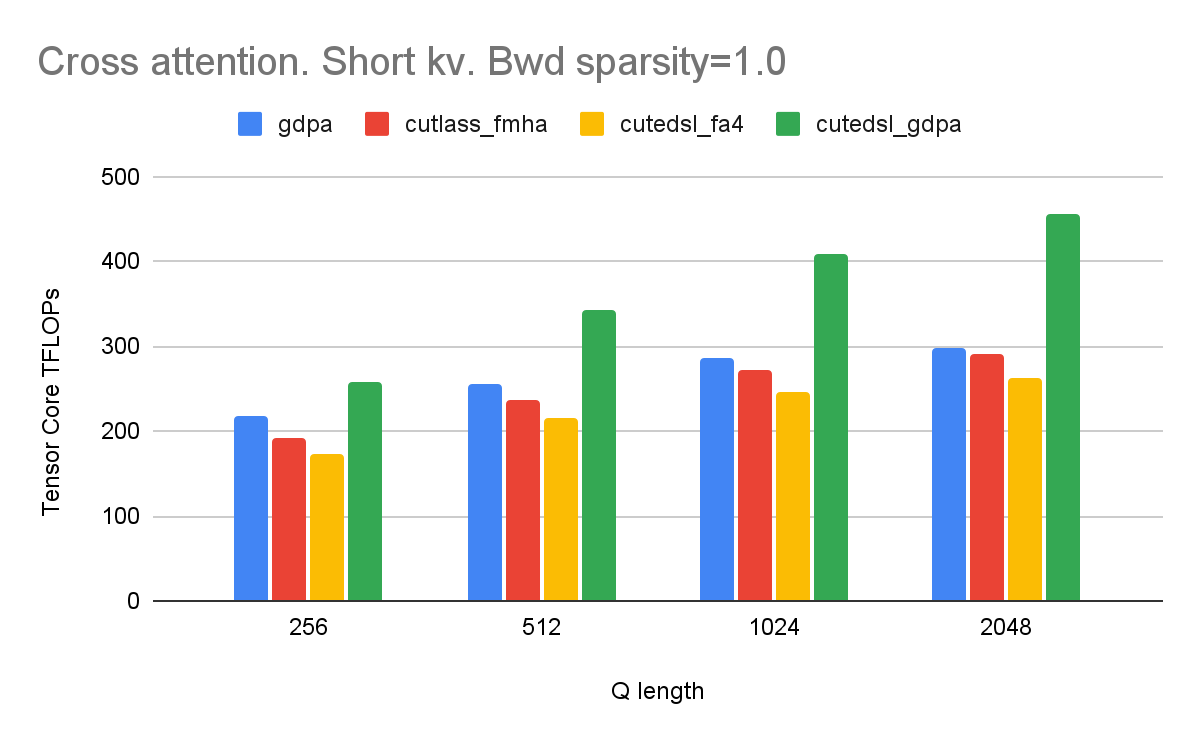
Сравнение тех же вариантов при обратном проходе.
Источник: Оригинальная иллюстрация · MetaОт скользящего окна к блочному вниманию
Полное самовнимание по истории требует сравнить каждую позицию почти с каждой другой: стоимость растёт пропорционально квадрату длины L. Meta сначала ограничила каждой позиции доступную часть истории скользящим окном ширины W (sliding-window attention, SWA). Стоимость стала порядка L × W; модификация JFA пропускала плитки за пределами окна. На длинных последовательностях задержка слоя самовнимания снизилась до 68%, а Normalized Entropy (NE), используемая авторами как показатель качества модели, осталась нейтральной.
Но скользящее окно всё ещё пересекает края плиток. Схема блочного внимания выделяет зелёным разрешённые взаимодействия: слева они образуют полосу около диагонали с частично заполненными блоками. Справа при BlockAttention каждый блок запросов обращается только к соответствующему блоку ключей/значений; блоки вне диагонали полностью запрещены. Для GEM команда выбрала фиксированные неперекрывающиеся блоки по 64 токена. Получаются независимые задачи размера 64 × 64, и стоимость по длине истории становится линейной при фиксированном размере блока.
Для этих небольших независимых задач на TLX создали отдельное ядро и исключили дополнительные операции FlashAttention: динамическую коррекцию softmax, передачу logsumexp через HBM и отдельную предварительную подготовку Di для обратного прохода. Обратный проход вращательного позиционного кодирования RoPE объединили с завершающей частью ядра внимания; градиенты при этом остаются в регистрах FP32, без дополнительного прохода через память.
Совместно TLX BlockAttention и объединённый RoPE увеличили MFU слоя самовнимания на 30,6% относительно реализации блокового внимания на Triton или примерно на 44% относительно варианта SWA. Это изменение MFU конкретного слоя, а не сквозной MFU всего обучения. Нейтральная NE в статье явно приведена для SWA; отдельного численного результата NE для BlockAttention здесь нет.
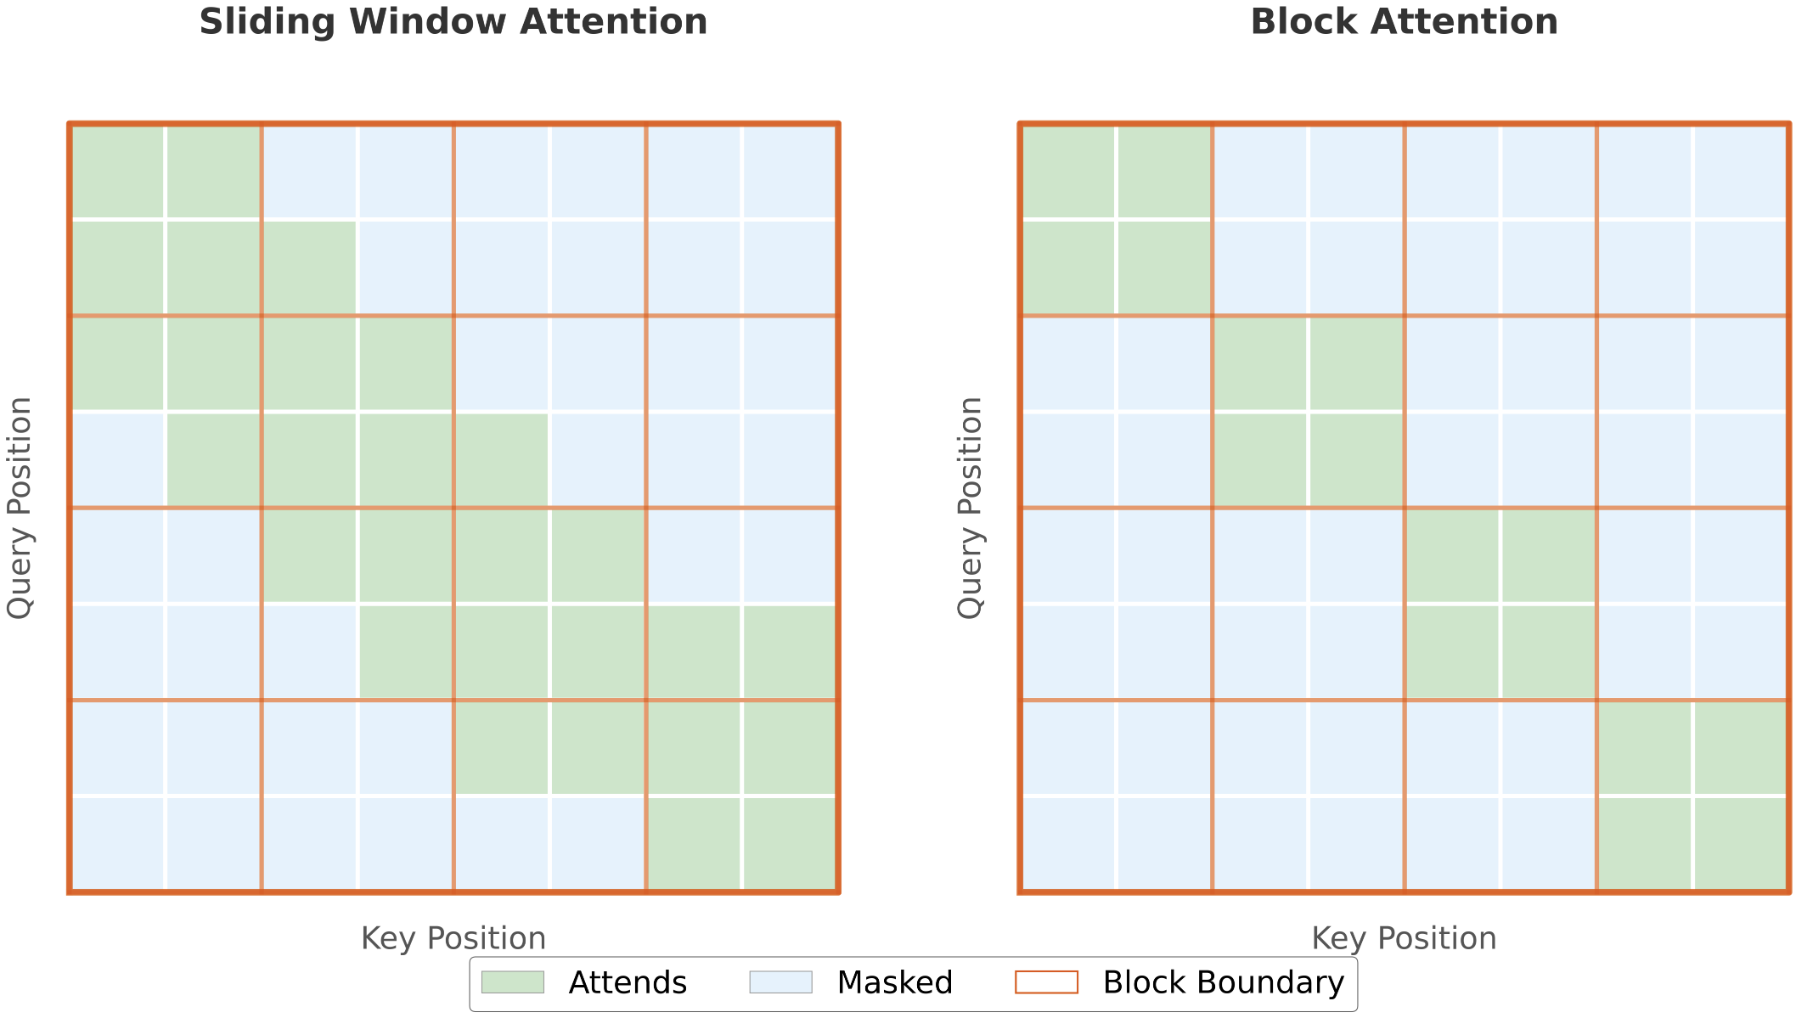
Блочное внимание организует разрешённые связи иначе, чем простое скользящее окно.
Источник: Оригинальная иллюстрация · MetaMXFP8 ускоряет прямой и обратный проходы
Современные Tensor Cores быстрее умножают матрицы с числами меньшей разрядности. Для обсуждаемого поколения GPU пиковая производительность FP8 вдвое выше FP16, а FP4 — вчетверо выше. В обучении такой выигрыш реализуется только тогда, когда квантизация — перевод значений в более грубое числовое представление — не вызывает регрессии качества и не съедает время на преобразования и обмен данными.
Для GEM Meta разработала смешанный режим сверхнизкой точности для внимания и MLP, выделив сложный случай механизма внимания. Внутри FlashAttention 4 (FA4) прямой и обратный ходы используют блочно масштабированные матричные умножения MXFP8 (block-scaled MMA). Каждой группе значений нужен свой коэффициент масштаба, который вычисляют вдоль сворачиваемой размерности K матричного умножения. Эти коэффициенты проходят через разделяемую память SMEM и тензорную память TMEM, уже активно занятую FA4. Дополнительные масштабы нужны и для промежуточных тензоров, например вероятностей внимания P после softmax и dS при обратном распространении.
Диаграмма MXFP8 помогает проследить весь модуль. В прямом ходе BF16-входы x_q и x_kv проходят нормализацию RMS с интегрированной квантизацией, затем проекции Wq и Wk, совмещённые с преобразованиями Q; блок SF Scatter готовит расположение масштабов, после чего работает FA4 Forward и получается выход O в BF16. Для обратного хода показаны dO в BF16, FA4 Backward с производными dQ/dK/dV, специальные FP8-умножения и обратные проходы нормализации. Подпись схемы отделяет рваные FP8-данные от выровненных до 128 позиций масштабных коэффициентов: за счёт этого не требуется дополнять сами длинные истории пустыми FP8-токенами.
Важна интеграция соседних операторов. Нормализация и линейные проекции сразу выдают FP8-активации и масштабы в удобном для Tensor Cores расположении. Иначе выигрыш быстрого матричного умножения пришлось бы оплатить дополнительным чтением и записью BF16-активаций в глобальную память GPU. Для разреженных по длине входов массив FP8 сохраняет только реальные позиции, а сборка и дополнение выполняются над компактными коэффициентами масштаба для TMA.
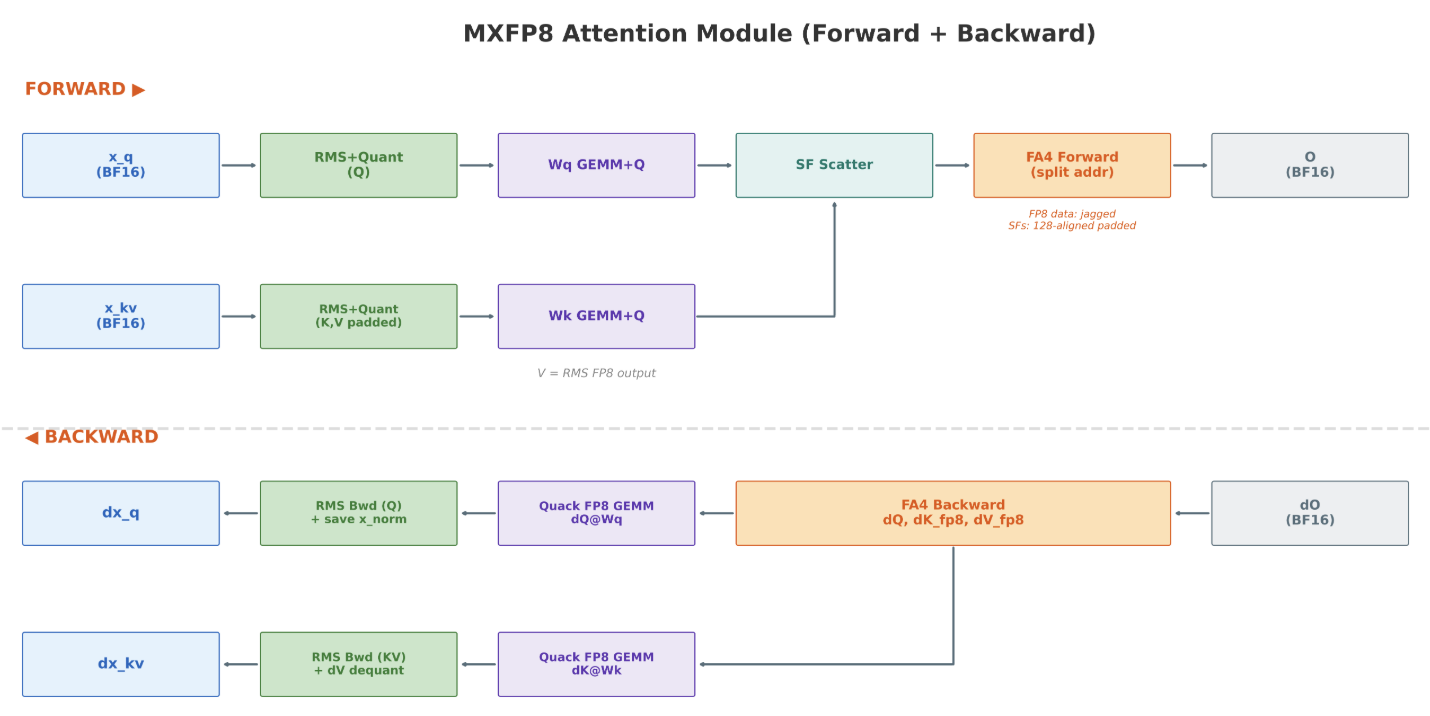
Схема attention-модуля с MXFP8 в прямом и обратном проходах.
Источник: Оригинальная иллюстрация · MetaТри технических приёма низкоточного внимания
Первая проблема возникла в TMEM: исходный FA4 занимает все 512 столбцов тензорной памяти накопителями, поэтому масштабам MXFP8 негде лежать. Инженеры помещают коэффициенты S(i) в часть пространства накопителя S(1−i), которая на данном этапе не используется. Для согласования нужен лишь один дополнительный лёгкий барьер, скрывающийся за уже выполняющимся матричным умножением. Так обеспечивается место для масштабов без существенного увеличения промежуточного хранения.
Вторая оптимизация касается матрицы P на выходе softmax. Её переводят в MXFP8 прямо внутри warp, который уже считает softmax, и повторно используют вычисленный максимум строки. Для масштабов вместо дорогих последовательностей log2, округления и обрезания диапазона применяют оптимизированные операции с битами в PTX — низкоуровневом представлении инструкций GPU.
Третья оптимизация — квадратные группы квантизации 32 × 32. Один общий масштаб на блок находят с помощью warp-wide операции redux.sync.max.abs.f32. Такой способ не меняет разбиение при транспонировании матрицы: для обратного прохода, где понадобятся Qᵀ и Kᵀ, не требуется заново квантизовать те же значения.
На графиках FA4 показаны замеры FA4 на B200 при sparsity 0,5 и характерных для GEM формах перекрёстного внимания, с N от 1000 до 6000. В прямом проходе диаграмма различает FA4 OSS BF16, внутренний FA4 BF16, FA4 MX8 и FA4 MX4; MX4 быстрее всех показанных вариантов, однако график сам по себе не подтверждает его применение во всём обучении с нужным качеством. На графике обратного прохода есть MX8, но нет MX4, и MX8 заметно превосходит обе BF16-реализации.
В тексте авторы обобщают измерения на характерных формах GEM и внутреннем GPU Meta с ограничением энергопотребления: MXFP8 даёт ускорение ядра forward более 1,3 раза, а backward — более 1,5 раза. Это ускорения конкретных ядер в условиях бенчмарка. Их нельзя подменять полным увеличением скорости всего обучающего шага, и не следует приравнивать MX4 на графике forward к подтверждённому повсеместному FP4-обучению.
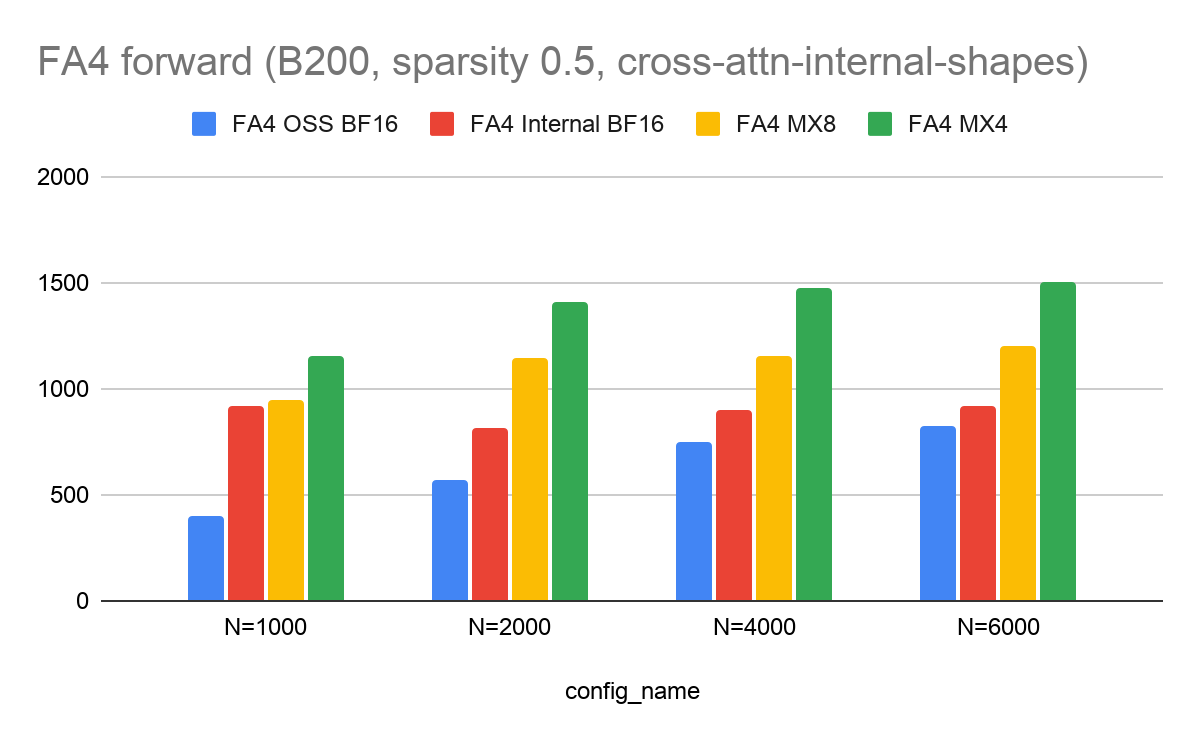
Сравнение вариантов FA4 при указанных на графике конфигурациях и точностях: forward.
Источник: Оригинальная иллюстрация · Meta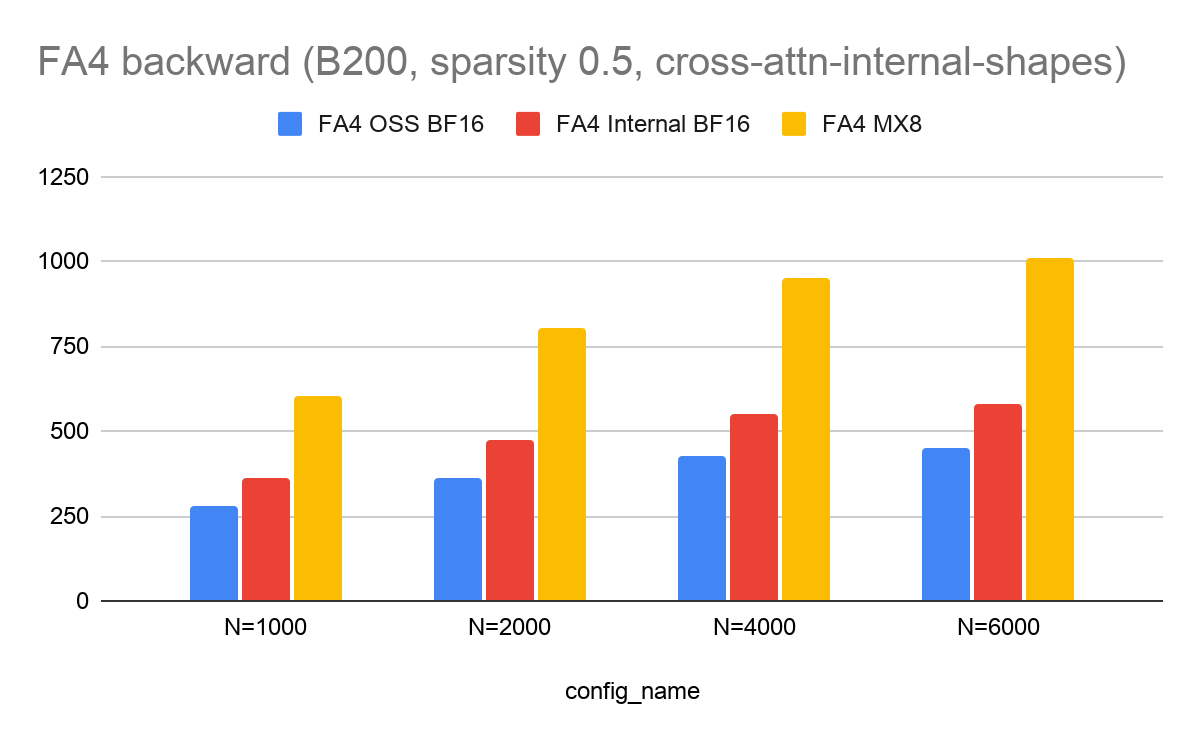
Сравнение вариантов FA4 при обратном проходе.
Источник: Оригинальная иллюстрация · MetaКак устранили накладные расходы квантизации
При работе с низкой точностью сама квантизация может стать дорогой. У весов возникает повторное преобразование на каждом участнике FSDP — схемы, где параметры модели разделены между GPU и временно собираются для вычислений. В наивном варианте каждый rank сначала получает полный BF16-вес через all-gather, а уже затем квантует его. Каждый заново делает одну и ту же работу и передаёт по сети крупный BF16-тензор.
Meta поменяла порядок: каждый rank квантует только свой локальный фрагмент веса до all-gather, а коллективная операция передаёт уже низкоточное представление. Квантизация таким образом выполняется один раз для исходного фрагмента, а не на каждой копии собранного веса. Дополнительно сокращается объём сетевого сообщения и задержка all-gather.
Для активаций проблема другая. В наивной цепочке нормализация выдаёт BF16, данные записываются в HBM, затем отдельное ядро считывает их и квантует перед матричным умножением. PreNorm fusion соединяет нормализацию и квантизацию в одну операцию. В слоях внимания квантизацию также соединяют с предыдущей проекцией, чтобы само ядро внимания сразу получало нужную разрядность.
Именно две такие перестановки показаны на схеме квантизации. Верхняя половина схемы — наивный путь с BF16 all-gather и отдельным преобразованием активаций. Нижняя — квантизация шарда до MX8 all-gather и RMSNorm+Quant для активаций. Важный вывод рисунка: уменьшить число битов внутри GEMM недостаточно; необходимо одновременно убрать лишние ядра, многократную квантизацию и передачи через медленную память.
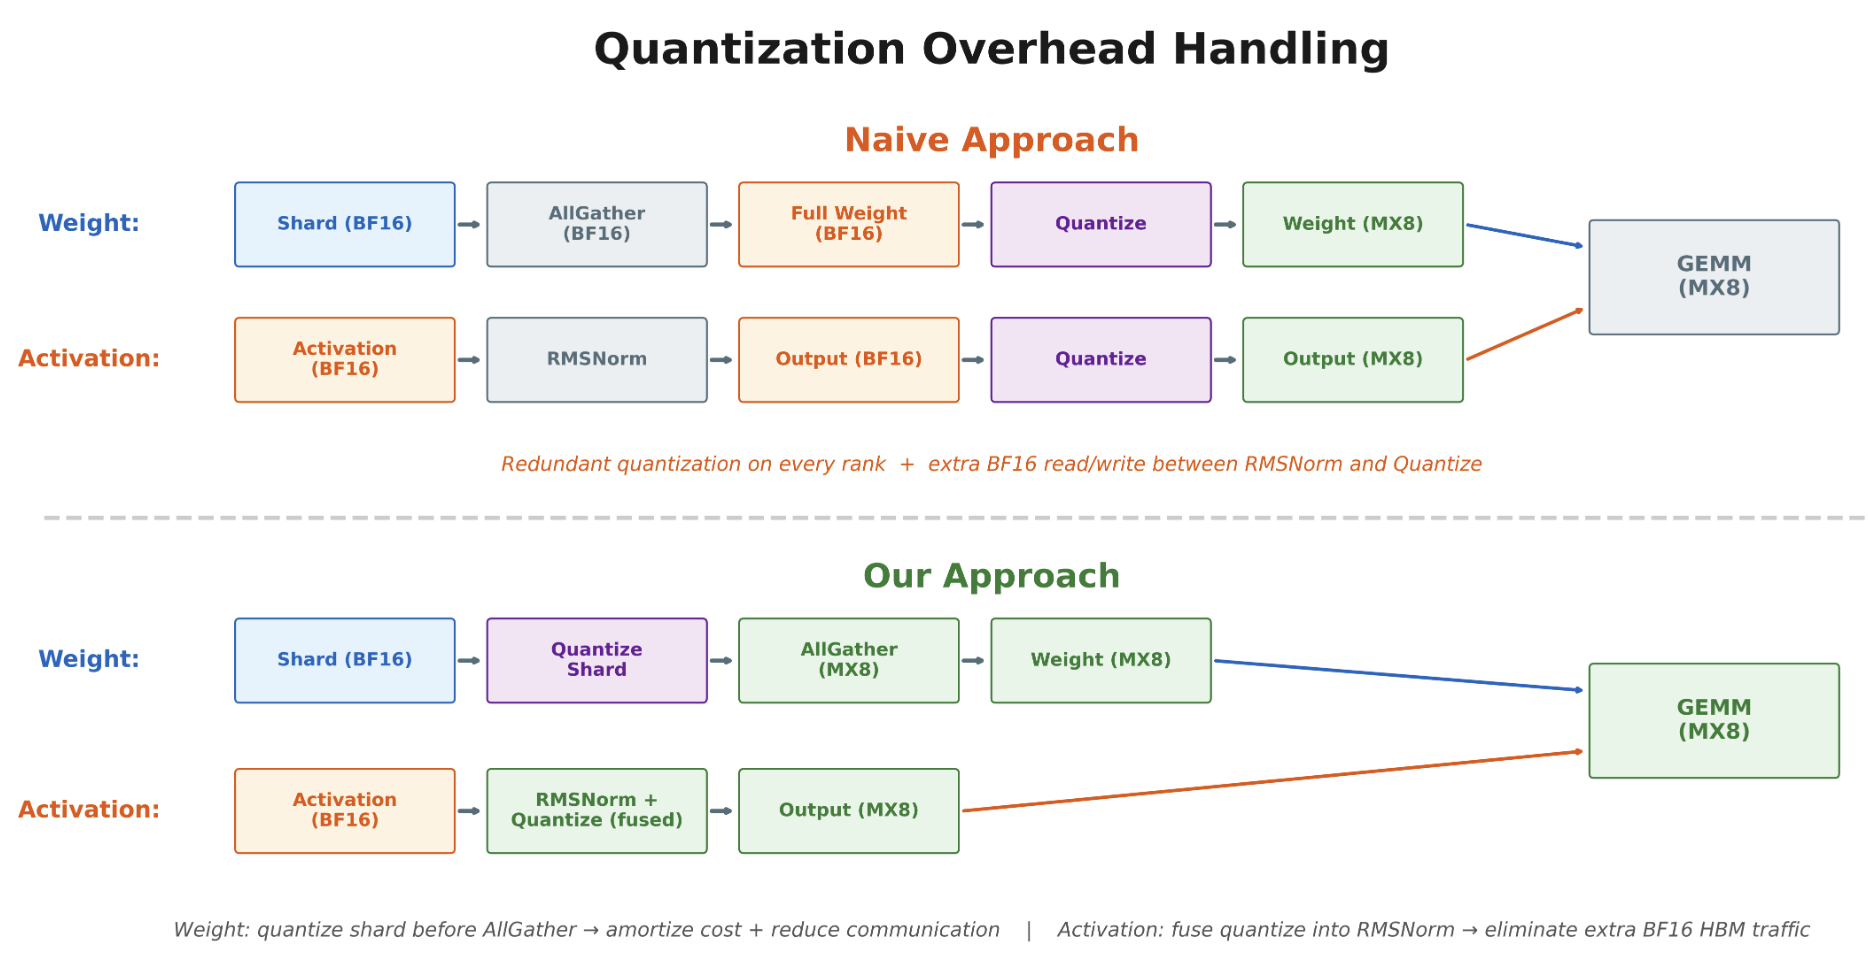
Организация квантизации может создавать дополнительную работу. Схема показывает оптимизированный путь обработки.
Источник: Оригинальная иллюстрация · MetaКак сохранили устойчивость низкоточного обучения
CTR и CVR зависят от небольших изменений предсказанных вероятностей. При обучении ошибка низкоточного округления распространяется через градиенты, а редкие большие значения — выбросы — могут нарушить масштабирование целого блока. Поэтому рецепт Meta использует низкую точность выборочно и включает несколько мер против накопления ошибок.
Перед квантизацией применяют случайные преобразования Адамара (Random Hadamard Transform), которые перераспределяют крупные значения между координатами, делая распределение более ровным. Стохастическое округление случайно выбирает соседний представимый уровень так, чтобы уменьшить систематическое смещение по сравнению с постоянным округлением в одну сторону.
Для градиентов весов (weight gradients, WGrad) авторы обнаружили особенно тяжёлое поведение выбросов в активациях и градиентах. Поэтому отдельные расчёты WGrad выборочно пропускают в низкой точности либо выполняют с большей точностью, когда это существенно для качества. Наконец, большие матричные умножения получают максимум пользы от MXFP8, а чувствительные поздние слои могут продолжать работать в BF16.
Получается смешанная схема, а не одно глобальное переключение формата всех тензоров. Параметры вариантов округления, критерии выбора BF16-слоёв и количественную таблицу качества авторы здесь не приводят, однако прямо связывают необходимость этих защит с устойчивостью обучения и отсутствием регрессии целей CTR/CVR.
Addressing Numerical StabilityСетевая топология определяет пять измерений параллелизма
На тысячах ускорителей одного универсального способа распределения GEM недостаточно: плотные слои умножают матрицы и синхронизируют градиенты, разреженные таблицы хранят огромные наборы векторов и пересылают признаки к нужным фрагментам. Meta использовала пять измерений параллелизма: три для плотных параметров и два для разреженных. Это обозначение относится к распределённому обучению, а не к пяти измерениям входных тензоров.
В основе — принцип согласовать объём сообщения с пропускной способностью конкретной части сети. На схеме сети видно три уровня обучающего кластера: восемь GPU внутри сервера связаны NVLink, серверы в одной AI-zone соединены через RoCE, а каналы RoCE между AI-zone переподписаны (oversubscribed) и имеют меньшую доступную полосу. На схеме также показаны стойки и узлы, но размер и пропускная способность каждой стойки количественно не заданы.
Поэтому самый интенсивный обмен выгодно оставлять внутри одного сервера на NVLink, обмен фрагментами параметров ограничивать группами внутри зоны, а через более медленные межзонные связи передавать относительно небольшие синхронизации градиентов. Если коллективная операция не помещается по времени на данном уровне, команда добавляет измерение параллелизма, которое уменьшает размер группы или объём сообщения.
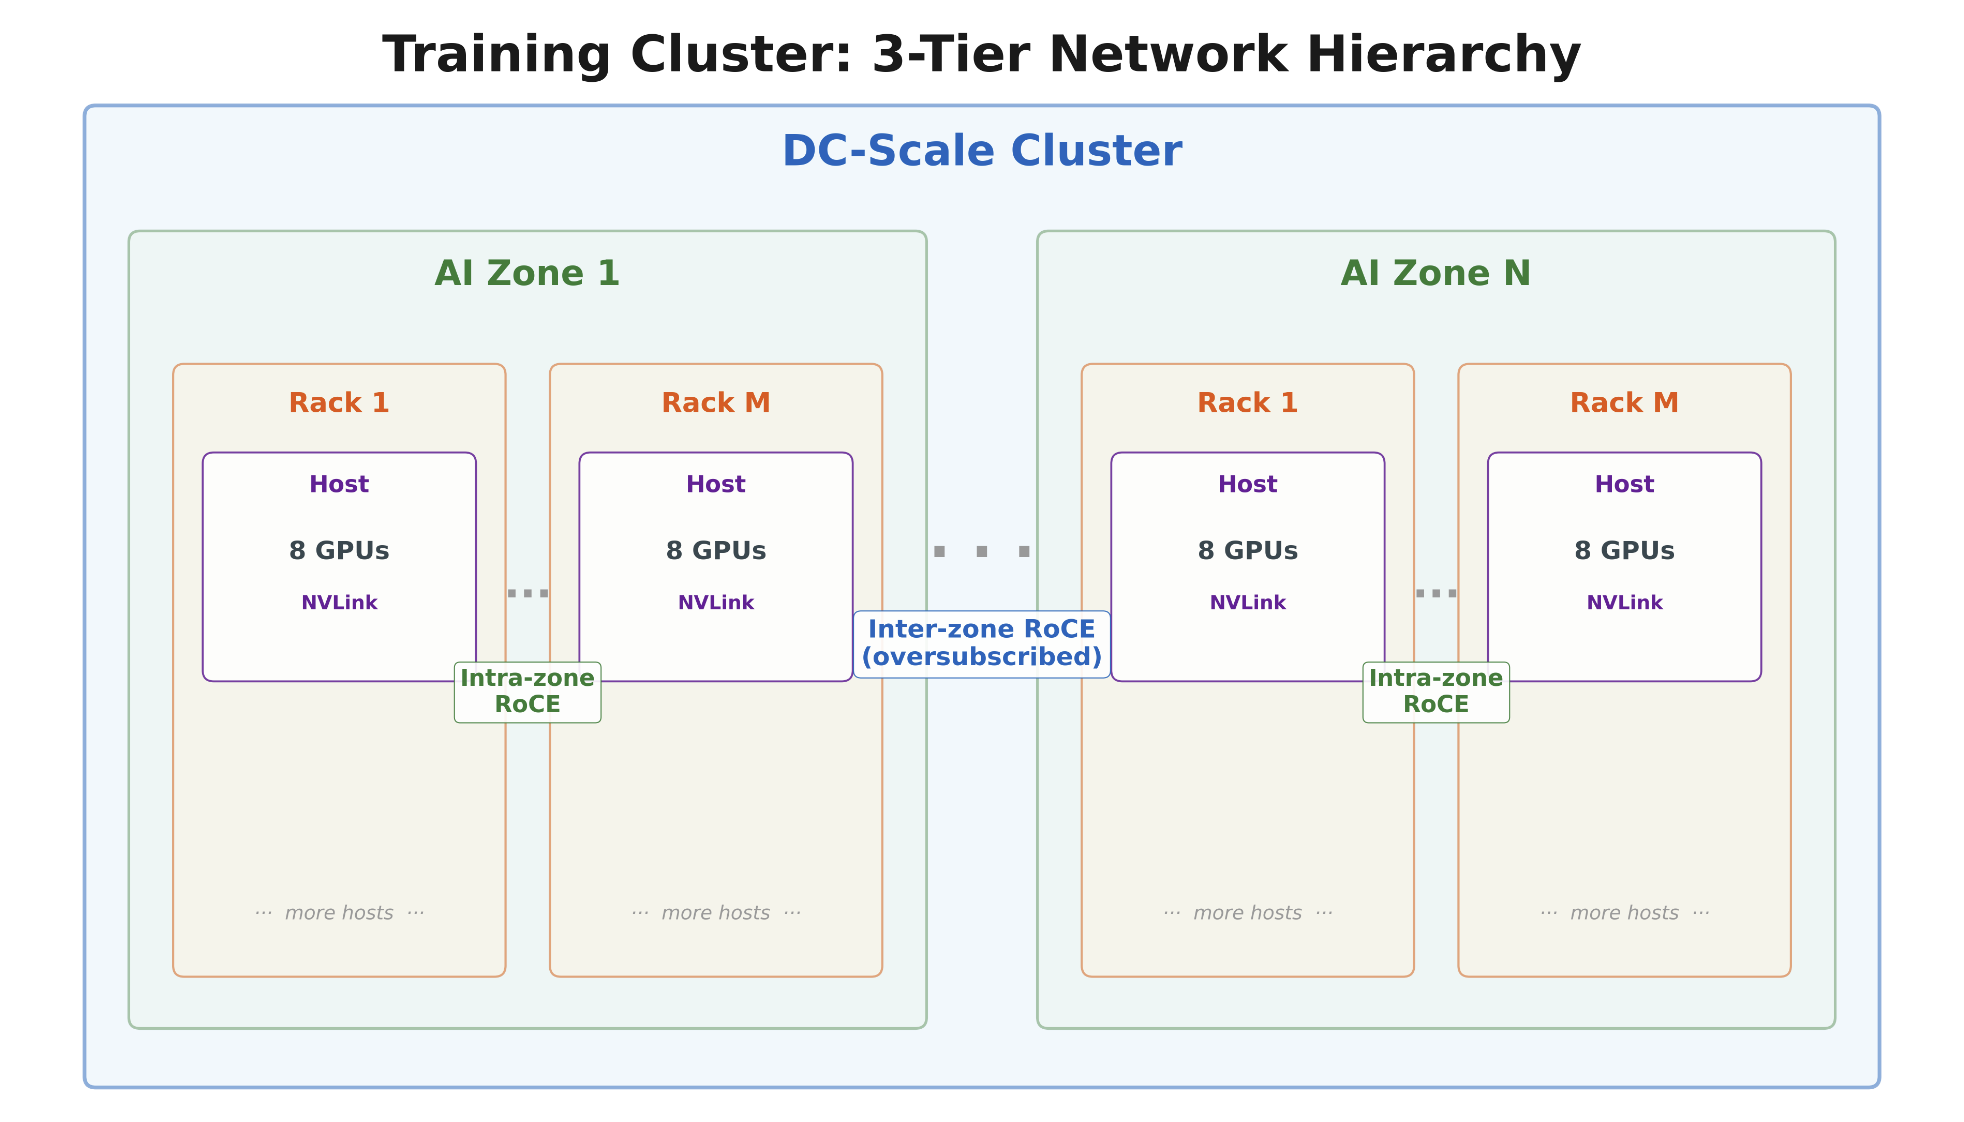
Три уровня сети обучающего кластера: GPU внутри сервера, серверы в стойке и связи между стойками и зонами.
Источник: Оригинальная иллюстрация · MetaПлотные параметры разделили на три измерения
Для плотной части GEM, содержащей миллиарды параметров, базовый инструмент — Fully Sharded Data Parallel (FSDP). Каждый GPU хранит только фрагмент весов и состояний оптимизатора. Перед расчётом модуля участники выполняют all-gather, то есть временно собирают необходимые фрагменты, а после вычисления градиентов используют reduce-scatter: суммируют вклады и оставляют у каждого его часть. При обычной одномерной FSDP-группе размером в несколько тысяч GPU обе операции могут стать дорогими, особенно при пересечении разных AI-zone.
Сначала FSDP объединили с ещё одним измерением — группами реплик Data Distributed Parallel (DDP), получив двумерную FSDP. Внутри небольшой группы, например на 128–256 GPU, параметры собираются и делятся обратно. Между группами реплик градиенты синхронизируют через all-reduce, но передаются уже градиенты локальных шардов, а не полная копия всего слоя. Благодаря небольшому размеру сообщения этот этап переносит даже ограниченную межзонную полосу.
Meta заранее запрашивает следующий набор параметров, перекрывая all-gather очередного слоя с вычислениями предыдущего. Для большинства модулей это скрывает задержку сети. Исключением оказались крупные эксперты DHEN (Deep Hierarchical Ensemble Network): их весов настолько много, что обмен дольше соседних вычислений. Предвыборка не может полностью спрятать передачу — приходится менять структуру параллелизма.
Третье измерение — Expert Parallelism (EP). Каждый rank хранит одного эксперта, поэтому FSDP собирает параметры только этого эксперта, а для обработки полного пакета эксперты обмениваются активациями внутри сервера по быстрому NVLink. На схеме распределения плотных параметров эти три типа коллективов имеют отдельные стрелки: FSDP all-gather/reduce-scatter параметров по межсерверному RoCE, EP all-gather/reduce-scatter активаций внутри узла и DDP all-reduce градиентов между репликами, потенциально между AI-zone. Это распределение соответствует неодинаковой стоимости трёх сетевых уровней.
В приведённом авторами ходе forward: FSDP собирает веса эксперта в 16-участной межсерверной группе; EP собирает активации в паре GPU внутри узла; каждый rank вычисляет своего эксперта на полном пакете; EP выполняет reduce-scatter результатов. При backward FSDP снова собирает параметры эксперта, EP собирает градиенты выходов, затем после расчёта градиентов эксперта делает reduce-scatter градиентов входов, и FSDP распределяет градиенты параметров обратно. Указанные 16-way и 2-way — конкретная иллюстрация организационного решения, а не предписание для любого кластера.
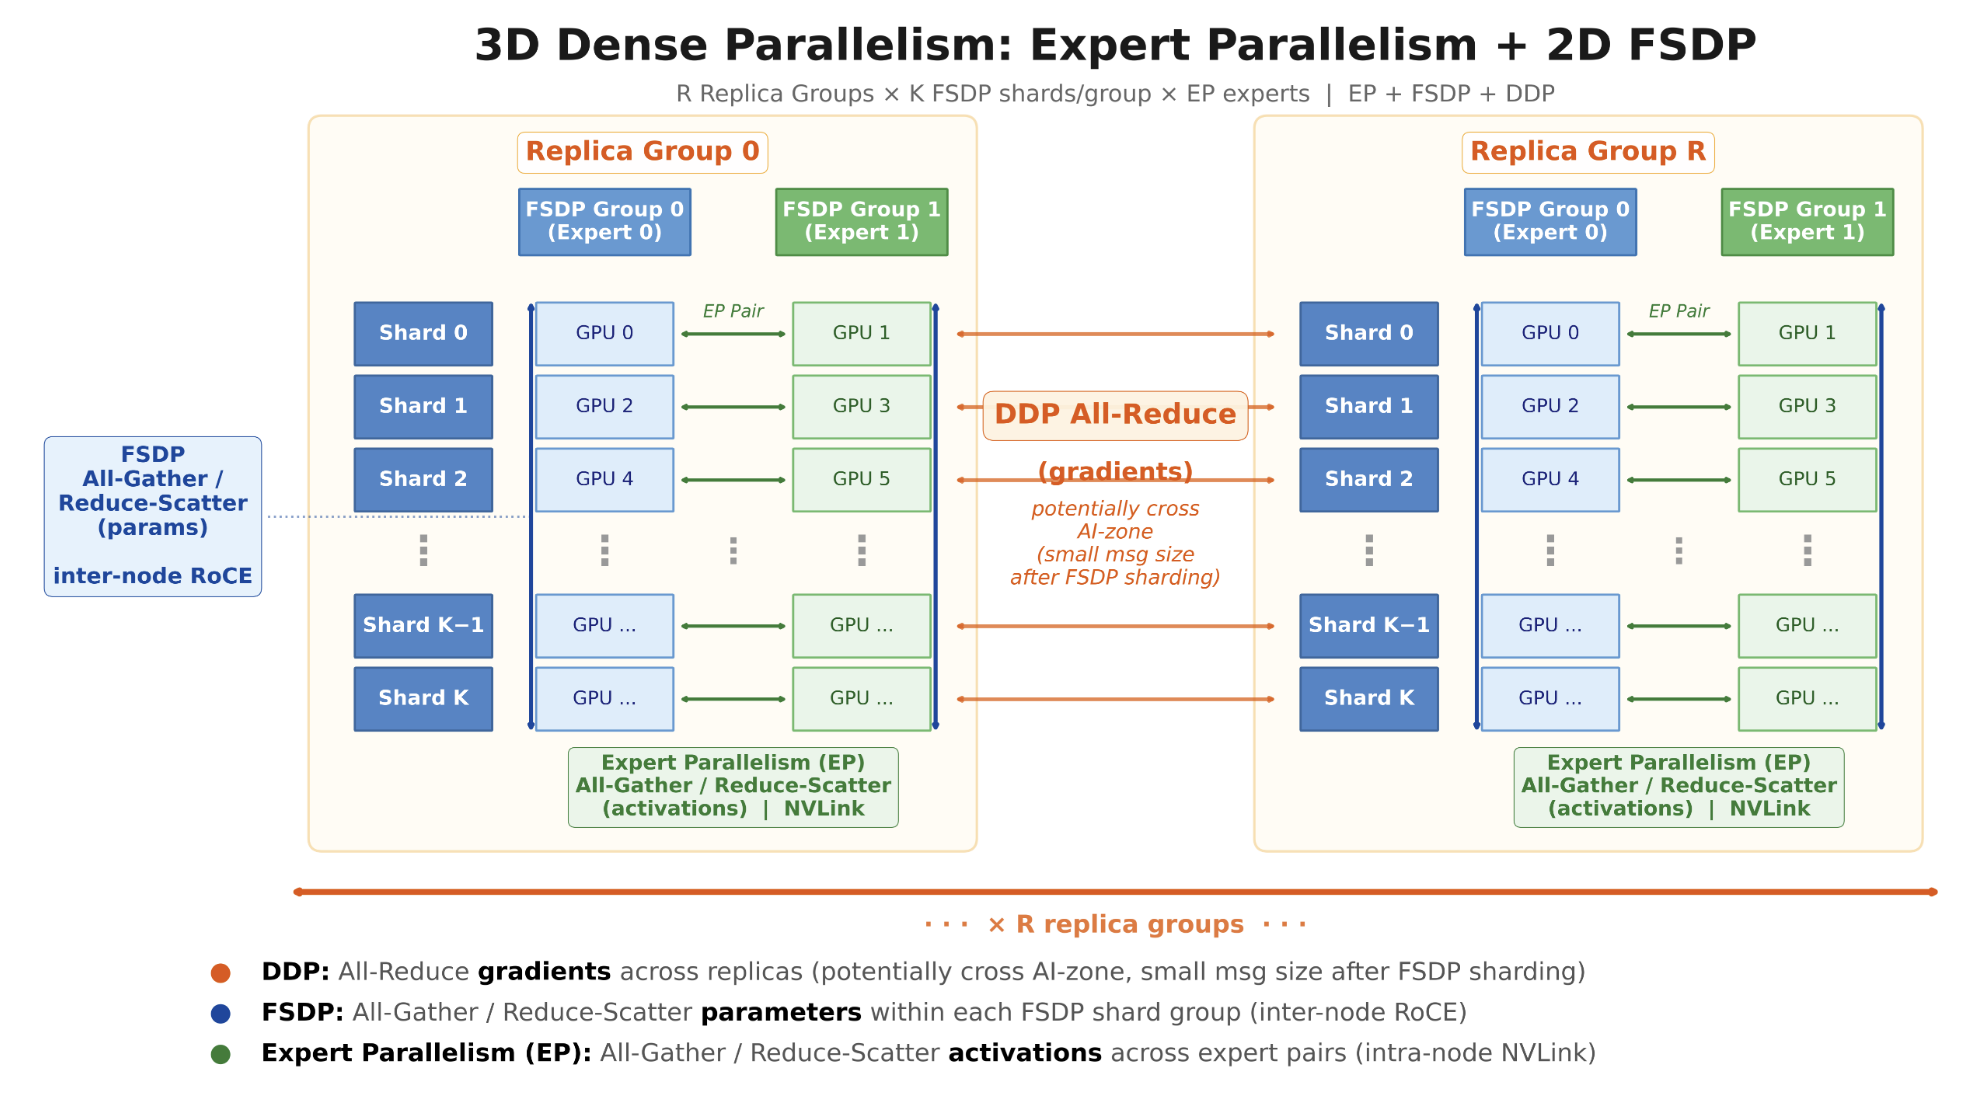
Параллелизм плотной части модели учитывает несколько уровней топологии.
Источник: Оригинальная иллюстрация · MetaРазреженные таблицы прошли три поколения
Разреженная часть GEM принципиально иная: таблицы представлений имеют порядок триллионов параметров, но на одном примере нужны лишь строки для выбранных идентификаторов. Их размещают на разных GPU через модельный параллелизм, а признаки доставляют владельцам таблиц коллективной операцией all-to-all — каждый участник отправляет данные многим другим. В отличие от плотных экспертов здесь необходимо одновременно контролировать неравномерность таблиц, задержку такого обмена и видеопамять HBM.
Таблицу можно прокрутить по горизонтали.
В V1 слишком много ускорителей делят набор таблиц: на одном rank остаётся мало фрагментов для хорошего выравнивания нагрузки, а all-to-all включает сразу тысячи участников и может пересекать перегруженные каналы между зонами. В V2 ранги разбивают на небольшие модельно-параллельные группы, например по 256 GPU. Несколько таких групп обрабатывают разные пакеты данных, а обмен признаками остаётся внутри меньшей группы. Это улучшило балансировку и заметно подняло QPS обучения, но не устранило проблему памяти.
Цена V2 — репликация: каждая группа должна держать собственную полную копию триллионных разреженных параметров. Общий дополнительный объём растёт вместе с числом групп и занимает HBM. Поэтому третья версия сохраняет двумерную организацию, но делит между группами и саму копию шардов таблиц: каждый rank постоянно хранит только долю, а полный нужный фрагмент восстанавливается на время операции.
На схеме распределения разреженных таблиц разными цветами показаны два направления общения. Фиолетовый all-to-all передаёт признаки и эмбеддинги внутри модельно-параллельной группы; синий all-gather/reduce-scatter восстанавливает и затем снова делит фрагменты таблиц между группами. Таблицы A, B, C и далее представлены частями A[0/N], B[0/N] и так далее. Это наглядно показывает, почему V3 устраняет дорогое постоянное дублирование, но добавляет временное восстановление таблиц.
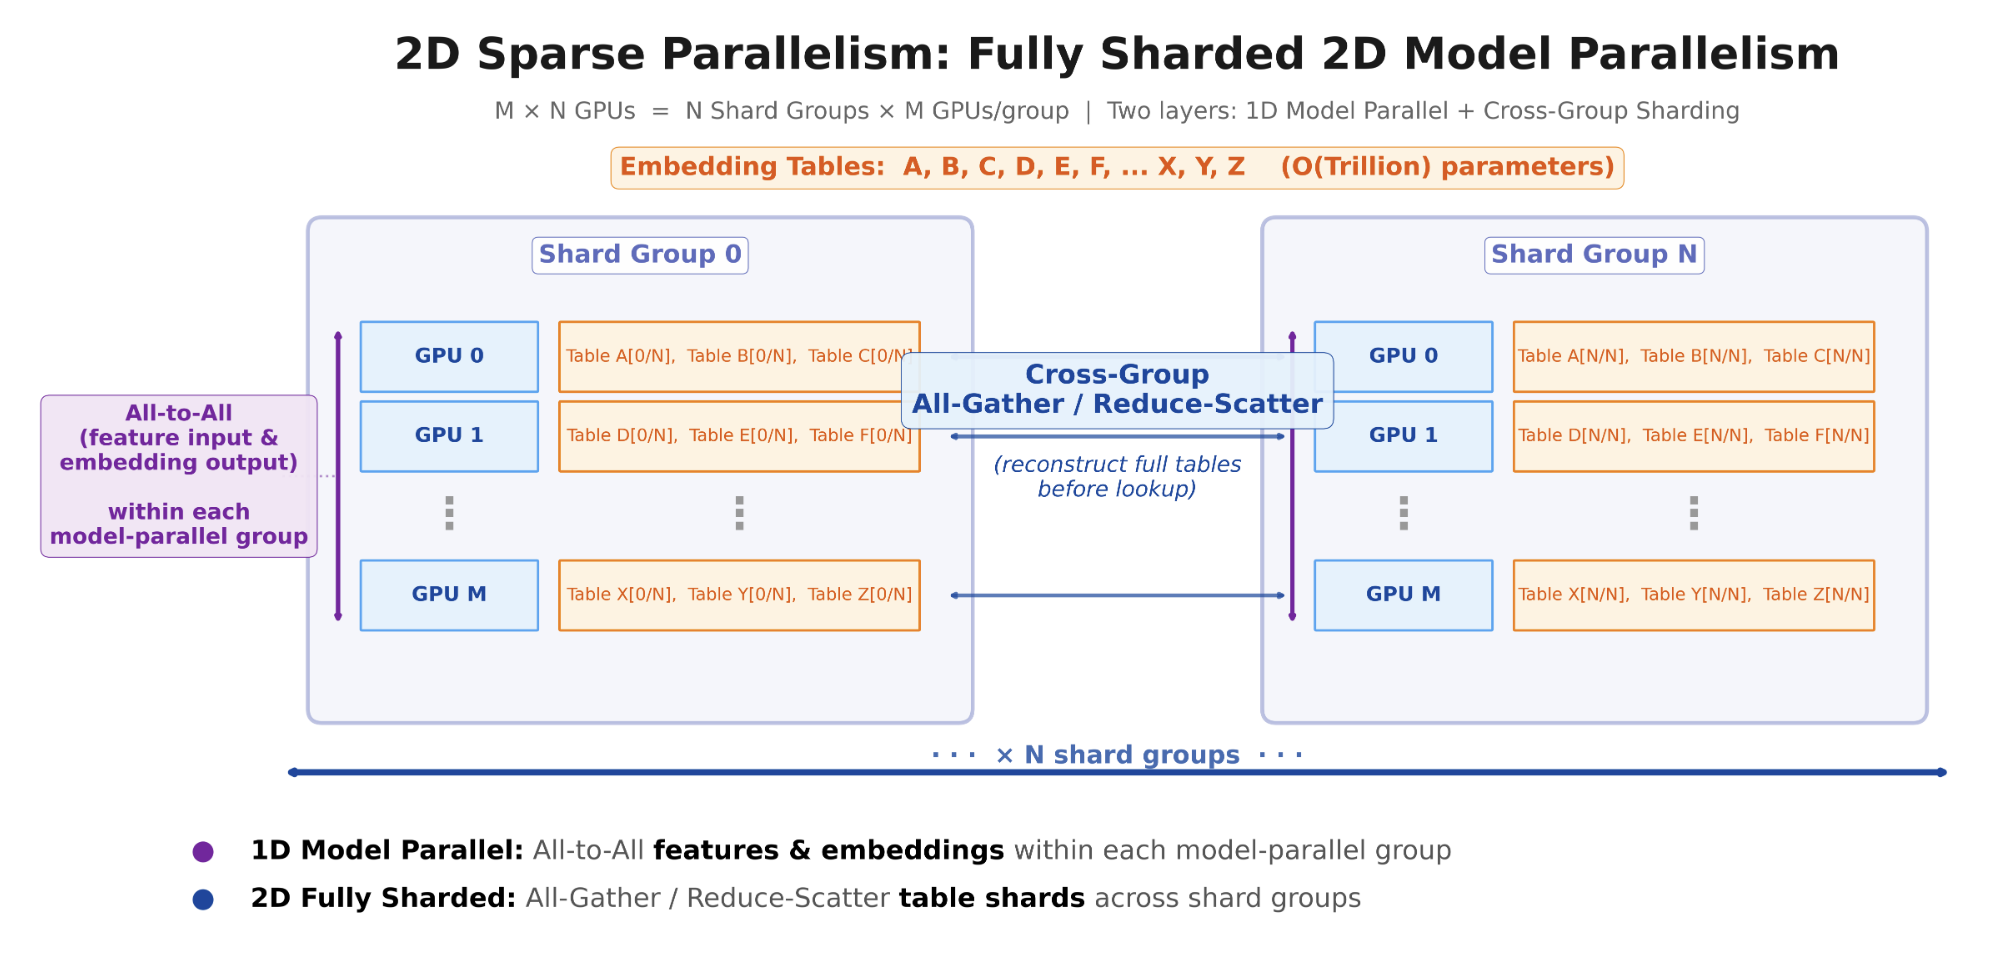
Разреженные таблицы представлений распределяются между процессами отдельно от плотной части модели.
Источник: Оригинальная иллюстрация · MetaКак обучают полностью шардированные таблицы
При прямом проходе V3 сначала выполняет all-gather нужных фрагментов таблиц. Затем all-to-all отправляет признаки к GPU, владеющим соответствующими частями, выполняется поиск строк эмбеддингов (embedding lookup), после чего ещё один all-to-all возвращает рассчитанные представления туда, где продолжается плотная часть модели. Важно различать эти две задачи обмена: восстановление параметров и маршрутизацию признаков.
В обратном проходе снова собирают нужные части таблиц, через all-to-all передают градиенты к участникам, отвечающим за строки, выполняют локальное обновление и reduce-scatter параметров. Дополнительные операции all-gather/reduce-scatter V3 направлены по быстрым каналам NVLink. Команда перекрывает их плотными вычислениями и освобождает временно восстановленные таблицы перед пиком расхода HBM.
За счёт этого авторы описывают масштабирование разреженной части как почти не добавляющее расходов на память и с небольшим видимым временем обмена на применённом масштабе GEM. Это инженерное свойство данной топологии и планирования; буквального нулевого обмена V3 не обещает.
V2 → V3: Eliminating Memory OverheadКак NCCLX освободил вычислительные блоки GPU
Даже если обмен параметрами формально перекрыт с вычислениями, он может забирать те же GPU-ресурсы. Обычные коллективные операции запускают ядра копирования на потоковых мультипроцессорах (Streaming Multiprocessors, SM), на которых одновременно должны работать GEMM и внимание. По профилю Meta all-gather или reduce-scatter могли занимать около 24 SM. Конкуренция снижала эффективность до 15%, причём потеря скорости иногда была больше простой доли занятых блоков из-за неудачного планирования волн вычислений.
Для операций, где нужно только перенести данные без их арифметического объединения, команда использовала NCCLX — собственное расширение библиотеки NCCL. Пересылку внутри сервера выполняет аппаратный Copy Engine по NVLink, между серверами — RDMA. Основные данные перемещаются без участия вычислительных SM; один SM может оставаться для координации.
На схеме NCCLX этот переход показан на GPU с 148 SM: до оптимизации 24 заняты коммуникацией и 124 доступны для вычислений; после — один занимается координацией и 147 могут исполнять модель. Таким образом освобождается около 23 SM. На полном масштабе обучения GEM эта замена дала примерно 5% прироста QPS. Это измерение сквозной пропускной способности обучающего запуска, а не ускорение одного all-gather на 5%.
Для операций с редукцией — например all-reduce, где нужно складывать данные — простого копирующего движка недостаточно. Авторы рассматривают NVLink SHARP, позволяющий выполнять арифметическую редукцию в сетевом оборудовании. В статье это обозначено как работоспособный вариант, без отдельного численного эффекта для обучения всей GEM.
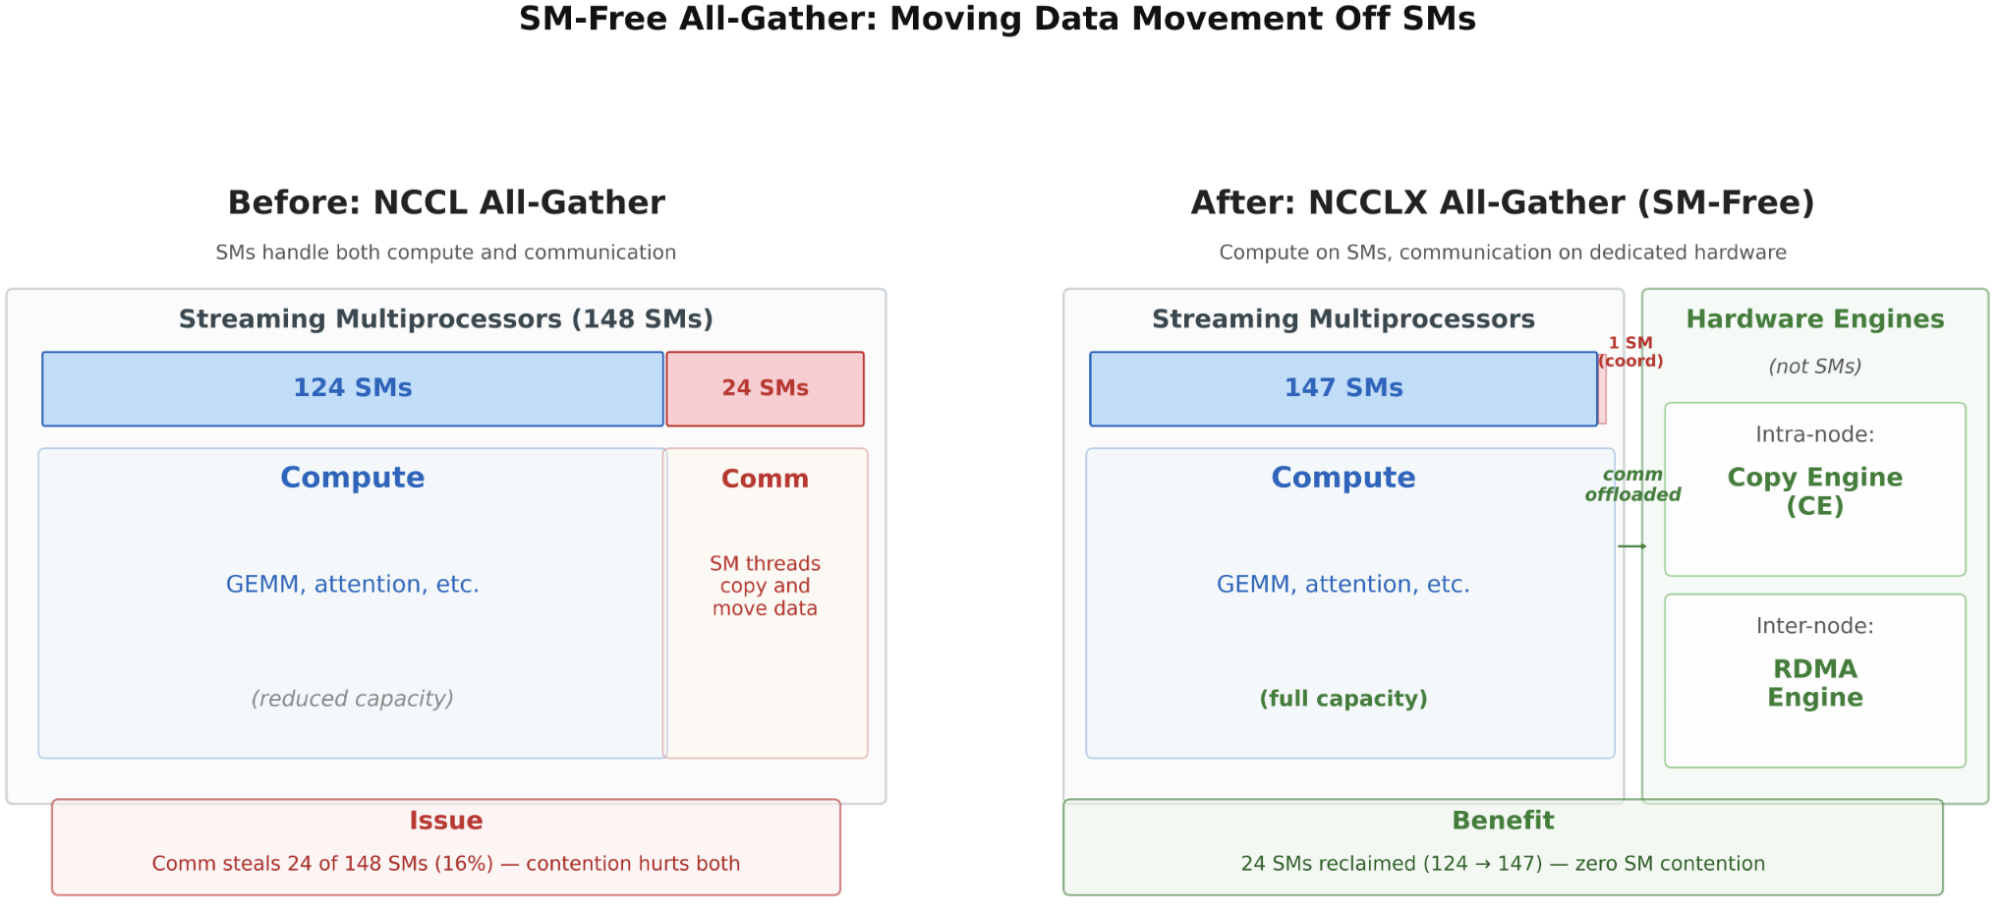
Перенос коммуникации с вычислительных блоков освобождает ресурсы GPU для основной работы.
Источник: Оригинальная иллюстрация · MetaПочему память одного GPU заняли активации
При обучении GPU хранит параметры и состояние оптимизатора, промежуточные выходы слоёв (активации), необходимые для обратного прохода, и шардированные таблицы эмбеддингов. На уровне всей GEM объём разреженных таблиц огромен. Но когда и плотные, и разреженные параметры распределены между тысячами ускорителей, на одну карту попадает относительно небольшая доля весов, тогда как промежуточные значения для её локального пакета данных остаются большими.
Это прямо видно на диаграмме памяти. Левая круговая диаграмма для модели целиком отводит около 80% памяти таблицам эмбеддингов, 11% оптимизатору и градиентам, около 4% активациям и 4% плотным параметрам (небольшое расхождение суммы с 100% связано с округлением отображённых долей). Справа для одного GPU после распределения параметров около 85% занимает хранение активаций, 7% — оптимизатор и градиенты, 6% — фрагменты эмбеддингов и 2% — плотные фрагменты.
Следовательно, следующая проблема масштабирования — не просто как распределить ещё больше весов, а как удержать разумный размер обучающего пакета на каждом GPU. Если активаций слишком много, нужно пересчитывать их из промежуточных слоёв при backward; если уменьшить пакет, падает локальная эффективность. Meta оптимизирует именно этот компромисс между доступной HBM, памятью для градиентов и повторным вычислением.
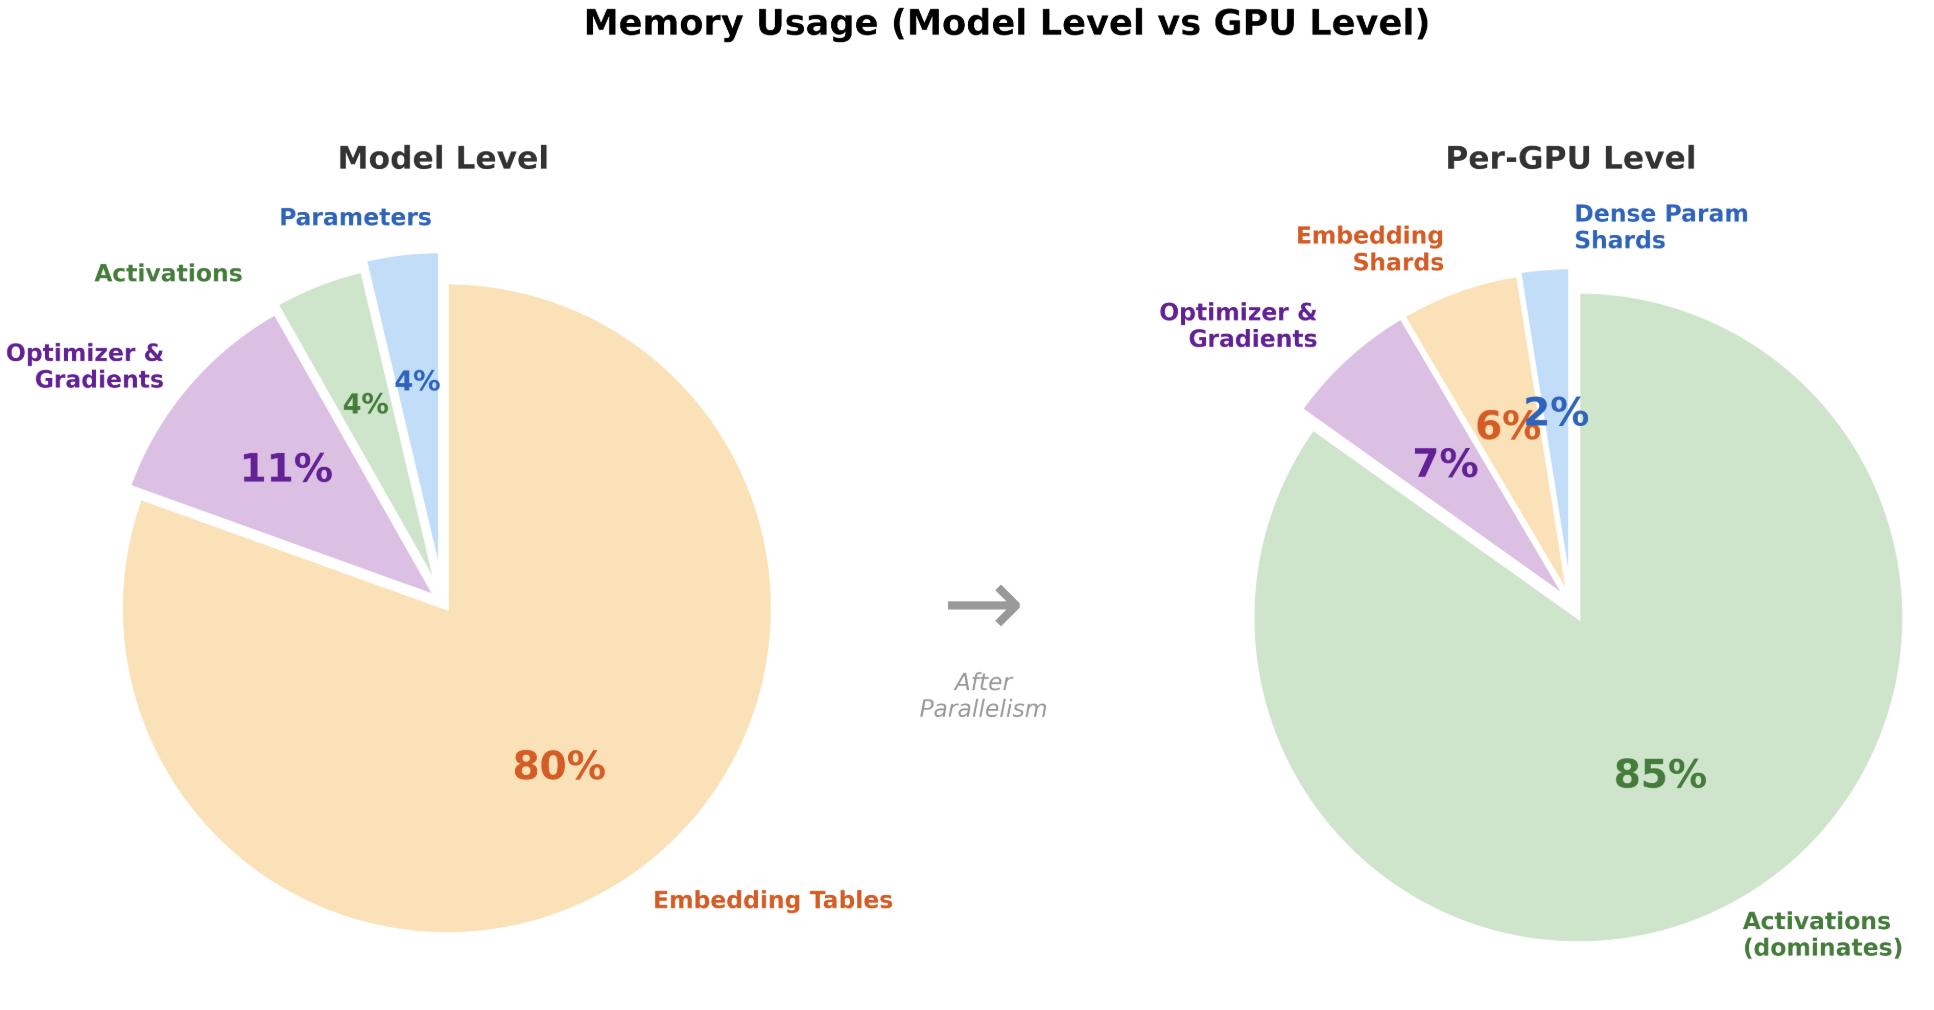
Главные потребители памяти на уровне полной модели и одного GPU различаются.
Источник: Оригинальная иллюстрация · MetaВыборочное сохранение и квантизация активаций
Обычное сохранение всех активаций требует много памяти, а крайний вариант с пересчётом почти всего во время backward расходует вычисления. Автоматическая контрольная точка активаций (activation checkpointing) ищет промежуточные значения, которые выгоднее хранить, и те, которые дешевле пересчитать. Компиляторный механизм PyTorch Automatic Activation Checkpointing (AutoAC) анализирует совместный граф прямого и обратного проходов: дорогие операции старается не повторять, простые поэлементные — может выполнить ещё раз.
Meta обнаружила недостаток одинакового бюджета памяти для всей модели. Вычисления разбиты на компилируемые участки между разрывами графа (graph breaks), и у каждого разная отдача от сохранённого гигабайта: для одного участка сохранение активаций сэкономит много времени, для другого — почти ничего. Авторы заменили единый бюджет своим распределением памяти по участкам. Больше памяти достаётся там, где сохранение промежуточных значений сильнее сокращает задержку backward.
Второй шаг — сжать именно те активации, которые AutoAC уже решил оставить для обратного прохода. На границе между forward и backward эти сохранённые тензоры могут переводить, например, из BF16 в FP8 или MX4. Квантизация уменьшает число байтов на сохранённое значение, поэтому пакет может стать больше при приемлемом объёме повторных вычислений. Это именно квантизация сохранённых активаций, а не заявленный перенос всей истории или активаций из HBM на CPU.
В получившемся режиме авторы смогли использовать локальные пакеты более тысячи примеров на GPU с умеренными накладными расходами на повторный расчёт. Здесь размер локального пакета — ещё и средство улучшения MFU: слишком маленький пакет не загружает GPU, а слишком агрессивный checkpointing тратит время вместо обучения.
Compiler-based Automatic Activation Checkpointing (AutoAC)Неровные истории создают отстающие процессы
JFA убирает вычисления по пустым позициям внутри каждой истории. Но это выявляет другую проблему: один rank случайно получает больше длинных пользовательских историй, другой — больше коротких. На синхронном шаге все ждут наиболее занятую карту. Дополнение последовательностей до общей длины могло бы сгладить разброс времени ценой тех самых 50% и более лишних вычислений, поэтому команда сохранила переменные длины и занялась балансировкой пакетов.
На графике разброса нагрузки синяя линия — средняя суммарная длина историй среди rank на шаге обучения, оранжевая — максимальная нагрузка одного отстающего rank, зелёная пунктирная — минимальная; голубая полоса показывает интерквартильный диапазон P25–P75. На множестве последовательных шагов самый тяжёлый rank находится примерно на 15% выше среднего. Смена такого rank от итерации к итерации делает статическую ручную настройку бесполезной.
Meta сравнила две стратегии. Локальная балансировка меняет состав пакетов внутри одного rank: качество такого выравнивания авторы оценивают примерно в 90% теоретически лучшего результата и она не требует обмена между GPU. Глобальная балансировка через all-to-all передаёт сами примеры между rank, достигает почти идеального выравнивания, но каждый шаг получает дополнительную сетевую операцию. Её накладные расходы съели бы собственный выигрыш — поэтому команда отказалась от глобальной пересылки данных.
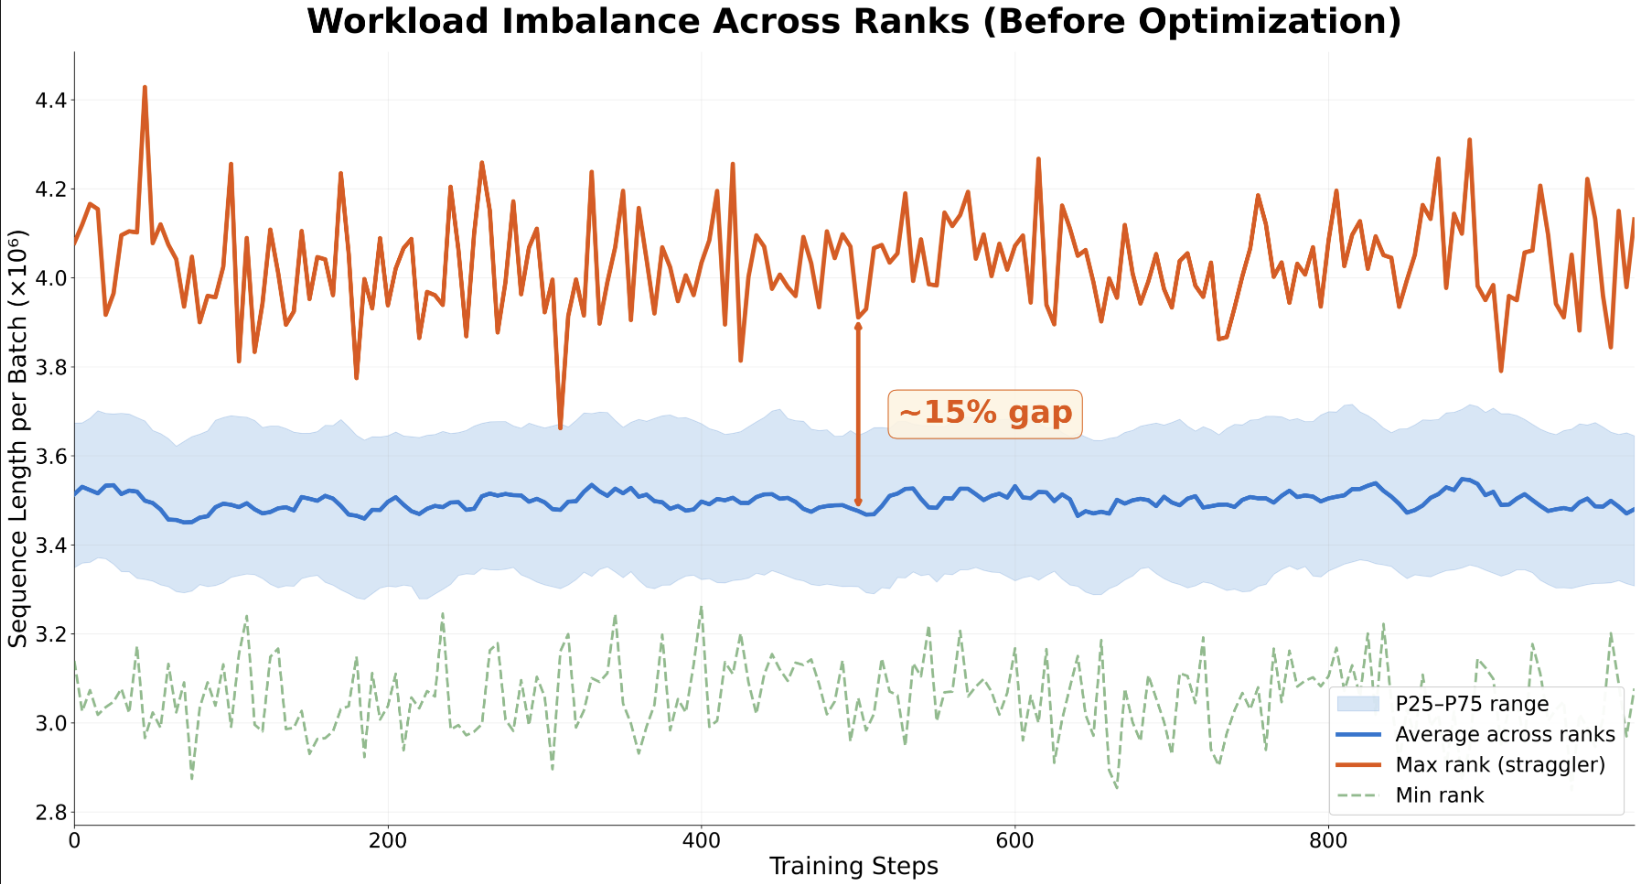
Неравномерная нагрузка на процессы оставляет часть оборудования ждать самый медленный процесс.
Источник: Оригинальная иллюстрация · MetaBase Batch Shuffling выравнивает обучающие пакеты
Решением стала Base Batch Shuffling (BBS). Распределённые процессы чтения данных сначала формируют небольшие базовые подпакеты по 128 примеров. Для каждого считают суммарную длину содержащихся пользовательских последовательностей — приближённую меру будущей вычислительной работы. Затем подпакеты сортируют и перемежают: тяжёлые ставят рядом с лёгкими, прежде чем собрать полный пакет из более чем тысячи примеров для каждого rank.
Смысл BBS — перераспределить разброс ещё на этапе сборки пакетов, а не пересылать примеры через all-to-all между GPU после распределения. Суммарная длина полной партии становится более похожей на других rank. При этом переменные последовательности по-прежнему обрабатываются без дорогостоящего глобального дополнения пустыми позициями.
На графике BBS точка включения BBS отмечена вертикальной линией. До неё разница максимальной нагрузки rank относительно средней держится примерно около 15%; после короткого переходного периода зелёная кривая выходит примерно на 3%. В том же обучении GEM авторы измерили увеличение QPS примерно на 4% и снижение пиковой потребности в памяти примерно на 4%; отдельно описали это как 4% выигрыш эффективности. Эти две метрики отражают скорость и память одного изменения — их не нужно складывать.
Такой эффект невелик по сравнению с ускорением отдельных ядер, но он устраняет задержки, которые остаются после оптимизации вычислений. Более равномерные пакеты помогают использовать освобождённые SM и сохранять увеличенный локальный размер пакета, не упираясь каждый раз в наиболее тяжёлую историю на одной карте.
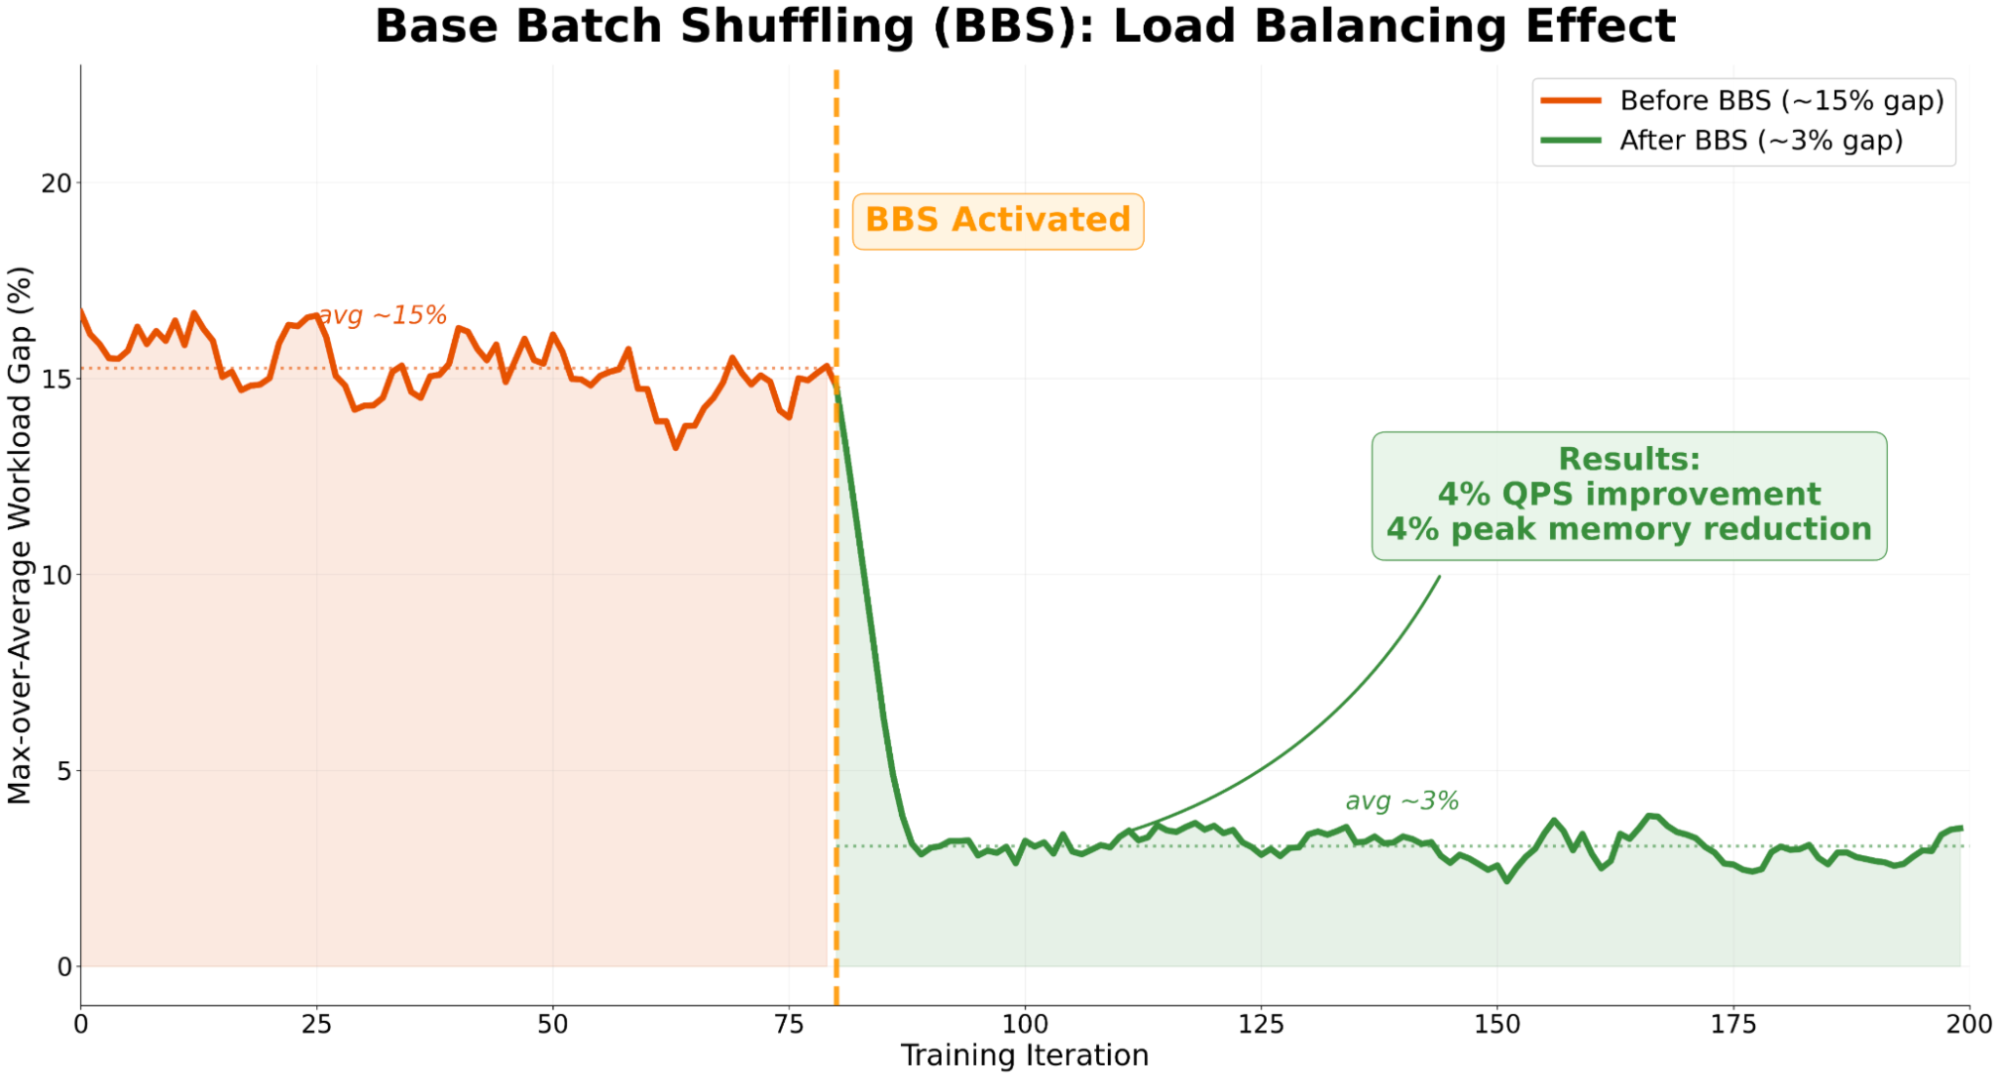
Base Batch Shuffling снижает перекос нагрузки в показанном эксперименте; условия и результаты остаются относящимися к этой конфигурации.
Источник: Оригинальная иллюстрация · MetaСовокупный результат и дальнейшие направления
Meta описывает итог как совместную оптимизацию ядер, точности чисел, распределения параметров, сети, памяти и балансировки. За 12 месяцев сквозная эффективность обучения GEM удвоилась и достигла 20–25% Model FLOPs Utilization на нескольких тысячах GPU последнего поколения. За тот же период суммарный объём training FLOPs увеличился в четыре раза. Первая величина отвечает на вопрос об эффективности использования вычислений в ходе обучения; вторая — о выросшем масштабе вычислительной работы. Рост training FLOPs нельзя считать четырёхкратным ускорением одного шага или ростом качества рекомендаций.
Детали результатов важно читать на правильном уровне. JFA повышает Local MFU и QPS; GDPA в измеренном варианте даёт более 30% прироста пропускной способности обучения всей модели; BlockAttention сообщает о MFU только слоя самовнимания; MXFP8 — об ускорении прямого и обратного GPU-ядер; NCCLX и BBS — о прибавках QPS всего обучающего запуска. Эти эффекты получены на разных базах сравнения и не образуют аддитивную таблицу долей общего 2×.
Авторы связывают следующий этап развития с дальнейшим увеличением масштаба GEM и совместной настройкой уровней системы. Они ожидают возможности ещё двукратного повышения эффективности и намерены привлекать агентов для автоматизации части инженерных циклов поиска оптимизаций. Это направление будущей работы, а не уже достигнутый результат.
Границы опубликованных измерений: нет полной матрицы вкладов отдельных изменений в общее удвоение, воспроизводимого описания всех конфигураций GPU/кластера и независимого сравнения качества на едином наборе CTR/CVR. Измеренные улучшения относятся к вычислениям и обучающей пропускной способности. Показатели пользовательской реакции на рекламу или экономический эффект здесь не оцениваются.
On to the Next Level of Scale and EfficiencyИтог: путь обучающего пакета через GEM
GEM показала, что обучение рекламной рекомендательной модели на нескольких тысячах GPU упирается сразу в несколько ресурсов. Длинные пользовательские истории мешают эффективно выполнять внимание, таблицы эмбеддингов требуют памяти и обмена, а крупные плотные слои конкурируют за вычислительные блоки. Meta решала эти ограничения совместно: специализированные ядра ускоряли отдельные операции, смешанная точность уменьшала их стоимость, а топологически согласованный параллелизм позволял сохранить выигрыш на всём кластере.
- 01
Подготовка признаков
Считыватели собирают числовые и категориальные признаки и истории действий переменной длины. Base Batch Shuffling перемежает тяжёлые и лёгкие подпакеты до отправки полных пакетов на GPU.
- 02
Таблицы и плотные представления
Шарды эмбеддингов временно собираются и получают нужные признаки через all-to-all. Плотная часть получает представления, распределённые между группами FSDP и экспертов.
- 03
Прямой проход
JFA и GDPA обрабатывают различные формы внимания; BlockAttention ограничивает взаимодействия внутри истории. MXFP8 используется там, где выдерживаются требования к численной точности.
- 04
Обратный проход и обмен
Для градиентов выполняются обратные GPU-ядра, reduce-scatter и синхронизации. NCCLX переносит копирование на специализированные механизмы; AutoAC сохраняет или пересчитывает активации.
- 05
Обновление параметров
Распределённые фрагменты параметров и состояния оптимизаторов обновляются после расчёта градиентов. Временные копии освобождаются, затем начинается следующий пакет.
Эффективность проверяли на нескольких уровнях: TFLOPS отдельных ядер, MFU отдельных слоёв и одного GPU, QPS обучающего запуска и сквозной E2E MFU. В исследованной конфигурации E2E MFU удвоилась до 20–25%, одновременно за 12 месяцев объём training FLOPs вырос в четыре раза. Эти числа описывают эффективность и масштаб обучения, а не изменение CTR, CVR или выручки. Отдельные измерения не складываются напрямую; опубликованные подробности не дают полной таблицы вкладов всех оптимизаций. Следующее удвоение эффективности и автоматизация инженерных поисков агентами остаются планами Meta.
On to the Next Level of Scale and Efficiency