A-vibe: русский токенизатор, обучение и скорость под нагрузкой
Авито нужна общая языковая модель для своих задач: с хорошим русским, управляемым обучением и приемлемой стоимостью работы. Взяли Qwen3-8B-Base, адаптировали токенизатор, затем провели инструктивное обучение и обучение по обратной связи.
Статья · на русском
Как мы в Авито сделали свою LLM — A-vibeАнастасия Рысьмятова · Опубликовано: 27 октября 2025 г.
Почему адаптировали готовую модель
Обучение с нуля требовало слишком больших затрат, а внешние API ограничивали контроль над данными и доработками. Открытая модель позволяла сохранить достижения базового обучения, но её русская токенизация была менее экономной.
Токенизатор разбивает текст на единицы, которыми оперирует модель. Если одно русское слово требует меньше таких единиц, тот же запрос короче и генерировать ответ можно за меньшее число шагов. Поэтому Авито начала оптимизацию ещё до настройки ответов.
Этот фрагмент в оригиналеКак объединили словари
Простая замена всего токенизатора плохо сохраняла уже выученные представления. В новом подходе оставили частотные английские и программные токены Qwen, а русские взяли из собственного словаря. Частоты считали отдельно на английском корпусе, внутреннем коде и русских текстах.
Для старых токенов сохранили готовые векторы, для новых обучали новые. Сначала остальные веса замораживали, затем размораживали модель. Важная деталь реализации: нулевого градиента недостаточно, если AdamW продолжает менять веса через weight decay; для фиксируемых представлений его отключили.
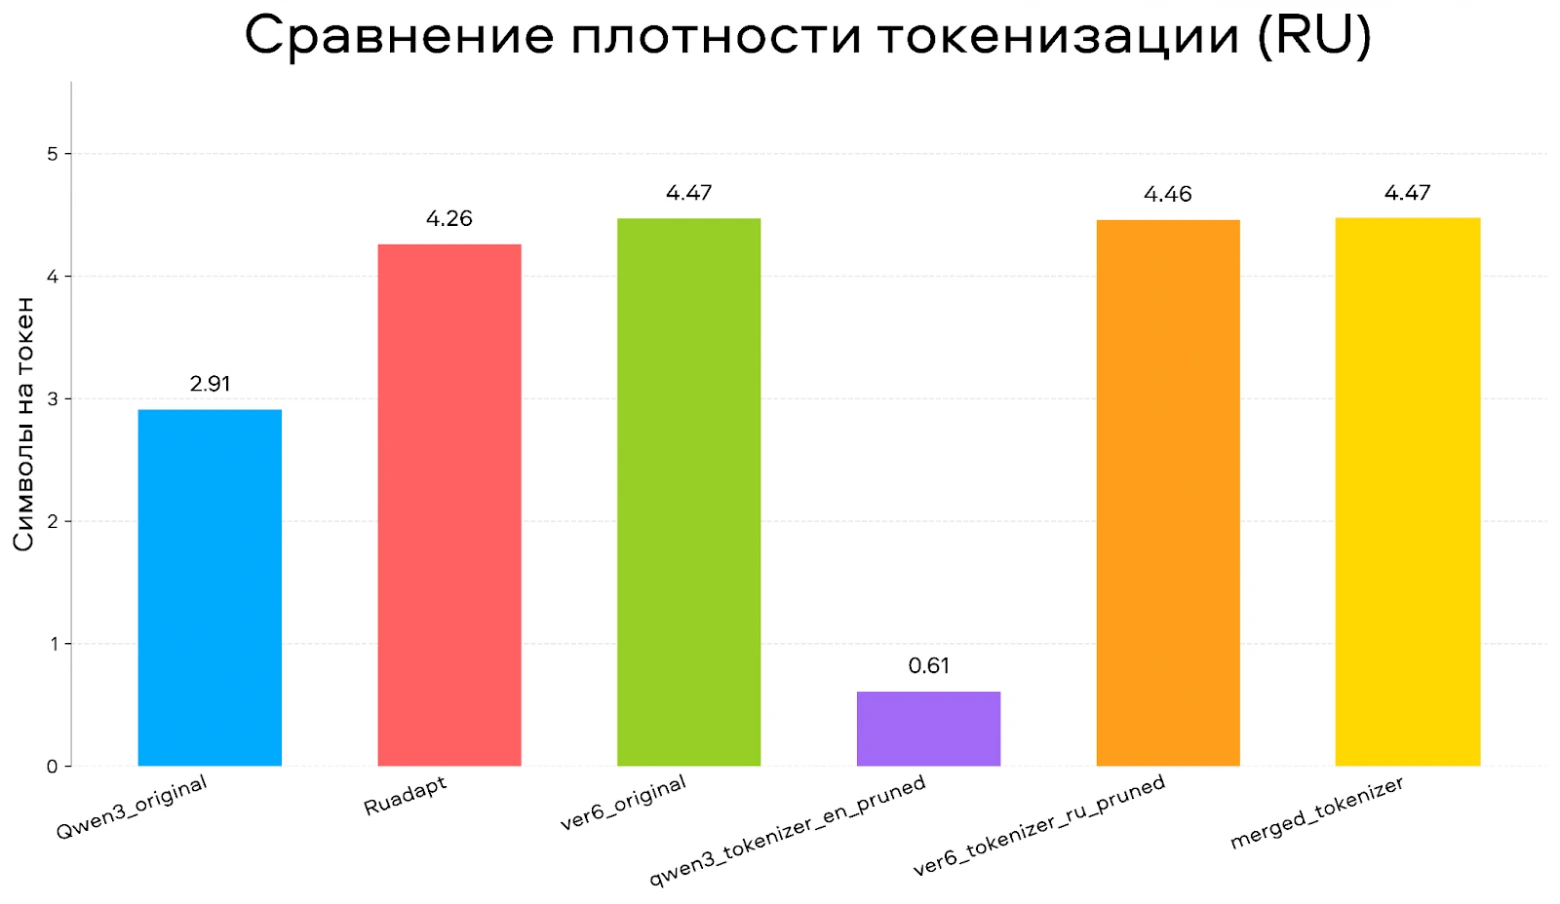
Сравнение токенизации русского текста.
Источник: Иллюстрация из оригиналаSFT, GRPO и DPO решали разные задачи
После адаптации словаря модель обучали выполнять инструкции. Далее на этапе GRPO улучшали решение задач с проверяемым ответом: модель генерирует несколько вариантов, получает оценку и учится чаще выбирать успешные. Слишком простые задачи убрали, потому что одинаково успешные ответы почти не давали полезного сигнала обучения.
DPO использовали для предпочтений в диалоге и безопасности. Для вопроса генерировали восемь ответов целевой модели, большая модель выбирала лучший и худший. Балансировали длину ответов, чтобы предпочтение не сводилось к многословности. Вариант, где положительный ответ брали у большой модели, а отрицательный — у целевой, хорошего результата не дал.
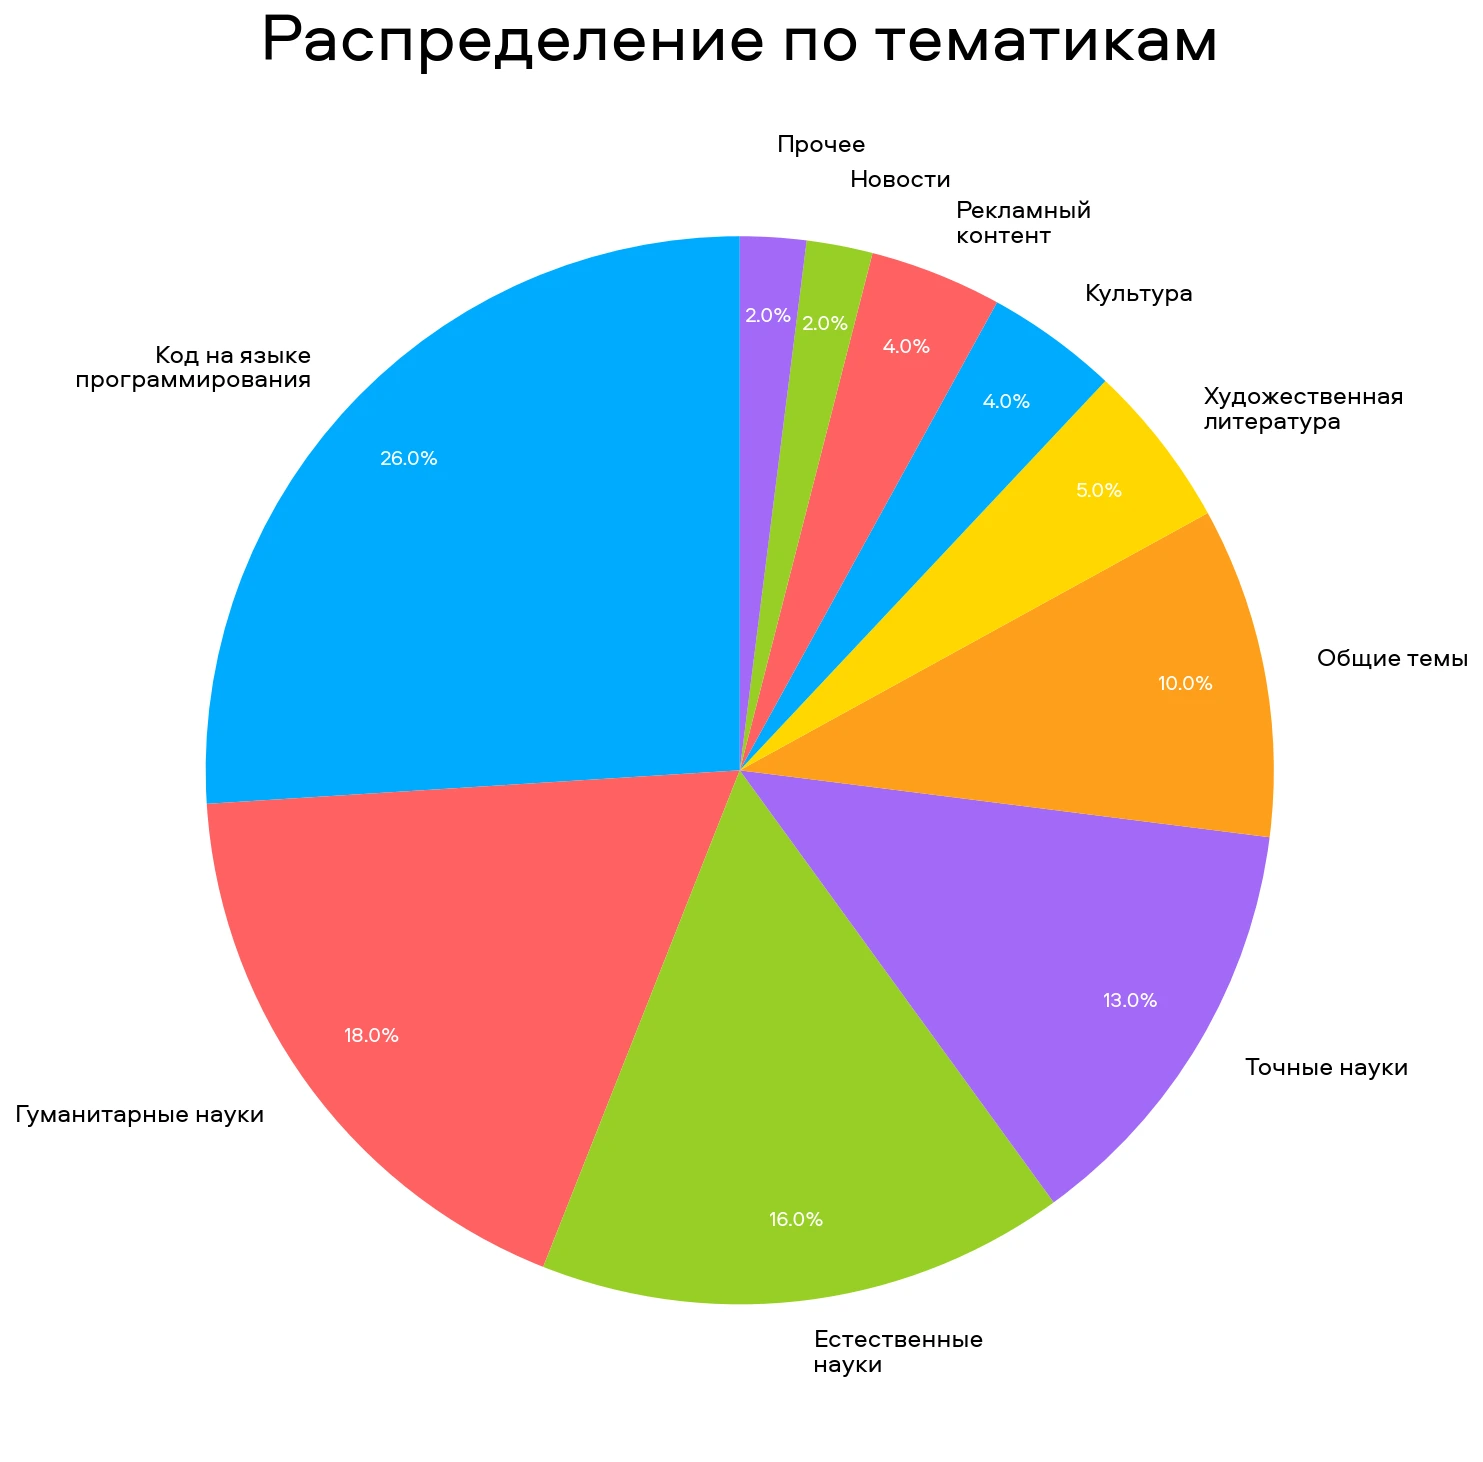
Состав обучающих данных по темам.
Источник: Иллюстрация из оригиналаОценивали не одной итоговой цифрой
Авторы показывают общие знания, русский язык, математику, код, вызов функций и внутренние задачи Авито: нарушения в объявлениях, релевантность поиска и извлечение параметров товара. Улучшения не одинаковы: рост одной оценки сопровождается снижением другой.
Сравнивать таблицы нужно в опубликованном режиме: Qwen3 и Ruadapt в части замеров работали без рассуждений, параметры генерации и формулировки заданий зафиксированы авторами. Результаты внешнего рейтинга, полученные с другим судьёй, не являются тем же экспериментом.
Этот фрагмент в оригиналеУскорение меняется с нагрузкой
На преимущественно русских примерах SFT модель работала в среднем на 15–25% быстрее исходной Qwen3-8B. Кроме более плотной токенизации, уменьшился размер модели. Это сравнение одинаковых текстов, а не скорости генерации произвольного токена.
Отдельно проверили EAGLE-3: маленькая модель предлагает продолжение, основная проверяет его. На одиночных запросах получили до 2,7 раза ускорения; при нагрузке 12 запросов в секунду — до 1,9 раза. При размере пакета 64 преимущество сходило к нулю. Поэтому максимальную цифру нельзя обещать для любого сервиса.
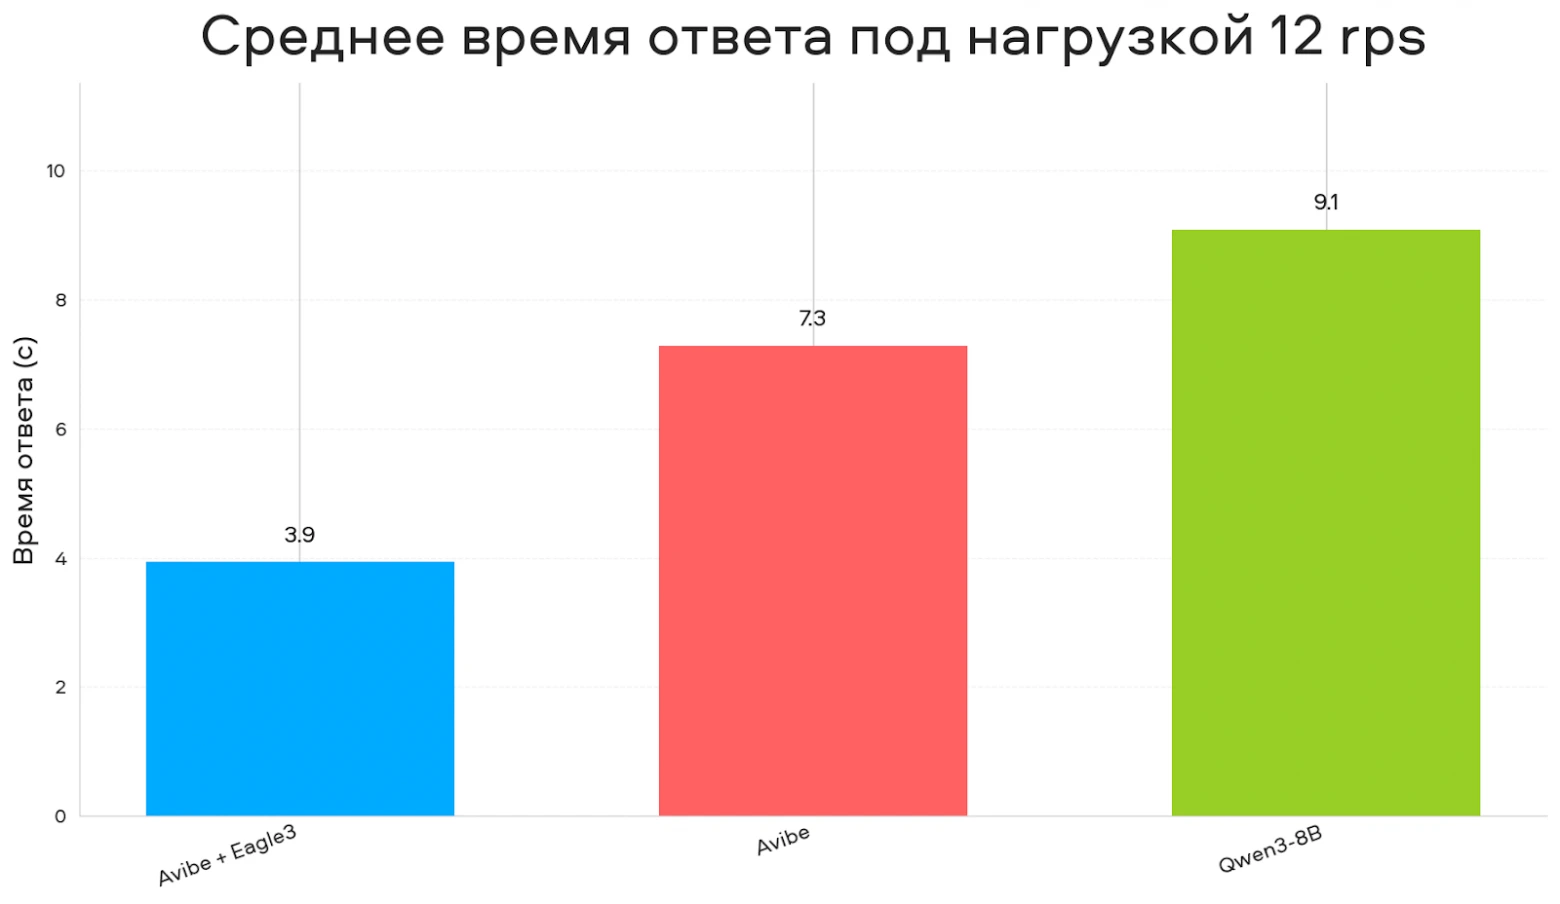
Задержка модели при разной нагрузке.
Источник: Иллюстрация из оригинала