Как кандидат выбирает важные события из истории слушателя
Один общий вектор пользователя не одинаково хорошо описывает его интерес к каждому треку. Полная совместная обработка истории с тысячами кандидатов слишком дорога. Кандидаты обращаются к уже рассчитанным состояниям истории через один слой cross-attention.
Видео · на русском
Ранжирование в реалтайме: target-aware-архитектура Яндекс Музыки / Пётр ЗайдельПётр Зайдель · Опубликовано: 23 октября 2025 г.
Исходный доклад · Открыть оригинал
Где находится тяжёлая модель
В описанной «Моей волне» из каталога примерно в 100 млн треков набирают 10 тысяч кандидатов. Лёгкий CatBoost оставляет 3 тысячи, тяжёлый ранжирует их с богатым набором признаков. Затем выбирают пять треков с учётом правил, например ограничения повторов артиста.
Новая нейросеть поставляет признаки финальному ранжировщику, сохраняя остальную схему. Это позволяет внедрять тяжёлую модель без замены всего рекомендательного процесса.
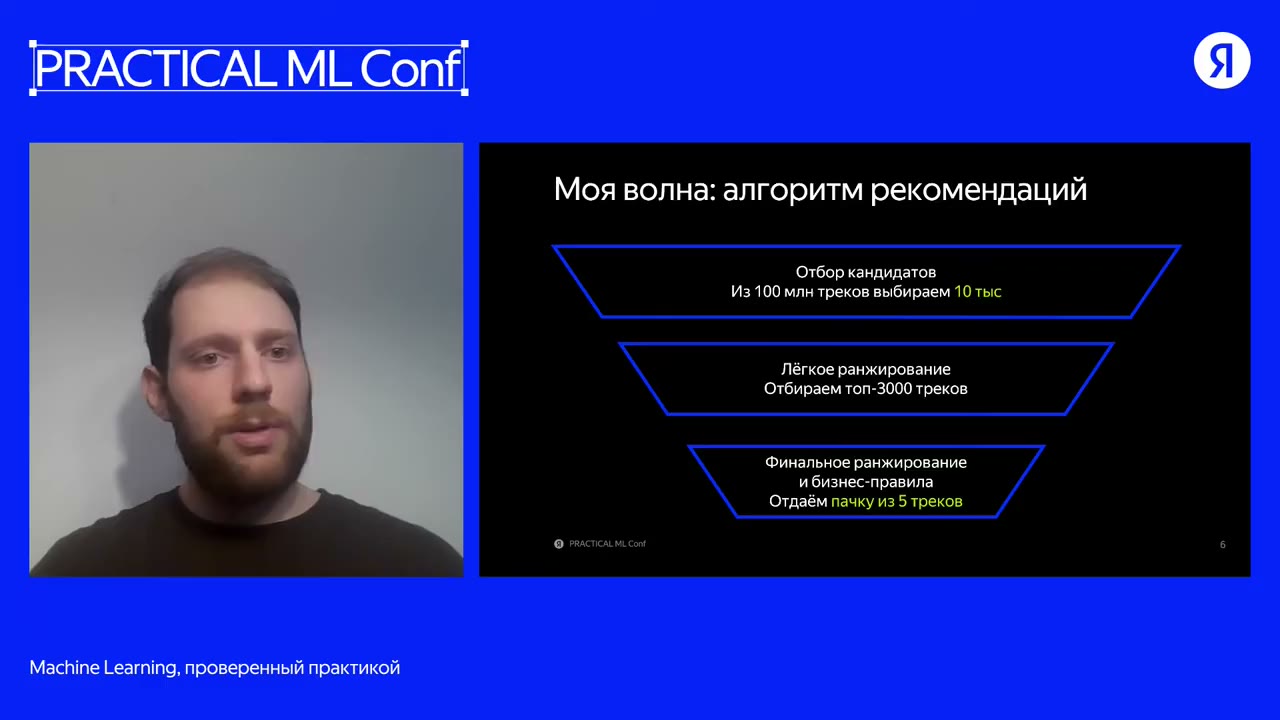
Отбор и ранжирование треков в Моей волне.
Источник: Кадр из докладаARGUS учит не только следующий трек
Предобучение предсказывает следующий объект истории и реакцию слушателя, включая лайк и долю прослушивания. Контекст помогает различать собственный выбор и рекомендации. Каузальная маска позволяет получить состояния для многих моментов истории за один проход.
Двухбашенная версия удобна: векторы треков и пользователей можно считать отдельно. Но суточное обновление пользователя отстаёт от сессии, а единый вектор ограничивает взаимодействие с конкретным кандидатом.
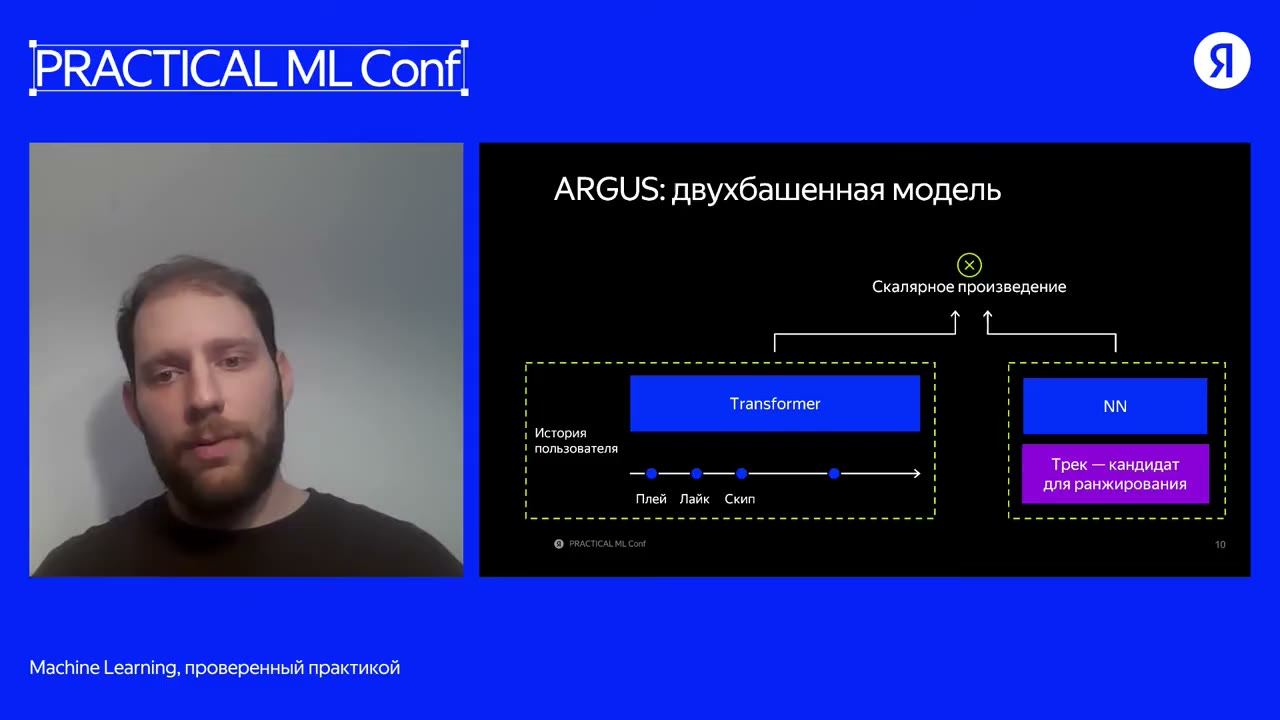
Двухбашенная модель ARGUS.
Источник: Кадр из докладаУпрощённое раннее взаимодействие
Историю пропускают через трансформер один раз. Затем каждый кандидат использует cross-attention: его вектор задаёт запрос, а состояния прошлых событий служат ключами и значениями. Так разные треки выделяют разные части одной истории.
Вместо повторного полного трансформера для каждого кандидата добавляется один слой внимания. На выходе сервис возвращает уже оценки кандидатов, а не только общий вектор пользователя.
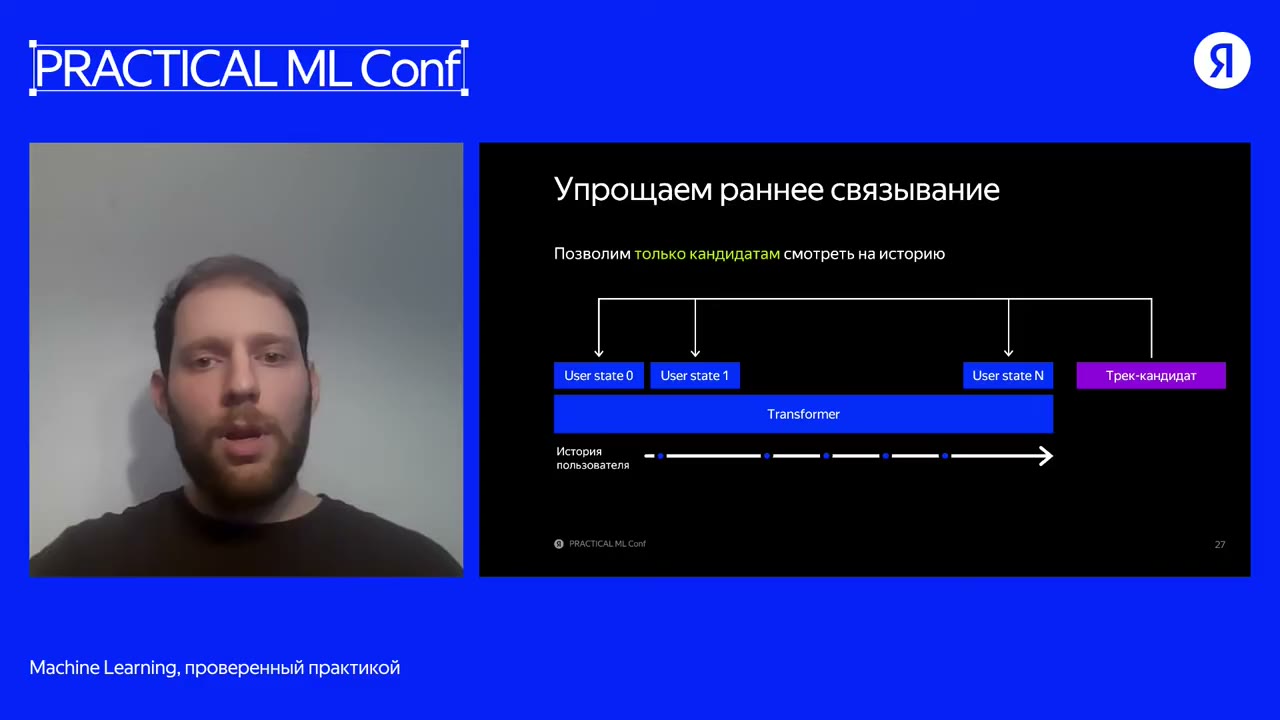
Упрощение раннего взаимодействия кандидата и истории.
Источник: Кадр из докладаОдинаковая подготовка данных в обучении и применении
CPU-сервис получает актуальную историю, добавляет необходимые признаки и готовит тензоры. Отдельный GPU-сервис объединяет запросы в пакеты и выполняет модель. Код подготовки истории переиспользуется при обучении, чтобы входы не расходились.
По докладу добавление cross-attention увеличило время вычисления модели примерно на 10%. При размере пакета 32 вычисление на GPU занимало около 28 мс, весь процесс с историей и передачей данных — около 75 мс; называлась нагрузка примерно 1000 запросов в секунду на GPU. Эти величины описывают конкретную конфигурацию.
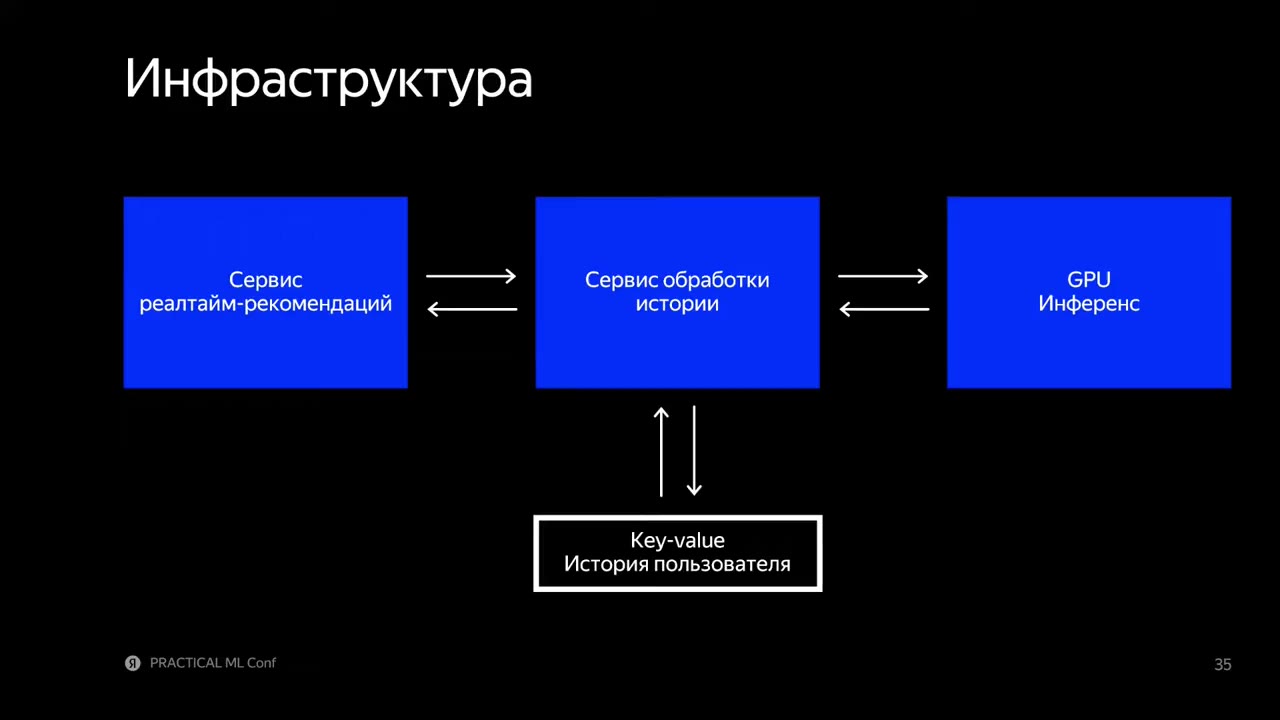
Инфраструктура применения модели.
Источник: Кадр из доклада