Разбор готов
Alice AI T5-35B-0.6A: как Яндекс улучшал быстрые ответы на Поиске
Алиса на Поиске должна за несколько секунд дать содержательный ответ, даже когда вопрос непростой и пользователь ожидает качества большой чатовой модели. При массовой нагрузке нельзя решить эту задачу только увеличением модели и времени генерации. Команда Яндекса одновременно меняла архитектуру, обучение и подготовку найденных документов. Так появилась Alice AI T5-35B-0.6A — модель с отдельными частями для чтения контекста и составления ответа, в которых используются разреженные экспертные слои. Разберём путь команды: почему небольшая T5 оказалась конкурентоспособной на поисковой задаче, как поведение пользователей превратилось в обучающий сигнал и почему более качественные ответы неожиданно замедлили систему настолько, что выпуск оказался под угрозой.
Материал полезен ML-инженерам, которые создают ответы с опорой на найденные документы, дообучают языковые модели или отвечают за их производительность. На конкретном продукте видно, чем различаются результаты бенчмарков, предпочтения при сравнении ответов и поведение реальных пользователей — и почему улучшать эти показатели приходится совместно.
Видео · на русском
Alice AI Search: быстрые ответы Алисы на ПоискеАртур Петросян · Опубликовано: 19 сентября 2026 г.
Исходный доклад · Открыть оригинал
Исходная модель: отдельно прочитать документы и составить ответ
На момент доклада генеративный ответ Алисы появлялся почти на каждом втором поисковом запросе — там, где такой ответ был необходим. Докладчик характеризует его как самый массовый генеративный продукт Яндекса. При этом пользователь ждёт не только быстрого появления первых слов, но и полного развёрнутого ответа за единицы секунд. У больших чатовых моделей может быть существенно больше времени и вычислительных ресурсов на тот же вопрос.
В 2025 году в продукте работала T5 2B: около 1 млрд параметров приходилось на энкодер и ещё 1 млрд — на декодер. Параметры — это числовые величины, которые модель настраивает при обучении. Энкодер преобразует входной текст в представления, удобные для дальнейшей обработки, а декодер последовательно составляет ответ. Такое разделение называют архитектурой «энкодер–декодер».
Текст поступает в модель в виде токенов — единиц, на которые его разбивает токенизатор. Энкодер обрабатывает предоставленный контекст целиком. Механизм внимания связывает разные позиции текста, причём в энкодере эти связи двунаправленные: начало документа может учитываться вместе с его концом и наоборот.
Декодер обращается к подготовленным представлениям через перекрёстное внимание, или cross-attention. Получается разделение работы: сначала обработать документы, затем использовать результат при генерации. В архитектуре только с декодером, или decoder-only, отдельной части для такого чтения нет. Именно между этими вариантами команда выбирала фундамент будущей модели, а не просто между большим и маленьким числом параметров.
Основа главы — доклад Артура Петросяна «Alice AI Search: быстрые ответы Алисы на Поиске» на Practical ML Conf 2026. Все дальнейшие результаты относятся к описанным в нём моделям, экспериментам и условиям поискового продукта.
Доклад · 00:02:02Почему общие тесты не определили победителя
Выбор архитектуры начинается с предварительного обучения: модель осваивает закономерности большого корпуса текстов, прежде чем её настраивают под поисковые ответы. Но оценить качество такого фундамента можно по-разному. Команда рассматривала два пути, и ни один не давал готового ответа без дополнительных проверок.
Таблицу можно прокрутить по горизонтали.
Последнее ограничение особенно важно при выборе архитектуры. Если пробная модель обучена на 1 трлн токенов, трудно надёжно предсказать, что изменится после обучения на 15 или 30 трлн. В докладе эти объёмы приведены как пример проблемы переноса выводов, а не как объявленный объём обучения итоговой Alice AI T5-35B-0.6A.
Первое неожиданное наблюдение команда получила при сравнении YandexGPT 5 Lite — декодерной модели на 8 млрд параметров — и T5 2B. Более крупная модель заметно выигрывала на MMLU, наборе вопросов по разным областям знаний, и на внутреннем фактологическом тесте Ru Culture. Но на извлечении информации из длинного контекста преимущество меняло сторону.
Таблицу можно прокрутить по горизонтали.
После настройки под поисковые ответы модели оказались примерно равны в парном сравнении, хотя T5 2B работала быстрее. Такое сравнение называют side-by-side, или SbS: сопоставляют ответы двух систем на один запрос. Доля побед, или winrate, показывает, как часто предпочли одну из них. Это не доля фактически правильных ответов и не процент успешных пользовательских сессий.
Однако сравнение готовых YandexGPT и T5 ещё не отделяло влияние архитектуры от влияния данных. Поэтому команда обучила небольшую модель с энкодером и декодером и небольшую модель только с декодером на объёме 1 трлн токенов. На поисковой задаче T5 получила 65% winrate. Этот эксперимент стал основанием не отказываться от энкодера–декодера только потому, что более крупные декодерные модели лучше выглядели на общих тестах.
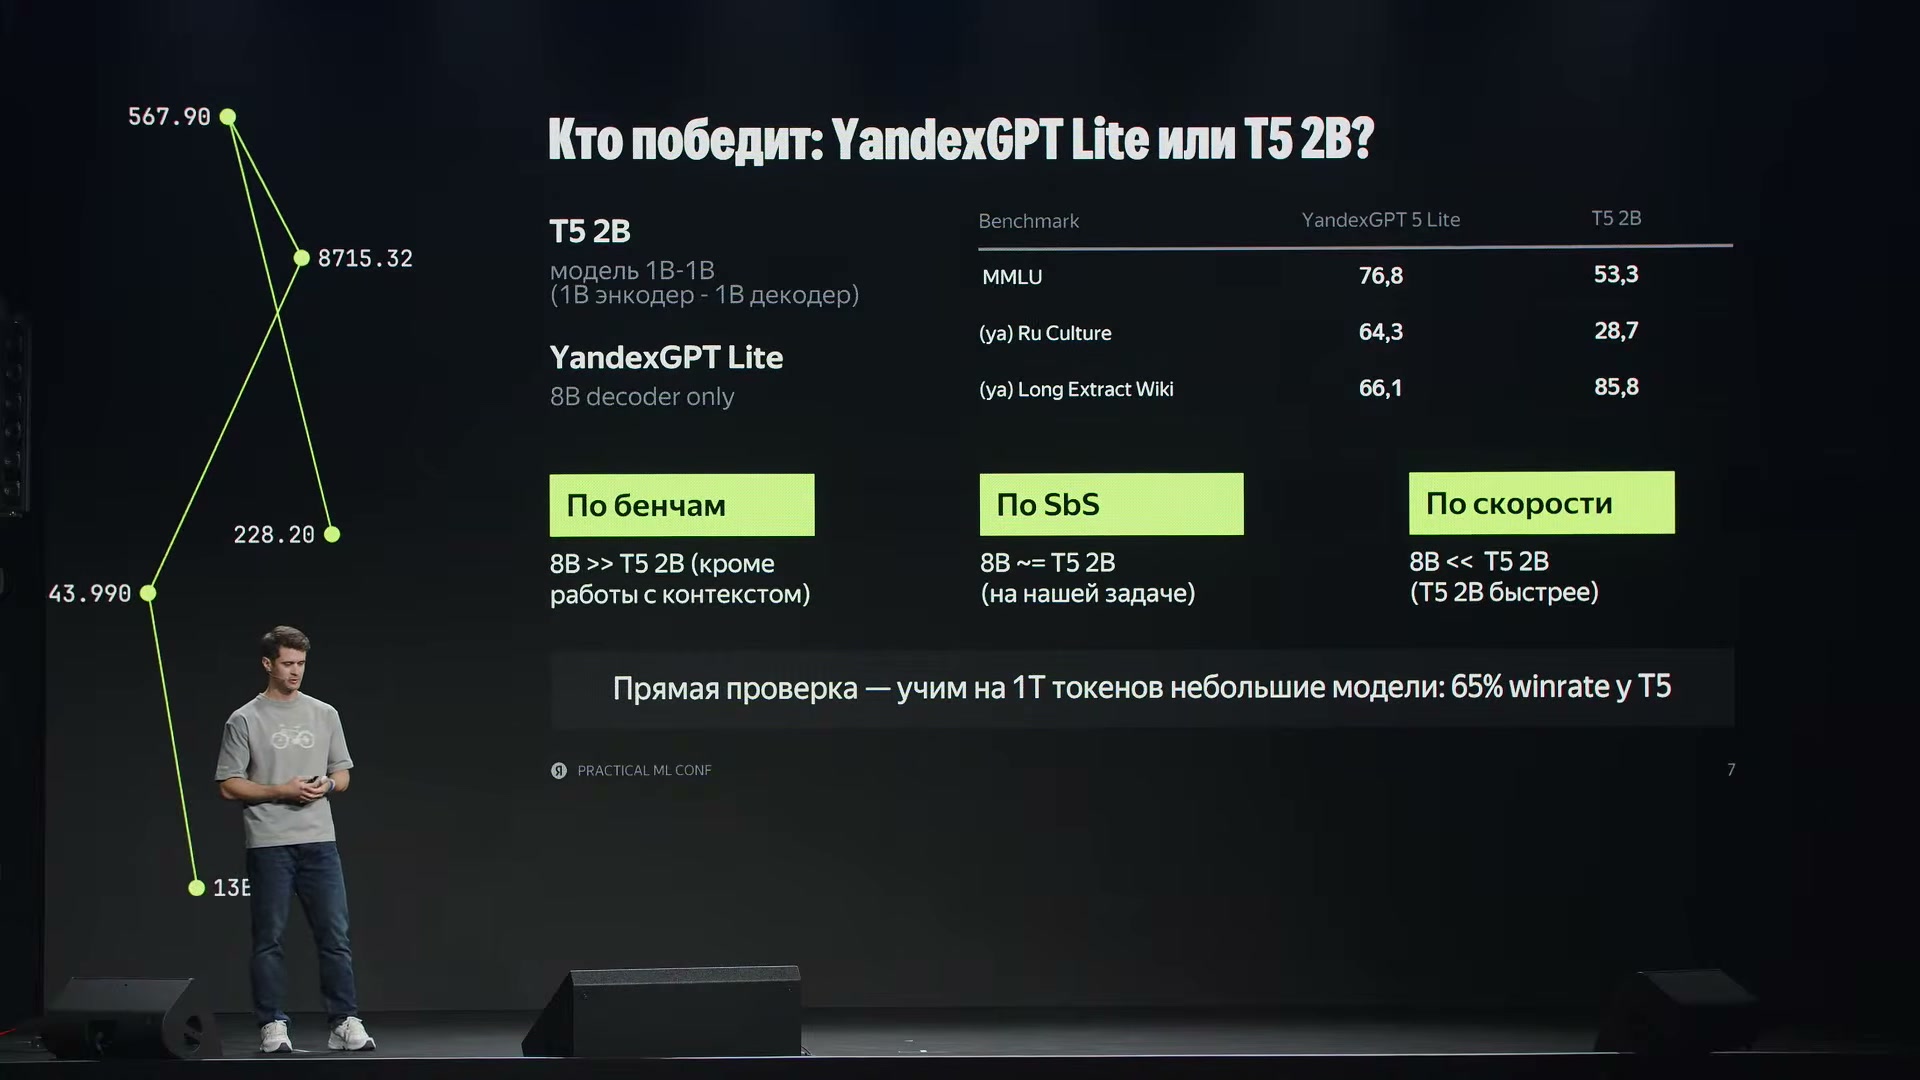
YandexGPT 5 Lite сильнее на MMLU и Ru Culture, но T5 2B выигрывает на Long Extract Wiki. После настройки под поиск ответы близки по качеству, а T5 быстрее.
Источник: Артур ПетросянЧто помогает энкодеру–декодеру работать с контекстом
Результат на поисковых ответах не означает, что энкодер–декодер лучше для любой языковой задачи. В докладе предложены несколько возможных объяснений того, почему такое устройство оказалось удачным именно при работе с предоставленными документами.
Первое объяснение связано с задачей предварительного обучения. На слайде указан UL2: вместо одного только предсказания следующего токена модель учится восстанавливать скрытые или искажённые части текста. В устном объяснении речь идёт в том числе о нескольких соседних токенах. Чтобы восстановить такой фрагмент, приходится использовать окружающий контекст, а не только продолжать уже прочитанную последовательность.
Второе объяснение — двунаправленное внимание энкодера. Правило, определяющее доступные связи между позициями, называют маской внимания. В энкодере каждая позиция может учитывать весь входной документ. В обычном декодере представление раннего токена не использует последующие позиции. Поэтому одинаковый текст проходит через разные условия обработки ещё до появления ответа.
Третье объяснение касается перекрёстного внимания. Энкодер сначала перерабатывает вход, после чего декодер обращается к этим представлениям на своих слоях. Во время генерации у него есть доступ не просто к исходной последовательности, а к информации, уже обработанной с учётом всего контекста.
Наконец, у энкодера и декодера раздельные параметры. Докладчик предлагает удобную интерпретацию: одна часть специализируется на понимании, другая — на генерации. При этом он не представляет такое разделение ролей как доказанную причину выигрыша. Это объяснение результата, а не отдельный эксперимент, изолировавший влияние каждого фактора.
Дополнительным ориентиром служат показанные в докладе графики T5Gemma из работы Google 2025 года. Горизонтальная ось отражает вычислительную стоимость применения модели — Inference Flops, количество операций с плавающей точкой. Верхний график показывает PT Score до настройки поведения, нижний — IT Score после неё. В этих сравнениях энкодер–декодер часто даёт лучшее соотношение качества и вычислений. Но это другой эксперимент: его нельзя подменять собственным SbS Яндекса или читать горизонтальную ось как задержку в миллисекундах.
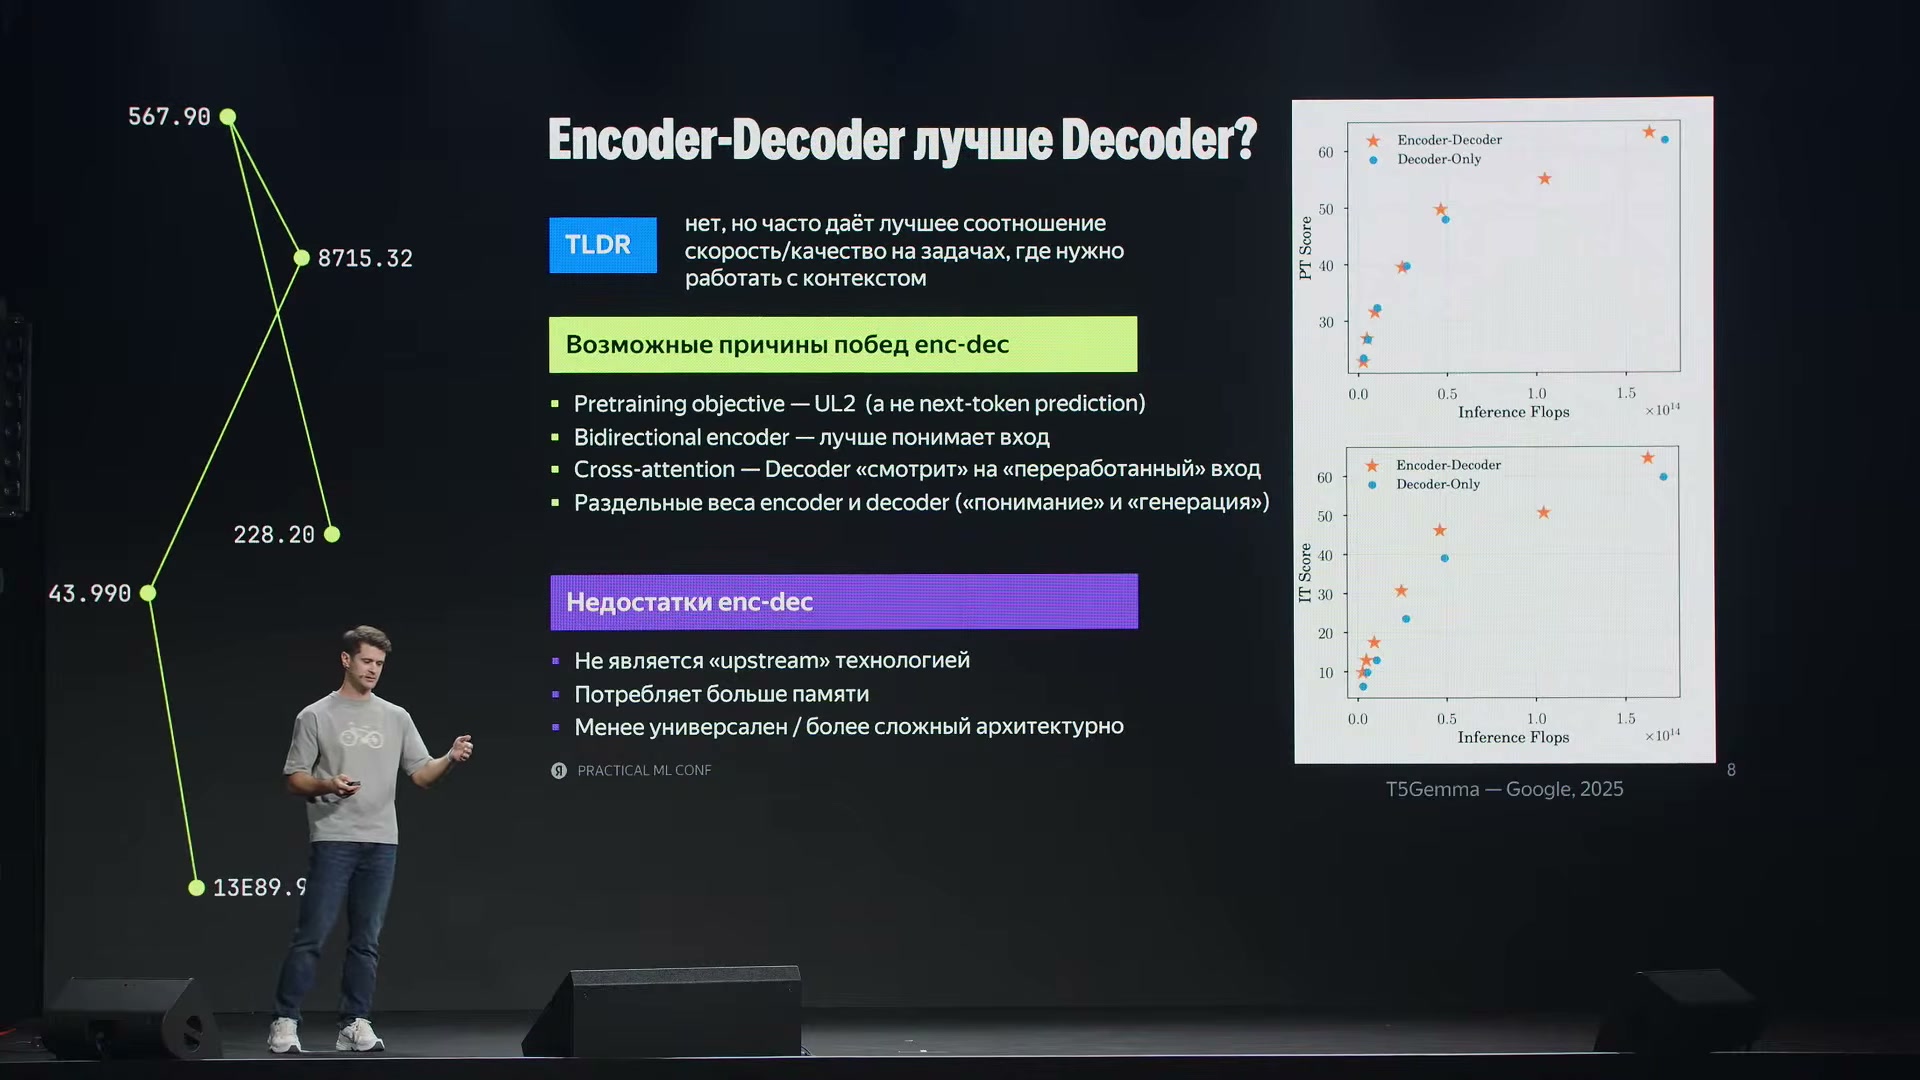
Возможные преимущества энкодера–декодера: UL2, двунаправленное чтение, перекрёстное внимание и раздельные параметры. Графики T5Gemma показывают качество относительно вычислительной стоимости, а не задержки.
Источник: Артур ПетросянПопытка сохранить обычный декодер и цена альтернативной архитектуры
У сохранения T5 были серьёзные издержки. По опыту команды, энкодер–декодер потреблял больше памяти, был менее универсален и требовал более сложной поддержки обучения и применения модели. Основной поток новых открытых решений развивался вокруг декодерных архитектур. Оставаться на T5 означало сознательно брать на себя дополнительную инженерную работу.
Команда проверила, нельзя ли получить нужные свойства внутри обычного декодера с помощью PrefixLM. В этом варианте входной части разрешают двунаправленное внимание, а ответ по-прежнему генерируется последовательно. Это перенос одного из преимуществ энкодера в модель без отдельной части для чтения.
Публикации по-разному оценивали эффект такого изменения, поэтому его воспроизвели на своей задаче. Двунаправленная маска помогла, но полностью разрыв не закрыла.
После этого команда решила сохранить T5 и использовать дополнительную возможность её настройки: энкодер и декодер не обязаны быть одинаковыми. Можно распределить между ними возможности модели под конкретную задачу и профиль нагрузки.
Вывод оставался локальным. Для других сценариев обычный декодер мог быть не хуже и заметно проще в реализации. Например, перенос нового способа внимания в энкодер–декодер требует отдельно решить, что делать с двунаправленным чтением входа. В докладе в качестве такого примера приведено линейное внимание — альтернативная организация работы с контекстом. Готовое улучшение для декодера не обязательно без изменений подходит обеим частям T5.
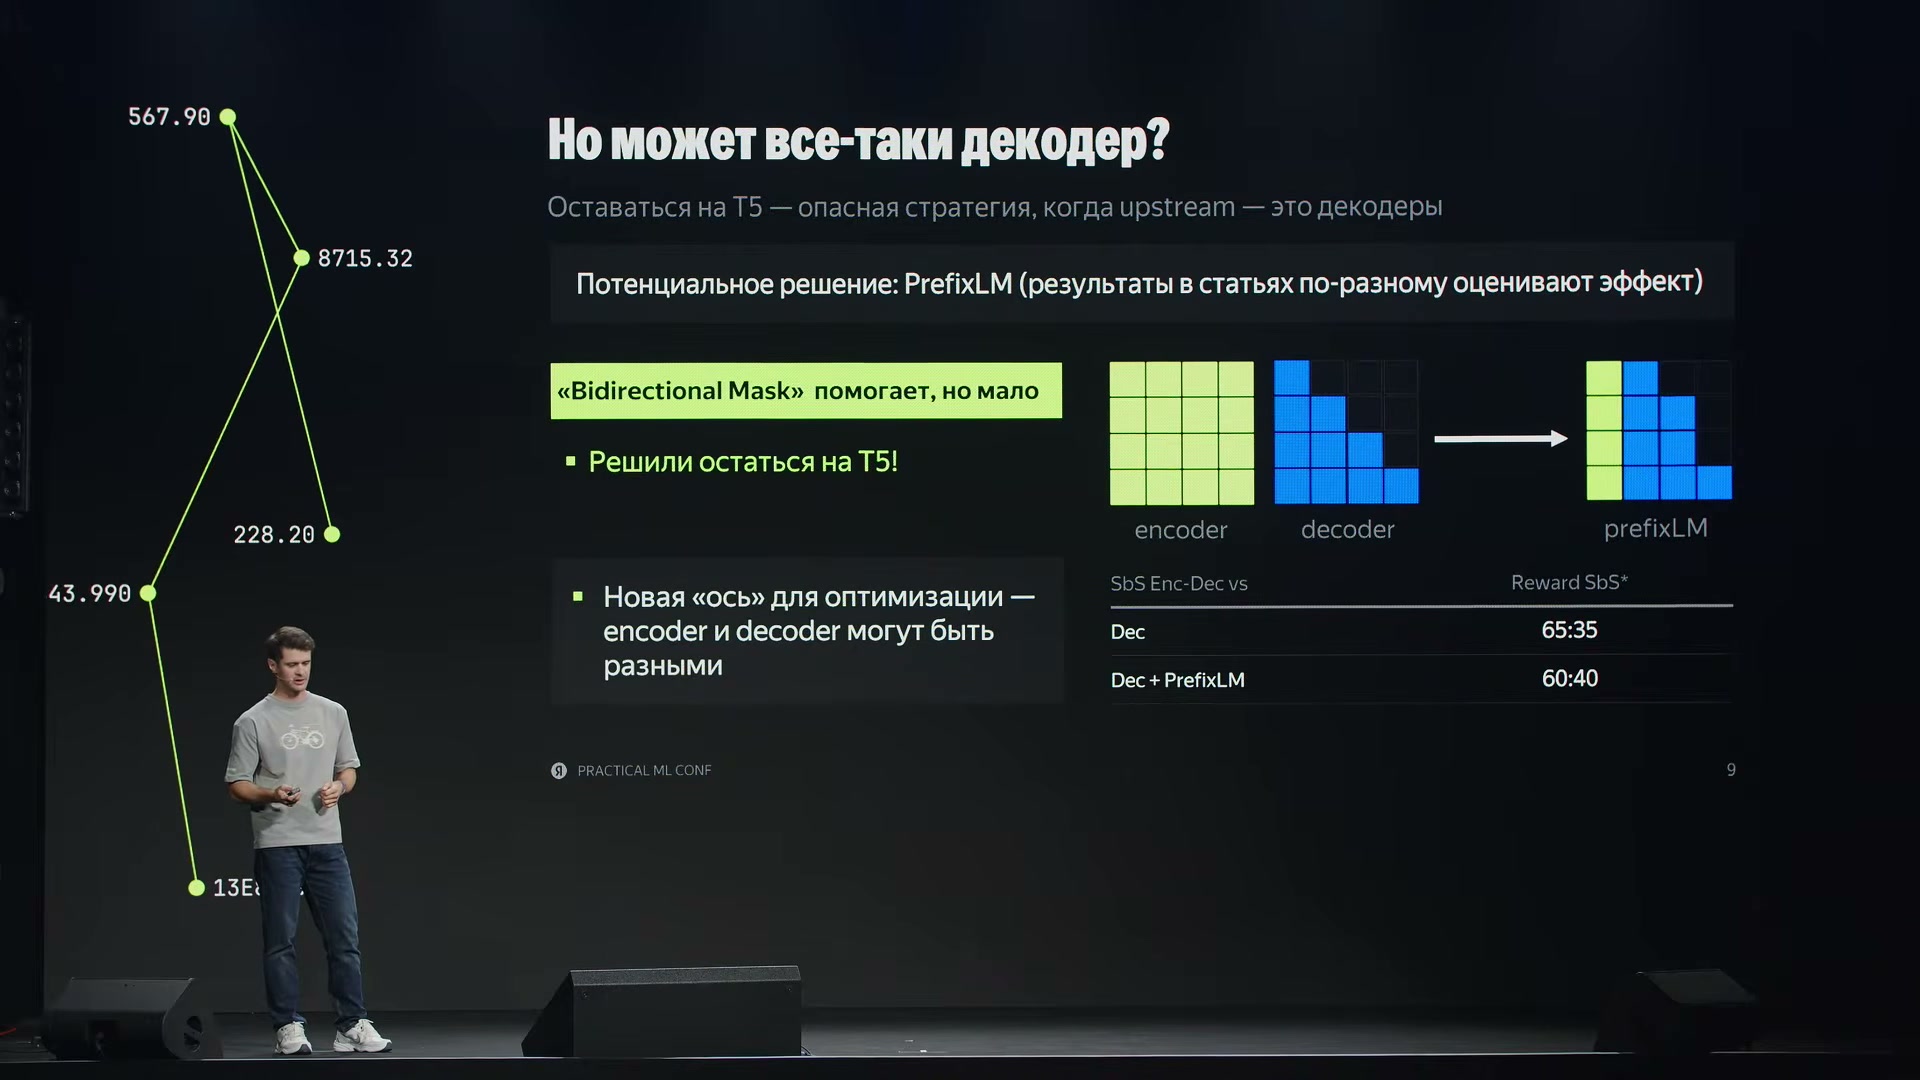
PrefixLM добавляет двунаправленное чтение входа декодеру, но только сокращает разрыв: 65:35 превращаются в 60:40 в пользу энкодера–декодера.
Источник: Артур ПетросянКак распределили возможности между чтением и генерацией
Следующий выбор касался размеров двух частей. Усилить обработку найденных документов и усилить самостоятельное составление ответа — не одно и то же. Архитектура с раздельными параметрами позволяет проверить эти варианты непосредственно.
На показанном графике T5Gemma сравниваются точность решения математических задач GSM8K и задержка в миллисекундах. Увеличение энкодера с 2B до 9B при декодере 2B улучшает качество без большого сдвига по задержке. Но в устной части докладчик подчёркивает условие: измерение выполнено при размере пакета из одного примера. При более крупных пакетах соотношение могло быть другим.
Команда провела собственное сравнение, меняя глубину частей. Слой — это последовательный этап преобразования представлений внутри модели. Вариант с 16 слоями энкодера и 8 слоями декодера сопоставили с обратным распределением: 8 и 16 слоёв.
Таблицу можно прокрутить по горизонтали.
Пропускная способность, или throughput, показывает объём выполненной работы за единицу времени. Её нельзя отождествлять с задержкой отдельного ответа. Поэтому 55:45 и +20% описывают два разных свойства одной архитектурной замены.
Окончательная конфигурация оказалась осторожнее выигравшего экспериментального варианта. Команда опасалась плохих ответов на творческих запросах и других задачах, где внешний контекст мало помогает. Поэтому декодер не стали уменьшать до 8 слоёв. Это было основание для выбора 16E:12D, а не показанное в докладе измеренное ухудшение творческого среза. Сам докладчик допускает, что осторожность могла оказаться излишней.
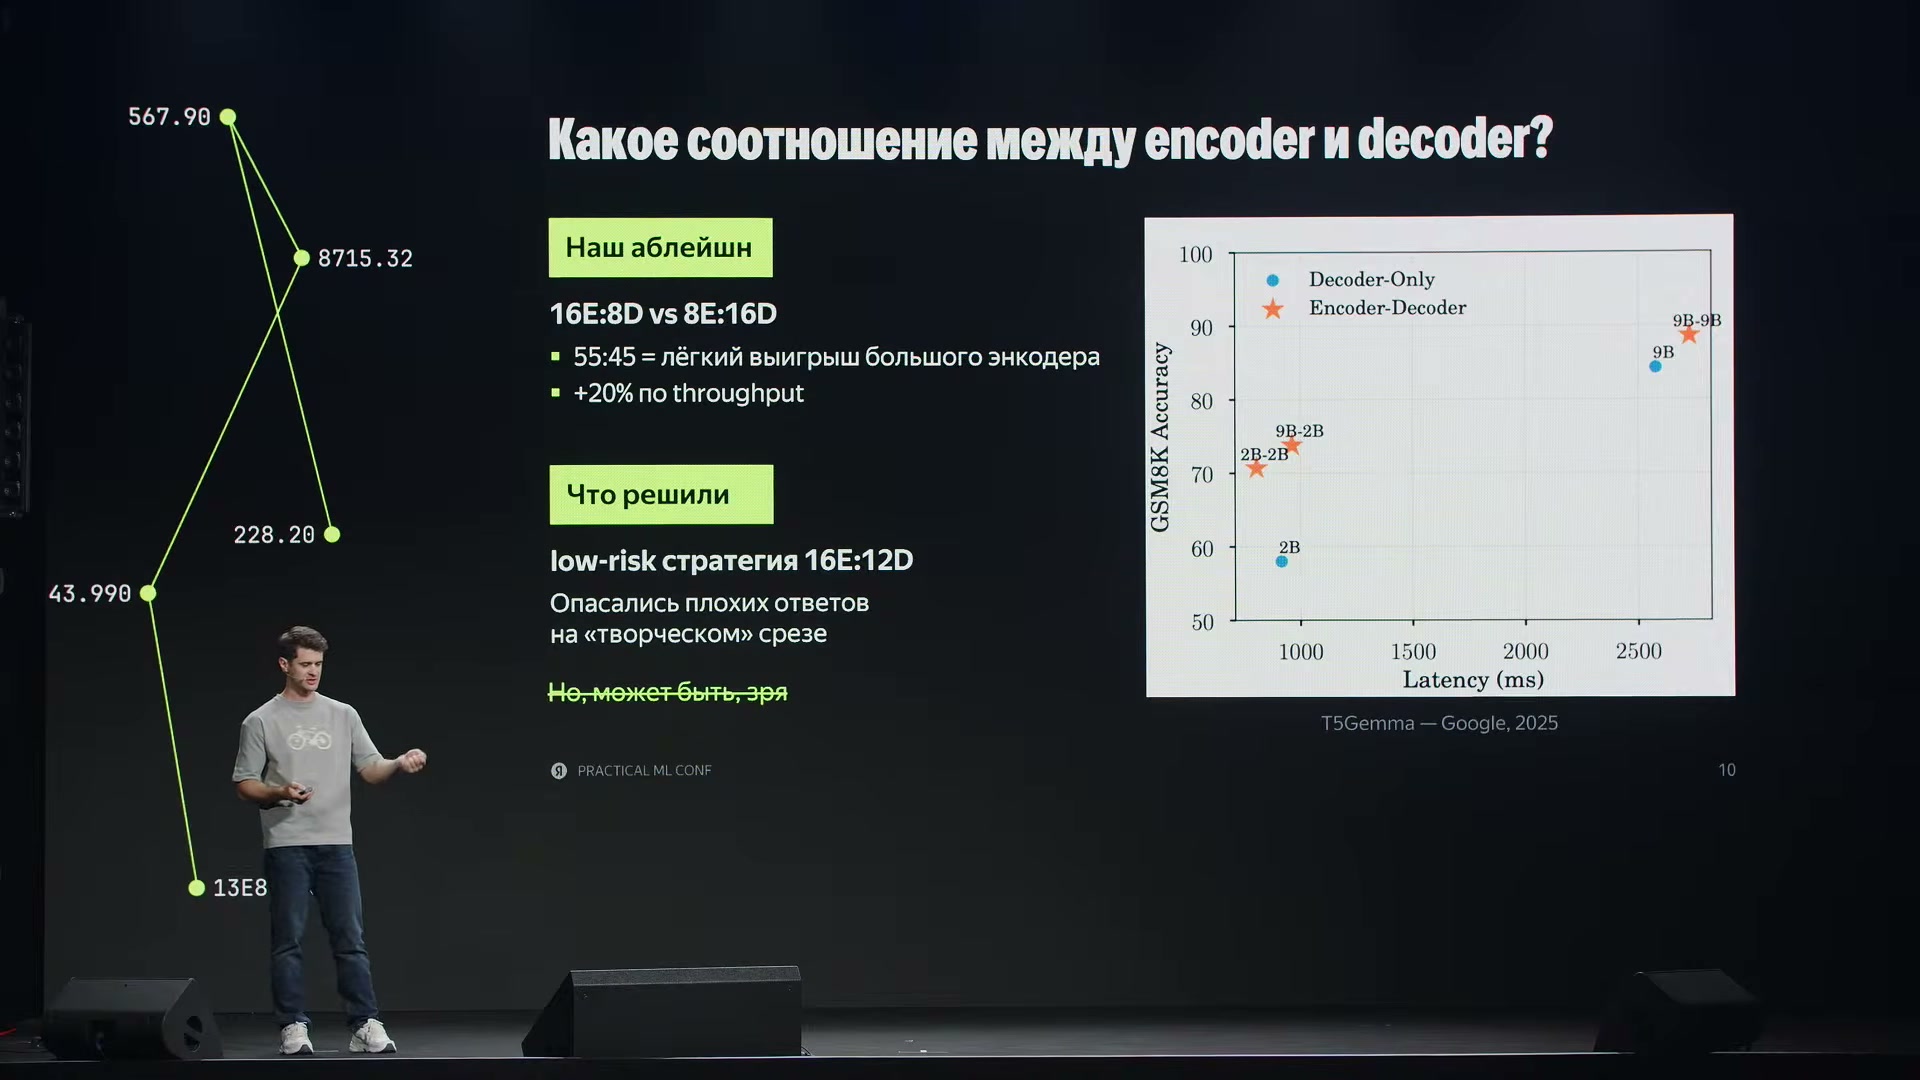
16E:8D выигрывает у 8E:16D со счётом 55:45 и даёт +20% throughput. В продукт выбрали более осторожные 16E:12D из-за опасений за творческие запросы.
Источник: Артур ПетросянЗачем понадобились эксперты и почему их число зависит от нагрузки
Далее команда добавила слои со смесью экспертов — Mixture of Experts, или MoE. В такой модели для конкретного токена выбирается только часть доступных экспертных блоков. Компонент, который делает выбор, называют маршрутизатором. Благодаря этому можно увеличивать общее число параметров, не заставляя каждый токен проходить через них все.
Поэтому нужно различать общие и активные параметры. Общие характеризуют всю модель, активные участвуют в обработке конкретного токена. Сначала команда ограничила активную часть исходя из допустимой стоимости генерации, а затем выбирала, насколько увеличить общую ёмкость и число экспертов. Современных открытых примеров сочетания MoE с энкодером–декодером было мало. По словам докладчика, доступные ориентиры крупных команд в основном относились к 2023 году, а один из новых аналогов появился примерно одновременно с их собственным выпуском.
В энкодере увеличение общего числа экспертов оказалось сравнительно удобным. Обработка входа до начала генерации, или prefill, на контекстах длиннее 10 тысяч токенов преимущественно ограничивалась вычислениями. При неизменной активной части дополнительные эксперты почти не ухудшали пропускную способность в проверенном режиме. Поэтому энкодер можно было сделать более ёмким, сохранив высокую разреженность — использование лишь небольшой доли экспертных параметров.
Для декодера компромисс был сложнее. Больше общих параметров давало более сильную модель, но увеличивало нагрузку на память. На верхнем графике сравнивается пропускная способность декодера при числе экспертов от 8 до 512. Вертикальная ось нормирована на вариант с 8 экспертами; отдельные линии соответствуют 1, 16, 64 и 256 одновременно обрабатываемым запросам. Это уровень параллельной нагрузки, а не число экспертов и не автоматически равный ему размер пакета.
При одном одновременно обрабатываемом запросе увеличение числа экспертов давало небольшую потерю. Остальные кривые показывали другую чувствительность к памяти. На собственном потоке команда оценивала восьмикратное увеличение параметров примерно в 20% потери throughput; в устной части это обсуждается через переход от 64 к 512 экспертам. Такой обмен скорости на возможности модели сочли приемлемым.
В пользу решения были ещё два соображения. По оценке команды, рост общей ёмкости мало влиял на стоимость обучения при выбранной активной части. Кроме того, оставался запасной вариант — удалить часть параметров, то есть выполнить прунинг. В докладе это возможность на крайний случай, а не уже проведённый этап. Нижний график поддерживает мотив увеличения ёмкости: ошибка предварительного обучения уменьшается с ростом общего числа параметров.
В итоге и для энкодера, и для декодера выбрали высокую разреженность; на слайде решение записано как 1/64 sparsity, с ориентиром на DeepSeek V4 Pro. Это характеристика использования экспертной части, а не готовое описание всей модели. Главная причина выбора — подходящий для команды профиль нагрузки. При других условиях выгодное соотношение общей ёмкости и активных вычислений могло бы отличаться.
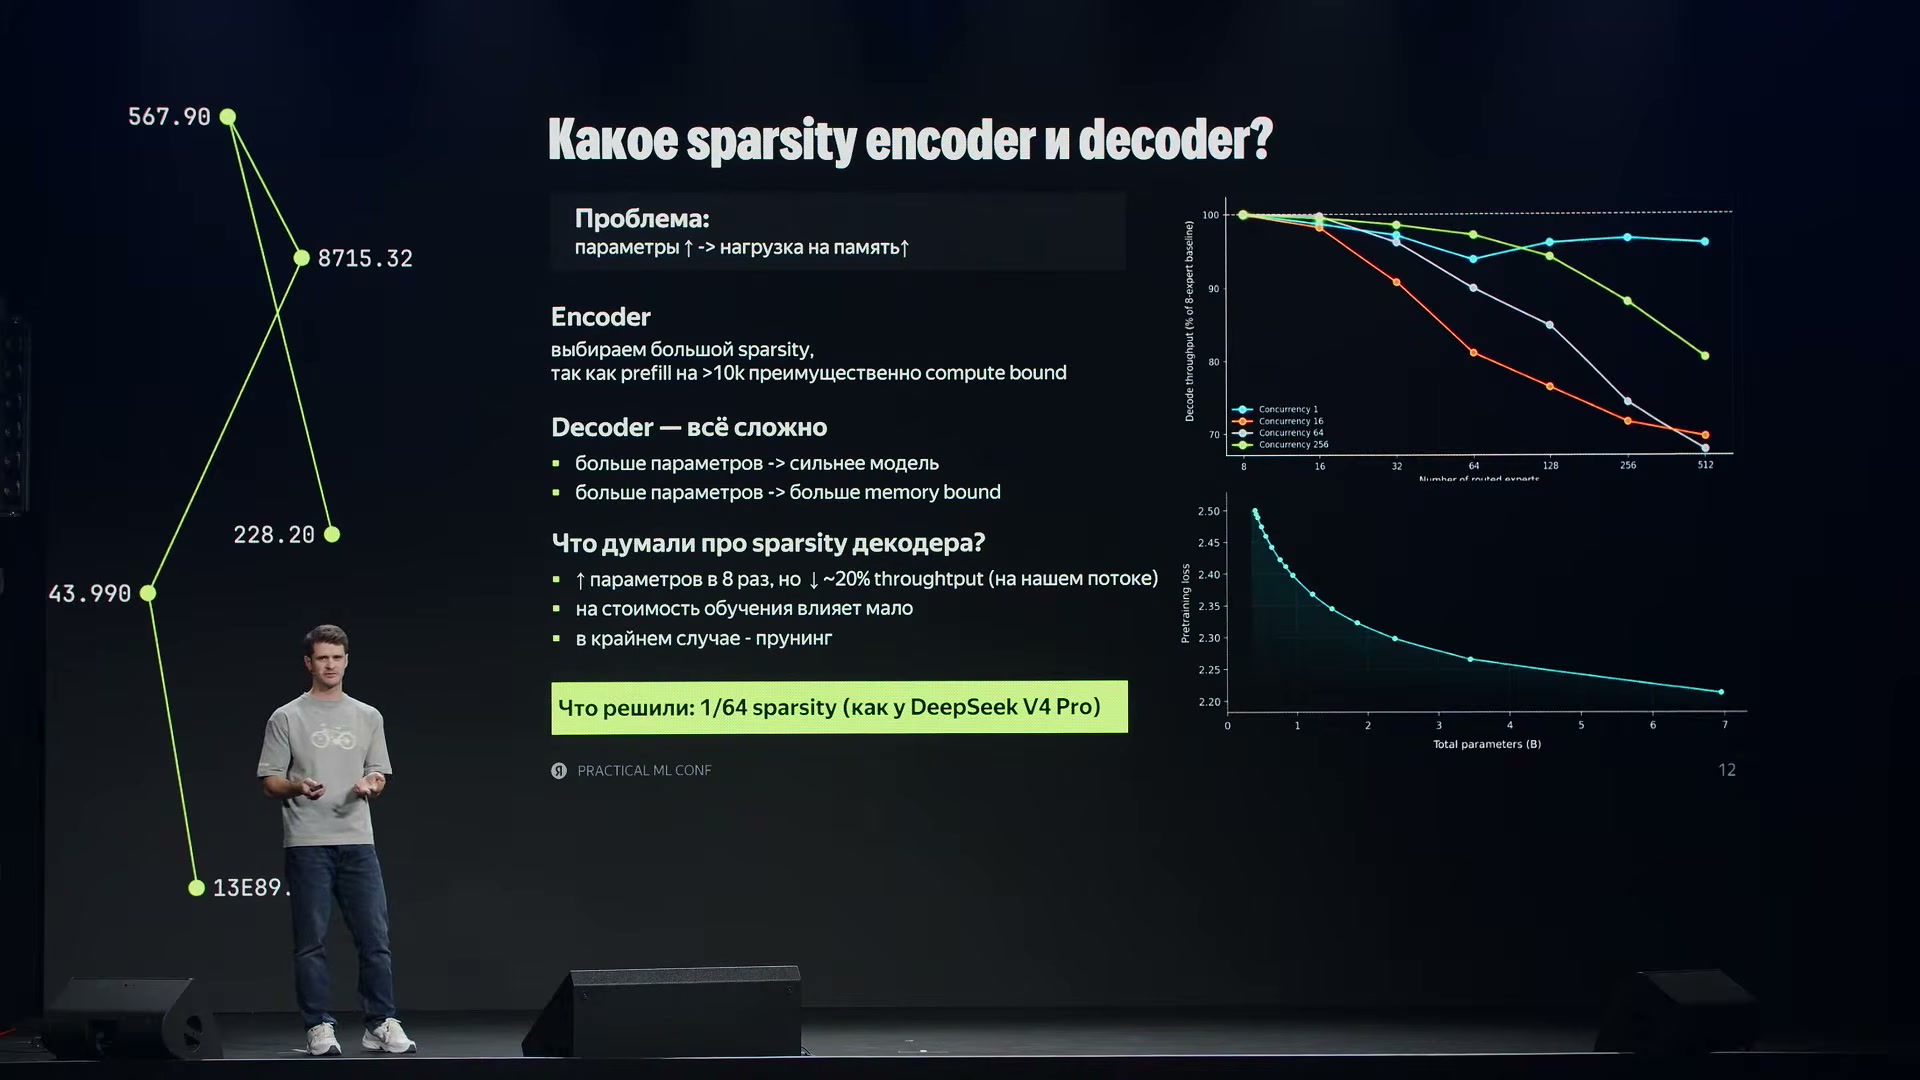
Цена дополнительных экспертов зависит от режима работы: энкодер и декодер ограничены разными ресурсами. Для своей нагрузки команда выбрала разреженность 1/64.
Источник: Артур ПетросянПредварительное обучение остановилось на маршрутизаторе
После успешной проверки на 1 трлн токенов команда запустила большое предварительное обучение. Выделенных ресурсов хватало примерно на один такой запуск. Однако после четверти обучения маршрутизатор энкодера потерял устойчивость. На графике это видно как резкий всплеск ошибки у варианта Qwen-like routing.
В исходной схеме неравномерное использование экспертов штрафовалось внутри функции потерь — величины, которую обучение старается уменьшить. Такой дополнительный штраф называют auxiliary loss. Он меняет градиенты, то есть сигналы, по которым обновляются параметры модели. Именно с этой схемой команда столкнулась с коллапсом маршрутизации.
Таблицу можно прокрутить по горизонтали.
В первой записи L_task — потеря основной задачи, а λ определяет вес добавленного члена балансировки. Во второй TopK означает выбор K наибольших скорректированных оценок: к оценке эксперта добавляется поправка b_i, которая изменяется с шагом γ. Для понимания различия важнее место вмешательства: штраф внутри обучающей цели или поправки при выборе экспертов. Полные определения и нормировки величин f_i и P_i в докладе не раскрываются.
Команда перешла на балансировку без такого вспомогательного штрафа — aux-free routing из DeepSeek-V3. После замены T5 MoE удалось обучить. На графике линия Deepseek-like routing продолжает снижаться без всплеска, который остановил исходный вариант. Полученную модель Alice AI T5-35B-0.6A команда открыла для внешнего использования.
В ответах на вопросы докладчик подтвердил, что сбой возник именно при предварительном обучении. Другие способы исправления — изменение активаций, то есть внутренних преобразований модели, или дополнительный штраф на их значения — обсуждались, но не были проверены из-за нехватки времени. Переход к DeepSeek-V3 поэтому не доказывает невозможность починить исходную схему.
Сведения об инфраструктуре раскрыты частично. При обучении модель распределялась между несколькими графическими ускорителями, а не размещалась целиком на одном. Число ускорителей и конкретная схема распределения не названы. Обучение в FP8 докладчик прямо отрицает. Эти ограничения не меняют сам результат, но не позволяют восстановить полный рецепт большого запуска.
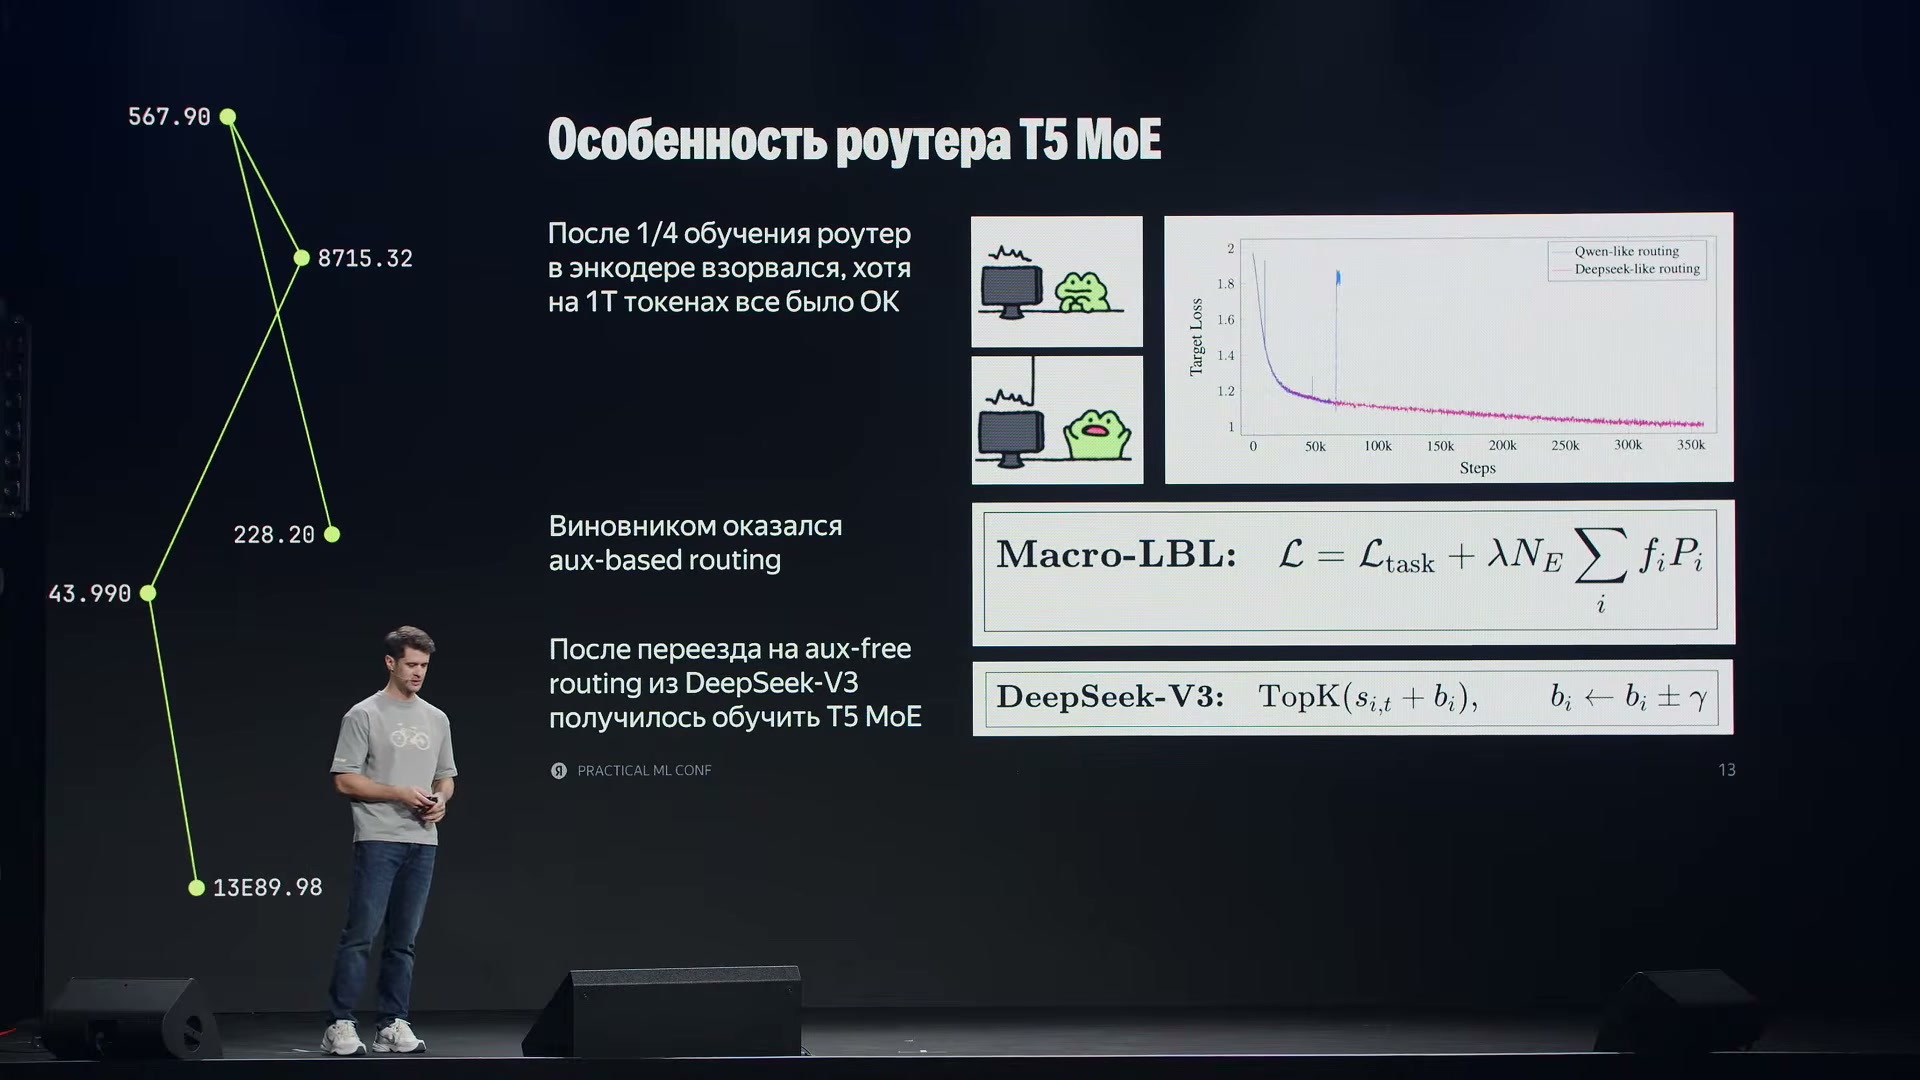
Маршрутизатор энкодера потерял устойчивость после четверти обучения. Переход от дополнительного штрафа к aux-free routing из DeepSeek-V3 позволил завершить обучение T5 MoE.
Источник: Артур ПетросянЧто получилось на бенчмарках и на поисковых ответах
Сначала команда сопоставила среднее качество на открытых бенчмарках с производительностью. На графике горизонтальная ось — Output Throughput, количество выходных токенов в секунду; вертикальная — Average benchmark score, средняя оценка в процентах. В это усреднение не включались внутренние тесты.
Alice AI T5-35B-0.6A оказалась немного медленнее Qwen 3.5 2B, но заметно быстрее Qwen 3.5 4B при близком среднем качестве. Qwen 3.5 35B-A3B давала более высокое среднее качество, но меньшую пропускную способность. На том же графике показаны Gemma 4 E4B и T5 Gemma 2 4B-4B. Их наличие важно для состава сравнения, но координаты точек не заменяют подробный разбор отдельных задач.
Такой разбор меняет картину. Модель команды особенно сильна на русскоязычных фактах, но не лидирует на каждой группе. Общие экзаменационные задачи представлены сочетанием MMLU, MMLU-Pro и GPQA; отдельными строками идут факты, математика с кодом и извлечение сведений из длинного контекста.
Таблицу можно прокрутить по горизонтали.
На русских фактах AliceAI получает 74,7 — выше всех трёх показанных Qwen. На TriviaQA её 60,5 располагаются между Qwen3.5-4B с 50,4 и Qwen3.5-35B-A3B с 71,4. На математике и коде результат почти совпадает с Qwen3.5-4B: 72,2 против 72,4. Для извлечения информации и длинного контекста снова получается промежуточная позиция: 72,2 против 67,7 и 75,2.
Сильные русскоязычные факты докладчик связывает с корпусом предварительного обучения, общую фактологическую ёмкость — с разреженной MoE, а работу с контекстом — с энкодером–декодером. Это предложенные объяснения. Сравнение готовых моделей само по себе не изолирует причинный вклад каждого из этих факторов.
Затем проверили главное: разные базовые модели настроили примерно одинаковым способом под поисковые ответы и сравнили попарно. Теперь измеряется не результат тестовых задач, а предпочтительность ответов после продуктового дообучения.
Результат поддержал выбранный компромисс: заметное преимущество над Qwen 3.5 2B и T5Gemma 2 4B-4B, близкое качество относительно Qwen 3.5 4B и отставание от более тяжёлой Qwen 3.5 35B3A. Это не победа над всеми моделями, а подходящее для продукта сочетание качества и скорости. Полный состав запросов, правила учёта ничьих и интервалы неопределённости SbS в докладе не приведены.
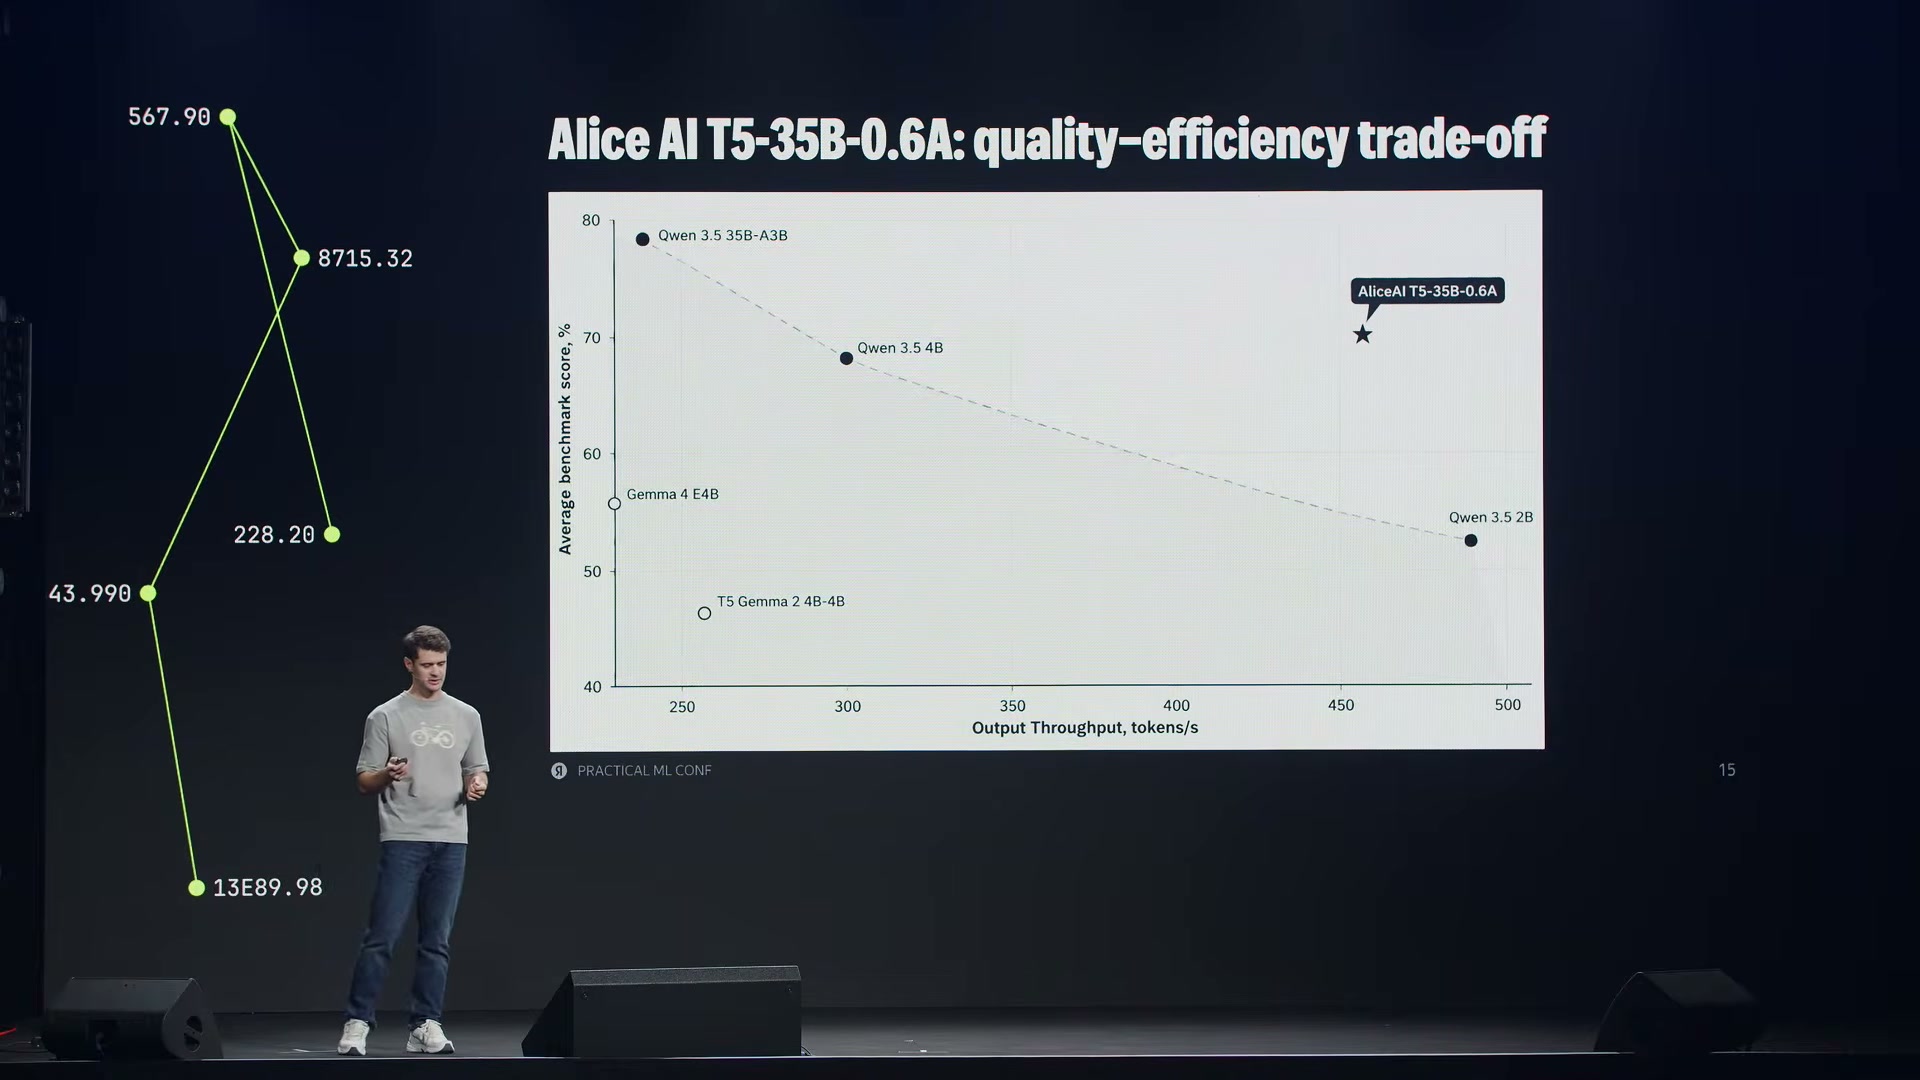
Alice AI T5-35B-0.6A сопоставляется с Qwen и Gemma по средней оценке открытых тестов и выходным токенам в секунду. Это сравнение качества и производительности, не пользовательский эксперимент.
Источник: Артур Петросян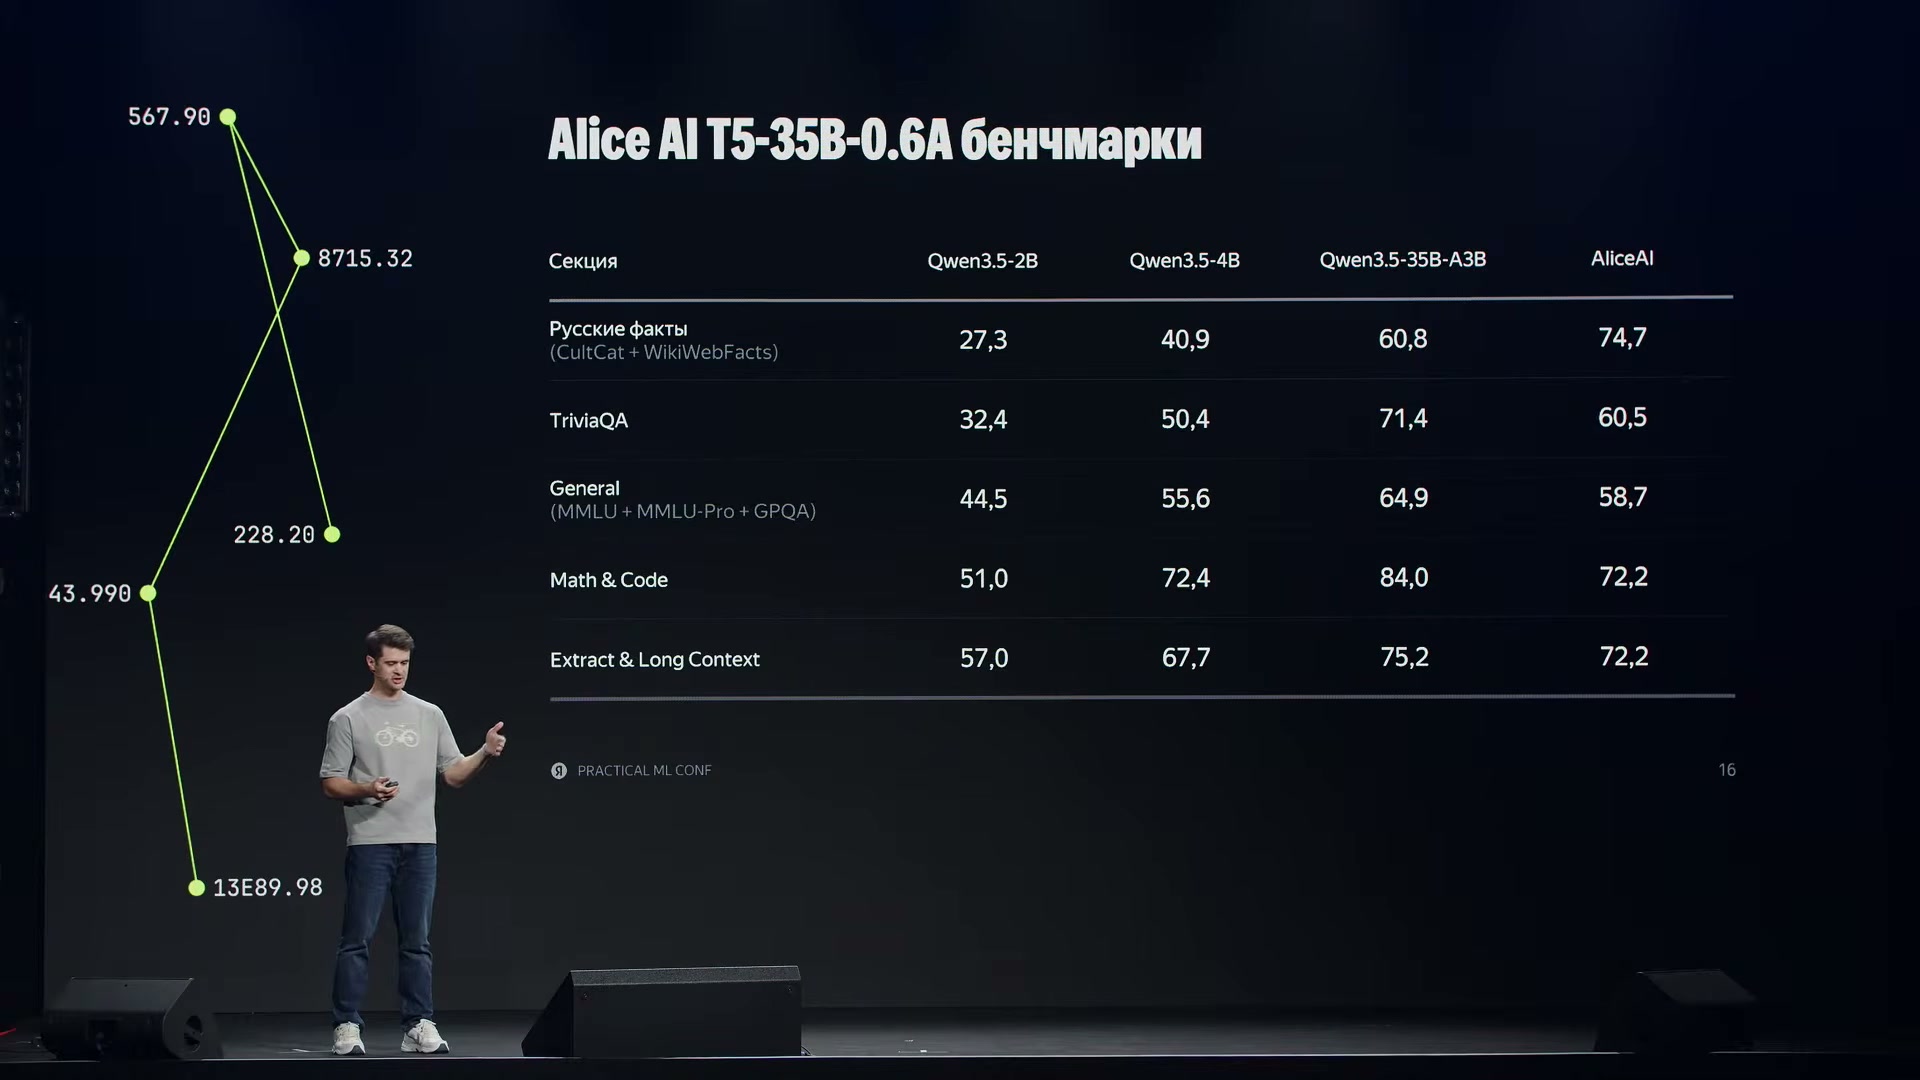
Полная таблица пяти групп задач: у AliceAI 74,7 на русских фактах, 60,5 на TriviaQA, 58,7 на общих тестах и по 72,2 на математике с кодом и работе с контекстом.
Источник: Артур Петросян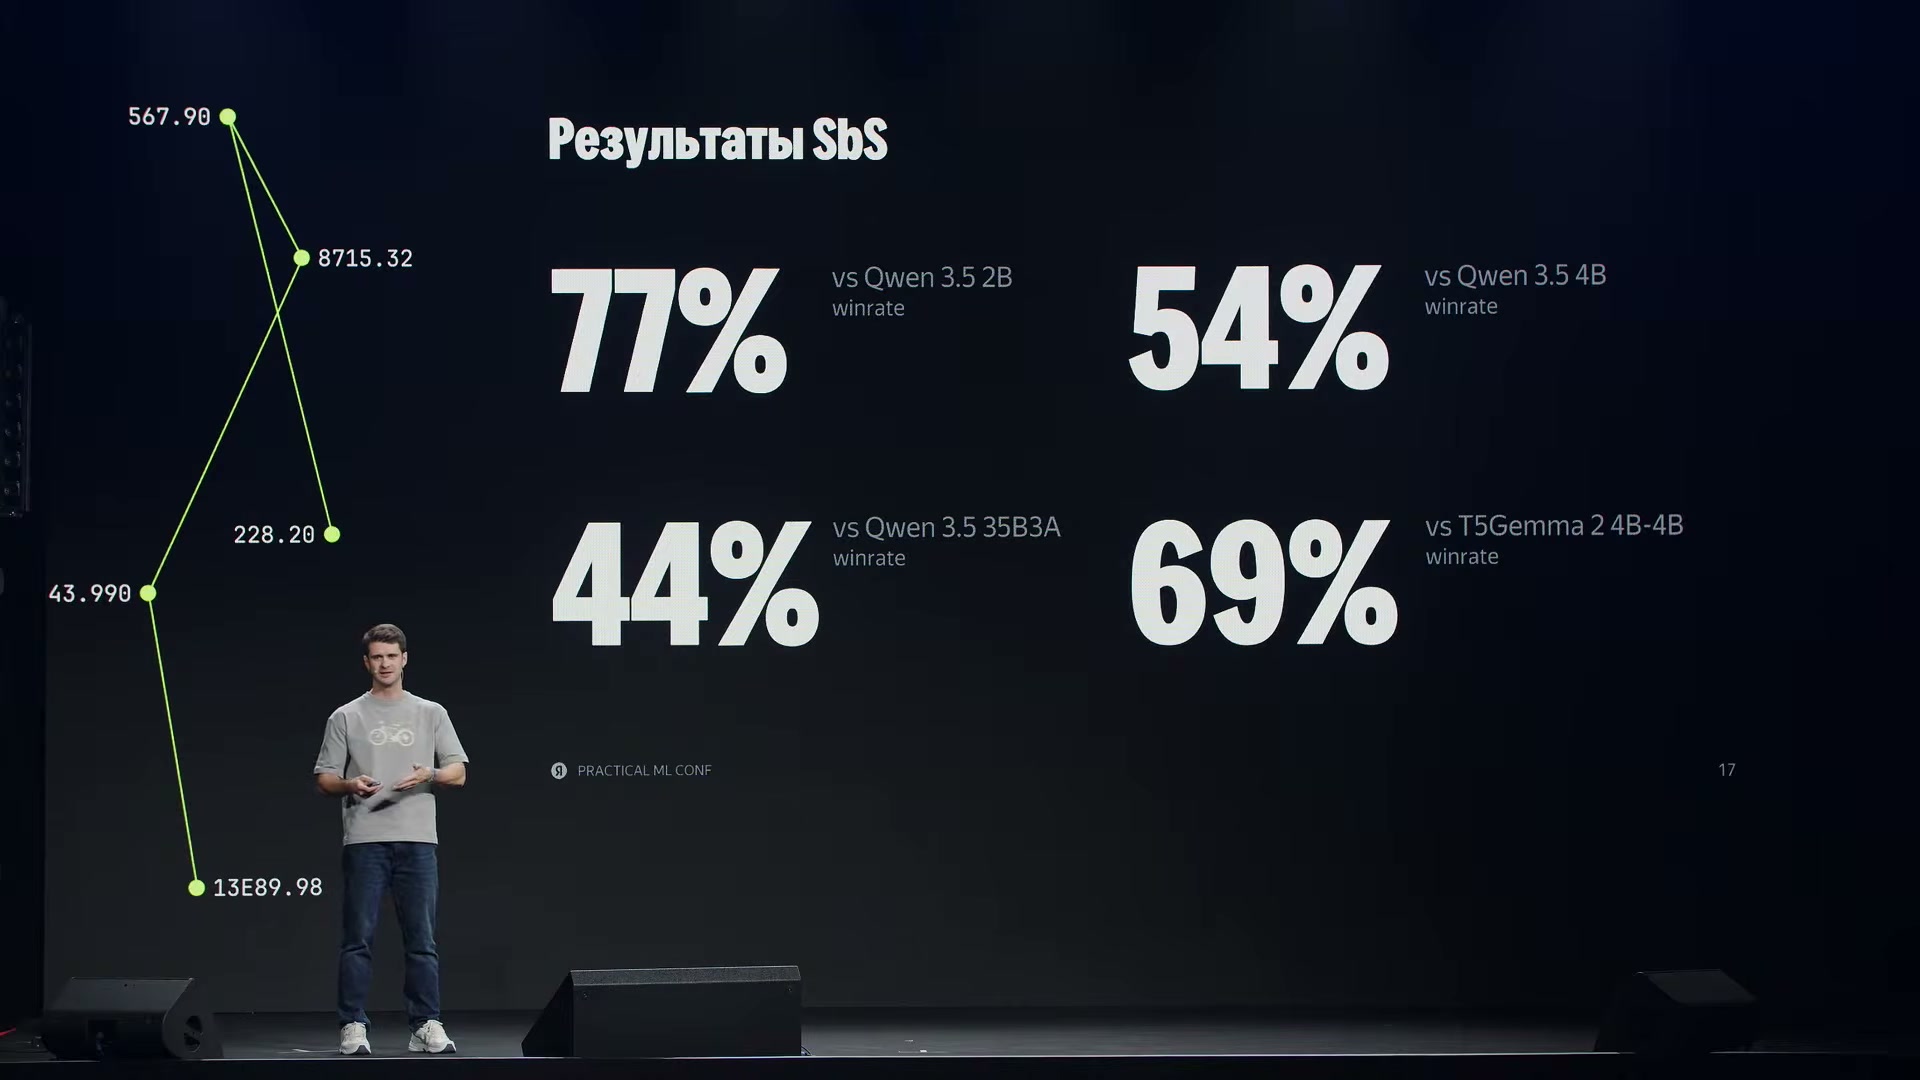
После настройки под поиск Alice AI получает 77%, 54%, 44% и 69% winrate против четырёх указанных соперников. Результат зависит от того, с какой моделью сравнивают ответы.
Источник: Артур ПетросянКак определить, какой ответ действительно лучше
Сильная базовая модель ещё не гарантирует подходящий поисковый ответ. Её нужно настроить на нужное поведение: выбирать полезные сведения, не преувеличивать, соблюдать требуемую подробность. Такую настройку называют alignment. В описанном процессе два основных сигнала отвечали за полезность ответа и проверку фактов.
Разницу между ними докладчик объясняет на новости о собственной модели. Громкая формулировка о новой архитектуре, превзошедшей все аналоги, привлекает внимание, но плохо выдерживает проверку: похожие архитектуры уже существовали, а результат зависит от группы задач. Другая крайность — сообщить только техническое имя модели. Такая формулировка точнее, но мало объясняет большинству читателей. Хороший ответ должен одновременно передавать значимый результат и оставаться достоверным.
На практике сигналов было больше: длина ответа, лаконичность, надёжность, доля изображений и видео, отдельные требования к группам запросов. Оценки, которые используют для отбора примеров или изменения поведения модели, здесь выступают наградами — reward. Но высокая оценка текста вне пользовательского взаимодействия не показывает напрямую, что человек сделал после чтения.
Это ограничение проявилось за сутки до выпуска. В ходе обучения ответы удлинялись, а продуктовый менеджер после просмотра примеров возразил против дальнейшего увеличения длины. На слайде показана соответствующая переписка. Команде пришлось быстро менять стратегию. Случай не доказывает, что длинные ответы всегда хуже: он показывает, насколько легко оптимизировать внутренние оценки не в ту сторону, которая нужна продукту.
Поэтому команда добавила ещё один источник информации — поведение пользователей. Оно должно было приблизить обучение к вопросу «помог ли ответ решить задачу», а не только к вопросу «соответствует ли текст нашим правилам хорошего ответа».
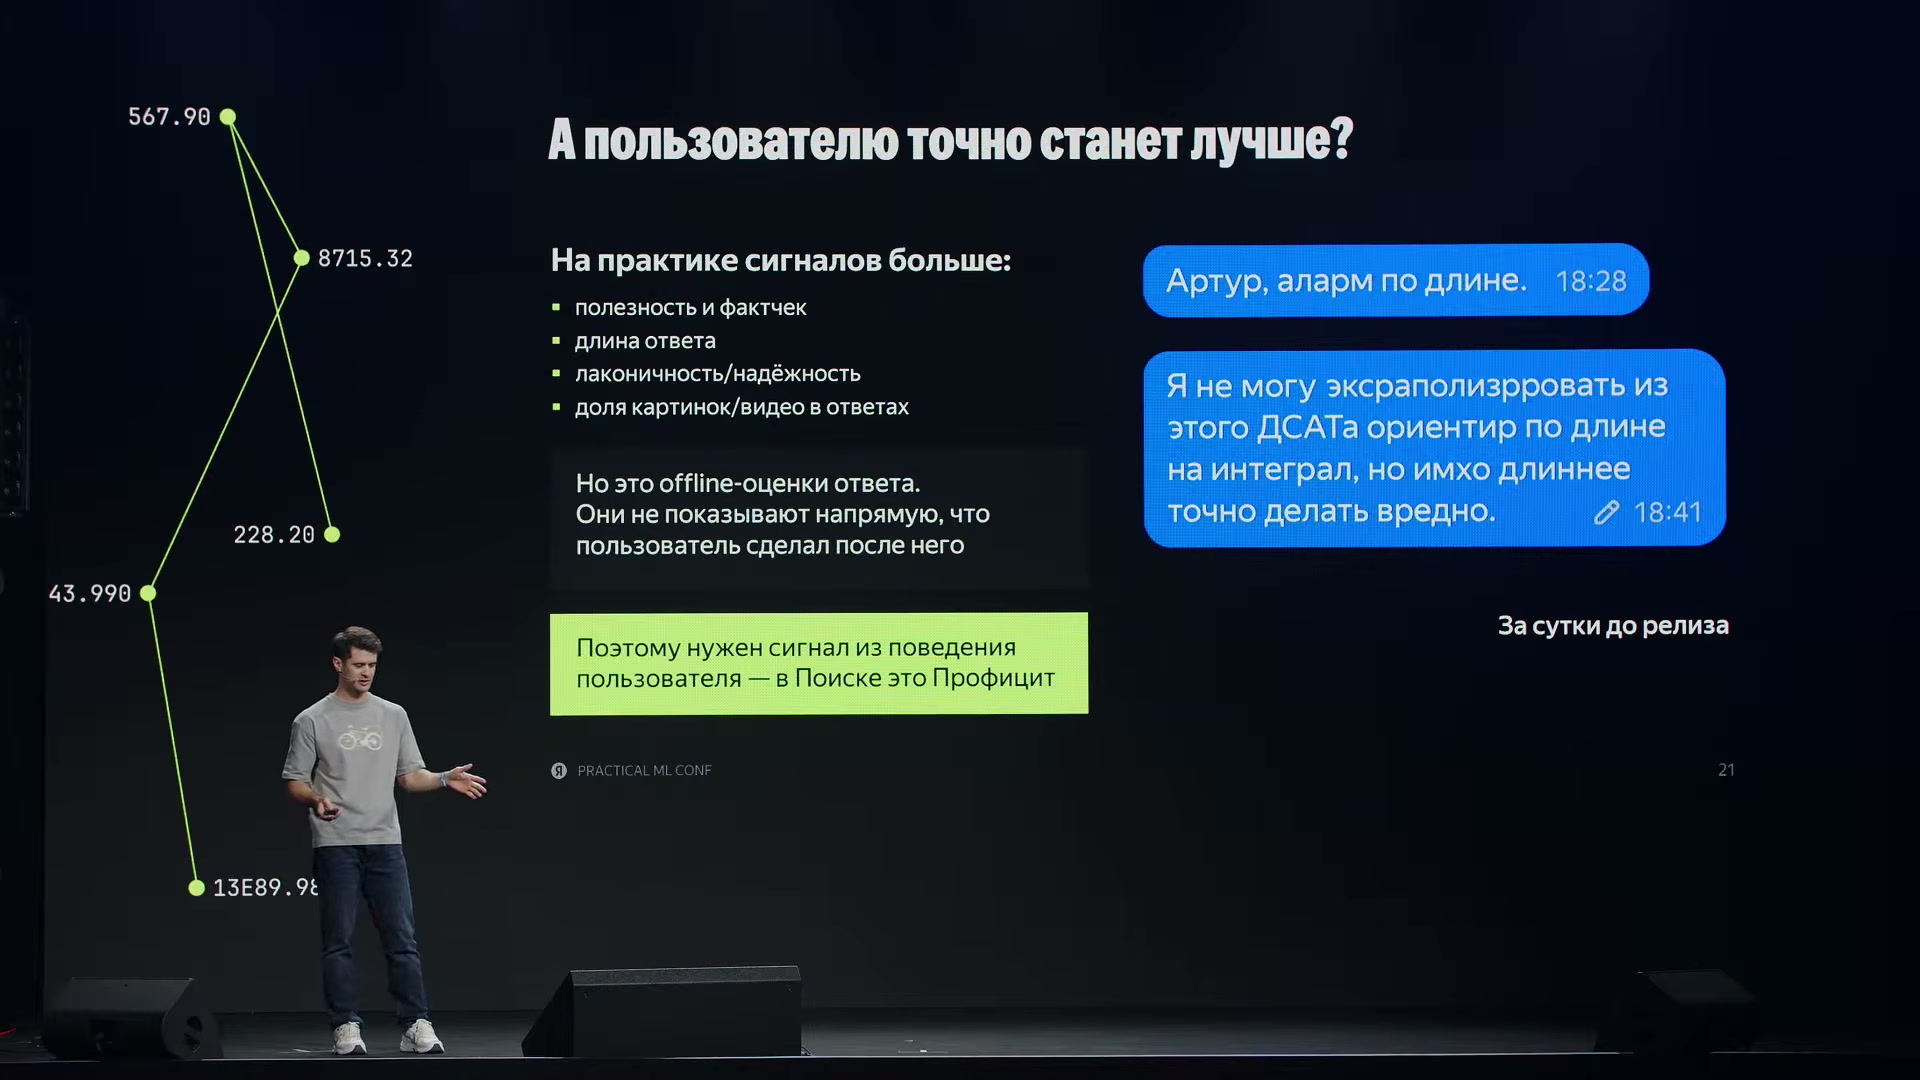
Полезность, фактчек, длина и доля изображений или видео описывают ответ, но не показывают напрямую действия пользователя. Переписка за сутки до выпуска иллюстрирует проблему растущей длины.
Источник: Артур ПетросянПоведение пользователей: полезный, но шумный сигнал
В Поиске такой сигнал называется профицитом. Он измеряет полезность выдачи через то, насколько быстро пользователь решает задачу. В докладе приведён запрос о распределении баллов на экзамене по английскому языку. Ответ с нужной шкалой помогает сразу получить искомую информацию. Рассказ об устройстве экзамена может быть тематически близким, но не закрывать конкретный вопрос.
Высокий профицит связан с ситуацией, когда человек нашёл ответ и не вернулся с похожим запросом. Возвраты, переформулировки и новые попытки найти сведения могут указывать, что задача ещё не решена. Но отдельное действие нельзя безошибочно приравнять к удовлетворённости. Речь идёт об оценке поисковой сессии — связанной последовательности действий пользователя.
Первое решение было прямолинейным: взять журналы действий, научиться предсказывать профицит и использовать этот прогноз как награду. Оно дало 55% accuracy — доли верных предсказаний пользовательского сигнала в проверке команды. Проблема заключалась в шуме. Например, пользователя могли отвлечь, после чего он два дня не возвращался к запросу. По событиям это выглядело как решённая задача, хотя ответ мог вообще не быть использован.
Таблицу можно прокрутить по горизонтали.
В текущем решении реакции нескольких пользователей на одинаковый ответ усредняли. Это снижало влияние случайностей отдельной сессии и повышало accuracy прогноза до 75%. Эти 75% не означают, что столько же поисковых ответов стали полезными или правильными: измеряется качество модели пользовательского сигнала.
Модель, обученную с этим сигналом, уже внедрили. Команда сообщает о статистически значимом положительном A/B-тесте — сравнении вариантов продукта на разных группах пользователей. В устной части результат описан как рост профицита и успешности сессий.
Целевое решение использовало бы повторяемость частых запросов ещё систематичнее: разным пользователям показывали бы разные варианты ответа и собирали достаточно наблюдений для их сопоставления. Этот план следует отличать от уже работающего усреднения реакций на одинаковый ответ.
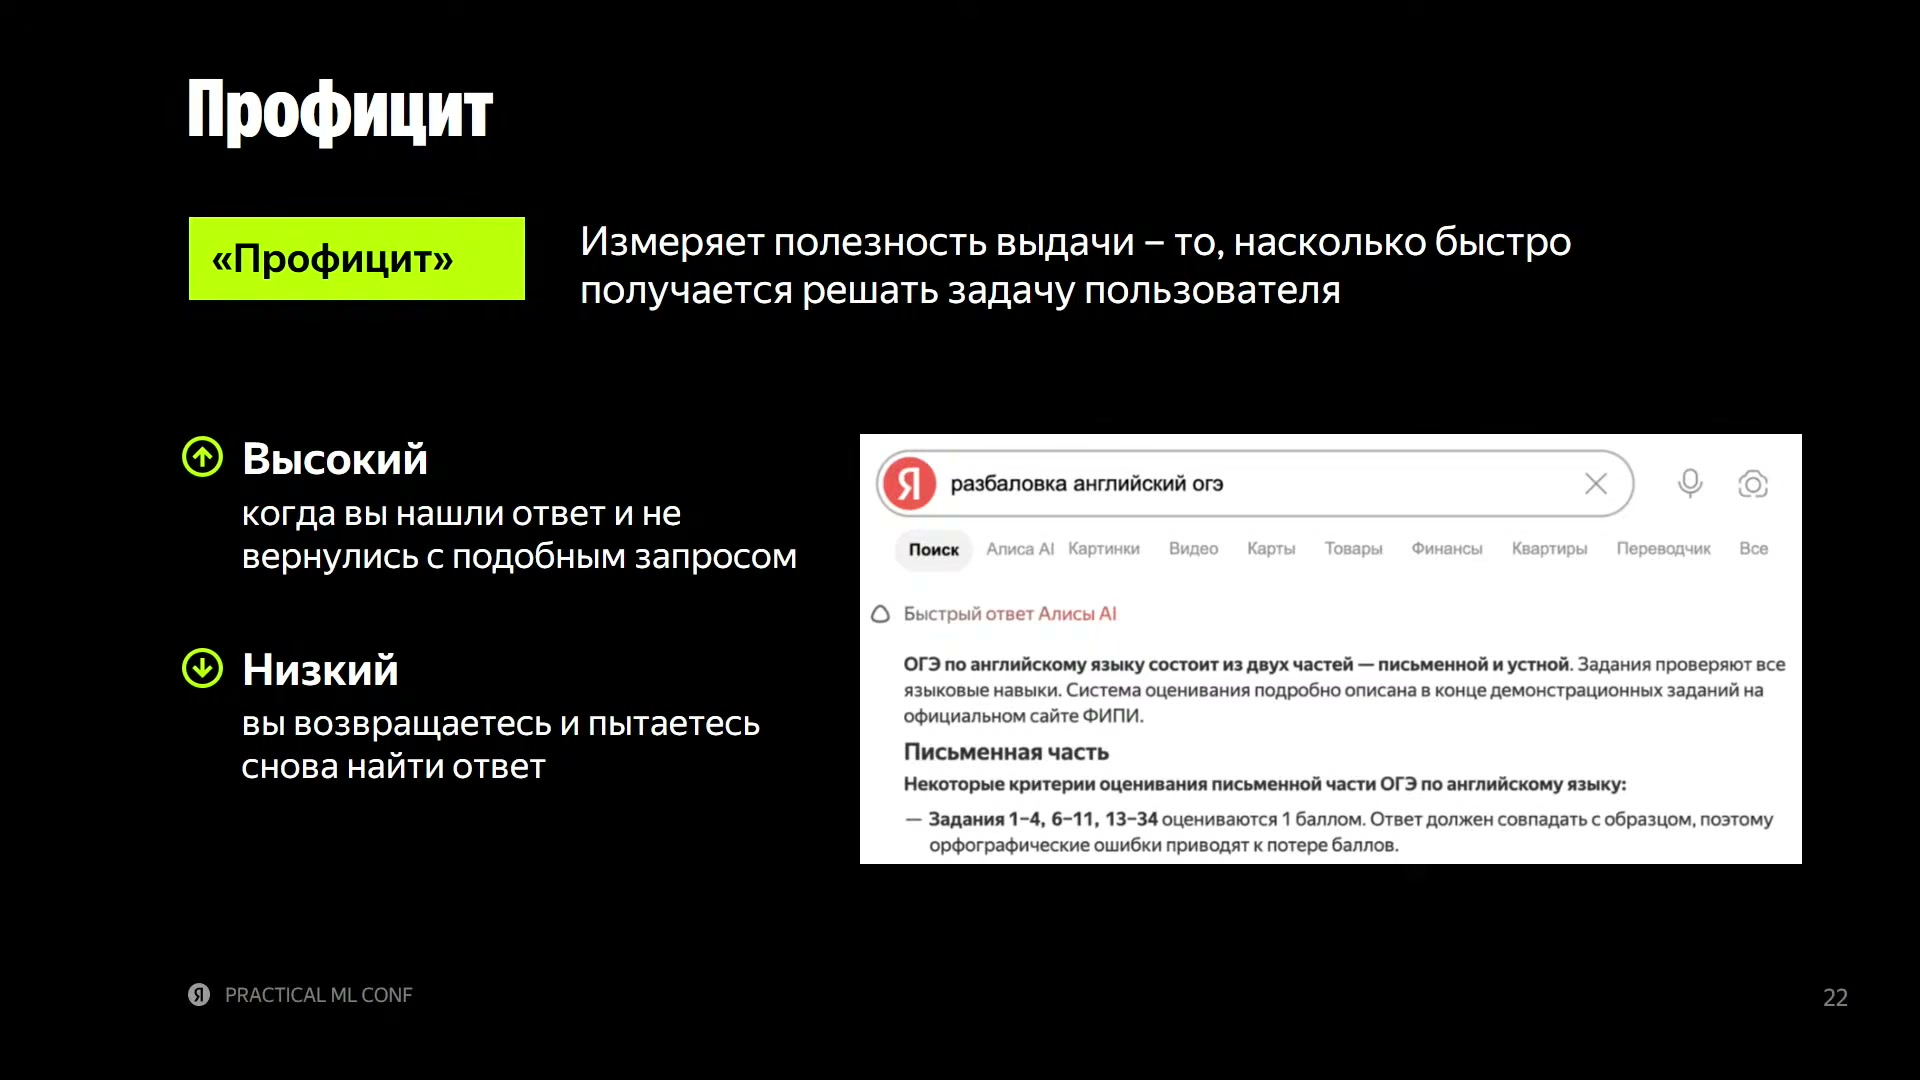
Профицит связывает полезность выдачи с решением задачи: нашёл ли человек нужный ответ или вернулся с похожим запросом.
Источник: Артур Петросян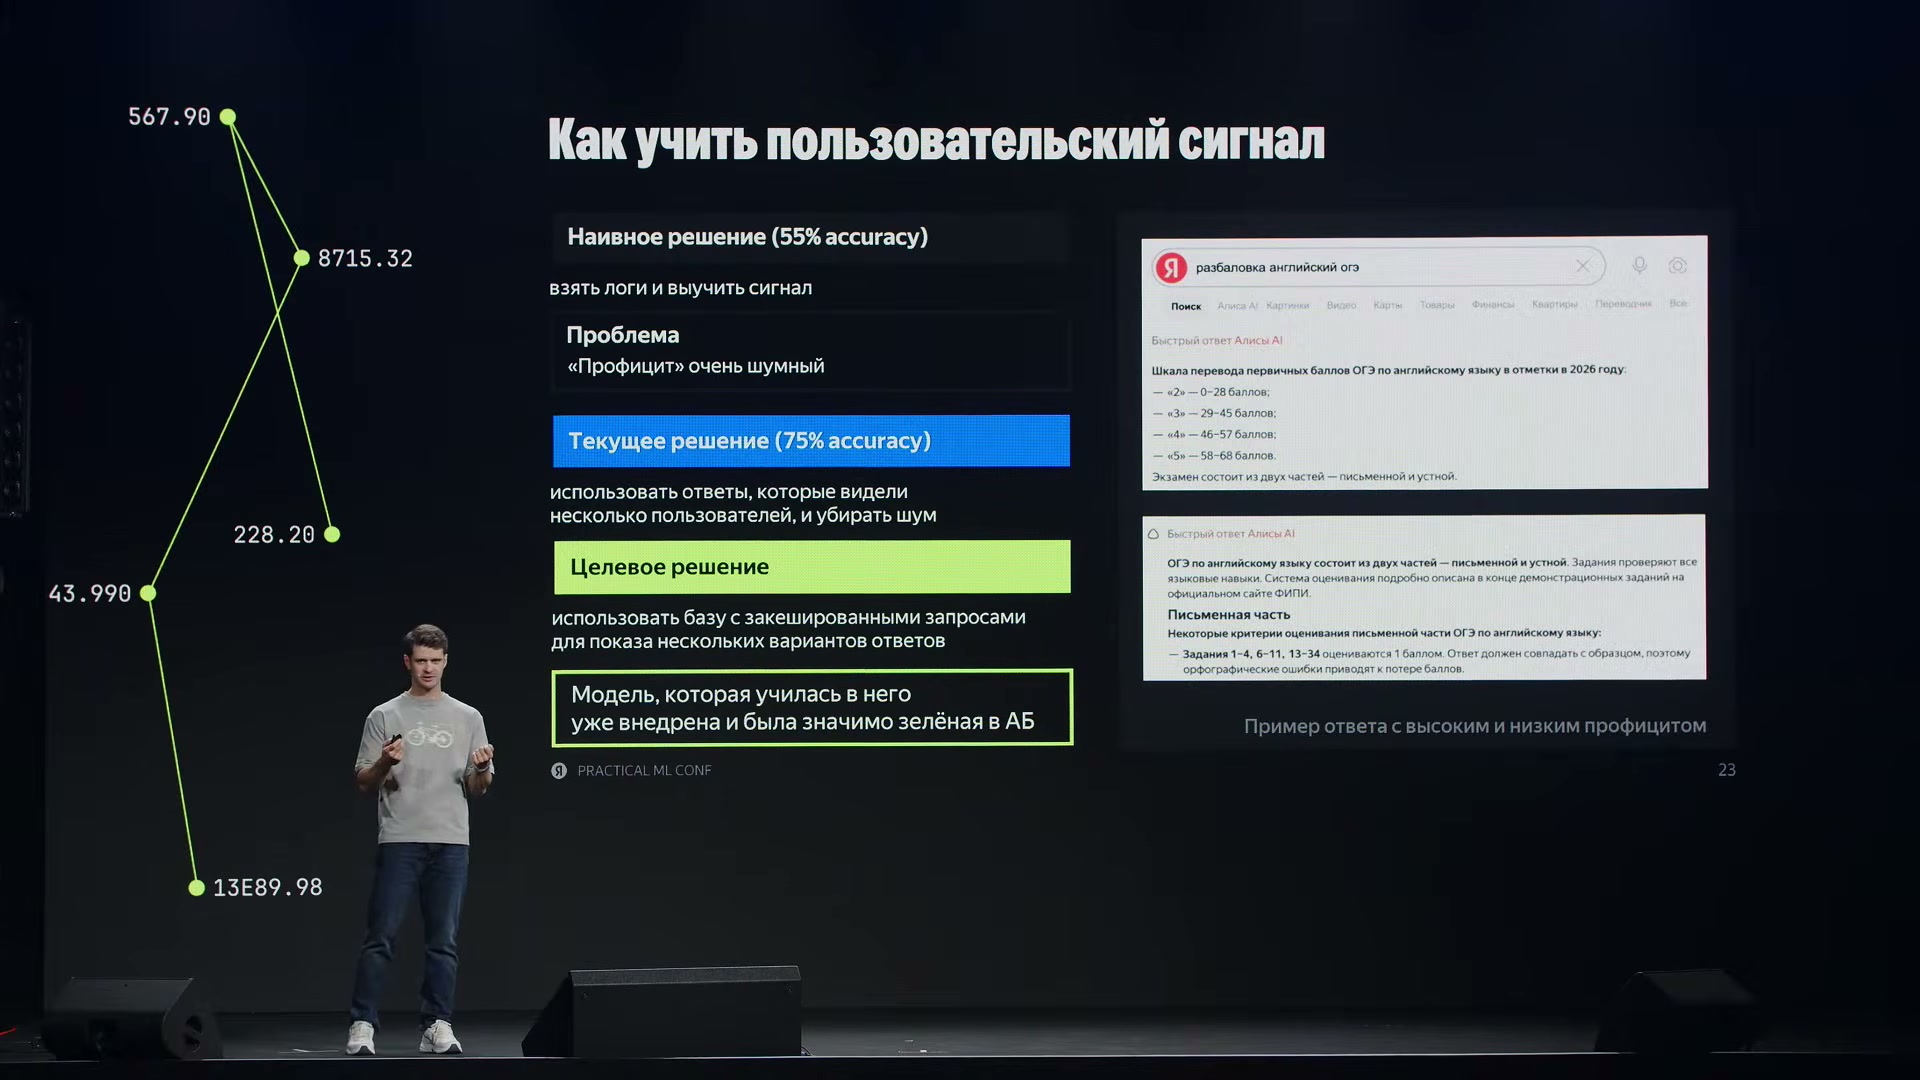
Уменьшение шума наблюдений повышает accuracy прогноза пользовательского сигнала с 55% до 75%. Справа показаны содержательно разные ответы на один запрос.
Источник: Артур ПетросянКак собирали обучающие ответы и исправляли неудачные
Первый этап настройки — обучение на примерах желаемых ответов, или SFT. Команда брала реальные поисковые запросы и распределяла их по тематическим группам, чтобы учитывать разные области и требования. Такая организация выборки называется стратификацией. Дополнительно включали запросы, на которых пользователи поставили отрицательные оценки: эта обратная связь непосредственно участвовала в улучшении модели.
Для каждого запроса более крупные модели, включая Алису, создавали сотни, иногда тысячи кандидатов. Разнообразие генераций регулировалось температурой — параметром, влияющим на случайность выбора продолжения. Затем ответы упорядочивали по наградам и требованиям соответствующей группы запросов: полезности, проверке фактов, профициту и специальным критериям.
Такой подход, при котором создают много вариантов и оставляют подходящие, называют rejection sampling. Он давал сильный исходный набор для SFT, но имел два ограничения. Хорошего ответа могло не оказаться даже среди множества генераций. А пример от очень сильной модели мог плохо соответствовать возможностям обучаемой модели с более скромной активной частью.
Поэтому команда добавила процедуру критики и переписывания. Вместо того чтобы только искать готовый удачный ответ, она исправляла недостатки кандидата по требованиям конкретного запроса.
- 01
Определить требования
Для запроса формулируют, какие сведения и свойства должны присутствовать в хорошем ответе.
- 02
Получить критику
Модель-судья проверяет кандидат по этим требованиям и описывает недостатки.
- 03
Переписать ответ
Новый вариант учитывает замечания, а не просто повторяет исходную генерацию.
- 04
Добавить пример
Исправленный ответ включают в данные для последующего обучения модели.
Процедура помогала получать более качественные примеры и исправлять собственные ответы модели. По устному описанию эксперимента, SFT с добавлением таких данных получила около 55% winrate против варианта без них. Это отдельное сравнение способа подготовки данных, а не 55% accuracy прогноза профицита из предыдущего раздела.
Обучающие ответы в описанном процессе генерировались моделями, а не писались людьми. Это не означает отсутствия человеческих решений: команда выбирала требования, сигналы и правила отбора. Утверждение относится именно к происхождению текстов, на которых учили отвечать.
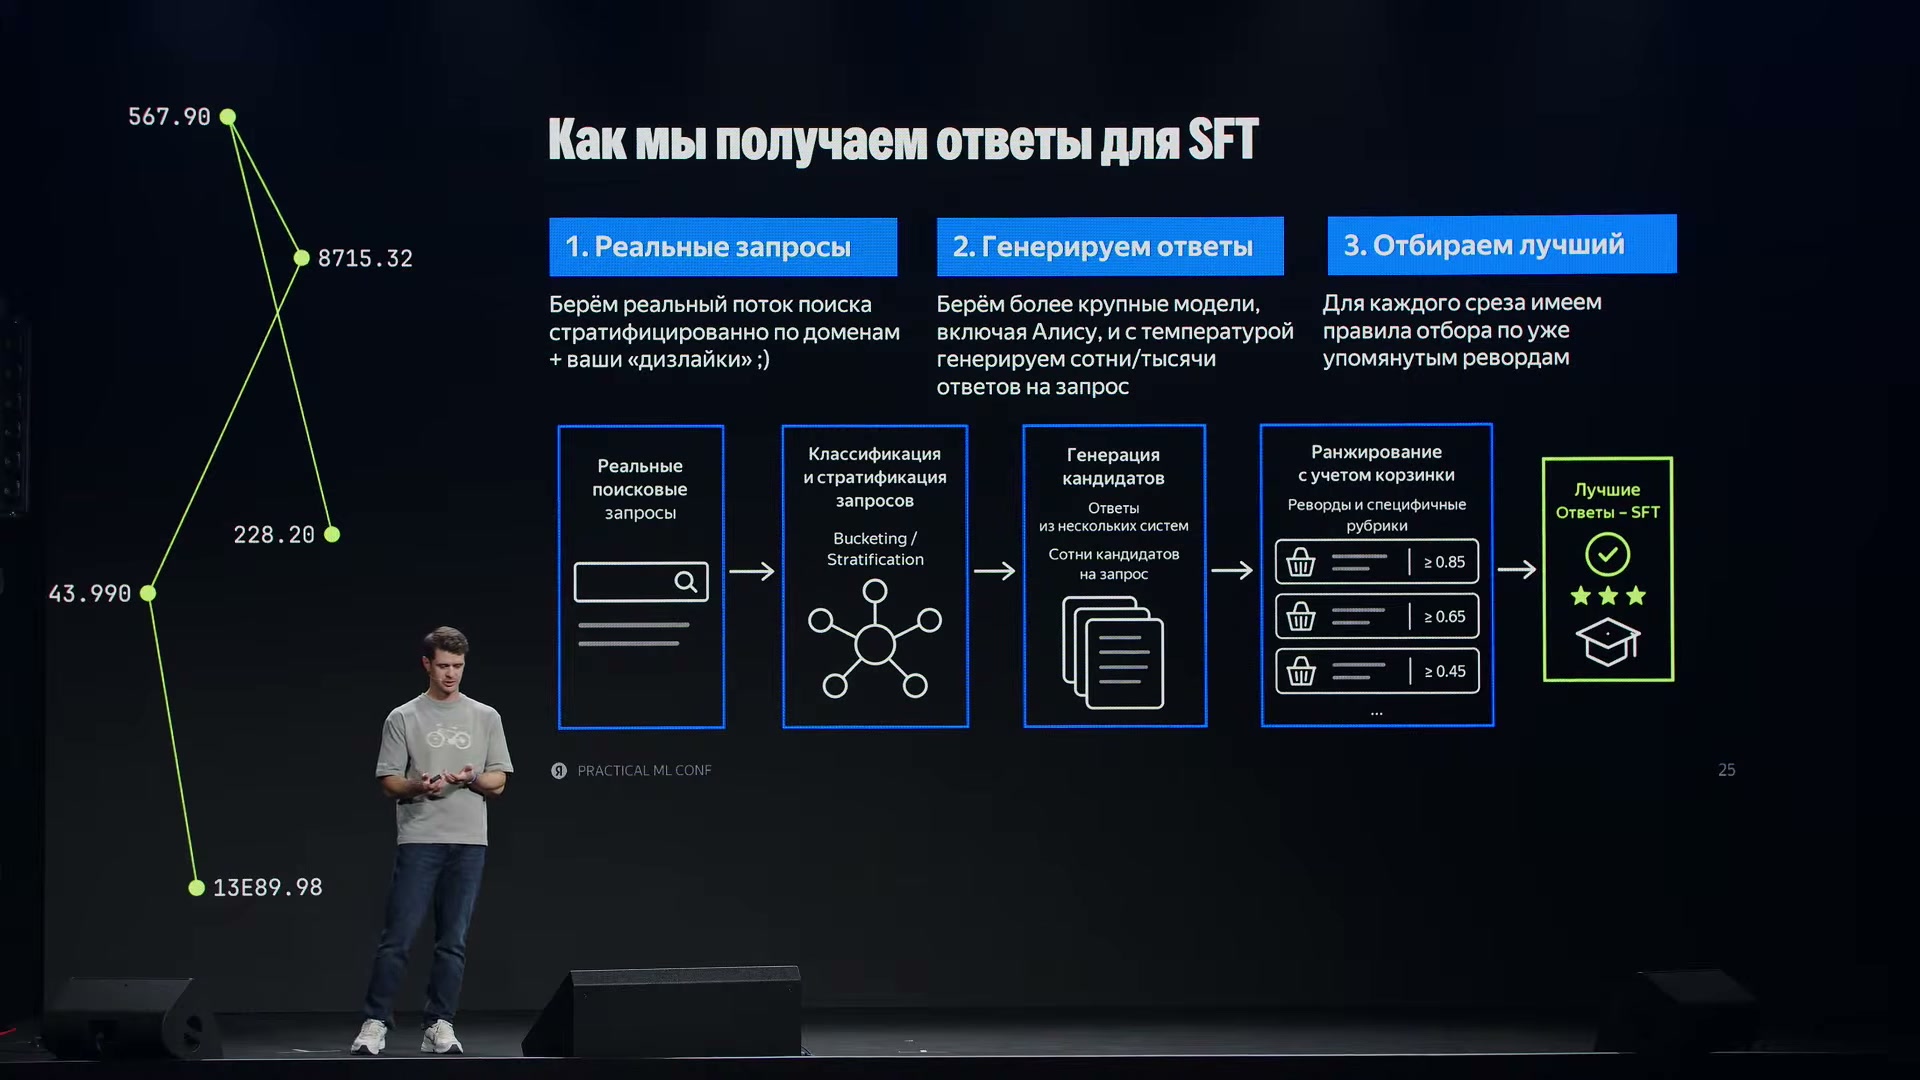
Реальные запросы распределяют по группам, генерируют сотни или тысячи кандидатов и отбирают ответы по требованиям соответствующей группы для последующего SFT.
Источник: Артур ПетросянОбучение с подкреплением и повторное использование улучшенных ответов
После SFT модель продолжали улучшать с помощью обучения с подкреплением, или RL. Здесь модель не только воспроизводит заранее выбранные примеры: её поведение меняют так, чтобы собственные ответы получали более высокие награды. В показанном процессе использовался алгоритм GRPO в системе VeRL со стабилизацией TiS.
На слайде прямое сравнение с моделью на SFT-стадии даёт 65% SbS winrate в пользу RL-варианта. Это показывает, что обучение на отобранных ответах было сильной отправной точкой, но не исчерпывало возможности настройки.
За рассматриваемое полугодие команда перешла от офлайн-RL к онлайн-RL, где новые ответы получают в ходе обучающего цикла. Такой переход ускорил проведение экспериментов в 2–3 раза. Речь идёт о скорости работы над моделями, а не об ускорении ответа в Поиске. Онлайн-обучение здесь также не означает изменение параметров прямо во время обслуживания пользователя.
Улучшенную модель затем возвращали в процесс подготовки данных. Её сильные ответы добавляли в SFT, чтобы следующая модель начинала обучение с более высокой точки. Одновременно обновляли модели награды: новые генерации могли обнаруживать способы получить высокую оценку без соответствующего улучшения ответа. Такие слабые места оценивания требовалось исправлять, а не закреплять.
- 01
Обучить на примерах
Модель осваивает отобранные и исправленные поисковые ответы.
- 02
Улучшить по наградам
GRPO меняет поведение модели на основе оценок её генераций.
- 03
Разобрать новые ответы
Удачные генерации становятся новыми примерами; способы обойти оценивание показывают, где нужно обновить награды.
- 04
Обновить SFT и награды
Следующий цикл начинается с более сильных данных и уточнённых оценок.
Совокупный эффект проверили отдельно от архитектуры: взяли одну и ту же базовую модель и применили прежний и новый способы дообучения. Новый вариант получил более 70% winrate. Это другой эксперимент, чем 65% SbS RL против SFT: здесь сравниваются два поколения процесса настройки при неизменном предварительном обучении.
Таблицу можно прокрутить по горизонтали.
Прирост профицита +0,7% — результат поведения пользователей после обучения с соответствующей наградой. Его нельзя читать как рост точности модели на 0,7 процентного пункта или прибавлять к winrate. Повторное использование собственных удачных ответов, обновление оценок и пользовательский сигнал решали разные части одной задачи: сделать улучшение не разовым, а воспроизводимым в следующих циклах.
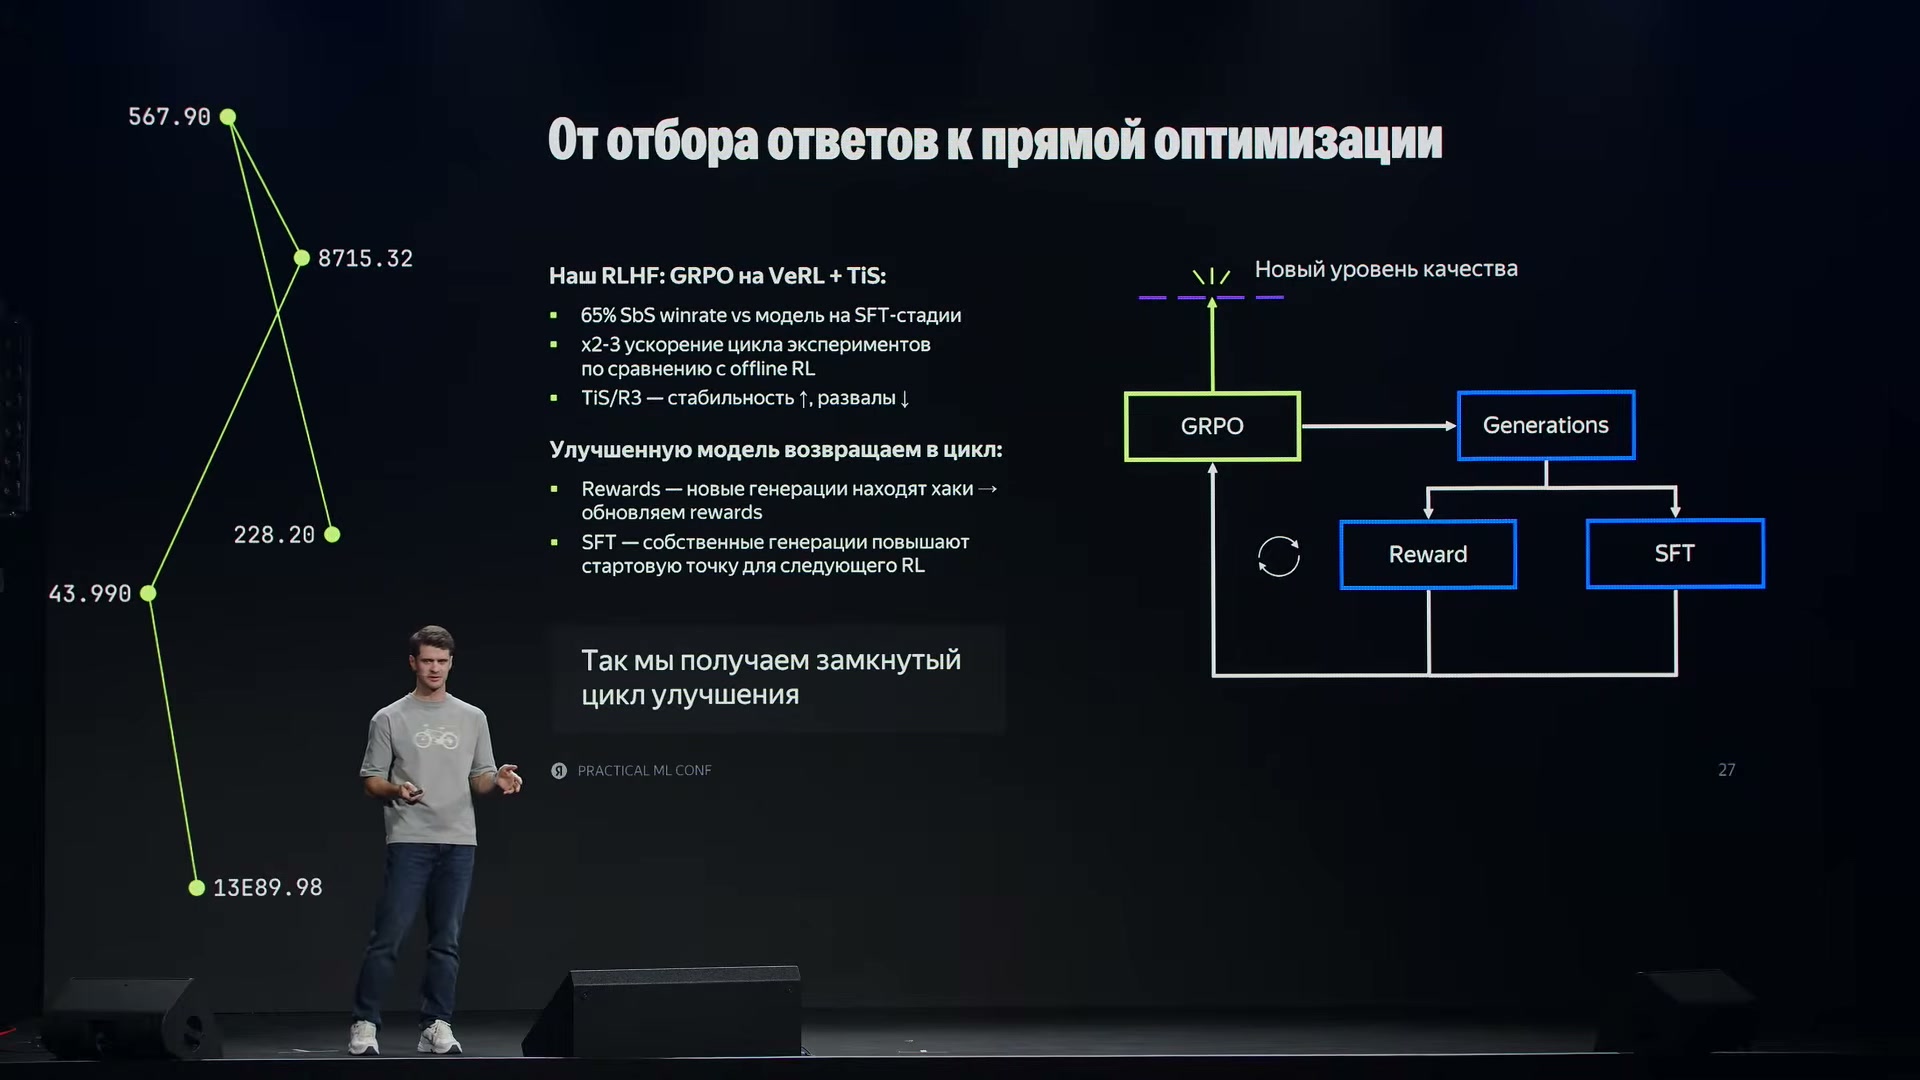
RL даёт 65% SbS winrate против SFT. Новые генерации возвращаются в данные и модели награды, образуя повторяющийся цикл улучшения; статус R3 уточнён спикером после выступления.
Источник: Артур Петросян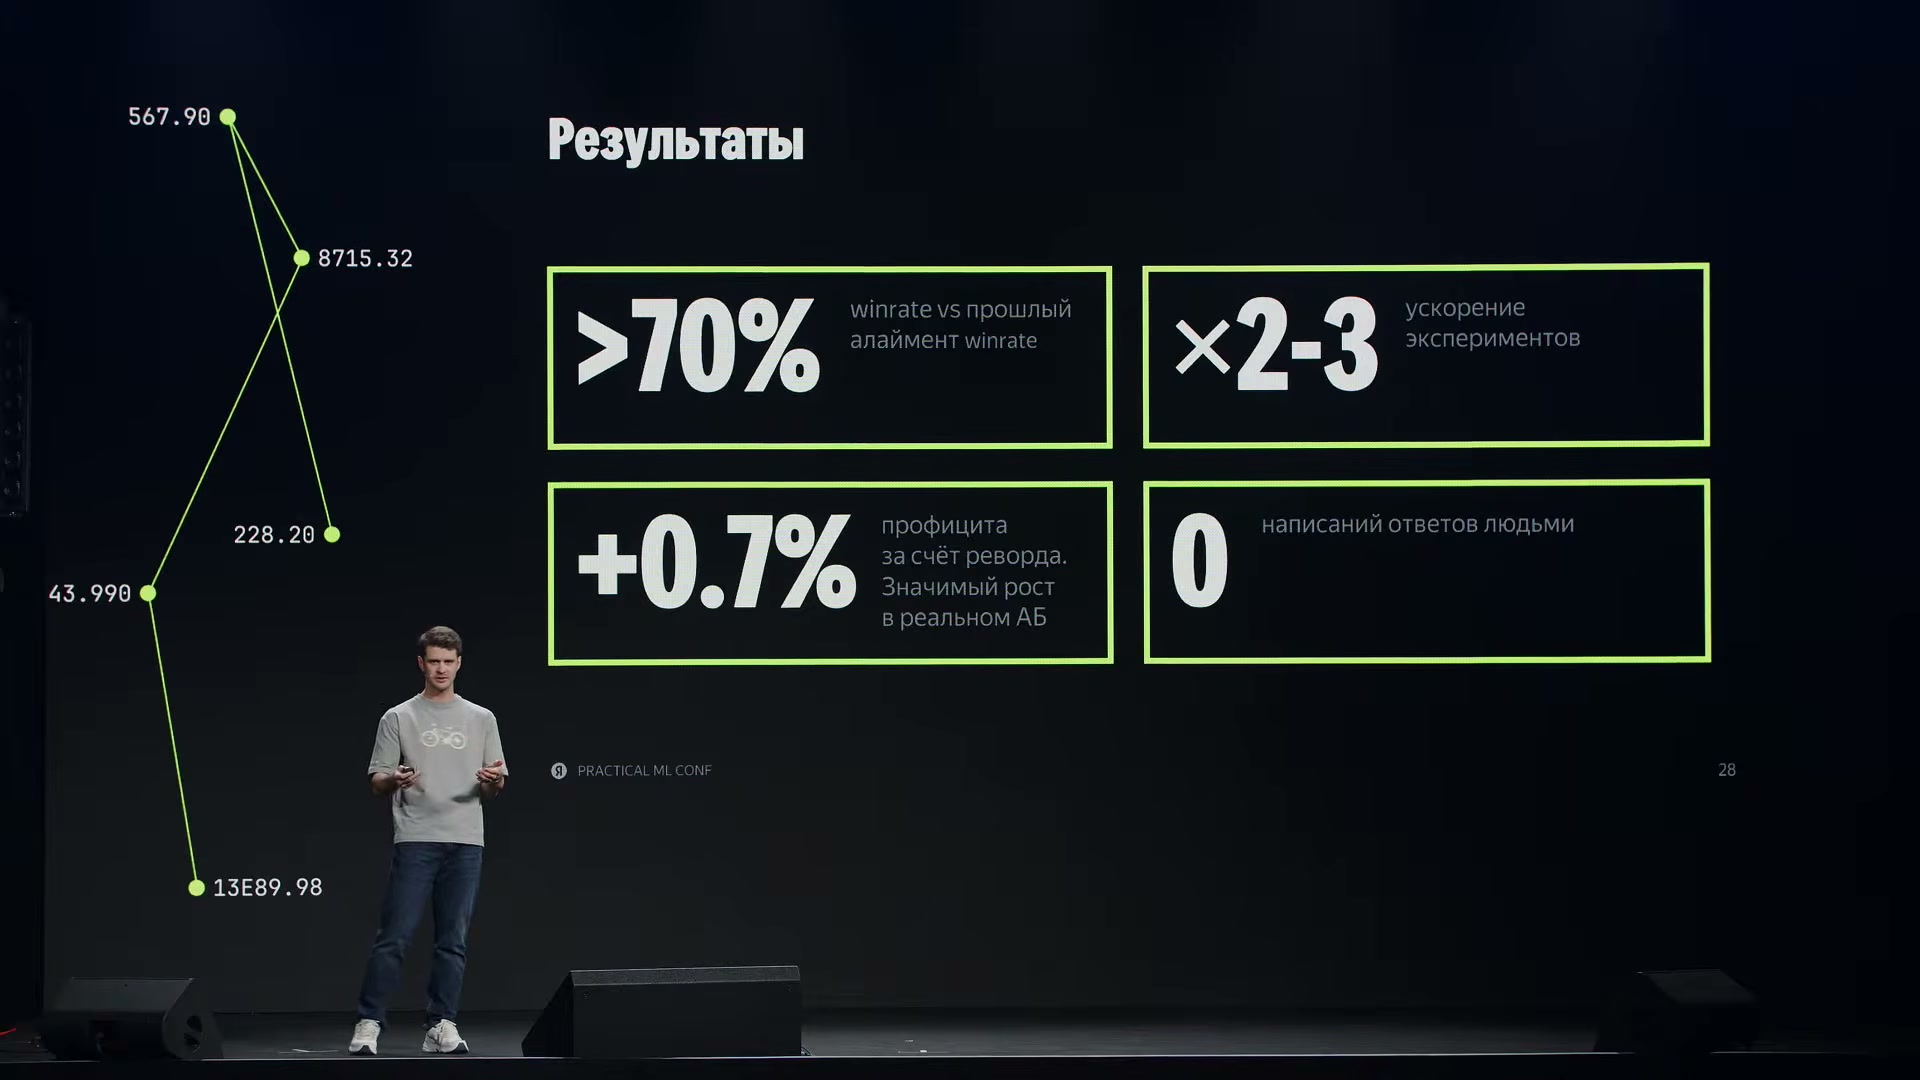
Четыре отдельных итога: >70% winrate нового дообучения, ускорение экспериментов ×2–3, +0,7% профицита в A/B-тесте и 0 написанных людьми обучающих ответов.
Источник: Артур ПетросянПочему устойчивость экспериментов важна не меньше отдельного выигрыша
Отдельное направление работы — устойчивость обучения с подкреплением: способность завершать запуски без развала обучения. В основном выступлении TiS и R3 названы среди методов, помогающих стабилизации. Подробности их устройства и настройки не разбираются.
В ответах на вопросы докладчик делает важное уточнение: R3 для этой архитектуры ещё внедряют, и на тот момент он не используется. Энкодер–декодер снова требует дополнительной инженерной адаптации. Поэтому результаты уже проведённых экспериментов нельзя приписывать внедрённому R3, даже если он перечислен на общем слайде вместе с методами стабилизации.
На вопрос о применимости GRPO к экспертной модели докладчик отвечает, что обучение возможно и без R3, хотя ожидается польза от его добавления. Команда также пробовала и использовала GSPO — другой метод обучения, обсуждавшийся в вопросах. По её наблюдениям, он работал немного лучше, но основная польза заключалась в устойчивости.
В отдельном запуске разница могла быть небольшой. На длинной последовательности экспериментов меньше запусков разваливалось, и команда приходила к более сильному результату. Таким образом, стабильность влияла не только на удобство разработки: она определяла, сколько гипотез удастся проверить и какой модели команда достигнет за доступное время.
Доклад · 00:25:20Как более качественные ответы замедлили генерацию
После улучшения архитектуры и обучения возникла неожиданная проблема. Предыдущая модель часто извлекала части документов и переносила их в ответ. Новая чаще составляла собственные формулировки, лучше приспосабливая объяснение к запросу и используя выученные знания.
На слайде это показано на вопросе о формировании колоновидной яблони. В прежнем ответе выделены длинные фрагменты, совпадающие с предоставленной статьёй. Новый ответ формулирует объяснение иначе. Для читателя это изменение могло быть полезным, но для ускорения генерации оно оказалось неудобным.
Команда использовала EAGLE-3 — механизм спекулятивного декодирования. Вспомогательная модель предлагает следующие токены, а основная проверяет продолжение. Экономия зависит от того, насколько хорошо удаётся предсказывать её генерацию. После изменения поведения ответы стали менее предсказуемыми для этого механизма.
По измерению команды throughput упал на 30–40% из-за уменьшения количества успешно предсказанных EAGLE-3 токенов. Это потеря пропускной способности, а не утверждение, что каждый ответ стал на 30–40% длиннее или что качество снизилось на такую величину.
Падение обнаружили перед выпуском. Для прежней нагрузки потребовалось бы больше ускорителей, и релиз оказался под угрозой. Самым большим оставшимся резервом команда считала входные токены: если генератору нужно прочитать меньше материала, можно уменьшить вычислительную стоимость ответа. Так изменение поведения модели привело к отдельной работе над подготовкой документов.
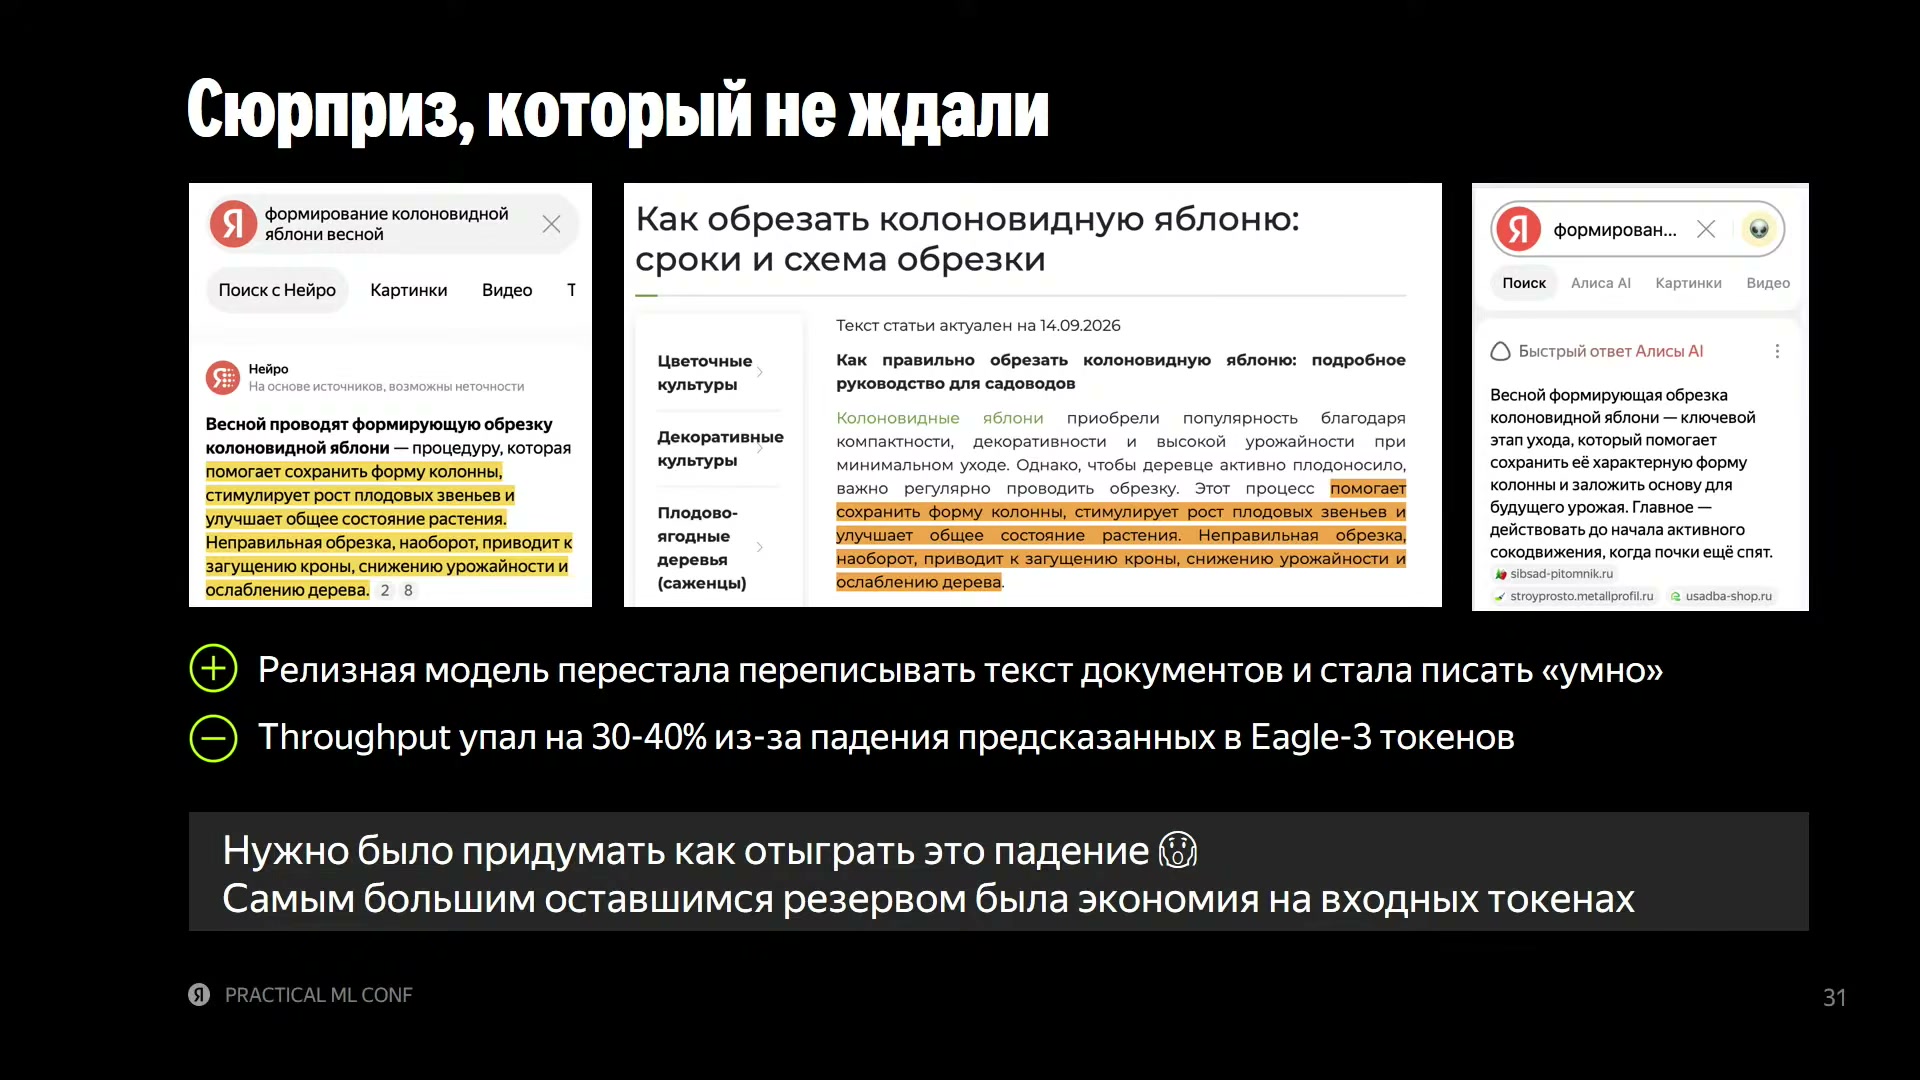
На примере ответа об обрезке яблони видно уменьшение прямого переноса текста источника. Одновременно EAGLE-3 стал хуже предсказывать продолжения, и throughput упал на 30–40%.
Источник: Артур ПетросянПервое сокращение входа: оставить только относящееся к вопросу
Человек и языковая модель по-разному используют найденные документы. Человек может посмотреть краткое описание результата, открыть страницу и быстро перейти к нужному фрагменту. Модель либо получает большой объём текста сразу, либо делает дополнительные обращения к инструментам, чтобы извлечь нужные сведения. Оба варианта были слишком затратными для рассматриваемого режима быстрых ответов.
В измерениях команды увеличение числа входных токенов снижало пропускную способность. Поэтому перед основным генератором поставили отдельную небольшую модель, которая извлекает полезные части документов. Это не энкодер самой Alice AI T5-35B-0.6A, а дополнительный компонент подготовки входа.
Релевантные токены — части документа, относящиеся к заданному вопросу. На схеме модель получает запрос и текст, после чего сохраняет нужные фрагменты. Из них формируется информационный контекст, сокращённо ИК, который затем читает основной генератор. Это извлечение исходного текста, а не свободное написание нового пересказа.
Пример из доклада — вопрос о дне рождения Яндекса. В документе сначала сказано, что Яндекс является российской IT-компанией, а затем названа дата — 23 сентября. Для этого запроса первая часть ничего не добавляет, тогда как фрагмент с датой непосредственно нужен. Экстрактор оставляет вторую часть.
Такой отбор работал быстро, но необходимой экономии не обеспечил. Причина в том, что «относится к вопросу» и «нужно этой модели для хорошего ответа» — разные критерии. Даже релевантный текст может дублировать сведения, которые генератор уже умеет воспроизводить.
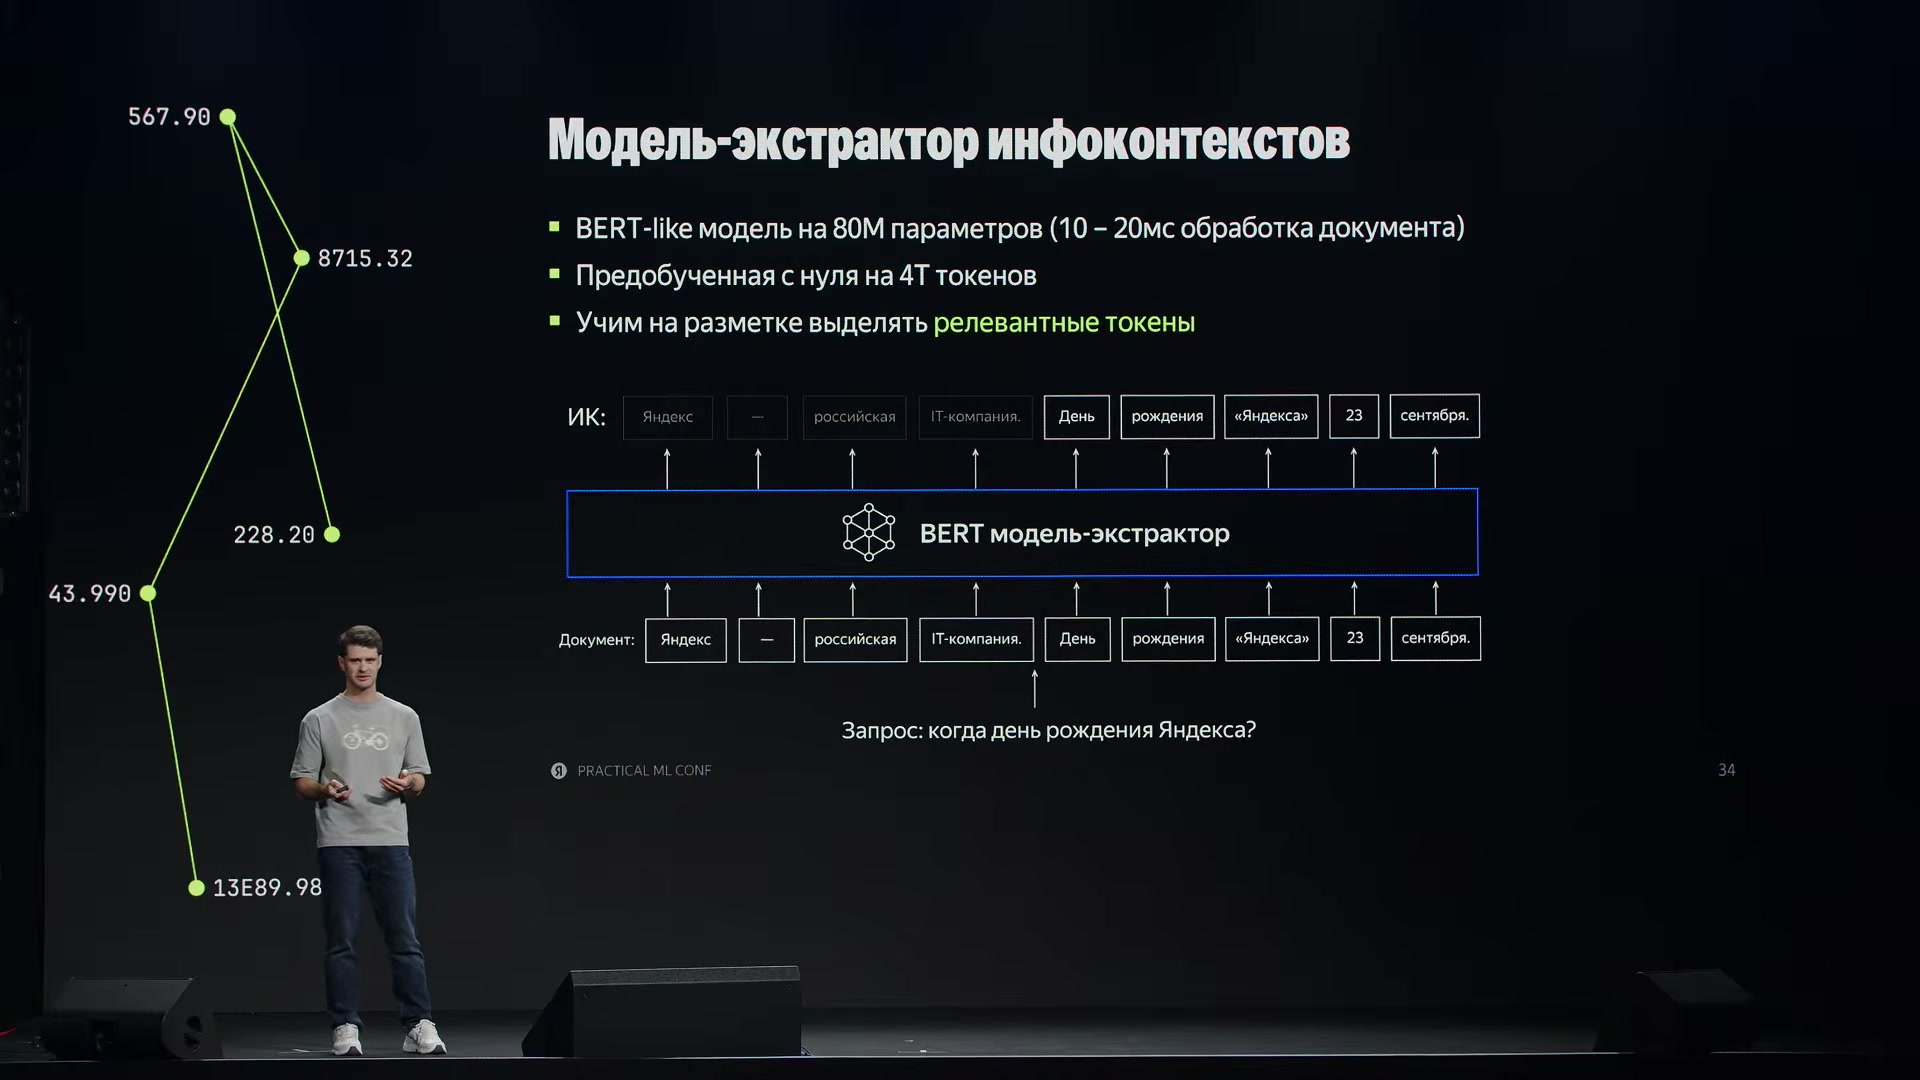
BERT-like экстрактор на 80 млн параметров выбирает релевантные токены. Его предварительно обучили на 4 трлн токенов; обработка документа занимает 10–20 мс.
Источник: Артур ПетросянСокращение по результату: что нужно конкретному генератору
Следующий пример — вопрос о том, почему осенью листья меняют цвет. В документе могут находиться общие сведения о похолодании, сокращении светового дня и уменьшении количества хлорофилла. Они относятся к вопросу, но модель уже может их знать. Рядом может быть более редкое объяснение механизма красной окраски, без которого ответ окажется менее содержательным.
Поэтому новую задачу сформулировали иначе: минимизировать длину информационного контекста без ухудшения качества конечного ответа. Проверять нужно было не только связь фрагментов с вопросом, но и результат работы конкретного генератора по этим фрагментам.
Для сравнения вариантов использовали оценку ответа со штрафом за длину: reward(answer) − λ × (длина ИК). Здесь reward(answer) — награда сгенерированному ответу, а λ задаёт, насколько сильно штрафуется длинный контекст. Сначала нужно получить ответ и оценить его, а не объявить короткий вход хорошим только потому, что в нём мало токенов.
- 01
Задать начальные вероятности
Берут вероятности выбора токенов из экстрактора, уже обученного на релевантности.
- 02
Создать варианты и ответы
По этим вероятностям выбирают разные информационные контексты и генерируют ответ для каждого.
- 03
Оценить качество и длину
Для вариантов считают награду ответа за вычетом штрафа за длину контекста.
- 04
Обновить выбор токенов
Лучшие контексты используют как новую целевую разметку и изменяют исходные вероятности.
- 05
Повторить поиск
Цикл многократно повторяют, чтобы находить короткие контексты, сохраняющие качество генерации.
Авторы называют эту процедуру Cross-Entropy Method, или CEM. В данном случае это итеративный поиск: создавать кандидатов, оценивать их и смещать следующий выбор в сторону удачных вариантов. Это не просто другое название функции потерь для SFT. Многократная генерация нужна для оптимизации отбора; она не включается заново в полный обучающий цикл при каждом пользовательском запросе.
Подход не требует заранее безошибочно определить, какие факты генератор хранит в параметрах. Полезность оставленных сведений проявляется через качество ответа. Поэтому экстрактор настраивается не на сохранение всего тематически подходящего, а на обслуживание конкретной модели.
Таблицу можно прокрутить по горизонтали.
Таким образом, общий результат разработки включал ещё не внедрённое улучшение. Слайд относит 25% прироста к дообучению и 15% — к RL, отдельно отмечая предстоящее включение последних +15%. Эту разбивку следует сохранять в авторской записи, а не пересчитывать в новую итоговую метрику. Она также не означает уменьшения задержки каждого ответа на 40%.
По оценке докладчика, сокращение входа позволило справиться с проблемой, поставившей выпуск под угрозу. При этом падение throughput на 30–40% после изменения ответов и последующий рост на 40% не образуют простую сумму: базы этих сравнений подробно не раскрыты.
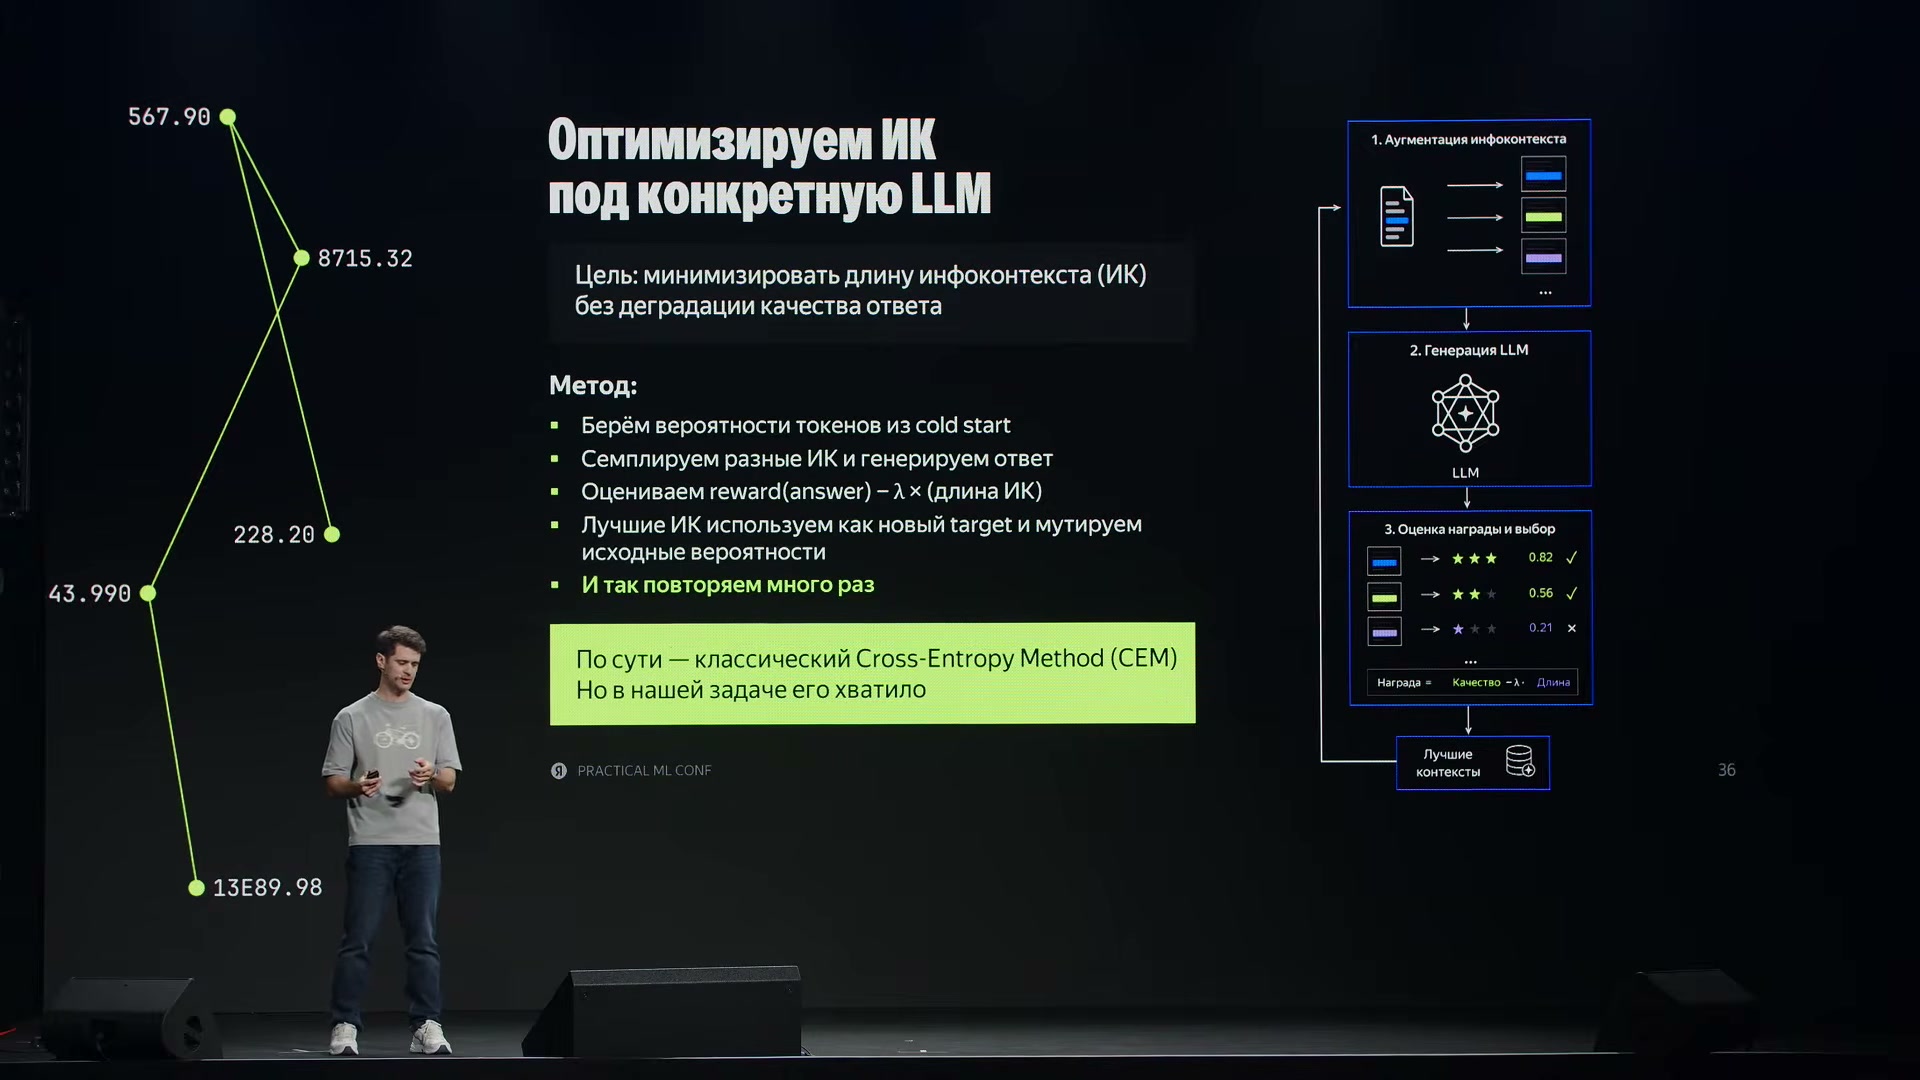
CEM выбирает контексты по награде конечного ответа со штрафом за длину. Лучшие варианты меняют следующий выбор токенов, поэтому сокращение учитывает конкретный генератор.
Источник: Артур Петросян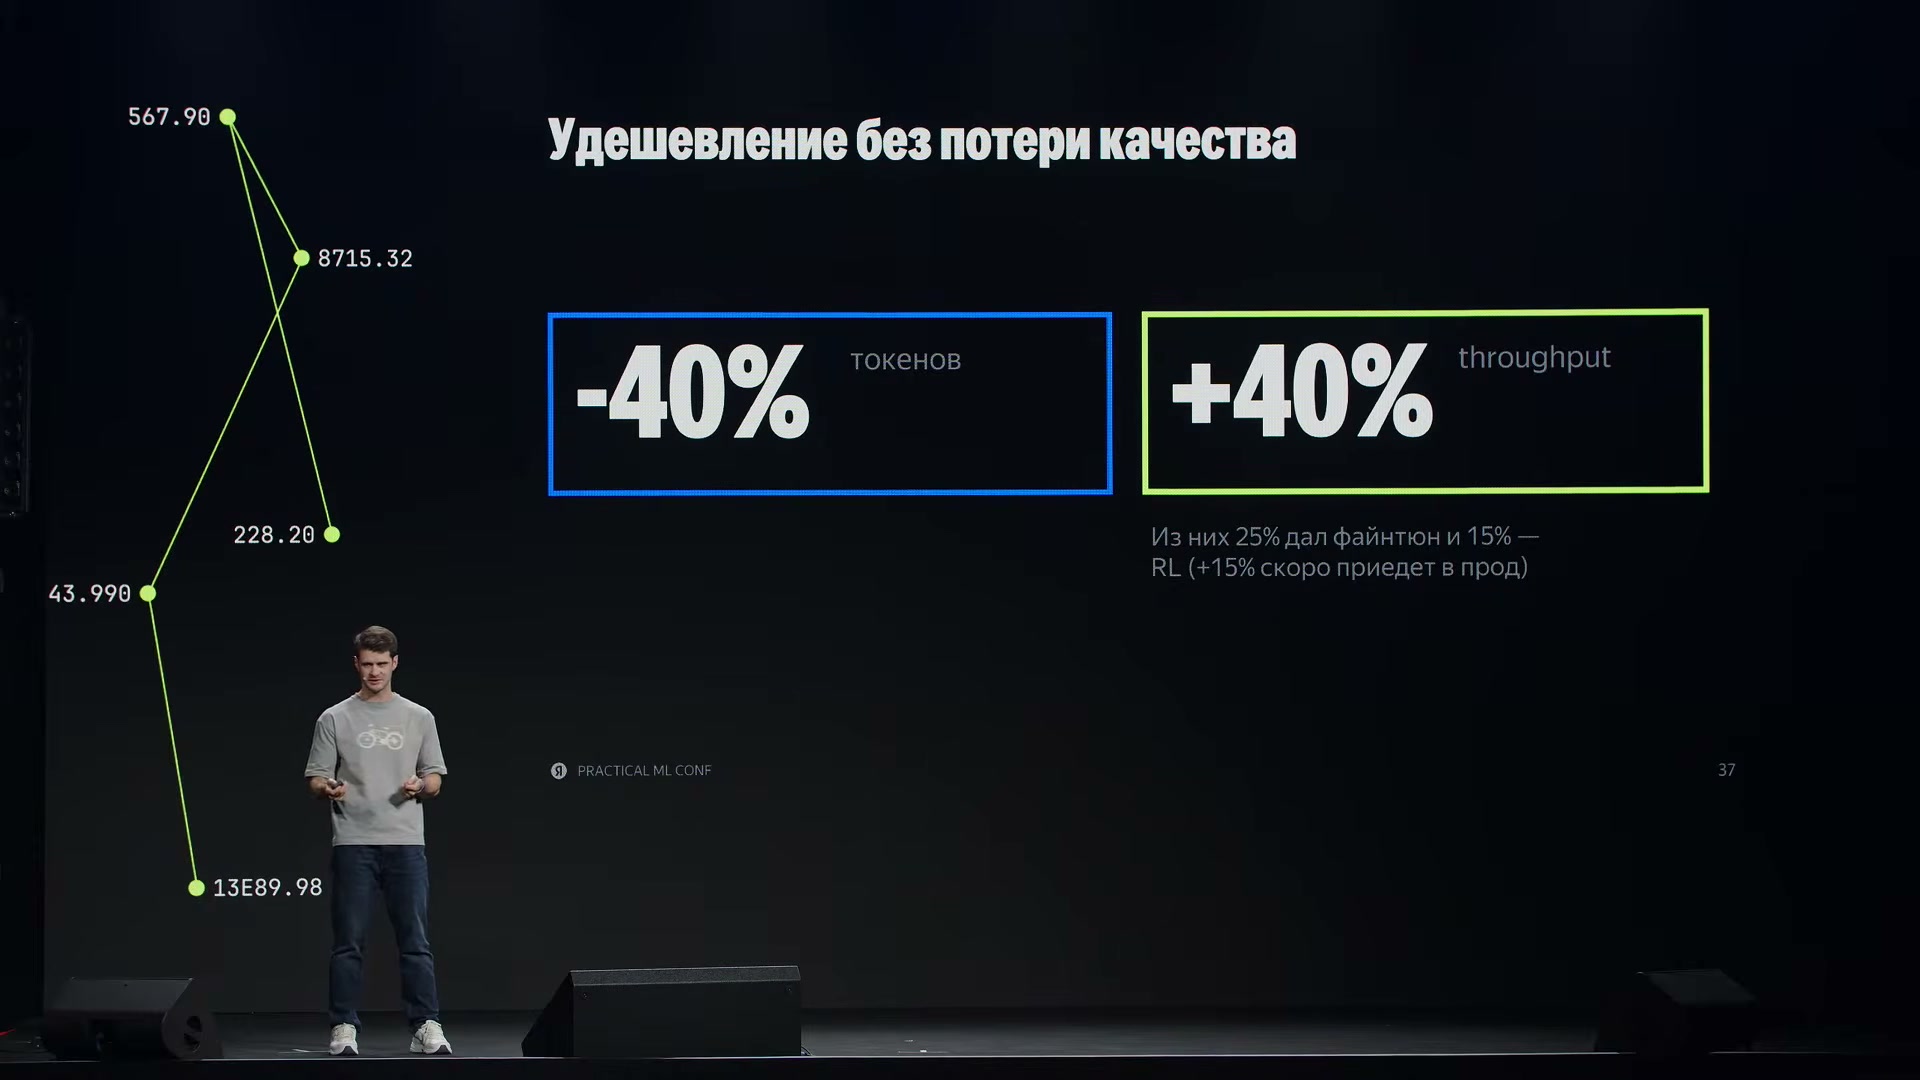
Оптимизация дала −40% входных токенов и +40% throughput. В авторской разбивке 25% связаны с дообучением, 15% — с RL; последние +15% ещё ожидали внедрения.
Источник: Артур ПетросянЧто изменилось для пользователей
Финальная продуктовая проверка отличается и от бенчмарков, и от измерений производительности. В A/B-тесте команда сравнивала поведение реальных пользователей. На последнем слайде приведён прирост SPU; в устном объяснении докладчик связывает этот показатель с тем, как часто люди используют Поиск.
Таблицу можно прокрутить по горизонтали.
Эти результаты нельзя подменять друг другом. +0,34% по SPU — не доля побед модели, а изменение показателя в пользовательском эксперименте. 56,7% SbS — результат сопоставления ответов, а не процент людей, которые стали чаще пользоваться Поиском, и не доля безошибочных генераций.
Вся история поэтому содержит несколько уровней проверки. Архитектурные эксперименты помогли выбрать модель с подходящей стоимостью. Дообучение улучшило предпочтительность её ответов. Пользовательская награда дала +0,7% профицита в отдельном A/B-тесте. Итоговый продуктовый эксперимент показал +0,34% SPU. Полные протоколы этих проверок — длительность, размер групп и интервалы неопределённости — в докладе не раскрыты.
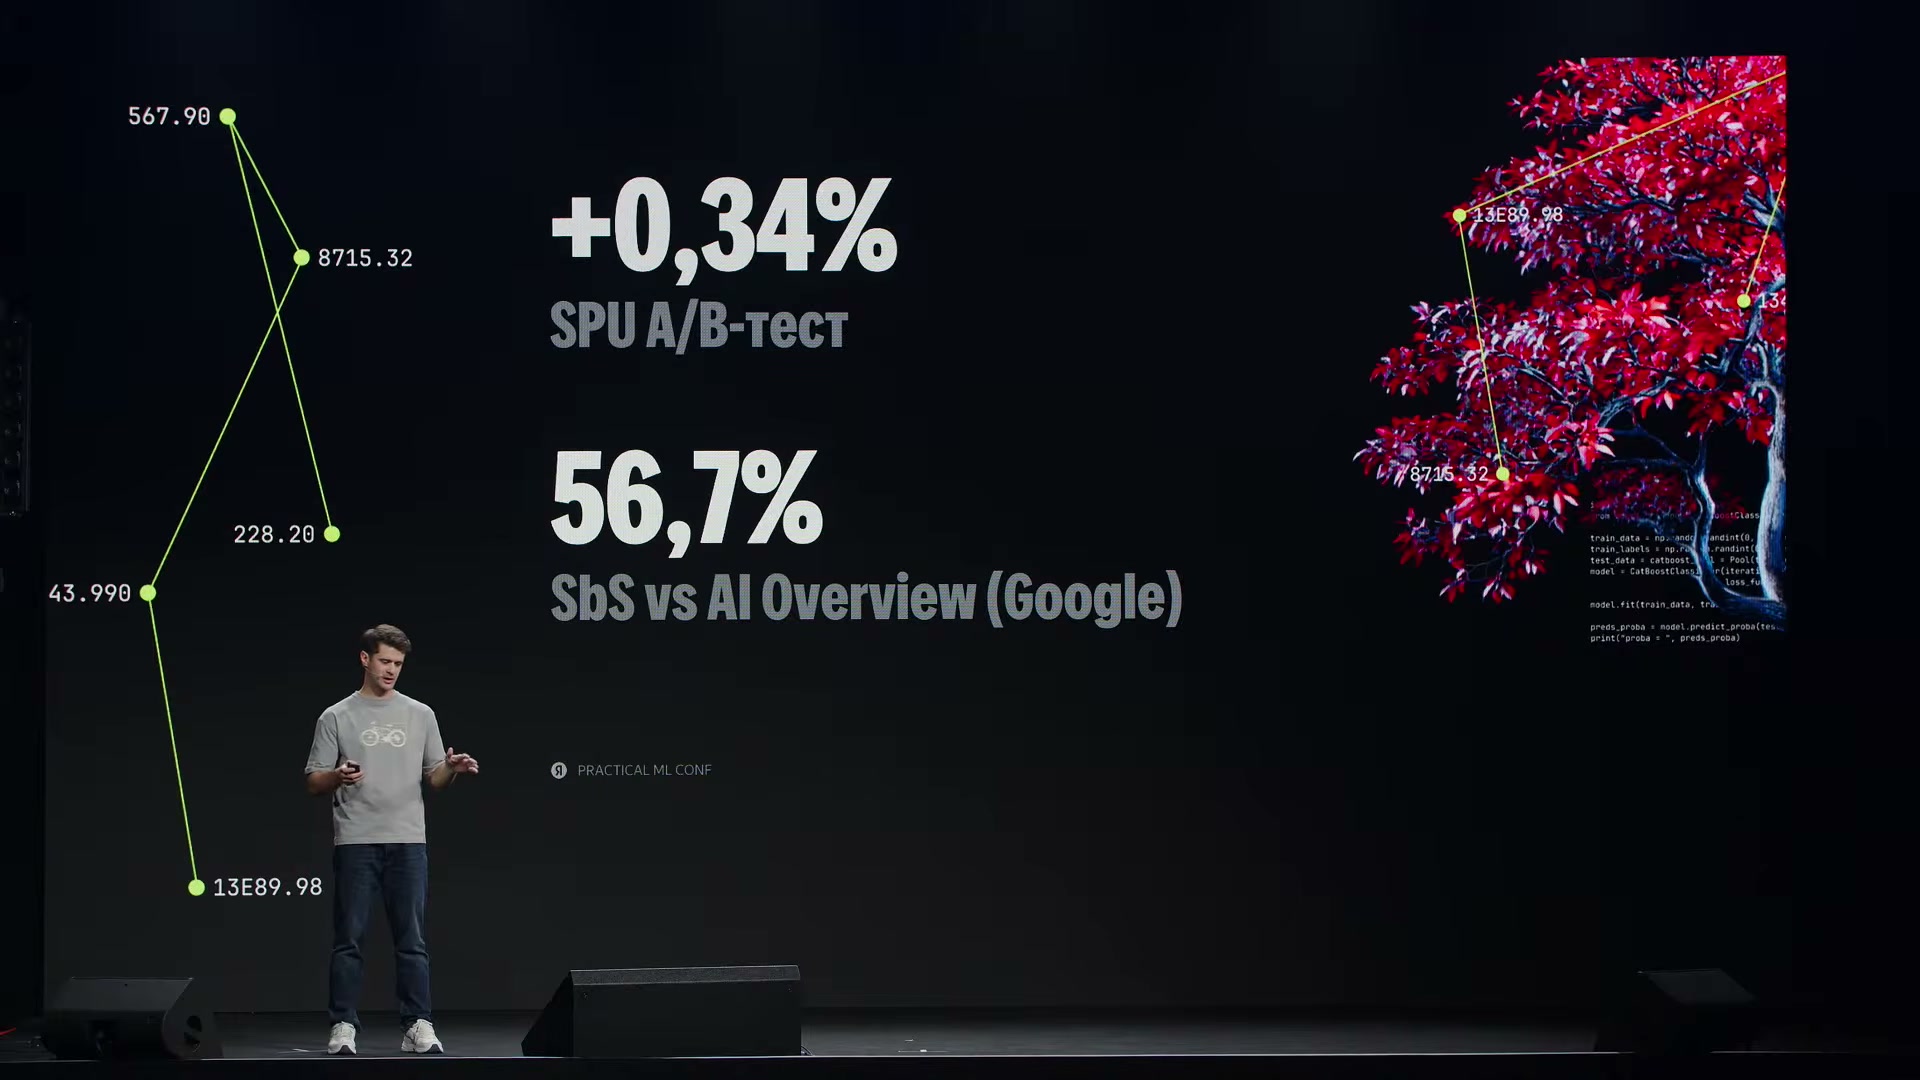
Итоговые проверки: +0,34% SPU в A/B-тесте и 56,7% SbS против AI Overview (Google). Это пользовательская метрика и парное сравнение ответов соответственно.
Источник: Артур ПетросянДостоверность, экономика продукта и незавершённые направления
Вопросы после выступления уточняют несколько границ решения. Первая касается достоверности. Если модель чаще использует собственные знания, она может воспроизвести устаревший факт, даже когда найденные документы содержат обновлённую информацию. Команда не ставила отдельной целью запретить использование знаний из параметров: докладчик считает главным критерием правильность ответа, а не происхождение каждого факта.
Уровень достоверности удерживали с помощью награды за проверку фактов при обучении. По словам докладчика, его не допускали до ухудшения, но ошибки не считались устранёнными. Неправильные или неподтверждённые утверждения, обычно называемые галлюцинациями, продолжали встречаться. Наличие найденных документов и соответствующей награды само по себе не гарантировало верность каждой генерации.
Вторая граница — экономика Поиска. Из зала спросили, не уменьшают ли хорошие готовые ответы внимание к рекламе и рекламную выручку. Ответ сводился к необходимости баланса между выручкой, удобством пользователя и восприятием продукта. Численных результатов по рекламе не приводилось. Поэтому улучшение SPU или профицита нельзя автоматически объявлять измеренным ростом дохода.
Третье направление — передача поведения более сильной модели компактной, то есть дистилляция. Рабочую модель команда уже сделала настолько большой, насколько позволяла требуемая скорость ответа. При этом простое перенесение поведения доступных крупных моделей могло подавлять специфические свойства поискового продукта: их поведение не полностью совпадало с нужным.
Вопрос касался в том числе дистилляции на собственных генерациях обучаемой модели — on-policy distillation. Для такого подхода нужно согласовать поведение учителя с продуктовыми требованиями и найти баланс между дистилляцией и обычным обучением по наградам. В обсуждении уточнили альтернативу: обучить отдельного большого учителя под нужные особенности, не отправляя его самого в продукт. Команда уже рассматривала этот вариант, но к моменту доклада он оставался в экспериментах.
Наконец, на вопрос о диффузионных моделях, другом подходе к генерации через последовательное уточнение результата, докладчик ответил, что команда их рассматривает. Архитектуру, предполагаемую роль и результаты он не раскрыл. Это направление дальнейшей работы, а не часть уже показанного решения.
Доклад · 00:35:31Итог: качество и скорость пришлось улучшать совместно
Команда сохранила разделение чтения и генерации после сравнений, в которых небольшая T5 оказалась конкурентоспособной на поисковых ответах. Затем в Alice AI T5-35B-0.6A усилили энкодер, добавили разреженные экспертные слои и заменили нестабильную маршрутизацию. Подготовка модели включала отбор синтетических ответов, исправление неудачных примеров и повторяющееся обучение с подкреплением. Пользовательский сигнал помог приблизить обучение к решённой задаче, а оптимизация контекста — уменьшить вычислительные затраты. Все эти изменения готовятся отдельно от обработки очередного запроса.
- 01
Запрос и документы
Поиск получает вопрос пользователя и предоставляет найденные документы. Именно из этих материалов система выбирает сведения для будущего ответа.
- 02
Отбор контекста
Небольшой экстрактор выделяет полезные части документов. В генератор поступает сокращённый информационный контекст, а не весь исходный текст.
- 03
Обработка энкодером
Энкодер обрабатывает оставленные сведения с двунаправленным вниманием. Подготовленные представления становятся опорой для декодера.
- 04
Генерация с EAGLE-3
Декодер составляет ответ, обращаясь к представлениям энкодера. EAGLE-3 предлагает продолжения для ускорения генерации; основная модель проверяет их.
- 05
Показ ответа
Готовый ответ появляется в Поиске. Пользовательские действия затем могут стать данными для следующего обучения, но параметры не переобучаются ради этого ответа.
В итоговом A/B-тесте получено +0,34% по SPU, а в парном сравнении с AI Overview — 56,7% SbS. Отдельная оптимизация контекста дала −40% входных токенов и +40% пропускной способности без заявленной потери качества; её последние +15% ещё ожидали внедрения. Эти результаты относятся к разным проверкам. Архитектура требует дополнительной поддержки, поведенческие наблюдения остаются шумными, а награда за проверку фактов не устраняет все ошибки.
Доклад · 00:31:12