Трансформеры в поиске и рекламе: опыт Яндекса 2022 года
Точное сопоставление каждого кандидата с длинной историей пользователя дорого, а клик отражает не только релевантность. Доклад показывает раздельное вычисление представлений, сочетание старой и свежей истории и разложение кликового сигнала.
Видео · на русском
Кирилл Хрыльченко | Яндекс Трансформеры для персонализацииКирилл Хрыльченко · Опубликовано: 23 июня 2022 г.
Исходный доклад · Открыть оригинал
Раннее взаимодействие стоит дорого
Модель, которая совместно читает историю и каждого кандидата, может учитывать тонкие зависимости. Но повторять тяжёлую обработку для каждого объекта неудобно. Раздельное кодирование пользователя и кандидата позволяет повторно использовать вычисления.
Переход требует подбора архитектуры: механическая замена на два простых персептрона может потерять полезную информацию. Контрастивное предобучение и обучение под целевую задачу помогают вернуть качество.
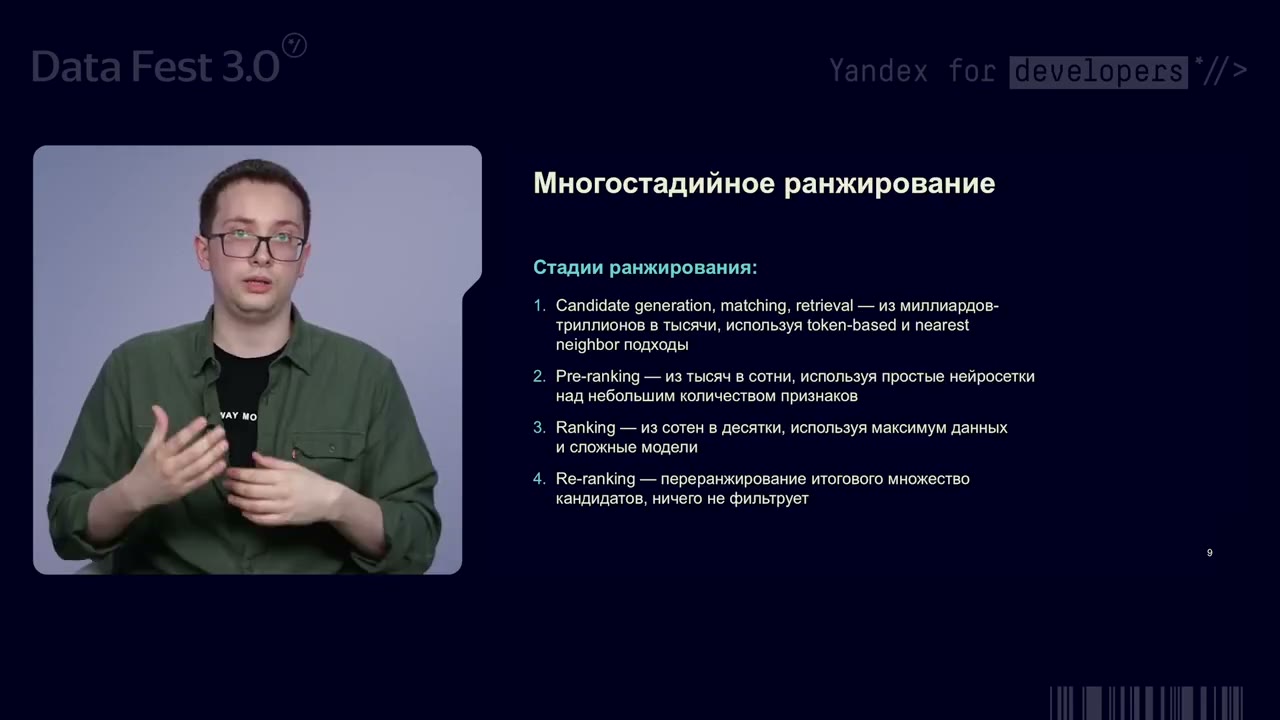
Многостадийное ранжирование.
Источник: Кадр из докладаДлинная история и свежие действия живут в разных режимах
Глубокую историю вычисляют заранее, а последние события обрабатывают в момент запроса. Так модель использует устойчивые интересы и реагирует на текущую сессию, не пересчитывая всю жизнь пользователя онлайн.
Эта декомпозиция обсуждается как условие масштабирования, а не только ускорение одного слоя. Увеличение доступного контекста само по себе может быть ценнее усложнения обработки короткой истории.
24:00 — фрагмент докладаКлик нельзя приравнять к полезности
Пользователь может не увидеть хороший результат внизу страницы, довериться высокой позиции или нажать на знакомый бренд и кликбейт. Предшествующие результаты также меняют вероятность просмотра следующего.
В докладе вероятность клика раскладывается на компоненты: просмотр, релевантность и дополнительные причины реакции. Это позволяет получать более интерпретируемые сигналы вместо одного смешанного прогноза.
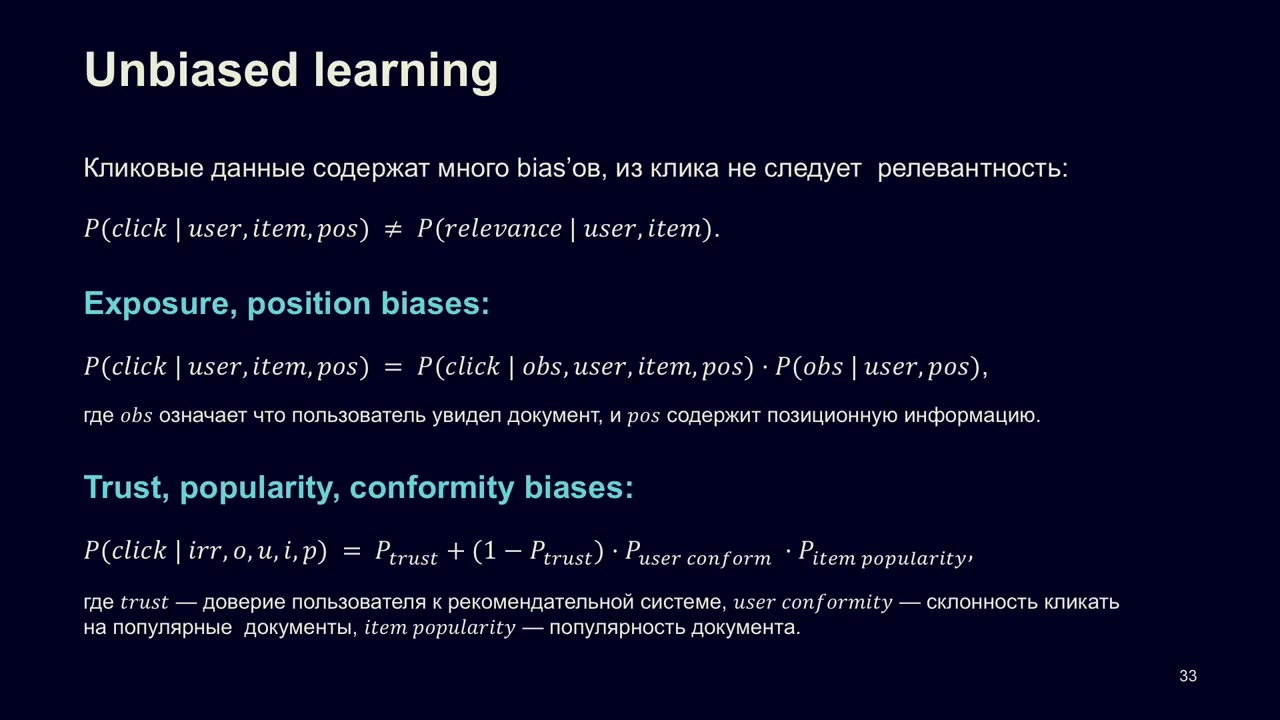
Смещения в данных о кликах.
Источник: Кадр из докладаКак использовать модель внутри действующей системы
Нейросеть может поставлять признаки существующему бустингу. Тогда способ её обучения стоит согласовать с задачей финального ранжировщика: в докладе отмечена польза попарной постановки.
Дистилляция помогает уменьшить модель, а многозадачное обучение — совместно использовать более частые клики и редкие конверсии. Конкретные выигрыши зависят от поверхности и целевой метрики; доклад не даёт универсального коэффициента ускорения любой рекомендательной системы.
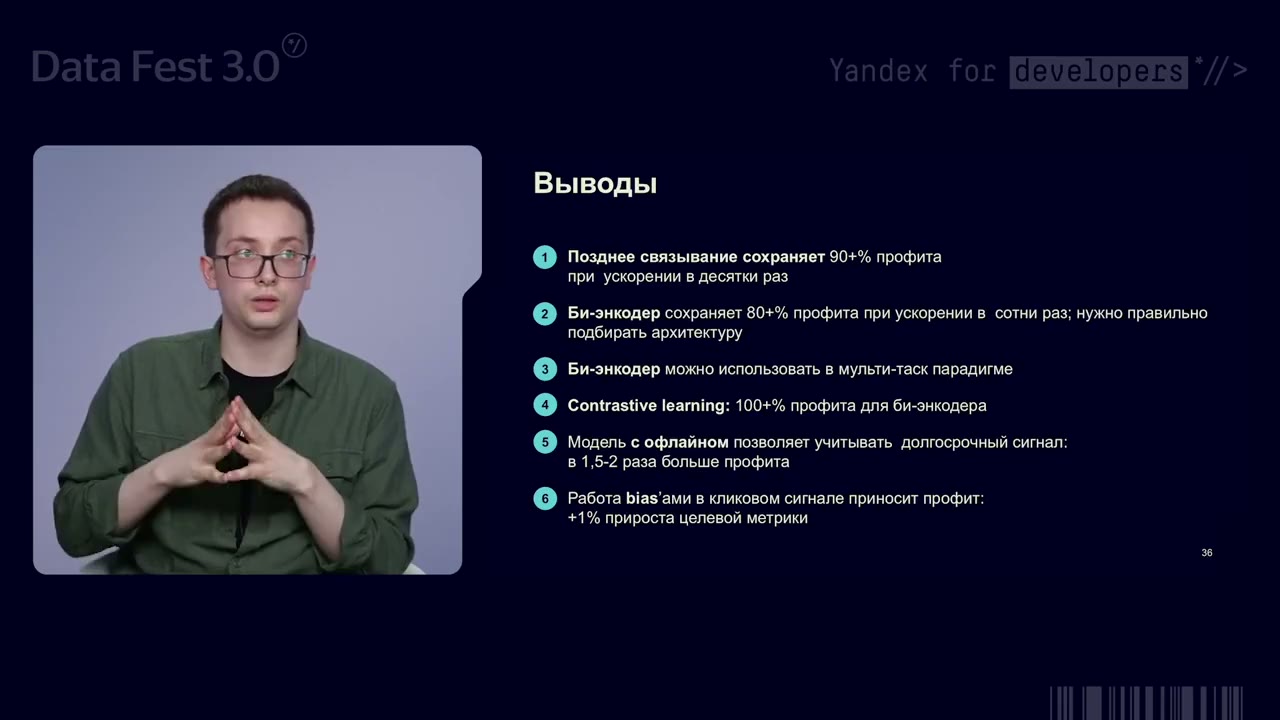
Выводы докладчика о применении моделей.
Источник: Кадр из доклада