Когда нейросетевой ранжировщик может заменить CatBoost
На небольших табличных датасетах бустинг часто сильнее. Но рекомендации располагают большим потоком данных, ID высокой размерности и выходами других нейросетей. Яндекс исследует кодирование числовых признаков, явные взаимодействия и масштабирование обучения.
Видео · на русском
Нейросетевое ранжирование для рекомендательных систем / Кирилл ХрыльченкоКирилл Хрыльченко · Опубликовано: 14 января 2025 г.
Исходный доклад · Открыть оригинал
Почему сравнение с обычными таблицами неполное
Ранжировщик оценивает уже отобранные объекты и может использовать богатые совместные признаки пользователя и кандидата. В индустриальных рекомендациях объём данных существенно больше многих академических табличных задач.
Категориальные признаки, включая ID объектов, можно представить обучаемыми векторами. Для числовых значений важны распределения, пропуски и способ кодирования: просто подать необработанные числа в сеть недостаточно.
03:00 — фрагмент докладаПолносвязные слои не решают всё
Если только соединить векторы признаков и подать их в MLP, полезные комбинации могут усваиваться плохо. Пример — сочетание страны и языка, которое несёт больше смысла, чем два отдельных значения.
Deep & Cross Network явно моделирует взаимодействия. В описанной архитектуре такой блок располагают перед полносвязными слоями либо используют параллельно. Низкоранговые разложения помогают сократить вычисления; выходы других моделей также добавляют информацию.
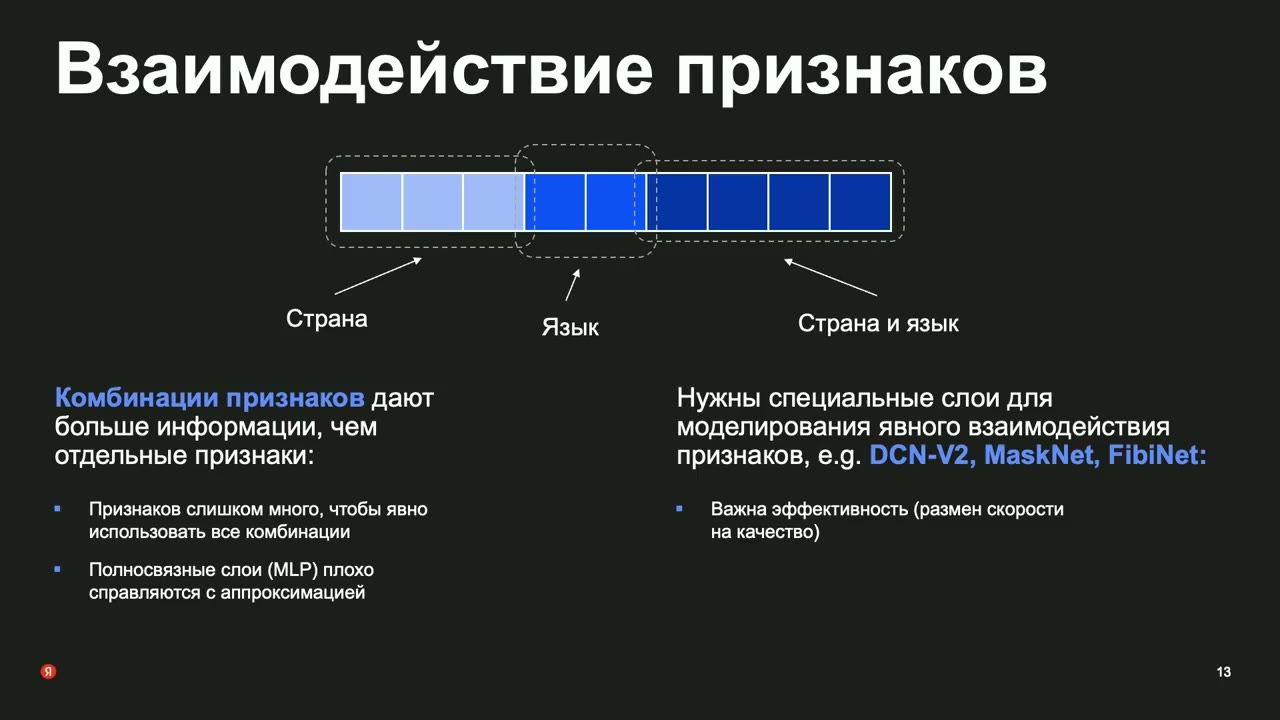
Взаимодействие признаков в нейронной модели.
Источник: Кадр из докладаМасштаб данных меняет сравнение
В экспериментах увеличение обучающей выборки ограничивалось памятью бустинга, тогда как нейросеть могла учиться по частям. Поэтому сравнение одной пары моделей на небольшом фиксированном наборе не отвечает на вопрос о пределе каждой технологии.
Доклад показывает результаты для Маркета, Музыки и рекомендаций фильмов. Метрики в доменах различаются и относятся к offline-ранжированию: их нельзя складывать или представлять как единый рост бизнеса.
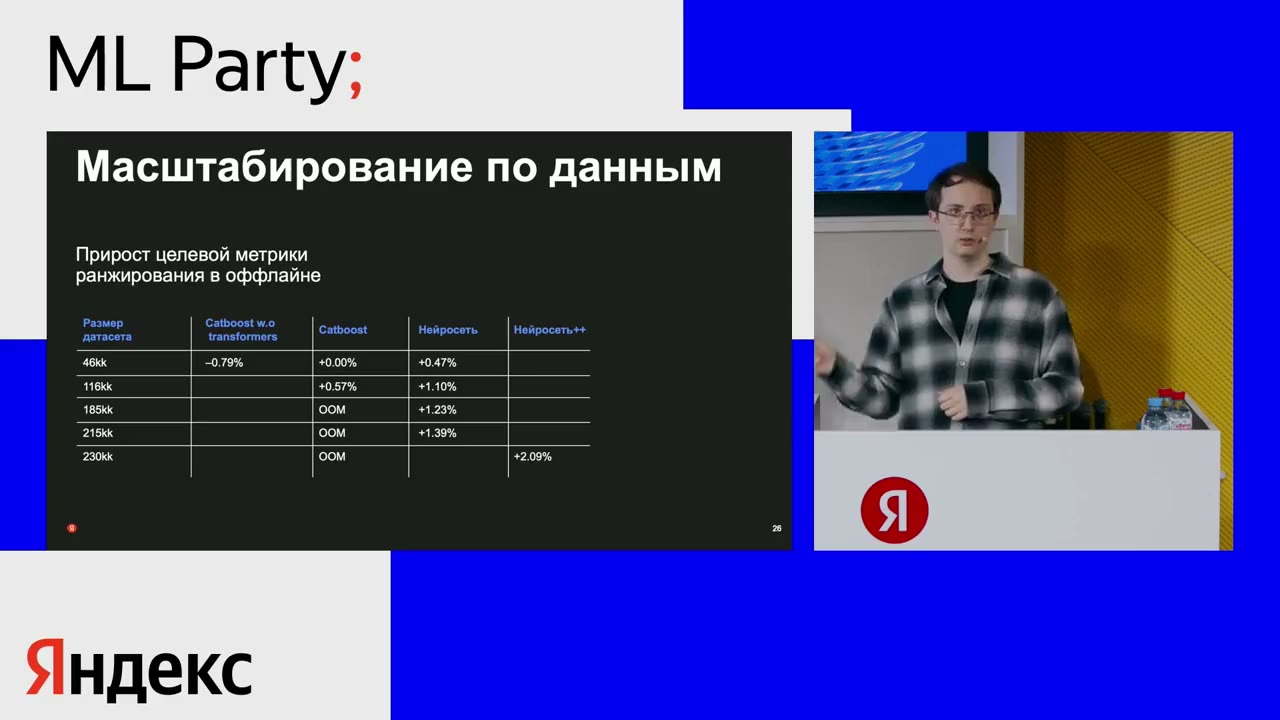
Сравнение при увеличении объёма данных.
Источник: Кадр из докладаОнлайн-проверка остаётся отдельной задачей
Для первого внедрения подготовили применение на CPU, чтобы проще заменить существующий бустинг. Однако исторические логи собраны прежней системой. Новый ранжировщик изменит показы и распределение обратной связи.
Потребуется наблюдение в A/B-тесте и обучение на собственных показах. Оно может как исправить прежние смещения, так и усилить новые. На момент выступления заявлять окончательный онлайн-эффект было рано.
17:00 — фрагмент доклада